
AI Agent 面试题第一弹:ReAct、Plan-and-Execute、Multi-Agent 核心架构 13 题
第一弹,聚焦 Agent 核心架构——ReAct、Plan-and-Execute、Multi-Agent、异步并行。
这几个方向面试出现的频率最高,也是 PaiCLI 第 1、2、5、7 期的核心内容。
01、什么是 ReAct 模式?
ReAct 是 Reasoning + Acting 的缩写,Yao et al.(姚顺雨)在 2022 年提出。
核心就一句话:让 LLM 在推理的同时能执行动作,根据动作结果继续推理,形成一个闭合的循环。
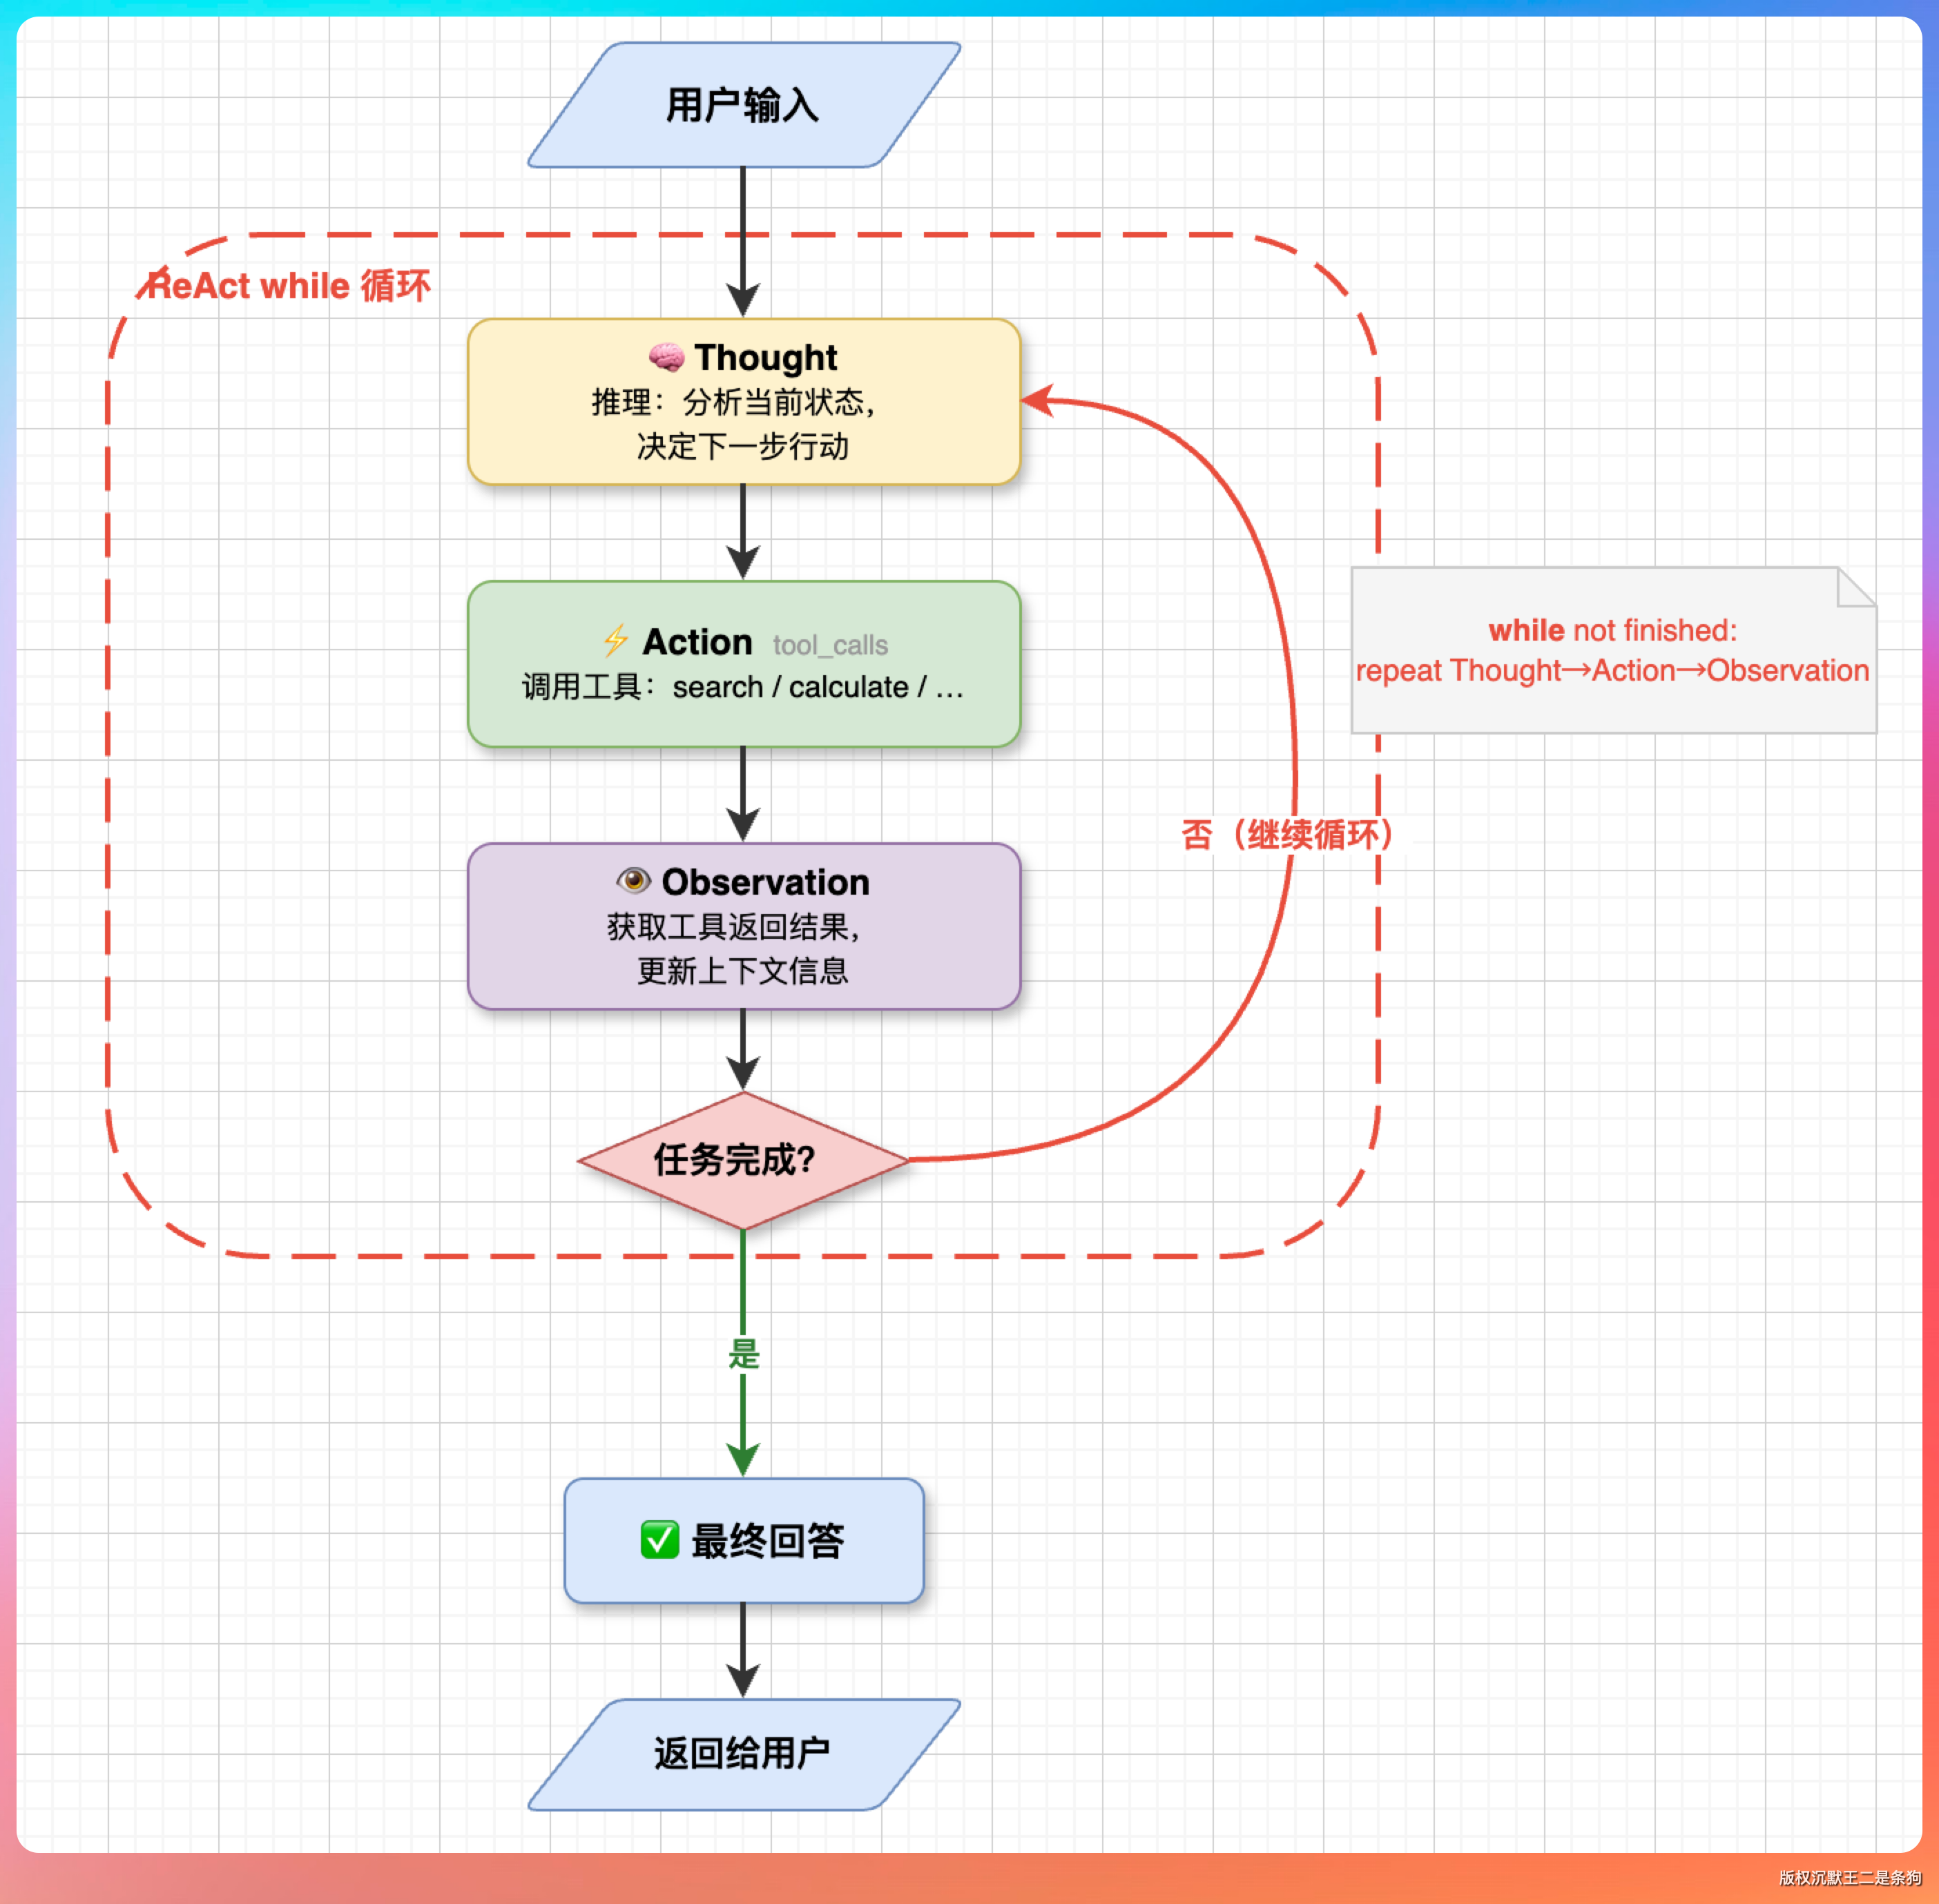
PaiCLI 第一期的 Agent.java 就是一个标准的 ReAct 实现。核心是一个 while 循环,每轮做三件事:
- 把消息历史发给 LLM、
- 检查响应里有没有
tool_calls - 有的话执行工具把结果塞回历史。
LLM 不再返回 tool_calls 就退出循环,把最终回复输出给用户。
整个 Agent 的骨架就这么简单。
它和 Chain-of-Thought 有什么区别?
Chain-of-Thought(CoT)只推理不执行。
LLM 一口气想完所有步骤,直接输出最终答案。做数学题、逻辑推理可以,但碰到“帮我读一下 pom.xml”这种需要外部信息的任务就歇菜了——LLM 没有读文件的能力,想得再好也是瞎猜。
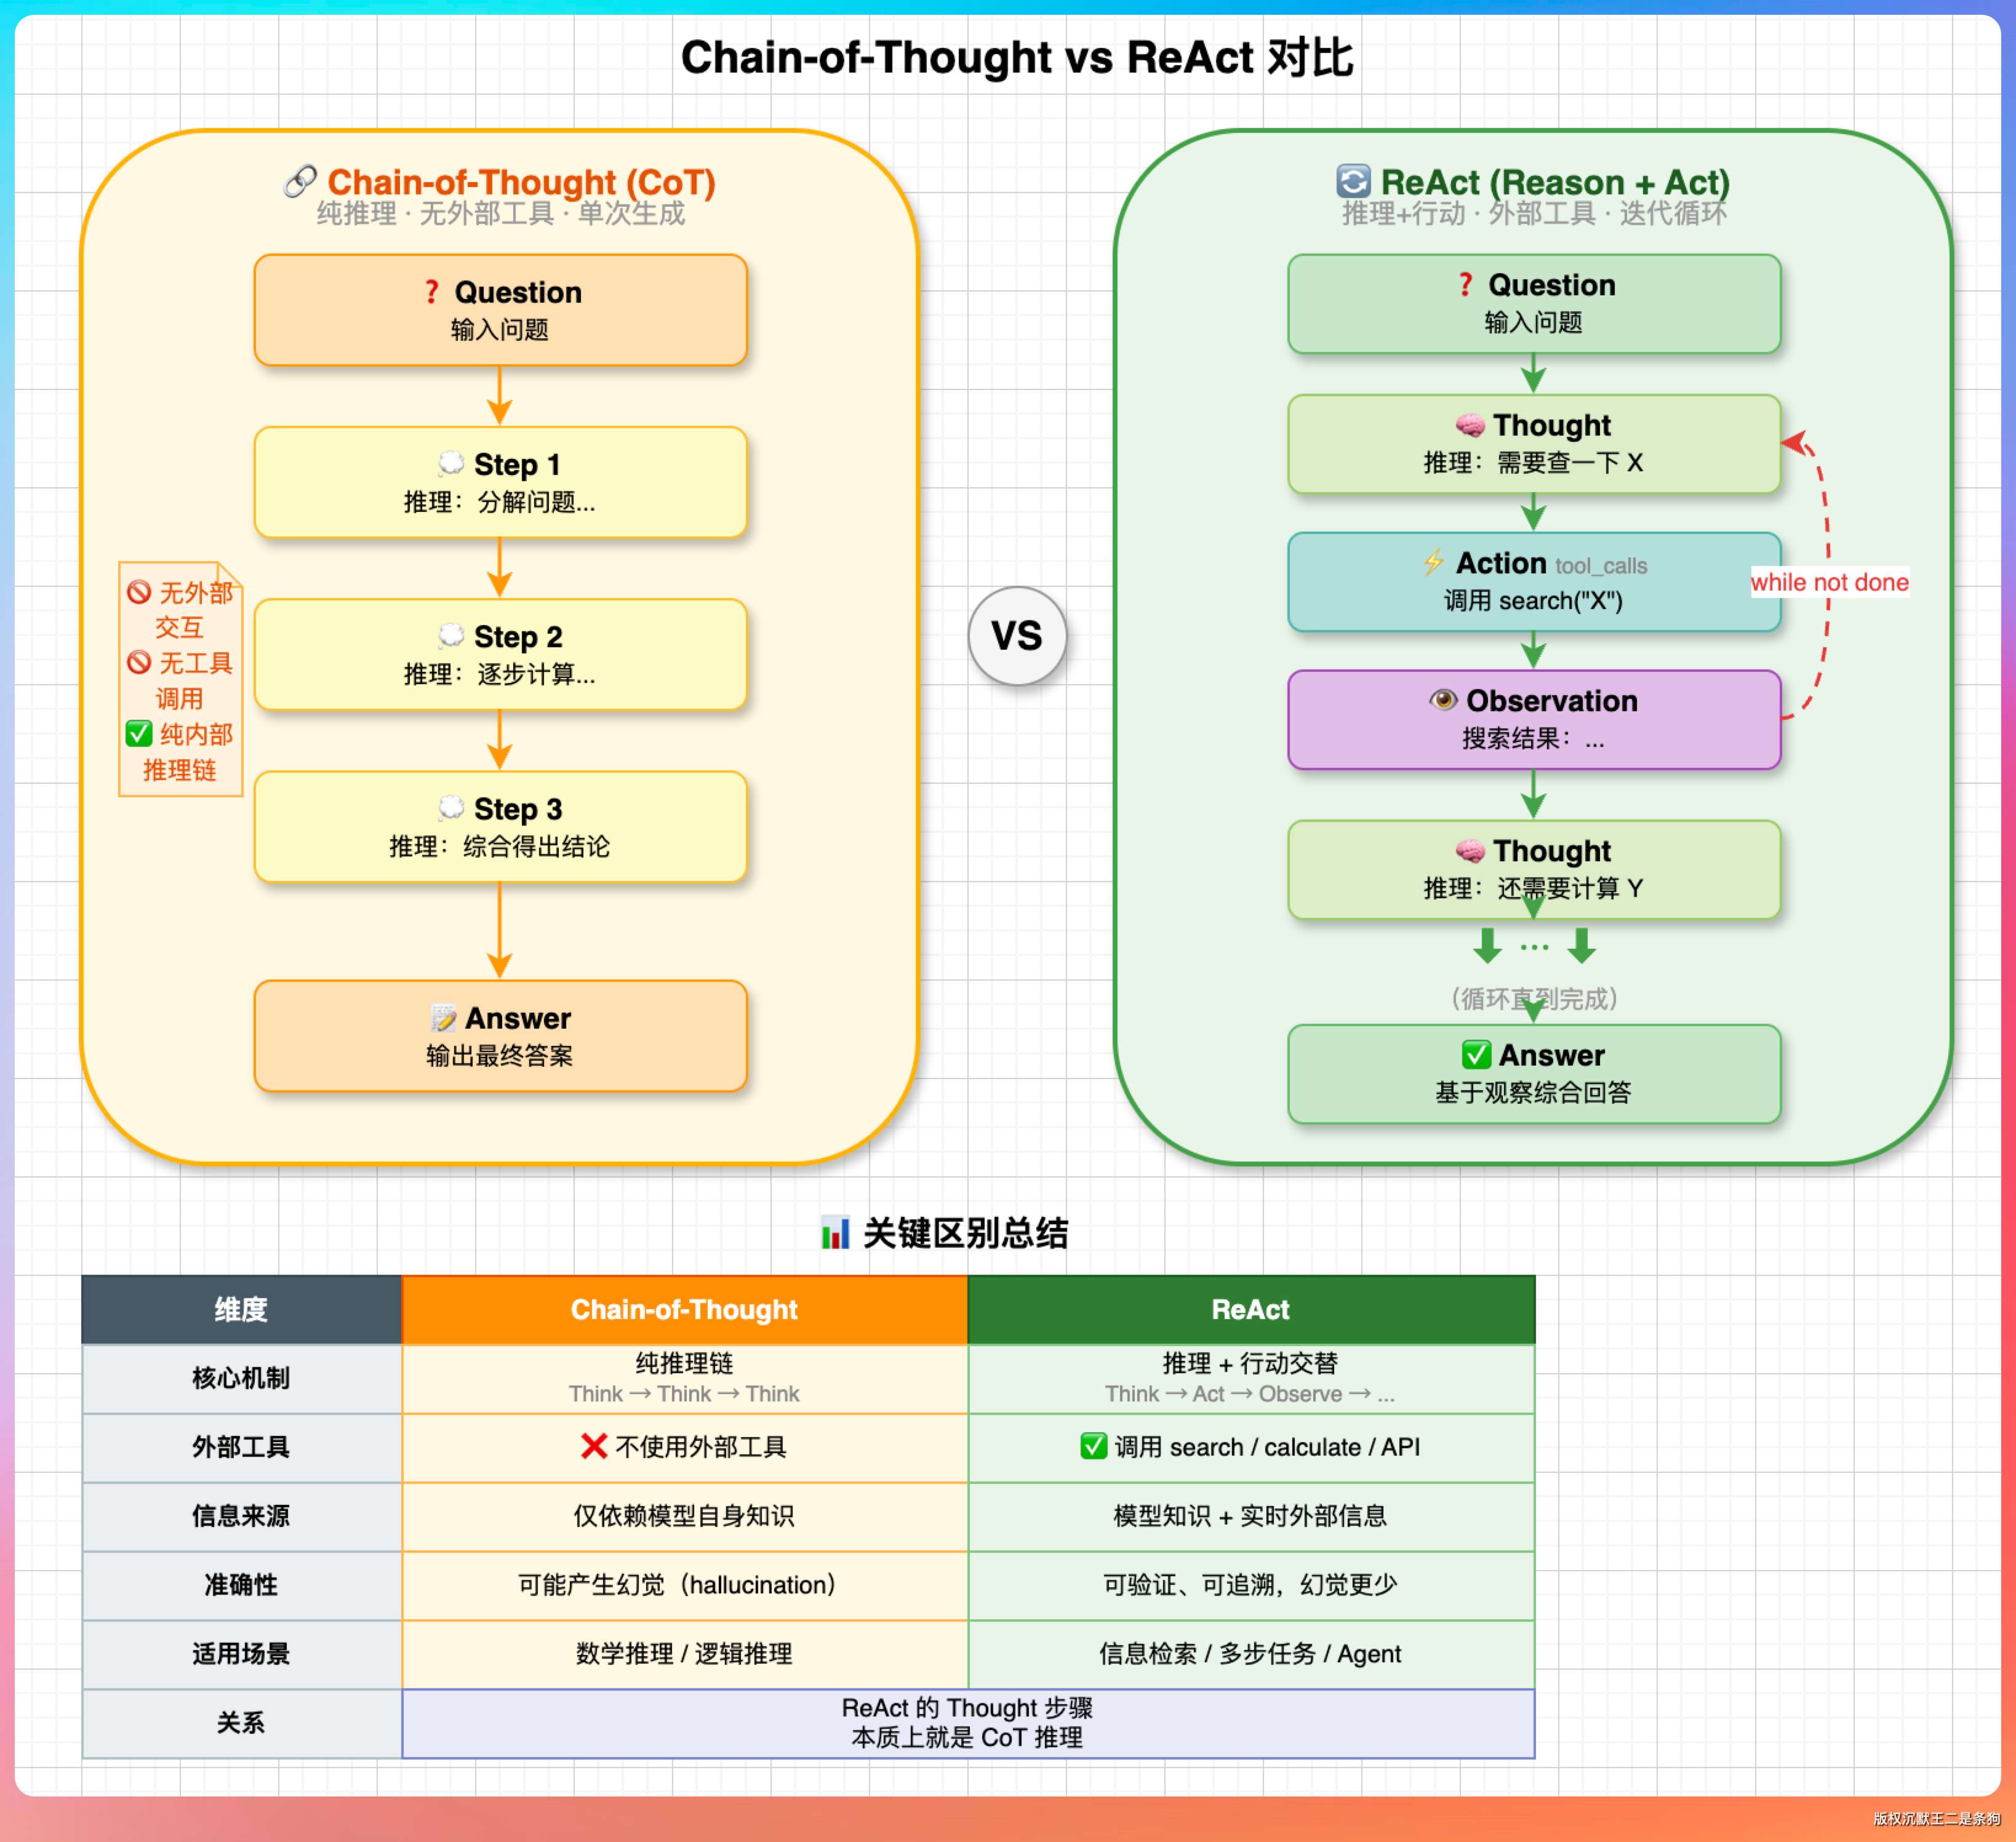
ReAct 的突破在于加了 Action 和 Observation 两个环节。LLM 想到“我需要读 pom.xml”,就输出一个 read_file 的 tool_call,Agent 真去读了文件,把内容返回回来,LLM 基于真实的内容继续推理。
用一个表格说清楚两者的边界:
| 维度 | CoT | ReAct |
|---|---|---|
| 能力范围 | 纯推理 | 推理 + 外部工具调用 |
| 信息来源 | 训练数据里的知识 | 实时获取(文件、命令、搜索) |
| 适合场景 | 数学、逻辑、代码生成 | 需要与外部世界交互的任务 |
| 典型产品 | ChatGPT 的思考过程 | Claude Code、PaiCLI、Cursor |
面试官追问到这一步,可以补一句:
PaiCLI 的 LLM 响应里也有 reasoning_content(思考过程),这个其实就是 CoT 的部分。
ReAct 在 CoT 的基础上加了行动能力,推理之后可以真的去调用工具、拿到观察结果再接着推理。思考内容怎么处理要看模型:DeepSeek V4、GLM-5.3、混元 Hy4 和 Kimi 的思考模式要求带工具调用的那条 assistant 消息,必须把 reasoning_content 原样带回下一轮请求,这是这几家接口在思考模式下的约定,PaiCLI 组装请求时会把这个字段补回去;其他 provider 的思考内容 PaiCLI 只写日志和展示,不进对话历史。
02、Agent 怎么知道该调用哪个工具?
这道题很多人会答错,以为 Agent 里有个什么路由规则在做工具匹配。实际上 Agent 本身不做工具选择,选择权完全在 LLM 手里。
流程是这样的:Agent 在构造请求时,把所有可用工具的定义(名称 + 描述 + 参数 JSON Schema)放在请求体的 tools 字段里发给 LLM。LLM 根据用户意图和工具描述,在响应的 tool_calls 字段里返回工具名和参数 JSON。
这就是 OpenAI 定义的 Function Calling 协议,GLM、DeepSeek、Kimi 这些国产模型也都兼容。
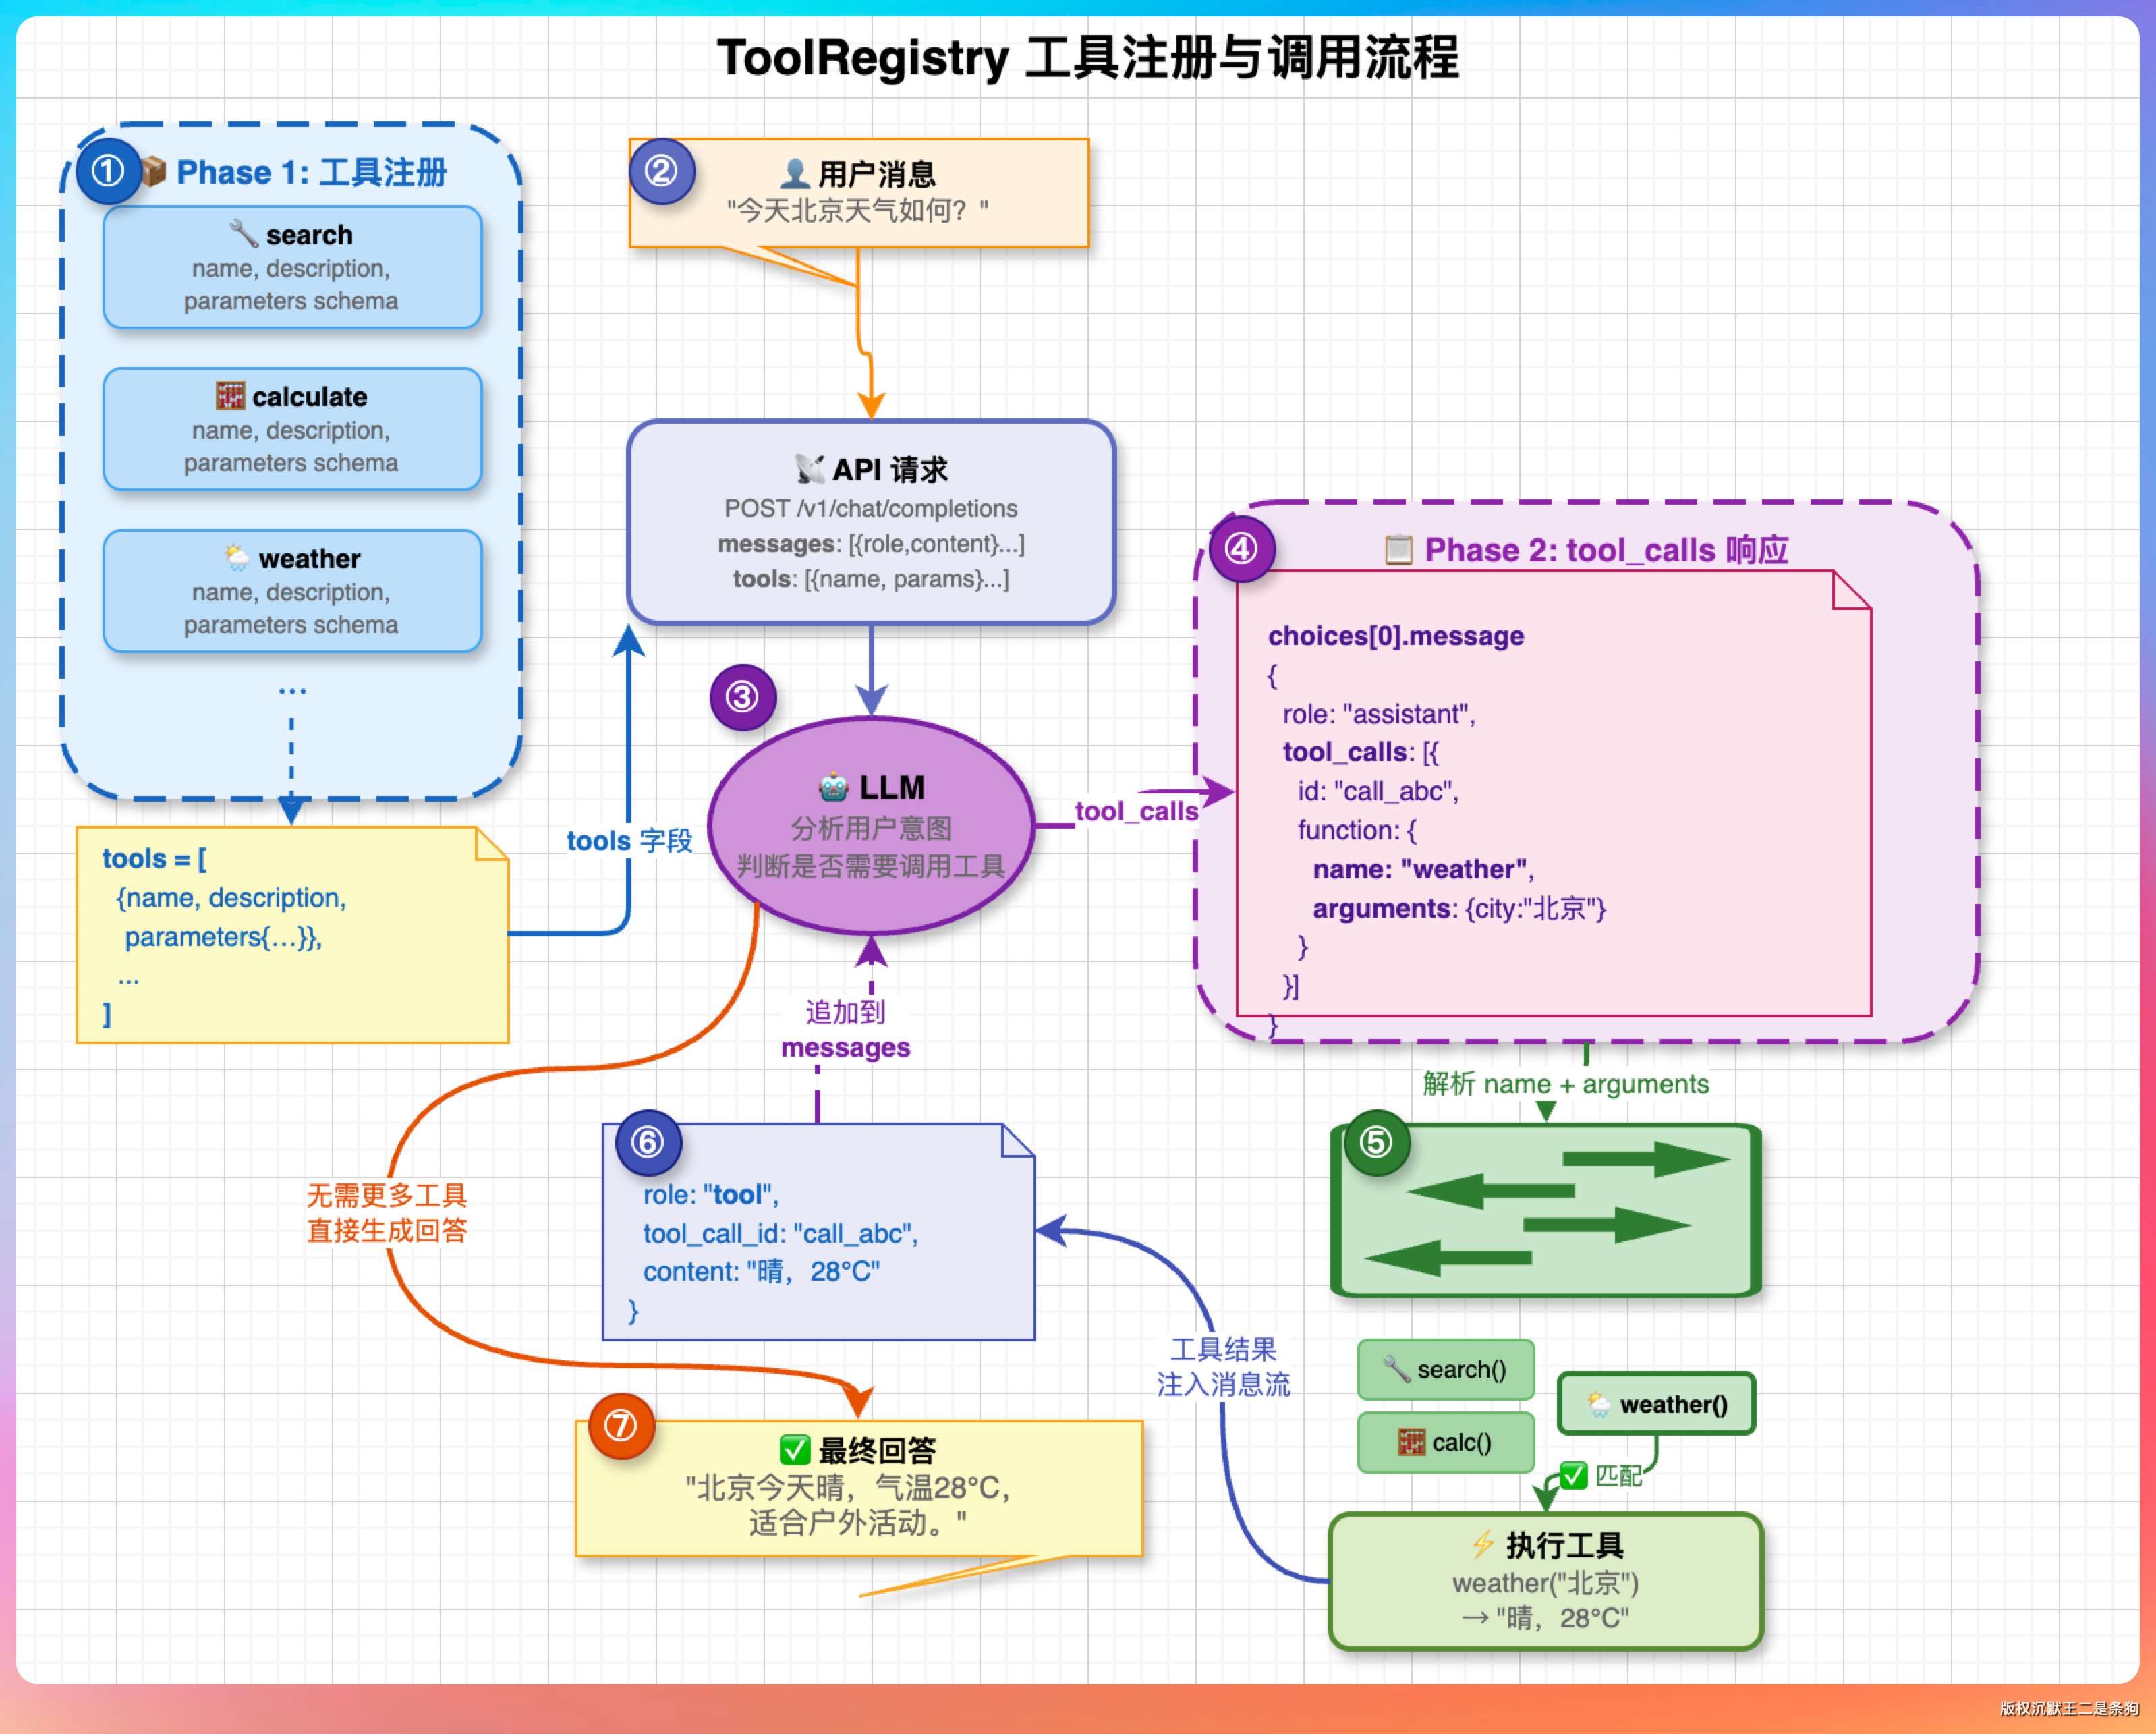
PaiCLI 的 ToolRegistry.java 维护了一个工具注册表。每个工具注册时提供 name、description、parameters schema。Agent 每次请求 LLM 前,从注册表拉出全量工具定义塞进请求体。LLM 返回 tool_calls: [{name: "read_file", arguments: {path: "pom.xml"}}],Agent 就从注册表里找到 read_file 的执行逻辑来跑。
// ToolRegistry.java 核心结构
private final Map<String, ToolDefinition> tools = new LinkedHashMap<>();
private final Map<String, ToolExecutor> executors = new LinkedHashMap<>();

public String executeTool(String name, String argumentsJson) {
    ToolExecutor executor = executors.get(name);
    if (executor == null) {
        return "未知工具: " + name;
    }
    return executor.execute(argumentsJson);
}这里有个实战经验值得提一下:工具描述的质量直接决定 LLM 的选择准确率。
PaiCLI 早期 execute_command 的描述写得太简洁,LLM 经常用 cat 代替 read_file 读文件。后来在描述里加了“在项目根目录执行的短时 Shell 命令,如 ls、mvn compile,不要用来读取文件内容”,准确率就上去了。
如果 LLM 返回了不存在的工具名怎么办
ToolRegistry.executeTool() 做了兜底——找不到工具就返回 "未知工具: xxx"。这个错误信息作为 tool message 塞回对话历史,LLM 下一轮看到了会自动修正。
但如果 LLM 反复返回不存在的工具名,说明 system prompt 或工具描述有问题,需要优化 prompt 而不是加更多兜底逻辑。
03、ReAct 循环会死循环吗?
会。
常见的死循环场景
场景一:execute_command 执行失败,LLM 不甘心,换个参数再试,又失败,无限重试。比如让 Agent 编译项目,mvn compile 报错了,LLM 改了一下代码再编译,又报错,改了再编译……
场景二:LLM 输出一段推理但不调用工具也不给最终答案。Agent 把这段推理塞回去再请求 LLM,LLM 继续自言自语,永远不收尾。
PaiCLI 怎么处理死循环的?
PaiCLI 源码里有四层防护:
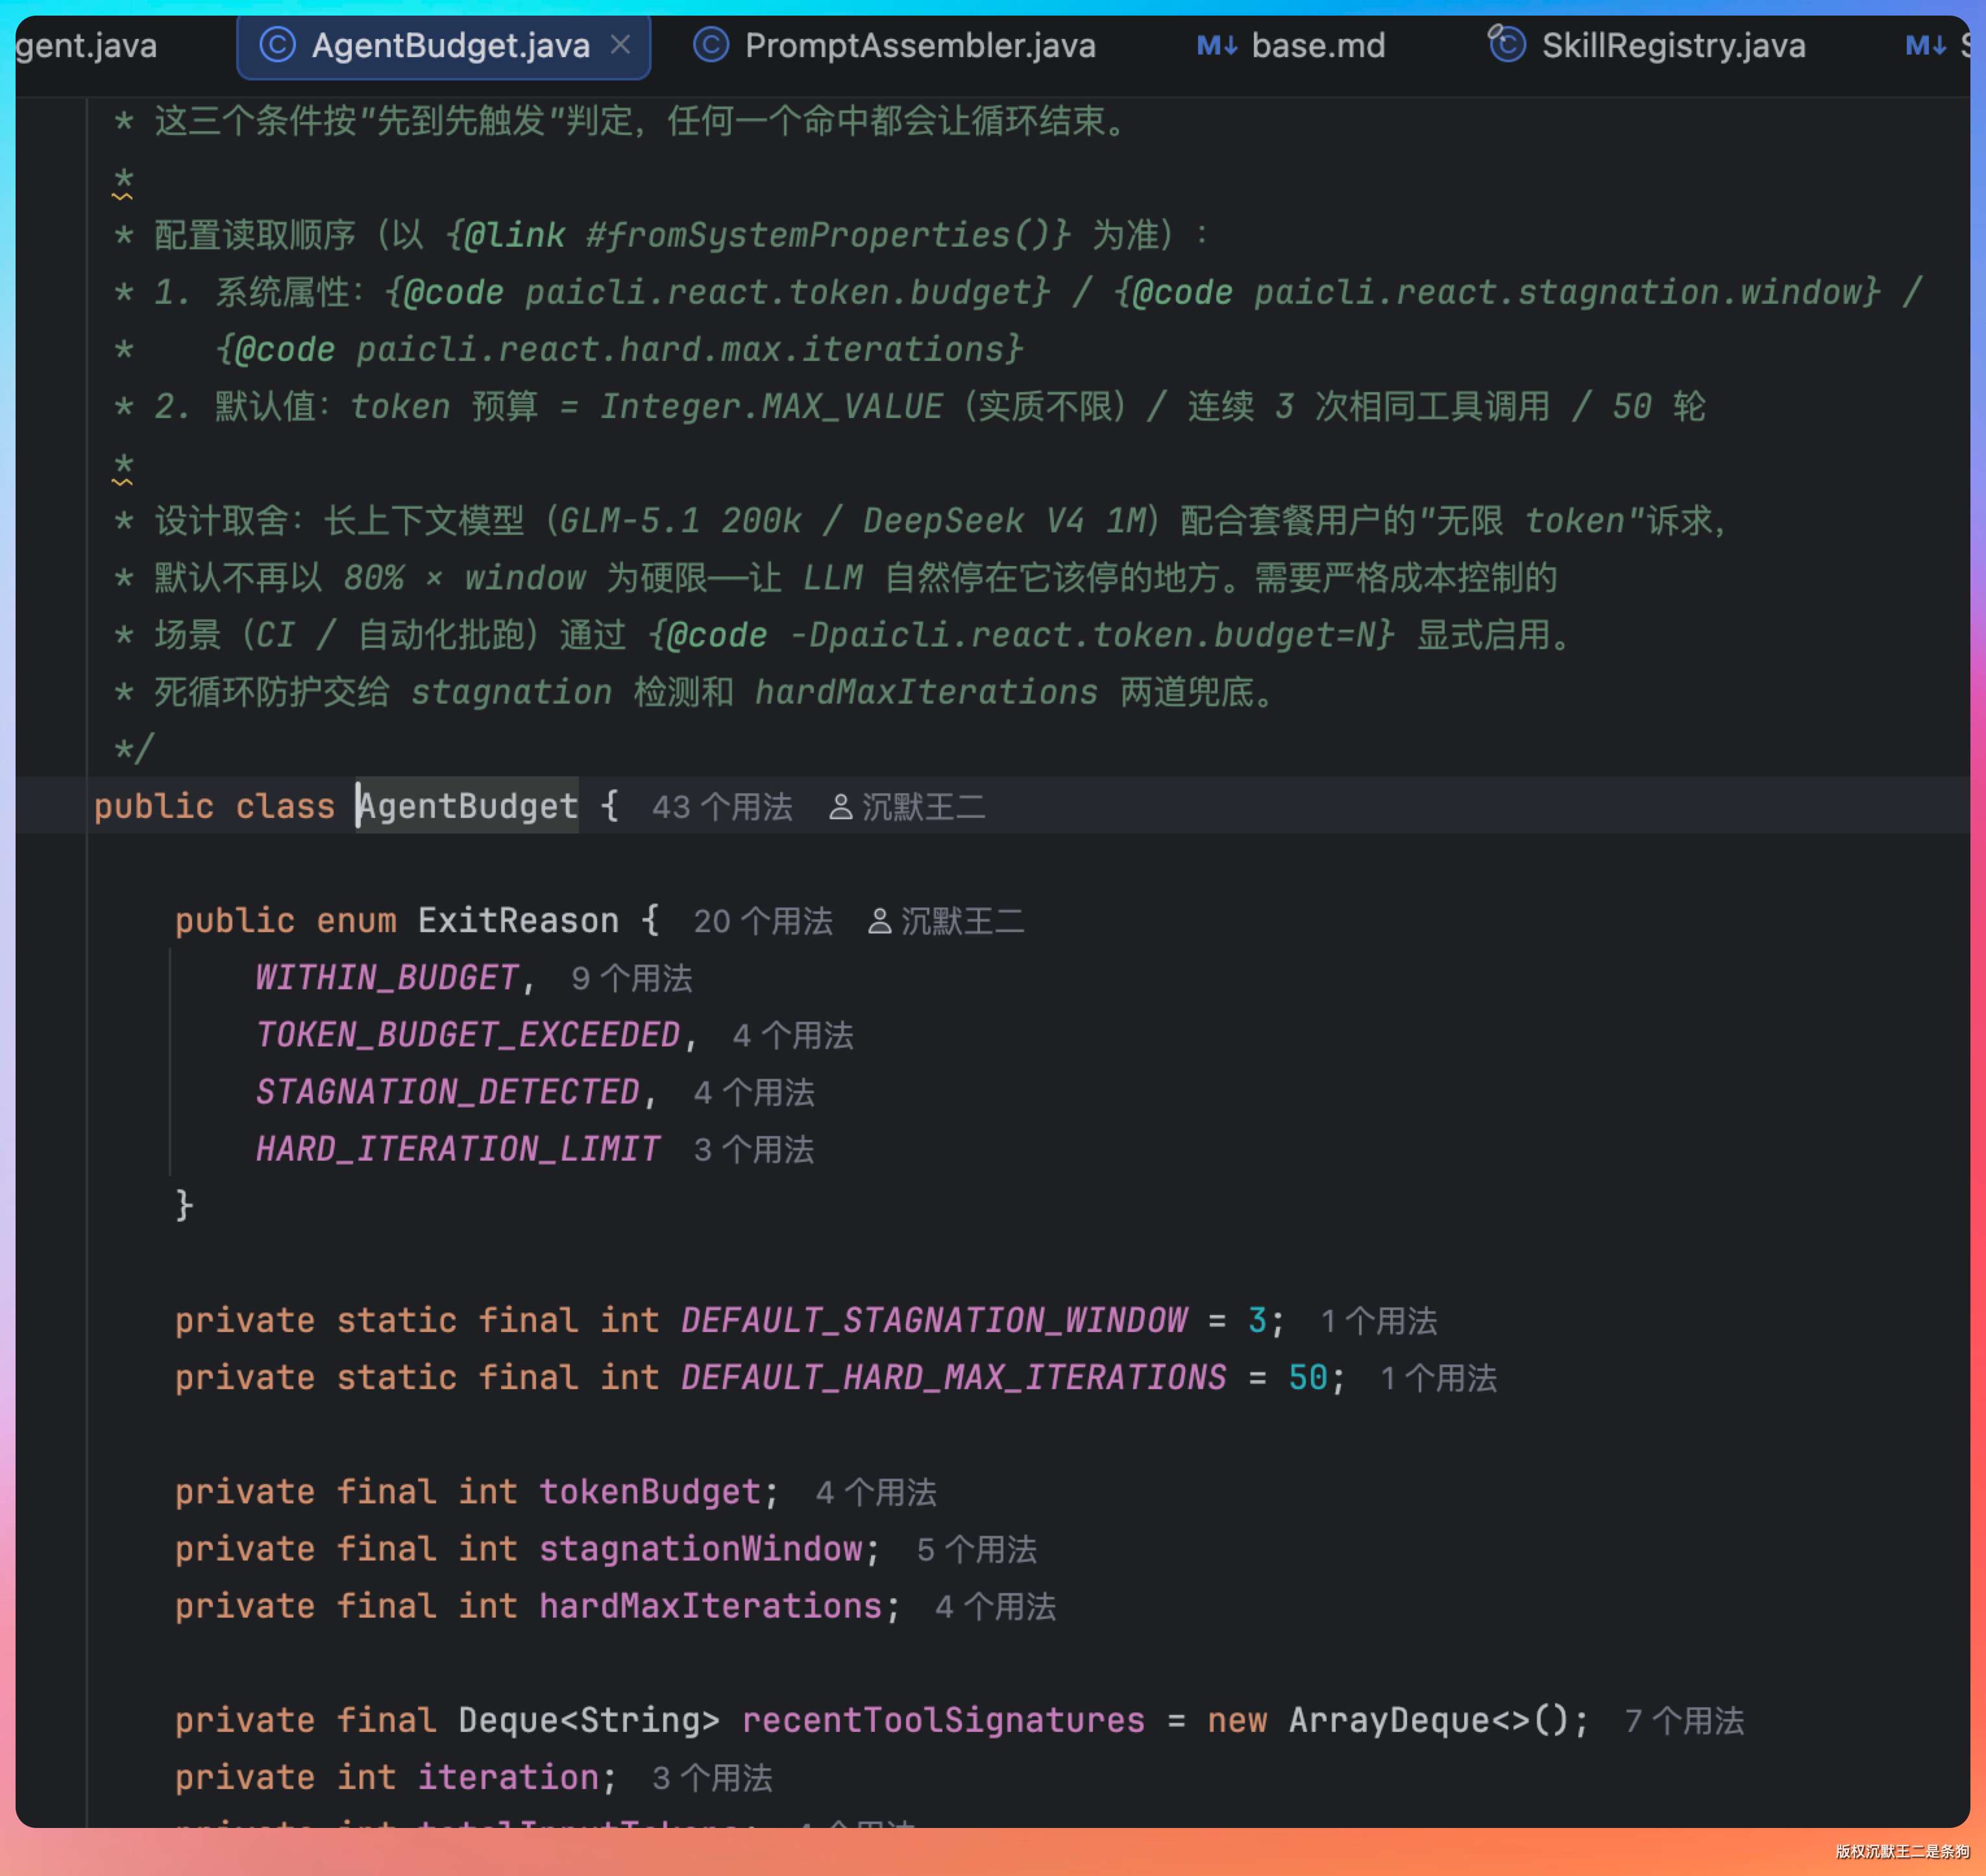
第一层是 循环预算和停滞检测。AgentBudget 管三个上限:轮数、Token 和停滞。早期版本写死最多 5 轮,复杂任务可能做不完,现在默认不限轮数和 Token,只开停滞检测,连续 3 轮工具名和参数完全相同就判定原地打转。轮数和 Token 上限可以在 CI、微信无人值守这类场景里显式配置。任何一项触发后,程序关掉工具再调一次模型,让它基于已有结果收尾,返回“⚠️ 部分完成”,已经做的工作不会丢。
第二层是 工具执行超时。execute_command 有 60 秒超时,超时直接返回超时结果给 LLM,不会卡在那里。
第三层是 用户取消。运行中按 ESC 或输入 /cancel 可以请求取消当前 Agent run。ReAct、Plan、Team 三条路径在边界处都会检查取消信号。
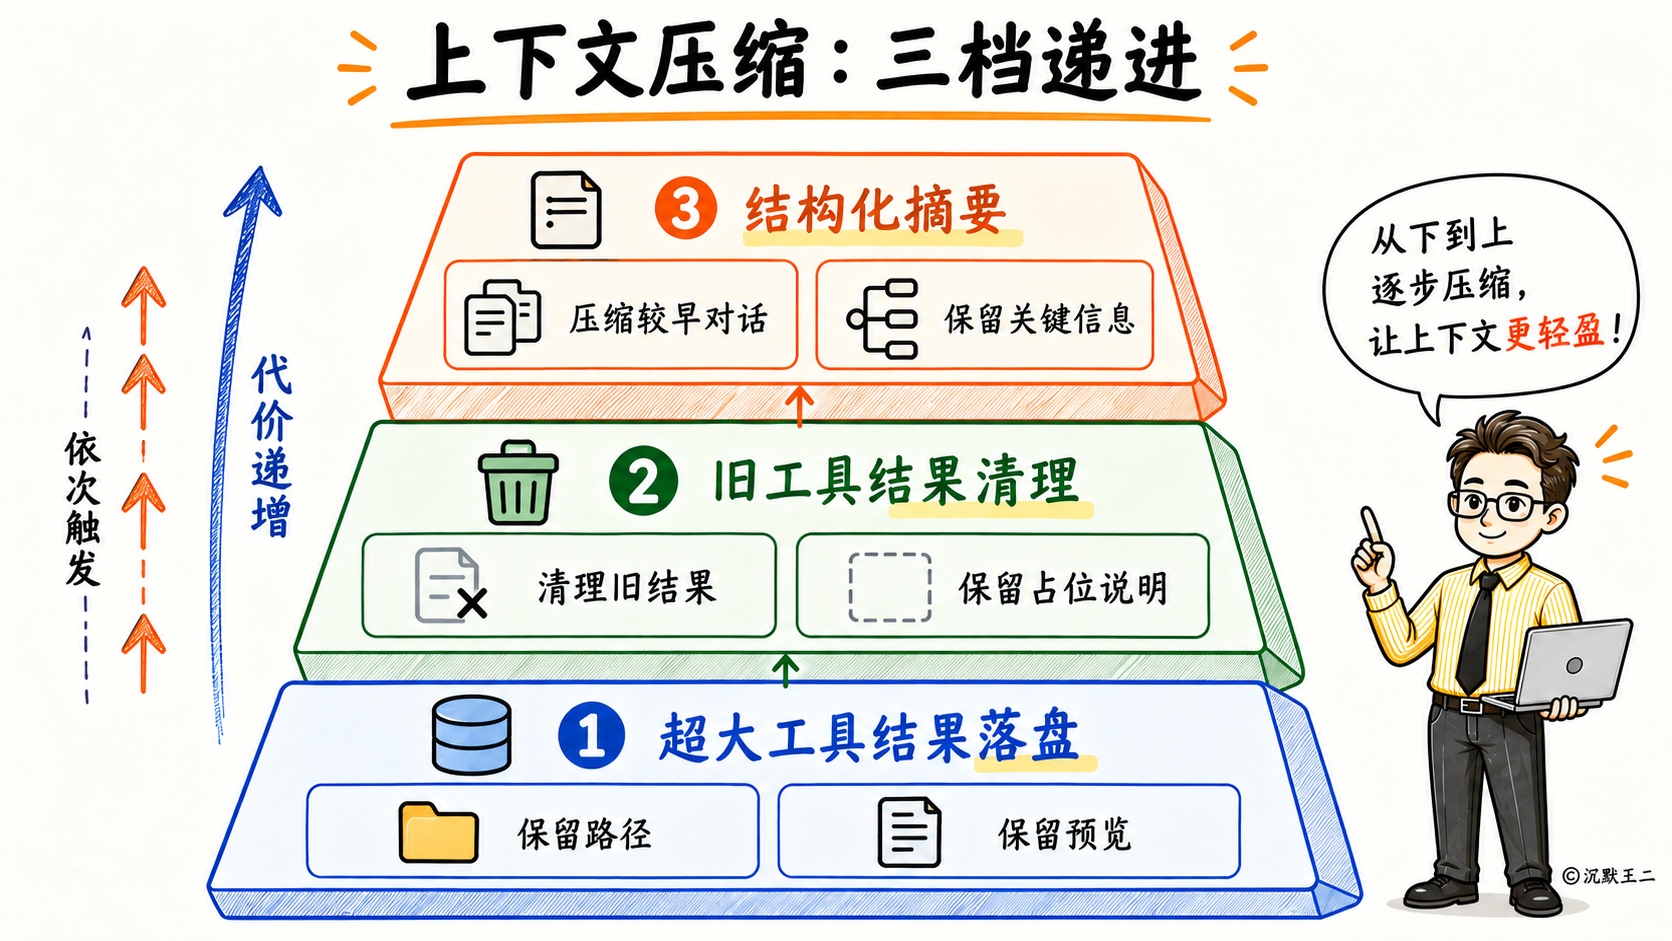
第四层是 上下文压缩。它不直接防死循环,但能防止循环跑久了把上下文撑爆。每次调用模型前检查一次,超大工具结果落盘、旧工具结果清理、摘要三档依次生效,第 10 题展开。
面试时说到这四层,面试官通常会追问“哪层最关键”。我的回答是停滞检测,它是唯一一个直接识别“在打转”的机制。超时只管单个工具,用户取消依赖人的反应速度,压缩只管长度。
它也有盲区,最好主动说出来。停滞检测只认“连续完全相同”的调用,模型在两个调用之间来回切换,或者每次把参数改一点点,都能绕过去。更稳妥的做法是检测周期性重复、先把参数规范化再比较,再配一个默认的轮数上限,到了就停下来问用户要不要继续。
04、什么是 Plan-and-Execute 模式?
Plan-and-Execute 是先规划后执行的两阶段模式。
用户输入一个复杂任务,Agent 不急着动手,先让 LLM 拆解成多个子任务并明确依赖关系,生成一份执行计划。用户确认后,再按计划逐个执行子任务。
PaiCLI 第 2 期实现了 PlanExecuteAgent.java,通过 /plan 命令触发。
用户输入 "/plan 创建 demoapp 项目,读取 pom.xml,验证项目结构"
    ↓
Planner 生成计划:
  task_1: 创建 demoapp 项目(无依赖)
  task_2: 读取 pom.xml(依赖 task_1)
  task_3: 验证项目结构(依赖 task_2)
    ↓
用户确认(回车执行 / Ctrl+O 展开 / ESC 取消 / I 补充要求)
    ↓
按轮执行:每轮取出依赖都已完成的任务,同一轮的任务并行
(每个子任务内部是一个独立的模型与工具循环)
它比 ReAct 好在哪?
纯 ReAct 是“走一步看一步”——LLM 做完一个动作才决定下一步干什么,执行顺序不可预期。
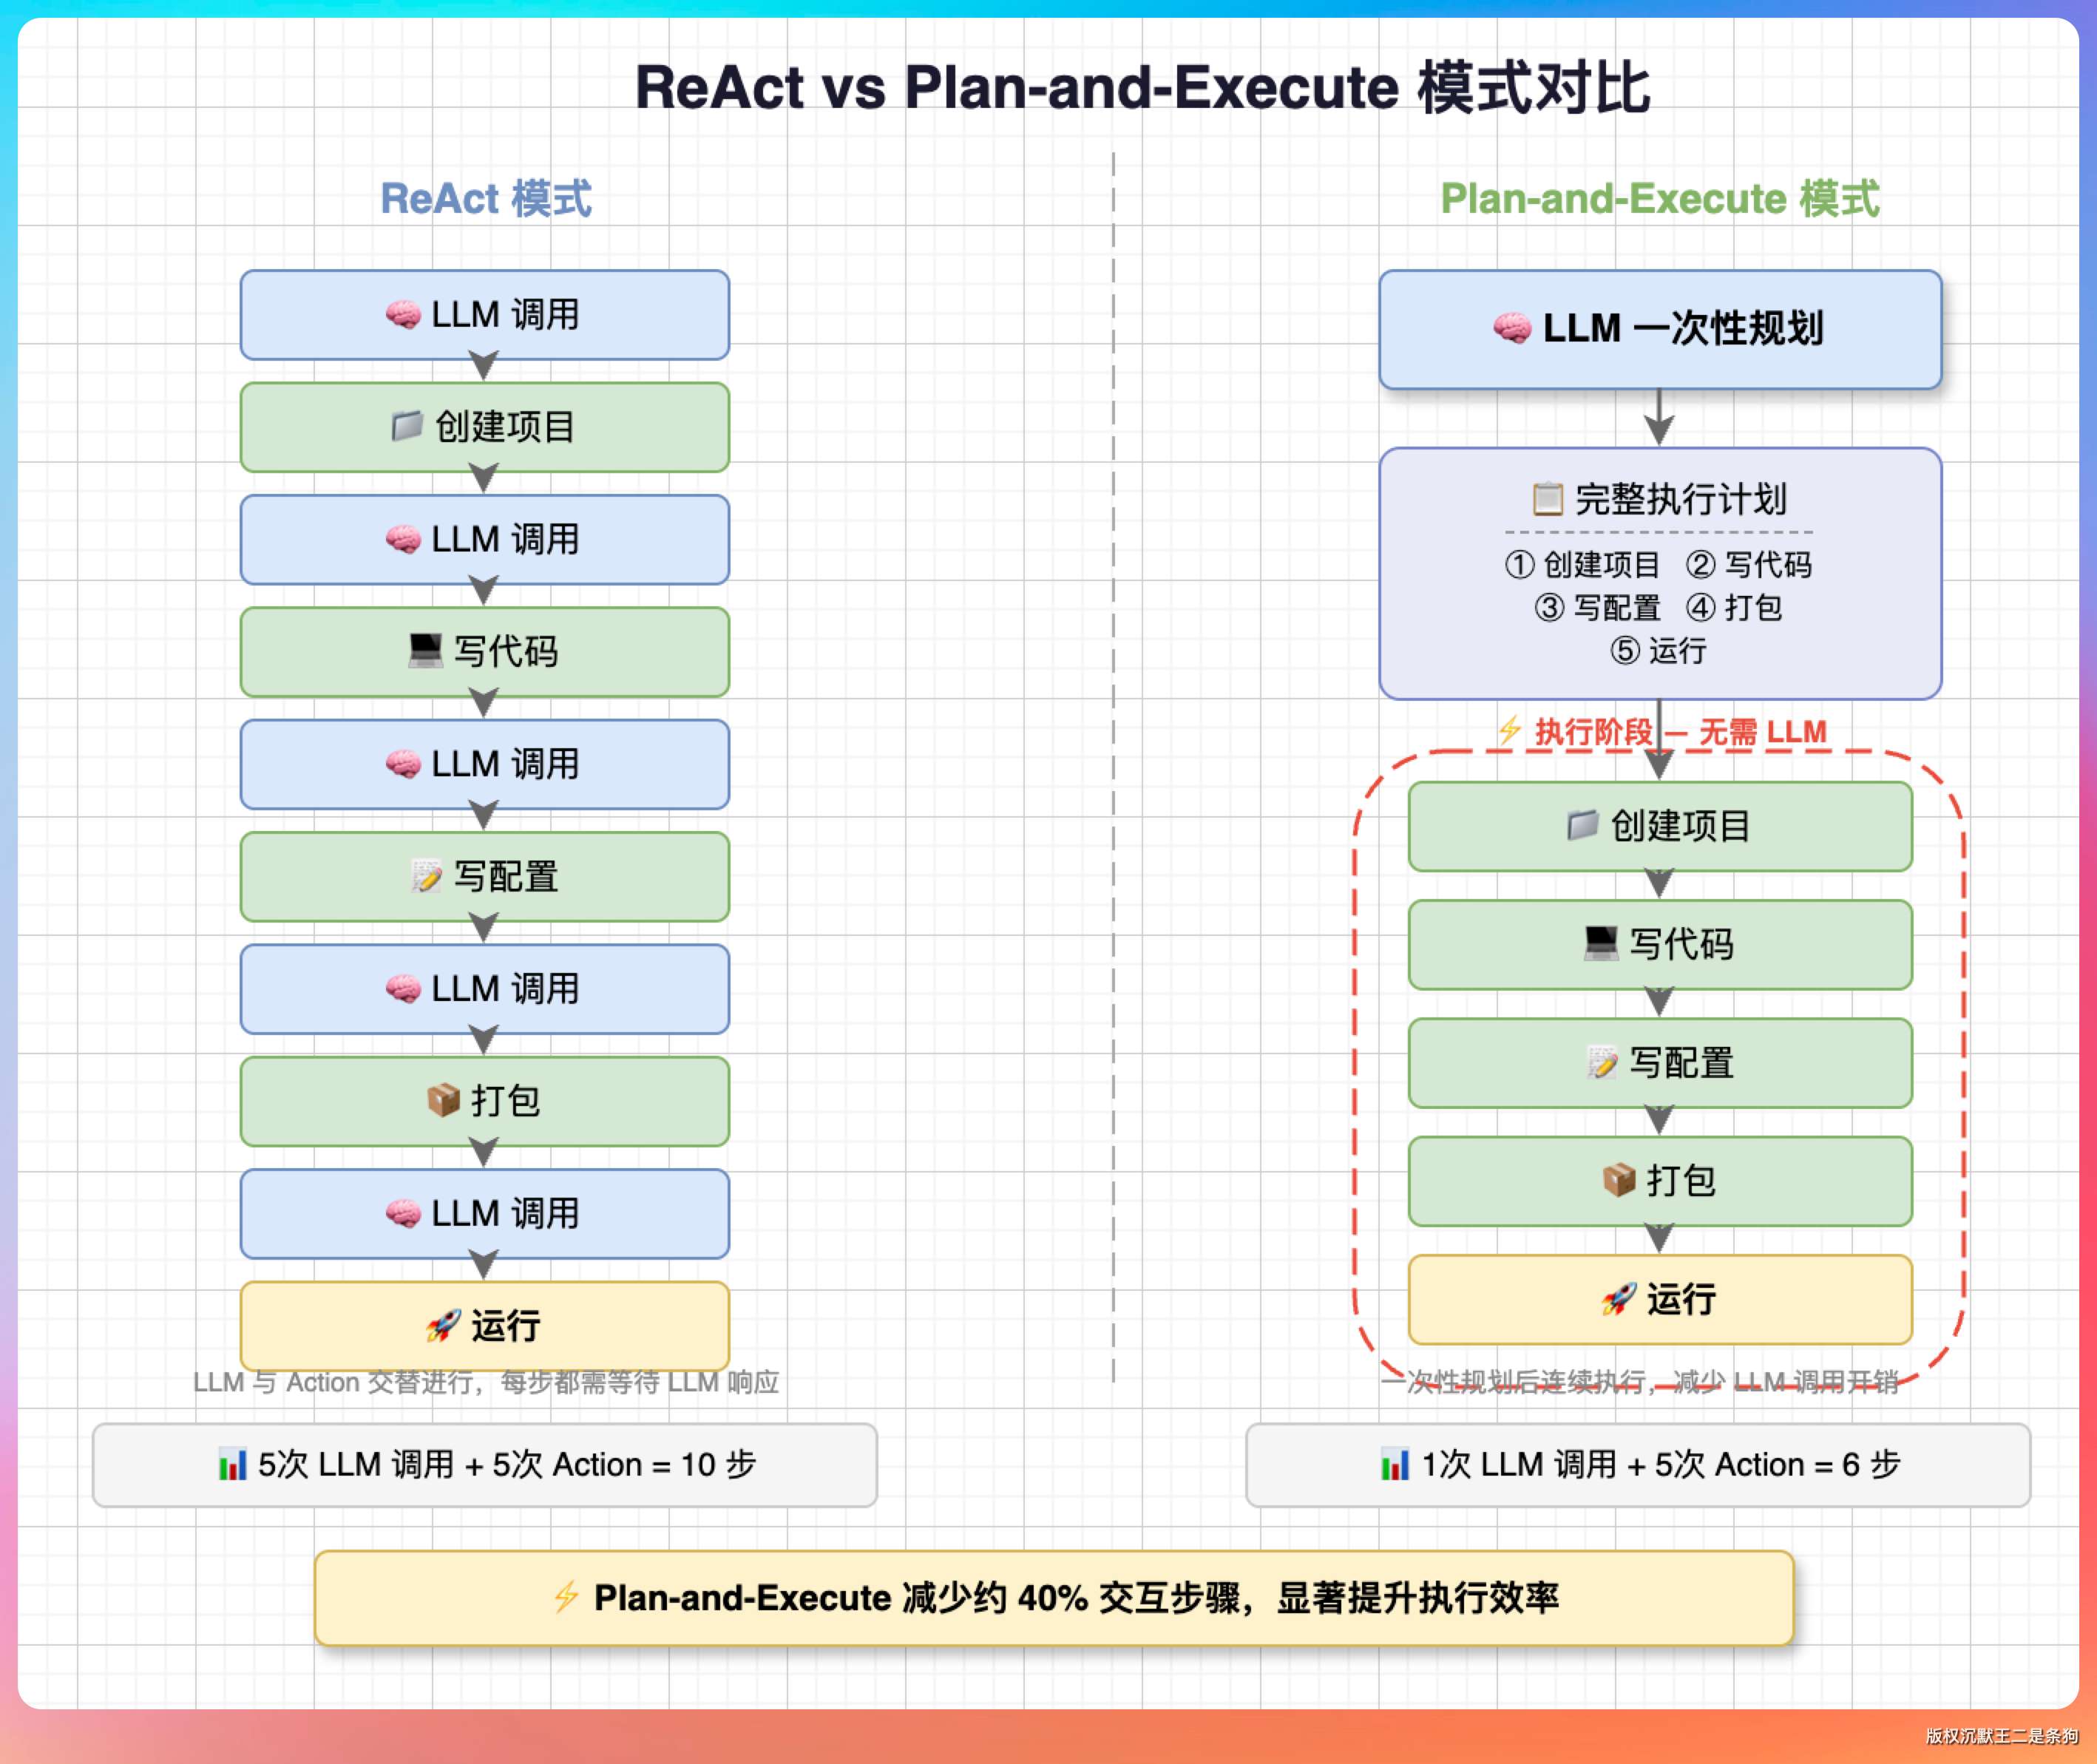
Plan-and-Execute 是“先想清楚再动手”——用户在 Agent 动手之前就能看到完整计划,觉得不对可以取消或修改。可预测性是最大的优势。
PaiCLI 在执行前加了计划审阅:回车执行、Ctrl+O 展开完整计划、ESC 取消、按 I 输入补充要求。补充要求会拼到目标后面,让 Planner 整份重新规划,原计划不支持逐条编辑。
每个子任务内部的工具循环是 PlanExecuteAgent 自己实现的,不复用 ReAct 的 Agent 类。任务有独立的消息历史,只拿到直接依赖任务的完整结果。
当然代价是多了一轮 Planner 的 LLM 调用。
简单任务用 Plan-and-Execute 反而浪费——“帮我读一下 README”不需要规划。PaiCLI 的设计是默认 ReAct,用户显式 /plan 才切换,执行完自动回到 ReAct。
05、Plan-and-Execute 里的 DAG 是怎么工作的?
DAG(Directed Acyclic Graph,有向无环图)用来管理子任务之间的依赖关系。每个子任务声明自己依赖哪些前置任务(dependencies 字段),形成一个有向图。
Planner 解析计划时做严格校验,id 重复、依赖引用了没声明的任务、依赖有环,都直接判定计划无效,不会悄悄删掉一条边接着跑。
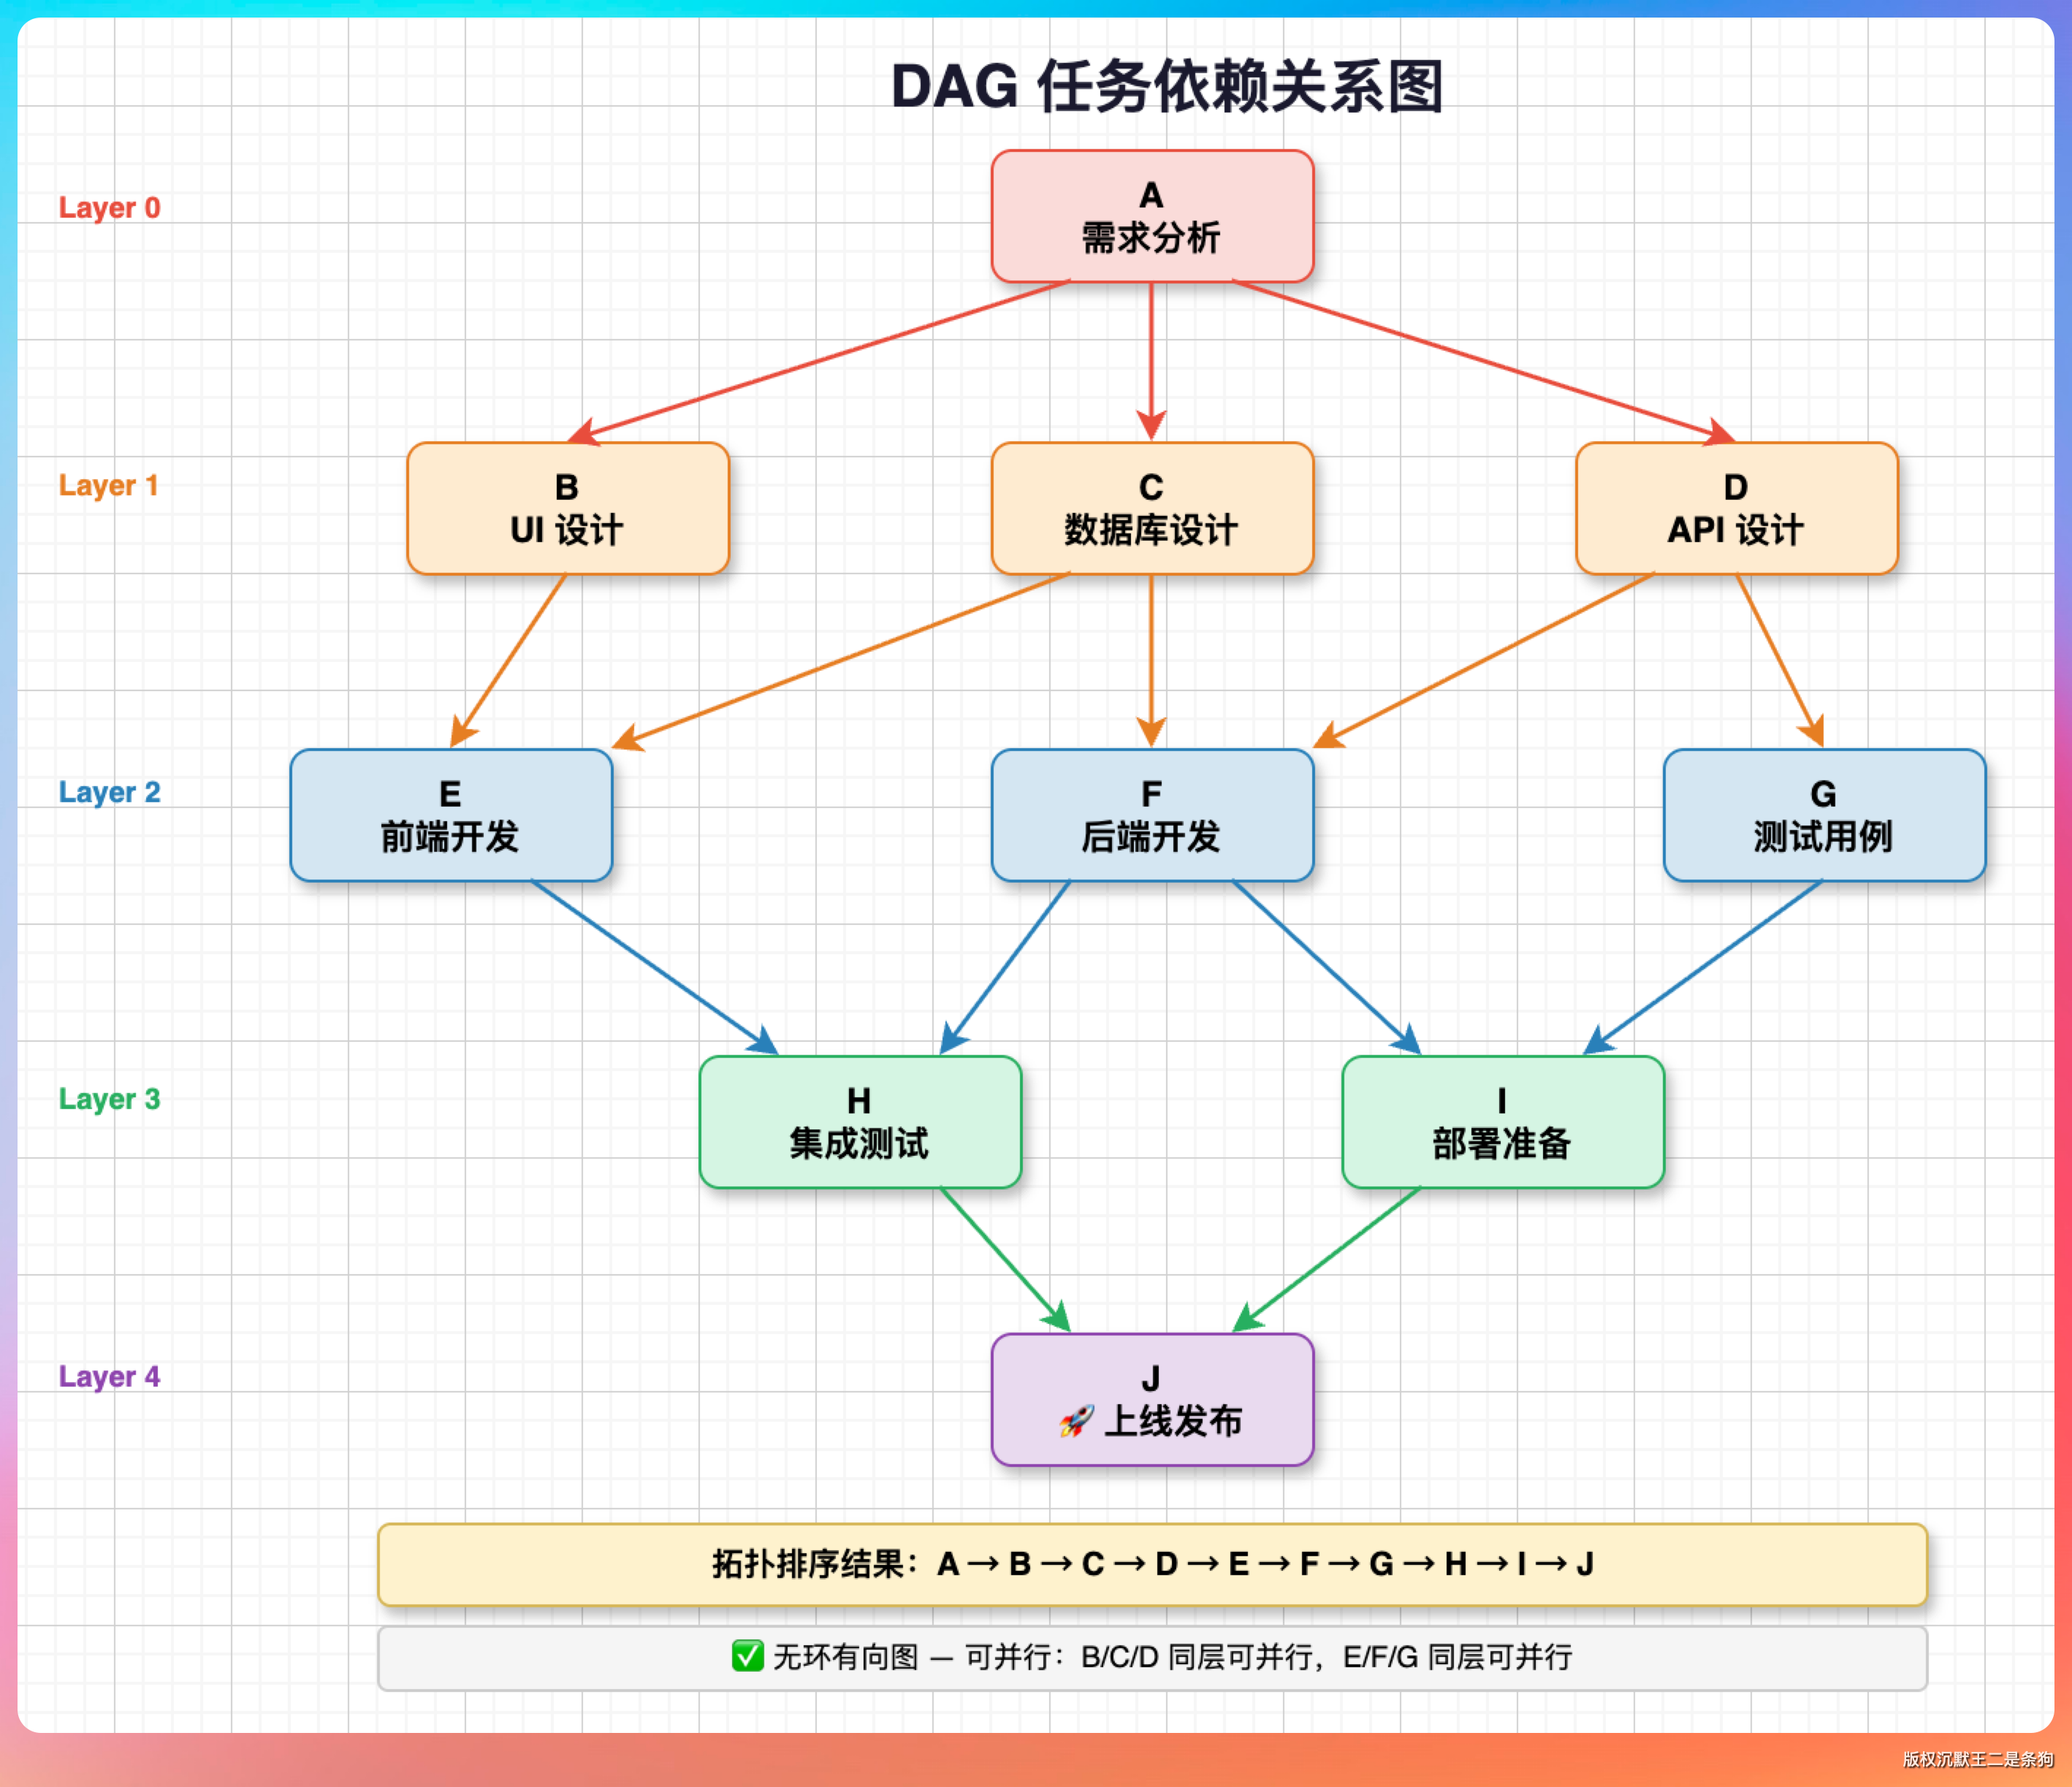
PaiCLI 的 ExecutionPlan.java 持有任务列表和 DAG 关系。执行时不预先算批次,每一轮用 isExecutable 取出依赖都已完成的任务,这一轮全部结束再算下一轮。拓扑序只用来给同一轮的任务排先后。效果上相当于下面这样分批:
批次1: task_1, task_2(无依赖,可并行)
批次2: task_3(依赖 task_1), task_4(依赖 task_2)
批次3: task_5(依赖 task_3 和 task_4)
同一批次内的任务由 PlanExecuteAgent 自己的线程池并行执行,并发度是本批任务数和 4 取小,不同批次之间严格串行。第 7 期的并行调度器管的是另一层,同一个任务内部一轮返回的多个工具调用。
某个任务失败了怎么办
失败处理的策略也在 PlanExecuteAgent 里,先看计划完成了多少。
完成度低于一半时,Planner 基于已完成的任务重新规划,默认最多 2 次,可以用 PAICLI_PLAN_MAX_REPLANS 调整。到了上限就不再启动新任务,剩下的全部标 SKIPPED。
完成度不低于一半时,失败的任务标 FAILED,所有直接或间接依赖它的下游任务标 SKIPPED,和它没有依赖关系的其他任务继续执行。效果和 GitHub Actions 里一个 job 失败、依赖它的 job 被跳过差不多。
最后的汇总会先列已完成任务的结果,再列失败和跳过的原因。这几条是 2026 年 9 月才补齐的,之前下游任务会一直停在 PENDING,重规划也没有次数上限。
面试官可能追问“有没有重试机制”。
PaiCLI 的 Plan-and-Execute 当前没有任务级重试,但 Multi-Agent 模式下 Reviewer 审查不通过时有重做机制(最多 2 次)。这是有意的设计选择——Plan 模式强调可预测性,自动重试会让执行过程变得不可控。
06、Multi-Agent 协作是怎么实现的?
PaiCLI 第 5 期实现了三个角色的 Multi-Agent 架构。
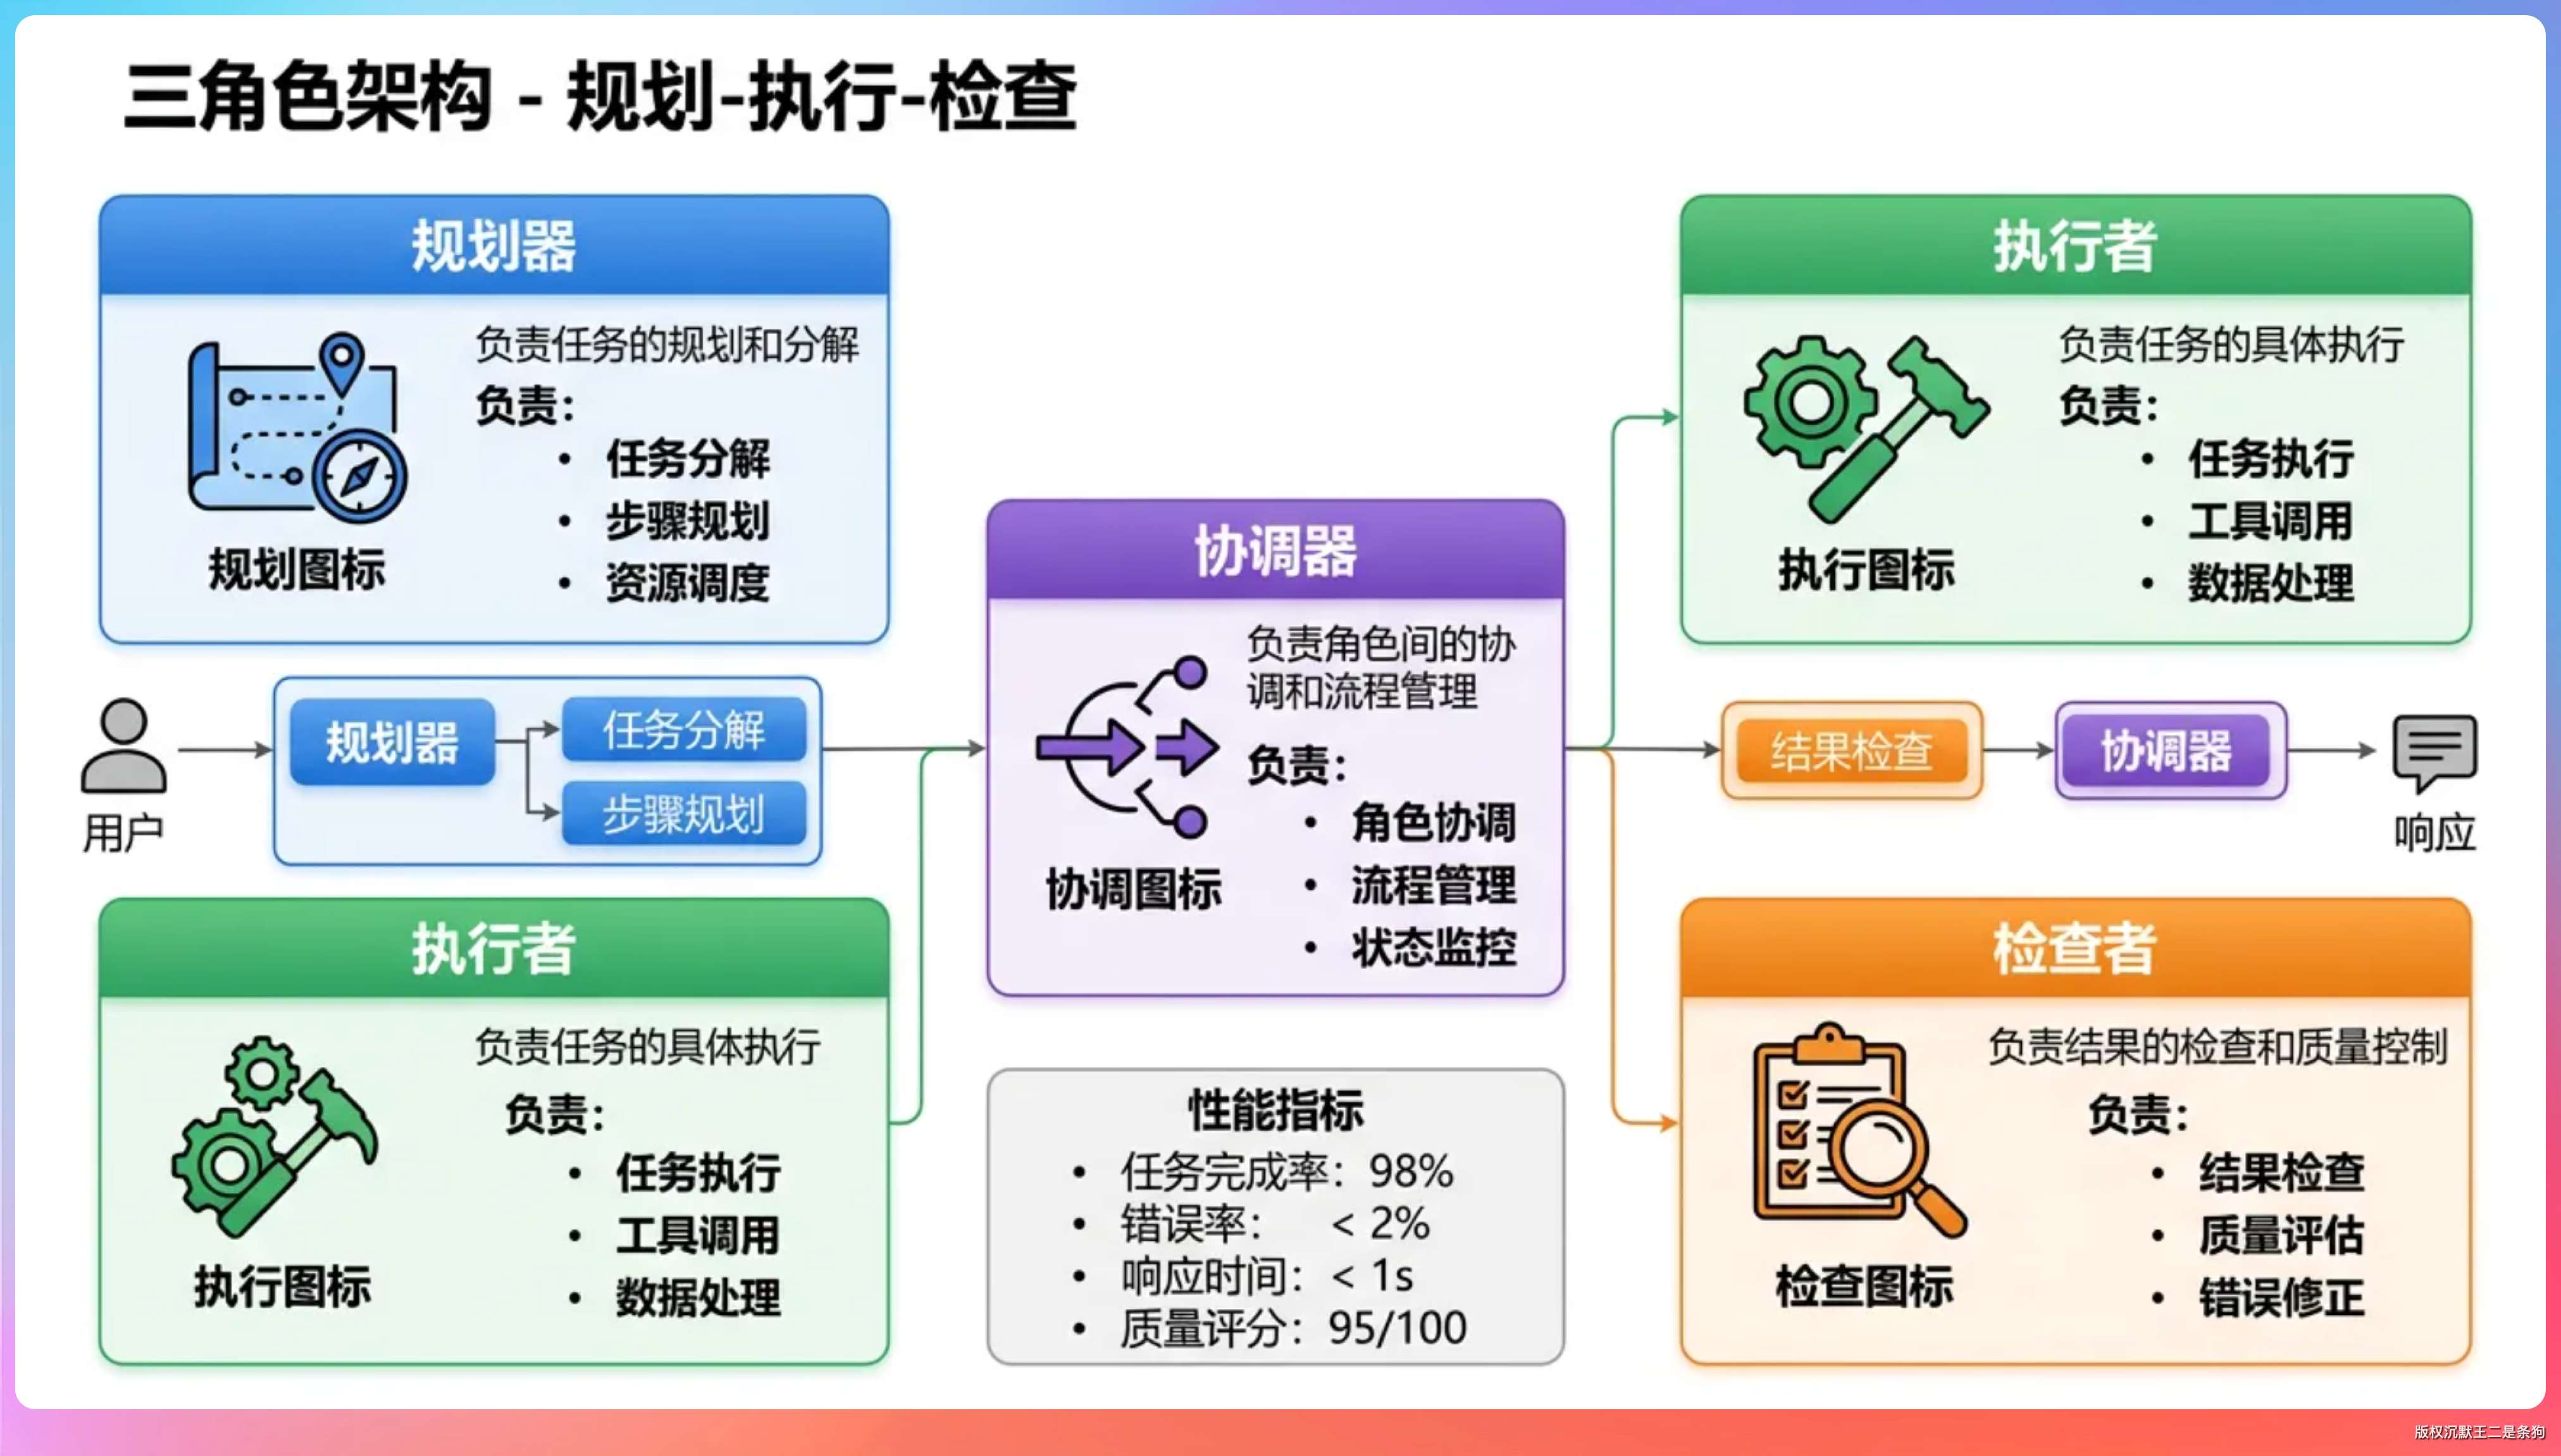
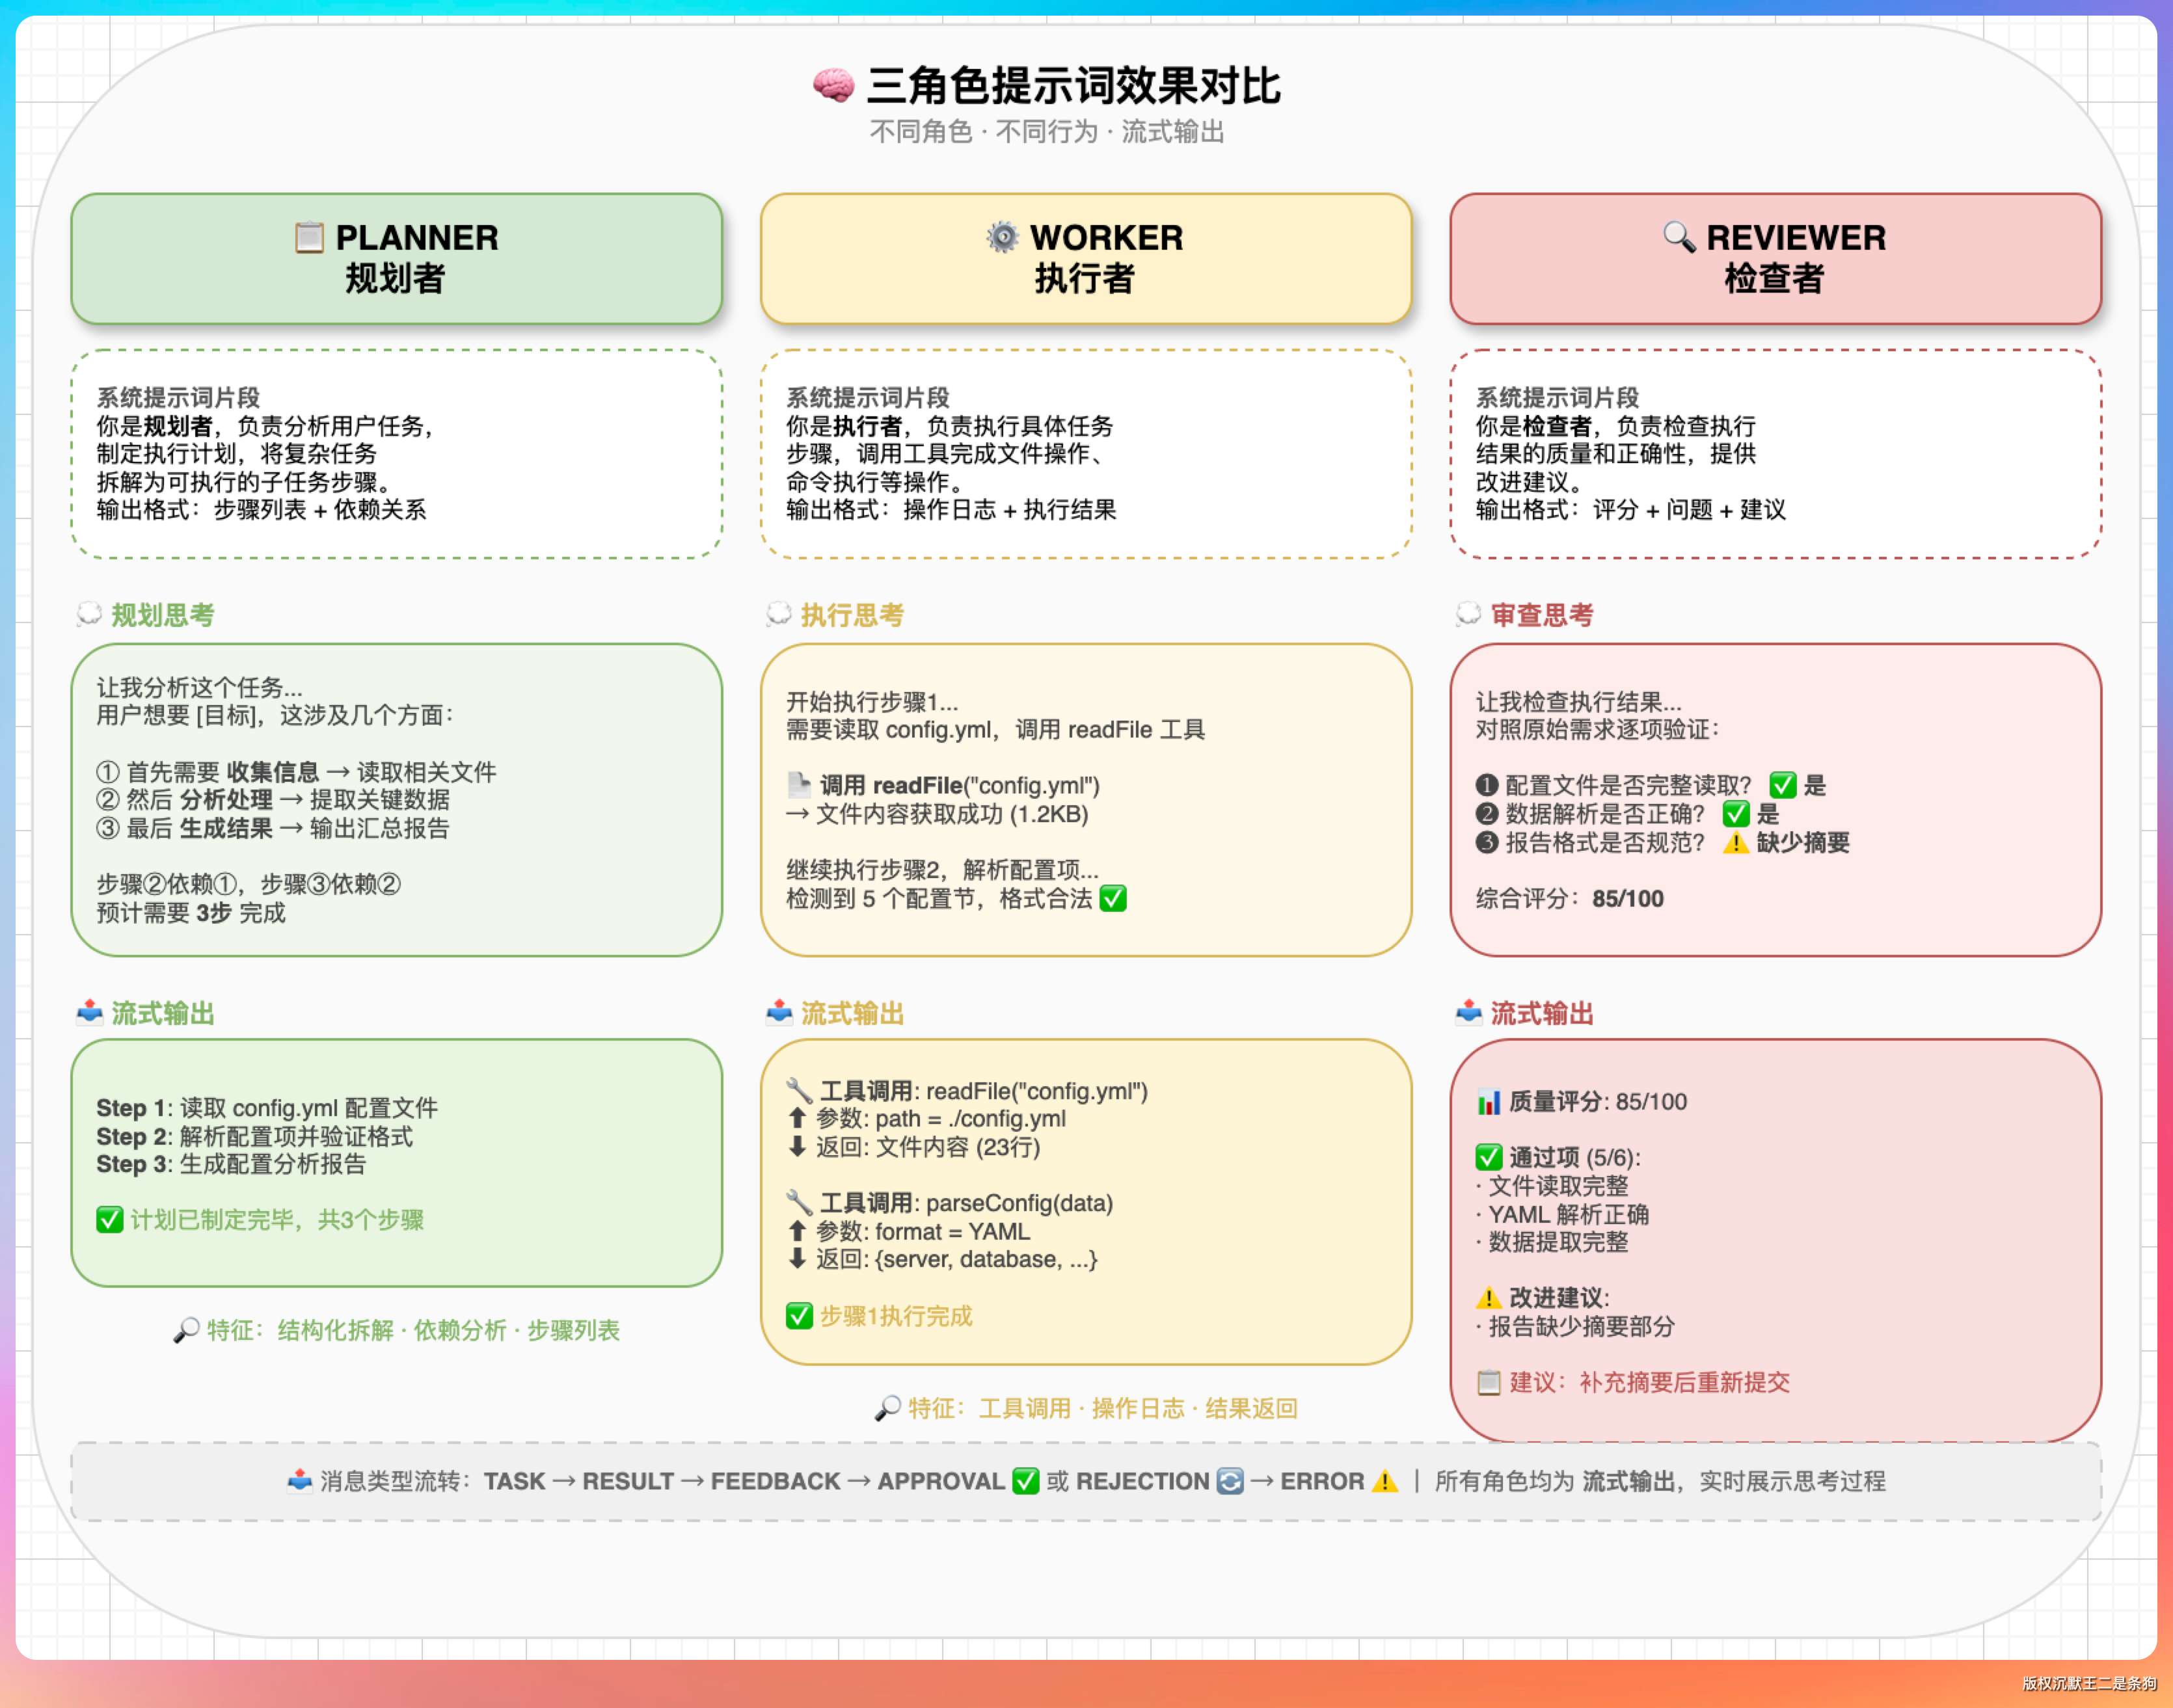
三个角色分工明确:Planner(规划者) 拆解任务分配工作,Worker(执行者) 实际执行子任务,Reviewer(检查者) 审查 Worker 的执行结果。
编排器 AgentOrchestrator.java 是总调度,协调三个角色的交互。实际运行时有 1 个 Planner、2 个 Worker(worker-1、worker-2)和 1 个 Reviewer,每个都是一个 SubAgent 实例,有独立的 system prompt 和各自的消息历史。它们共享同一个 ToolRegistry,所以工具、人工审批和联网授权规则是同一套。
MemoryManager 由编排器持有,只用来保存用户要求记住的事实,以及任务完成后的自动提取。SubAgent 执行时不检索长期记忆,这一点和 ReAct、Plan 两种模式不一样。
Planner 输出的 JSON 计划由 TeamPlanParser 严格校验,规则和 Plan 模式一致:唯一的非空 id、依赖必须引用已声明的步骤、不能有环。步骤统一重编号成 step_N,计划不合法就直接返回“❌ 规划失败”,不会带着一份残缺的计划往下跑。
用户输入 "/team 重构登录模块"
    ↓
Planner 拆解(JSON,严格校验):
  step_1: 分析现有登录代码
  step_2: 梳理调用方(依赖 step_1)
  step_3: 重构 LoginService(依赖 step_1、step_2)
    ↓
按批执行:每批取出依赖都已完成的步骤
  批次 1: step_1          → worker-1 执行 → Reviewer 审查
  批次 2: step_2          → 同上
  批次 3: step_3          → 同上
  (一批里有多个独立步骤时,两个 Worker 并行,输出先缓冲,再按步骤顺序打印)
    ↓
审查通过 → 进入下一批
审查不通过 → Worker 带反馈重做,最多 2 次
每个步骤只拿到直接依赖步骤的结果作为上下文。Worker 执行出错或者交回空结果,这个步骤就标记失败,所有依赖它的后续步骤会被跳过,终端提示“因前置步骤失败被跳过”。
各角色的 system prompt 有什么不同?
这个问题能体现你对实现细节的理解。
Planner 的 prompt 侧重任务拆解和依赖分析,要求输出结构化的 JSON 步骤列表。Worker 的 prompt 侧重工具使用和执行,有完整的工具使用指导。Reviewer 的 prompt 侧重质量标准和反馈格式,要求只输出一个 JSON 对象,包含布尔字段 approved,以及 summary、issues、suggestions。
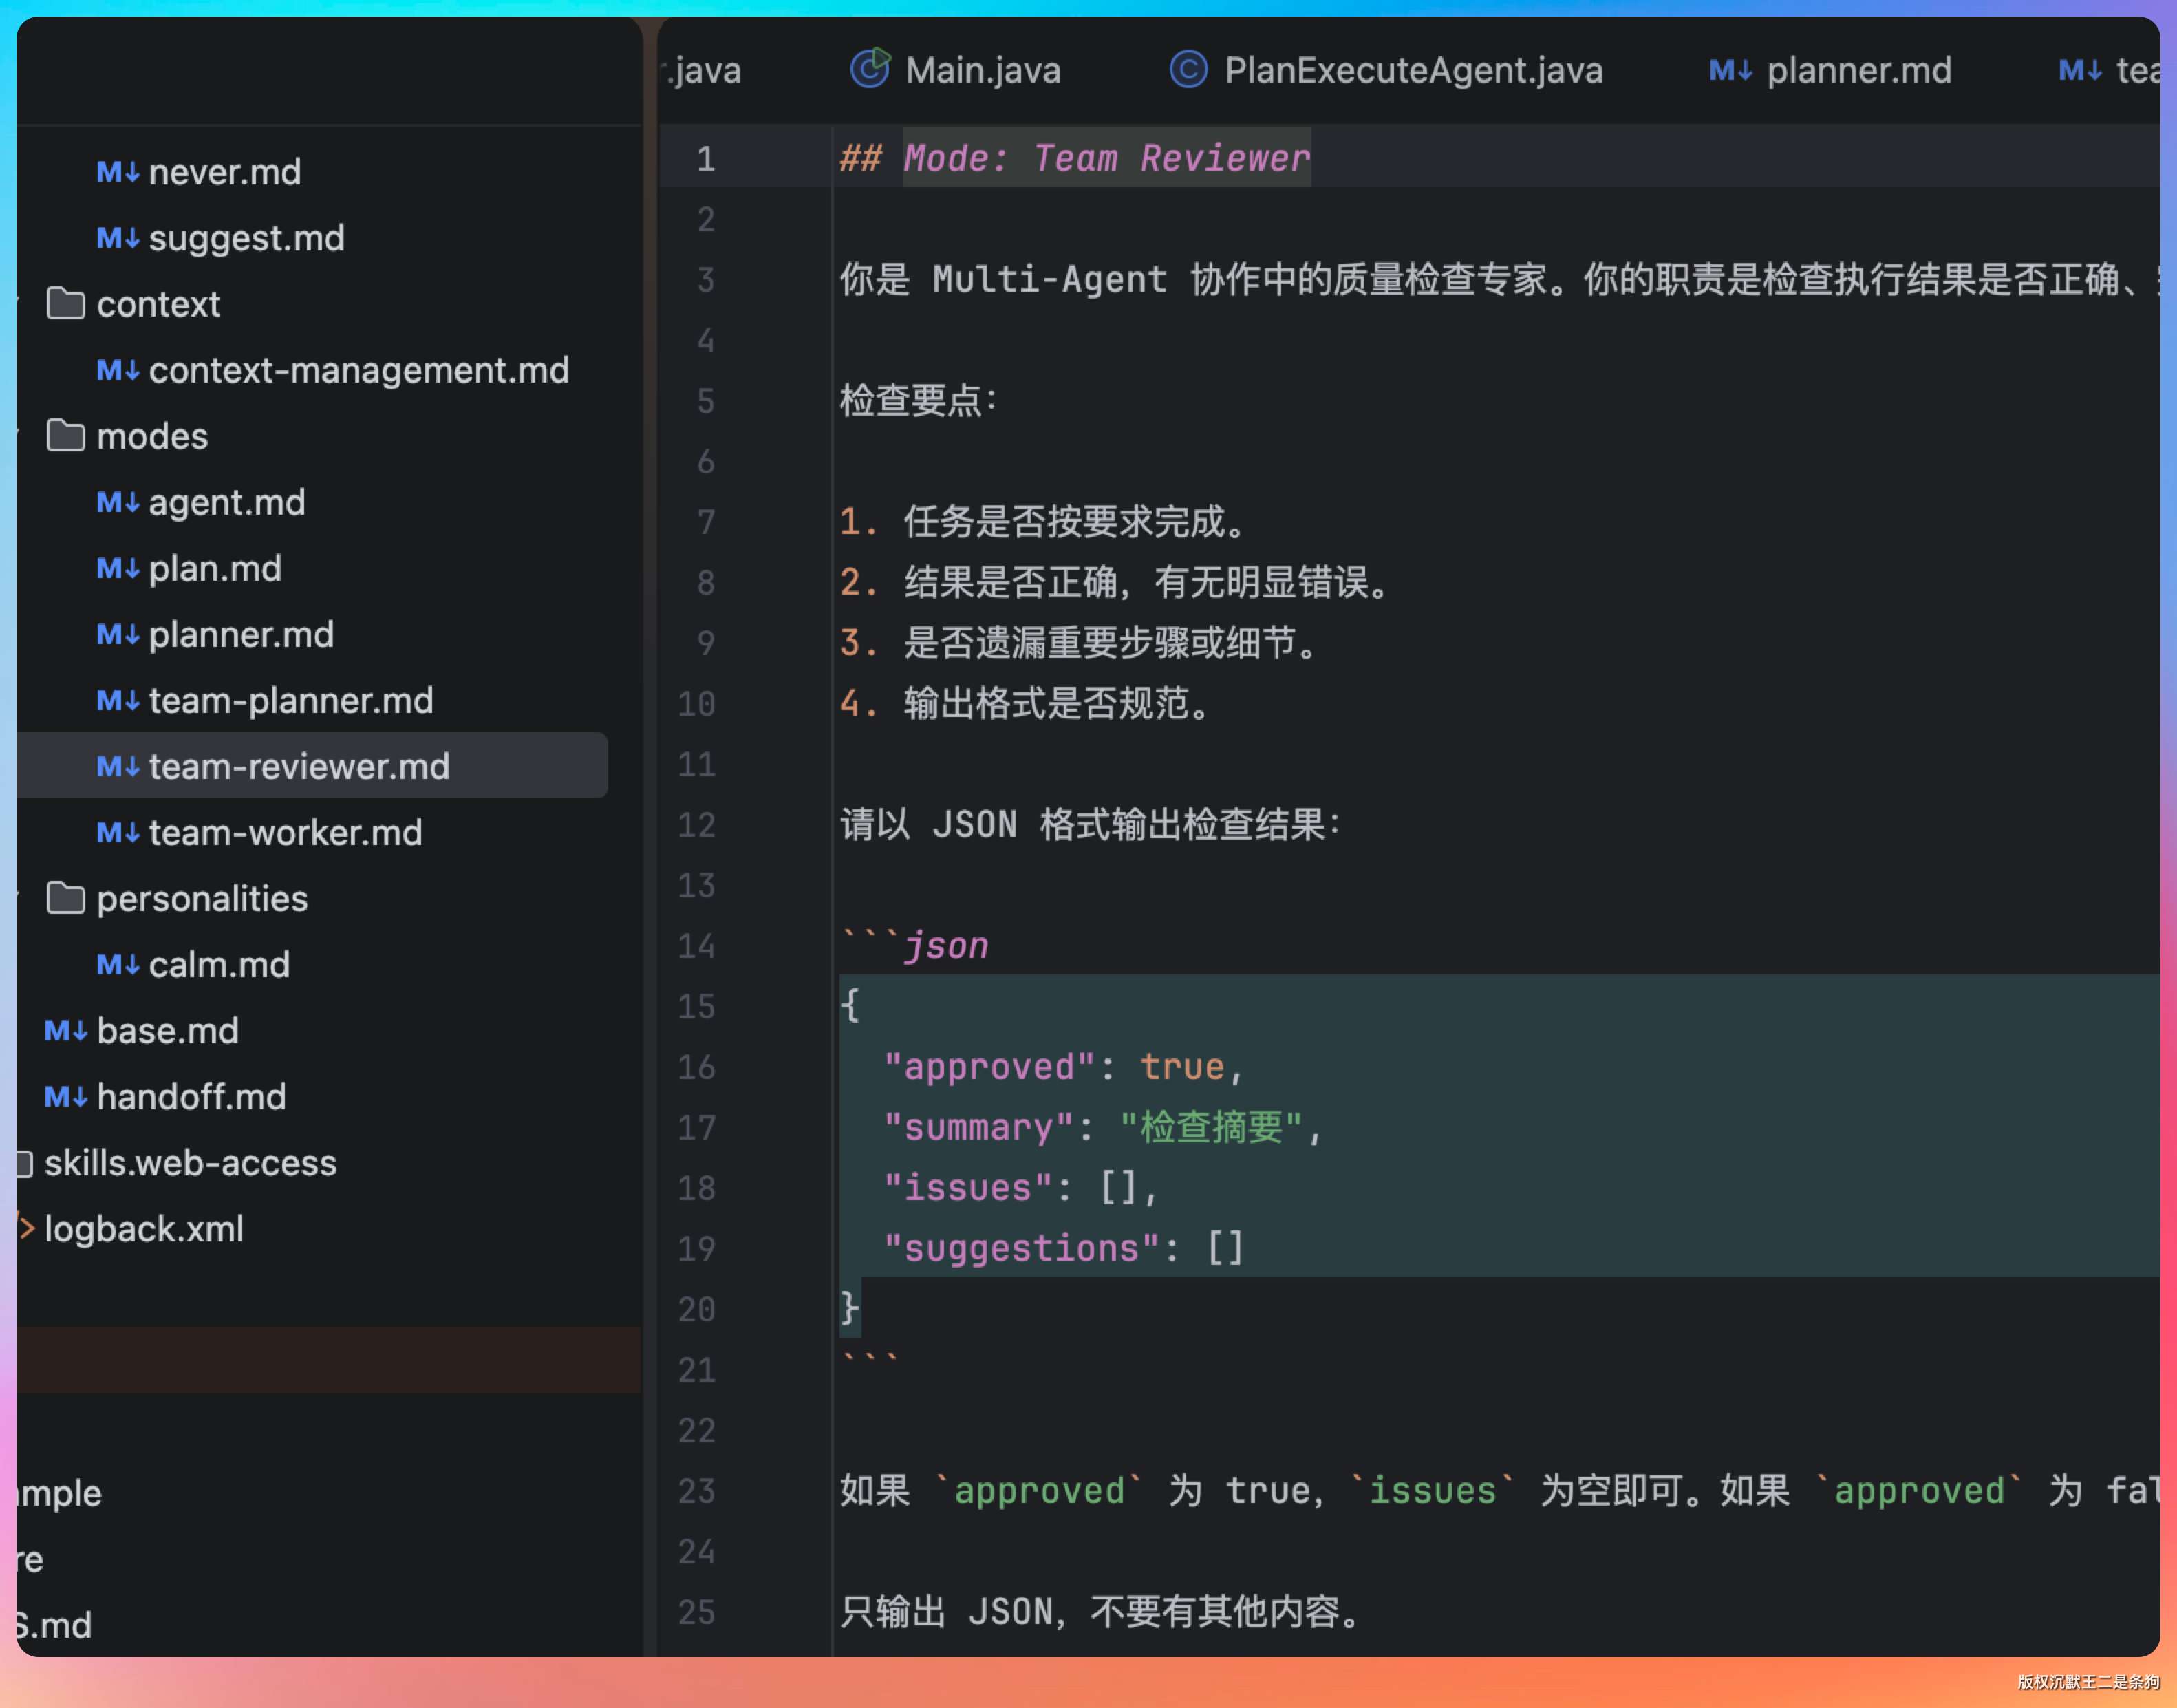
第 19 期 Prompt 分层架构落地后,这些 prompt 都拆成了独立的 Markdown 文件:modes/team-planner.md、modes/team-worker.md、modes/team-reviewer.md,在 src/main/resources/prompts/ 目录下。改 prompt 不用改 Java 代码了。
07、Reviewer 审查不通过怎么处理?
先说怎么判定“不通过”。编排器只读 Reviewer 回复里的 approved 字段,而且只有 JSON 布尔值 true 才算通过。回复不是单个 JSON 对象、缺少这个字段、写成字符串 "true",或者干脆是一段文字,一律按不通过处理。早期版本宽松得多:approved 写成字符串 "true" 也会被当成通过;回复解析不了 JSON 时,还会退回到关键词判断,文字里有“通过”、又没出现“不通过”“有问题”这几个否定词,就算批准。这两条兜底现在都去掉了。
不通过之后,AgentOrchestrator 把 Reviewer 给的问题拼到上下文后面,格式是“之前的执行结果被审查拒绝,原因:……”,再交给同一个 Worker 重做。重做的结果再交给 Reviewer 审查。每个步骤最多重试 2 次(MAX_RETRIES_PER_STEP = 2),重试时 Worker 出错或交回空结果,也算用掉一次。两次都没通过,就保留最后一次的结果,把步骤标记为完成,终端提示“超过最大重试次数,保留当前结果”。
这里有一个我得主动交代的不一致。审查结论的解析很严格,审查调用本身出错却是放行的:Reviewer 那次 LLM 调用失败时,编排器会保留当前结果,直接把步骤标记为完成。面试时我会把这点说出来,改进方向是审查出错时把步骤标成“未审查”,或者先重试一次审查,而不是默认通过。
这里有个容易被忽略的细节:每次重试都消耗一轮完整的 LLM 调用。
Worker 执行一次 + Reviewer 审查一次 = 至少 2 次 LLM 调用。重试 2 次就是额外 4 次调用。成本控制是限制重试次数的主要原因。
面试官可能问“为什么不把 Reviewer 的反馈直接塞给 LLM 让它一次改对”。
我们就是这么做的,反馈作为上下文传给 Worker,Worker 能看到具体哪里不行。但 LLM 不是确定性系统,看到反馈也不保证一次改对,所以要有重试上限。
这个模式和 Code Review 有什么关系
可以把它看成自动化的 Code Review。
Planner 是 Tech Lead 分任务,Worker 是开发写代码,Reviewer 是审查者提 comment。审查不通过就打回重写。
区别在于 AI Reviewer 的审查标准是 prompt 里定义的。
08、同一轮 LLM 返回多个 tool_calls 时怎么处理?
当 LLM 认为当前步骤需要同时做多件事(比如同时读 3 个文件),会在一次响应里返回多个 tool_calls。
PaiCLI 第 7 期在 Agent.java 里实现了并行工具调用。
代码的核心路径是:从 LLM 响应解析出所有 tool_calls → 提交到 ExecutorService 线程池并行执行 → 等待全部完成(有统一超时兜底)→ 按原始 tool_call 顺序拼装结果 → 一起塞回消息历史。
// 简化后的并行执行逻辑
List<Future<ToolResult>> futures = new ArrayList<>();
for (ToolCall call : toolCalls) {
    futures.add(executor.submit(() ->
        toolRegistry.executeTool(call.name(), call.arguments())
    ));
}
// 等待所有工具完成,按原始顺序收集结果
for (int i = 0; i < futures.size(); i++) {
    results.add(futures.get(i).get(timeout, TimeUnit.SECONDS));
}按原始顺序拼装这一点很重要。LLM 的 API 协议要求每个 tool message 的 tool_call_id 和对应的 tool_call 严格匹配,乱序会导致模型理解错误。
并行执行的性能提升有多大
I/O 密集型操作提升最明显。3 个文件读取各 100ms,串行 300ms,并行约 100ms。读文件、搜索代码、联网搜索这类只读工具才会并行,写文件、执行命令这类有副作用的调用按顺序串行,原因见下一题。
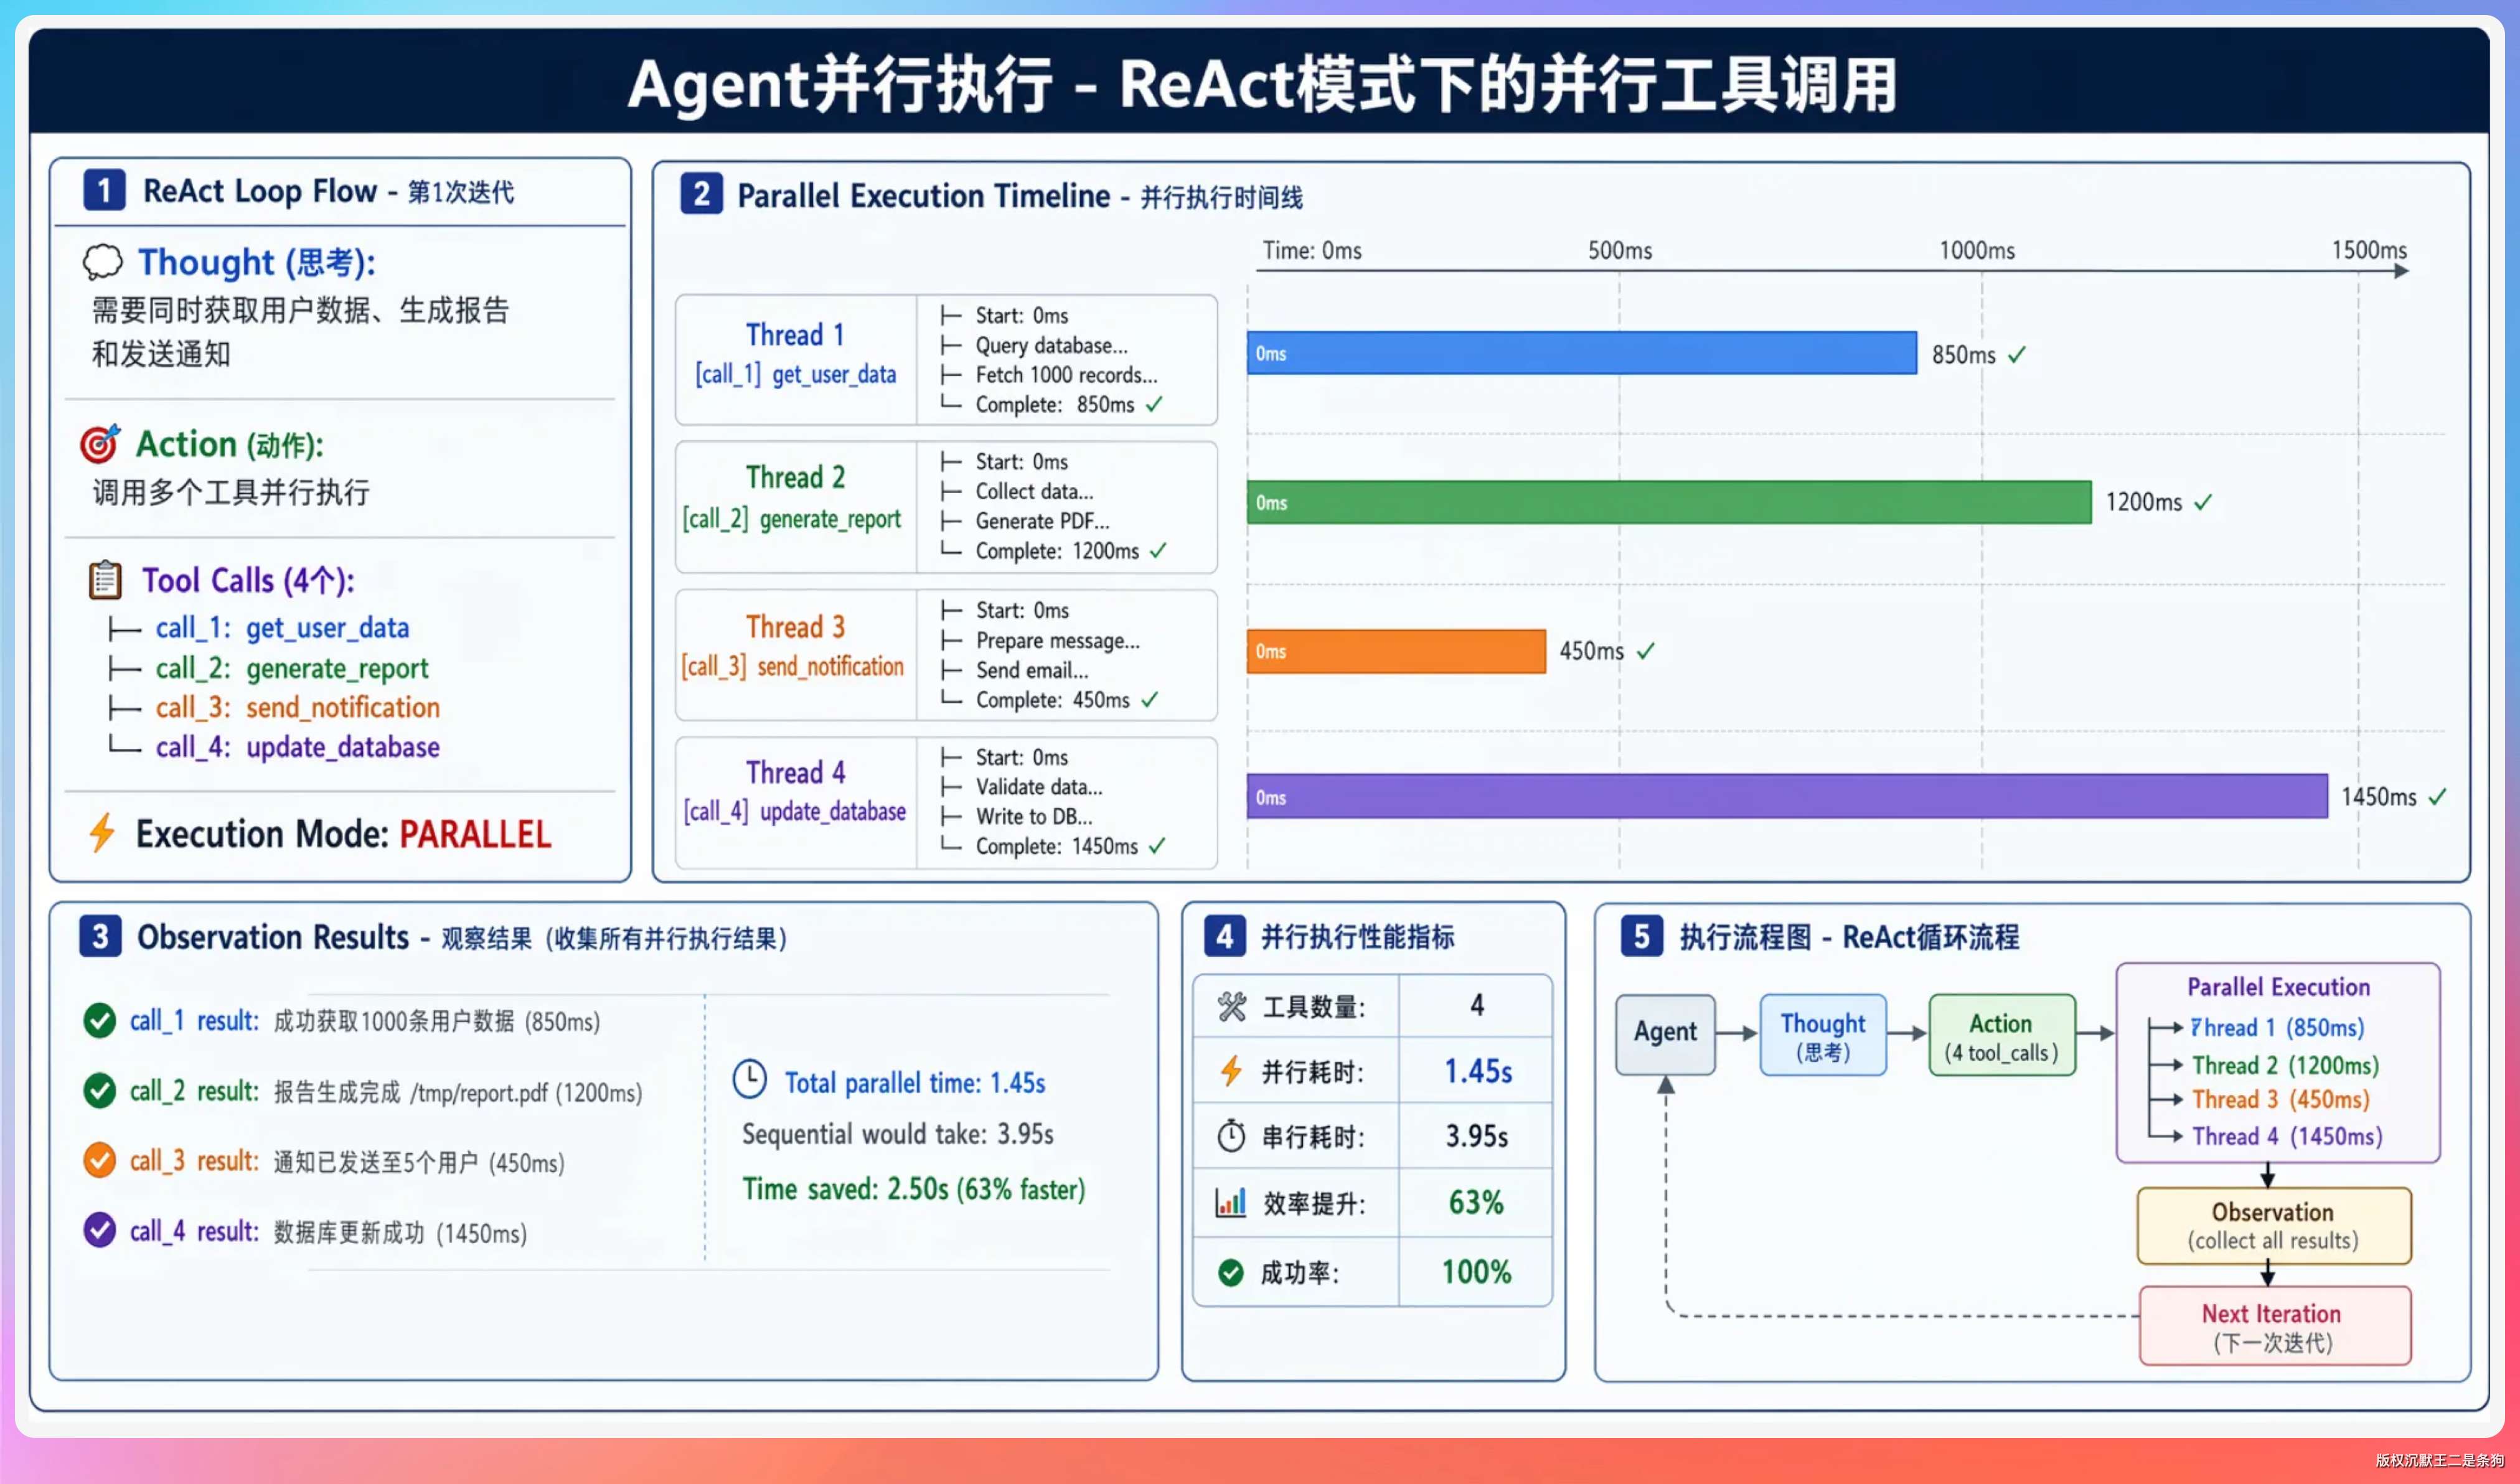
ReAct、Plan-and-Execute、Multi-Agent Worker 三条路径都复用了同一套并行工具执行机制,代码不重复。
09、并行工具调用会有冲突吗
会有。
两个工具同时写同一个文件、一个读文件一个改同一个文件,都是冲突场景。
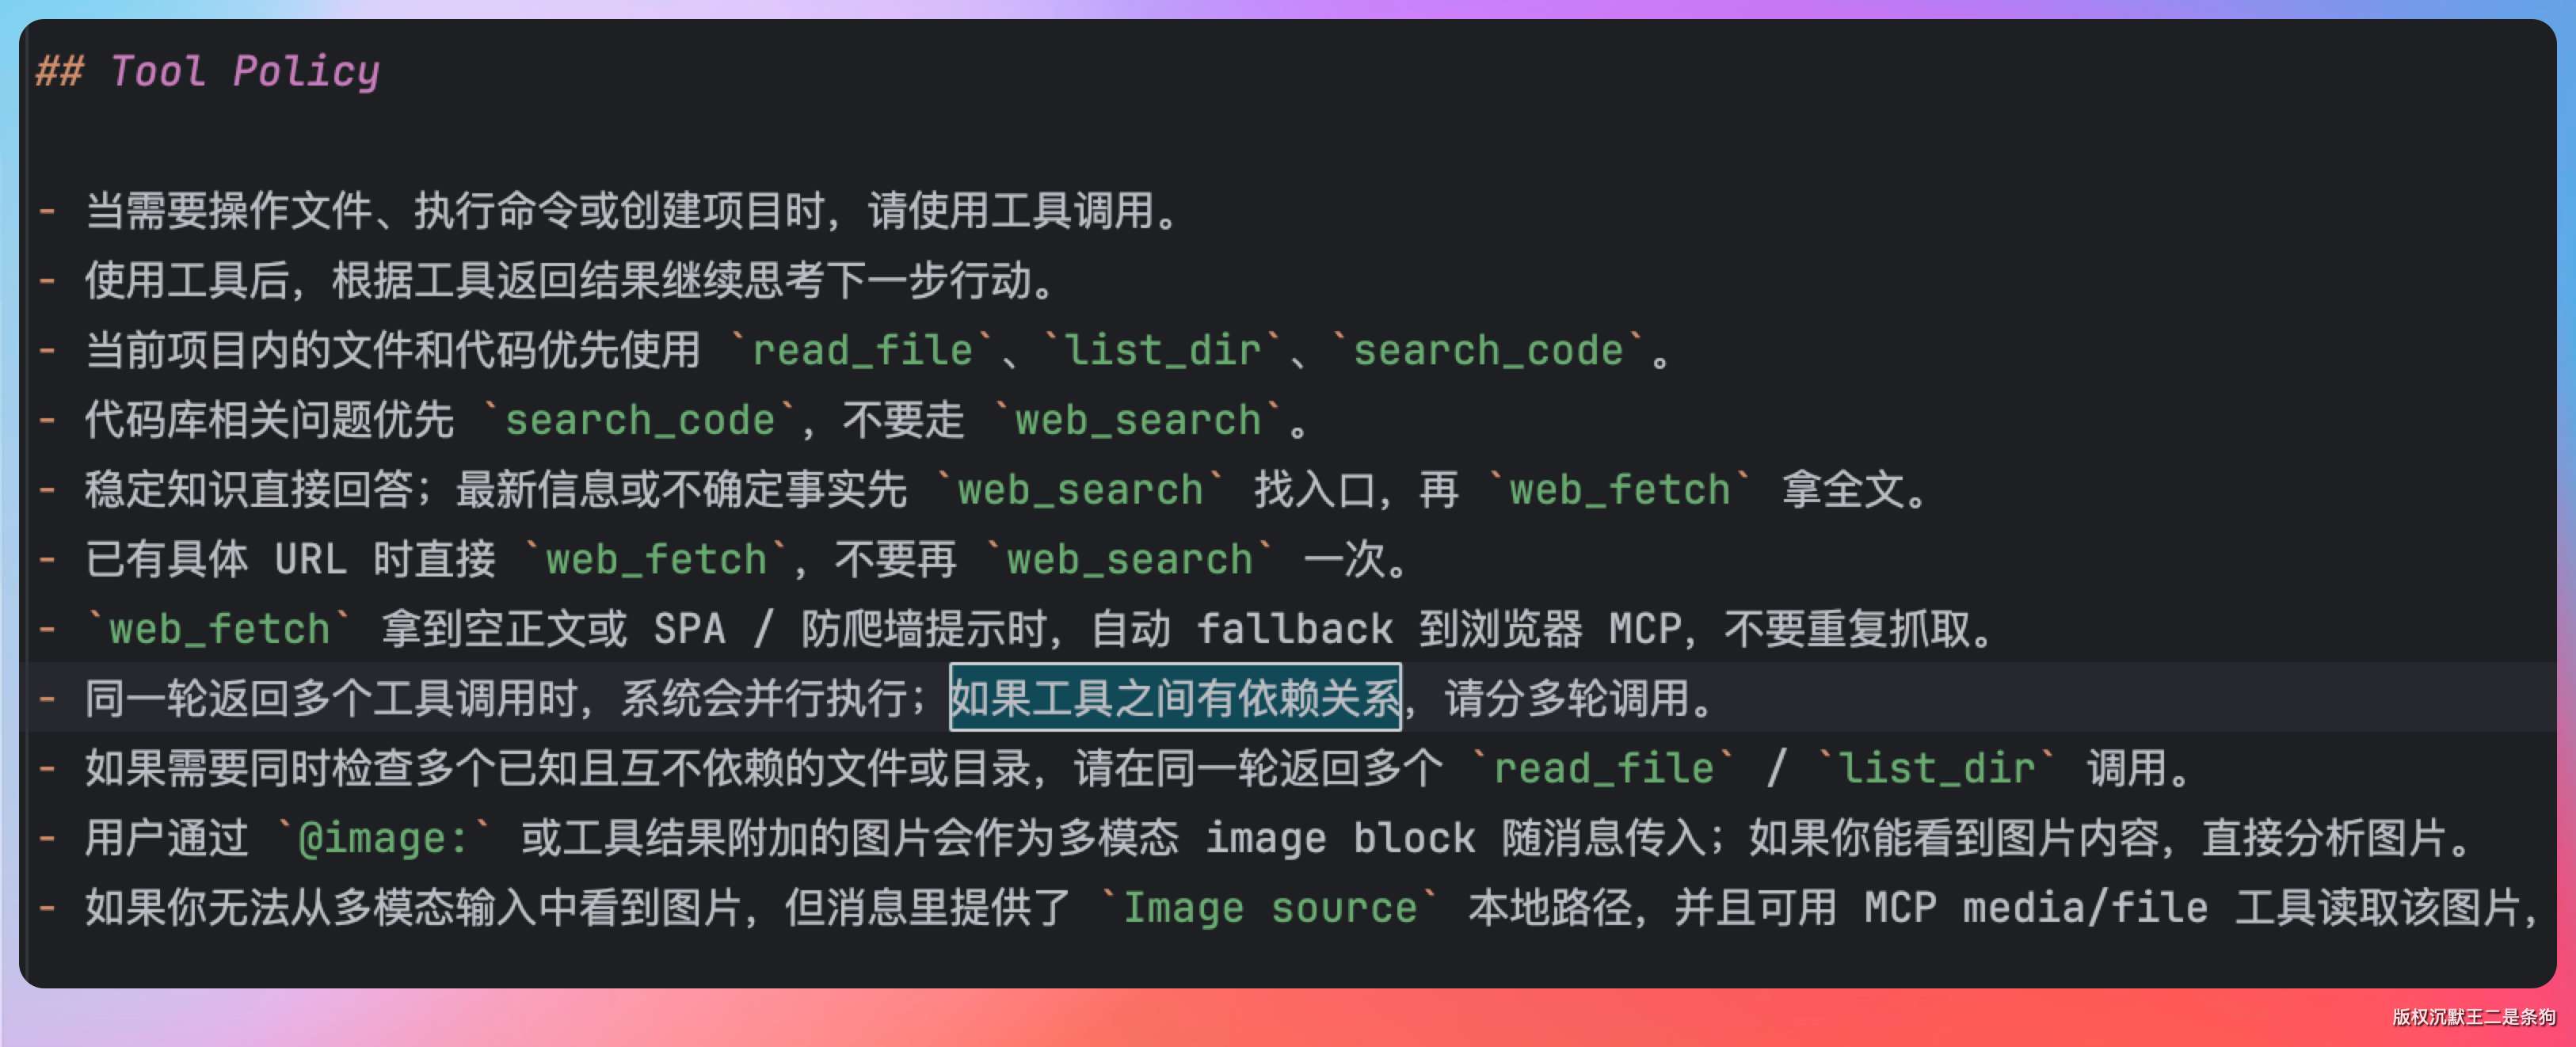
PaiCLI 早期的处理策略是“不做锁,靠提示词引导加工程兜底”。base.md 里写了“如果工具之间有依赖关系,模型应分多轮调用”,然后就指望模型别在同一轮写同一个文件。
后来代码审查时实测了一下,同一轮对同一个文件发起多次 edit_file,50 轮里有 49 轮丢了改动,而且每个工具都报告成功。每次编辑都是“读文件、改一处、整文件写回”,并行执行时后写的把先写的盖掉了。模型觉得“改的是同一个文件的不同位置,互不影响”,从它的角度看这个判断并没有错。
现在按工具性质区分:read_file、list_dir、glob_files、grep_code、search_code、web_search、web_fetch、load_skill 这些只读工具可以并行;写文件、执行命令、MCP 调用、写记忆、回滚以及不认识的工具,一律按模型给出的顺序串行。连续的只读调用组成一段并行,遇到有副作用的调用,先等前面那段结束,再单独执行它。
工程兜底层面:
每个工具有独立超时,单个卡死不阻塞其他的。某个工具执行失败只返回该工具的错误给 LLM,不影响同批次其他工具的结果。
为什么不按文件路径加锁?路径锁要解析每个工具的参数,execute_command 里的一行 shell 命令会写哪些文件根本解析不出来,MCP 工具更是黑盒。按“有没有副作用”统一处理,规则简单,损失的只是写操作之间的并行度,而写操作本来就不多。
10、Token 预算是怎么管理的?
LLM 有上下文窗口限制,GLM-5.1 是 200k token,DeepSeek V4 是 1M。Agent 必须在窗口范围内工作。
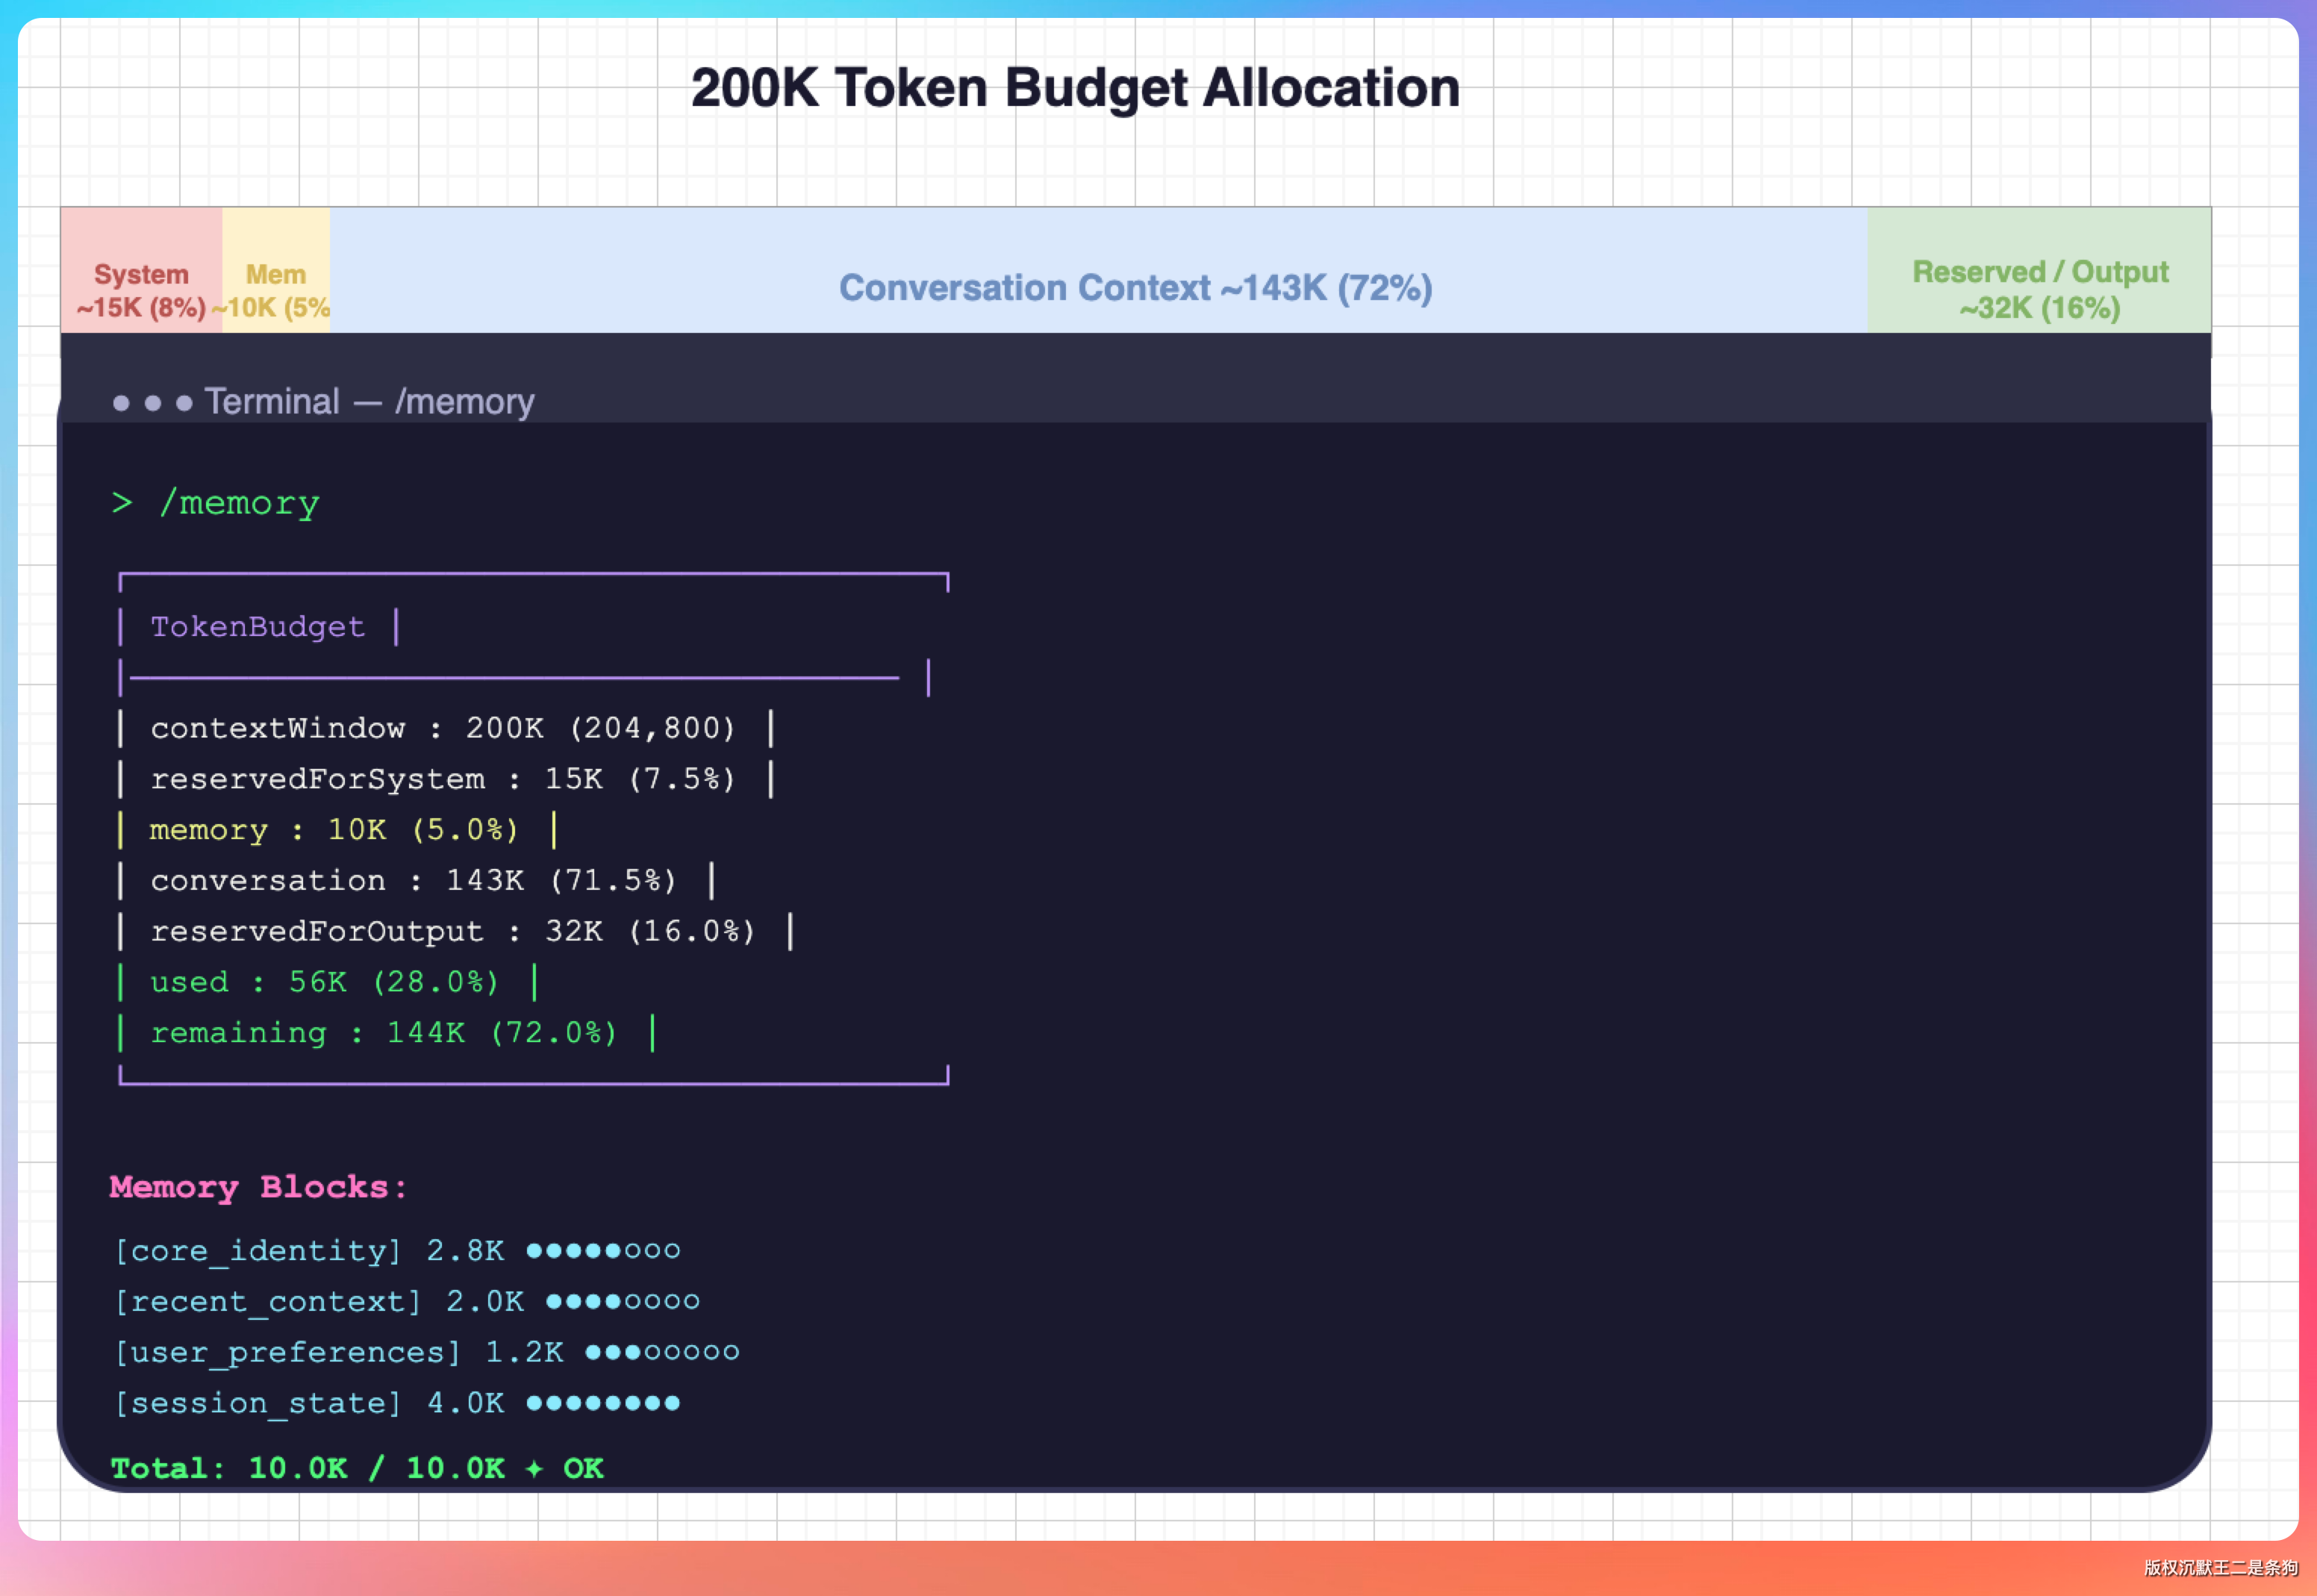
PaiCLI 的上下文预算在 com.paicli.context 和 com.paicli.memory 两个包里。每次调用模型前,Agent 估算当前对话历史的 Token 数,达到阈值就交给自动压缩模块。
阈值参考 Claude Code 的做法,给摘要输出和安全缓冲各留一块,公式是 window - min(20000, window/4) - min(13000, window/8)。200K 窗口大约 167K 触发,1M 窗口大约 967K 触发,128K 窗口是 95K。
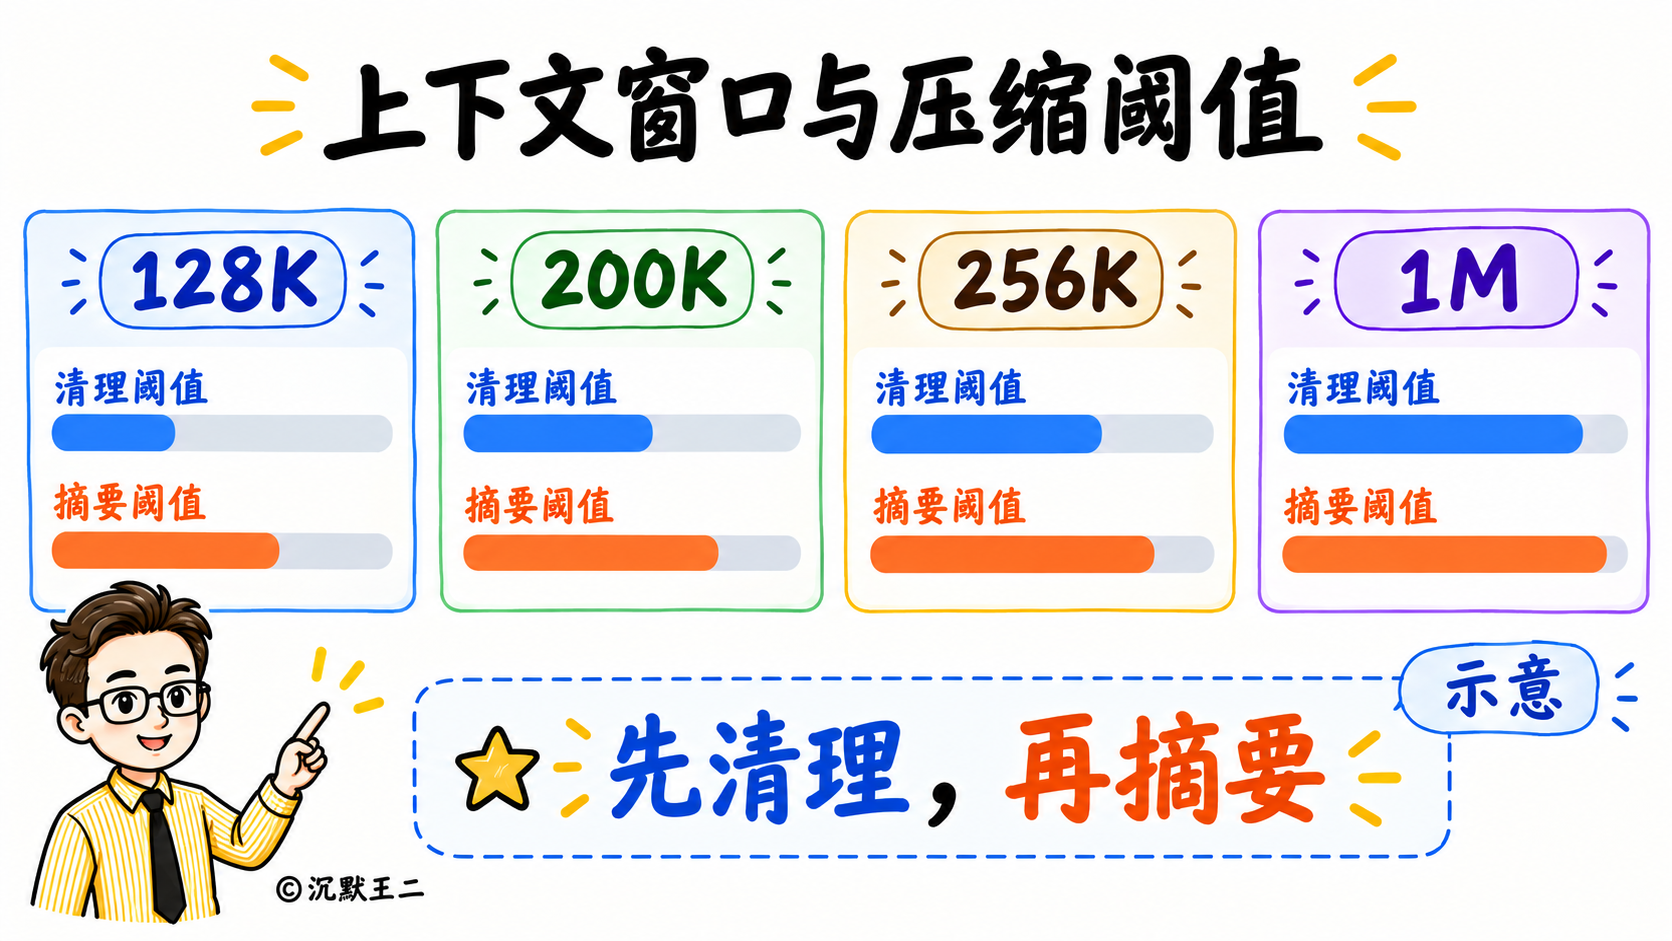
压缩按代价从小到大分三档。单个工具结果超过 32000 字符先落盘,上下文只留路径和首尾预览;越过清理阈值(默认 100K 和摘要阈值 60% 取小)后,较早的工具结果换成占位说明;还不够才做摘要,按 user 边界切分,保留最近 3 轮,旧消息按 60000 字符分段摘要再合并,要求四个固定栏目。
第 12 期曾经有过一个 long 模式,窗口不小于 100K 的模型直接跳过摘要压缩。8 月底这个设计去掉了,所有窗口都保留自动压缩。长对话里工具结果累积得很快,1M 窗口也会满,没有压缩的话,满了只能报错。
估算用的是字符数折算,中文 1.5 个字、其他字符 4 个一个 Token。它没有计入工具 schema 和思考模型回传的 reasoning 内容,所以偏小,这是已知的待改进点。
11、ReAct、Plan-and-Execute、Multi-Agent 三种模式怎么选?
这道题面试官很爱问,标准做法是给出一个清晰的决策矩阵。
| 场景 | 推荐模式 | 理由 |
|---|---|---|
| 简单问答、单文件修改 | ReAct | 一两步搞定,规划是浪费 |
| 创建项目、多文件重构 | Plan-and-Execute | 步骤多、有依赖,需要先规划 |
| 大规模任务、需要质量保障 | Multi-Agent | 分工协作 + 审查机制 |
PaiCLI 的设计是默认 ReAct,/plan 或 /team 显式切换,执行完自动回到 ReAct。
日常使用中大部分交互 ReAct 就能搞定。
面试官可能追问“能不能让 Agent 自己判断用哪种模式”。
答案是可以。
但我不会把这个判断完全交给大模型自由发挥,我会做一个“模式路由层”。这是我的设计设想,PaiCLI 目前还没有实现,现在只有用户显式输入 /plan 或 /team 才会切换。
用户输入进来后,先判断任务特征:是不是简单问答、是否需要工具调用、是否涉及多文件修改、是否有明显步骤依赖、是否适合并行拆分、风险是不是比较高。简单任务走 ReAct;有明确步骤和依赖的走 Plan-and-Execute;能拆成多个相对独立子任务的,再升级到 Multi-Agent。
我会让 Agent 输出一个结构化决策,比如 mode=react/plan/team、confidence、reason,但最终还要结合规则兜底。
比如用户显式输入 /plan 或 /team,就尊重用户命令;如果模型判断置信度低,就默认走 ReAct,或者先生成计划让用户确认;如果执行过程中发现任务比预期复杂,也可以从 ReAct 升级到 Plan,而不是一开始就定死。
12、如果让你从零设计一个 Agent 架构,你怎么做?
这道开放题面试官想看的是架构思维。
第一步,最小可用的 ReAct 循环。一个 while 循环 + LlmClient 接口 + ToolRegistry 注册表。先跑通“用户输入 → LLM 推理 → 工具调用 → 结果返回 → 继续推理”这条链路。PaiCLI 第一期就是这么做的,400 行代码。
第二步,加防护。Token 预算、循环次数上限、工具超时——这三个不加,Agent 会失控。PaiCLI 第 3 期加了 Token 预算管理,第 6 期加了 HITL 审批。
第三步,按需加复杂度。任务复杂了加 Plan-and-Execute(第 2 期),质量要求高了加 Multi-Agent(第 5 期),工具多了加并行调度(第 7 期)。
第四步,抽象与可扩展。LlmClient 接口不绑死模型(第 8 期),ToolRegistry 支持动态注册 MCP 工具(第 10 期),Prompt 从硬编码拆成 Markdown 文件(第 19 期)。
关键原则:先跑通再优化,先简单再复杂。一上来就设计完美架构是最大的陷阱。
13、面试中怎么介绍你的 Agent 项目(1 分钟版本)
“我从零开始用 Java 实现了一个 AI Agent CLI,叫 PaiCLI,对标 Claude Code,分 23 期从 ReAct 循环做到了完整产品。
核心架构方面,实现了 ReAct、Plan-and-Execute、Multi-Agent 三种模式。ReAct 是默认的,Plan-and-Execute 加了 DAG 拓扑排序支持任务并行,Multi-Agent 是 Planner-Worker-Reviewer 三角色协作。
工具系统接入了 MCP 协议,支持 stdio 和 Streamable HTTP 两种传输,内置了 Chrome DevTools 浏览器操控。安全层有 HITL 审批、路径围栏、命令黑名单、操作审计。
产品化方面做了 Claude Code 风格的 inline TUI、LSP 诊断注入、Git Side-History 快照回滚、HTTP Runtime API。
整个项目从第一期的 400 行代码演进到 23 期的完整产品形态,我最大的收获是理解了 Agent 从原理到产品的整个过程——什么时候该用简单方案,什么时候必须加复杂度。“
ending
面试时带着源码讲,比背答案管用得多。
【面试说到 ReAct,打开 Agent.java 指给面试官看那个 while 循环。说到 Plan,指 ExecutionPlan.java 的任务依赖图。说到 Multi-Agent,指 SubAgent.java 的角色定义和 prompt 文件。代码和回答能对上,面试官就知道你是真做过的。】
项目名称:PaiCLI — Java Agent CLI(对标 Claude Code)
项目简介:从零开始用 Java 实现的终端 AI Agent,覆盖 ReAct、Plan-and-Execute、Multi-Agent 三种架构模式,集成 MCP 协议、HITL 审批、RAG 检索和 Chrome DevTools 浏览器操控。
技术栈:Java 17、Maven、GLM-5.1/DeepSeek V4/Kimi K2.6 多模型、OkHttp + SSE 流式解析、JLine3 终端交互、SQLite 向量存储、JGit 快照管理、JUnit 5 + Mockito
核心职责:
- 基于 ReAct 模式实现 Agent 核心循环(Thought-Action-Observation),通过
ToolRegistry注册 17 个内置工具并动态接入 MCP 外部工具,工具选择由 LLM Function Calling 驱动 - 实现 Plan-and-Execute 模式,严格校验计划 DAG,按轮并行执行依赖已满足的任务,单任务失败时下游依赖自动跳过,完成度不足一半时有上限地重新规划
- 设计 Multi-Agent 三角色协作架构(Planner/Worker/Reviewer),Reviewer 审查不通过时带反馈重试(最多 2 次),编排器
AgentOrchestrator统一管理角色生命周期 - 实现并行工具调用机制,只读工具并行、写类工具按序串行,解决同一文件并发编辑丢更新的问题,结果按原始顺序返回保证 LLM 协议兼容,ReAct/Plan/Team 三条路径复用同一套调度器
- 实现循环预算与停滞检测,触发后关闭工具做一次部分完成收尾;上下文按窗口计算阈值,依次执行工具结果落盘、旧工具结果清理和结构化摘要三档压缩,支持 128K-1M 窗口模型