
CPU、GPU、NPU 到底有什么区别?
AI 时代,你是不是也经常听到 CPU、GPU、NPU 这三个 PU?但完全不知道他们是干嘛的,今天就用三分钟,给你彻底讲清楚。
拿 Codex 这个应用程序来说,他跑在你电脑的 CPU 上,你发出去的每一个请求,则由数据中心的 GPU 完成推理。
那喜欢点赞的你应该已经注意到了,这两年新出的手机和电脑,参数表里都多了一个 NPU。比如说小米 18 Pro 就搭载了第六代骁龙 8 至尊版芯片,该芯片内部就集成了高通最新一代的硬件 NPU;再比如说微软和联想就联合规定,只有 NPU 算力达到 40 TOPS(每秒万亿次操作)以上的电脑,才能被称为真 AI PC。
恭喜看到这里的你,已经成功击败 30% 的学习者,给自己鼓个掌吧。接下来我问你,CPU 和 GPU 的区别是什么?
A,CPU 的主频更高;B,GPU 的核心更多;C,两种芯片各有各的场景。喜欢收藏的你可以把答案打在弹幕区或者留言区。
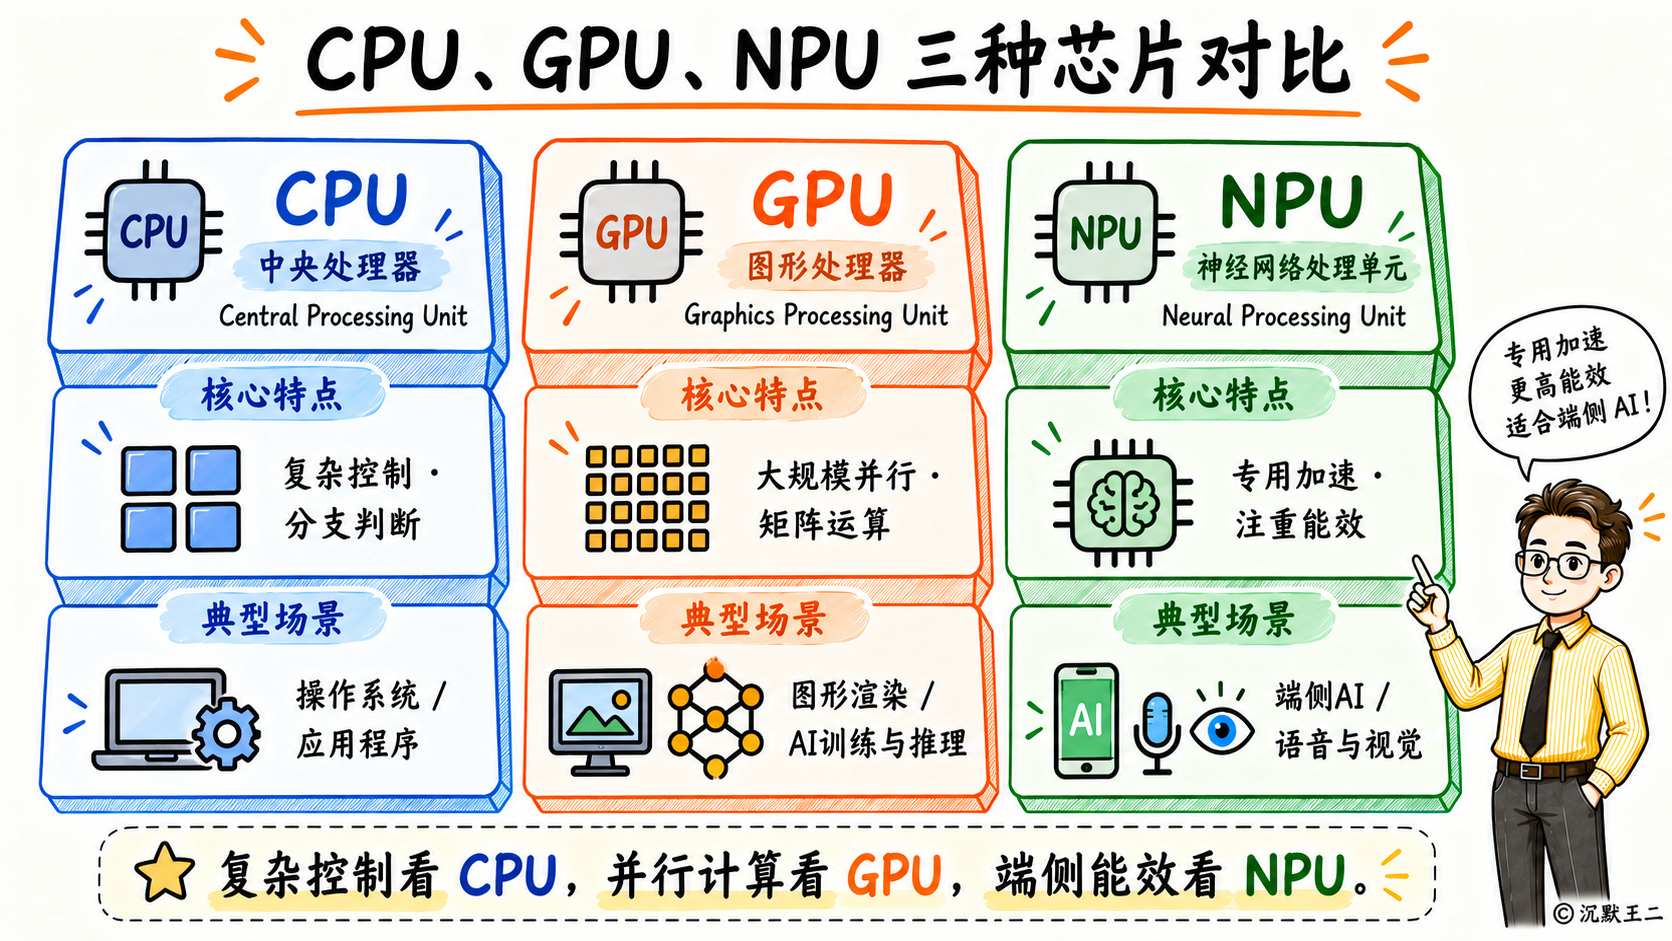
说一下我的答案。CPU 也就是中央处理器,核心数少,但每个核心都很强,擅长串行处理,擅长分支和复杂的条件判断,适合运行操作系统和各种应用程序,它是整台电脑的指挥中心。
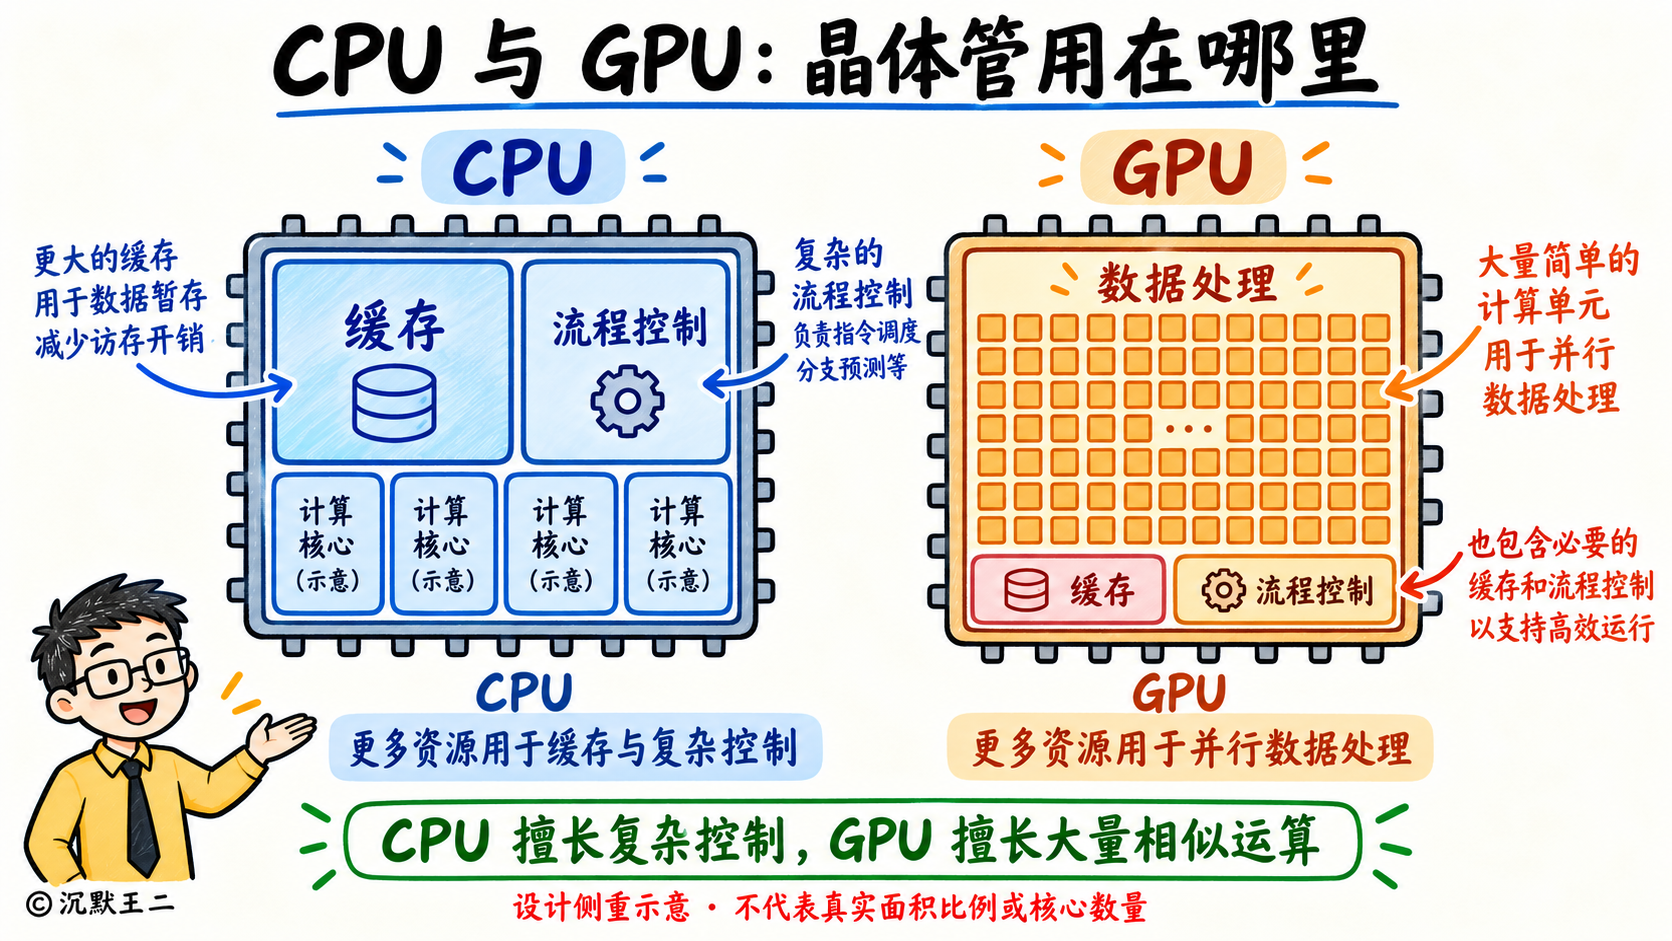
GPU 也就是图形处理器,拥有非常多的核心,能并行处理且高速完成矩阵计算和向量运算。功耗大吞吐高,适合 3D 图形绘制、游戏渲染、机器学习的训练和大模型推理、视频剪辑、仿真模拟等需要一次性处理大量相似运算的并行计算。
按照英伟达 CUDA 编程指南的说法,CPU 把更多晶体管用在了缓存和流程控制上,GPU 则把更多晶体管用在了数据处理上。一台拥有两颗 32 核 CPU 的服务器只能同时运行 64 个线程,而一块有 80 个 SM 的 GPU,能同时挂载 16 万个以上的活跃线程。解释下,SM 是流式多处理器,也就是 GPU 里的基本计算单元。
GPU 把 32 个线程编为一组,称其为 warp,同一个 warp 里的线程可以同时执行同一条指令。大模型里最吃计算的就是矩阵乘法,由于每个元素的计算互不依赖,所以正好可以交给 GPU。
恭喜看到这里的你,已经成功击败 50% 的学习者了。接下来继续问你,GPU 已经能跑 AI 了,手机为什么还要单独加一块 NPU?
A,NPU 的算力比 GPU 强;B,同样的计算,NPU 更省电;C,NPU 什么模型都能跑。喜欢推荐的你会选哪一个?
我的答案是 B。NPU,也就是神经网络处理器,专为神经网络中的矩阵运算而设计,极度适配智能手机或者边缘设备上的端侧 AI 推理。典型应用场景包括人脸识别、语音识别、实时翻译以及计算机视觉检测,契合所有希望在终端设备运行 AI 的业务需求,因为 NPU 是省电专家。
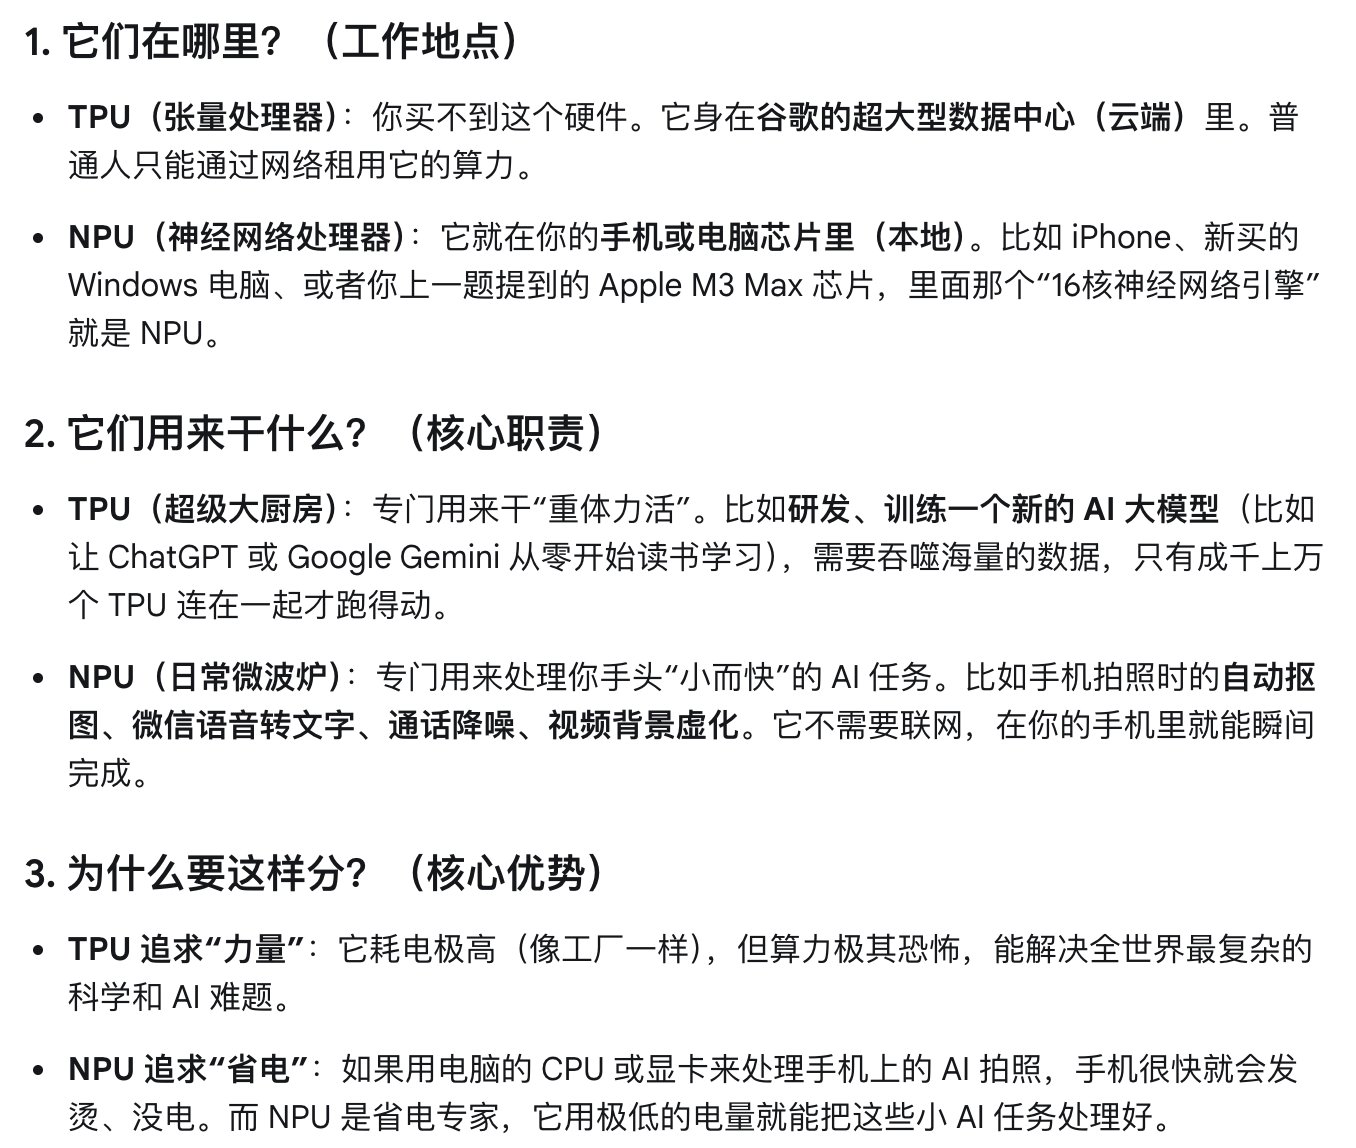
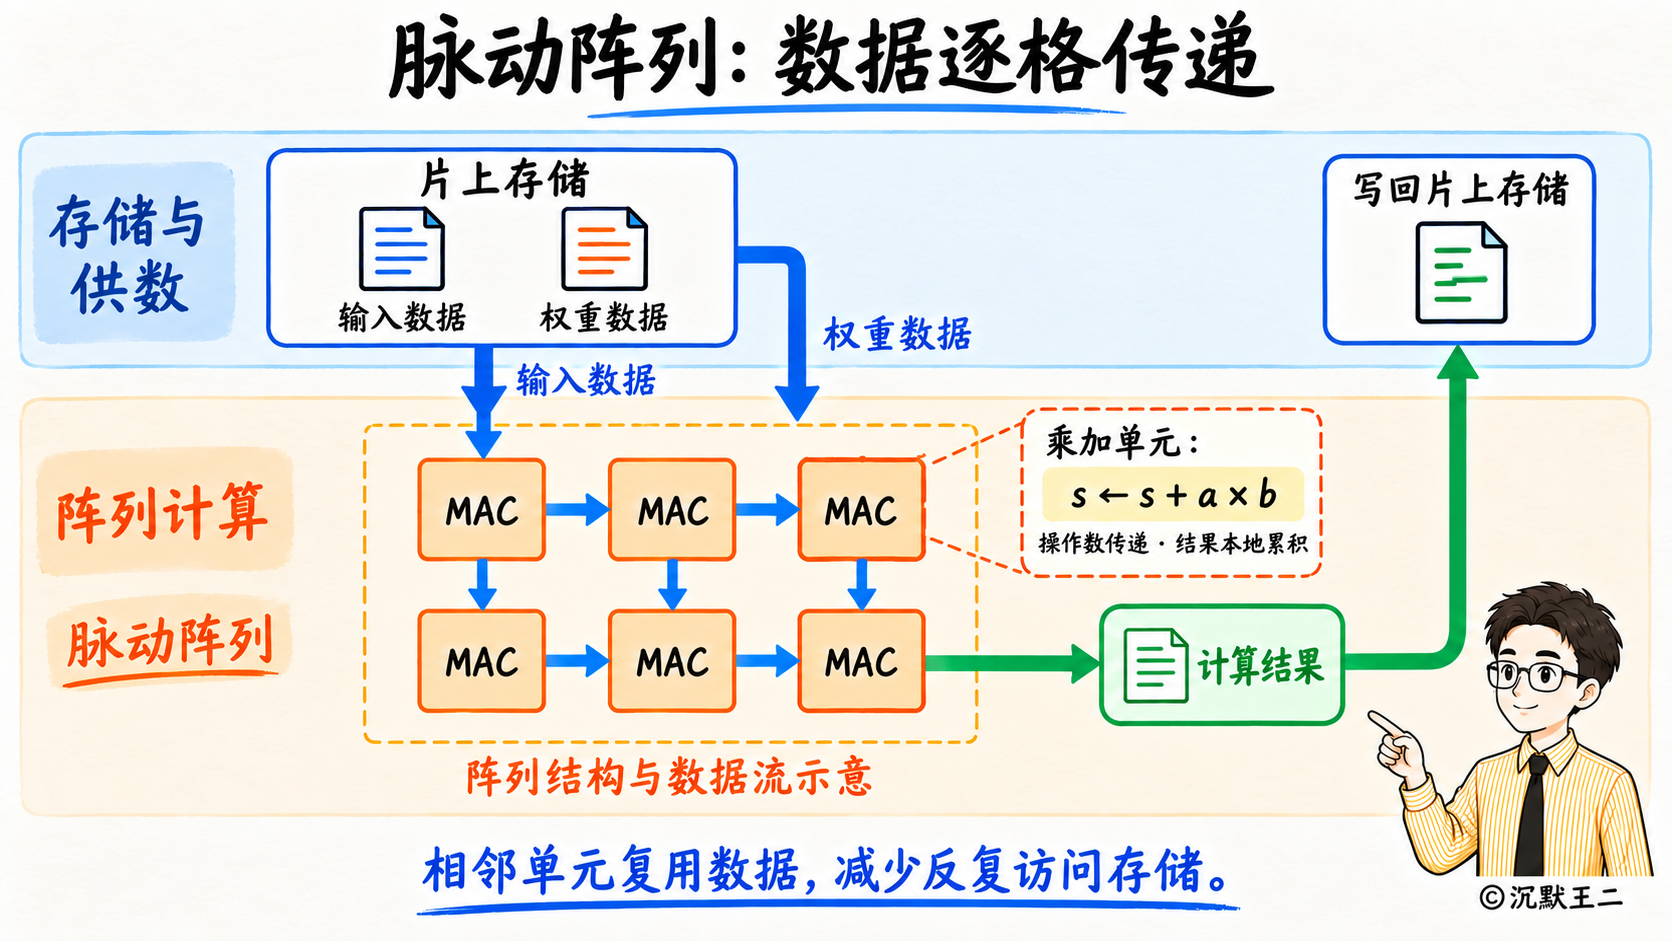
Google 曾发表过一篇关于 TPU 的论文,里面讲得很清楚,TPU 和 NPU 是同一类专用芯片。TPU 里有一块矩阵乘法单元,由 65536 个 8 位乘加单元组成,排成脉动阵列。数据在阵列里像工厂流水线一样一格一格往下传递,每个单元算完直接交给下一个单元,不用反复读写存储。TPU 的每瓦性能是同期 CPU 和 GPU 的 30 到 80 倍。
恭喜看到这里的你,成功击败 70% 的学习者了。继续问你,在自己的电脑上跑大模型,Token 生成的速度主要看什么?
A,NPU 的 TOPS;B,GPU 的核心数;C,内存带宽。喜欢收藏的你会选哪一个?
说一下我的答案。大模型推理分两个阶段。第一个阶段是 Prefill 预填充,模型需要一次性读完你的整段提示词,做的是大块的矩阵乘法,瓶颈在算力。第二个阶段是 Decode 解码,模型需要一个 token 一个 token 地生成,token 也就是词元。每生成一个 token,都要把全部权重从内存里读一遍,这时候瓶颈主要在内存带宽。
按 NVIDIA 技术博客的估算,一个 7B 参数的模型用 FP16 也就是 16 位浮点数存储,权重大约 14GB。Token 生成的速度上限,大约等于内存带宽除以权重大小。
拿苹果的芯片来说。M5 对比 M4,第一个 token 的生成快了 3 到 4 倍,正是因为苹果在 M5 芯片的全新 GPU 架构中,首次为每个 GPU 核心集成了专属的神经加速器(Neural Accelerator)。
后续 token 的持续生成则受限于内存带宽,M5 的内存带宽从 M4 的 120 GB/s 提升到了 153 GB/s,得益于这 27% 的带宽增幅,M5 在本地持续生成 Token 的速度也比 M4 提升了 27 个百分点。
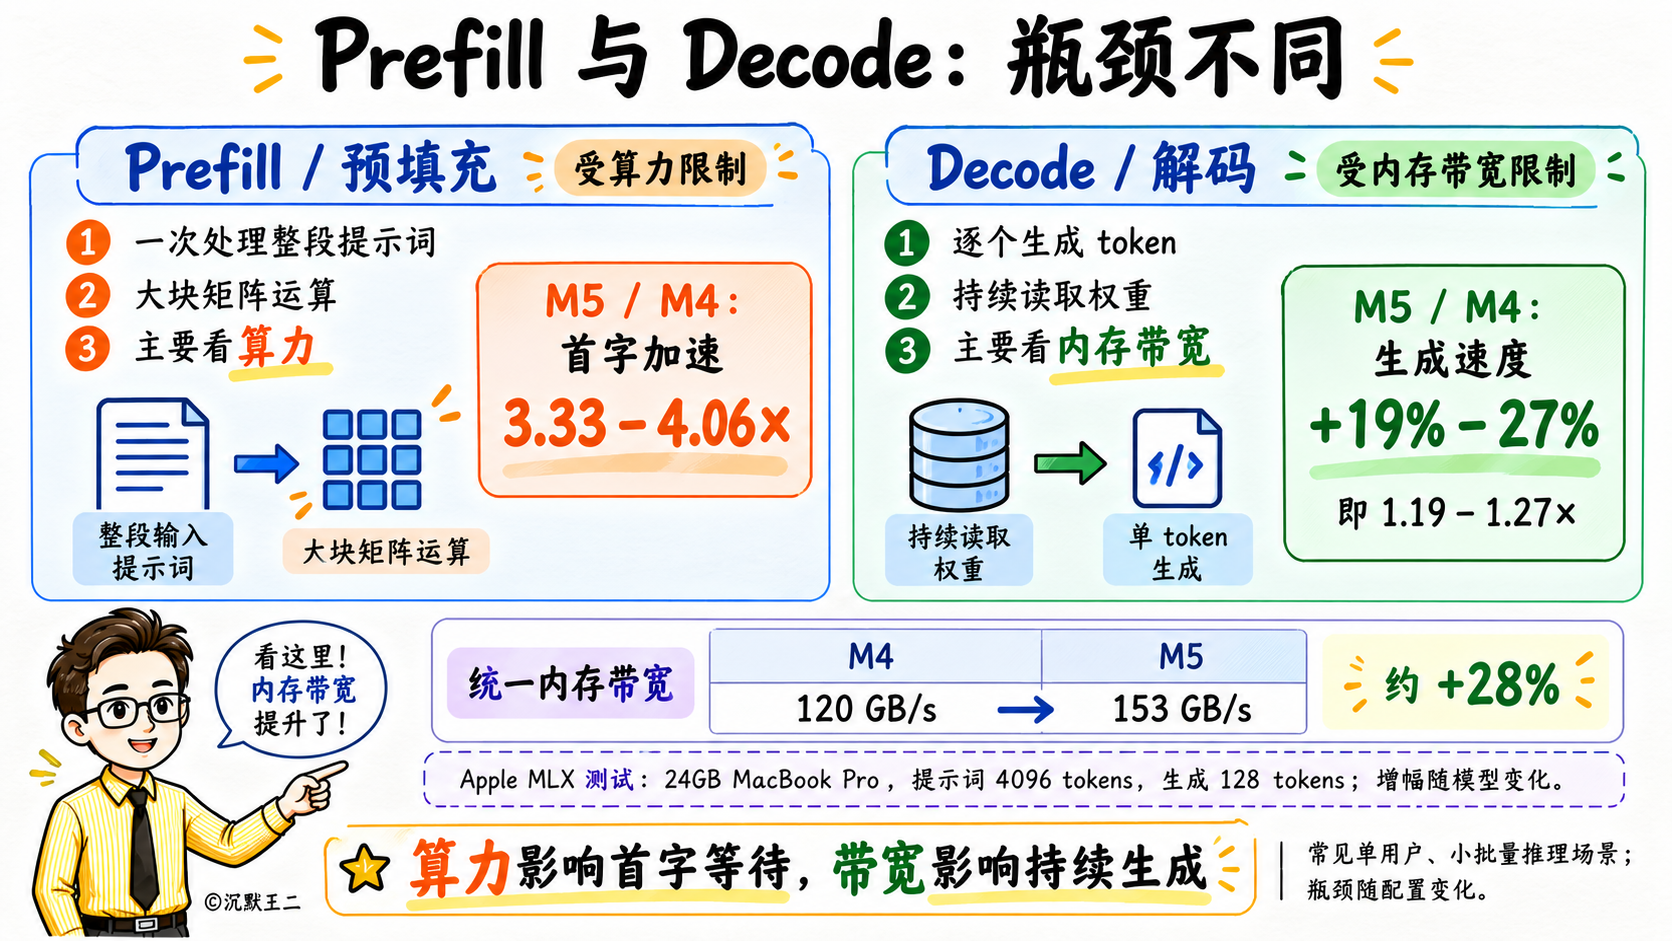
算力决定首字的速度,带宽决定后续 Token 的速度。恭喜看到这里的你,成功击败 90% 的学习者了。
最后问你:“Agent 时代,算力都交给 GPU 了,CPU 是不是就不重要了?”
我的答案是否定的。Agent 等于 Model 加 Harness,Model 跑在 GPU 上,Harness 跑在 CPU 上。Claude Code 读取文件、执行 Bash 命令、调用工具、运行测试,这些都由 CPU 完成。
NVIDIA 在技术博客里专门讲过这件事,Agent 在两次 GPU 计算之间,要靠 CPU 完成工具调用、代码执行和沙箱运行。CPU 慢的话,GPU 就只能干等;等得太久,KV Cache 也就是模型缓存在显存里的中间结果,还可能会被挤出显存,需要重新计算。
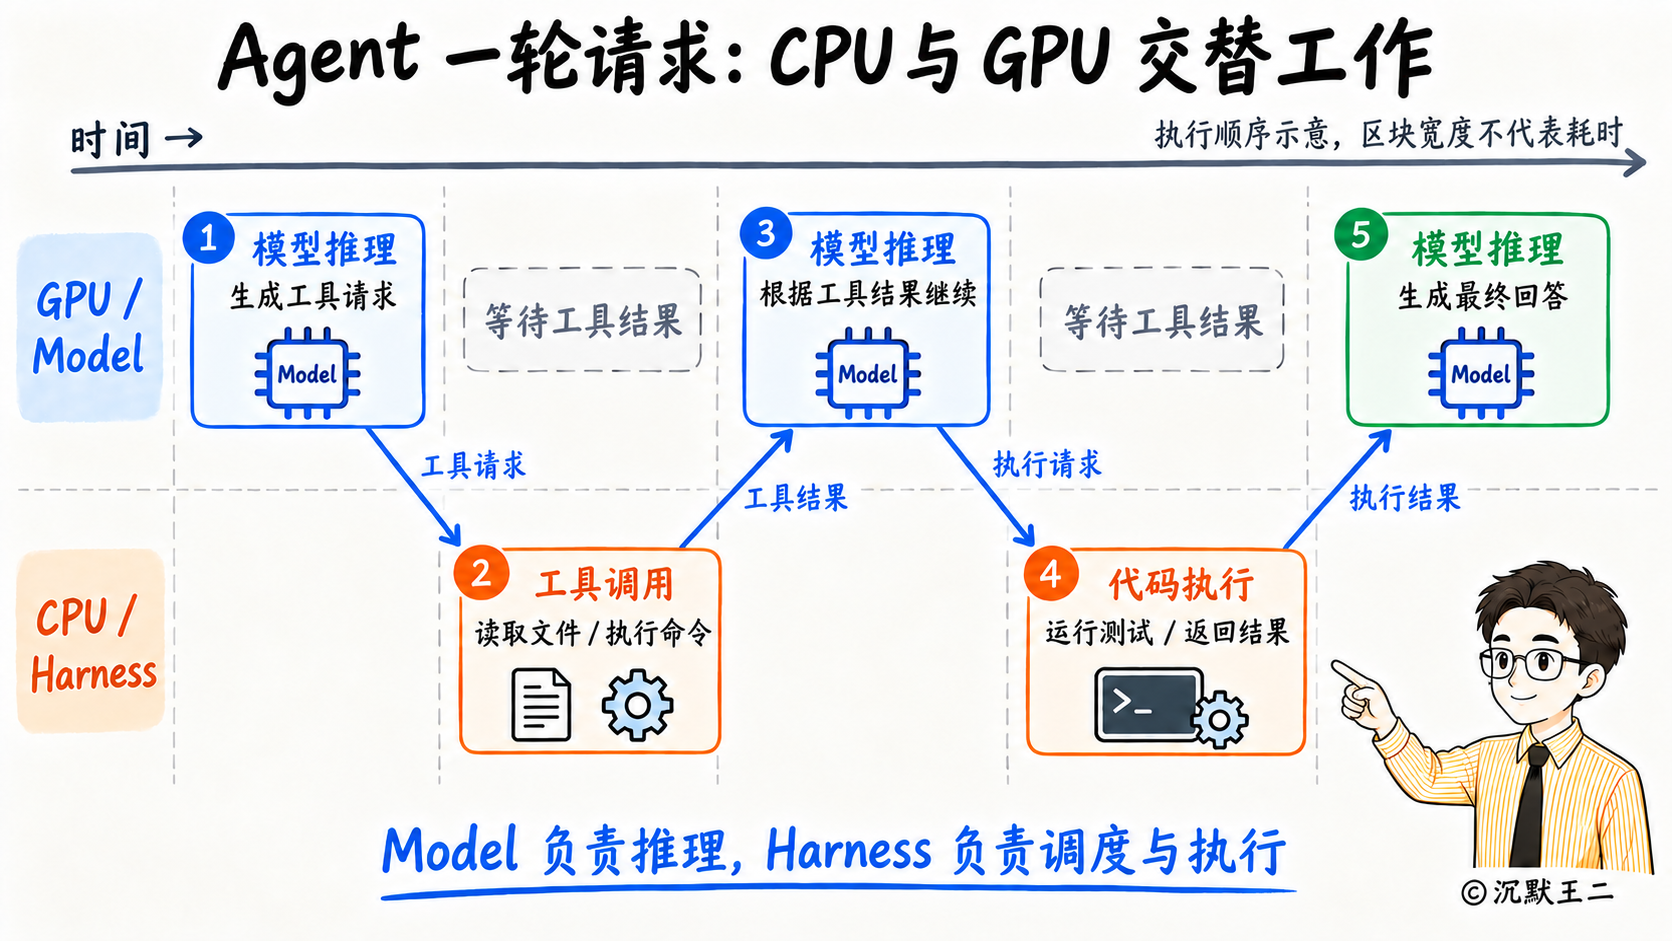
恭喜看到的这里的你升到王者段位了,成功击败 99% 的学习者,点个推荐证明自己的实力吧。
最后简单总结下。CPU 负责本机 Agent 的执行调度,GPU 决定 LLM 在云端的计算速度,NPU 是端侧 AI 的主力,让我们的手机和电脑能够不插电、不联网也拥有强大的 AI 能力。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!