
AI Agent 面试题 365 道(Agent八股+视频讲解)|王二讲Agent
从 2025 年开始,到现在的 2026年,大厂面试出现了一个明显的转向。传统的八股文比重在降,取而代之的是 Agent 相关的问题。字节、阿里、腾讯、蚂蚁、快手、小红书,几乎每一家都在问「你做过 Agent 项目吗」「RAG 检索怎么做的」「MCP 协议了解吗」。不光是面试,整个行业的技术栈也在往 Agent 方向迁移。Claude Code、Codex 这些产品已经不是概念验证了,它们在真实的生产环境里跑着,每天帮我们写代码、改 bug、做 Code Review。
甚至今年下半年涌现了一大批桌面Agent,包括WorkBuddy、豆包工作、千问办公等的。
模型也在不断升级,DeepSeek V4、Kimi K3、GLM-5.3、Fable 5、GPT-6 Astra 等等。
这意味着两件事。
第一,Agent 不再是「了解即可」的加分项,而是后端和 AI 方向求职的必答题。你不需要成为 Agent 框架的贡献者,但你得说清楚 ReAct 怎么控制迭代、上下文窗口爆了怎么压缩、RAG 的混合检索怎么设计、Prompt Caching 的命中条件是什么。这些问题,已经是面试中的常客了。
第二,理解 Agent 的工作原理也会直接提升你使用 AI 工具的效率。知道 Context Engineering 的人,写 Prompt 的质量和不知道的人完全是两个水平。
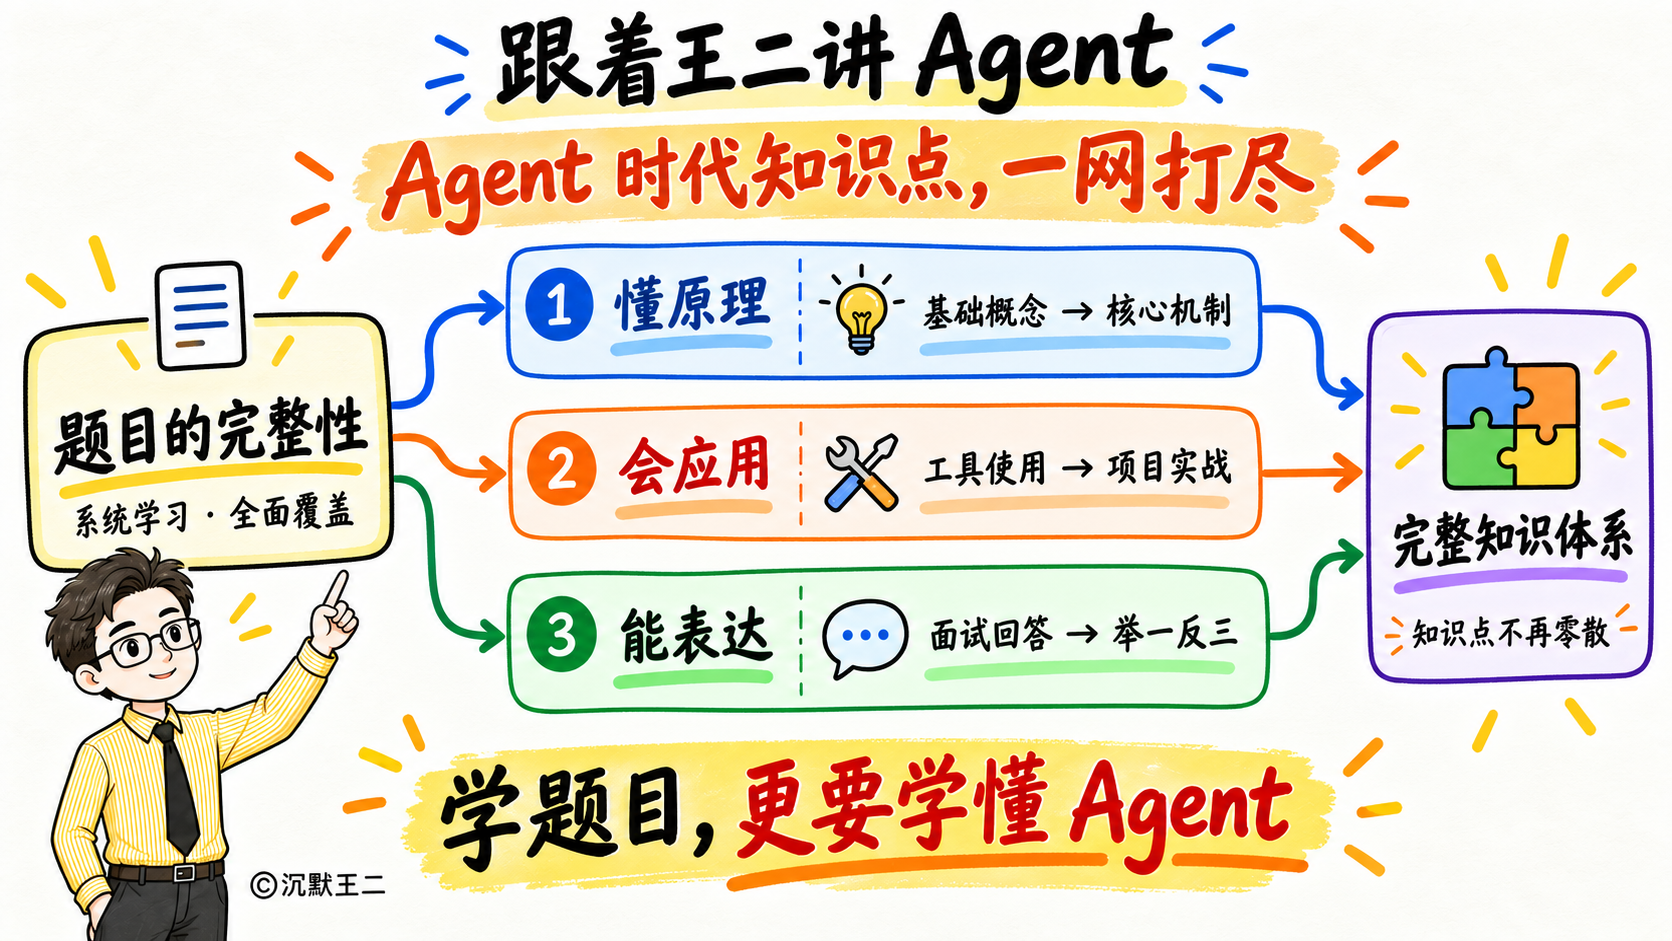
这套题库一共 365 道(还会持续追加),覆盖 Agent 基础、上下文与记忆、Harness、RAG、LLM、Claude Code、Codex、DeepSeek、Prompt、MCP、LangChain、Spring AI、模型微调和 Agent 产品演进。题目来源是牛客、星球、各大厂真实面经,按出现频次和难度权重筛选,随着视频更新持续补充。
每道题都不是孤立的概念解释,而是串联到三个实战项目来回答。
- PaiAgent/PaiFlow,LangGraph4j + Spring AI 的工作流编排平台
- PaiCLI,对标 Claude Code 的 终端 Agent
- 派聪明,基于 ES 混合搜索的 RAG 知识库
每一道题的回答都有项目代码可以兜底。
题目难度分三级:🟢 基础、🟡 进阶、🔴 深入。已完成图文解析和视频讲解的题目会标注链接,方便按图索骥。
飞书题库入口:按分类浏览题目和详细答案,展开左上角目录即可切换阅读。
分类与排序说明:题目按知识主题分类,网站侧边栏收录已完成的脚本;「热点解读」用于拆解模型发布和行业事件。每类已发布视频的题目按发布顺序倒序排列,新视频优先;尚未发布视频的题目保留在后面。原题号作为固定编号保留,不随展示顺序改变;疑似重复题仍保留,确认前暂不删除。
你也可以加我的微信【备注AI】,小助理会拉你进AI交流群的。
01、Agent 基础(43 题)
聚焦 Agent 的定义、工作方式、规划、反思和多 Agent 协作。部分新增题目参考了开源书《深入理解 AI Agent:设计原理与工程实践》(bojieli/ai-agent-book)的章节结构和各章思考题。
31. 用户中途取消,Agent 任务怎么停下来?
NEW 新增题目
取消分两层。第一层是 Agent Loop,每一轮调用模型和执行工具之前都检查取消信号,收到就不再发起新的一步。第二层是正在执行的操作,模型的流式请求要中断连接,工具要能响应取消,比如 Java 里用 Future.cancel 配合线程中断,命令行进程要结束整个进程组。取消之后要给进行中的工具调用补一条“已被用户取消”的结果再写回会话,否则下一轮请求里会出现没有结果的工具调用,Anthropic 这类 API 会直接报错。前端断开 SSE 连接时,后端也要感知到并真正停止推理,不然 Token 还在继续消耗。如果用户只是补充要求而不是取消,更好的做法是把新消息排队,在当前这一步结束后注入上下文,Pi 的 steer 就是这样设计的。
抖音视频:观看本集视频
🟡 进阶 | → PaiCLI
27. 工具调用失败或超时怎么处理?
NEW 新增题目
先分类再处理。网络抖动、限流这类瞬时错误,在工具内部做有限次数的指数退避重试,对模型透明;参数错误、业务校验失败这类确定性错误不要盲目重试,把错误原因和修改建议作为工具结果返回给模型,让模型换参数重新调用;超时要真正取消底层操作,而不是只丢掉返回值。模型输出非法 JSON 时,先尝试修复,修复不了就把解析错误返回给模型重新生成,并限制次数。有副作用的工具必须保证幂等,用请求 ID 去重,否则一次重试就可能重复扣款。同一步连续失败超过阈值,就停止当前任务,交给用户或人工处理。
抖音视频:观看本集视频
🟡 进阶 | → PaiCLI / PaiAgent
26. Agent 的意图路由怎么设计?
NEW 新增题目
按成本分层。第一层用规则和关键词拦截确定性高的请求,比如“查订单”直接进入订单 Agent;第二层用小尺寸模型或 Embedding 分类器做意图分类,输出固定的枚举值和置信度;置信度低于阈值或者同时命中多个意图时,再交给主模型判断,主模型也判断不了就反问用户。路由的输出必须是结构化的枚举,不能让模型自由发挥。路由错了要有兜底,子 Agent 发现任务不属于自己时返回“不匹配”,由主 Agent 重新分发,同时限制重新分发的次数,避免子 Agent 之间互相推诿。效果用标注好的测试集评估,按意图分别统计准确率和召回率。
抖音视频:观看本集视频
🟡 进阶 | → PaiAgent
25. 多 Agent 之间怎么传递上下文?
NEW 新增题目
默认传结构化的中间结果,不传完整对话。主 Agent 派活时写清任务目标、已知约束、输入数据和期望的输出格式,子 Agent 在自己独立的上下文里执行,最后只把结论和关键证据以 JSON 或摘要的形式交回,中间的试错过程留在自己的上下文里。传完整对话看起来不丢信息,实际会把无关的工具输出和失败尝试一起灌给下游,上下文越传越长,还会让下游把上游的错误判断当成事实继承下来。大块数据不走消息,写进共享文件系统或存储,只传路径或 ID。Claude Code 的 Sub-agent 就是这样,只拿到主 Agent 写的任务描述,结束时只把一段总结返回给主 Agent。
完整答案:阅读全文《多 Agent 上下文传递》 · 飞书版
抖音视频:观看本集视频
🟡 进阶 | → PaiCLI / PaiAgent
24. Plan 模式已经死了吗?
NEW 新增题目
说对了一半。2026 年 9 月 24 日 Ayman Nadeem 发表《Plan mode is dead》,在 Hacker News 上引发了大量讨论,Claude Code 团队的 Boris Cherny 也在讨论里表示,plan mode 以前有用,现在已经没那么有用了,因为当前的模型基本能准确理解意图。他还提到,Claude Code 的 plan mode 只是在每条消息里追加一句“先不要写代码”的提醒,并不改动工具集,因为改动工具集会让 Prompt Cache 失效。死掉的是“先出计划、等人审批、再执行”这个强制阶段,它原本是为了弥补模型猜不准意图而存在的,现在模型在推理过程中自己规划,进度交给 todo 或任务工具跟踪。Pi 的作者 Mario Zechner 更早就不内置 plan mode,主张把计划写进文件,需要时再用扩展实现。规划本身没有死,只是换了地方。方向不确定、要改很多文件、走错代价高时,先只读探索再给方案依然值得;长任务和并行的 Sub-agent 需要一份写成文件的 Spec 作为共同依据。Claude Code 官方最佳实践给了一条简单的判断标准,如果一句话就能说清要改什么,就跳过计划。
完整答案:阅读全文《Plan 模式已经死了吗》 · 飞书版
抖音视频:观看本集视频
🟡 进阶 | → PaiCLI
23. Pi Agent 系统里有哪些反复出现的设计模式?
NEW 新增题目
从 Pi 的源码可以看出三个典型模式:策略模式让工具切换本地与 SSH 等执行环境;适配器模式把不同厂商的请求和流式事件转换为统一接口;责任链模式让多个扩展依次检查工具调用,并在需要时终止执行。
完整答案:阅读全文《Pi Agent 设计模式》 · 飞书版
抖音视频:观看本集视频
🟡 进阶 | → PaiCLI
22. 如何做出像Pi一样优秀的Agent?
NEW 新增题目
来自 Anthropic 的《Building effective agents》。保持简单,直接的 API 调用优于复杂框架,每多一层抽象都是以后调试的盲区。保持透明,明确显示规划步骤、执行日志和决策轨迹。设计好 Agent-Computer Interface,从 Agent 的视角而不是程序员的视角设计工具,容易误用的地方从设计上让错误无法发生。
完整答案:阅读全文《构建 Agent 的三个原则》 · 飞书版
抖音视频:观看本集视频
🟢 基础 | → PaiCLI
21. 订机票客服该用工作流还是自主 Agent?
NEW 新增题目
先看能不能用单次调用解决,不行再考虑工作流,只有需要动态决策时才上自主 Agent。核实身份、付款、预订这类顺序不能乱的合规步骤用工作流写死,改签、航班取消这类预设流程覆盖不到的情况交给自主 Agent。混合的另一种做法是先由自主 Agent 把工作流写出来,再由工作流去执行,执行阶段就回到了确定性。
完整答案:阅读全文《订机票:工作流还是 Agent》 · 飞书版
抖音视频:观看本集视频
🟡 进阶 | → PaiAgent / PaiCLI
20. 模型越来越强,Harness 会不会被模型「吃掉」?
NEW 新增题目
要区分“补短板”和“划边界”。格式修正、工具调用适配等补短板能力,会随着模型变强逐步被内化;文件和网络权限、危险操作确认、审计与业务规则,则仍需 Harness 在模型外执行。模型不能保证永不犯错,也无法替用户决定哪些操作被授权,所以模型越强,越需要可靠的执行边界。
完整答案:阅读全文《模型会吃掉 Harness 吗》 · 飞书版
抖音视频:观看本集视频
🔴 深入 | → PaiCLI
19. Agent 的沙箱(Sandbox)你了解吗?
NEW 新增题目
命令黑名单在动态生成的代码与复杂的系统调用面前形同虚设,随便用 base64 编码、管道拼接或临时脚本即可绕过,更防不住模型幻觉误操作。合格的沙箱绝不是在恶意命令表面贴创可贴,而是必须在系统底层筑牢文件系统读写、网络出入站、进程空间与硬件资源配额四道防线。一线工程在隔离强度和启动成本之间各有取舍:Claude Code 采用 Git Worktree 隔离工作区并结合抽象语法树(AST)解析命令,Codex 在操作系统层依托 Bubblewrap 命名空间与 Seatbelt 规则锁死未授权读写与网络,Devin 则在云端直接拉起具备硬件级隔离的独立微型虚拟机。对于轻量本地 Agent,通常通过前置物理路径围栏、危险指令快速熔断、人机协同(HITL)审批以及系统原生沙箱包装来逐层设防,开源实现可参考 bubblewrap、E2B 与 Firecracker。
完整答案:阅读全文《Agent 沙箱》 · 飞书版
抖音视频:观看本集视频
🟡 进阶 | → Claude Code / Codex / PaiCLI
18. 了解 Agent 的 Checkpoint 机制吗?
NEW 新增题目
Checkpoint 是运行时内存与工作环境状态的持久化保存机制,本质上是任务执行过程中的自动存档点,用于在崩溃、暂停或回滚时恢复状态,而不仅仅是存储对话历史。一个合格的 Checkpoint 至少需要覆盖任务规划、对话历史、文件系统、进程状态和环境配置五个维度。在工程落地层面,保存有序的工具调用日志比只存最终快照更有利于还原前后的因果决策关系;业界实践中,Claude Code 采用本地影子快照与三层比对实现每轮自动存档,Codex 区分会话状态与文件差异进行分层撤销,Devin 则在微型虚拟机底层基于写时复制(Copy-on-Write)实现毫秒级磁盘快照。对于发送外部通知或支付等不可逆操作,则需要结合交互确认或状态补偿机制予以兜底。
完整答案:阅读全文《Agent Checkpoint》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
🟡 进阶 | → Claude Code / Codex / PaiCLI
17. 如果只能给 Agent 增加一项能力,更强的 LLM,更长的 Context,还是更多的 Tool?
NEW 新增题目
优先用 Tool 主动丰富动态 Context。被动把 Context 窗口拉到上百万 Token 不仅昂贵迟钝,塞满的全是静态死数据;在生产级 Agent 里,绝大多数 Tool 的核心目的,恰恰是作为探针主动把运行时报错与代码现场捞进 Context 变成活信息,比如 Claude Code 和 Codex 靠轻量探针与终端命令把原本不可解的重构任务直接跑通。只有当现场信息已经给足,但面对二十轮以上的长程长周期任务发生规划迷航、或在复杂多重堆栈前无法归因时,升级更强的 LLM 才具有真正不可替代的价值。
完整答案:阅读全文《LLM、Context 还是 Tool》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
🟡 进阶 | → PaiCLI
16. Harness 的五要素是什么?
NEW 新增题目
上下文管理、工具接口、约束、验证、纠正。前两项就是「Agent = LLM + 上下文 + 工具」里的上下文和工具,构成最小 Harness,生产系统再加上后三项保障。所以两个公式不是两套划分,Agent = Model + Harness 是同一个 Agent 在生产形态下的展开,LLM 对应 Model。两个公式都只描述 Agent 边界之内,不包含它交互的环境。
完整答案:阅读全文《Harness 五要素》 · 飞书版
B站视频:观看本集视频
抖音视频:观看本集视频
🟢 基础 | → Claude Code / Codex
15. Multi-Agent 协作时意见冲突怎么办?
Multi-Agent 冲突不能靠投票或裁判 Agent 解决,同源模型会集体盲从。主 Agent 与 Sub-agent 分歧时由主 Agent 裁决,但要把反对意见当事实重新评估,超出权限交给用户。Worker 与 Reviewer 对抗,审查 Agent 不能改代码,必须附上实际执行的命令和输出,任务依赖保证审查和编码不同时跑。并发 Worker 的写冲突靠写操作串行、git worktree 隔离或 CAS 乐观锁。
完整答案:阅读全文《Multi-Agent 冲突处理》 · 飞书版
B站视频:观看本集视频
抖音视频:观看本集视频
🔴 深入 | → PaiCLI | 字节、阿里
14. Agent 怎么做经验积累和自我学习?
Agent 的自我学习不能靠运行时微调参数,权重实时更新算力顶不住,还会引发灾难性遗忘。经验积累靠上下文工程搭建的外挂认知系统。遇到报错或用户纠错时先反思提炼教训,再归档到外部存储,比如 Claude Code 写入 memory 目录,Codex 写入本地 SQLite,新任务到来时再检索注入给模型。记忆越积越多,Claude Code 的 AutoDream 会在后台合并重复经验、淘汰过时策略,沉淀出精炼的长期记忆。
完整答案:阅读全文《Agent 经验积累》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
🔴 深入 | → PaiCLI
13. 为什么你选择手搓 Agent 而不用框架?
框架的问题在于过度封装和版本频繁变动,一次文本生成要过好几层类才送达 LLM,业务逻辑没变代码却得跟着升级改。Anthropic 官方建议直接调用 API,Octomind 也因为无法控制 Agent 的中间状态,用了一年多后换成手搓。手搓的价值在于掌控 Harness 细节,模型每一步调了什么工具、返回值合不合理都能实时拦截修正,上下文能做前缀感知与动态压缩,只读并发、写操作串行的调度也能自己设计。框架只在快速验证原型时有价值。
完整答案:阅读全文《为什么手搓 Agent》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
🟡 进阶 | → PaiCLI
12. Agent 的反思机制是什么?为什么需要反思?
反思和重试的区别在于有没有反馈信号,重试是闭着眼睛重来一遍,反思是带着诊断去修改。Self-Refine 让同一个 LLM 生成初稿后自己当裁判挑毛病,再带着修改意见重新生成,没有外部反馈,只在一次任务内修正。Reflexion 则由 Evaluator 通过测试用例和外部工具判定对错,失败后由 Self-Reflection 分析失败轨迹写成反思总结存入记忆库,教训能跨轮次指导下一次尝试。两者的差别就在反馈依据、作用范围和记忆机制上。
完整答案:阅读全文《Agent 反思机制》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
🟡 进阶 | → PaiCLI
11. Agent 的 Planning 模块有哪些实现方式?
Plan-and-Execute 把规划与执行解耦,比 ReAct 多了全局视角,适合确定性强的长任务。Reflective Planning 在每步执行后对比结果与预期,偏离就重排剩余步骤,适合易出错的开放任务。Graph-based Planning 则给出多条路径,由评估器选胜率最高的分支推演,适合数学推导和代码生成。企业级合规场景下,SOP 和状态机规划用确定性的工程骨架把大模型限定在给定分支和节点间做选择。
完整答案:阅读全文《Agent Plan 模式》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
🟡 进阶 | → PaiCLI | 字节、阿里、腾讯
4. 说说 Agent 是如何工作的?
Agent 处理一次请求分四步。先组装上下文,把系统提示词、工具定义列表、CLAUDE.md 项目规范、对话历史和用户消息拼在一起,这才是模型真正看到的输入。然后调用模型,关键信号是 stop_reason,返回 tool_use 就调工具、循环继续,返回 end_turn 则任务完成。接着执行工具,先检查权限再执行。最后把结果包装成 tool_result 追加到对话历史。不同 Agent 核心逻辑相同,差异在 Harness 层。
完整答案:阅读全文《Agent 如何工作》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
🟡 进阶 | → PaiCLI | 字节、淘天、阿里云
5. 一个 Agent 有哪些核心组件?
一个能跑的 Agent 至少需要五大核心组件协作。模型负责推理、决策、选工具、填参数,但只会想不会动手。工具带名称、描述和参数的 JSON Schema 注册到工具表,模型返回 tool_calls 后由 Harness 找到函数执行。记忆分短期和长期,规划有 ReAct 和 Plan-and-Execute 两种。Harness 是把前四者串起来的躯干,管循环、权限、上下文压缩和错误恢复,它不做思考,但没有它其余组件只是散装零件。
完整答案:阅读全文《Agent 核心组件》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
🟢 基础 | → PaiCLI | 字节、阿里
7. 到底什么是 ReAct?和 CoT 有什么区别?
CoT 是让 LLM 一步步推理再给答案,全程在脑子里完成,不查任何外部数据,所以它记得的数据可能过时或编造,自己不知道。ReAct 全称 Reasoning + Acting,由姚顺雨作为第一作者和 Google 联合提出,核心是 Thought、Action、Observation 三步循环,每一步推理都有真实数据兜底。CoT 是闭卷考试,ReAct 是开卷考试。ReAct 里每个 Thought 本身就是 CoT,两者是组合关系。
完整答案:阅读全文《什么是 ReAct》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
🟡 进阶 | → PaiCLI | 淘天、腾讯、字节、百度
3. Workflow 和 Agent 有什么区别?
Workflow 和 Agent 的核心区别只有一个问题,谁控制流程。Workflow 由开发者提前定好流程,LLM 在节点里干活但不决定下一步往哪走,Agent 则由 LLM 自己决定下一步干什么、调什么工具、什么时候停。判断方法是任务开始前能不能画出完整流程图,能画出来就用 Workflow。Dify 的可视化画布和 Claude Code 里编排多个 Sub-agent,控制权都在开发者手里。步骤无法提前确定的才交给 Agent。
完整答案:阅读全文《Workflow 与 Agent》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
🟢 基础 | → PaiCLI(Agent)
2. Agent 和 ChatBot 最大的区别是什么?
可以按一次任务闭环来回答:先理解用户目标并做规划(Planning),再维护上下文和长期记忆(Memory),按需选择外部工具(Tool Use),执行行动并根据观察结果继续迭代(Action/Observation)。
落到 PaiCLI,就是 Plan-and-Execute 负责任务拆解,Memory 管理上下文和长期信息,MCP 接入外部工具,ReAct 循环把工具结果反馈回来继续决策。
完整答案:阅读全文《Agent 与 ChatBot》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
🟢 基础 | → PaiCLI | 字节、阿里云
1. 什么是 Agent?和直接调大模型 API 有什么本质区别?
Agent 不是加了 system prompt 的大模型调用,而是 Model 加 Harness。直接调 API 是一问一答,下一步由业务代码写死,每次调用相互独立。Agent 的核心是一个 ReAct 循环,LLM 决定下一步做什么并返回 tool_calls,Harness 执行工具、把真实结果喂回模型,并维护任务状态。所以本质区别不在有没有 prompt,而在有没有这个决策循环,RAG 每一步都写死,因此不算 Agent。
完整答案:阅读全文《什么是 Agent》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
🟢 基础 | → PaiCLI | 字节、腾讯、阿里
10. Multi-Agent 协作是怎么实现的?
没有协调机制的 Multi-Agent 只会互相打架。生产环境最主流的是编排器(Orchestrator)模式,一个主 Agent 拆任务、派活、收结果。编排器先调 LLM 把需求拆成子任务,再按子 Agent 的角色描述做语义匹配分配,每个子 Agent 在独立的上下文窗口里执行,彼此不直接通信,全部通过编排器中转,最后返回结构化 JSON 由编排器综合。跨领域知识单个 context 装不下才上 Multi-Agent。
完整答案:阅读全文《Multi-Agent 协作》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
🟡 进阶 | → PaiCLI | 字节、阿里云、蚂蚁、小红书
9. 什么是 Plan-and-Execute?
Plan-and-Execute 的核心是把规划和执行分开。Planner 先生成任务清单;Executor 逐项执行,每个任务仍可能多轮调用模型和工具;需要调整计划时,规划器还会再次请求模型。规划器和执行器可以使用不同模型来控制费用,但这不保证总 Token 或调用次数少于 ReAct。PaiCLI 当前的规划器和执行器使用同一个 LlmClient。
完整答案:阅读全文《Plan-and-Execute》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
🟡 进阶 | → PaiCLI | 淘天、腾讯
8. ReAct 会死循环吗?
ReAct 真的会死循环,因为 Thought、Action、Observation 循环什么时候停,取决于 LLM 的判断。有三种情况,一是重复调用,ReAct 没有原生的去重机制。二是上下文混乱,LLM 对长上下文的注意力分布是 U 型的,中间的内容会被遗忘。三是错误重试,工具报错后用同样的方式重试,直到耗尽 Token。生产环境靠三道防线兜底,硬性迭代上限,LangChain 默认最多跑 15 轮。循环检测,同样的调用指纹连续出现 3 次就判定卡死。还有上下文压缩。
完整答案:阅读全文《ReAct 死循环》 · 飞书版
抖音视频:观看本集视频
B站视频:观看本集视频
6. Agent 怎么知道该调用哪个工具?
NEW 新增题目
Agent 本身不做工具选择,选择权在 LLM 手里。ToolRegistry 把所有工具注册成一张列表,每个工具带名称、描述和参数的 JSON Schema。Agent 把对话历史和全量工具定义塞进 LLM 接口的 tools 字段,模型自己读描述判断调哪个、参数填什么,并返回 tool_calls 数组,这就是 Function Calling 协议。LLM 返回不存在的工具名时,ToolRegistry 兜底报错让模型修正。
完整答案:阅读全文《Agent 如何选工具》 · B站视频 · 飞书版
抖音视频:观看本集视频
28. Human-in-the-loop 怎么设计?
NEW 新增题目
按操作的风险和可逆性决定在哪里设审批点。只读操作自动执行,可回滚的写操作事后通知,不可逆或者涉及资金、权限、对外发送的操作必须事前审批。审批不能只问一句“是否继续”,要展示将要执行的具体参数和影响范围,比如完整的命令、要修改的文件 diff、订单金额。降低人工成本靠两点,一是记住授权,同一类操作在会话内批准过就不再重复询问;二是把规则前置,能用规则判定安全的就不打扰人。实现上 Agent 在审批点挂起并保存 Checkpoint,等人的决定回来再恢复执行,人也要能随时中断。要求全流程自动化的场景,就用沙箱、权限白名单和事后审计代替事前审批。
🟡 进阶 | → PaiCLI / PaiAgent
29. Agent 的幻觉怎么治理?
NEW 新增题目
Agent 的幻觉比模型的幻觉危害更大,因为它会依据幻觉去执行动作,比如调用不存在的工具、编造参数、声称测试已经通过。治理的核心是让每个结论都有来自环境的证据。调用前用 Schema 校验工具名和参数,调用后以工具的真实返回为准;最终回答要引用工具结果或检索片段的出处,没有出处的结论不输出;关键结论交给独立的 Critic,或者用测试、查询去验证,不让同一个 Agent 审查自己。多 Agent 场景下,下游会把上游的幻觉当成事实继续推理,所以 Agent 之间传递结论时要带上证据。涉及资损的操作,最后一步必须由确定性代码校验。
🟡 进阶 | → PaiCLI / PaiAgent
30. Tool 的设计原则是什么?
NEW 新增题目
按 Agent 要完成的任务来设计工具,而不是把后端接口一对一暴露出去。Anthropic 在 2025 年 9 月的《Writing effective tools for agents》里举过例子,与其提供 list_users、list_events、create_event 三个工具,不如提供一个 schedule_event。参数尽量少且类型明确,能用枚举就不用自由文本。描述写清什么时候用、什么时候不用,以及和相似工具的区别。返回结果只给高信息量的字段,过长就分页或截断,Claude Code 默认把工具返回限制在 25000 个 Token 以内。错误信息要告诉模型下一步怎么改,而不是只给一个错误码。权限不能交给模型判断,参数合法但业务非法的请求,比如查询别人的订单,由工具根据当前登录用户在内部校验。
🟢 基础 | → PaiCLI
32. 用户需求模糊时 Agent 怎么澄清?
NEW 新增题目
先判断缺的信息会不会改变执行结果。缺的是关键参数,比如订机票不知道日期、改代码不知道改哪个模块,必须反问;有合理默认值,或者能用工具自己查到的,就不要打扰用户,先读代码库找到相关文件,再带着具体选项去问。反问要一次问全,并给出选项,不要一轮只问一个问题。实现上把“向用户提问”也做成一个工具,模型调用它时 Agent Loop 挂起,用户回答后作为工具结果返回,Claude Code 的 AskUserQuestion 就是这样实现的。没法反问的后台任务,就把自己做出的假设写进输出,让用户事后确认。
🟢 基础 | → PaiCLI
33. Agent 执行跑偏怎么拉回来?
NEW 新增题目
跑偏通常有三个原因,目标在长上下文里被稀释,工具结果误导了判断,以及反复尝试同一种失败的方法。拉回来靠三件事。一是让目标一直可见,把任务目标和计划写成 todo list 或计划文件,每一步都能看到,上下文压缩时也保留。二是检测偏离,比如连续多次用相同参数调用同一个工具,或者多轮没有产生新进展,就判定为路径震荡,强制模型停下来反思或换一种方法。三是分阶段验证,长任务按阶段拆分,每个阶段用测试或检查结果确认后再进入下一阶段,出了问题从最近的 Checkpoint 回滚,而不是从头重跑。跑一整天的任务,还要设置总步数和 Token 预算的上限。
🟡 进阶 | → PaiCLI
34. 多个 Agent 同时改一个文件怎么办?
NEW 新增题目
最好从设计上避免。拆分任务时按文件或模块划分边界,让每个 Agent 负责不同的文件。必须并行开发同一个仓库时,用 Git Worktree 给每个 Agent 一个独立的工作目录和分支,互不干扰,最后像合并人写的代码一样合并,冲突交给主 Agent 或人来解决,Claude Code 和 Codex 的并行任务都采用了这种隔离方式。同一个进程里并发写同一个文件,就按文件加锁串行执行,Pi 的 file-mutation-queue 按文件的真实路径排队,不同文件之间仍然并行。写入前还要检查文件在上次读取之后有没有被改过,被改过就重新读取,Claude Code 的 Edit 工具遇到这种情况会直接拒绝写入。
🔴 深入 | → PaiCLI
35. 权限模式(Permission Mode)是什么?
NEW 新增题目
权限模式决定 Agent 执行动作之前要不要先问人。它和沙箱是一对,沙箱限制 Agent 能碰到什么,权限模式决定碰之前要不要审批。Claude Code 有六种模式,default 只有读操作不询问;acceptEdits 自动放行文件编辑和 mkdir、mv 这类常见文件命令;plan 只读分析、不改文件;auto 由另一个模型作为分类器在后台审查每个动作;dontAsk 只允许预先批准的工具,其余一律拒绝,适合 CI;bypassPermissions 全部放行,只应该在隔离的容器或虚拟机里使用。从 v2.1.283 开始,auto 成为终端和 VS Code 交互会话的默认模式。Codex 把这件事拆成两个独立的配置,审批策略有 untrusted、on-request、never 等,沙箱模式有 read-only、workspace-write、danger-full-access。模式只是基线,deny 规则在任何模式下都生效,包括 bypassPermissions。
🟡 进阶 | → Claude Code / Codex / PaiCLI
36. Agent 执行过程中,用户插话怎么处理?
NEW 新增题目
这种做法叫 Steering。不能直接打断当前这一步,也不能等整个任务结束再处理,而是先把用户的新消息放进队列,等当前这一轮模型输出和工具调用完成后再注入上下文,模型在下一轮就能看到并调整方向。之所以不立刻插入,是因为模型 API 要求每个工具调用后面紧跟对应的结果,半路塞进一条用户消息会破坏消息顺序。Pi 把这件事拆成两个队列,steer 在当前这一轮结束后注入,followUp 等 Agent 本来要停下时才执行,适合“做完这个再做那个”。和取消的区别在于,插话保留已有进展,只修正方向。
🟡 进阶 | → PaiCLI
37. Agent 的 Todo List 有什么用?
NEW 新增题目
让模型把任务拆成一张清单,边做边更新状态。它解决两个问题。一是长任务里目标容易被越来越长的上下文稀释,Manus 在 2025 年 7 月的《Context Engineering for AI Agents》里提到,他们让 Agent 不断重写 todo.md,把目标复述到上下文的末尾,模型的注意力就不容易偏离。二是让人看得到进度,能在跑偏之前纠正。Claude Code 早期用 TodoWrite 一次覆写整张清单,现在默认换成了 TaskCreate、TaskUpdate、TaskList 这组工具,可以单独更新某一项的状态和依赖。Codex 用 update_plan,并在提示词里说明它只是进度清单,不代表进入 Plan 模式。Pi 则选择不内置,作者认为内置的 todo 会让模型困惑,建议直接写一个 TODO.md 文件。
🟢 基础 | → Claude Code / Codex / PaiCLI
38. Durable Execution 和 Checkpoint 有什么区别?
NEW 新增题目
Checkpoint 是存档,Durable Execution(持久化执行)是一种执行语义,保证任务在进程崩溃、机器重启之后从中断的地方继续,已经完成的步骤不再重复执行。实现上通常记录每一步的输入和输出,恢复时按记录重放,遇到已完成的步骤直接取记录里的结果。LangGraph 的恢复不是从中断的那一行代码继续,而是从最近的检查点开始重放后面的步骤,所以官方要求把 API 调用、写文件这类有副作用的操作包进 task,重放时直接读取持久化的结果。Temporal、Inngest 走的是同一条路,Temporal 要求工作流代码是确定性的,副作用全部放进 Activity。对 Agent 来说,最危险的是重放时重复扣款、重复发消息,所以 Durable Execution 不能替代幂等设计。
🔴 深入 | → PaiAgent
39. Handoff 和把 Agent 当作工具调用有什么区别?
NEW 新增题目
这是两种多 Agent 协作方式。Handoff 是移交控制权,当前 Agent 把对话整个交给另一个 Agent,由它直接和用户继续交互;Agent as Tool 是调用,主 Agent 把另一个 Agent 当成一个函数,传入结构化参数,拿回结果后自己继续。OpenAI Agents SDK 把 Handoff 也暴露成工具,移交给退款 Agent 就对应一个叫 transfer_to_refund_agent 的工具,由模型决定什么时候调用;还可以用 input_filter 过滤接收方能看到的历史,比如去掉之前所有的工具调用记录。客服场景里,前台把用户分流给退款、改签这类专员,适合 Handoff;需要汇总多个专家的意见再统一回答,适合 Agent as Tool,因为控制权始终在主 Agent 手里。
🟡 进阶 | → PaiAgent
40. Agent 的凭证怎么管理?
NEW 新增题目
原则是密钥不进上下文,也不进 Agent 能读到的环境。放进提示词的密钥可能被提示词注入套出来,放进环境变量的密钥,Agent 执行一句 env 或者读一下 .env 文件就拿到了。常见做法是凭证代理,Agent 在沙箱里发出的请求不带真实凭证,请求离开沙箱时,由宿主机上的代理注入真实凭证,Agent 自始至终拿不到真正的 Key。Pi 的容器化文档里,Docker Sandboxes 方案就是这样,真实的 Provider 凭证留在宿主机,由代理替换,文档还特意提醒不要在沙箱里执行登录,因为那会把真实凭证写进沙箱。代表用户访问第三方服务时,用 OAuth 换取短期、最小权限的令牌,而不是使用用户的密码或长期 Key,所有使用记录都要进审计日志。
🟡 进阶 | → PaiCLI
41. 什么是 Agent 的 Headless 模式?
NEW 新增题目
不开交互界面,把 Agent 当成一个命令或一个库来调用,用在 CI、定时任务和自己的业务系统里。Claude Code 用 claude -p 执行一次任务后退出,配合 --output-format json 或 stream-json 输出结构化结果;Codex 对应的是 codex exec;Pi 除了交互模式,还有 print、JSON 和 RPC 三种模式,并提供 TypeScript SDK,官方文档强调所有界面共用同一套 Agent 和会话机制。Headless 的难点在于没有人可以审批,所以要提前把权限定死,比如 Claude Code 的 dontAsk 模式只放行预先批准的工具,其余一律拒绝;还要给任务设置步数、时间和成本的上限。需要嵌入得更深,就用 Claude Agent SDK 这类 SDK,在代码里直接拿到每一步的事件。
🟢 基础 | → Claude Code / Codex / PaiCLI
42. Agent Framework、Runtime、Harness 有什么区别?
NEW 新增题目
LangChain 在 2025 年 10 月的博客《Agent Frameworks, Runtimes, and Harnesses- oh my!》里给过一个划分,LangChain 是 Framework,LangGraph 是 Runtime,DeepAgents 是 Harness。Framework 提供抽象,帮你更快地写出一个 Agent,比如 OpenAI Agents SDK、Vercel AI SDK、CrewAI。Runtime 在更底层,负责让 Agent 可靠地运行,提供 Durable Execution、流式输出、人工介入这些基础设施,Temporal、Inngest 也在这一层。Harness 在最上层,开箱即用,自带默认提示词、工具调用处理、规划工具和文件系统访问,Claude Code 就是典型。三者的边界并不绝对,LangGraph 既是 Runtime,也能当 Framework 用。一句话区分,Framework 管怎么写,Runtime 管怎么跑,Harness 管模型跑起来之后能看到什么、能做什么。
🟡 进阶 | → PaiAgent / PaiCLI
43. Computer Use 是什么?说说它的原理
🟡 中等 | AI / 大模型 | → PaiAgent / PaiCLI
02、上下文与记忆(22 题)
聚焦上下文窗口、Context Engineering、短期记忆、长期记忆、压缩、检索与会话隔离。
52. Agent 的长期记忆怎么实现?
NEW 新增题目
短期记忆是内存,退出 Codex 或 Claude Code 就清空。长期记忆是磁盘,存成文件,下次打开 Agent 会自动加载进上下文。实现分四步,提取是从对话里识别关键信息,存储是写到磁盘,Claude Code 存成 Markdown 文件,检索是新开对话时找出相关记忆,这一步最难,注入是把记忆塞进系统指令。记忆存多了靠记忆反思更新过时、合并重复、修正矛盾。项目规则建议主动写进 CLAUDE.md 或 AGENTS.md。
完整答案:阅读全文《Agent 长期记忆》 · B站视频 · 飞书版
抖音视频:观看本集视频
48. 为什么聊着聊着 Agent 就变笨了?
NEW 新增题目
Agent 变傻不是 bug,是压缩带来的信息损耗。短期记忆靠重发聊天记录实现,记录越长注意力越分散,这叫 Context Rot。窗口快满时会自动把旧记录压成摘要,但压缩有损,Claude Code 会丢掉工具返回的长结果,Codex 连文件内容都可能丢,压得越多丢得越多。少忘事有三条办法,一个线程只干一件事,用 /compact 主动压缩并说明保留什么,重要规则写进 CLAUDE.md 或 AGENTS.md,系统指令不会被压缩。
完整答案:阅读全文《Agent 为什么变笨》 · B站视频 · 飞书版
抖音视频:观看本集视频
51. Agent 的短期记忆怎么实现?
NEW 新增题目
Agent 的短期记忆就是 messages 数组。LLM 无状态,Agent 按顺序存下 system、user、assistant、tool 四种角色的消息,每次调 API 全量发给模型,模型才“知道”前面说过什么。上下文窗口有上限,而且模型对中间内容关注度低。窗口不够用有三种策略,滑动窗口只保留最近 N 轮,摘要压缩用 LLM 把早期对话压成摘要,混合策略旧消息压缩、近期留原文,生产环境最常用。短对话选滑动窗口,长对话选混合策略。
完整答案:阅读全文《Agent 短期记忆》 · B站视频 · 飞书版
抖音视频:观看本集视频
50. 怎么让 Agent 拥有记忆?
NEW 新增题目
LLM 无状态,把上下文窗口开大只能得到临时的短期记忆,新开窗口就消失,Agent 的记忆要在工程层面维护短期记忆和长期记忆。短期记忆解决一次对话内的问题,靠滑动窗口只保留最近 N 轮,或者用 LLM 把早期对话压缩成摘要塞回窗口。长期记忆解决跨对话的问题,分提取、存储、检索、注入四步,把关键信息写进外部文件或数据库,下次新开对话检索出来注入 system prompt。记忆存多了过时了,靠记忆反思更新过时信息、合并重复、修正矛盾。
完整答案:阅读全文《让 Agent 拥有记忆》 · B站视频 · 飞书版
抖音视频:观看本集视频
45. Agent 的上下文窗口是什么?
NEW 新增题目
上下文窗口是 LLM 一次能看到的全部文本容量,计量单位是 token 而不是字数。窗口装的不只是聊天记录,system prompt、工具定义、历史对话、当前输入和模型回复五样东西共用一个窗口。就像考试的草稿纸,写满了只能擦掉最早的内容腾地方,所以 Agent 聊到后面会忘事,不是不聪明,是内容被挤出了窗口。窗口也不是越大越好,越大越慢越贵,加上 Lost in the Middle 的 U 型记忆,关键信息要放在开头或结尾。
完整答案:阅读全文《什么是上下文窗口》 · B站视频 · 飞书版
抖音视频:观看本集视频
49. 为什么说 LLM 本身没有记忆?
NEW 新增题目
LLM 是无状态的,每一次请求都是独立的,前后两次对话之间模型不保留任何信息。模型“知道”的东西来自两处。参数记忆是训练阶段压缩进权重的知识,训练结束权重冻结,知识停在训练截止日期。上下文记忆是系统每次把之前所有聊天记录全部打包发给模型,让模型从头读一遍。所以 ChatGPT 记得上一轮的话,不是模型记住了,是系统帮它复习了一遍。记忆功能也只是把关键信息存进外部数据库再注入 system prompt,记忆在模型外面。
完整答案:阅读全文《LLM 为什么没记忆》 · 飞书版
抖音视频:观看本集视频
44. 什么是上下文工程(Context Engineering)?
NEW 新增题目
Prompt Engineering 只管写好一句提示词,上下文工程要让 LLM 在正确的时间以正确的格式拿到正确的信息和工具。按卡帕西的类比,LLM 是 CPU,上下文窗口是内存,开发者是决定加载什么数据的操作系统。上下文包含 System Prompt、用户输入、历史记录、长期记忆、RAG、工具定义和结构化输出七大组件,每次请求动态组装。Agent 的差距不在模型能力而在信息供给,但上下文并非越多越好,否则会中毒、干扰、混淆、冲突。
完整答案:阅读全文《上下文工程》 · B站视频 · 飞书版
抖音视频:观看本集视频
46. 为什么 LLM 的上下文窗口不能无限大?
NEW 新增题目
窗口不能无限大,限制远不止显存。Self-Attention 要每个 token 和所有 token 做点积,复杂度 O(n²),128K 扩到 1M 计算量暴增 61 倍。推理时还要缓存 KV Cache,70B 模型在 1M tokens 下就要 310GB。Lost in the Middle 更证明文档放中间准确率暴跌。百万 token 靠压缩存储、稀疏注意力、多卡分工和 RAG 做到,核心是让每个 token 都值得。
完整答案:阅读全文《上下文为何有限》 · B站视频 · 飞书版
抖音视频:观看本集视频
47. Agent 怎么避免上下文爆炸?
NEW 新增题目
避免上下文爆炸的核心不是删旧对话,而是在不丢关键信息的前提下控制长度。窗口大小固定且 LLM 注意力呈 U 型分布,Agent 每一轮 ReAct 循环都往窗口里追加内容,读日志、读源码、跑测试几轮就撑爆。解法四招,工具输出只留摘要和指向原始数据的指针,旧对话做语义摘要,复杂任务交给 Sub-agent 在全新窗口干完只返回结论,工具和 Skill 按需加载。压缩太狠会丢关键信息,上下文占到 60% 到 75% 时就该手动压缩。
完整答案:阅读全文《避免上下文爆炸》 · B站视频 · 飞书版
抖音视频:观看本集视频
53. 为什么不能在系统提示词里放时间戳?
NEW 新增题目
因为 Prompt Cache 只认 token 前缀。时间戳让每次请求从那个位置开始都不一样,之后的 KV 状态全部要重算,而系统提示词在最前面,等于几乎整段前缀都失效。书里的案例是首 token 延迟从 0.5 秒涨到 3 到 5 秒,月账单接近翻倍。三条铁律,系统提示词和工具定义定下来就不改,动态信息追加到末尾,使用标准 API 消息格式不要自己拼字符串。
🟡 进阶 | → PaiCLI
54. 滑动窗口对话历史有什么问题?
NEW 新增题目
两个问题。一是每次丢掉最早的消息都会改变前缀,KV Cache 失效。二是会丢关键的工具调用结果,第 2 轮读到的文件内容到第 15 轮已经滑出窗口,模型只能靠猜,实验里的 Agent 经常因此陷入循环,反复执行同一个工具调用。正确做法是压缩工具结果而不是截断历史,或者把大体积任务交给子 Agent 隔离。
🟡 进阶 | → PaiCLI
55. 什么是 Agent 状态栏?
NEW 新增题目
状态栏是 Harness 在上下文末尾持续注入的结构化状态摘要,比如已经调了几次工具、TODO 还剩几项、当前工作目录。它有效的原因是上下文学习更像检索而不是推理,模型擅长从上下文里查东西,不擅长把散落的记录归纳成结论,让它数自己打了几次电话很容易数错。把算好的结论直接写在末尾,模型瞥一眼就能用。注意状态栏要用代码维护,模型几乎无条件相信状态栏的内容。
🔴 深入 | → PaiCLI
56. 上下文压缩会不会和 KV Cache 冲突?
NEW 新增题目
看似冲突,其实互补。压缩不在单次调用里改上下文,而是在两次 API 调用之间由 Harness 预处理消息列表。系统提示词和工具定义永远不动,压缩的对象是历史里的工具结果,替换点之后的缓存会失效,之前的仍然有效。所以压缩频次要权衡,最好在接近阈值时批量压,不要每轮都压。
🔴 深入 | → PaiCLI
57. 为什么说隔离优于压缩?
NEW 新增题目
压缩是信息进了上下文之后做减法,有损,还要额外一次 LLM 调用。隔离是让大体积的中间信息根本不进主上下文,把「在代码库里大范围搜索」这类任务交给子 Agent,它在自己的上下文里探索,只把几百 token 的结论回传。主 Agent 的 KV Cache 前缀完全不受影响。代价是子 Agent 看不到主 Agent 的完整上下文,任务描述必须自包含。
🟡 进阶 | → PaiCLI
58. 用户记忆有哪几种存储格式?
NEW 新增题目
四种,粒度和结构递进。Simple Notes 每条一个最小事实,开销最低但信息关联丢失。Enhanced Notes 保存带上下文的完整段落,语义完整但冗余、难更新。JSON Cards 三层嵌套分类,支持局部更新,但多维信息被迫归入单一类别。Advanced JSON Cards 再加上来源背景、主体身份、关系和时间戳,能区分「我的张医生」和「我父亲的张医生」。实践里关键且少量的信息用 Advanced JSON Cards,大量非关键的对话事实用 Simple Notes。
🟡 进阶 | → PaiCLI
59. 用户前后给了矛盾的信息,记忆系统怎么处理?
NEW 新增题目
不要简单地以后来的为准。先看两条信息是不是同一个主体,「家庭住址」可能一条是自己的一条是父母的,靠记忆卡片里的主体和关系字段区分。确实是同一主体的更新,则按时间戳判断新旧,旧值保留来源以便回溯。对话块索引时带上时间、人物和意图的前缀,Agent 才有依据判断哪条指令最终有效。
🔴 深入 | → PaiCLI
60. Agent 记忆压缩通常有哪些方法?
主流三种:摘要压缩(把 10 轮对话压成一段摘要)、实体提取(只保留关键实体和关系)、向量化存储(记忆转向量,按相似度召回)。
🟡 进阶 | → PaiCLI | 腾讯
61. 长期记忆的 FIFO 淘汰有什么问题?怎么优化?
FIFO 最大的坑是把重要但不常用的记忆淘汰掉了。
🔴 深入 | → PaiCLI | 腾讯
62. 长上下文压缩有哪些方案?
主流方案有三种:对话摘要(把历史对话压缩成一段摘要)、关键信息提取(只保留重要的事实和决策)、滑动窗口(只保留最近 N 轮)。PaiCLI 支持 1M token 窗口的模型,同时配合动态压缩策略,在窗口快满时自动触发压缩。
🟡 进阶 | → PaiCLI 动态压缩 + 1M token 窗口 | 快手、淘天、拼多多、腾讯
63. 同一个用户在私聊和群组里和 Agent 对话,应该共享会话还是隔离?OpenClaw 是怎么设计会话隔离粒度的?
🟡 中等 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
64. Agent 的短期记忆和长期记忆分别怎么实现?
REVIEW 疑似重复 · 待确认:与「怎么让 Agent 拥有记忆?」等 3 道已更新记忆题内容重合
短期记忆就是当前对话上下文,长期记忆需要持久化存储跨会话的事实。🟡 进阶 | → PaiCLI | 淘天、快手
65. LLaMA 模型中,输入句子的长度理论上是否可以无限长?
REVIEW 疑似重复 · 待确认:与「为什么 LLM 的上下文窗口不能无限大?」内容重合
🔴 困难 | `自然语言处理(NLP) / 大语言模型` | → PaiCLI / PaiAgent 大模型应用基础03、Harness 与 Skills(42 题)
聚焦模型之外保障 Agent 稳定运行的工程系统,包括循环、Skills、评测、安全、权限、可观测性、成本、容错和发布。
67. 什么是 Loop Engineering?
NEW 新增题目
ReAct 是 Agent 的内循环,推理、行动、观察、重复。Loop Engineering 是外循环,像 crontab 一样调度,让 Agent 按预设节奏无人值守工作。Claude Code 有两种实现,/goal 设定完成条件,独立评估器每轮检查,满足就停,适合一次性任务;/loop 设定时间间隔重复执行,不自动停,适合持续巡检,但很烧 Token。Harness 管单条指令执行安全,Loop 管你睡觉后 Agent 还在跑。
完整答案:阅读全文《Loop Engineering》 · B站视频 · 飞书版
抖音视频:观看本集视频
66. 什么是 Harness Engineering?
NEW 新增题目
提示词工程管“怎么说”,上下文工程管“知道什么”,Harness Engineering 管“能做什么、不能做什么”,即 Agent 的运行时环境和安全边界。Harness 有四个核心组件,验证循环让 Agent 写完代码先跑测试再修复,错误恢复处理调错工具和死循环,权限控制让危险操作经人工确认,状态管理让 Agent 挂了能从断点恢复。Agent = 模型 + Harness,模型只管思考和生成,Harness 管剩下的所有事。
完整答案:阅读全文《Harness Engineering》 · B站视频 · 飞书版
抖音视频:观看本集视频
68. Agent 挂了几十个 Skill,怎么保证命中率?
NEW 新增题目
Skill 的选择不走路由,走 LLM 语义匹配。Agent 启动时把所有 description 注入 system prompt,LLM 自己判断触发哪个,命中率全看 description 怎么写。所以要写具体场景和触发关键词,一个 Skill 只干一件事,语义重叠的 Skill 要么合并要么划清边界,只该由斜杠命令触发的设 disable-model-invocation 防误触。数量膨胀就分组做两阶段匹配,别盲目堆。
完整答案:阅读全文《Skill 命中率》 · B站视频 · 飞书版
抖音视频:观看本集视频
69. Skill 正文是怎么进入上下文的?
NEW 新增题目
规范只规定加载时序,目录先于正文可见,正文被选中后按需加载,消息角色由 Harness 决定。Claude Code 里两条路径落点相同,正文都作为 user message 追加在调用位置。用户输入斜杠命令时客户端在本地展开,轨迹里没有工具调用;模型读目录后自己判断需要,则调用 Skill 工具,多一次 ReAct 往返,返回的 tool result 只是一句占位符。Codex 每轮重新渲染 Skills 目录作为 developer 片段,正文以带 skill 标记的 user 片段注入。
🔴 深入 | → PaiCLI
70. 一份可用的 Skill 应该包含哪几部分?
NEW 新增题目
参考宝玉《图解 Skill》的四部分。角色与读者,说明服务谁、面向什么任务、输出标准。核心原则,只留三到五条最重要的判断,配正例和反例。禁止清单,记录高频错误、越权动作和容易误解的表达,同时写清合法例外。参考资料,放术语表、模板、范文和子文档。规则尽量写成「作用域 + 动作 + 例外 + 验证方式」,不要堆成越来越长的禁用词表。
🟡 进阶 | → PaiCLI
71. 工具的风险等级怎么按参数动态判断?
NEW 新增题目
风险等级不能只绑在工具名上,要落到参数上。把判定写成确定性规则而不是交给模型,路径是否在项目目录内、是否命中系统路径或受保护文件、操作是否可逆、影响范围多大,命中高风险条件就升级到人工确认。判定必须由上下文之外的代码完成,否则会和被注入的 Agent 一起沦陷。
🔴 深入 | → PaiCLI
72. 需要人工确认但用户不在线,Agent 该怎么办?
NEW 新增题目
先区分触发原因,超过失败阈值和遇到高风险操作是两类。等待期间不能空转烧 token,应该把状态持久化后挂起,并把已完成的、待确认的和被阻塞的部分写清楚,用户回来能接上。可以先做不依赖答案的部分,涉及不可逆操作的一律不猜。指令模糊时给出自己的假设和选项,而不是反复追问。
🟡 进阶 | → PaiCLI
73. Pass@k 和 Pass^k 有什么区别?
NEW 新增题目
Pass@k 是同一任务跑 k 次至少一次通过,看的是能力上限,适合科研探索、漏洞挖掘、开放式创作这类挑一条最好轨迹就有价值的场景。Pass^k 是连续 k 次每次都通过,且不能触发安全、合规、幻觉的一票否决,看的是可靠性。单次成功率 0.6 时,Pass@5 约 99%,Pass^5 只有约 7.8%。支付、退款、权限变更、生产部署这类场景要看后者。评估报告必须写清 k 次的口径。
🔴 深入 | → PaiCLI
74. LLM-as-a-Judge 有什么已知偏差?
NEW 新增题目
最典型是长度偏差,倾向给更长更详尽的回复打高分,哪怕内容并不更正确。三种防范手段,在 Rubric 里显式惩罚冗长并规定长度上限,配对比较时先把两个候选的长度控制到相近,定期审计评分与长度的相关性。Rubric 本身要满足四条准则,基于专家指导、全面覆盖并写明陷阱、按重要性加权并支持一票否决、评价标准自包含可验证。
🟡 进阶 | → PaiCLI
75. Agent 的失败轨迹怎么做归因?
NEW 新增题目
归因对象是轨迹里首个导致任务偏离的错误,后续错误往往只是连锁反应。edit_file 匹配失败后连续三次重试,主因是工具调用错误,三次重试是后果而不是三个根因。归因记录要结构化,引用步骤号、工具名和观察证据。很多失败并不报错,比如 Agent 在第 8 步的思考里已经承认没拿到数据却继续推进,之后所有输入都基于编造的数据。根因还要分清是模型问题还是 Harness 问题,纯文本 Agent 读不了图片,该补的是观察通道,不是换模型。
🔴 深入 | → PaiCLI
76. 评估分差 3 个点,能据此切换模型吗?
NEW 新增题目
不能。100 个用例、成功率 70% 时,95% 置信区间约正负 9 个百分点,3 个点的差异在噪声之内。正确做法是配对分析,两个配置共享同一批任务和随机种子,逐题记录谁胜出,用 McNemar 检验或配对 bootstrap 判断。每个配置跑 3 到 5 个种子,报告均值和波动。预期收益只有两三个点而评估集只有几十题时,先扩大样本。
🔴 深入 | → PaiCLI
77. 多轮工具调用,怎么判断该继续调用还是该停?
两种策略:一是模型自己判断(返回的 finish_reason 不含 tool_calls 时停止),二是工程侧兜底(设最大迭代次数)。
🟡 进阶 | → PaiCLI | 淘天
78. Token 预算管理怎么做?
在模型调用前估算本次请求的 token 用量,如果超预算就先压缩上下文。PaiCLI 支持 Prompt Cache 可视化,让用户能看到每次请求的 token 消耗分布(系统提示词占了多少、历史对话占了多少、工具描述占了多少),方便针对性优化。
🟡 进阶 | → PaiCLI 动态预算 + Prompt Cache 可视化
79. 大模型部署有哪些主流方案?vLLM、TGI、llama.cpp 怎么选?
vLLM(PagedAttention,显存利用率高,适合高并发在线服务)、TGI(HuggingFace 出品,和 HF 生态集成好)、llama.cpp(C++ 实现,CPU/低端 GPU 也能跑)、SGLang(RadixAttention,适合复杂 Prompt 复用场景)。生产环境高并发首选 vLLM。
🟡 进阶
80. 有没有用过大模型网关框架?网关层解决了什么问题?
大模型网关(如 LiteLLM、OneAPI)统一管理多个模型提供商的 API 密钥、请求路由、限流、重试、负载均衡。PaiAgent 的 ChatClientFactory 其实就承担了部分网关职责,根据节点配置动态路由到不同的模型服务。生产环境建议上专门的网关。
🟡 进阶 | → PaiAgent ChatClientFactory 路由功能
81. Agent 系统从 demo 到生产级落地要走哪些流程?
需求定义 → 技术选型 → 原型验证 → 工具集成 → 评测体系搭建 → 安全审计 → 灰度发布 → 监控告警。PaiAgent 的完整落地历程就经历了这些阶段,从单节点 DAG 到 LangGraph4j 双引擎的演进过程本身就是很好的面试素材。
🟡 进阶 | → PaiAgent 从 DAG 到 LangGraph4j 的演进 | 万类智生、蚂蚁、字节、腾讯
82. Agent 的执行效果怎么评估?
三个维度:任务完成率(Agent 能不能把事干完)、回答质量(输出是否准确有用)、用户满意度(人工评分或隐式反馈)。PaiAgent 的执行记录会以成功/失败状态写入数据库,方便后续统计分析。量化指标能拿出来说的候选人凤毛麟角。
🔴 深入 | → PaiAgent 执行记录 + 状态追踪 | 数坤科技、字节
83. 大模型能力评测指标有哪些?
通用能力看 MMLU(多学科知识)、HumanEval(代码生成)、GSM8K(数学推理)。中文场景看 C-Eval、CMMLU。对话能力看 MT-Bench、Chatbot Arena ELO 排名。RAG 场景看 RAGAS。选型时不能只看一个榜,要结合自己场景做私有评测。
🟡 进阶
84. Agent 响应太慢怎么优化?
工程侧:工具调用并行化、缓存高频查询结果、流式输出减少用户等待感。基座侧:用更快的模型做初筛(比如 Haiku),复杂任务再调大模型。PaiAgent 的 TTS 模块就用了 CompletableFuture 做并行处理,多个音频片段同时生成。
🟡 进阶 | → PaiAgent CompletableFuture 并行 / PaiCLI 多模型切换
85. Agent 系统有哪些安全风险?怎么防范?
三大风险:Prompt Injection(恶意指令注入)、沙箱逃逸(Agent 执行了不该执行的系统命令)、越权操作(Agent 访问了不该访问的数据)。PaiCLI 的防范体系包括 HITL 人工审批、路径围栏、命令黑名单、结构化审计日志四道防线。
🔴 深入 | → PaiCLI 四道安全防线
86. Skill 预置知识包机制是什么?怎么设计的?
Skill 是把某个专业领域的最佳实践封装成结构化知识包,Agent 执行任务时自动加载对应 Skill 的指南和参考文档。PaiAgent 的 SkillRegistry 在应用启动时一次性加载所有 Skill 到 ConcurrentHashMap,支持全量注入和渐进式加载两种模式。PaiCLI 也有独立的 Skill 系统,还多了站点经验库的积累能力。
🟡 进阶 | → PaiAgent SkillRegistry / PaiCLI Skill + 站点经验
87. 多工具调度引擎怎么设计?工具之间有依赖怎么处理?
核心是拓扑排序。先分析工具之间的输入输出依赖关系,构建 DAG,然后按拓扑序执行。PaiAgent 的 GraphBuilder 就是干这事的,通过边的 source/target 关系构建执行图,没有入边的节点先执行。
🔴 深入 | → PaiAgent GraphBuilder 拓扑构建 | 字节、阿里云
88. Agent 流式输出怎么设计?怎么提升用户体验?
模型还在“想”的时候就开始给用户展示中间结果。PaiCLI 在 ReAct 循环中实时展示 Thought(“我在想...”)、Action(“正在调用 xxx 工具”)、Observation(“工具返回了...”),让用户看到 Agent 的思考过程而不是干等一个最终结果。
🟡 进阶 | → PaiCLI ReAct 过程可视化
89. Agent 系统的可观测性怎么做?需要监控哪些指标?
核心指标:请求成功率、平均响应时间、token 消耗量、工具调用成功率、模型 API 错误率。PaiAgent 的每次工作流执行都记录完整的执行日志(每个节点的输入输出、耗时、状态),出了问题能快速定位是哪个节点挂了。
🟡 进阶 | → PaiAgent 执行日志 + 节点级追踪
90. Agent 灰度发布怎么做?
不能一次性把新版 Agent 推给所有用户。常见做法是按用户 ID 或流量比例分桶,先让 5% 的用户用新版,观察一段时间(错误率、满意度)没问题再逐步扩大。PaiAgent 可以通过工作流配置实现 A/B 测试,同一个任务走两套不同的节点编排。
🟡 进阶 | → PaiAgent 工作流 A/B 配置
91. Agent 系统的成本怎么控制?
大模型 API 按 token 计费,成本失控是真实风险。控制手段:设用户级别的 token 配额、用小模型做初筛(PaiCLI 支持多模型切换)、Prompt Cache 减少重复计算、批量请求合并。派聪明就设了聊天消息每分钟 30 次的速率限制。
🟡 进阶 | → PaiCLI 多模型切换 / 派聪明速率限制
92. Agent 系统怎么做容错?单点故障怎么处理?
工具调用失败要有重试和降级策略,模型 API 挂了要能自动切换到备用模型,消息队列保证异步任务不丢。PaiAgent 的节点执行失败会把 status 设为 FAILED 并记录 errorMessage,上层可以根据失败类型决定重试还是跳过。
🟡 进阶 | → PaiAgent FAILED 状态 + 错误记录
93. 数据标注在 Agent 项目中有多重要?怎么做?
评测数据集需要人工标注“标准答案”,Prompt 优化需要标注“好回答 vs 坏回答”,微调需要高质量的指令-回答对。标注质量直接决定了模型效果的上限。可以用 AI 辅助标注(先让模型生成初版,人工校正),效率能提升 3-5 倍。
🟡 进阶
94. Agent 项目如何处理合规与用户隐私?
用户输入可能包含敏感信息(个人信息、商业机密),不能直接存储或发送给第三方模型。处理方式:输入脱敏、审计日志加密、模型 API 选择数据不出境的国内厂商、用户明确授权后才开启数据收集。派聪明的多租户隔离也是合规要求之一。
🟡 进阶 | → 派聪明多租户隔离
95. 你在 Agent 项目中遇到的最大技术挑战是什么?
开放题,但最能看出候选人的真实水平。建议准备 2-3 个真实案例:一个架构层面的(比如 PaiAgent 从 DAG 引擎迁移到 LangGraph4j 双引擎的决策过程),一个工程层面的(比如 PaiCLI 上下文爆炸的优化方案),一个业务层面的(比如派聪明多租户权限隔离的需求变更)。
🔴 深入 | → 三个项目各准备一个案例
96. 什么是护栏技术?
护栏是保障 Agent 行为安全可控的分层防线,按被绕过的难度分三层。上下文层管模型能看到什么,在内容进入上下文前拦截,相关性分类器、安全分类器、内容审核、基于规则的过滤都在这一层,但同一上下文里的 Agent 很难判断自己是否已被注入,所以这层只能降低攻击成功率。执行层管模型能做什么,核心是工具风险评级,高风险操作由上下文之外的机制复核,独立审查进程、最小权限凭证、沙盒、人在回路。数据层管世界最终能被改成什么样,行级安全策略、约束校验器、受控视图,即使注入得手,越权操作也在这层被拒绝。护栏还有误拒绝这类失败,评估时也要测明确允许的请求能否正常完成。 🟢 简单 | AI / 大模型 | → PaiAgent / PaiCLI
97. OpenClaw 的核心组件有哪些?请描述它们之间的关系
🟡 中等 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
98. 如果一个 Agent 系统要同时接入 Web、飞书、钉钉等渠道,你会怎么设计渠道抽象层?OpenClaw 的 Channel Plugin 接口是怎么设计的?
🟢 简单 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
99. 如何设计和管理 AI Agent 的 Skills 体系?在实际项目中有哪些挑战?
🟡 中等 | AI / 大模型 / Agent / Skills | → PaiAgent / PaiCLI
100. 同一个系统里可能有多个 Agent,不同渠道用户群组的消息需要路由到不同的 Agent。你会怎么设计这个路由?OpenClaw 的路由匹配优先级是怎样的?
🟡 中等 | AI / OpenClaw / 大模型应用开发 / Agent开发 / AI应用开发 | → PaiAgent / PaiCLI
101. 同一个工具(比如「执行命令」)在不同场景下应该有不同的权限。你会怎么设计工具的权限控制?OpenClaw 的工具策略管道是怎么分层的?
🟡 中等 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
102. Agent 系统中 Hook 中间件模式有什么用?能举几个典型场景吗?OpenClaw 的 Hook 系统是怎么设计的?
🟡 中等 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
103. 父 Agent spawn 子 Agent 时,有哪些边界问题需要考虑?OpenClaw 做了哪些限制和保护?
🟡 中等 | AI / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
104. OpenClaw 采用插件架构,第三方可以注册新渠道、工具、Hook。设计一个插件系统需要考虑哪些关键问题?OpenClaw 的插件 API 长什么样?
🟡 中等 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
105. OpenClaw 的 Gateway 对 Agent 请求做了幂等性处理。为什么 Agent 系统特别需要幂等性?工具已经产生副作用时怎么办?
🟡 中等 | AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发 | → PaiAgent / PaiCLI
106. 如果一个GPU集群的LLM处理能力为1000tokenss,那1000个用户同时并发访问,响应给每个用户的性能只有1 tokens吗?怎么分析性能瓶颈
🟡 中等 | 后端 / 场景题 / 大模型 | → PaiCLI / PaiAgent
107. 什么是 AI 编程中的自动修复循环(Auto-fix Loop)?它的工作流程和退出策略怎么设计?
🟢 简单 | AI Coding / 自动修复循环 / 退出策略 | → PaiCLI / PaiAgent
04、RAG知识库(43 题)
聚焦文档解析、分块、向量检索、混合搜索、Rerank、Agentic RAG、权限隔离与生产优化。
108. Agent 的 RAG 遇到 PDF 怎么办?
NEW 新增题目
PDF 是排版格式不是数据格式,纯文本抽取碰到扫描件、表格、图表就失效。解析先判断类型,电子 PDF 用 PyMuPDF、pdfplumber 拿文字和坐标,扫描件和复杂表格上 OCR 或多模态模型,表格转成 Markdown Table 或 JSON 单独存。分块按标题层级、段落、表格来分。Agent 场景把读上一页、查原始表格封装成 Tool,让 LLM 自己判断证据够不够。延迟靠入库时缓存解析结果,证据不足才让多模态模型精读。
完整答案:阅读全文《RAG 处理 PDF》 · B站视频 · 飞书版
抖音视频:观看本集视频
109. RAPTOR 和 GraphRAG 分别擅长什么查询?
NEW 新增题目
RAPTOR 自底向上递归聚类摘要,形成从细节到概括的树,适合「从概念逐步钻进细节」的查询。GraphRAG 把知识建模为实体关系图,强在多跳关系推理和实体消歧,适合「A 和 B 是什么关系」的查询。判断标准很简单,查询主要是「找到包含某信息的片段」,混合检索就够了;经常需要跨文档综合或多层次导航,才值得付出索引和查询时多次 LLM 调用的代价。
🔴 深入 | → 派聪明
110. 什么是知识库的文件系统范式?
NEW 新增题目
以火山引擎开源的 OpenViking 为代表,把记忆、资源、技能都映射成虚拟文件系统里的目录和文件,每个目录自动生成 L0 一句话摘要、L1 概览、L2 全文三层,大部分查询到 L1 就能决策。底层用 Markdown 纯文本,用户可以直接读和改,可以 Git 版本控制和回滚,Agent 也能自主写入。前提是文件之间必须建立链接和索引,像 Wikipedia 那样互相引用,否则知识越多越难检索。
🟡 进阶 | → 派聪明
111. 什么是上下文感知检索(Contextual Retrieval)?
NEW 新增题目
Anthropic 提出的做法,在向量化之前先用 LLM 给每个分块生成一段包含来源和背景的前缀,比如「本段节选自 ACME 公司 2025 年 Q2 财报的关键业绩指标章节」,再拼接索引。它同时增强稀疏检索和稠密检索,前缀给 BM25 补了可精确匹配的关键词,给向量补了语义背景。Anthropic 的数据是结合 BM25 可将检索失败率降低 49%,再结合重排序降幅达 67%。区别在于,上下文感知检索发生在索引期,对知识库分块做加法;上下文感知压缩发生在运行期,对对话历史做减法。
🟡 进阶 | → 派聪明
112. 为什么需要 RAG?直接把文档塞给大模型不行吗?
上下文窗口有限、塞太多 token 费钱又慢、模型对长文档的“注意力”分配不均匀(中间内容容易被忽略)。RAG 的核心价值是“先检索再生成”,只把最相关的片段喂给模型。
🟢 基础 | → 派聪明整体架构 | 字节、淘天
113. RAG 和微调怎么选?各自适合什么场景?
RAG 适合知识频繁更新、需要溯源的场景(客服、文档问答);微调适合需要改变模型行为风格、固定领域的场景(医疗、法律术语)。可以先微调让模型熟悉领域术语,再用 RAG 补充最新知识。
🟢 基础 | → 派聪明(RAG 路线)
114. 描述一下完整的 RAG 系统工作流程?
文档索引(解析→分块→向量化→入库)→ 查询处理(查询向量化→KNN 召回→关键词匹配与权限过滤→BM25 rescore)→ 生成(拼接检索结果 + 用户问题→LLM 生成→引用标注)。
🟢 基础 | → 派聪明完整实现 | 字节、快手
115. 文档分块策略怎么设计?chunk 大小怎么定?
🟡 进阶 | → 派聪明 ParseService | 快手、字节、Moka、阿里
116. 怎么规避语义被切割掉的问题?
三个手段:重叠切分(相邻 chunk 留重叠区)、按自然语义边界切分(段落、句号、标题)、递归切分(先按大结构切,不够再细分)。
🟡 进阶 | → 派聪明
117. Embedding 模型怎么选型?维度越高越好吗?
不是。维度高意味着存储成本高、检索速度慢。
🟡 进阶 | → 派聪明 Embedding 2048 维 | 快手、阿里
118. Embedding 有哪几种算法?各自的特点是什么?
Word2Vec(静态词向量,不考虑上下文)、BERT 类(双向编码,适合短文本语义匹配)、Sentence Transformers(专门做句子级别嵌入)、BGE/GTE 系列(中文优化,MTEB 榜单前列)。派聪明默认走阿里 text-embedding-v4,维度 2048,也预留了智谱 embedding-3 这类 OpenAI 兼容 Embedding Provider 的切换路径。
🟡 进阶 | → 派聪明选型依据
119. 向量数据库怎么选型?你们项目用的哪个?
主流选择:Milvus(大规模分布式)、Qdrant(Rust 高性能)、Weaviate(GraphQL 友好)、Elasticsearch(已有 ES 集群就直接用)、Chroma/FAISS(轻量原型验证)。派聪明选了 ES,因为团队本身就熟悉 ES 生态,不需要额外引入新组件。
🟡 进阶 | → 派聪明 ES 8.10 + dense_vector | 字节、快手
120. 向量检索和关键词检索的混合搜索怎么做?
派聪明的 HybridSearchService 先用 KNN 做向量召回,召回窗口是 topK×30;同时用 textContent match 做关键词约束,并叠加 userId、public、orgTag 权限过滤,最后通过 BM25 rescore 做第二阶段排序。纯向量搜索容易漏掉精确关键词,纯关键词又缺语义理解,混合搜索两头都兼顾了。
🟡 进阶 | → 派聪明 HybridSearchService KNN + BM25 | 快手、字节
121. 什么是 Query Rewrite?为什么需要改写用户查询?
用户提问偏口语化、模糊、有歧义。Query Rewrite 把用户原始问题改写成更适合检索的形式,比如补全指令、拆分意图、扩展同义词等。派聪明当前是查询向量化 + KNN/BM25 混合检索,Query Rewrite 可以作为检索增强点继续接入。
🟡 进阶 | → 派聪明可扩展 | 快手、阿里
122. 什么是多路召回?具体怎么做?
同一个查询走多条检索通道(向量召回、关键词召回、知识图谱召回),每条通道返回一批候选,最后合并去重排序。派聪明当前更准确地说是 KNN 召回叠加关键词约束和 BM25 rescore,不是完全独立的多路召回;后续可以扩展成向量、关键词、知识图谱等多路候选合并。多路召回的核心价值是降低单一路径漏召回的风险。
🟡 进阶 | → 派聪明 KNN + BM25 rescore,可扩展多路召回 | 快手、字节
123. 为什么检索之后还需要 Rerank?
向量检索是“粗筛”,召回量大但排序不够精准。Rerank 可以用交叉编码器对 query 和每个候选文档做精细打分,把最相关的排到前面。派聪明当前采用的是 KNN 召回后再用 BM25 rescore 做第二阶段排序,独立 Rerank 可以作为后续增强。
🟡 进阶 | → 派聪明 KNN 召回 + BM25 rescore | 快手
124. Rerank 的 Top-K 怎么确定?
没有银弹。一般先设一个较大的召回窗口,然后在测试集上逐步缩小,找到精度和延迟的平衡点。K 太大增加排序和上下文拼接成本,K 太小可能漏掉相关文档。派聪明现在的思路是 topK 放大召回窗口,再用 BM25 rescore 精确结果。
🟡 进阶 | → 派聪明召回窗口与 rescore 权重 | 快手
125. RAG 系统怎么评测?核心指标有哪些?
检索阶段看召回率(Recall)、精准率(Precision)、MRR(平均倒数排名)。生成阶段看忠实度(Faithfulness,答案是否基于检索到的内容)、相关性(Relevancy)。RAGAS 框架把这套评测体系标准化了。
🟡 进阶 | → 派聪明 RAG 评测指标 | 快手、Moka
126. 向量数据库里的历史文档怎么做时间衰减?
老文档的信息可能过时了,但向量相似度不会因为时间变化而降低。解决方案:给检索分数乘以一个时间衰减因子(比如指数衰减),或者在索引里加时间字段做过滤。
🟡 进阶 | → 派聪明 ES 元数据过滤可扩展 | 快手
127. 在什么场景下会用图数据库来增强向量检索?
当知识之间有复杂的关联关系时(比如“A 公司收购了 B 公司,B 公司的 CEO 是 C”),纯向量检索很难捕捉这种关系。图数据库(Neo4j、NebulaGraph)擅长处理实体关系查询,和向量检索配合可以回答“C 现在在哪家公司任职”这类需要推理的问题。
🔴 深入 | → 派聪明未来可扩展方向
128. Agentic RAG 和传统 RAG 的核心区别?
传统 RAG 是“检索→生成”的单次流水线。Agentic RAG 给 RAG 加了 Agent 能力,模型可以判断“这次检索结果不够好,换个关键词再搜一次”,或者“这个问题需要先查 A 再查 B 最后综合”。派聪明的 ReAct 循环和 AgentToolRegistry 里的 search_knowledge 工具,就是把知识库检索变成 Agent 可调用工具的实现。
🟡 进阶 | → 派聪明 ReAct + search_knowledge 工具
129. 处理长文档时怎么避免 OOM?
派聪明在 ParseService 里做了两个关键设计:一是流式分块处理,避免一次性把整个文档加载进内存;二是内存阈值保护,运行时内存占用超过 80% 会先触发 GC,复查后仍超阈值才拒绝继续处理。大文件场景下,这比单纯扩大 JVM 堆更稳。
🟡 进阶 | → 派聪明流式处理 + 内存阈值保护
130. RAG 知识库怎么实现动态更新?
文档更新后要同步更新向量索引。派聪明通过 Kafka 异步处理文件上传队列(默认 topic 为 file-processing-topic1),新文档上传后自动触发“解析→分块→向量化→入库”的完整流程,不需要手动重建索引。删除文档时同步清理对应的向量记录。
🟡 进阶 | → 派聪明 Kafka 异步更新
131. 多租户场景下 RAG 的权限隔离怎么做?
派聪明用了三层权限过滤:userId(用户私有文档)、orgTag(组织级隔离)、isPublic(公开标志)。检索时在 ES 查询里加 filter 条件,确保 A 公司的人搜不到 B 公司的文档。这道题在 ToB 方向的公司面试里高频出现。
🟡 进阶 | → 派聪明 userId + orgTag + isPublic 三层过滤
132. 在 RAG 应用中为了优化检索精度,其中的数据清洗和预处理怎么做?
🟡 中等 | AI / 大模型 / RAG | → 派聪明
133. 什么自查询?为什么在 RAG 中需要自查询?
🟢 简单 | AI / 大模型 / RAG | → 派聪明
134. 什么提示压缩?为什么在 RAG 中需要提示压缩?
🟢 简单 | AI / 大模型 / RAG | → 派聪明
135. 在 RAG 中,索引流程中的文档解析你们怎么做的?
🟡 中等 | AI / 大模型 / RAG | → 派聪明
136. 向量数据库中的 HNSW、LSH、PQ 分别是什么意思?
🟡 中等 | AI / 大模型 / RAG / 向量数据库 | → 派聪明
137. 向量数据库中的 ANN 是什么?为什么需要用它?
🟡 中等 | AI / 大模型 / RAG / 向量数据库 | → 派聪明
138. 向量数据库中,常见的向量搜索方法:余弦相似度、欧几里得距离和曼哈顿距离分别是什么?有什么区别?
🟡 中等 | AI / 大模型 / RAG / 向量数据库 | → 派聪明
139. 什么是 Advanced RAG?
🟡 中等 | AI / 大模型 / RAG | → 派聪明
140. 什么是 Modular RAG?
🟡 中等 | AI / 大模型 / RAG | → 派聪明
141. 什么是上下文查询增强?它有什么作用?如何基于 Spring AI 实现上下文查询增强来处理无关问题?
🟡 中等 | 后端 | → 派聪明
142. 什么是 Spring AI 提出的模块化 RAG 架构?预检索、检索和后检索阶段各自负责什么?
🟡 中等 | 后端 | → 派聪明
143. 你有多个知识库,做 RAG 的时候,怎么保证查询效率和准确性兼容,并尽可能减少幻觉?
🟡 中等 | AI / 大模型 / RAG | → 派聪明
144. 如何构建和使用向量索引?HNSW 和 IVF 有什么区别?
🟡 中等 | RAG / 向量索引 | → 派聪明
145. RAG 检索时相似度阈值如何设置?设置不当有什么影响?
🟡 中等 | RAG / 相似度阈值 | → 派聪明
146. RAG 系统如何利用元数据过滤提升检索精度?
🟡 中等 | RAG / 元数据过滤 | → 派聪明
147. 如何处理 RAG 检索不到相关文档的情况?
🟡 中等 | RAG / 检索失败处理 | → 派聪明
148. RAG 系统如何标注信息来源和提供引用?
🟡 中等 | RAG / 引用标注 | → 派聪明
149. RAG 系统在生产环境中如何优化性能和降低成本?
🔴 困难 | RAG / 性能优化 | → 派聪明
150. RAG 系统如何处理 PDF、Word、Markdown 等不同格式文档?
REVIEW 疑似重复 · 待确认:与「Agent 的 RAG 遇到 PDF 怎么办?」内容重合
🟡 中等 | `RAG / 文档处理` | → 派聪明05、LLM 基础与 API(82 题)
聚焦 NLP、Transformer、模型结构、推理机制、API、缓存、Token、结构化输出和模型服务。
155. DeepSeek 的 Prompt Caching 为什么能全自动生效,Claude 为什么要手动加 cache_control?
NEW 新增题目
DeepSeek 的提示词缓存不用改代码,后台自动缓存重复前缀,命中的输入每百万 Token 一毛五,未命中四块五。Claude 则要手动写 cache_control 字段。全自动的底气是上下文硬盘缓存,把算好的 KV Cache 从显存转到分布式硬盘阵列,配合 MLA 压缩,按请求结束、公共前缀、固定 Token 间隔三种时机落盘。命中要从第 0 个 Token 起逐字匹配,所以系统提示词放前面,动态内容放末尾。
完整答案:阅读全文《DeepSeek 与 Claude 的 Prompt Caching》 · B站视频 · 飞书版
抖音视频:观看本集视频
154. Prefix Caching(前缀缓存)是什么?和 KV Cache 是什么关系?
NEW 新增题目
传统推理里 KV Cache 是单次请求专用的,回答结束就被清空,下一个请求再相似也要从头算。Prefix Caching 把公共前缀对应的 KV 数据存进共享缓存池跨请求复用,命中后直接跳过 Prefill 阶段,首字延迟从几秒缩到几十毫秒。引擎把文本切成固定大小的 Token 块,按哈希组成 Radix Tree 前缀树来比对。命中要求从第一个 Token 起完全匹配,所以静态内容放开头,时间戳等动态变量放最后。
完整答案:阅读全文《什么是 Prefix Caching》 · B站视频 · 飞书版
抖音视频:观看本集视频
153. KV Cache 是什么?为什么只缓存 K 和 V,不缓存 Q?
NEW 新增题目
大模型自回归生成,每吐出一个新词都要回头看前面所有的词,没有缓存就得把历史从头重算。KV Cache 用空间换时间,把前面所有词的中间结果存进显存,每次只算新词。注意力里 Q 是当前这一轮的提问,算完就作废,而 K 和 V 在后面每个新词生成时都还要翻看,所以只缓存 K 和 V。代价是 KV Cache 随上下文长度和并发数增长,显存占用可能超过模型权重,所以 PagedAttention、GQA 和 MLA 都在压缩它。
完整答案:阅读全文《什么是 KV Cache》 · B站视频 · 飞书版
抖音视频:观看本集视频
157. 什么是线性注意力?GLM-5.3-Flash 为什么采用线性注意力加稀疏注意力的混合架构?
NEW 新增题目
标准注意力要算 Q 乘以 K 的转置这个 N×N 矩阵再做 softmax,计算量是 O(n²)。线性注意力去掉 softmax,利用矩阵连乘的结合律先算 K 的转置乘以 V 得到 d×d 的小矩阵,再用 Q 去乘,计算量降到 O(n)。代价是它推理时等价于 RNN,状态矩阵大小固定,序列开头容易被覆盖。GLM-5.3-Flash 大部分层用线性注意力管近处,每隔几层插一层稀疏注意力 DSA,只挑最相关的 Token 做远程检索。
完整答案:阅读全文《线性注意力与混合架构》 · B站视频 · 飞书版
抖音视频:观看本集视频
151. Responses API 和 Chat Completions API 有什么区别?
NEW 新增题目
Responses API 为 Agent 而生,Chat Completions 为聊天而生。Chat Completions 把所有内容塞进 message 数组靠 role 区分,每轮都要重发完整聊天记录。Responses API 把文本、推理、工具调用拆成独立类型,用 previous_response_id 让服务端存上下文,内置联网搜索、代码执行、文件检索。DeepSeek V4 Pro 支持后能直接接入 Codex。
完整答案:阅读全文《Responses API 对比》 · B站视频 · 飞书版
抖音视频:观看本集视频
152. 大模型 API 缓存命中和未命中为什么差价巨大?
NEW 新增题目
推理分两步,Prefill 阶段把输入 token 并行做矩阵运算,算出 K 和 V 向量存进显存,最烧 GPU 算力;Decode 阶段逐个生成输出 token,直接读显存里的 K 和 V,即 KV Cache。缓存命中指前缀和上次相同,服务端就跳过 Prefill,DeepSeek V4 Flash 缓存命中 0.02 元、未命中 1 元,差 50 倍。要多命中,把 system prompt、工具定义放前面,用户输入放后面。
完整答案:阅读全文《API 缓存命中》 · B站视频 · 飞书版
抖音视频:观看本集视频
156. MoE 是什么?DeepSeek 模型为什么采用混合专家架构?
NEW 新增题目
MoE 把 Transformer 每层的前馈网络拆成 256 个路由专家和 1 个共享专家。路由器给每个 Token 打分,按 Top-K 挑出 6 个路由专家,加上共享专家共 7 个。总参数按全部专家数算,激活参数按激活的专家数算,所以 DeepSeek V4 Flash 总参数 284B 只激活 13B,剩下的参数不是闲着,是还没轮到。DeepSeek 用 MoE,训练时靠大参数学知识,推理时只花小计算量,速度快成本低。
完整答案:阅读全文《什么是 MoE》 · B站视频 · 飞书版
抖音视频:观看本集视频
158. SWE-bench、Terminal-Bench、GPQA Diamond 这些大模型评测集到底在测什么?
NEW 新增题目
评测分三类。代码能力看 SWE-bench 系列,给模型真实 GitHub Issue 和整个仓库,自己定位 bug 写补丁并跑通测试,Pro 版平均要改 170 行,DeepSWE 全部从零出题。Agent 工具能力看 Terminal-Bench 在沙箱里敲命令,MCP-Atlas 考跨服务器调用 MCP,CyberGym 要写出复现漏洞的 PoC。推理能力看 GPQA Diamond,考生物、物理、化学的研究生级推理。
完整答案:阅读全文《大模型评测集在测什么》 · 飞书版
159. 什么是大语言模型?和传统 NLP 模型有什么区别?
传统 NLP 模型(LSTM、CRF)针对特定任务训练,换任务就得重新训练。大语言模型通过海量数据预训练获得通用语言能力,一个模型能处理翻译、摘要、问答、代码生成等各种任务,靠 Prompt 引导就行。
🟢 基础
160. 讲讲 Transformer 的基本架构?Encoder 和 Decoder 分别干什么?
Encoder 负责理解输入(把文本编码成语义向量),Decoder 负责生成输出(基于语义向量逐 token 生成文本)。GPT 系列只用 Decoder,BERT 只用 Encoder,T5 用完整的 Encoder-Decoder。现在主流的大语言模型基本都是 Decoder-only 架构。
🟢 基础 | 字节、腾讯
161. 多头注意力(MHA)有哪些局限?MQA、GQA、Flash Attention 怎么解决?
MHA 每个头都有独立的 KV 矩阵,显存占用大。MQA(Multi-Query Attention)所有头共享一组 KV,省显存但效果有损。GQA(Grouped-Query Attention)折中方案,几个头共享一组 KV。Flash Attention 从计算层面优化,减少 HBM 访问次数,不改注意力机制本身。
🟡 进阶 | 字节、腾讯
162. 位置编码是干什么用的?RoPE 和 ALiBi 有什么区别?
Transformer 本身不感知 token 顺序,位置编码告诉模型“第几个词在第几个位置”。RoPE(旋转位置编码)通过旋转矩阵编码相对位置,外推性好。ALiBi 直接在注意力分数上加一个和距离相关的偏置,实现简单,不需要额外参数。
🟡 进阶
163. 分词器是什么?BPE、WordPiece、SentencePiece 有什么区别?
分词器把文本拆成 token(模型能理解的最小单位)。BPE(字节对编码)从字符出发逐步合并高频对,GPT 系列在用。WordPiece 类似 BPE 但用似然概率选合并对,BERT 在用。SentencePiece 直接在原始文本上训练,不依赖预分词,多语言友好。
🟡 进阶
164. 什么是 Scaling Law?大模型的涌现能力是怎么回事?
Scaling Law 说的是模型性能随参数量、数据量、算力的增加呈可预测的幂律关系。涌现能力是指模型规模达到某个阈值后突然出现的能力(比如思维链推理),小模型完全不会,大模型突然就会了。
🟡 进阶
165. 大模型生成文本时有哪些解码策略?
贪心搜索(每步选概率最高的 token,确定性强但无聊)、束搜索(保留 top-k 条候选路径)、温度采样(temperature 控制随机性)、Top-P 采样(nucleus sampling,动态截断低概率 token)、Top-K 采样(只从前 K 个 token 里采样)。
🟡 进阶
166. Temperature、Top-P、Top-K 分别是什么?怎么调?
Temperature 控制概率分布的“平滑度”(低→保守,高→发散),Top-P 控制累积概率阈值,Top-K 控制候选集大小。代码生成建议低 temperature(0.1-0.3),创意写作用高 temperature(0.7-1.0)。PaiAgent 的 ChatClientFactory 默认 temperature=0.7。
🟡 进阶 | → PaiAgent ChatClientFactory temperature 配置
167. 大模型幻觉问题怎么减少?
RAG 是最有效的方案之一,让模型基于检索到的真实文档回答,而不是“自由发挥”。派聪明用 generationId 关联 referenceMappings,并在 ChatGenerationStateService / ConversationService 中保存引用详情,前端可以点击“来源”回看命中的 chunk。其他手段还有降低 temperature、增加 system prompt 约束、让模型说“我不确定”。
🟡 进阶 | → 派聪明 generationId + referenceMappings 引用追踪 | 阿里云、京东、蚂蚁
168. 什么是 CoT(思维链)?为什么效果好?有什么局限?
CoT 让模型“一步步想”而不是直接给答案,把推理过程显式化。效果好是因为把复杂问题分解成了多个简单步骤。局限是增加了 token 消耗和延迟,而且模型可能生成“看起来合理但实际错误”的推理链。
🟡 进阶
169. 多模型动态切换怎么实现?不重启服务就能换?
PaiAgent 的 ChatClientFactory 每次调用都 new 一个新的 ChatClient,不用 Spring 单例。每个节点可以配不同的 apiUrl 和 model,第一个节点用 DeepSeek 做初步分析,第二个节点用 GPT 做精细加工,改个配置下次执行就生效。
🟡 进阶 | → PaiAgent ChatClientFactory 动态工厂 | Shopee、腾讯、Moka
170. OpenAI 兼容协议是什么?各家大模型的差异在哪?
请求格式统一走 /v1/chat/completions,差异在 base_url 和 api_key。响应大部分字段一致,个别细节不同,比如 token 统计有的叫 prompt_tokens 有的叫 input_tokens。PaiAgent 用 Spring AI 的 OpenAiChatModel 统一了 OpenAI、DeepSeek、通义千问三家的接入。
🟡 进阶 | → PaiAgent OpenAiApi 统一多厂商
171. 流式输出(SSE / WebSocket)怎么设计?
派聪明用 WebSocket 做长连接,结合 DeepSeek 流式接口实现“打字机效果”,模型每生成一个 token 就推送给前端。还支持用户主动停止生成。技术细节包括心跳保活、断线重连、背压处理。
🟡 进阶 | → 派聪明 WebSocket + DeepSeek 流式接口 | 快手
172. 对比使用过哪些主流大模型?你们项目里最终选了哪个?
PaiAgent 支持 OpenAI、DeepSeek、通义千问、智谱四家。PaiCLI 接了 GLM、DeepSeek V4、Kimi、StepFun 等。选型原则:代码生成优先 DeepSeek/Claude,中文对话优先通义千问/GLM,性价比优先 DeepSeek。没有最好的模型,只有最适合场景的模型。
🟡 进阶 | → PaiAgent 四家模型 / PaiCLI 多模型适配 | Shopee、腾讯
173. 怎么让 LLM 返回结构化内容,比如和 Java 对象字段一一对应?
NEW 新增题目
Spring AI 可以通过 .entity() 将模型输出映射为 Java 对象;生产环境还需要配合 Schema 约束、字段校验和失败重试。
完整答案:待更新
174. LLM 返回的内容被截断了怎么办?
NEW 新增题目
先检查输出 Token 上限与 finish_reason,再根据场景选择提高上限、缩短上下文、分段生成或续写,并对最终结果做完整性校验。
完整答案:待更新
175. Chat Template 是什么?
NEW 新增题目
Chat Template 把 API 层的结构化消息翻译成模型训练时见过的线性 token 流,用特殊 token 划分消息边界和角色,不同模型家族格式不同,服务端自动完成。自己拼成「USER: ... ASSISTANT: ...」偏离了训练格式,模型要额外花注意力去推断角色边界,会出现重复执行已完成操作、忽略工具结果、该调工具时生成文本。把工具结果当普通 user 消息传也有问题,Chat Template 会误判为新话题,清掉之前的思考过程。
🟡 进阶 | → PaiCLI
176. 多轮工具调用时,历史的 reasoning 要不要回传给模型?
NEW 新增题目
各家策略不同而且在变。DeepSeek R1 时代要求剥离全部历史思考,因为训练时历史思维链从不出现在输入里。但 Agent 场景下中间思考承载着「为什么调这个工具、排除了哪些假设」,剥离后每轮从零推理,容易重复犯错。所以 DeepSeek V4 反转为只要请求带 tools 参数就必须原样回传 reasoning_content,否则返回 400,Kimi K2、GLM-5 采用同样协议。Claude 要求在工具调用循环里原样回传带签名的 thinking block。把跑到一半的轨迹交给另一家模型时,这些差异会变成实打实的接口错误。
🔴 深入 | → PaiCLI
177. 给 Agent 选模型要看哪些维度?
NEW 新增题目
绝大多数 Agent 需要支持思考的模型,多步决策没有思考能力表现很差。除了成本和榜单成绩,还要看输出 token 速度,20 轮推理每轮慢 2 秒就是多等 40 秒;多模态是否硬需求;厂商的策略边界,模型有能力不等于产品允许你调用。评估驱动选型时区分 TTFT、解码速度、思考延迟和 p95 尾部延迟,性能指标按场景选 Pass@1、Pass^k 或 Pass@k。一个便宜但成功率低的模型,因为频繁重试实际可能更贵。
🟡 进阶 | → PaiCLI
178. 什么是词嵌入(Word Embedding)?有哪些常见的词嵌入方法?
🟡 中等 | 自然语言处理(NLP) / 词嵌入 / Word2Vec | → PaiCLI / PaiAgent 大模型应用基础
179. 是否使用 Word2Vec 训练过数据?在这个过程中,如何获取语料?如何选择超参数?语料、词表和维度大小如何确定?怎样把握训练时长?
🔴 困难 | 自然语言处理(NLP) / 词嵌入 / Word2Vec | → PaiCLI / PaiAgent 大模型应用基础
180. Word2Vec 有哪些加速方法?
🔴 困难 | 自然语言处理(NLP) / 词嵌入 / Word2Vec | → PaiCLI / PaiAgent 大模型应用基础
181. 解释 hierarchical softmax 的流程,以及它有什么优点?
🔴 困难 | 自然语言处理(NLP) / 词嵌入 / Word2Vec / hierarchical softmax | → PaiCLI / PaiAgent 大模型应用基础
182. 说一说负采样技术在 Word2Vec 中的运用。
🟡 中等 | 自然语言处理(NLP) / 词嵌入 / Word2Vec / 负采样 | → PaiCLI / PaiAgent 大模型应用基础
183. CBOW 和 Skip-gram 分别更适合哪些应用场景?
🟡 中等 | 自然语言处理(NLP) / CBOW / Skip-gram | → PaiCLI / PaiAgent 大模型应用基础
184. 说说 GloVE 技术,怎样进行训练?有哪些应用场景?相比 Word2Vec 有哪些优缺点?
🔴 困难 | 自然语言处理(NLP) / Word2Vec / GloVE | → PaiCLI / PaiAgent 大模型应用基础
185. 说说 FastText 技术,是否比 Word2Vec 更优越?哪些情况下更适合使用 FastText
🔴 困难 | 自然语言处理(NLP) / Word2Vec / FastText | → PaiCLI / PaiAgent 大模型应用基础
186. 聊一聊 ELMo 技术,它有哪些优缺点?可以做到一词多义吗?为什么?
🔴 困难 | 自然语言处理(NLP) / ELMo | → PaiCLI / PaiAgent 大模型应用基础
187. 说说 LSTM 的基本原理。
🟢 简单 | 自然语言处理(NLP) / LSTM | → PaiCLI / PaiAgent 大模型应用基础
188. 与循环神经网络(RNN)相比,LSTM 是如何解决梯度消失问题的?
🟡 中等 | 自然语言处理(NLP) / LSTM / RNN / 梯度消失 | → PaiCLI / PaiAgent 大模型应用基础
189. 解释一个 LSTM 单元(LSTM cell)的基本组成,以及它们各自的作用。
🟡 中等 | 自然语言处理(NLP) / LSTM | → PaiCLI / PaiAgent 大模型应用基础
190. LSTM 中,隐藏状态(hidden state)和单元状态(cell state)有什么区别?
🟡 中等 | 自然语言处理(NLP) / LSTM | → PaiCLI / PaiAgent 大模型应用基础
191. LSTM 和 GRU 有什么区别?
🟡 中等 | 自然语言处理(NLP) / LSTM / GRU | → PaiCLI / PaiAgent 大模型应用基础
192. 请描述 BERT 模型的架构和应用场景。
🟡 中等 | 自然语言处理(NLP) / BERT | → PaiCLI / PaiAgent 大模型应用基础
193. BERT 是如何处理自然语言文本中不常见词或者罕见词的?
🟡 中等 | 自然语言处理(NLP) / BERT | → PaiCLI / PaiAgent 大模型应用基础
194. Word2Vec 到 BERT 有怎样的改进?
🟡 中等 | 自然语言处理(NLP) / BERT / Word2Vec | → PaiCLI / PaiAgent 大模型应用基础
195. BERT 怎样进行 mask 相比 CBOW 有什么区别?
🟡 中等 | 自然语言处理(NLP) / BERT / CBOW | → PaiCLI / PaiAgent 大模型应用基础
196. 你有什么办法可以比较好地解决 BERT 输入长度的限制?
🔴 困难 | 自然语言处理(NLP) / BERT | → PaiCLI / PaiAgent 大模型应用基础
197. 说说你是怎样有效地优化和微调 BERT,以应对你做过的一些特定的 NLP 任务的?
🔴 困难 | 自然语言处理(NLP) / BERT | → PaiCLI / PaiAgent 大模型应用基础
198. 如何比较文本的相似度?
🟢 简单 | 自然语言处理(NLP) / 文本分类 | → PaiCLI / PaiAgent 大模型应用基础
199. 支持向量机可以用于文本分类任务吗?若可以,请说明。
🟢 简单 | 自然语言处理(NLP) / 文本分类 / 支持向量机 | → PaiCLI / PaiAgent 大模型应用基础
200. 在文本分类任务中,如何处理高维和稀疏数据?
🟡 中等 | 自然语言处理(NLP) / 文本分类 | → PaiCLI / PaiAgent 大模型应用基础
201. 在文本分类任务中,如何处理样本(类别)不平衡的问题?
🟡 中等 | 自然语言处理(NLP) / 文本分类 | → PaiCLI / PaiAgent 大模型应用基础
202. 现有文本分类算法在处理多语种文本数据时可能遭遇哪些挑战?
🟡 中等 | 自然语言处理(NLP) / 文本分类 | → PaiCLI / PaiAgent 大模型应用基础
203. 简述 Word Embedding 可以怎样运用于文本分类任务?
🟡 中等 | 自然语言处理(NLP) / 文本分类 / Word Embedding | → PaiCLI / PaiAgent 大模型应用基础
204. 简述 LLaMA(Large Language Model Meta AI)的基本原理。
🟡 中等 | 自然语言处理(NLP) / 大语言模型 | → PaiCLI / PaiAgent 大模型应用基础
205. LLaMA 有哪些实际应用?
🟢 简单 | 自然语言处理(NLP) / 大语言模型 | → PaiCLI / PaiAgent 大模型应用基础
206. Transformer 在计算 attention 的时候使用的是点乘还是加法?请说明理由。
🟡 中等 | Transformer | → PaiAgent / PaiCLI 模型选型背景
207. self attention 中的 K 和 Q 是用来做什么的?
🟢 简单 | Transformer / 自注意力机制 | → PaiAgent / PaiCLI 模型选型背景
208. K 和 Q 可以使用同一个值通过对自身进行点乘得到吗?
🟡 中等 | Transformer | → PaiAgent / PaiCLI 模型选型背景
209. 如果让 K 和 Q 变成同一个矩阵,你觉得对模型性能会带来怎样的影响?
🔴 困难 | Transformer | → PaiAgent / PaiCLI 模型选型背景
210. 在不考虑计算量的情况下,head 能否无限增多?
🟡 中等 | Transformer / 多头注意力机制 | → PaiAgent / PaiCLI 模型选型背景
211. 在进行多头注意力的时候需要对每个 head 进行降维吗?
🟡 中等 | Transformer / 多头注意力机制 | → PaiAgent / PaiCLI 模型选型背景
212. 讲一下你对 Transformer 的 Encoder 模块的理解。
🟡 中等 | Transformer / Encoder | → PaiAgent / PaiCLI 模型选型背景
213. Transformer 中,Decoder 阶段的多头自注意力和 Encoder 阶段的多头自注意力是相同的吗?
🟡 中等 | Transformer / Encoder / Decoder / 多头自注意力机制 | → PaiAgent / PaiCLI 模型选型背景
214. 了解 Transformer 模型训练中的梯度裁剪(Gradient Clipping)吗?
🟡 中等 | Transformer / 梯度裁剪 | → PaiAgent / PaiCLI 模型选型背景
215. Transformer 为什么采用 Layer Normalization 而不是 Batch Normalization
🟡 中等 | Transformer / normalization | → PaiAgent / PaiCLI 模型选型背景
216. Transformer 中的注意力遮蔽(Attention Masking)的工作原理是什么?
🟡 中等 | Transformer / 注意力遮蔽 | → PaiAgent / PaiCLI 模型选型背景
217. 什么是自回归属性(autoregressive property)?
🟡 中等 | Transformer / 自回归属性 | → PaiAgent / PaiCLI 模型选型背景
218. Transformer 中的“残差连接”可以缓解梯度消失问题吗?
🟡 中等 | Transformer / 残差连接 / 梯度消失 | → PaiAgent / PaiCLI 模型选型背景
219. Transformer 中,如何处理大型数据集?
🟡 中等 | Transformer | → PaiAgent / PaiCLI 模型选型背景
220. Transformer 模型训练完成后,如何评估其性能和效果?
🟡 中等 | Transformer | → PaiAgent / PaiCLI 模型选型背景
221. Transformer 模型的性能瓶颈在哪?
🟡 中等 | Transformer | → PaiAgent / PaiCLI 模型选型背景
222. 你觉得可以怎样缓解这个性能瓶颈?
🔴 困难 | Transformer | → PaiAgent / PaiCLI 模型选型背景
223. 了解 ViT(Vision Transformer) 吗?
🟡 中等 | Vision Transformer | → PaiAgent / PaiCLI 模型选型背景
224. 了解 ViLT(Vision-and-Language Transformer) 吗?
🔴 困难 | ViLT | → PaiAgent / PaiCLI 模型选型背景
225. ViLT 模型是如何将 Transformer 应用于图像识别任务的
🟡 中等 | ViLT / 图像识别 | → PaiAgent / PaiCLI 模型选型背景
226. chatGLM 和 GPT 在结构上有什么区别?
🟡 中等 | Transformer / 语言模型 | → PaiAgent / PaiCLI 模型选型背景
227. 什么是 GPT Structured Outputs?
🟢 简单 | AI / 大模型 | → PaiAgent / PaiCLI
228. 什么是 GPTCache?
🟢 简单 | AI / 大模型 | → PaiCLI / PaiAgent
229. 大模型的 Token 是什么?输入 Token 和输出 Token 在计费上有什么区别?
🟢 简单 | 大模型 / Token / 计费模型 | → PaiCLI / PaiAgent
230. MoE 混合专家模型是什么?DeepSeek、Qwen 为什么用 MoE?
REVIEW 疑似重复 · 待确认:与「MoE 是什么?DeepSeek 模型为什么采用混合专家架构?」内容重合
MoE 把一个大模型拆成多个“专家”子网络,每次推理只激活其中几个专家。好处是模型总参数量大(知识储备多),但每次推理的计算量小(只用部分专家)。DeepSeek V3 用的就是 MoE,671B 总参数但每次只激活 37B。🟡 进阶
231. 什么是 Token 缓存机制?它如何帮助降低 AI 应用的成本?
REVIEW 疑似重复 · 待确认:与「大模型 API 缓存命中和未命中为什么差价巨大?」内容重合
🟢 简单 | `大模型 / Token 缓存 / 成本优化` | → PaiCLI / PaiAgent232. KV Cache 是什么?Prompt Caching 又是什么?
REVIEW 疑似重复 · 待确认:与「KV Cache 是什么?为什么只缓存 K 和 V,不缓存 Q?」「DeepSeek 的 Prompt Caching 为什么能全自动生效」内容重合
KV Cache 缓存已计算的 Key/Value 矩阵,避免每生成一个新 token 都重新算前面所有 token 的注意力。Prompt Caching 更上一层,缓存相同前缀 Prompt 的计算结果,多次请求共享同一份缓存。PaiCLI 支持 Prompt Cache 可视化,让用户看到缓存命中率。🟡 进阶 | → PaiCLI Prompt Cache 可视化
06、Claude Code与Codex(17 题)
聚焦 Claude Code、Codex 及其背后的代码理解、上下文管理、诊断、审查、回滚和自动修复能力。
238. Codex 的长期记忆是怎么实现的?
NEW 新增题目
Codex 在开新任务时后台处理旧任务,派 Sub-agent 读历史对话,优先读用户消息和工具结果,只留能让 Agent 表现更好的内容,脱敏后写入 SQLite。每条记忆带 usage_count 和 last_usage,按使用频率和时效排序淘汰,不用 Embedding。再由权限很小的 Sub-agent 把它们整理成记忆总结、操作手册、任务证据和 skills 四层,存在 ~/.codex/memories/ 目录。
完整答案:阅读全文《Codex 长期记忆》 · B站视频 · 飞书版
抖音视频:观看本集视频
235. Claude Code 如何检索长期记忆?
NEW 新增题目
Claude Code 检索长期记忆不用向量检索,也不用数据库。新开对话时它读 MEMORY.md 索引文件的前 200 行或 25KB,不做筛选,全部塞进上下文,交给大模型靠注意力自己判断哪些相关。前提是 MEMORY.md 控制在 200 行以内,所以索引要精简到一条记忆一行摘要。OpenClaw 走另一条路,Markdown 负责存,SQLite 存向量负责找,再加关键词匹配,代价是要额外跑 embedding 模型,速度慢。
完整答案:阅读全文《Claude Code 记忆检索》 · B站视频 · 飞书版
抖音视频:观看本集视频
236. CLAUDE.md 到底要怎么写才有用?
NEW 新增题目
CLAUDE.md 里写“使用 Java 17”“保持代码整洁”等于没写,因为 Claude 自己能推断,或者没有标准无法执行。有效的规则一句话写完,只写 Claude 推断不出来的,有明确的行动指导。Anthropic 的 claude-code-action 仓库分六个板块,从构建命令到踩坑清单,当新员工入职须知来写,控制在 80 行以内,其余拆进 .claude/rules/ 按 paths 字段按需加载。
完整答案:阅读全文《CLAUDE.md 写法》 · B站视频 · 飞书版
抖音视频:观看本集视频
234. Claude Code 的长期记忆是怎么实现的?
NEW 新增题目
Claude Code 的长期记忆分两层,一层是 CLAUDE.md,由用户写在项目根目录,提交到 Git 供团队共享。另一层是 memory 文件夹,在 ~/.claude/projects/ 下,由 Claude Code 自动记录,不提交 Git,里面是 MEMORY.md 索引和记忆文件,自动或手动写入。新开对话时先读 MEMORY.md 前 200 行再按需加载,CLAUDE.md 则直接注入系统指令,压缩时永远不会丢。
完整答案:阅读全文《Claude Code 长期记忆》 · B站视频 · 飞书版
抖音视频:观看本集视频
237. Codex 的短期记忆是怎么实现的?
NEW 新增题目
大模型本身没有记忆,Codex 和 Claude Code 一样,靠每次调用重新发送完整聊天记录实现短期记忆。Codex 基于 Responses API 维护一个混合列表,每次请求开头和上一次保持一致,以便命中 Prompt Caching。上下文快满时,Codex 把完整上下文交给 OpenAI 服务端压缩,返回的是只有模型能读的加密数据。压缩后系统指令和工具定义会重新注入,读过的文件内容却可能丢失,所以一个线程只做一件事。
完整答案:阅读全文《Codex 短期记忆》 · B站视频 · 飞书版
抖音视频:观看本集视频
233. Claude Code 的短期记忆是怎么实现的?
NEW 新增题目
Claude Code 的短期记忆是一个 Messages 数组,用户、模型和工具的消息依次追加,每次调大模型时把整个数组重新发一遍。上下文窗口有上限,autoCompact 估算 Token 总量接近上限时,起一个 Sub-agent 按 9 个维度把历史消息压成摘要,再重新注入最近读过的 5 个文件和工具 schema,并插入 Boundary Marker,之后只发送标记后的消息。压缩会丢细节,尽量在一个上下文窗口内做完一件事。
完整答案:阅读全文《Claude Code 短期记忆》 · B站视频 · 飞书版
抖音视频:观看本集视频
239. AI 辅助编程在实际工作中怎么提效的?
这道题考的不是技术深度,而是真实使用经验。PaiCLI 在日常开发中能做到:自然语言描述需求 → 自动生成代码 → 编译检查 → 自动修复错误 → 提交 Git。关键不在于代码生成准确率有多高,而在于“生成→反馈→修正”的循环效率。
🟡 进阶 | → PaiCLI 日常开发全流程 | 小红书、蚂蚁、影石
240. 代码生成场景下 AST 分析有什么用?
AST(抽象语法树)能让 Agent 理解代码的结构而不只是文本。PaiCLI 集成了 JavaParser 做 AST 分析,可以精确定位类、方法、字段的位置和关系,比正则匹配靠谱得多。生成代码时能确保插入位置正确、不破坏已有的代码结构。
🟡 进阶 | → PaiCLI JavaParser AST 分析
241. LSP 诊断注入在 AI Coding 中解决什么问题?
LSP(Language Server Protocol)能提供实时的编译错误、类型检查、未使用变量等诊断信息。PaiCLI 把 LSP 诊断信息注入到 Agent 的上下文里,让模型在生成和修改代码时能“看到”IDE 级别的错误提示,修复准确率大幅提升。
🟡 进阶 | → PaiCLI LSP 诊断注入
242. 怎么保障 AI 改代码的安全性?Git 快照回滚怎么做?
AI 改错代码是常有的事,关键是能快速恢复。PaiCLI 实现了 Git Side-History 机制,每次 AI 修改前自动创建快照,改坏了一键回滚到修改前的状态。类似游戏里的存档读档,心理负担一下子就没了。
🟡 进阶 | → PaiCLI Git Side-History 快照回滚
243. 代码库的向量化和语义搜索怎么做?
把代码文件按函数/类切块,生成向量存入数据库,搜索时用自然语言描述找到语义最匹配的代码片段。PaiCLI 用 SQLite 做代码向量的持久化存储,还构建了代码关系图谱,能理解函数之间的调用关系。
🟡 进阶 | → PaiCLI SQLite 向量存储 + 代码关系图谱
244. AI 代码审查和人工代码审查有什么互补关系?
AI 审查擅长的是:风格一致性检查、常见 bug 模式识别、安全漏洞扫描、代码复杂度评估。人工审查擅长的是:业务逻辑正确性、架构合理性、可维护性判断。最佳实践是 AI 先过一轮自动审查,人工只关注 AI 标记出来的问题和业务逻辑。
🟡 进阶
245. 多文件编辑时上下文怎么管理?
AI 改一个功能可能涉及 5-10 个文件,全部塞进上下文 token 就炸了。PaiCLI 的做法是:先用 Glob/Grep 精准定位相关文件和代码段,只把必要的片段加入上下文,改完一个文件就释放那部分上下文。代码关系图谱在这里也能帮忙,自动找出“改了 A 文件,B、C 文件也需要同步改”。
🟡 进阶 | → PaiCLI Glob/Grep + 代码关系图谱
246. CLI 形态的 AI Agent 和 IDE 插件形态有什么优劣?
CLI 形态(PaiCLI、Claude Code):不依赖特定 IDE,跨平台通用,适合全栈开发和 DevOps 场景,但缺少 GUI 交互。IDE 插件形态(GitHub Copilot、通义灵码):和编辑器深度集成,补全体验好,但绑定特定 IDE。PaiCLI 选 CLI 是因为 Java 开发者用的 IDE 太分散了,IntelliJ、Eclipse、VS Code 都有人用。
🟡 进阶 | → PaiCLI CLI 形态设计考量
247. 什么是 Agentic Engineering?它和 Vibe Coding 有什么区别?
🟢 简单 | AI Coding / Agentic Engineering / Vibe Coding | → PaiCLI / PaiAgent
248. 什么是深度思考(Deep Thinking)和自适应思考(Adaptive Thinking)?它们在 AI 编程中有什么应用?
🟢 简单 | AI Coding / Deep Thinking / Adaptive Thinking | → PaiCLI / PaiAgent
249. 什么是 Background Agent(后台 Agent)?它改变了 AI 编程的什么工作方式?
🟢 简单 | AI Coding / Background Agent / 异步任务 | → PaiCLI / PaiAgent
07、DeepSeek专题(5 题)
聚焦 DeepSeek 的后训练、注意力结构、缓存机制、多模态与 Harness 插件系统。
254. 多模态模型和纯文本模型有什么区别?以 DeepSeek V4-Flash-Vision-Exp 为例
NEW 新增题目
V4-Flash 和 V4-Flash-Vision-Exp 只差一个视觉编码器。大模型的入口只有 token,视觉编码器把图片切成大小相同的方块,编码成离散的 token,一张图最多算 384 个 token。它是前置模块,视觉 token 和文字 token 走同一个模型、同一套参数,文本能力不变差,多模态 Agent 任务则纯文本模型比不了。升级只需把 model 改成 deepseek-v4-flash-vision-exp。
完整答案:阅读全文《多模态与纯文本的区别》 · B站视频 · 飞书版
抖音视频:观看本集视频
251. CSA、HCA 与 KV Cache:DeepSeek V4 缓存为什么更便宜?
NEW 新增题目
V4 缓存命中便宜,不只因为跳过了 Prefill 计算,更因为 KV Cache 显存被压到了 V3 的 7%。MLA 只压薄每个 token 的 KV,100 万个 token 仍要存 100 万份。V4 直接减少份数,CSA 把每 4 个相邻 token 合并成 1 份,再用索引器只挑最相关的 512 条计算,HCA 每 128 个 token 合并成 1 份。一张卡能服务十几个请求,V4 才敢把上下文窗口开到 100 万。
完整答案:阅读全文《CSA HCA 与缓存》 · B站视频 · 飞书版
抖音视频:观看本集视频
252. DeepSeek V4 为什么用 CSA 和 HCA 替换 MLA?
NEW 新增题目
MLA 用投影矩阵把每个词元的 K 和 V 压缩成低维 latent 向量,即把每份笔记压薄,V2 和 V3 在 128K 上下文又快又省全靠它。但 V4 把上下文扩到 1M,token 数翻了 8 倍,每个词元仍要记一份,百万 token 请求的 KV Cache 能吃满一张顶配 GPU 卡,只能服务一个请求,并发上不去,API 就贵。所以 V4 从份数下手,把相邻多个词元合并成一份共享笔记,由 CSA 和 HCA 两个机制实现。
完整答案:阅读全文《V4 为何替换 MLA》 · B站视频 · 飞书版
抖音视频:观看本集视频
253. Cordis 是什么?DeepSeek Harness 的插件系统如何理解?
NEW 新增题目
Cordis 是构建框架的框架,不是应用框架,而是给框架开发者用的底层基座。它由 DeepSeek 的 Shigma 创建,是从聊天机器人框架 Koishi 抽出来的插件内核。核心能力是可逆副作用,每个副作用在创建时就记录了撤销方式,卸载时一键回滚,不留内存泄漏,因此能真正热重载。插件之间靠依赖声明协作,依赖的服务就绪后才启动插件。DeepSeek Harness 里模型、工具、技能、沙箱全是插件,切换运行模式就是换一组插件组合。
完整答案:阅读全文《什么是 Cordis》 · B站视频 · 飞书版
抖音视频:观看本集视频
250. 为什么更小的激活参数也能获得更强 Agent 能力?
NEW 新增题目
DeepSeek V4 Flash 正式版只有 13B 激活参数,V4 Pro 有 49B,架构没改,只重做了后训练,9 项 Agent 测试全面超过 Pro 预览版。后训练分 SFT、偏好优化和强化学习三步,用 GRPO 让模型在 Agent 任务里反复试错。这能弥补参数差距,因为 Agent 需要的规划、工具调用、错误恢复和长程追踪能力,预训练“预测下一个词”的目标几乎学不到。所以选模型先看 Agent 专项跑分,参数量排最后。
完整答案:阅读全文《后训练为何重要》 · B站视频 · 飞书版
抖音视频:观看本集视频
热点解读(7 题)
模型发布和行业事件的快速拆解,面试聊到最新动态时用得上。
Kolibri 如何蒸馏 GLM-5.3 和 Qwen3.8?
NEW 新增题目
Kolibri 用 78B 总参数、3.46B 激活参数降低每次推理的计算量,结合混合专家和滑动窗口注意力控制开销;后训练数据由 GLM-5.3、Qwen3.8 等模型生成,文章拆解其训练方法、跑分和使用边界。
完整内容:阅读全文《Kolibri 解读》 · 飞书详细答案
抖音视频:观看本集视频
Gemini 4 Argon 发布,100 万 Token 输出意味着什么?
NEW 新增题目
从 Prefill、Decode 和 KV Cache 的成本差异,理解百万 Token 输出的工程难点;结合长代码修改、安全攻防和 CodeMender 的工作方式,拆解 Gemini 4 Argon 的能力与使用边界。
完整内容:阅读全文《Gemini 4 Argon 解读》 · 飞书详细答案
抖音视频:观看本集视频
MiMo-V3 的 HySparse2 和混合滑动窗口注意力有什么区别?
HySparse2 将模型分成 Self-Decoder 和 Cross-Decoder:前半段保留全注意力与滑动窗口,后半段结合全注意力与稀疏注意力。通过模块内部 KV Reuse 和跨段 KV Bridging,让后半段复用或从前半段计算 KV Cache,使 Prefill 提前结束,减少长输入和工具返回内容带来的计算成本。
完整内容:阅读全文《MiMo-V3 与 HySparse2》 · 飞书版
抖音视频:观看本集视频
推荐 5 个复刻 Jev 的开源项目
开源社区在 48 小时内复刻出了 Jev,思路是扔掉全量语言模型头,换成轻量决策头,冻结底层参数只挂 LoRA 微调,块因果掩码让单次前向并发完成多项决策。文中盘点 Kev(Qwen3.5 基座,兼容官方 SDK,本地首选)、Nimble(对比数据构建,准确率 90.1%)、Laya(ModernBERT 双向编码器,单次 33 毫秒)、Open-Jev(截流下一个 token 的概率对数)四个项目,以及意图路由、工具护栏、历史剪枝三个落地入口。
完整内容:阅读全文《Jev 开源复刻》 · 飞书版
B站视频:观看本集视频
抖音视频:观看本集视频
不生成文本的 Jev,为什么让 14 万开发者排队?
Jev 是 TypeSafe AI 9 月 15 日发布的 System One 模型,不生成文本,只做判断。给它一段应用状态和一个预定义的结构化问题,它用一次前向计算直接在选项上分配概率,支持是否、单选、打分三种决策。它用 RLCD 训练校准过的置信度,比同类 LLM 快 40 到 200 倍,便宜 40 到 400 倍。Agent 里意图路由、审核、风控初筛这类高频小决策交给它,复杂推理仍然交给大模型。
完整内容:阅读全文《Jev 是什么》 · 飞书版
B站视频:观看本集视频
抖音视频:观看本集视频
GPT-6 Astra 全量上线,为什么 OpenAI 敢说 AGI 时代来了?
GPT-6 Astra 在 ARC-AGI-3 上拿到 99.9%,靠的是紧凑符号世界模型加有状态的 Harness。它能直接操作电脑,网络安全等级首次达到 Critical。模型越强,Harness 的设计就越关键。
完整内容:阅读全文《GPT-6 Astra 解读》 · 飞书版
Claude、ChatGPT、Grok 全崩,你的中转为什么还能用?
官网和 API 共用 Cloudflare 做流量入口,入口挂了就全挂。中转还能跑,是因为 OpenAI 兼容协议让切换模型零成本,而各家模型的能力和风格已经趋同到难以分辨。文中给了三个验证中转到底在调谁的方法。
完整内容:阅读全文《官网全崩中转为什么还能用》 · 飞书版
08、Prompt 工程(16 题)
聚焦系统提示词、Few-shot、自洽性、提示词评测、注入防护,以及 Prompt Engineering 的实践方法。
270. 如何写好 Prompt?分享下 Prompt 工程的实践经验?
核心原则:角色设定(“你是一个资深Java工程师”)、明确任务(具体描述要做什么)、输出格式约束(JSON/Markdown)、Few-shot 示例(给几个例子)、约束条件(不要做什么)。PaiCLI 做了一套 Prompt 分层设计,从系统级到 Skill 级,层级越高优先级越高。
完整答案:查看图文解析《9 个提示词技巧》 · 飞书详细答案
抖音视频:观看本集视频
🟡 进阶 | → PaiCLI Prompt 分层覆盖机制
255. 什么是提示词工程(Prompt Engineering)?
NEW 新增题目
提示词工程是一门有具体方法论的技术学科,同一个任务,提示词不同,输出质量天差地别。三大核心技术是零样本提示、少样本提示和思维链。零样本提示不给示例,重点是任务描述足够具体。少样本提示给 2 到 5 个输入输出示例,示例要有代表性。思维链要求模型先展示推理过程再给结论。实战上还有角色设定和结构化输出。模型再聪明,提示词工程也不会被淘汰,它现在是上下文工程的一个子集,管的是这句话怎么说,上下文工程管的是该给模型提供哪些信息。
完整答案:阅读全文《提示词工程》 · B站视频 · 飞书版
抖音视频:观看本集视频
256. 系统提示词是流程驱动好还是规则堆砌好?
NEW 新增题目
流程驱动。给模型上百条零散规则,多条同时适用时不知道选哪条,未覆盖的情况不知道怎么办。流程驱动的提示词像一份新员工 SOP,模型任何时刻都知道自己在哪个阶段、当前目标是什么、完成后去哪一步,遇到异常按所处阶段处理,而不是遍历所有规则找匹配。书里的消融实验里,信息组织混乱导致成功率下降 30% 以上。检验标准一句话,聪明的新员工读完不知道该怎么做,Agent 也一样不知道。
🟡 进阶 | → PaiCLI
257. 系统提示词怎么防止越写越乱?
NEW 新增题目
把按场景才用到的规则拆成 Skill 按需加载,不全塞进系统提示词。每条规则写明作用域、动作、例外和验证方式,不写「更自然一点」这种没法验证的话。保留带正反例的评估集,每次改动跑回归。定期做垃圾回收,删掉已经被模型内化或者过时的条目。系统提示词纳入版本控制,改动带来源和理由。
🟡 进阶 | → PaiCLI
258. 提示词中的分隔符有什么作用?如何使用?
🟢 简单 | Prompt / 分隔符 | → PaiCLI / PaiAgent
259. 什么是系统提示词 System Prompt?它和用户提示词有什么区别?
🟢 简单 | Prompt / System Prompt | → PaiCLI / PaiAgent
260. 什么是 Few-shot Learning?Zero-shot、One-shot、Few-shot 有什么区别?
🟡 中等 | Prompt / Few-shot Learning | → PaiCLI / PaiAgent
261. 如何选择和设计 Few-shot 示例以提升效果?
🟡 中等 | Prompt / Few-shot 示例设计 | → PaiCLI / PaiAgent
262. 什么是自洽性?如何应用?
🟡 中等 | Prompt / 自洽性 | → PaiCLI / PaiAgent
263. 什么是负面提示词?在什么场景下使用?
🟡 中等 | Prompt / 负面提示词 | → PaiCLI / PaiAgent
264. 什么是提示词链接?如何实现?
🟡 中等 | Prompt / 提示词链接 | → PaiCLI / PaiAgent
265. 如何为不同领域设计专用提示词?比如编程、创作、数据分析
🟡 中等 | Prompt / 领域专用提示词 | → PaiCLI / PaiAgent
266. 如何系统地评估和优化提示词的效果?
🔴 困难 | Prompt / 效果评估 | → PaiCLI / PaiAgent
267. 提示词注入攻击是什么?如何防范?
🔴 困难 | Prompt / 安全防护 | → PaiCLI / PaiAgent
268. 在实际项目中如何进行提示词的 AB 测试和迭代?
🔴 困难 | Prompt / A/B 测试 | → PaiCLI / PaiAgent
269. 什么是思维树 Tree of Thoughts?它相比 CoT 有什么优势?
🔴 困难 | Prompt / 思维树 | → PaiCLI / PaiAgent
09、MCP 与工具调用(26 题)
聚焦 Function Calling、Tool Calling、MCP、A2A、ACP、工具 Schema、权限与协议适配。
271. Function Calling 底层是怎么实现的?
模型在训练阶段见过大量“函数描述→调用参数”的样本,推理时根据用户意图生成结构化的函数调用 JSON。PaiAgent 里每个工具通过 Spring AI 的 FunctionCallback 接口注册,getName/getDescription/getInputTypeSchema 三件套就是 Function Calling 的标准协议。
🟡 进阶 | → PaiAgent FunctionCallback 实现 | 字节、阿里
272. LLM 是如何学会调用外部工具的?Function Call 能力怎么训练?
两种路径:一是在 SFT 阶段用大量“用户问题→工具调用→工具返回→最终回答”的样本做微调;二是在 Prompt 里描述工具并给 Few-shot 示例,利用 In-Context Learning 能力。前者效果更稳定,后者不需要重新训练。GPT 系列走的是第一条路。
🟡 进阶
273. MCP 是什么?它解决了什么问题?
MCP 是一套标准化的“模型↔工具”通信协议,让 AI 应用能像 USB 一样即插即用地接入各种外部工具。之前每接一个工具就要写一套适配代码,有了 MCP,工具提供方按协议封装一次,所有支持 MCP 的 Agent 都能直接用。
🟡 进阶 | → PaiCLI MCP 集成 / PaiAgent MCP 工具配置 | 腾讯、蚂蚁、字节
274. MCP 由哪几部分组成?
三大组件:MCP Server(提供工具/资源的服务端)、MCP Client(Agent 侧的客户端,发起调用)、协议规范(定义工具描述格式、请求响应格式、传输方式)。PaiCLI 里同时实现了 Client 端(调用外部 MCP Server)和对协议的完整支持。
🟡 进阶 | → PaiCLI MCP Client 实现
275. MCP 和 Function Calling 有什么区别?
Function Calling 是模型层面的能力,模型决定调用什么函数、传什么参数。MCP 是传输层的协议,规定了工具怎么描述自己、怎么接收调用、怎么返回结果。可以理解为 Function Calling 是“大脑的决策”,MCP 是“手脚的执行通道”。
🟡 进阶 | → PaiAgent(Function Calling)+ PaiCLI(MCP 传输) | 作业帮、腾讯
276. Function Calling、Skill、MCP 三者有什么区别?
FC 是模型决策层(决定调什么工具),MCP 是传输层(工具怎么通信),Skill 是知识层(预置的最佳实践指南)。三者不互斥,一次完整的工具调用可能同时涉及:Skill 告诉模型“这个场景该用搜索工具”,模型通过 FC 生成调用参数,MCP 把请求发给搜索服务。
🟡 进阶 | → PaiAgent(FC + Skill)+ PaiCLI(FC + MCP + Skill)
277. MCP Server 的 stdio 和 HTTP 模式分别怎么用?
stdio 模式通过子进程通信,适合本地工具(文件操作、Git 命令等),延迟低但只能单机。HTTP 模式走网络请求,适合远程服务(数据库、第三方 API),支持分布式但有网络开销。PaiCLI 两种都支持,还能自动发现和注册 MCP Server 的工具列表。
🟡 进阶 | → PaiCLI stdio + HTTP 双模式
278. 为什么有些推理模型不支持 MCP?
推理模型(比如 o1、DeepSeek-R1)在设计时优化了长链推理能力,但牺牲了工具调用能力。它们的训练数据和 RLHF 流程侧重于“想清楚再回答”而不是“边调工具边回答”。解决方案是用推理模型做规划,再用普通模型执行工具调用。
🟡 进阶
279. 什么是 A2A 协议?和 MCP 有什么区别?
A2A(Agent-to-Agent)是 Google 提出的 Agent 间通信协议,解决的是“Agent 和 Agent 怎么对话”的问题。MCP 解决的是“Agent 和工具怎么通信”。一个是 Agent 间的横向协作,一个是 Agent 向下调用工具。
🟡 进阶
280. WebSocket 和 SSE 通信有什么区别?在 AI 场景中各自怎么用?
SSE 是单向的(服务端→客户端),适合模型流式输出。WebSocket 是双向的,适合需要客户端随时发消息的场景(比如中途打断生成)。派聪明用 WebSocket 就是因为需要支持用户主动停止生成。
🟡 进阶 | → 派聪明 WebSocket 双向通信
281. 工具描述(Tool Description)怎么写才能让模型准确调用?
关键是写清楚“什么时候该用这个工具”而不只是“这个工具能干什么”。比如 search_code 的描述不该是“搜索代码”,而该是“当需要在代码库中查找特定函数、变量名或代码片段时使用”。PaiAgent 的 FunctionCallback.getDescription() 就遵循这个原则。
🟡 进阶 | → PaiAgent FunctionCallback 描述设计
282. 敏感工具的安全控制怎么做?
PaiCLI 实现了一套完整的安全机制:HITL(Human-in-the-Loop)人工审批,执行高危操作前先问用户同意;路径围栏,限制文件操作只能在项目目录内;命令黑名单,禁止 rm -rf / 这类危险命令;结构化审计日志,每次工具调用都有迹可查。
🟡 进阶 | → PaiCLI HITL + 路径围栏 + 命令黑名单 | 快手
283. 模型编造不存在的工具调用(工具幻觉)怎么防?
两个手段:一是在工具列表里做白名单校验,模型返回的 tool_calls 如果不在已注册列表里就直接拒绝;二是优化工具描述让模型更准确地理解工具边界。PaiAgent 的 NodeExecutorFactory 通过 Map 注册机制天然实现了白名单校验。
🟡 进阶 | → PaiAgent NodeExecutorFactory 白名单 | 淘天
284. 在 Spring AI 框架中如何集成 MCP?
🟢 简单 | 大模型 / AI / MCP / Spring / Spring AI / Java | → PaiAgent(Spring AI)/ PaiCLI(MCP 对照)
285. MCP 协议安全性设计包含哪些层面?
🟢 简单 | 大模型 / AI / MCP / 安全性 | → PaiAgent / PaiCLI
286. 如何将已有的应用转换成 MCP 服务?
🟢 简单 | 大模型 / AI / MCP / 开发实践 | → PaiAgent / PaiCLI
287. 什么是 A2A 协议,它的核心架构及主要组件有哪些?
🟡 中等 | 大模型 / AI / A2A / 系统架构 | → PaiAgent / PaiCLI
288. A2A 协议有哪五大设计原则?
🟡 中等 | 大模型 / AI / A2A / 系统架构 | → PaiAgent / PaiCLI
289. MCP 和 Skills 有什么区别?分别适用于什么场景?
🟢 简单 | AI / 大模型 / Agent / Skills | → PaiAgent / PaiCLI
290. 不同的 LLM Provider 对 Tool Schema 的支持不完全一致,你会怎么处理这种差异?OpenClaw 是怎么做 Schema 适配的?
🟡 中等 | AI / OpenClaw / 大模型应用开发 / AI应用开发 | → PaiAgent / PaiCLI
291. 什么是 ACP 协议?它有哪两个不同的含义?
🟢 简单 | AI Coding / ACP 协议 / Agent 协议 | → PaiCLI / PaiAgent
292. Agent 的工具分哪几类?
NEW 新增题目
五类。感知工具主动获取信息,设计关键是控制输出信息量防止上下文爆炸。执行工具改变外部世界,错误代价高,安全约束是核心。协作工具驱动其他 Agent 或人类,比如创建子 Agent。用户沟通工具主动向用户传递信息,多渠道异步场景下「说话」本身也要成为显式工具调用。事件触发工具由 Agent 注册、外部触发,定时器、监控后台任务、连接外部事件源,没有它 Agent 只能被动等用户开口。
🟢 基础 | → PaiCLI
293. 一项能力该做成专用工具、通用执行器还是 Skill?
NEW 新增题目
默认通用优于专用,一个 code_interpreter 能代替几十个特定功能的工具,还能处理没预想到的边缘场景。四种情况退回专用工具,涉及安全权限审计的操作,需要屏蔽平台差异给出更好反馈的操作(grep、find),使用频率极高的操作,参数结构复杂的操作。Skill 对人更友好、改起来便宜,但要模型自己生成命令行参数和转义,参数复杂时更容易出错。四个决策维度,安全与权限、参数复杂度、变更频率、模型能力。
🟡 进阶 | → PaiCLI
294. 什么是工具参数的静默转换?
NEW 新增题目
工具在执行前悄悄「修正」模型的输入。某 IDE 2026 年初的一个版本把 old_string 里的中文弯引号静默转成直引号,模型明明在文件里看到了弯引号,替换却总报「未找到匹配」,反复重试反复失败,它没法理解为什么。还有静默参数注入,bash 工具给每次 git commit 自动附加参数,旧版 Git 不认就报错,模型怎么改提交信息都没用。原则是模型感知到的世界和工具操作的世界之间不能有系统性偏差,确实要规范化就写进工具描述并在返回里告知。
🔴 深入 | → PaiCLI
295. Agent 有上百个工具时怎么办?
NEW 新增题目
工具超过一百个时最先进的模型也容易选错,5 个 MCP 服务器就可能引入数万 token 的定义。三层答案,一层比一层按需。层次化组织与按需加载,只暴露工具名索引,需要时再查定义,某 IDE 的 A/B 测试显示相关任务 token 消耗减少 46.9%。主动工具发现,系统提示词只留基础工具和一个「工具搜索工具」,Agent 意识到能力缺口时用自然语言声明需求,系统匹配注入,新 schema 追加到轨迹末尾固定在原位置,不破坏前缀缓存。Skills 最轻,把工具当参考资料按需查阅,不需要嵌入索引那套基础设施。
🔴 深入 | → PaiCLI
296. 多个 MCP 服务器有功能重叠的工具,怎么选?
NEW 新增题目
先在 Harness 层解决,不要把选择难题全推给模型。同名工具按来源加命名空间避免混淆,功能重叠的按来源设优先级或去重,只暴露一个入口再路由。留给模型选的,描述里必须写清差异,返回摘要还是全文、成本、时延、边界,让模型按「什么时候用」来选。模型自己感知不到行为差异,靠的是描述和返回值说明,不是靠猜。
🟡 进阶 | → PaiCLI
10、LangChain 与 Spring AI(21 题)
聚焦 LangChain、LangGraph、LlamaIndex、Spring AI 的编排、记忆、检索、工具与结构化输出能力。
297. 什么是 LangGraph ?
🟢 简单 | AI / 大模型 / LangGraph / 工作流编排 | → PaiAgent
298. LangGraph 编排的原理是什么?
🟢 简单 | AI / 大模型 / LangGraph / 工作流编排 | → PaiAgent
299. LangChain 和 LangGraph 有什么区别?
🟢 简单 | AI / 大模型 / LangGraph / 工作流编排 | → PaiAgent
300. LlamaIndex 如何与 LangChain 结合?
🔴 困难 | 大模型 / AI / Agent / LangChain / LlamaIndex | → PaiAgent 框架选型对比
301. 什么是 Spring AI 框架?它有哪些核心特性?
🟢 简单 | 后端 / Spring AI | → PaiAgent
302. 什么是结构化输出?Spring AI 是怎么实现结构化输出的?
🟡 中等 | 后端 / Spring AI | → PaiAgent
303. 什么是 Re-Reading?如何基于 Spring AI 实现 Re-Reading Advisor?
🟡 中等 | 后端 / Spring AI | → PaiAgent
304. 什么是工具调用 Tool Calling?如何利用 Spring AI 实现工具调用?
🟡 中等 | 后端 / Spring AI | → PaiAgent
305. LangChain 中的 Chain 是什么?有哪些常见类型?
🟢 简单 | LangChain / Chain 链式调用 | → PaiAgent 框架选型对比
306. LangChain 的 Memory 组件有什么作用?常见的 Memory 类型有哪些?
🟡 中等 | LangChain / Memory 记忆机制 | → PaiAgent 框架选型对比
307. 在 LangChain 中如何实现流式输出?
🟡 中等 | LangChain / 流式输出 | → PaiAgent 框架选型对比
308. 如何在 LangChain 中自定义 Tool 工具?
🟡 中等 | LangChain / Tool 工具 | → PaiAgent 框架选型对比
309. LangChain 和 LlamaIndex 有什么区别?各自适合什么场景?
🟡 中等 | LangChain / LlamaIndex / 框架对比 | → PaiAgent 框架选型对比
310. LangChain 中的 DocumentLoader 有哪些类型?如何选择?
🟢 简单 | LangChain / DocumentLoader 文档加载 | → PaiAgent 框架选型对比
311. LangChain 的 OutputParser 有什么作用?有哪些常见类型?
🟢 简单 | LangChain / OutputParser 输出解析 | → PaiAgent 框架选型对比
312. LangChain 中的 Callback 回调机制是什么?有什么用?
🟡 中等 | LangChain / Callback 回调 | → PaiAgent 框架选型对比
313. LangChain 中的 LCEL 表达式语言是什么?有什么优势?
🟡 中等 | LangChain / LCEL | → PaiAgent 框架选型对比
314. LangChain 中如何实现条件分支和动态路由?
🟡 中等 | LangChain / 条件路由 | → PaiAgent 框架选型对比
315. LangChain 中的 Retriever 检索器有哪些类型?各有什么特点?
🟡 中等 | LangChain / Retriever 检索器 | → PaiAgent 框架选型对比
316. 如何处理 LangChain 应用中的错误和异常?
🟡 中等 | LangChain / 异常处理 | → PaiAgent 框架选型对比
317. 如何保证 LangChain 应用的输出质量和一致性?
🔴 困难 | LangChain / 质量保证 | → PaiAgent 框架选型对比
11、模型训练与微调(32 题)
聚焦预训练、SFT、RLHF、DPO、LoRA、PEFT、量化、蒸馏、数据集与训练资源。
318. 大模型预训练完了,为什么还要做强化学习?
NEW 新增题目
预训练是自监督学习,模型靠遮住词自己猜来刷题,学到的是知识。强化学习没有老师也没有教材,模型直接和环境互动,答对给奖励,答错给惩罚,靠试错调整策略。DeepSeek-R1-Zero 没用任何标注数据,纯靠 RL 让模型自己学会了推理,训练中涌现出「等一下,让我重新想想」这样的反思。各家往 RL 砸钱,是因为高质量预训练数据快用完了,RL 只需要一个能判断对错的奖励信号。小米 MiMo-V2.6 的 RL 训练每步约 20 亿 token,4 万多个沙箱并行。
完整答案:阅读全文《什么是强化学习》 · 飞书版
B站视频:观看本集视频
抖音视频:观看本集视频
🟢 基础 | → DeepSeek R1 / MiMo
319. 大模型是怎么训练出来的?预训练→SFT→RLHF 三阶段讲一下?
预训练(在海量无标注文本上学语言能力)→ SFT(用人工标注的指令-回答对微调,学会“听话”)→ RLHF(用人类偏好反馈做价值观校准,学会“说人话”)。三阶段花费依次降低但重要性递增。
🟡 进阶 | 字节、腾讯
320. 大模型微调有哪些方案?LoRA 的原理是什么?
全量微调(改所有参数,贵)、LoRA(冻结原始权重,只训练低秩分解矩阵,参数量减少 99%+)、QLoRA(量化 + LoRA,更省显存)、Adapter(在层间插入小模块)、Prefix Tuning(只调前缀向量)。LoRA 是目前性价比最高的方案。
🟡 进阶 | 字节、阿里
321. SFT 之后还有哪些 Post-Training?RLHF、DPO、GRPO 什么关系?
SFT 让模型学会格式和基本能力,Post-Training 让模型学会“什么样的回答更好”。RLHF 用奖励模型 + PPO 训练,DPO 去掉奖励模型直接用偏好对训练,GRPO 去掉 Critic 网络用组内相对比较。进化路径是越来越简化训练流程。
🔴 深入 | 作业帮、腾讯
322. DPO 和 PPO 的区别是什么?
PPO 需要先训一个奖励模型,再用奖励模型的分数做策略梯度优化,流程复杂。DPO 直接用偏好数据对(好回答 vs 坏回答)优化策略,把奖励模型隐式地融入到损失函数里,训练更简单稳定。
🔴 深入 | 腾讯、三七互娱
323. 大模型量化是什么?INT8/INT4/AWQ/GPTQ 怎么选?
把模型参数从 FP16 压缩到 INT8/INT4,显存占用直接减半或减四分之三。GPTQ 是训后量化(快但精度损失稍大),AWQ(Activation-aware)考虑激活值分布做量化(精度更好),INT4 省显存最多但精度损失最大。实际选型看你的显卡显存和精度要求。
🟡 进阶
324. 微调中常用的优化器有哪些?
🟡 中等 | 大模型 / AI / 微调 / 优化器 | → PaiAgent / PaiCLI 模型工程面试扩展
325. 微调的过拟合风险如何通过正则化缓解?
🔴 困难 | 大模型 / AI / 微调 | → PaiAgent / PaiCLI 模型工程面试扩展
326. 在多模态微调(如图文生成)中,如何确保文本和图像数据的对齐质量?
🔴 困难 | 大模型 / AI / 微调 / 多模 | → PaiAgent / PaiCLI 模型工程面试扩展
327. 参数高效微调(PEFT)如何减少计算成本?
🔴 困难 | 大模型 / AI / 微调 | → PaiAgent / PaiCLI 模型工程面试扩展
328. 冻结层在微调中的作用是什么?
🔴 困难 | 大模型 / AI / 微调 | → PaiAgent / PaiCLI 模型工程面试扩展
329. 为什么需要混合精度训练?
🔴 困难 | 大模型 / AI / 微调 | → PaiAgent / PaiCLI 模型工程面试扩展
330. 模型输出重复和幻觉如何微调解决?
🔴 困难 | 大模型 / AI / 微调 | → PaiAgent / PaiCLI 模型工程面试扩展
331. 微调大模型需要什么样的硬件?7B 和 70B 模型分别需要多少显存?
🟢 简单 | 大模型 / 微调 / 显存评估 | → PaiAgent / PaiCLI 模型工程面试扩展
332. 2026 年主流的微调工具有哪些?Unsloth、Axolotl、TRL 各有什么特点?
🟢 简单 | 大模型 / 微调工具 / Unsloth / Axolotl / TRL | → PaiAgent / PaiCLI 模型工程面试扩展
333. LoRA 的超参数应该怎么设置?有什么经验法则?
🟢 简单 | 大模型 / LoRA / 超参数 | → PaiAgent / PaiCLI 模型工程面试扩展
334. 对比 LoRA、QLoRA、DoRA 和全量微调,在不同场景下应该如何选择?
🟢 简单 | 大模型 / LoRA / QLoRA / DoRA / 全量微调 | → PaiAgent / PaiCLI 模型工程面试扩展
335. ORPO 是什么?它如何将指令微调和偏好对齐合二为一?
🟢 简单 | 大模型 / ORPO / 偏好对齐 | → PaiAgent / PaiCLI 模型工程面试扩展
336. 如何构建高质量的 SFT 微调数据集?数据质量和数量哪个更重要?
🟢 简单 | 大模型 / SFT / 数据集构建 | → PaiAgent / PaiCLI 模型工程面试扩展
337. 什么是模型蒸馏(Knowledge Distillation)?它和模型量化有什么区别?
🟢 简单 | 大模型 / 模型蒸馏 / 模型量化 | → PaiAgent / PaiCLI 模型工程面试扩展
338. 大模型的训练和推理分别是什么?它们在计算资源需求上有什么区别?
🟢 简单 | 大模型 / 训练 / 推理 / 资源评估 | → PaiAgent / PaiCLI 模型工程面试扩展
339. 什么是大模型的参数量?参数量和模型能力之间是什么关系?
🟢 简单 | 大模型 / 参数量 / 模型能力 | → PaiAgent / PaiCLI 模型工程面试扩展
340. Mid-training 是什么?
NEW 新增题目
Mid-training 沿用预训练的下一个词目标,把数据分布收窄到目标领域,混入通用保留数据控制遗忘,对整段文档的全部 token 算损失。它回答的是模型有没有完成任务所需的知识和基本能力,SFT 回答的是回答长什么样。判断方法是在留出任务上测 pass@1 和 pass@k,pass@k 仍接近 0 说明正确策略根本不在模型分布里,RL 和 SFT 都没东西可放大,先做 Mid-training。用少量问答 SFT 硬塞事实,只会记住问法。
🔴 深入 | → PaiCLI
341. SFT 和 RL 的本质区别是什么?
NEW 新增题目
SFT 在数学上和预训练是同一个任务,都是预测下一个词,区别只有数据换成输入输出示范对,以及损失只算在回答部分。它最大化标注回答的概率,样本效率极高,擅长固化格式、风格、流程这类协议性知识,但示范不够多样时容易对表面模式过拟合。RL 最大化期望奖励,模型探索多条路径并提高高奖励路径的概率,能发现示范里没有的策略,代价是样本效率低几十到上百倍、训练不稳定。一句话,SFT 细致学习已有地图,RL 拿着奖励这枚指南针探索地图外的路线。
🟡 进阶 | → PaiCLI
342. 怎么判断该做 Mid-training、SFT 还是 RL?
NEW 新增题目
先排除不需要改权重的方案,Prompt、工具、代码约束、上下文管理能解决就不训练,事实需要频繁更新优先 RAG。再在留出集上测能力支持,不只看 pass@1,还看 pass@k、部分进展率、格式解析率,并人工审计失败原因。pass@k 近零且失败集中在知识和基础能力,先 Mid-training;会做但不按要求做,用 SFT 立协议;已有非零成功率和可靠奖励、只是好策略概率低,才上 RL。全零 rollout 上直接加 PPO 或 GRPO 只会消耗采样预算。
🔴 深入 | → PaiCLI
343. 结果奖励和过程奖励怎么选?
NEW 新增题目
结果奖励只在结束时判成败,最简单,探索自由度最大,但反馈稀疏,长轨迹难归因;「是否完成」的判定要交给模型写不了的隐藏测试,不能只看模型自己声称完成。过程奖励在中间步骤给反馈,缓解信用分配,但可能把模型限制在设计者预设的路径上,标注成本也高。工程上先用结果奖励建基线,再只为真正可验证的中间事件加过程信号。
🔴 深入 | → PaiCLI
344. 什么是 RLVP?
NEW 新增题目
RLVP(Reinforcement Learning with Verified Penalty)的原则是奖励结果、惩罚路径。结果奖励只能说明事情有没有办成,说明不了是否按规定办成,Agent 可能靠改测试文件、跳过身份验证拿到表面成功。RLVP 对可机器判定的违规动作逐动作扣分,结果奖励始终保留,避免模型学会什么都不做。它只针对结果中性的路径约束,不能替代对交付完整性和早停行为的独立检查。
🔴 深入 | → PaiCLI
345. 什么是在轨蒸馏(On-Policy Distillation)?
NEW 新增题目
区别在于谁生成学生要学习的状态前缀。SFT 的轨迹由人类或教师采样,监督密集但只覆盖教师会走到的状态,学生一旦犯了教师不会犯的错就进入陌生前缀。RL 在学生自己的状态上训练,但通常只有轨迹结束时一个成败信号。在轨蒸馏把两者组合,学生决定走到哪里,教师在学生已经走到的位置给出下一步的完整 token 分布,一条长度 T 的轨迹产生约 T 组逐 token 监督。数学任务上达到同等性能的训练步数约为纯 RL 的十分之一。没有更强的教师时可以用在轨自蒸馏,让同一个模型看到标准答案的版本当教师。
🔴 深入 | → PaiCLI
346. 编辑文件经常失败,该改 Harness 还是后训练?
NEW 新增题目
先归因再决定。沿「文件字节、工具返回、Harness 序列化、模型上下文、模型输出、解析、工具匹配」这条链路逐层对比,工具或 Harness 改变了字节就归因给它们,改代码就行。只有模型收到的上下文和原始字符串完全一致,而模型输出是链路上首个出现差异的位置,才算模型的精确复制问题,才进后训练候选。书里用 LoRA SFT 把随机字符串的逐字节抄写准确率从 37.5% 提到 78.9%。
🔴 深入 | → PaiCLI
347. Coding Agent 过早结束,怎么用后训练修?
NEW 新增题目
先用 Harness 兜底,模型宣称完成时在隔离工作区跑它看不到的验收测试。要训练的话,把首个错误定位在「准备宣称完成」这个决策边界,构造偏好对做 DPO,被拒绝的是过早结束,被选中的是先跑测试再下结论。评估时边界集和保留集缺一不可,保留集确认任务真完成时模型还敢收尾,否则会训成永远不敢结束的过度矫正。
🔴 深入 | → PaiCLI
348. 微调时怎么缓解灾难性遗忘?
NEW 新增题目
优先 LoRA,原权重冻结,对基座已有能力的扰动更小,但不是免疫。数据上按小配比混入通用任务数据,Mid-training 也要混通用保留语料。评估上边界集和保留集缺一不可,训练后抽查通用能力,确认补丁没有破坏其他能力。只盯着目标任务的指标,会把过拟合当成进步。
🟡 进阶 | → PaiCLI
349. 在多模态微调中,如何确保文本和图像数据的对齐质量?有哪些技术挑战?
REVIEW 疑似重复 · 待确认:与同分类的「如何确保文本和图像数据的对齐质量?」内容重合
🟢 简单 | `大模型 / 多模态微调 / 数据对齐` | → PaiAgent / PaiCLI 模型工程面试扩展12、Agent 产品与框架演进(9 题)
从 AutoGPT 到 Manus、OpenManus,再到 OpenClaw,这些产品和框架本身已经不是热点,但每一个都代表 Agent 发展的一个阶段。这一类题不考「它是什么」,考的是它当时解决了什么问题、为什么后来被替代、留下了哪些至今还在用的设计。一条主线可以贯穿全部,产品能力的演进就是观察空间和动作空间的演进。拿 OpenClaw 当 Harness 案例的设计题仍然放在「03、Harness 与 Skills」。
351. 什么是 Manus?说说你对它的了解
Manus 不是聊天机器人,而是能动手干活的 AI Agent,ChatGPT 是参谋,Manus 是执行者。它底层用 Claude,没有自研模型,通用靠的是把 Deep Research、Coding 和 Computer Use 三条路线放进同一个 Agent,用虚拟浏览器扩大观察空间,用代码执行和命令行扩大动作空间。爆火靠邀请码稀缺、GAIA 榜单成绩和“套壳”争议,技术门槛不高,工程化的差距才是壁垒。
完整答案:阅读全文《什么是 Manus》 · 飞书版
B站视频:观看本集视频
抖音视频:观看本集视频
🟢 简单 | AI / 大模型 / Manus | → PaiAgent / PaiCLI
350. AutoGPT 如何实现自主决策?
AutoGPT 是最早把「让模型在循环里自己决定下一步」做成产品的项目之一,靠提示词让模型输出思考、计划和下一条命令,再把执行结果喂回去。它当年暴露的问题,循环停不下来、token 消耗失控,至今仍是 Agent 工程的核心问题。当年靠提示词硬撑的规划和工具选择,现在已经被模型内化成原生能力。 🔴 困难 | 大模型 / AI / Agent / AutoGPT | → PaiCLI / PaiAgent Agent 范式对比
352. 什么是 OpenManus?它的实现原理是什么?
OpenManus 是 MetaGPT 团队在 Manus 发布后很快开源的复现项目,价值在于用很少的代码把通用 Agent 的骨架摆在明面上,一个 ReAct 循环,加上浏览器、代码执行、文件读写几类工具。面试时重点讲这个骨架和 Manus 的差距在哪,差的不是循环,是 Harness 里的约束、验证和纠正。 🔴 困难 | 后端 | → PaiAgent / PaiCLI
353. 最近 OpenClaw 这么火,你知道它的原理吗?
OpenClaw 把接口延伸到了用户的数字生活。它通过 WhatsApp、Telegram、Slack、Discord、iMessage 这些用户已经在用的消息渠道接收任务和返回结果,用本地 Gateway 连接 Google Drive、Notion 和本地文件系统,本地优先,常驻运行。内核仍然是 Coding Agent,文件系统是记忆、知识和能力的中枢,长期记忆存在 MEMORY.md 和按日期归档的 Markdown 日志里。 🟢 简单 | AI / OpenClaw / 大模型应用开发 / Agent 开发 / AI 应用开发 | → PaiAgent / PaiCLI
354. 市面上有哪些主流的 LLM Agent 框架?各自的特点是什么?
可以按编排模式和开发方式来分。Codex Harness 和 Claude Agent SDK 是模型厂商开放的自主 Agent 运行时,LangChain / LangGraph 是工作流加自主的通用框架,n8n 和 Dify 走低代码,CrewAI 做角色化多 Agent 编排,DeepSeek Harness 走一切皆插件。框架更迭很快,选型的关键不是框架本身有多完整,而是它能不能用尽量少的抽象层让你专注业务逻辑。 🟢 简单 | 大模型 / AI / Agent | → PaiAgent / PaiCLI
355. 什么是 Google ADK?
🟢 简单 | AI / 大模型 | → PaiAgent / PaiCLI
356. 用感知、行动、策略三个维度分析一个 AI 产品
NEW 新增题目
Coding Agent 感知需求、代码片段、目录和终端输出,行动是代码搜索、文件读写和执行命令,策略是理解需求、搜索代码、编辑、测试、修复的增量开发。Deep Research 感知搜索结果和网页内容,策略是根据已有信息迭代调整搜索方向。Computer Use 感知截图或无障碍树,策略是观察屏幕、识别目标、执行操作、验证结果。这些产品的共同点是开放式动作空间、行动前内部思考、根据环境反馈持续交互。
🟡 进阶 | → PaiCLI
357. 为什么说 Coding 是通用 Agent 的核心能力?
NEW 新增题目
Manus、OpenClaw 这类通用 Agent 把 Deep Research、Computer Use 和 Coding 融合在一起,其中 Coding 是内核,因为几乎所有高效的内容生成最终都落到代码上。PPT 和 Word 本质是 OOXML,PDF 报告可以由 Markdown 或 LaTeX 生成,数据分析交给 Python 脚本,成功的浏览器操作序列也能固化成可复用的代码。Computer Use 通用性更强,但成本、延迟和稳定性都不如直接通过代码或 API 完成同样的事。这个判断主要适用于开放任务的通用 Agent,客服这类任务空间封闭的 Agent,代码只是工具箱里的一件工具。
🟡 进阶 | → PaiCLI
358. OpenClaw 是什么?它要解决什么问题?它的核心能力有哪些?
REVIEW 疑似重复 · 待确认:与「最近 OpenClaw 这么火,你知道它的原理吗?」内容重合
🟢 简单 | `AI / OpenClaw / 大模型应用开发 / AI应用开发 / Agent开发` | → PaiAgent / PaiCLIending
做这套题库的时候,我反复在想一个问题,技术更迭这么快,什么样的学习才是不浪费时间的。
Agent 这一轮变化和以往不太一样。以前的技术迭代,学一门新语言、学一个新框架,旧的东西还能用很久。但 Agent 正在改变的是软件的开发方式本身。你写代码的方式、调试的方式、搭建系统的方式,都在被重新定义。这不是「学不学」的问题,而是「早学还是晚学」的问题。
Alan Kay 说过一句话,「预测未来最好的办法就是去创造它」。我觉得这话放在今天特别合适。与其等着被 Agent 浪潮推着走,不如自己先把原理搞透,把项目跑通,把面试里会被问到的每一个点都准备好。
所以我们选择了最笨但最扎实的方式。365 道题,每道题录视频讲,每道题写图文解析,每道题映射到真实项目的真实代码。没有速成,没有捷径,就是一道一道地拆,一个知识点一个知识点地过。
我始终相信一件事,技术的价值不在于它有多新,而在于你是否真正理解它、用过它、能把它讲清楚。这套题库要做的就是帮你到达这个状态。
共勉。