到底什么是语义缓存?
你有没有算过,调用大模型 API 的钱,有多少花在了重复的问题上?
比如说商城 Agent 最常见的客服机器人,每天都要回答“怎么重置密码?”、“怎么退款?”,假如用户问一次大模型就推理一次,那可就太费 Token 了。
有没有这样一种说法,问过的问题直接返回答案,不再调用模型?
有。就是语义缓存——Semantic caching。
我翻了 GPTCache 的学术论文,可以自信地、大方地、光明磊落地帮你搞清楚这三件事:
- 语义缓存到底是什么?和 KV Cache、Prompt Caching 有什么本质区别?
- 它怎么判断两个问题“差不多”?
- 什么场景适合用,什么场景不适合?
在这梳理了一份 AI Agent 开发学习路线和 288 道配套八股,需要的可以来个222。
先说第一件事。
之前讲过 KV Cache、Prefix Caching、Prompt Caching,这三种缓存有一个共同点,都在 Token 上做精确匹配,存的是注意力计算的中间结果,主要影响 LLM 的 API 账单,不影响答案的正确性。
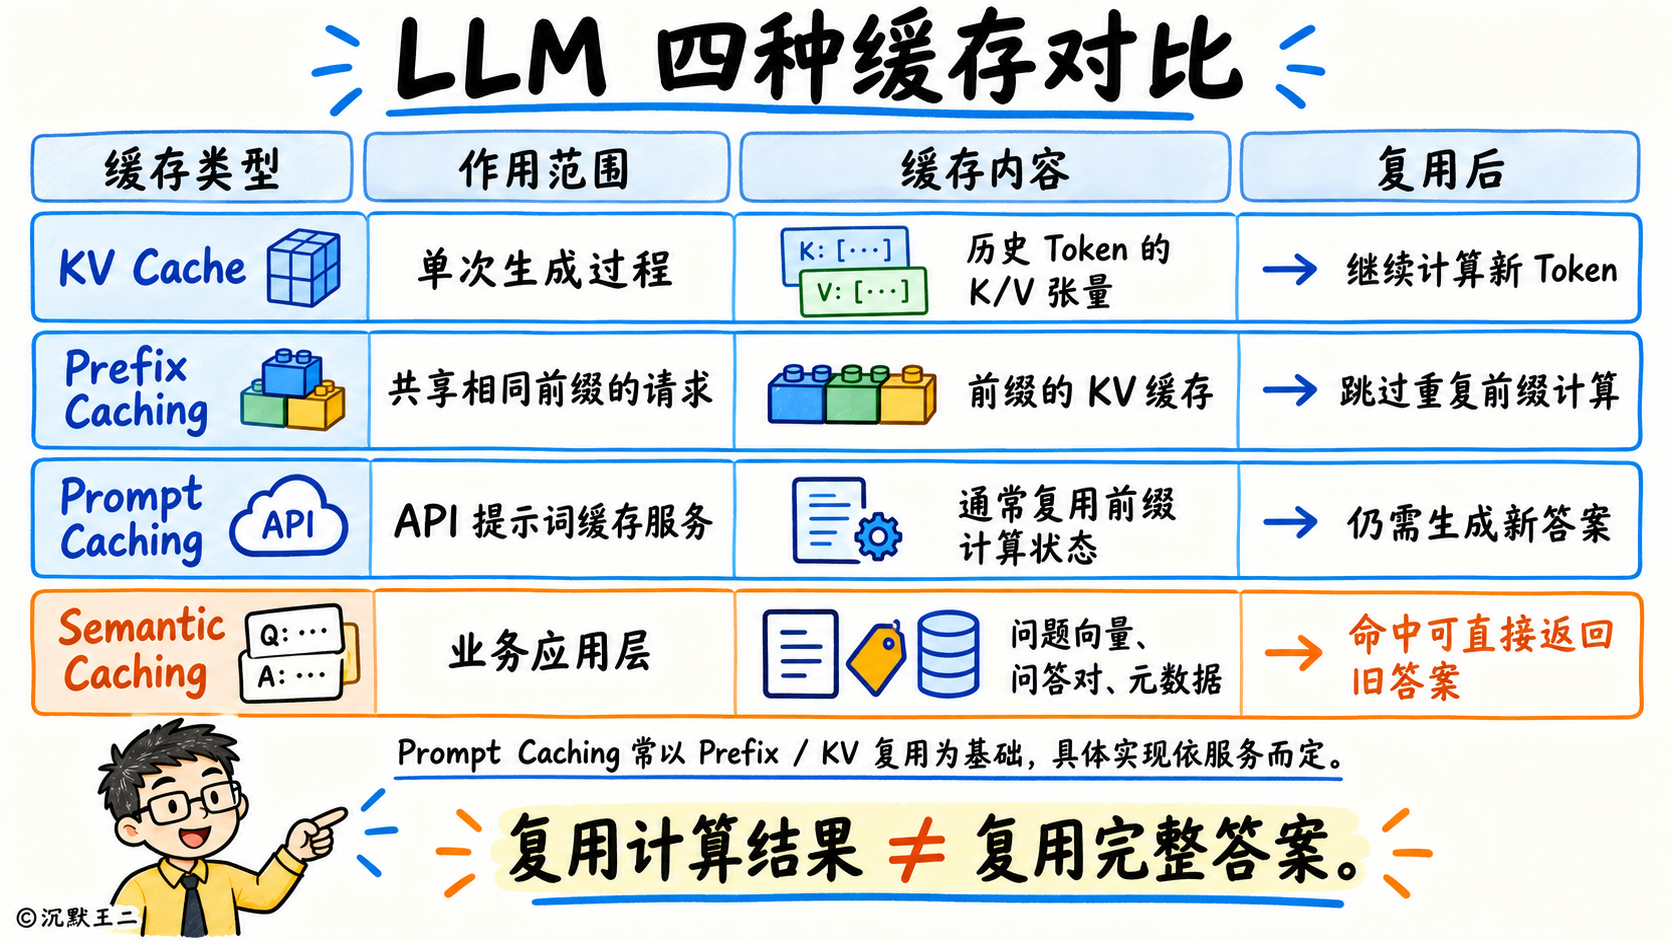
语义缓存完全不同。
它存的是完整的问答对。你问了“怎么重置密码”,模型回了一段话,语义缓存把这一问一答整个存下来。下次有人问了一句意思差不多的话,直接返回上次的答案,不再去调用 API。
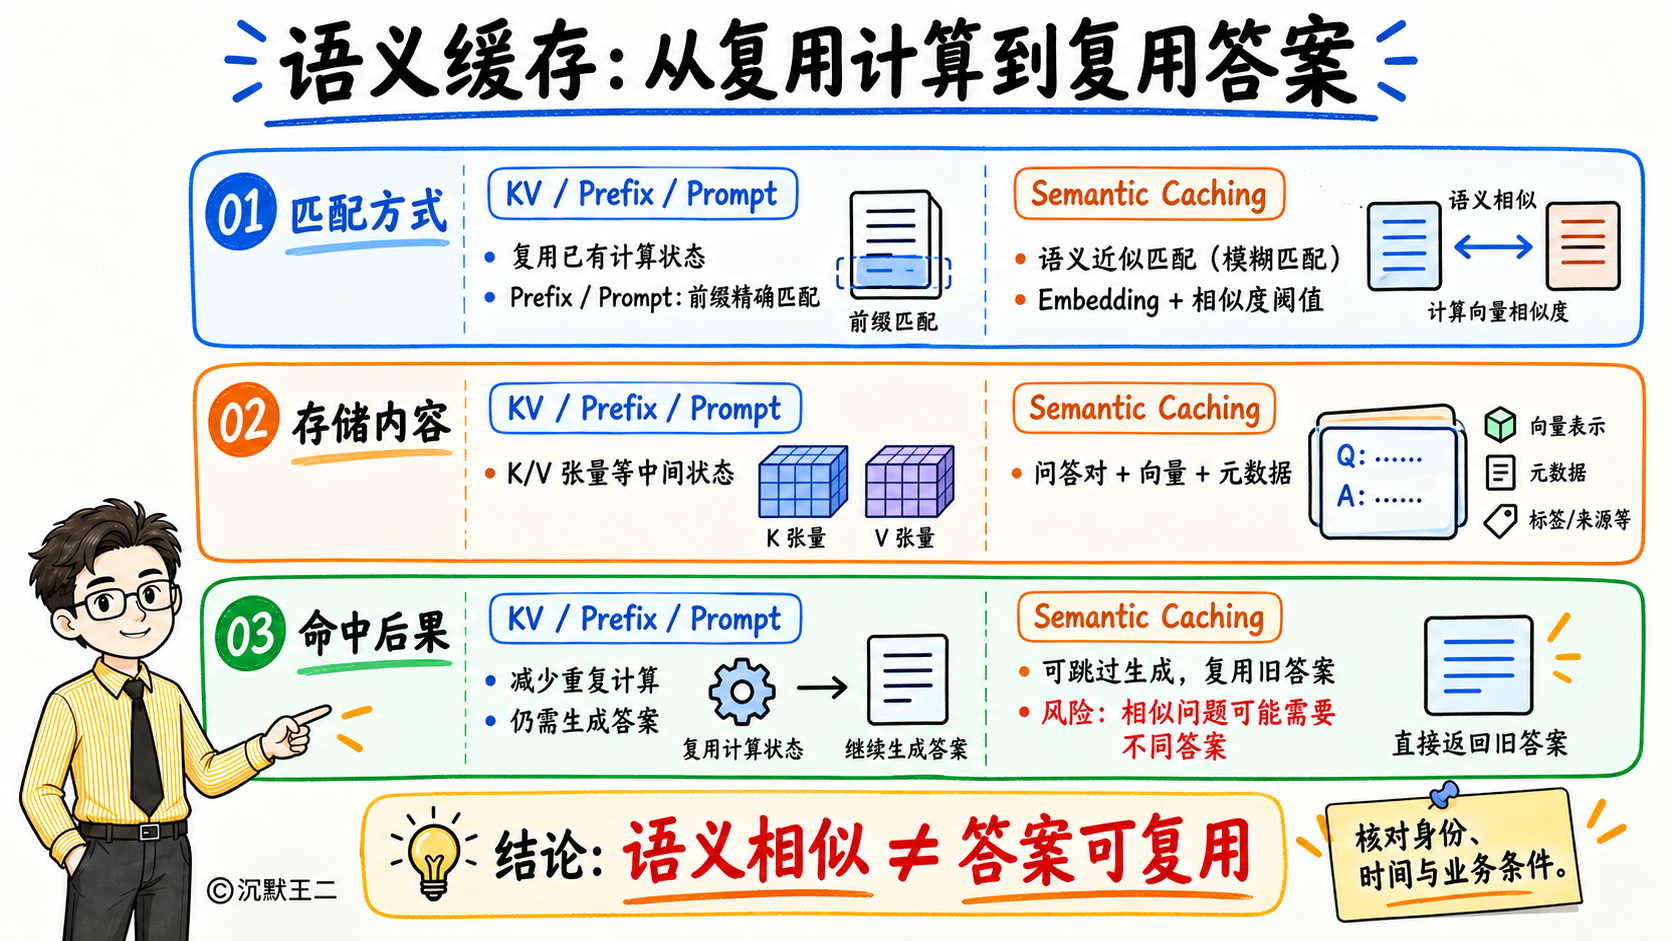
那聪明的你肯定想到了,靠什么判断两个问题“差不多”?
靠 Embedding。
Embedding 说白了,就是把一句话变成一组数字,这组数字叫向量。【怎么重置密码】可能变成 [0.12, 0.87, 0.45, ...] 这样一组数字,【密码忘了怎么办】可能变成 [0.13, 0.86, 0.44, ...] 这么一组数字。两句话意思越接近,向量就接近。
它是AI应用(如 RAG 检索增强生成、语义搜索、文本分类和聚类)的基石。
有了向量,就可以用余弦相似度(Cosine Similarity)比较两个问题有多接近。
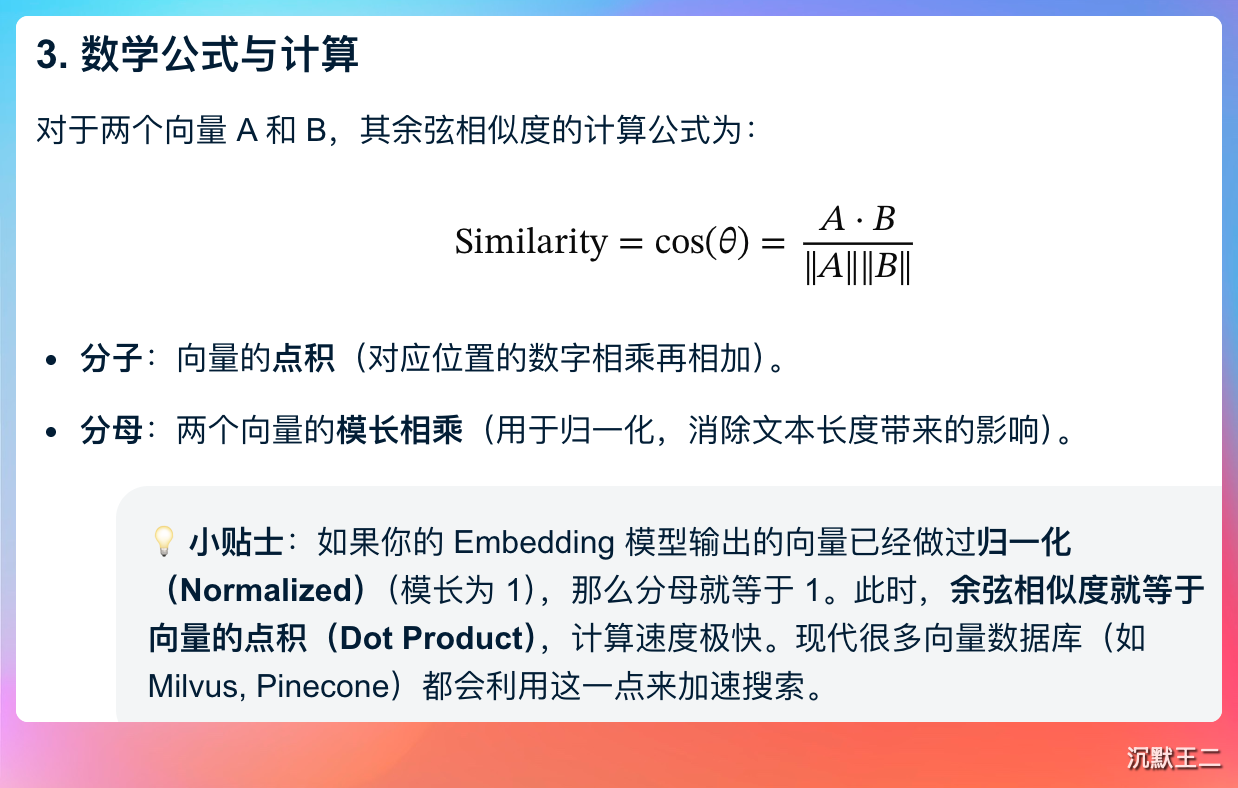
比如“我喜欢吃苹果”和 “苹果是我最爱的水果”经过 Embedding 转化为向量后,之间的夹角就非常小,接近 1。
那聪明的你可能要问,为什么余弦相似度能确认两个语义非常近?
原因在于 Embedding 模型在训练时,已经把“语义相似性”转化为了几何空间中的“方向一致性”。
在深度学习(如 BERT、GPT 等大模型)训练 Embedding 时,有一条核心铁律就是上下文相似的词,其语义就相似(这就是著名的分布式假设)。
模型在阅读了几千亿字的海量文本后发现,“苹果”和“富士苹果”经常出现在“吃”、“甜”、“水果”等相同的上下文里。
为了在数学上表达这种规律,模型在多维空间(通常是 768 或 1536 维)中给它们建模时,会赋予它们高度相似的特征维度激活值。
在几何空间中,这意味着代表这两个词的向量,都指向了同一个狭窄的方向。余弦相似度测量的恰恰就是这个“指向”,方向越同步,夹角越小,余弦值就越接近 1。
好,那设一个阈值,比如 0.85。超过就认为差不多,直接返回缓存答案。没超过就老老实实调模型生成新的答案。
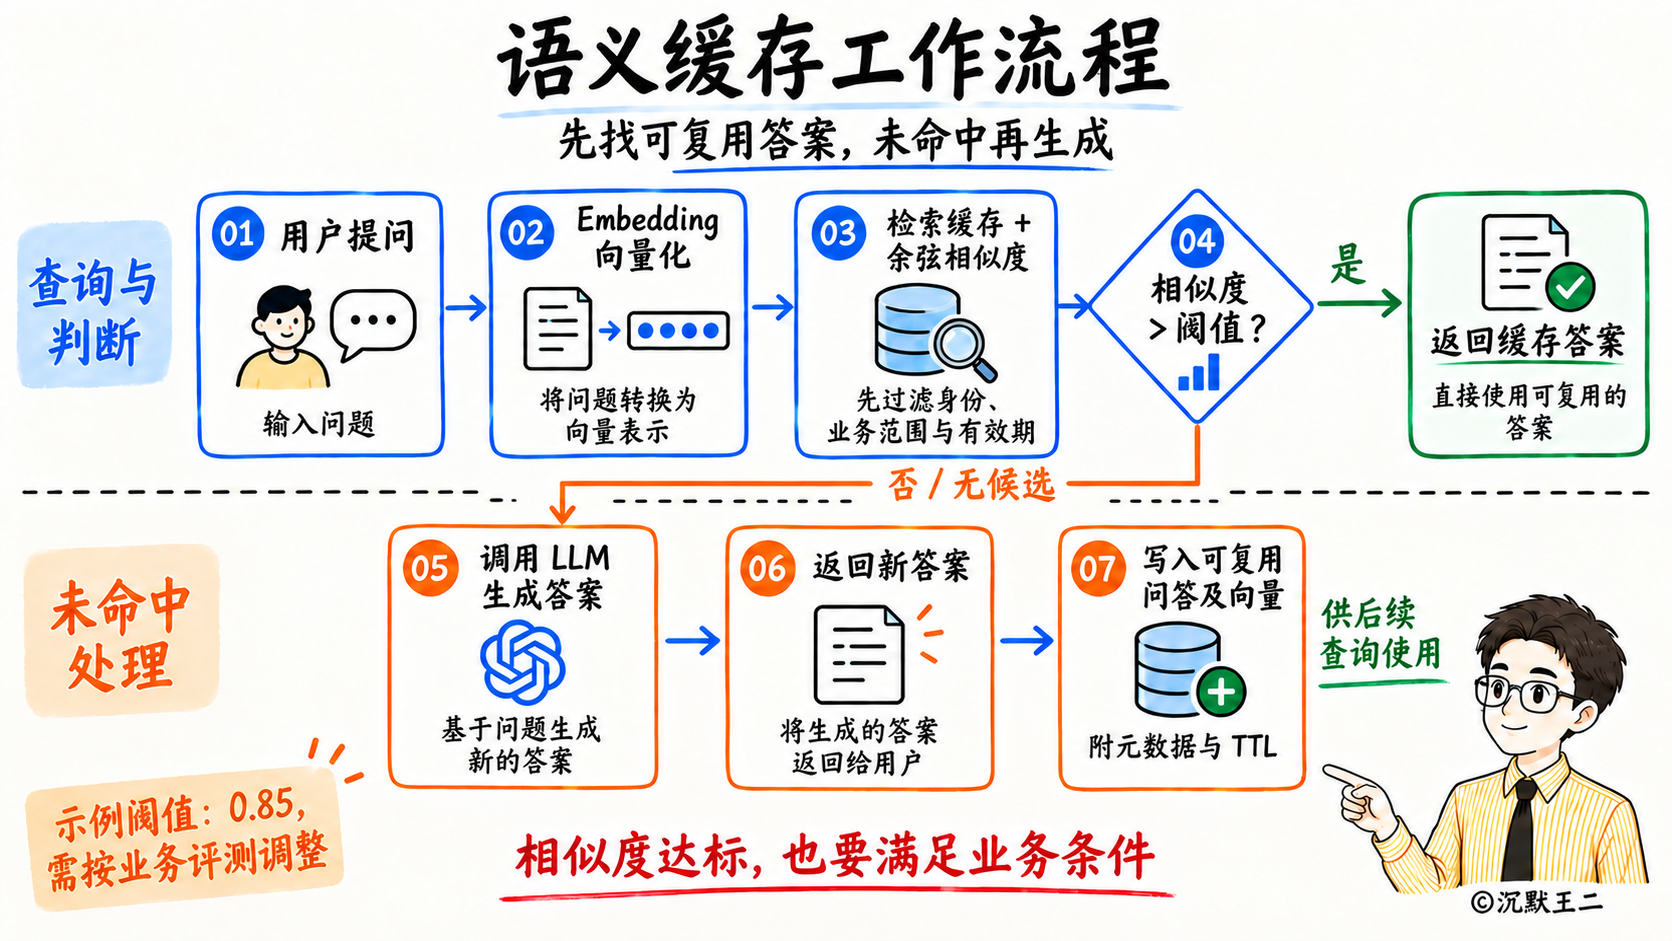
打个比方。精确匹配是按身份证号码找人,语义缓存像凭印象找人,“上次来的那个戴眼镜的,帅得像吴彦祖的小伙子就是你吧”。
那聪明的你肯定又要问了,语义缓存有认错人的风险吧?
答案是肯定的。
但高频重复的问题,既然叫重复,肯定在语义上是高度相似的。客服场景中的“怎么重置密码”和“怎么帮我重置密码”就是高频重复的问题,这种问题问一万遍答案都一样的。
直接用Redis把问题和答案存起来,Embedding 达标后直接返回一般不会有问题。可以稍微加一条,如果答案不是你想要的,请转人工,就兜底成功了。
什么场景不适合用语义缓存呢?
答案会随时间、地域、用户身份变化的场景。比如说“2026 年 Q1 的营收”和“2025 年 Q1 的营收”,余弦相似度超过 0.95,答案却完全不一样。
Embedding 一般都会针对这种问题做专项训练的,所以不用担心。
最后简单总结下。
语义缓存和 KV Cache、Prefix Caching、Prompt Caching 不是一种缓存,虽然名字上都带有 Cache。前三种主要是为了做 LLM 层面的优化。语义缓存更像是一种业务上的优化。
这道题你学会了吗?想解锁更多 AI 硬核知识,点赞关注,我是二哥,咱们下期见!