
宇宙厂员工:坐标北京月base 7.7,年终奖按3个月算,23万股权激励每年30万,总包差不多 145万(附Agent面试题)
有读者给我发来一张截图,问我真假。
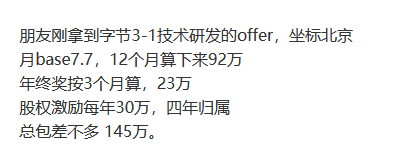
我不置可否。
因为钱多钱少都是别人的,自己能拿到多少才是真的。你认为能激发你的竞争心那最好,如果激发的只是嫉妒心,那无益还有害。
我的朋友中,有一个月几k的,当然也有一个月几W的,还有几十W的,之前去海南旅游朋友还带我认识了一个顶级富哥,我们住的整个酒店都是人家的,我当时还晒了朋友圈。
字节作为国内的顶级互联网大厂,心之所往的不在少数。
一是字节给的钱多,二是字节的产品确实多,尤其是对于新人,成长速度贼快。
我也梳理了一些产品线,大家可以作为参考,也可以自己去研究,作为你的开发惊艳,给自己上上分。
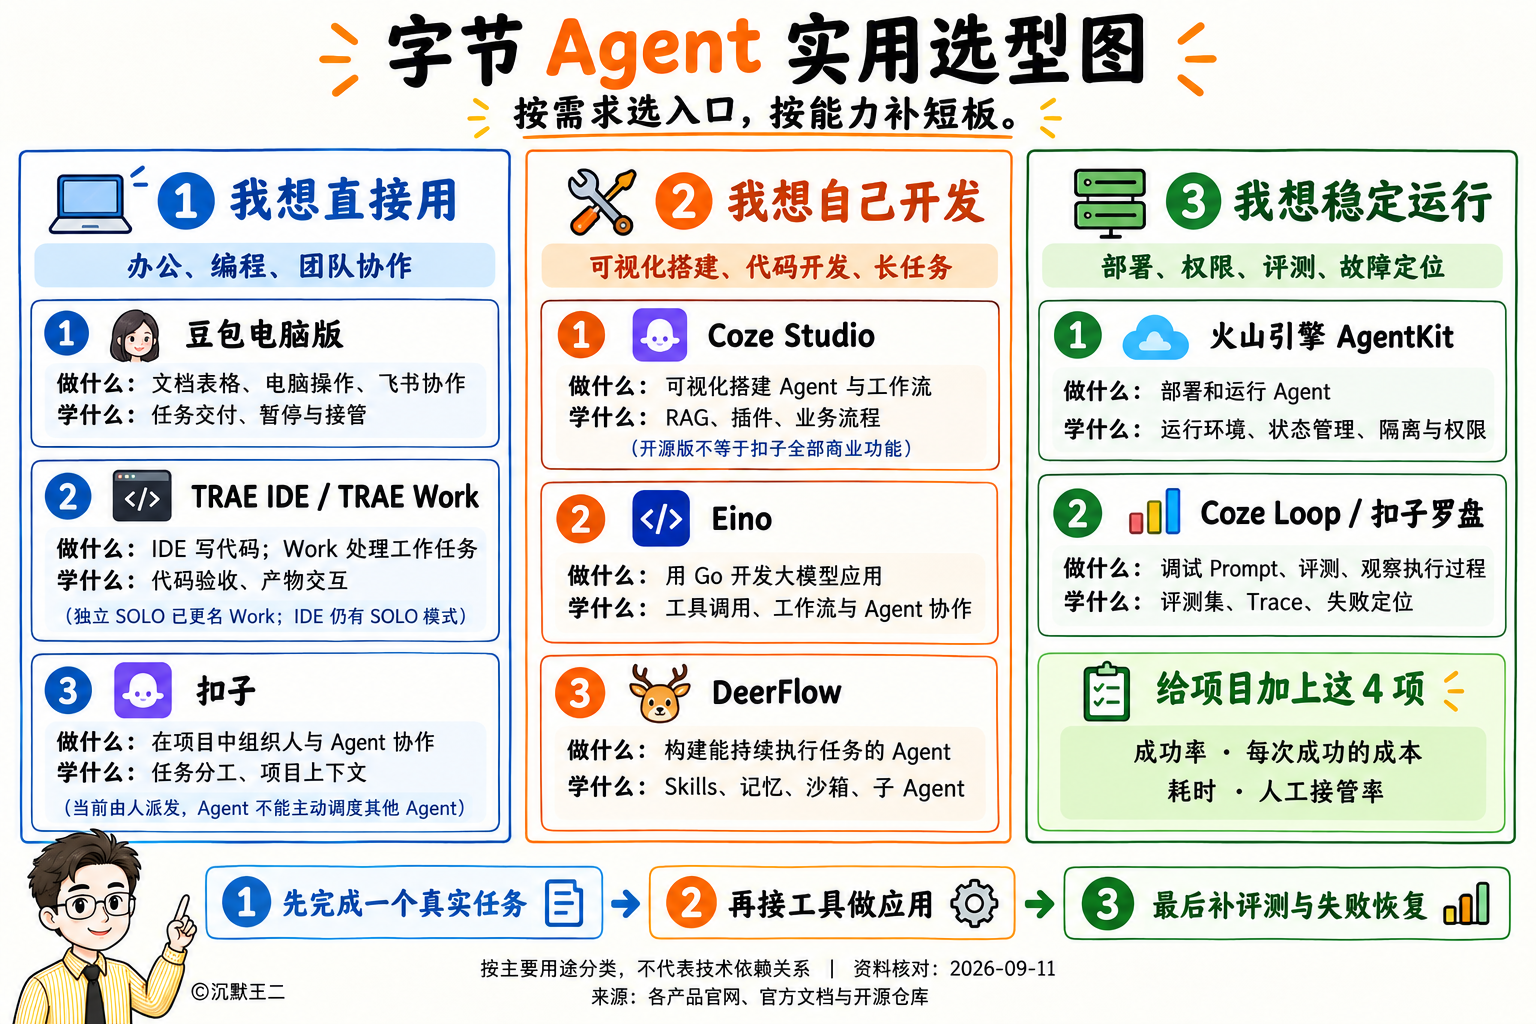
1、字节开源的 DeerFlow 2.0 已围绕子 Agent、持久记忆、沙箱和可扩展的 Skills/工具系统重构。一个 Agent 要持续完成任务,需要保存中间结果、管理工具、处理上下文,并交付可检查的文件或代码。
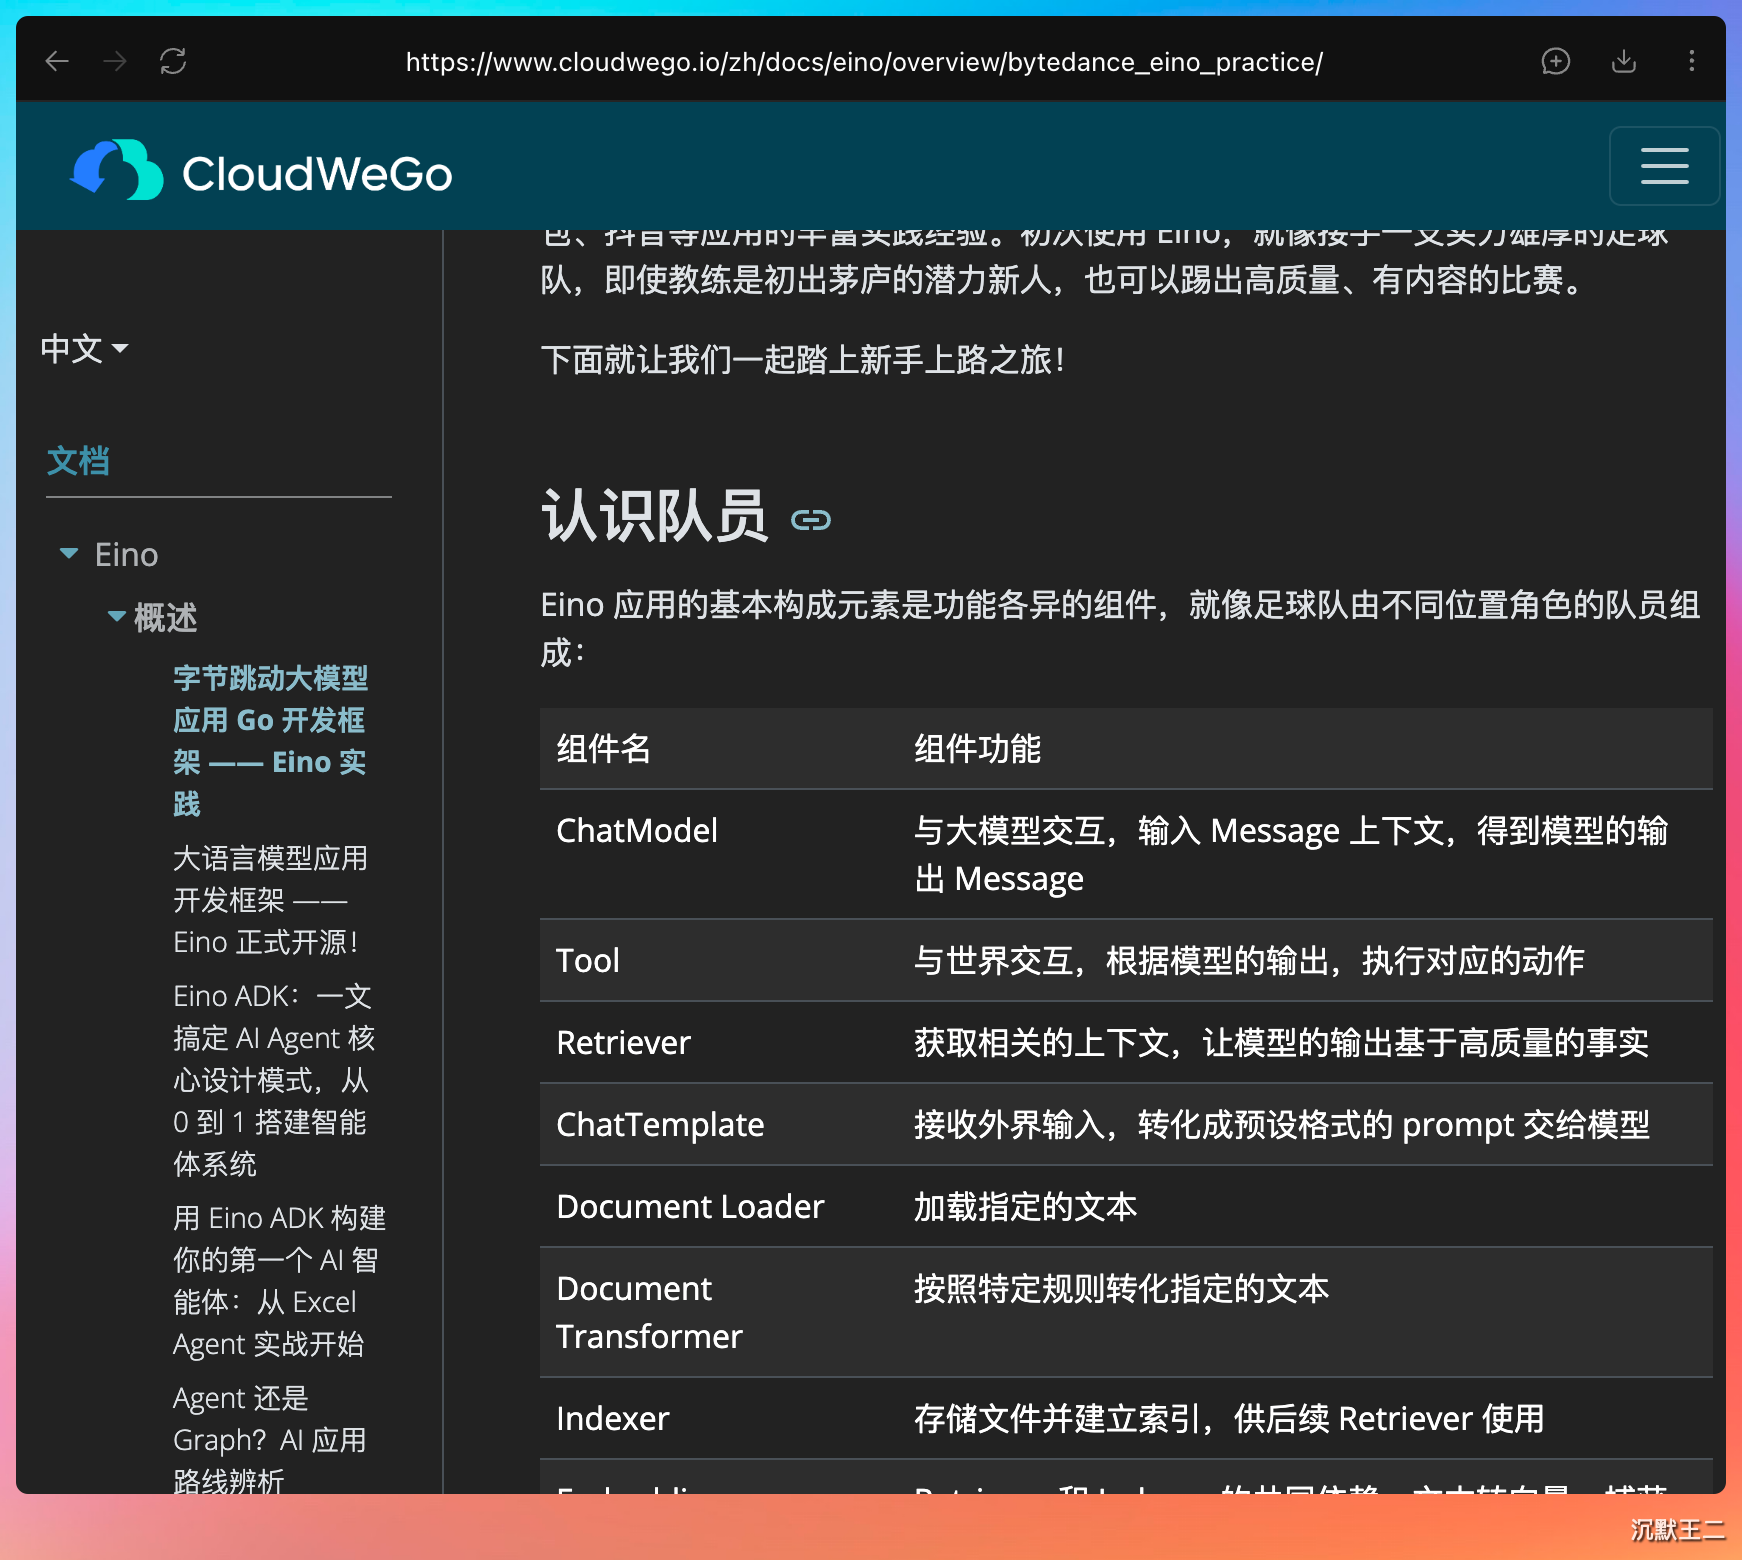
2、Eino 是字节开源的 Go 大模型应用开发框架。官方有一篇非常适合做面试素材的文章,专门讨论 Agent 与 Graph 的关系,并提出将确定性业务流程封装为工具,交给 Agent 调用的组合方式。
https://www.cloudwego.io/docs/eino/overview/bytedance_eino_practice/
3、Coze Studio 开源版提供了 Prompt、RAG、插件、工作流以及 API/SDK 等能力,适合做可视化开发和工程拆解素材。
4、火山引擎 AgentKit 的官方资料覆盖 Agent 构建、部署与运行,涉及运行时、沙箱、会话、记忆及观测等能力。任务在哪运行、状态存在哪里、工具失败如何恢复、不同用户如何隔离都非常值得研究。
如果你是一位愿意相信努力、相信过程、相信一步一个脚印、相信自己能在 AI 时代分一杯羹的人,那接下来这份硬核的面经,希望你能认真读一读。
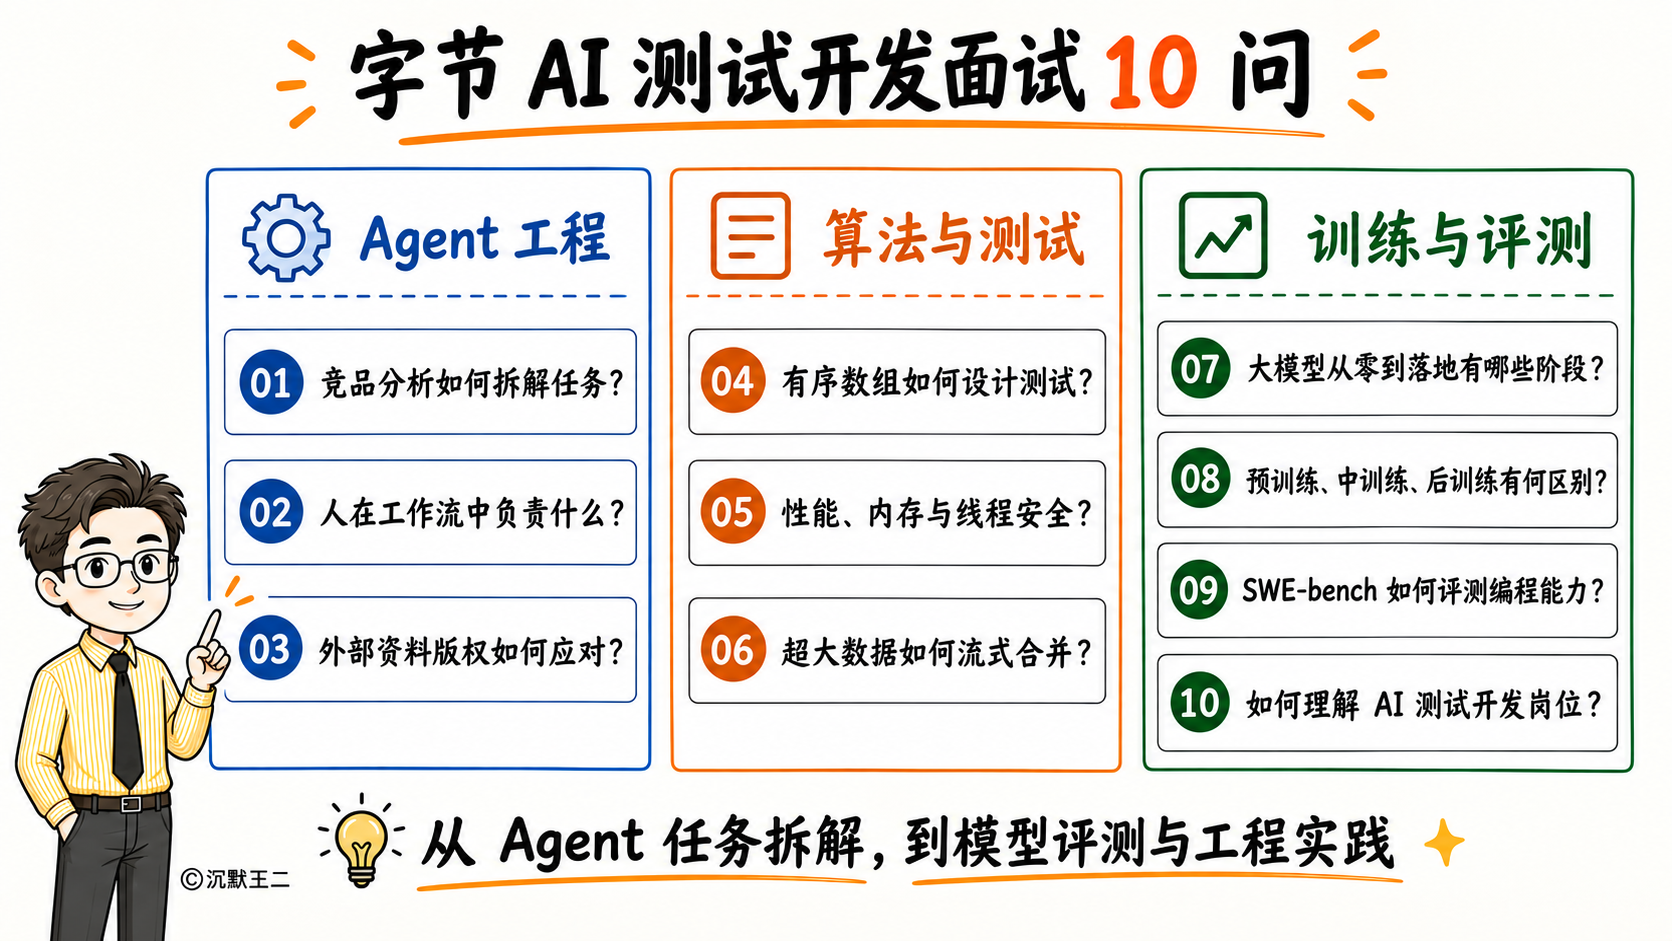
(全文比较肝,保证大家能学到很多很多,系好安全带,我们粗粗粗发~)
content
文中涉及的PaiCLI Agent 已经开源到GitHub,Go版本也有:https://github.com/itwanger/PaiCLI-Python
01、如果让 Agent 完成一份竞品分析报告,你会怎么拆解这个任务?
“第一步,明确分析目标。得先定好要分析哪些竞品、从哪些维度比,比如产品功能、定价策略、用户口碑、技术架构。这一步必须人来定,Agent 不知道哪些维度对业务决策最有价值。”
“第二步,信息采集。这一步适合用多个 Sub-agent 并行处理。一个负责抓竞品官网的产品文档和定价页,一个负责搜技术社区和开发者评价,另外一个去收集应用市场的评分和用户反馈。DeerFlow 2.0 的做法就是这样,Lead Agent 把目标拆成可并行的子任务,派给不同的 Sub-agent 同时执行,最后汇总。”
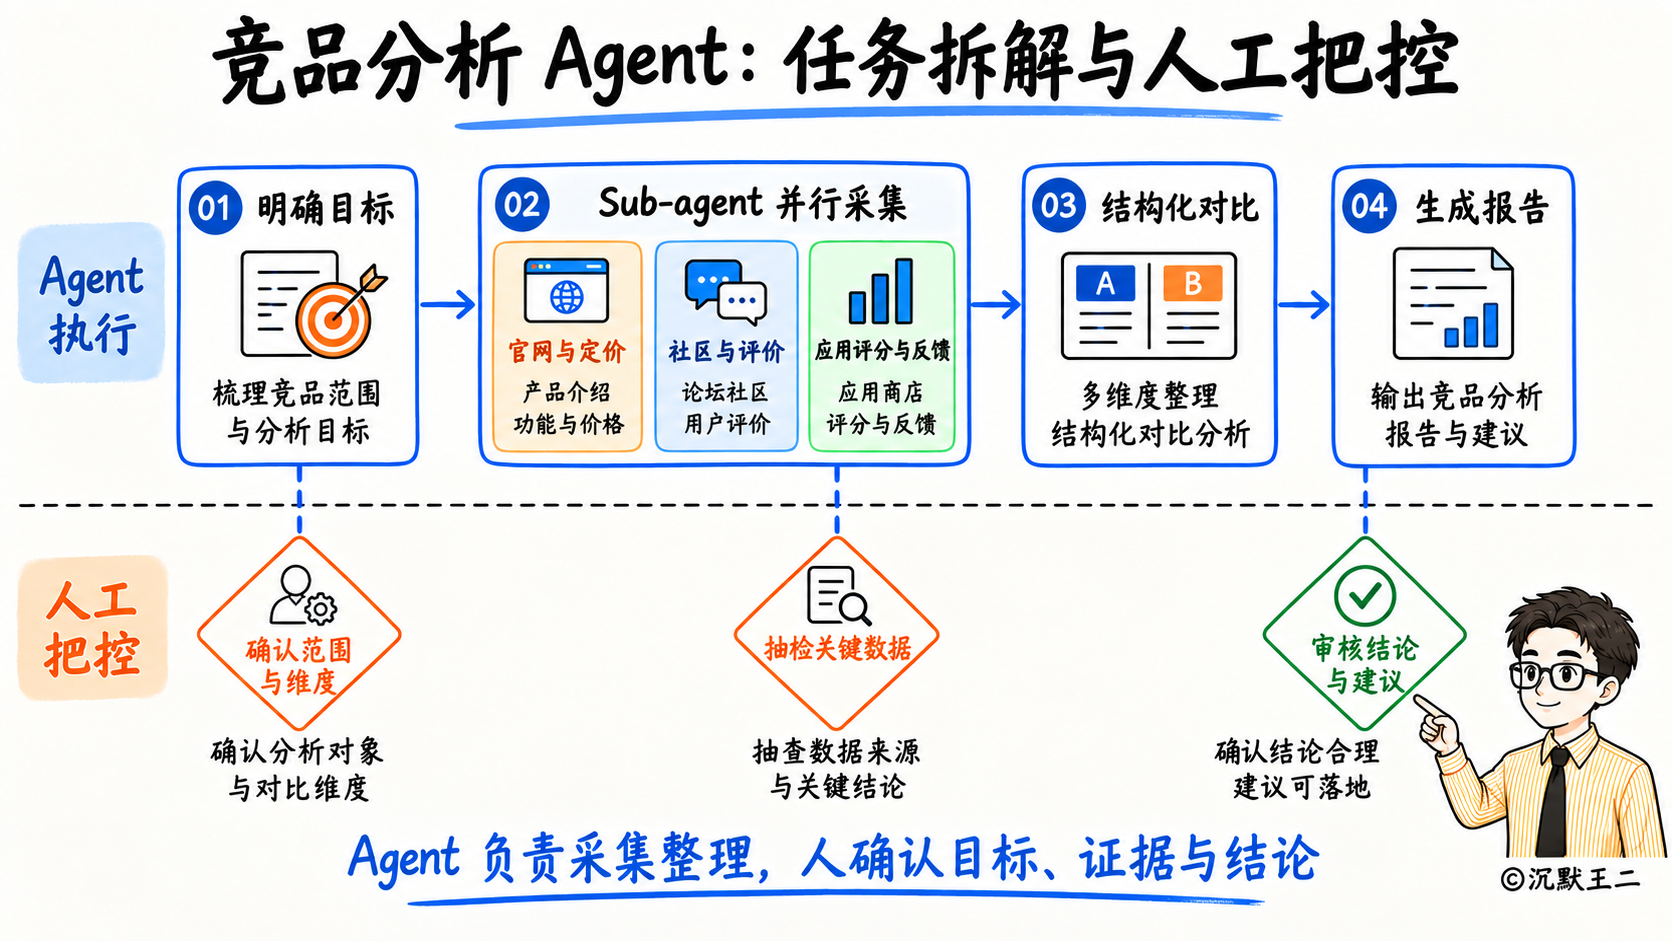
“第三步,把采集回来的原始信息按维度归类,做结构化对比。Agent 可以自动生成对比表格,把差异标注出来。”
“第四步,基于分析结果输出结构化报告,包括对比矩阵、差异点分析、结论建议。”
哪些环节需要人工把控?
“开始之前,要人工确认分析范围和重点维度,以及数据采集完成后的抽检。”
大模型获取竞品销量这类数据,如何判断数据准确性?
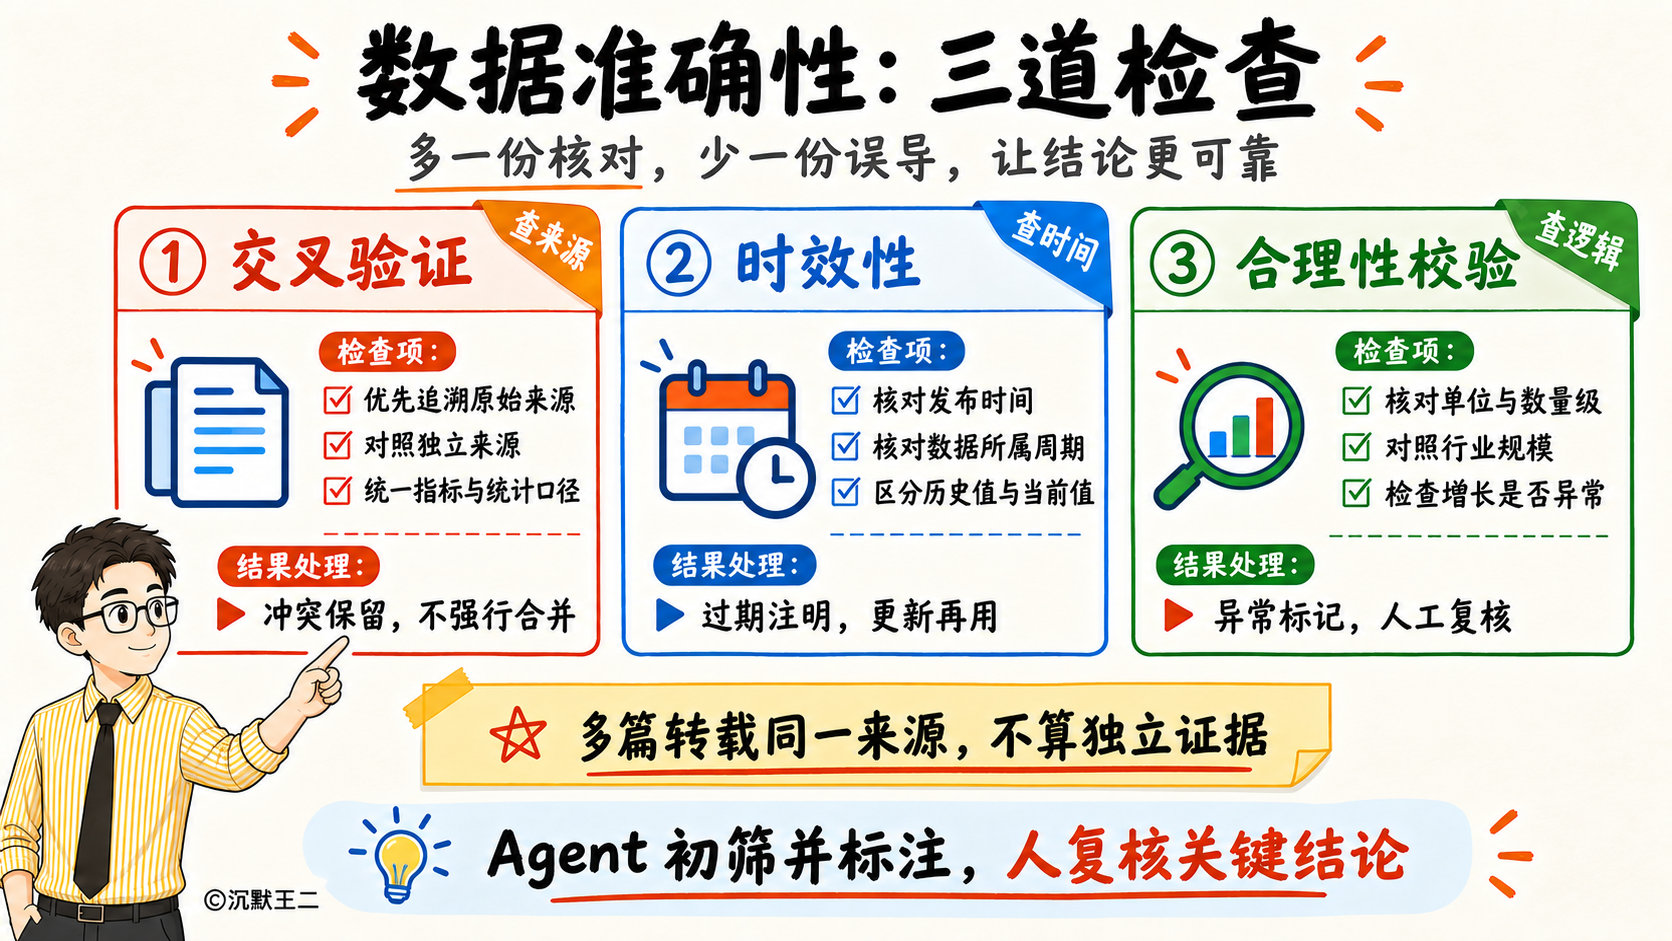
“第一个手段是多源交叉验证。同一个数据从至少两个独立来源获取。官方财报里有月活数据,第三方分析平台也有,两边差不多的可以用。差太多就标注为'数据存在冲突',留给人工判断。”
“第二个是时效性检查。大模型的训练数据有知识截止日期,它给出的销量数据可能是好几个月前的。Agent 必须检查数据的时间戳,过期的标注出来,能联网搜索的就用搜索工具拿最新数据。”
“第三个是合理性校验。用行业常识做初筛。”
02、在这套 Agent 工作流里,人的核心作用是什么?
“第一个是定目标。Agent 能采集、分析、生成报告,但需要我们告诉他一个目标任务。”
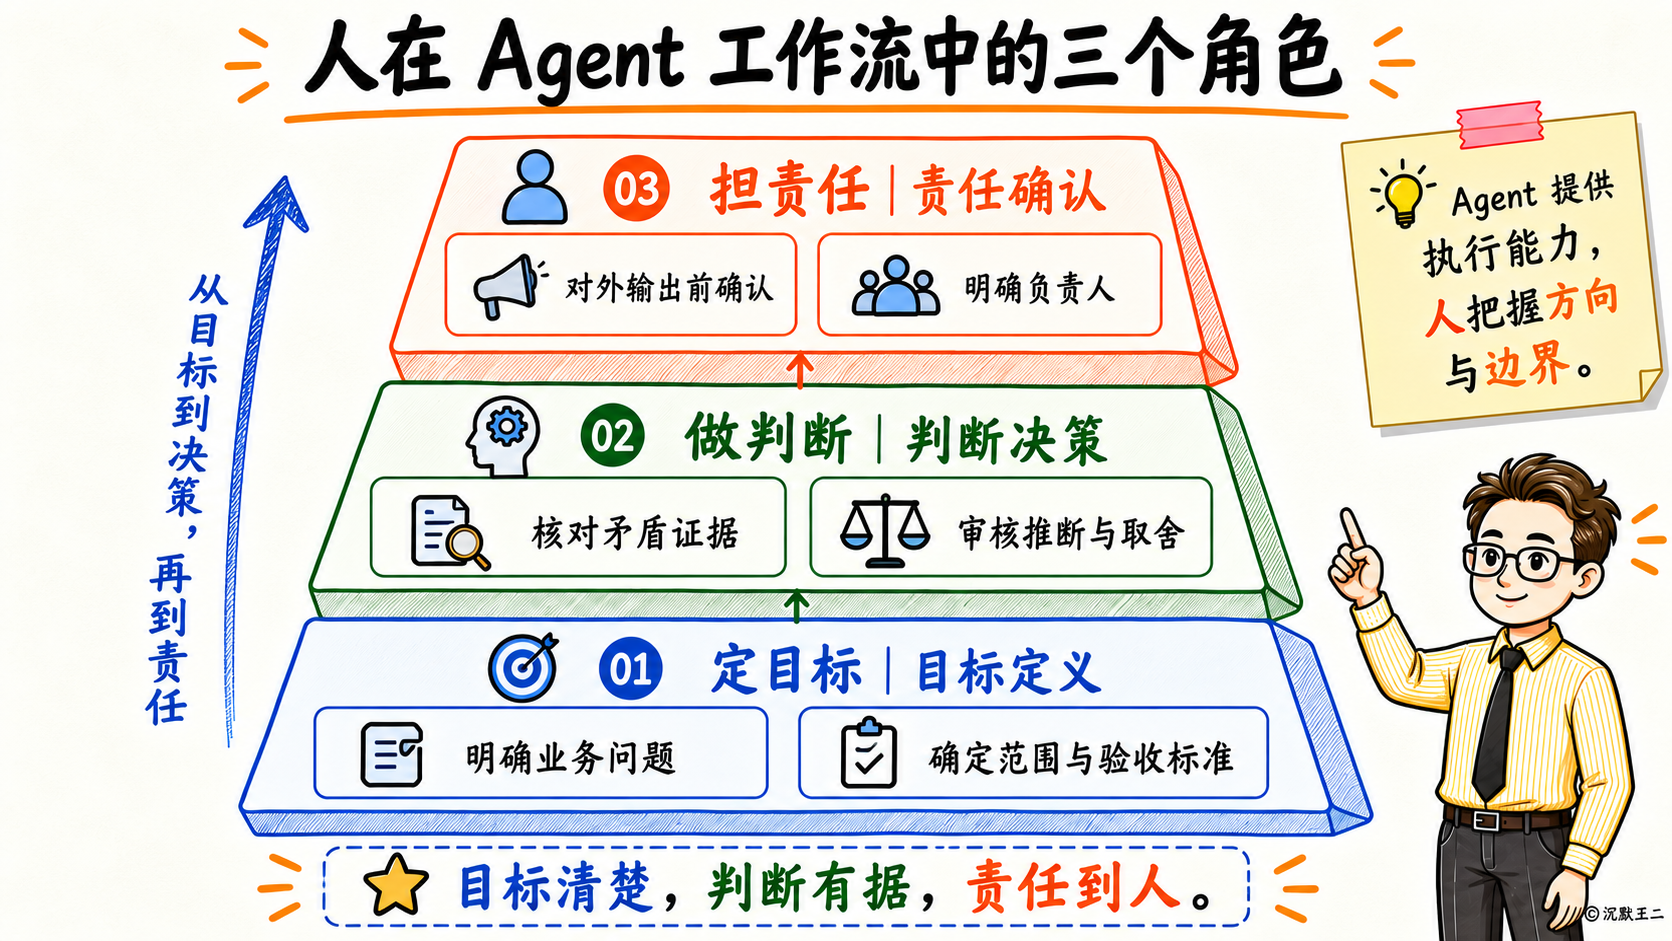
“第二个是做判断。第三个是担责任。报告如果要给老板看、给客户看,里面每一个结论都得有人背书。Agent 生成的内容,发出去之前人必须确认过。”
03、使用大模型检索外部资料,如何应对版权风险,有哪些识别、规避手段?
“先说识别。”
“Agent 检索到的每一段内容,都要记录来自哪个网站、哪篇文章、什么时间发布的。没有来源信息的内容不能用。”
“然后看内容的发布协议,CC BY 协议的可以引用但必须标注作者,CC BY-NC 的不能用于商业用途,付费内容和有明确版权声明的一律不碰。”
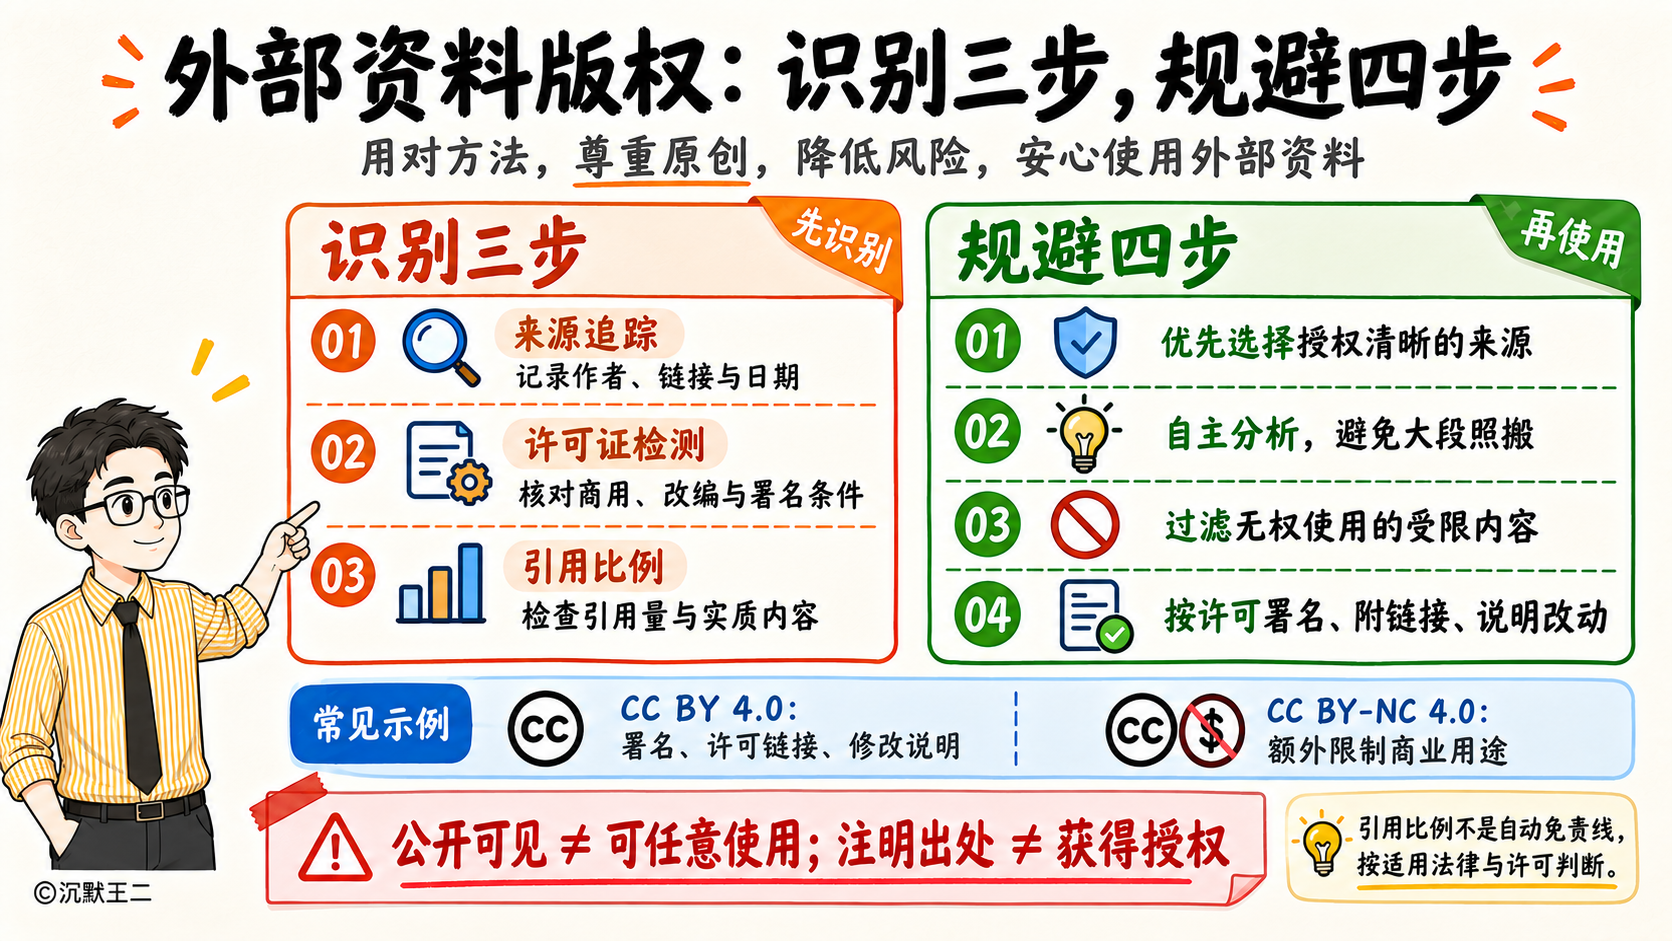
“就算内容来源合规,大段原文复制也有侵权风险。”
“再说规避手段。”
“优先用公开数据源。开源文档、企业官方白皮书,这些版权风险最低。”
“检索结果要做二次加工。Agent 理解内容之后用自己的方式表述,不要原文搬运。”
“所有引用都标注出处。附上来源链接,读者可以自己去验证。”
04、合并有序数组这个函数,该怎么设计测试用例?
“第一类是正常路径,验证基本功能。”
// 标准合并
assertArrayEquals(new int[]{1,2,3,4,5,6},
    merge(new int[]{1,3,5}, new int[]{2,4,6}));

// 有重复元素
assertArrayEquals(new int[]{1,2,2,3,3,4},
    merge(new int[]{1,2,3}, new int[]{2,3,4}));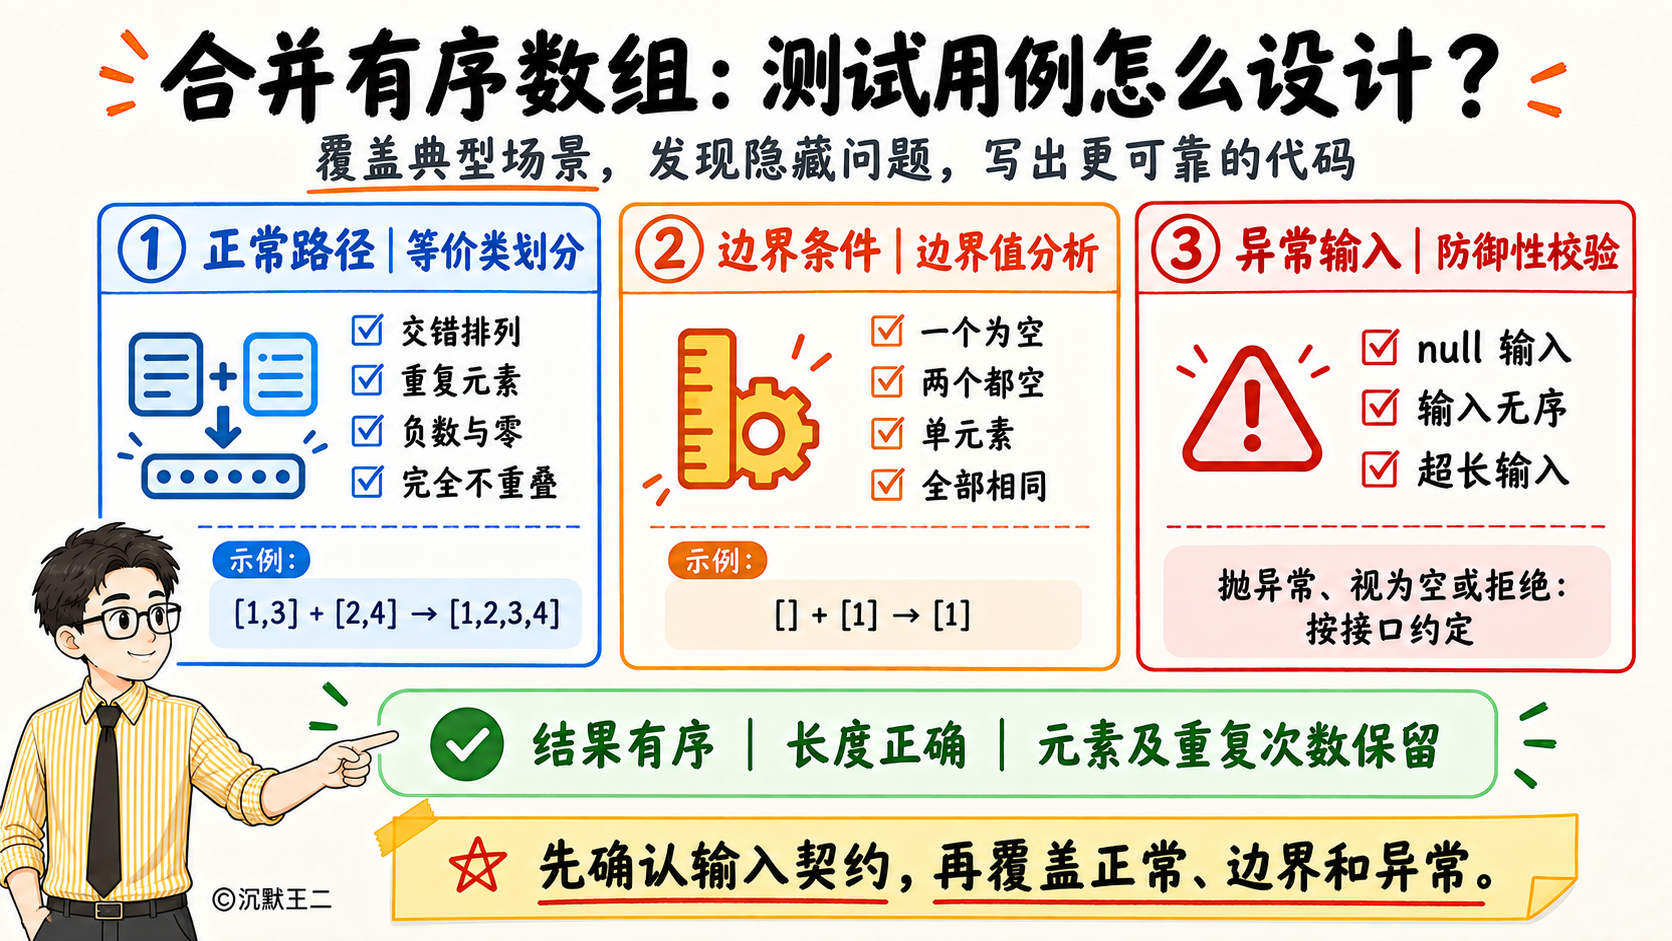
“第二类是边界条件。”
“第三类是异常输入。null 怎么处理、传进来一个无序数组怎么办。”
// null 输入,当作空数组处理
assertArrayEquals(new int[]{1,2,3},
    merge(null, new int[]{1,2,3}));
05、合并有序数组,考虑大量数据场景,如何处理性能、内存、线程安全问题?
“性能方面,双指针是最优解,时间复杂度 O(m+n)。两个指针分别从两个数组头部开始,每次比较取较小的放进结果数组,指针往后移一位。”
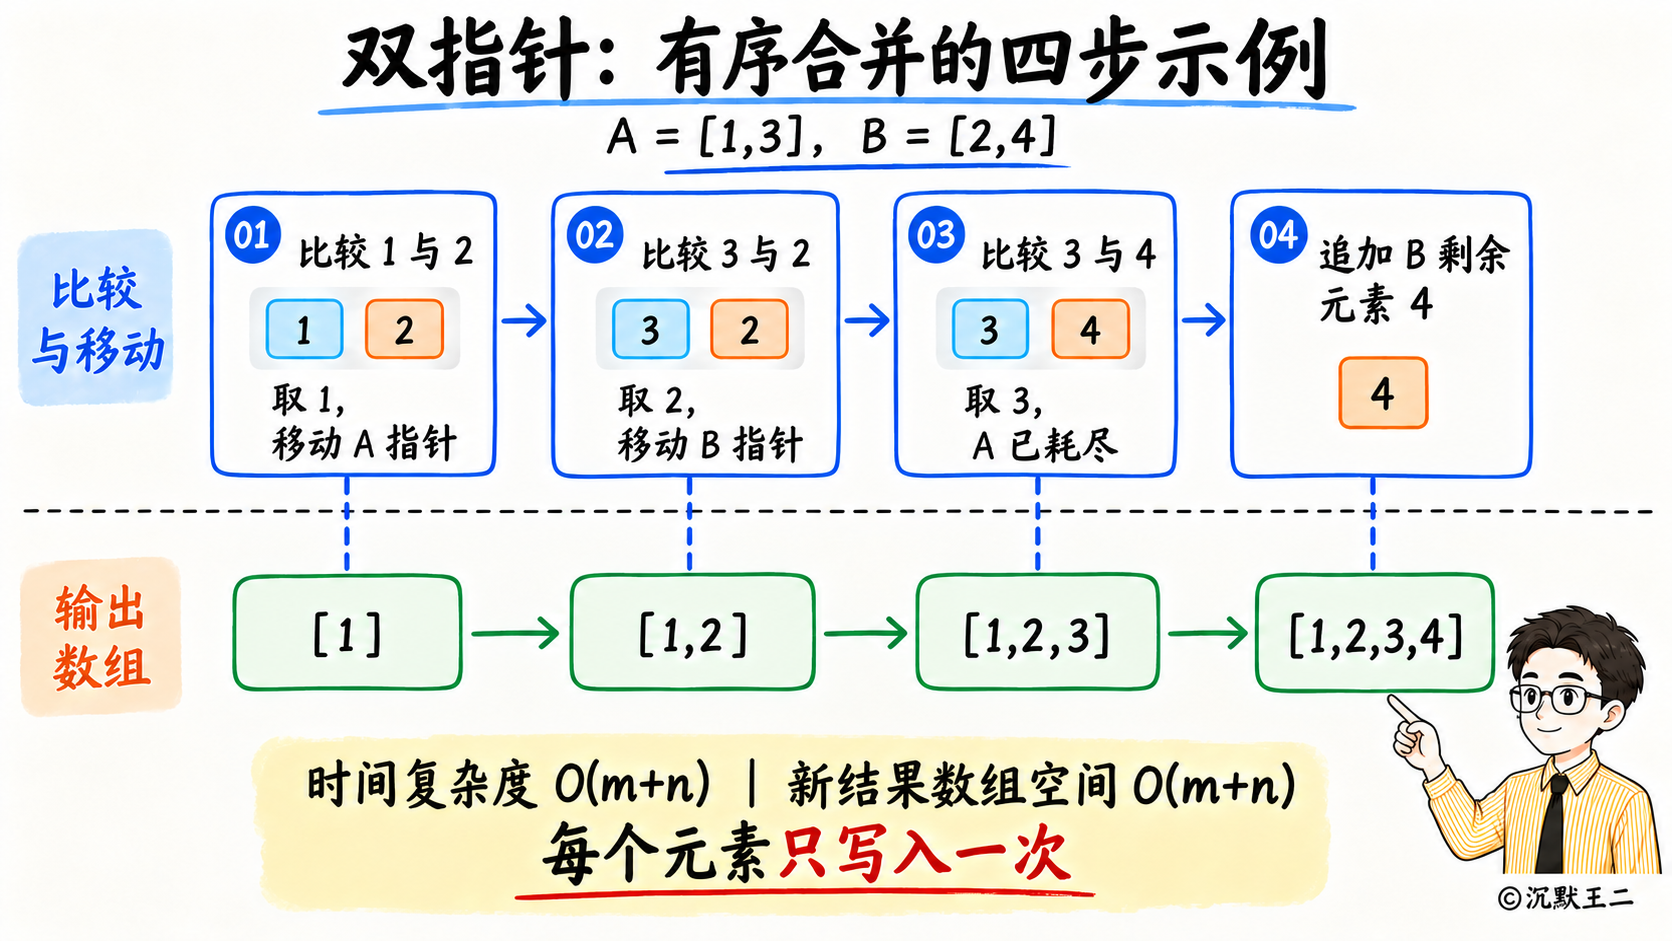
“内存方面,如果其中一个数组末尾有预留空间,可以从后往前填充。”
“数据量大的时候,可以用流式处理,内存里只保留当前比较的两个元素和一个输出缓冲区。”
“线程安全方面,最简单的做法是保持输入数组只读,结果写到一个新数组。输入不修改、输出不共享。”
06、如果两个有序数组数据量极大(百万级别),该怎么优化处理?
“一百万个 int,一个数组差不多 4MB,两个加起来 8MB,直接双指针就行,不需要特殊优化。”
“但如果是百万个复杂对象,或者数据存在磁盘上、或者网络。就需要分块读取加流式合并,可以借鉴外部排序(External Sort)的思路。”
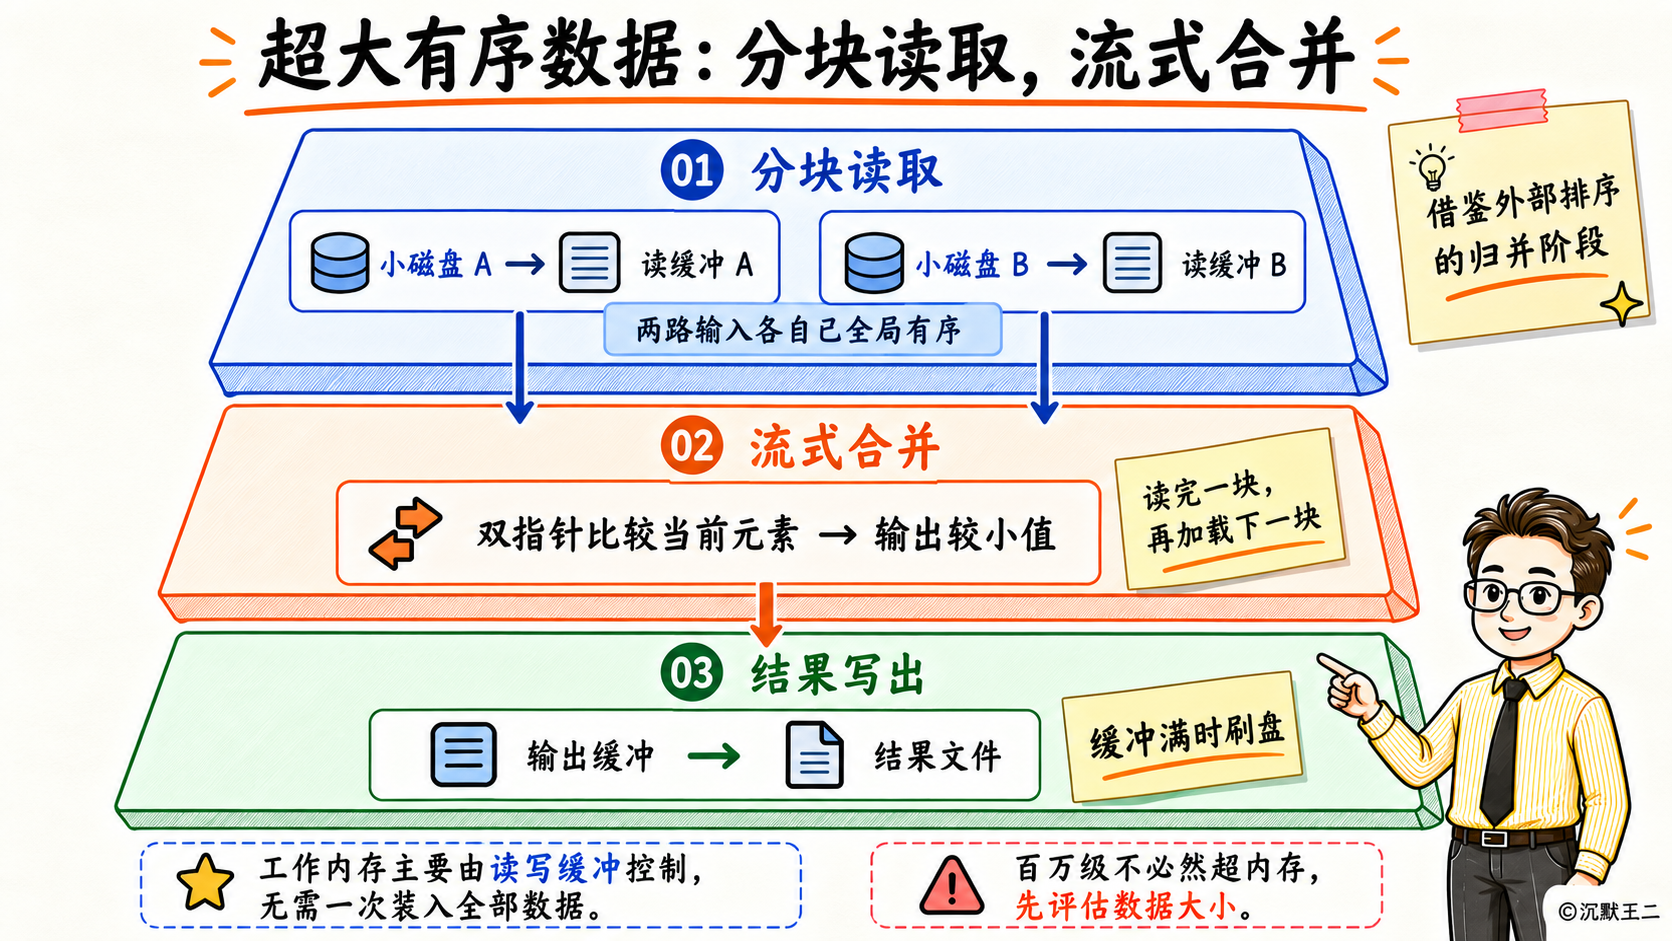
“每个数组分配一个读缓冲区,比如 64MB。每次从磁盘读一块数据到缓冲区,双指针在缓冲区之间做合并,合并结果写到输出缓冲区。输出缓冲区满了就刷到磁盘,某个输入缓冲区读完了就从磁盘加载下一块。全程内存占用就是两个读缓冲区加一个写缓冲区的大小,跟总数据量无关。”
“进一步提速的话,可以用内存映射文件(mmap)。让操作系统自动管理页面调度,省去手动管理缓冲区的麻烦。”
07、讲讲大模型训练相关知识,大模型从零开发到可落地使用,完整经历哪些阶段?
“第一个阶段是数据准备。从互联网采集文本、代码、书籍,做清洗、去重、过滤有害内容。数据质量决定模型质量。”
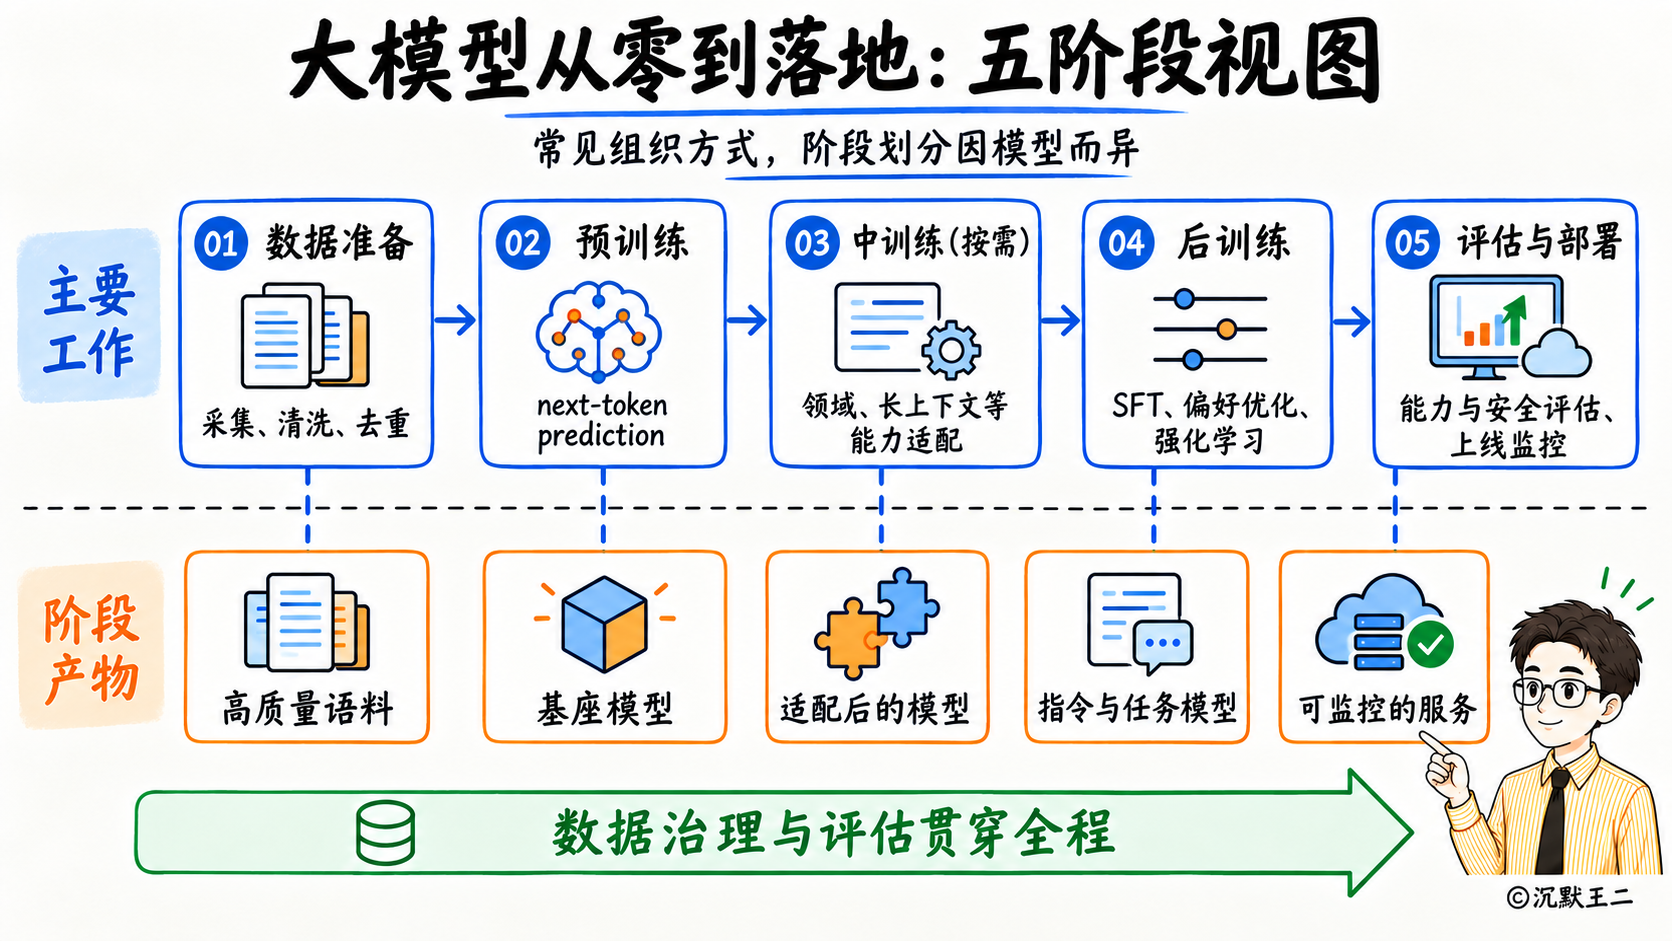
“第二个是预训练。用处理好的数据训练基座模型,这个阶段消耗的算力最多。”
“第三个是 Mid-training,目的是在保留通用能力的前提下注入领域知识,或者扩展上下文窗口。做法是把原始预训练数据和新数据按比例混合继续训练。”
“第四个是后训练(Post-training)。包括 SFT(监督微调)、RLHF(基于人类反馈的强化学习)、DPO(直接偏好优化)这些。”
“第五个是评估和部署。跑基准测试验证能力,做安全评估和红队攻防,通过之后上线。上线之后还要持续监控,发现问题及时迭代。”
08、预训练、中训练、后训练目标是什么?包含哪些内容?主要解决什么问题?
“预训练的目标是让模型学会语言本身的规律。”
“训练方式就是不断地预测下一个 token。输入'今天天气',模型要预测下一个最可能的 token 是'真好'还是'不错'还是别的什么。用万亿级别的 token 量喂出来,模型就具备了基本的语言理解和生成能力。”
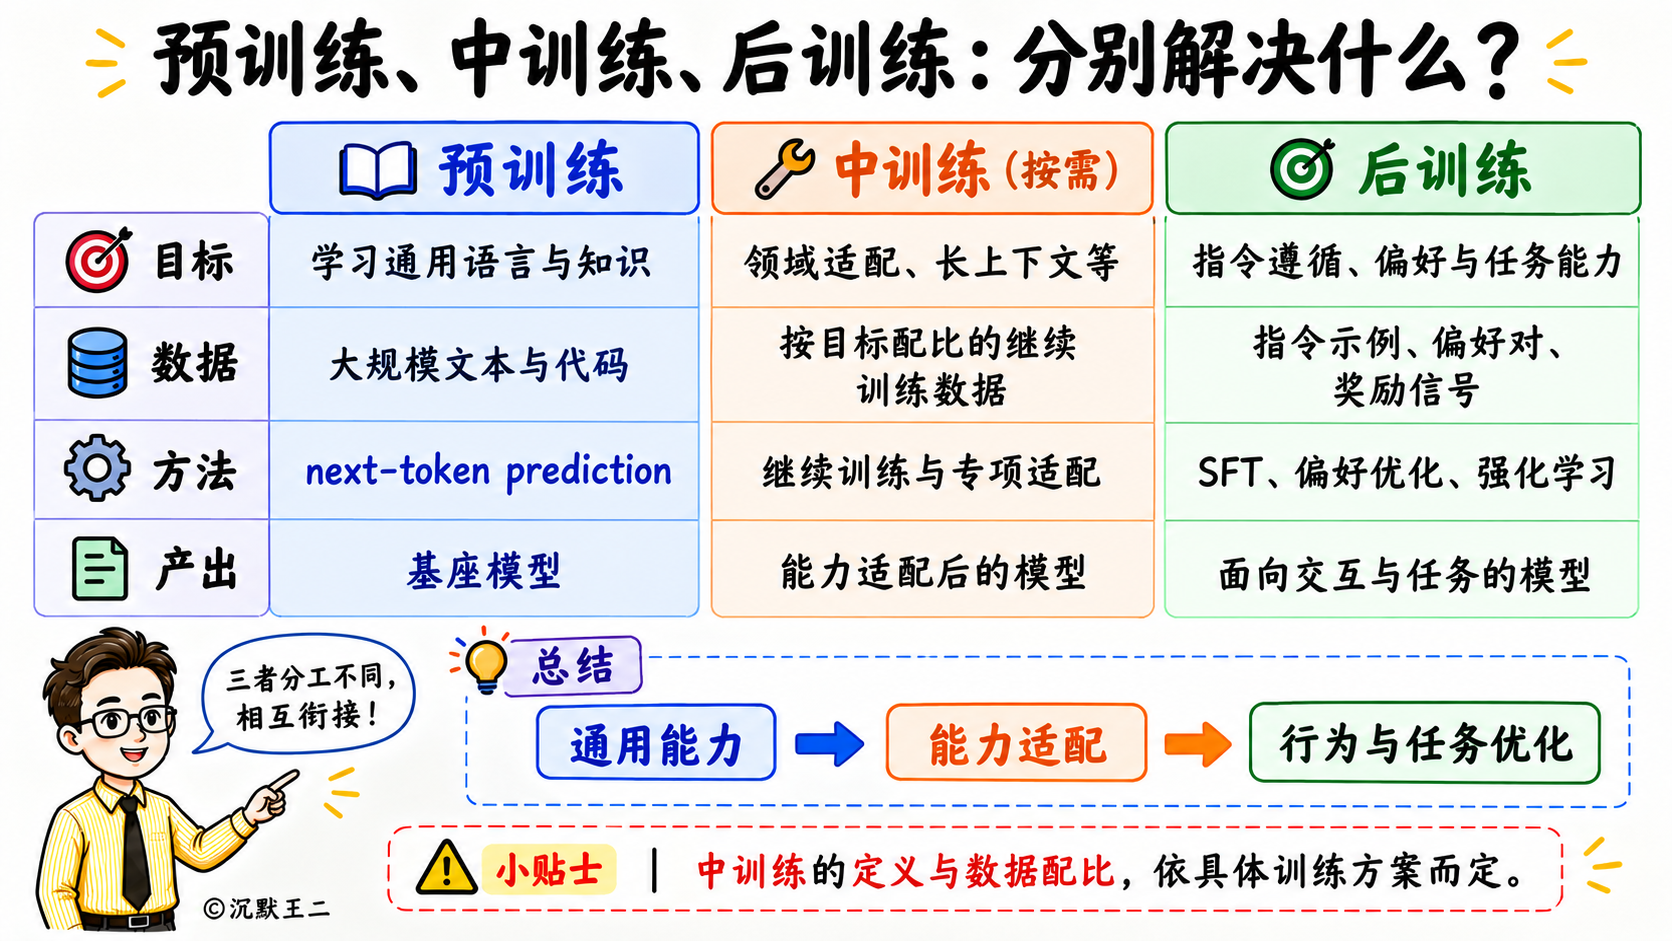
“预训练出来的基座模型能生成流畅的文本,但它不会回答问题,不会拒绝有害请求,也不知道该用什么格式输出。就像一个读了很多书但没上过班的人,有知识,但不会干活。”
“中训练解决的是领域适配问题。”
“比如要让模型掌握最新的知识,或者增强在医疗、法律某个垂直领域的能力,就需要中训练。做法是把原始预训练数据和新数据按比例混合继续训练,新数据占的比例不能太高,大部分还是用原来的数据。”
为什么不能全用新数据?
“因为会导致灾难性遗忘(Catastrophic Forgetting),模型学了新的把旧的忘了。混合训练就是为了避免这个问题,让模型学新东西的同时保住原来的通用能力。”
“后训练的目标是让模型从'能说话'变成'能干活'。”
“第一步是 SFT,用精心标注的问答对教模型遵循指令。”
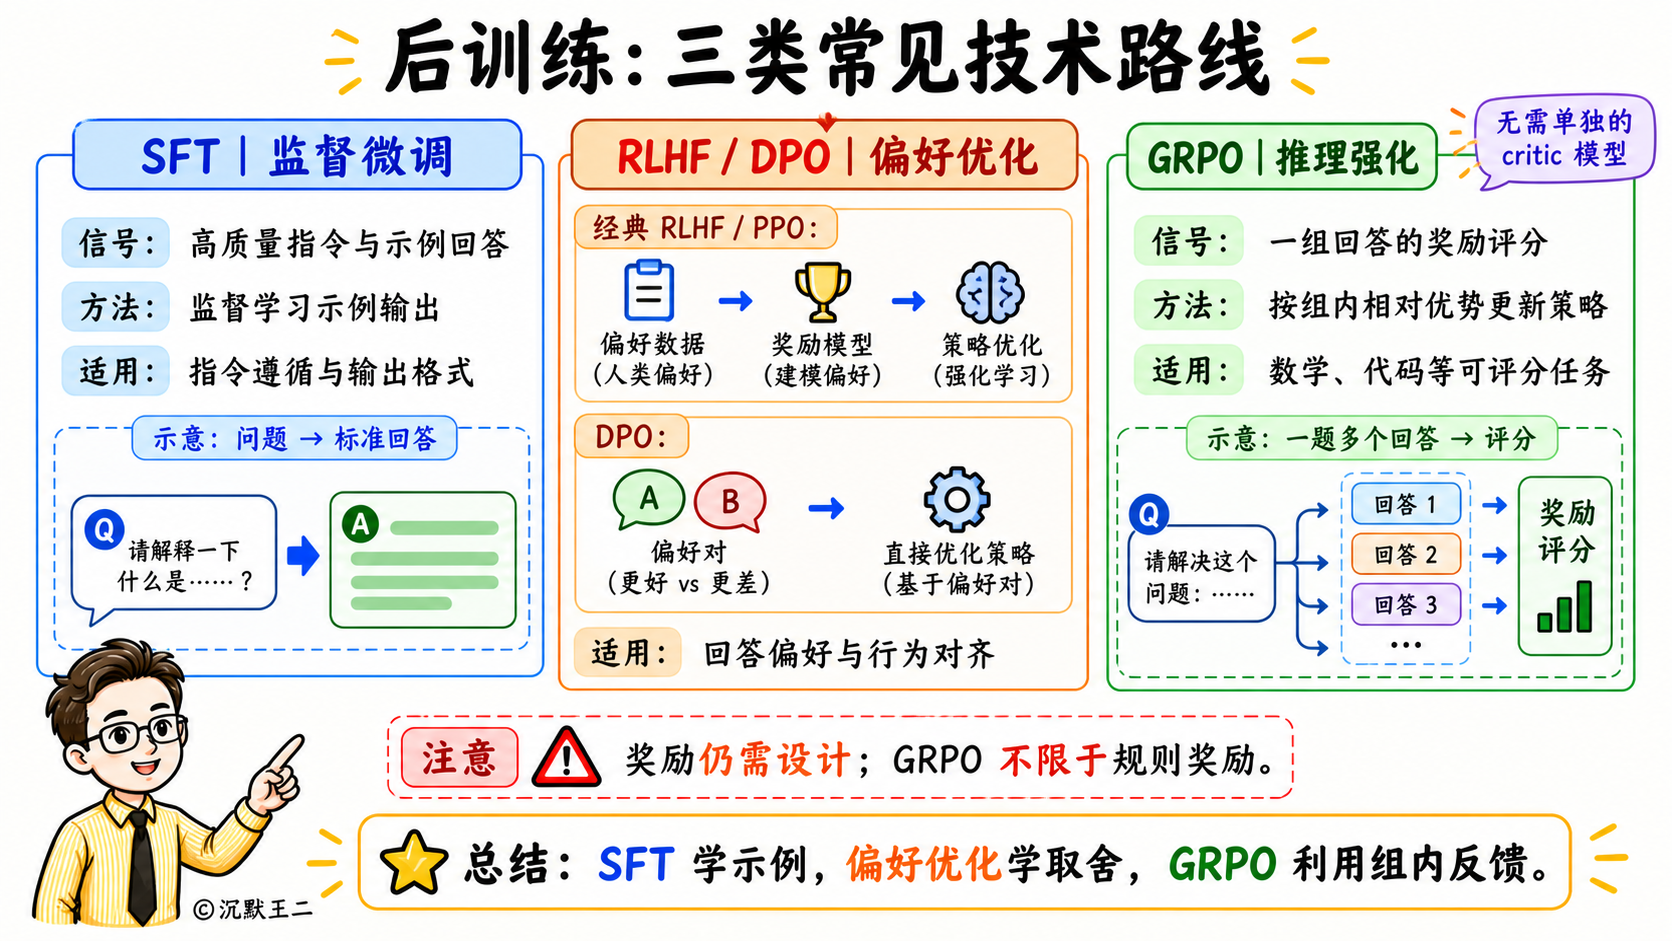
“第二步是偏好优化。RLHF 是经典方案,让人类评判模型的多个回答,训练一个奖励模型(Reward Model),再用 PPO 算法让模型学会生成人类偏好的回答。DPO 是 RLHF 的简化版,不需要单独训练奖励模型,直接拿偏好数据做优化,效果差不多但成本低很多。”
“GRPO 是 DeepSeek 提出来的,专门用于训练推理模型。让模型生成多个回答,用可验证的正确答案(比如数学题的解、代码的测试结果)来打分,不需要人工标注。DeepSeek-R1 就是这么训出来的。”
09、了解 SWE 数据集吗?
“SWE-bench 是目前评估 AI 编程 Agent 最权威的基准。”
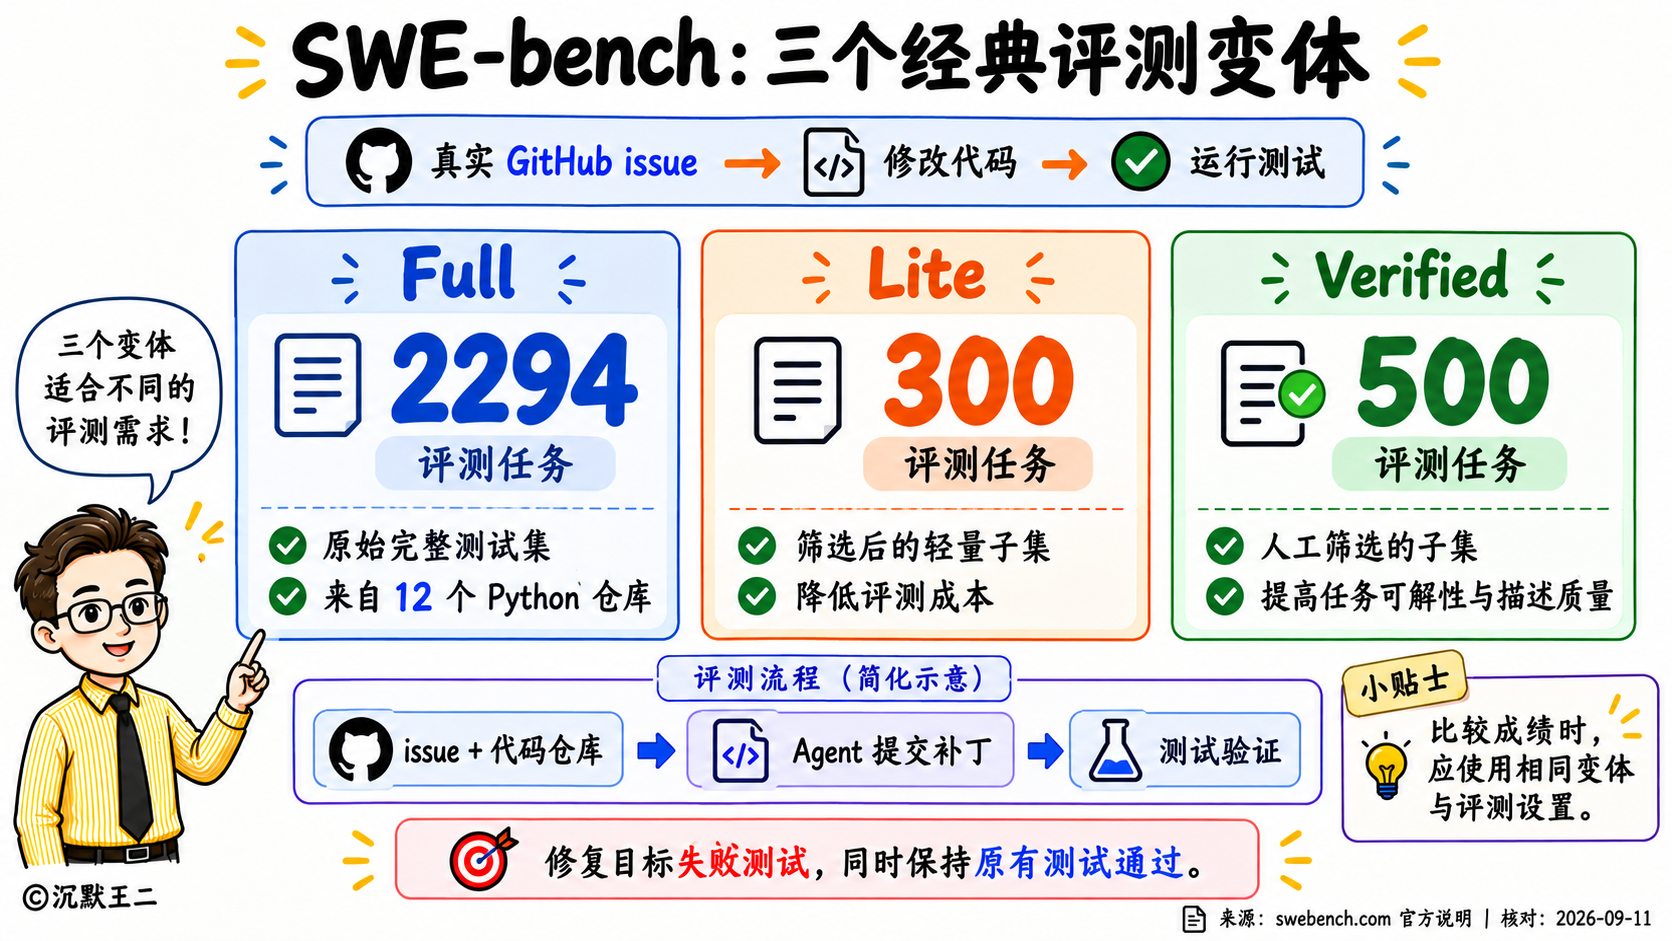
“数据来源于 12 个 Python 开源项目的真实 GitHub issue,一共 2294 个任务。每个任务给你一个 issue 描述和对应的代码仓库,AI Agent 需要读懂 issue、定位代码、写出修复补丁,让原本失败的测试通过。”
10、你投递的岗位是什么,对 AI 测试开发岗位怎么理解?
“我投递的是 AI 测试开发。”
“传统测试验证的是确定性逻辑,输入 A 预期输出 B。AI 系统不一样,模型输出是概率性的,同一个输入跑两次可能得到不同的结果。所以 AI 测试开发做的事情,是构建评测体系。”
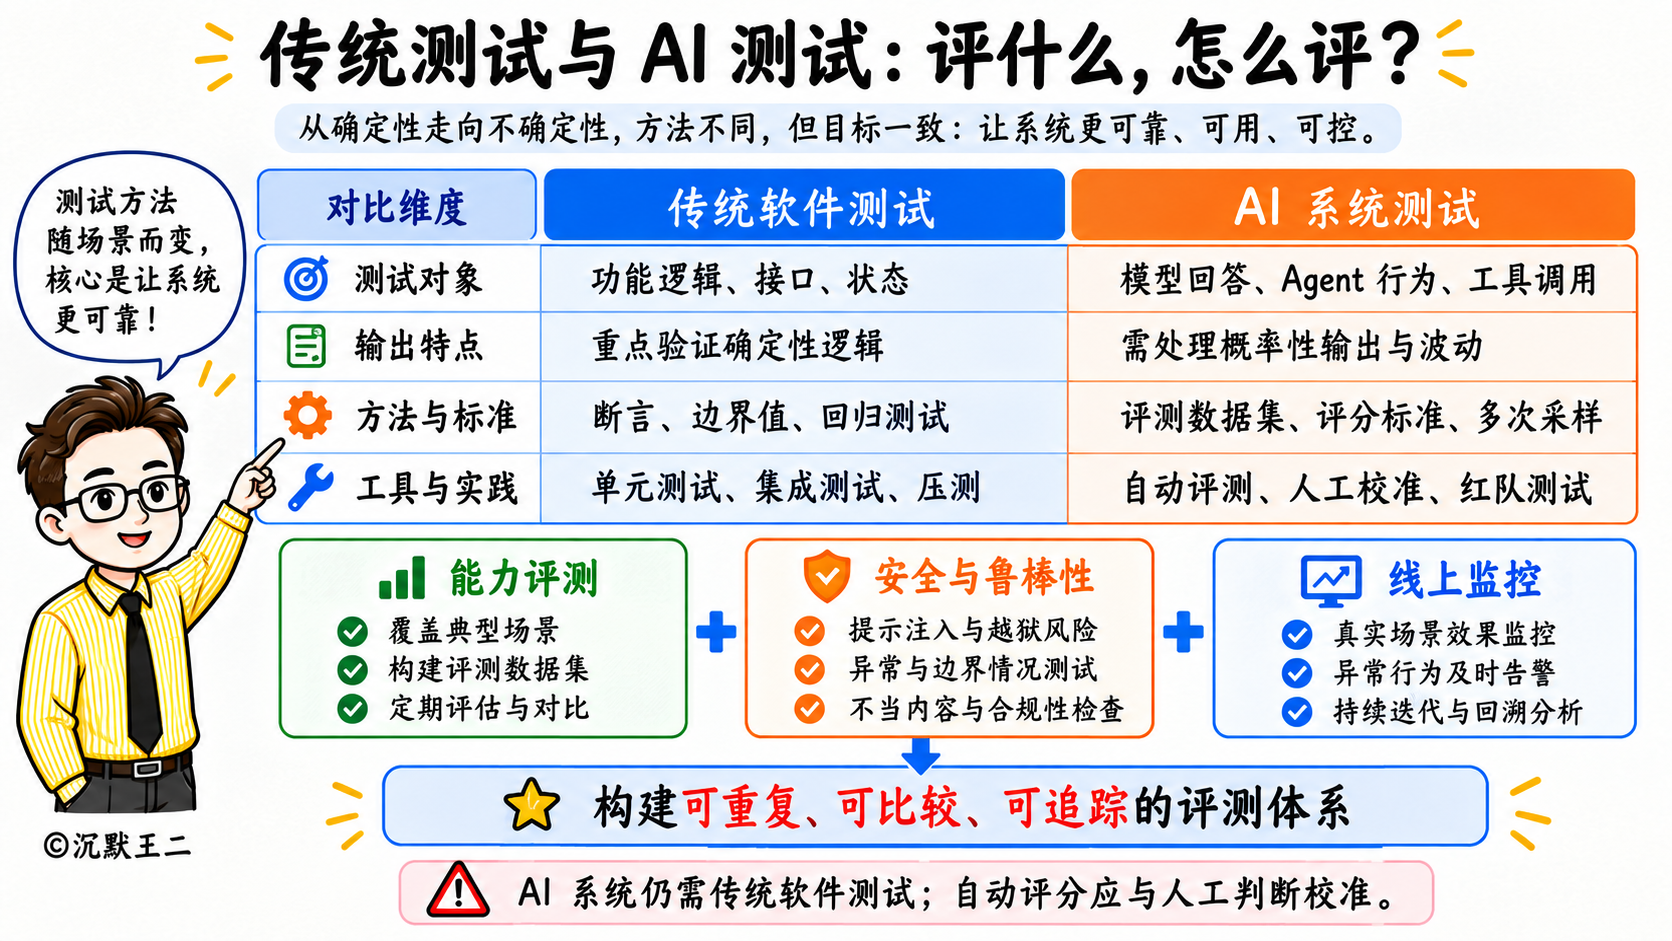
“第一块是评测数据集的建设。针对模型不同维度的能力,比如指令遵循、代码生成、多轮对话、安全性,分别构建测试集。每个测试集要有明确的评分标准,可以是精确匹配,也可以是 LLM-as-Judge 自动打分。”
“第二块是自动化评测流水线。模型每次迭代都要跑一遍完整评测,生成对比报告,哪些能力提升了、哪些回退了,要搞清楚。”
“第三块是红队测试。主动找模型弱点,构造对抗性输入,测模型在极端情况下会不会出问题。比如说能不能被诱导输出有害内容、会不会泄露训练数据,这些都要覆盖。”
“第四块是线上监控。模型上线之后持续追踪回答质量和用户满意度,发现异常 case 及时反馈给训练团队。”
ending
每个时代都有属于自己的幸运儿。
而我们要做的,就是成为AI时代的幸运儿。
人的一生,总要创造出一些价值,留下一些痕迹,才能不碌碌无为。
模型能力的提升,反而放大了我们这群普通人的能力上限,不是吗?
与其想那些杂七杂八的东西,不如踏踏实实每天进步一点点,不管你的薪资是 7.7 w 还是 7.7k,也不管你在互联网大厂,还是普普通通的小公司,只要你做出改变,并持之以恒,我想你就会成为这个时代的弄潮儿。
希望今天这篇内容,你又能收获亿点点(😄~