
张江芯片员工:32岁税前80个,没有互联网那么卷,现在国产卡都在招人,算是踩中这波算力红利了(附Agent面试题)
看到标题这条帖子,32 岁在张江做芯片相关研发,税前 80 万,还没有互联网那么卷。
我身边有几个在张江上班的朋友,状态确实都还不错。以前大家聊起高薪,第一反应总是去互联网大厂卷业务。但随着 AI 的发展,大家发现,底层算力越来越紧俏,离硬件近的地方反而成了香饽饽。
很多人看到芯片这两个字,本能地觉得那是画电路板、搞硬件的事,我告诉你,招得最多、缺口最大的,恰恰是夹在硬件和大模型之间的软件全栈工程师,尤其是 AI 编译器和算子开发。
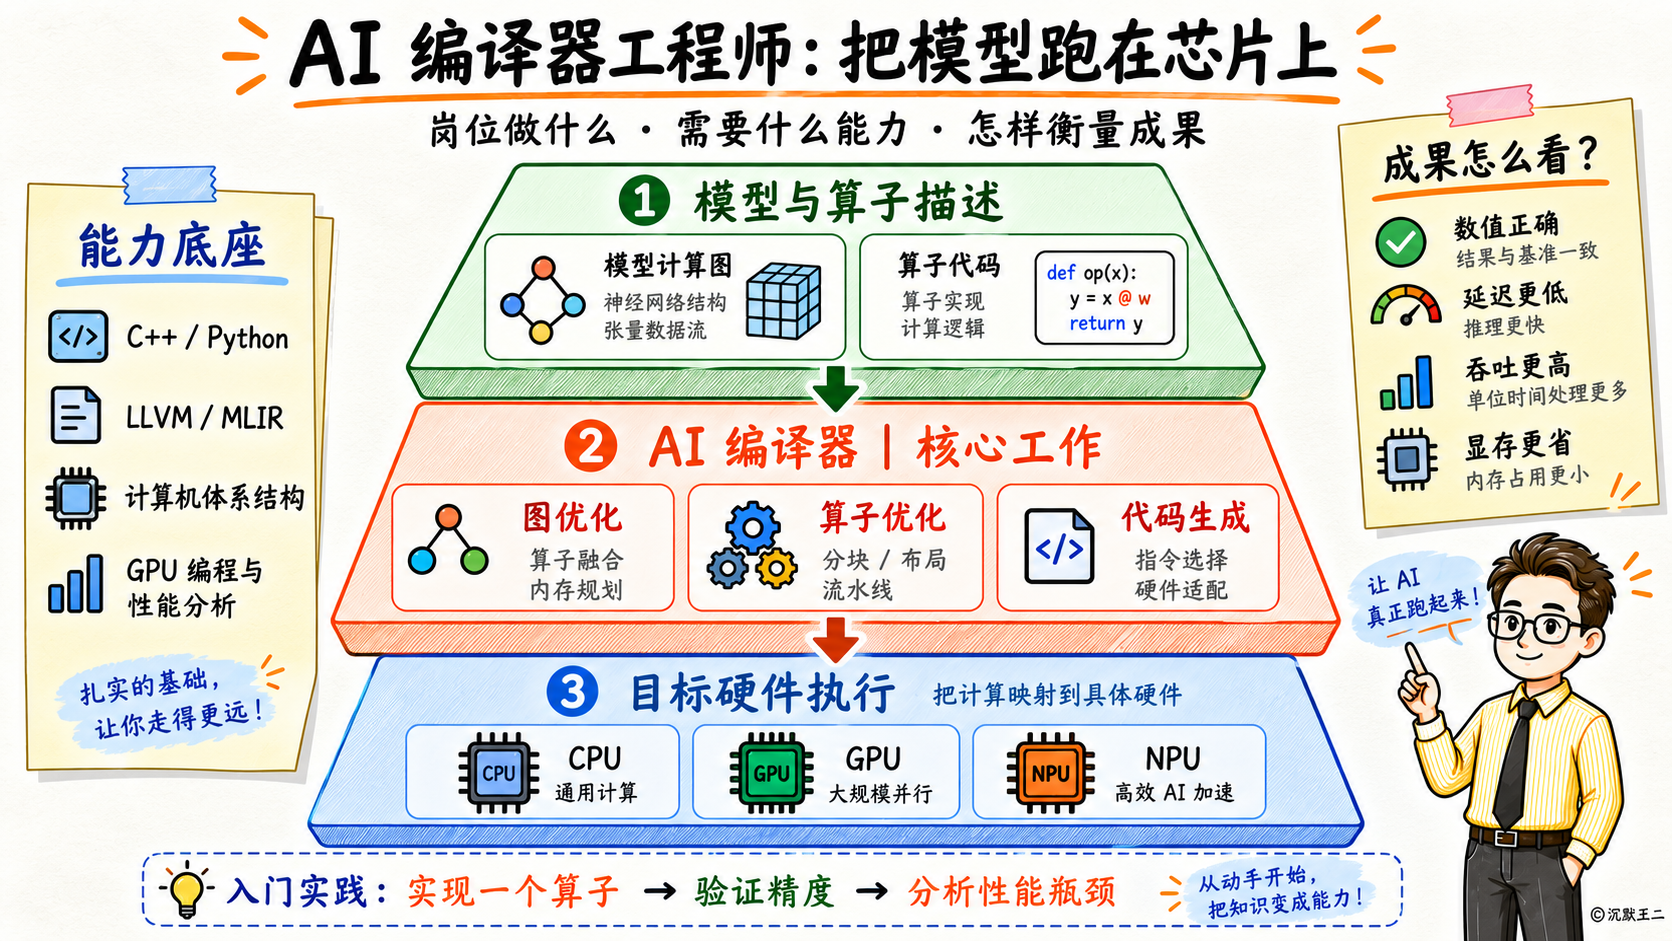
不管是英伟达的 H100、Blackwell,还是华为昇腾、寒武纪这些国产卡,硬件账面上的算力再高,如果没有编译器把计算图翻译成贴合硬件存储层级的机器码,计算单元大部分时间都在空等显存搬数据。
拿字节来说,大家平时看到的是 C 端的豆包、底层的 Seed 模型、编码工具 Trae 和火山引擎,但在很多人不太注意的算力底座上,字节在 AI 编译器方向开源了不少硬核项目。ByteIR 是基于 MLIR 的模型编译方案,Triton-distributed 和 Flux 都在解决多卡训练和推理时计算与通信怎么重叠的问题。
就算我们平时主要做上层的 Agent 和 RAG,不去写底层的算子,把硬件和编译器怎么配合的逻辑摸清楚依然很有必要。
一方面现在面试大厂 AI 工程岗,面试官很喜欢顺着推理延迟和显存占用往下深挖一层,问你 CPU 和 GPU 架构到底差在哪、GPU 有哪些存储层级、Triton 为什么能成为行业标准;另一方面,当你真正看懂数据是怎么在显存、L2 缓存、共享内存和寄存器之间流转的,以前觉得神秘的底层概念一下子就通透了。
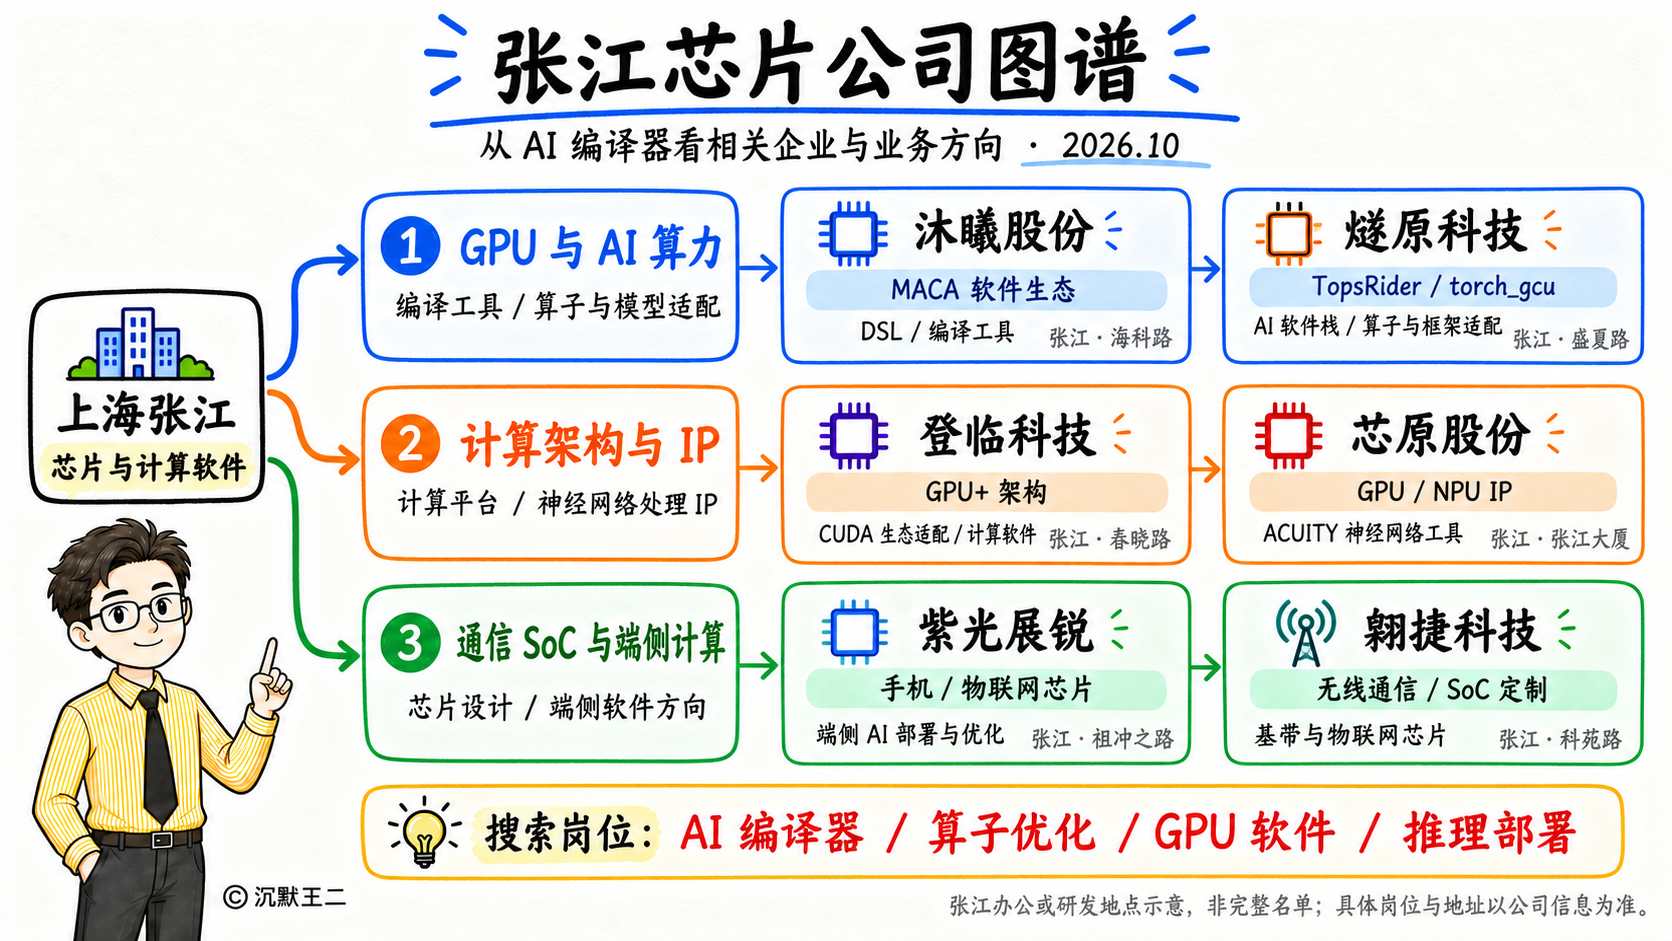
我把张江地区的芯片公司也帮大家简单梳理了一下,可参考。
好,接下来,继续啃干货。
这部分其实和昨天的RAG是一家公司面试问的,你敢信?只不过合在一篇,文章的篇幅直接飙到了两万字,所以我就拆开了两篇,如果能把 AI 编译器的内容拿下,那你的学习能力真的没得说。
干啥都能干的成。
content
01、AI 编译器岗位大致做什么?
“我的理解是,这个岗位做的事情是把一个算子的数学描述,翻译成在特定硬件上执行得最快的机器码。往上接深度学习框架导出的计算图,也就是把模型里各个运算步骤连成的有向图,比如 PyTorch 这一层,或者 StableHLO 这类介于框架代码和底层指令之间的中间表示;往下接硬件的指令集,NVIDIA 上是虚拟指令集 PTX 和硬件机器码 SASS,昇腾和寒武纪也各有自己的一套。”
“具体的工作,我的理解是从一个算子的内部往外扩展。最里面是算子的调度,两个大矩阵做矩阵乘法时,怎么把大矩阵切分成小块,才能让数据一直留在芯片内部的寄存器和共享内存里(也就是常说的片上存储,直接做在 GPU 核心计算芯片上,读写极快但容量只有几百 KB),怎么用一条指令同时读写和计算多个数据(也就是向量化),数据搬运和矩阵计算怎么重叠起来形成流水线。单个算子调好了,放到整张计算图里还有新的优化空间,相邻的算子融合成一个就能省掉中间结果来回读写显存的开销,数据在显存里按什么顺序排布、显存空间怎么复用也要跟着一起定下来。算子内部和整张计算图这两处的决策合起来,会产生大量的参数组合,同一个算子换一个输入矩阵的维度大小、换一张显卡,最优的那组参数就变了,所以最后还要有自动调优机制去搜索这些参数。”
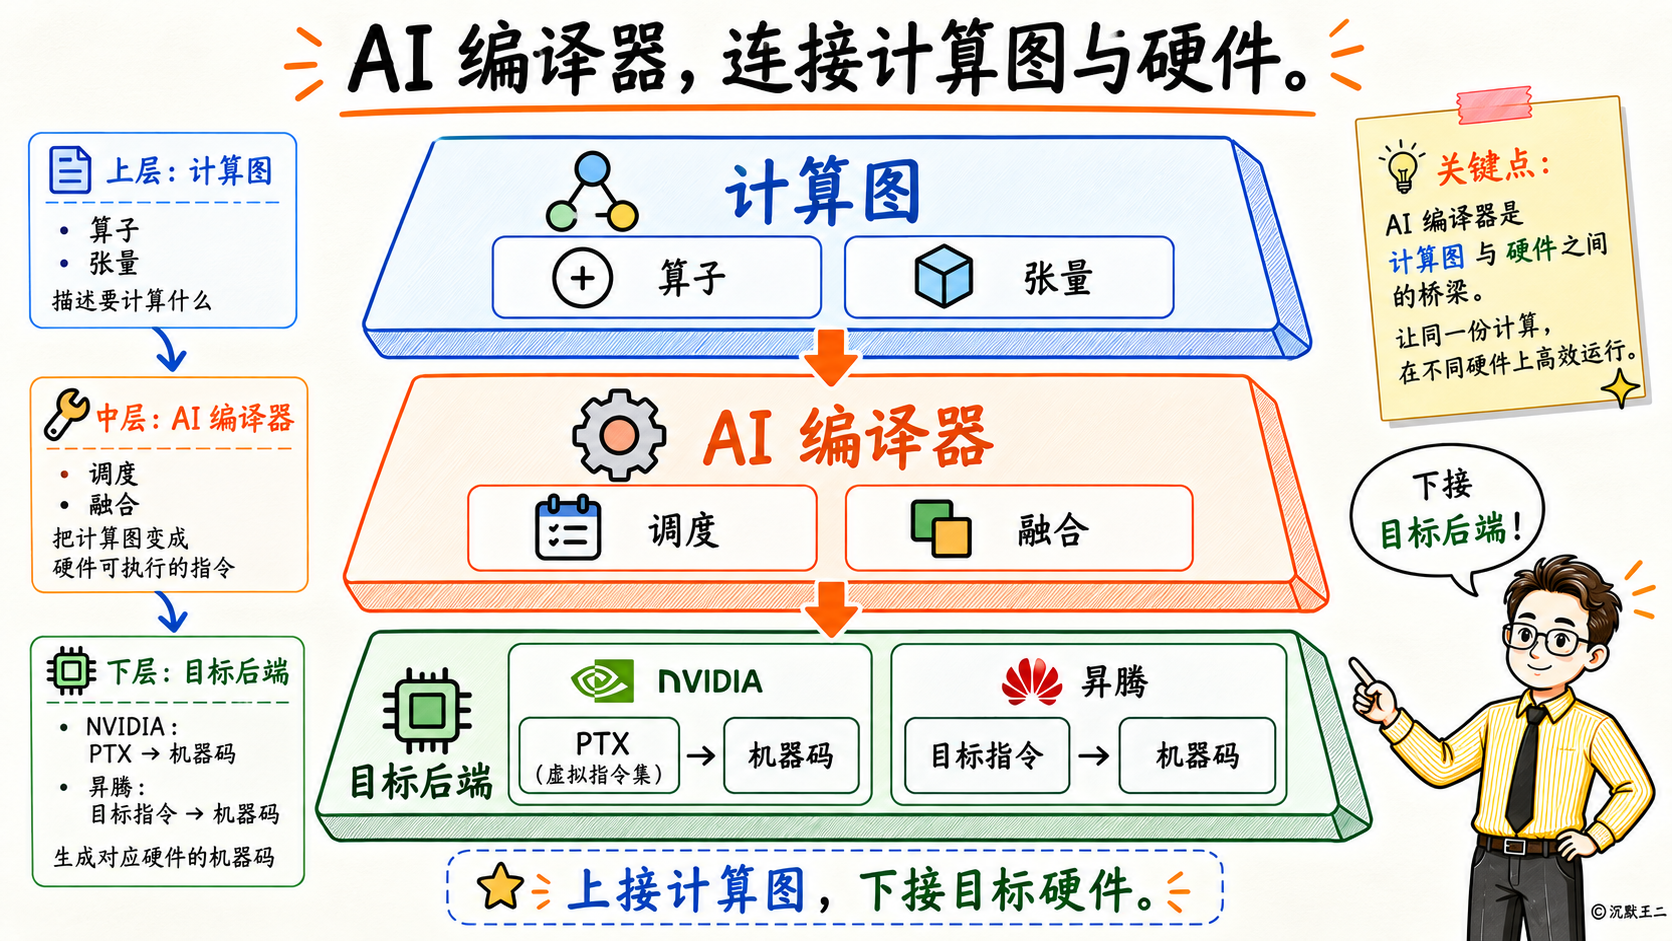
“字节开源的 ByteIR 就是一套基于 MLIR 的模型编译方案,前端先把模型转换成 StableHLO 中间表示,编译器部分复用上游 MLIR 的方言(也就是针对特定抽象层次定义的一组指令和操作类型),里面的编译优化步骤(编译器里叫 pass,每一步负责一种特定的代码变换或优化)和上游兼容,可以混着用。”
“ByteIR 管的是把模型编译出来,Flux 和 Triton-distributed 管的是多卡之间的通信怎么不拖慢计算。大模型用张量并行或者专家并行切分到多张卡上之后,每张卡各算一部分,每一层算完都要跨卡汇总或者交换一次数据,也就是做一次集合通信。通信的时候计算单元在干等,硬件利用率就掉下来了。Flux 的做法是把通信和计算都切分成很细的数据小块(tile),再融合进同一个大的 GPU 核函数(kernel,也就是放到 GPU 上执行的函数)里,把跨卡归约分发(ReduceScatter)融进矩阵乘法核函数的收尾阶段,把跨卡收集(AllGather)融进矩阵乘法核函数的开头准备阶段。论文里给的数字是,128 卡训练的吞吐最高能到 Megatron-LM 的 1.24 倍,推理的首字预填充阶段(prefill)和逐词生成阶段(decode)最高能到 vLLM 的 1.66 倍和 1.30 倍。”
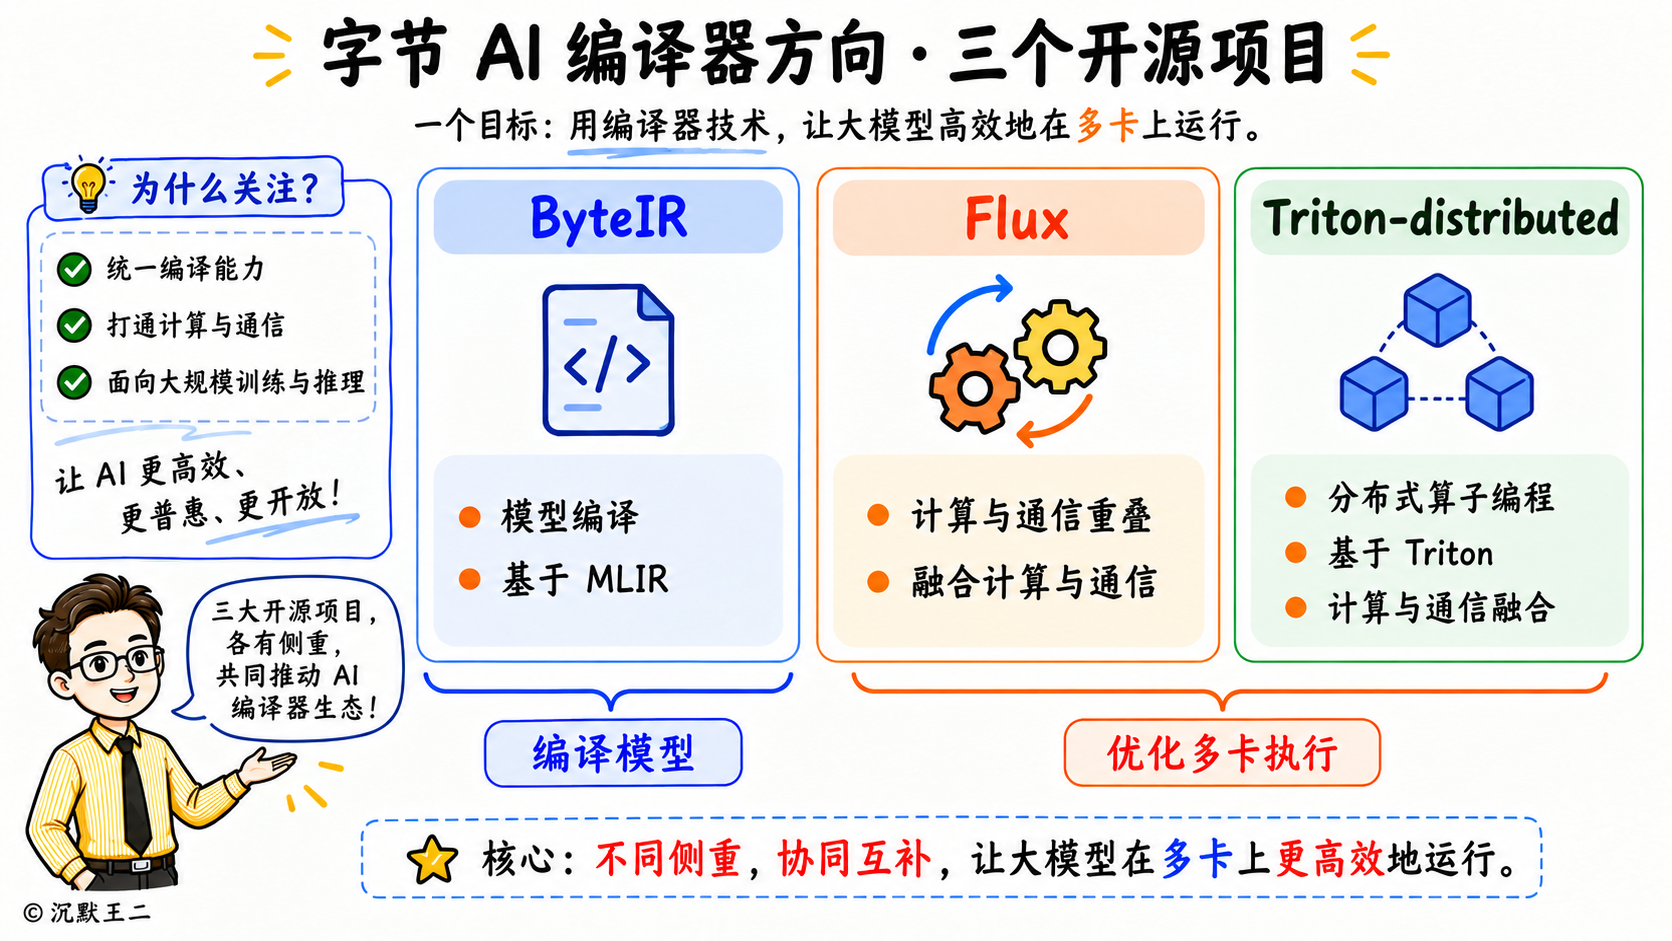
“Flux 是把融合做好了直接提供现成的算子,Triton-distributed 则是把这件事做成编程模型,让写算子的人自己去融合。它基于 Triton,给每张卡分配一块同样大小的全局缓冲区,叫做对称内存,写算子的人可以直接读写别的卡上对应位置的数据;同步用的信号对象也放在这块对称内存里,通过信号交换判断对方的数据到没到。这样计算和通信就可以写在同一个 GPU 核函数里。在混合专家模型(MoE)场景下部分算子的加速超过 40 倍。”
“我自己的判断是,这个岗位和写业务代码的差别在于评价标准只有一个,在目标硬件上快了多少倍,所以得能读硬件手册、会用性能分析工具(profiler)看计算单元有多少时间是空闲的。”
02、CPU 与 GPU 架构的主要区别是什么?
“最根本的区别是晶体管把精力花在了什么地方。CUDA 的编程指南里指出,GPU 把更多晶体管用于数据处理,而不是数据缓存和流程控制。”
“读一次显存要几百个时钟周期,两边处理这个延迟的思路不同。CPU 的办法是想方设法避免这次等待,用大容量的多级缓存把数据留在近处,用分支预测提前猜测走哪条路,用乱序执行让后面不依赖的指令先执行。这些部件很占芯片面积,但它们能把单个线程的执行时间压到最短。”
“GPU 的办法是让等待的时间被别的线程用掉。一组线程卡在读取显存上,调度器就立刻切换到另一组已经准备好的线程去执行计算。所以 GPU 不需要分支预测和乱序执行这些复杂的控制部件,省下来的芯片面积全用来放计算单元和寄存器。CUDA 文档里明确写了,GPU 的指令是按顺序发射的,没有分支预测,也没有提前猜测并执行后续指令的推测执行机制。”
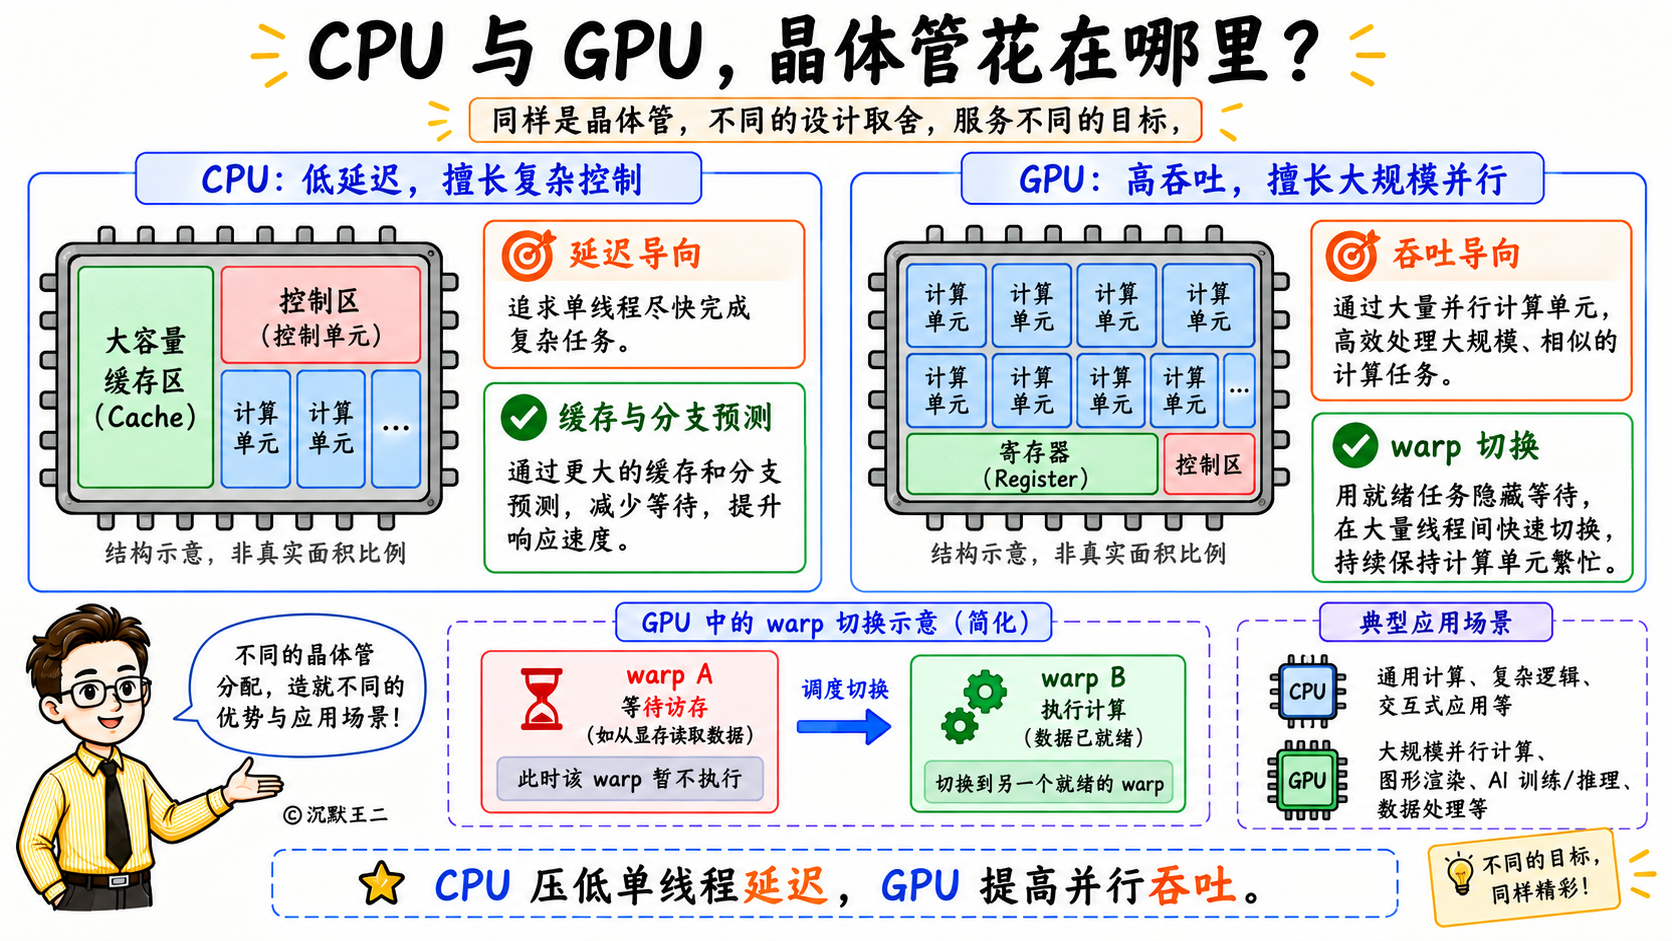
“第二个区别是线程的组织方式。GPU 用的是 SIMT,单指令多线程。流式多处理器,也就是常说的 SM,以 32 个线程为一组创建、管理、调度和执行,这一组叫一个线程束(warp),一条指令发下去就是 32 个线程同时做同样的操作。”
“这个模型直接影响代码怎么写。既然 32 个线程共用一条指令,那么一个 if else 条件判断如果让同一个 warp 里的线程走向不同的分支,硬件只能先执行第一条分支、把不走这条分支的线程屏蔽掉,再回头执行另一条分支,两条分支都要走一遍。所以在 GPU 上写条件判断,要尽量让分支差异发生在不同的 warp 之间,而不是同一个 warp 内部。Volta 架构之后引入了独立线程调度,每个线程有了自己独立的、用来记录当前执行到哪一条指令的程序计数器,但同一个 warp 内只要出现分支分叉,两条分支都要执行的硬件开销依然存在。”
“第三个区别是规模。H100 的服务器底座直连版(SXM5)有 132 个 SM,完整的 GH100 芯片是 144 个,插卡式的 PCIe 版本是 114 个。每个 SM 上还能同时驻留几十个 warp。这个量级决定了优化的方向。CPU 上优化是减少指令数量和分支预测失败,GPU 上优化是提高占用率和做好访存合并。占用率指的是每个 SM 上实际驻留的 warp 数量占硬件上限的比例;访存合并指的是让同一个 warp 里的 32 个线程读取连续相邻的显存地址,这样硬件可以把 32 次零散的读取合并成一次整块读取。同一个算法在 CPU 和 GPU 上的最优写法往往完全不同。”
03、GPU 有哪些缓存和存储层级?
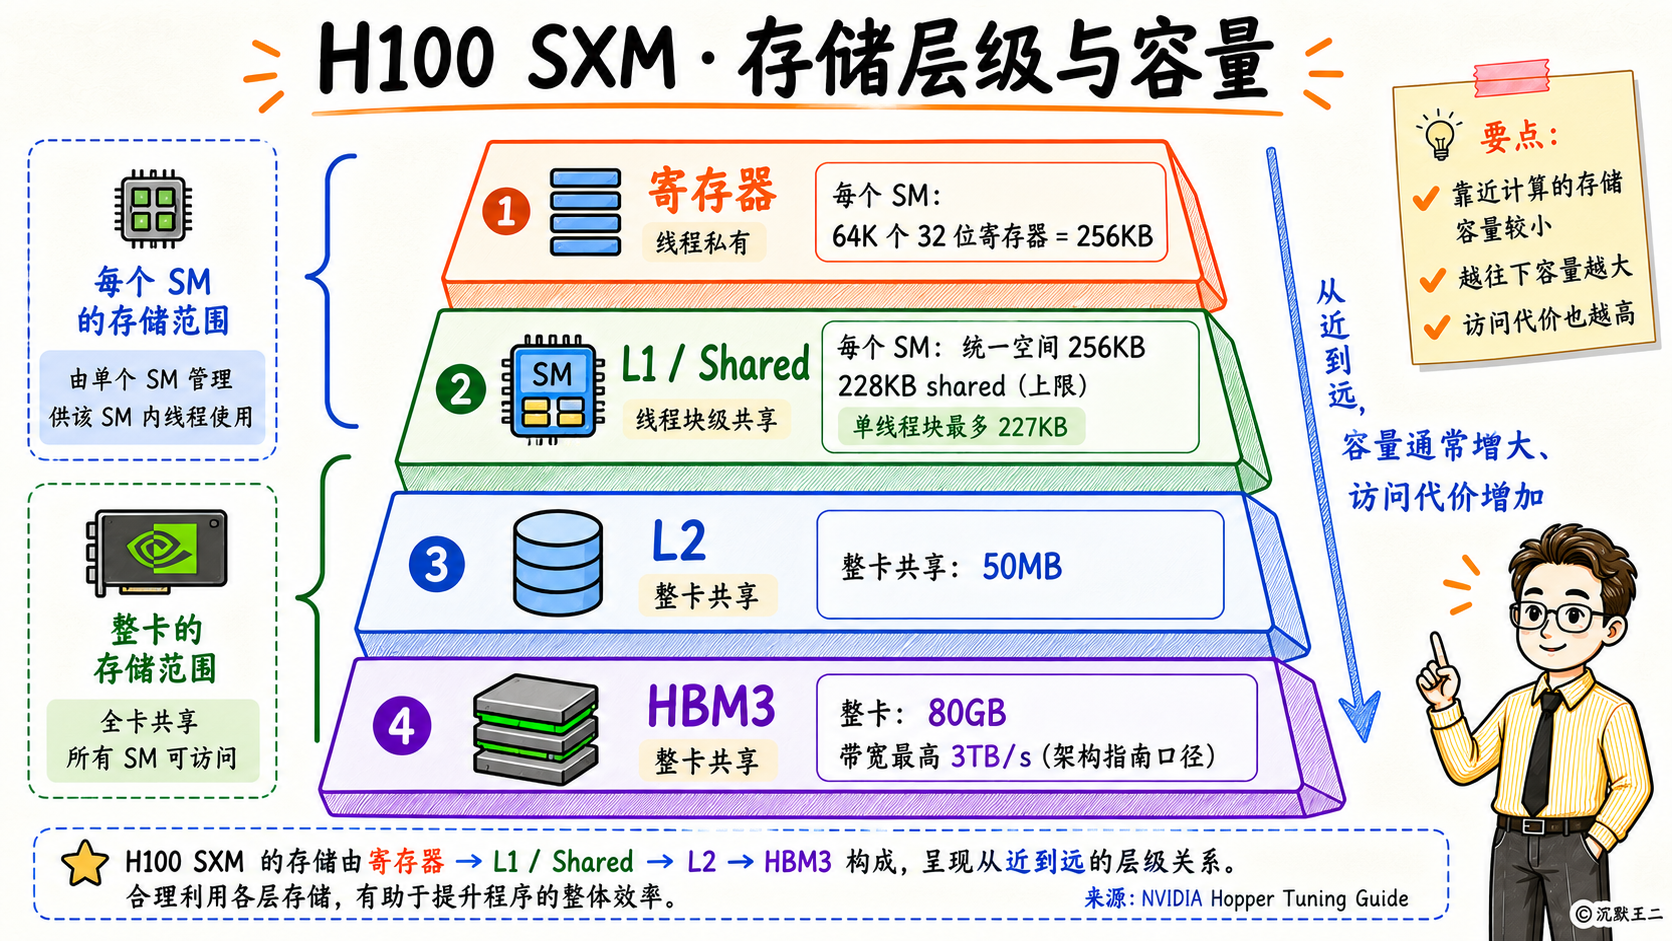
“按离计算单元从近到远的顺序说,以 H100 为例。前面四层都在核心计算芯片内部,也就是前面说的片上存储,最后一层显存在核心芯片外部。”
“离计算单元最近的是寄存器。每个 SM 有 64K 个 32 位寄存器,换算过来是 256KB,单个线程最多能用 255 个。寄存器是每个线程私有的,一个核函数里单个线程用的寄存器越多,这个 SM 上能同时驻留的 warp 数量就越少,占用率就会下降,这是写核函数时第一个要权衡的地方。”
“往下是 L1 缓存和共享内存。H100 把 L1 缓存、原本给图形渲染用的纹理缓存、共享内存合并成一块 256KB 的片上空间,A100 上是 192KB。这块空间的划分比例是可以配置的,共享内存最多能分到 228KB,单个线程块(由多个 warp 组成的线程组)最多能用 227KB,CUDA 运行时自己预留了 1KB。可选的共享内存档位是 0、8、16、32、64、100、132、164、196、228KB。需要注意,代码里静态声明的共享内存上限仍然是 48KB,超过 48KB 必须用动态分配的方式向运行时申请。”
“同一层还有常量缓存。常量内存总共 64KB,每个 SM 上的常量缓存工作集是 8KB,从早期的 CUDA 计算能力版本到现在都没变过。核函数的入参,编译器一般也会放进常量内存。纹理缓存现在已经并进上面说的那块 256KB 统一数据缓存,不再是独立结构,所以它的可用容量会随架构和共享内存划分比例变化,官方文档给的是一个区间而不是固定值。”
“再往下是 L2 缓存,H100 上是 50MB,A100 上是 40MB。L2 缓存是整张芯片所有 SM 共享的,也是片上存储的最后一层,所有 SM 都要经过它去访问芯片外面的显存。”
“最远的是芯片外部的显存。H100 的 SXM 版本配了 80GB 的 HBM3 高带宽显存,带宽这里有两个数字,架构白皮书里写的是最高 3TB/s,产品数据手册里给的是 3.35TB/s,看文档时要注意出处。Blackwell 架构的 B200 按官方规格是 180GB 的 HBM3e 显存,带宽最高 8TB/s。网上流传的 192GB 是物理堆栈的总容量,不是官方规格里的可用容量。L2 缓存这一层,NVIDIA 给 Blackwell 公布的数字是 GB200 上有 126MB。”
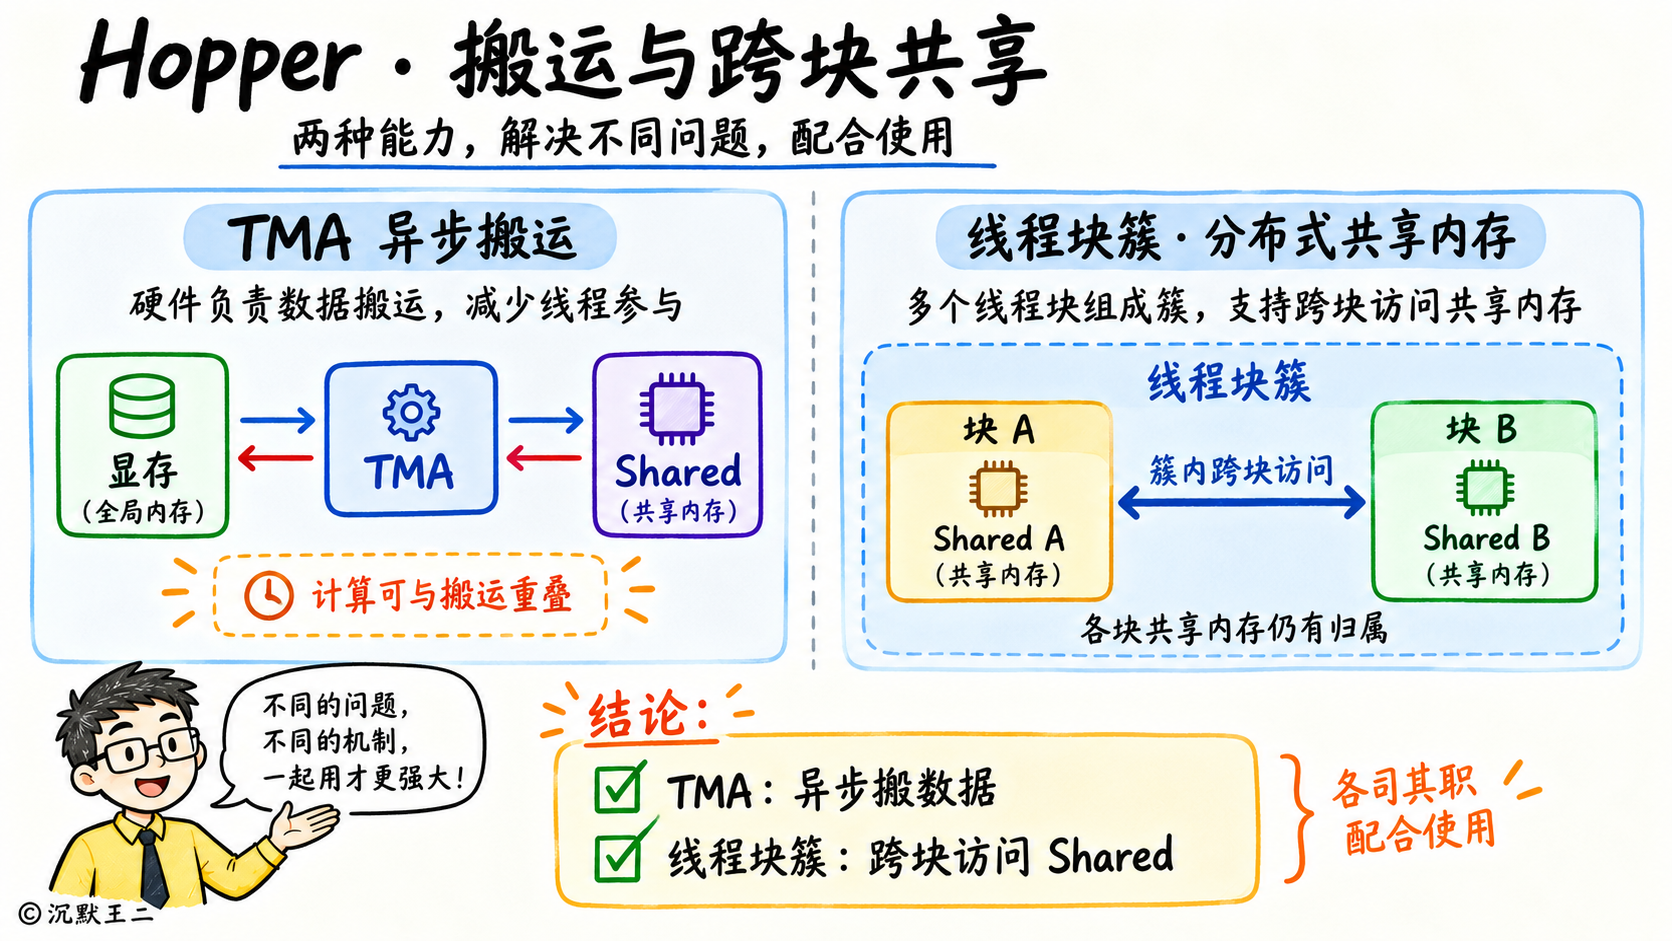
“H100 所属的 Hopper 架构这一代,在传统层级之外还加了两样新的硬件机制。先说 TMA,张量内存加速器,它是一个专门负责搬运数据的异步硬件引擎,能在显存和片上共享内存之间直接搬运一维到五维的张量,从共享内存往显存写回时还能顺带完成逐个元素的求和、取最大值这类归约操作。有了它,搬运数据不用再占用计算单元去一个个计算内存地址。”
“搬运数据的效率解决了,剩下的问题是片上容量。共享内存还是受限于每个 SM 最多 228KB,单个线程块能用的就这么多。所以 Hopper 又在 CUDA 计算能力 9.0 版本里加了线程块簇(Thread Block Cluster),这是介于线程块和整个网格之间的新一层线程组织。同一个簇里的多个线程块保证会被硬件调度到同一个图形处理簇(GPC,也就是芯片内部由多个 SM 组成的硬件分区)上,可移植的最大规模是 8 个线程块,打开允许非可移植簇规模的开关之后可以用到 16 个,但不能跨硬件架构直接移植。线程块簇存在的意义是实现分布式共享内存,同一个簇内的不同线程块可以互相读写、原子操作对方 SM 上的共享内存,相当于把多个 SM 的共享内存拼成一块更大的片上空间,总容量等于簇内线程块数量乘以每块的共享内存大小。官方调优指南建议这种跨线程块读取要把相邻地址合并成一次请求,并且起始地址按 32 字节的整数倍对齐。”
“到了 Blackwell 这一代,芯片内部又新增了一块专门给第五代张量核心(Tensor Core)用的片上存储,叫做张量内存(Tensor Memory)。PTX 指令集文档里写的是,在数据中心版 Blackwell(架构代号 sm_100)上,张量内存按线程块(PTX 文档里叫协作线程阵列 CTA)来组织,每个线程块有 512 列乘 128 行,每一格 32 位,换算下来正好是 256KB。它的分配规则很严格,以列为单位,最少分配 32 列,列数必须是 2 的幂,而且必须由同一个 warp 调用指令申请和释放,每个 warp 只能访问属于自己的那 32 行,对应 warp 里的 32 个线程通道(lane)。配套的矩阵乘法指令是 tcgen05.mma,Hopper 架构上的异步矩阵乘法指令 wgmma.mma_async 在 Blackwell 上已经弃用了。这一层张量内存只有数据中心版的 Blackwell 芯片有,消费级显卡那一版没有。”
“把这些层级串起来看,规律非常固定,离计算单元越远,容量越大、带宽越低、延迟越高。所以算子优化的绝大部分工作,就是想办法把数据尽量留在上面几层片上存储里,矩阵分块切多大、什么时候提前预取下一块数据、要不要用 TMA 异步搬运,都是在算这笔账。”
04、对 LLVM、MLIR 有什么了解?
“我是从一个问题开始了解这套东西的,深度学习编译器为什么不直接把模型转换成 LLVM 的中间表示(LLVM IR)。”
“原因在于 LLVM IR 的抽象层次太低了,它只有单个数字(标量)和固定长度的一维数组(定长向量),没有多维张量这种类型,也没有多层循环嵌套这种结构。一个矩阵乘法一旦直接转换成 LLVM IR,就退化成了三层嵌套跳转加上单个数字的乘法和加法,原来循环之间的依赖关系、哪些循环可以交换执行顺序、哪两个相邻算子可以融合在一起,这些高层信息在转换下来的过程中全部丢失了。LLVM 擅长的是已经转换到底层之后的事情,比如寄存器分配、硬件指令选择、指令执行顺序调度。”
“MLIR 的解法是不急着一步转换到底层,而是分成很多层逐步往下转换,也就是渐进式降级(progressive lowering)。每一层用一种方言(dialect)来表达,不同抽象层次的方言可以共存在同一个模块里,一边往下转换一边做当前层次最擅长的优化。”
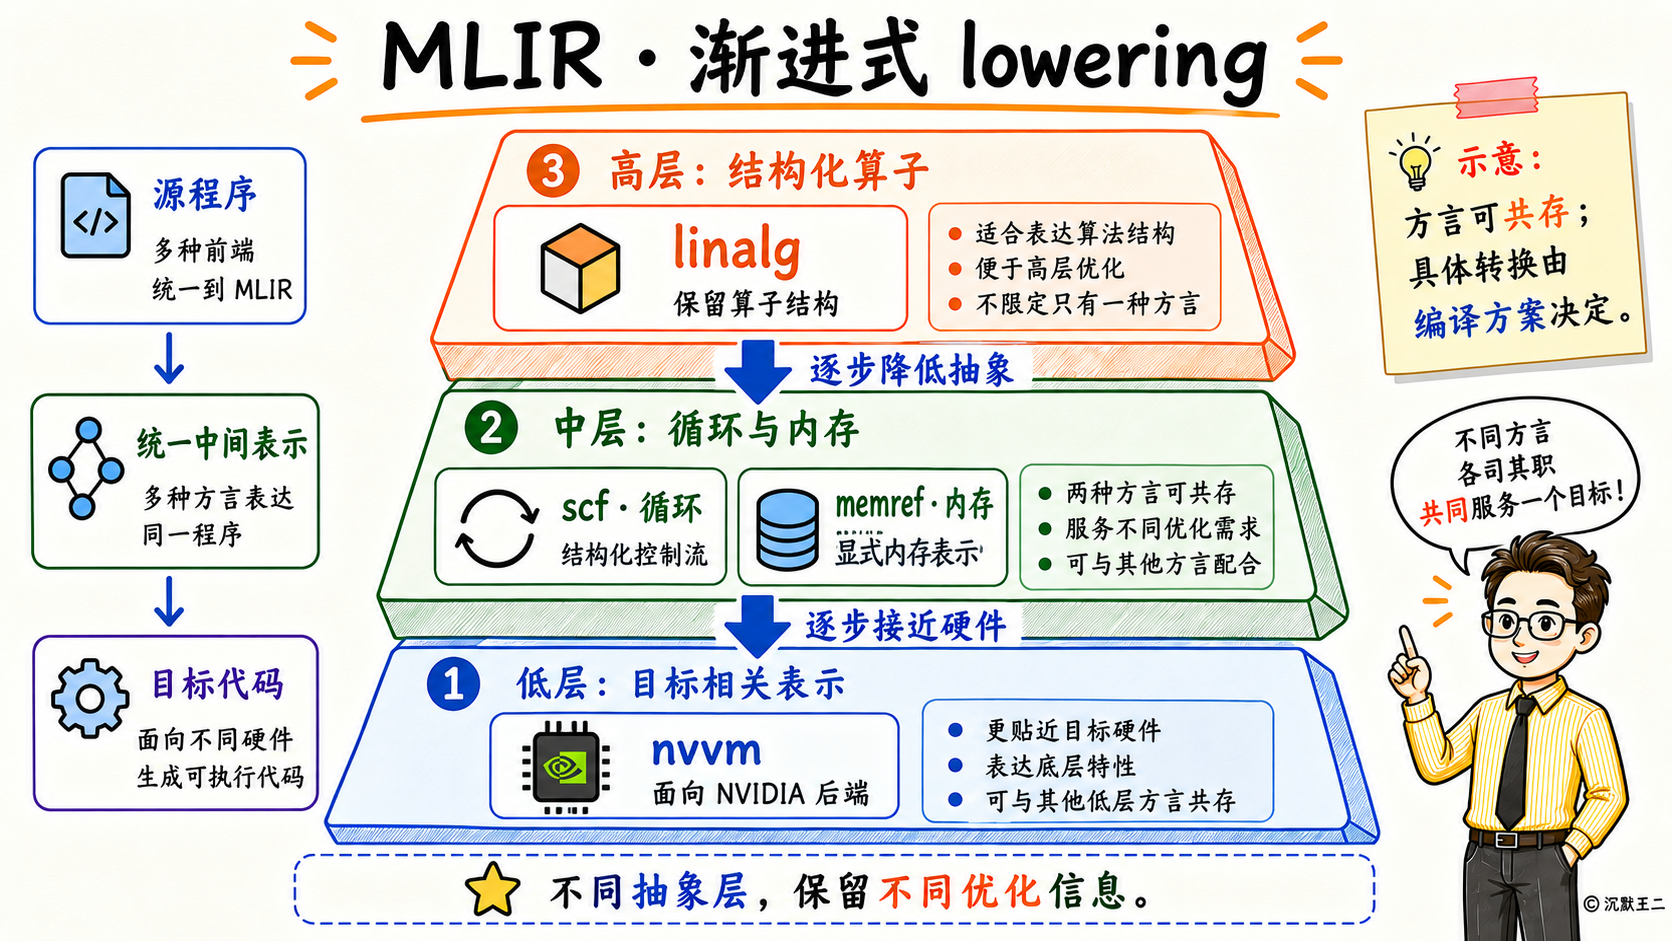
“常见的方言按抽象层次从高到低排下来大概是这样。linalg 方言用来表达结构化的算子,一个矩阵乘法在这一层仍然是一个完整的算子,矩阵分块、算子融合这些变换在这一层做最方便。tensor 方言和 memref 方言分别对应数学上的张量值和实际的物理内存,tensor 只表达计算结果是什么、不管数据存在哪里,memref 则带有具体的内存指针和排布信息,两者之间要经过一次内存化转换(bufferization),给每个张量分配实际的内存缓冲区。再往下,affine 方言和 scf 方言用来表达循环结构,affine 对循环下标的写法限制更严格,但正是因为限制严格,编译器分析循环之间的数据依赖关系才做得准确。arith 方言负责基础的算术运算。继续往下,gpu 方言用来表达 GPU 的线程和线程块概念,nvvm 方言对应 NVIDIA 硬件的内建函数,最后转换成 llvm 方言,交给 LLVM 后端生成目标机器码。”
“这套分层机制拿 Triton 编译器来看最直观。Triton 的编译过程分成四级。先把开发者写的 Python 源码转换成 TTIR,这一层是以数据块为单位、和具体显卡型号无关的中间表示。然后转换成 TTGIR,这一层开始带上具体的 GPU 硬件信息,数据在各个 warp 之间怎么分布、显存读写怎么合并、共享内存用哪种排布方式都在这一层确定。中间执行的都是 MLIR 的编译优化步骤(pass),比如用 remove_layout_conversions 消除多余的内存排布转换、用 accelerate_matmul 把矩阵乘法替换成 Tensor Core 硬件加速指令、用 optimize_dot_operands 优化点积运算的操作数。接着再从 TTGIR 转换成 LLVM IR,往下生成 NVIDIA 的虚拟指令集 PTX,最后由 NVIDIA 的汇编器 ptxas 编译成 GPU 可直接执行的二进制文件 cubin。各个硬件后端把这些编译阶段注册在自己的 compiler.py 文件里,AMD 显卡后端的前三级完全一样,只是最后换成 AMD 自己的汇编表示 amdgcn 和二进制文件 hsaco。”
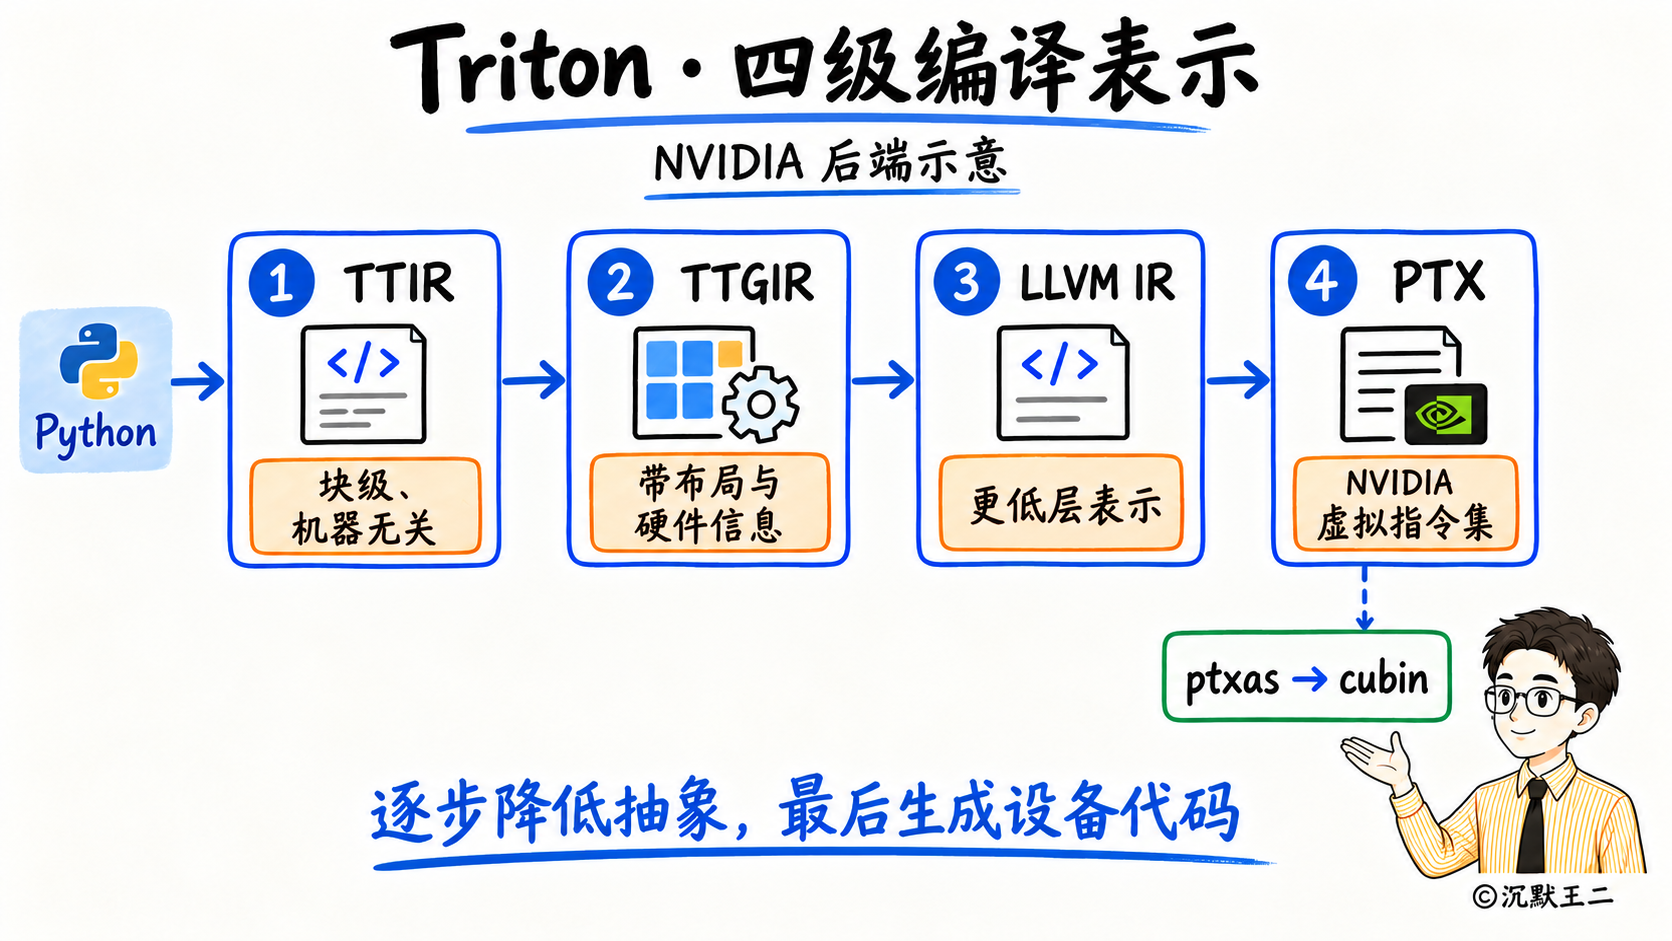
“MLIR 的来历是,2018 年在 Google 内部启动,2019 年 4 月先开源在 TensorFlow 仓库里,同年 9 月 Chris Lattner 在 llvm-dev 邮件列表发起提案,10 月 LLVM 基金会正式接受,12 月底代码合入 LLVM 的主仓库,目录名就是 mlir。所以它现在是 LLVM 官方项目的一部分,不是一个外部独立项目。”
“我没有亲手写过 MLIR 的 pass。我了解的是这套多层中间表示为什么要这么设计,以及排查问题时怎么把每一层的中间表示打印出来对照着看。真让我上手用 C++ 写一个自定义的 pass,还需要时间去熟悉它的接口。”
05、了解哪些 AI/GPU DSL?
“DSL 是领域特定语言,在 GPU 编程里指的就是专门用来写高性能算子的编程语言或编程库。我按抽象层次从低到高说,顺便说一下它们各自适合什么场合。”
“最贴近硬件的那一层,有 CUTLASS 的 CuTe DSL 和 ThunderKittens。CuTe DSL 是 NVIDIA 从 CUTLASS 4.0 开始提供的 Python 接口,核心抽象和 C++ 版的 CuTe 是一一对应的,开发者依然要直接和内存排布、张量切分、硬件原子操作指令这些底层概念打交道,Python 安装包名叫 nvidia-cutlass-dsl,目前还标着公开测试版(public beta)。ThunderKittens 是斯坦福大学 Hazy Research 团队开源的一个 C++ 库,它的基本数据结构是 warp 级别的 16 乘 16 矩阵块,线程块这一级的代码固定按加载数据、执行计算、写回存储、收尾处理这个模板来写。这一层的特点是性能上限极高,但要求写代码的人清楚每一块数据在寄存器和共享内存里的具体位置。”
“往上一层是 Triton,也是目前的事实标准。它的设计取舍是让开发者只管数据块这一级的逻辑,至于一个数据块里的数据怎么分给 warp 里的 32 个线程、片上共享内存怎么分配,全部交给编译器自动决定。写起来很像写 NumPy 数组运算,跑出来的性能却能达到手写 CUDA 代码的大部分水平。它的开源仓库现在放在 triton-lang 组织下,原来的 openai/triton 地址已经重定向过去了。PyTorch 里面调用 torch.compile 自动生成的 GPU 算子代码,底层生成的就是 Triton 代码。”
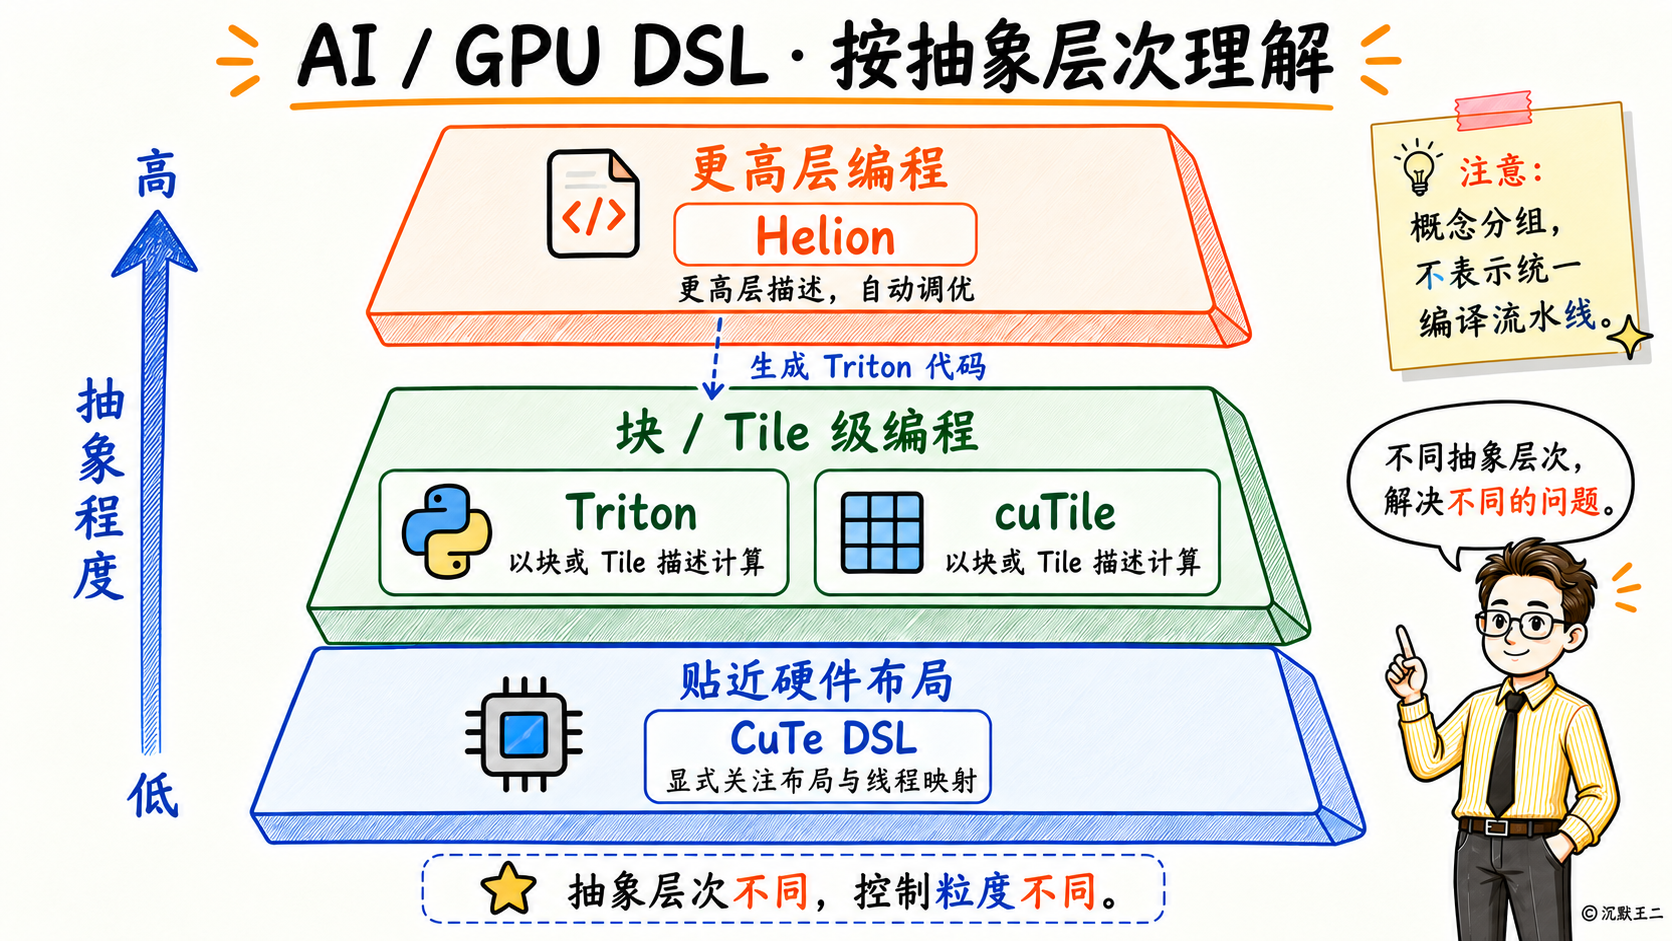
“Triton 之上还有更高的一层。PyTorch 基金会仓库里的 Helion 是 Meta 团队开发的,写法比 Triton 更接近普通 Python 函数,它编译出来的产物就是经过自动调优的 Triton 代码,最核心的机制就是内置了自动搜索最优分块参数的调优引擎。这个项目在 2025 年 4 月建仓,同年 10 月发布了 Beta 版本。”
“NVIDIA 官方自己也在推一套新的。CUDA 13.1 引入了 cuTile,它包含三个组成部分,一套新的虚拟指令集 CUDA Tile IR,一套面向 Python 开发者的编程接口 cuTile Python,再加一个把 Tile IR 字节码直接编译成硬件原生机器码(SASS)的编译器。它是 2025 年 12 月随 CUDA 13.1 正式公开的,首发针对 Blackwell 架构。这件事很值得关注,因为它意味着以数据块(tile)为单位的编程模型,已经被 NVIDIA 正式吸收进了 CUDA 官方底座。”
“就目前的工程实践来说,如果要在 NVIDIA 显卡上手写自定义算子,Triton 依然是最省力的入口,社区里能参考的现成代码最多,遇到报错也最容易搜到解决办法。只有当业务真要榨干硬件最后那百分之几的极限性能时,才需要下沉到 CuTe 或者 C++ 这一层。”
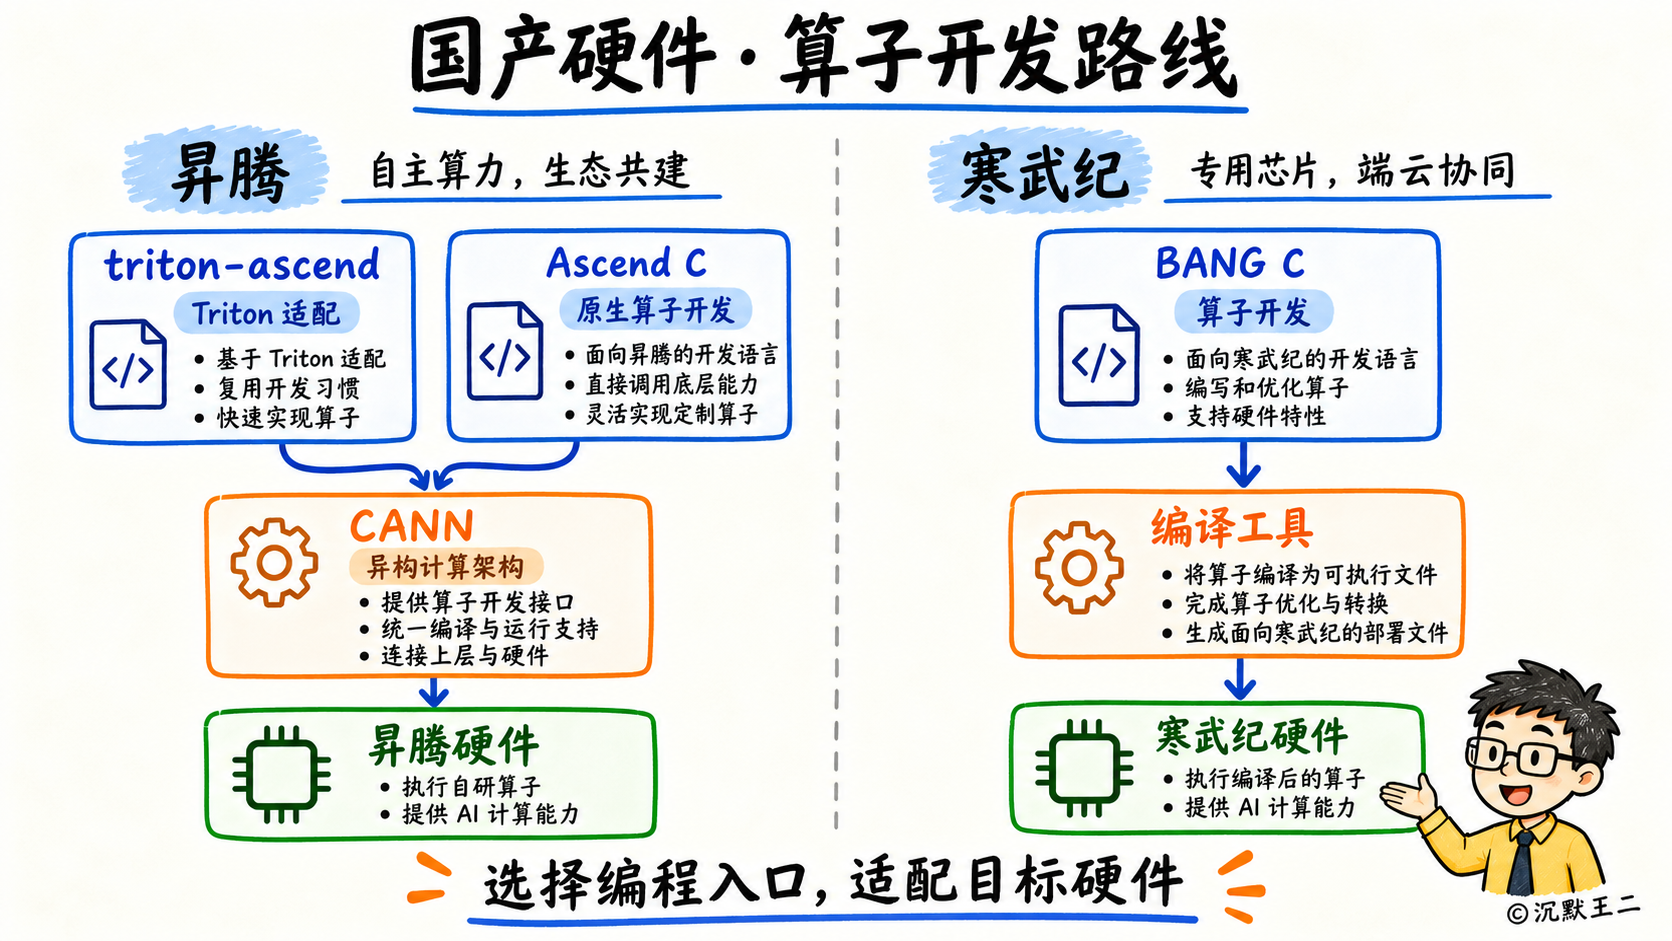
“国产硬件这边我也顺带了解了一下。华为昇腾走的是兼容适配 Triton 的路线,triton-ascend 这个项目已经正式迁移到了 triton-lang 官方组织下,2025 年 5 月开源,2026 年 1 月发布了 3.2.0 正式版,底层依赖昇腾的 CANN 社区版 9.0.0 软件栈;如果要写更底层的自定义算子,用的是在 C 和 C++ 基础上做裁剪扩展的 Ascend C 语言。寒武纪则是另一套体系,它的通用并行编程模型叫 BANG,写算子用的语言是在 C 和 C++ 上扩展出来的 BANG C,编译时先用自研编译器 CNCC 把 BANG C 源码编译成寒武纪自己的底层指令集 MLISA,再用汇编器 CNAS 把 MLISA 汇编成目标二进制文件,另外寒武纪也提供了一套基于 Python 的算子开发接口 BANGPy。”
ending
以前看到 LLVM、MLIR、GPU 寄存器和共享内存这些词,很多做后端和做业务的同学本能地就会划走,觉得那是底层神仙才碰的东西。
但现在真不一样了。
有 Opus 5.5、DeepSeek V4.1 Flash 这些顶级模型在手边,以前啃半个月硬件手册都未必能看明白的底层机制,现在只要你愿意追问,一个下午就能摸清来龙去脉。
我现在学这些,就一个目的,让自己的脑子学会学习,以后不管你从事什么,如果说给你一个以前不了解的知识,你学不会就会很尴尬。
平时趁着精力还行的时候,每天啃一点这种硬骨头,心里会踏实很多。
今天就到这吧,能坚持看完这篇的都是高手,完事摸会鱼休息休息,我们下期见。