
宇宙厂员工:不打算往上爬的话,苟在2-2/3性价比最高,尽量多存款多靠近AI,再往上,过程累、成功率30%左右(附Agent面试题)
看到标题这样一段心声,感觉还挺有道理。他说如果不打算往上爬,苟在 2-2 或者 2-3 是性价比最高的,尽量多存款,多靠近 AI。再往上走,过程很累,成功率三成左右。
2-2 算是资深工程师、干活主力,3-1 是更高一档的骨干、开始扛方向性职责。特点是收入已经到行业高位,但责任还没质变,你能控制自己的产出,也不用为别人的产出和跨部门博弈买单。
再往上游戏规则变了,需要从【把事做成】切换成【管人、争资源、向上管理】。时间就被会议和资源协调沉默掉,个人可控的产出反而下降,心更累一点。
靠近 AI、多存款确实是目前大多数人的最优解。
拿 zijie 来说,C 端是豆包,模型是 Seed,编码工具有 Trae,算力和云服务在火山引擎。除此之外,还有很多人不太注意的一块,字节在 AI 编译器方向也有不少开源项目,ByteIR 是基于 MLIR 的模型编译方案,Triton-distributed 和 Flux 都在解决计算和通信怎么重叠的问题。
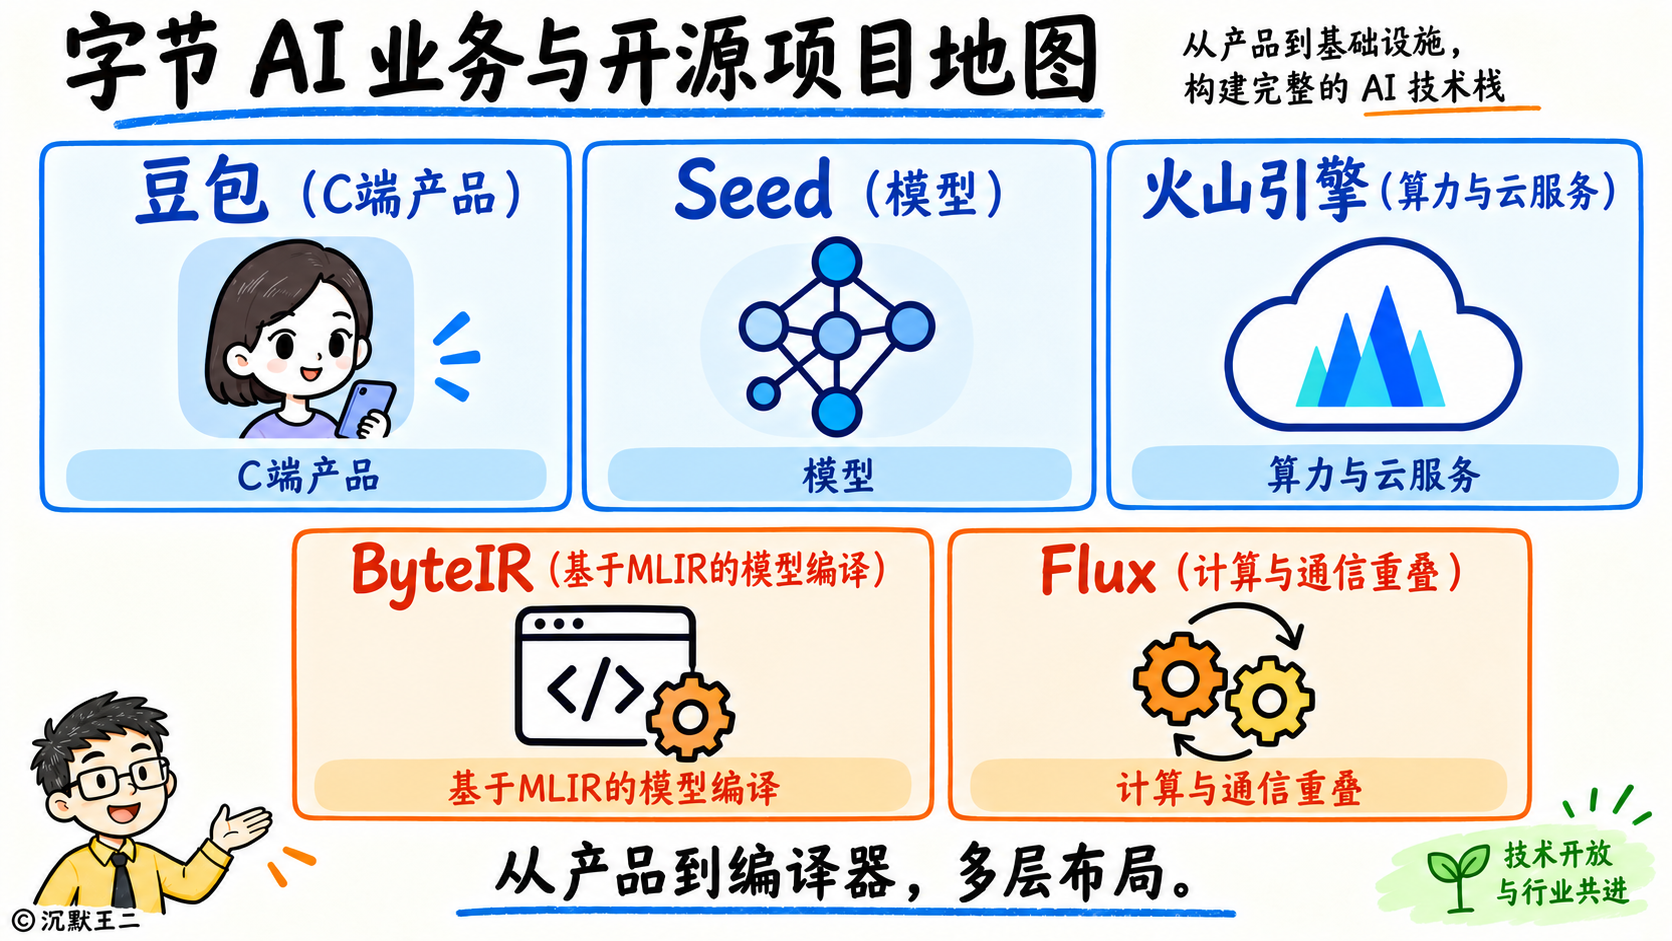
之所以提这两块,是因为接下来的内容除了和传统的RAG有关,和 AI 编译器也有关。
AI 是洪水猛兽,也是能力边界的放大器。
能让你在不懂编程的情况下开发出产品,也能让你在顶级的老师辅助下搞懂以前学不动的知识,但于此同时,身体也会感觉到知识的应接不暇。
所以我的建议是,能学得进去就多学一点,学不进去的时候就照顾好身体。
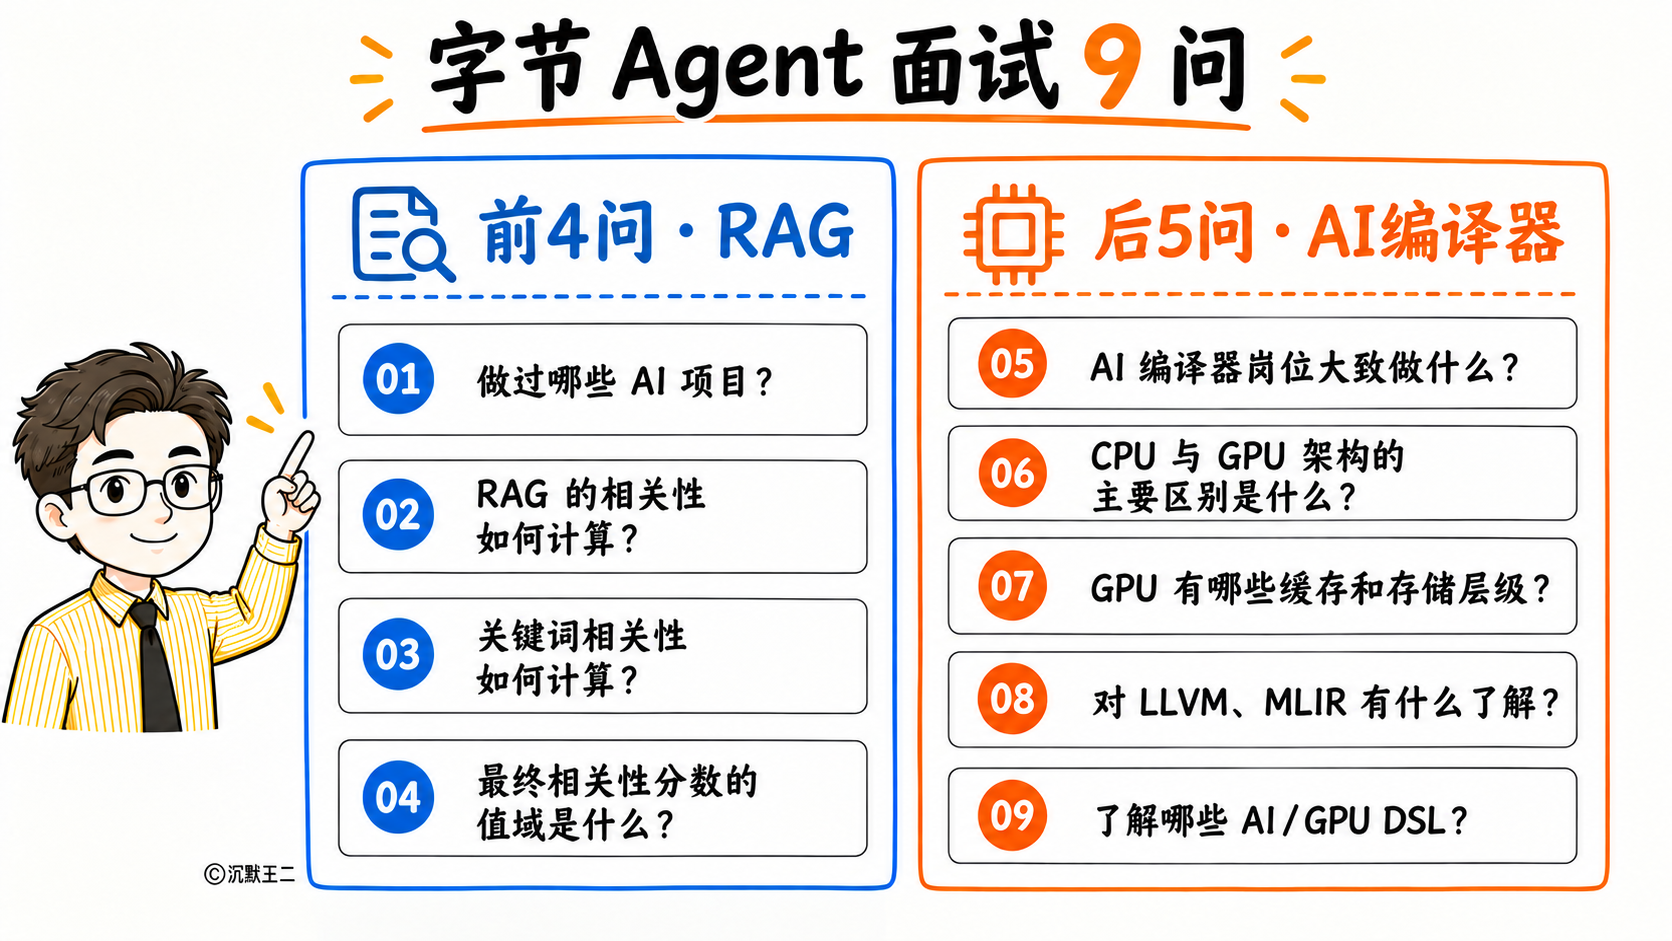
让我们开始吧。
content
01、做过哪些 AI 项目?
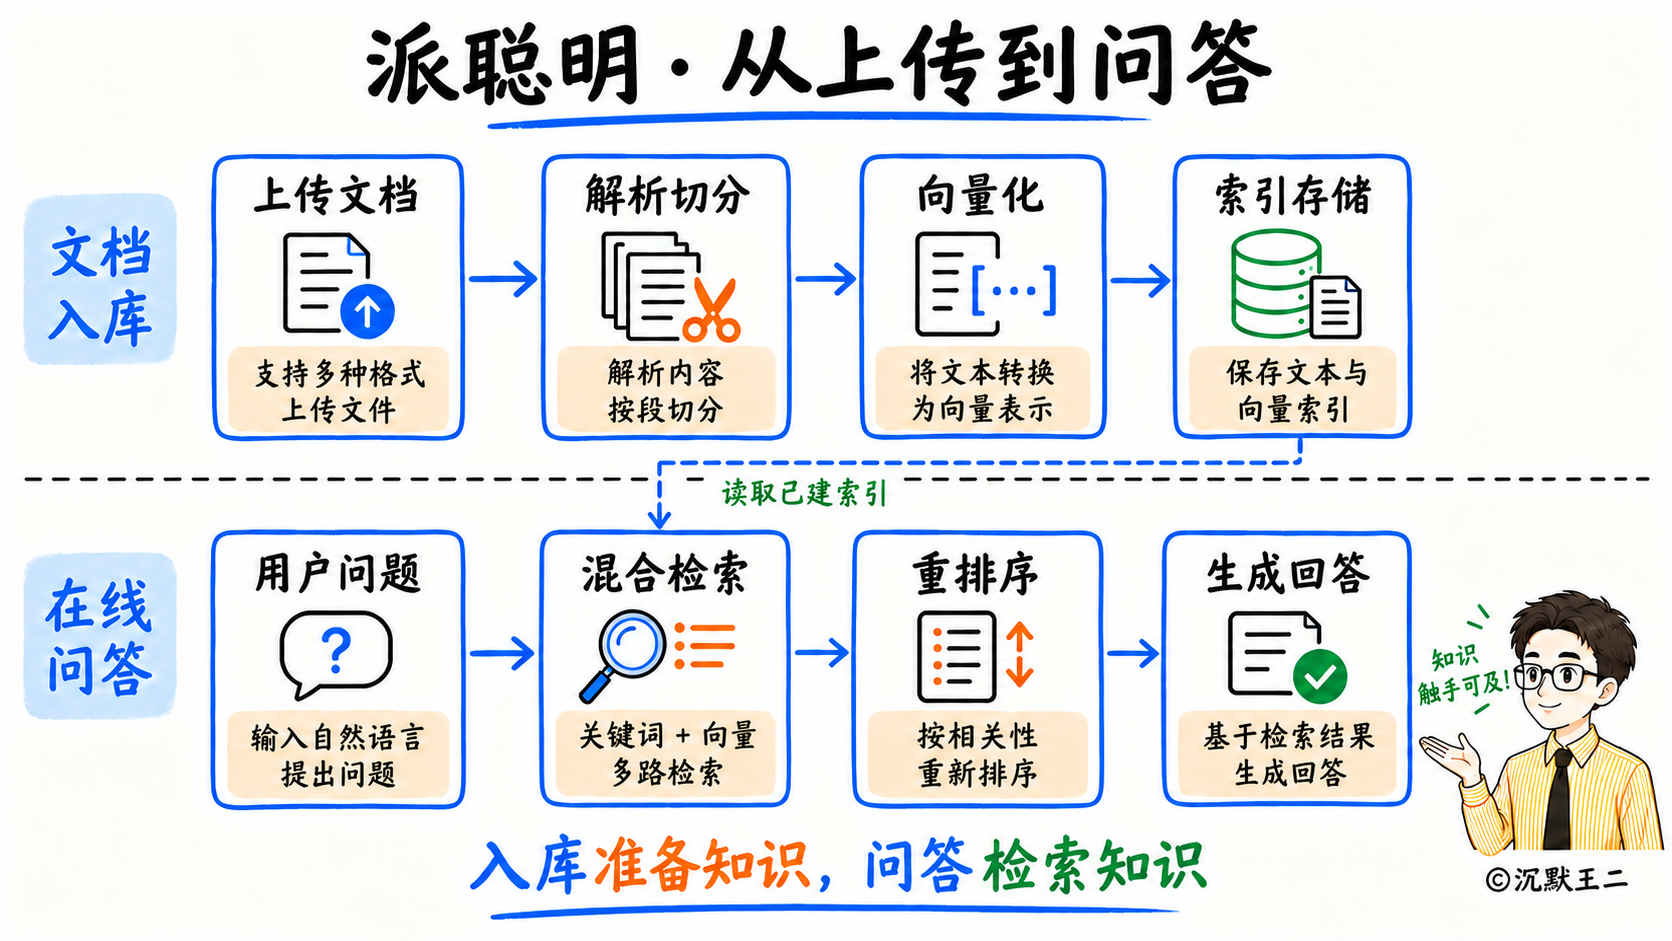
“最早做的是派聪明,一个企业级的 RAG 知识库。我做的是文档上传、解析、切分、向量化,以及问答时的混合检索。技术栈是 Spring Boot 3 加 Elasticsearch 8,Embedding 和重排序用阿里的 text-embedding-v4 和 gte-rerank-v2,大模型用的 DeepSeek,上传后的解析任务走 Kafka 异步处理,文件存在 MinIO 里。”
“第二个项目是 PaiCLI,一个 Java 写的终端 Agent。里面有 ReAct 循环、Plan-and-Execute 任务图、多角色协作三种执行模式,工具调用、代码检索、MCP 接入都是自己实现的。技术栈是 Java 17 加 OkHttp,终端界面用 JLine,代码检索用结巴分词加 SQLite,Java 文件的语法树解析用 JavaParser,Git 快照回滚用 JGit,内置了八家模型供应商的客户端。”
02、RAG 的相关性如何计算?
“派聪明一次检索其实算了三次分,向量一次、关键词一次,融合完以后还要再算一次。”
“向量这一次算的是余弦相似度。用户的问题先用 text-embedding-v4 转成 2048 维向量,Elasticsearch 里存文档向量的字段是 dense_vector,相似度函数配的是 cosine。”
“派聪明的召回窗口按请求的 topK 乘 30 算,上限 300 条,topK 默认是 5,所以向量一次取 150 条。KNN 查询里还有一个候选数,设成召回窗口的两倍,也就是 300。这个参数管的是 HNSW 图在搜索时每层保留多少个候选节点,给大一点结果更接近真实的最近邻,代价是搜索变慢。权限过滤放在 KNN 内部做预过滤,先过滤再找最近邻,不然召回 150 条里可能有一百多条这个用户无权查看,过滤完就剩不下几条了。”
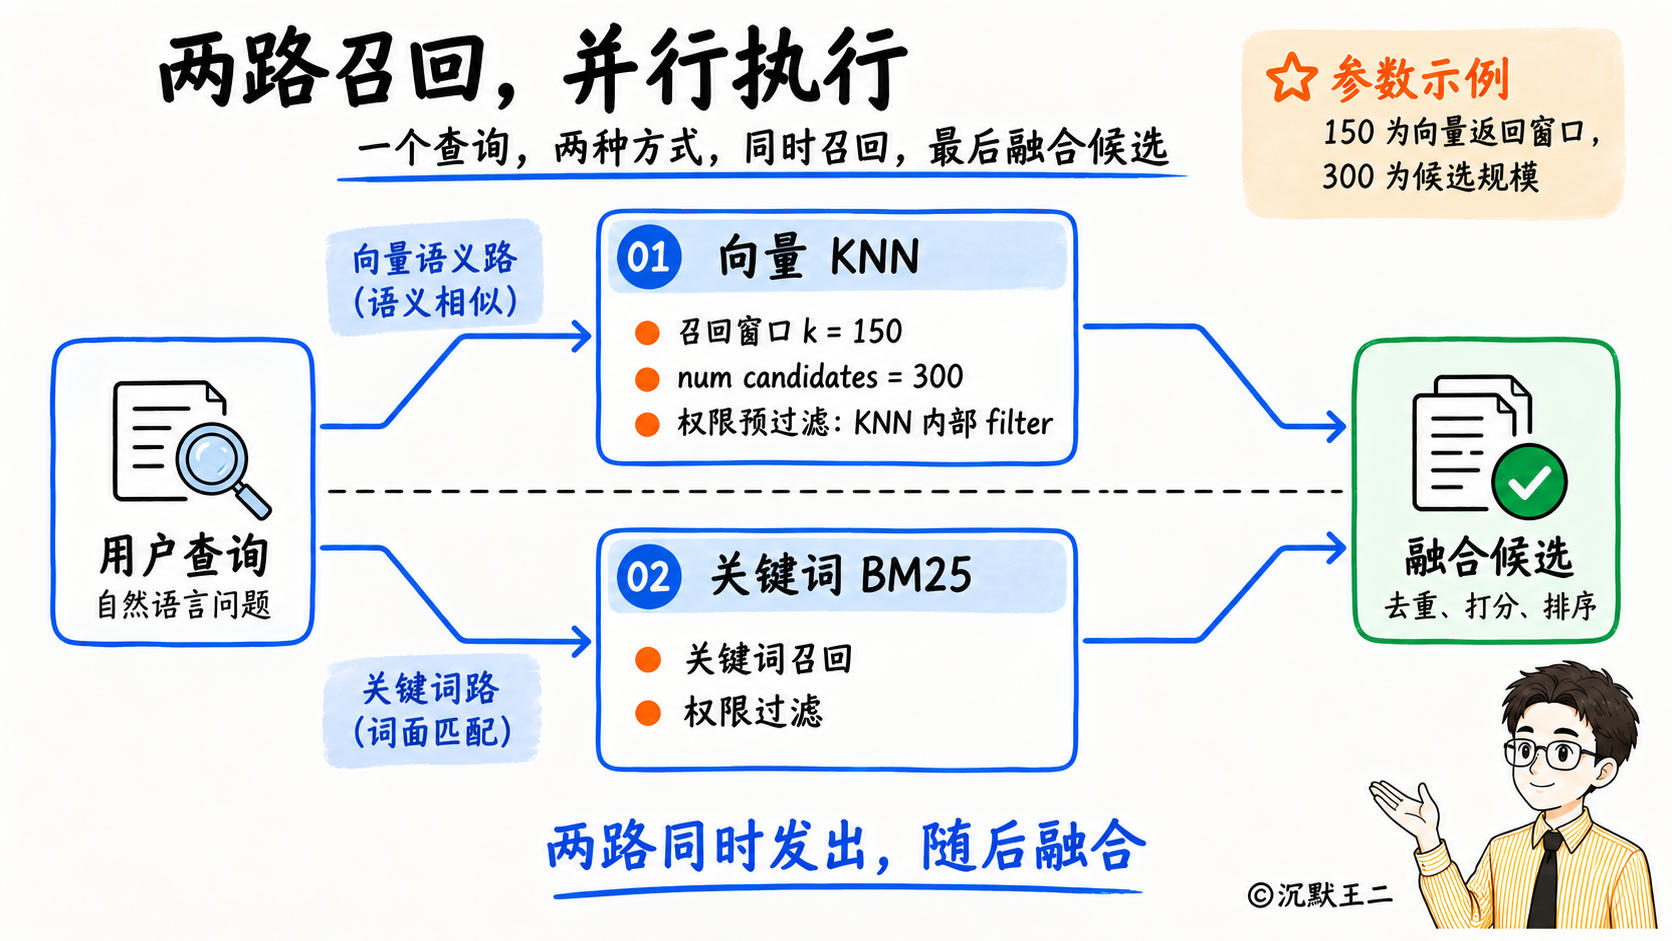
“关键词算的是 BM25。这两路是并行发出去的,用 CompletableFuture 同时执行。两路里任何一路出了问题,就用另一路的结果继续往下走,不让整次检索失败。”
“两路结果拿回来之后,向量分和 BM25 分没法直接相加。一个是零到一的相似度,一个是 BM25 算出来的分数,没有上界,两个数字不在同一个尺度上。做归一化也不靠谱,min-max 归一化要用这一批结果里的最大值做分母,同一篇文档换个问题去检索,分母变了,它的分数也跟着变,这个分数就没法用来做阈值判断了。”
“所以派聪明用的是 RRF,倒数排名融合。只看文档在每一路里排第几名,每一路贡献的分数是一除以 k 加名次,k 取 60,一篇文档的总分就是它在两路里的贡献之和。Elasticsearch 的向量分数在这一步没有被读取,用的只是名次。”
“k 取 60 的作用是压平头部的差距。如果不加这个 k,第一名贡献 1 分,第二名 0.5 分,差了一半,相当于完全相信单路的排序。加上 60 以后,第一名是 1/61,第二名是 1/62,两者很接近,一篇文档要排在前面,得在两路里都靠前,只在一路里排第一是不够的。这正是混合检索想要的效果,两种召回方式都认可的文档才是最可信的。”
“RRF 解决了排序,但它给出的分数无法表达相关程度。1/61 加 1/62 这个数字只说明这篇文档在两路里都排得很靠前,它没法告诉我这篇文档到底答不答得上用户的问题。所以融合之后还要再算一次分,派聪明把 RRF 结果的前 50 条交给 gte-rerank-v2 做精排,每条文本截断到 2000 个字符,模型返回一个相关性分数,最终的排序和过滤都用这个分数。”
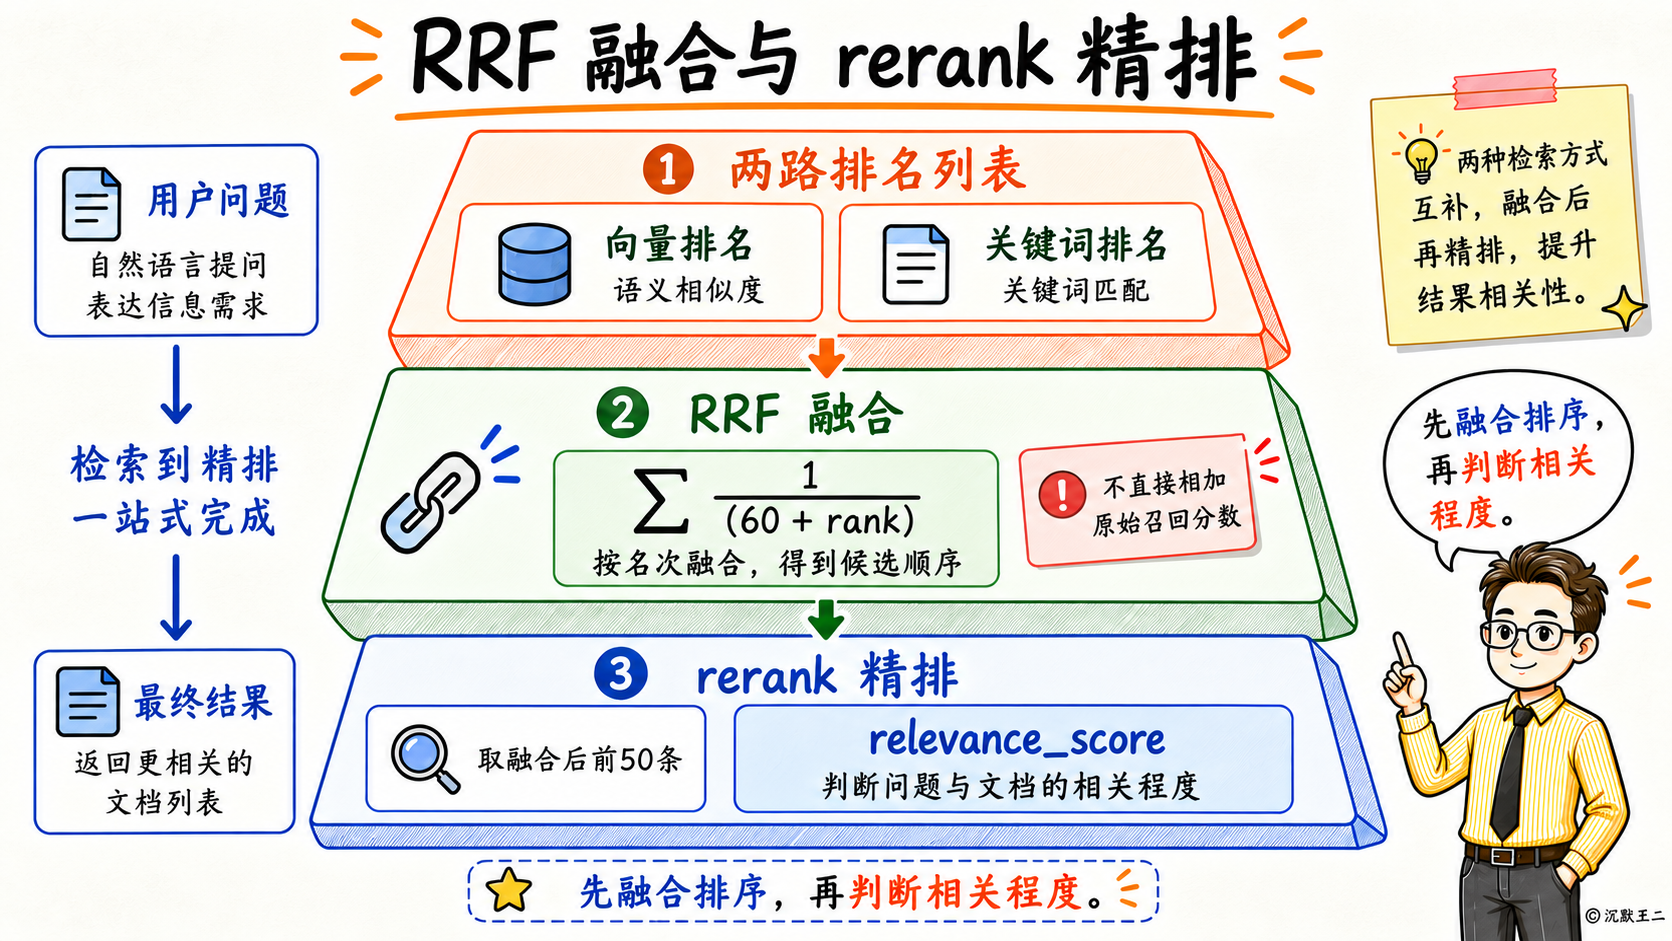
“精排用的是交叉编码器。把问题和文档拼在一起送进模型,模型能看到两者之间逐词的对应关系,所以判断得更准,代价是没法预先计算,有多少候选就要算多少次。50 条正好是一个能接受的量。”
“精排要再调用一次模型,所以它也有超时和降级。派聪明在请求入口生成一个截止时间,走到精排这一步,剩余时间不足 2 秒就跳过精排,直接用 RRF 的顺序返回。”
03、关键词相关性如何计算?
“关键词用的是 Elasticsearch 默认的 BM25,它算出来的是三个因子相乘的结果。”
“最直观的因子是词频,一个词在文档里出现得越多,这篇文档越可能是在讲这个词。但词频不能一直线性加分,出现 20 次和出现 100 次,相关程度并没有差 5 倍,所以 BM25 用参数 k1 控制加分的饱和速度,默认值 1.2,词频到了一定次数之后再增加,分数的涨幅就很小了。”
“光看词频会被常见词带偏,因为出现次数最多的往往是【的】这类词。所以每个词的贡献还要乘上一个逆文档频率,一个词在整个索引里出现在越少的文档中,它的区分能力越强,权重就越高。用户问派聪明的向量维度是多少,向量和维度这两个词只出现在少数文档里,权重高;的、是、多少几乎每篇文档都有,权重接近零。这个因子不用调,它是从索引的统计数据里自己算出来的。”
“这两个因子算完,长文档还是占便宜,因为它包含的词多,命中关键词的机会天然就大。所以 BM25 最后要按文档长度相对于平均长度做一次折算,参数 b 默认 0.75,给到 1 是完全按长度折算,给到 0 是完全不管长度。”
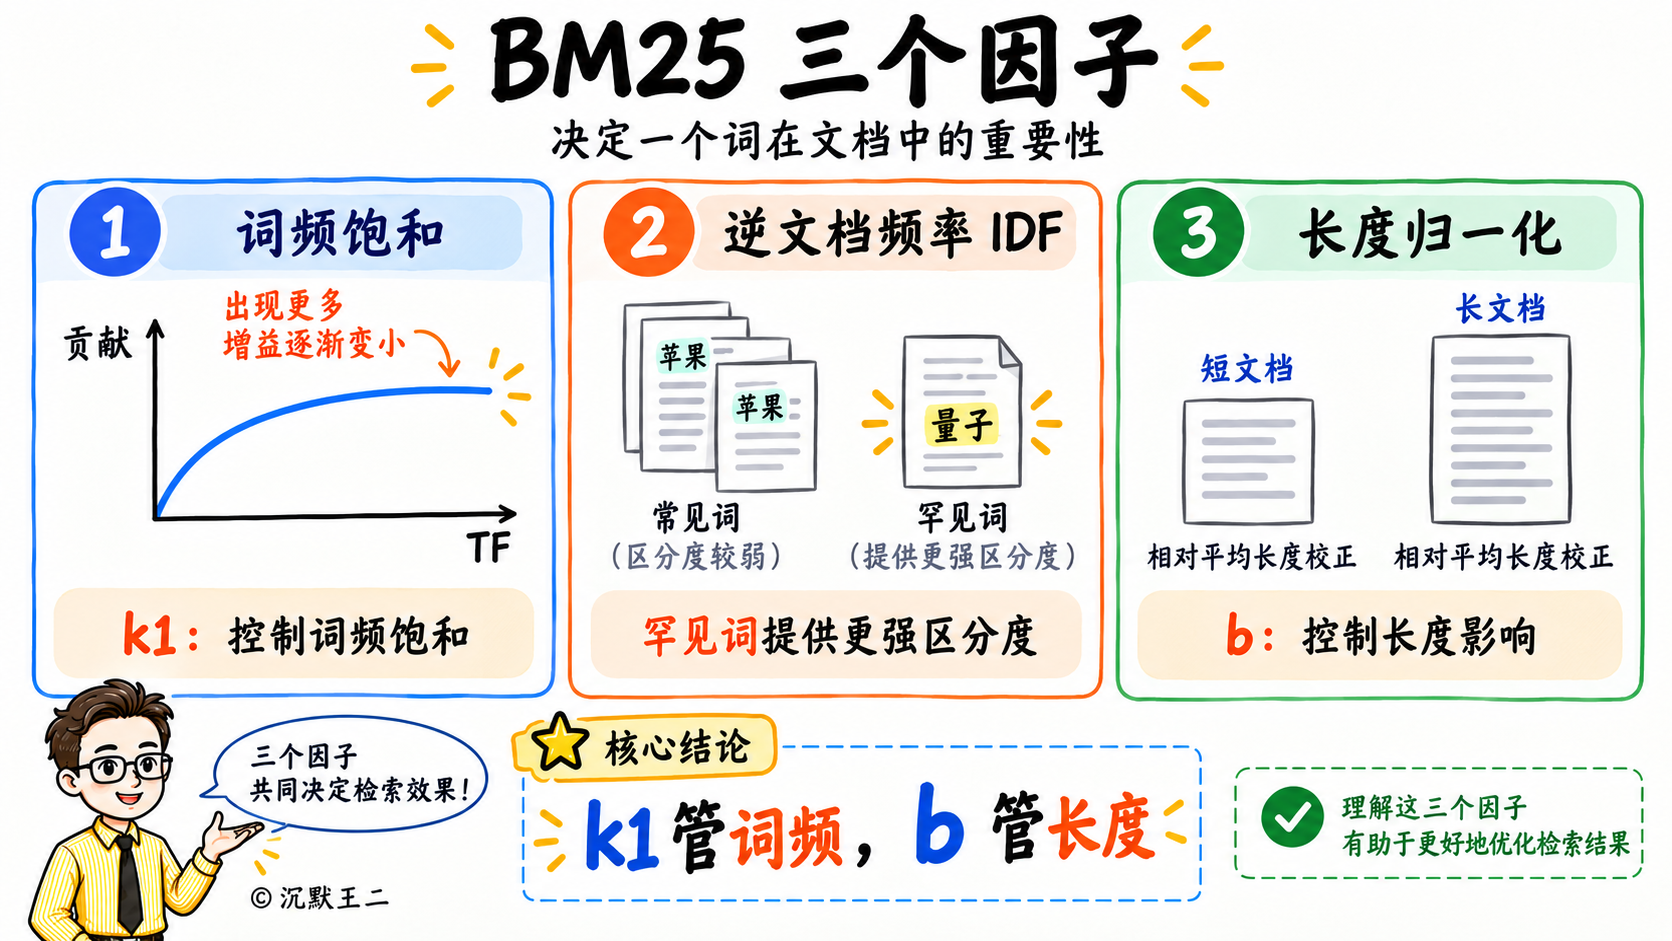
“派聪明这两个参数用的是默认值 1.2 和 0.75。知识库里的文档被切分成 512 个字符的分块,长度本来就比较均匀,长度归一化起的作用不大;一个关键词在 512 个字符里重复出现几十次的情况也很少,饱和速度调了意义不大。”
“中文这边还有一层分词。BM25 算的是词,中文得先把句子切分成词。派聪明的文本字段建索引时用 ik_max_word,查询时用 ik_smart,两边不一样。建索引用细粒度,把派聪明的向量维度切分成派、聪明、派聪明、向量、维度这些词都存进倒排索引,能被更多种问法命中;查询用粗粒度,避免用户的问题被切分得太碎,碎词命中的都是不相关的文档。”
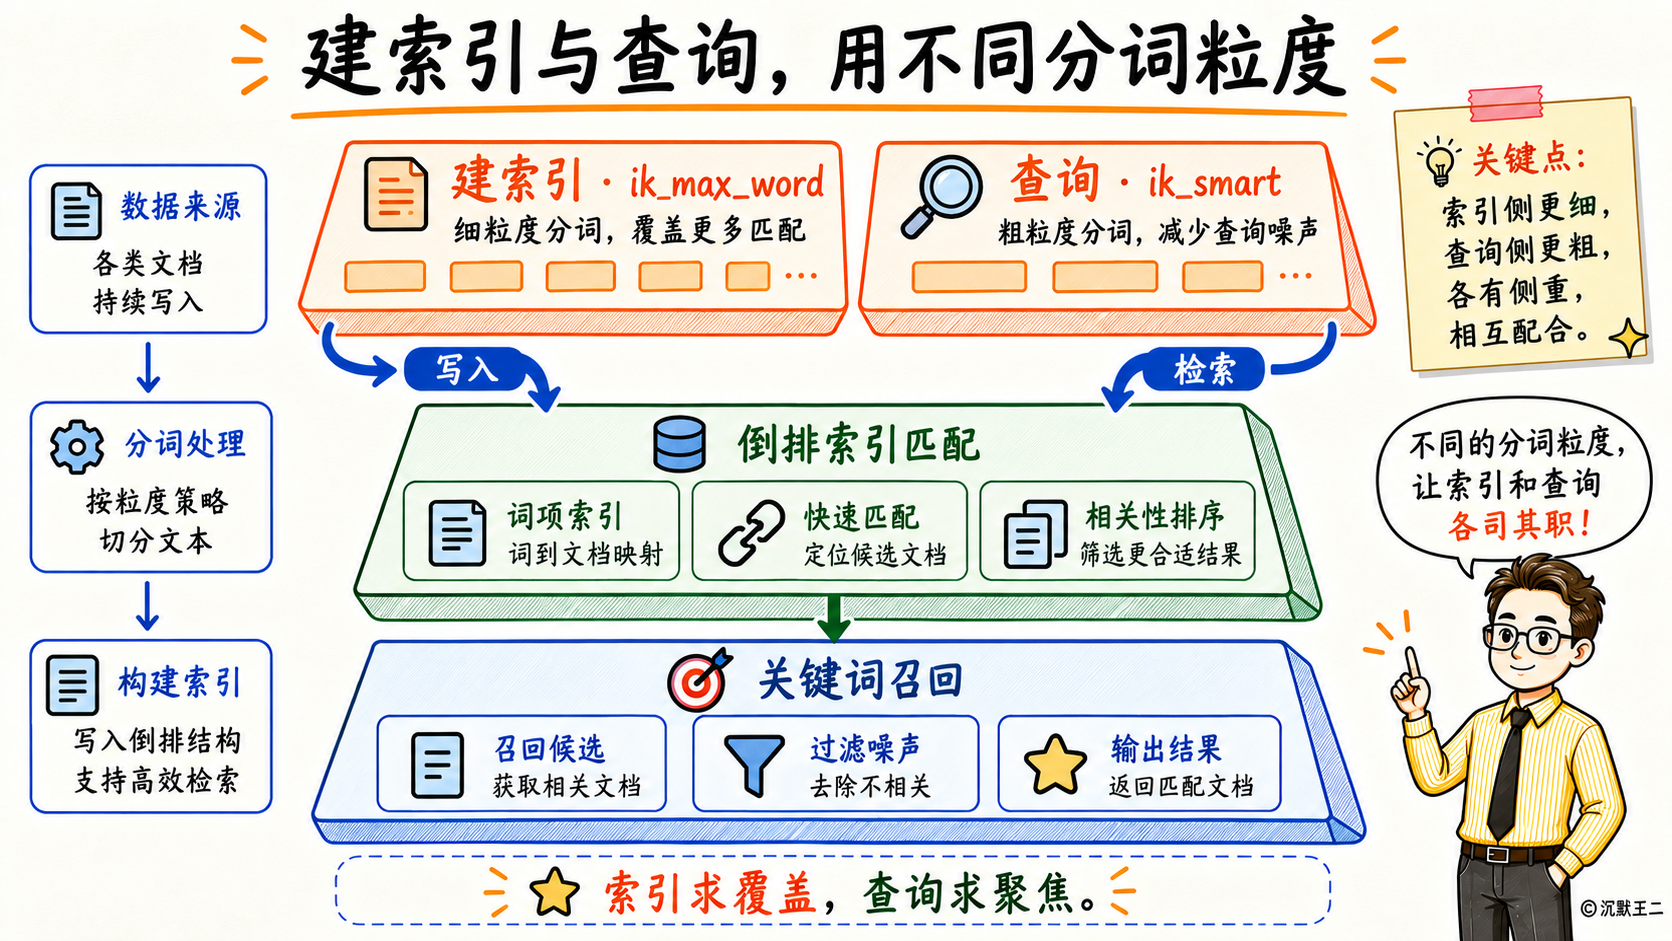
“默认的 match 查询,多个词之间的关系是或,只命中一个词的文档也会被召回。用户问一句,里面有一半是没有信息量的词,光靠 BM25 的名次,前几名很可能是只命中了某一个词的文档。所以 BM25 在派聪明里的职责只是提供一路名次,它和向量召回互相补充,谁也不单独决定结果,最终由精排模型来定。”
04、最终相关性分数的值域是什么?
“这个要分情况,因为派聪明返回的分数字段在三种模式下来源不同,值域也不同。”
“正常情况下走完整的混合检索加精排,分数就是 gte-rerank-v2 给出的相关性分数,大致在零到一之间。”
“精排被跳过或者调用失败时,返回的是 RRF 分数,值域能算出准确的上下界。两路都排第一是 1/61 加 1/61,约等于 0.0328,这是理论上的最大值;只被一路召回的文档,上界是 1/61 约 0.0164;召回窗口是 150 条,最后一名的下界是 1/210,约 0.0048。”
“向量生成失败时降级成纯关键词检索,返回的是 Elasticsearch 的 BM25 原始分数,这个分数没有上界,具体多大取决于查询词的稀有程度和文档长度,这条路径上用的是一个 0.3 的最低分过滤。”
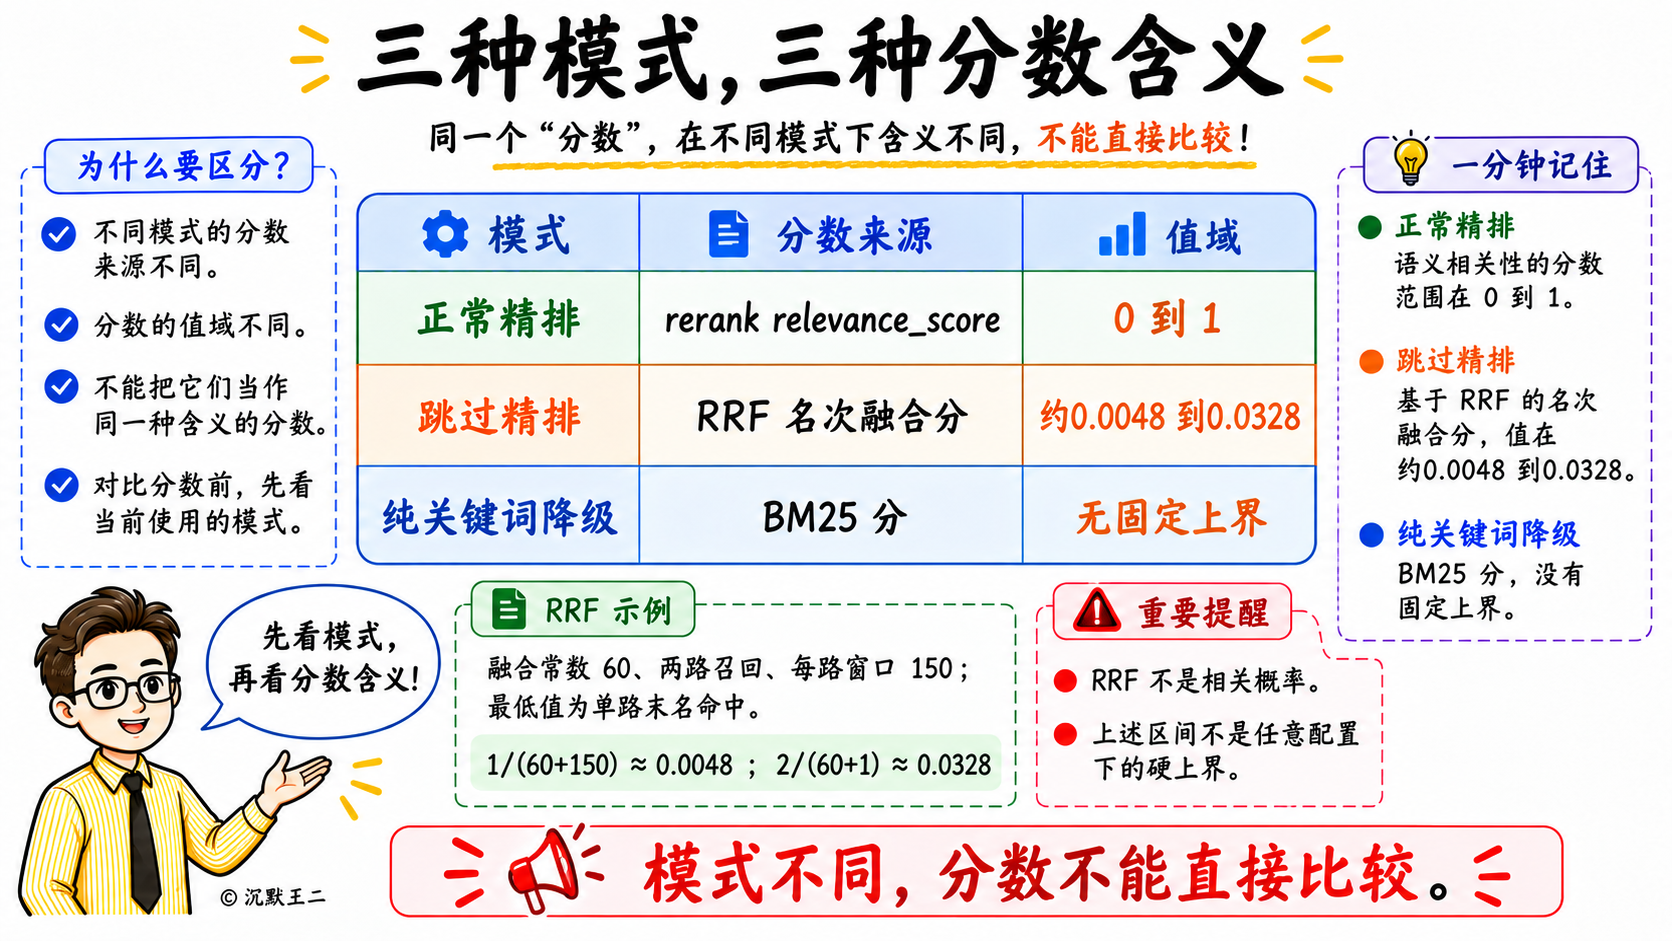
“所以这个字段的分数一定要和模式一起返回。0.02 这个数字,在精排模式下说明这篇文档几乎不相关,在 RRF 模式下却可能是排第一的结果,不带模式标记,谁拿到都会判断错。”
“模式分开之后,阈值才有地方可设,而且只能设在精排分数上。派聪明的阈值设的是 0.1,低于这个分的结果直接丢掉,不交给大模型。RRF 分数和 BM25 分数都不能套这个阈值,量纲不一样。”
“这个 0.1 是用评测集测出来的。派聪明有一个 50 道题的评测集,每道题标了应该命中哪些文档和哪段证据,改任何检索参数都要重新测一遍。阈值原来是 0.2,分块级的 Recall@5 只有 0.5652,MRR 0.4645,50 道题里有 13 道一条结果都没召回,大模型只能回答不知道。降到 0.1 之后,Recall@5 升到 0.7609,MRR 升到 0.5902,空检索降到 0,文档级的召回率到了 1.0。”
“评测时发现,用户问得比较口语化的时候,正确的那个分块只拿到 0.14 到 0.19 分,阈值定在 0.2,正确答案就被过滤掉了。”
05、AI 编译器岗位大致做什么?
“我的理解是,这个岗位做的事情是把一个算子的数学描述,翻译成在特定硬件上执行得最快的机器码。往上接框架导出的计算图,PyTorch 这一层,或者 StableHLO 这类中间表示;往下接硬件的指令集,NVIDIA 上是 PTX,昇腾和寒武纪各有自己的一套。”
“具体的工作,我的理解是从一个算子的内部往外扩展。最里面是算子的调度,一个矩阵乘怎么分块才能让数据留在片上存储里、怎么向量化、搬运和计算怎么重叠起来形成流水线。单个算子调好了,放到整张计算图里还有新的空间,相邻的算子融合成一个就能省掉中间结果来回写显存,数据用什么排布、显存怎么复用也要跟着一起定下来。算子内部和整张计算图这两处的决策合起来,会产生大量的参数组合,同一个算子换个输入形状、换一张卡,最优的那一组就变了,所以最后还要有自动调优去搜索这些参数。”
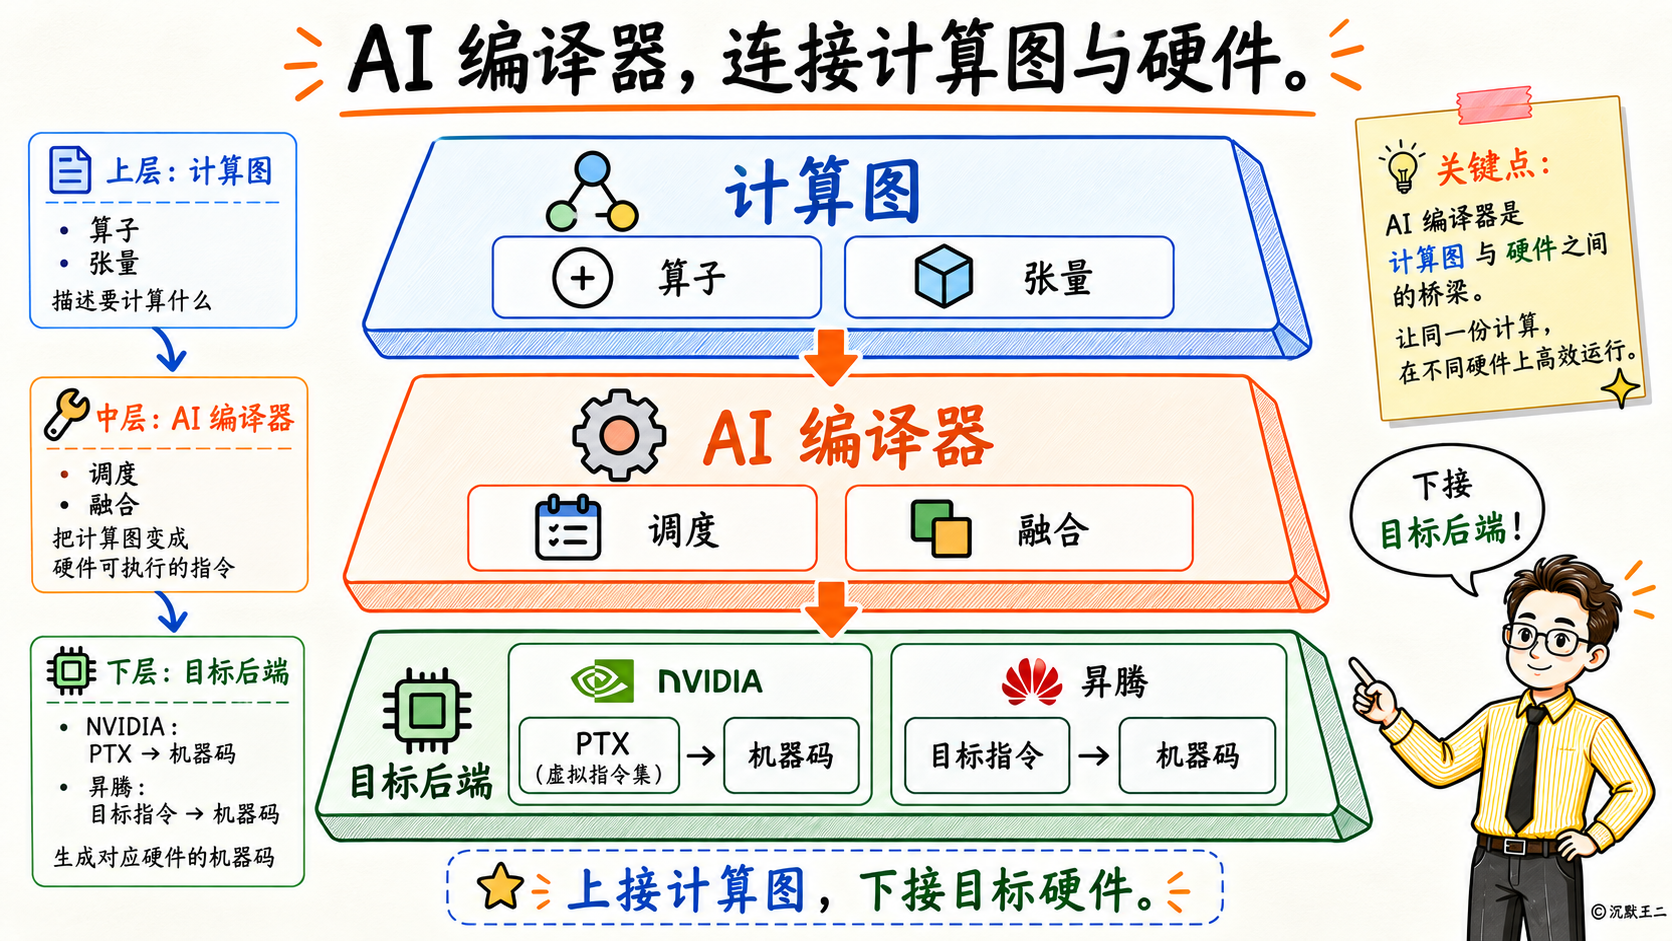
“字节在这个方向的开源项目能看出日常工作的样子。ByteIR 是一套基于 MLIR 的模型编译方案,前端把模型降到 StableHLO,编译器部分复用上游 MLIR 的方言,pass 和上游兼容,可以混着用。”
“ByteIR 管的是把模型编译出来,Flux 和 Triton-distributed 管的是多卡之间的通信怎么不拖慢计算。大模型用张量并行或者专家并行切分到多张卡上之后,每一层算完都要做一次集合通信,通信的时候计算单元在等着,利用率就掉下来了。Flux 的做法是把通信和计算都切分成很细的 tile,再融合进同一个大 kernel,ReduceScatter 融进矩阵乘 kernel 的收尾阶段,也就是 epilogue,AllGather 融进开头的 prologue。它论文里给的数字是,128 卡训练的吞吐最高能到 Megatron-LM 的 1.24 倍,推理的 prefill 和 decode 最高能到 vLLM 的 1.66 倍和 1.30 倍。”
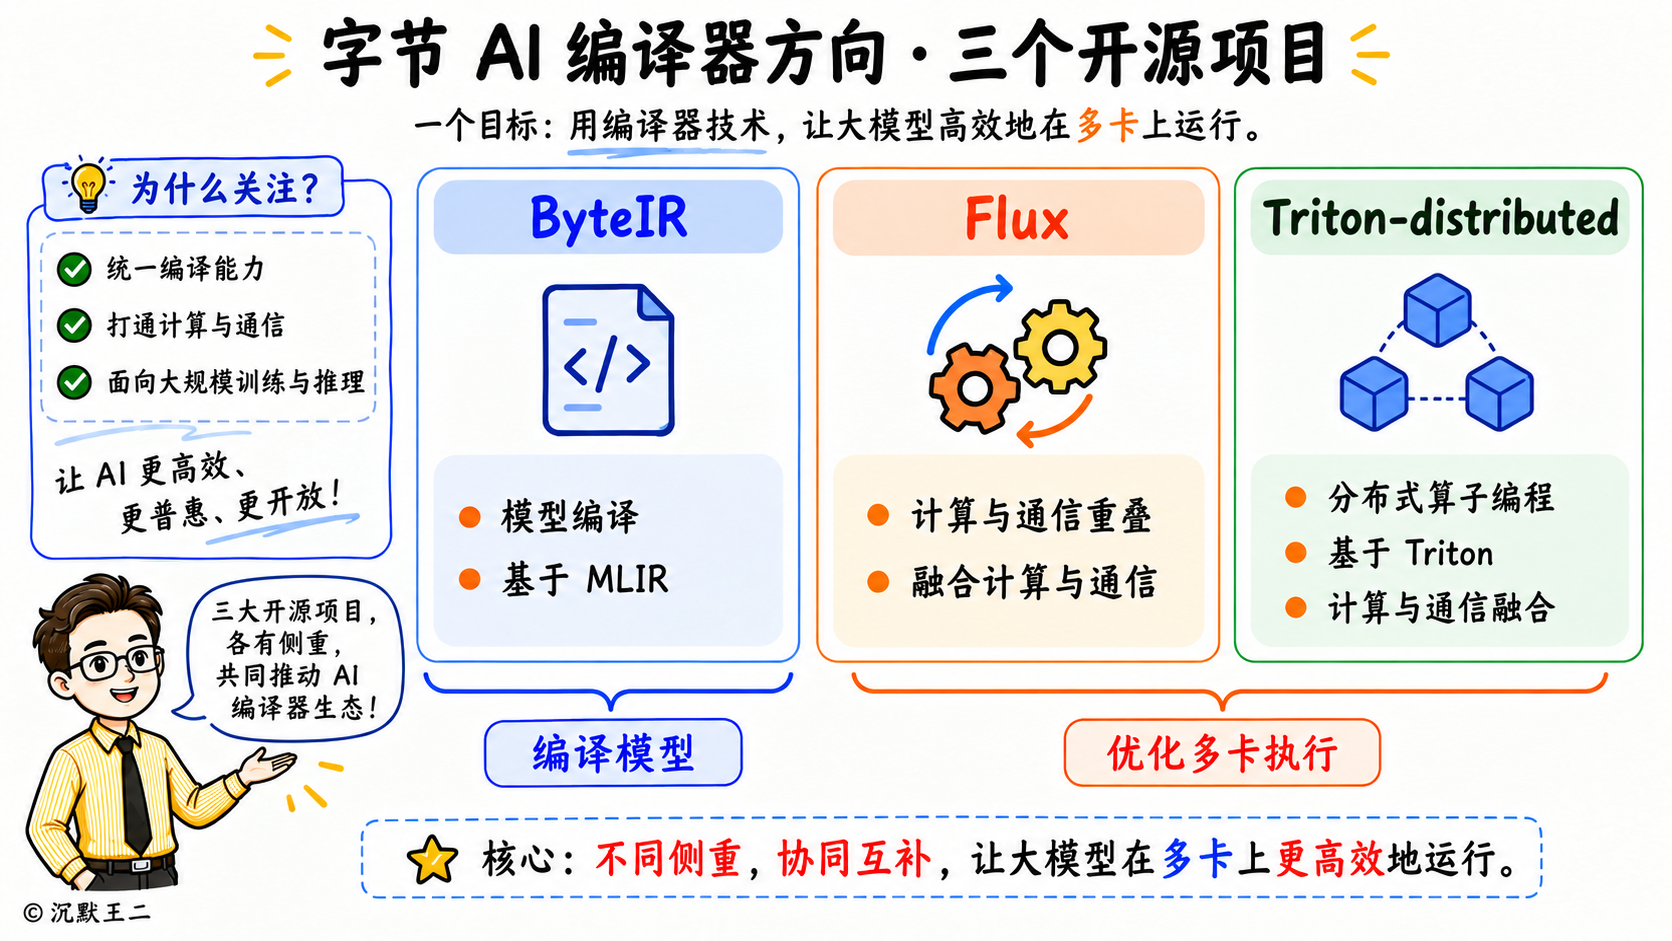
“Flux 是把融合做好了直接提供现成的算子,Triton-distributed 则是把这件事做成编程模型,让写算子的人自己融合。它基于 Triton,给每张卡分配一块同样大小的全局缓冲区,叫做对称内存,写算子的人可以直接读写别的卡上对应位置的数据;同步用的信号对象也放在这块对称内存里,通过信号交换判断对方的数据到没到。这样计算和通信可以写在同一个 kernel 里。它论文里报告 MoE 场景下部分算子的加速超过 40 倍,这个数字比的是单个算子,和上面 Flux 的端到端吞吐不是一个口径。”
“我自己的判断是,这个岗位和写业务代码的差别不在语言,C++ 和 Python 都是工具。差别在于评价标准只有一个,在目标硬件上快了多少倍,所以得能读硬件手册、会用 profiler 看计算单元有多少时间是空闲的。这两样我都还不具备,所以我做的是上层的 Agent 和 RAG,编译器这一块只是了解。”
06、CPU 与 GPU 架构的主要区别是什么?
“最根本的区别是晶体管花在了什么地方。CUDA 的编程指南里有一张图,说 GPU 把更多晶体管用于数据处理,而不是数据缓存和流程控制。”
“这个取舍是从内存延迟来的。读一次显存要几百个时钟周期,两边处理这个延迟的思路不同。CPU 的办法是想方设法避免这次等待,用大容量的多级缓存把数据留在近处,用分支预测提前猜测走哪条路,用乱序执行让后面不依赖的指令先执行。这些部件很占面积,但它们能把单个线程的执行时间压到最短。”
“GPU 的办法是不去避免,而是让等待的时间被别的线程用掉。一组线程卡在访存上,调度器就切换到另一组已经准备好的线程去执行。所以 GPU 不需要分支预测和乱序执行这些部件,省下来的面积全用来放计算单元和寄存器。CUDA 文档里明确写了,GPU 的指令是按顺序发射的,没有分支预测,也没有推测执行。”
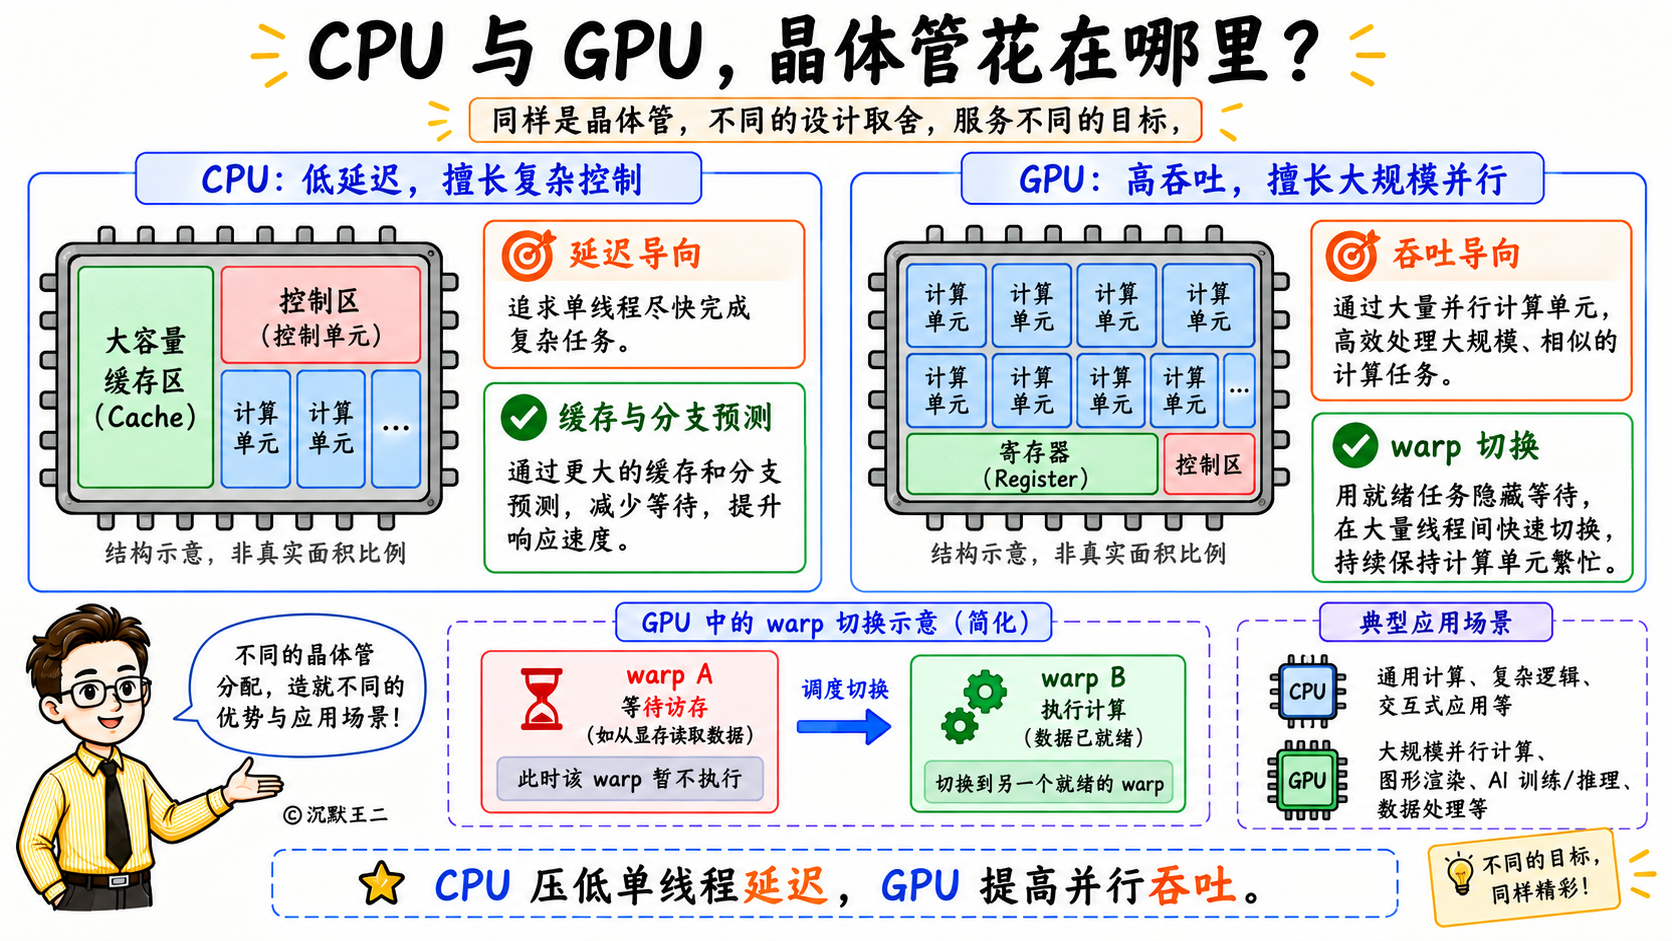
“第二个区别是线程的组织方式。GPU 用的是 SIMT,单指令多线程。流式多处理器,也就是常说的 SM,以 32 个线程为一组创建、管理、调度和执行,这一组叫一个 warp,一条指令下去就是 32 个线程同时做同样的操作。”
“这个模型直接影响代码怎么写。既然 32 个线程共用一条指令,那么一个 if else 如果让同一个 warp 里的线程分叉,硬件只能先执行一条分支、把不走这条路的线程屏蔽掉,再执行另一条分支,两条路都要走一遍。所以在 GPU 上写条件判断,要尽量让分叉发生在 warp 之间,而不是 warp 内部。Volta 之后引入了独立线程调度,warp 内的线程有了各自的程序计数器,但两条分支都要执行的开销还在。”
“第三个区别是规模。H100 的 SXM5 版本有 132 个 SM,完整的 GH100 芯片是 144 个,PCIe 版本是 114 个。每个 SM 上还能同时驻留几十个 warp。这个量级决定了优化的方向。CPU 上优化是减少指令数和分支误判,GPU 上优化是提高占用率和让访存合并,占用率指的是每个 SM 上同时驻留的 warp 数量占上限的比例。同一个算法在两边的最优写法往往完全不同。”
07、GPU 有哪些缓存和存储层级?
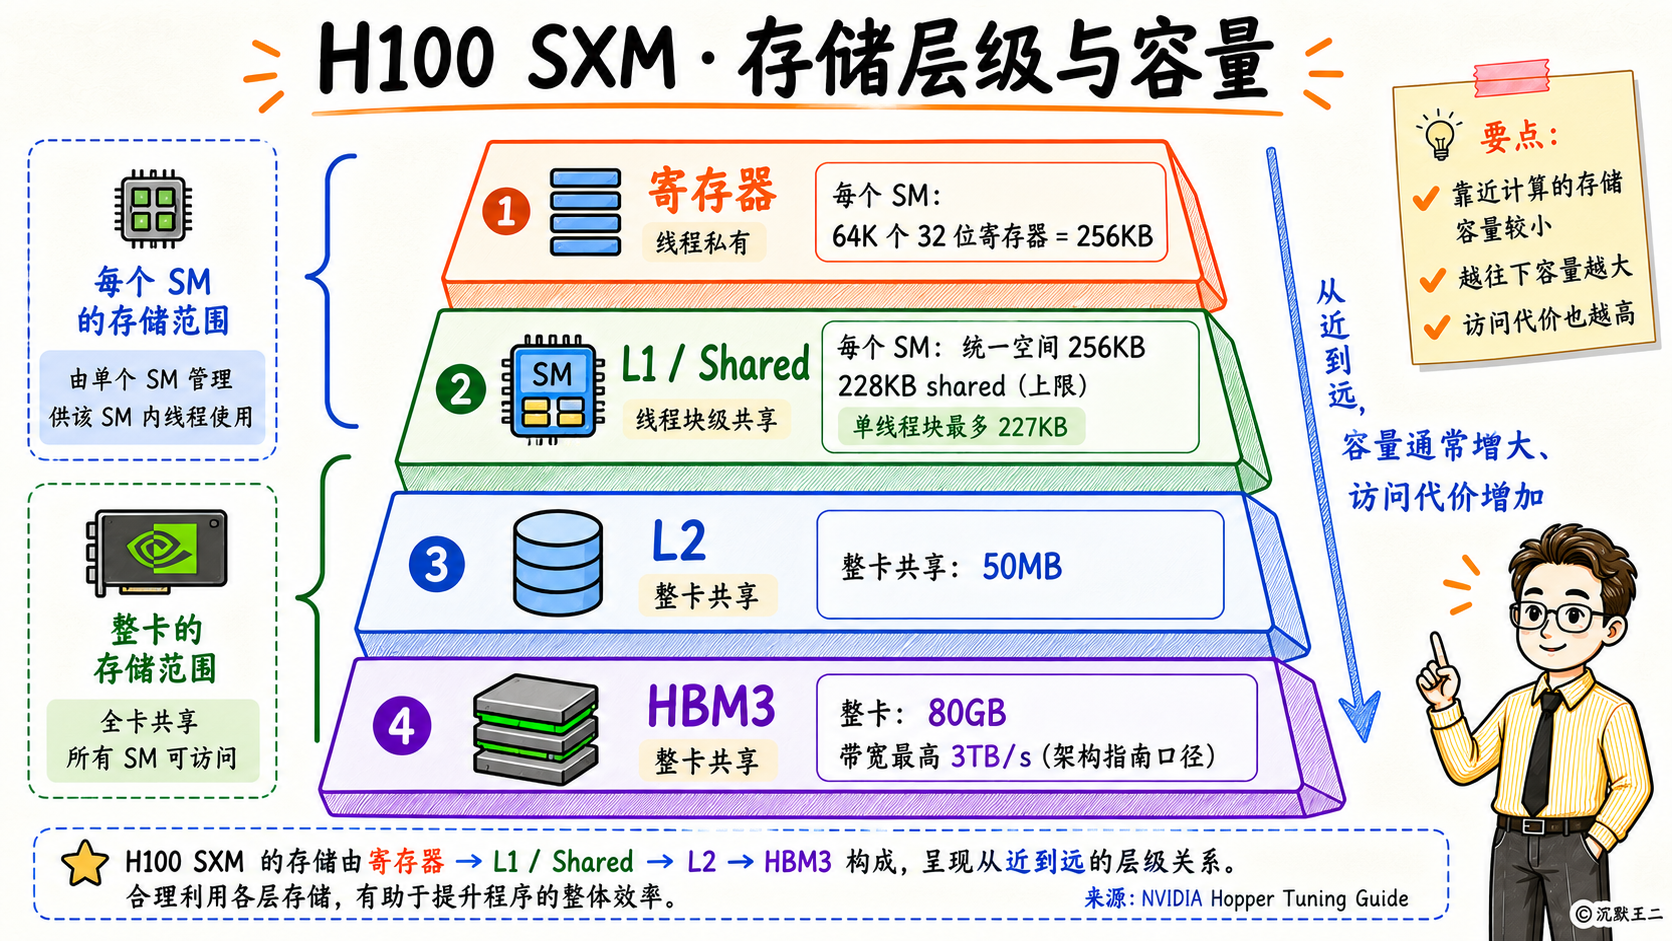
“按离计算单元的远近,从近到远说,以 H100 为例。”
“最近的是寄存器。每个SM有 64K 个 32 位寄存器,换算过来是 256KB,单个线程最多能用 255 个。寄存器是按线程私有的,一个 kernel 用的寄存器越多,能同时驻留的 warp 就越少,占用率就下降,这是写 kernel 时第一个要权衡的地方。”
“往下是 L1 缓存和共享内存。H100 把 L1、纹理缓存、共享内存合并成一块 256KB 的空间,A100 上是 192KB。这块空间的划分是可配置的,共享内存最多能分到 228KB,单个线程块最多用 227KB,CUDA 自己留了 1KB。可选的档位是 0、8、16、32、64、100、132、164、196、228KB。要注意静态声明的共享内存仍然只能到 48KB,超过这个数得用动态分配的方式申请。”
“同一层还有常量缓存。常量内存总共 64KB,每个SM上的常量缓存工作集是 8KB,从早期的计算能力版本到现在都没变过。kernel 的参数,编译器也可能放进常量内存。纹理缓存现在不是独立结构了,已经并进上面说的那块统一数据缓存,所以它的容量会随架构和划分配置变化,官方文档给的是一个区间而不是定值。”
“再往下是 L2,H100 是 50MB,A100 是 40MB。L2 是整张卡共享的,所有SM都经过它访问显存。”
“最远的是显存。H100 的 SXM 版本是 80GB 的 HBM3,带宽这里有两个口径,架构文档写的是最高 3TB/s,产品数据手册给的是 3.35TB/s,看文档时要注意是哪个口径。Blackwell 的 B200 按官方口径是 180GB 的 HBM3e,带宽最高 8TB/s。网上流传的 192GB 是物理堆栈容量,不是官方规格里的可用容量。L2 这一层,NVIDIA 给 Blackwell 公布的是 GB200 上 126MB。”
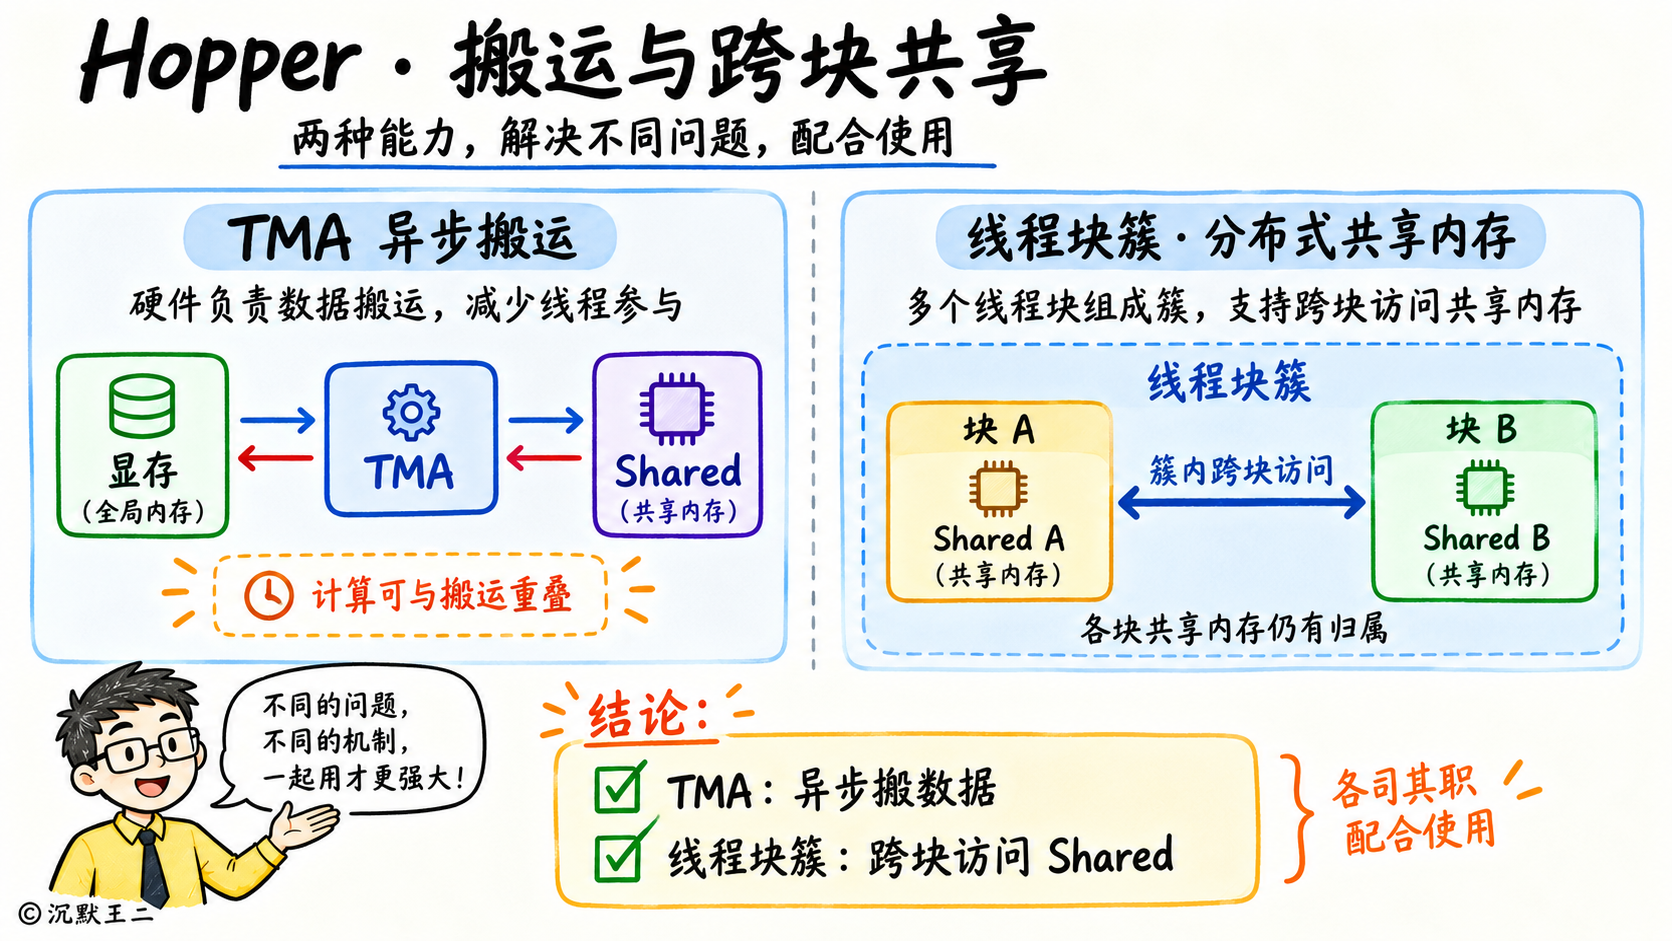
“Hopper 这一代在层级之外还加了新东西。先说 TMA,张量内存加速器,它是一个异步搬运引擎,能在显存和共享内存之间搬运一维到五维的张量,往显存写回时还能顺带做按元素的归约。有了它,搬数据不用再占着计算单元一个一个算地址。”
“搬运这一步解决了,剩下的问题是容量。共享内存还是卡在每个 SM 228KB,单个线程块能用的就这么多。所以 Hopper 又加了线程块簇,计算能力 9.0 引入的新一层线程层级。一个簇里的线程块保证被调度到同一个 GPC 上,可移植的最大规模是 8,打开一个允许非可移植簇规模的开关之后可以用 16,但就不能跨架构移植了。簇存在的意义是分布式共享内存,簇内的线程块可以互相读写、原子操作对方的共享内存,相当于把多个SM的共享内存拼成一块更大的空间,总量等于簇内块数乘每块的共享内存大小。官方建议这种跨块访问要合并,并且按 32 字节对齐。”
“Blackwell 又加了一层张量内存。PTX 的文档里写的是,在 sm_100 上第五代 Tensor Core 的张量内存按 CTA 组织,CTA 就是线程块,512 列乘 128 行,每格 32 位,换算下来是 256KB。它的分配很有讲究,以列为单位,最少 32 列,列数必须是 2 的幂,而且必须由同一个 warp 申请和释放,每个 warp 只能访问属于自己的那 32 行,也就是 32 个 lane。配套的矩阵乘指令是 tcgen05.mma,Hopper 上的 wgmma.mma_async 在 Blackwell 上已经弃用了。这一层只有数据中心的 Blackwell 有,消费级的那一版没有。”
“这些层级的规律是一致的,越往下容量越大、带宽越低、延迟越高。所以 kernel 优化的大部分工作就是想办法把数据留在上面几层,分块的大小、什么时候预取、要不要用 TMA,都是在算这件事。”
08、对 LLVM、MLIR 有什么了解?
“我是从一个问题开始了解这套东西的,深度学习编译器为什么不直接用 LLVM IR。”
“因为 LLVM IR 的抽象层次太低了,它只有标量和定长向量,没有张量这种类型,也没有循环嵌套这种结构。一个矩阵乘降到 LLVM IR 之后,就变成了三层嵌套循环加标量的乘加,循环之间的依赖关系、哪些循环可以交换顺序、哪两个算子可以融合,这些信息在降下来的过程中就丢掉了。LLVM 擅长的是降到这一层之后的事情,寄存器分配、指令选择、指令调度。”
“MLIR 的解法是不急着降到底,分很多层慢慢降,这就是渐进式 lowering。每一层用一种方言(dialect)来表达,不同层的方言可以共存在同一个模块里,一边降一边优化。”
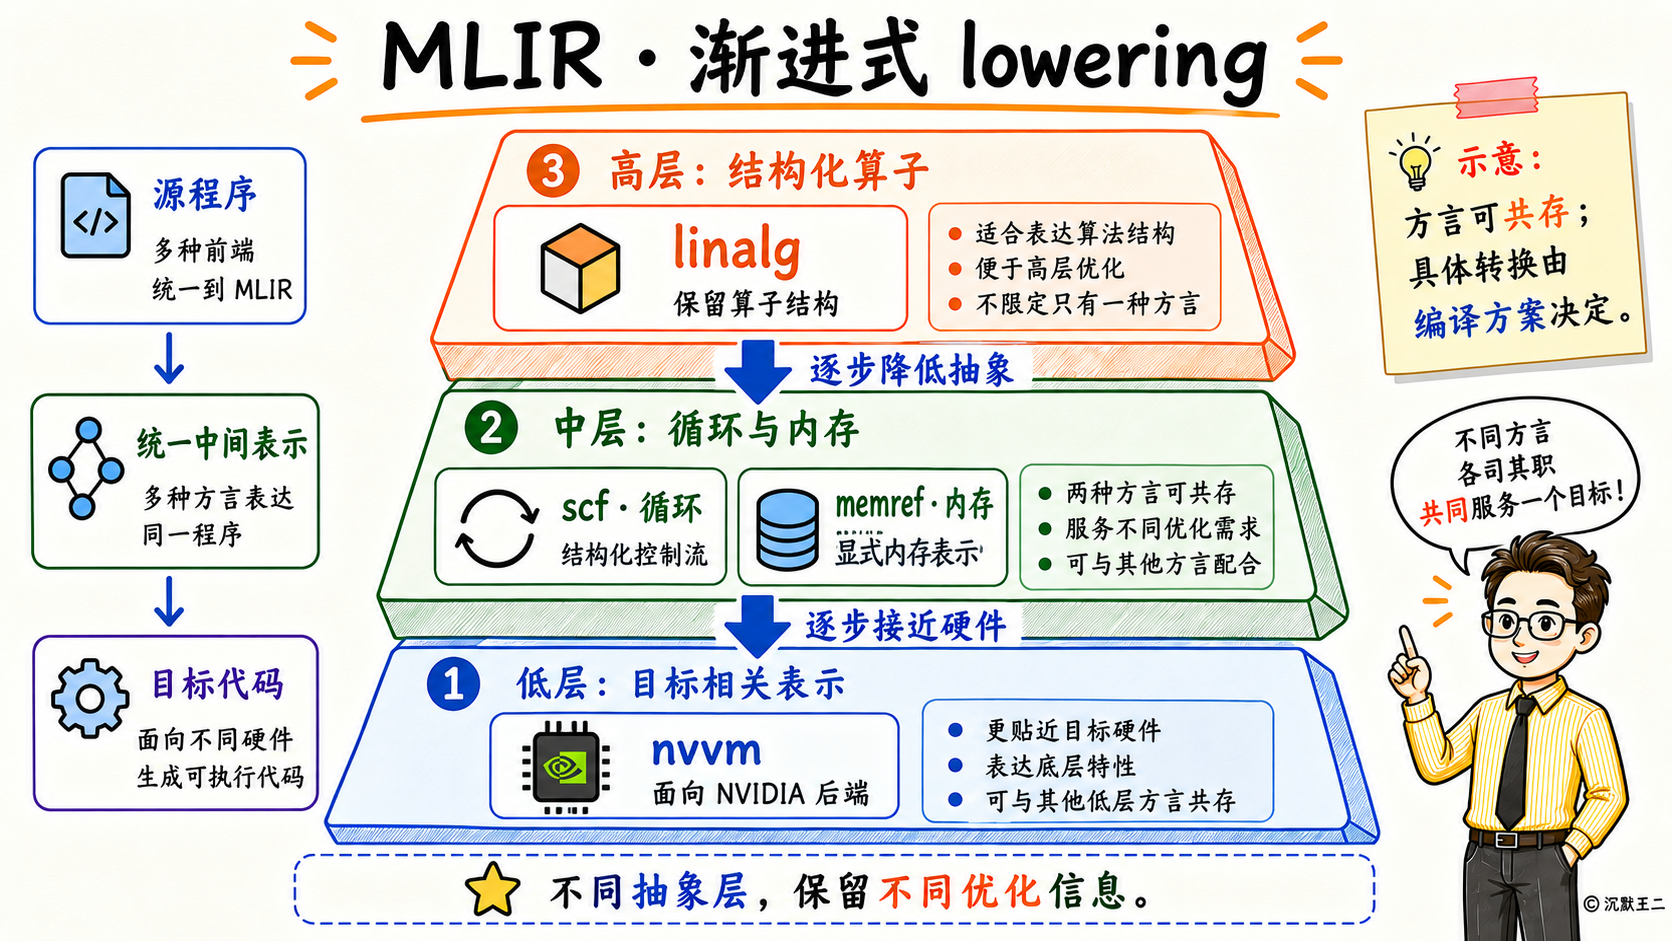
“常见的方言按层次排下来大概是这样。linalg 表达结构化的算子,一个矩阵乘在这一层还是一个完整的算子,循环分块、算子融合这些变换在这一层做最方便。tensor 和 memref 分别是值语义和内存语义,中间要经过一次 bufferization,把张量变成具体的内存缓冲区。affine 和 scf 表达循环,affine 的限制更严格,但正是因为限制严格,依赖分析才做得准。arith 是算术运算。再往下 gpu 方言表达线程和块的概念,nvvm 对应 NVIDIA 的那套内建函数,最后降到 llvm 方言,交给 LLVM 后端生成机器码。”
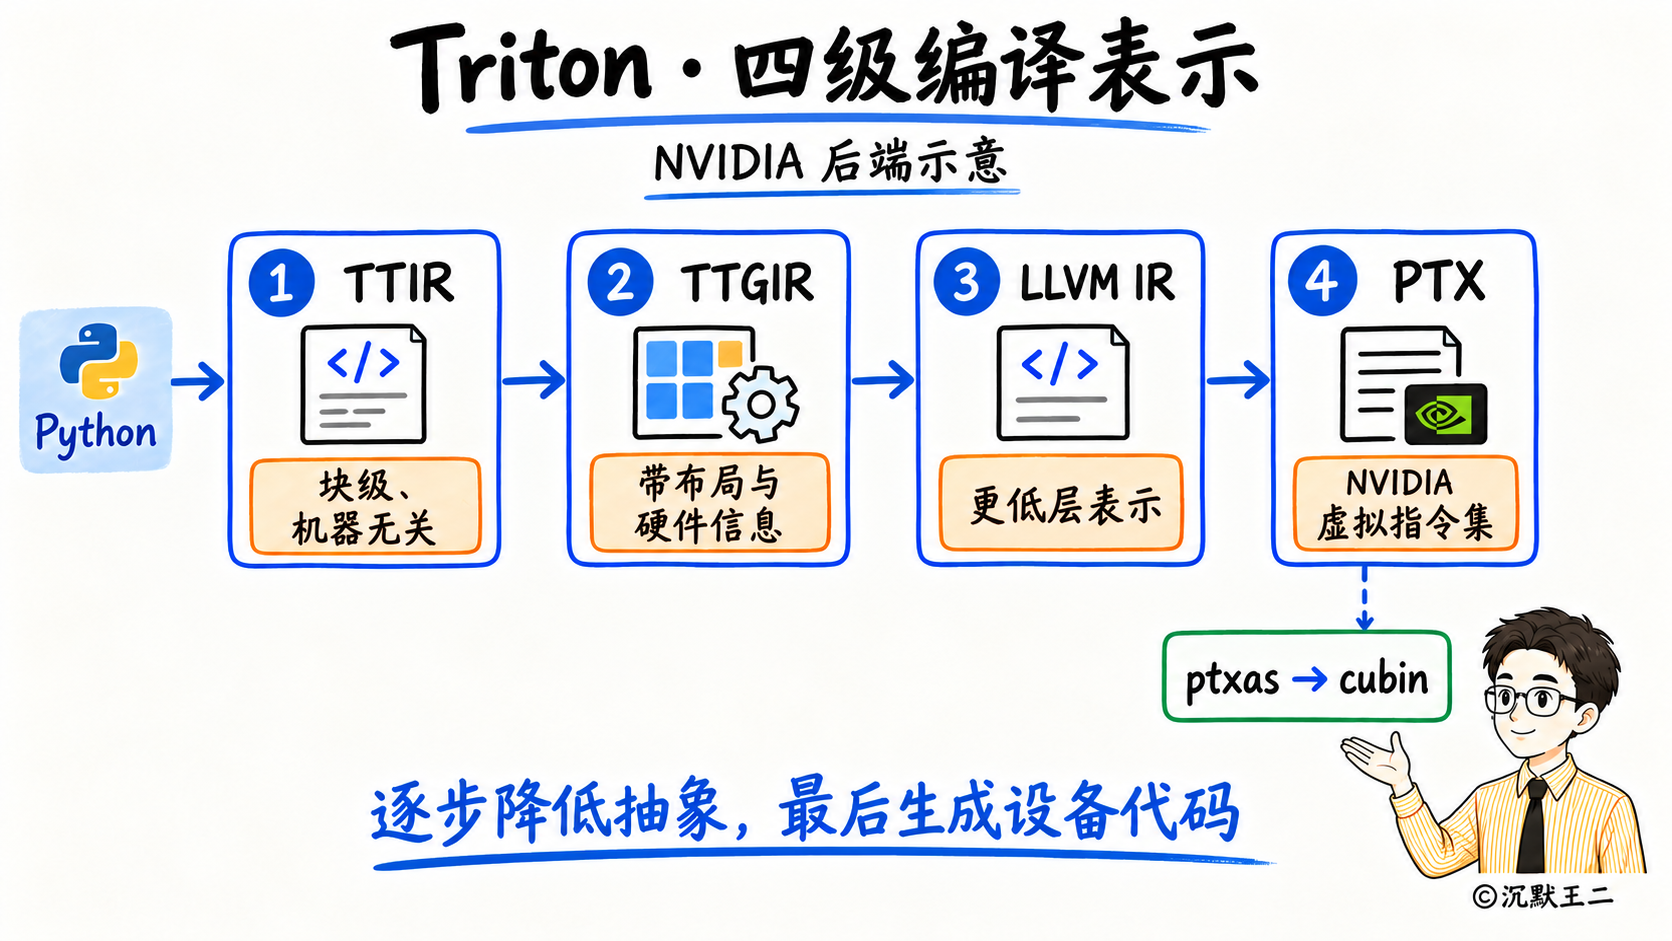
“这套分层拿 Triton 来看最直观。Triton 的编译分四级。先把 Python 源码转成 TTIR,这一层是块级的、和机器无关的表示。然后降到 TTGIR,这一层带上了硬件信息,数据在 warp 之间怎么分布、访存怎么合并、用哪种布局。中间执行的都是 MLIR 的 pass,比如 remove_layout_conversions 消除多余的布局转换、accelerate_matmul 给矩阵乘换上硬件加速指令、optimize_dot_operands 优化点积的操作数。再从 TTGIR 降到 LLVM IR,生成 PTX,最后由 ptxas 编译成 cubin。各个后端把这些阶段注册在自己的 compiler.py 里,AMD 后端前三级完全一样,之后换成 amdgcn 和 hsaco。”
“MLIR 的来历是,2018 年在 Google 启动,2019 年 4 月先放在 TensorFlow 仓库里,9 月 Chris Lattner 在 llvm-dev 邮件列表提案,10 月 LLVM 基金会正式接受,12 月底代码合入 LLVM 的主仓库,目录就是 mlir。所以它现在是 LLVM 项目的一部分,不是一个独立项目。”
“我没有写过 MLIR 的 pass。我了解的是这套分层为什么要这么设计,以及调试时怎么把每一层的 IR 打印出来对照着看。真让我上手写一个 pass,我需要时间。”
09、了解哪些 AI/GPU DSL?
“我按抽象层次从低到高说,顺便说一下它们各自适合什么场合。”
“最贴近硬件的那一层,有 CUTLASS 的 CuTe DSL 和 ThunderKittens。CuTe DSL 是 NVIDIA 从 CUTLASS 4.0 开始提供的 Python 接口,抽象和 C++ 版的 CuTe 是同构的,还是在和布局、张量、原子操作这些概念打交道,pip 包名是 nvidia-cutlass-dsl,目前还标着 public beta。ThunderKittens 是斯坦福 Hazy Research 的一个 C++ 库,它的基本数据结构是 warp 级的 16 乘 16 矩阵块,块级的代码按加载、计算、存储、收尾这个模板写。这一层的特点是性能上限高,但要求写的人清楚每一条数据在硬件上的位置。”
“往上一层是 Triton,现在的事实标准。它的取舍是只管块级的逻辑,一个块里的数据怎么分给 32 个线程、共享内存怎么分配,交给编译器决定。写起来像 numpy,性能能达到手写 CUDA 的大部分水平。仓库现在在 triton-lang 这个组织下,原来的 openai/triton 已经重定向过去了。PyTorch 里 torch.compile 生成的 GPU 代码就是 Triton 的。”
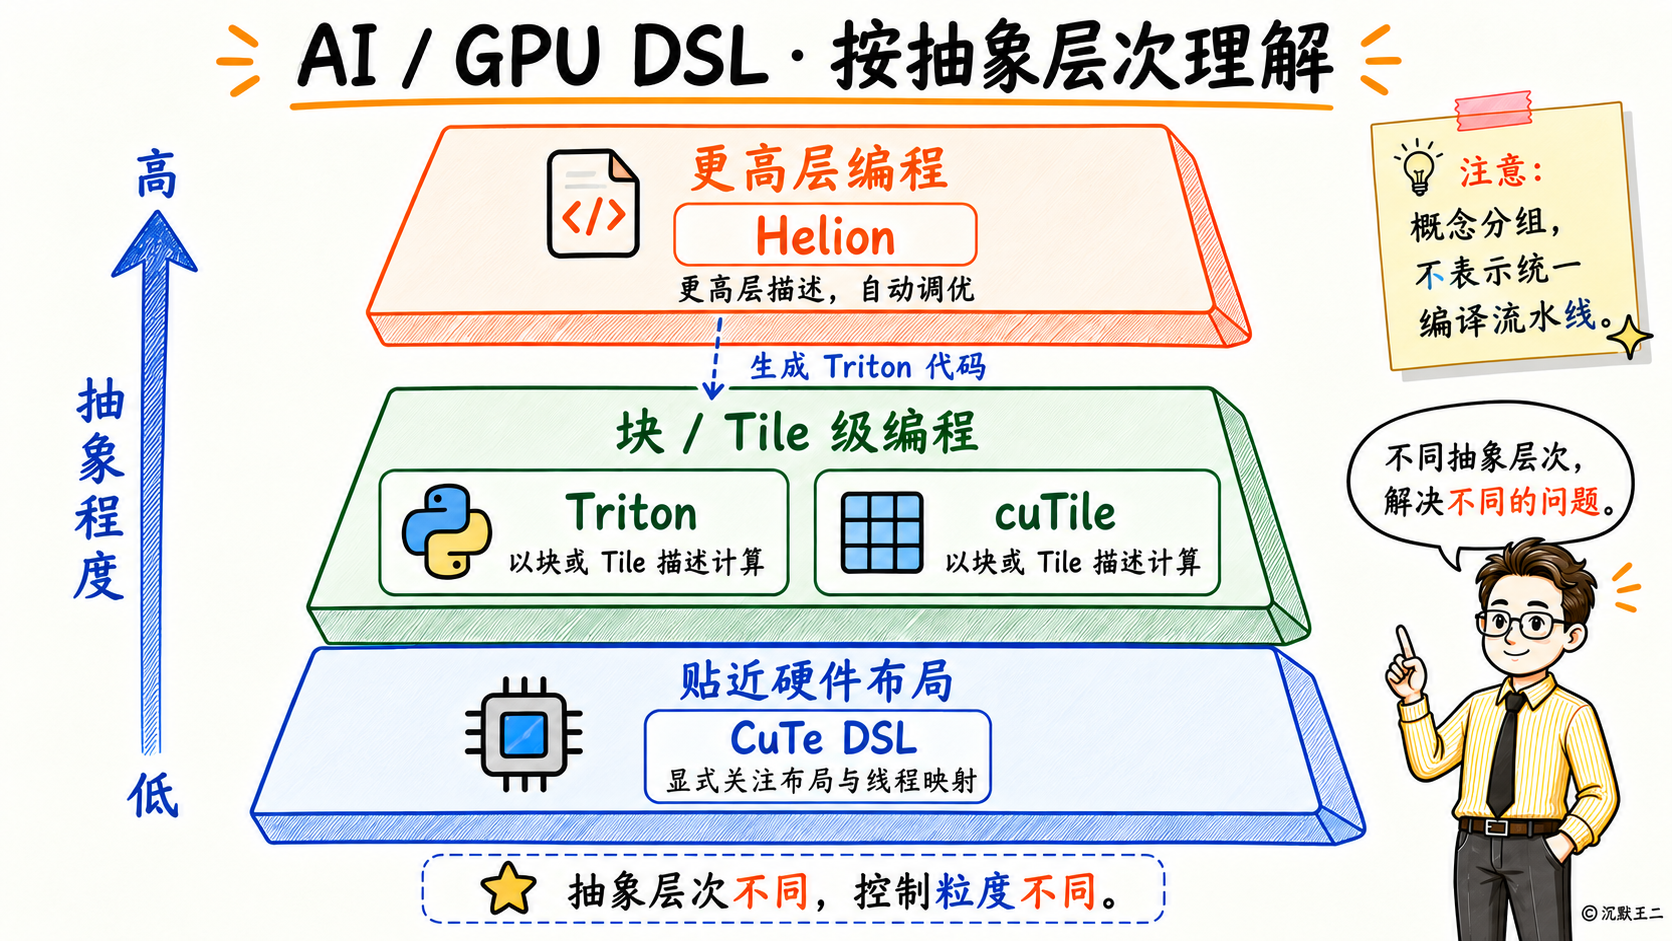
“Triton 之上还有一层。PyTorch 基金会仓库里的 Helion 是 Meta 做的,写法比 Triton 更高层,编译出来的产物就是自动调优过的 Triton 代码,它最主要的机制就是自动调优。2025 年 4 月建仓,10 月发的 Beta。”
“NVIDIA 自己也在推一套新的。CUDA 13.1 引入了 cuTile,它有三个组成部分,一套新的虚拟指令集 CUDA Tile IR,一套面向开发者的 cuTile Python,再加一个把 Tile IR 字节码编译成 SASS 的编译器。它是 2025 年 12 月随 CUDA 13.1 公开的,首发针对 Blackwell。这件事值得关注,因为它意味着 tile 这个编程模型被 NVIDIA 正式接受进了 CUDA 本体。”
“还有几个方向不同的。TileLang 是 tile-ai 组织的项目,作者来自北京大学、微软亚洲研究院和帝国理工,它的想法是把调度空间和数据流分开写,线程绑定、布局、张量化、流水线这些调度决策单独表达,这样同一份计算描述可以配不同的调度。JAX 的 Pallas 走的是跨硬件的路线,同一套 API 覆盖 GPU 和 TPU。这里容易记错,Pallas 在 GPU 上的后端现在是 Mosaic GPU,不是网上很多旧资料写的 Triton,Triton 后端只做尽力维护,而 Mosaic GPU 只支持 Hopper 及更新的架构。Mojo 是 Modular 做的独立语言,整个语言建立在 MLIR 之上,支持提前编译和即时编译,2025 年 6 月起标准库里内置了可移植的 GPU 编程能力,它不是 Python 源码兼容的。”
“再往前追,这套思路不是新的。Halide 在 2013 年就提出了算法和调度分开写,先描述算什么,再单独描述循环顺序、局部性、存储怎么安排。Apache TVM 把这件事做成了完整的框架,TVM Unity 之后,计算图层面的表示和张量层面的表示统一进同一个模块里。现在这些 DSL 的设计思路,基本都能在这两个项目里找到源头。”
“就目前来说,如果要在 NVIDIA 卡上手写算子,Triton 是最省力的入口,参考代码最多,社区问题也最容易搜到答案。要榨干最后那部分性能,还是得下到 CuTe 这一层。”
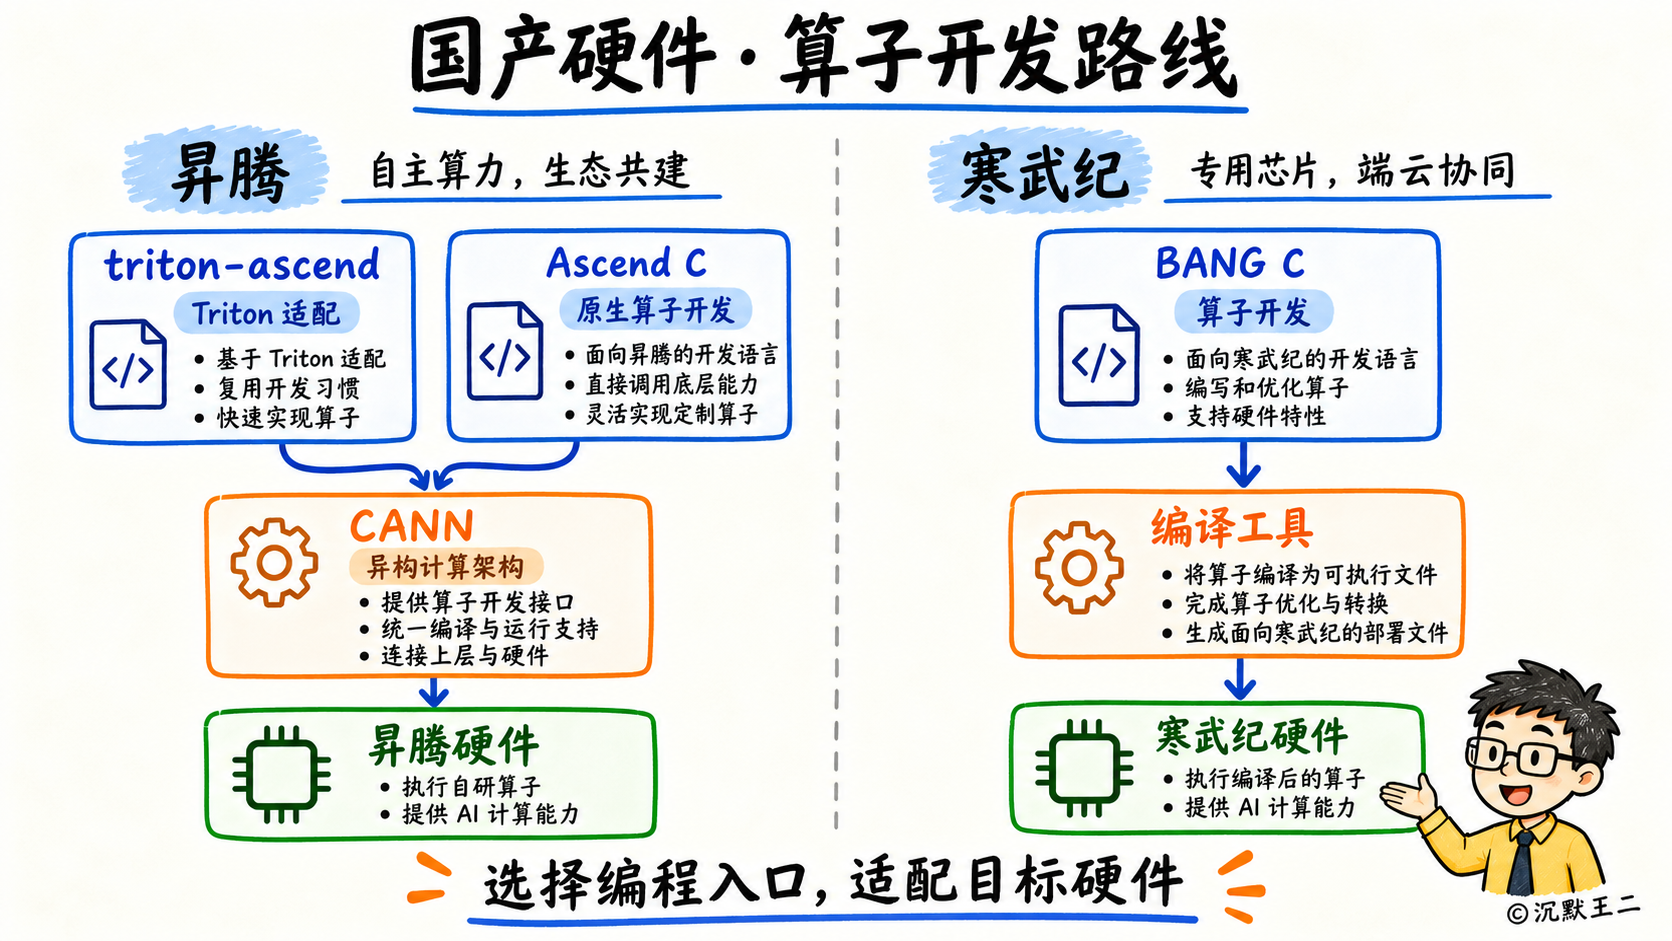
“国产硬件这边我也看了一下。昇腾走的是适配 Triton 的路线,triton-ascend 这个项目已经迁到 triton-lang 组织下,2025 年 5 月开源,2026 年 1 月发的 3.2.0 正式版,依赖 CANN 社区版 9.0.0,自定义算子的开发语言是 Ascend C,在 C 和 C++ 上做的裁剪扩展。寒武纪是另一套,编程模型叫 BANG,语言是 BANG C,工具链是 CNCC 把 BANG C 编译成寒武纪自己的指令集 MLISA,CNAS 再把 MLISA 编译成目标文件,另外还有基于 Python 的 BANGPy。”
ending
由于上周只休息了一天,所以今天周二就感觉已经上了一周的班,身上的班味很重。
不论干什么都有点提不起劲。
就连AI圈抄的不可开交的 REA 我都懒得去关注。
希望以后不要再调休了,我滴妈呀。
今天就到这吧,能看完这篇内容的都是高手,我只能说,完事摸会鱼休息休息吧。