
宇宙厂员工:不打算往上爬的话,苟在2-2/3性价比最高,尽量多存款多靠近AI,再往上,过程累、成功率30%左右(附Agent面试题)
看到标题这样一段心声,感觉还挺有道理。他说如果不打算往上爬,苟在 2-2 到 3-1 这一段是性价比最高的,尽量多存款,多靠近 AI。再往上走,过程很累,成功率三成左右。
2-2 算是资深工程师,项目里的主力,3-1 再上去一档,开始带小团队、扛一部分方向上的判断。这两档的共同点是收入已经到了行业高位,但责任还没质变,自己的产出自己能控制,也不用为别人的产出和跨部门博弈买单。
再往上游戏规则就变了,需要从【把事做成】切换成【管人、争资源、向上管理】。时间就被会议和资源协调占满,个人可控的产出反而下降,心更累一点。
靠近 AI、多存款确实是目前大多数人的最优解。
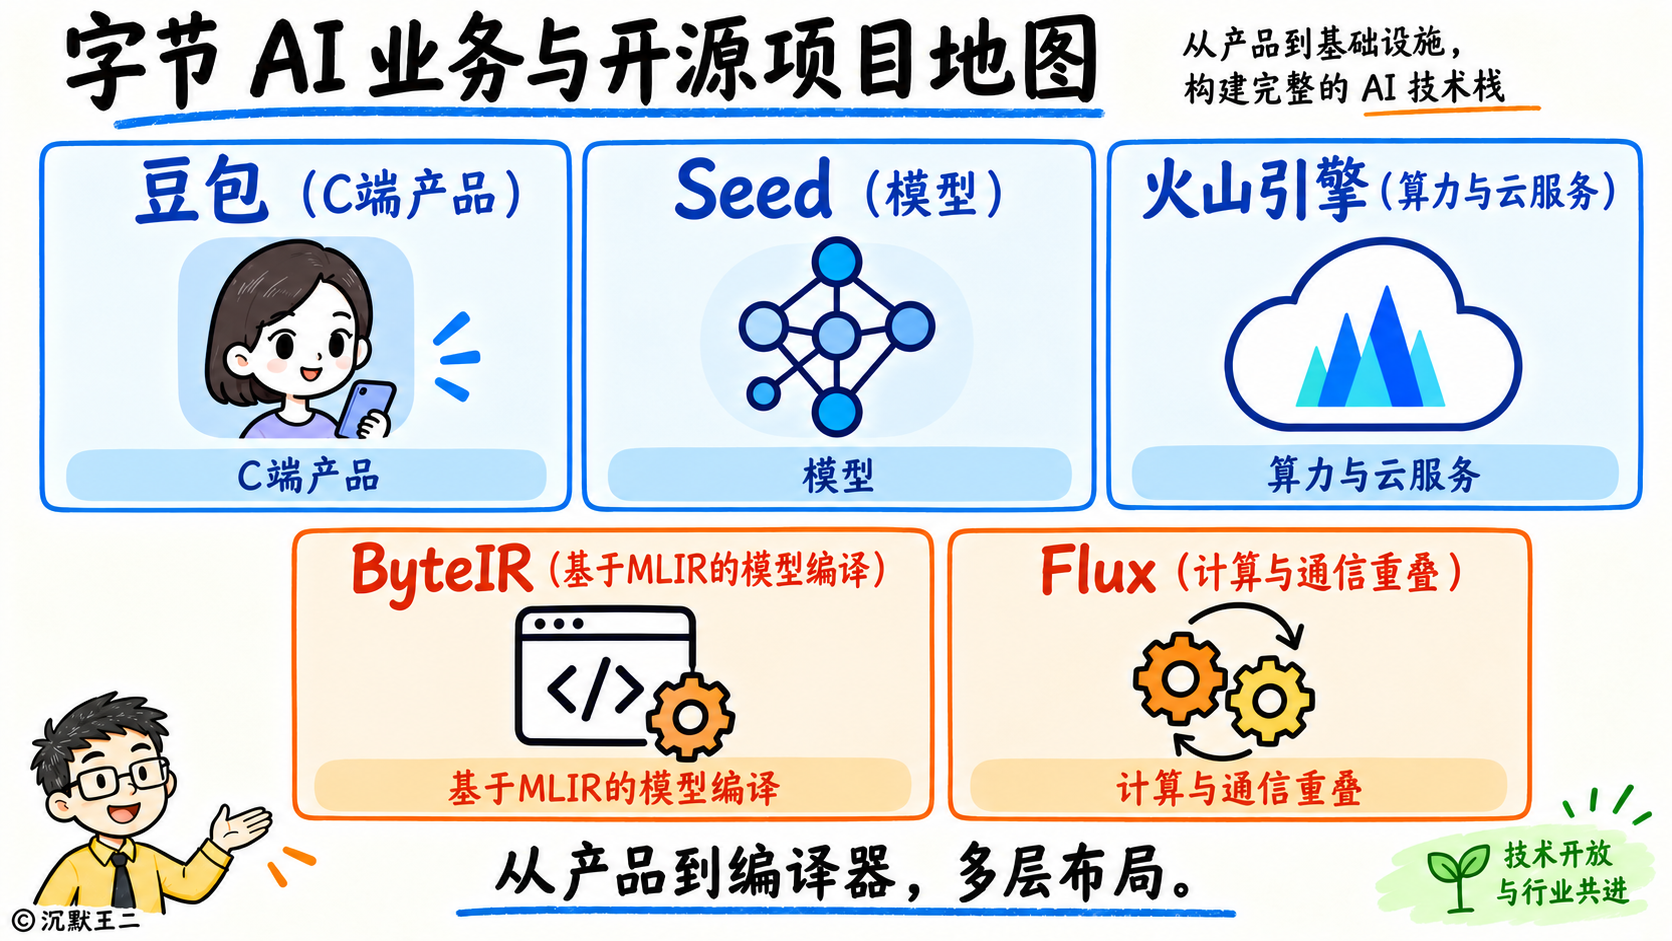
拿zijie来说,C 端是豆包,模型是 Seed,编码工具有 Trae,算力和云服务在火山引擎。除此之外,还有很多人不太注意的一块,字节在 AI 编译器方向也有不少开源项目,ByteIR 是基于 MLIR 的模型编译方案,Triton-distributed 和 Flux 都在解决计算和通信怎么重叠的问题。
豆包工作是最近一个月我一直在用的产品,不能说能力特别强,和Codex和Claude在某些方面,尤其是做事的能力上还有差距,但能做的事确实变得越来越多。
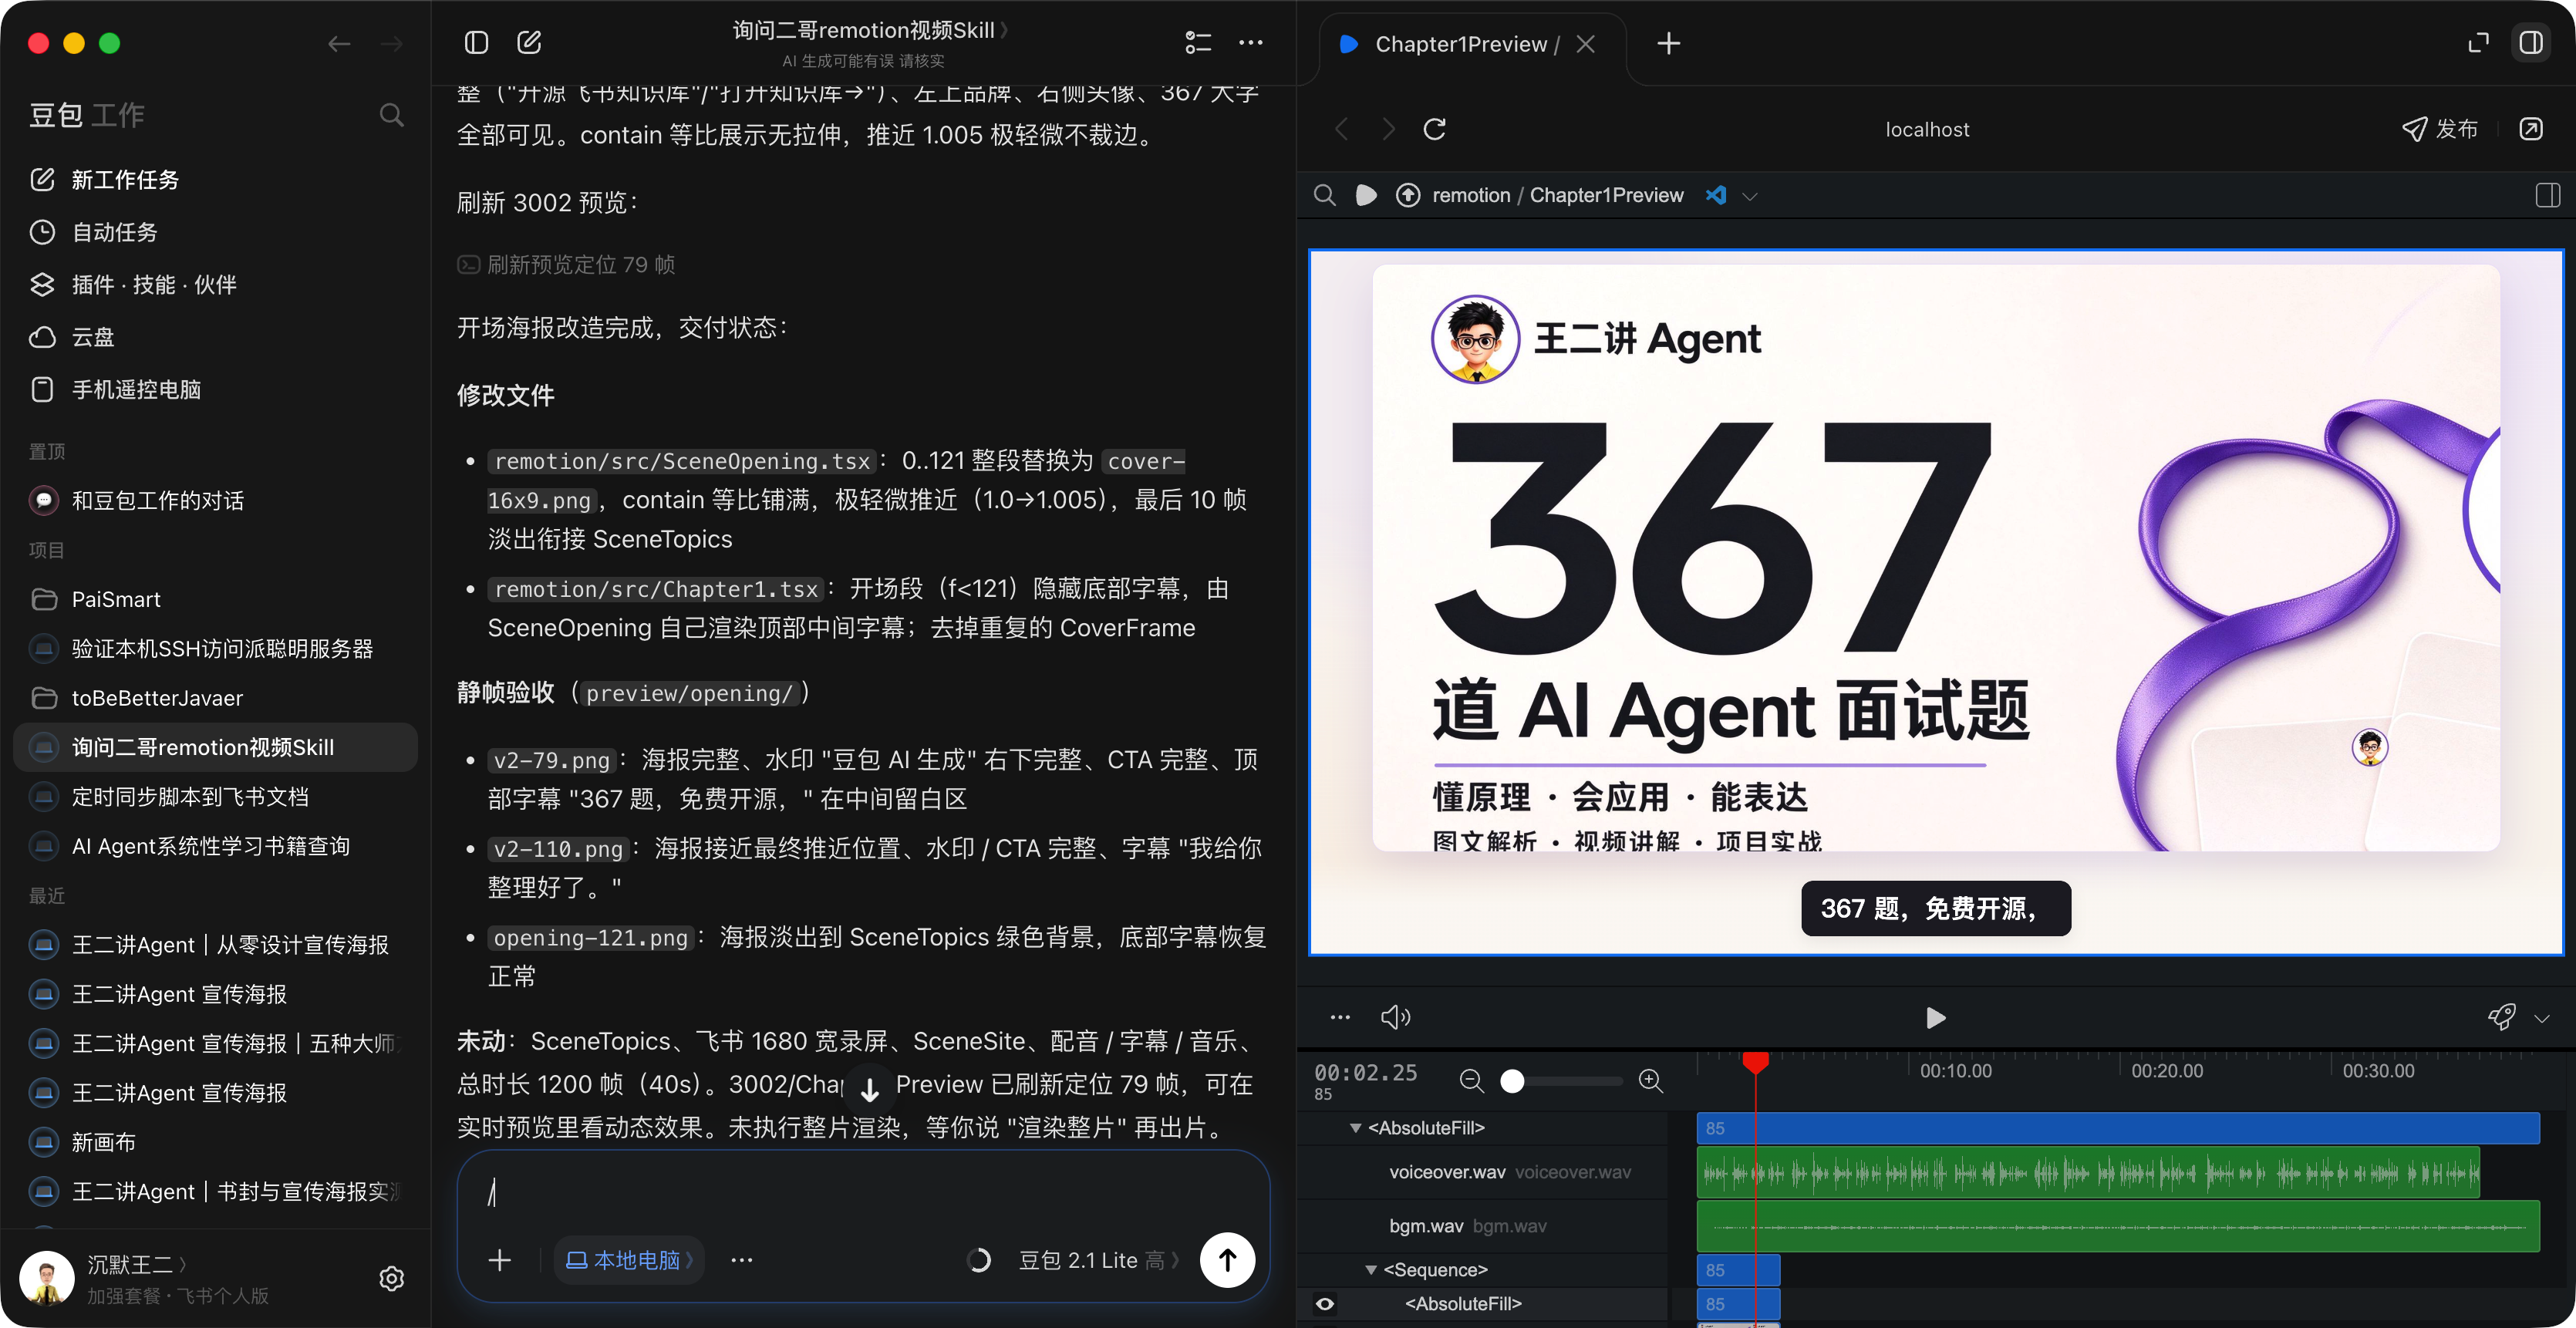
我甚至开始用豆包工作制作视频,还不错。
AI 是洪水猛兽,也是能力边界的放大器。
能让你在不懂编程的情况下开发出产品,也能让你在顶级的老师辅助下搞懂以前学不动的知识,不过要学的东西也多到应接不暇,人很容易累。
所以我的建议是,能学得进去就多学一点,学不进去的时候就照顾好身体。
让我们开始今天的硬核内容吧,主要围绕 RAG 这块展开,看完你会发现,和网上天天传的 RAG 已死有很大区别,这块往深处研究的话,东西还挺多。
content
01、做过哪些 AI 项目?
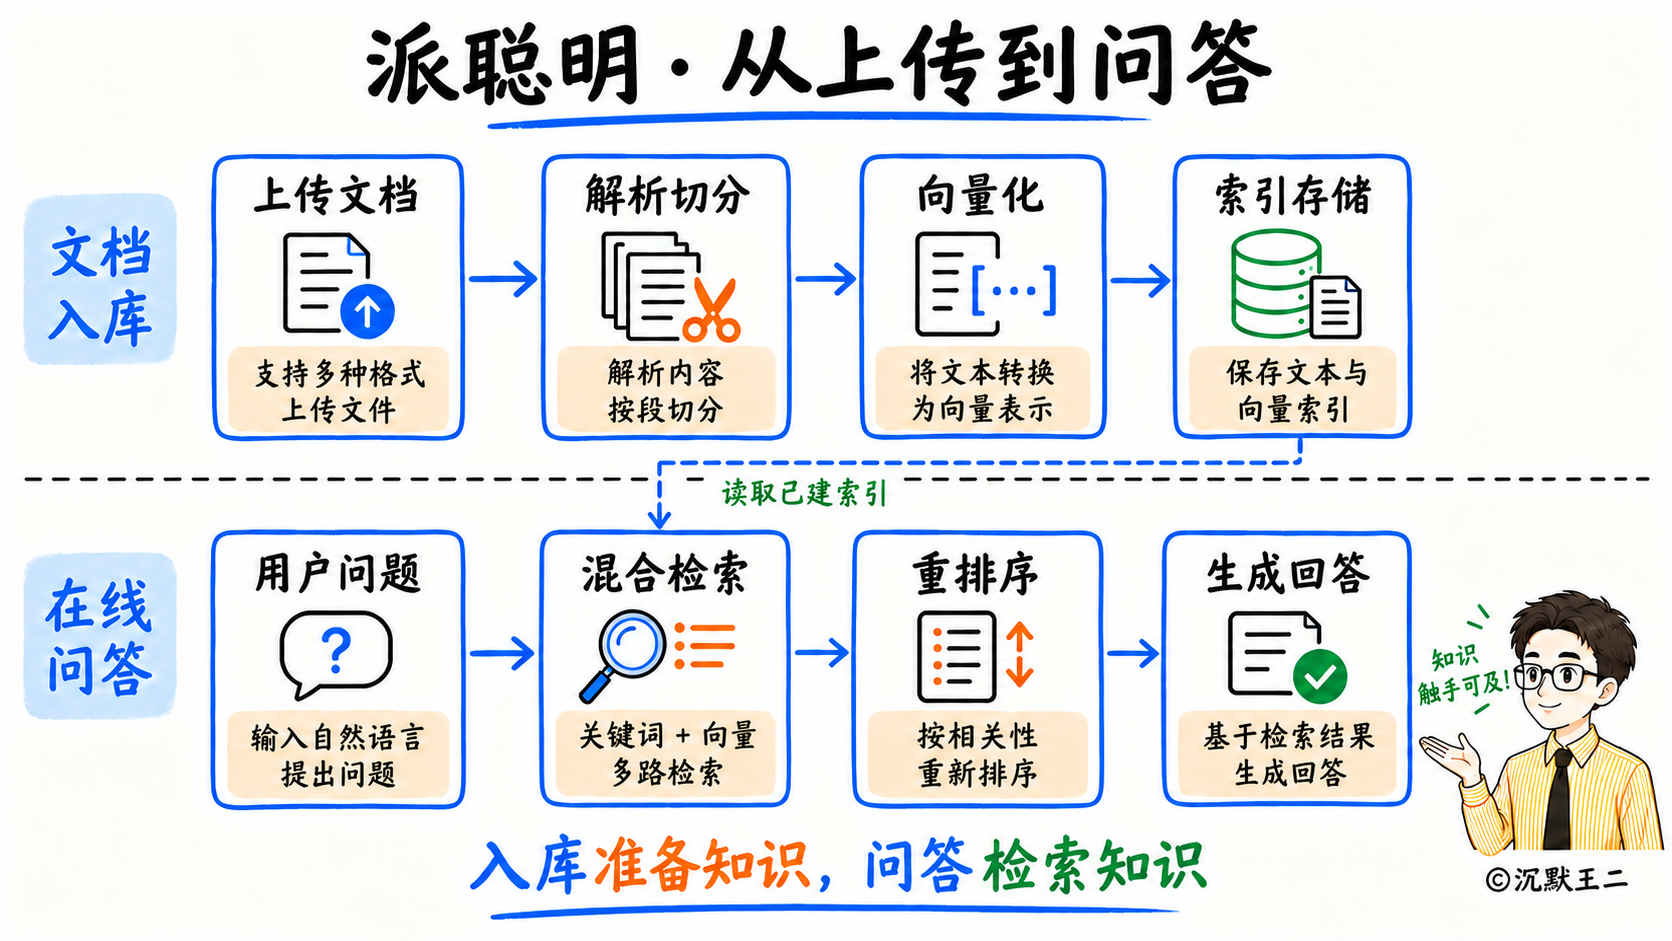
“最早做的是派聪明,一个企业级的 RAG 知识库。我做的是文档上传、解析、切分、向量化,以及问答时的混合检索。技术栈是 Spring Boot 3 加 Elasticsearch 8,Embedding 和重排序用阿里的 text-embedding-v4 和 gte-rerank-v2,大模型用的 DeepSeek,上传后的解析任务走 Kafka 异步处理,文件存在 MinIO 里。”
“第二个项目是 PaiCLI,一个 Java 写的终端 Agent。里面有 ReAct 循环、Plan-and-Execute 任务图、多角色协作三种执行模式,工具调用、代码检索、MCP 接入都是自己实现的。技术栈是 Java 17 加 OkHttp,终端界面用 JLine,代码检索用结巴分词加 SQLite,Java 文件的语法树解析用 JavaParser,Git 快照回滚用 JGit。”
02、RAG 的相关性如何计算?
“派聪明是按分工来的,一次检索算两路分,向量一次、关键词一次,两路合起来之后还要再算一次。”
“向量算的是余弦相似度。用户的问题先用 text-embedding-v4 转成 2048 维向量,Elasticsearch 里存文档向量的字段是 dense_vector,相似度函数配的是 cosine。”
“派聪明的召回窗口按请求的 topK 乘 30 算,上限 300 条,topK 默认是 5,所以向量这一路一次取 150 条。KNN 查询里还有一个候选数,设成召回窗口的两倍,也就是 300。这个参数管的是 HNSW 图在搜索时每层保留多少个候选节点,给大一点结果更接近真实的最近邻,代价是搜索变慢。权限过滤放在 KNN 内部做预过滤,先过滤再找最近邻,不然召回 150 条里可能有一百多条这个用户无权查看,过滤完就剩不下几条了。”
“这个倍数定得比较大,是因为召回阶段漏掉的文档,后面两步都补不回来。RRF 只能给已经召回进来的文档排序,精排只能在 RRF 的前 50 条里挑,第一步没取到的文档,后面再怎么算都不会出现。所以召回这一步宁可多拿一些,把筛选的压力留给后面两步。”
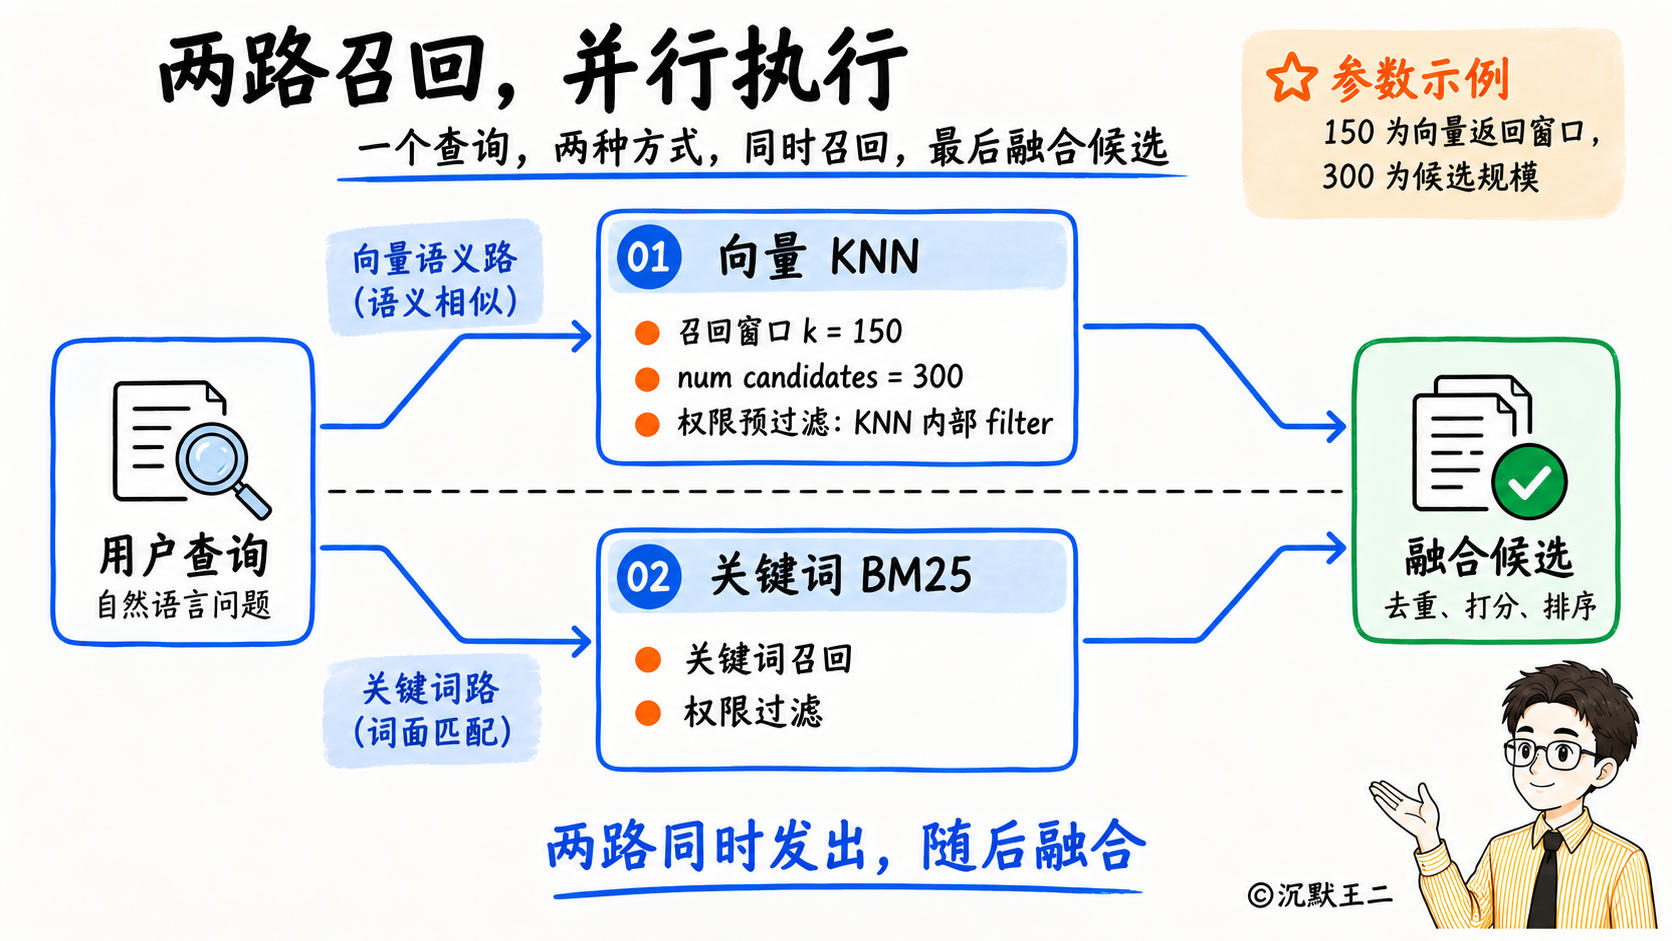
“关键词算的是 BM25。这两路是并行发出去的,用 CompletableFuture 同时执行。两路里任何一路出了问题,就用另一路的结果继续往下走,不让这次检索失败。”
“两路结果拿回来之后,向量分和 BM25 分没法直接相加。一个是零到一的相似度,另一个是 BM25 分数,没有上界,两个数字不在同一个尺度上。做归一化也不靠谱,min-max 归一化要用这一批结果里的最大值做分母,同一篇文档换个问题去检索,分母变了,它的分数也跟着变,这个分数就没法用来做阈值判断了。”
“业界另一种常见做法是加权求和,两路分数各自归一化之后按权重相加,比如向量占七成、关键词占三成。它的麻烦在于这两个权重只能拿评测集一点点试,而且换一批文档、换一个 Embedding 模型就得重新试一遍。RRF 只用名次,没有需要调的权重。”
“所以派聪明用的是 RRF,倒数排名融合。只看文档在每一路里排第几名,每一路贡献的分数是一除以 k 与名次之和,k 取 60,一篇文档的总分就是它在两路里的贡献之和。Elasticsearch 的向量分数在这一步没有被读取,用的只是名次。”
“k 取 60 的作用是压平头部的差距。如果不加这个 k,第一名贡献 1 分,第二名 0.5 分,差了一半,相当于完全相信单路的排序。加上 60 以后,第一名是 1/61,第二名是 1/62,两者很接近,一篇文档要排在前面,得在两路里都靠前,只在一路里排第一是不够的。这正是混合检索想要的效果,两种召回方式都认可的文档才是最可信的。”
“RRF 解决了排序,但它给出的分数无法表达相关程度。1/61 加 1/62 这个数字只说明这篇文档在两路里都排得很靠前,它没法告诉我这篇文档到底对不对得上用户的问题。所以融合之后还要再算一次分,派聪明把 RRF 结果的前 50 条交给 gte-rerank-v2 做精排,每条文本截断到 2000 个字符,模型返回一个相关性分数,最终的排序和过滤都用这个分数。”
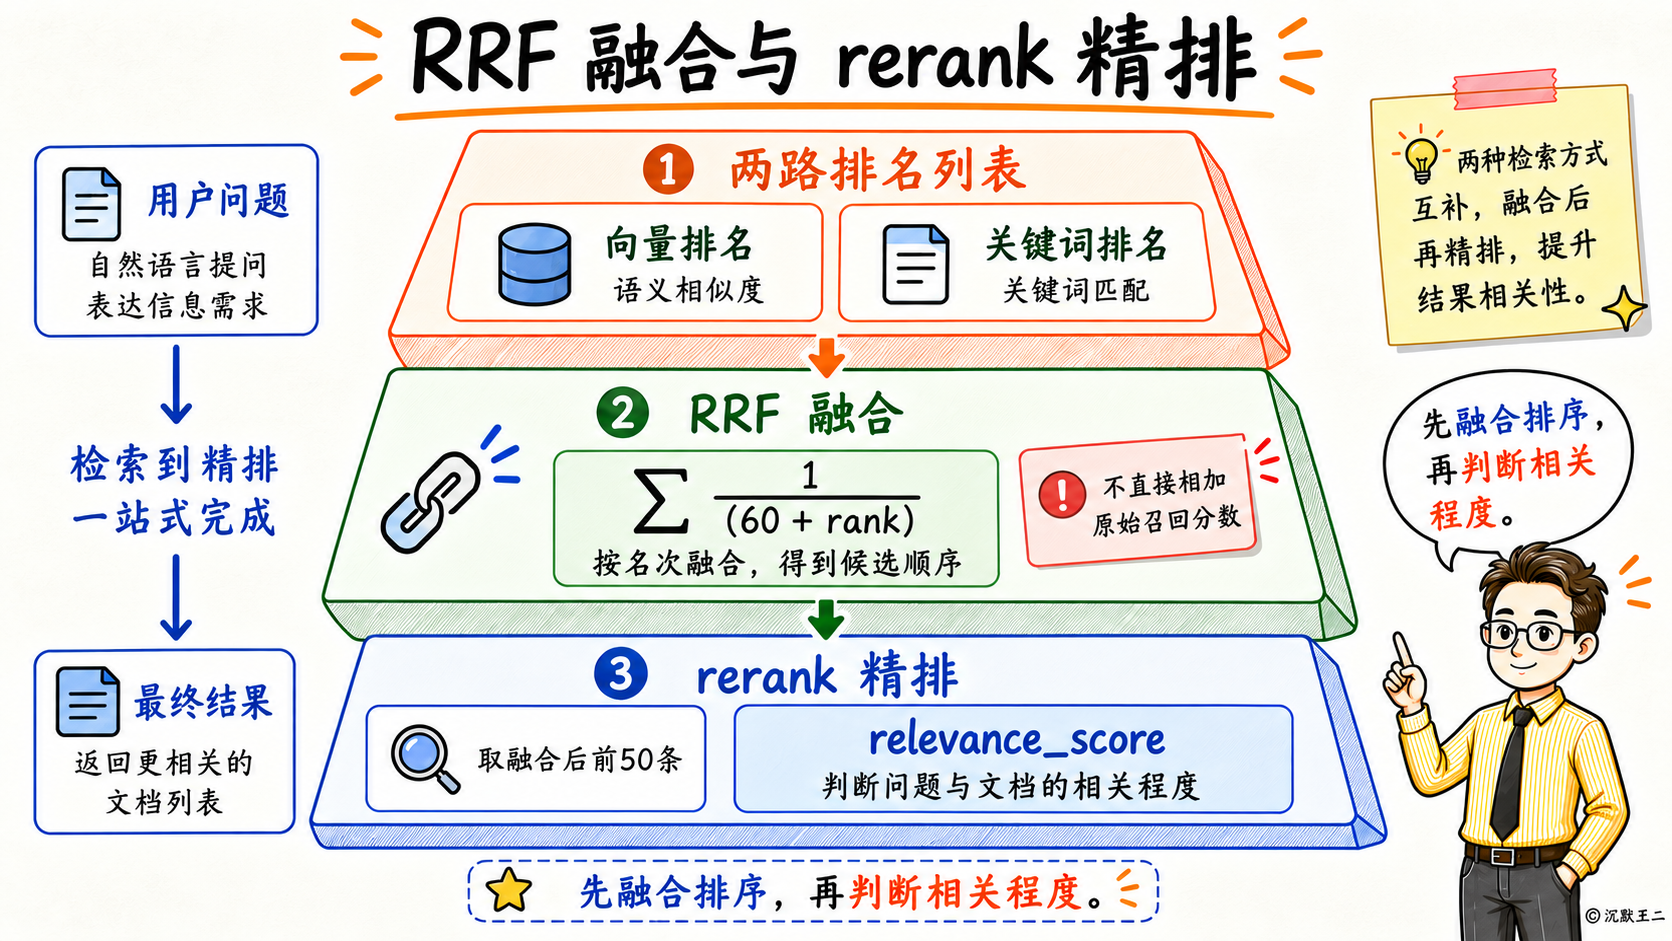
“精排用的是交叉编码器。把问题和文档拼在一起送进模型,模型能看到两者之间逐词的对应关系,所以判断得更准,代价是没法预先计算,有多少候选就要算多少次。50 条是一个能接受的量。”
“精排要再调用一次模型,所以它也有超时和降级。派聪明在请求入口生成了一个截止时间,走到精排这一步,剩余时间不足 2 秒就跳过精排,直接用 RRF 的顺序返回。”
03、关键词相关性如何计算?
“关键词用的是 Elasticsearch 默认的 BM25,它算出来的是三个因子相乘的结果。”
“最直观的因子是词频,一个词在文档里出现得越多,这篇文档越可能是在讲这个词。但词频不能一直线性加分,出现 20 次和出现 100 次,相关程度并没有差 5 倍,所以 BM25 用参数 k1 控制加分的饱和速度,默认值 1.2,词频到了一定次数之后再增加,分数的涨幅就很小了。”
“光看词频会被常见词带偏,因为出现次数最多的往往是【的】这类词。所以每个词的贡献还要乘上一个逆文档频率,一个词在整个索引里出现在越少的文档中,它的区分能力越强,权重就越高。用户问【派聪明的向量维度是多少】,向量和维度这两个词只出现在少数文档里,权重高;【的】几乎每篇文档都有,权重接近零。”
“这两个因子算完,长文档还是占便宜,因为它包含的词多,命中关键词的机会天然就大。所以 BM25 最后要按文档长度相对于平均长度做一次折算,参数 b 默认 0.75,给到 1 是完全按长度折算,给到 0 是完全不管长度。”
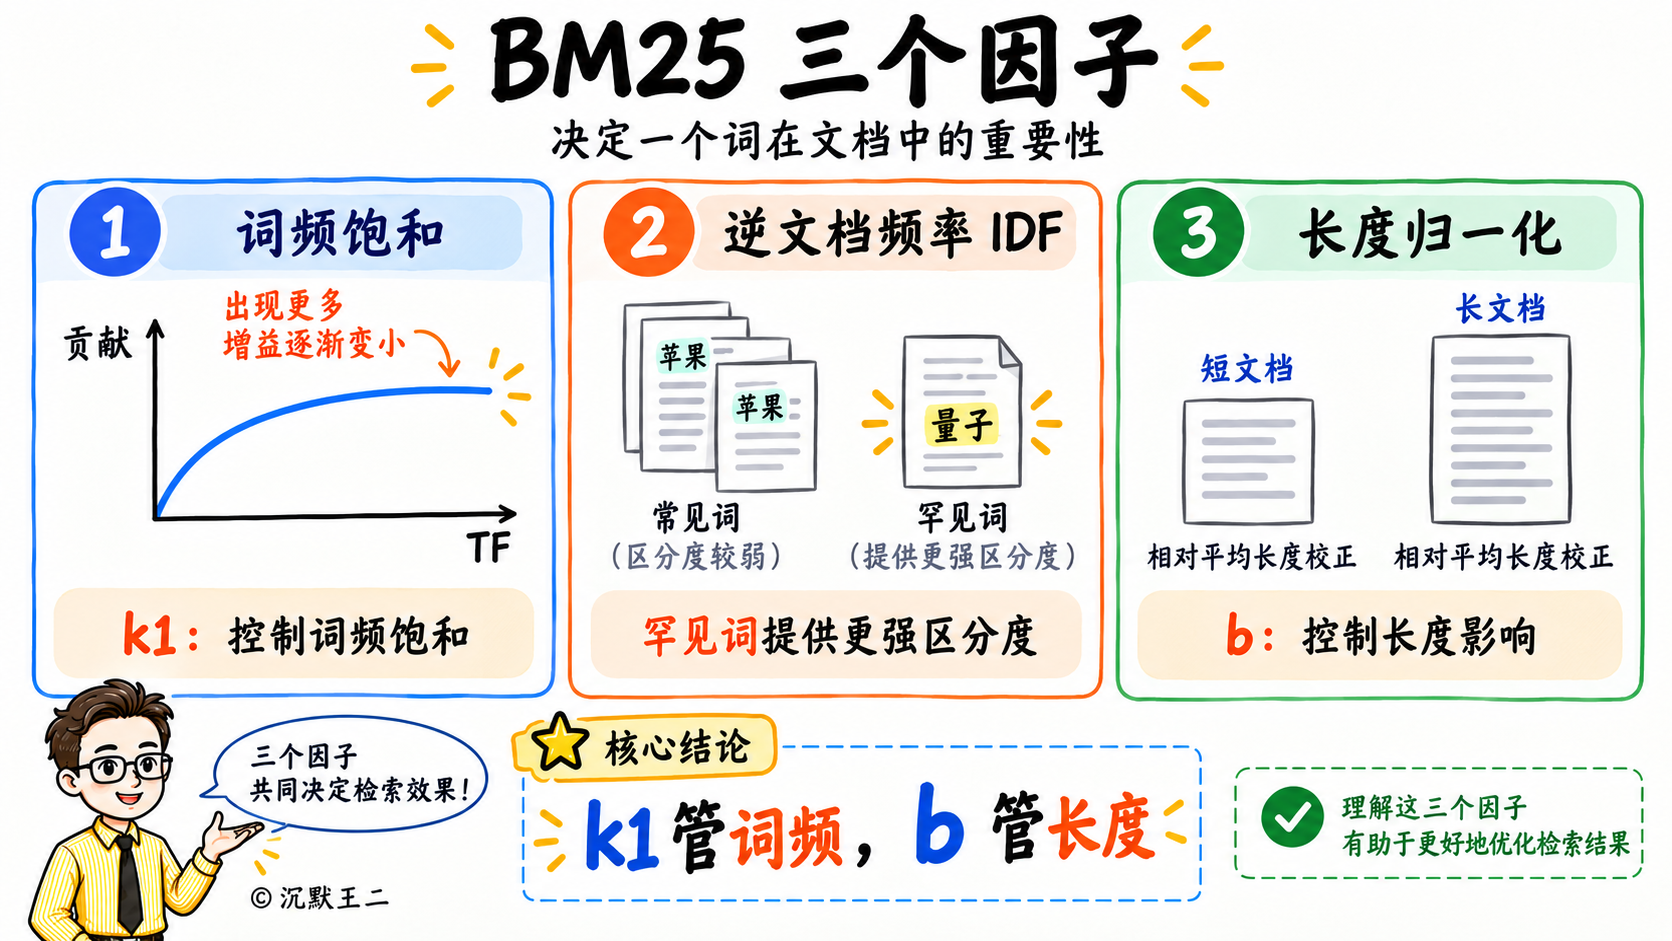
“派聪明这两个参数用的是默认值 1.2 和 0.75。知识库里的文档被切分成 512 个字符的分块,长度本来就比较均匀,长度归一化起的作用不大;一个关键词在 512 个字符里重复出现几十次的情况也很少,饱和速度调了意义不大。”
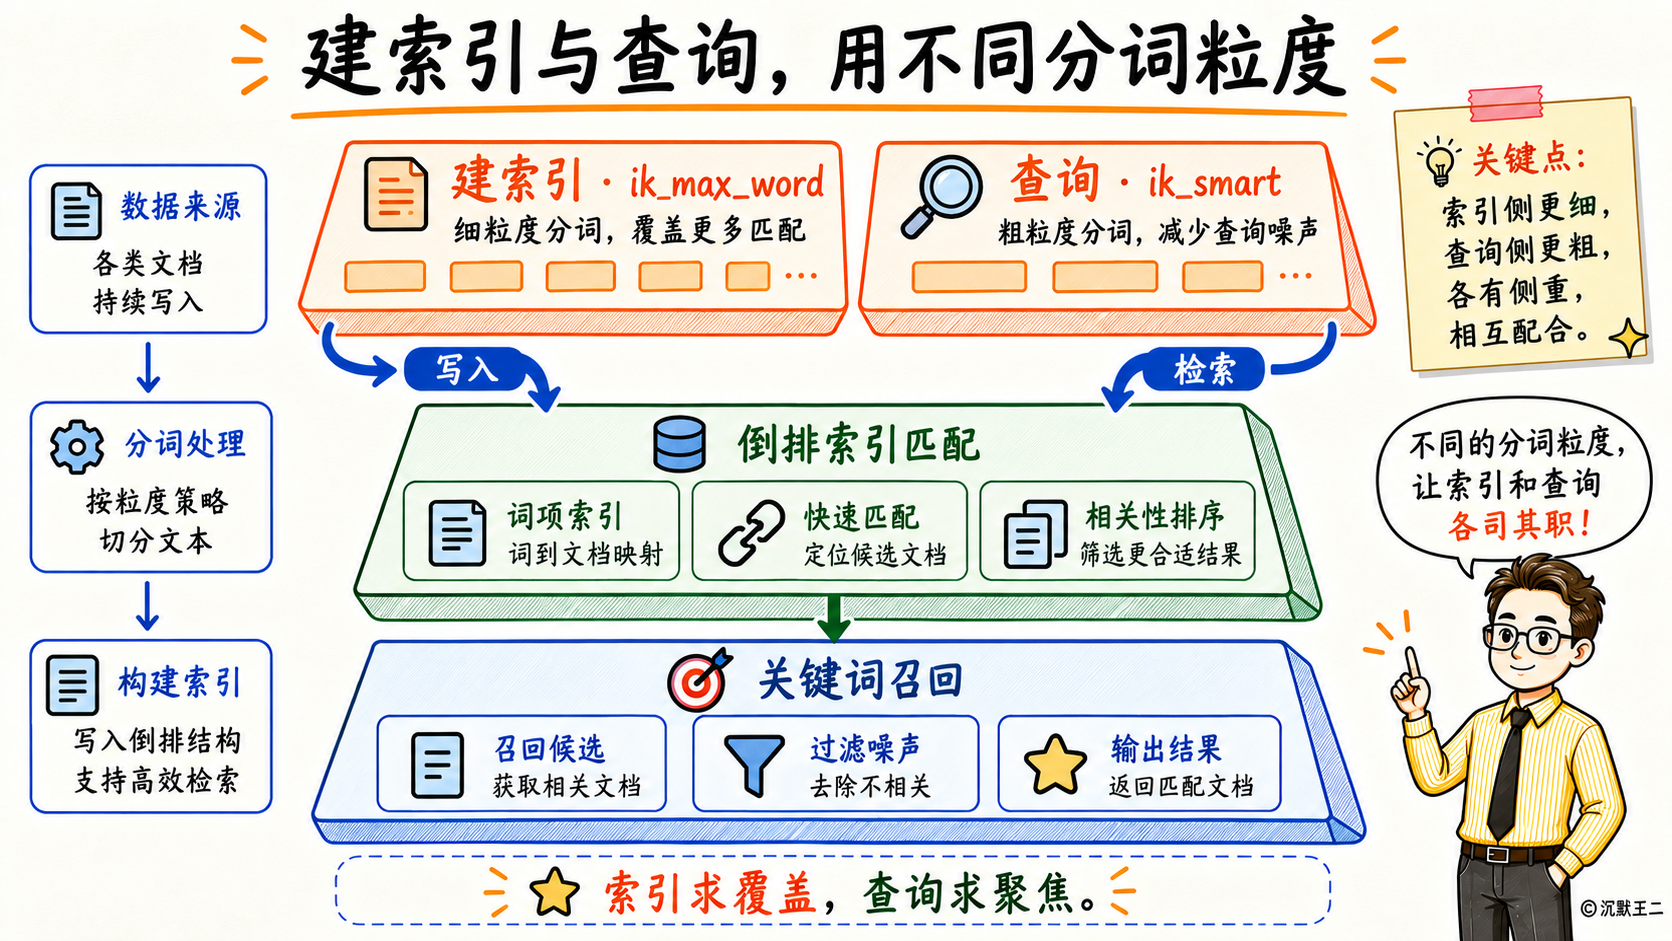
“中文这边还有一层分词。BM25 算的是词,中文得先把句子切分成词。派聪明的文本字段建索引时用 ik_max_word,查询时用 ik_smart,两边不一样。建索引用细粒度,把派聪明的向量维度切分成【派、聪明、派聪明、向量、维度】这些词都存进倒排索引,能被更多种问法命中;查询用粗粒度,避免用户的问题被切分得太碎,碎词命中的都是不相关的文档。”
“默认的 match 查询,多个词之间的关系是或,只命中一个词的文档也会被召回。假如用户的提问里有一半是没有信息量的词,光靠 BM25 的名次,前几名很可能是只命中了某一个词的文档。所以 BM25 在派聪明里的职责只是提供一路名次,它和向量召回互相补充,谁也不单独决定结果,最终由精排模型来定。”
“关键词检索还有一个绕不开的问题,分块里可能根本不出现那个关键词。一份文档按 512 个字符切开,中间某一段写的是“该参数默认开启,建议不要修改”,这个参数到底是哪一个,只有上一段才知道。用户按参数名去搜,这一段的倒排索引里没有这个词,BM25 召不回来,向量也召不回来。”
“派聪明的办法是入库时给每个分块生成一句上下文描述,说明这一段在整篇文档里讲的是什么、主语是谁,拼在分块正文前面,一起参与向量化和倒排索引。开启这个功能以后,关键词查询也从单字段匹配换成多字段匹配,分块正文和上下文描述各算一次 BM25 再合起来。代价是入库时每个分块都要多调用一次大模型,所以这个功能默认是关掉的,只在对准确率要求高的知识库上开。”
04、最终相关性分数的值域是什么?
“这个要分情况,因为派聪明返回的分数字段在三种模式下来源不同,值域也不同。”
“正常情况下走完整的混合检索加精排,分数就是 gte-rerank-v2 给出的相关性分数,大致在零到一之间。”
“精排被跳过或者调用失败时,返回的是 RRF 分数,值域能算出准确的上下界。两路都排第一是 1/61 加 1/61,约等于 0.0328,这是理论上的最大值;只被一路召回的文档,上界是 1/61 约 0.0164;召回窗口是 150 条,最后一名的下界是 1/210,约 0.0048。”
“向量生成失败时降级成纯关键词检索,返回的是 Elasticsearch 的 BM25 原始分数,这个分数没有上界,具体多大取决于查询词的稀有程度和文档长度,这条路径上设了 0.3 的最低分,低于这个分的直接丢掉。”
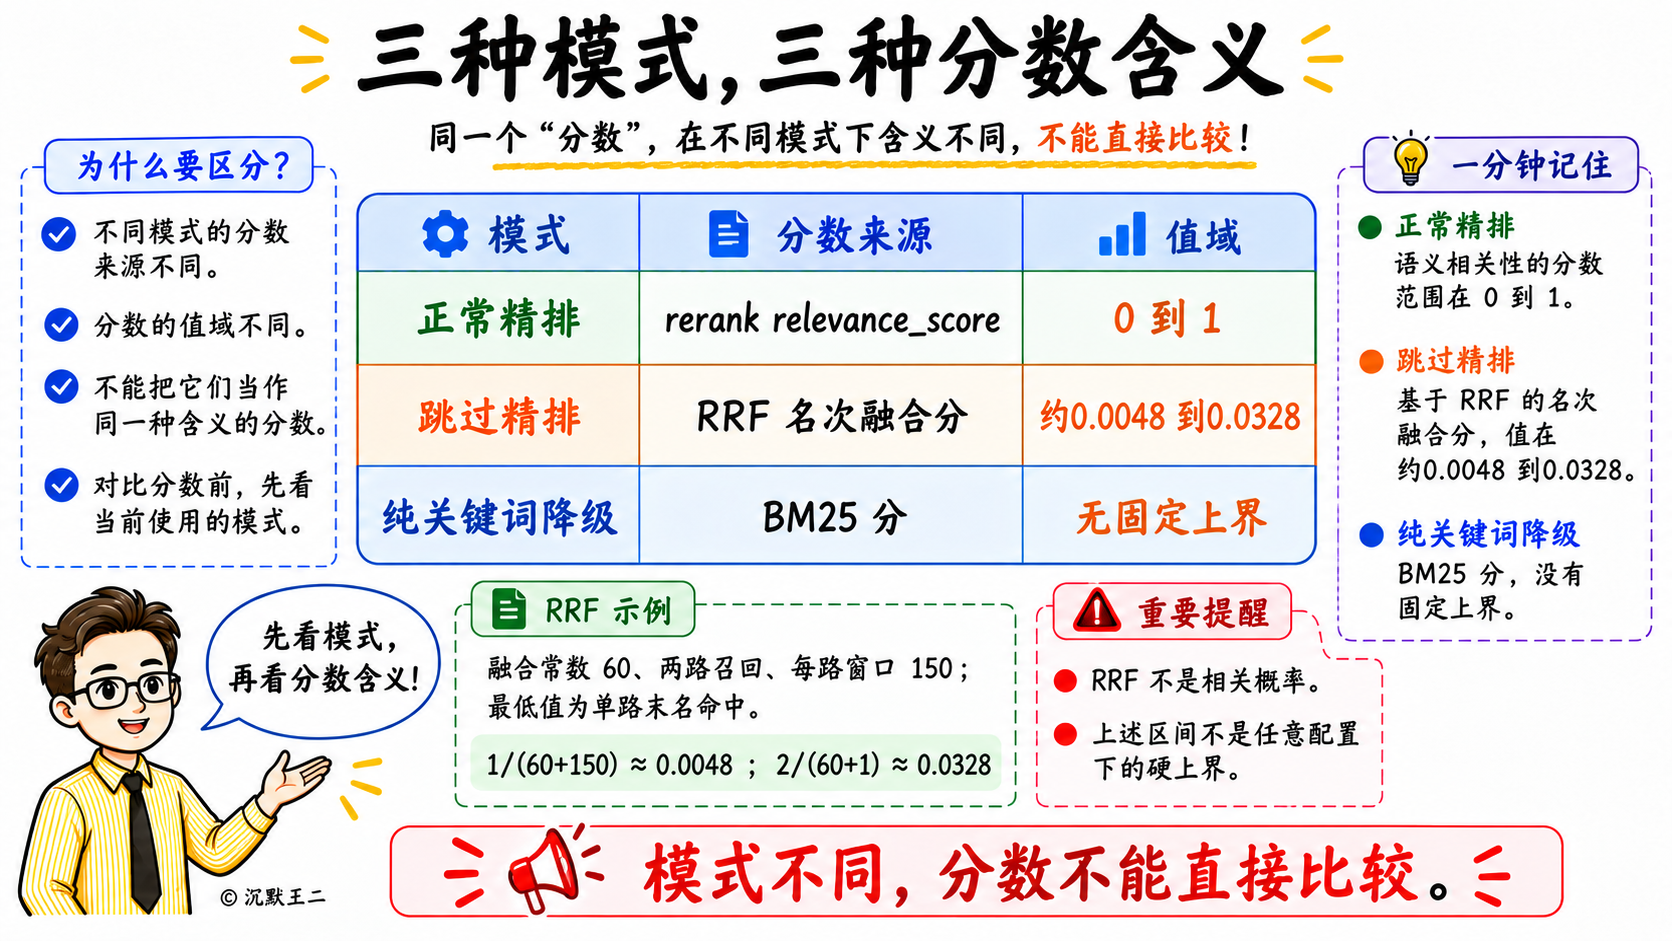
“这个字段的分数一定要和模式一起返回。0.02 这个数字,在精排模式下说明这篇文档几乎不相关,在 RRF 模式下却可能是排第一的结果,不带模式标记,谁拿到都会判断错。”
“模式分开之后,阈值才有地方可以设置,而且只能设在精排分数上。派聪明的阈值设的是 0.1,低于这个分的结果直接丢掉,不交给大模型。RRF 分数和 BM25 分数都不能套这个阈值,量纲不一样。”
“我会在出口统一换算,各自除以自己的理论上界,RRF 分除以 0.0328,精排分原样返回,同时把模式一起带出去。不用 min-max,min-max 的分母是当前这批结果里的最大值,同一篇文档在不同的问题下分数会不一样,跨查询没法比较,也没法拿来设一个固定的阈值。”
“0.1 是用评测集测出来的。派聪明有一套 50 道题的评测集,每道题标了应该命中哪些文档和哪段证据,改任何检索参数都要重新测一遍。阈值原来是 0.2,分块级的 Recall@5 只有 0.5652,MRR 0.4645,50 道题里有 13 道一条结果都没召回,大模型只能回答不知道。降到 0.1 之后,Recall@5 升到 0.7609,MRR 升到 0.5902,空检索降到 0,文档级的召回率到了 1.0。”
“评测时发现,用户问得比较口语化的时候,正确的那个分块只拿到 0.14 到 0.19 分,阈值定在 0.2,正确答案就被过滤掉了。”
“我还试过把阈值降到 0,Recall@5 和 MRR 和 0.1 完全一样,但逐题对比,0.1 还在过滤前五名里的噪声。比如两道私有文档题,阈值 0.1 时只返回 2 条,都是对的;阈值为 0 时会再放进 3 条 0.06 到 0.09 分的无关分块。正确分块已经排在第 1 位,所以指标看不出差别,但交给大模型的上下文少了三段噪声。这个阈值起作用的场合,是相关候选本来就很少的时候。”
“如果一条结果都没有,这种情况也得有明确的处理方式。系统要告诉用户没有查到相关内容,建议换个说法再问,而不是把几篇不相关的文档交给大模型。因为大模型拿到不相关的材料,不会说这些材料没用,它会顺着材料把话说得很圆满,这种错比直接回答不知道要难发现问题。”
派聪明如何写到简历上?
项目名称:派聪明(企业知识库智能问答系统)
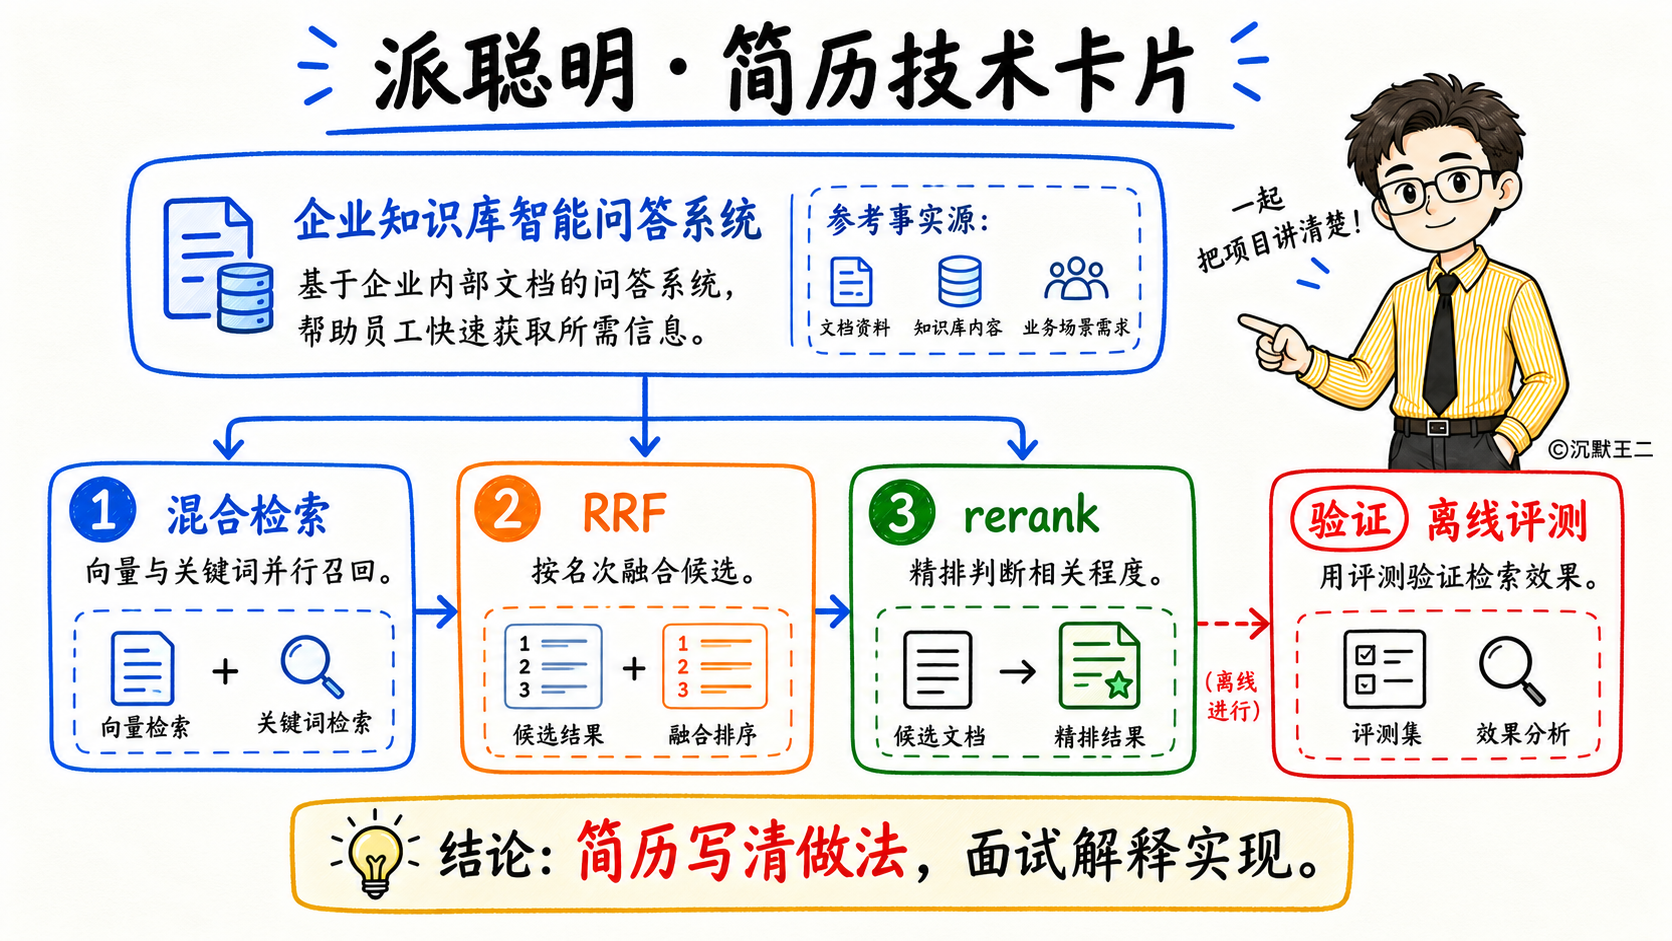
项目简介:基于 Elasticsearch 混合检索的 RAG 问答系统,支持文档上传解析、向量化入库、权限隔离的混合检索与多轮问答,检索效果由离线评测体系保障。
技术栈:Spring Boot 3 + Elasticsearch 8 + 阿里百炼 text-embedding-v4 / gte-rerank-v2 + Kafka + Redis + MySQL + MinIO
核心职责:
- 设计混合检索方案,BM25 关键词召回与 2048 维向量 KNN 召回并行执行,召回窗口按请求 topK 的 30 倍动态计算、上限 300 条,两路结果用 RRF 融合,耗时从两路之和降为较慢一路的耗时
- 引入 gte-rerank-v2 对融合后的前 50 条做精排,用 50 道题的评测集扫描相关性阈值,阈值从 0.2 调整到 0.1 后分块级 Recall@5 从 0.5652 提升到 0.7609,MRR 从 0.4645 提升到 0.5902,空检索从 13 题降为 0
- 搭建离线评测体系,覆盖 Recall@K、MRR、文档覆盖率三个检索指标,生成质量用大模型评分并抽样核对人工一致率,每次调整检索参数都重新执行并归档对比报告
- 实现请求级超时控制,入口生成截止时间,召回、精排、生成各步取自身超时与剩余时间中较小者,剩余时间不足时跳过精排直接使用融合顺序,Embedding 失败自动降级为纯关键词检索
- 实现三级权限过滤,用户私有、公开、组织标签三类条件在一次 Elasticsearch 查询内完成,组织标签支持层级继承,向量召回路径把权限条件放在 KNN 内部做预过滤,避免召回结果被过滤后不足
ending
由于上周只休息了一天,所以今天周二就感觉已经上了一周的班,身上的班味很重。
不论干什么都有点提不起劲。
就连 AI 圈吵得不可开交的 REA 我都懒得去关注。
希望以后不要再调休了,我滴妈呀。
今天就到这吧,能看完这篇内容的都是高手,我只能说,完事摸会鱼休息休息吧。