
要去大学讲课,我让豆包工作帮我备了两天课(PPT+视频制作)。
大家好,我是二哥呀。
老领导喊我去大学讲两天的课,我一开始是拒绝的,因为我从来没有上过台,更没有讲过课,怕误人子弟。
但老领导一直劝我,说我现在取得的成绩,多少人羡慕,是多少人不曾达到的高度,于是我的胆就肥了,准备去挑战一下自己。
(果然戴高帽子是有用的,哈哈)
那具体讲什么呢?怎么讲?怎么样才能给大家提供一点点帮助呢?
我也是咨询了很多 AI,咨询了很多朋友,今天重点说说豆包工作给我的帮助。其余 AI 的功劳,我后面再找机会。
先给大家看看它帮我制作的一个技术科普视频,关于 RRF 的,也是为了方便第一次看到的同学很快就能接收这些技术信号。
【视频 1】
是不是很丝滑?
01、梳理杂志风PPT
备课的起点是让豆包工作帮我梳理一份 PPT,作为这两天讲课的总大纲。脚本 luoyang-lit-ai-bootcamp.md 是我提前在本地写好的,操作的时候只需要在豆包工作的输入框里用斜杠加载一下内置的 PPT Skill,提示词很简单。
帮我按照 docs/src/sidebar/itwanger/ai/luoyang-lit-ai-bootcamp.md 这个制作一份 PPT,杂志风。
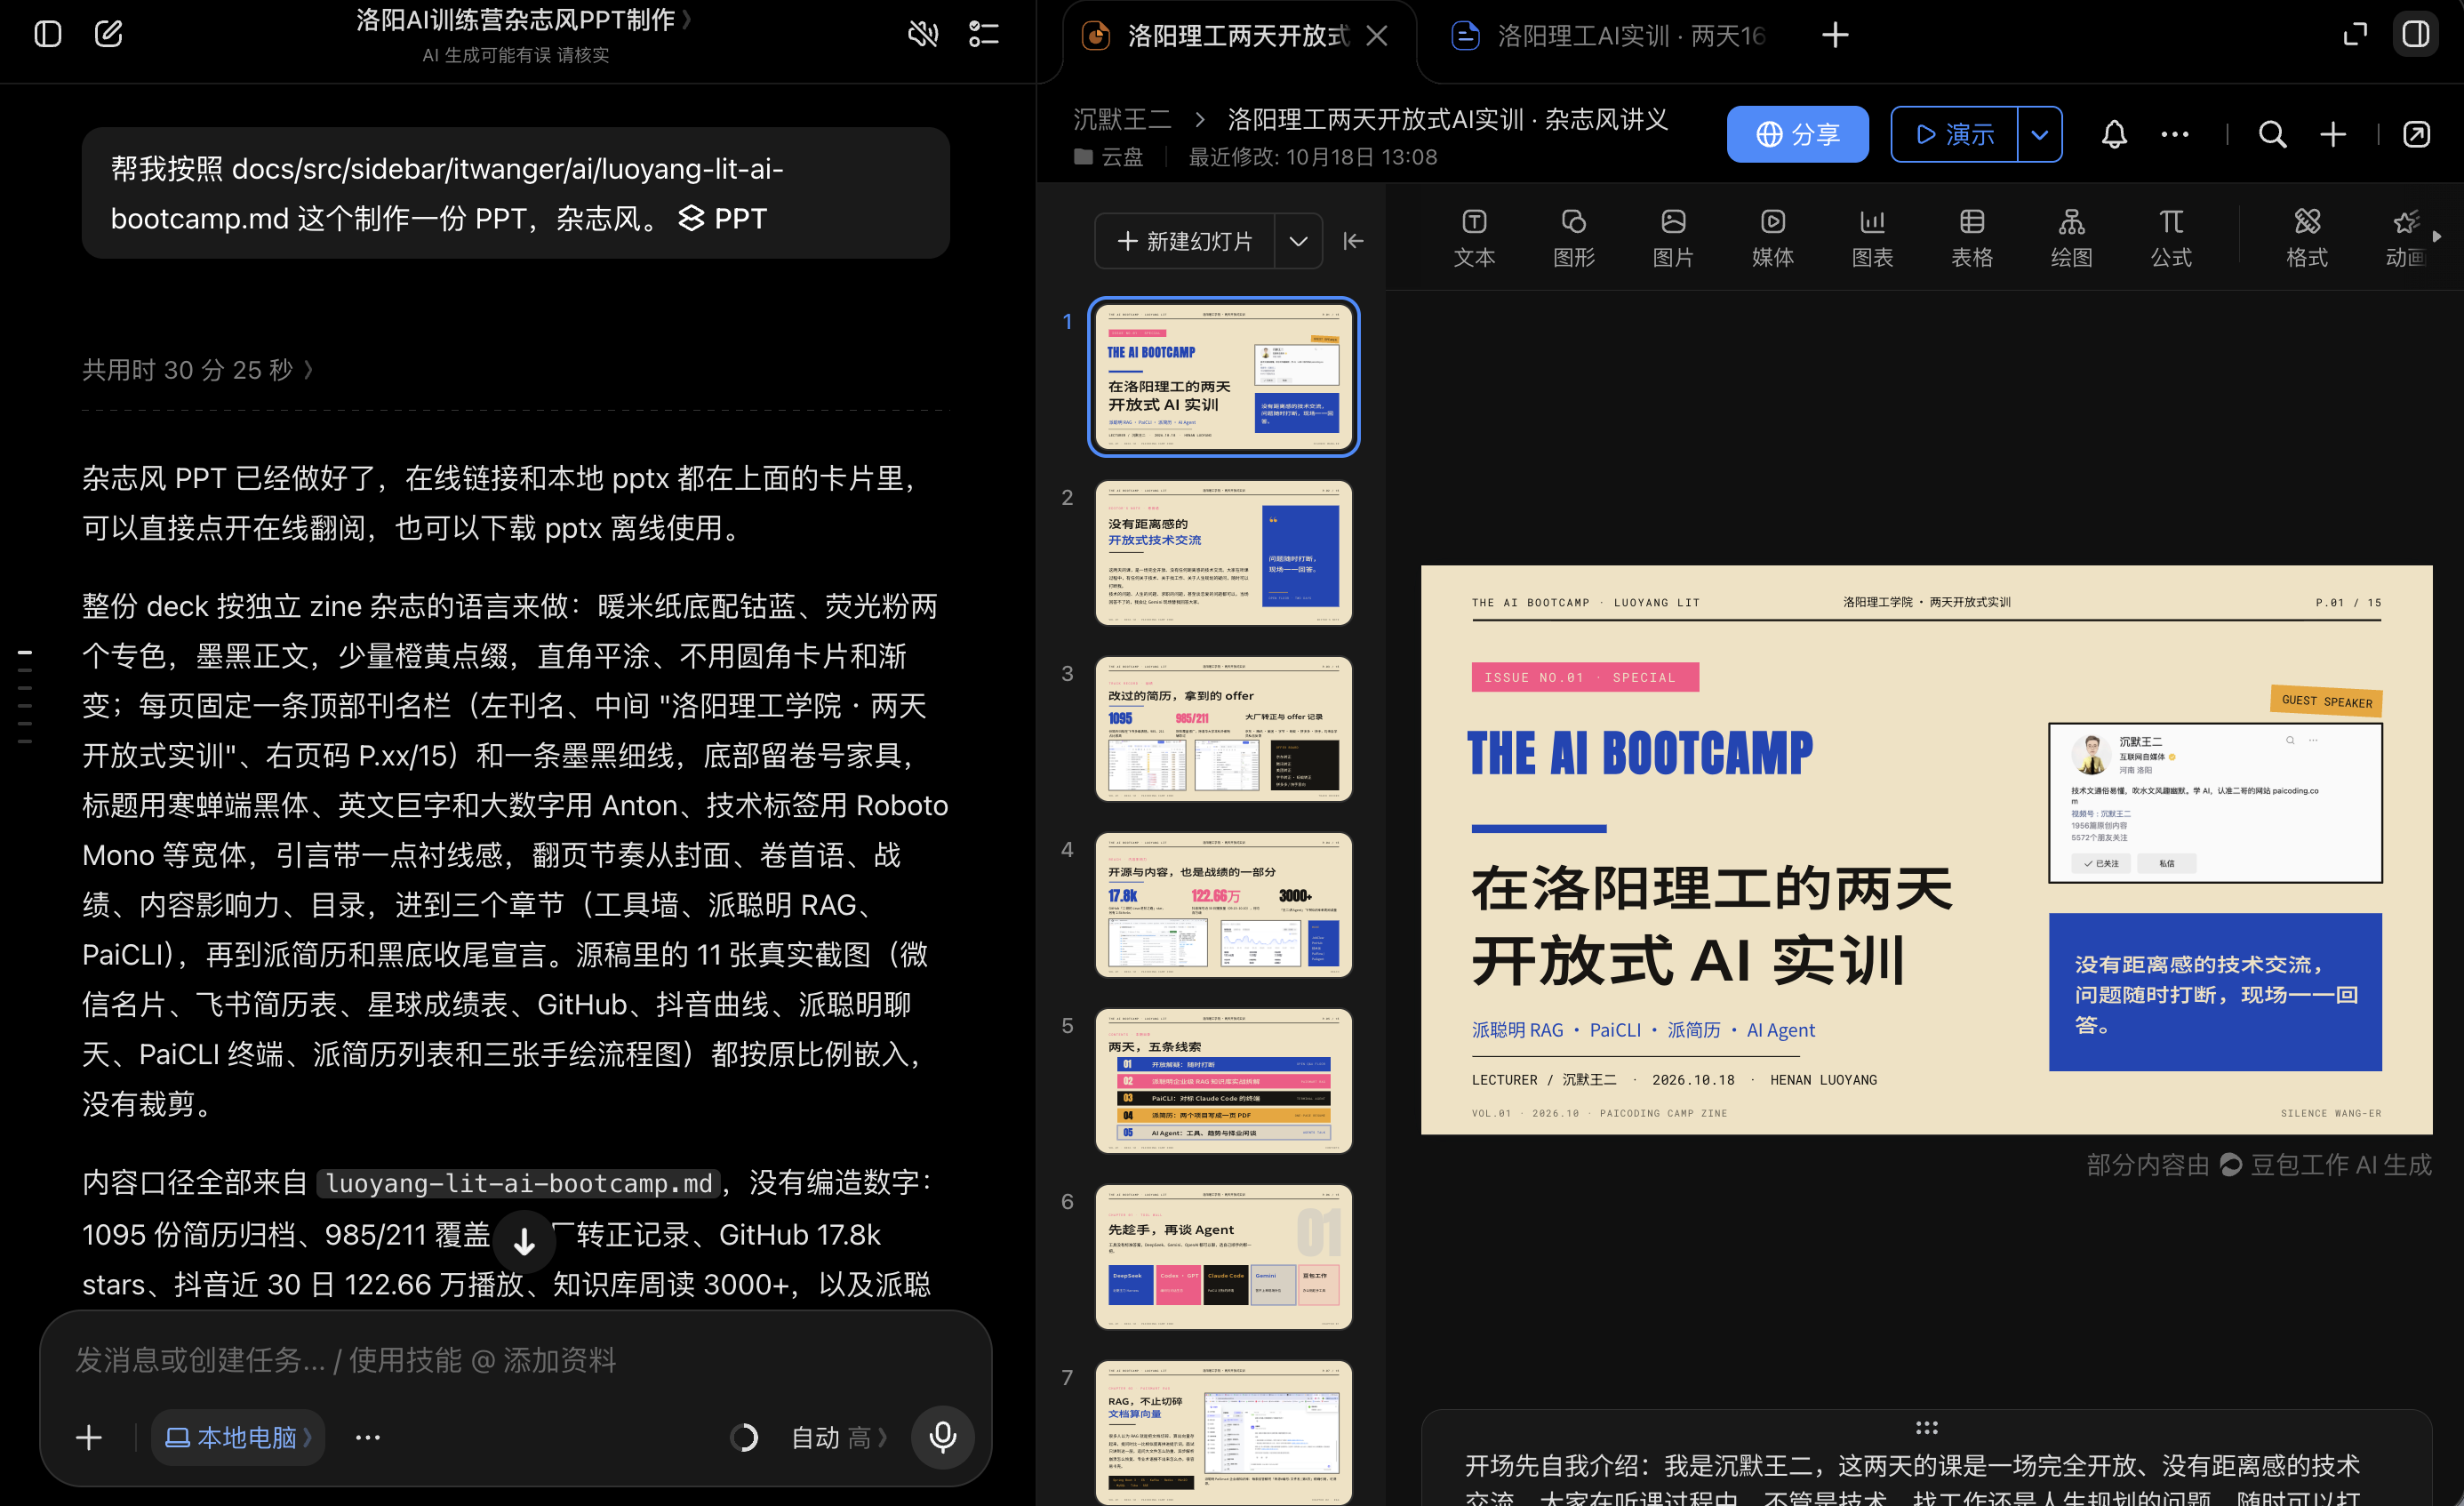
豆包工作在读取完本地的文稿和配图后,做了一套 15 页的杂志风讲义。整套课件按独立杂志的版式设计,原稿里的 11 张真实截图也全部按原比例嵌入到了页面里,没有任何生硬的裁剪。
这套 PPT 把我提前准备好的五块内容串成了清晰的课程主线。
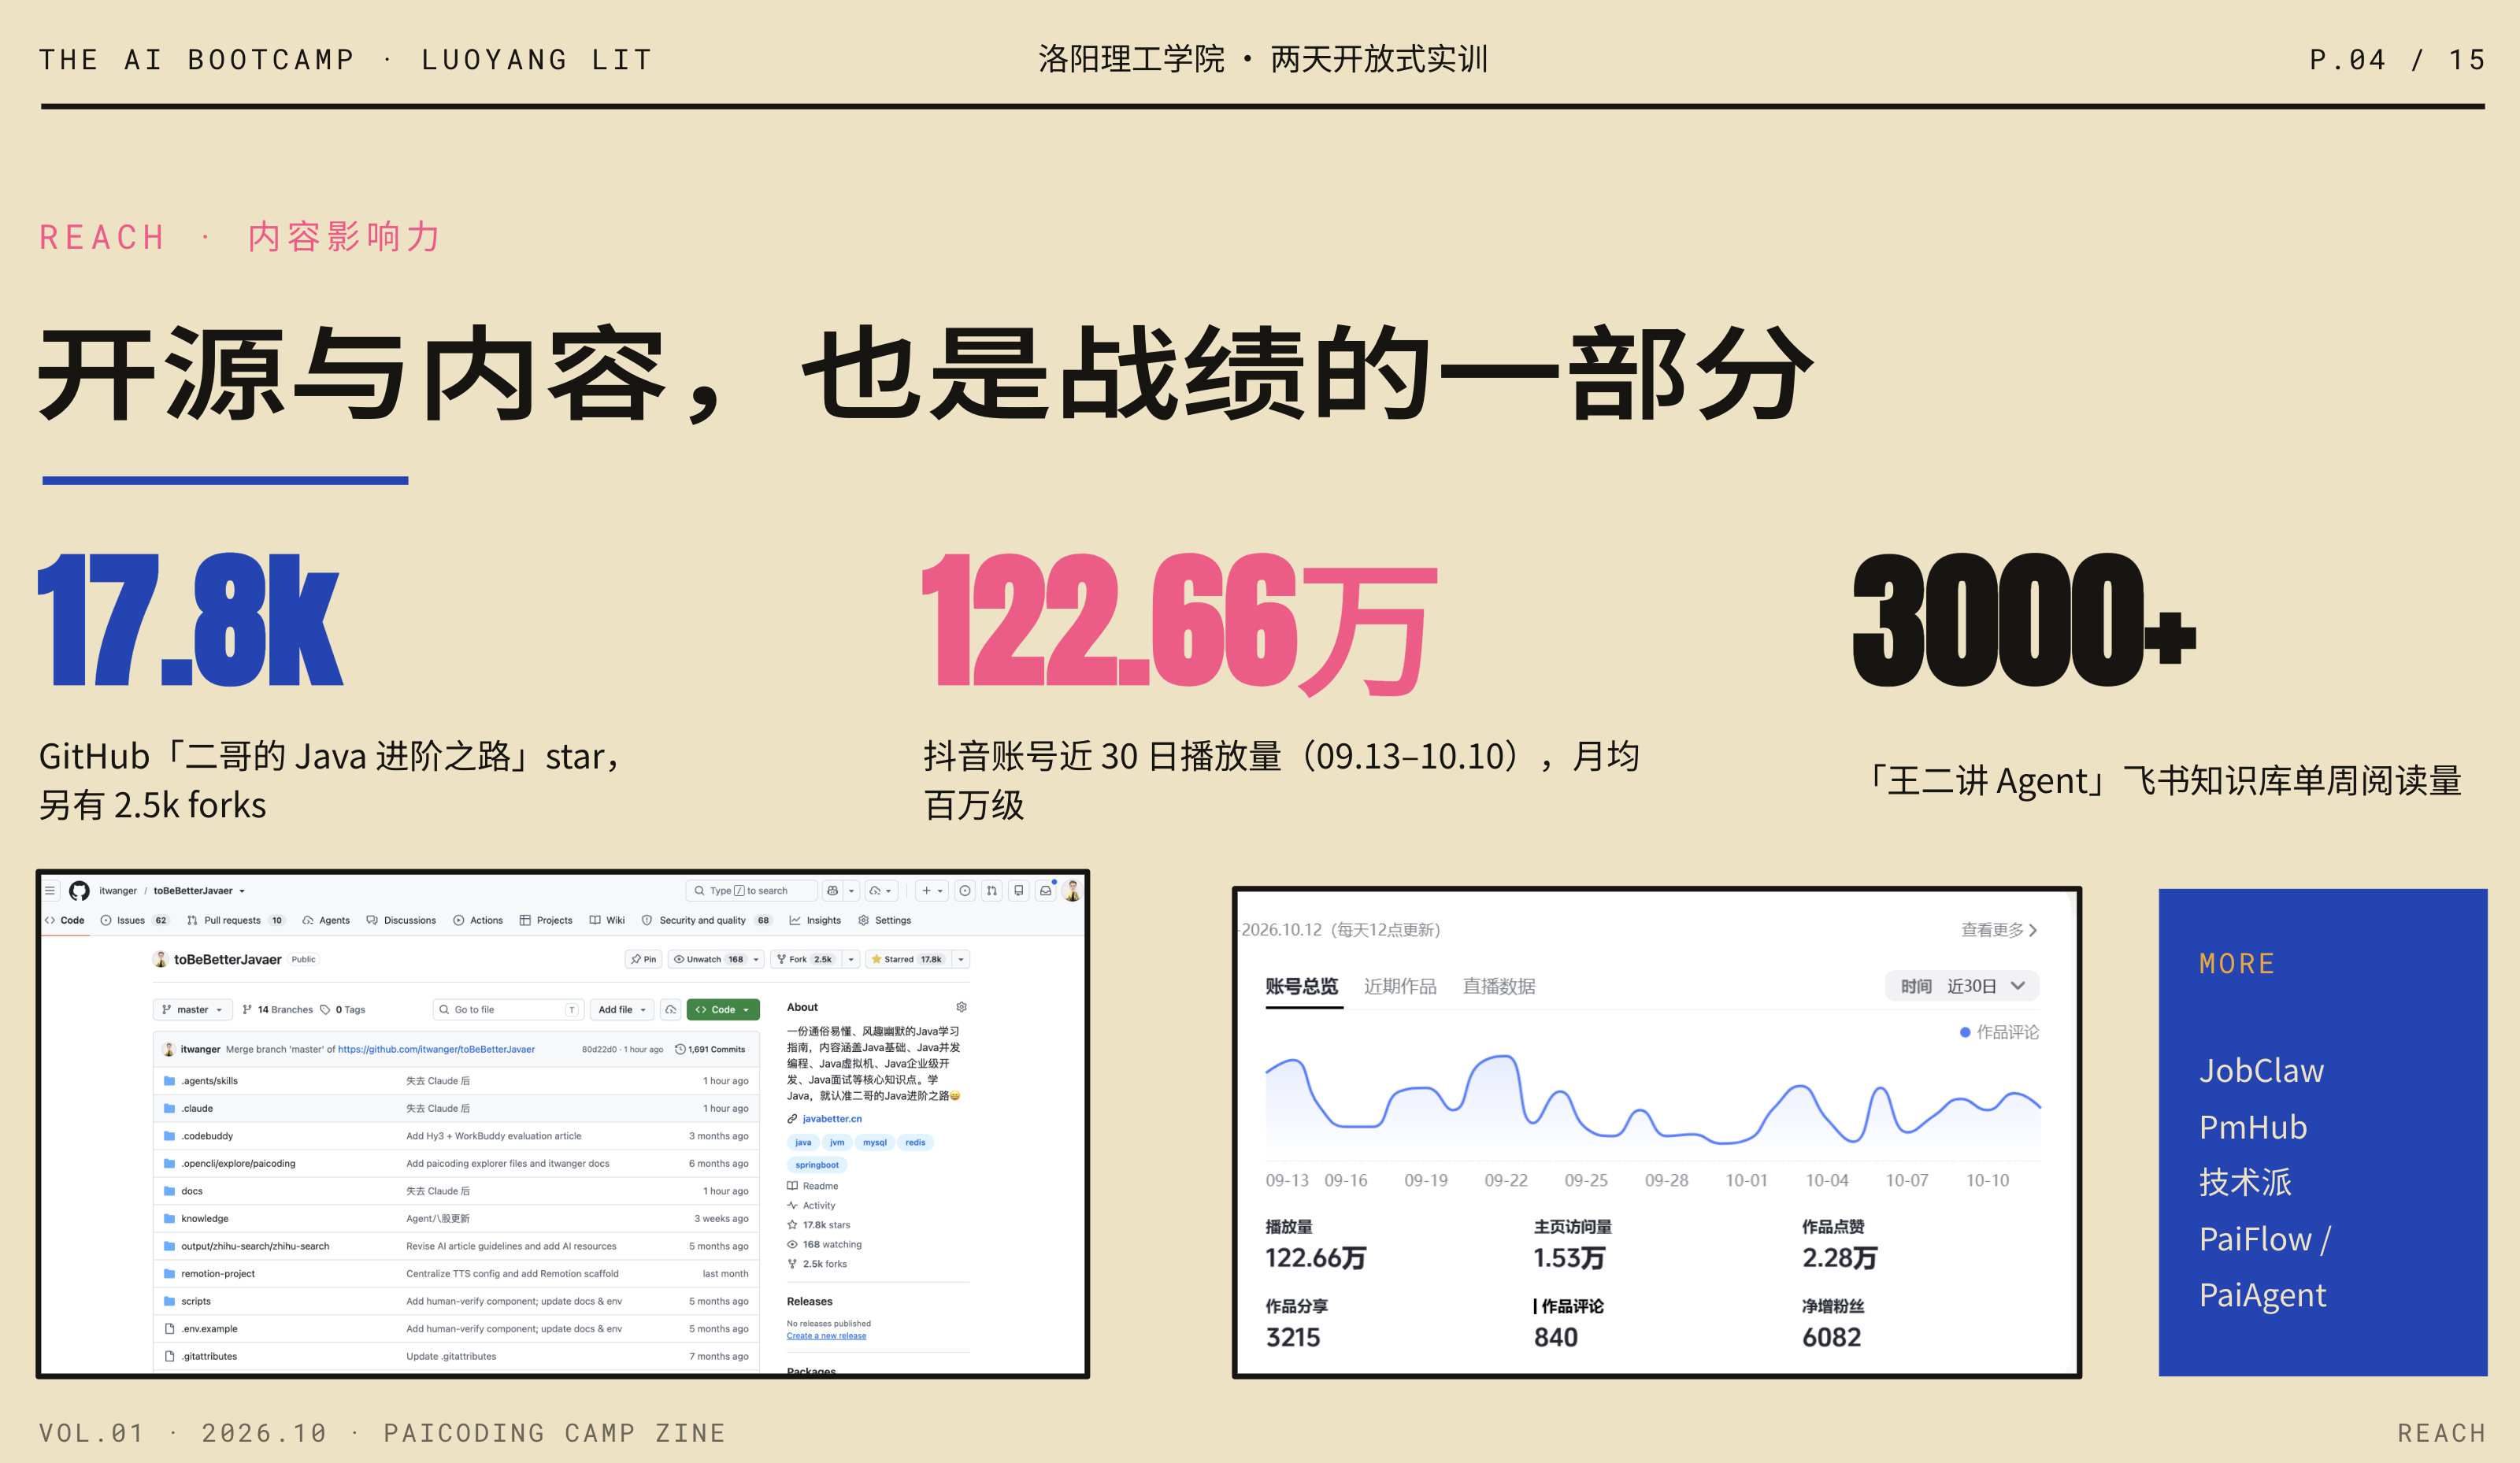
①、晒一些能让大家信服的成绩,比如说改过 1000 多份简历,覆盖全国所有的 985/211 名校,不完全统计的 offer 喜报(互联网大厂+银行央国企),《二哥的 Java 进阶之路》在 GitHub 上有 17.8k star,短视频近一个月有 122.66 万播放等等。
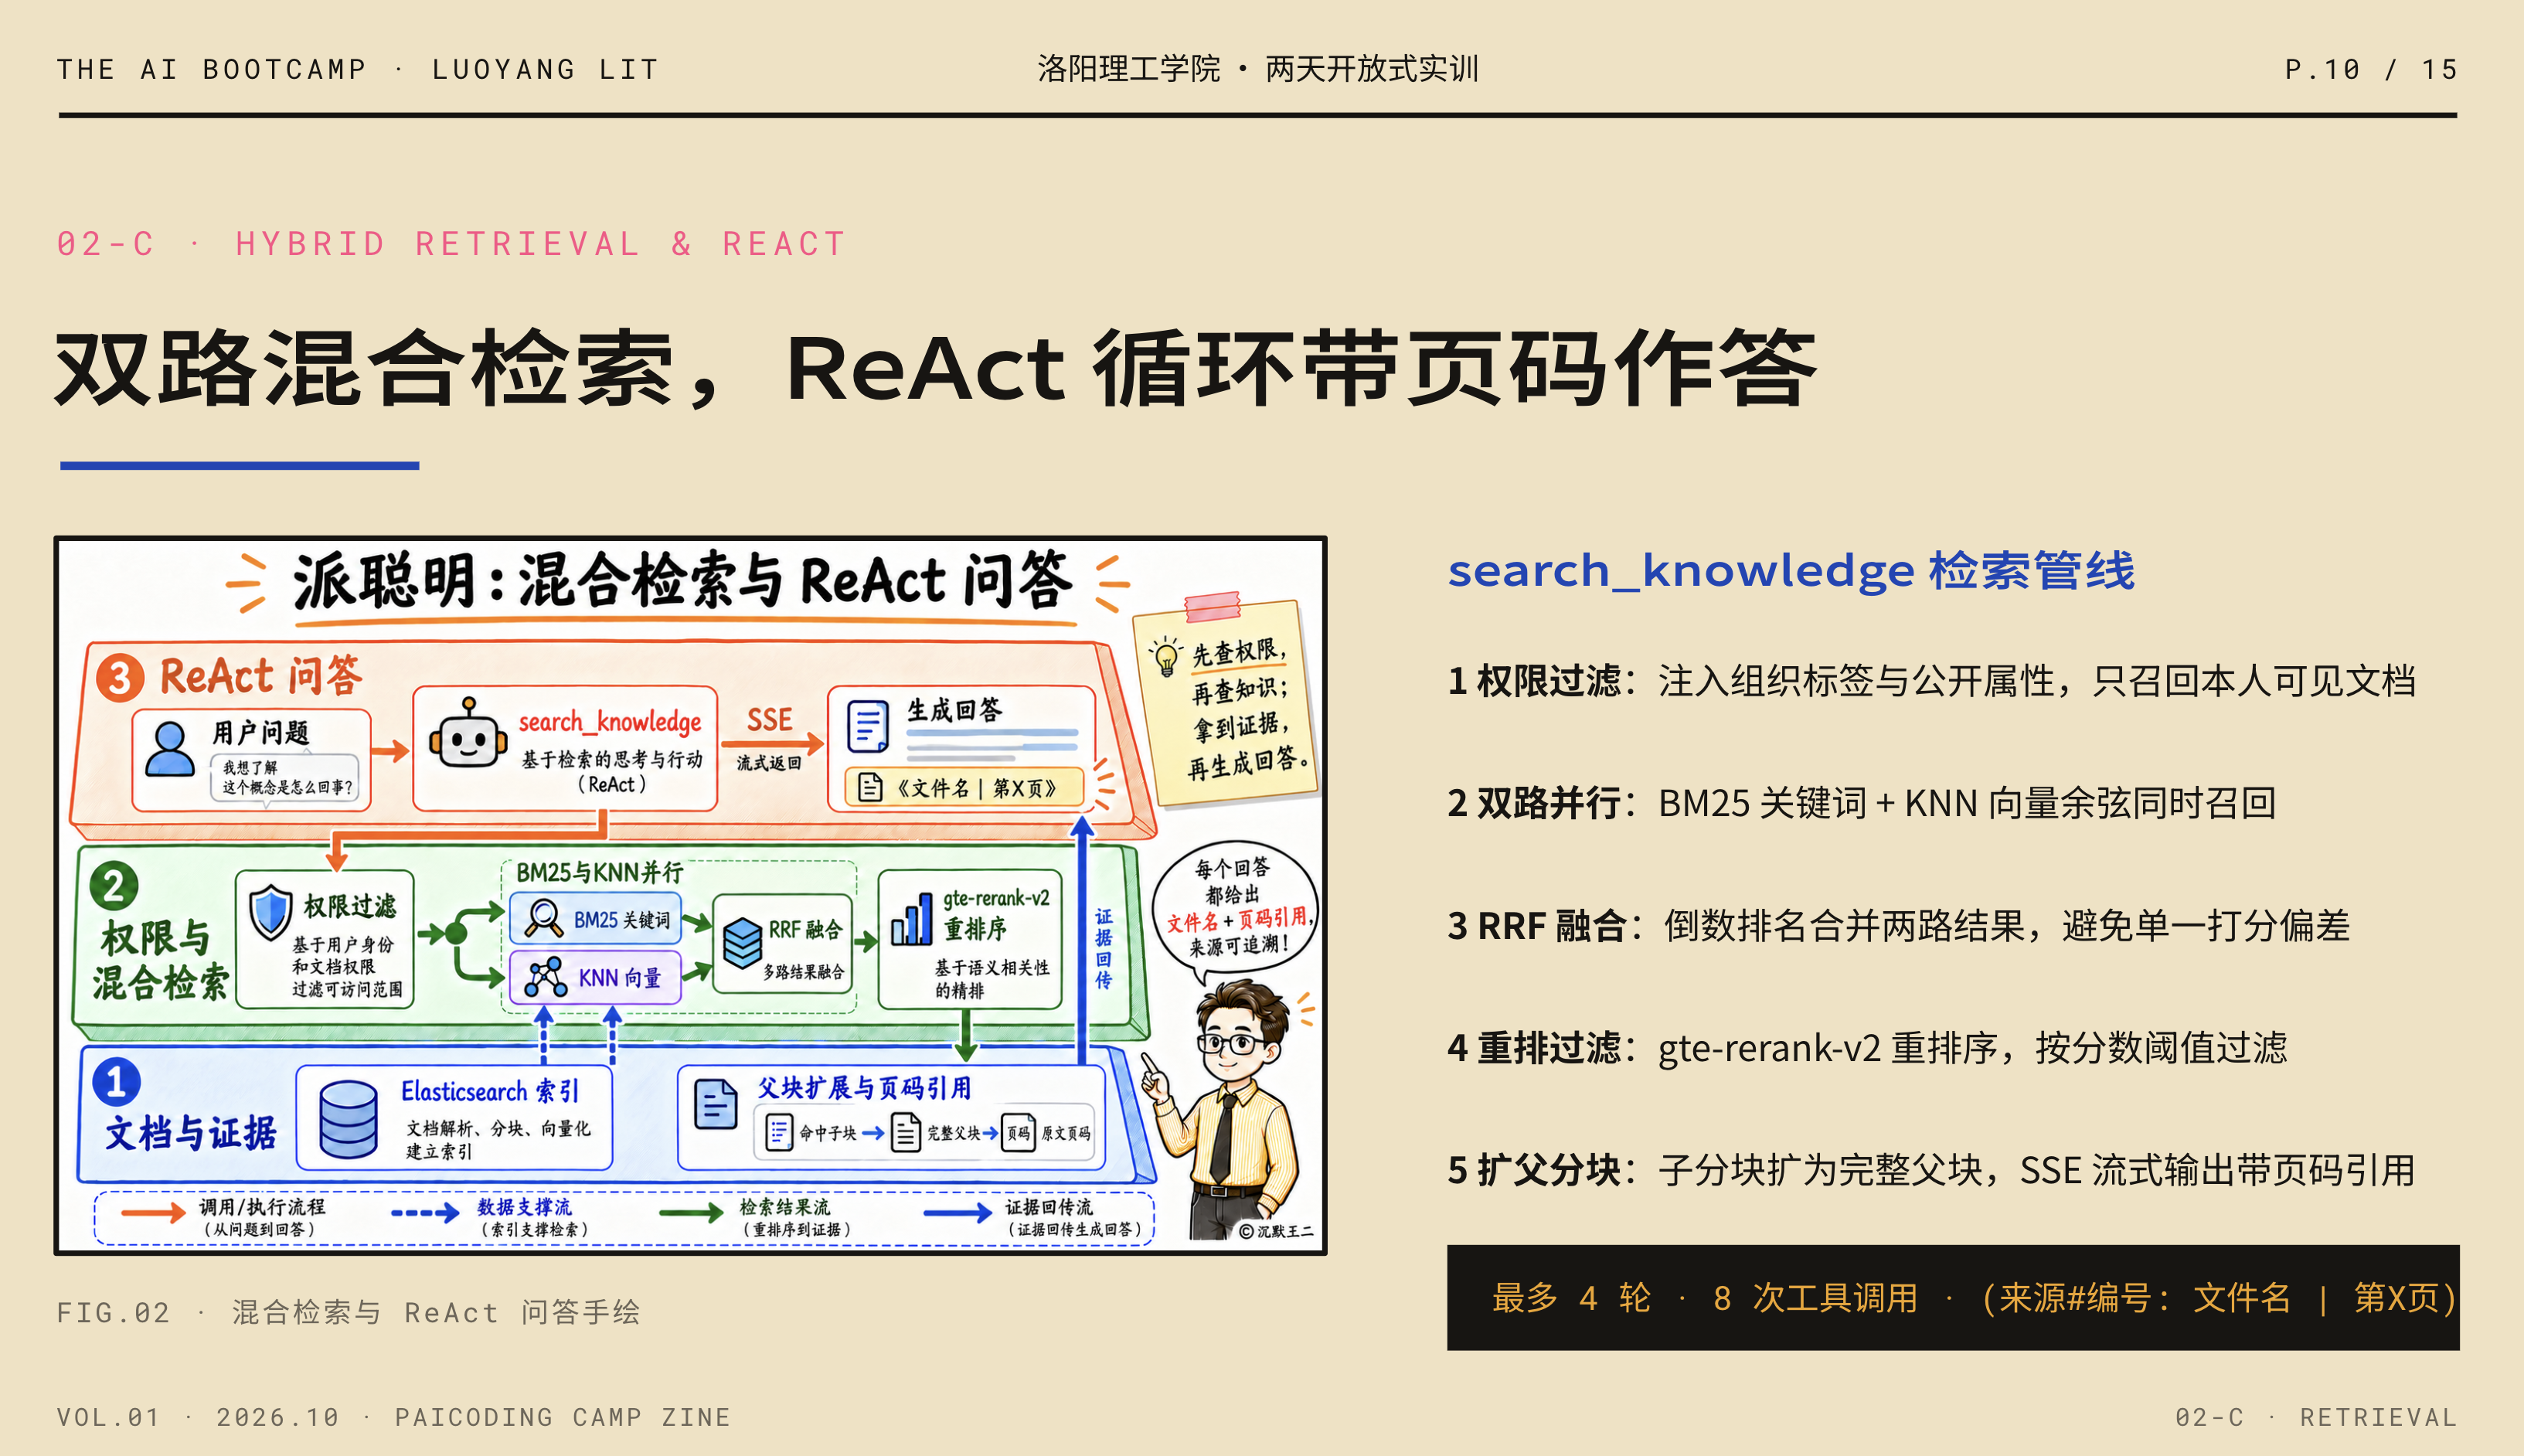
②、建立信任之后,重头戏是两个能直接写进简历的实战项目。先是派聪明 RAG 知识库,涵盖大文件分片上传、基于本地消息表与 Kafka 的异步解析,以及双路混合检索。重点讲 search_knowledge 是怎么先注入组织标签做权限过滤,再并行发起 Elasticsearch 的 BM25 关键词检索与 KNN 向量余弦检索,经倒数排名融合算法与重排序模型筛选后扩展为完整父分块,最终通过 ReAct 输出带页码引用的流式回答。
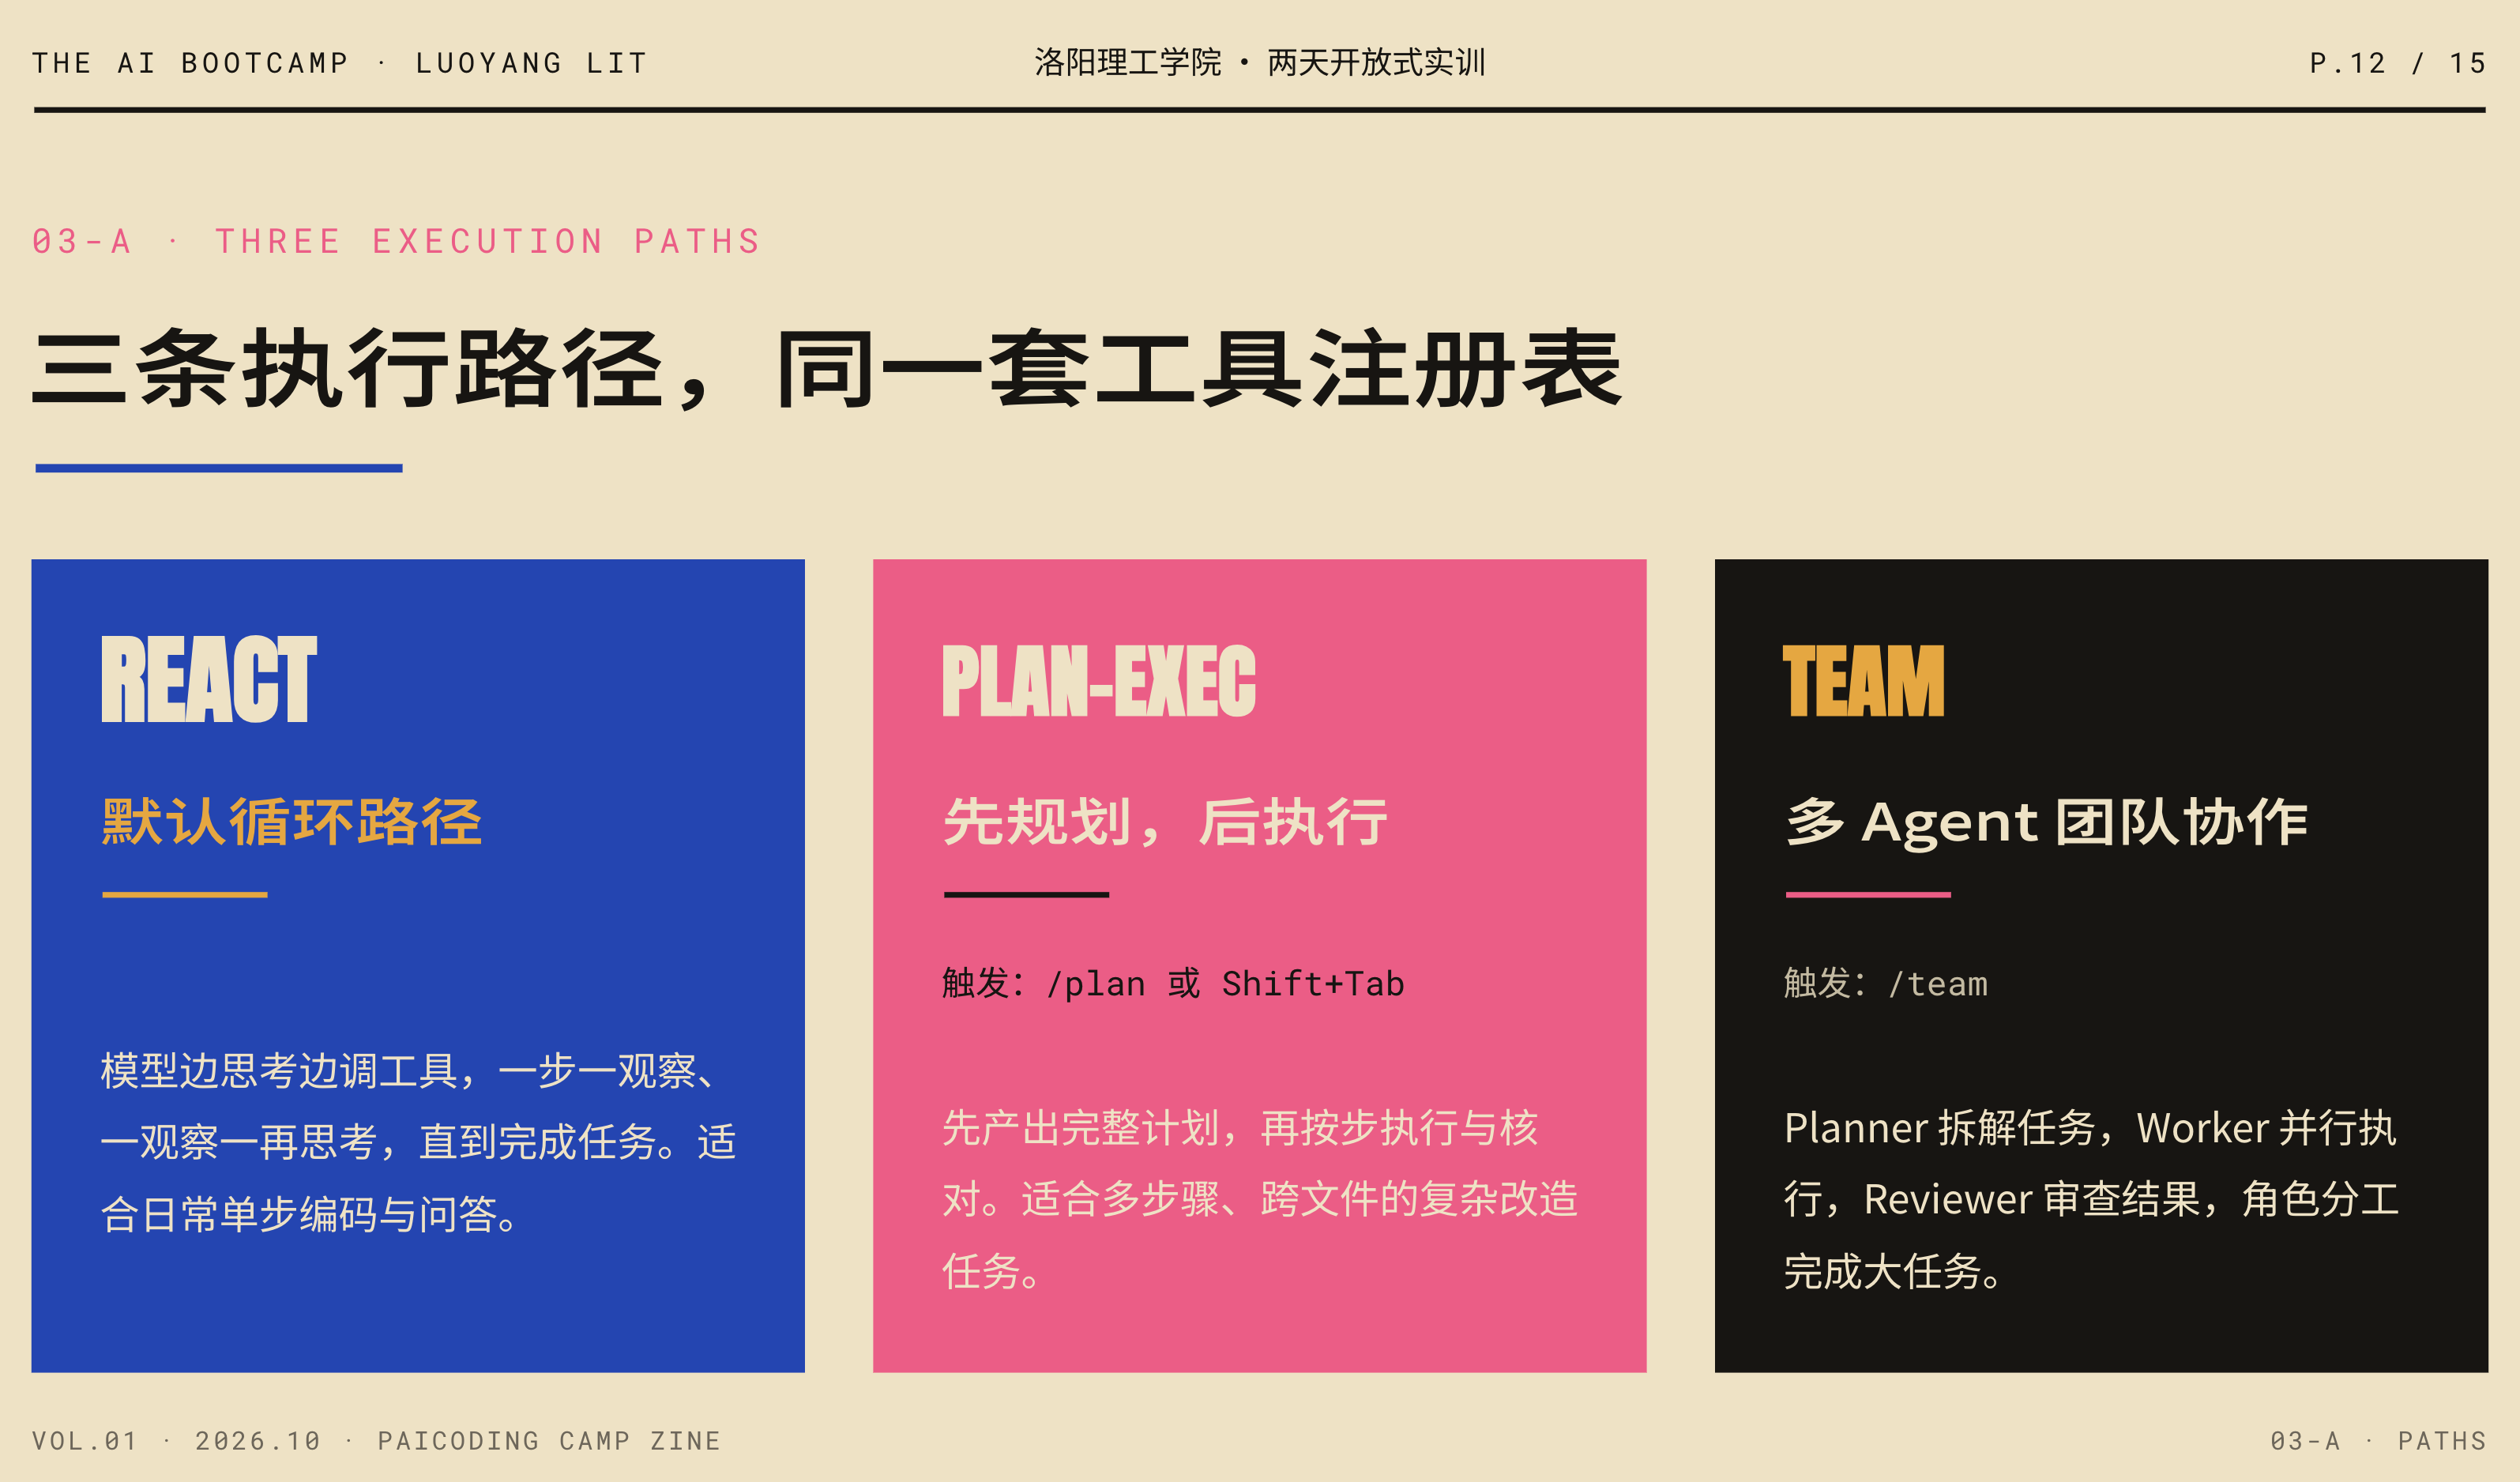
③、接着是终端 Agent 项目 PaiCLI,主要讲 Checkpoint、Sandbox、测评集、ReAct、Memory 机制等。
④、带大家用派简历生成一份可以直接拿去投递的一页 PDF 简历。
⑤、最后是对大家的人生与求职困惑做开放式解答,劝每位同学手头至少准备一个趁手的 Agent 工具。
02、定制排课表
有了 PPT 大纲,接下来要解决每节课具体讲什么。每天要上八节课,早上 8 点开始,下午 2 点半上课,一节课 40 分钟。直接让豆包工作帮我排课。
我每天要上八节课,早上 8 点开始,下午 2 点半上课,一节课大概 40 分钟,不需要每一分钟都在讲话,这时候应该怎么合理安排每一节课,帮我出一个排课表。
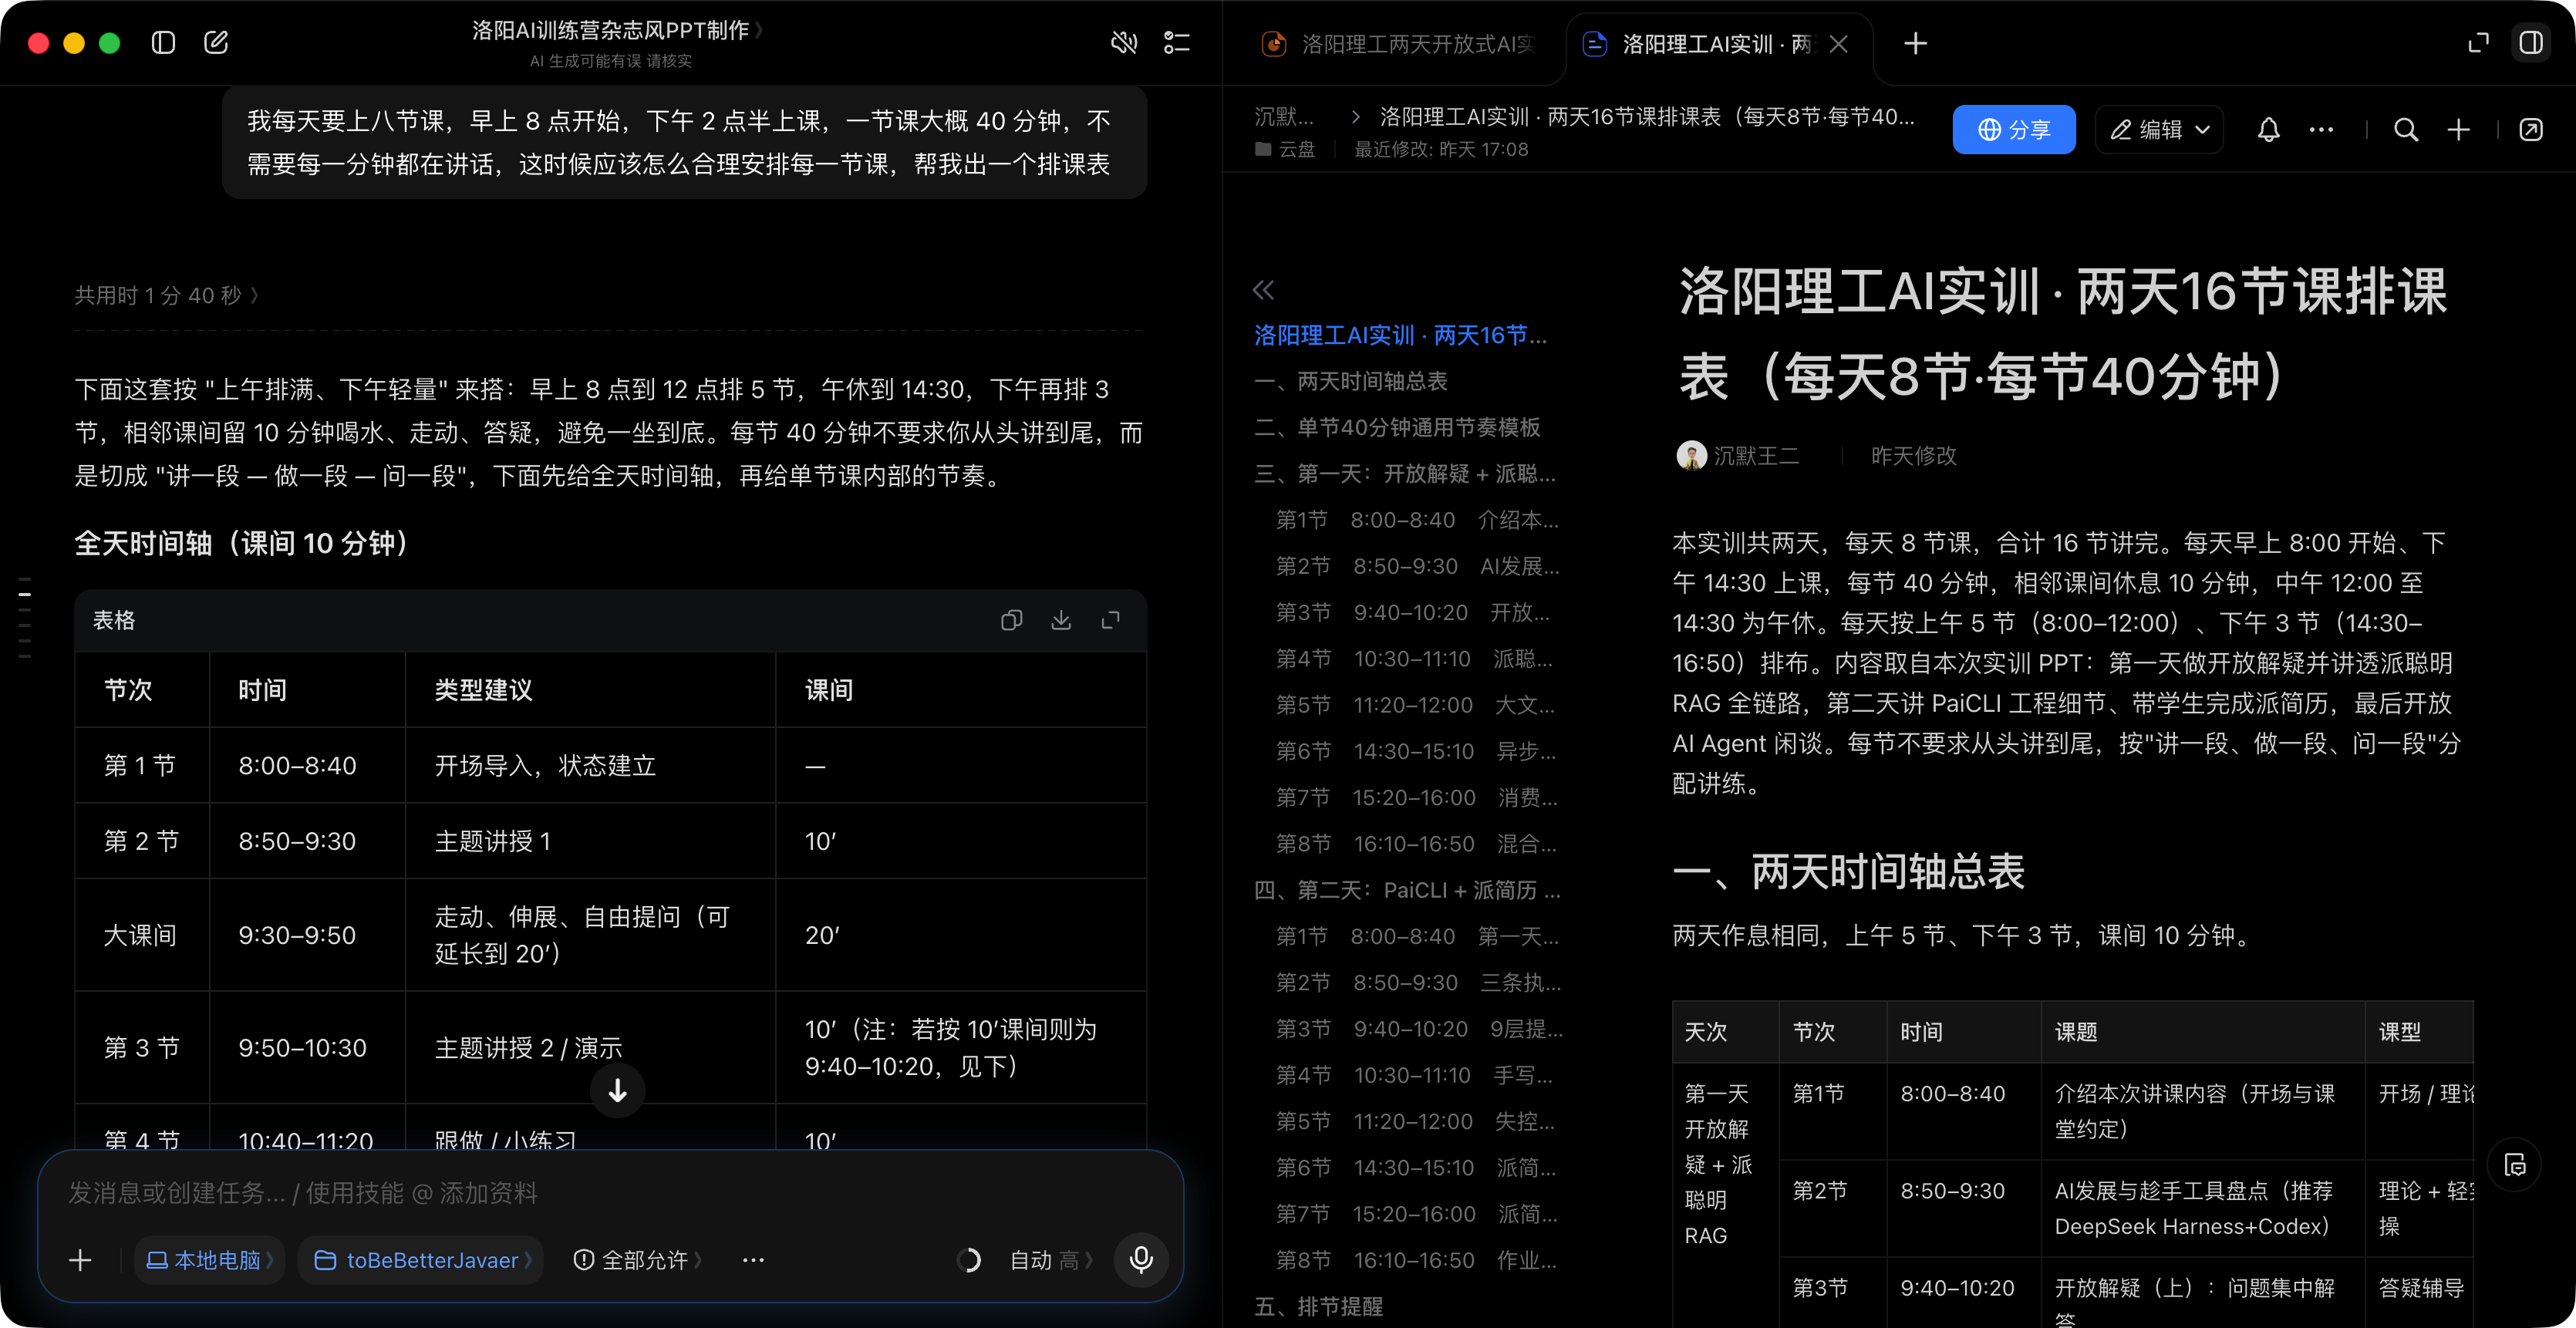
我细致看了一下,整体节奏把控非常到位。
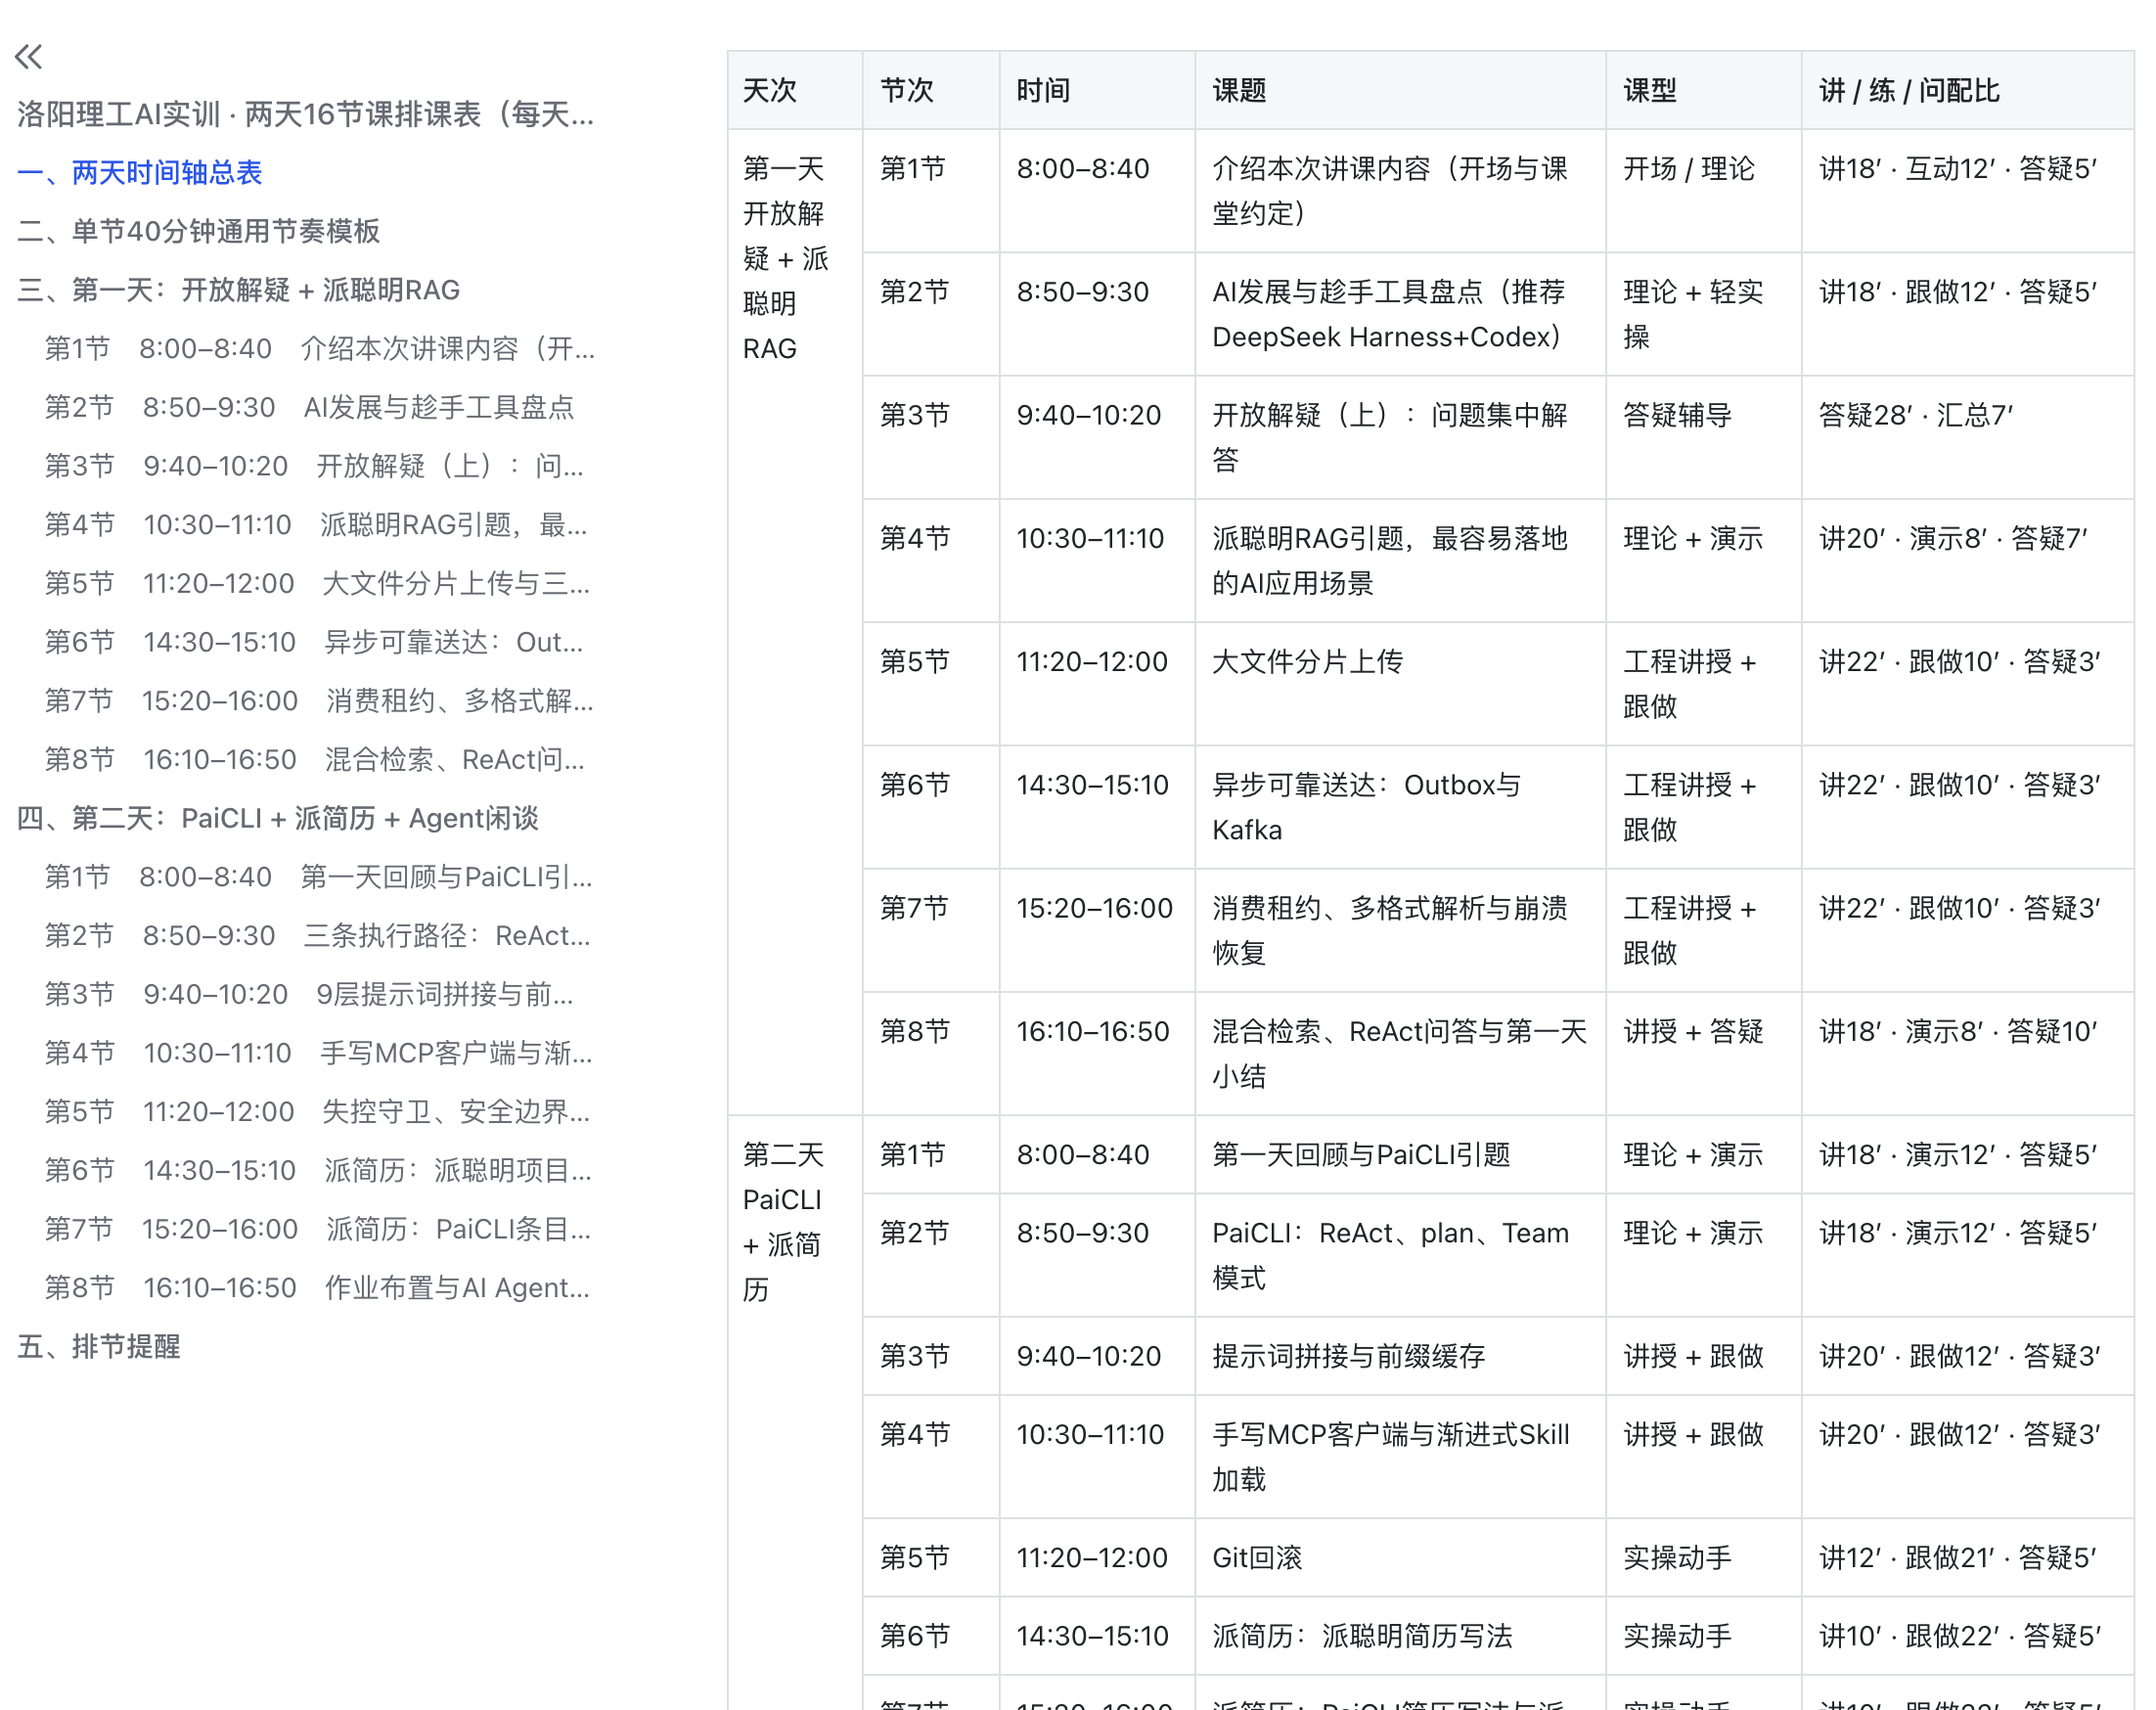
每节课具体应该讲什么、怎么和同学们互动,排课表里也写得一清二楚。
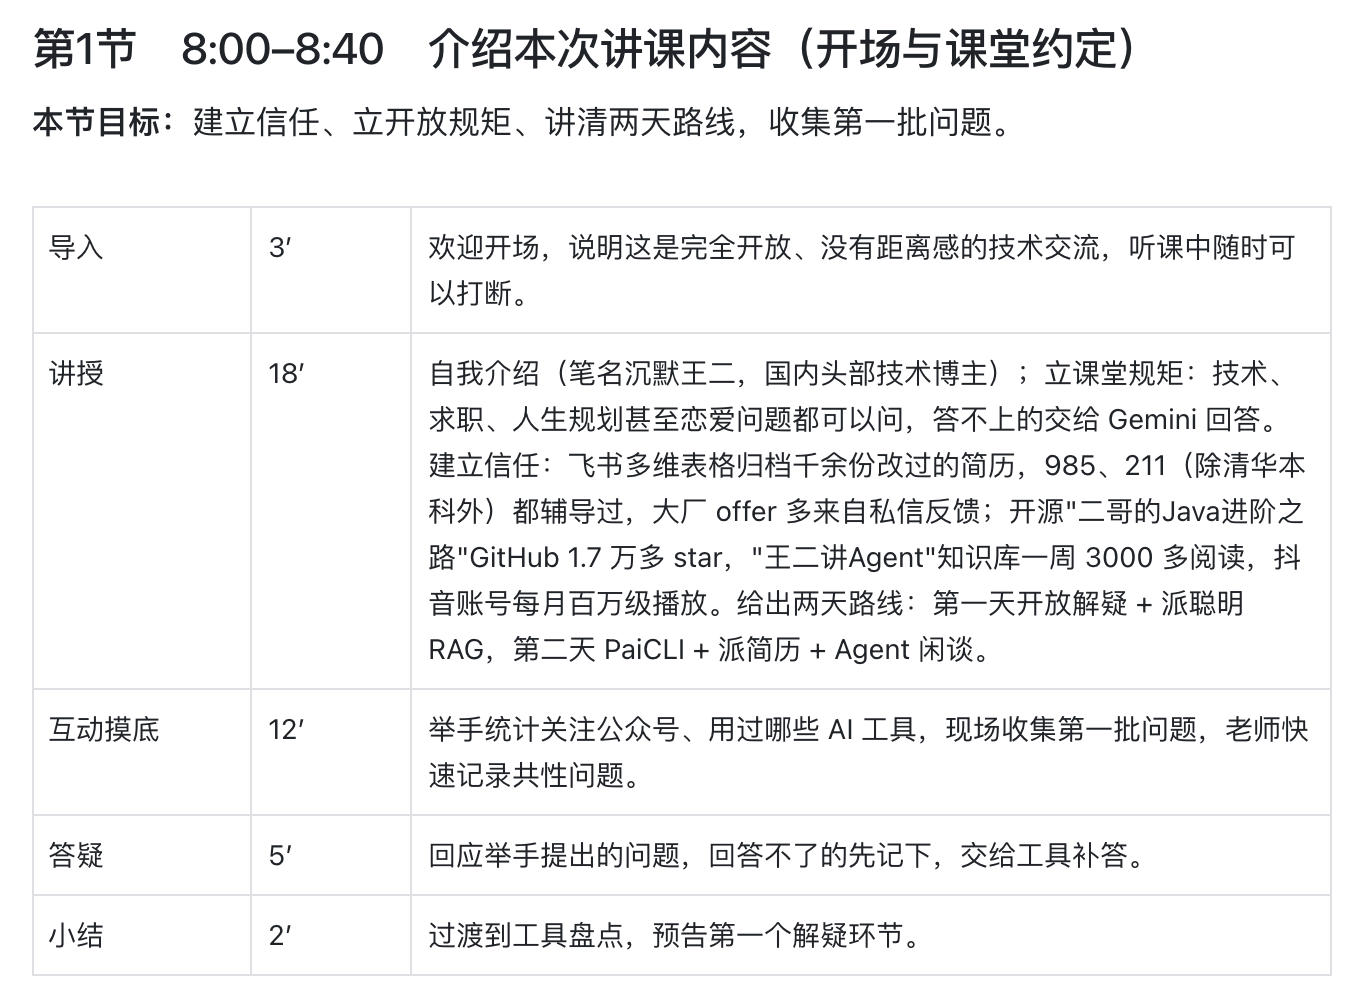
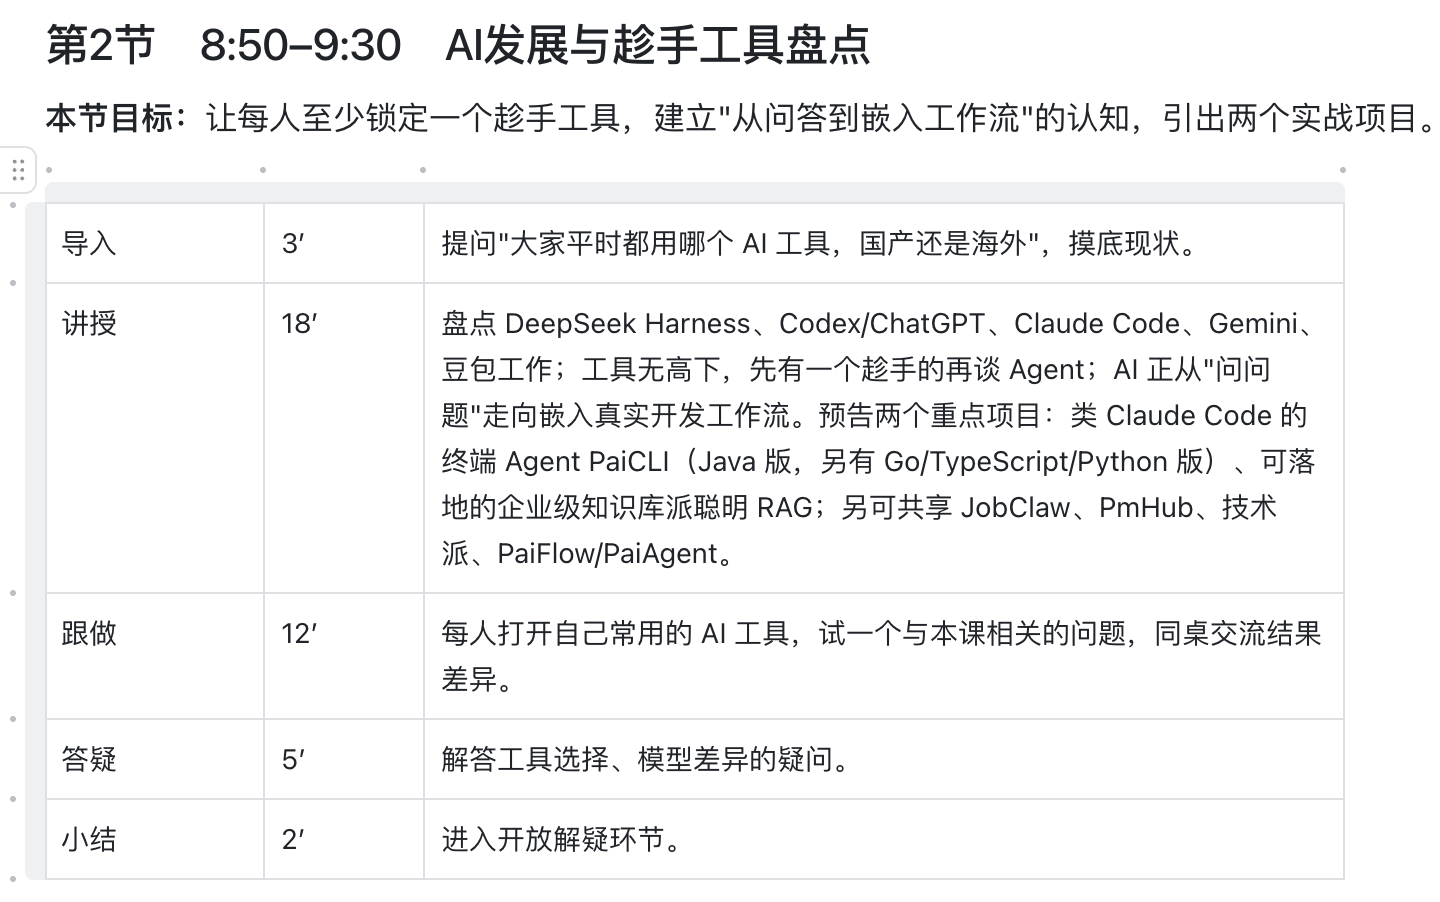
有了这些,我心里基本上就不慌了,再加上我可以随时随地让豆包工作根据课堂的反馈进行迭代升级。
比如说同学们喜欢听什么,对什么感兴趣,我都可以第一时间调整。
加上我这些年的经验积累,毕竟派聪明 RAG 和 PaiCLI 终端 Agent 这两个项目也都非常成熟,以及我对 AI 前沿知识的理解,我觉得完全可以给大家呈现出来一种比较有收获的课堂知识。
03、生成科普视频
讲课过程中难免会遇到一些同学们没听过的专业名词,比如 ReAct、RRF、RAG、CLI、Harness 等等。
光靠口头解释很容易枯燥,我干脆让豆包工作帮我整理了一个名叫 One Minute Remotion 的本地 Skill,用来把单个技术概念直接生成文稿和一分钟科普视频。
直接拿混合检索里的 RRF(倒数排名融合)来做测试,先在豆包工作里选中该技能,让它只出文案。
帮我给第一次接触 RRF 的同学写一分钟口播稿,先只出文案。
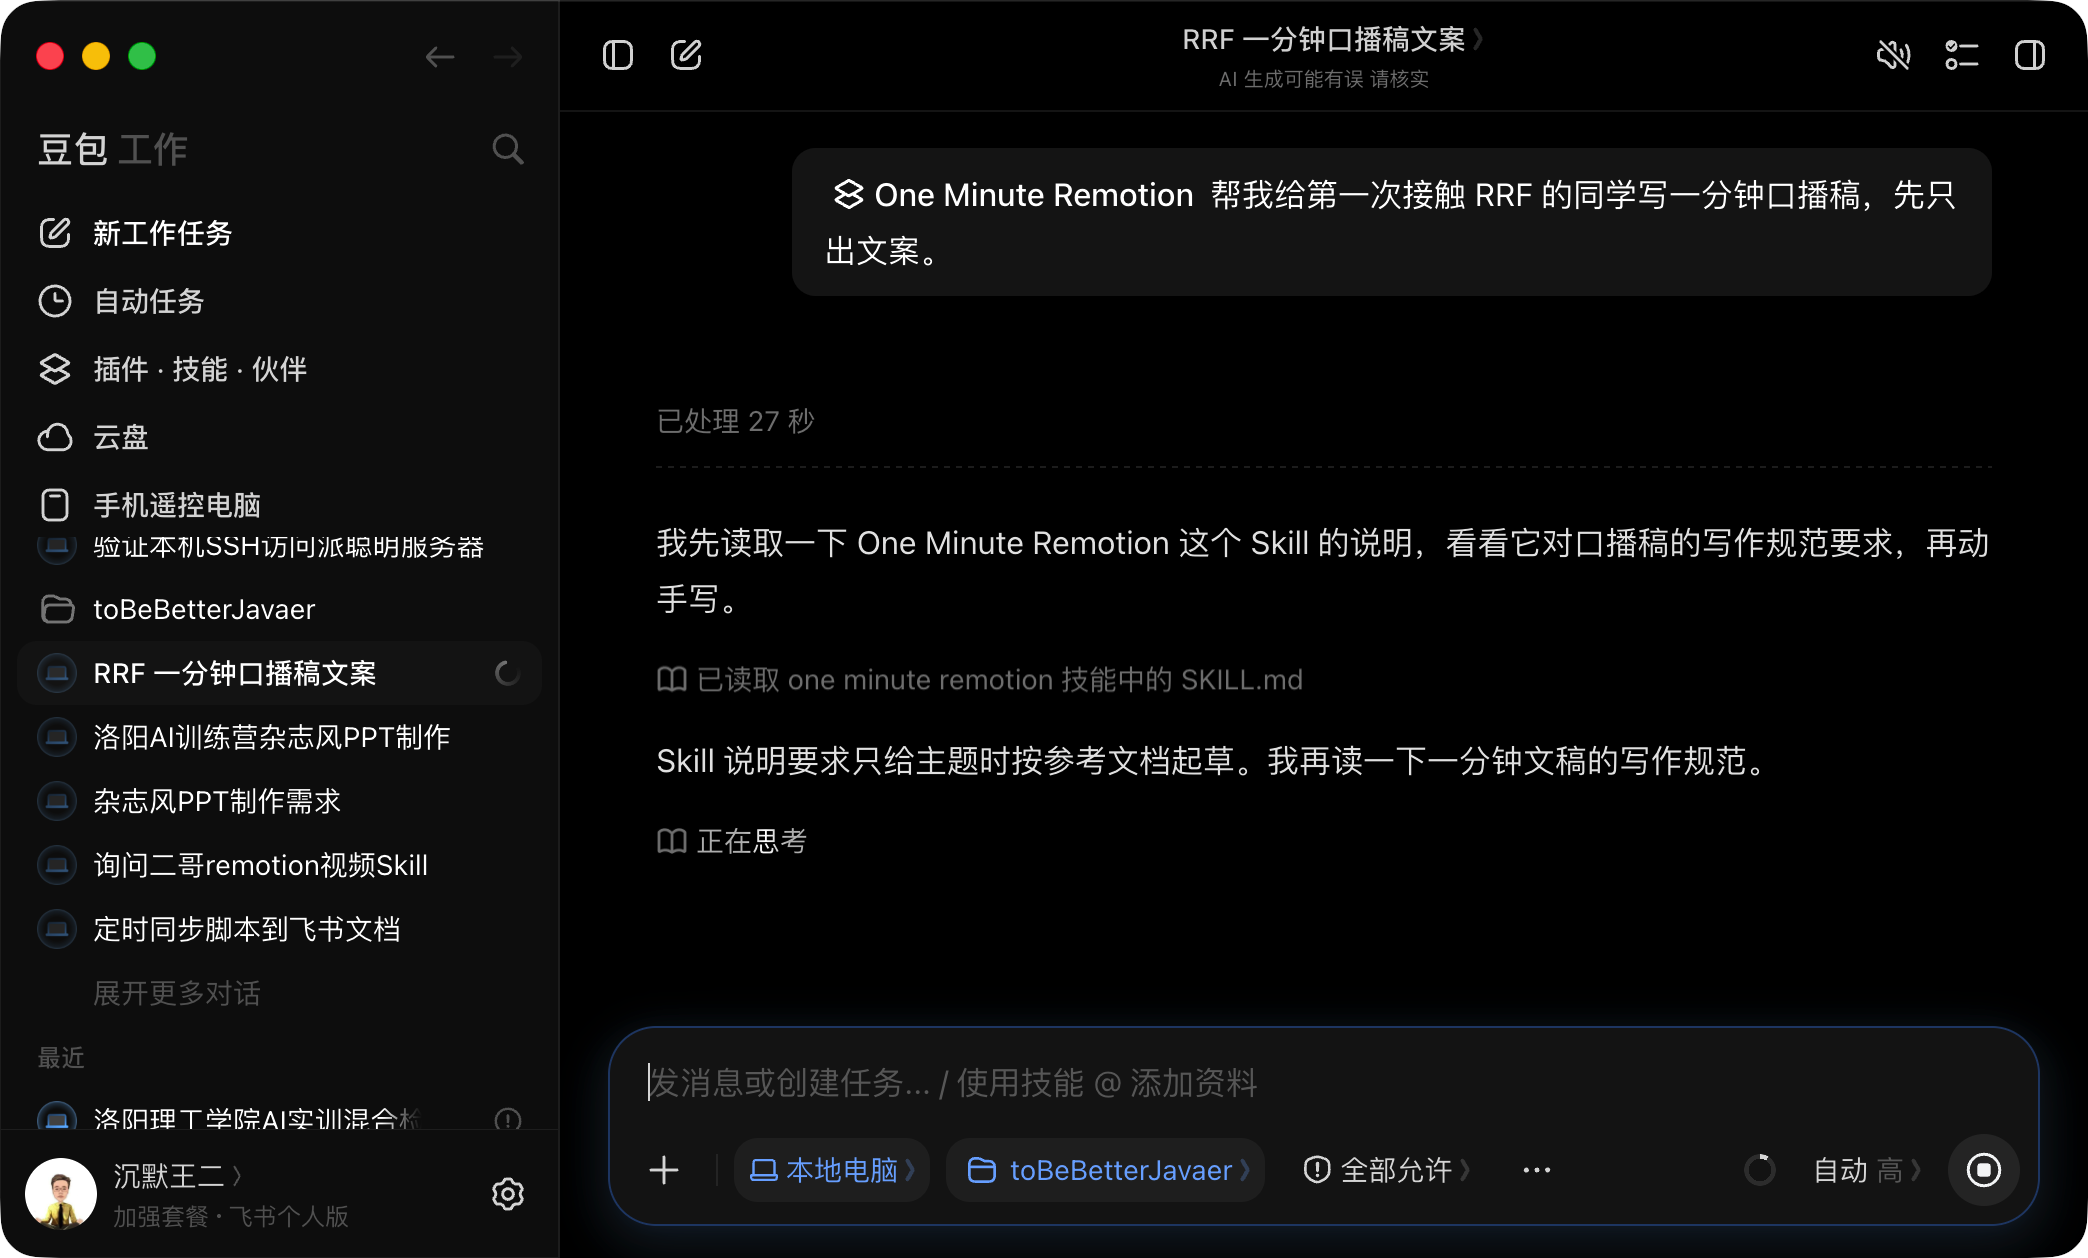
不到半分钟,口播稿就出来了,把为什么不能直接加原始分数、RRF 公式怎么算以及适用边界讲得很明白。
当知识库同时使用关键词检索和向量检索时,两路各自返回了一份排名,怎么把它们合并成一份最终榜单?

直接把原始分数相加是行不通的。向量检索的分数通常在 0 到 1 之间,而关键词检索的分数没有固定上限,直接相加会让总分被关键词检索主导。

解决办法是 RRF,全称 Reciprocal Rank Fusion,中文叫倒数排名融合。它不看原始分数,只看名次。一篇文档在某一路排第 rank 名,名次从 1 开始算,就拿到 1 除以 k 加 rank 的分数,常数 k 通常取 60;如果这一路没有命中,就记 0 分。

来看一组示例排名。关键词检索的前三名是文档 A、文档 B、文档 C;向量检索的前两名是文档 B、文档 C,文档 A 没有命中。

文档 A 只在关键词检索排第 1 名,得分是 1 除以 61 加 0,约为 0.0164。文档 B 在两路分别排第 2 名和第 1 名,得分是 1 除以 62 加 1 除以 61,约为 0.0325。文档 C 两路相加约为 0.0320。

最终,被两路共同认可的文档 B 和文档 C 升到前两名,单路第一的文档 A 退到第 3 名。不过 RRF 只看名次、不读正文内容,通常用来做多路检索的快速粗排。
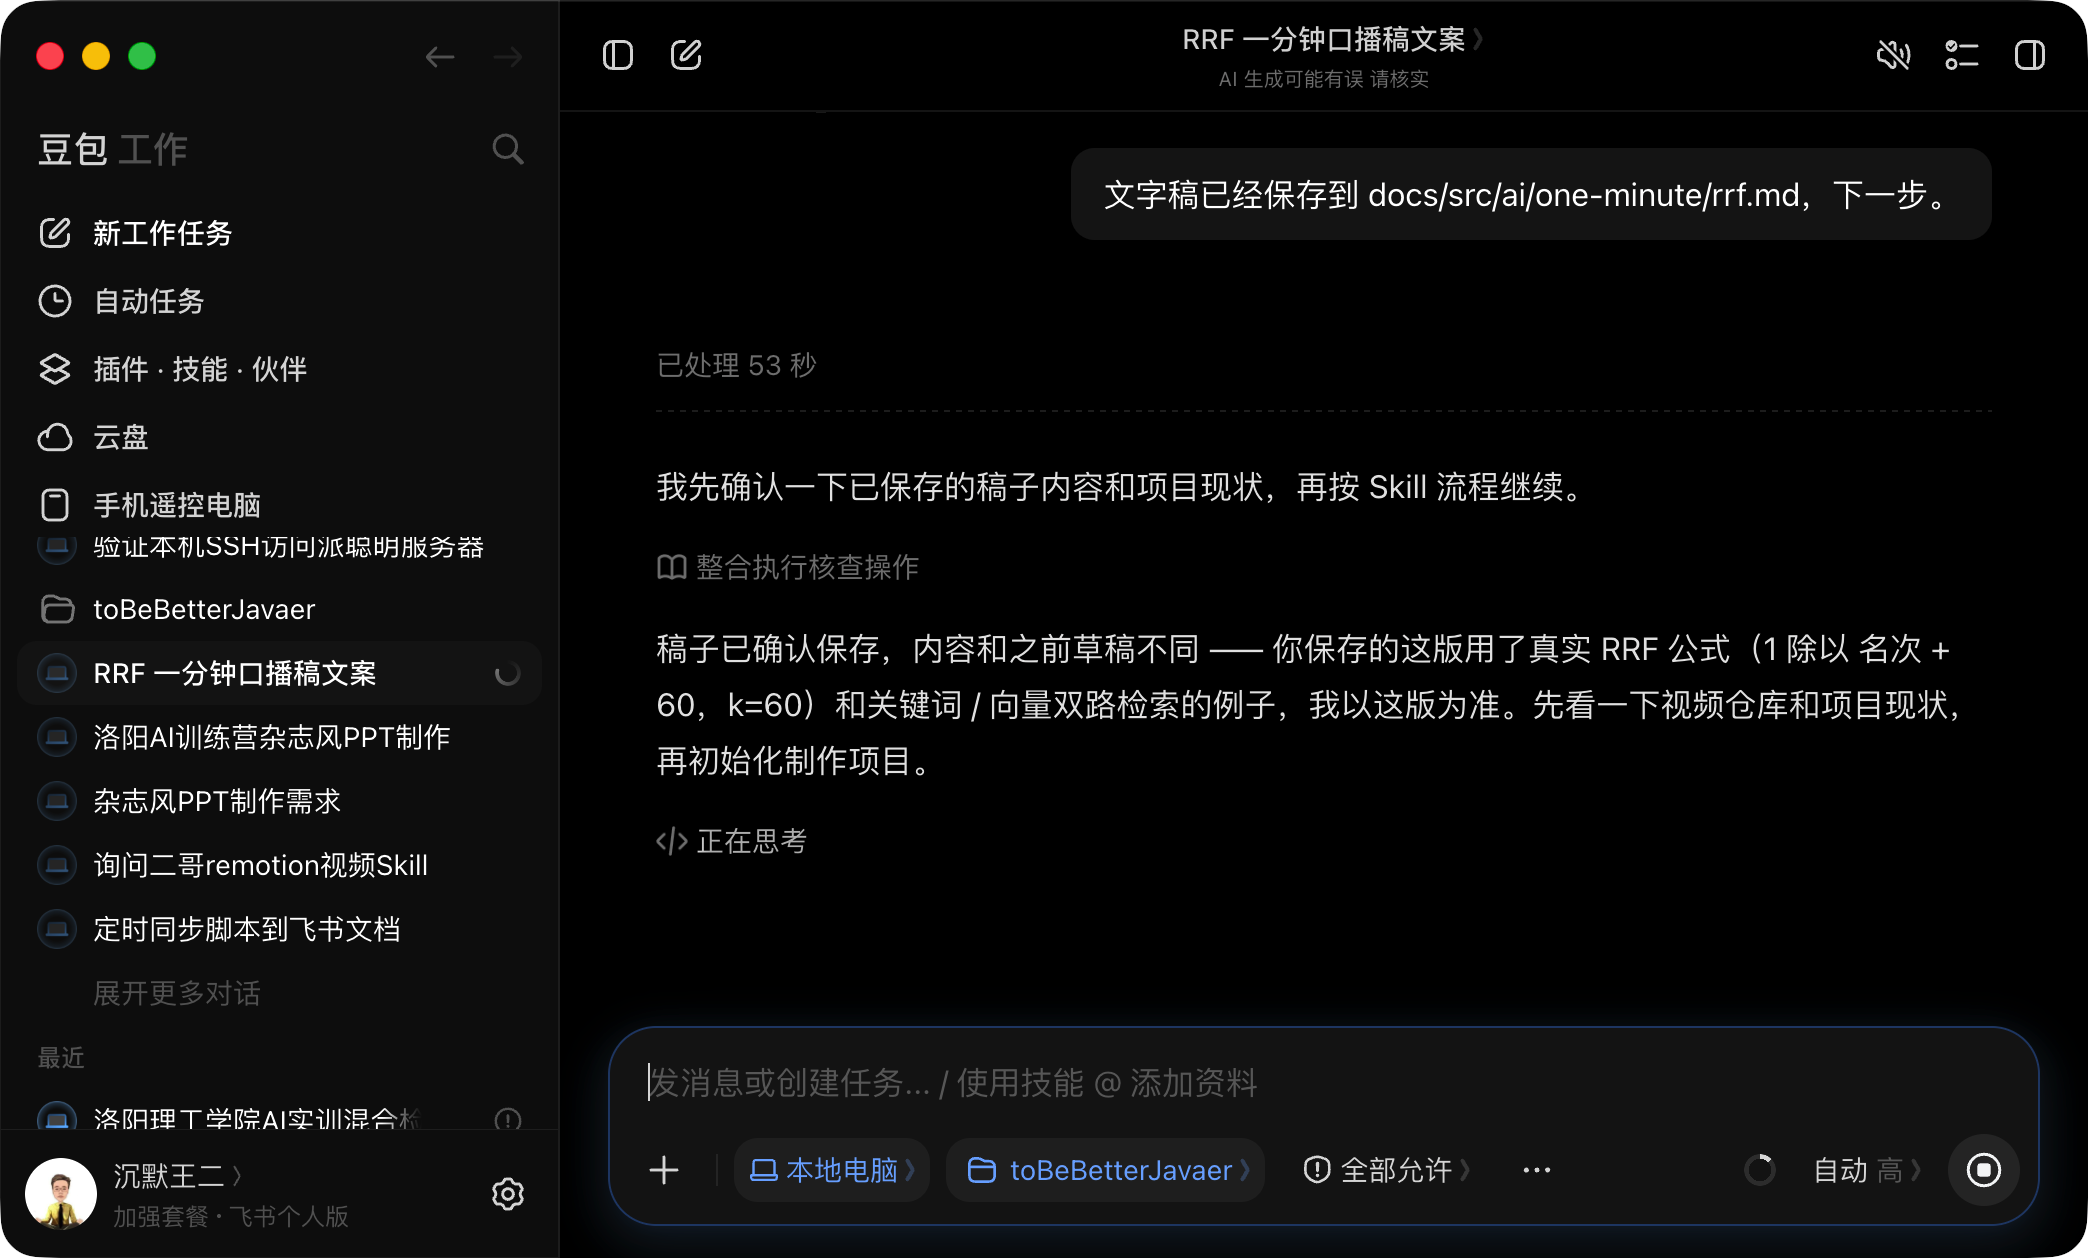
把文字稿保存到本地后,我们继续推进,让豆包工作把文字稿变成二哥声音的完整配音,检查有没有漏字、重复或术语读错,并测出实际时长。
文字稿已经保存到 docs/src/ai/one-minute/rrf.md,下一步。
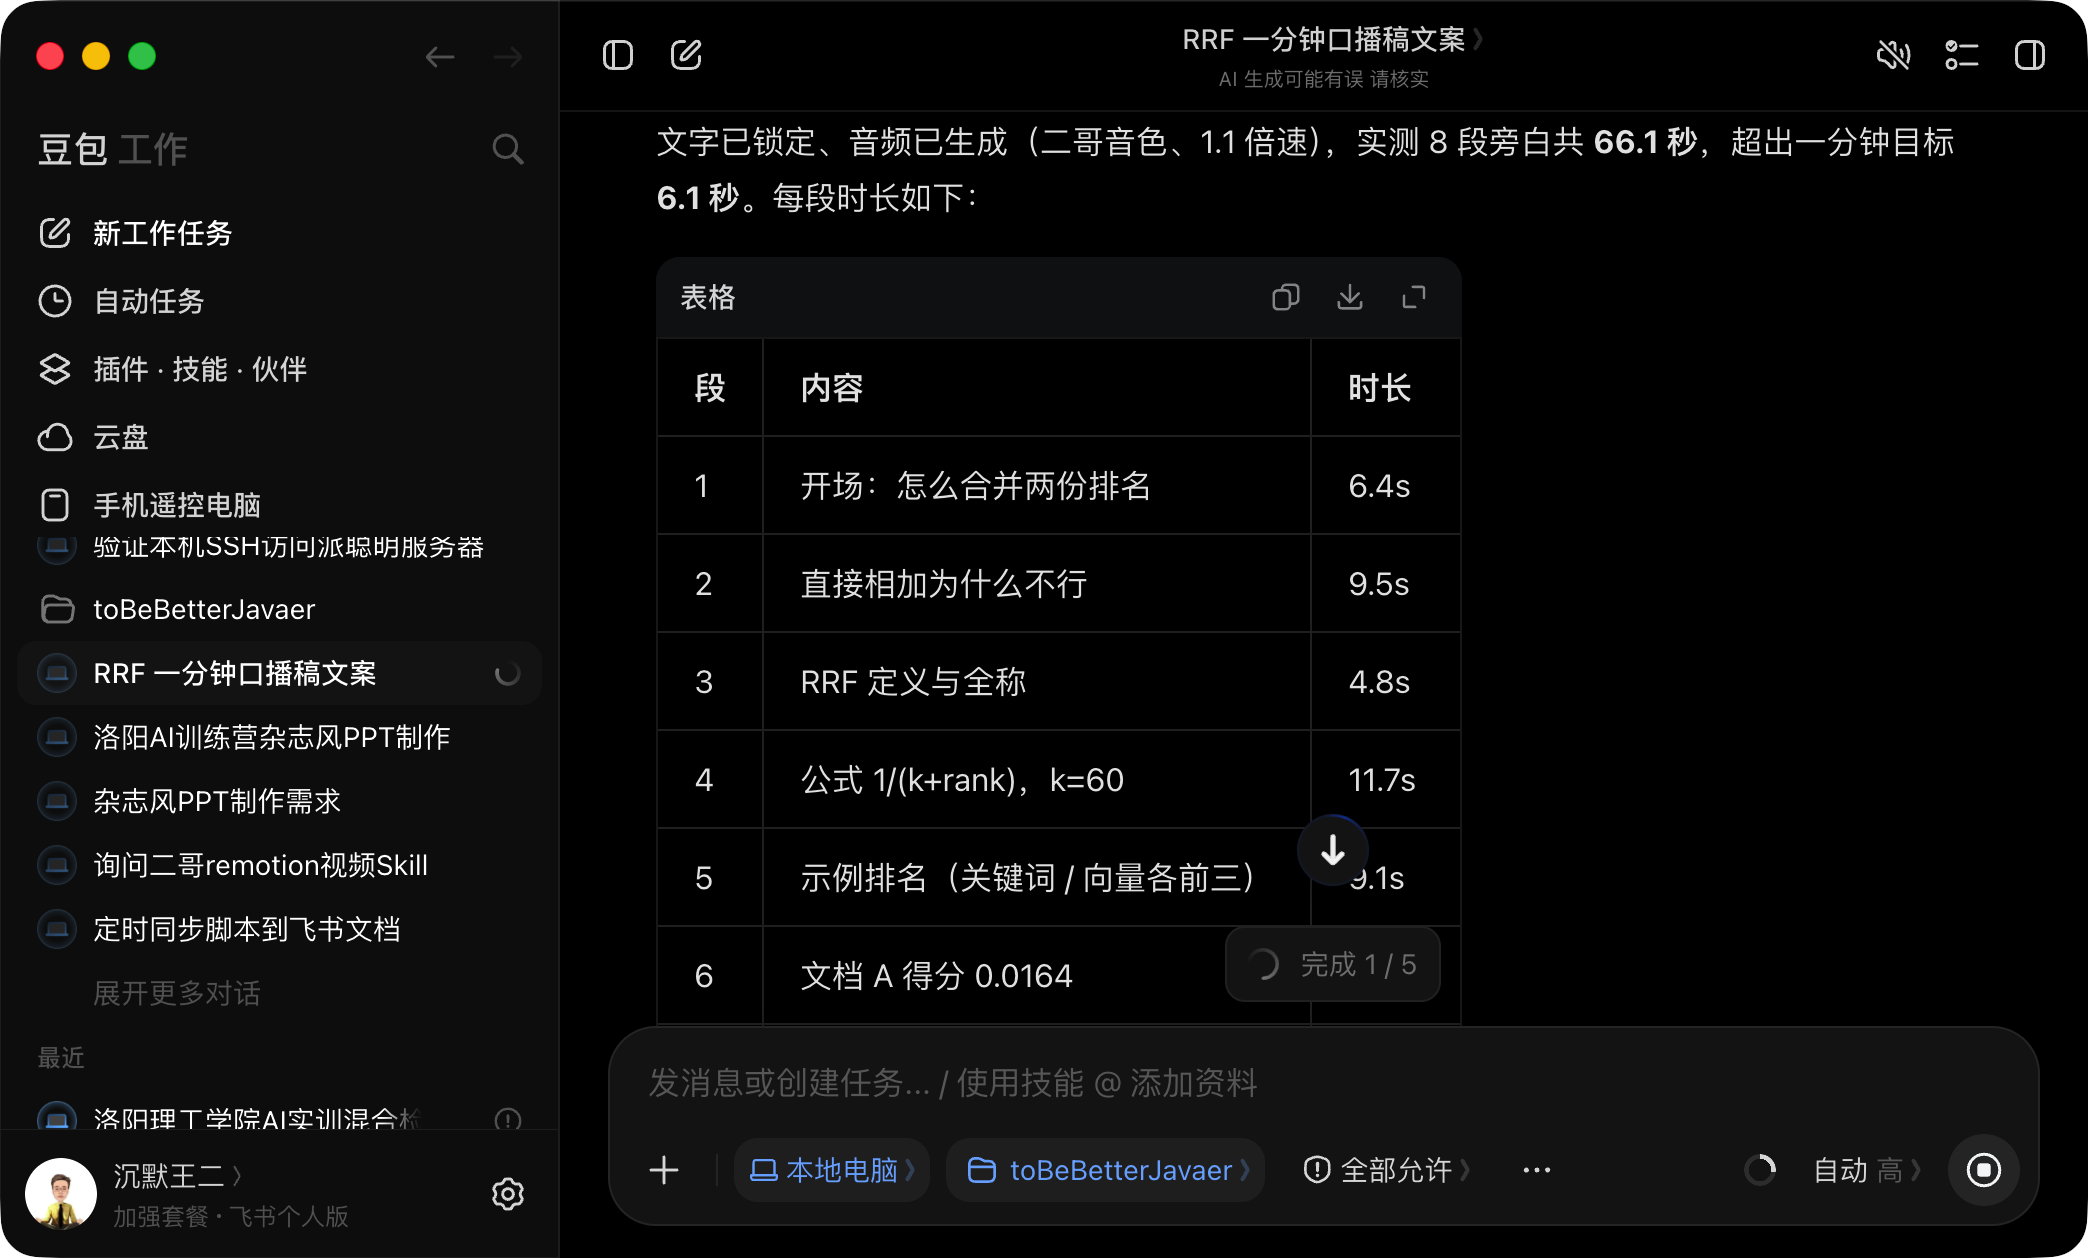
配音很快完成,豆包工作调用我本机的二哥音色按 1.1 倍速合成了音频,8 段旁白实测总时长 66.1 秒,每段的精确时长都列在了表格里。
同时它把生成的 voiceover.wav 和 voiceover.mp3 音频卡片交给我试听,并主动停在当前阶段等待确认。
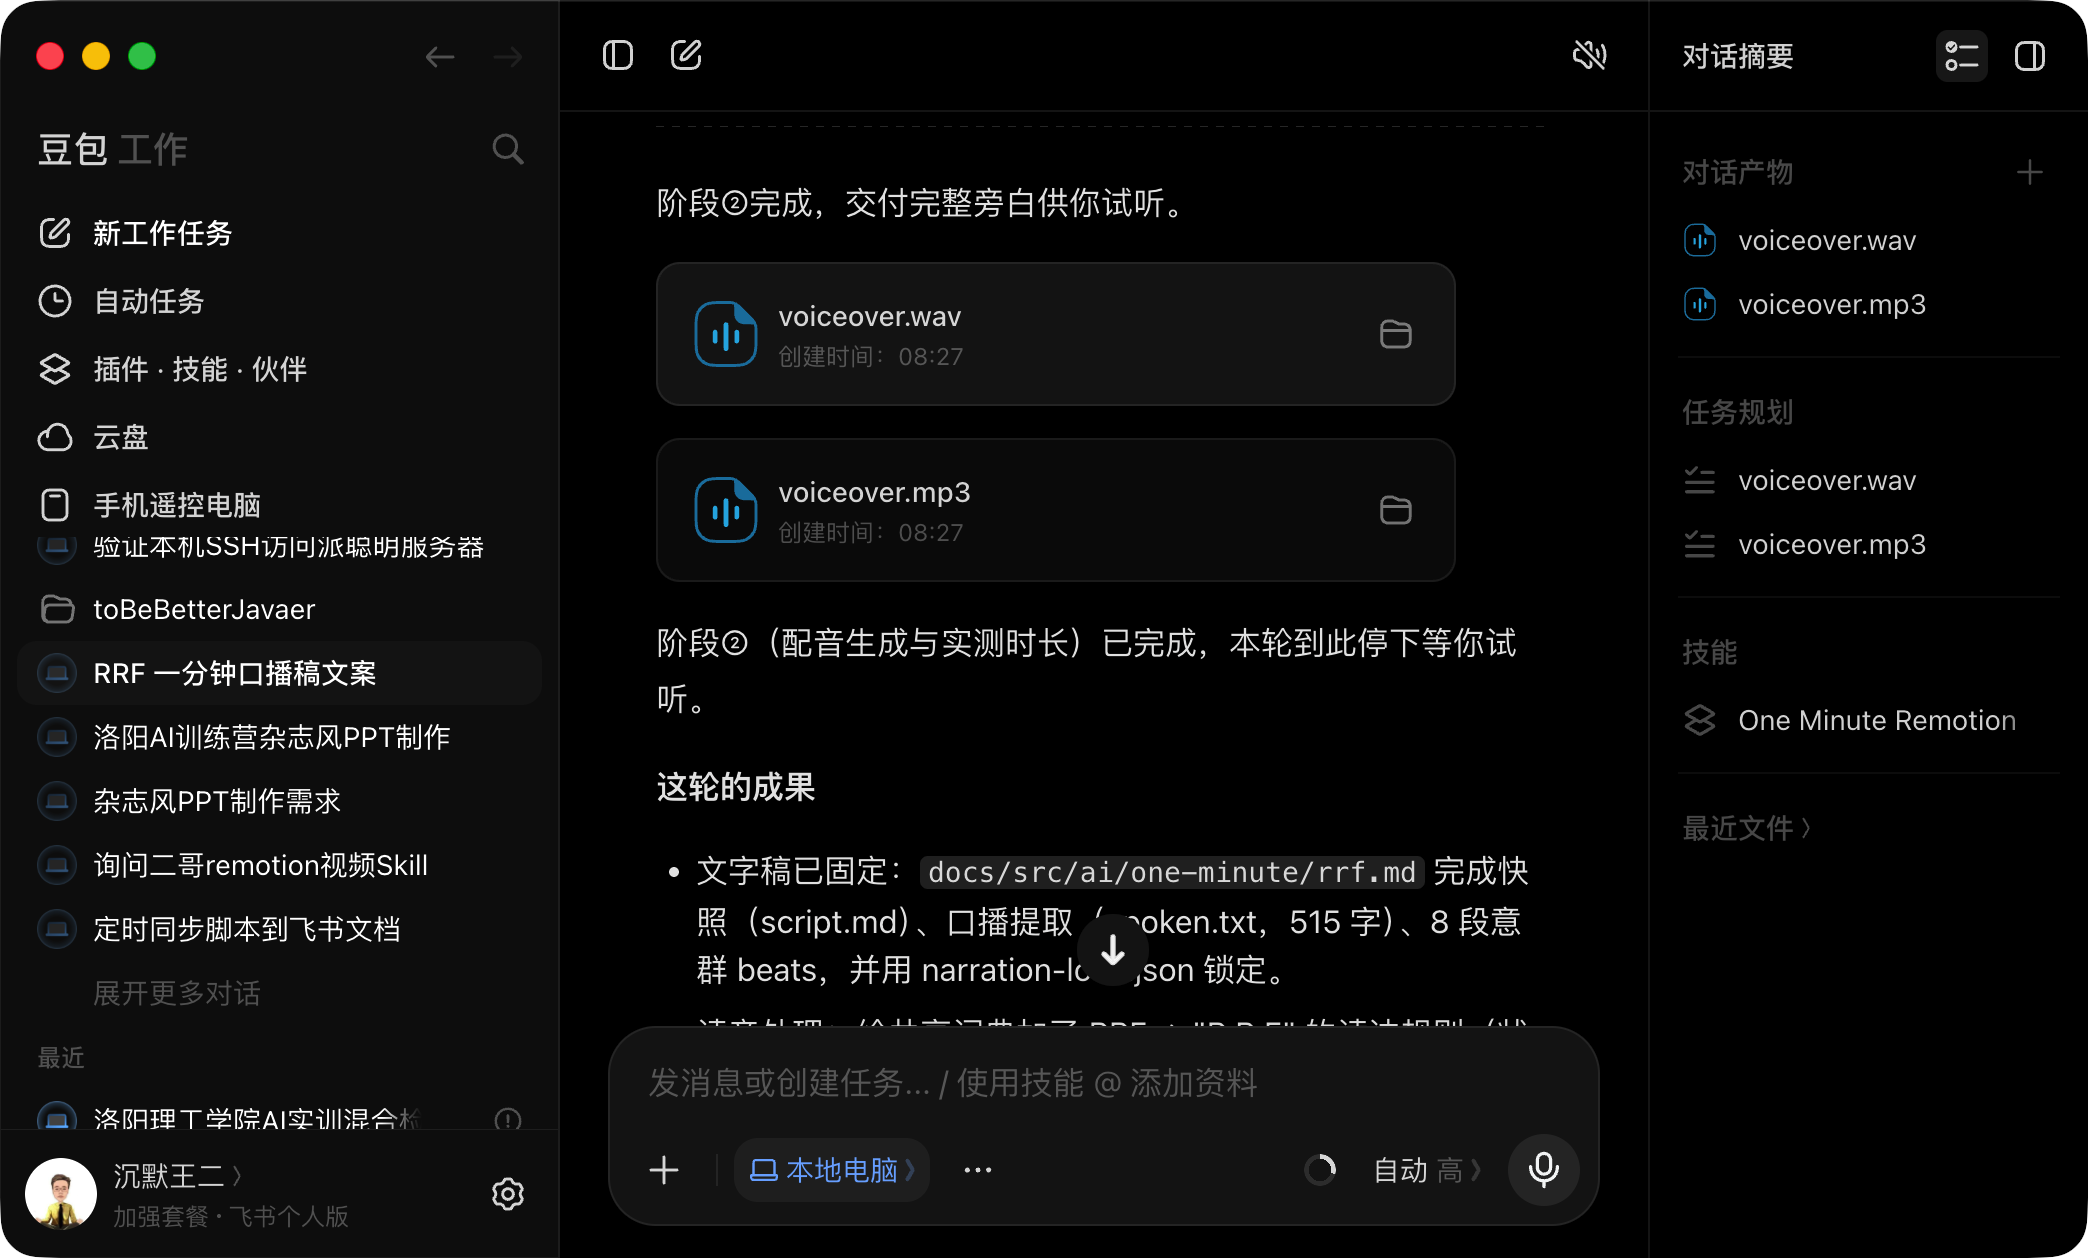
试听确认读音和节奏都没问题后,我回复“下一步”进入分镜设计。
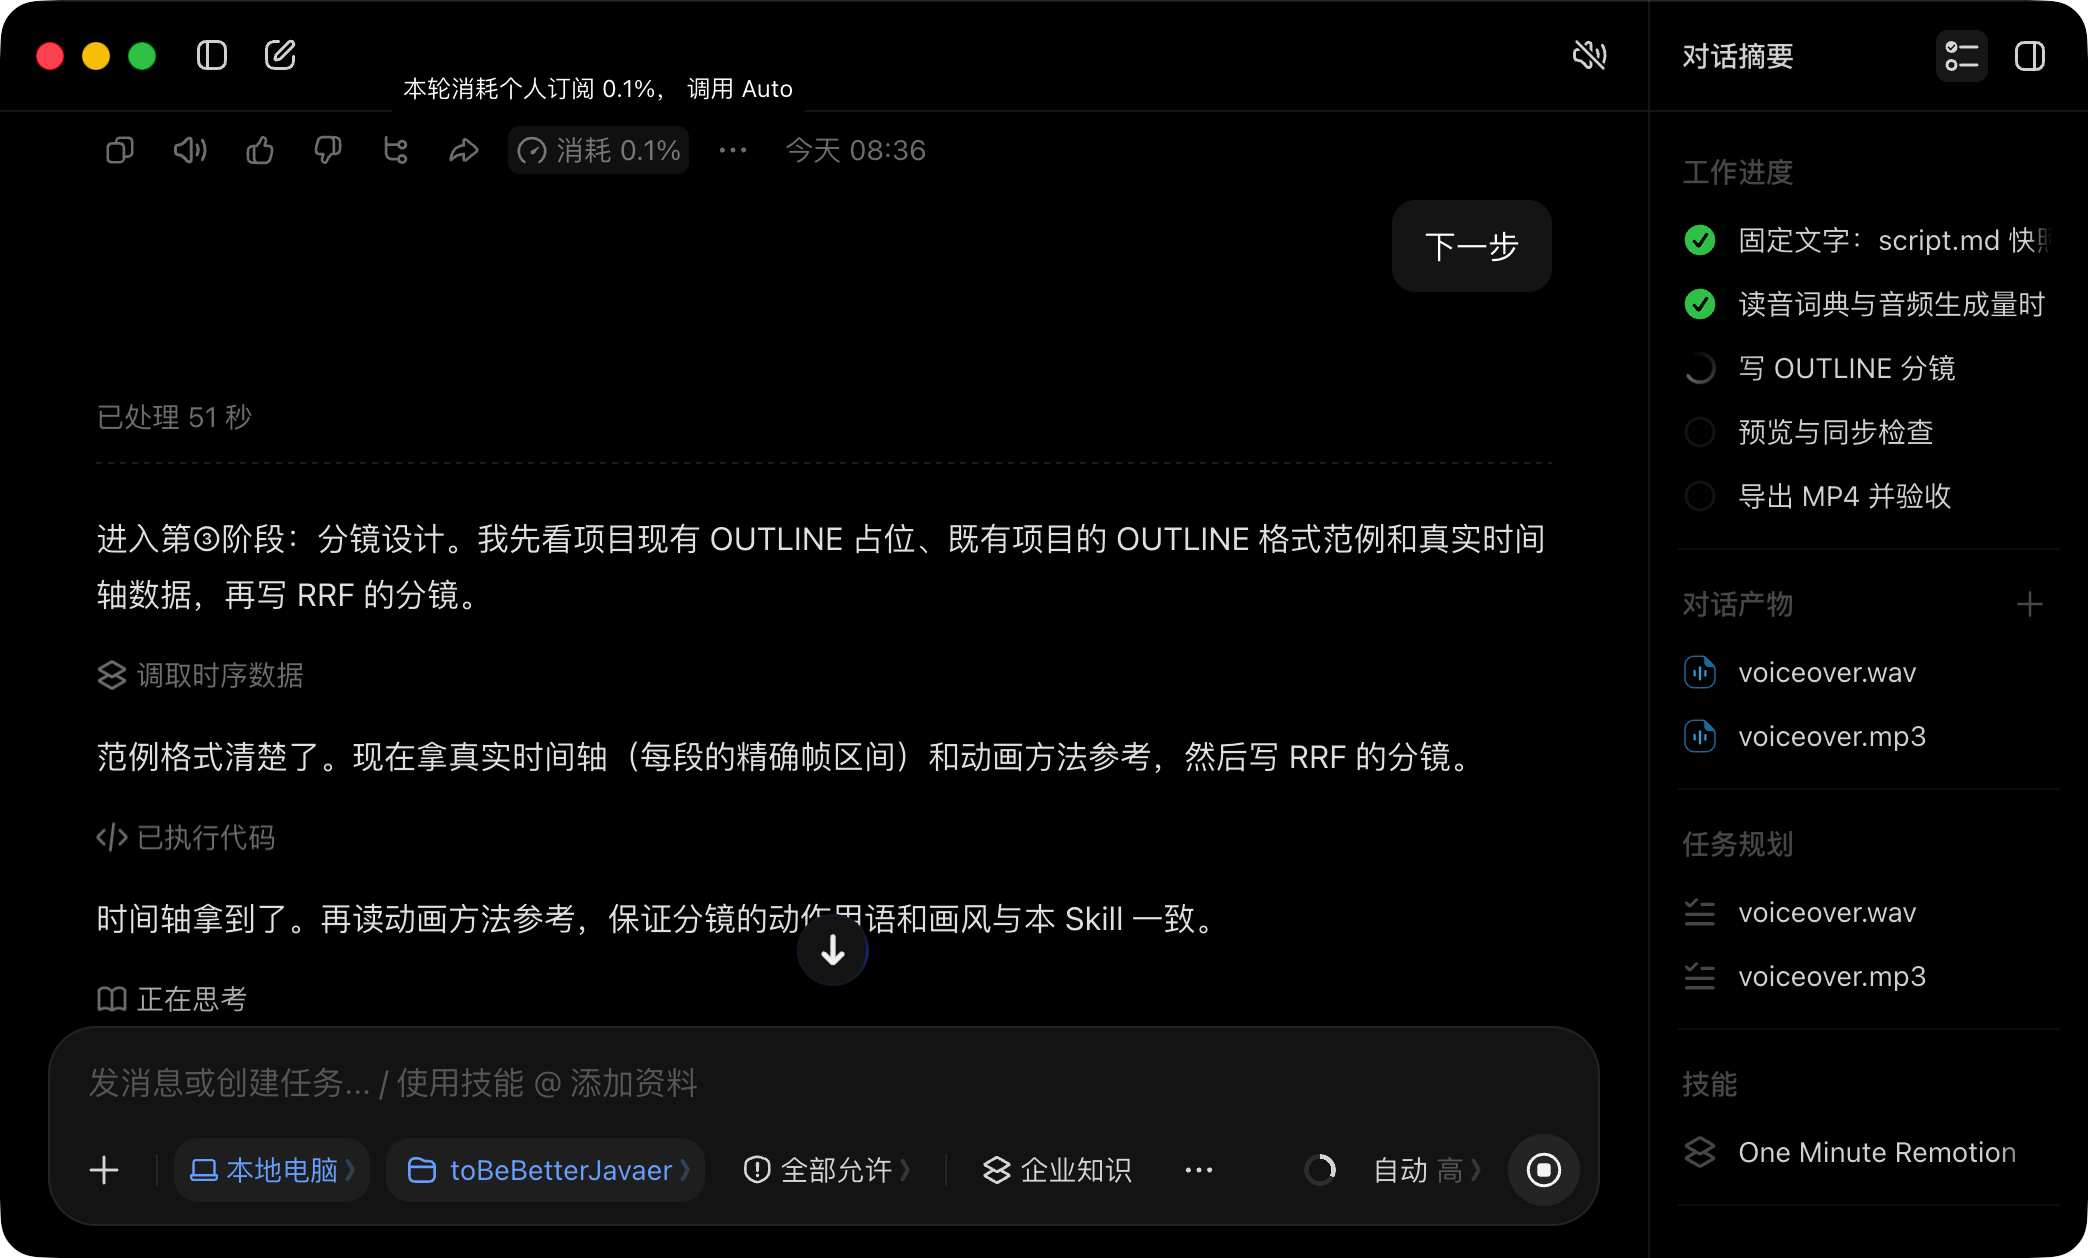
分镜的主要工作是根据脚本和实测音频的 1984 帧时间轴,把画面主体、连续动作和镜头设定好,生成 OUTLINE.md 分镜文档。
豆包工作把整条视频划分为开场问题、原始分数尺度对比、RRF 定义、倒数计分公式、示例排名、文档 A 得分、文档 B 与 C 得分以及最终结果边界共 8 个叙事单元,沿用暖米色底板搭配铁锈橙、蓝色与深色正文,让文档 A、B、C 的代表颜色和排名换位动画逐帧对应,同时标明教学示例排名,避免被误认为真实模型输出。
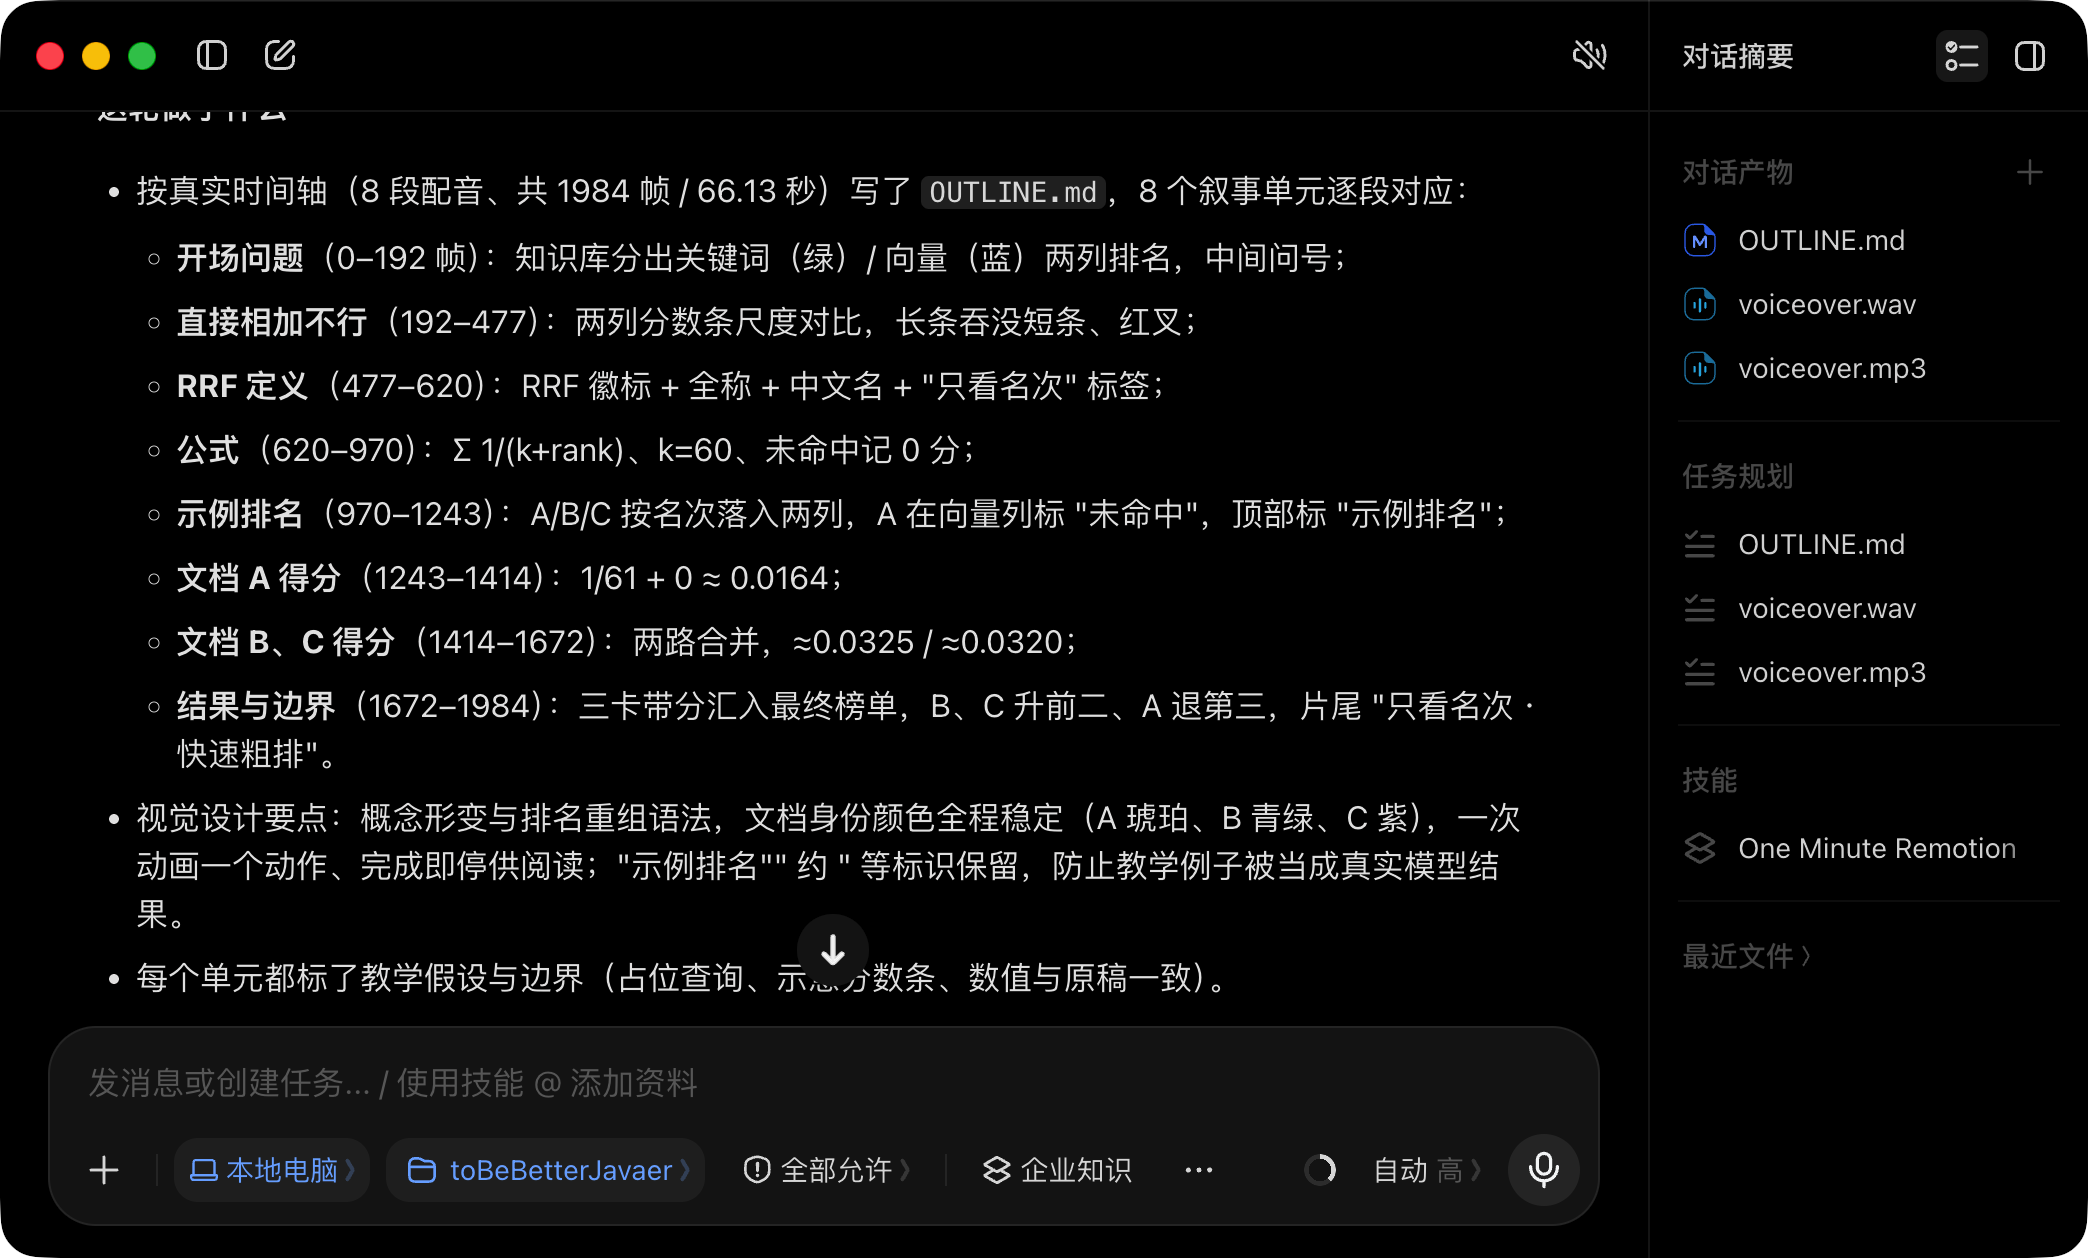
确认分镜没问题,再点“下一步”进入 Remotion 动画编码与字幕制作。
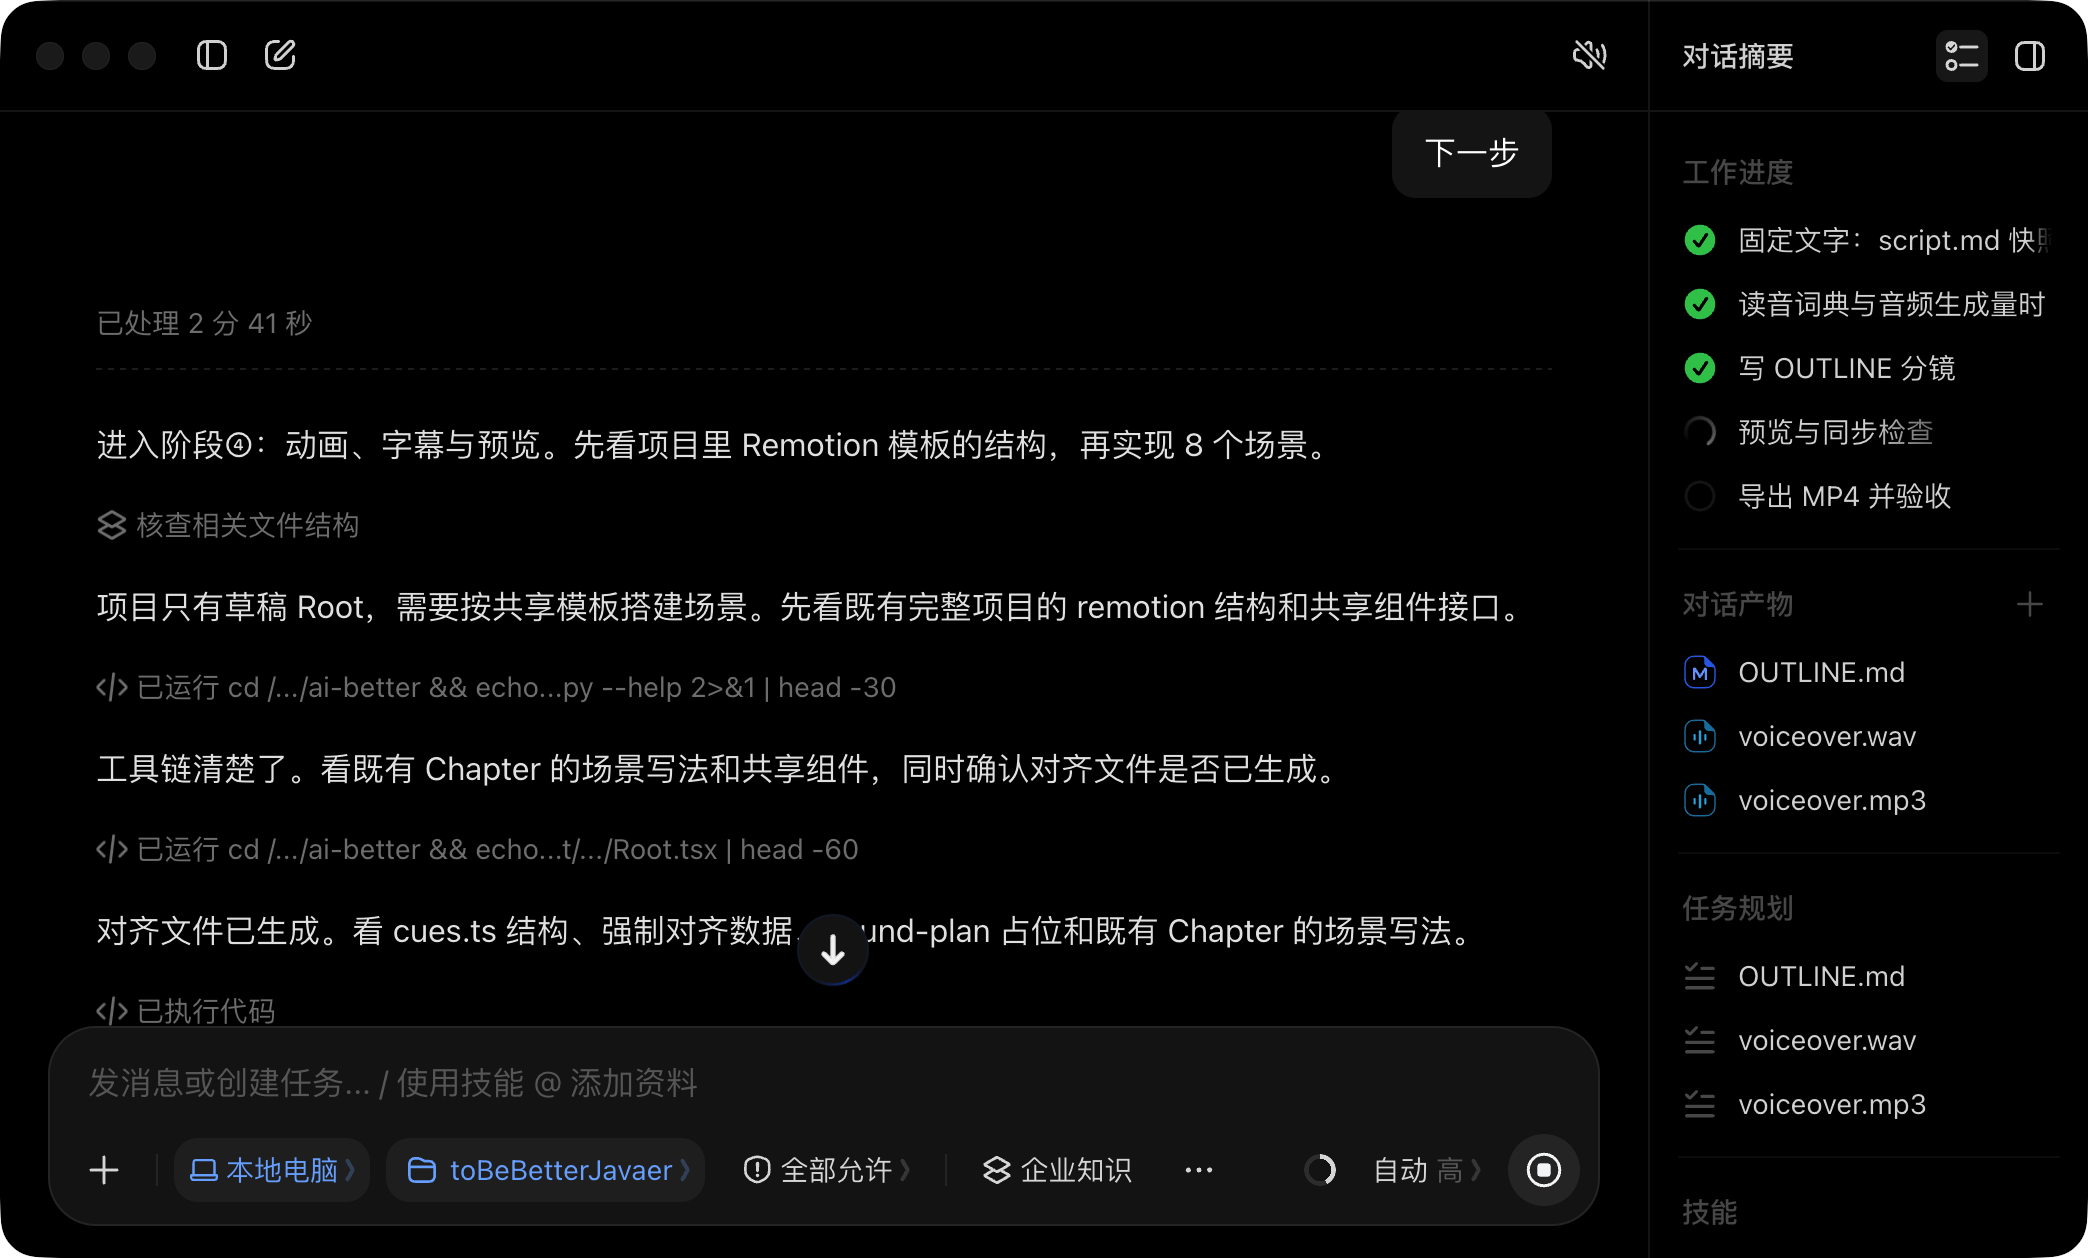
制作完成后,我让豆包工作启动 Remotion Studio 打开预览画面。
它在检查 3210 端口时发现服务曾随管道退出,自己排查后台日志后改成重定向输出重新启动,确保预览服务持续运行。
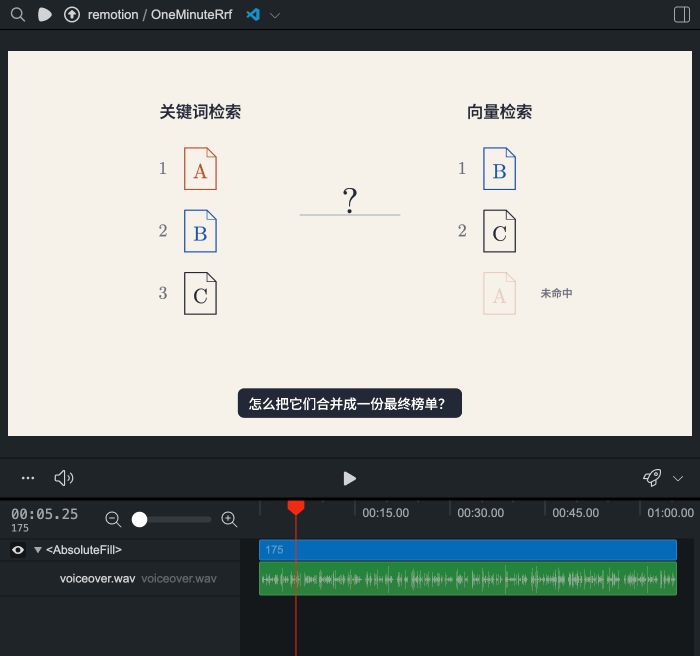
我录了个屏,大家看一下效果,感觉还是非常丝滑的。
【录屏】
ending
有了这套工作流,我讲课的整体大纲和细节都能兼顾到。到了课堂上,我甚至可以把制作 One Minute Remotion 技能和生成视频的过程直接展示给同学们,真正做到授人以渔。
对于以后的工作来说,纯手写代码的开发任务会越来越少,因为相当一部分执行工作都交给 AI 了。
如何利用好你手头的工具,比如豆包工作,把自己的经验固化成顺手的 Skill,让它帮你提升学习效率和工作效率,把它变成最趁手的工具,反而是更重要的。
如果讲课的过程中,我又产生了新的想法,或者新的工作流,我也会第一时间同步给大家,反正有了 AI,人的能力边界确实会无限大。
比如说这次准备的 PPT、飞书排课表、科普视频,放在以前,得花好几天准备,现在基本上就是几分钟,几十分钟就搞定了。
就看你学习能力和创新能力。
这里提醒一下,网页搜索「豆包工作」下载电脑端,限时领取 30 天会员权益。
https://www.doubao.com/work
我们下期见。