
31岁罗福莉,晋升小米最高职级22级
大家好,我是二哥呀。
看到一则消息,蛮感慨的,小米 MiMo 大模型团队的负责人罗福莉晋升到 22 级。据说,22 级是小米职级体系里的最高一级。
公开的资料显示,罗福莉毕业后去了阿里达摩院(我也是那时候加的她微信),主导跨语言预训练模型 VECO。2022 年她加入幻方量化,后来到 DeepSeek 参与了 DeepSeek-V2 的研发。2025 年 11 月,她在朋友圈官宣加入小米 MiMo。
从官宣到这次晋升,不到 11 个月。
可能很多小伙伴想知道这 11 个月里 MiMo 做出了什么。
于是我把 MiMo 从 2025 年 4 月到现在的技术报告、arXiv 论文、GitHub 仓库都翻了一遍。
模型从 7B 的推理模型做到了万亿参数,9 月 22 日开源的 MiMo-V2.6-Pro 在第三方评测机构 Artificial Analysis 的智能指数上拿了开源权重第一。并且这一版的 RL 训练是公开直播的,另外 MiMo-V3 会换上 HySparse2 架构。
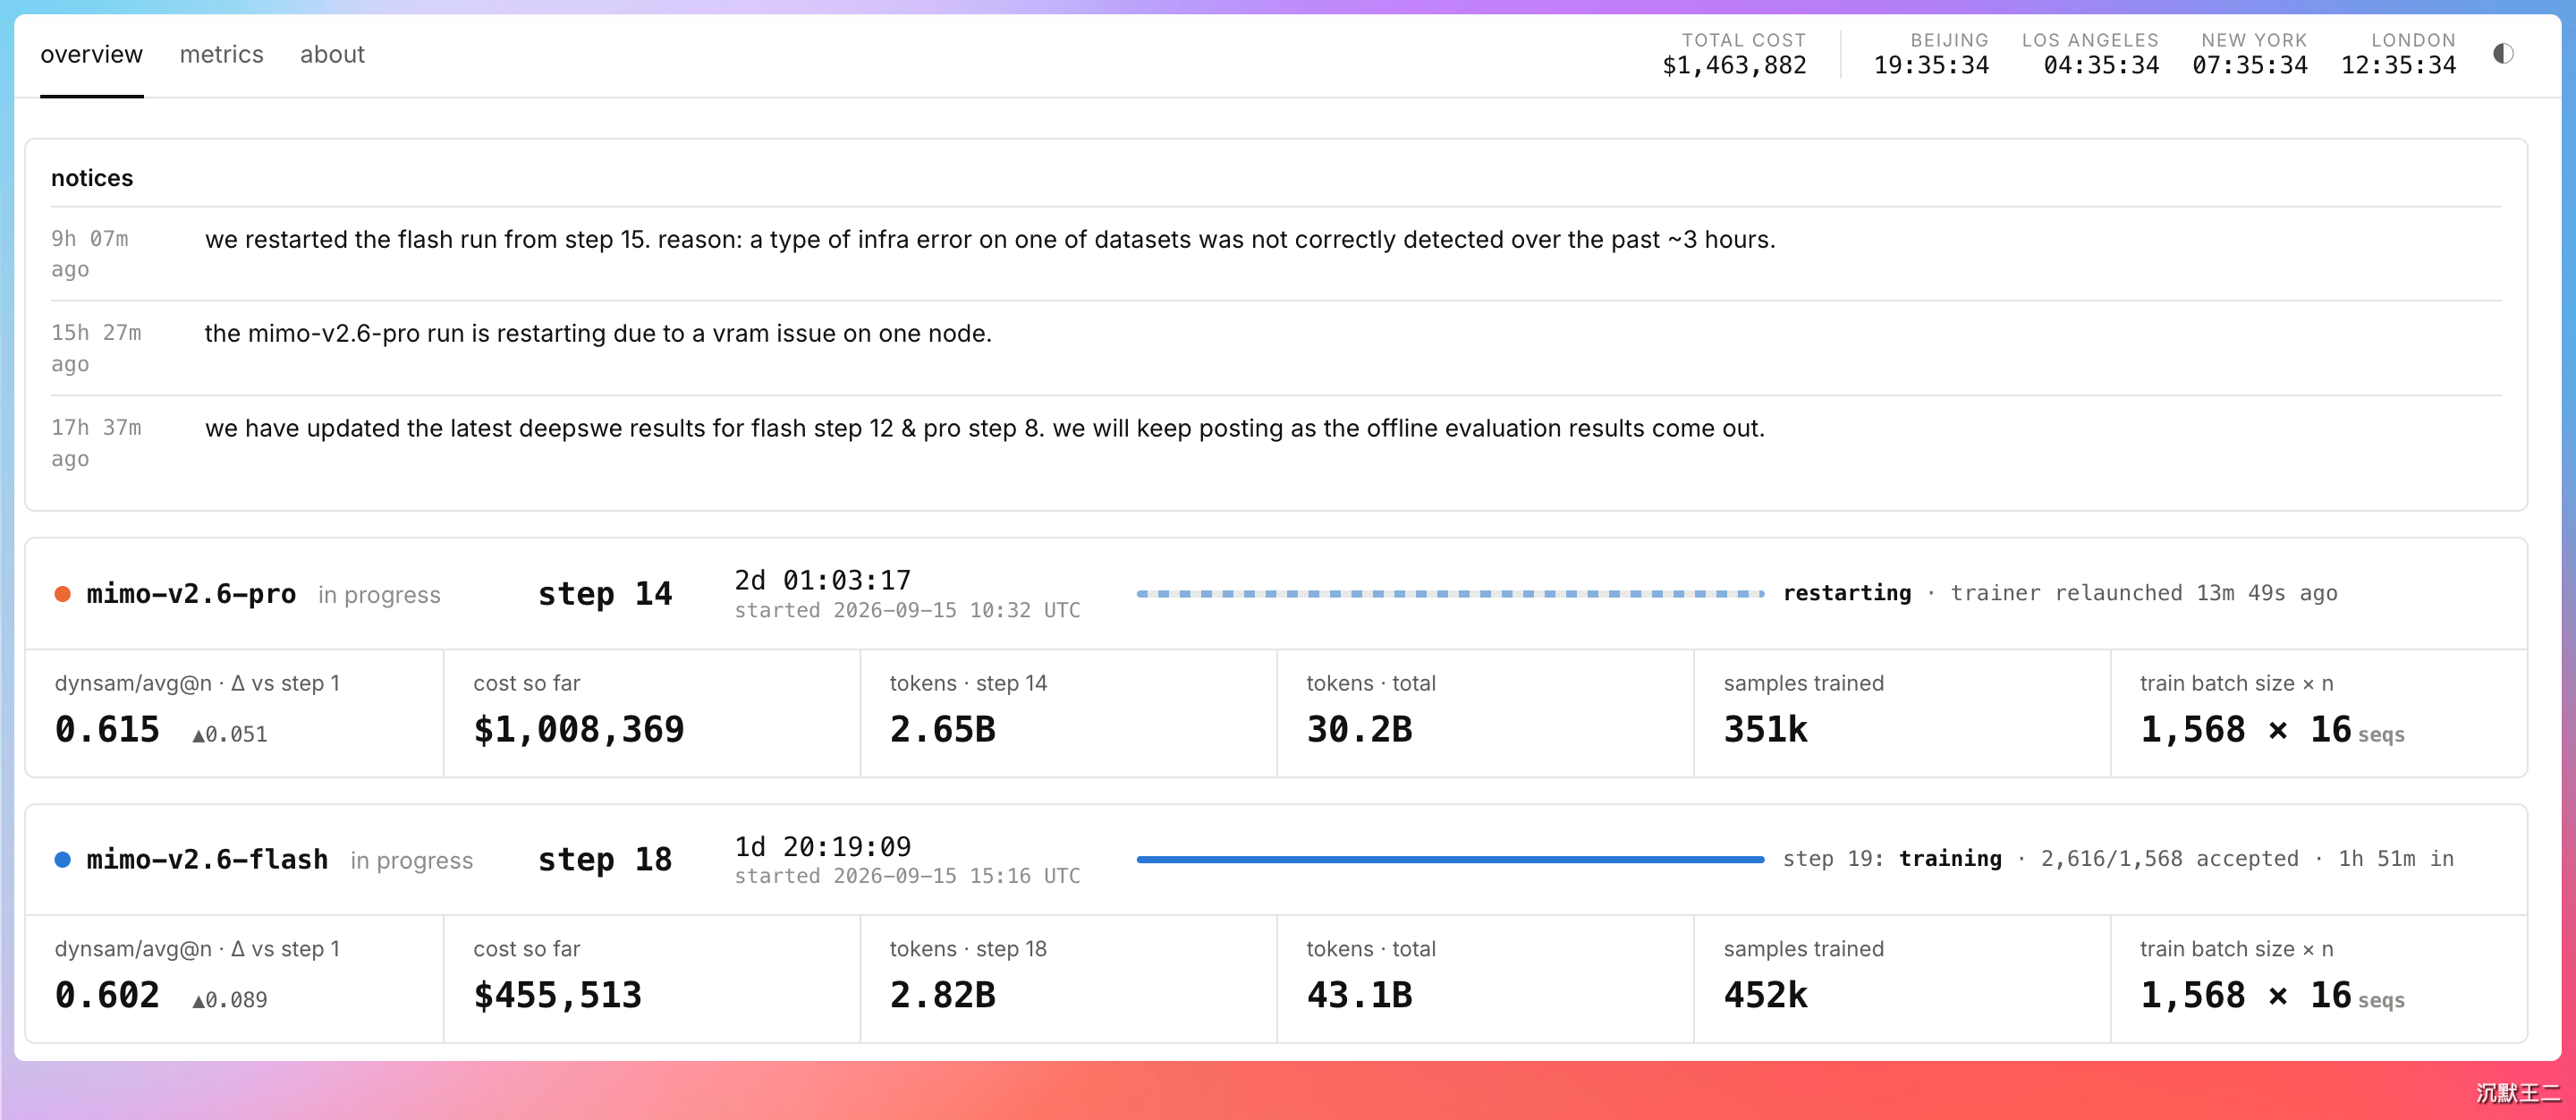
模型之外,小米还做了开源的终端编程 Agent MiMo Code 和桌面客户端 MiMo Desktop。
我之前做过两期视频,一期讲 MiMo 的 RL 训练,一期讲 HySparse2,播放量还挺高。接下来,我会帮大家梳理一下,一支国内大模型团队这一年是怎么把模型、训练、架构和产品一件件做出来的,应该会对你很有帮助。
(如有错误,都怪GPT-6.1 Sol,哈哈,都怪他调研不准确)
01、从 7B 开始
MiMo 的第一个模型是 2025 年 4 月底开源的 MiMo-7B,70 亿参数的稠密模型,MIT 协议。
技术报告(arXiv 2505.07608)里有写,预训练用了约 25T token,模型里还加了多 token 预测(Multi-Token Prediction,MTP)模块,让模型一次预测后面好几个 token。
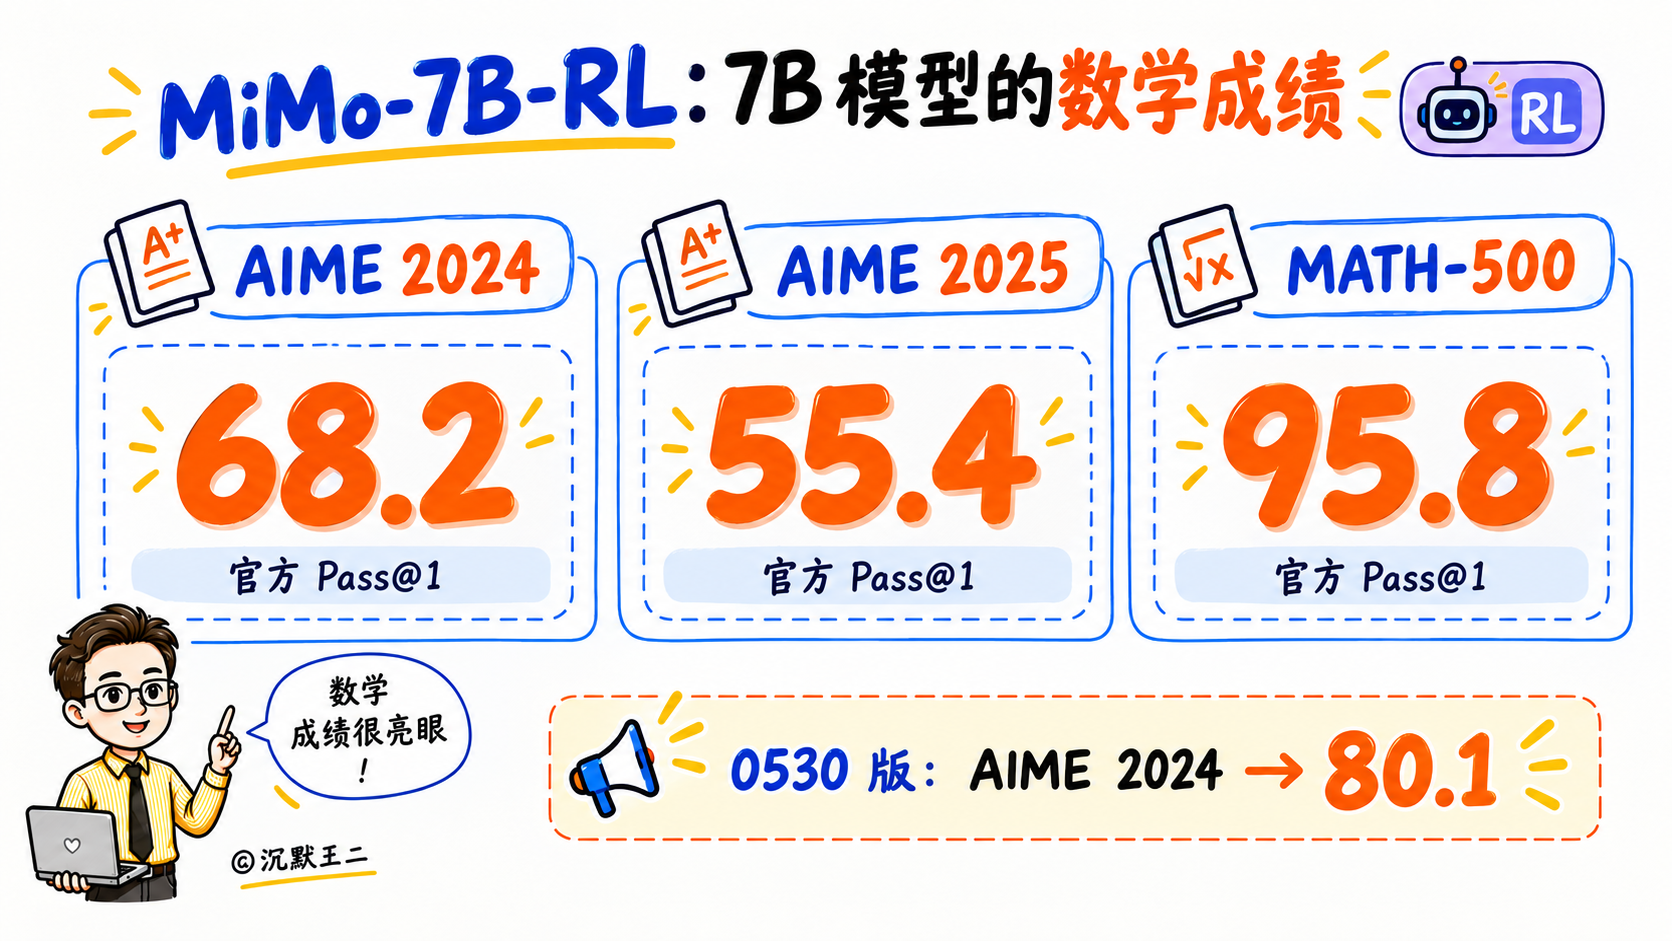
经过 RL 训练的 MiMo-7B-RL,在美国数学邀请赛 AIME 2024 的题目上拿到 68.2 分,AIME 2025 拿到 55.4 分,数学题集 MATH-500 拿到 95.8 分。5 月 30 日更新的 0530 版本,AIME 2024 提高到了 80.1 分。
接下来半年,团队在 7B 尺寸上延伸了多模态。5 月 30 日开源视觉语言模型 MiMo-VL-7B,9 月 18 日开源 MiMo-Audio-7B,预训练用了超过 1 亿小时的音频数据。11 月 19 日,又发布了同时面向自动驾驶和具身智能的 MiMo-Embodied-7B。
MiMo 模型第一次做到几百 B 的规模,是 2025 年 12 月的 V2-Flash。
02、V2-Flash 定下骨架
2025 年 12 月 16 日,小米开源了 MiMo-V2-Flash。第二天,罗福莉在小米人车家全生态合作伙伴大会上做了演讲,这是她第一次以 MiMo 负责人的身份公开亮相。
V2-Flash 是一个混合专家(Mixture of Experts,MoE)模型,总参数 309B,每处理一个 token 只激活其中 15B。上下文 256K,预训练用了 27T token。在修复真实 GitHub issue 的编程评测 SWE-Bench Verified 上,它拿到了 73.4,AIME 2025 是 94.1。
这一版最值得看的是注意力的排布。
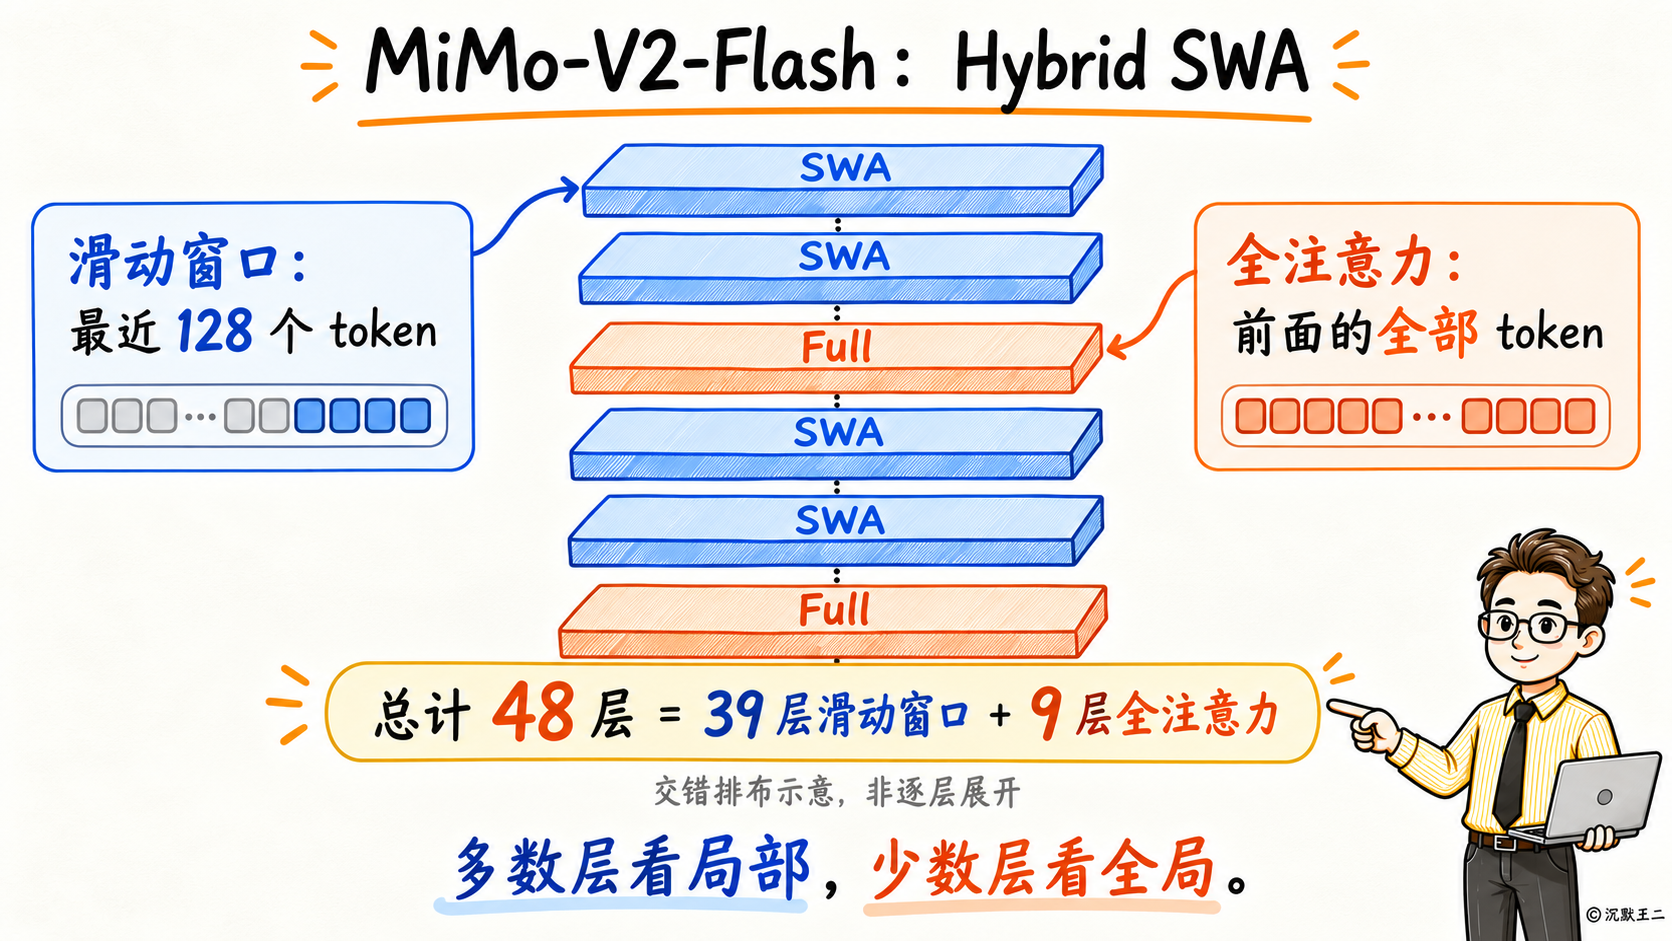
模型一共 48 层,其中 39 层是滑动窗口注意力(Sliding Window Attention,SWA),每个 token 只看自己前面最近的 128 个 token。剩下 9 层是全注意力,每个 token 要把前面所有内容看一遍。小米把这种排布称作混合滑动窗口注意力(Hybrid SWA)。
全注意力看得全,但上下文越长,计算就越慢,KV Cache 占的显存也越多。滑动窗口只看一小段,又快又省。大部分层用滑窗、少数几层看全局,是在速度和效果之间取的折中。
这套结构后来一直用到了 V2.6。
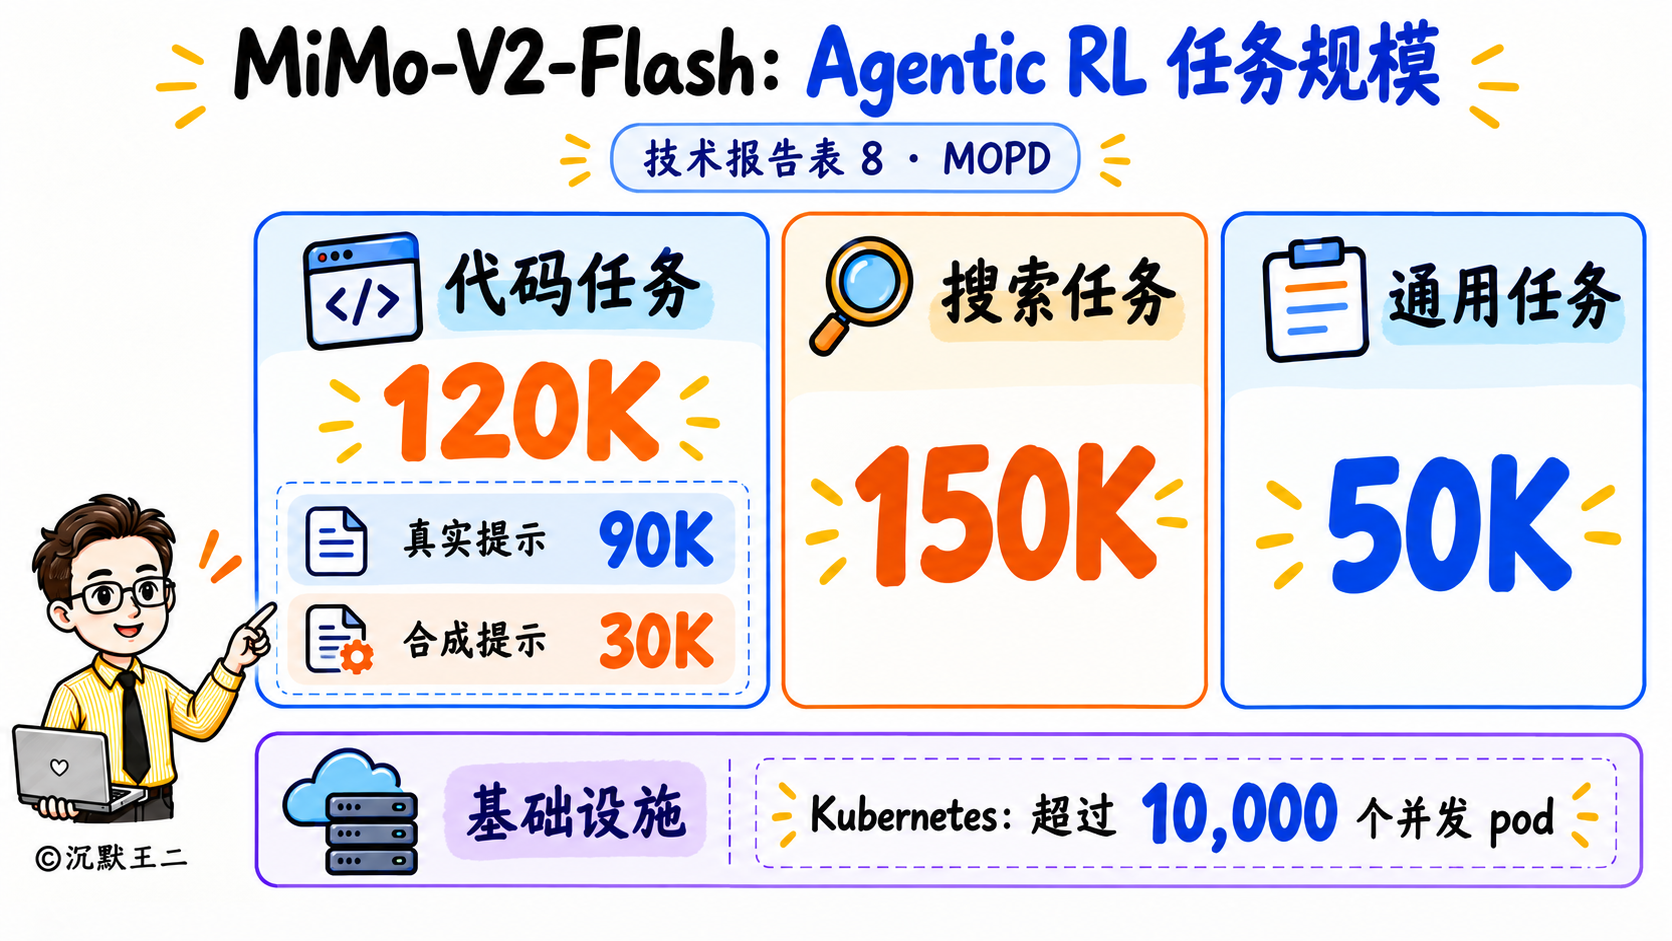
训练方法上,V2-Flash 用的是多教师在线策略蒸馏(Multi-Teacher On-Policy Distillation,MOPD)。做法分三步,先做监督微调(SFT),再为代码、搜索等不同领域分别训练教师模型,最后让学生模型自己生成回答,由教师模型在每个 token 上打分,作为学生的奖励。学生学的是自己生成的内容,一个模型就能把几个领域教师的本事学到手。
Agent 能力要靠 RL 环境来训练。真实环境里的代码 Agent 任务有 9 万个,搜索任务 15 万个,通用任务 5 万个。代码任务总数超过 10 万个,跑在 Kubernetes 上,同时运行的 pod(Kubernetes 里最小的运行单元)超过 1 万个,环境搭建成功率 70%,覆盖 8 种编程语言。
03、V2-Pro 到 V2.5
2026 年 3 月 19 日,小米发布了 MiMo-V2-Pro、MiMo-V2-Omni 和 MiMo-V2-TTS 三个模型。
V2-Pro 总参数超过 1T,激活 42B,总参数是 V2-Flash 的三倍多。发布之前,它用 Hunter Alpha 这个代号匿名挂在模型 API 聚合平台 OpenRouter 上,全模态的 Omni 用的代号是 Healer Alpha。
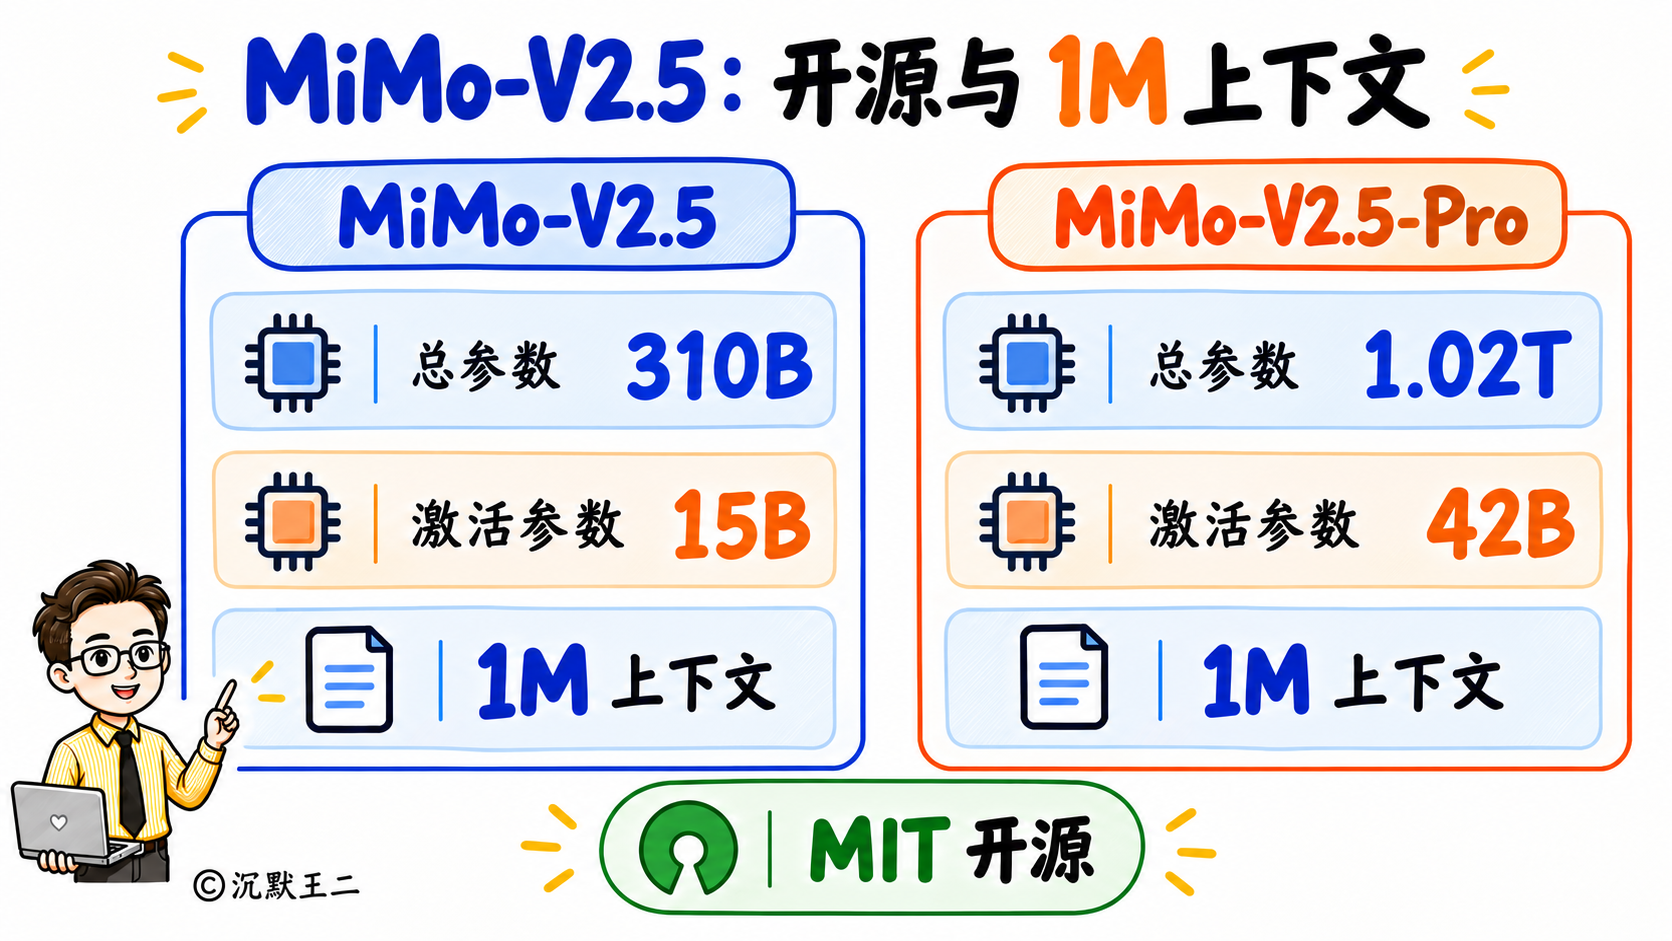
4 月 23 日 MiMo-V2.5 开始公测,4 月 28 日开源,还是 MIT 协议。
V2.5 总参数 310B、激活 15B,是原生全模态模型。
V2.5-Pro 总参数 1.02T、激活 42B,一共 70 层,60 层滑窗、10 层全注意力。两个模型的上下文都做到了 1M。
V2.5-Pro 在 SWE-bench Pro 上拿到了 57.2。Artificial Analysis 在它发布时给了 54 分,和 Kimi K2.6 并列开源模型第一。
从 V2-Flash 到 V2.5-Pro,四个多月,参数从 309B 做到了 1T 以上,上下文从 256K 做到了 1M。然后 MiMo 安静了将近半年。
04、V2.6 的 RL
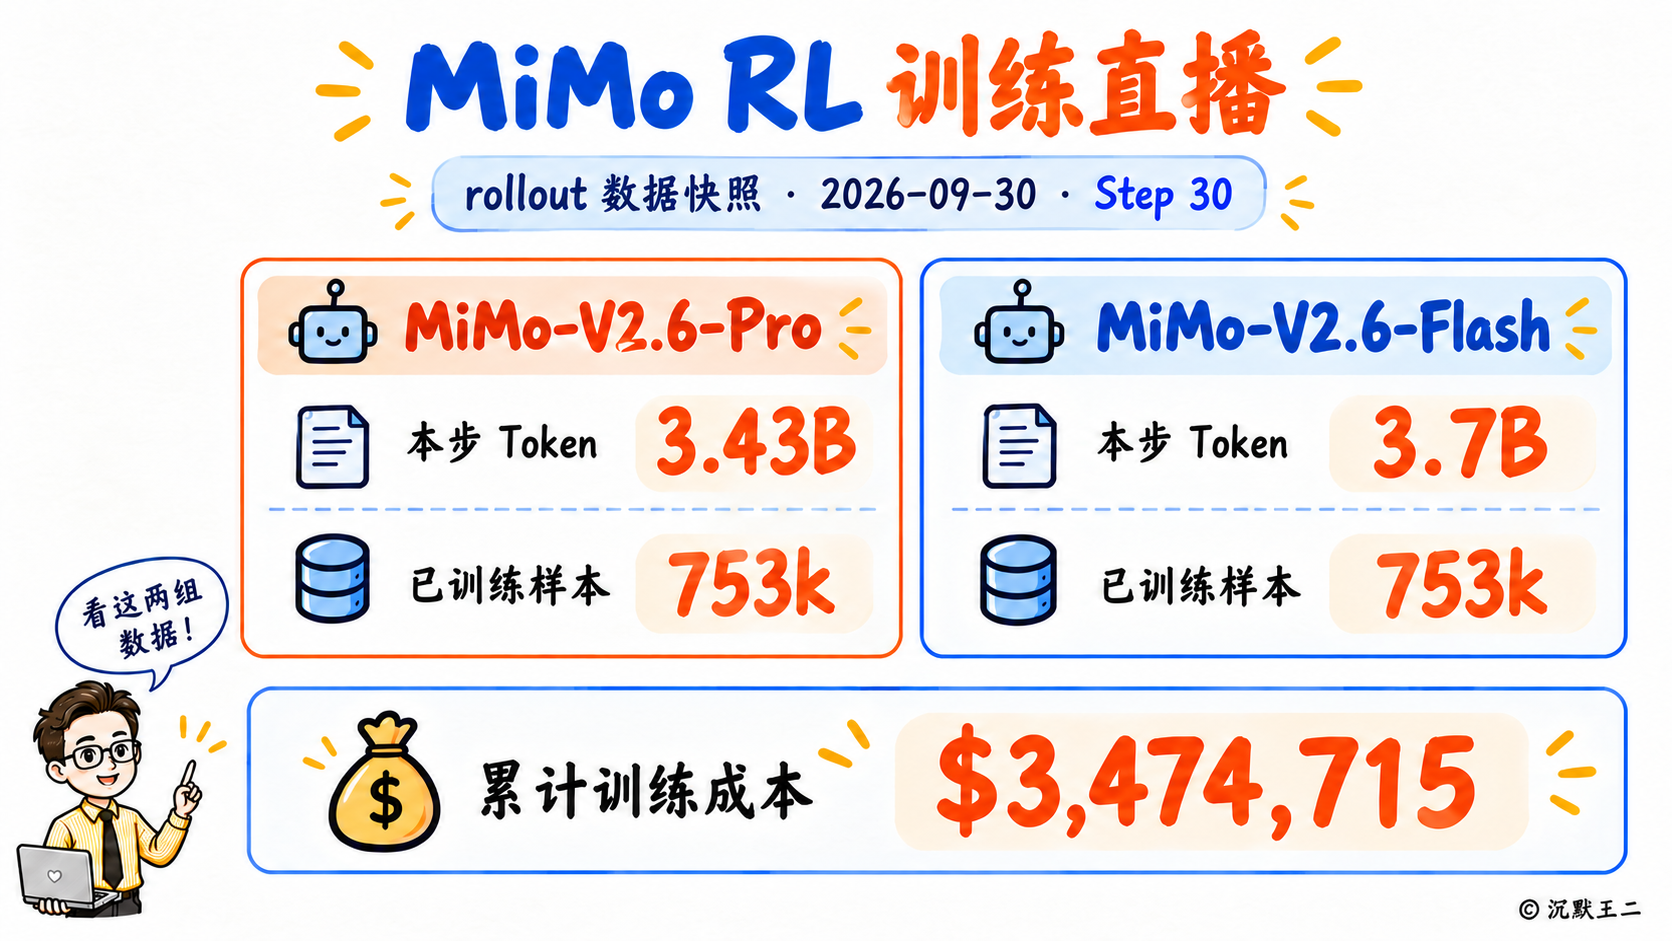
这半年在做什么,罗福莉 9 月 17 日发文说,团队在研究强化学习(Reinforcement Learning,RL)到底能扩展到多远,还把 V2.6 的 RL 训练做成了直播,训练面板放在 mimo.xiaomi.com/rl 上。
9 月 22 日 V2.6 发布,直播面板上,Pro 和 Flash 各训练了 75.3 万个样本。
这里需要讲两件事。
第一件是多任务混合。一次 RL 训练里同时混进多个 Harness 的任务,模型在同一轮训练里,既要在编程 Agent 的环境里改代码,也要在其他 Agent 环境里完成任务。
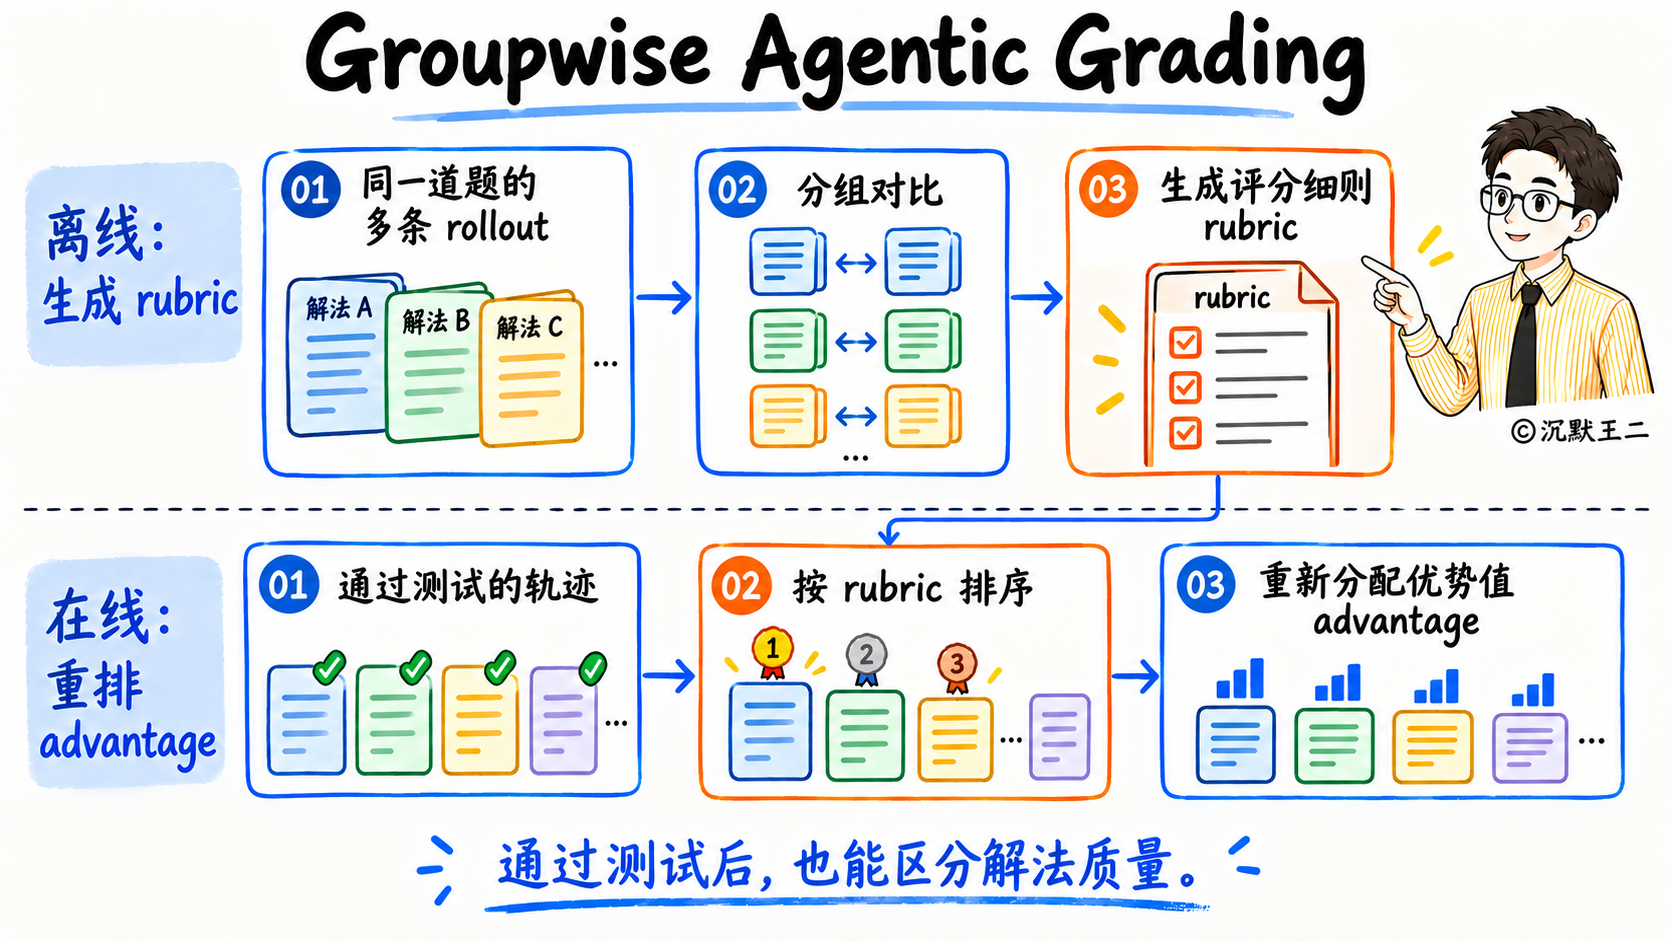
第二件是奖励怎么给。V2.6 的奖励同时看测试用例和评分细则(rubric)。
只用测试用例的话,所有通过的解法拿到的奖励都一样,写得好的和勉强凑合的分不出来。
小米的办法是分组 Agent 评分(Groupwise Agentic Grading)。离线阶段,把同一道题的多条 rollout 放在一起对比,自动生成评分细则。在线阶段,对通过测试的轨迹排序,重新分配优势值(advantage),也就是每条轨迹比同组平均水平好多少。
通用 Agent 任务则拆成一条条原子化的二元评分项,每一项只判断是或否。
不同的任务,V2.6 分开来练。
代码这类能自动验证、难度适中的任务,放在一起做混合 RL(MixRL)。难以验证的任务、步数特别长的任务,还有游戏、3D 这类,单独训练,最后用 MOPD 合并到一个模型里。
整套训练叫“You Only RL Once”,训练时冻结 MoE 的路由器,也就是决定每个 token 交给哪几个专家处理的模块。
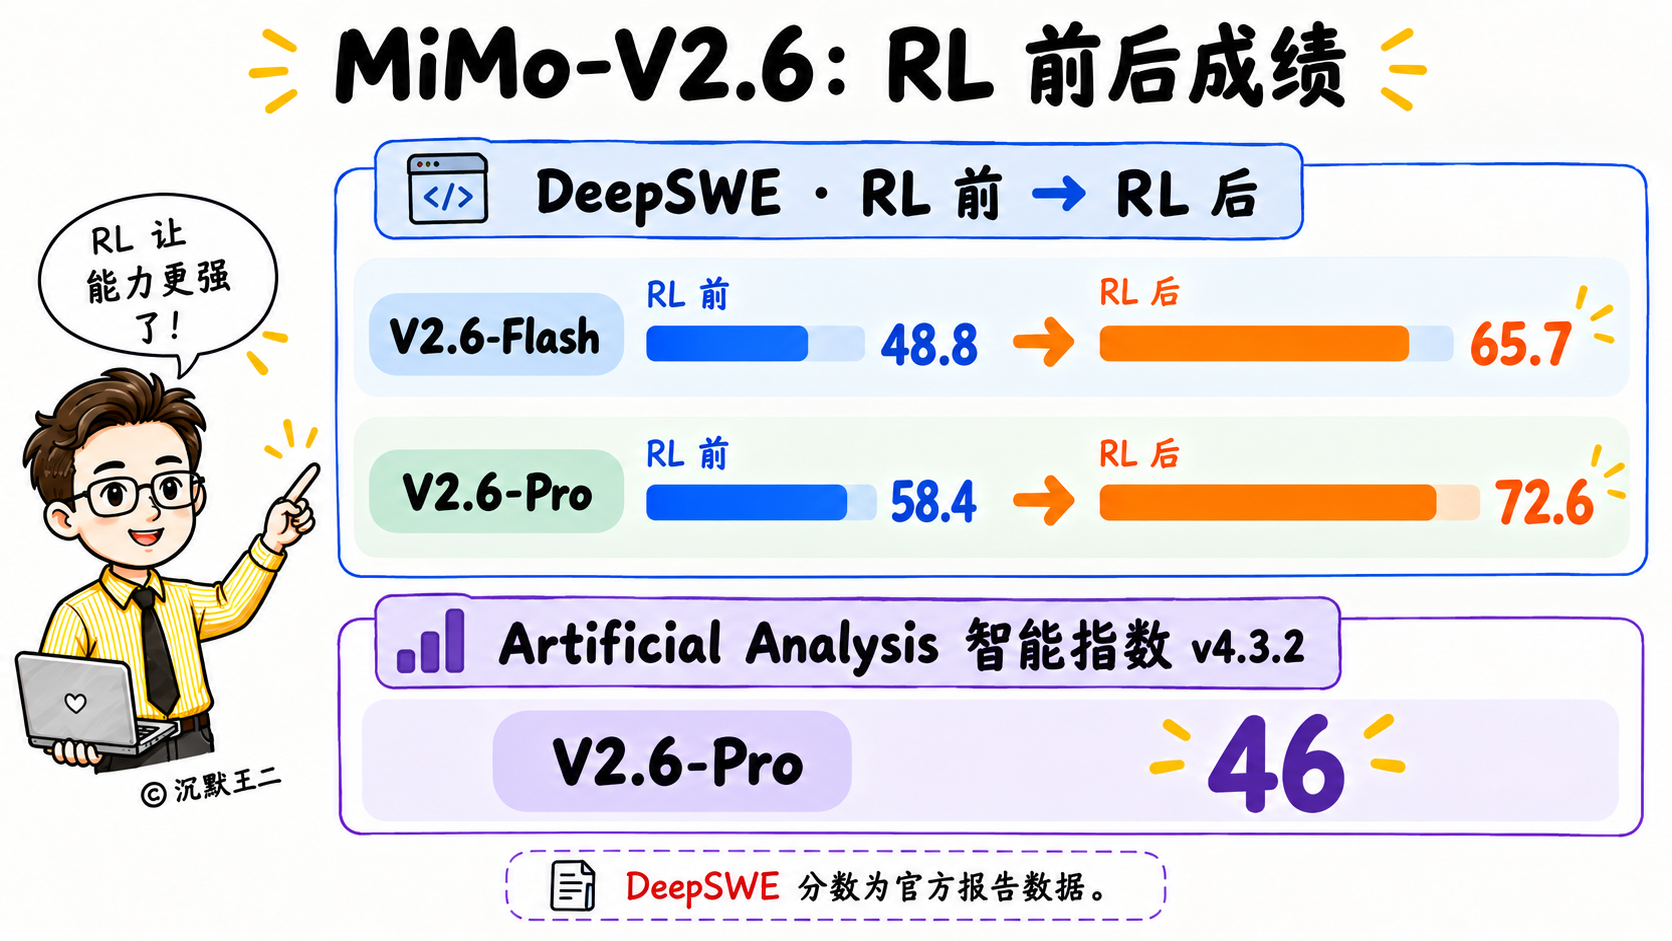
RL 前后的差距很明显,编程 Agent 评测 DeepSWE 上 Flash 从 48.8 提到 65.7,Pro 从 58.4 提到 72.6。Artificial Analysis 智能指数 v4.3.2 给 V2.6-Pro 打了 46 分,是开源权重模型里的第一名。小米还开源了 7000 个 RL 环境,以及一个蒸馏到 Qwen 上的 9B 模型 MiMo-V2.6-Distill-Qwen-9B。
9 月 27 日,小米又补发了 Pro-MOPD 和 Flash-MOPD 两个版本,用来缓解工具调用重复的问题。
05、HySparse2
9 月 23 日,罗福莉发文说 MiMo-V3 会换上一套新架构,核心组件是当天发布的 HySparse2。
为什么要换?
Agent 场景里模型的动作很快,但换回来的观察结果很长。模型输出一行命令,工具可能返回几百行日志,这几百行日志都要先读进去。
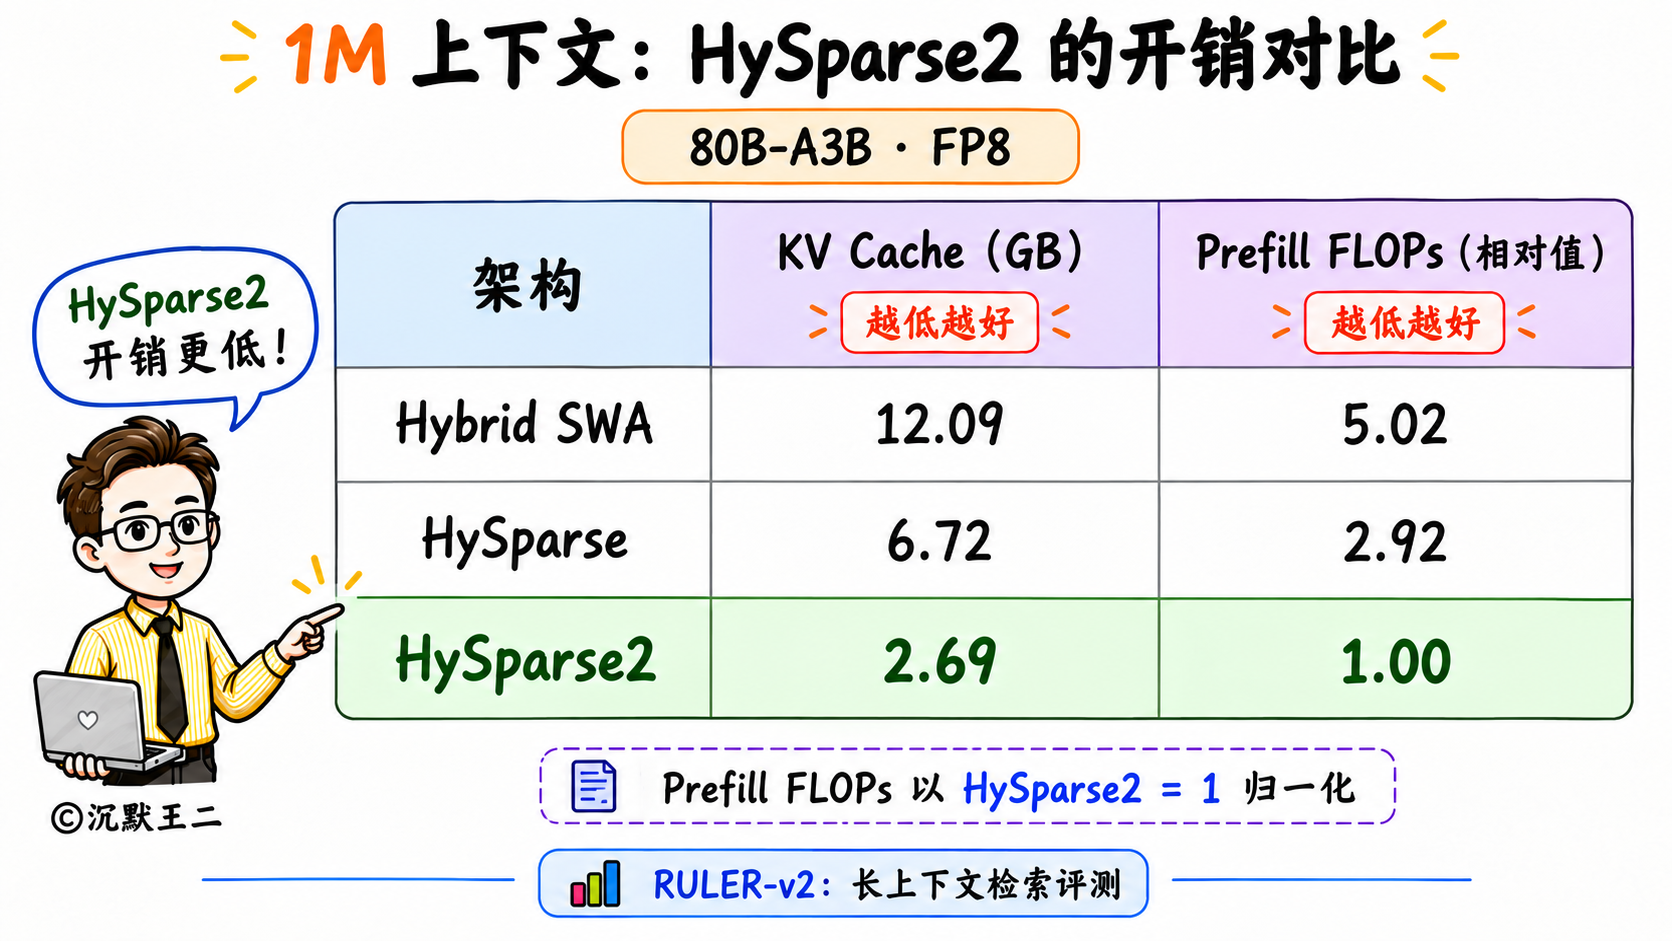
读进去这一步叫 Prefill(预填充),模型把输入从头读一遍,给每一层建好 KV Cache。KV Cache 存的是每个 token 在每一层算出来的 K 和 V,后面每生成一个 token 都要回头查它。
输入越长,Prefill 越慢,KV Cache 越占显存。
上一代的 HySparse(arXiv 2602.03560),名字取自混合稀疏注意力(Hybrid Sparse Attention)。在 80B 的 MoE 模型上,49 层里只保留 5 层全注意力,KV Cache 减少了接近 10 倍。稀疏注意力除了看最近的一段,还会从整段上下文里挑出最重要的一批 token 来看。
HySparse2(arXiv 2609.26368,9 月 22 日提交)在这个基础上,把模型切成了前后两段。前半段叫 Self-Decoder,全注意力层和滑窗层混合,和 V2 系列差不多。后半段叫 Cross-Decoder,由一个个小模块组成,每个小模块是一层全注意力,后面跟几层稀疏注意力。
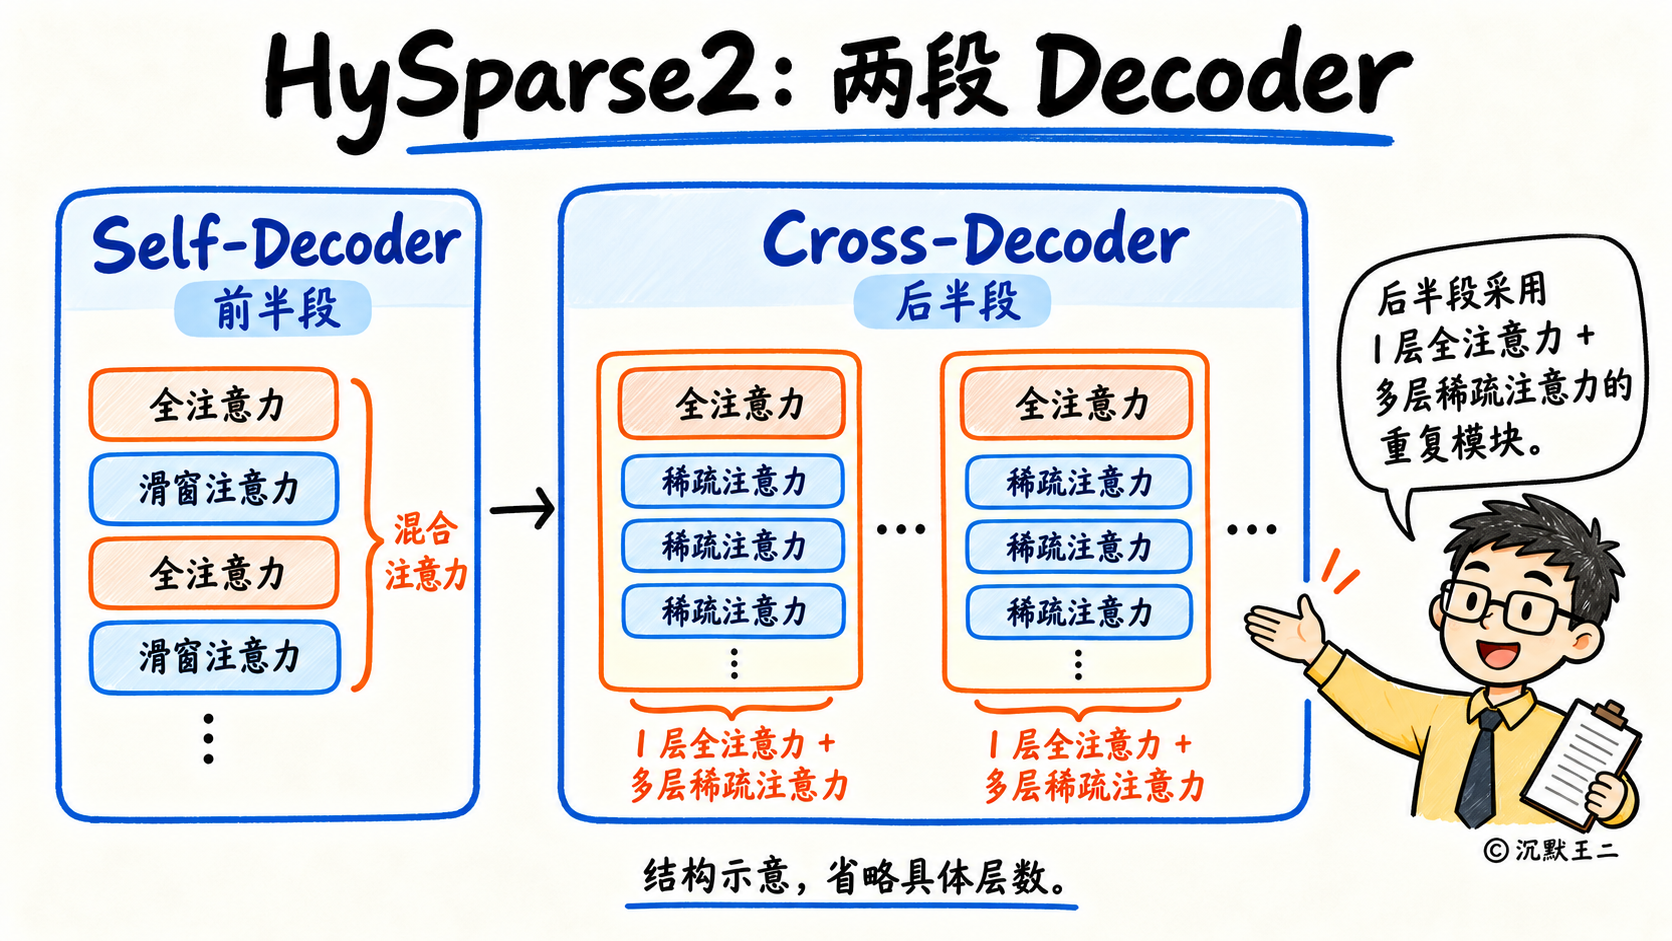
切成两段,是为了做两级 KV 共享。第一级在后半段的小模块内部,叫 KV Reuse,稀疏层直接复用本模块全注意力层的 KV Cache 和它挑出来的 token 名单,自己不存 KV Cache。
第二级跨越前后两段,叫 KV Bridging,后半段的全注意力层不用自己那一层的输入,而是拿前半段某一层的隐藏状态来计算 K 和 V。KV Bridging 的思路来自微软研究院和清华 2024 年提出的 YOCO(You Only Cache Once)。
两级共享合在一起,Prefill 跑完前半段就可以停。后半段的稀疏层不存 KV Cache,后半段全注意力层的 K 和 V 又都能从前半段算出来。工具返回的一大段日志进来,只要过完前半段,整个模型需要的 KV Cache 就齐了。
挑 token 的方式也改了。上一代以 64 个 token 为一块整块挑,HySparse2 改成逐个 token 挑。
上一代的稀疏层还外挂了一个单独的滑窗分支,这个分支要用后半段自己算出来的结果,Prefill 就得把后半段也跑一遍。HySparse2 取消了这个分支,改成挑选时强制保留最近的 128 个 token。
06、MiMo Code
小米自己也做了一个 Harness,就是 MiMo Code。
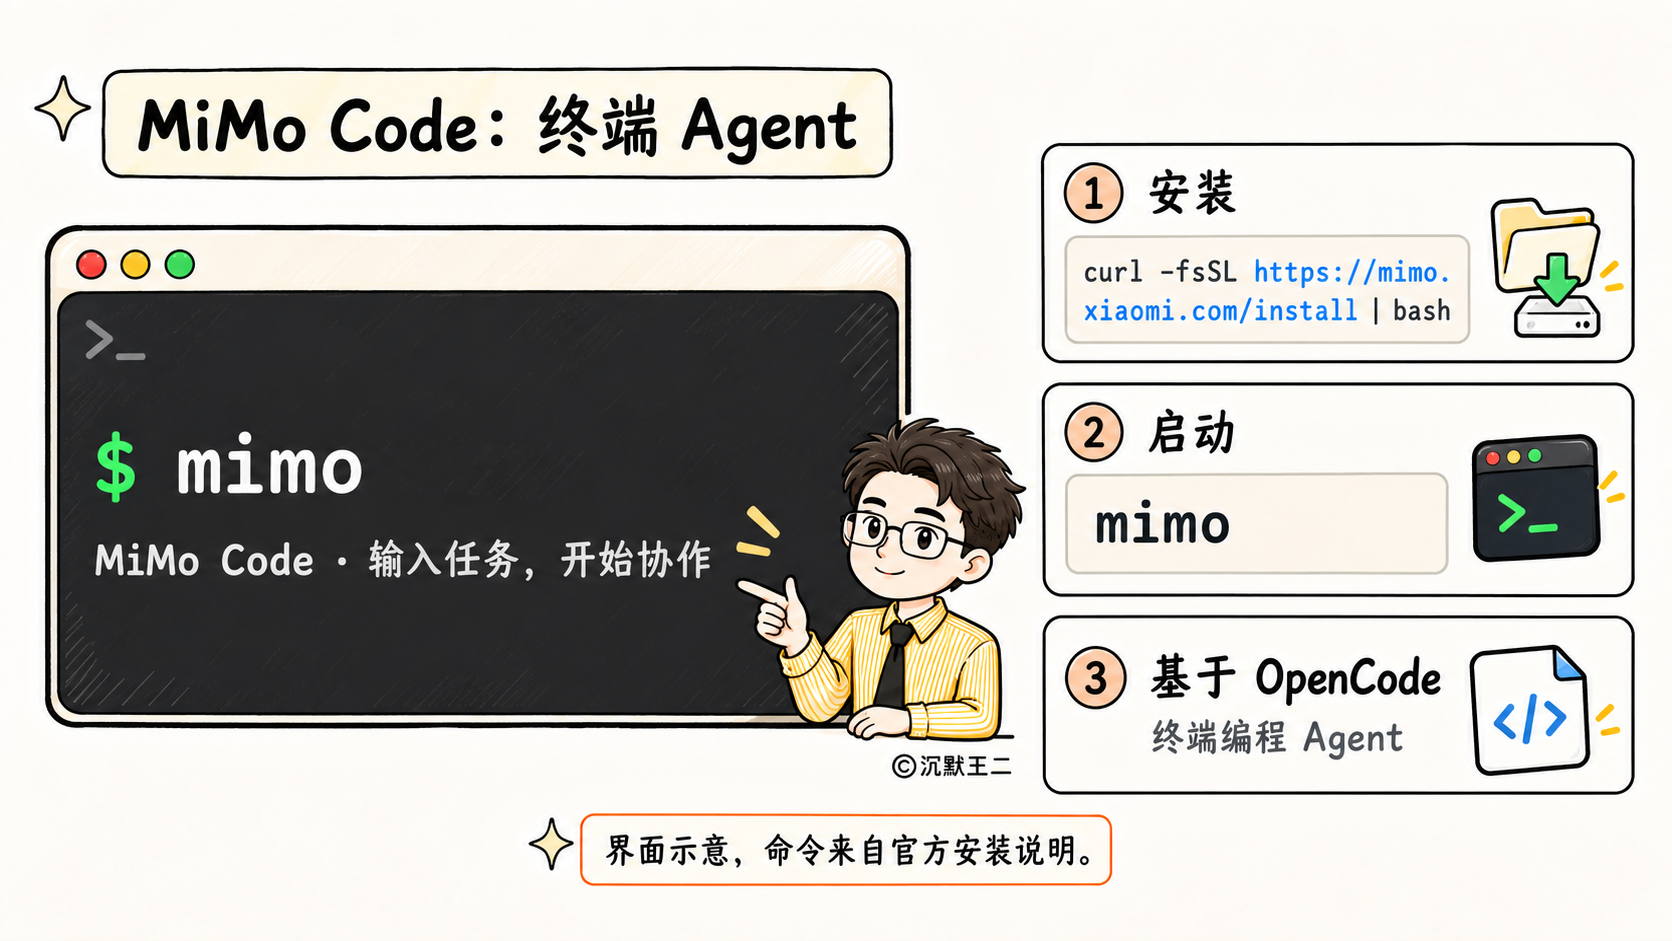
2026 年 6 月 10 日,MiMo Code V0.1 上线并开源,MIT 协议,一行 curl 命令就能安装。MiMo Code 是开源终端编程 Agent OpenCode 的 fork,多 Provider、终端界面(TUI)、语言服务协议(LSP)、MCP 这些能力都保留了下来。
MiMo Code 主打长程任务(long horizon),也就是任务跑到几十步、上百步之后还能不出错。
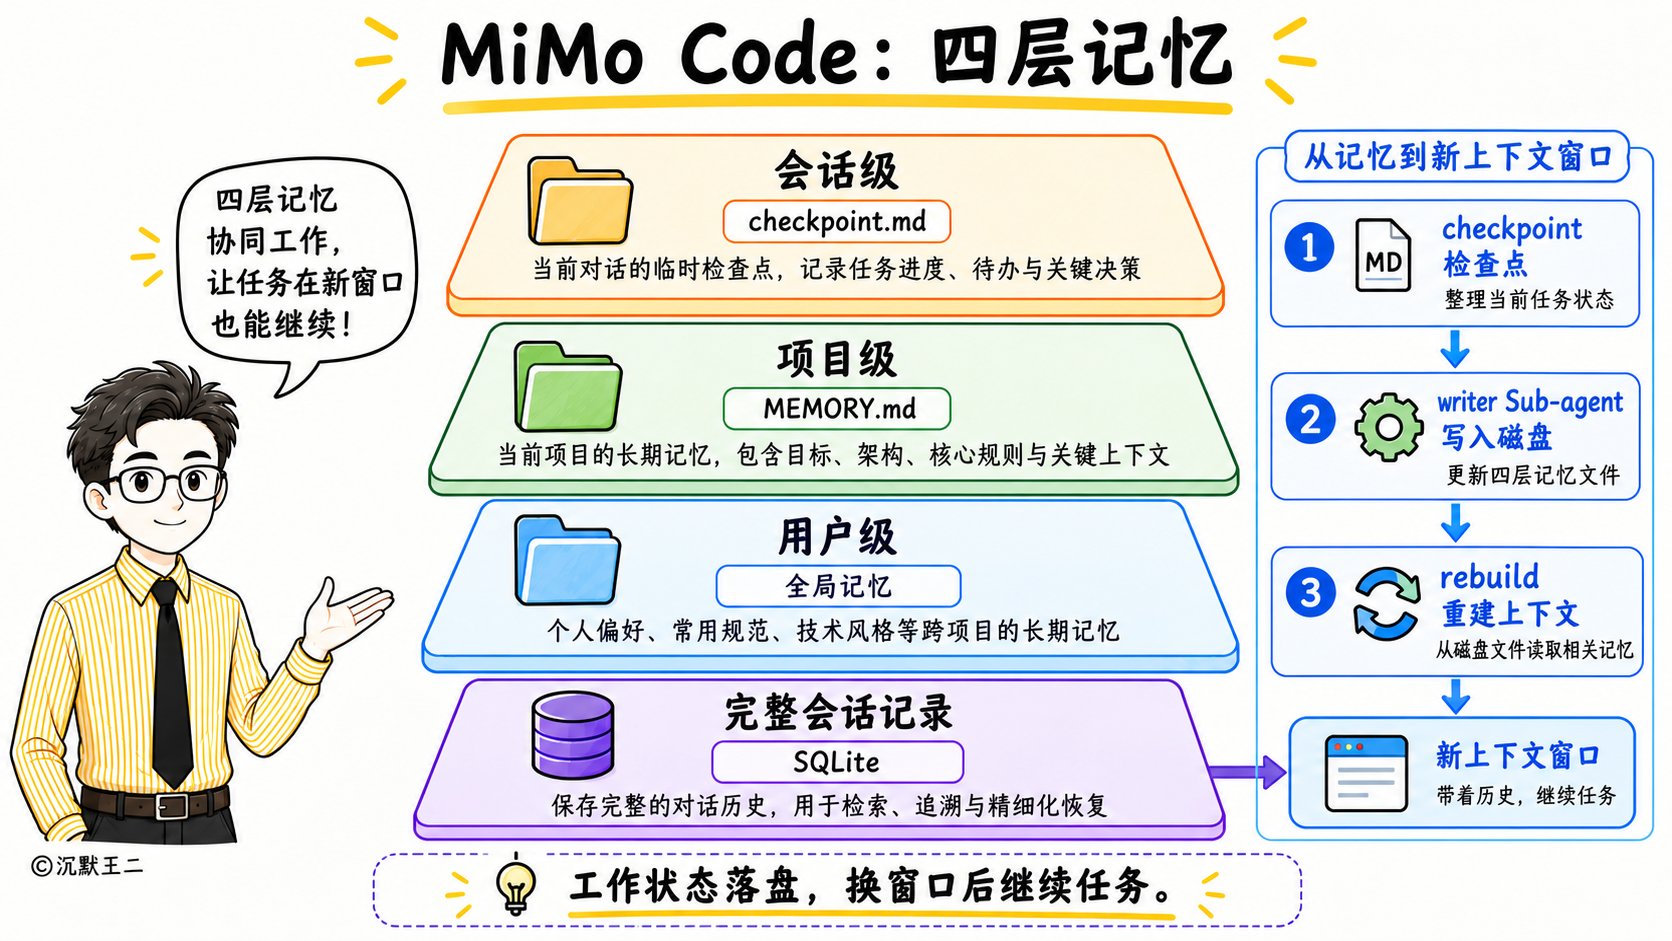
上下文这块,它在上下文预算用到约 20%、45%、70% 的时候各设一个检查点(checkpoint),派一个独立的 writer Sub-agent 把当前的工作状态写到磁盘上。上下文快满时执行一次 rebuild,开一个新窗口,用写好的文件重建上下文。
记忆分四层。会话级是 checkpoint.md,项目级是 MEMORY.md,用户级是全局记忆,最底下一层是用 SQLite 存下来的完整会话记录。另外还有两个定时任务,dream 每 7 天合并一次重复的记忆,distill 每 30 天把反复出现的流程整理成 Skill。
Max Mode 每一步并行生成 5 个候选方案,再由同一个模型当评委选一个执行,SWE-Bench Pro 上比单次采样高 10% 到 20%,token 消耗是 4 到 5 倍,目前还是实验功能。
任务再大一些,Dynamic Workflow 让主 Agent 生成一段 JavaScript 脚本,用 agent()、parallel()、pipeline() 三个函数派发 Sub-agent、控制并发,在沙箱里按代码执行。
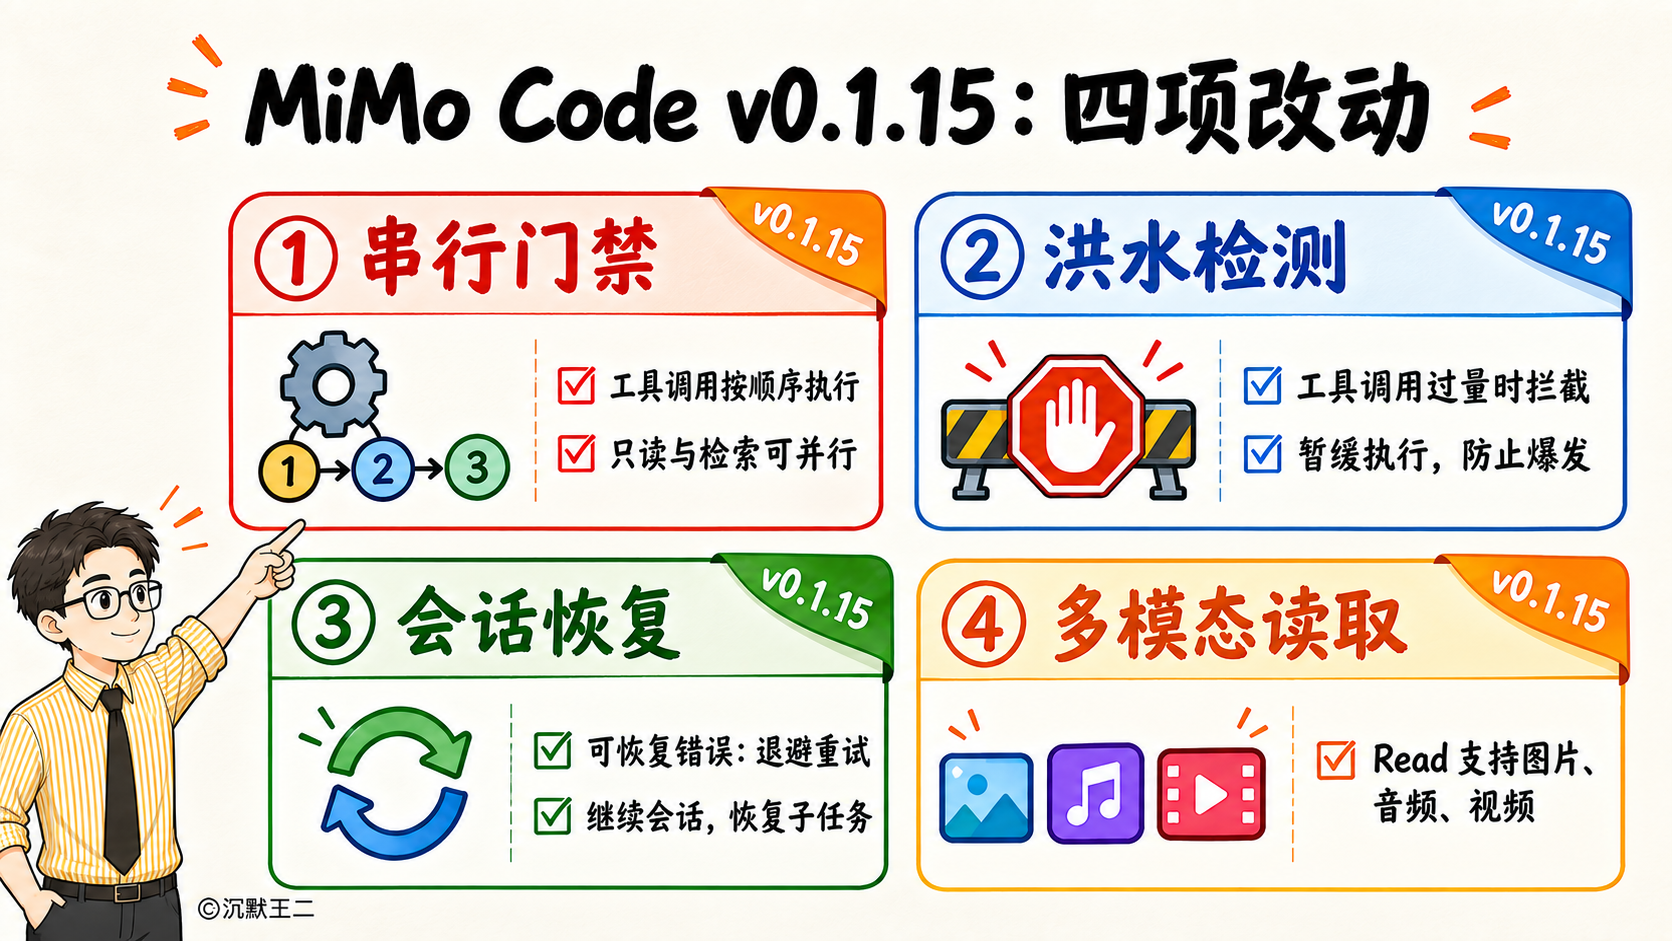
9 月 22 日,0.1.15 版把同一步里的多个工具调用改成了串行执行,只有只读和检索类的工具可以并行,还加了工具调用检测,专门拦截短时间内大量涌出的工具调用。
07、MiMo Desktop
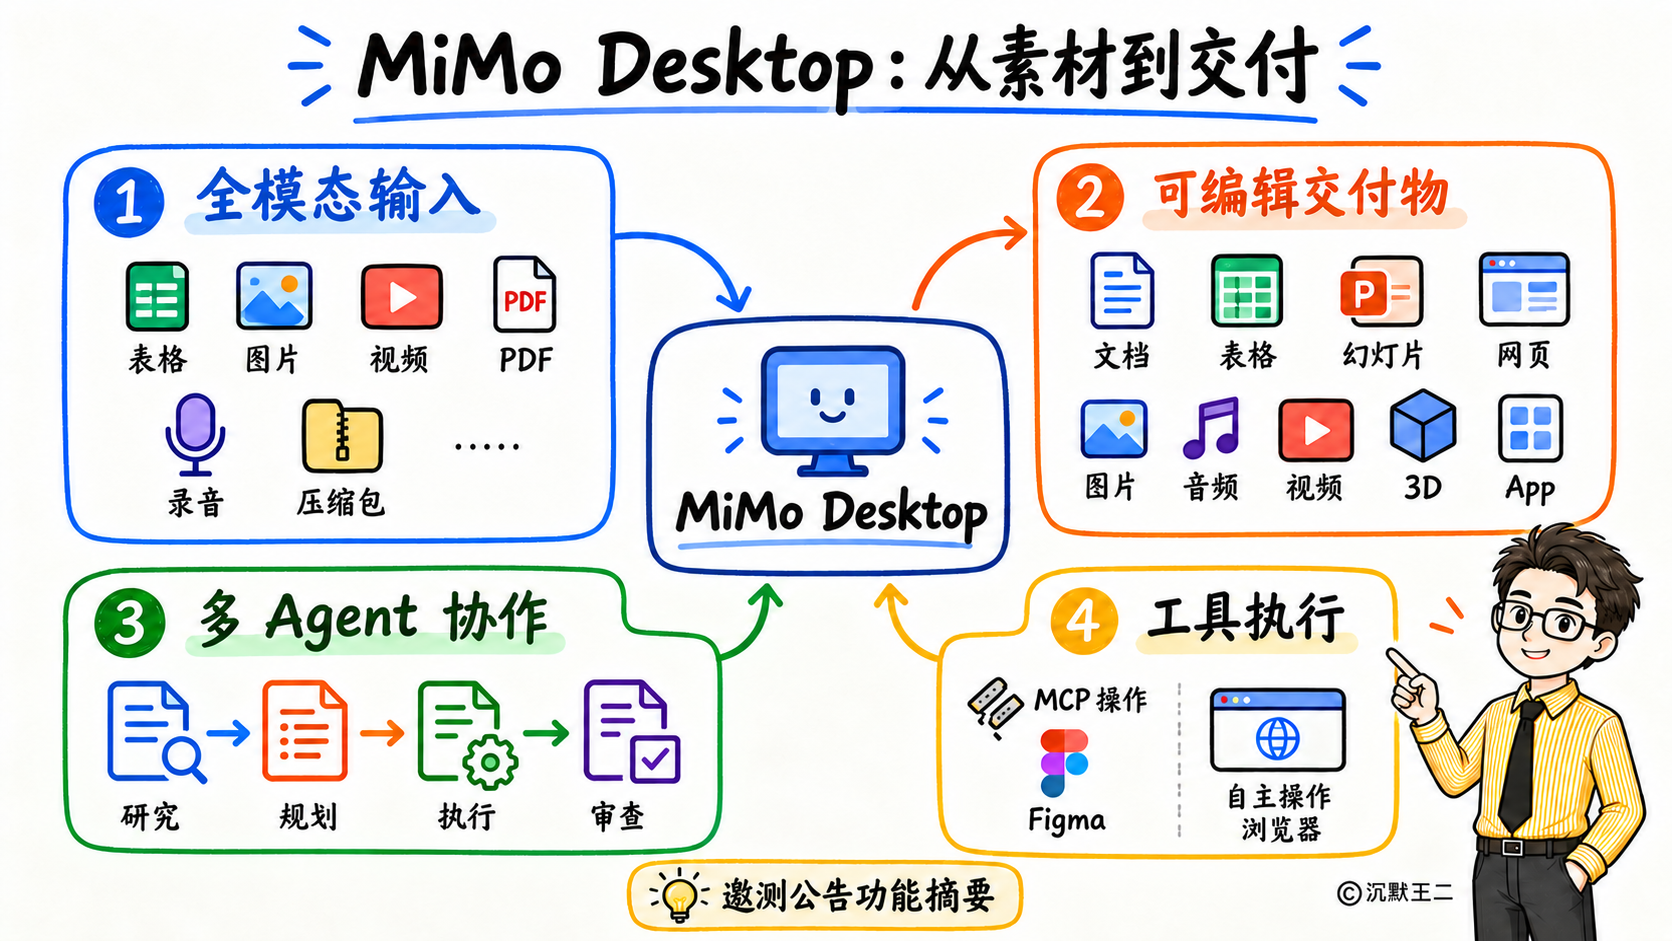
9 月 8 日,小米开放了桌面客户端 MiMo Desktop 的邀测,它的核心引擎就是 MiMo Code。
MiMo Desktop 能接收表格、图片、视频、PDF、录音,未解压的压缩包也能直接丢进去。交付的东西包括文档、表格、幻灯片、网页、图片、音频、视频,还有 3D 模型、App 和软件工程项目。
它可以让多个 Agent 协作,通过 MCP 控制 Figma,也能自主操作浏览器。
缓存命中率在同一个会话里最高 99%,跨会话最高 95%。
ending
今年 7 月小爱同学调整架构之后,基础模型也交给了 MiMo 团队。
不得不说,AI 时代,不仅模型进化得快,Agent 迭代的快,人的晋升也来得快。
这可能就是 AI 时代赋予我们最大的红利了。
我们下期见。