
替代 CC Switch,Magpie 真的很顶。
经常同时用 Claude Code 和 Codex 的小伙伴,手里大概率都不止一家大模型的 API key。
以前为了在几家模型之间来回切换,很多小伙伴会用 CC Switch。点一下就能换供应商,省去手改配置文件的麻烦。
昨天我看到 G 哥推荐了 yetone 开源的 Magpie,在 GitHub 已经拿下了 22.7k Star。
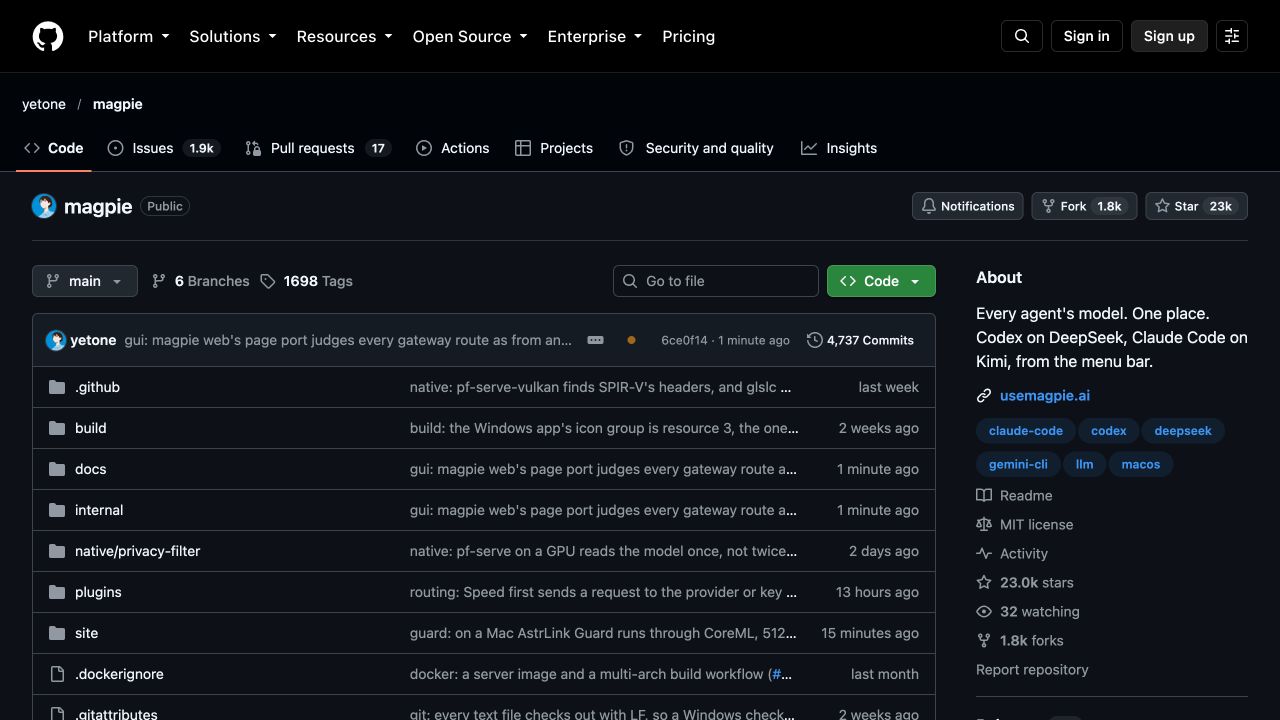
https://github.com/yetone/magpie
magpie 会在本机启动一个多协议网关,把 60 多种 AI 编码工具和各家大模型供应商统一接管起来。不仅支持给 Claude Code 的四档思考强度和 Sub-agent 分别绑定不同厂商的模型,还能在请求发出前按剩余额度和重置时间自动挑选账号,甚至帮你提前预热 5 小时的额度窗口。
既然这么顶,那我们直接来一波实践。
01、安装 Magpie
Magpie 是用 Go + Wails v3 开发的,把本地网关、系统托盘、桌面窗口和终端 TUI 打包在同一个二进制文件里,不依赖 Node.js 或外部运行时。打开终端,执行下面这段脚本就能完成安装。
curl -fsSL https://usemagpie.ai/install.sh | sh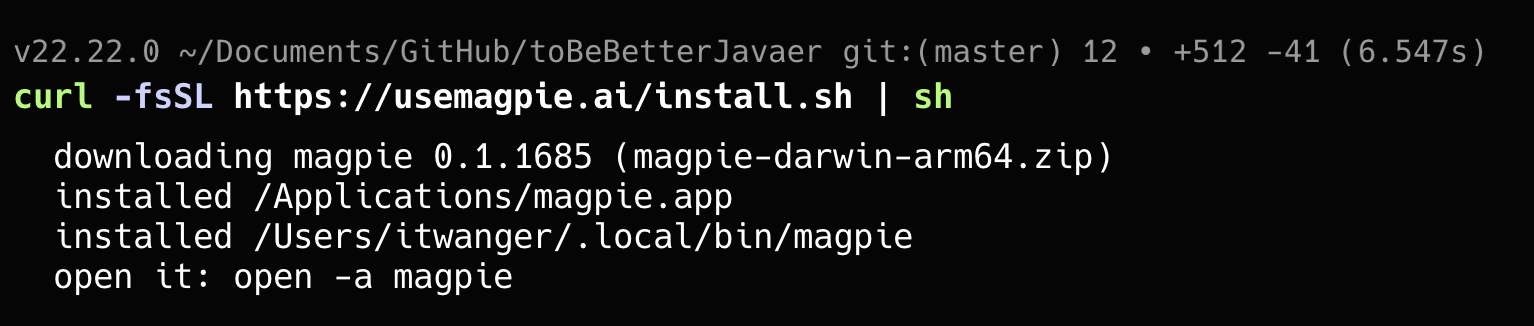
安装完成后,在终端输入 magpie 就能启动桌面应用和顶部菜单栏图标。如果平时不想开桌面窗口,输入 magpie tui 可以在终端里打开基于 Bubble Tea 构建的完整交互界面,输入 magpie daemon install 则会把网关注册为 macOS 的 launchd 后台服务,实现开机自动运行。
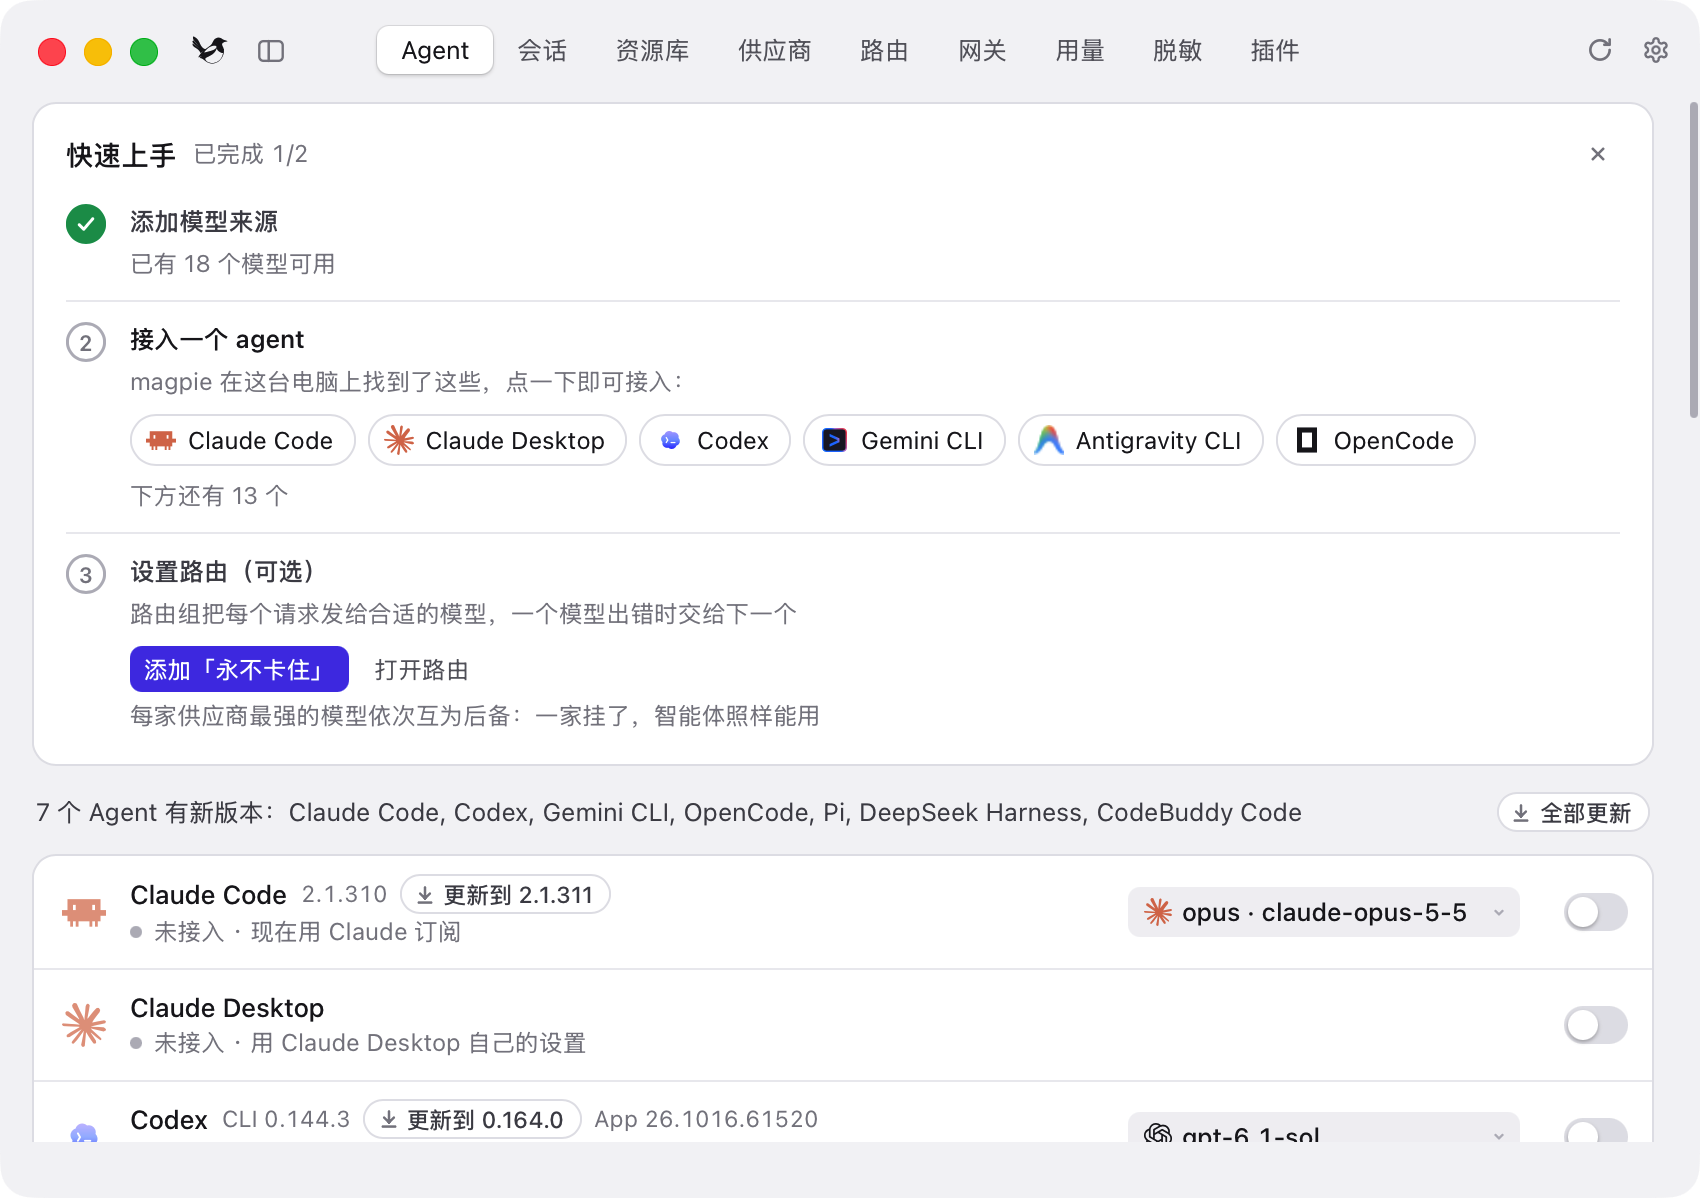
启动之后,本机就多了一个监听在 127.0.0.1:3425 的本地网关。
这个网关支持 OpenAI Chat Completions、OpenAI Responses、Anthropic Messages、Google Gemini 和 Ollama 原生协议,不仅能转换普通文本和流式分块,还会自动整理跨协议的工具调用索引顺序,并把不同厂商的思考内容做映射或剥离,避免中途切换模型时因为历史消息里带有别家模型的思考签名而报错。
如果你之前已经在 Claude Code 或 Codex 里配好了密钥,不用重新复制粘贴,支持一键从现有的配置文件里导入。
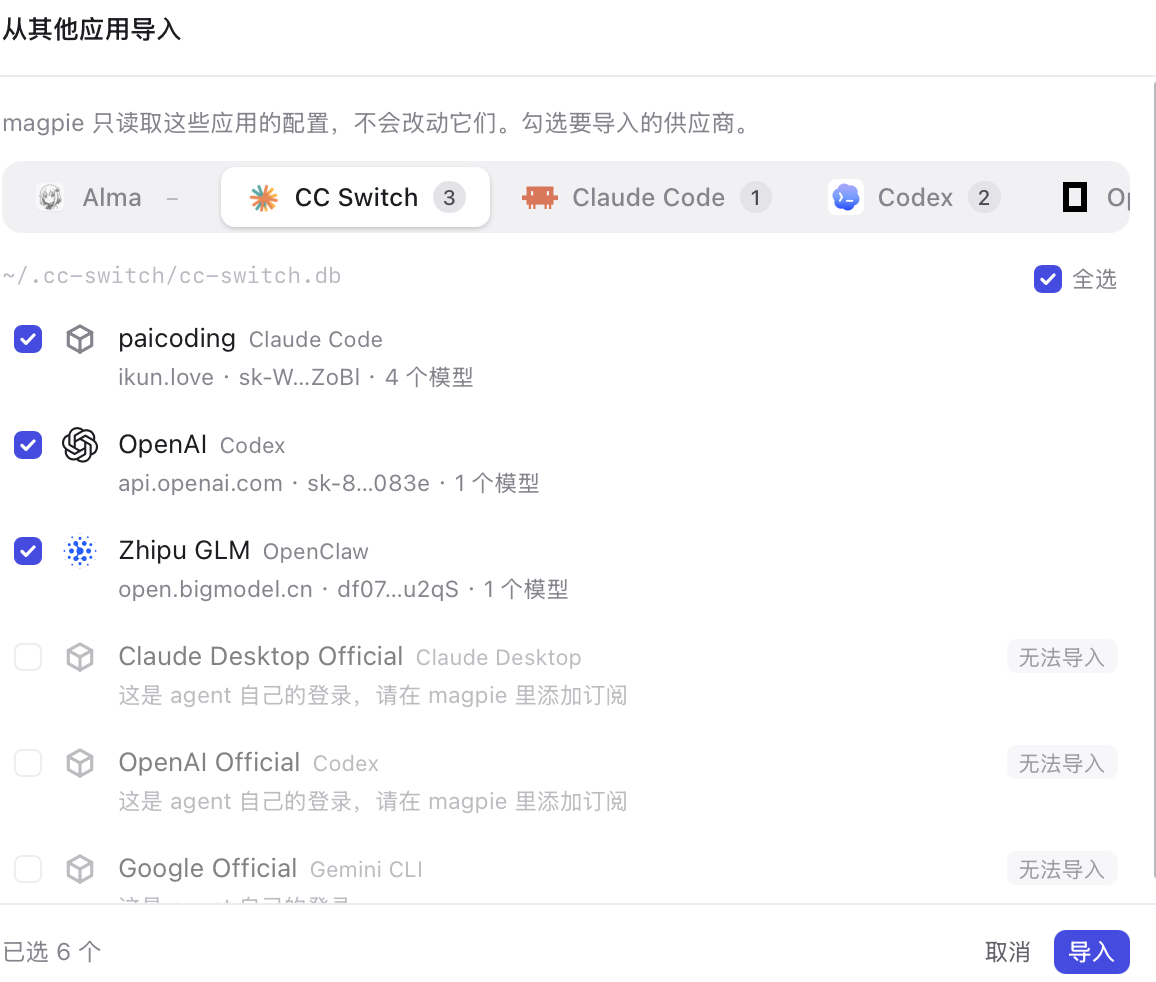
除了填 API Key,还支持免密钥登录 Claude、ChatGPT Codex、GitHub Copilot 等订阅账号,也能自动发现本机已经登录过的客户端凭证。
02、给 Claude Code 和 Codex 分配模型
点开 Agent 页面的 Claude Code 配置项,可以看到它给 opus、sonnet、haiku、fable 四个档位以及 Sub-agent 各留了一个独立的下拉框。
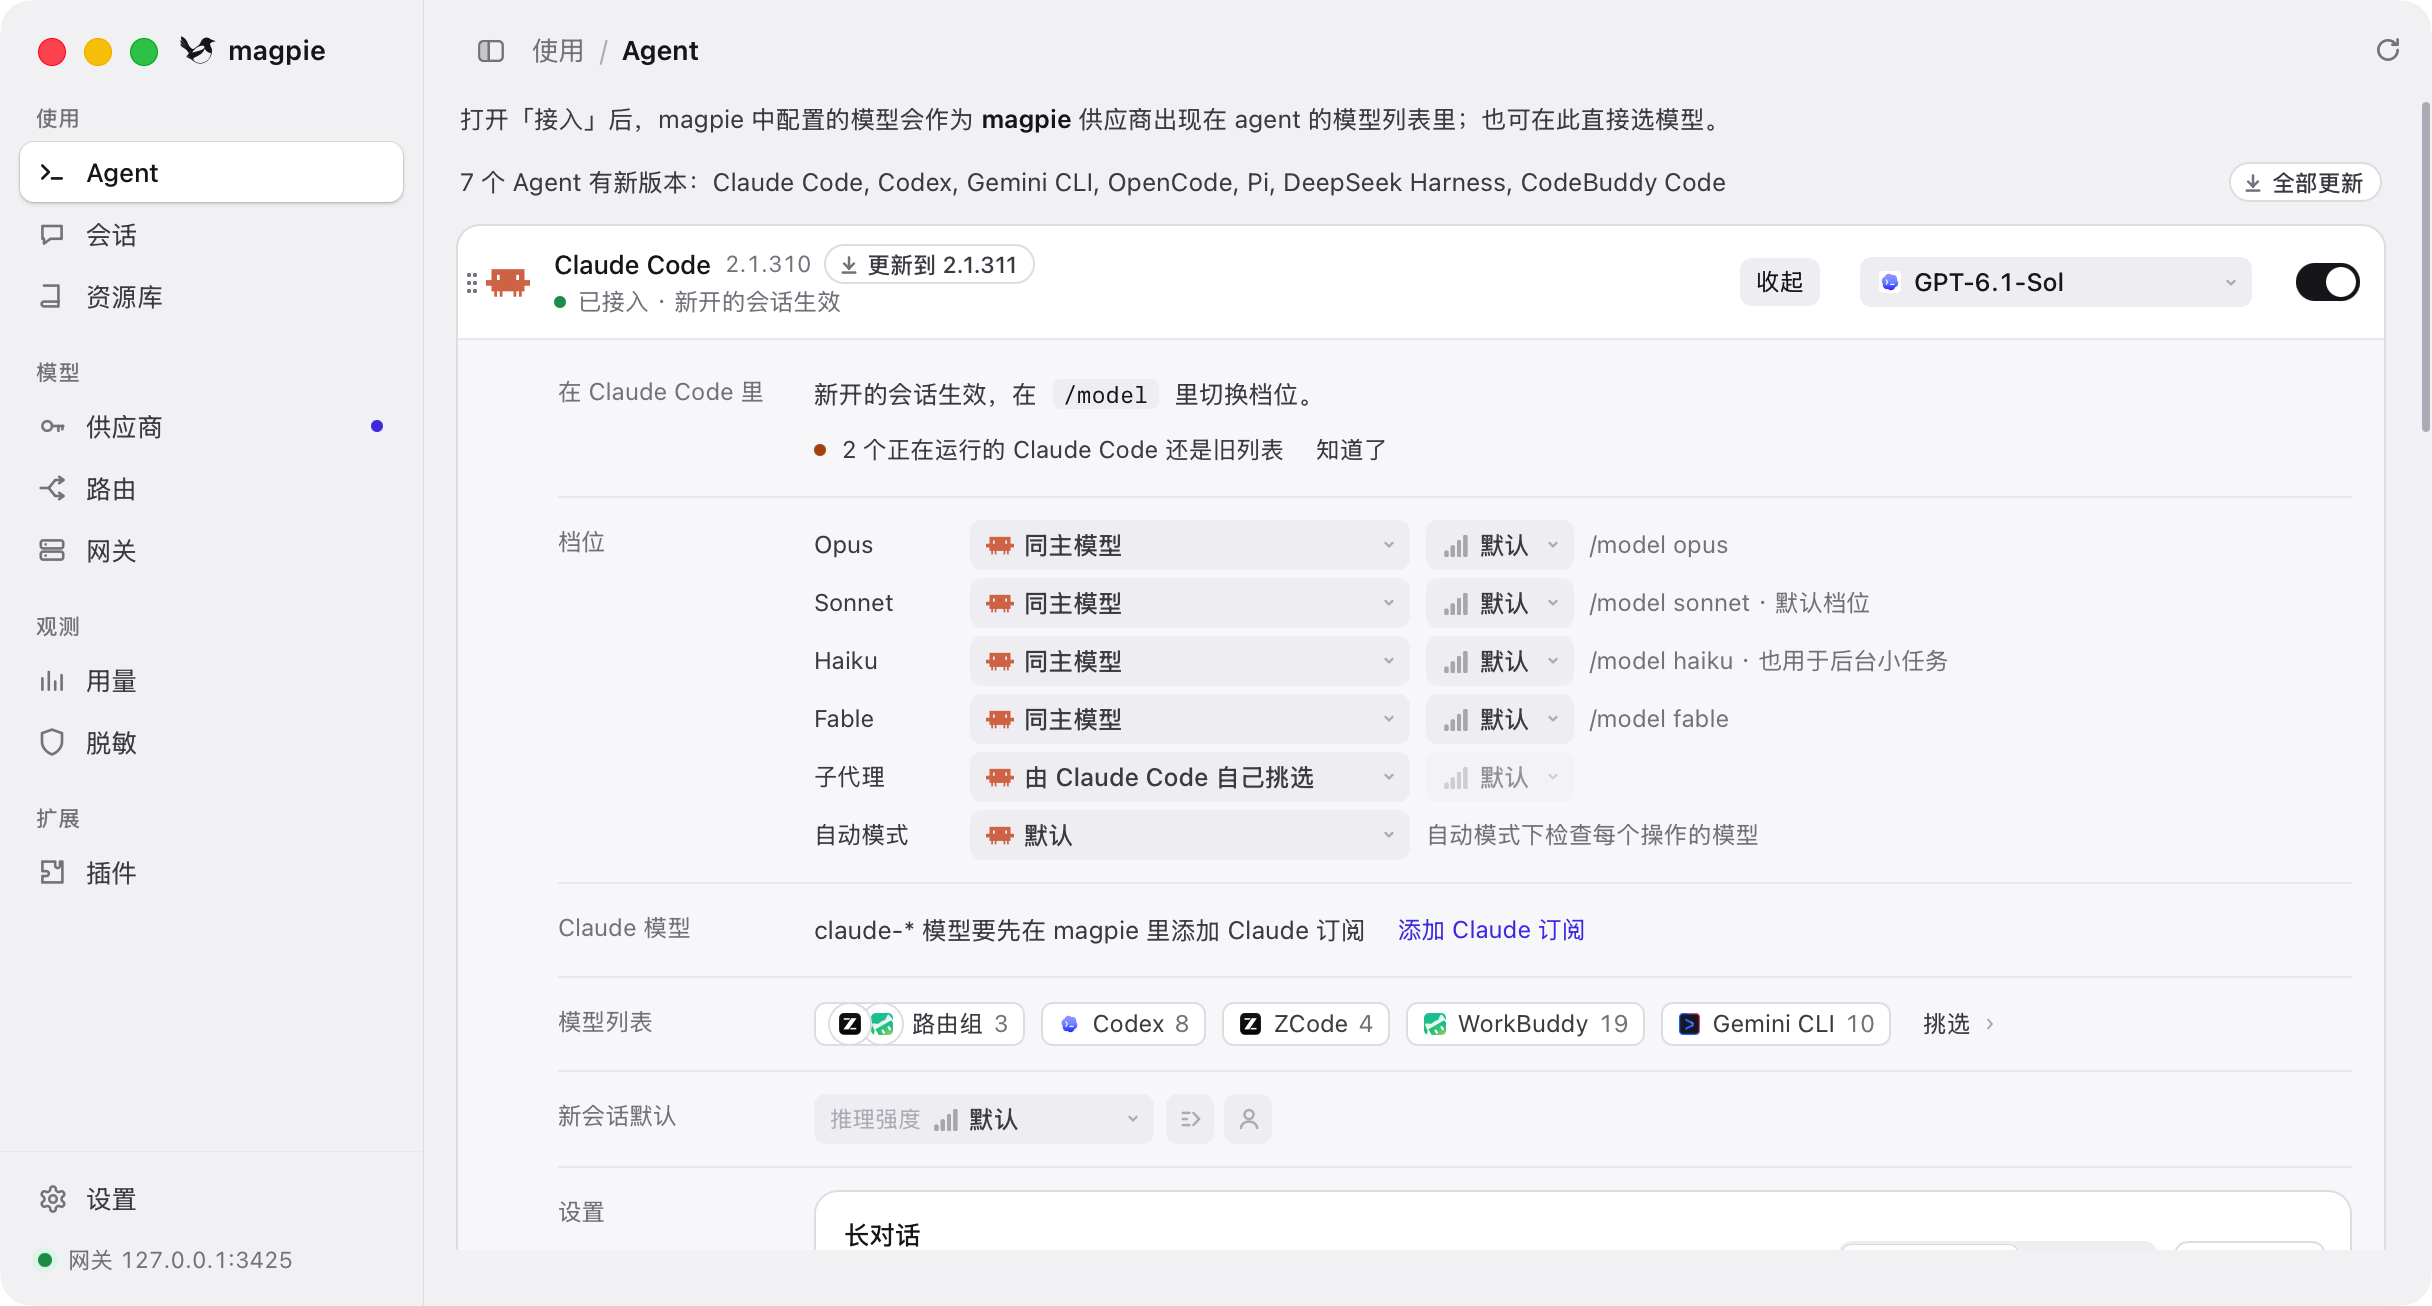
你可以把四档都指向同一个主力模型,也可以给 opus 挑一个推理能力最强的模型用来做复杂的架构设计,给 haiku 挑一个响应速度快、单价便宜的模型用来处理轻量操作,再单独给 Sub-agent 指定一个高性价比的国产模型去执行大批量代码检索。
网关收到请求时,会识别请求头里的 Agent 标识,把主会话和 Sub-agent 会话区分开,互不干扰。
改配置文件是最容易出事的环节,我专门检查了 Magpie 写回配置的方式。每次应用配置前,它都会先读取原文件,只修改连接本地网关必需的那几个字段,原文件里的注释、键名顺序和缩进格式全部保留,并在同目录下先写临时文件再通过原子重命名替换落盘。
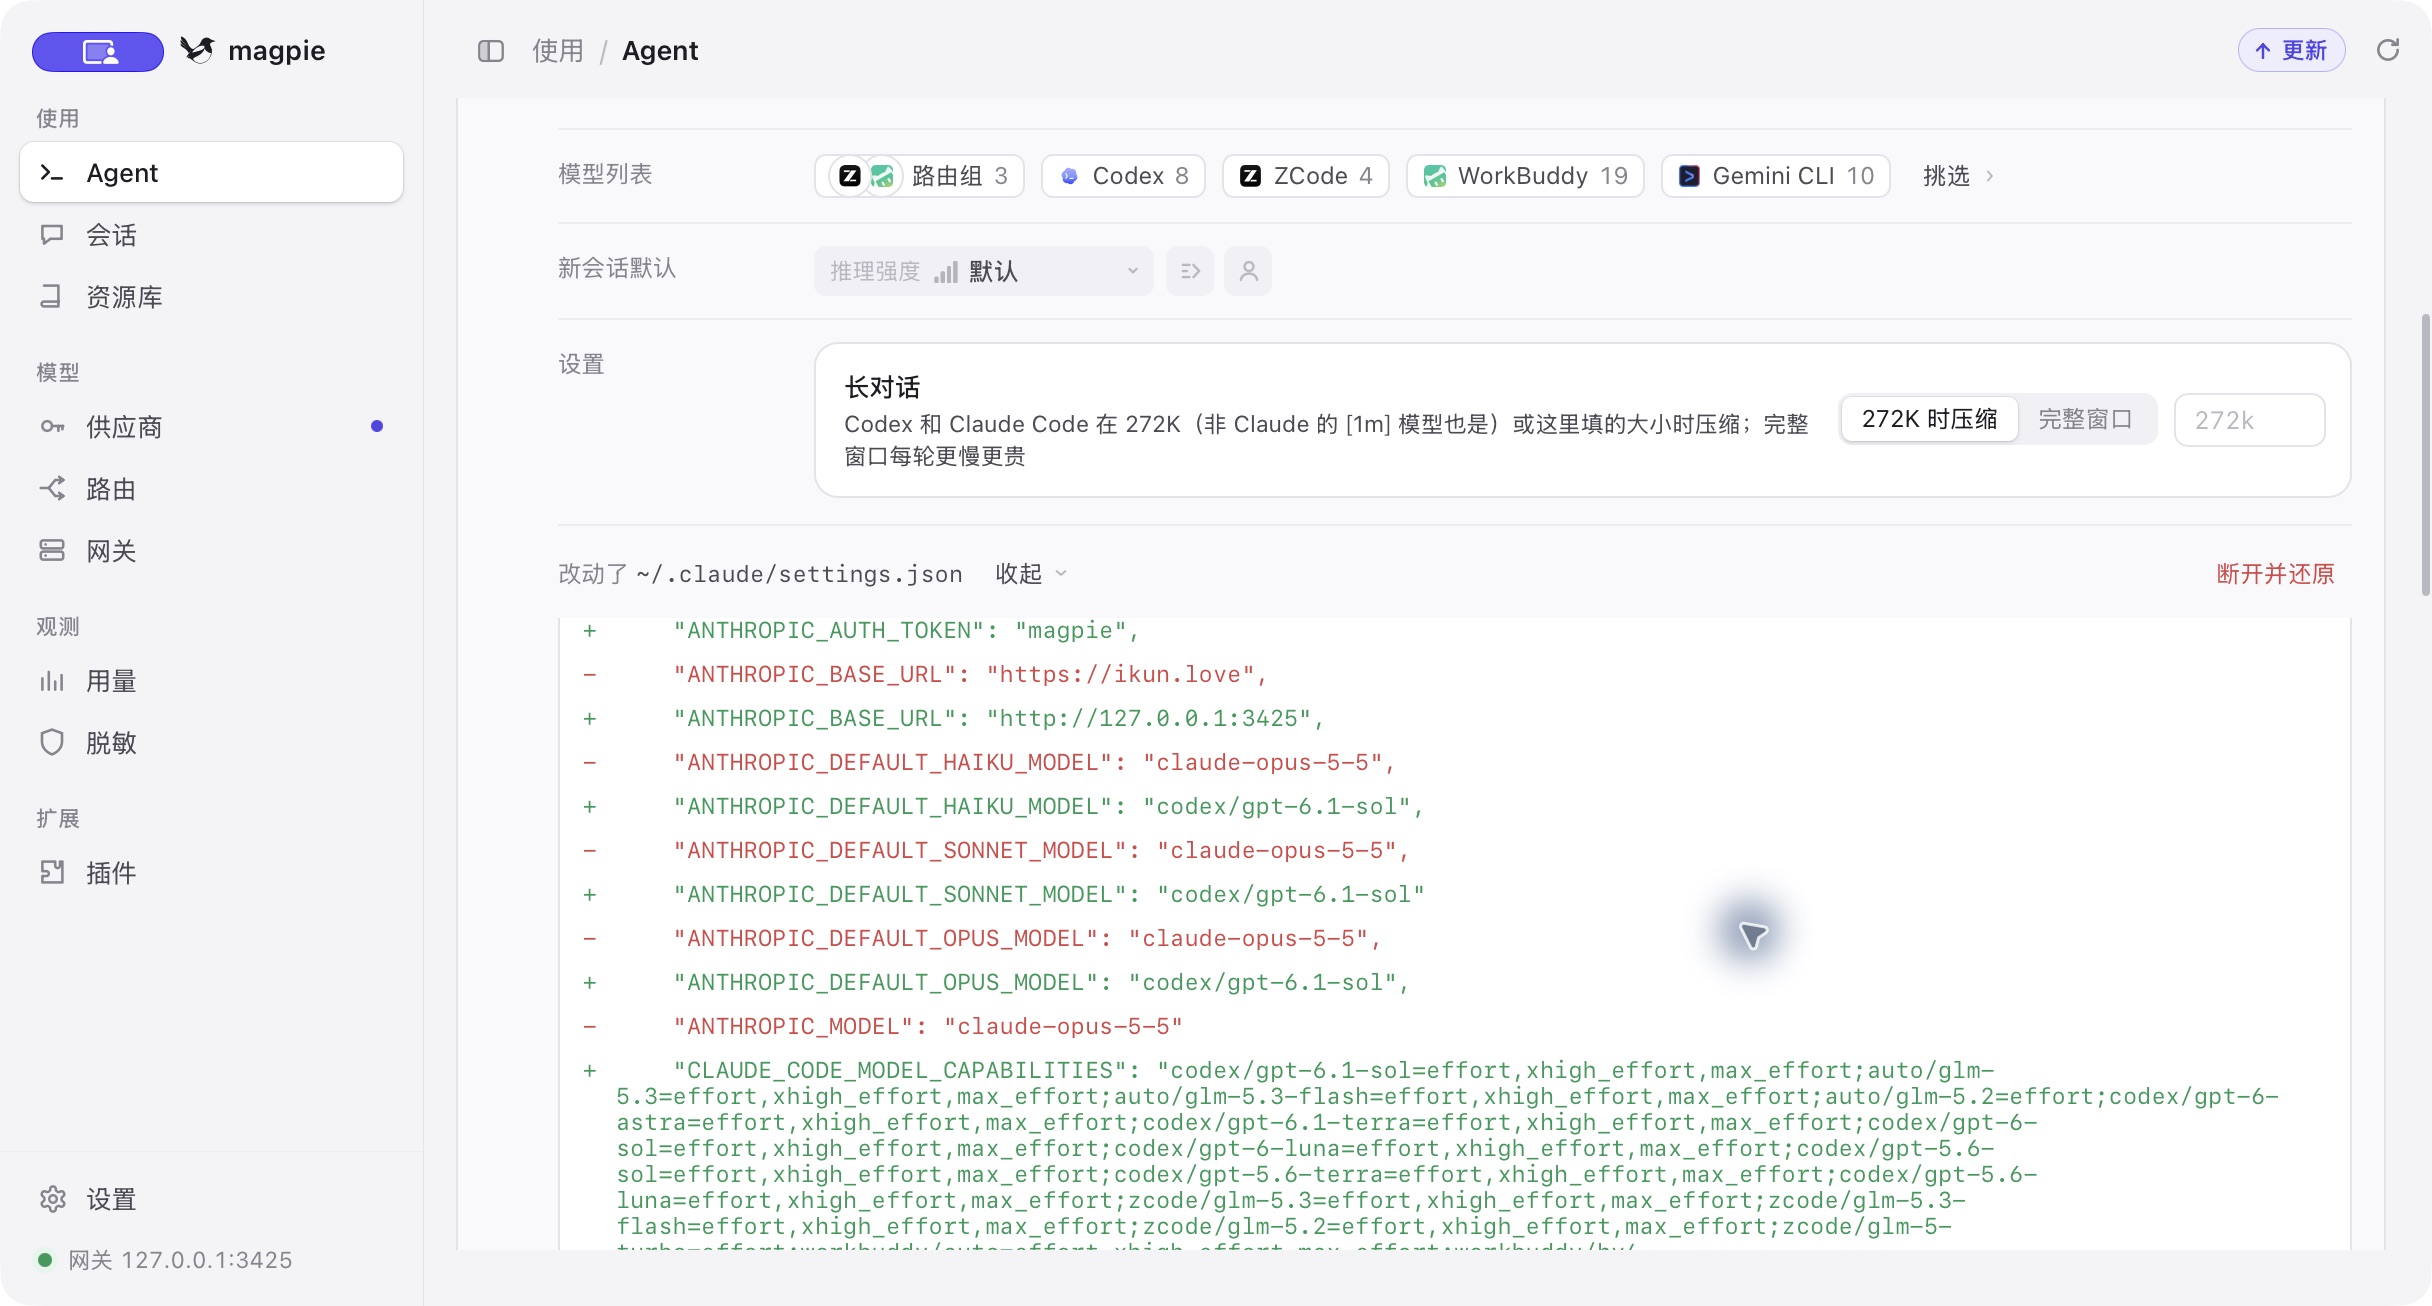
拿 Claude Code 来说,它只改动 ~/.claude/settings.json 里面 env 段的 ANTHROPIC_BASE_URL、ANTHROPIC_AUTH_TOKEN 以及四档思考强度对应的环境变量,把地址指向本机的 http://127.0.0.1:3425,凭证设为 magpie,你的状态栏、Hook 脚本和权限黑名单一概不碰。
Codex 是在 ~/.codex/config.toml 里新增一张 [model_providers.magpie] 表并把模型清单写进单独的 JSON 文件。
需要注意的一点是,如果你用它给 Claude Desktop 接入第三方供应商,它会额外新建一个 Claude-3p 配置目录来存放第三方配置。
03、多账号自动路由
开启自动创建路由组之后,只要有两个以上的供应商提供同名模型,系统就会根据模型归一表自动把它们合并成一个名为 auto/<模型 ID> 的路由组(同时兼容旧版的 group/auto- 前缀)。
比如你同时在火山引擎和官方平台配了 deepseek-v4-1-flash,在客户端里选中这个自动组,请求就会在两个来源之间自动调度。
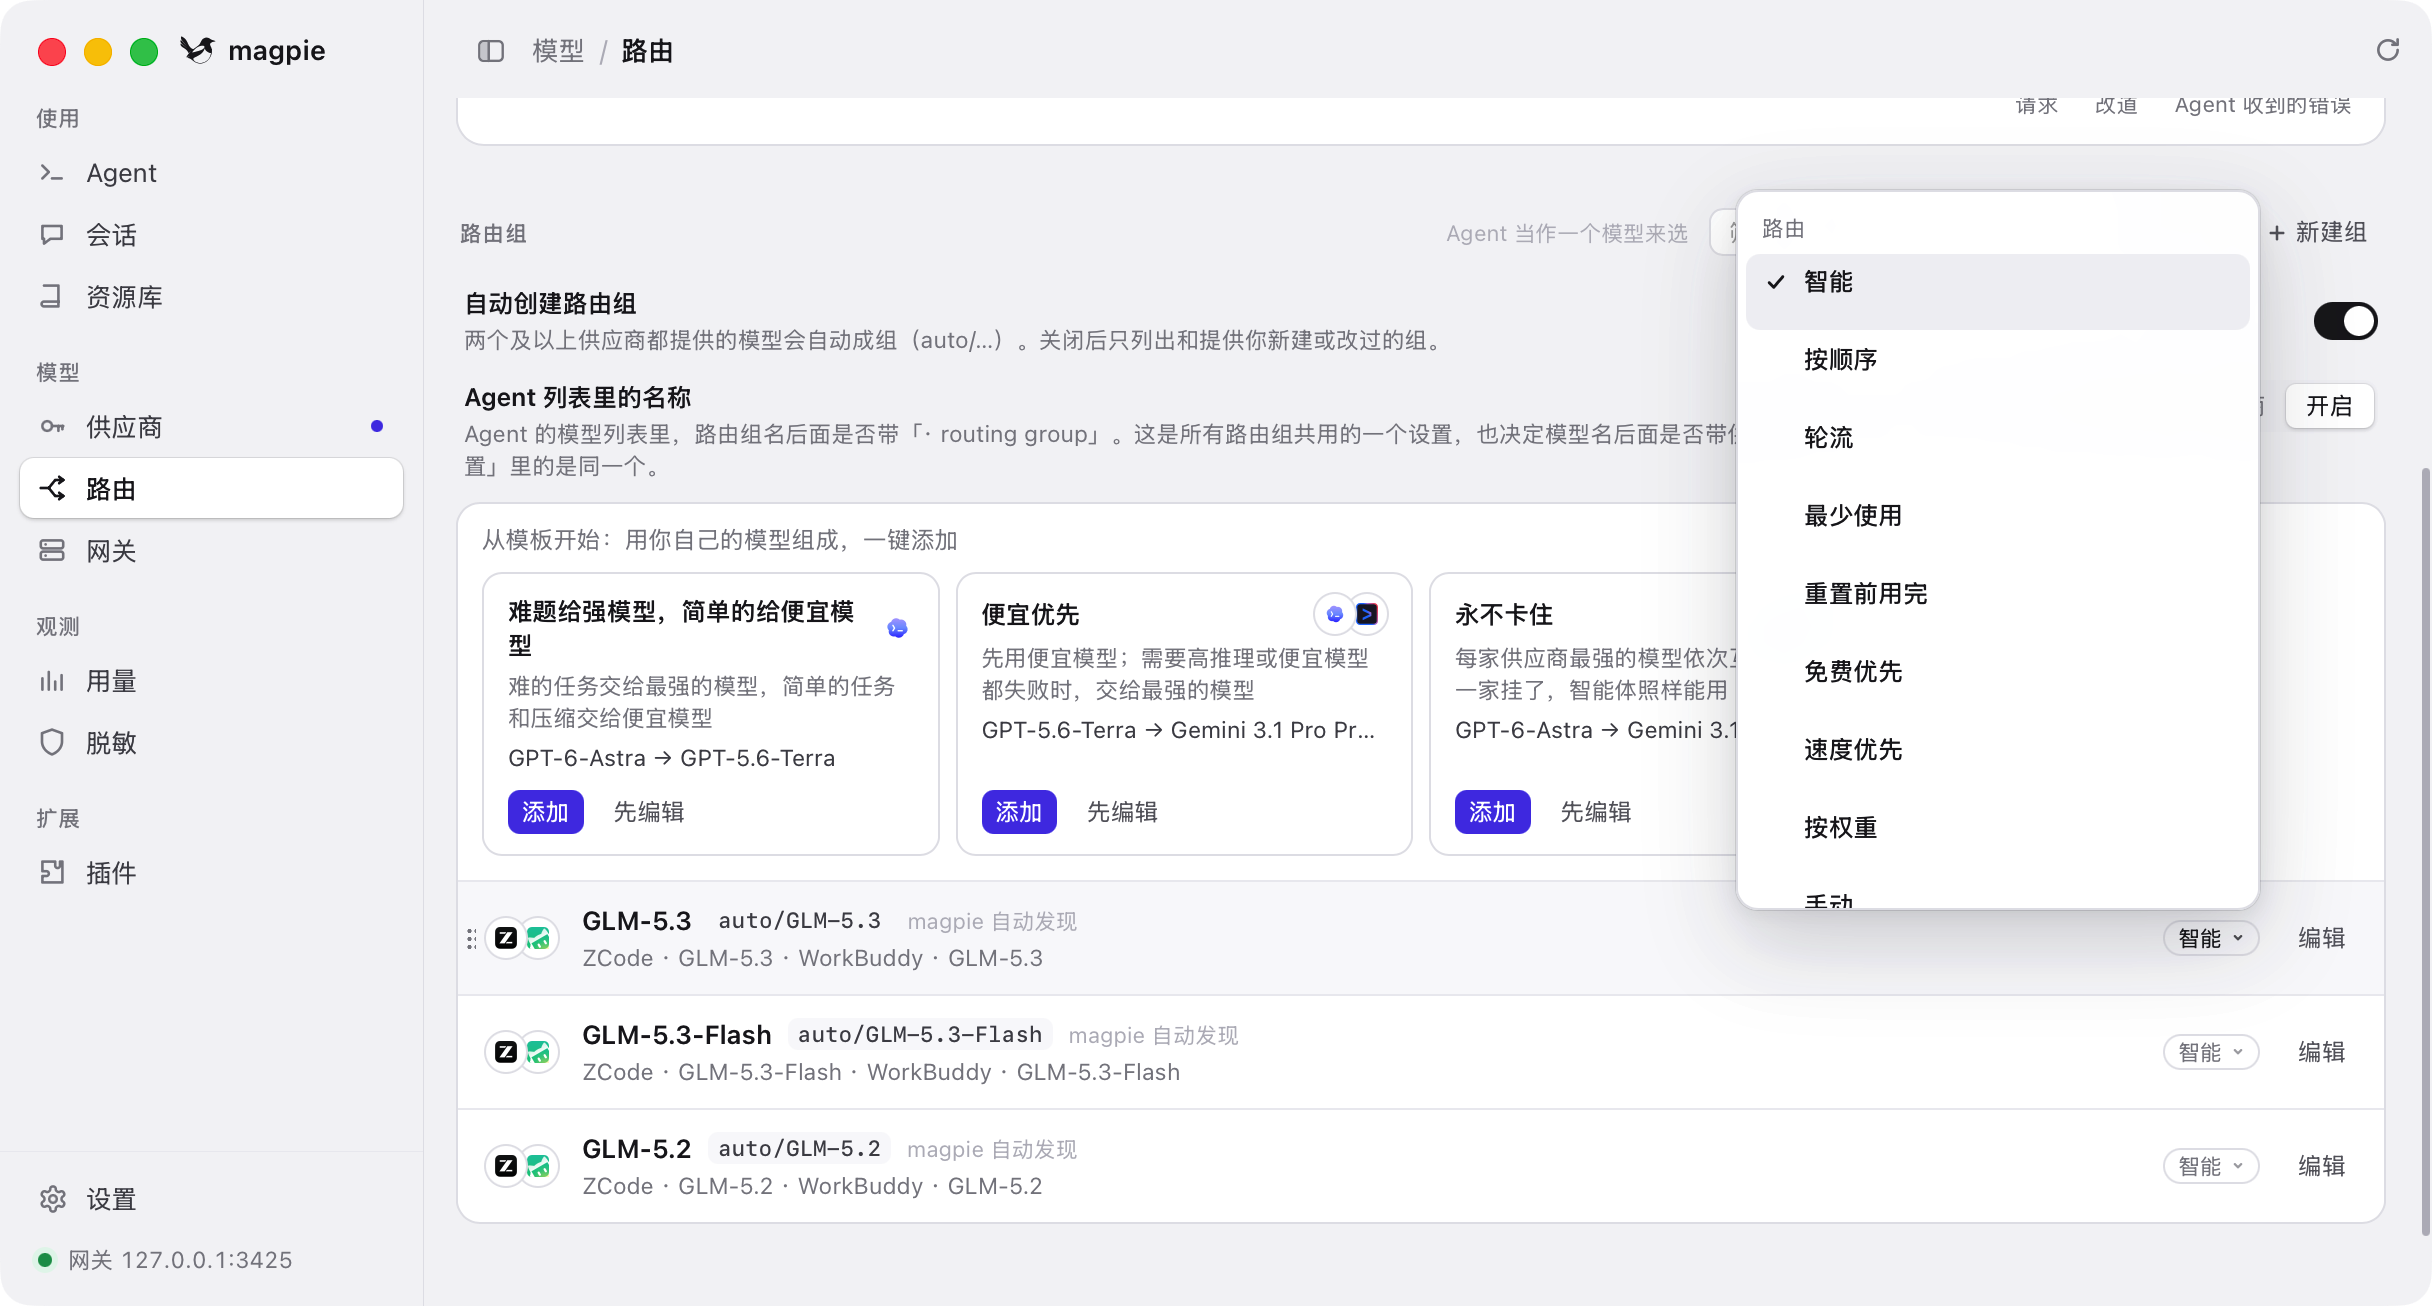
选中模型组或者给单个供应商挂载多个账号时,可以指定具体的路由策略,常用的有五种:
- 智能(默认):在还有额度的账号里,按剩余额度与距离重置时间的比例挑选最快到期,且额度充裕的账号
- 按顺序:固定按排好的顺序尝试,前一个账号无法响应时才换下一个
- 轮流:优先挑近期活跃会话最少的账号,把各账号的用量摊平
- 最少使用:有额度数据时优先选已用比例低的账号,普通 API Key 则按近期指数衰减的 Token 消耗量从低到高排序
- 重置前用完:比较各账号距离周重置每小时还能消耗多少额度,剩余多的先上,适合把周额度用干净
默认的智能策略对包月党很友好。
假设你手里有两个 Coding Plan 账号,额度都还充足,但一个明天重置周额度,另一个下周才重置,它会优先消耗明天重置的那个,免得额度白白过期;像只有 5 小时窗口没有周窗口的账号,会排在更晚重置的周窗口账号前面;而当前窗口已经用掉 90% 以上的账号会自动靠后。
当某个账号触发限流、欠费或报错时,故障转移机制会接手。网关在收到上游正常的响应头和首包之前,会先暂存响应,如果上游超过 15 秒还没返回首字,就每隔 15 秒给客户端发一条 SSE 保活。
只要回复还没有发给客户端,前一个账号报错就能无感知地切换到下一个候选账号。额度用完的账号会休息到重置时刻,欠费停用的账号冷却半小时,返回 429 限流的按厂商返回的 Retry-After 时间跳过,连续报错的账号则按指数退避延长休息时间。
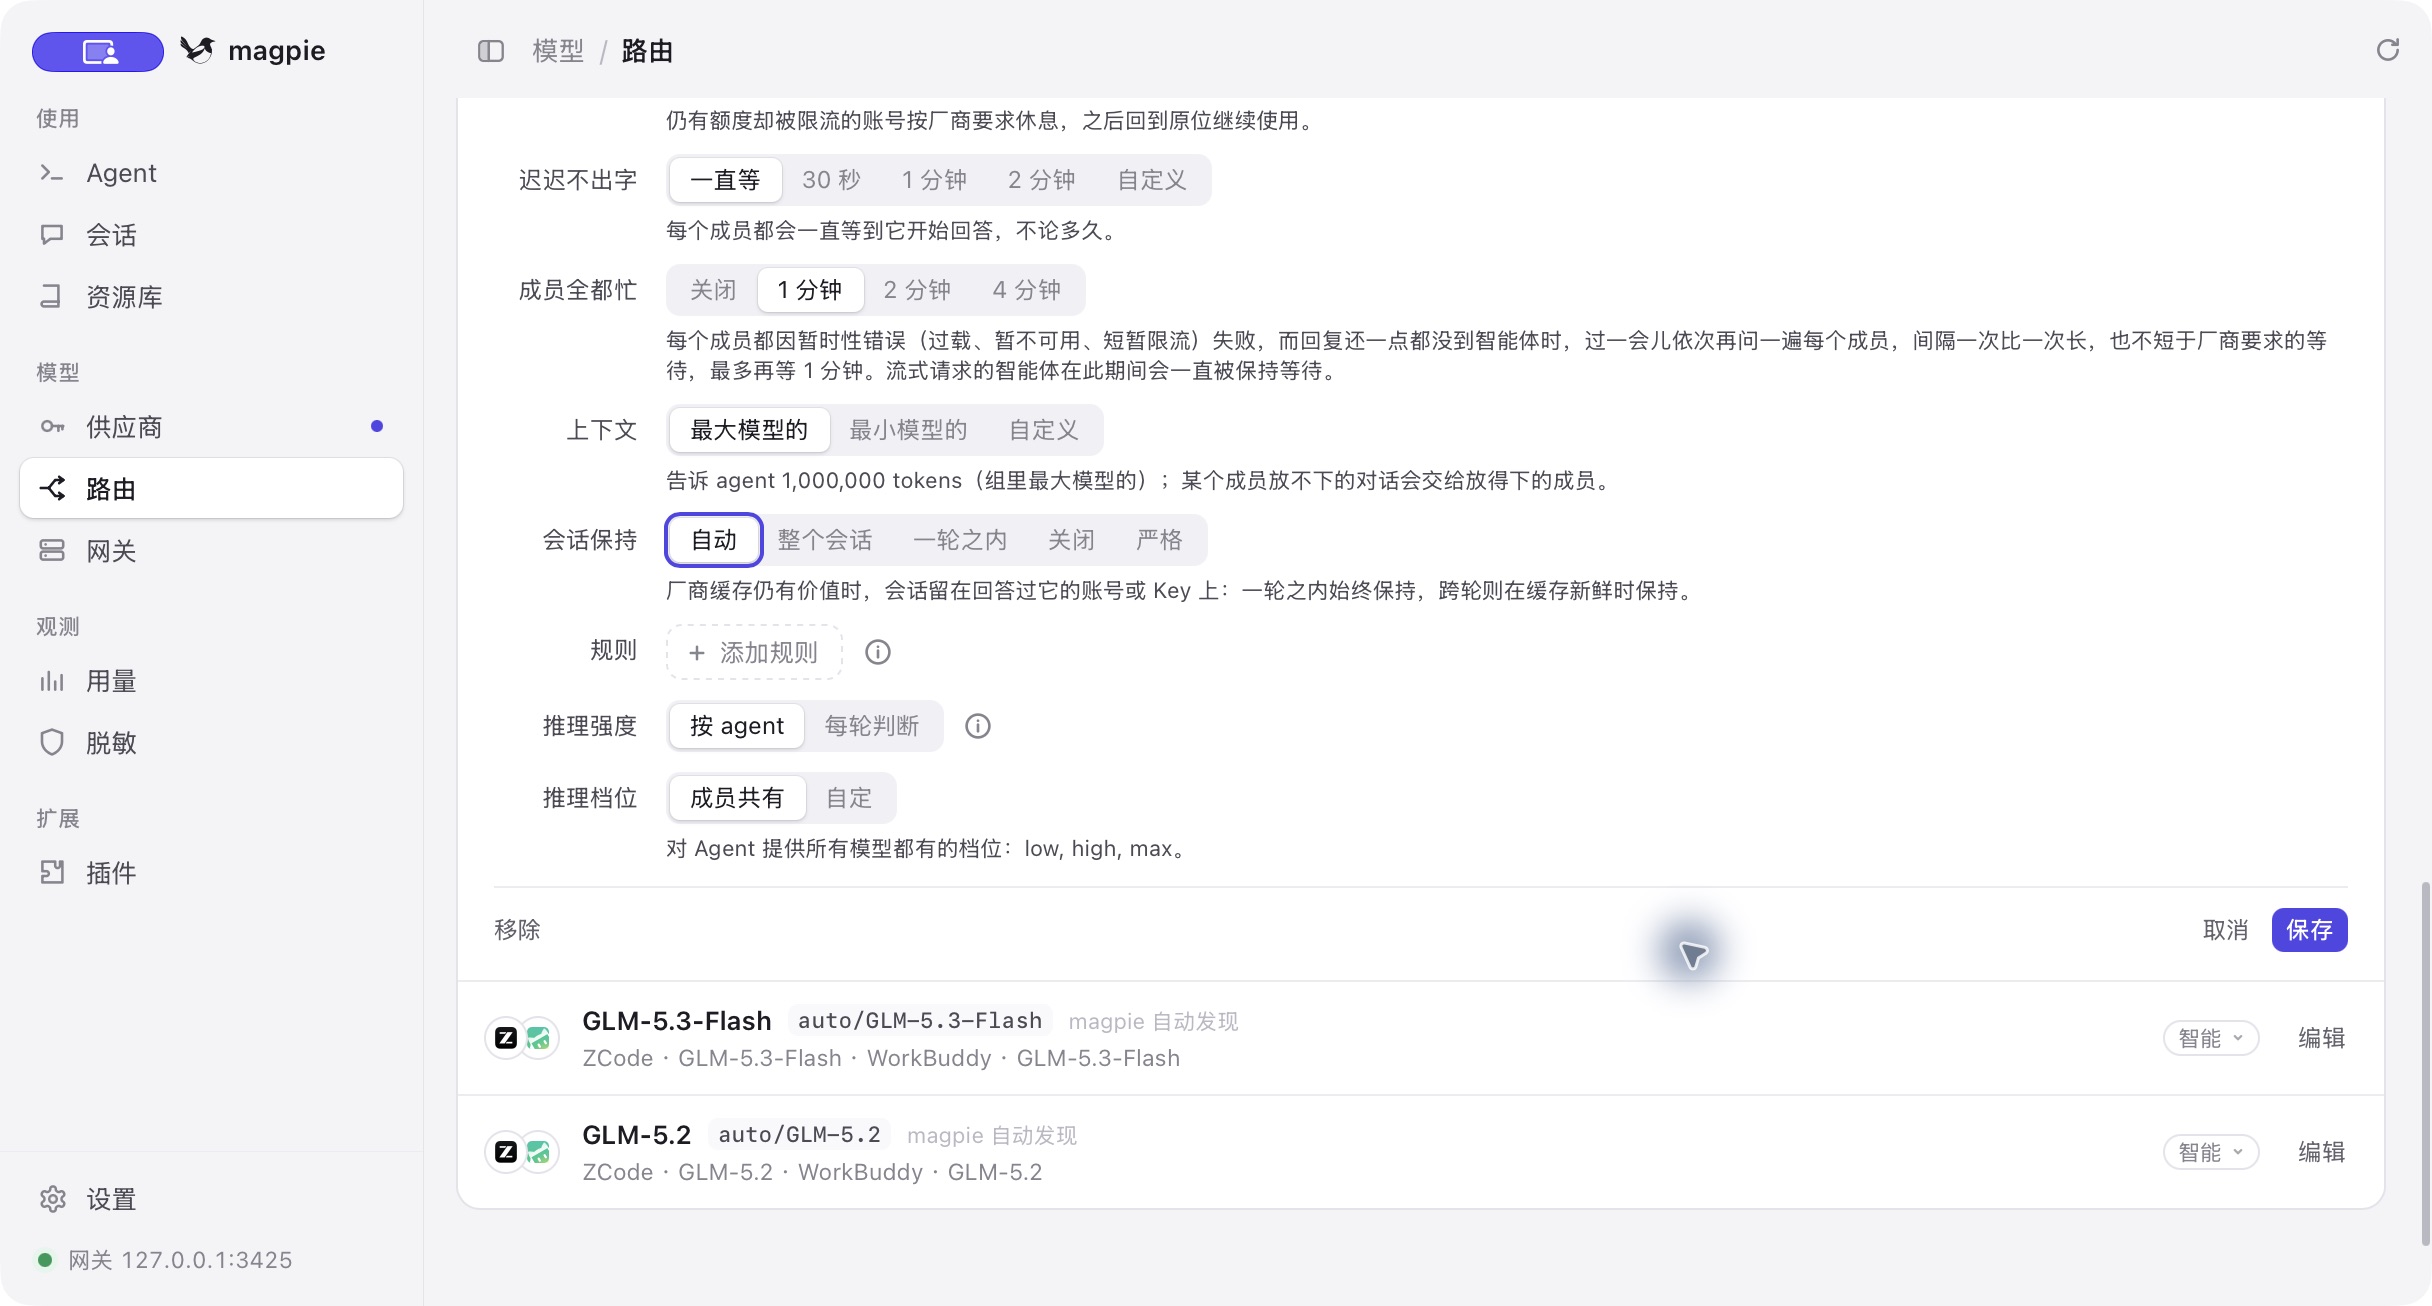
不过,如果每次发请求都换账号,会引发两个严重问题。
Agent 收到用户的一条指令后,往往要连续调用好几次工具,每次把工具结果返回给模型都是一次新的 API 请求;要是中途换了账号或厂商,前面的前缀缓存(Prompt Cache)就全失效了,而且有些厂商还不认别家模型生成的思考内容。为此,路由策略下面专门配了一组会话保持设置:
- 自动(默认):同一轮工具调用之内固定不换;跨轮提问时,如果上一轮读写的缓存达到 1024 Token 以上,就在 5 分钟缓存保鲜期内继续锁定原账号
- 整个会话:只要当前账号还能正常响应,24 小时会话期内始终绑定同一个账号
- 一轮之内:从用户发出消息到 Agent 完成所有工具调用回复为止保持不变,用户下次发言时重新选择
- 关闭:每次请求都重新选择账号
04、按请求特征分流
除了按账号额度排序,路由组还能根据请求本身的特征做细粒度分流。
一条规则可以同时检查请求的估算 Token 长度、是否包含图片、是否要求深度思考、来自哪个客户端、是不是上下文压缩请求,还能限定在星期几、哪个时间段或者哪几个工作文件夹下生效。
这里面很实用的是视觉替身和联网搜索替身。
很多时候我们主力写代码用的文本模型性价比很高,但不支持看图,或者没有原生联网搜索能力。以前遇到报错截图或者需要查阅最新文档时,只能手动切换到另一个多模态模型去问。
现在在路由规则里配好识图模型和搜索替身之后,当你往纯文本模型发截图时,网关会先拦截图片,调用你指定的识图模型生成详细的文字描述,替换掉原请求里的图片再交给主模型处理;同理,当客户端发起联网搜索调用而主模型不支持时,网关会让具备搜索能力的替身模型或搜索接口代为检索,把搜到的结果拼回上下文交给主模型继续写代码。
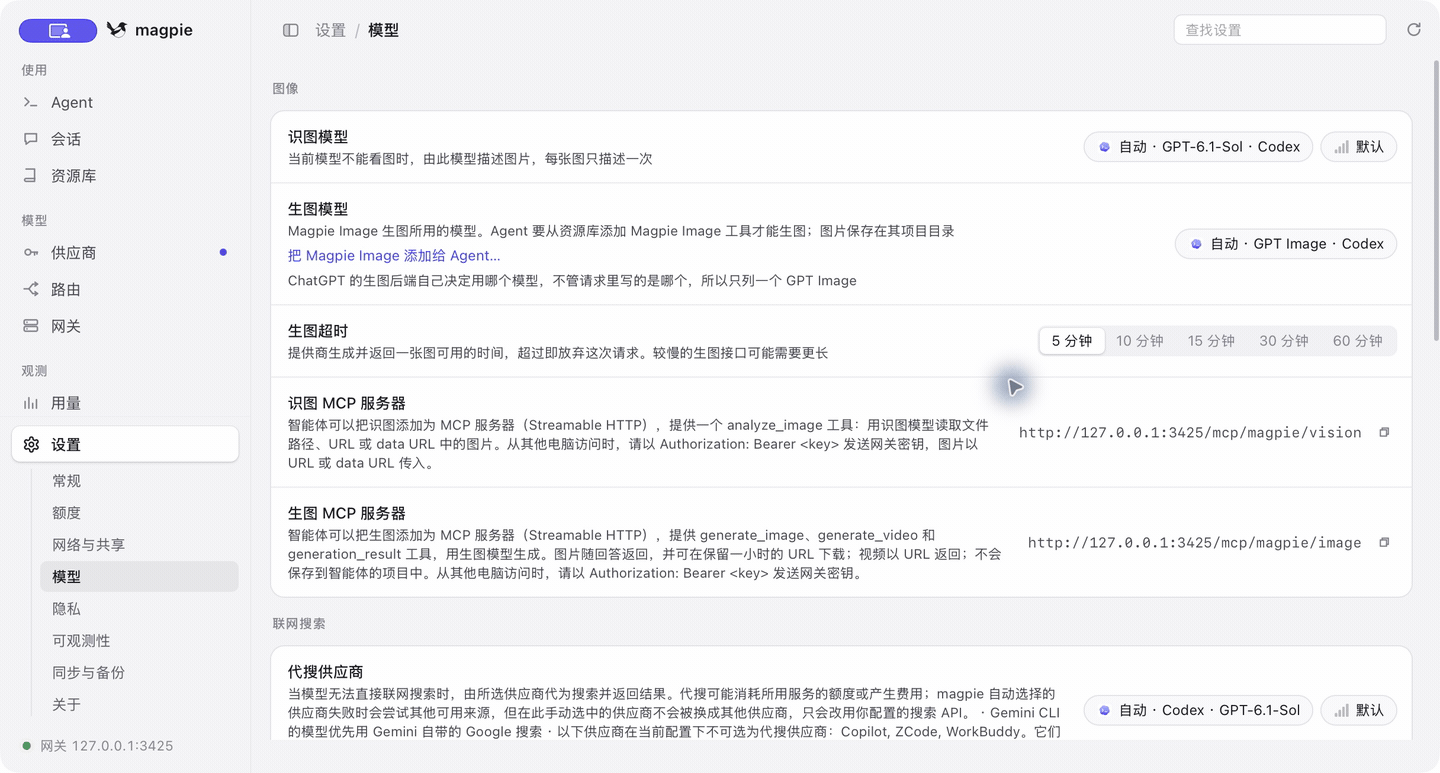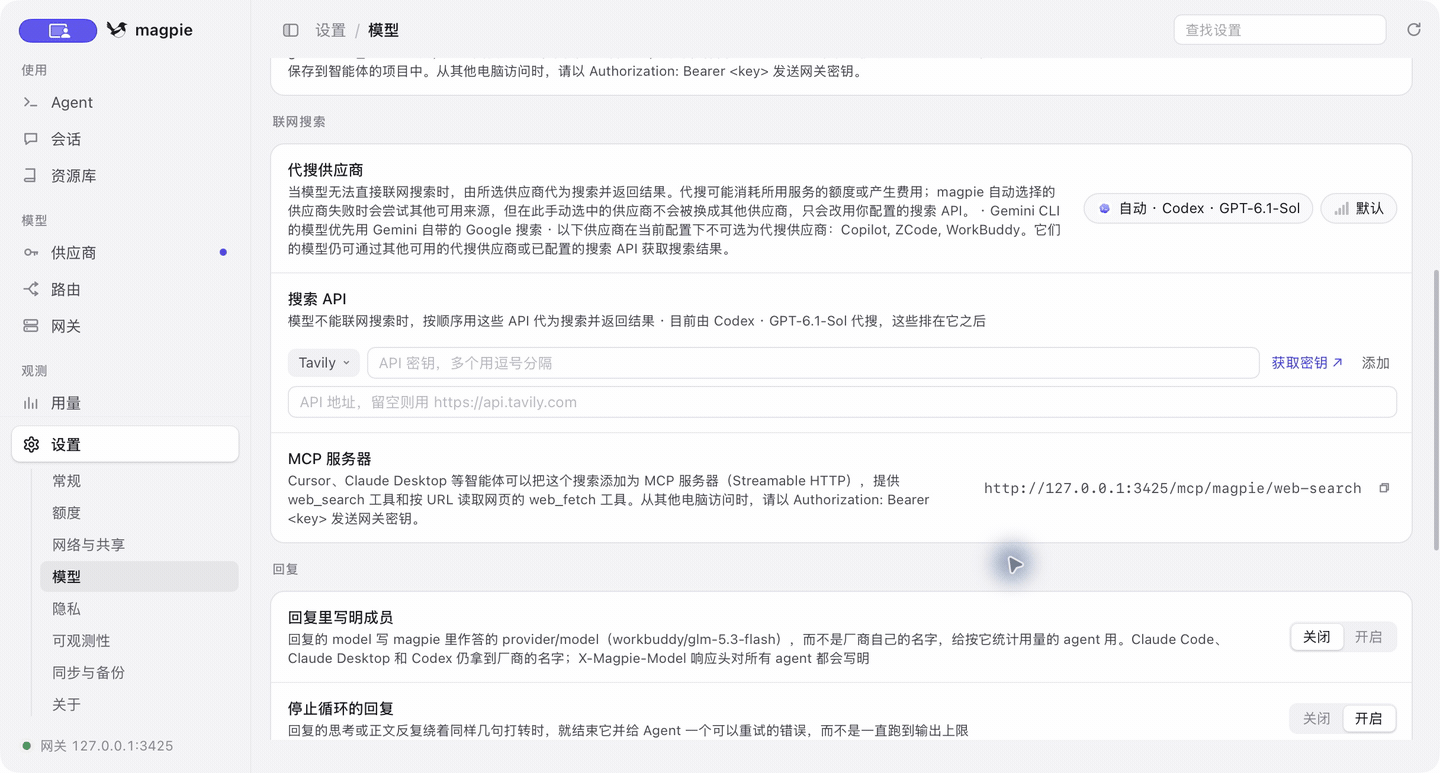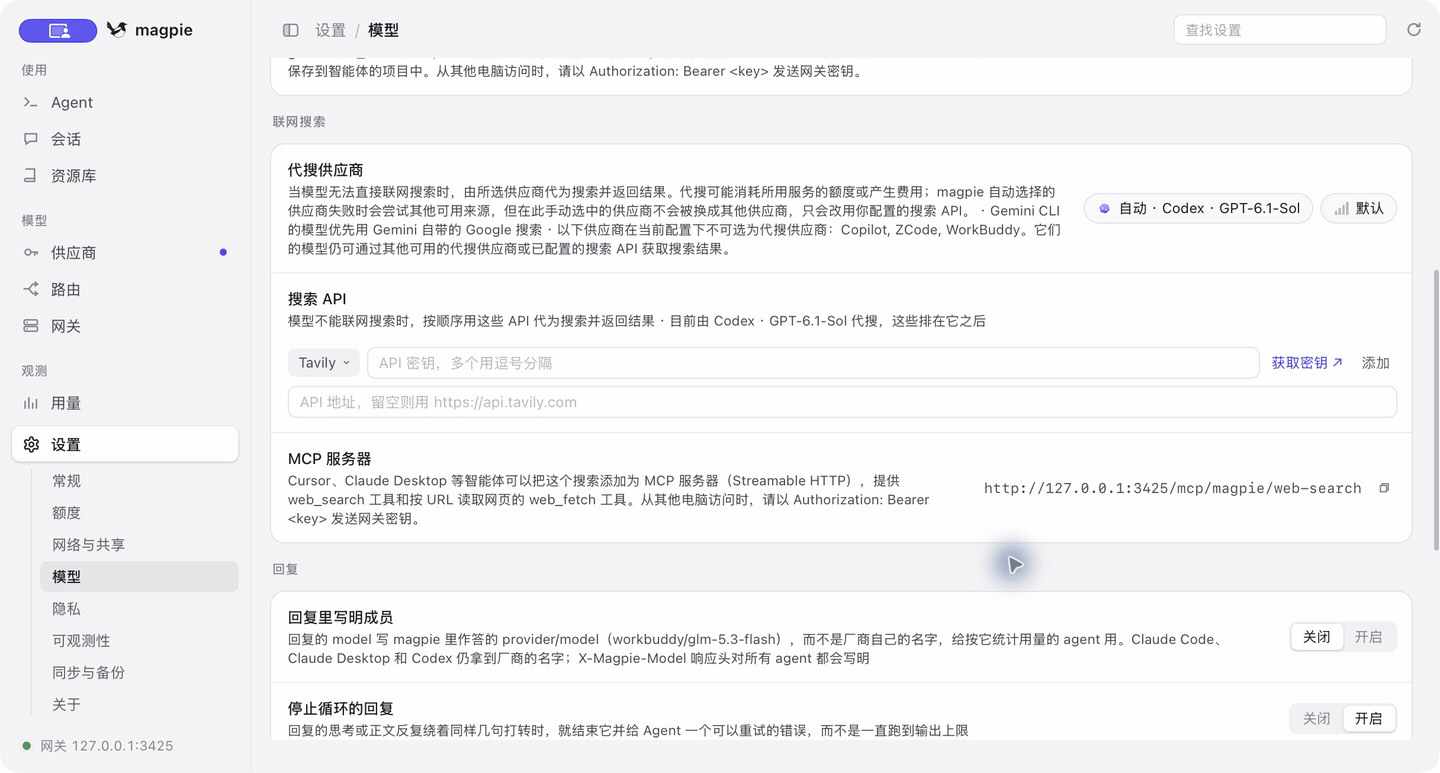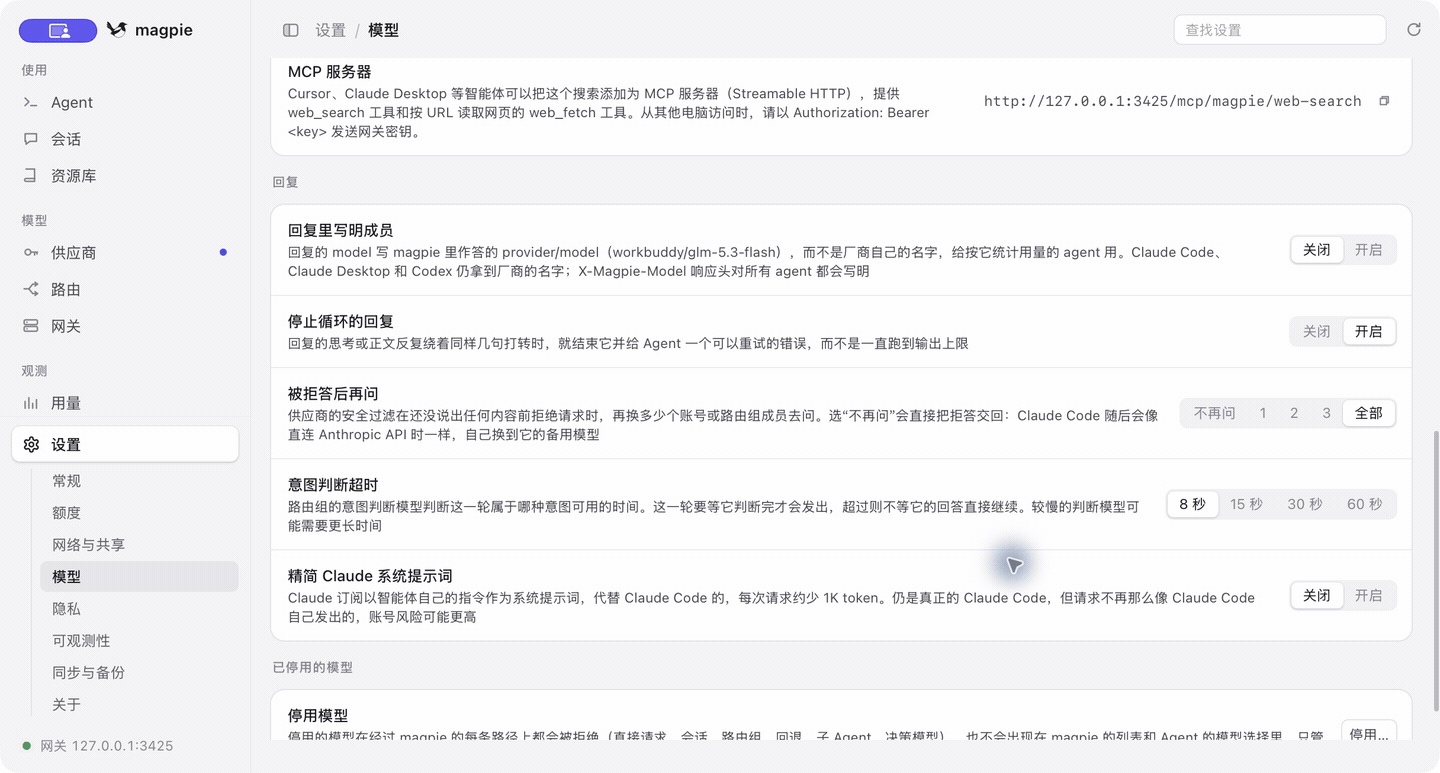
如果你想让不同任务自动找最合适的模型,还可以开启意图路由,让一个轻量模型先判断这轮请求属于“写单元测试”、“排查报错”还是“简单问答”,再分发给对应的模型。
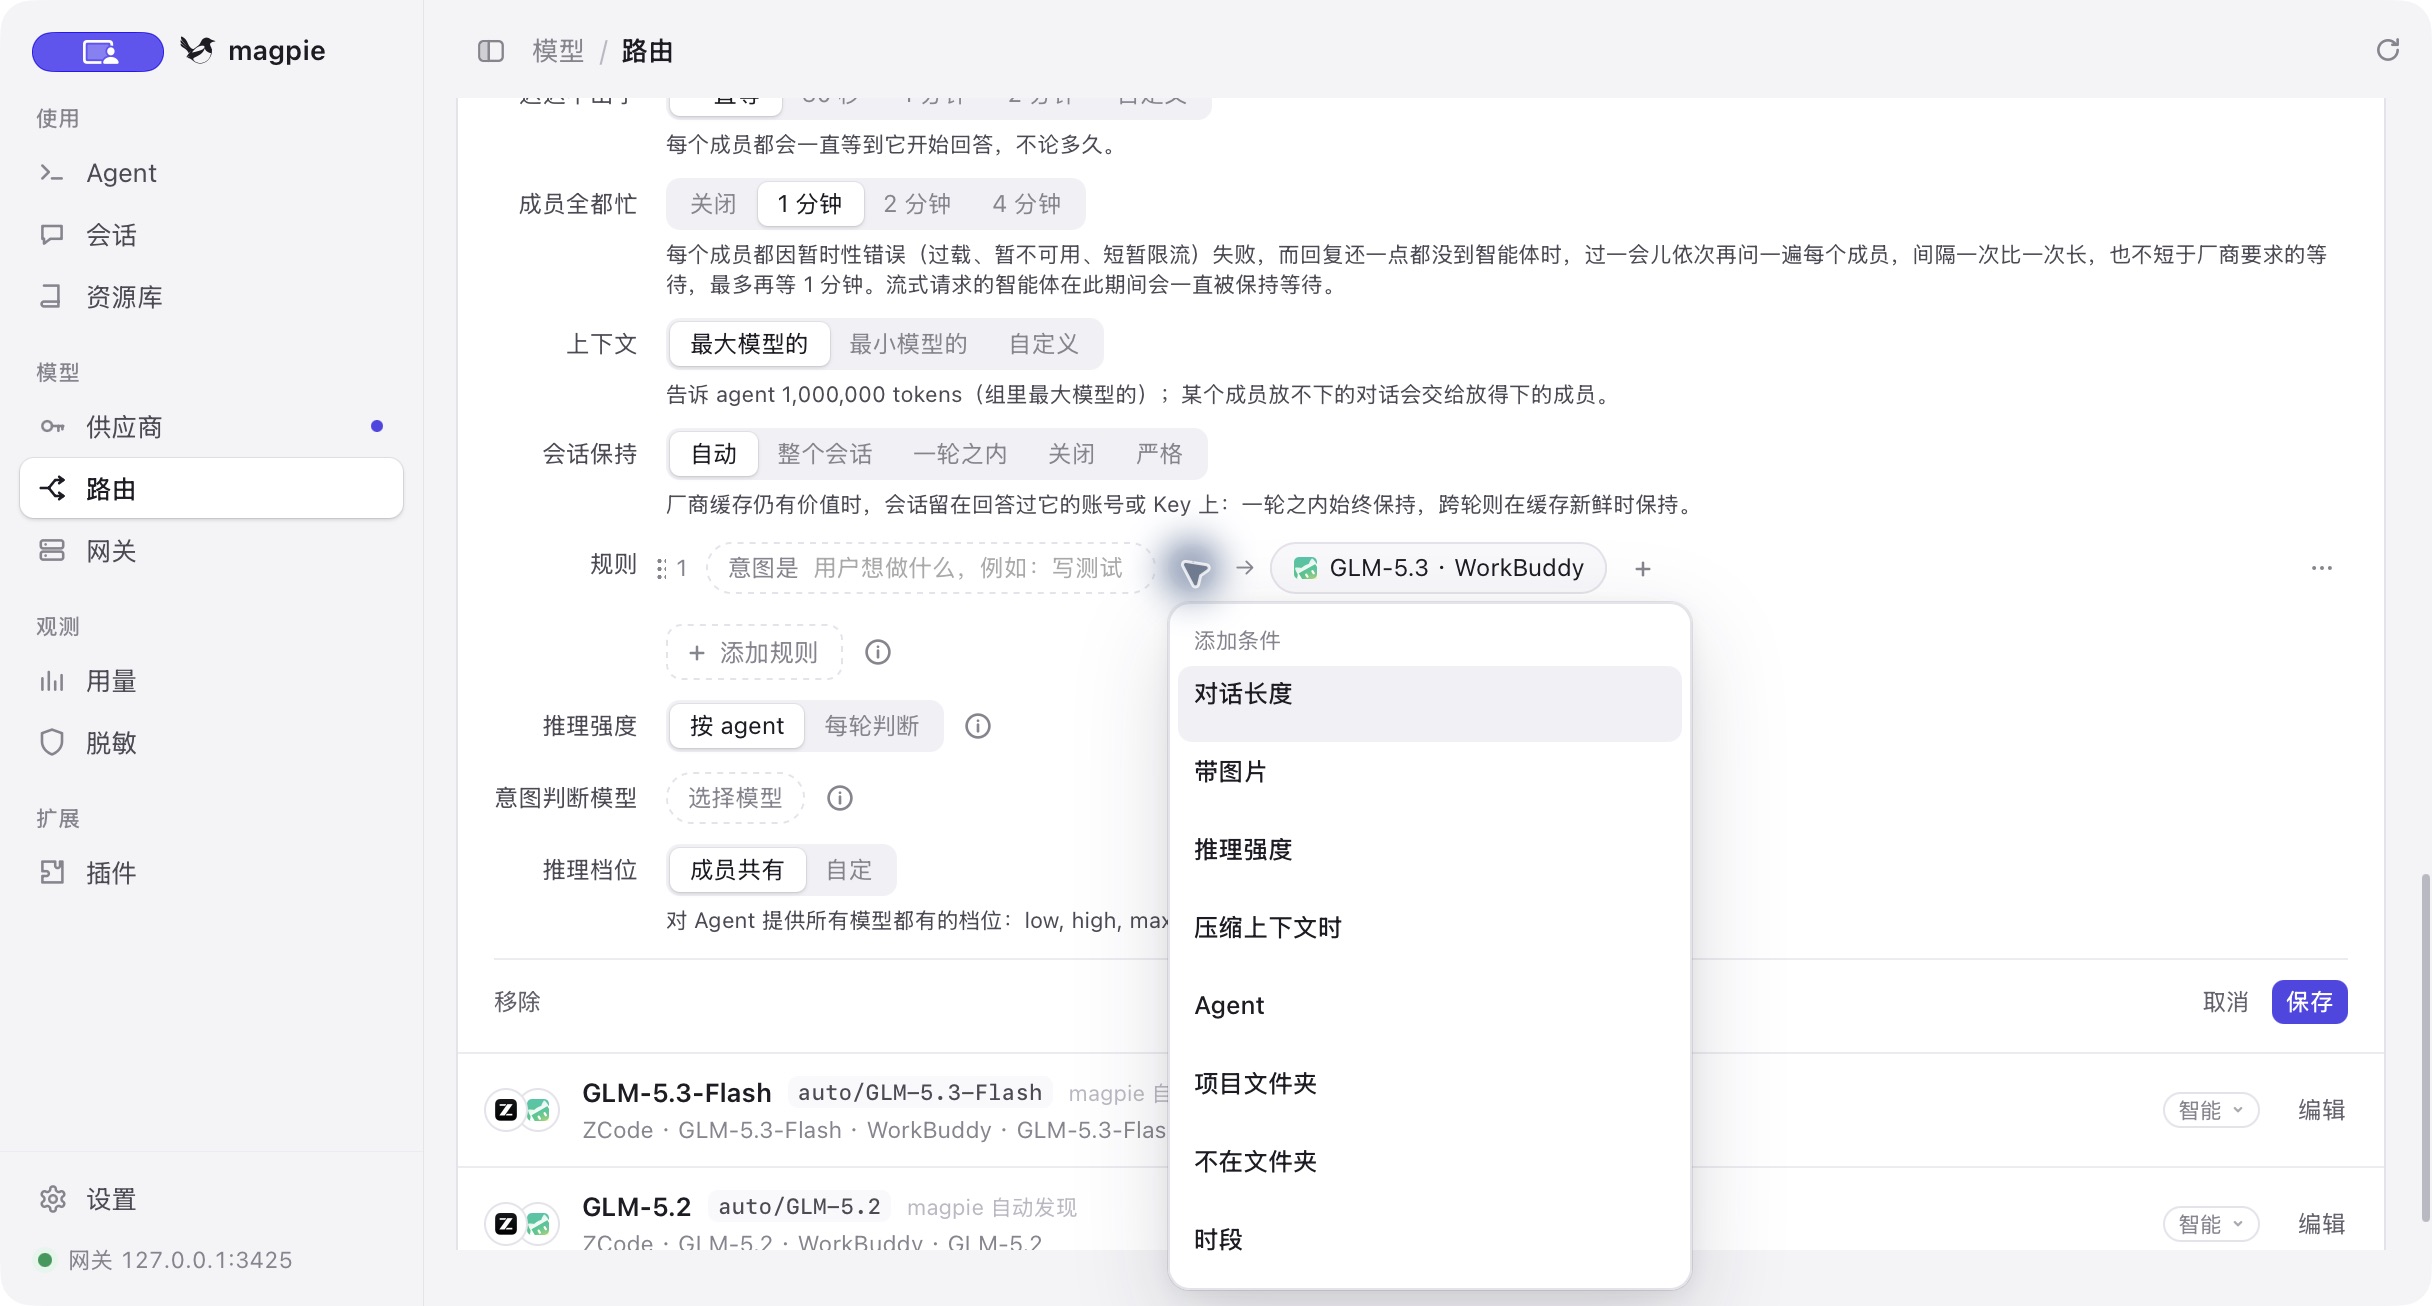
从 v0.1.1667 的网关源码实现来看,每一轮用户发新消息时,判断模型只会看到最新一条用户消息(截取前 3000 字符与后 1000 字符)以及经过截断的上一轮对话,用来理解“继续”“把刚才那个修一下”这类追问;系统提示词、思考内容、工具调用参数与结果以及 Claude Code 自动注入的 system-reminder 标签都会被剥离掉。
判断默认最多等待 8 秒(最高可调到 60 秒),得出的分类结果会在内存里缓存 10 分钟,同一轮后面的十几次工具调用全部复用这次决定;万一判断超时或报错,如果上一轮的意图还在本轮候选列表里就沿用上一轮意图,否则回退到默认规则,不会卡住正常提问。
因为每次判断都要多花一次轻量调用,你也可以在设置里把判断模型指向本地 Ollama 或 LM Studio 里的模型。
05、实时账本与套餐预热
以前用本地代理或配置工具时,请求到底发给了谁、为什么触发了切换、这轮对话花了多少 Token,往往是一笔糊涂账。
Magpie 把本机网关的运行状态全都摊开在了界面上。
在路由页面顶部有一条实时滚动的请求流水,Agent 经过网关发出的每一笔请求都会列在这里,清楚标明由哪个账号应答、命中了哪条路由规则、首字延迟(TTFT)和生成速率(TPS)是多少,以及中间经历过几次重试。
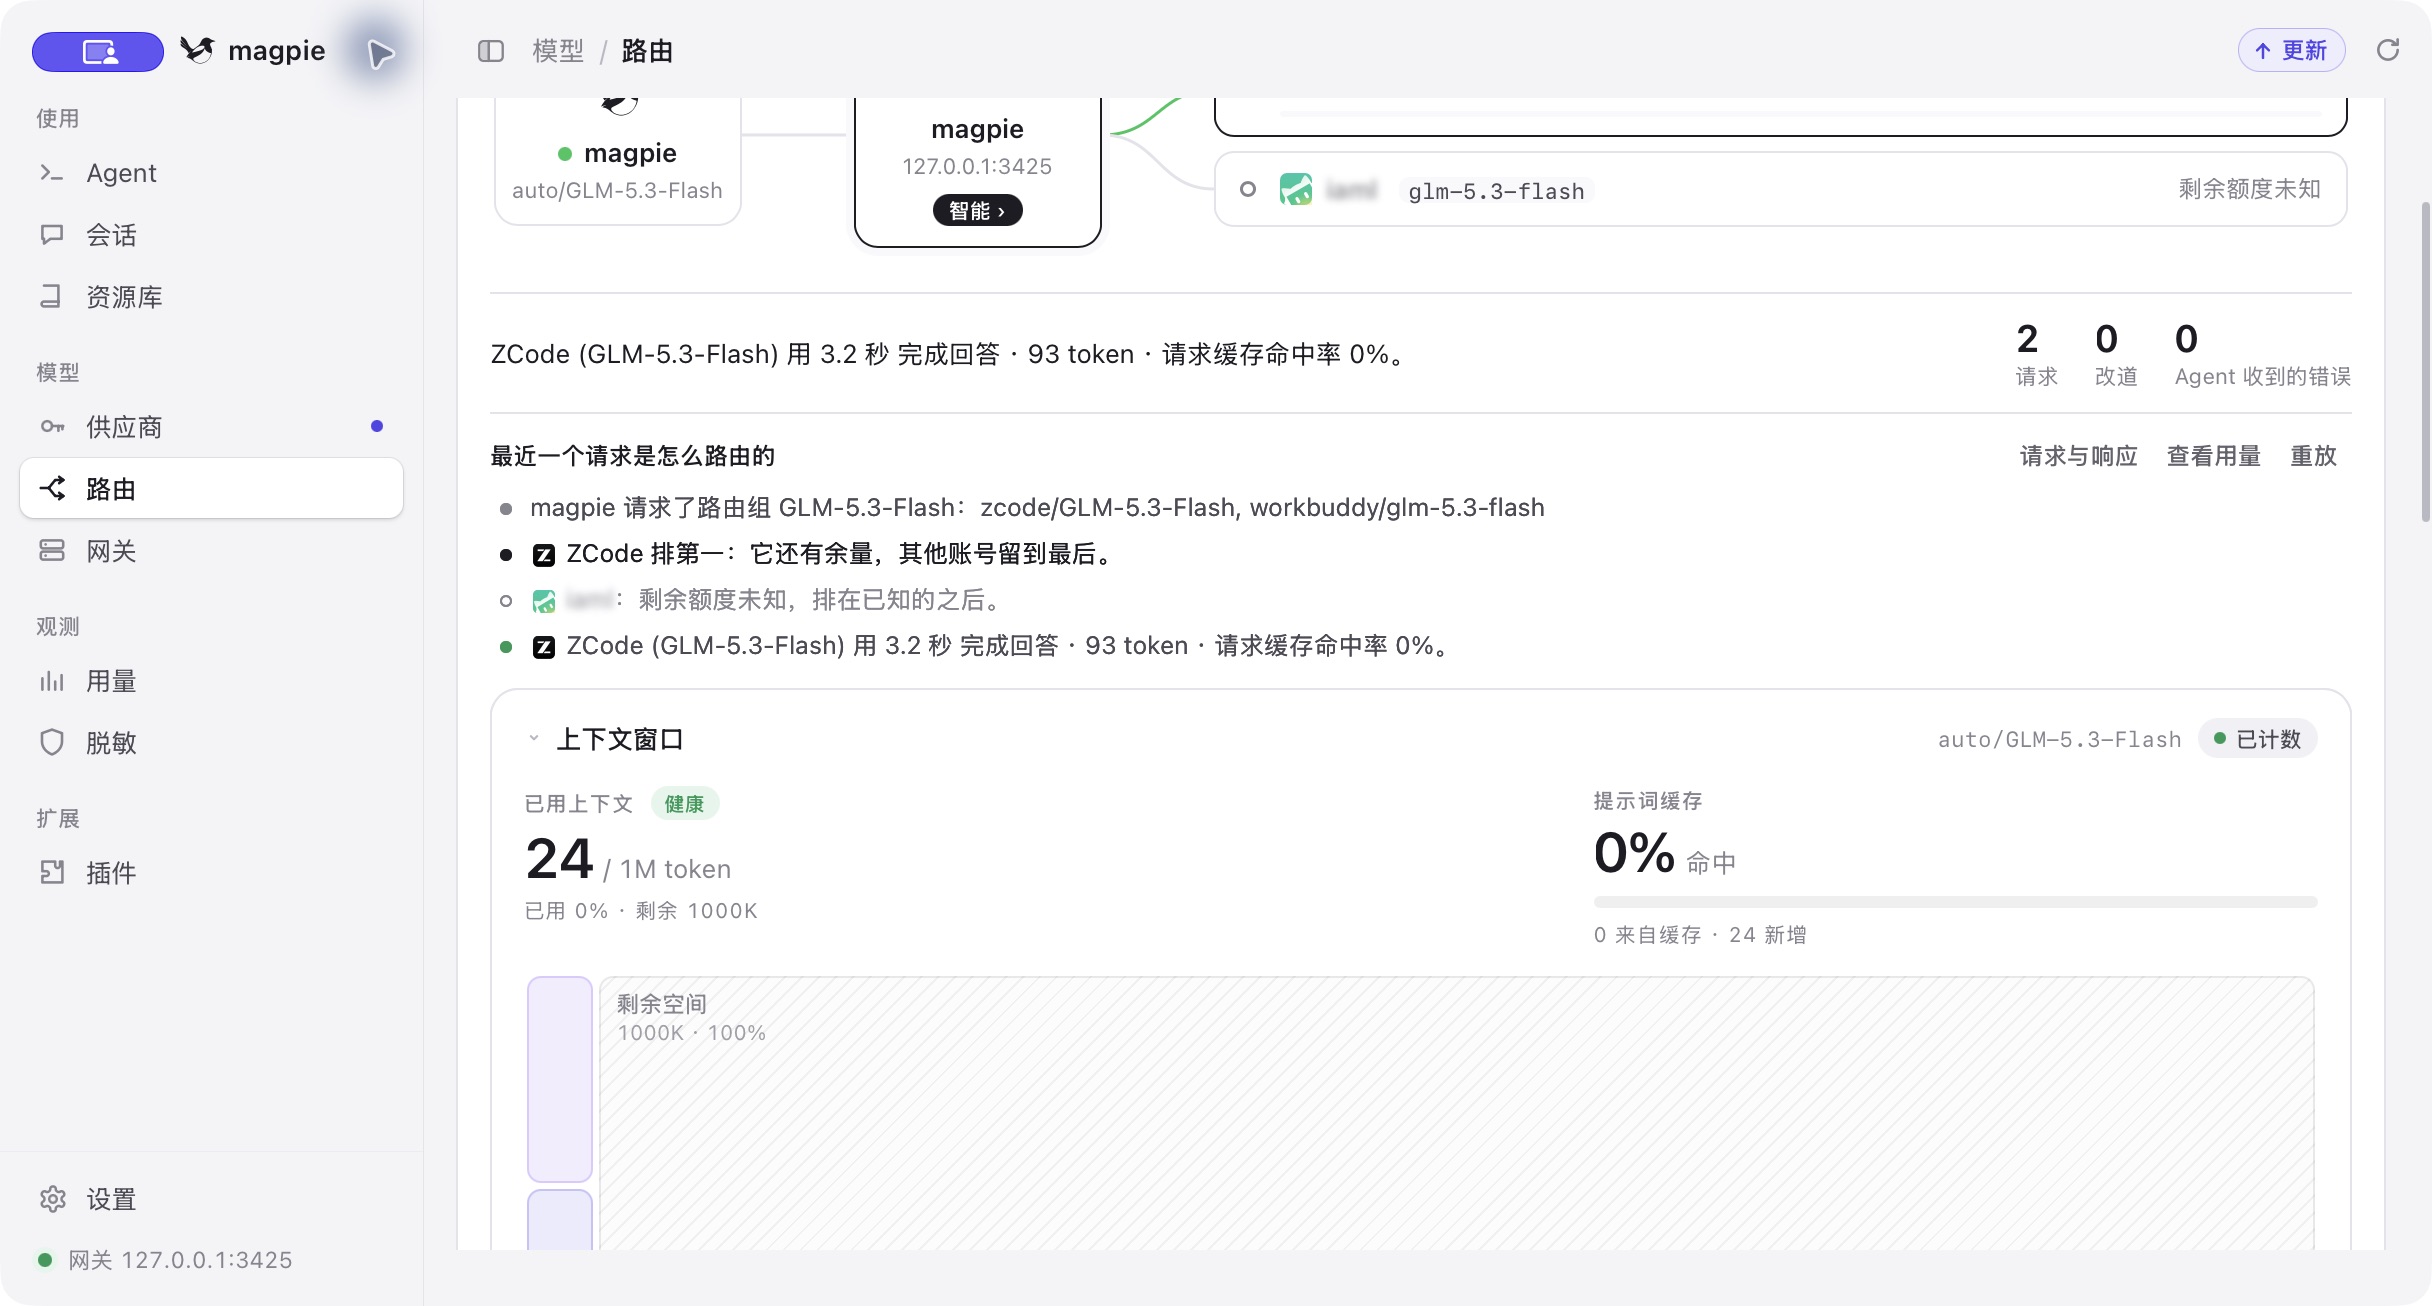
点开任意一条请求记录,下面会用可视化进度条把这笔请求的上下文结构拆解开,直观展示系统提示词、工具定义、历史消息、图片和当前输入各自占了多少比例的 Token;进入网关页,还能查看自动抹除密钥后的结构化原始 JSON 报文,排查工具调用报错或缓存未命中时都有记录可循。
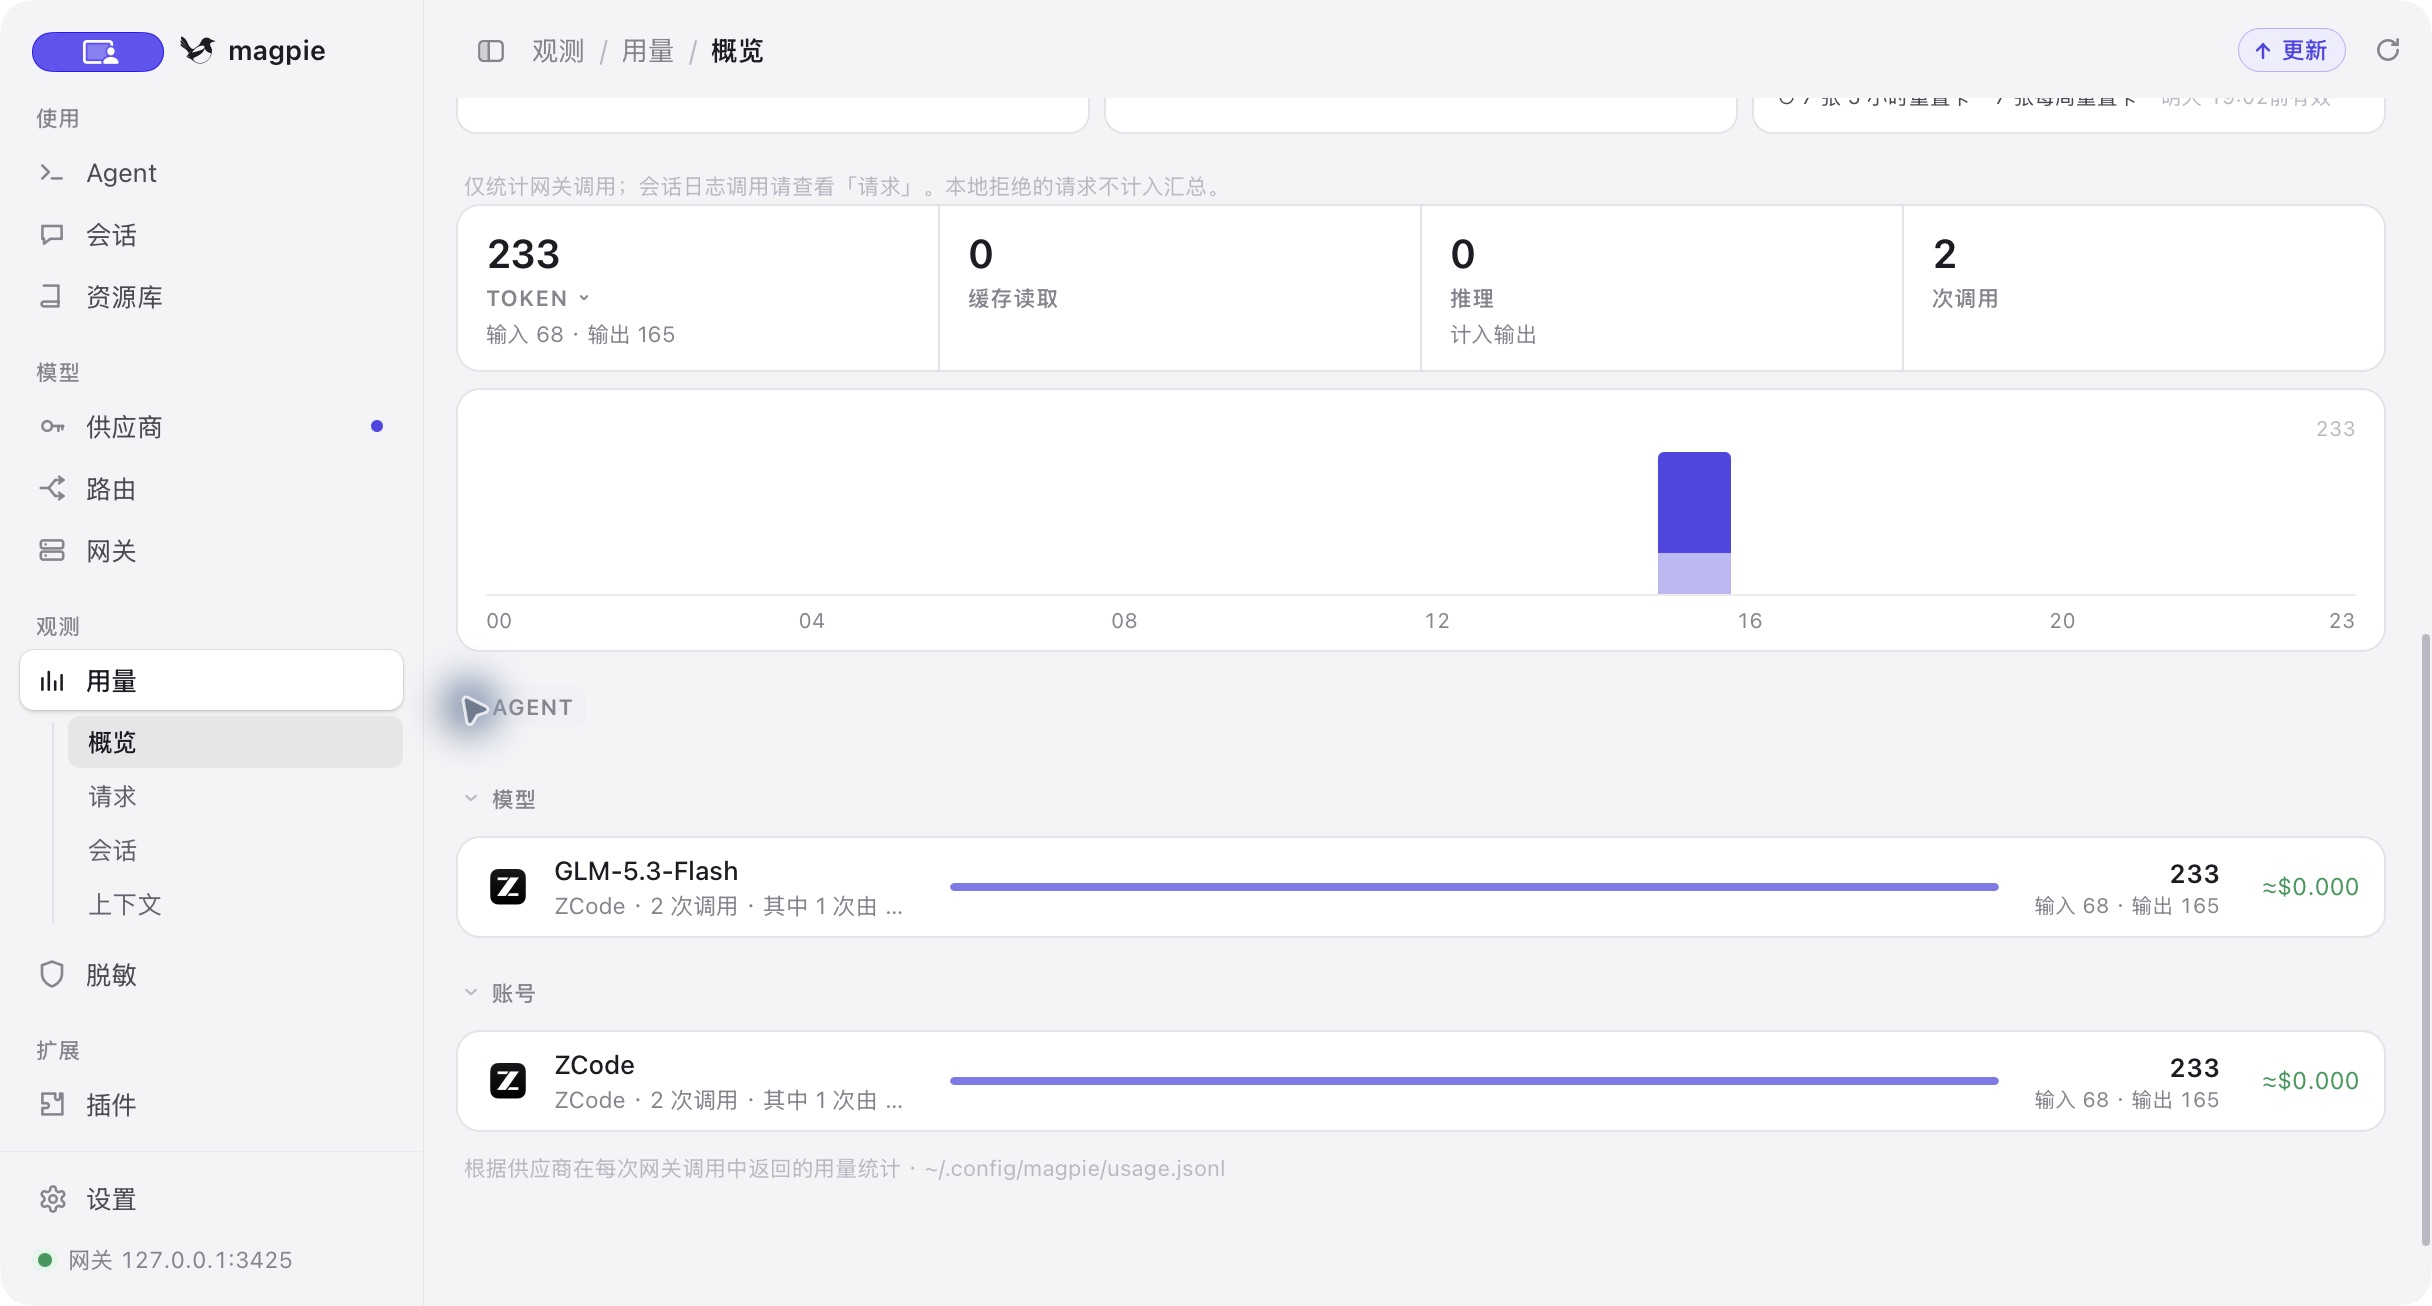
打开用量页面,则会按模型和账号汇总 Token 消耗、缓存命中率、折算费用,以及每个账号的尝试次数、成功次数、失败次数和距离下次额度重置的倒计时。
除了核心的路由和观测,它在系统托盘、套餐保活和隐私保护上也有几个很懂重度用户的细节。
系统菜单栏上只留了一个清爽的喜鹊图标,鼠标悬停上去就能看到当前订阅还剩多少额度,点开是 390×580 的快捷面板,不用每次都把主窗口翻出来。
如果你用的是支持额度重置卡的订阅,卡片上会显示还剩几张重置卡、什么时候过期,打开自动使用重置卡开关后,当周额度用尽且没有其他可用账号,或者重置卡快要过期作废前,它会自动帮你用掉重置卡恢复额度。
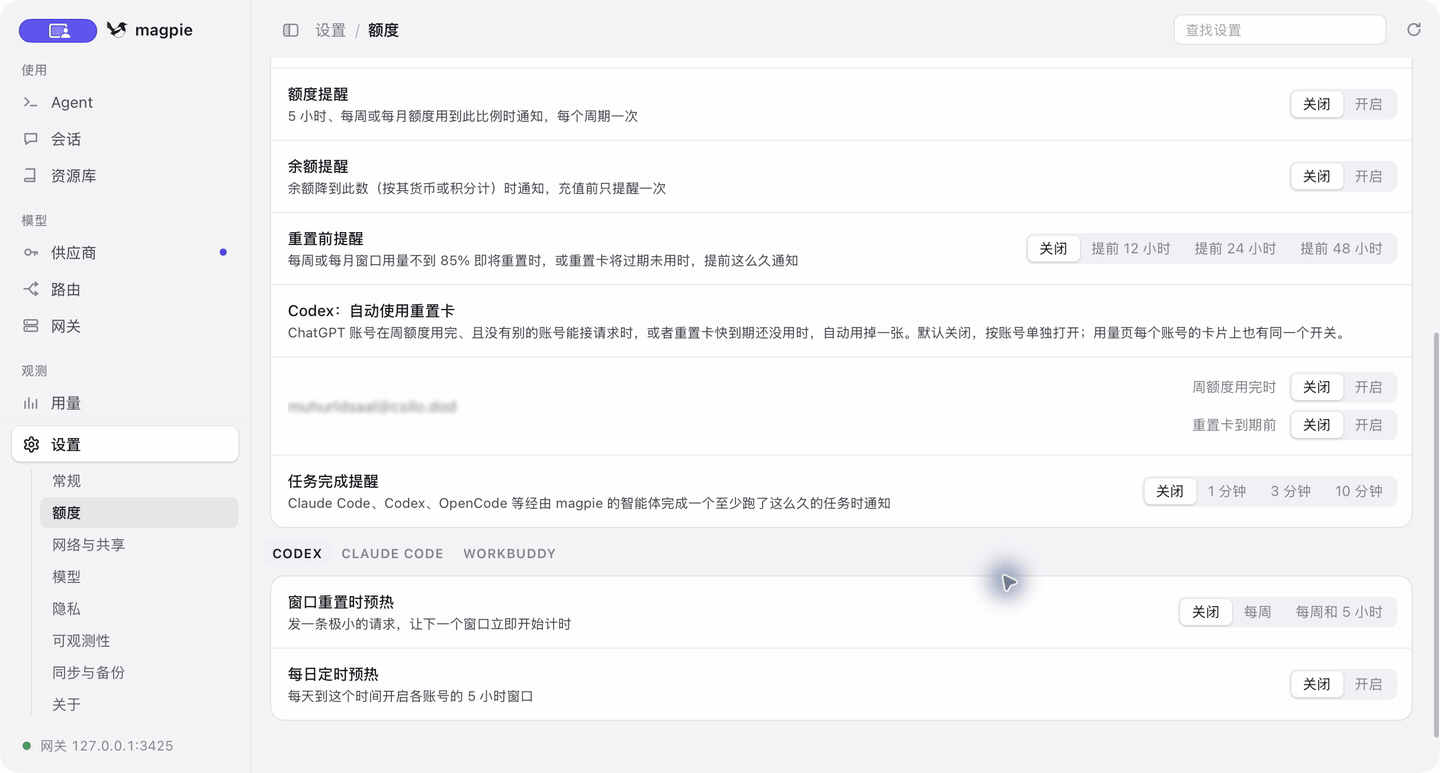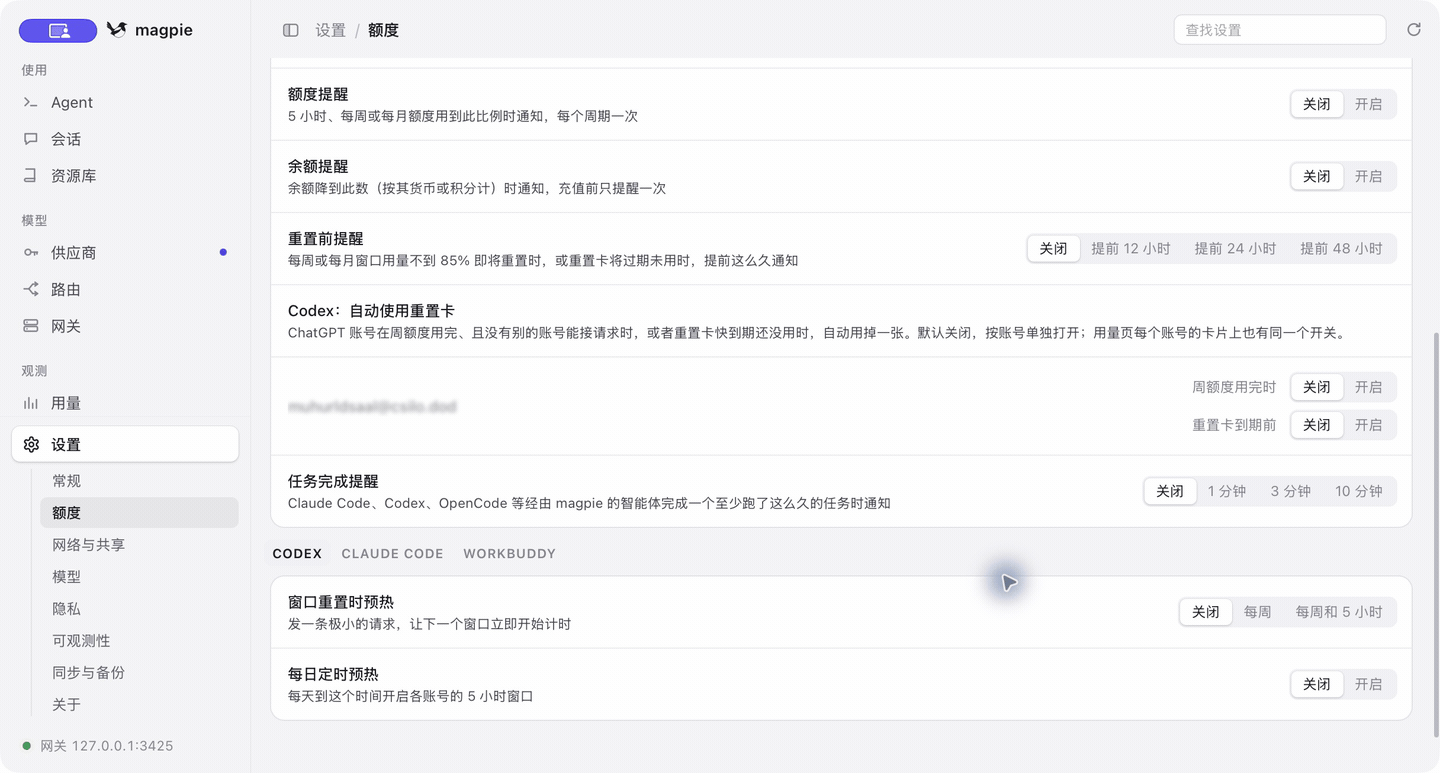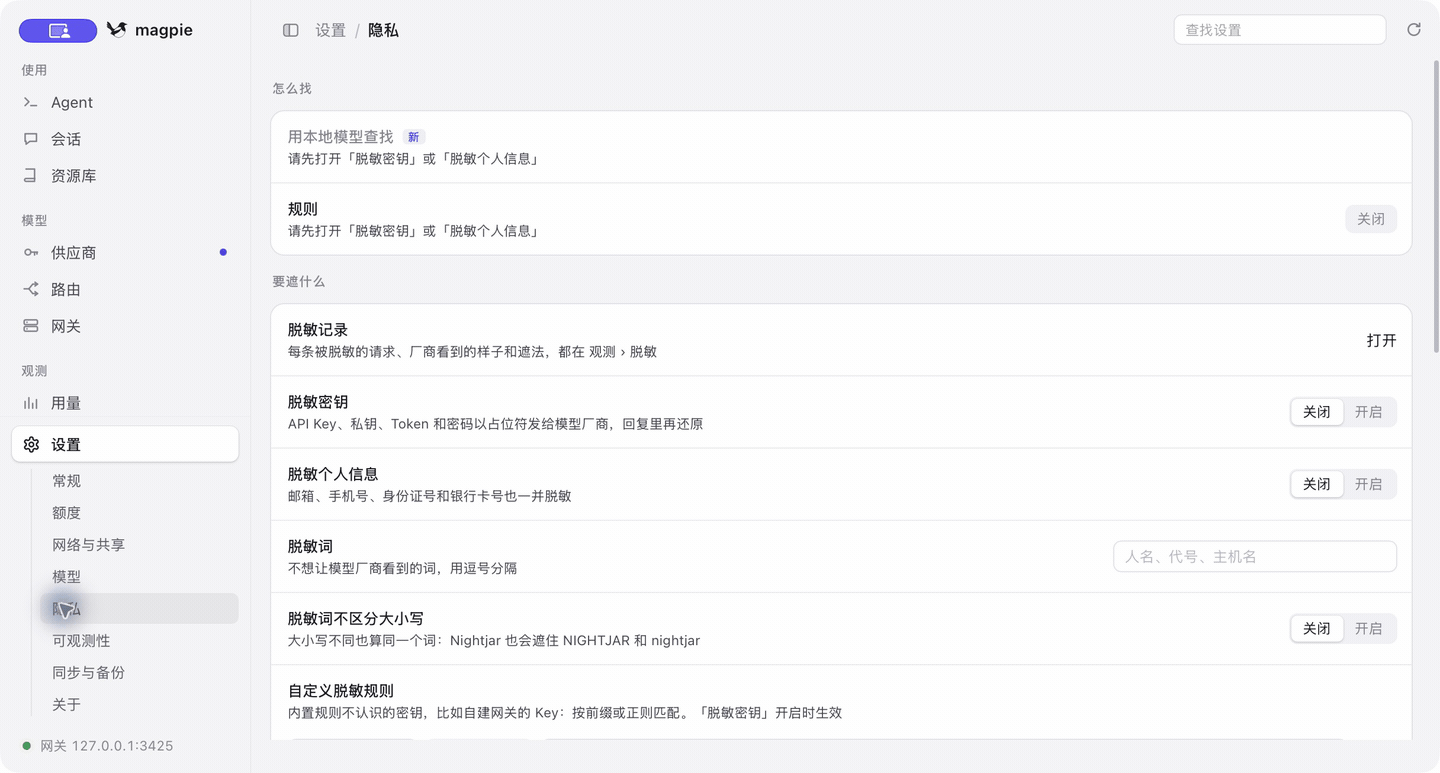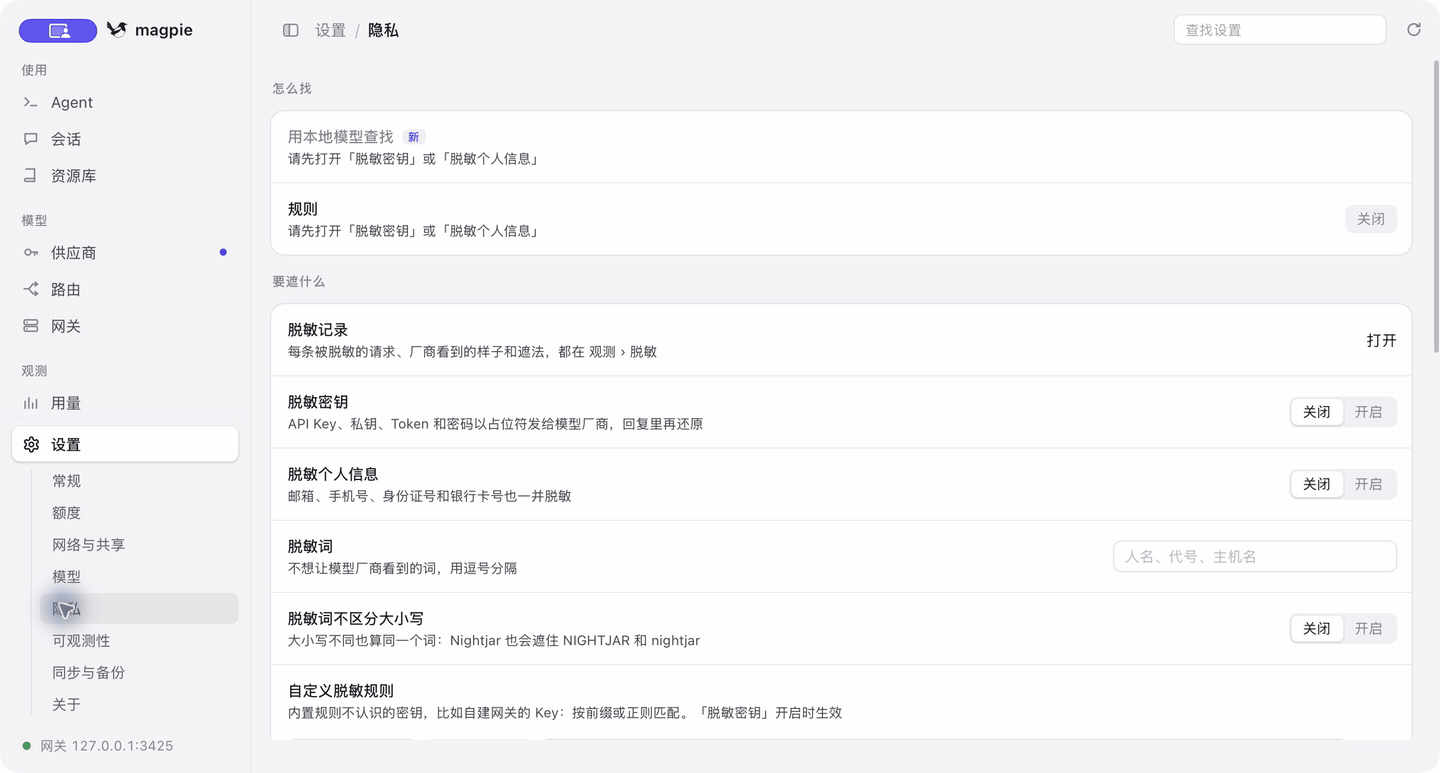
针对像 Claude 和 Codex 这种按首次请求才开始启动 5 小时额度窗口计时的订阅,设置里提供了两项预热功能。
开启“窗口重置时预热”后,每当上一个 5 小时窗口重置,它就会自动发一条极小的请求把下一个窗口的计时启动起来;开启“每日定时预热”并设好固定时间(比如早上 6 点,即使电脑当时在睡眠,唤醒后 1 小时内也会自动补发),早上 9 点打开电脑写代码时,第一个窗口已经计时了 3 个小时,等你高强度用完第一个窗口的额度,11 点刚好无缝接上第二个 5 小时窗口,一天之内能错峰用满三个窗口的额度。
此外,隐私设置页还内置了基于本地 39MB 量化模型的隐私脱敏开关,开启后能在请求发往云端前把代码和提示词里的姓名、邮箱、密钥、内部域名替换成占位符,等收到流式响应时再实时还原回来。
ending
说说我的真实感受。
AI 时代,推陈出新的速度非常快,一个新的模型很快淘汰一个旧的模型,一个新的产品很快淘汰一个旧的产品。
所以,目前的这个阶段,大家都在积极寻求改变,寻求抓住 AI 这波浪潮。
希望你我都能找到趁手的工具,趁手的模型,趁手的 Agent,从而让我们站在风口浪尖。
我们下期见。