
Codex 最新焚决发布,快!
大家好,我是二哥呀。
昨天刷到 G 哥分享的一篇 Codex 焚诀,标题叫《Rethinking skills and prompts for GPT-6 Astra》。
第一时间就去实践了一波,效果显著。
确实,模型能力变强后,Skill 要少一些,Memory 中的一些陈旧的记忆也要删掉,还有 AGENTS.md 和 CLAUDE.md 也要精简一下。
来,一起实践下吧。
第一步,在 Codex 中输入以下提示词:
按照这篇焚诀:https://developers.openai.com/blog/rethinking-skills-and-prompts-for-gpt-6-astra 审查当前项目的 AGENTS.md 和 Skills,找出过宽的 Skill 触发、无关文档强制读取、重复检查、冲突规则,以及频繁要求确认的指令。逐条告诉我问题和最小修改建议,先不要改文件。
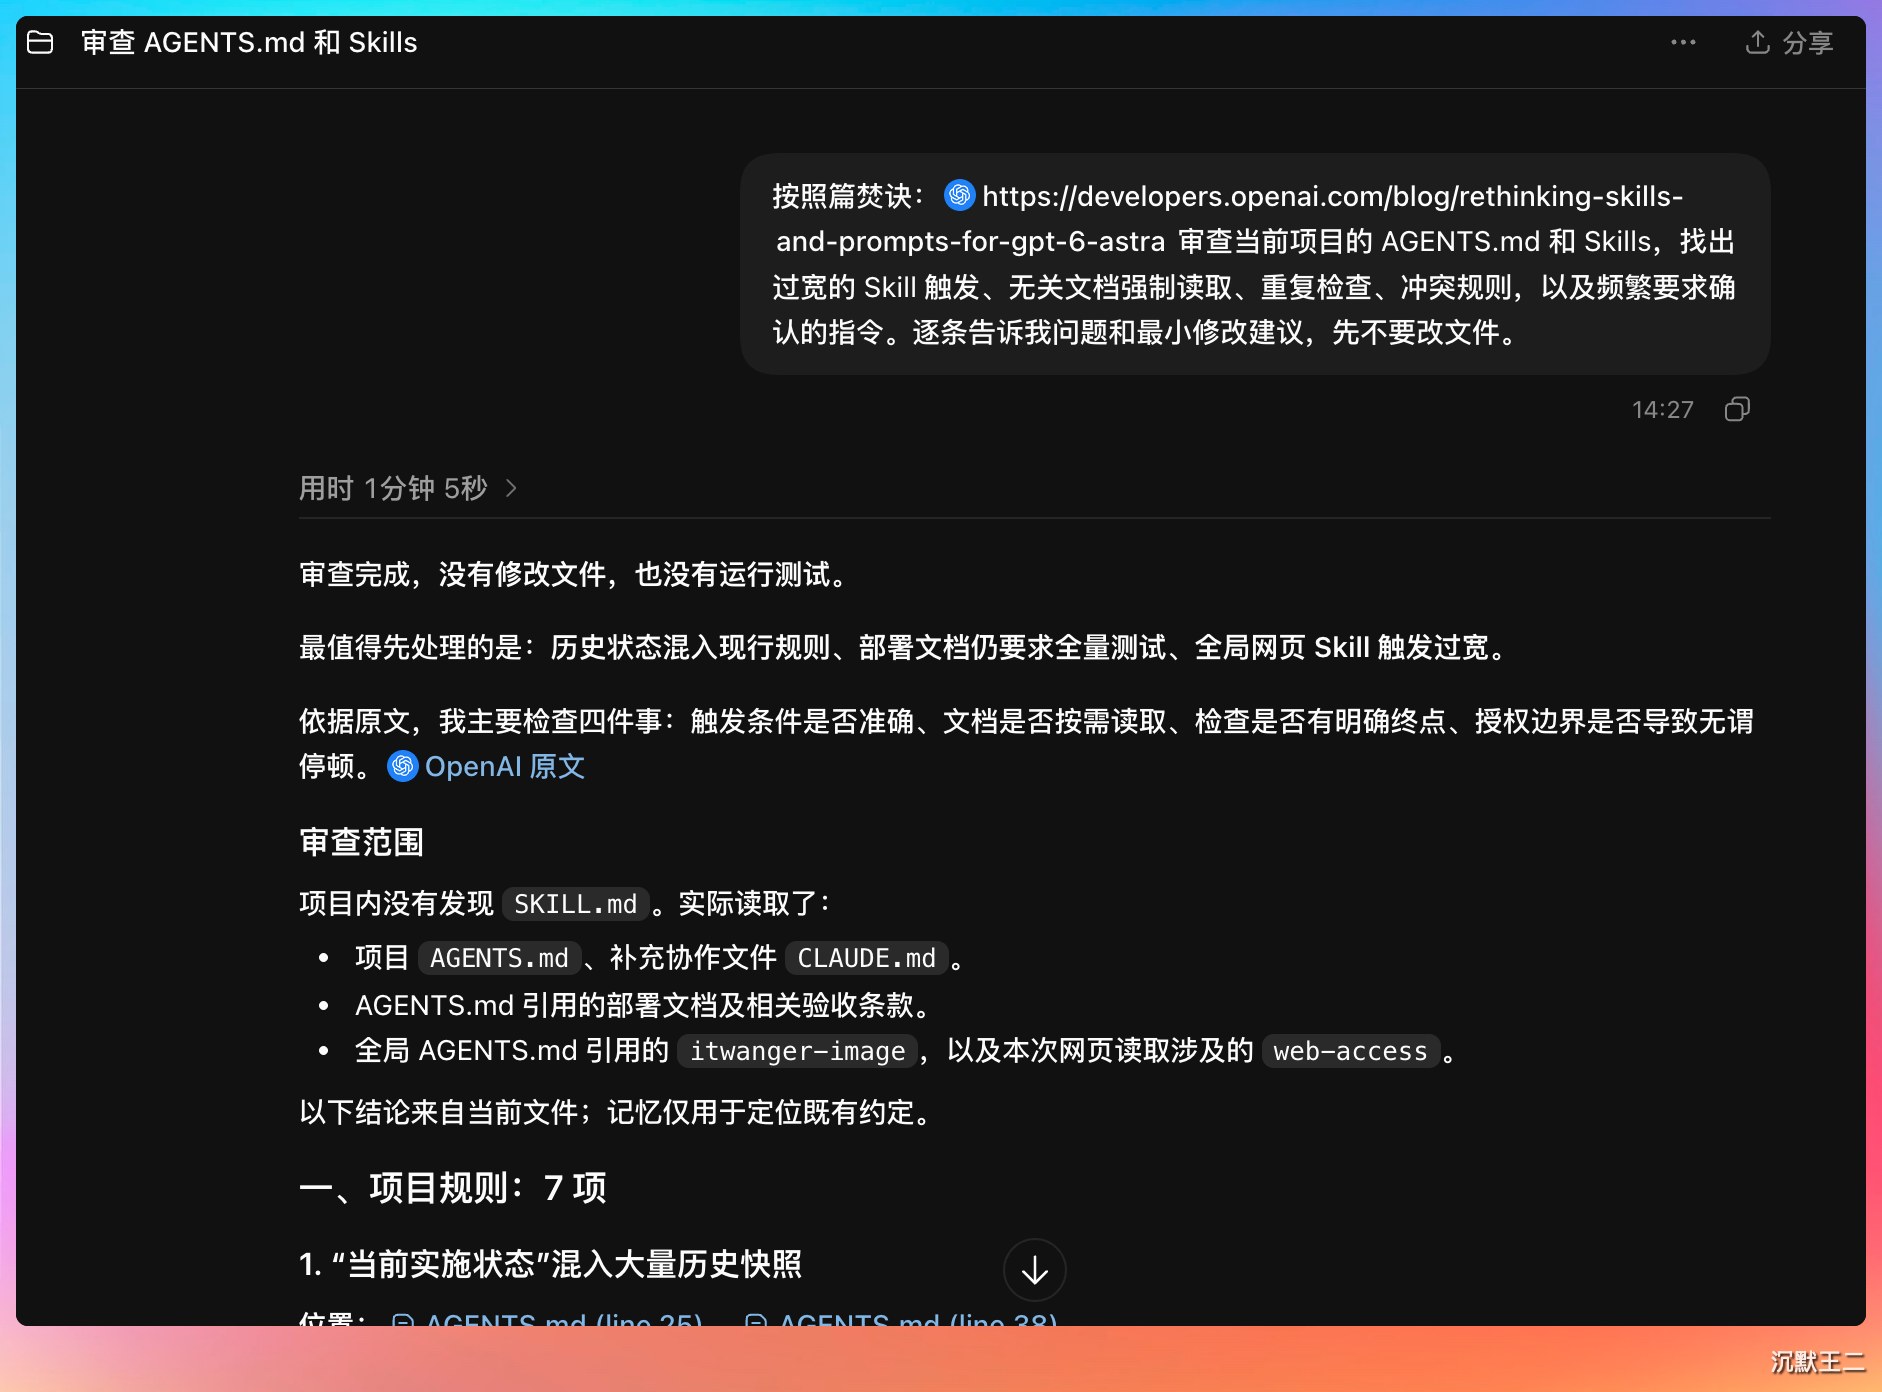
这样会找到很多需要修正的 Skills 细节,以及 AGENTS.md 的优化方案。
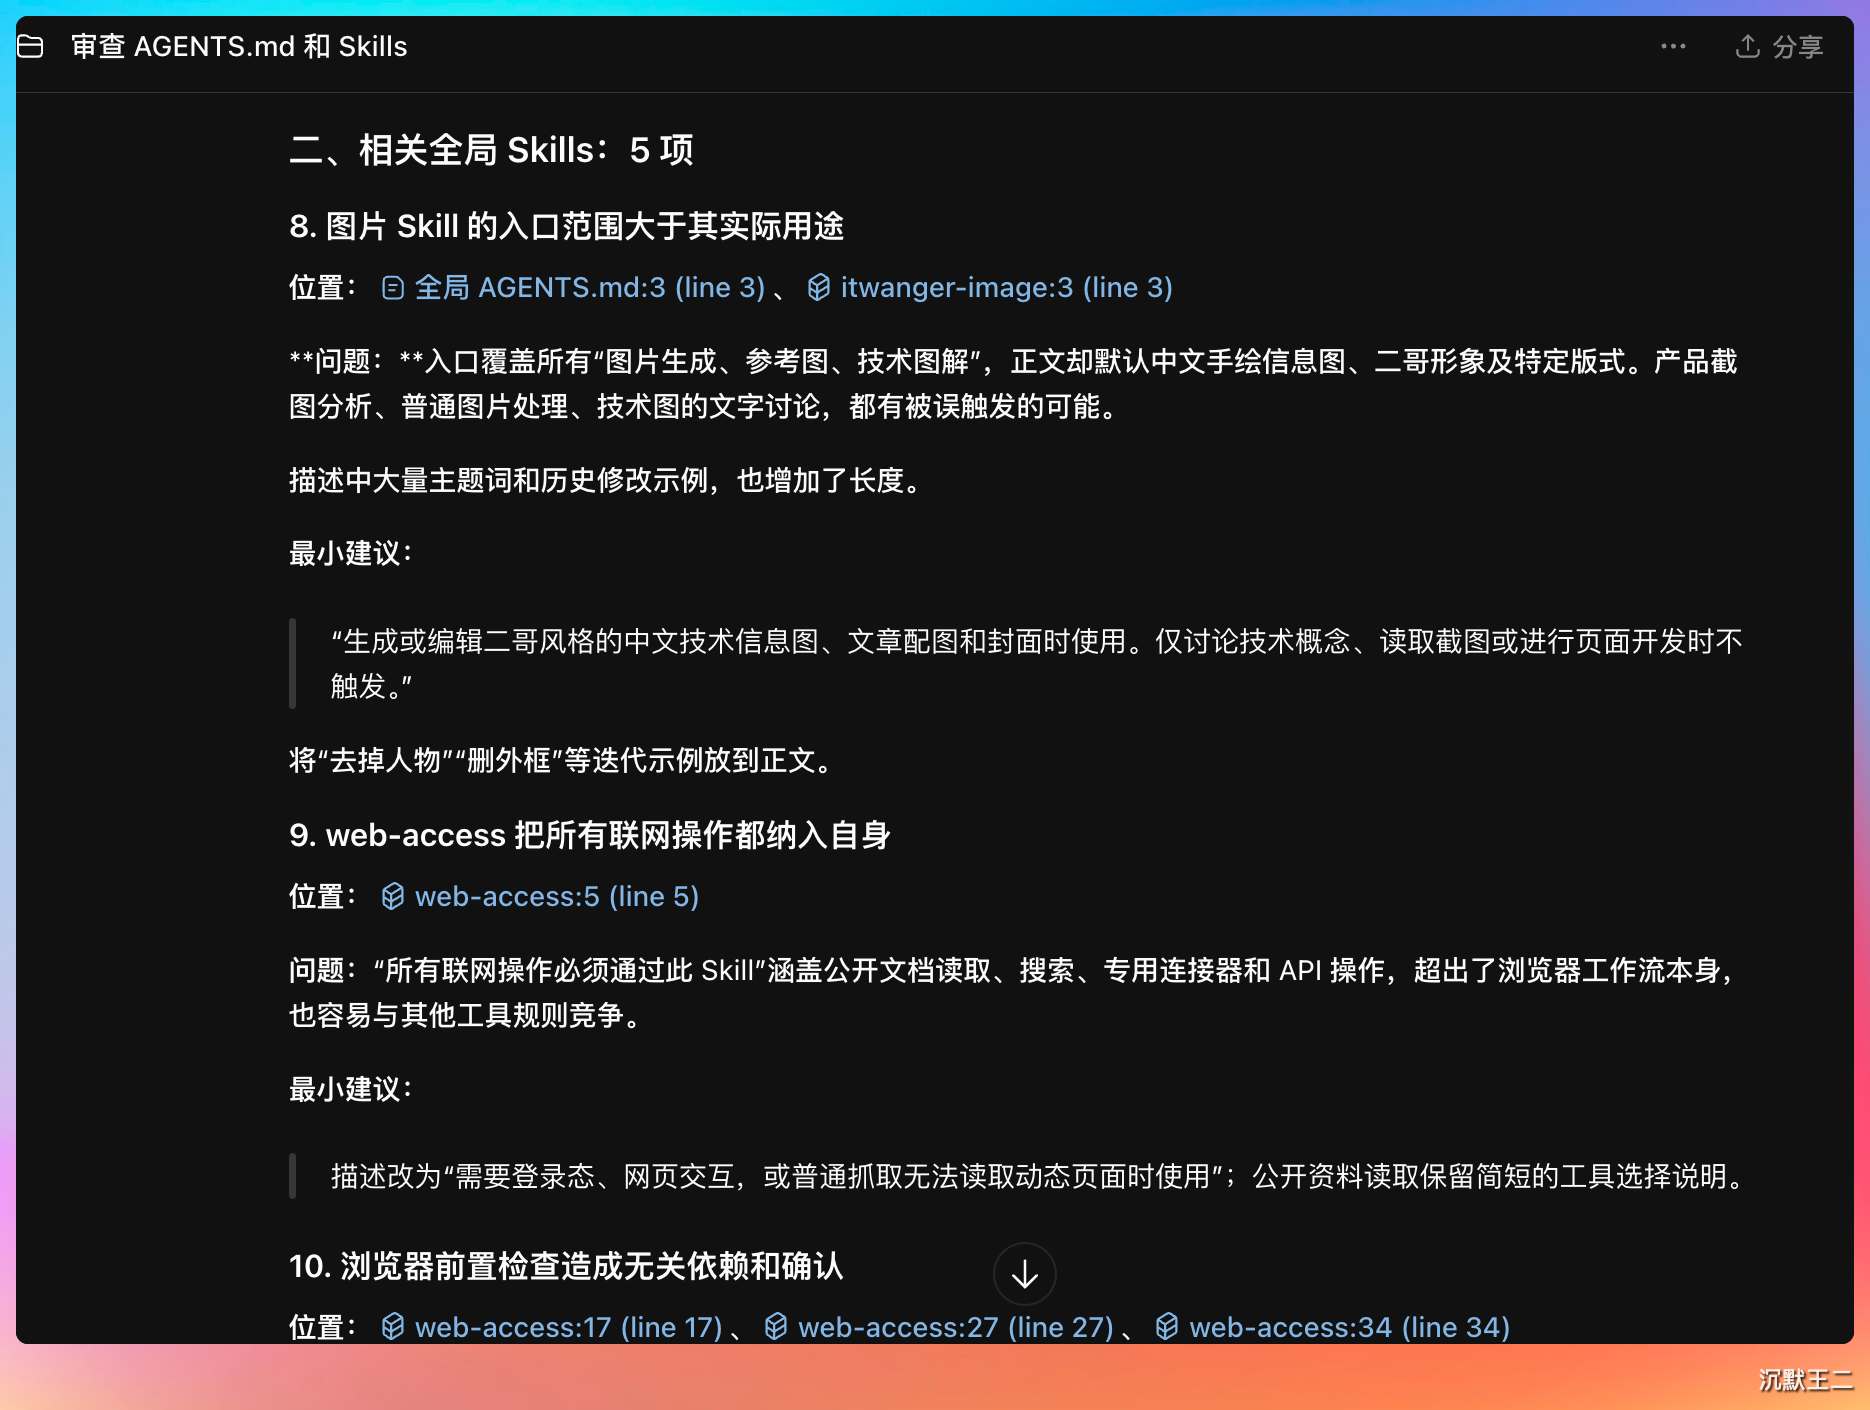
第二步,输入以下提示词。
根据刚才的审查结果优化 AGENTS.md 和 Skills。缩小 Skill 触发范围,删除无关文档读取,合并重复检查,解决冲突规则,并减少低风险任务中的无意义确认。保留安全边界、敏感操作确认和必要测试。修改完成后列出具体改动
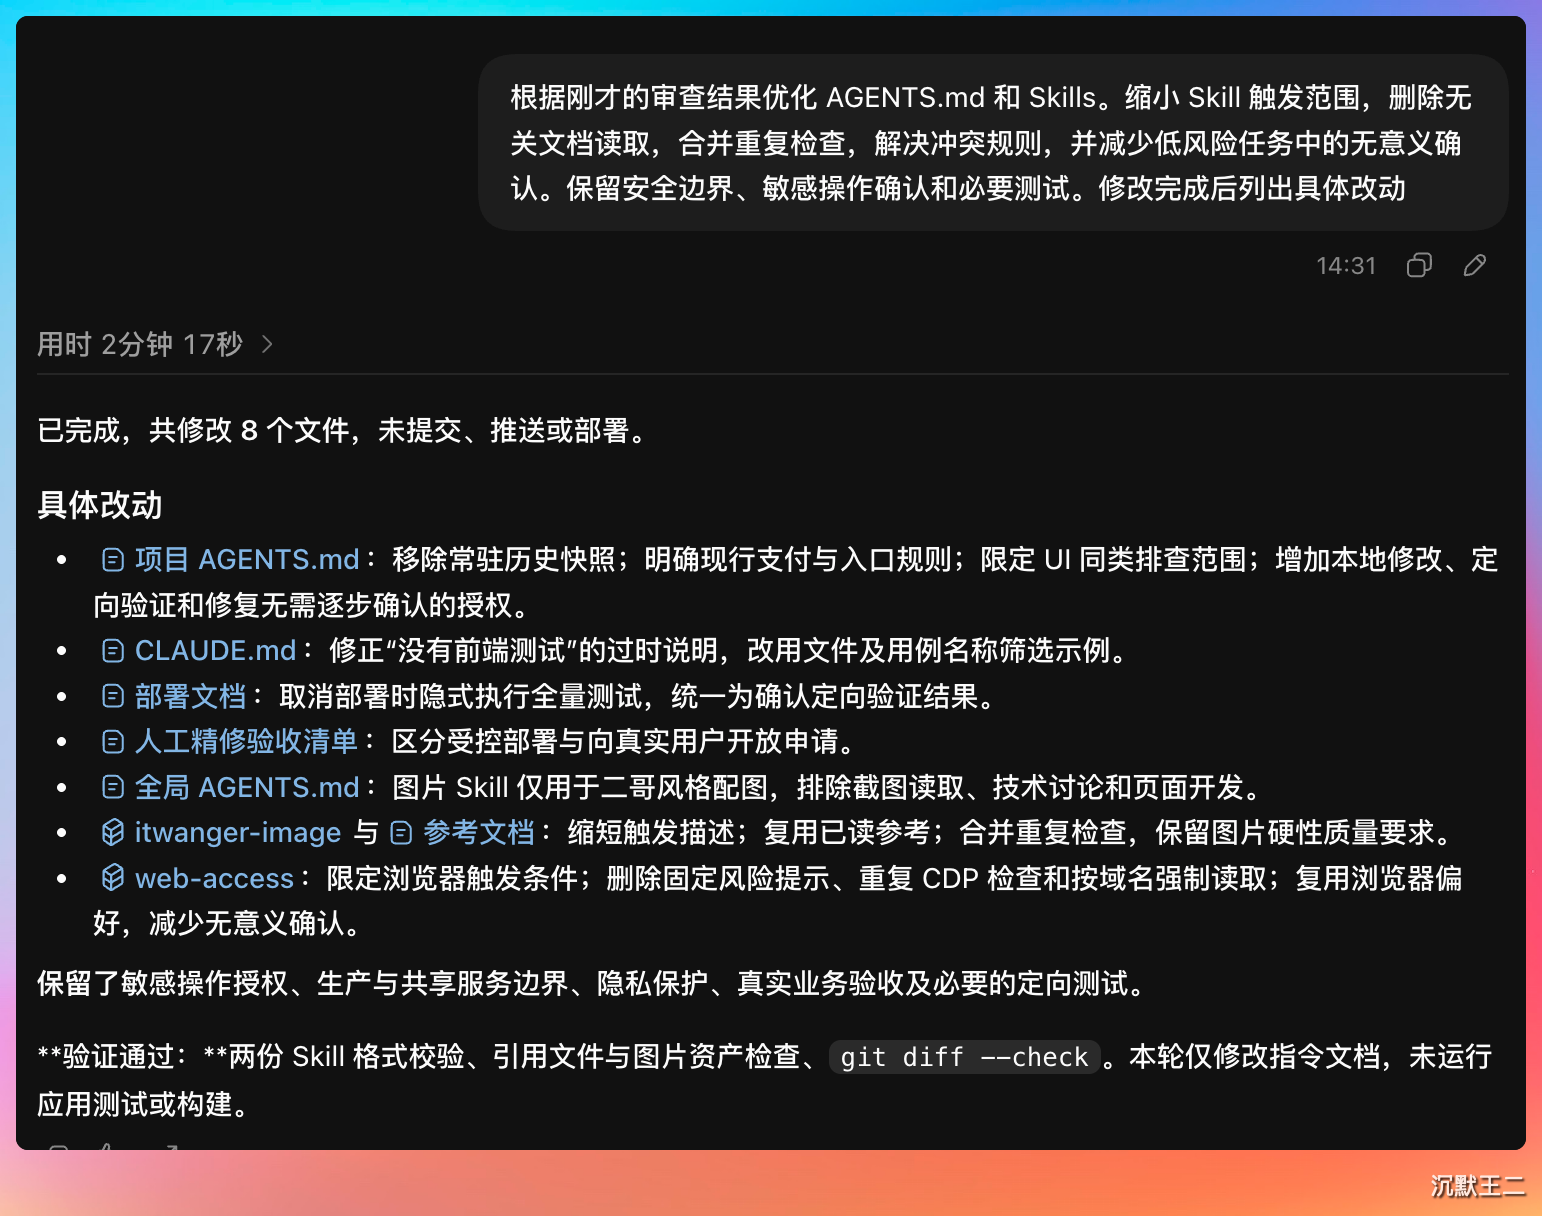
这样就算是瘦身成功了!
建议先挑一条有明确依据的建议改掉,然后用一个你熟悉的日常任务跑一遍,观察模型的行为有没有变化。确认没问题了再改下一条。
主要优化四个方向。
第一,Skill 的触发描述要收窄。比如说数据库迁移的 Skill,描述是「涉及数据库时使用」,那模型写个 SQL 查询也会触发它。
第二,AGENTS.md 里那些「每次修改前必须先读 XX 文档」的规则,在新模型上就是浪费上下文。GPT-6 Astra 能自己判断什么时候该读什么文档,不需要每次都强制它通读一遍。
第三,旧模型时代加的「必须先问我」「禁止自动执行」,在判断力更强的新模型上反而会让它过于谨慎。该放手的地方要放手。
01、给 Skill 描述做减法
先看 OpenAI 给的例子。
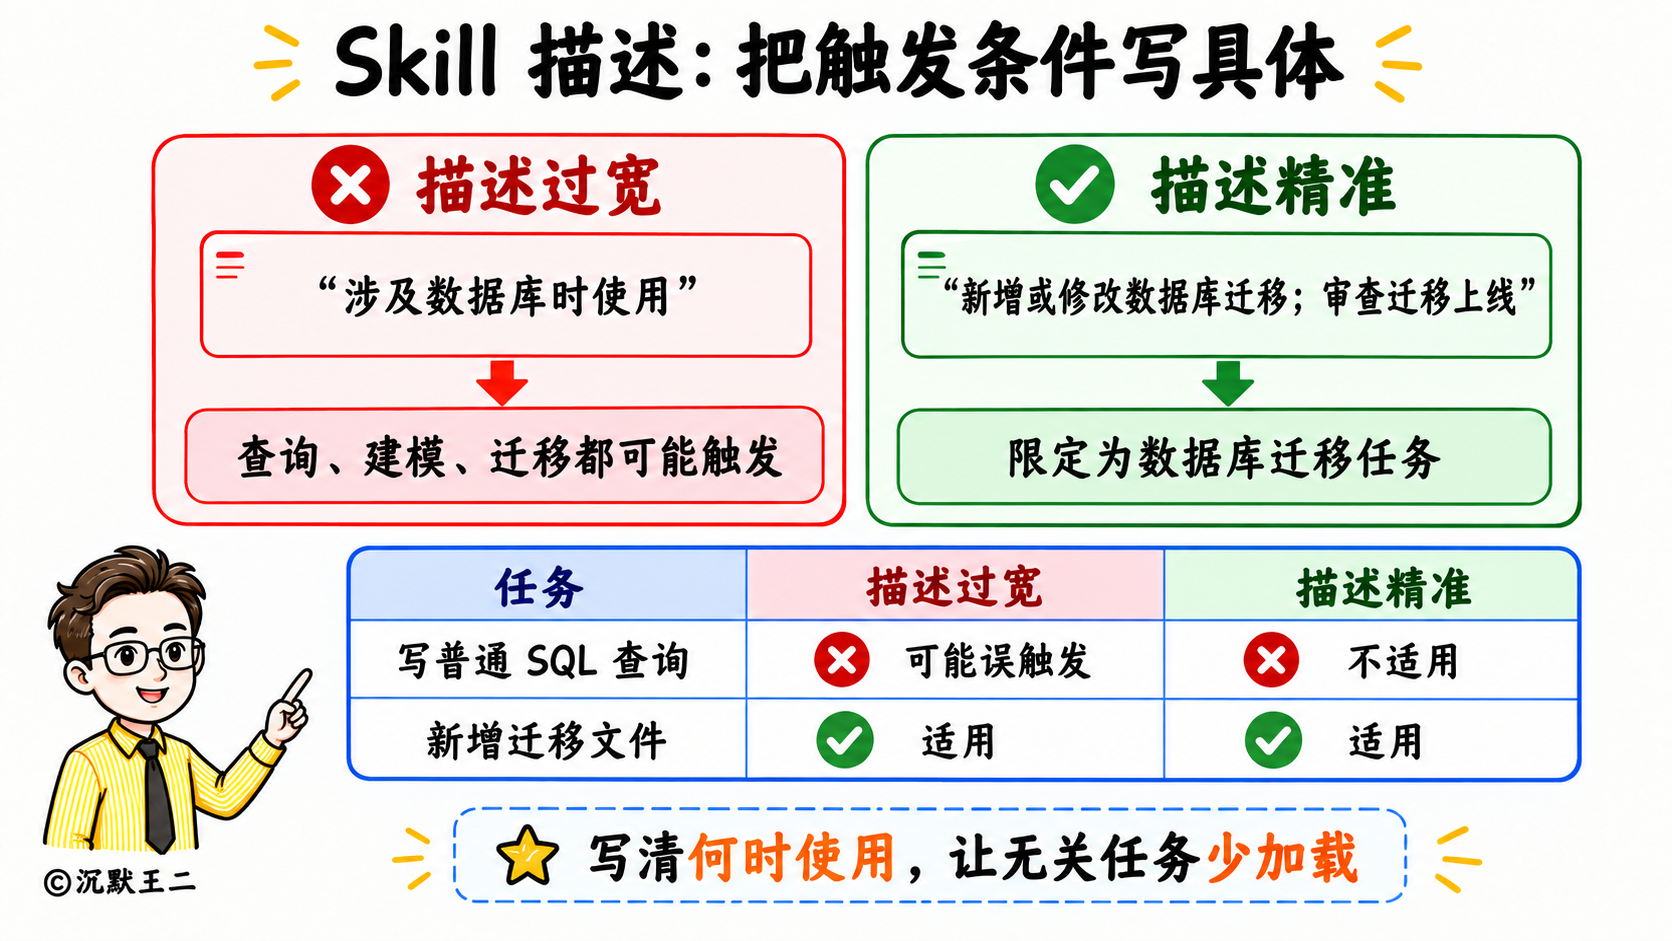
一个处理 Postgres 数据库迁移的 Skill,触发描述写成「涉及数据库、查询或数据模型时使用」。
看起来没毛病对吧?
问题是,用户只想写一条 SQL 查询语句,模型也会触发这个 Skill,把一整套迁移流程的指令加载进来。这些指令和当前任务完全不搭,白白浪费了上下文窗口。
OpenAI 给的改法是把描述收窄到「新增或修改迁移、审查迁移发布时使用」。触发条件和 Skill 实际要干的事匹配了,误触自然就少了。
我看了一眼 Claude Code 项目里的 Skills,类似的问题不少。
比如说 browser-act 这个 Skill,描述写了整整 4 行,触发条件覆盖了从「fetch URL」到「take screenshots」到「fill forms and click through workflows」几乎所有浏览器操作。只要任务里沾一点网页相关的事情,模型就会把它加载进来。
模型能力变强了,这些约束确实应该适当减少,毕竟模型变强的一部分原因就是它吸纳了那些优秀的 Skill。
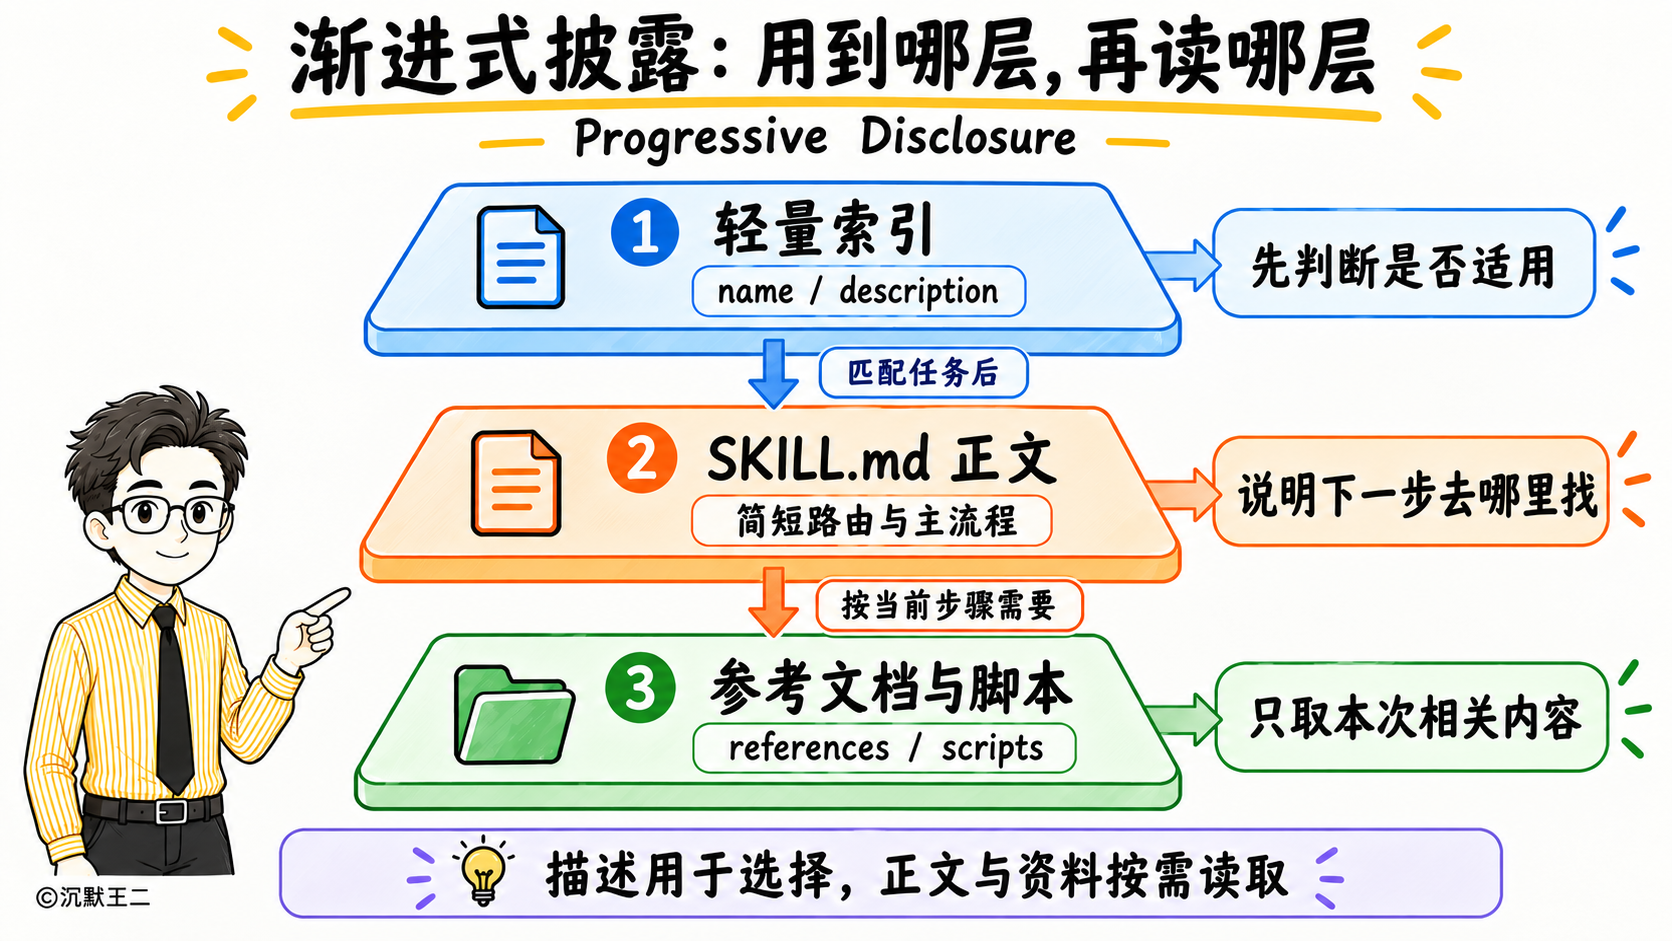
还有一点。很多 Skill 是在老模型时期写的,操作步骤恨不得精确到每一步。
新模型已经能处理模糊和复杂性了,过度详细的步骤清单反而会限制它的发挥。OpenAI 原文也提醒了一句:你留下的指令不只是给自己的模型看的,其他 Agent 也可能用到。对一个模型合适的约束,可能对另一个模型就是过度约束。
自检清单
- 每个 Skill 的描述能不能在一两句话内说清「做什么」和「什么时候用」?
- 有没有 Skill 的触发条件太宽,导致不相关的任务也会加载它?
- 多个 Skill 的描述有没有重叠?模型能不能分清该选哪个?
- 详细的操作步骤是放在子文档里,还是全塞在描述里?
02、CLAUDE.md 要瘦身
CLAUDE.md(Codex 对应的是 AGENTS.md)是全局规则文件,模型在项目里干活的时候,每次都会读它。
OpenAI 给了一个很典型的反面例子。
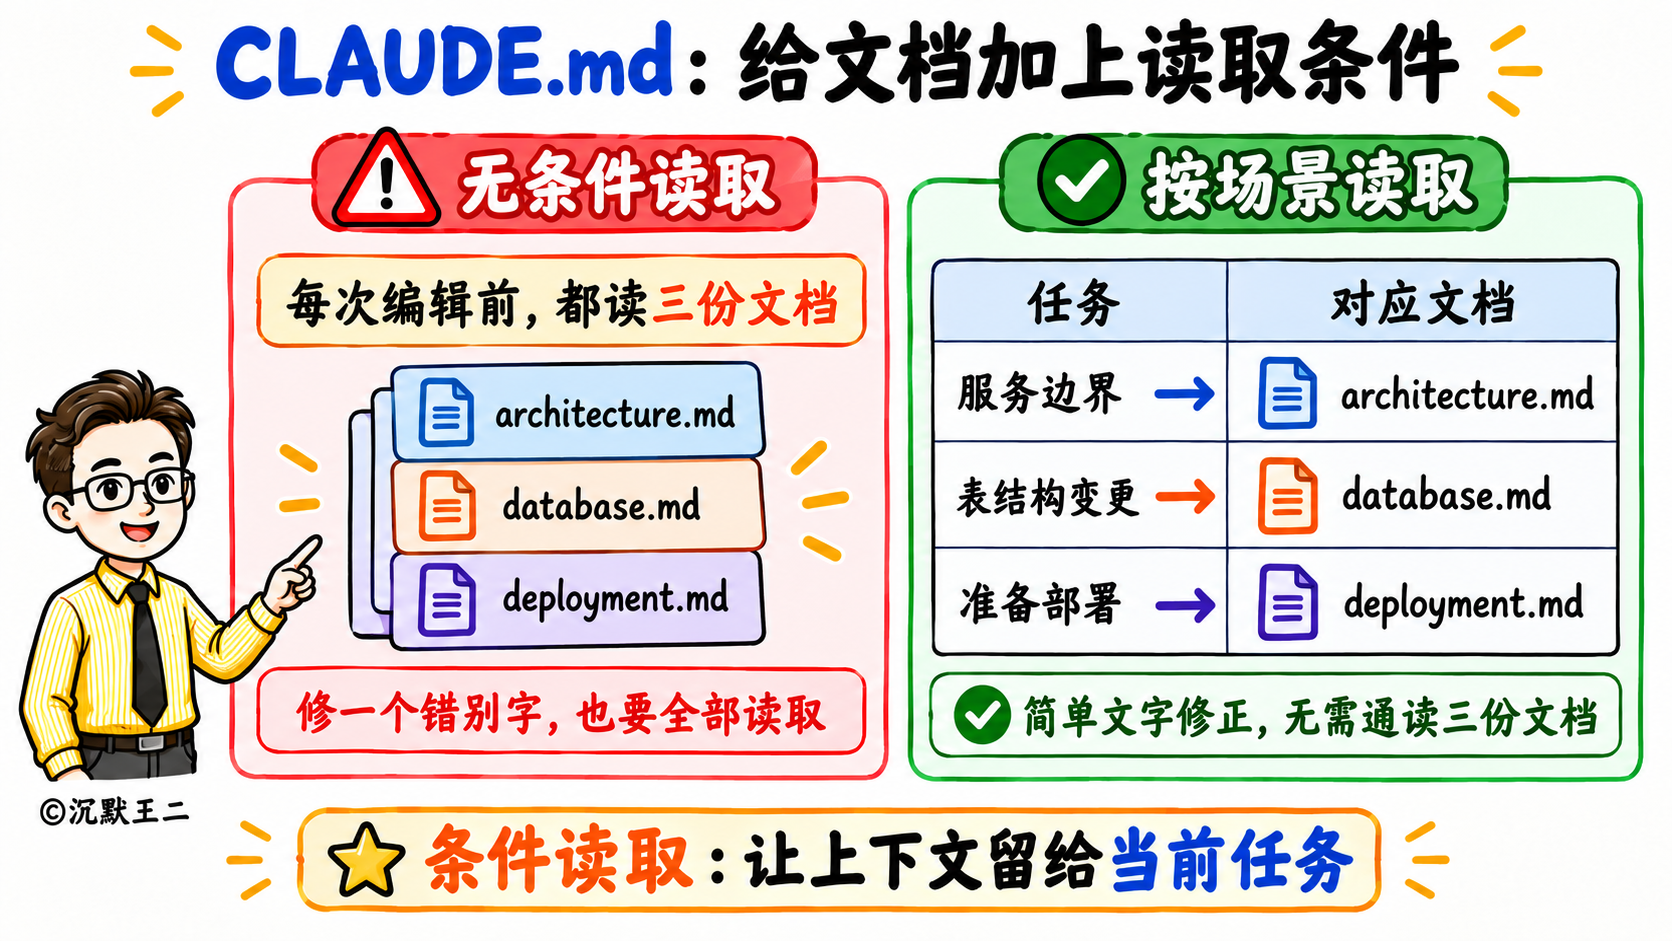
每次编辑前,都读 architecture.md、database.md 和 deployment.md。
改法是给每份文档加上读取条件。
涉及服务边界时读 architecture.md,修改表结构时读 database.md,准备部署时读 deployment.md。
前者不管改什么都要通读三份文档,后者只在确实需要的时候才加载对应的内容。
大部分小伙伴应该和我一样,在 CLAUDE.md 里写的都是限制和禁止。「不要 XX」「修改前必须 XX」「禁止自动 XX」。很少有人主动写「这件事你可以放心做」。
OpenAI 的建议是给安全的工作流显式授权。
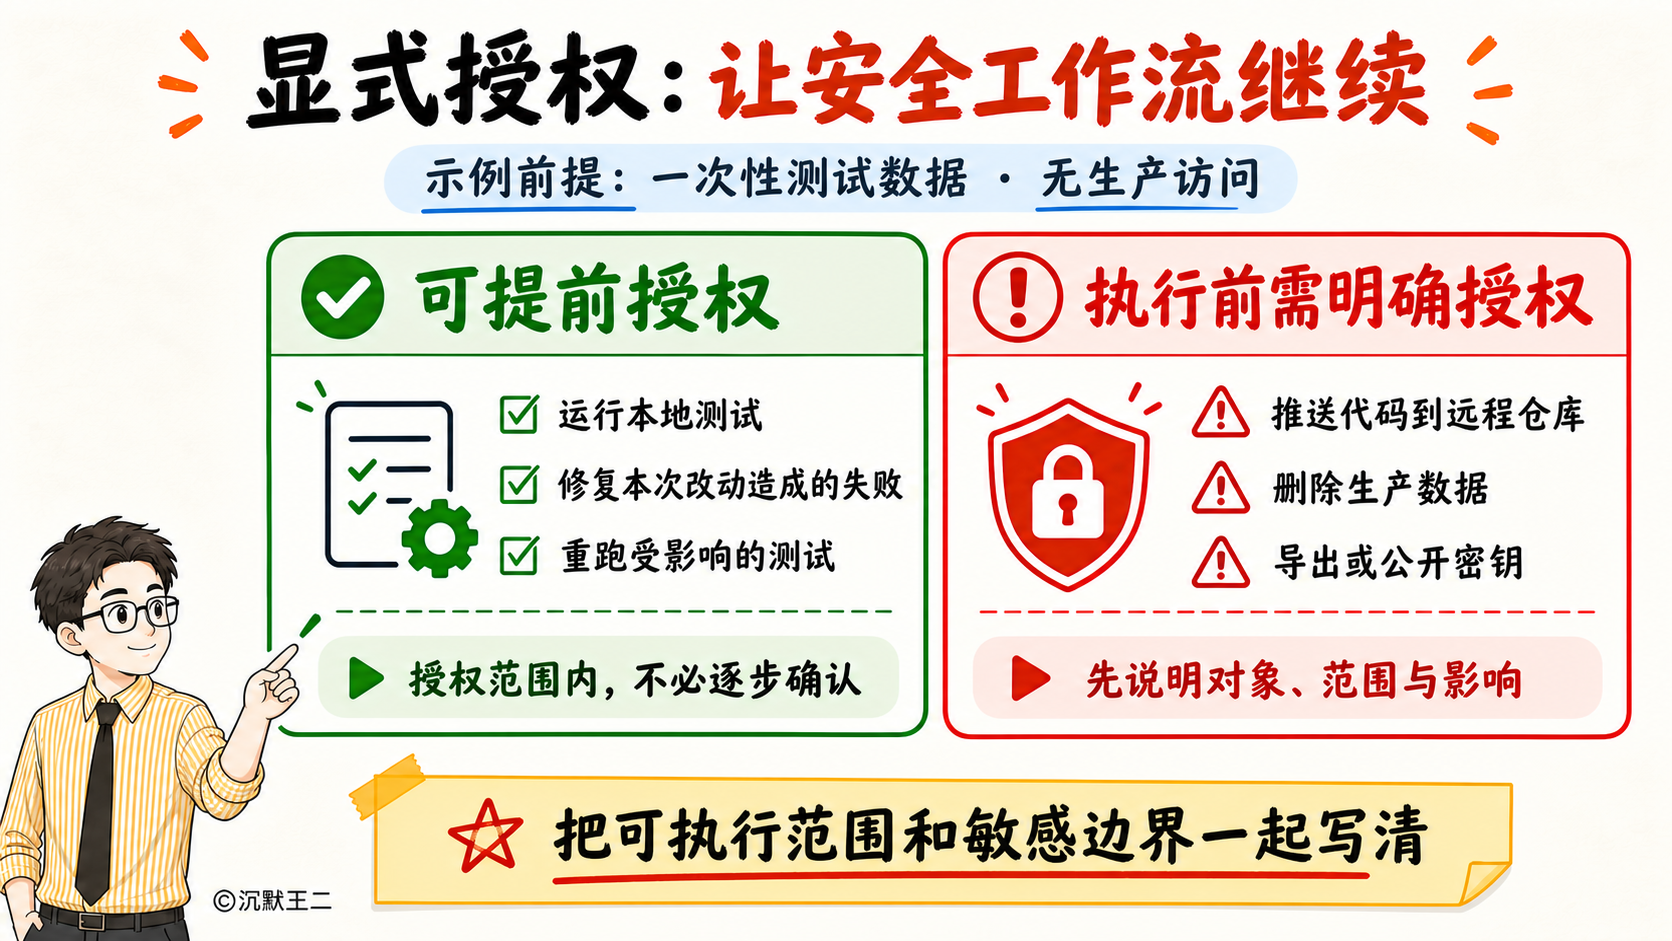
比如本地测试。测试用的是一次性的 fixture 数据,不会碰生产环境,跑完之后自动清理。这种情况下,可以在 CLAUDE.md 里写一句:
本地测试使用一次性数据,没有生产环境访问权限。直接跑测试、修复失败、重跑受影响的测试,不需要每一步都等确认。
自检清单
- CLAUDE.md / AGENTS.md 里有没有「每次都要 XX」这样的无条件规则?
- 这些规则各自适用于什么场景?能不能加上触发条件,或者移到具体的 Skill 里?
- 有没有安全的工作流可以显式授权,减少不必要的确认等待?
- 规则里引用的文档,和实际代码还对得上吗?
03、放松决策边界
老模型时代,我们会在 Skill、Memory、CLAUDE.md 里加各种限制。「修改文件前必须先问我」「禁止自动执行 shell 命令」「任何涉及数据库的操作都要等确认」。
当时是合理的。
老模型的判断力不够,放手让它干容易出问题。加限制是为了兜底。
但 Astra 这代模型对指令更敏感,对安全边界的判断也更准确。
当模型本身已经足够谨慎,再加一层「禁止」「必须先问」,结果就是过度谨慎。该做的事情不敢做,该继续的地方停下来等你点头。
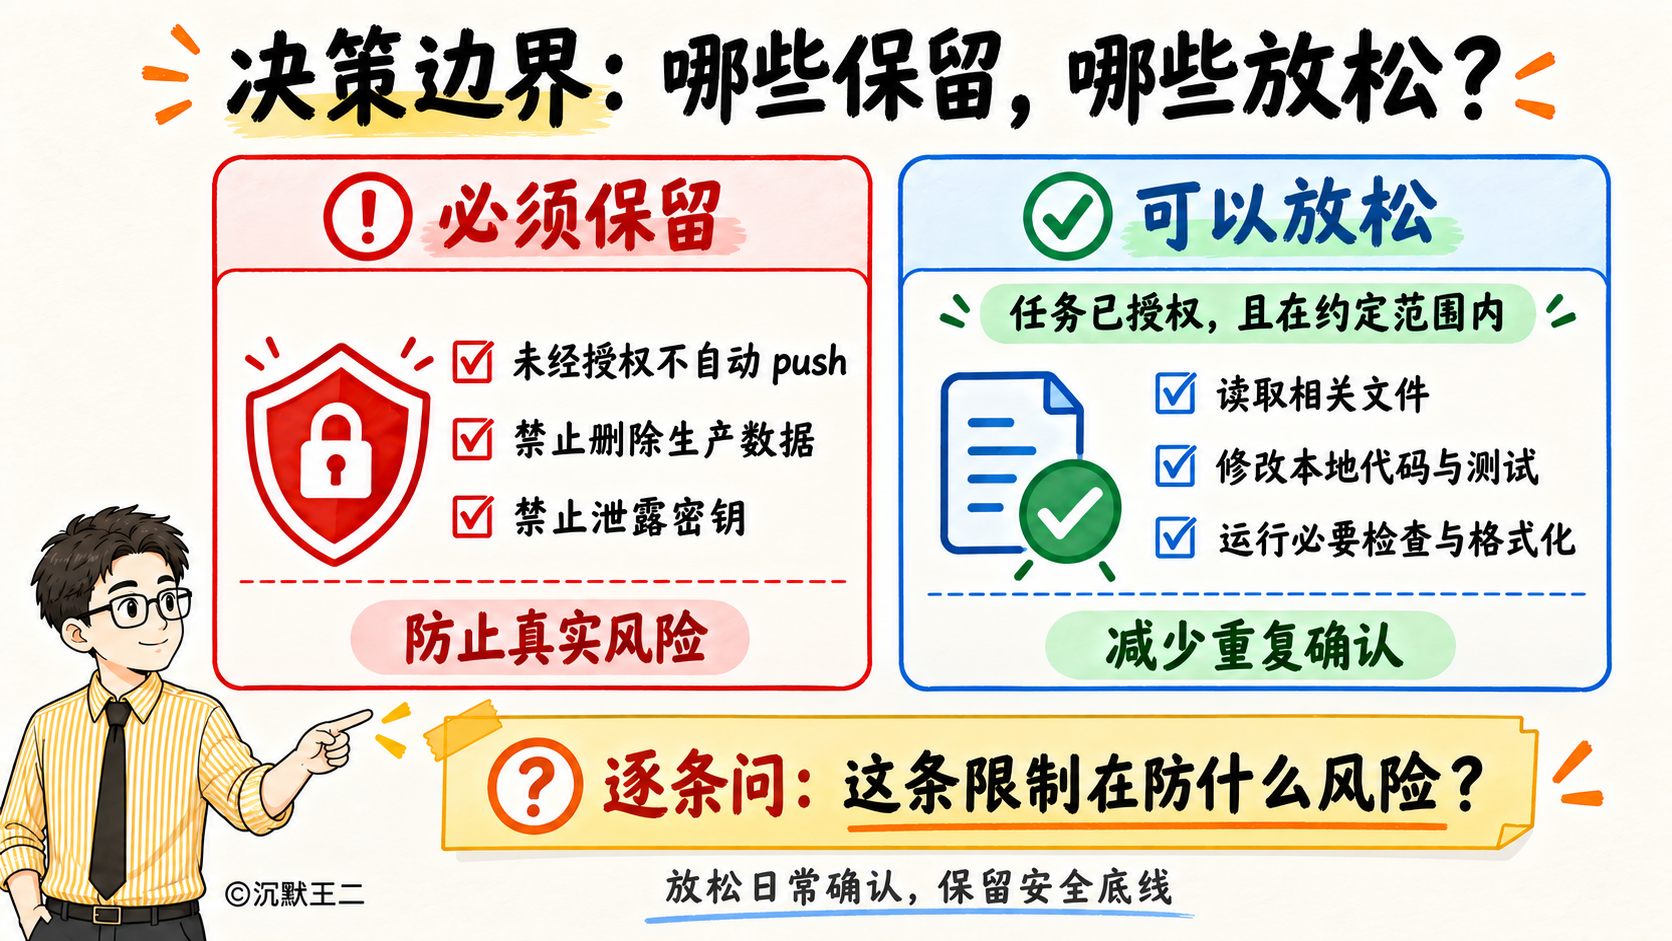
OpenAI 的建议是,把之前加的限制分成两类。
一类是安全底线。「不要自动 push 代码到远程仓库」「不要删除生产数据」「涉及密钥的操作必须确认」。这些不管模型多聪明都要保留。
另一类是日常操作的确认环节。读个文件要确认,写个测试要确认,跑个格式化也要确认。这些低风险操作可以交给模型自己判断。它现在有这个能力了。
04、在开始之前就定义完成标准
我就发现了,用国模制作视频的时候,会直接搞一个 goal 全部任务一直执行完,但 GPT-6 Astra 会停下来问你要不要继续。
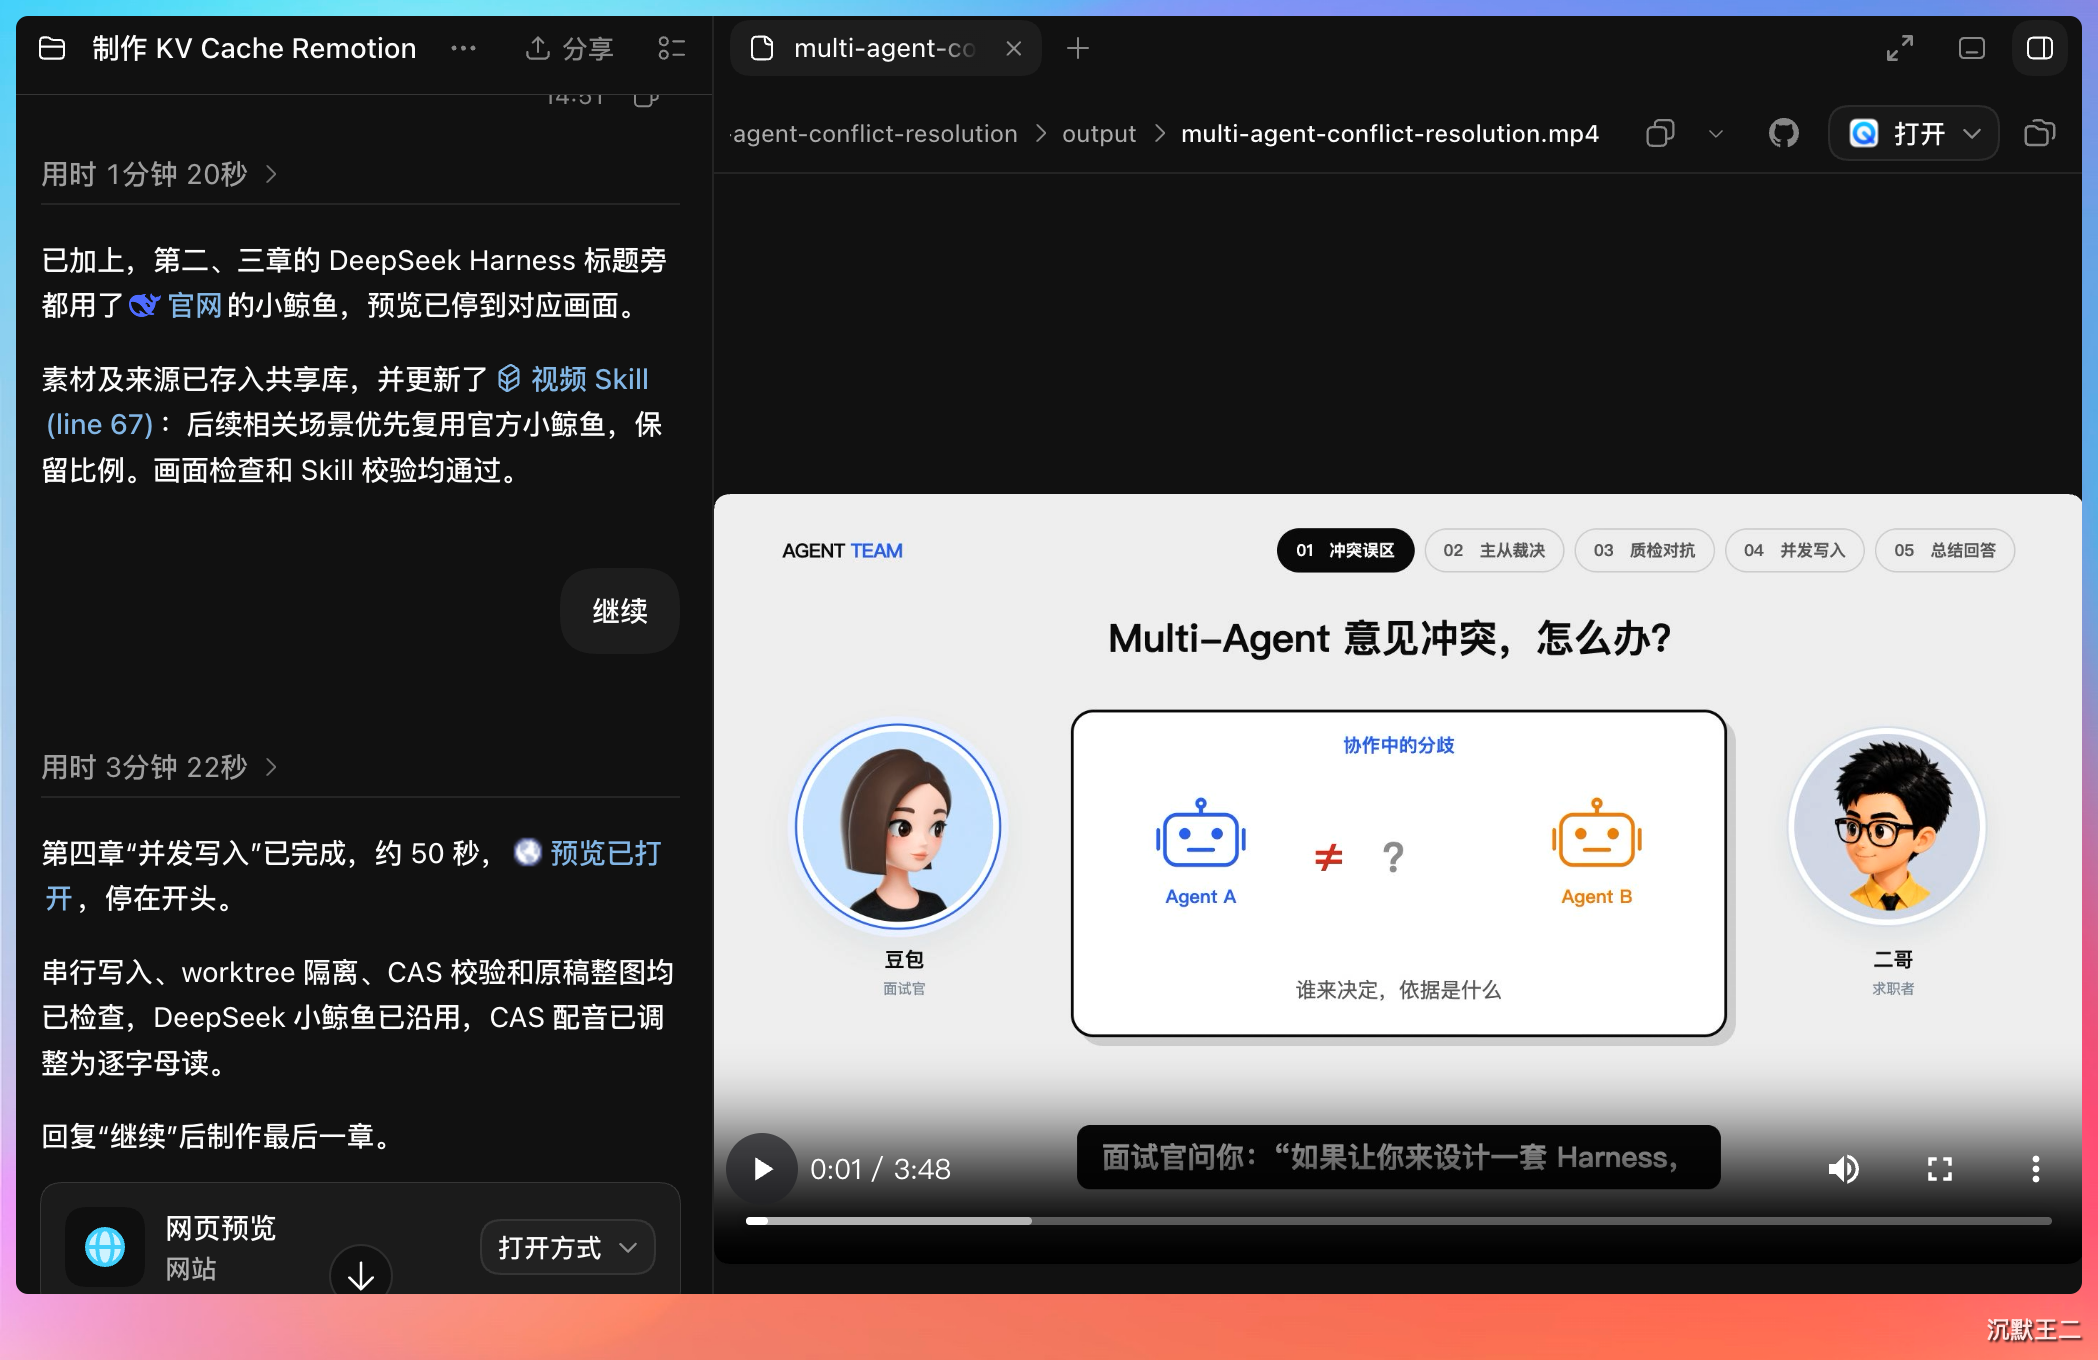
对做视频来说,这个行为是好事,省得出片了再去修改对应章节的问题。
但如果任务本身只是「跑测试、修 bug、验证通过」这些步骤,而你又希望它一口气做完,就得在任务提示里把「完成」两个字的定义写明白。
Bad 写法:
帮我实现用户登录功能。
模型写完代码就停了,等你手动去测试和验证。
Good 写法:
实现用户登录功能。完成后跑通本地测试套件,修复因为这次改动导致的测试失败,确认所有测试通过、没有报错后再汇报结果。
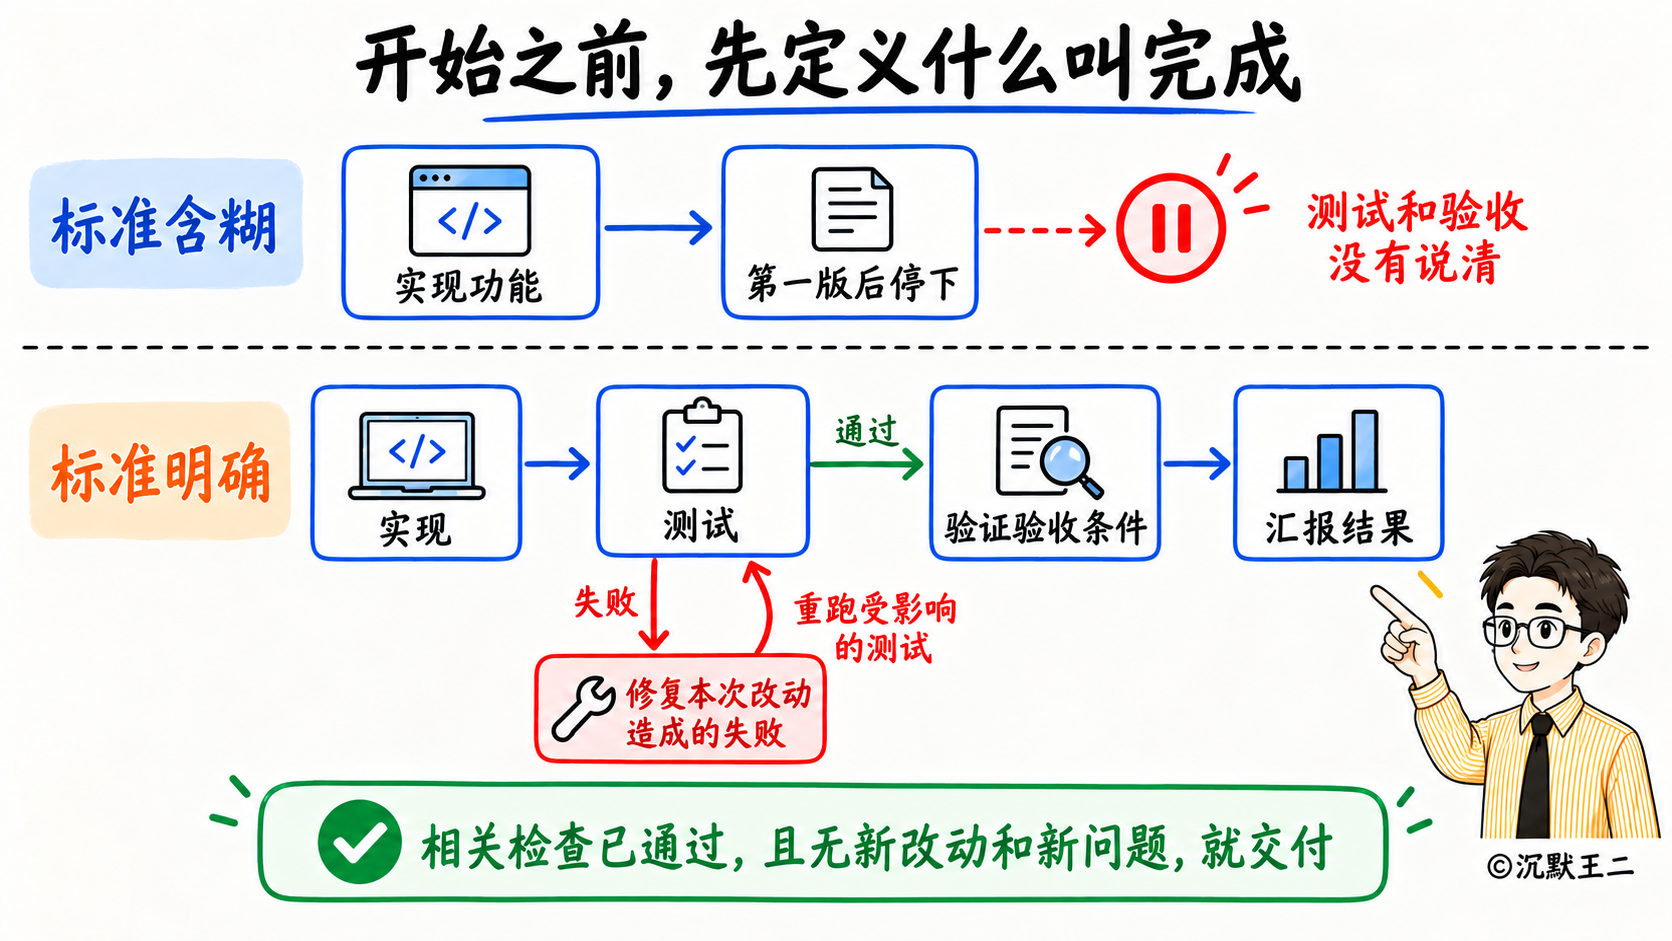
OpenAI 原文有一句话我觉得说得很到位:在开始之前就定义完成(define completion before starting)。
不是写完代码叫完成,也不是「多测几遍」叫完成。完成的定义应该具体到:跑哪些测试、通过什么条件、交付什么产物。
测试的停止条件也要写清楚。「相关检查已经通过,又没有新改动和新问题,就可以交付」。反复强调「多测几遍」很难产生实际效果,远不如一条明确的验收标准管用。
ending
一个新版本的模型发布,尤其是像 GPT-6 Astra 这种强力模型,确实值得去清理一波 AGENTS.md、Skills、Memory。
花不了太长时间,但之后每次开任务都会顺畅不少。
我们下期见。