
给 MinIO 说再见,最强 AI 存储 RustFS 发布正式版了!
大家好,我是二哥呀。
讲良心话,我绝对是 MinIO 的铁粉,几乎所有的项目,只要需要在服务器上持久化存储一些大文件,就会首选 MinIO。
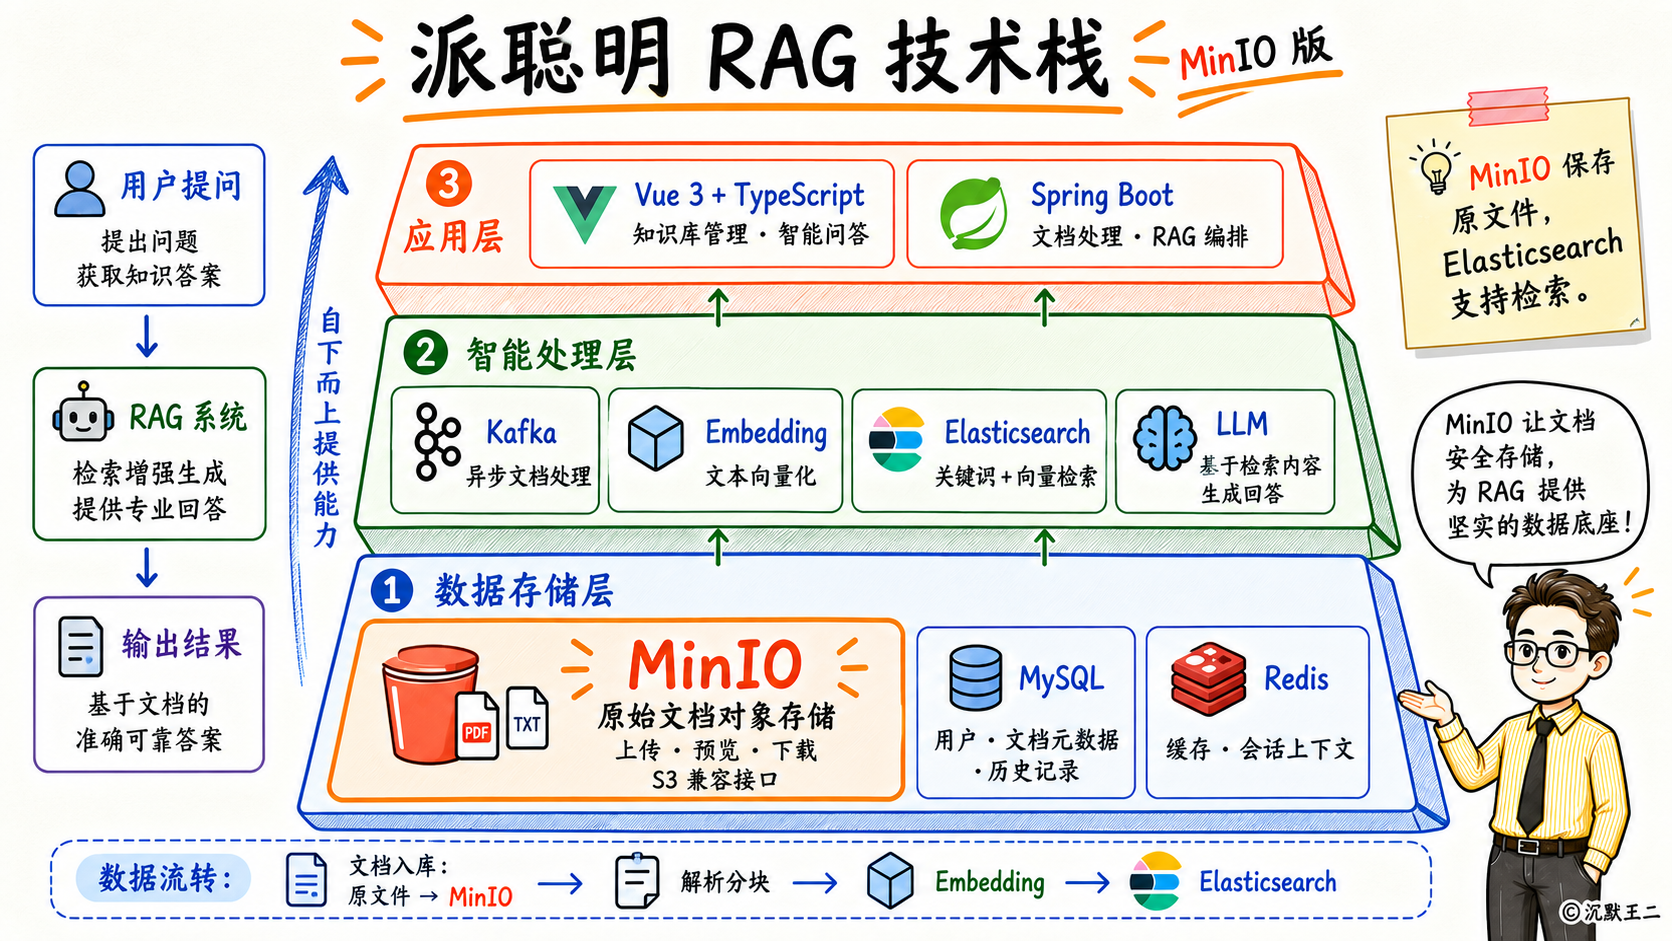
派聪明 RAG 这个项目用的就是 MinIO。
但是。
MinIO 继 4 月 25 日归档主仓库之后,于 7 月 15 日再次归档了 mc(MinIO Client)仓库,同时还删除了 Dockerhub 上的 mc 镜像仓库。
用过的同学应该都清楚,mc 是 MinIO 提供的一款命令行工具,可以对 S3 兼容的对象存储系统进行操作,实现对存储桶、对象以及集群等的管理。
归档后,意味着我们没办法获取 mc 的最新版本以及安全补丁。不管是 mc 还是 minio,市场都需要一个平替。
RustFS 正是这样一个完美的平替。
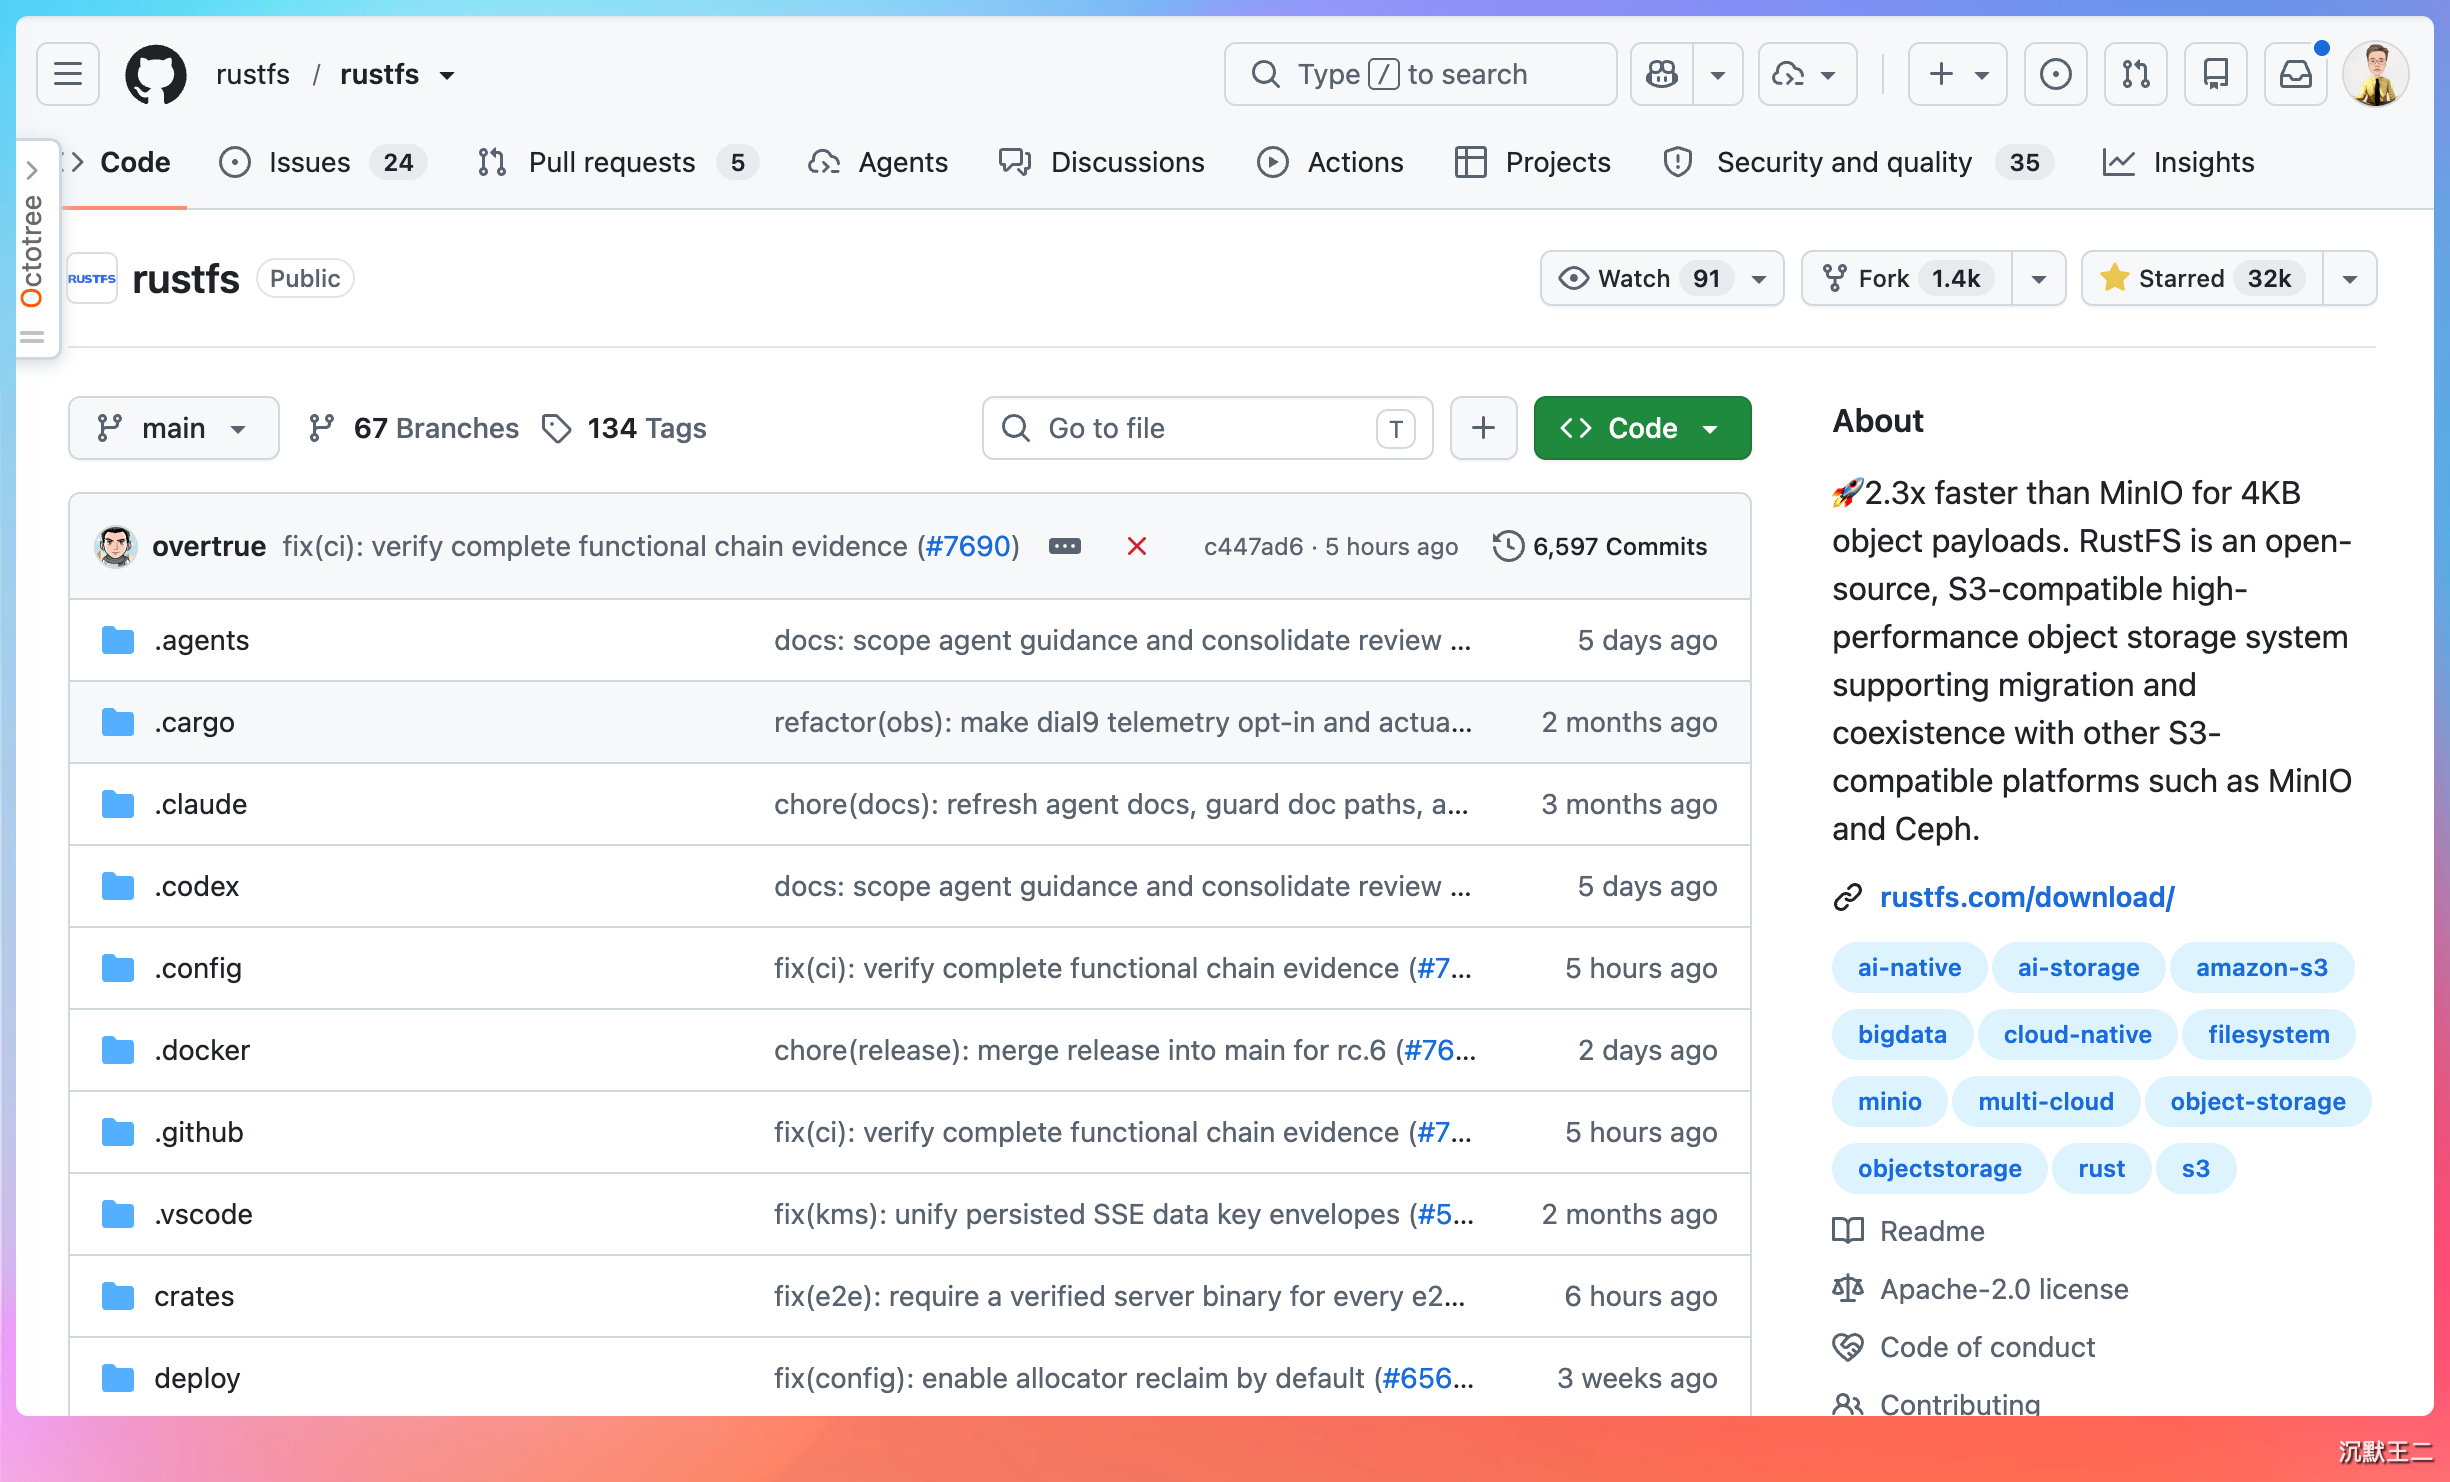
GitHub 已经 32K star 了:https://github.com/rustfs/rustfs
Apache 2.0 许可证,完美兼容 S3。
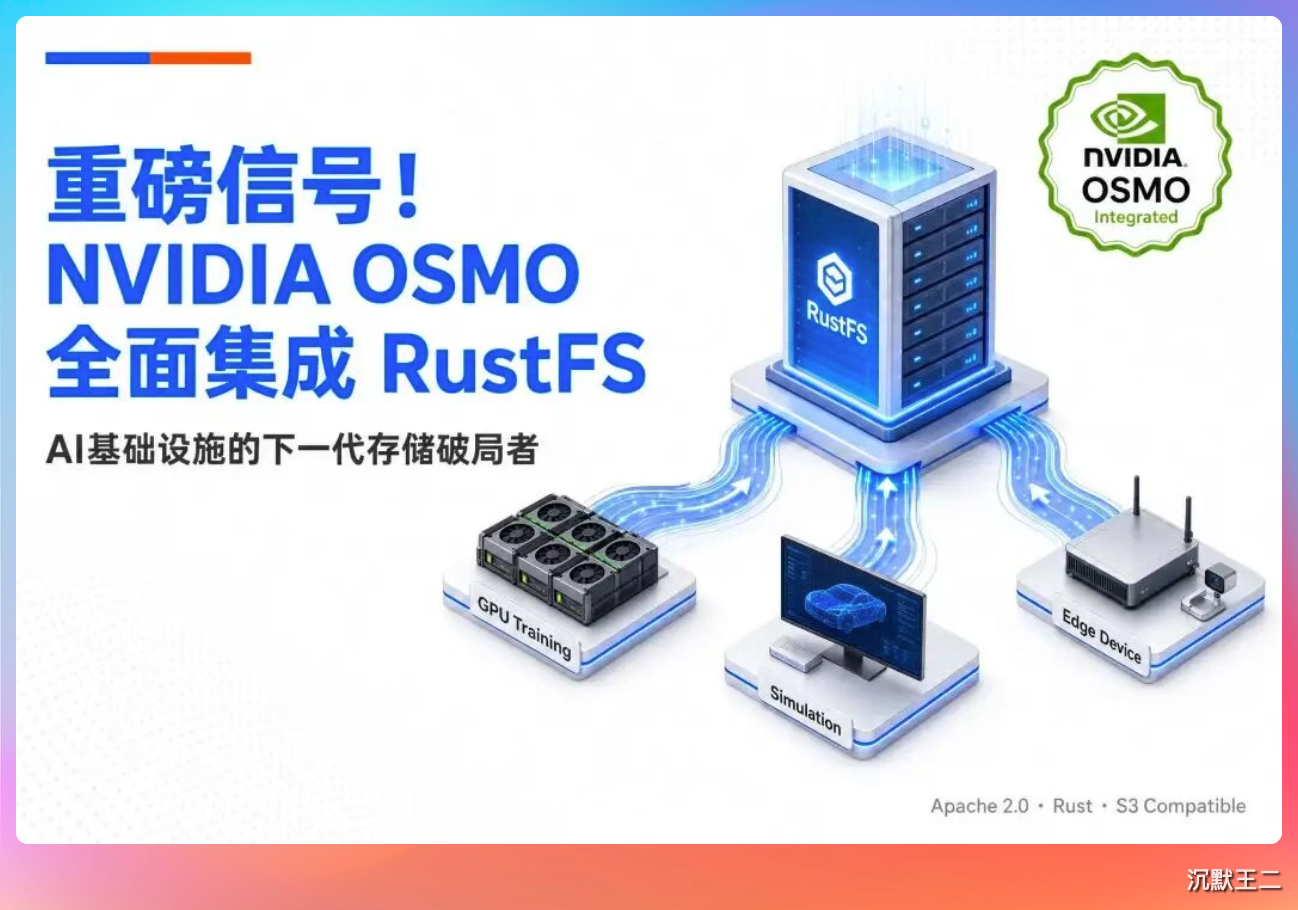
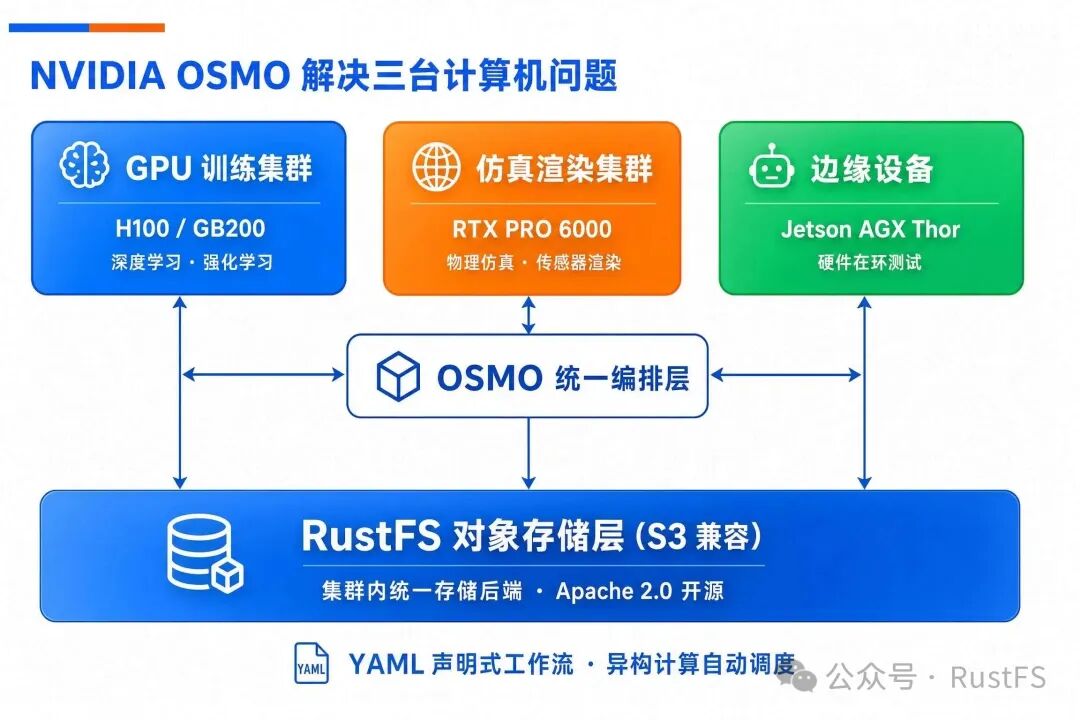
并且,还有一件事让我对 RustFS 的信任感倍增,那就是英伟达的物理 AI 和机器人领域编排平台 OSMO 全面集成了 RustFS 作为其集群内存储后端的直接替代方案。
于是就在上周六,我下定决心,把派聪明 RAG 的 MinIO 存储方案直接切换到了 RustFS。
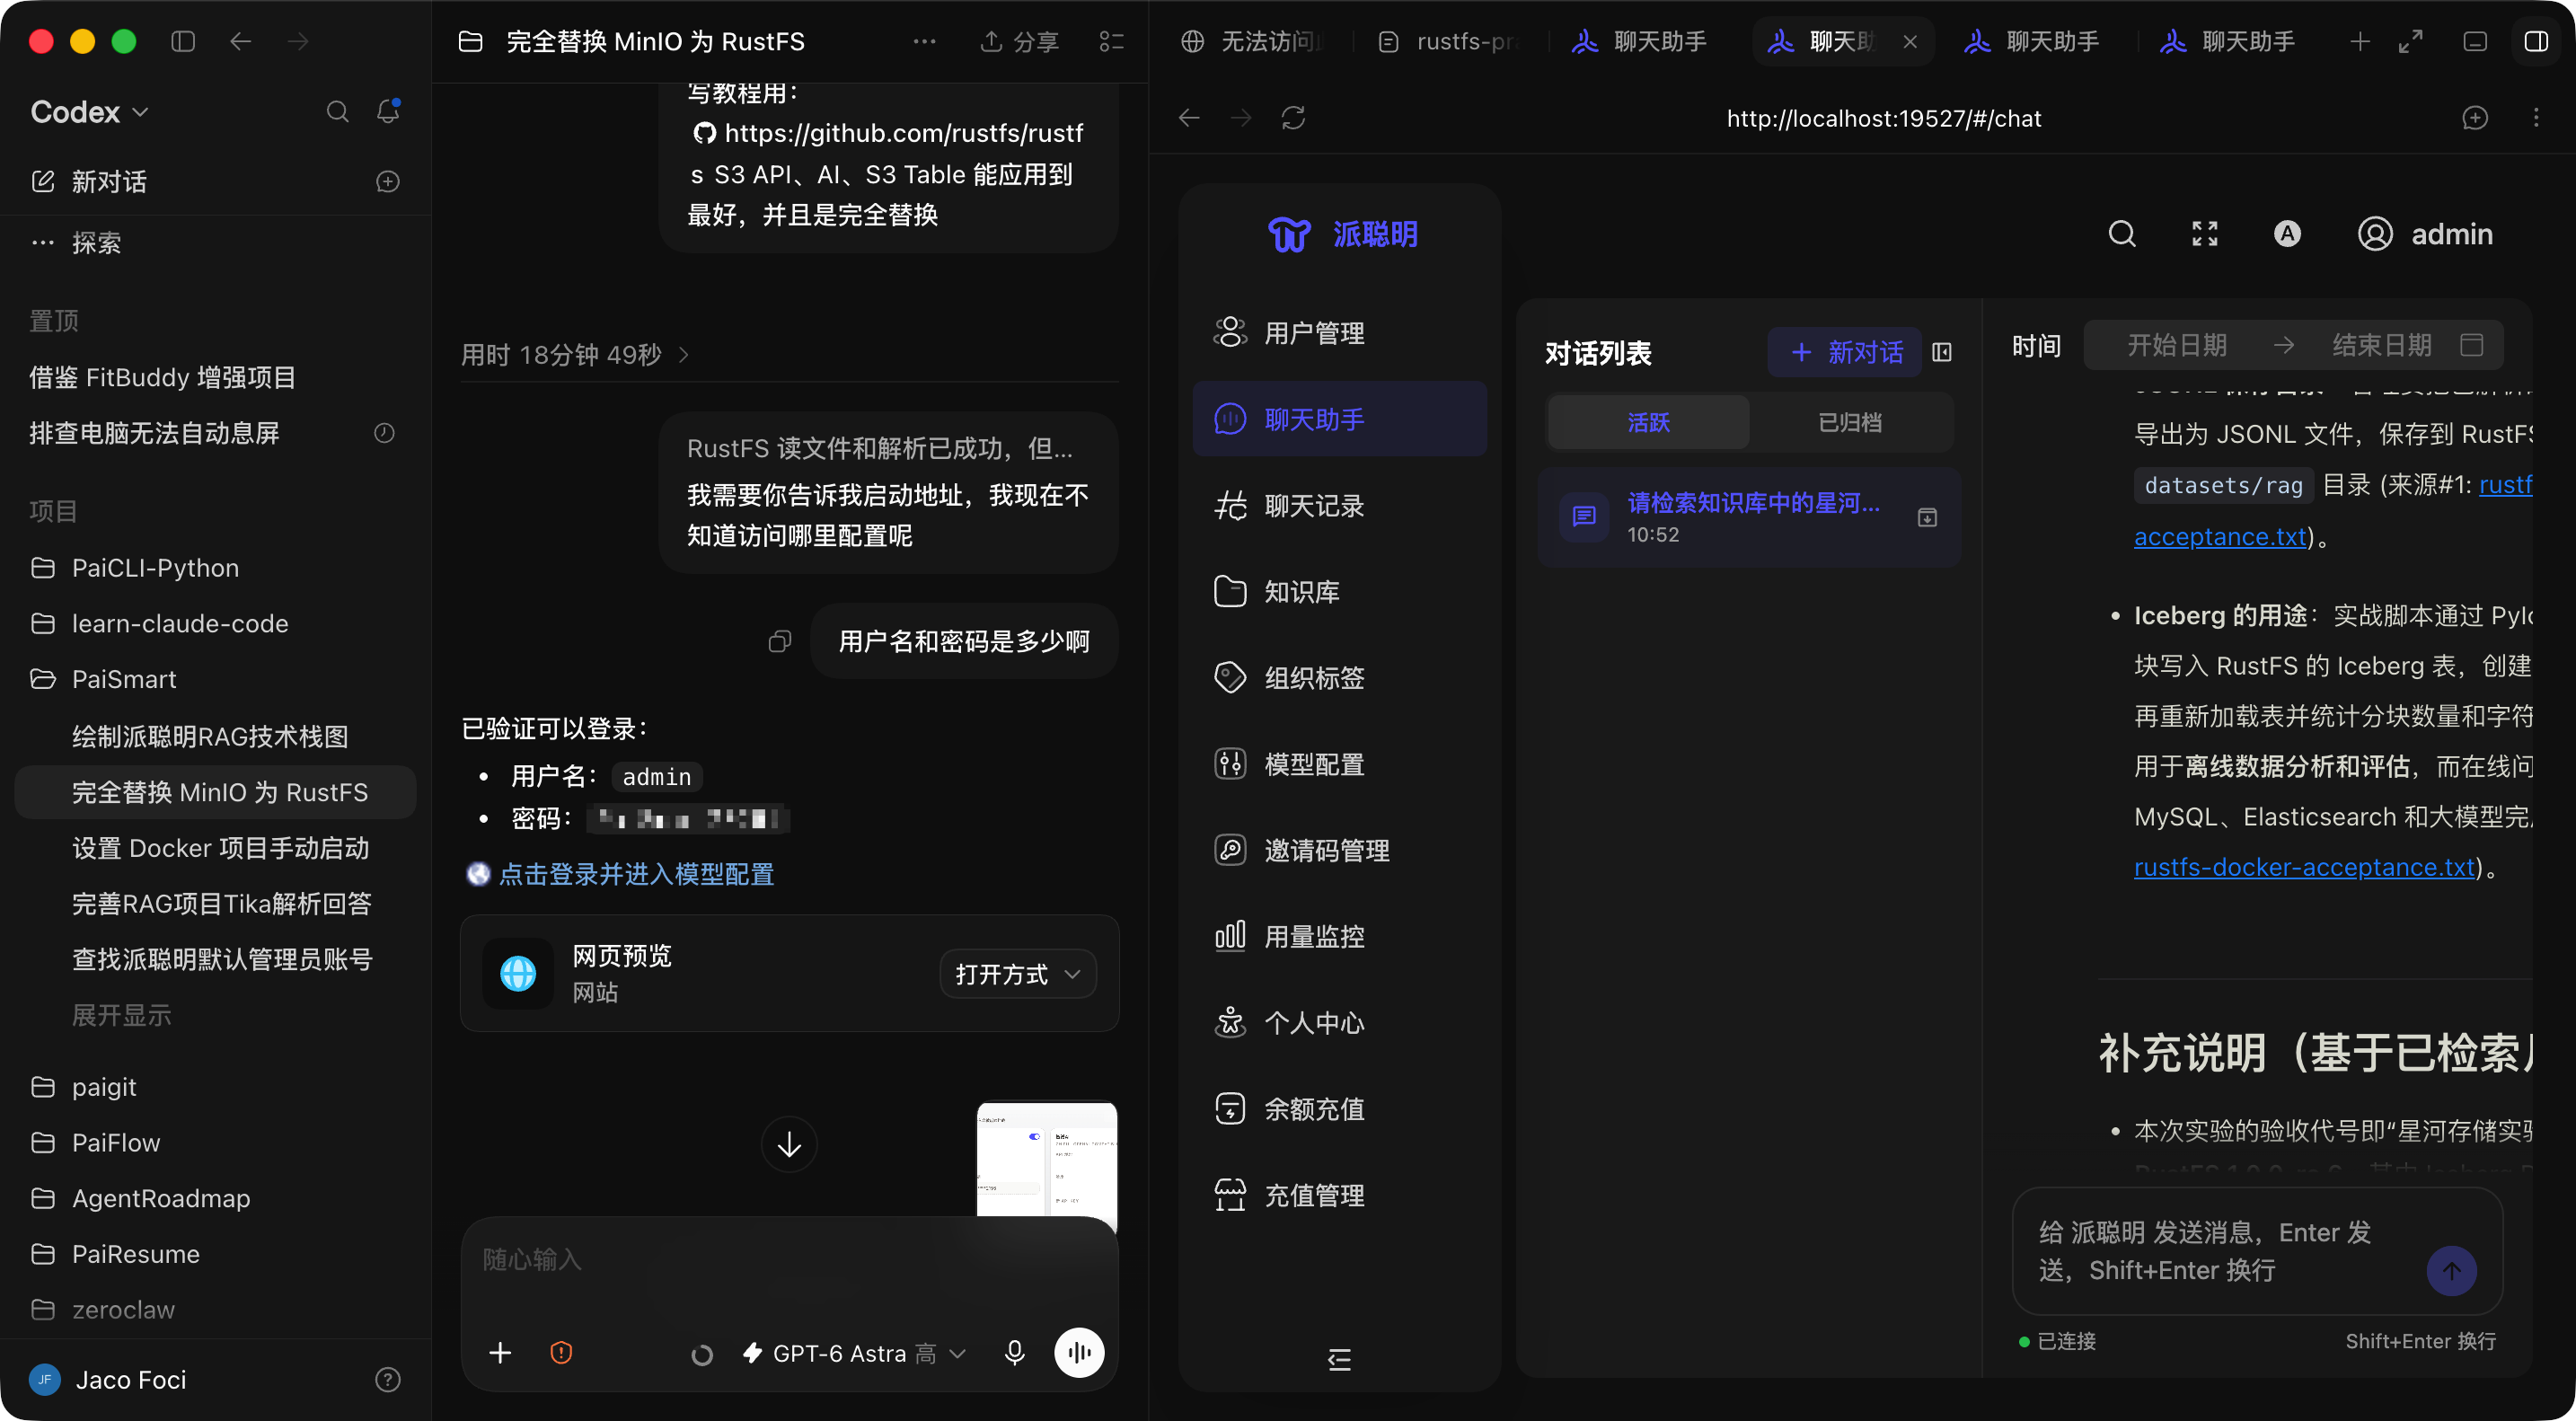
用 Codex+GPT-6 Astra high,30 分钟就搞定了。
连带测试。
这么高效的原因只有两个,要么 GPT-6 Astra 太强,要么 RustFS 对 MinIO 的兼容做的太好。
01、MinIO 是什么?
MinIO 是 2014 年开源的对象存储系统,Go 语言写的,S3 兼容,部署简单,这些年在国内几乎是对象存储的默认选项。
转折点出现在 2021 年。
MinIO 把许可证从 Apache 2.0 换成了 AGPLv3。AGPLv3 要求任何通过网络提供 MinIO 服务的公司都要开放自己的源代码。对于把 MinIO 嵌入自家产品提供 SaaS 服务的公司来说,这个条款相当致命。

2026 年 2 月 13 日,MinIO 更进一步,直接把社区版仓库归档。Web 控制台功能被剥离到企业版,年费相当贵。
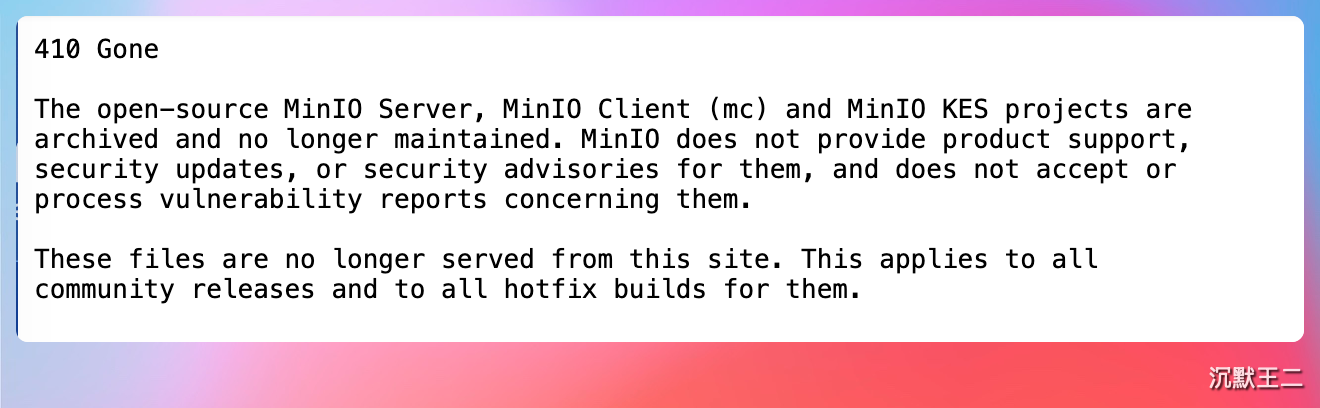
当时有不少派聪明的用户就卡在了这一步,索性我当时备份了历史存档。
02、RustFS 是什么?
RustFS 是一个用 Rust 语言从零构建的高性能分布式对象存储系统,2025 年 7 月开源,Apache 2.0 许可证,S3 API 完全兼容。
截至 2026 年 9 月,RustFS 在 DockerHub 上的下载量超过 1000 万次。从最开始的 alpha 到 beta 再到 rc,最近正式发布了 GA,也就是 1.0.0 版本。也就是意味着,这是告诉大家伙:放心大胆在生产环境上使用 RustFS 吧。
RustFS 从 2025 年 7 月开源,到今天,在 GitHub 上的 Stars 已经超过了 32k,这个增长在开源项目中也算是顶流了。
MinIO 用 Go 语言写的。Go 有垃圾回收机制(GC),在高并发写入小对象的场景下,GC 暂停会带来延迟抖动。MinIO 的官方测试数据里也提到过,极端情况下 GC 暂停可以达到 340ms。
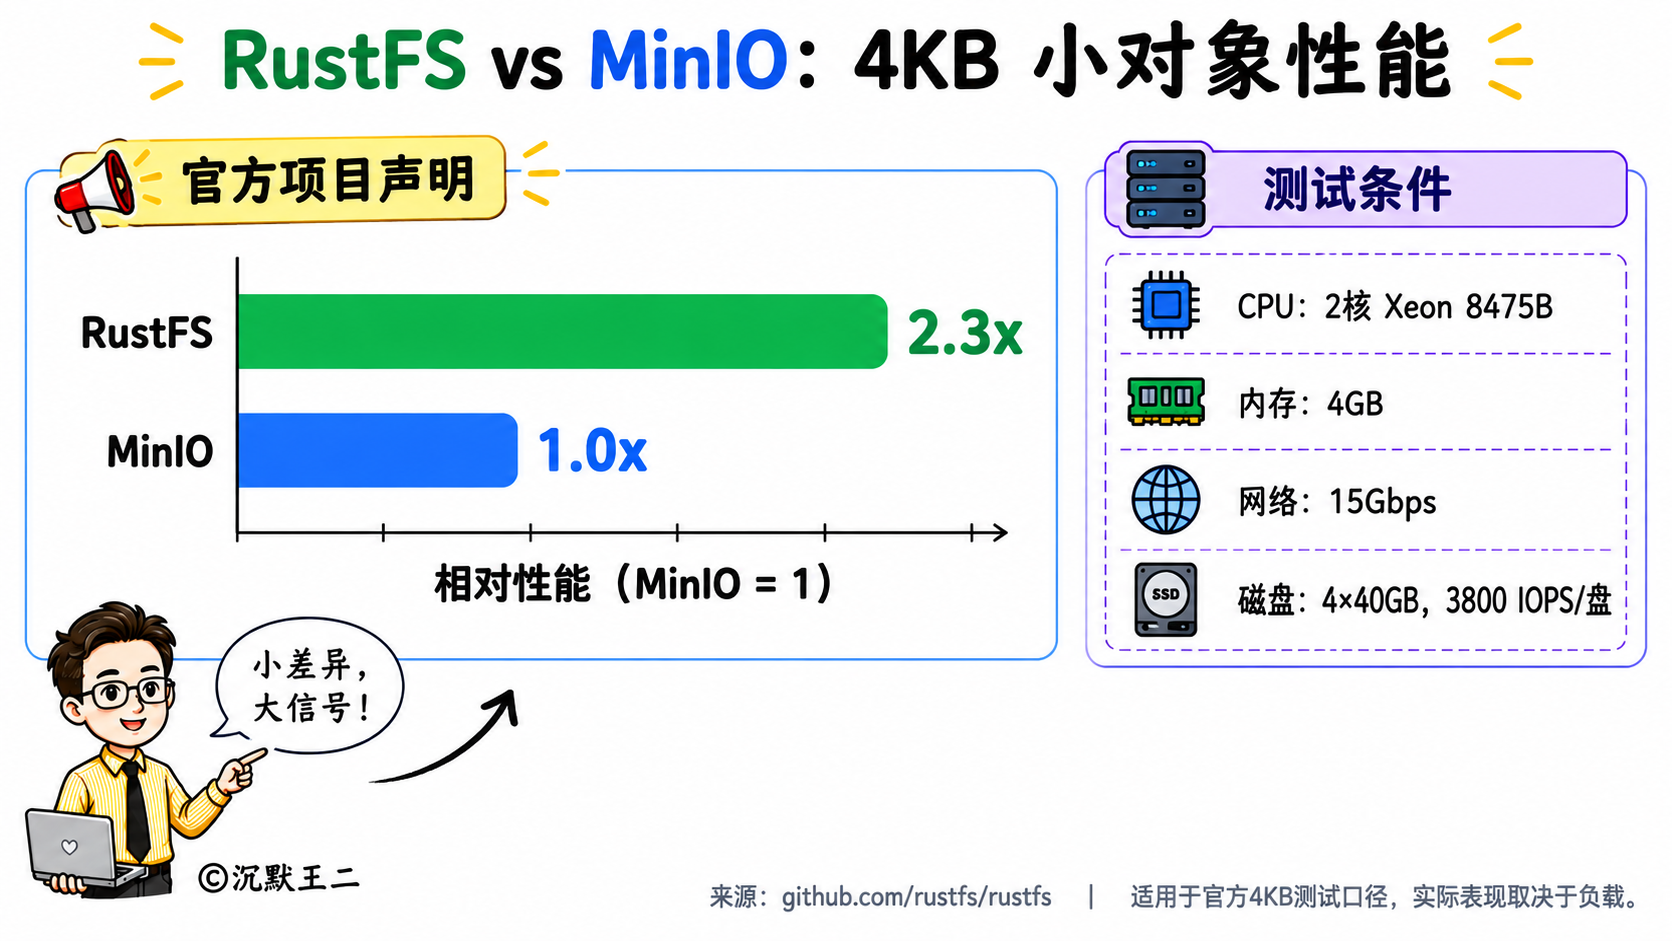
Rust 没有 GC。内存安全在编译期保证,运行时不会出现 stop-the-world 暂停。RustFS 在官方压测环境(2 核 Xeon Sapphire Rapids 8475B,4GB 内存,15Gbps 网络,4×40GB 磁盘,3800 IOPS)下,4KB 小对象的吞吐量是 MinIO 的 2.3 倍。
但我也得说句公道话。
GitHub issue #73 里有独立测试显示,在大文件顺序读取(20 MiB 对象)场景下,MinIO 的吞吐量(约 53 Gbps)明显高于 RustFS(约 23 Gbps)。RustFS 团队已经确认这个差距,目前测试看,RustFS 在大文件上的性能也已经追上了 MinIO。
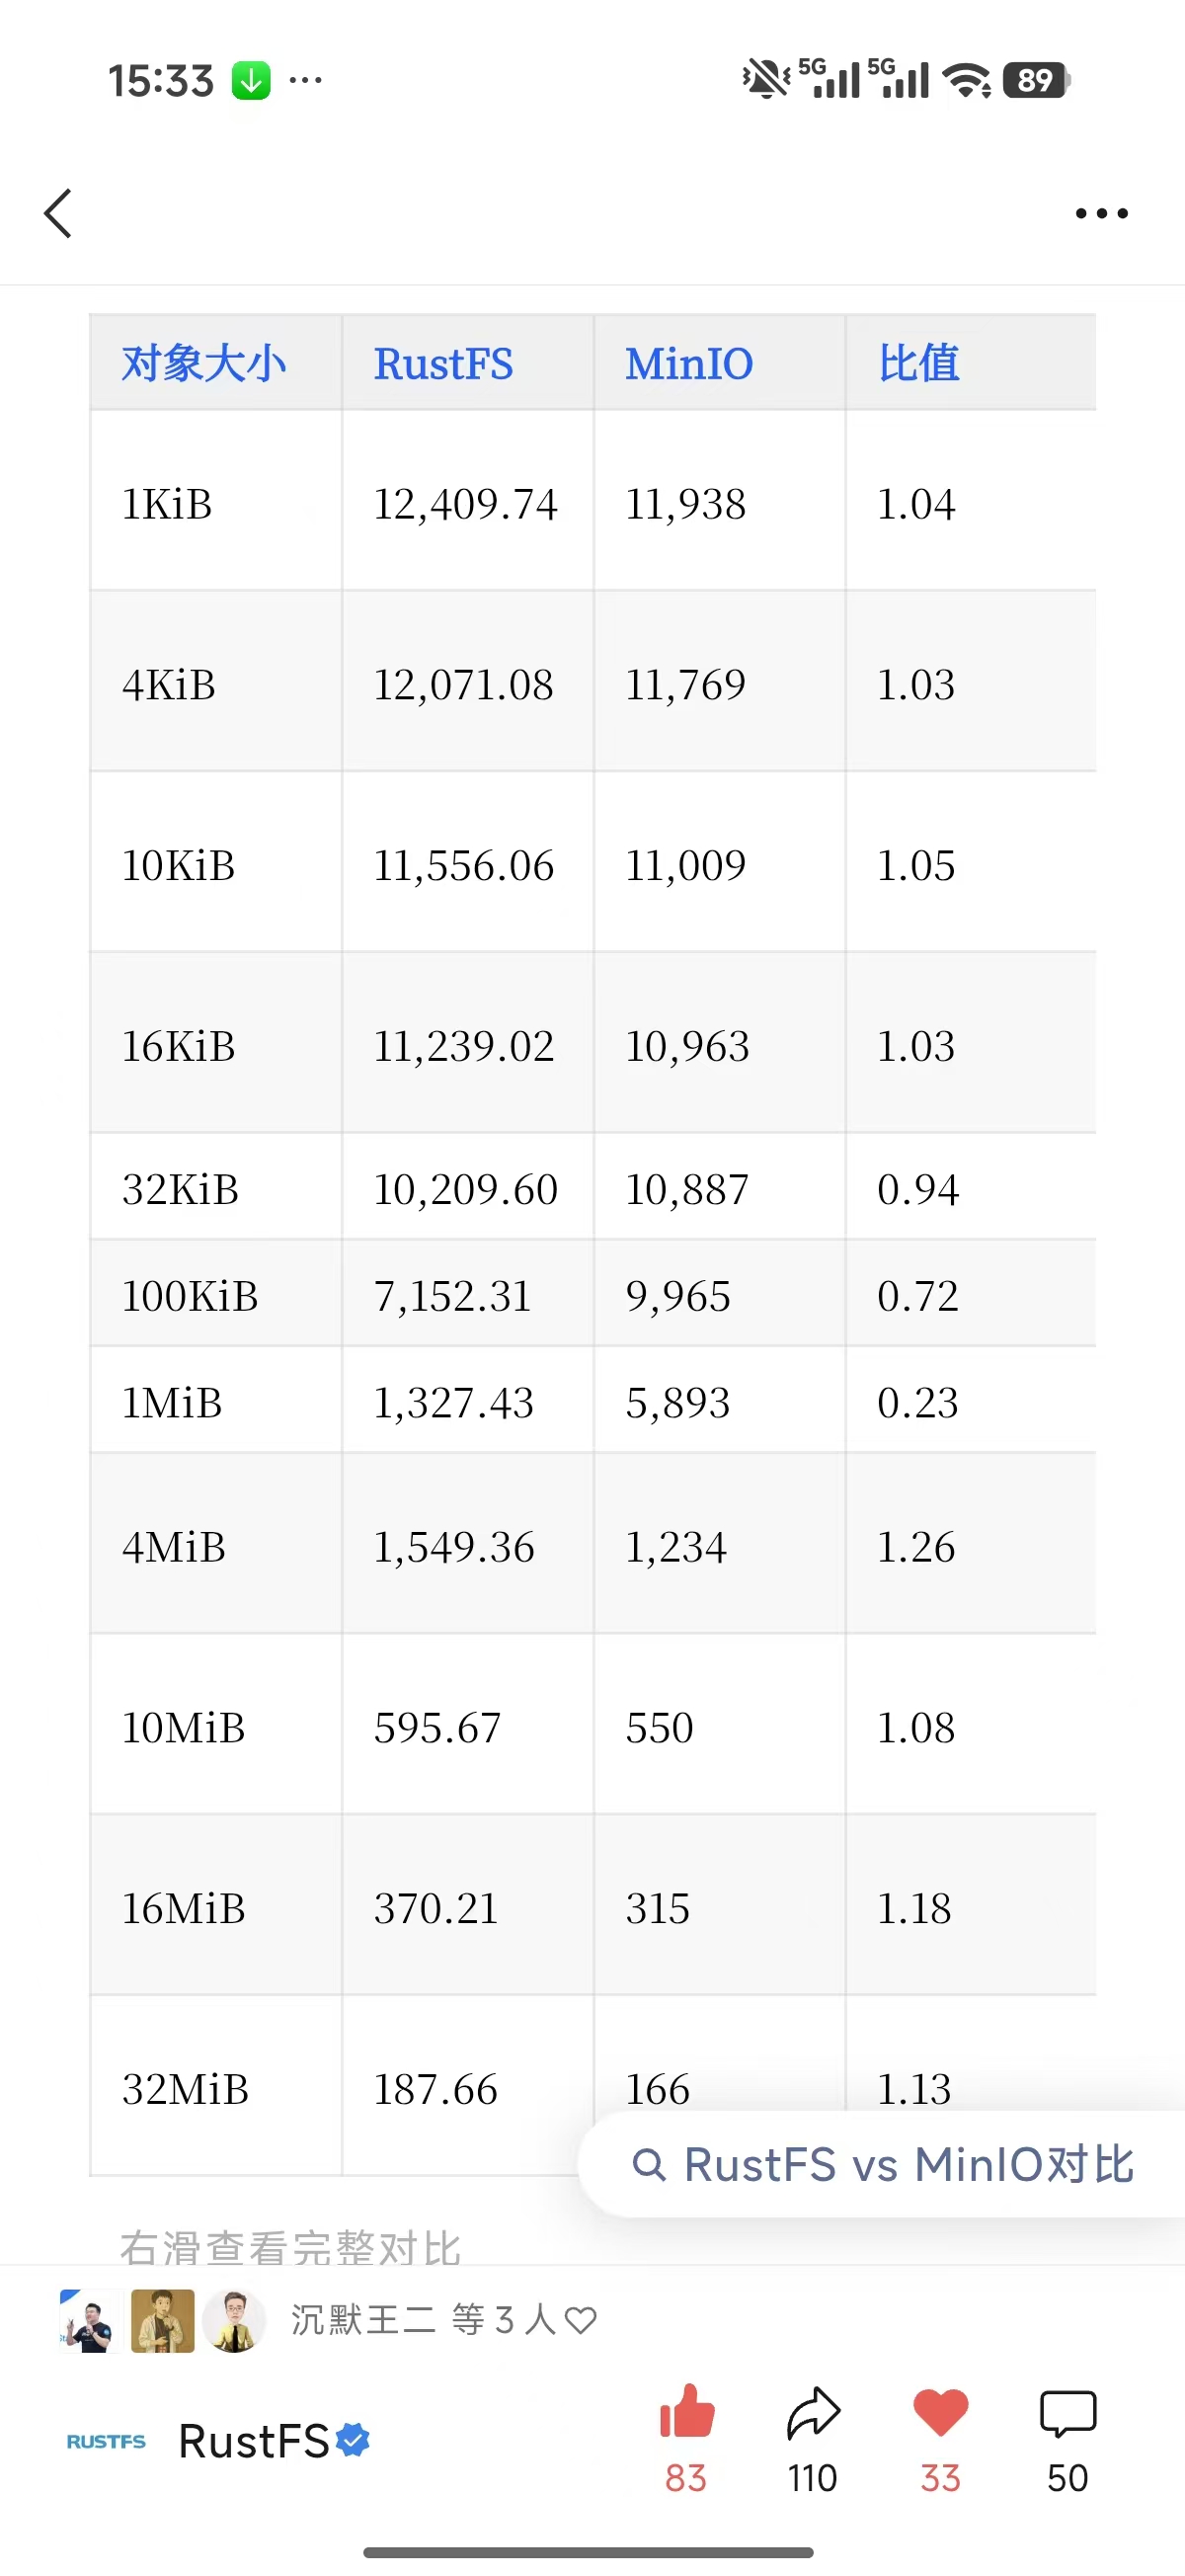
所以 RustFS 的性能优势主要在小对象和资源受限的环境。AI 训练场景下,需要大量小文件并发读写,正好是 RustFS 的甜点区。
底层架构上,RustFS 用 Tokio 异步处理并发请求,每个请求是一个轻量级 task,不需要为每个连接分配线程。Linux 环境下还支持 io_uring 异步 I/O,系统调用直接在内核完成,减少上下文切换。
数据保护采用纠删码(Erasure Coding),和传统的三副本方案相比省存储空间。RS(4,2) 配置下,4 个数据分片加 2 个校验分片,任意丢掉 2 个分片都能恢复。后台会定期做 SHA-256 校验,发现损坏的分片自动从存活分片重建。
分布式模式下没有中心元数据服务器,每个节点既存数据也存位置信息,写完立即可读,严格的 read-after-write 一致性。
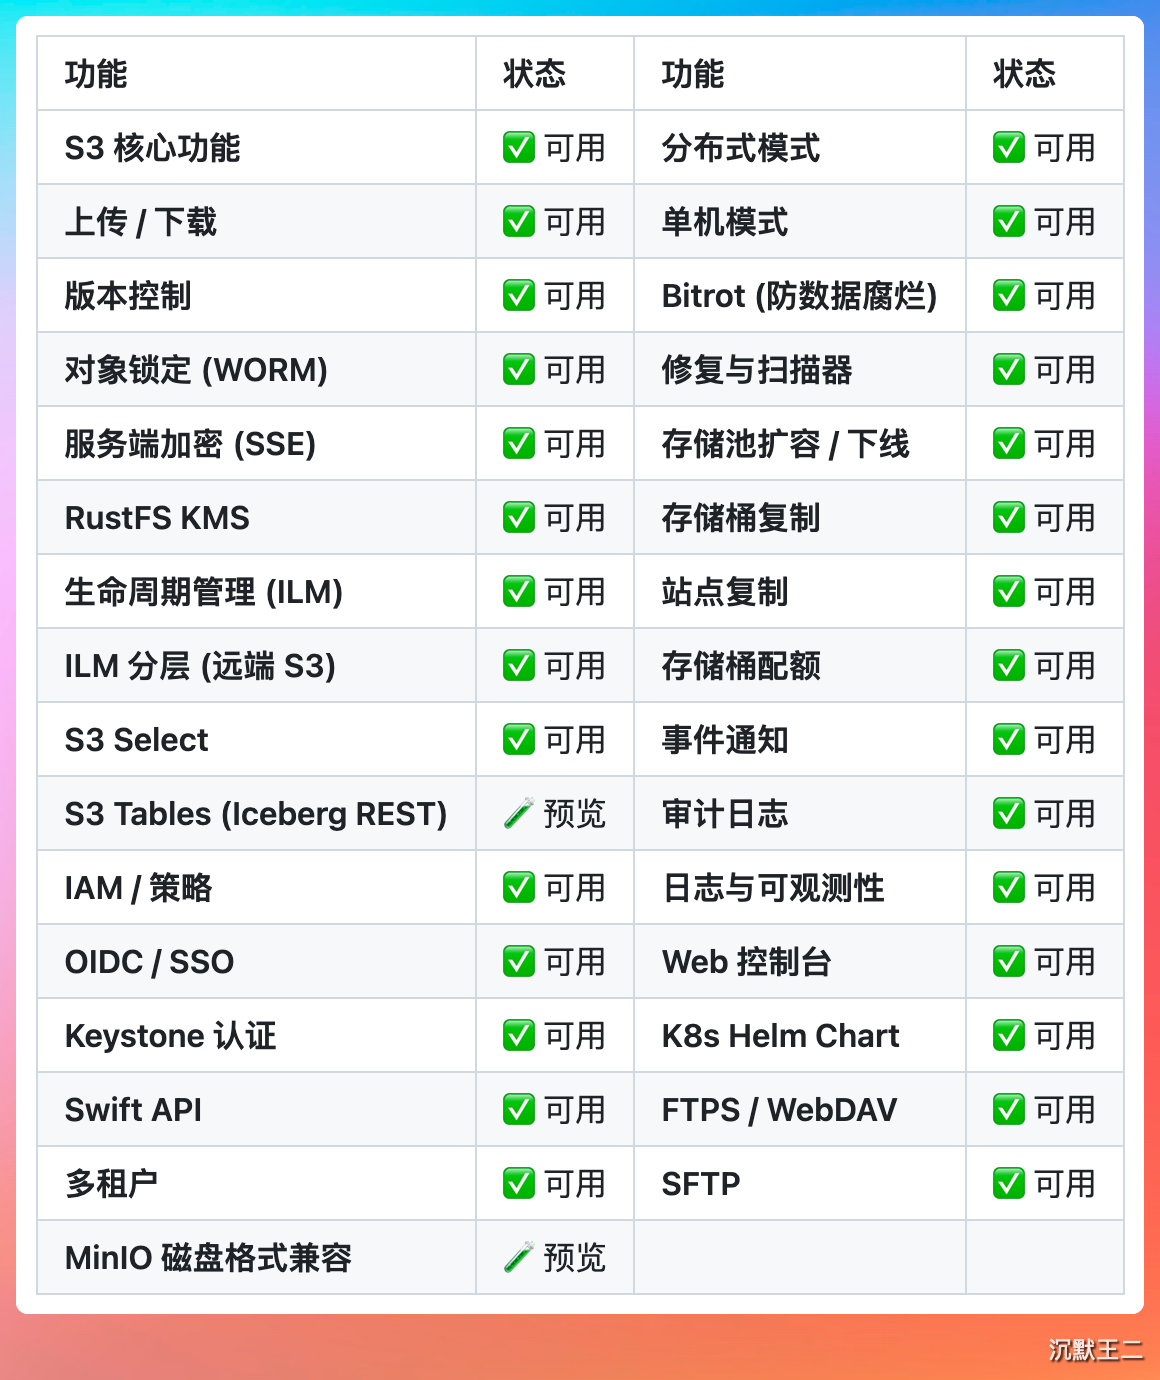
功能方面,RustFS 已经覆盖了生产环境需要的核心能力。
- 纠删码(Erasure Coding),RS(4,2) 配置下存储开销 50%,比三副本的 200% 省很多
- 版本控制、对象锁(WORM)、服务端加密
- IAM / OIDC / SSO 认证
- Web 控制台(Vue.js 3,开源可用,不像 MinIO 锁在企业版后面)
- Prometheus + Grafana 可观测性
- Kubernetes Helm Charts 和 Operator
- S3、MCP / FTPS / WebDAV / SFTP 多协议支持
许可证是 Apache 2.0,嵌入商业产品、提供托管服务、二次开发都没有问题。
03、NVIDIA 为什么选择 RustFS?
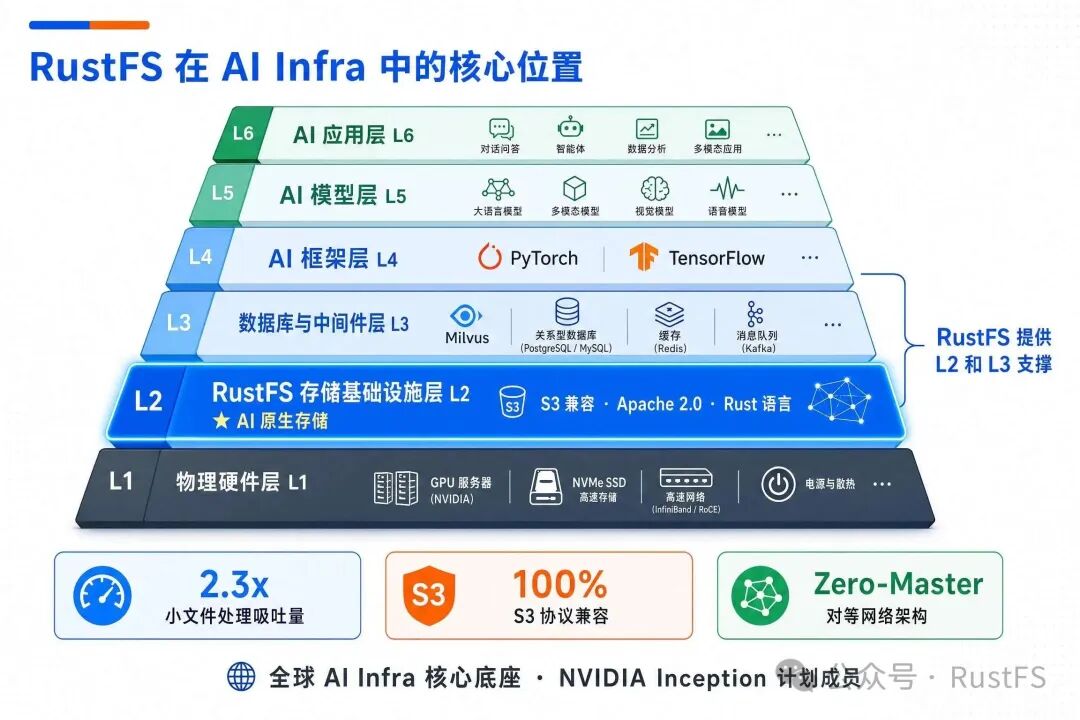
2026 年 4 月,RustFS 加入了 NVIDIA Inception 全球加速计划。
NVIDIA 的物理 AI 和机器人编排平台 OSMO 在 GitHub 上提交了 PR,要集成 RustFS 作为集群内存储后端的替代方案。OSMO 本身支持 S3 兼容的对象存储,RustFS 的 S3 完整兼容加上 Apache 2.0 许可证,正好满足 NVIDIA 对开源组件的要求。
更深层的合作在 DPU(数据处理单元)方向。RustFS 团队正在为 NVIDIA BlueField DPU 做原生 RDMA 支持,纠删码计算直接卸载到 DPU 硬件加速引擎上,加密操作也推到 DPU,目标是 400G/800G 线速性能,完全不占用主机 CPU。
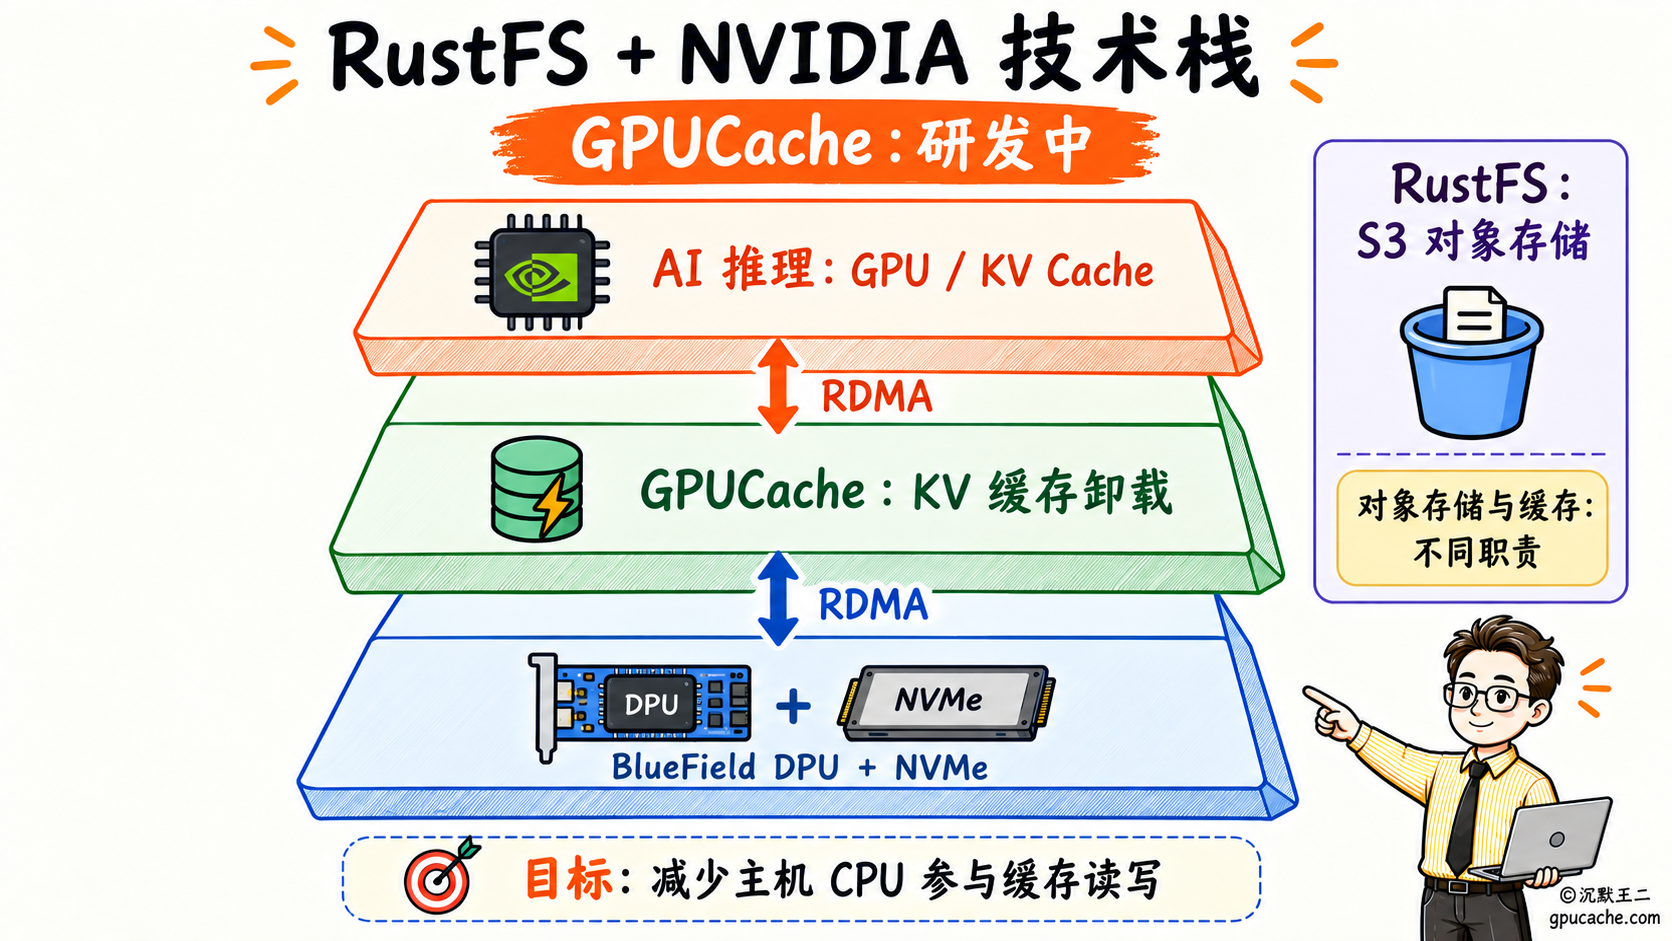
RustFS 团队还在开发 GPUCache 项目,一个基于 Rust + NVIDIA DOCA + RDMA + BF-4 DPU 的 PB 级 GPU 缓存系统,专门给 vLLM 和 TensorRT-LLM 这些推理框架用的。
推理场景下 KV Cache 的读写延迟要求很高,传统的存储方案 CPU 介入太多,GPUCache 就是为了解决这个问题。
这透露出一个信号。
RustFS 的定位不只是 MinIO 的替代品,而是 AI 基础设施存储层的候选方案。从对象存储到数据湖到 GPU 缓存,RustFS 团队在用一套技术栈(Rust + S3 协议)串起整个 AI 数据流转的各个环节。
04、S3 Tables 和数据湖是什么?
AWS 在 2024 年推出了 S3 Tables,把 Apache Iceberg 表格式嵌入到 S3 里,让对象存储从只存文件升级到能管结构化数据。
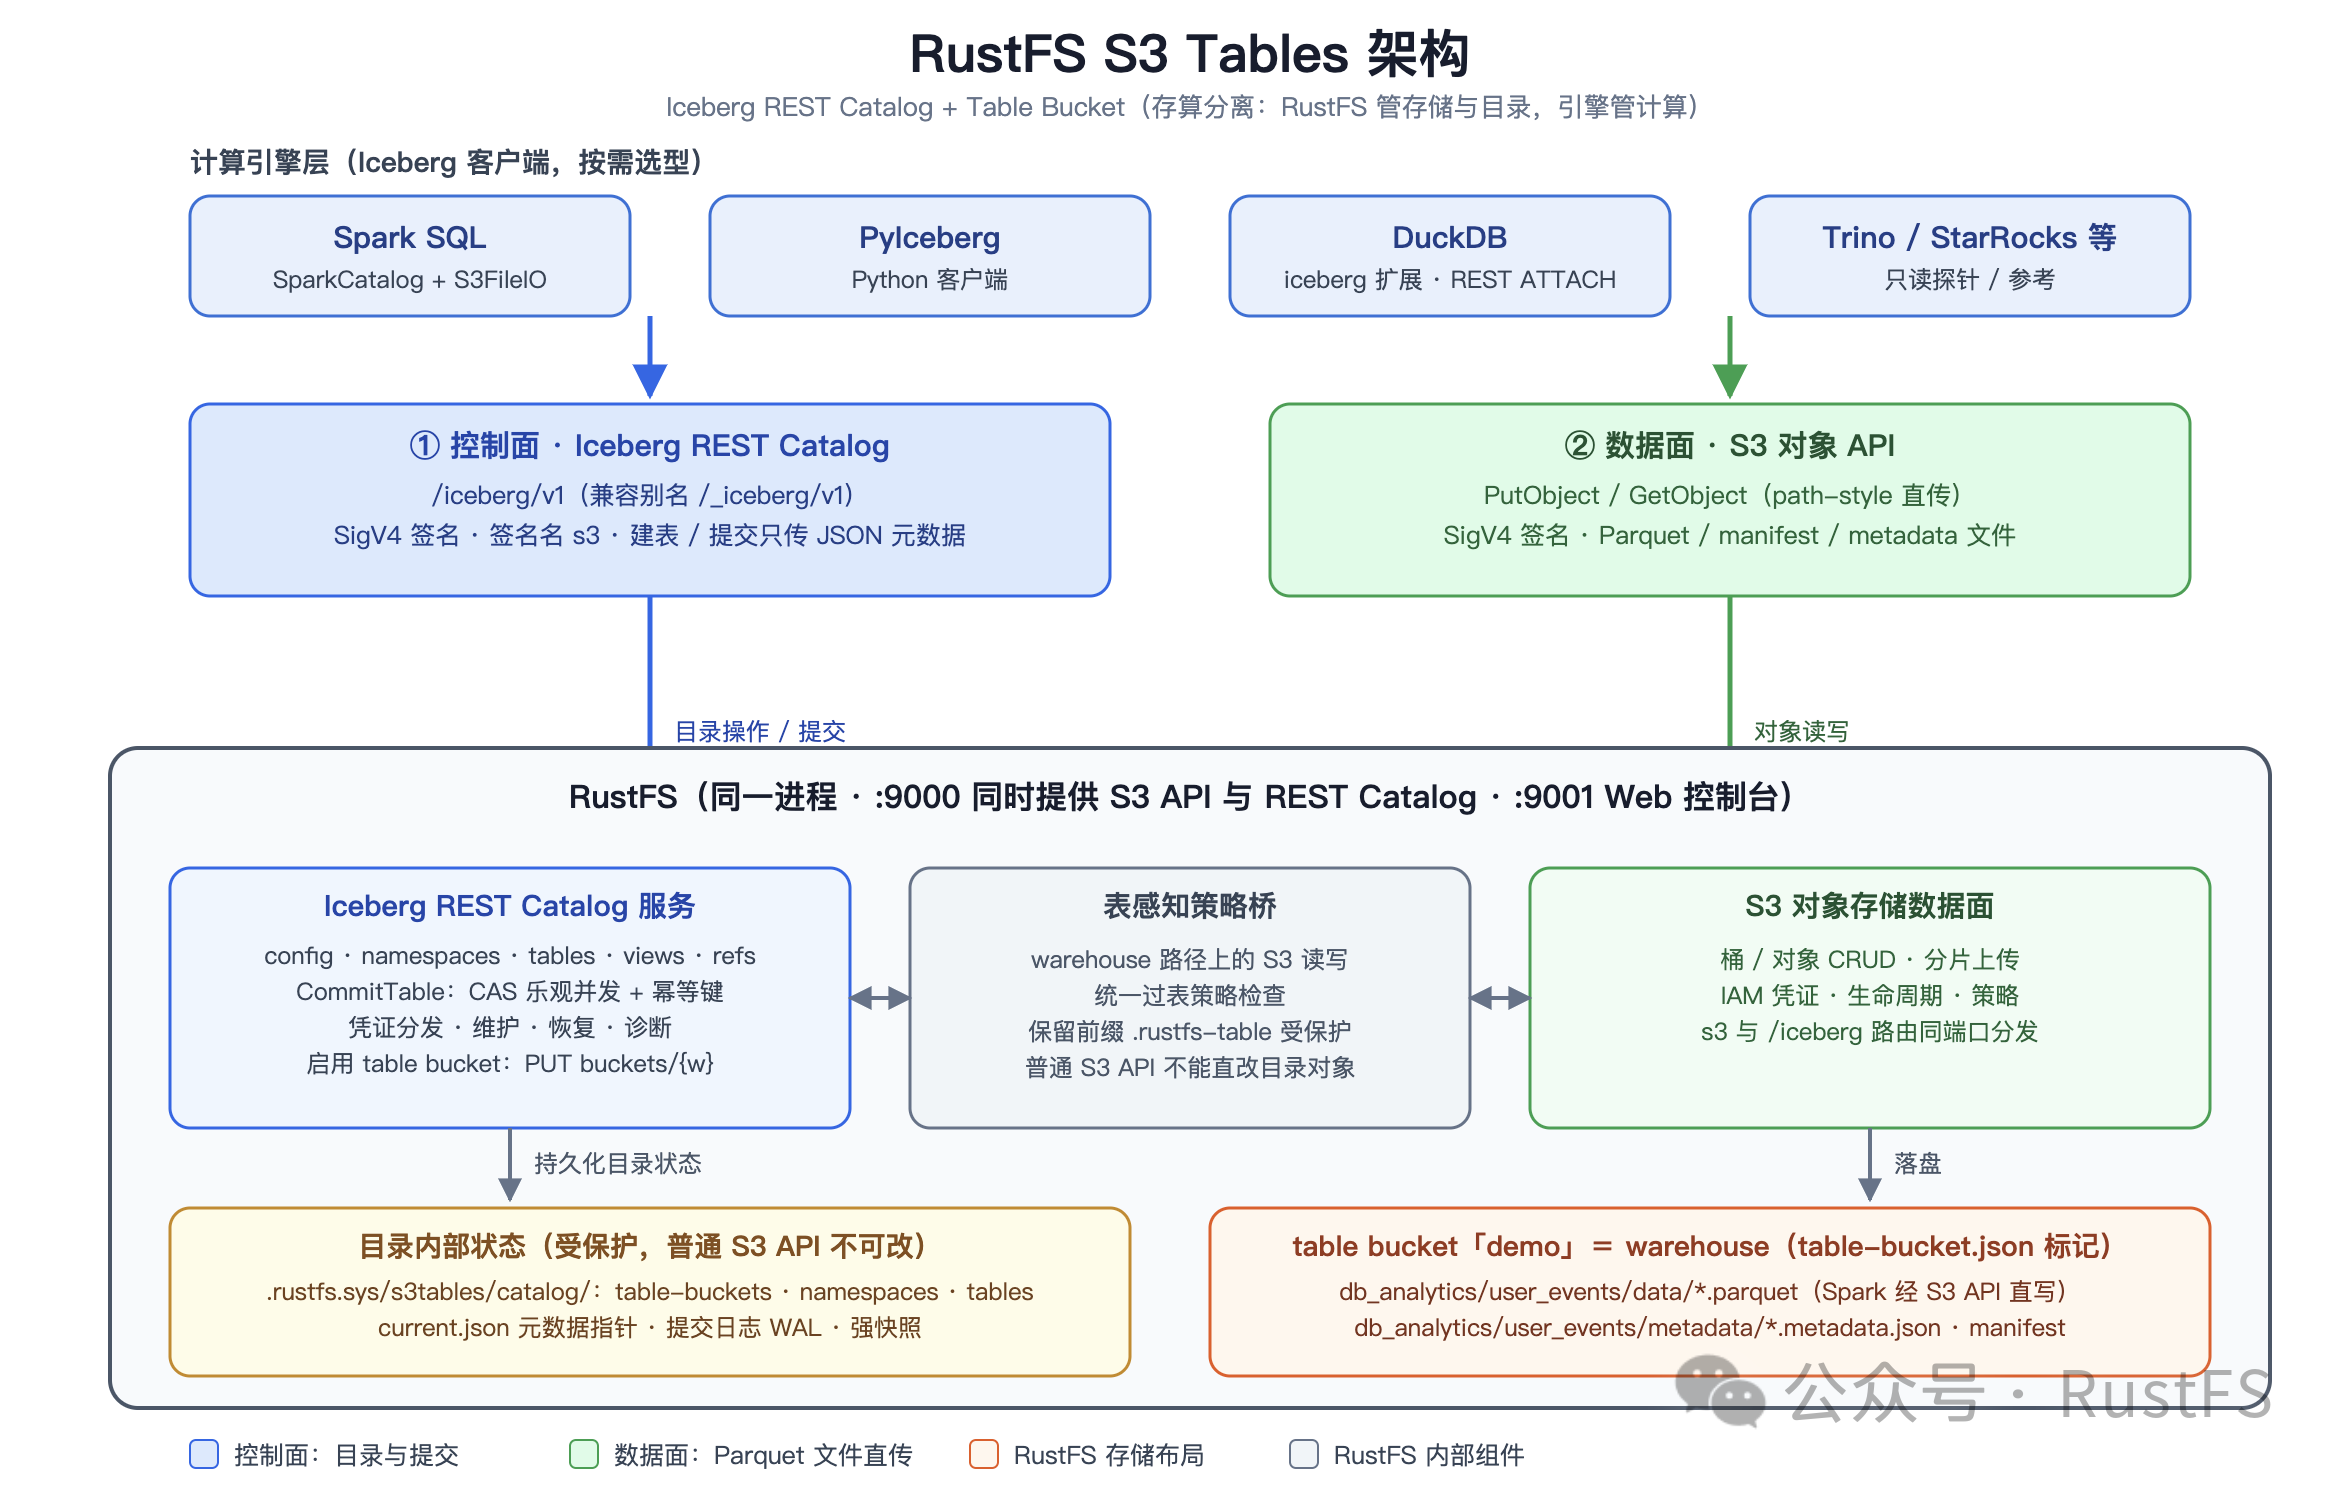
RustFS 也跟上了,实现了 Iceberg REST Catalog,支持 PyIceberg 和 DuckDB 直接连接。
目前这个功能还是 Preview 状态,不是 GA,但已经能完成建表和快照读写。
这个功能对 RAG 场景特别有意义。
传统的 RAG 架构里,原始文档存在对象存储(MinIO / S3),处理后的结构化元数据存在数据库(MySQL / PostgreSQL),向量索引存在 Elasticsearch 或 Milvus。
有了 S3 Tables,原始文档和处理后的结构化元数据可以放在同一个存储层里。RustFS 同时承担对象存储和数据湖的角色。
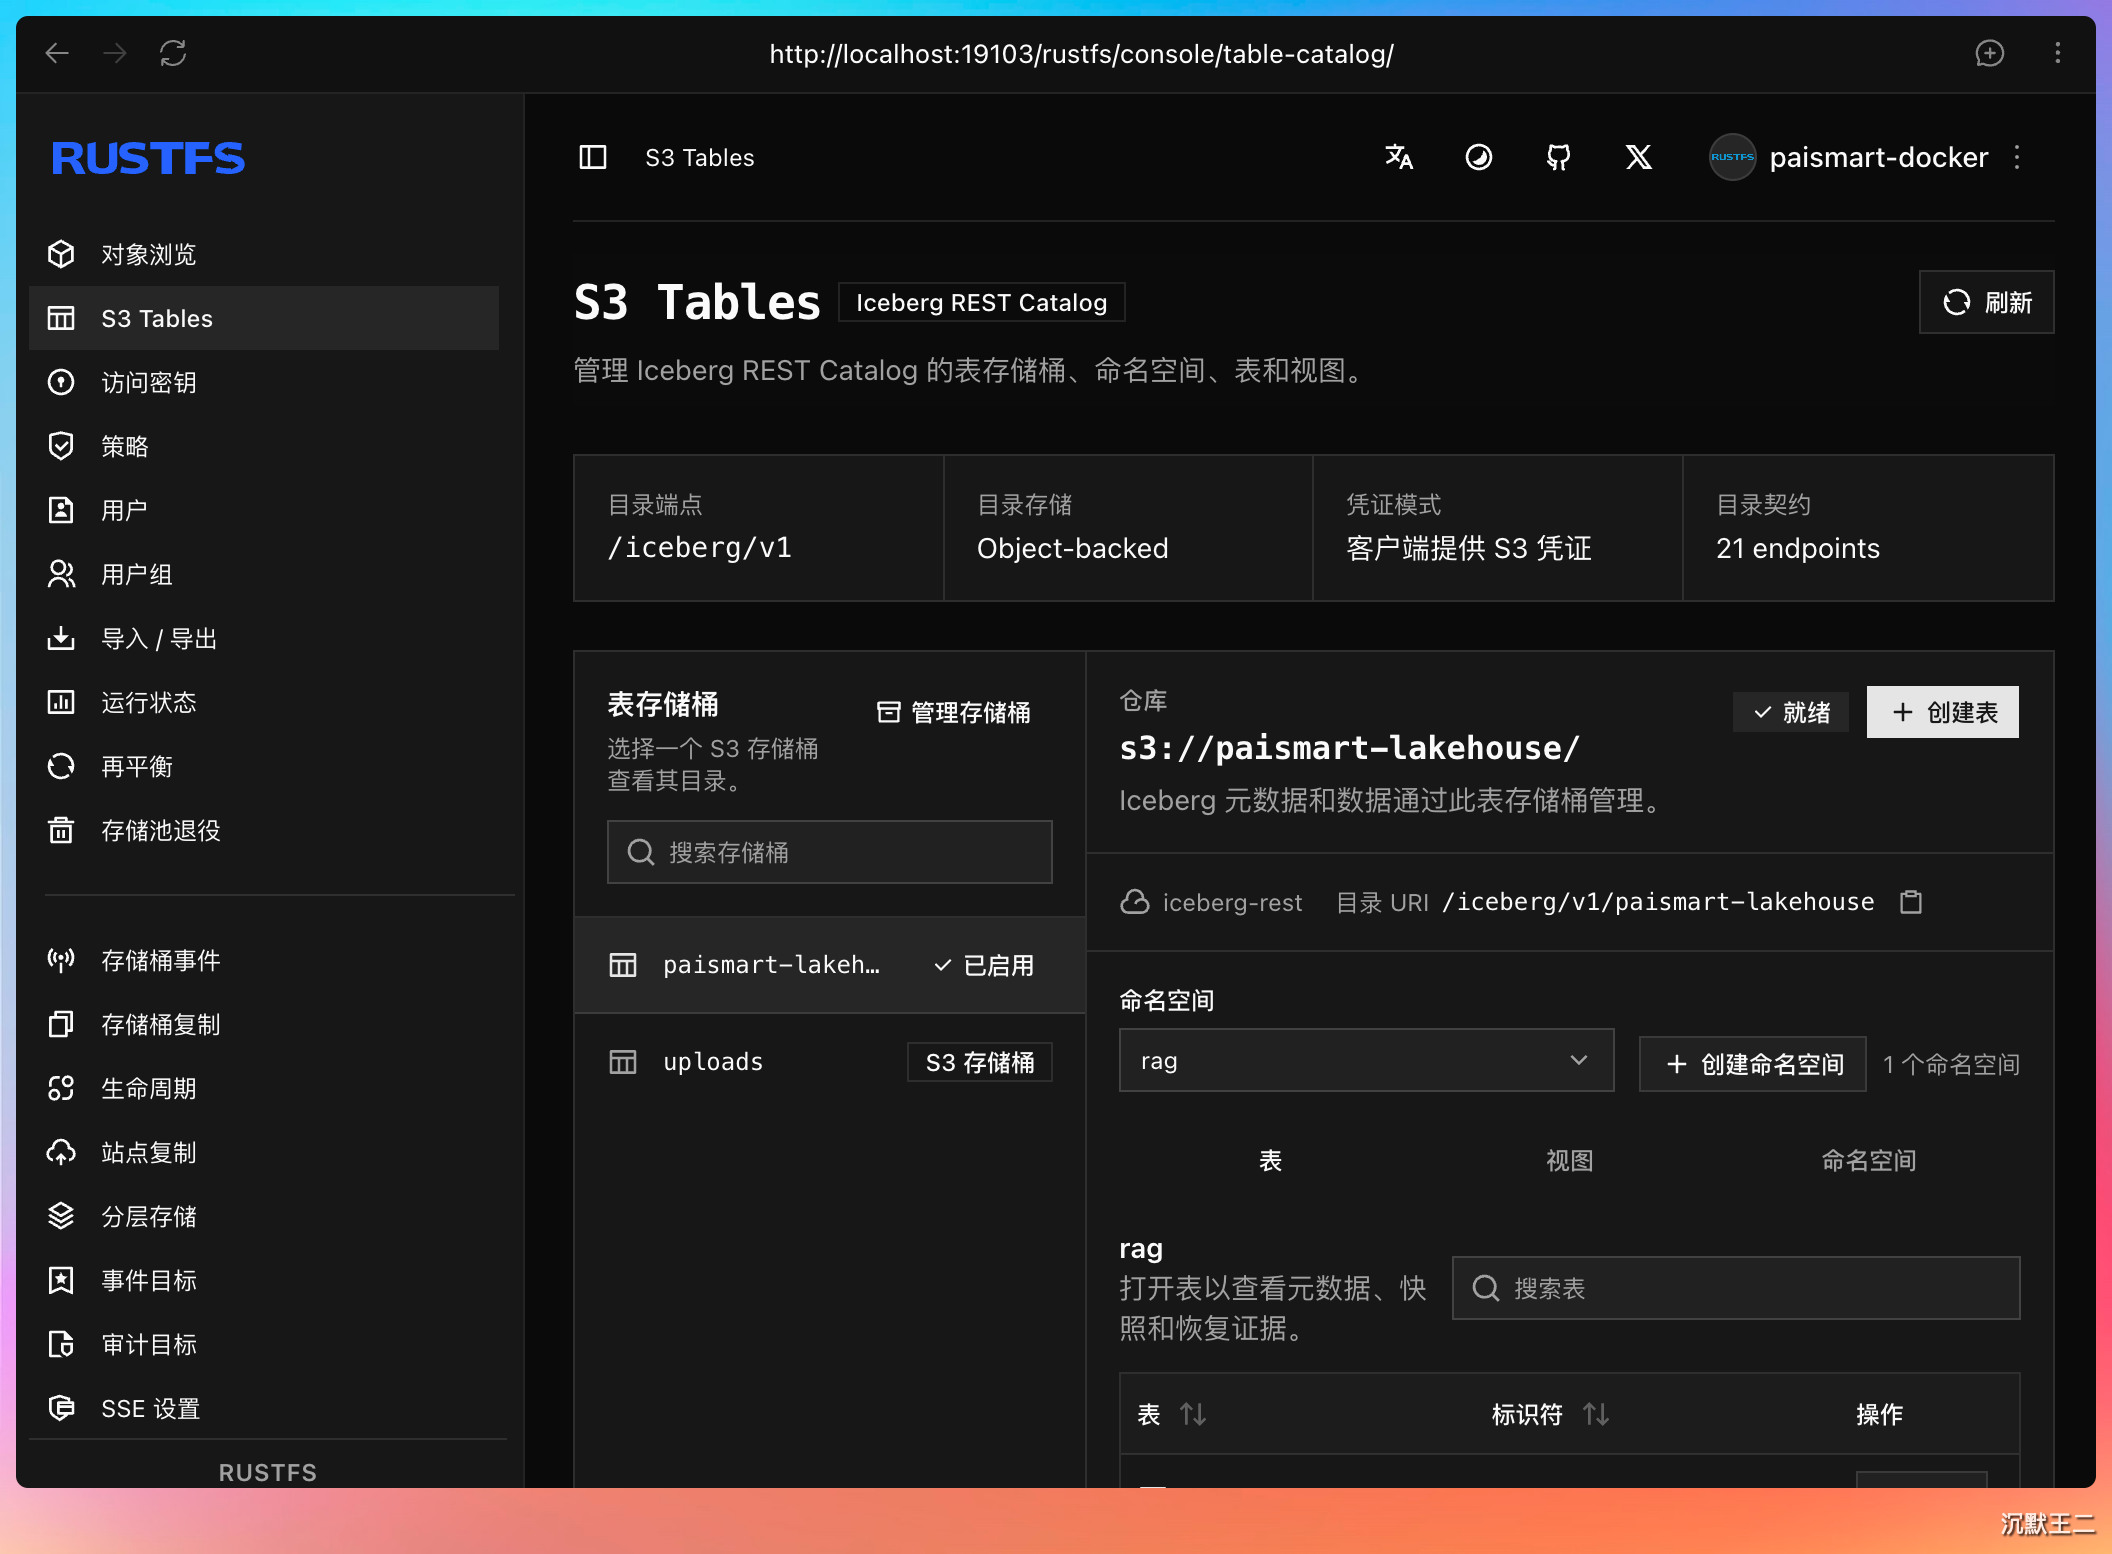
在派聪明项目里,我用 PyIceberg 0.10.0 把 RAG 的分块数据写入了 RustFS 的 Iceberg 表,能用 DuckDB 做 SQL 查询。脚本会创建独立的 paismart-lakehouse 桶,经签名请求开启 table bucket,连接 RustFS 的 /iceberg REST Catalog,创建 Iceberg 表,写入数据,重新加载表并读取快照。
python scripts/rustfs-iceberg-demo.py \
  --object-key datasets/rag/文件MD5/导出UUID.jsonl
SELECT count(*) AS rows,
count(DISTINCT (file_md5, chunk_id)) AS chunks,
sum(length(text)) AS characters
FROM rag_chunks;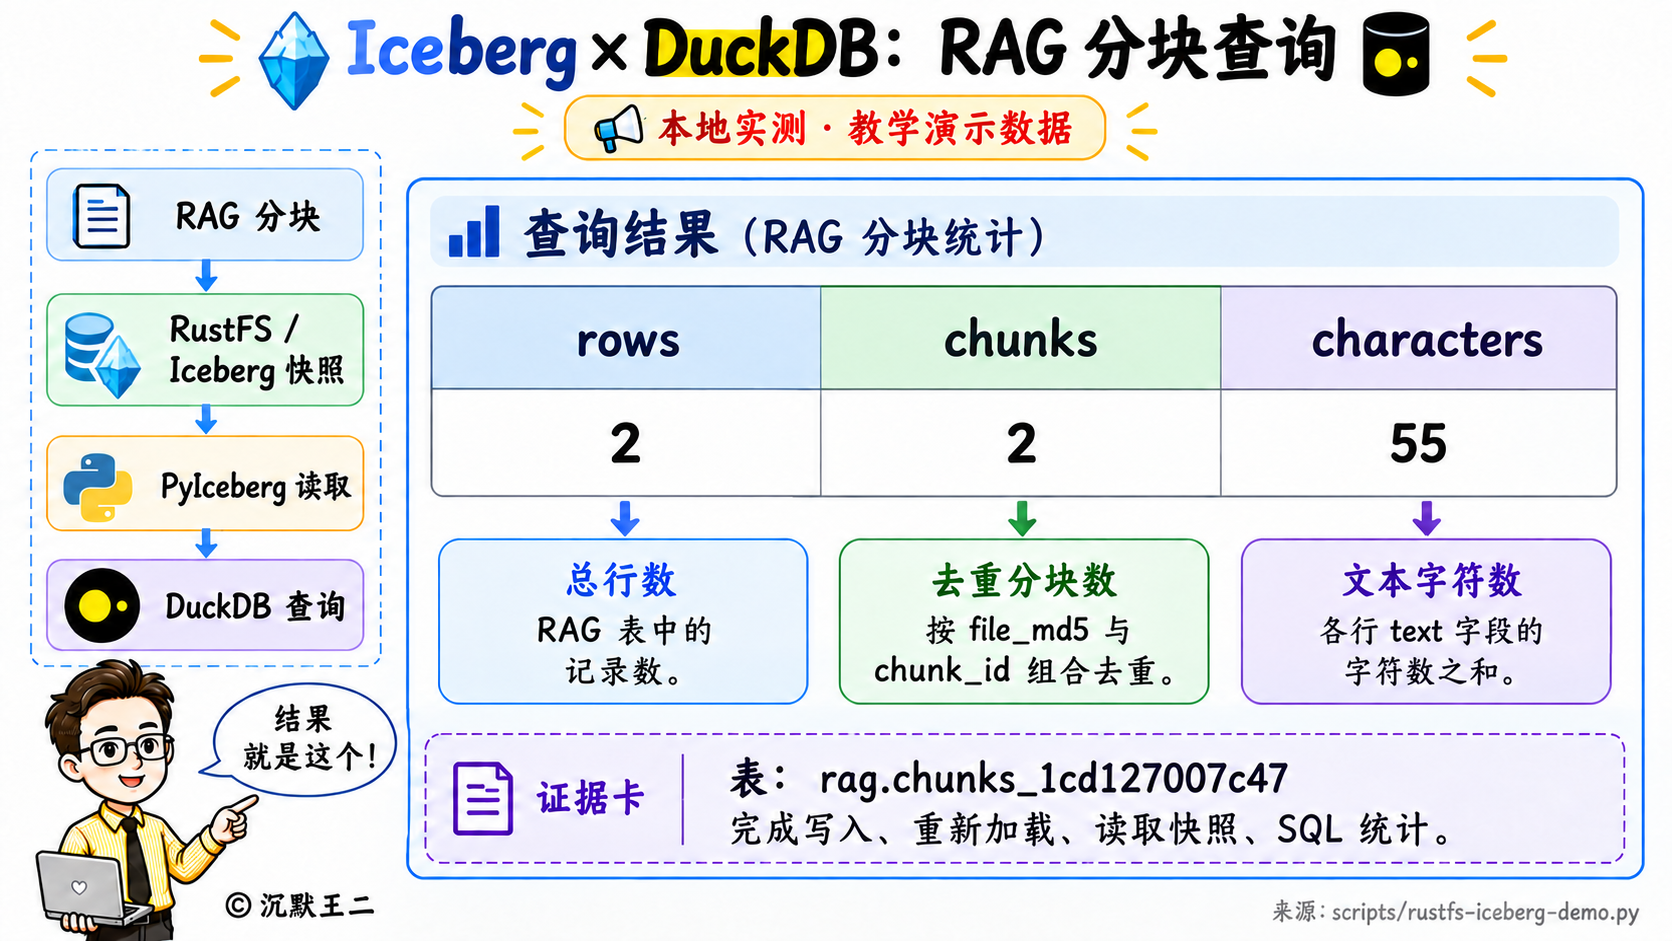
05、Docker 部署 RustFS
实战环节来了。
我们先部署 RustFS。
最简单的方式是用 Docker。RustFS 官方提供了镜像 rustfs/rustfs,API 端口 9000,控制台端口 9001。
如果只是想快速体验,一条命令就能跑起来。
docker run -d -p 9000:9000 -p 9001:9001 \ -e RUSTFS_ACCESS_KEY=rustfs@test \ -e RUSTFS_SECRET_KEY=rustfs@test \ -e RUSTFS_VOLUMES="/data/rustfs/ga/snsd" \ -e RUSTFS_ADDRESS=":9000" \ -e RUSTFS_CONSOLE_ADDRESS=":9001" \ -e RUSTFS_CONSOLE_ENABLE=true \ -e RUSTFS_OBS_LOGGER_LEVEL=error \ -e RUSTFS_OBS_LOG_DIRECTORY="/var/log/rustfs/" \ -v $(pwd)/data:/data \ -v $(pwd)/logs:/logs \ rustfs/rustfs:latest使用上一步指定的 RUSTFS_ACCESS_KEY 和 RUSTFS_SECRET_KEY 的值,打开 http://localhost:9001 就能看到控制台。
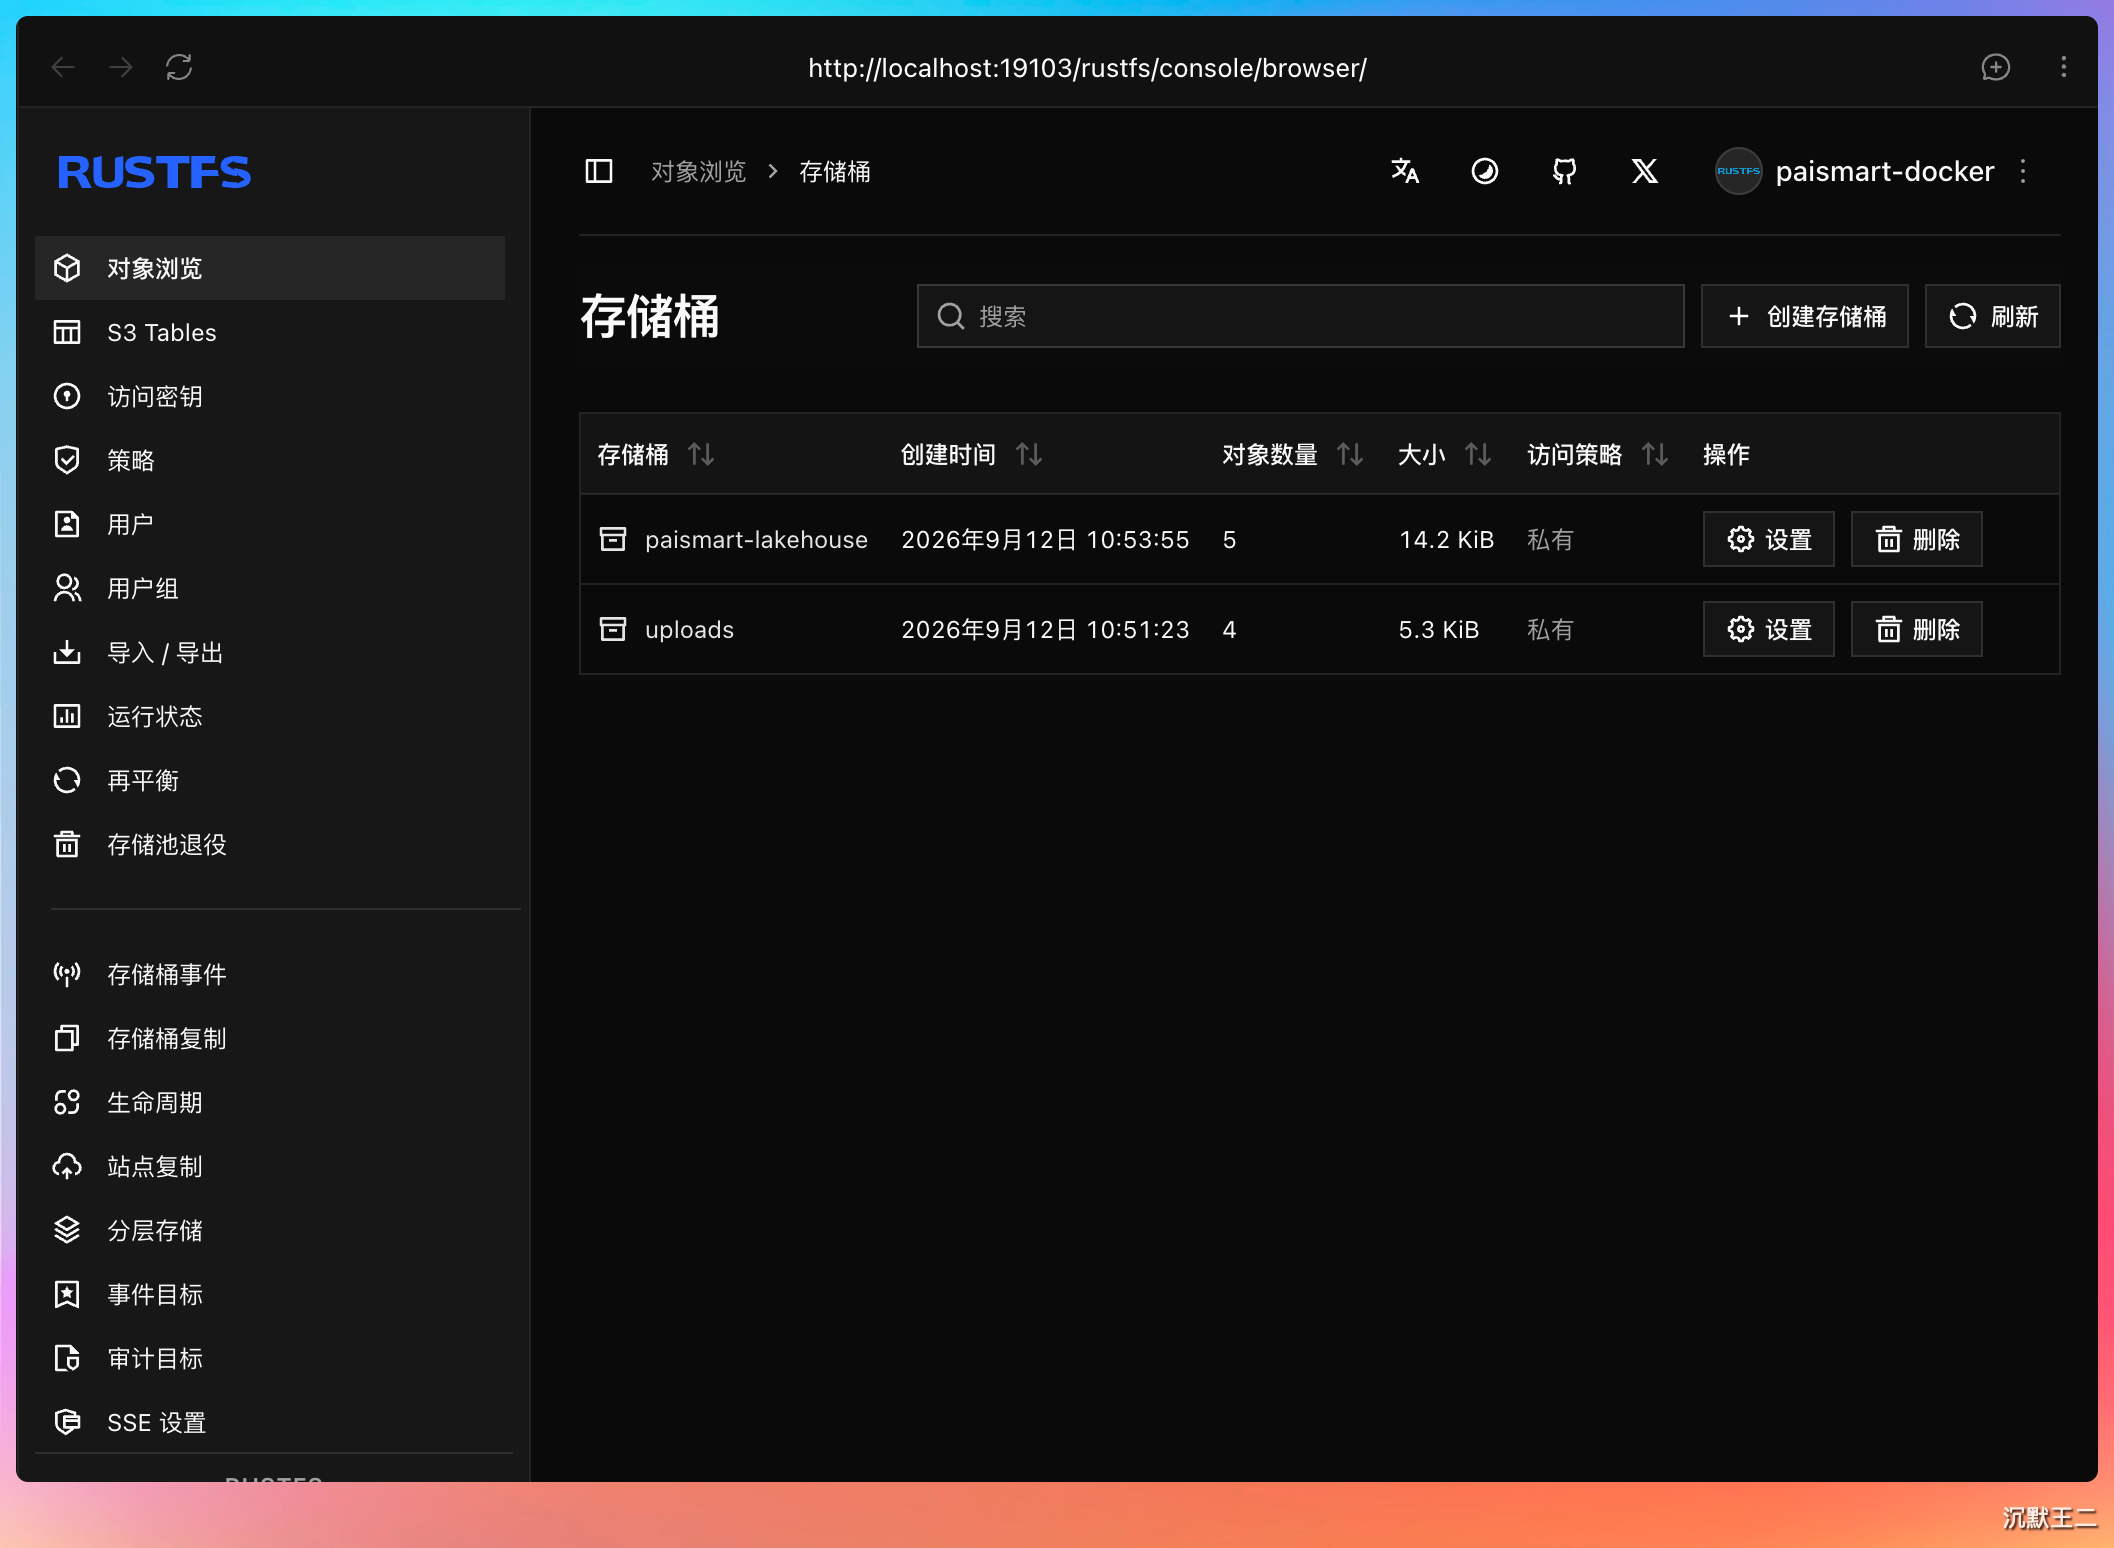
如果是 Linux 服务器,记得让容器内的 UID/GID 10001:10001 对挂载目录有写权限,否则启动会报权限错误。
在派聪明项目里,我直接把 RustFS 写进了 Docker Compose。
rustfs:
  image: rustfs/rustfs:1.0.0-rc.6
  ports:
    - '127.0.0.1:${RUSTFS_API_PORT:-19102}:9000'
    - '127.0.0.1:${RUSTFS_CONSOLE_PORT:-19103}:9001'
  environment:
    RUSTFS_VOLUMES: /data
    RUSTFS_ADDRESS: 0.0.0.0:9000
    RUSTFS_CONSOLE_ADDRESS: 0.0.0.0:9001
    RUSTFS_CONSOLE_ENABLE: 'true'
    RUSTFS_ACCESS_KEY: ${RUSTFS_ACCESS_KEY}
    RUSTFS_SECRET_KEY: ${RUSTFS_SECRET_KEY}
    RUSTFS_CORS_ALLOWED_ORIGINS: ${RUSTFS_CORS_ALLOWED_ORIGINS:-http://localhost:19527}
  volumes: [rustfs-data:/data, rustfs-logs:/logs]
  healthcheck:
    test: [CMD, curl, -f, 'http://localhost:9000/health']
    interval: 5s
    retries: 40
几个需要注意的地方。
RUSTFS_ACCESS_KEY和RUSTFS_SECRET_KEY是访问凭据,记得在.env文件里配置,不要硬编码到 Compose 文件里。RUSTFS_CORS_ALLOWED_ORIGINS控制浏览器跨域访问,前端直接访问预签名链接时必须配上前端的域名。
健康检查用 curl -f http://localhost:9000/health,RustFS 有内置的 health 端点。后端服务可以依赖这个健康检查。
backend:
  depends_on:
    rustfs: {condition: service_healthy}
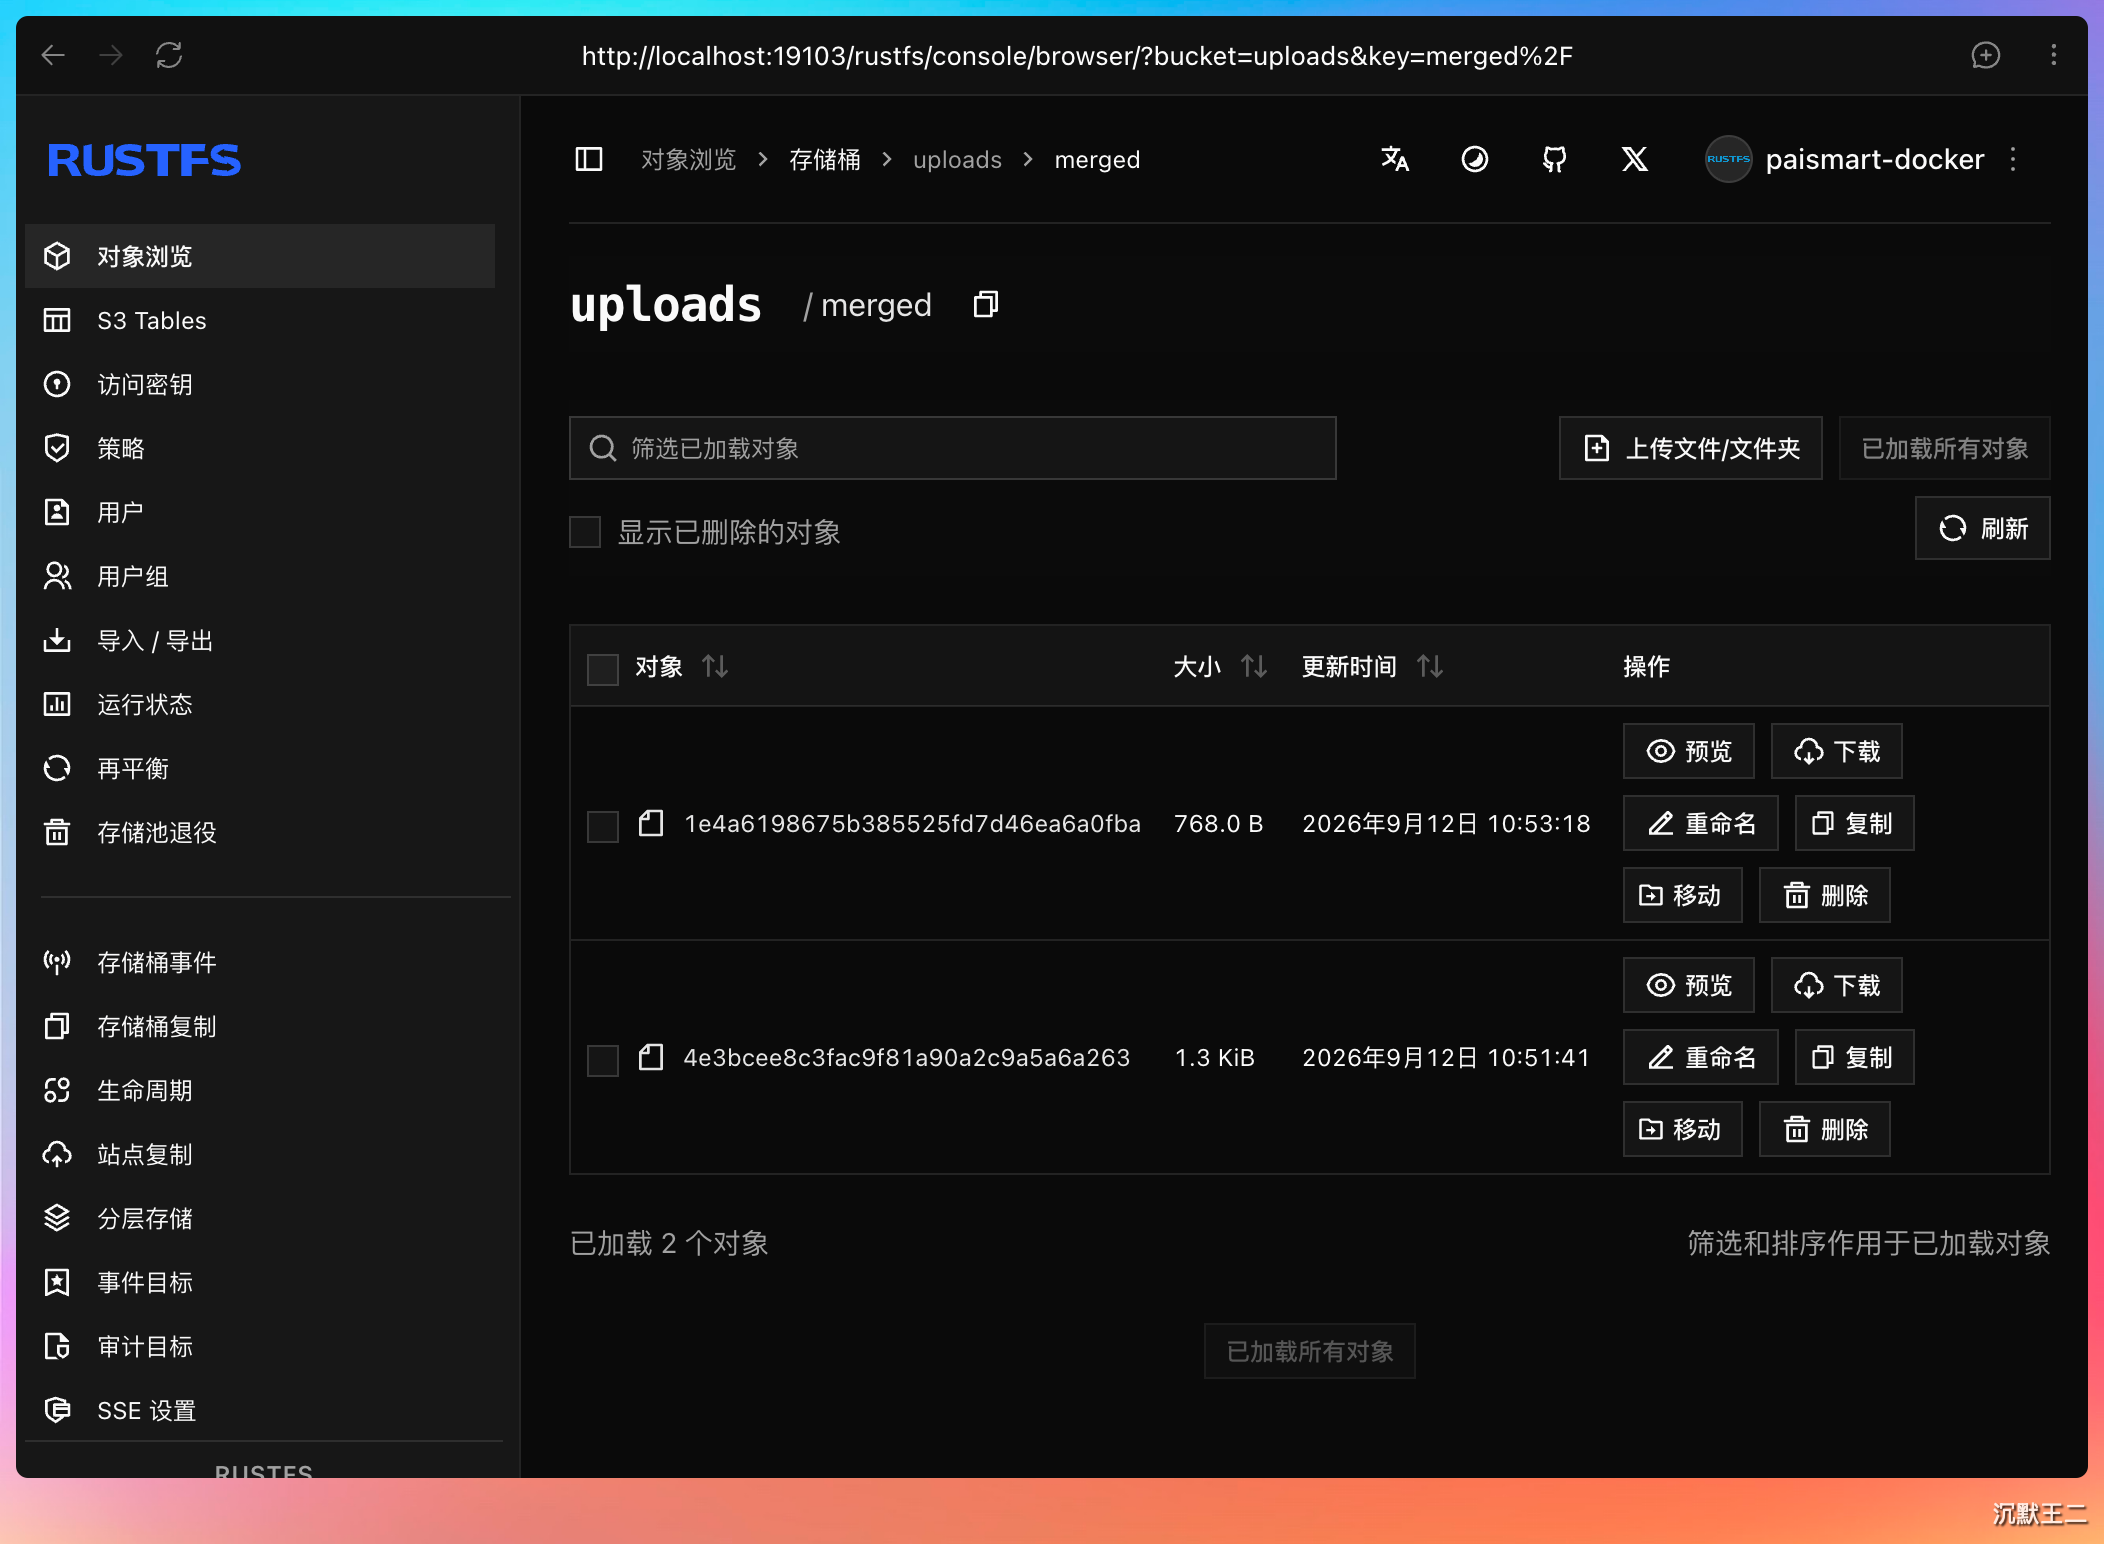
启动后访问 http://localhost:19103 就能看到 RustFS 的 Web 控制台。
环境变量配置复制 .env.example 为 .env 后修改。
RUSTFS_ENDPOINT=http://localhost:19002
RUSTFS_PUBLIC_URL=http://localhost:19002
RUSTFS_ACCESS_KEY=填写访问密钥
RUSTFS_SECRET_KEY=填写私密密钥
RUSTFS_BUCKET=uploads
RUSTFS_REGION=us-east-1
RUSTFS_CREATE_BUCKET=true
RUSTFS_ENDPOINT 是后端访问的内部地址,RUSTFS_PUBLIC_URL 是浏览器访问的公开地址,两个可以不一样。
比如容器内后端访问 http://rustfs:9000,浏览器通过 http://localhost:19002 访问。预签名链接的域名用的是 RUSTFS_PUBLIC_URL,因为 S3 SigV4 签名会把 Host 签进去,签完之后不能替换域名。
06、Spring Boot 对接 RustFS
RustFS 走的是标准 S3 API,Java 端用 AWS SDK for Java v2 就行。
pom.xml 加一个依赖。
<dependency>
    <groupId>software.amazon.awssdk</groupId>
    <artifactId>s3</artifactId>
    <version>2.54.17</version>
</dependency>
配置类 S3StorageConfig 负责创建 S3Client 和 S3Presigner。
@Configuration
public class S3StorageConfig {
    @Value("${storage.s3.endpoint}") private String endpoint;
    @Value("${storage.s3.public-url}") private String publicUrl;
    @Value("${storage.s3.access-key}") private String accessKey;
    @Value("${storage.s3.secret-key}") private String secretKey;
    @Value("${storage.s3.region:us-east-1}") private String region;
    @Value("${storage.s3.bucket:uploads}") private String bucket;

    @Bean
    public S3Client s3Client() {
        return S3Client.builder()
                .endpointOverride(URI.create(endpoint))
                .region(Region.of(region))
                .credentialsProvider(StaticCredentialsProvider.create(
                    AwsBasicCredentials.create(accessKey, secretKey)))
                .forcePathStyle(true)
                .build();
    }

    @Bean
    public S3Presigner s3Presigner() {
        return S3Presigner.builder()
                .endpointOverride(URI.create(publicUrl))
                .region(Region.of(region))
                .credentialsProvider(StaticCredentialsProvider.create(
                    AwsBasicCredentials.create(accessKey, secretKey)))
                .serviceConfiguration(S3Configuration.builder()
                    .pathStyleAccessEnabled(true).build())
                .build();
    }
}
注意 forcePathStyle(true) 这个设置。RustFS 用的是 path style(http://host/bucket/key),不是 virtual hosted style(http://bucket.host/key)。如果不加这个配置,SDK 会把桶名放到域名前面,请求直接 404。
S3Presigner 的 endpoint 用的是 publicUrl,保证浏览器拿到的预签名链接能正确访问。这里有个容易踩的坑,S3 SigV4 签名会把 Host 头签进去,所以不要先用内部地址生成签名再字符串替换成外部域名,签名校验会直接失败。
应用启动时,ObjectStorageService 会自动检查桶是否存在,不存在就创建。
@PostConstruct
public void initializeBucket() {
    if (!config.isCreateBucket()) return;
    try {
        client.headBucket(b -> b.bucket(config.getBucket()));
    } catch (S3Exception e) {
        if (e.statusCode() != 404) throw e;
        client.createBucket(b -> b.bucket(config.getBucket()));
    }
}
ObjectStorageService 封装了所有的存储操作,上传、下载、预签名、分片合并、删除、复制,全部走标准 S3 API。
@Service
public class ObjectStorageService {
    private static final int PART_SIZE = 8 * 1024 * 1024;

    public void put(String key, byte[] bytes, String contentType) {
        client.putObject(
            b -> b.bucket(config.getBucket()).key(key).contentType(contentType),
            RequestBody.fromBytes(bytes));
    }

    public String presign(String key) {
        return presigner.presignGetObject(
            b -> b.signatureDuration(Duration.ofHours(1))
                .getObjectRequest(r -> r.bucket(config.getBucket()).key(key)))
            .url().toString();
    }
}
分片合并这块稍微复杂一点。
浏览器端上传的分片可能小于 S3 Multipart Upload 的 5 MiB 最小 part 限制,所以 compose 方法先把所有分片下载到本地临时文件,再按 8 MiB 切片上传 Multipart,上传失败时自动 Abort,源分片保留用于重试。
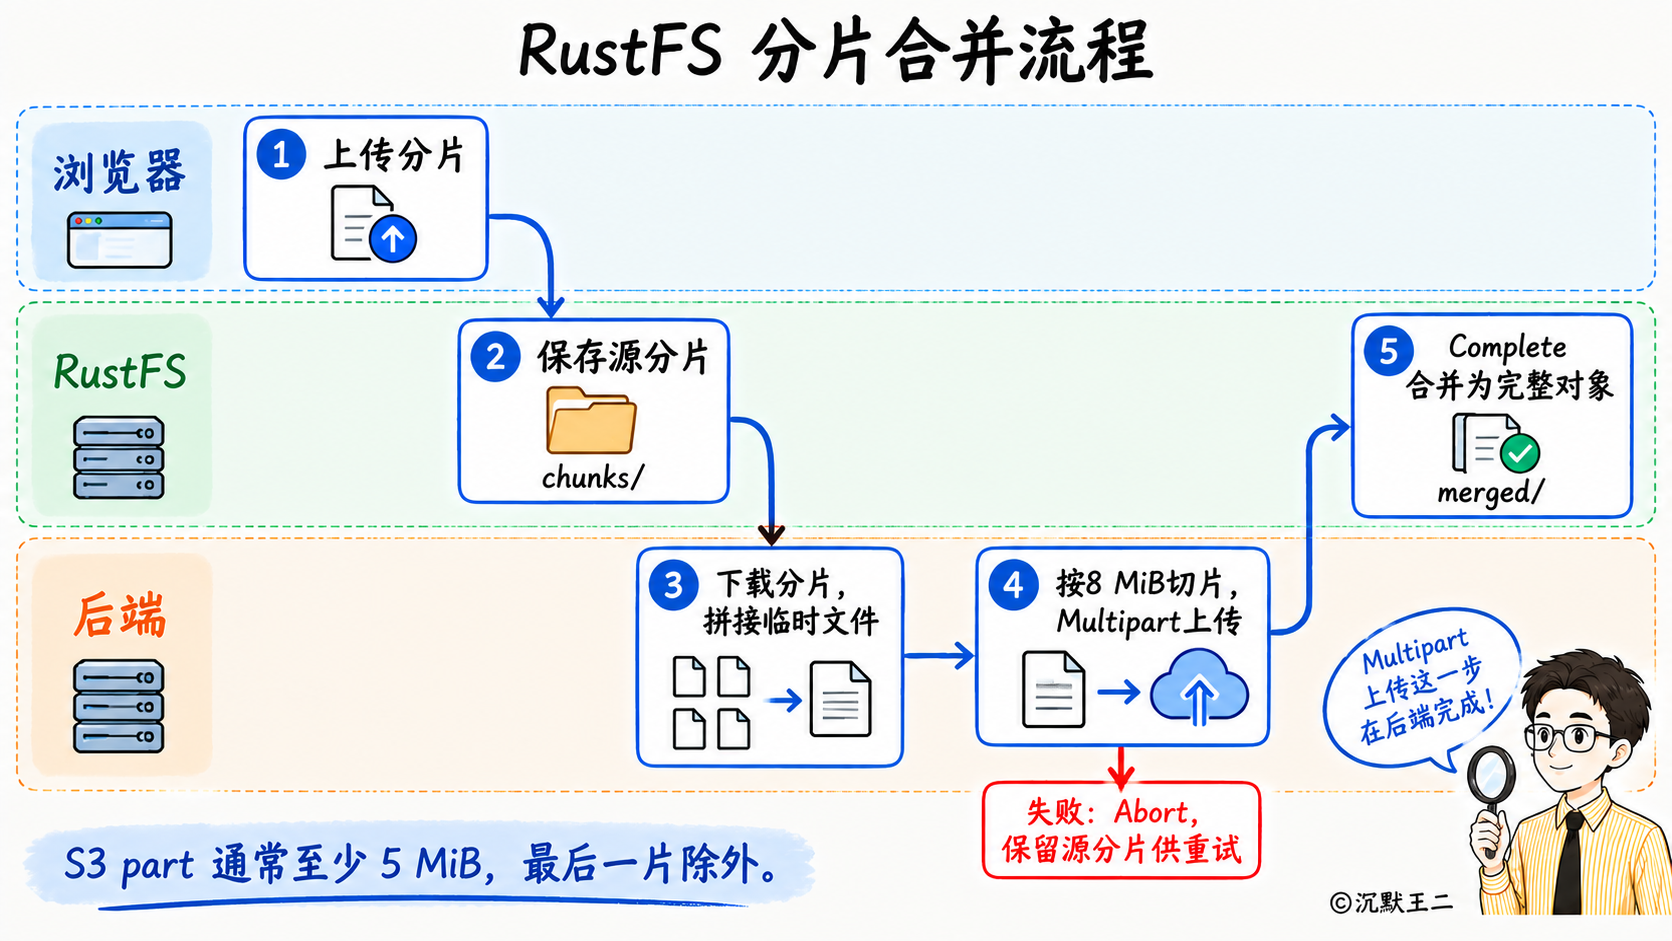
整个 RAG 场景的数据流是这样的。
- 前端把文件分片上传到 RustFS,对象路径是
chunks/{fileMd5}/{chunkIndex} - 分片上传完成后,后端把分片合并为完整文件,保存到
merged/{fileMd5} - Kafka 消息触发异步处理,消费者通过 S3Client 从 RustFS 读取原文
- 文档解析器切块,文本分块存 MySQL,Embedding 模型生成向量写入 Elasticsearch
- 前端预览、下载用的是 1 小时有效的预签名链接
07、从 MinIO 迁移到 RustFS
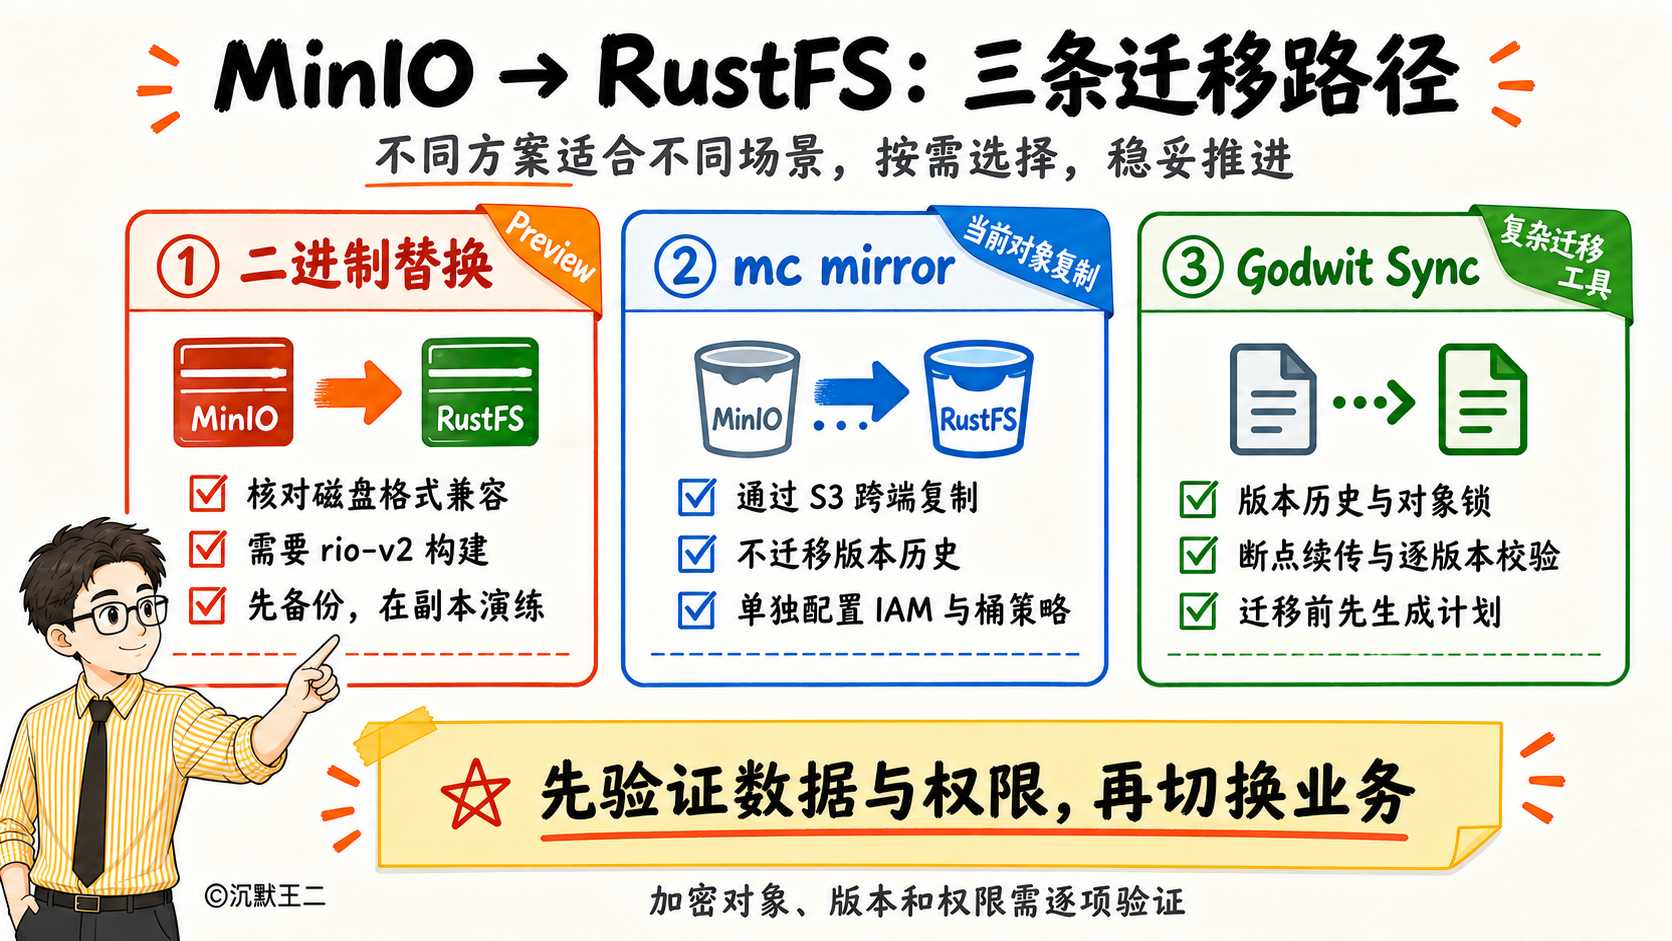
三条路可以走。
第一条,二进制替换。RustFS 可以直接读取 MinIO 的数据目录,不需要移动数据。停掉 MinIO,启动 RustFS 指向同一个数据目录,IAM 配置自动继承。
Docker 用户换一下镜像就行。停机时间大概 2-5 分钟。
第二条,mc mirror 跨服务器复制。用 MinIO 的命令行工具 mc 做数据迁移。
mc alias set minio-old https://minio.example.com ACCESS SECRET
mc alias set rustfs-new https://rustfs.example.com ACCESS SECRET
mc mirror --watch --overwrite minio-old/bucket rustfs-new/bucket
这种方式只复制当前版本的对象,不迁移版本历史。
第三条,Godwit Sync。处理版本历史、对象锁、断点续传这些复杂场景。生产环境推荐这种方式。
在派聪明项目里,我写了一个 Python 迁移脚本 migrate-object-storage.py,通过标准 S3 API 从旧存储读取对象,复制到 RustFS 后逐对象校验 SHA-256。
# 默认只统计,不执行复制
python scripts/migrate-object-storage.py

# 确认无误后加 --apply 真正执行
python scripts/migrate-object-storage.py --apply
脚本默认只做统计,列出有多少对象、总大小多少,不会真的往 RustFS 写任何数据。确认数据量和对象清单没问题后,加 --apply 参数才会执行复制。每个对象复制完成后立即做 SHA-256 校验,源和目标的哈希对不上就报错停止。
脚本还会保留对象的 ContentType、ContentEncoding、Metadata 和 Tags,不会丢失元信息。如果目标桶里已经存在同名对象但内容不同,脚本会停止,防止覆盖。重复执行时会跳过已经成功复制的对象,支持中断后继续。
ending
从 MinIO 切换到 RustFS 后,说说我的真实感受。
1、有了 GPT-6 Astra 之后,代码迁移这部分是真的方便,半个小时就搞定了。
2、整体兼容度是真的高,迁移后没有任何问题。当然了,我这个项目的用户量比较小,数据量也比较小。老项目可以继续用MinIO,但新项目可以直接上RustFS了。
我们下期见。