
xiaom员工:年终奖3月5号发,已经谈了系数,今年的年终奖有点给力,基本都拿满了(附Agent面试题)
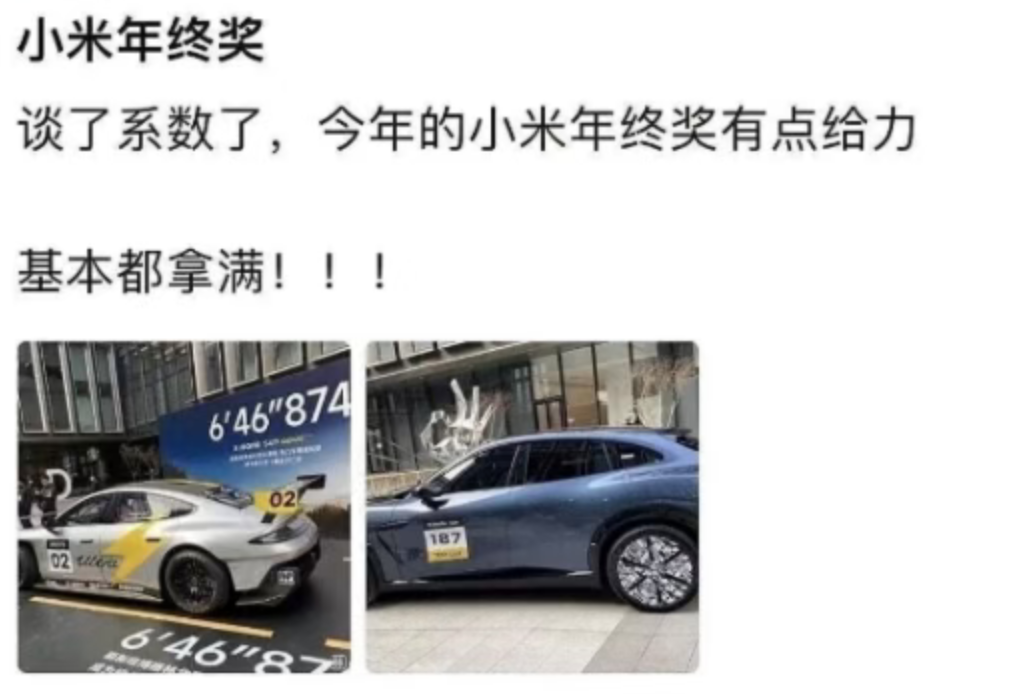
有同学后台发来一张包浆的截图,问我xiaom的年终奖真的已经谈好系数了吗?
说一下我的判断。
图片左下角晒出的“6分46秒874”是 SU7 Ultra 在纽北赛道刷出的纪录,右边是 SUV 车型(YU7),这些是 2026 年初的标志性事件。
所以 3 月 5 号发年终没问题,但说的应该是已经发生的事情,当时这两款汽车销量都很不错,所以汽车部门对年终奖满意也没问题。
新一轮的年终奖我觉得 xiaom 的 AI 团队有很大的机会满意。
不管是 MiMo 模型本身,还是衍生出来的 Harness,都值得一蹬。之前做 MiMo Code 的测评,评论区反馈就还不错。
9月8日,官方正式启动了自研桌面客户端 mimo desktop 的内测,我也第一时间申请了,但到今天还没拿到资格,呜呜呜。
不过从朋友苍何的测评来看,MiMo 桌面端的表现还不错。
1、支持自主操控电脑浏览器,虽然这已经是桌面端 Agent 的标配。
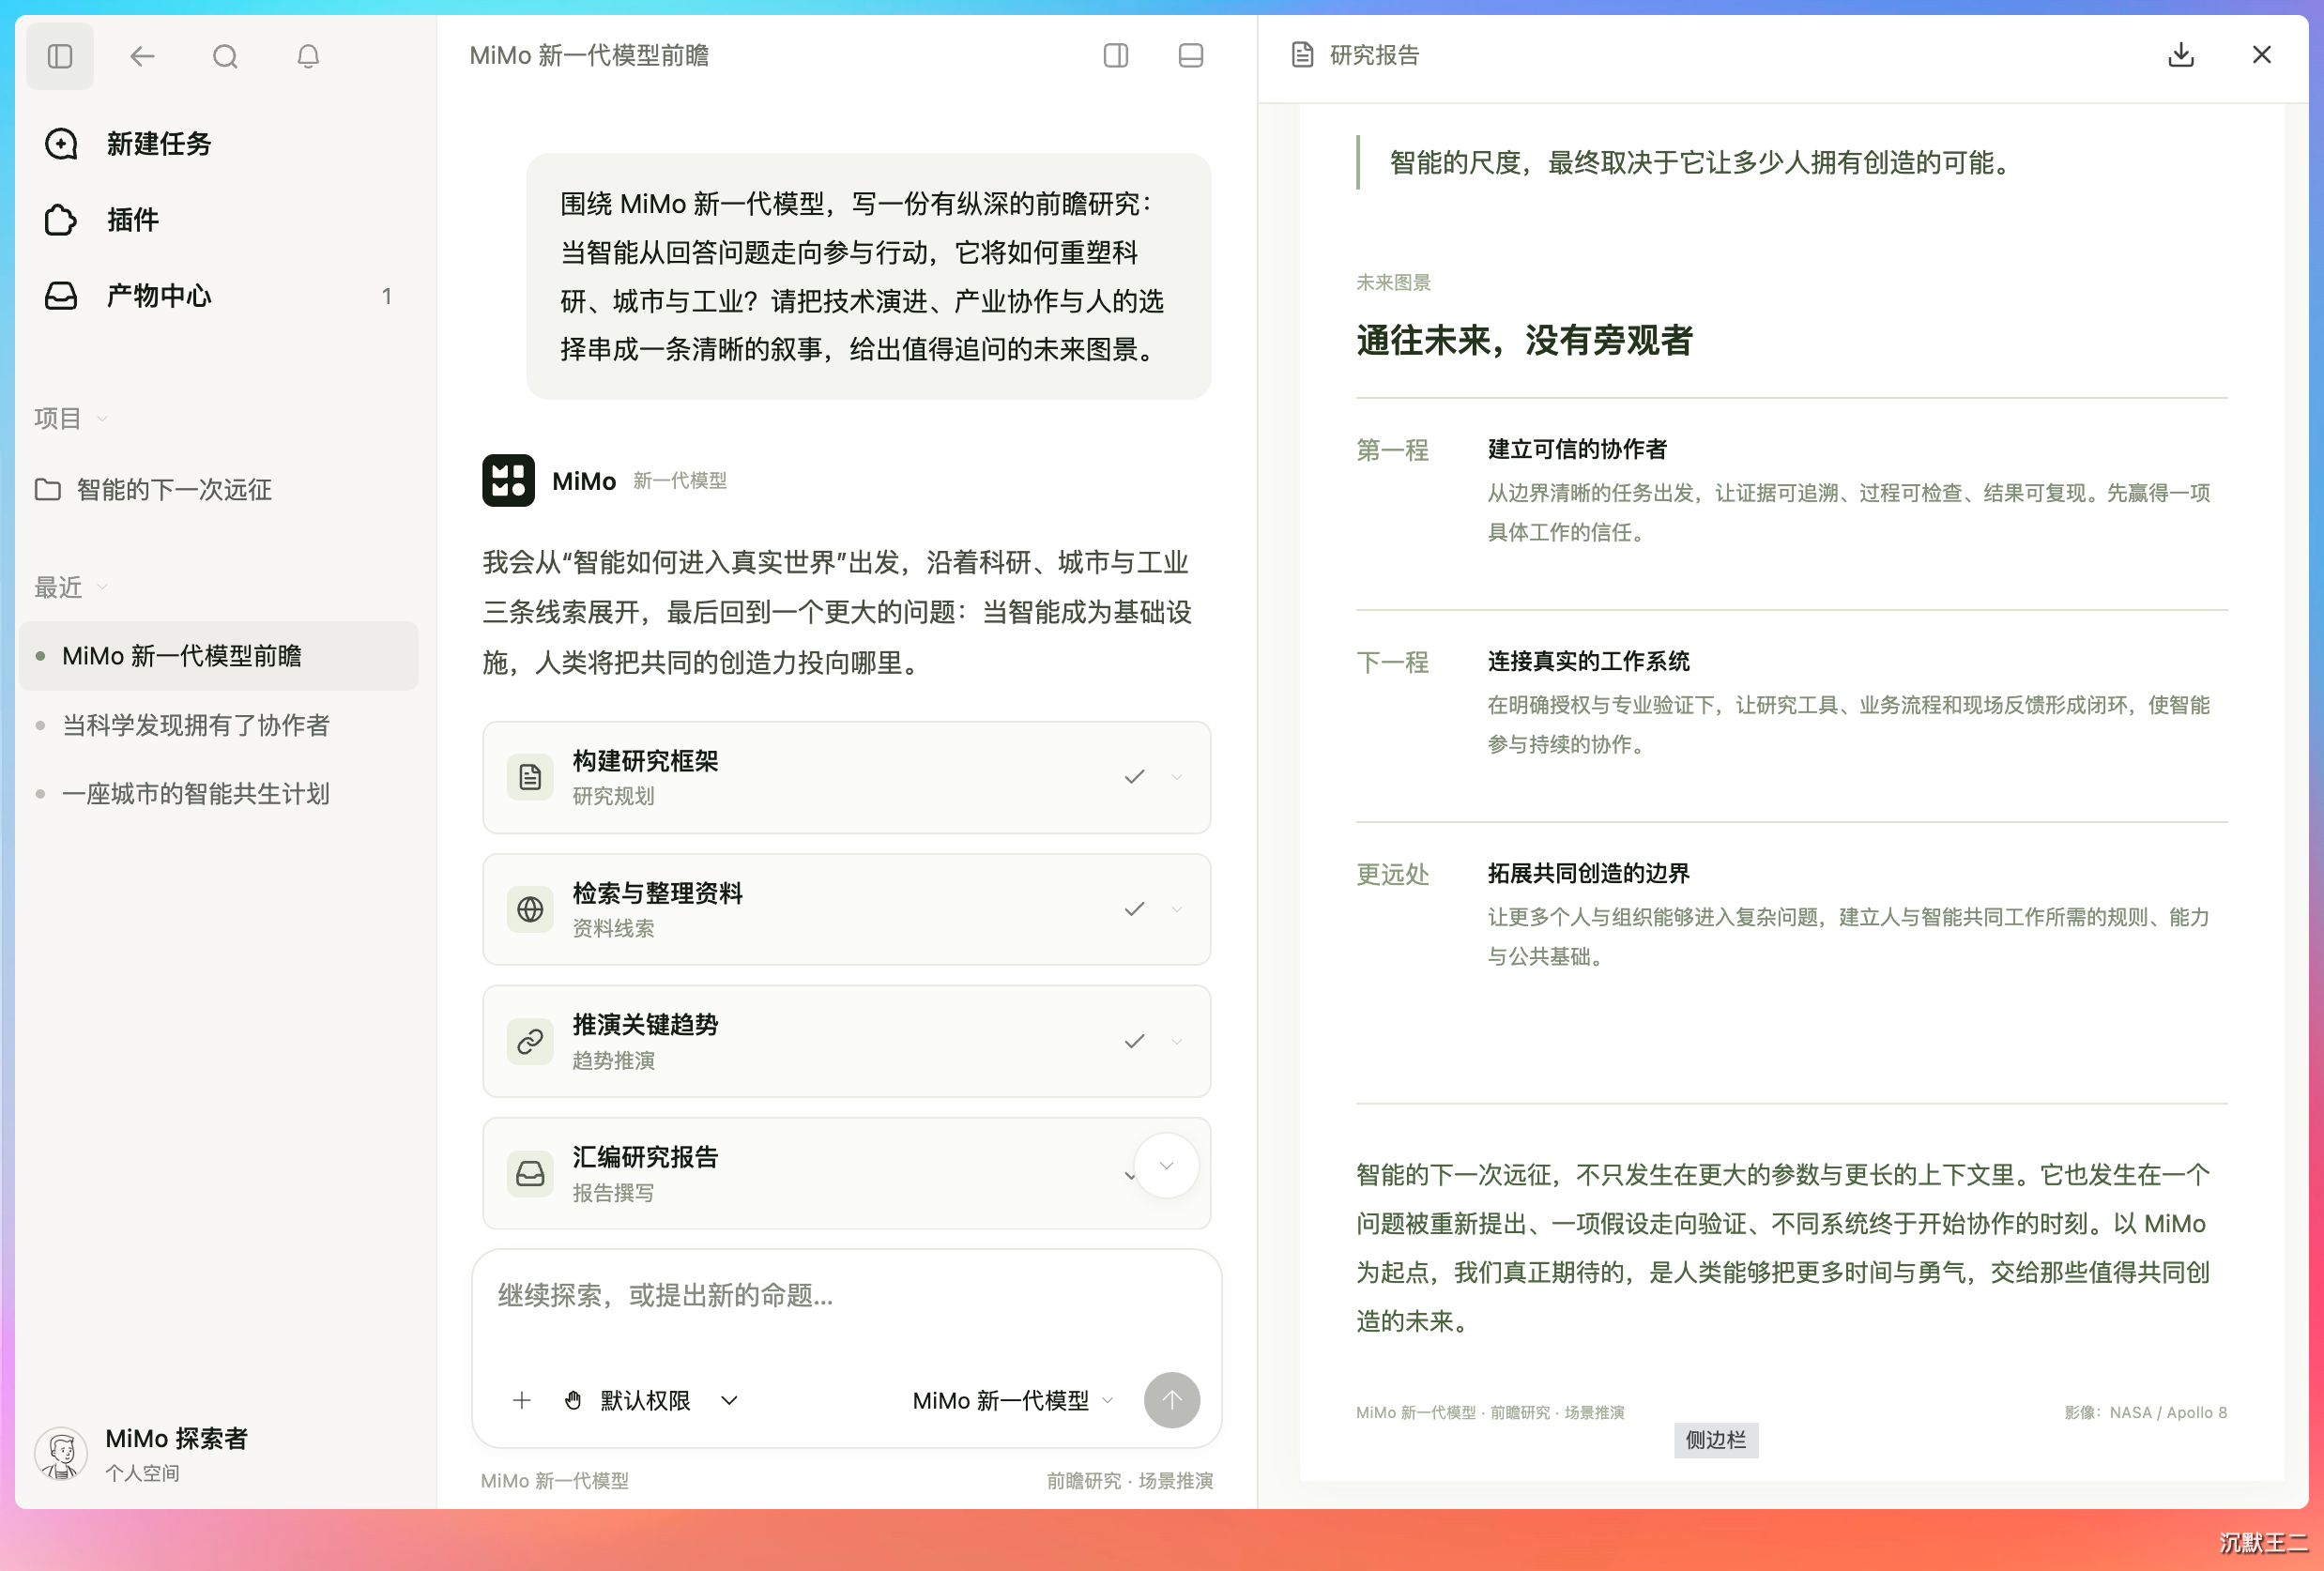
2、全模态工作台(可直接拖入压缩包):支持直接把文档、图片、音频、视频,甚至压缩包拖进去。可以一站式帮你生成可继续编辑的成果,涵盖 PPT、高保真 Office 文件、HTML 网页、甚至 3D 模型和轻量游戏原型。
3、测试期间还可以免费体验小米全新一代的大模型预览版(代号分别为:MiMo-X-Pro-Preview 和 MiMo-X-Flash-Preview)。
要我说,相比纯软件的 AI 公司,小米最强大的底牌是将大模型能力,放入全球连接数超 11 亿台的消费级 AIoT 硬件生态圈中,真正实现从数字界面走向物理世界的“硬核 AI”。
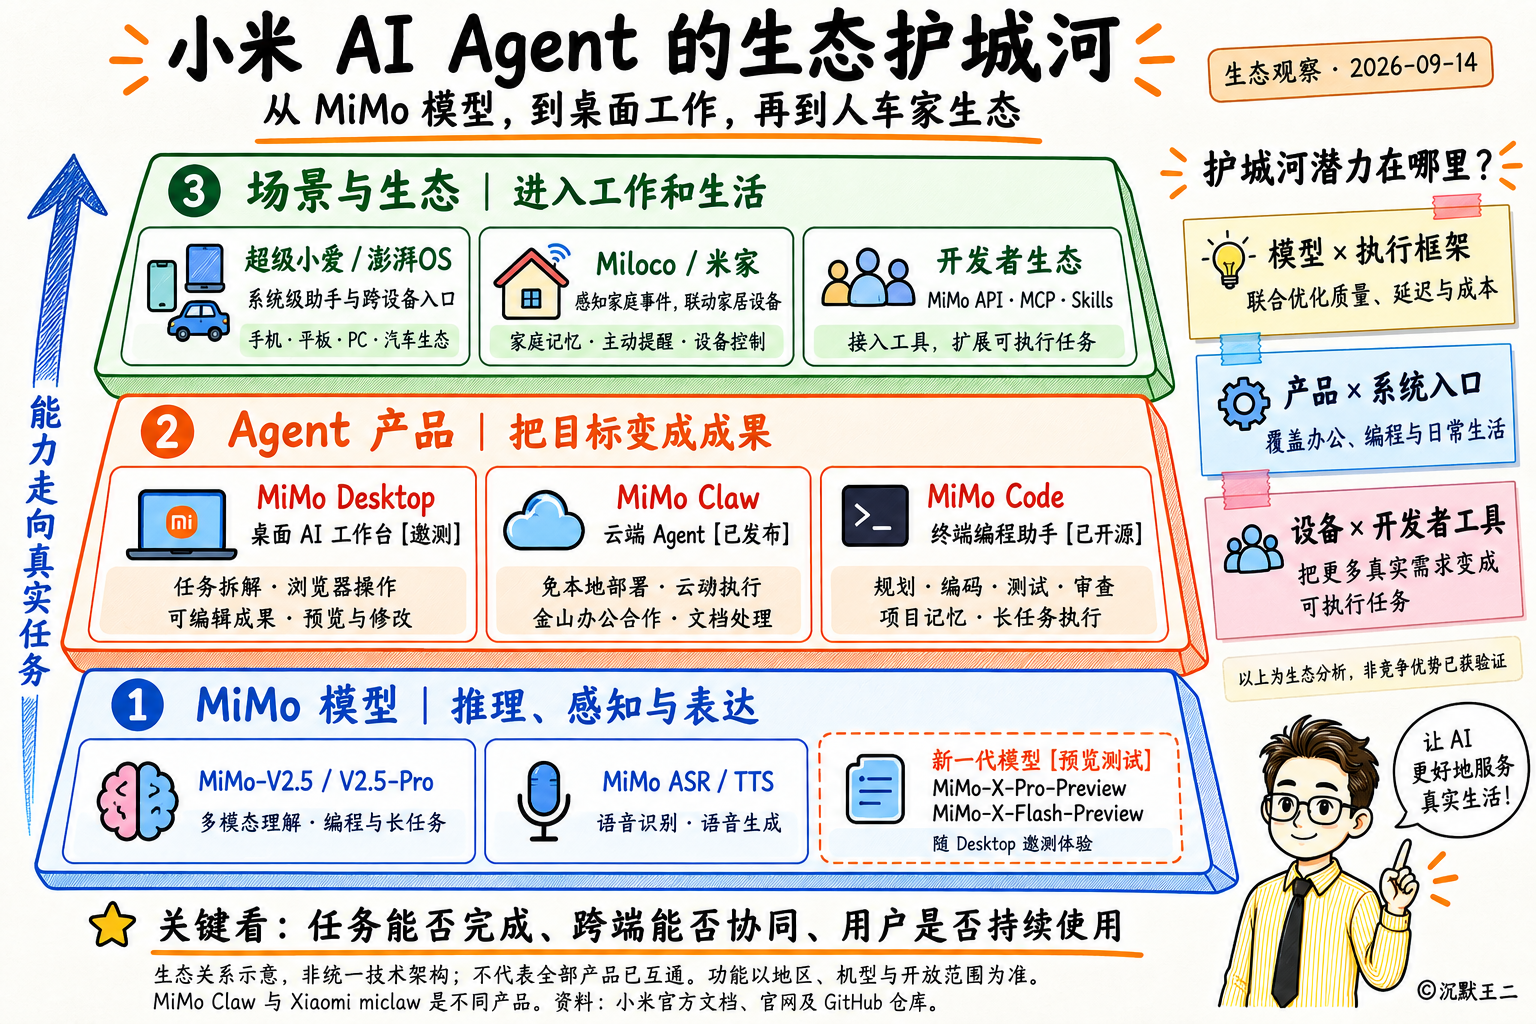
我个人是非常期待小爱同学能上端侧大模型的,至少我认为小爱同学是强过 Siri 的(真的真的。
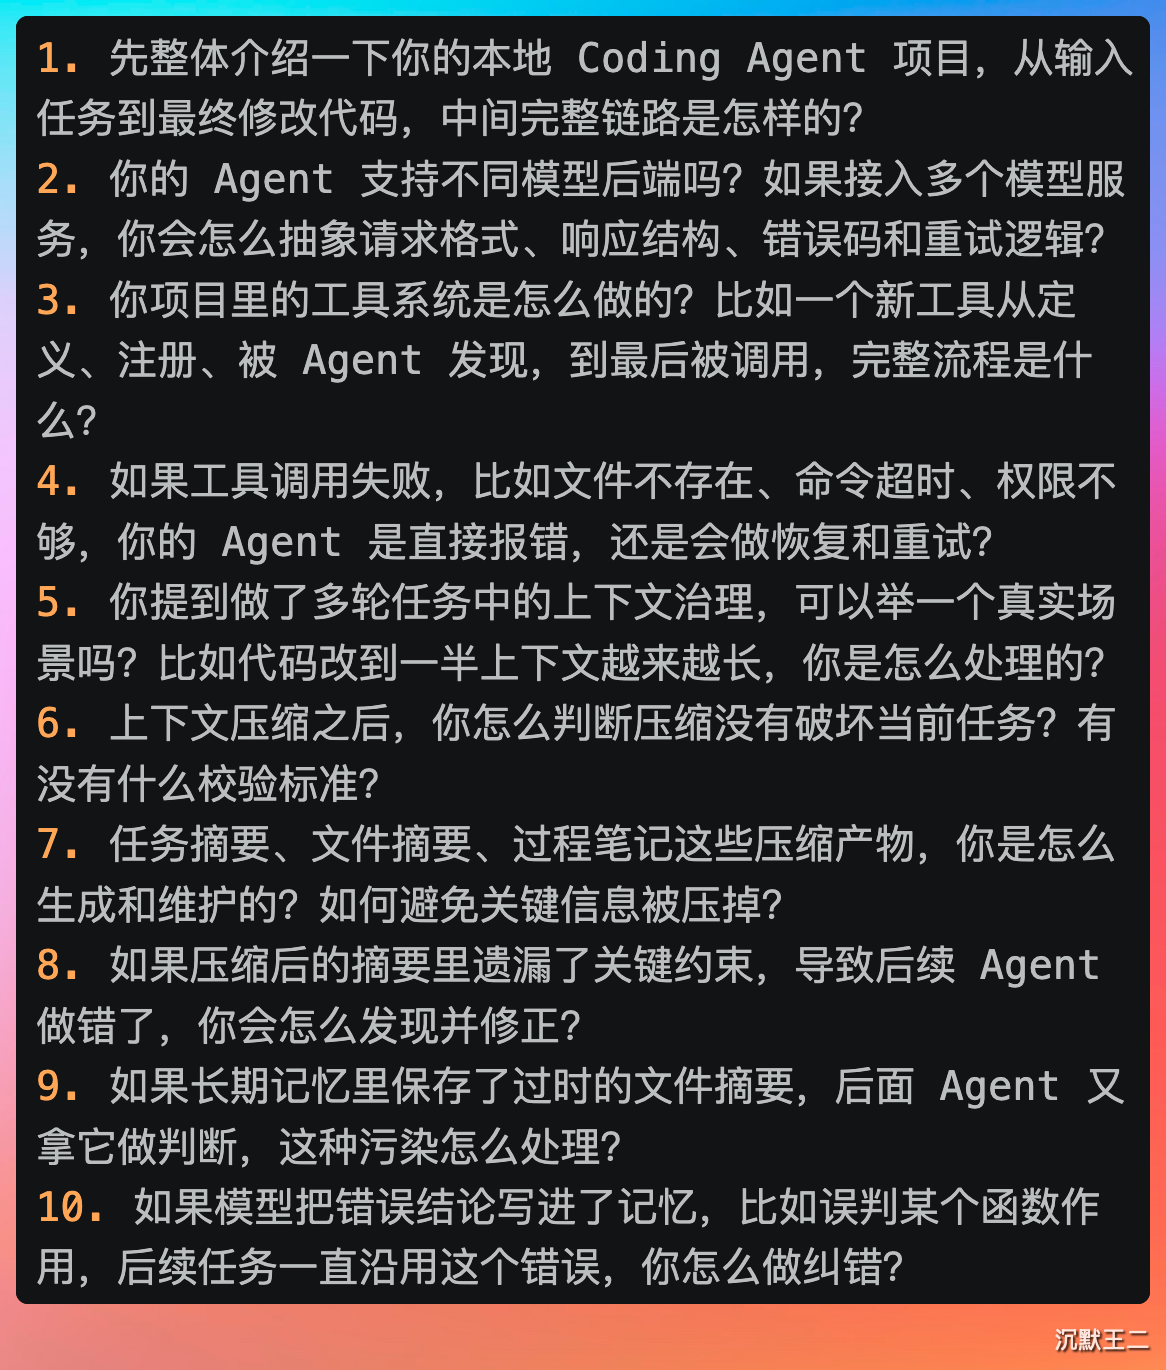
接下来,上我们的传统艺能,下面这些题目是一位小伙伴强烈要求我分享一波答案的,说非常硬核,被问的概率很高。
content
注意,我自研的Python版PaiCLI已开源:https://github.com/itwanger/PaiCLI-Python
01、先整体介绍一下你的本地 Coding Agent 项目,从输入任务到最终修改代码,中间完整链路是怎样的?
“我做的是一个终端 Coding Agent,Java 写的,基于 Spring AI。从用户输入到代码修改,大致分四步:组装提示词、模型决策、工具执行、继续 ReAct。”
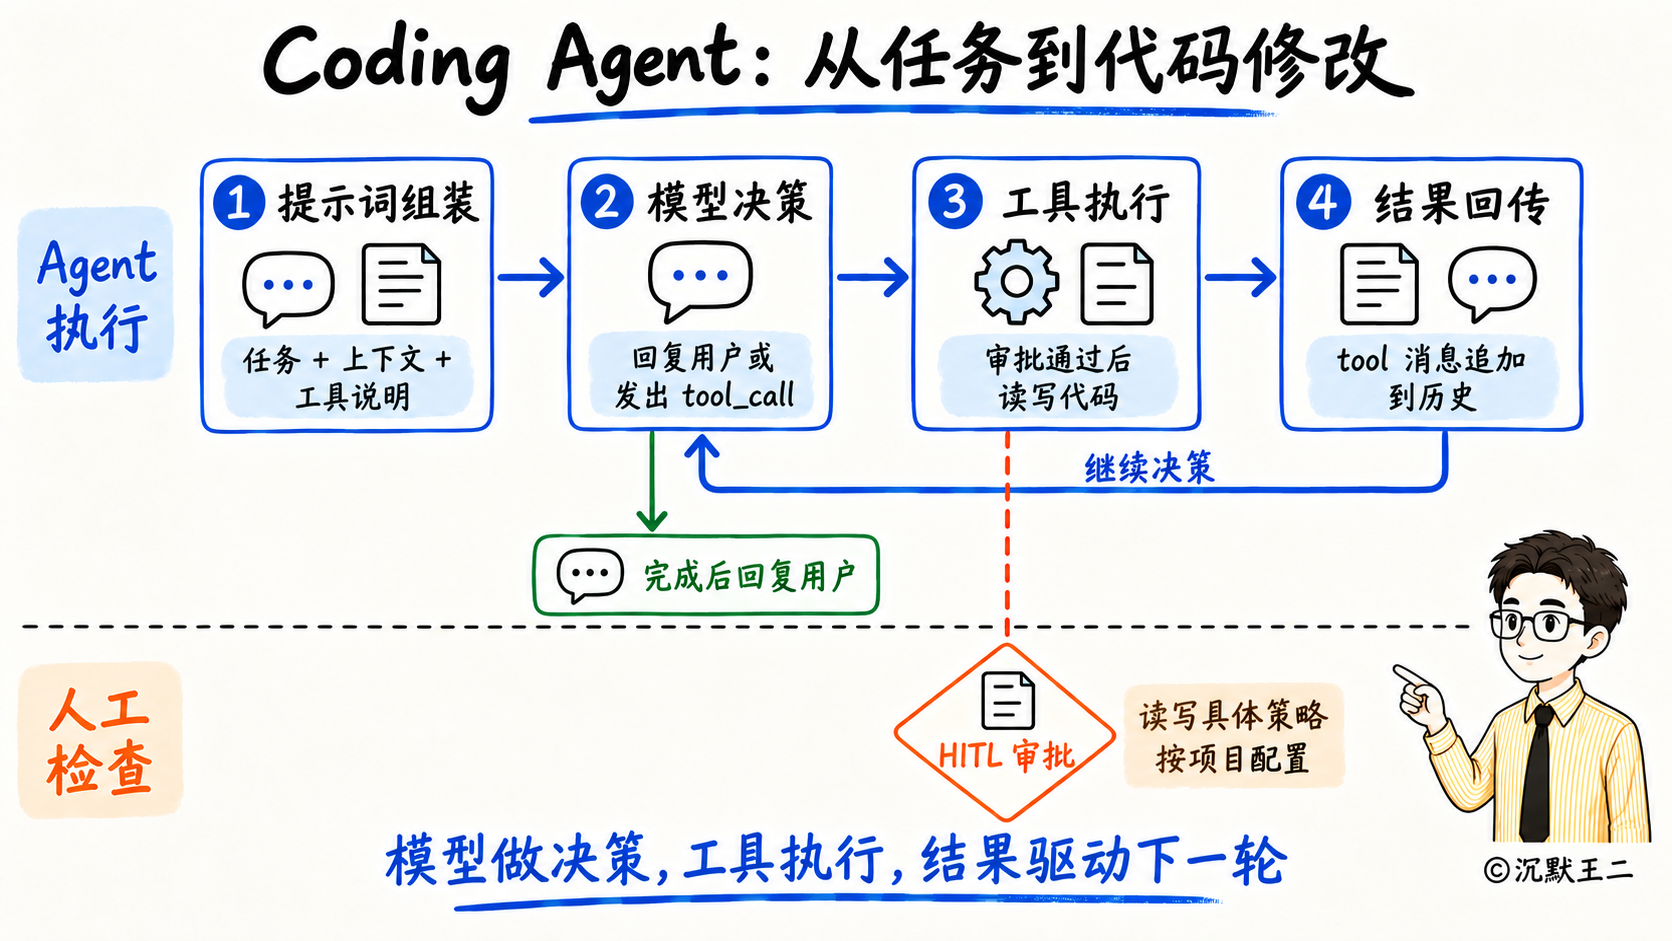
“用户输入进来后,第一步是组装提示词。我把提示词分成了 9 层,前 4 层是静态的,身份定义、风格定义、执行模式、审批策略,会话期间保持不变。后 5 层是动态的,运行时、项目记忆、Skills 索引、上下文管理策略、收尾指令,每轮都会更新。”
“静态层排在最前面是因为提示词缓存按最长公共前缀匹配,前缀越稳定,缓存命中率越高,token 成本差不多能省一个数量级。”
“提示词拼好后发给模型,模型返回 tool_call,告诉 Agent 它想调什么工具、传什么参数。然后进入工具执行,先从模型响应里解析出工具调用列表,然后人工审批,最后用线程池并行执行。”
“执行完的结果作为 tool 消息追加到对话历史,模型看到结果后继续决策。”
02、你的 Agent 支持不同模型后端吗?如果接入多个模型服务,你会怎么抽象请求格式、响应结构、错误码和重试逻辑?
“支持,包括 GLM、DeepSeek、混元、Step、Kimi、讯飞等等。”
“最上面是一个统一接口,定义了阻塞式和流式(SSE)两种调用方式,还有能力声明,比如是否支持工具调用、是否支持图片输入、上下文窗口多大。上层代码只跟接口打交道,不关心底下是哪家模型。”
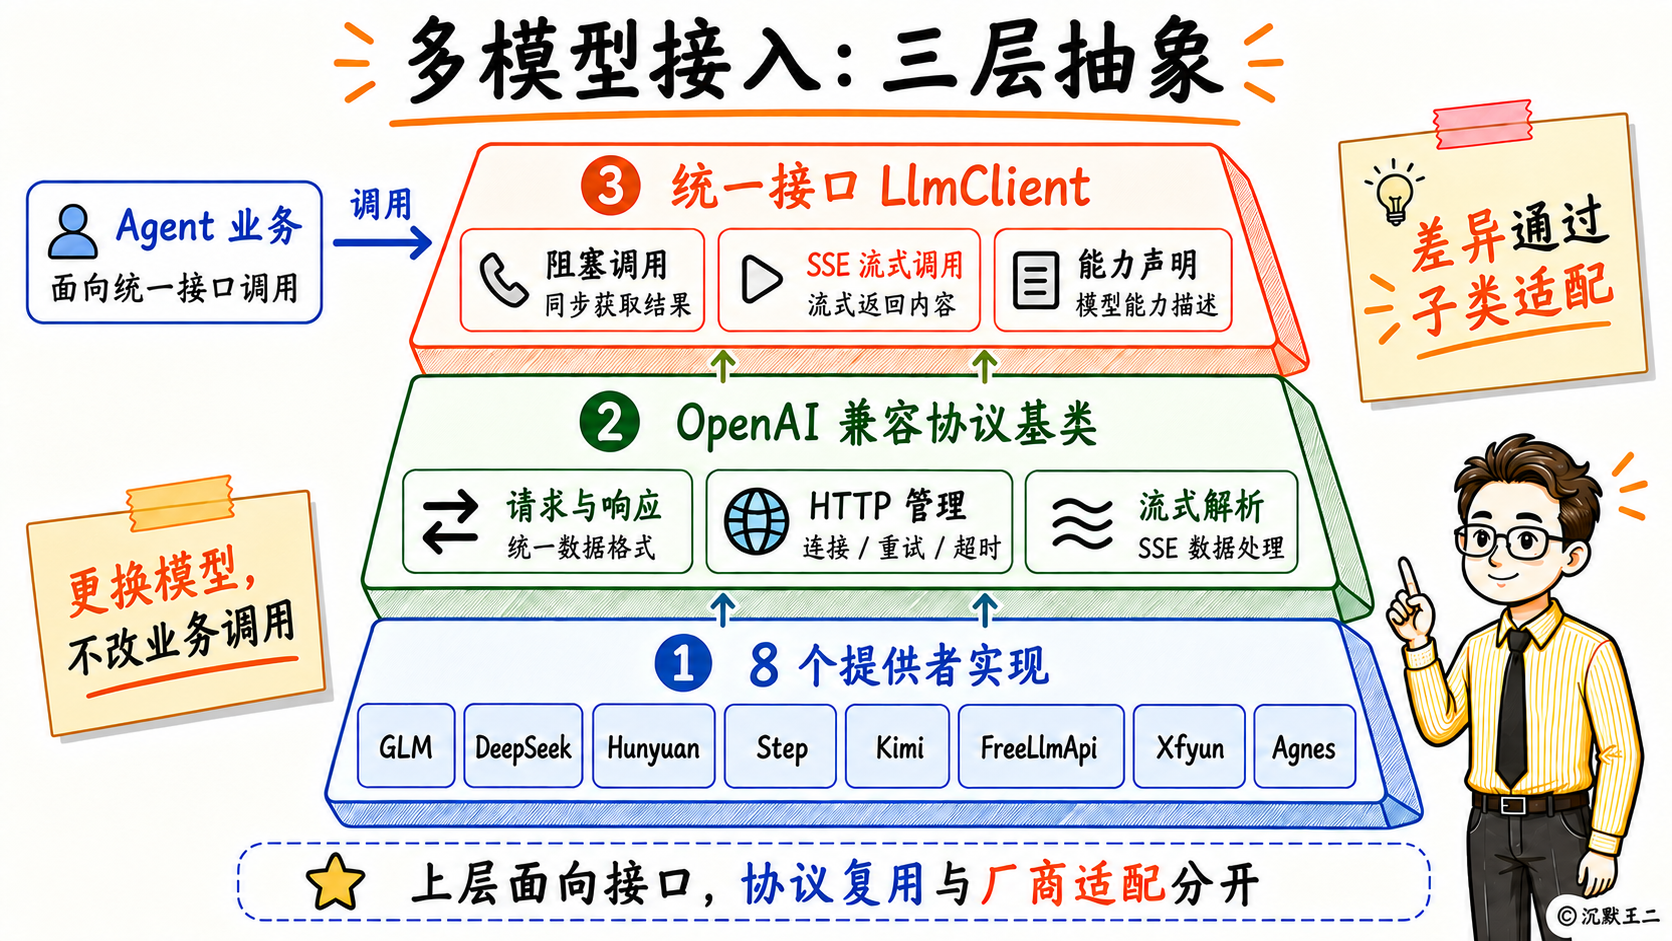
“中间是一个协议基类,实现了 OpenAI 兼容协议的通用逻辑,HTTP 客户端管理、SSE 流解析、请求构造、响应解析都在这一层。国产模型的 API 基本都兼容了 OpenAI 格式,所以这层能覆盖绝大多数场景。”
“最下面是具体实现,每个对应一家模型服务。新接一个供应商,继承基类、实现钩子方法。”
错误码和重试逻辑是怎么设计的?
“我写了一个失败分类器,把所有异常归成 5 类:网络抖动、服务端 500 一类;认证失败一类;请求参数错误一类;响应格式异常一类;超时或取消一类。”
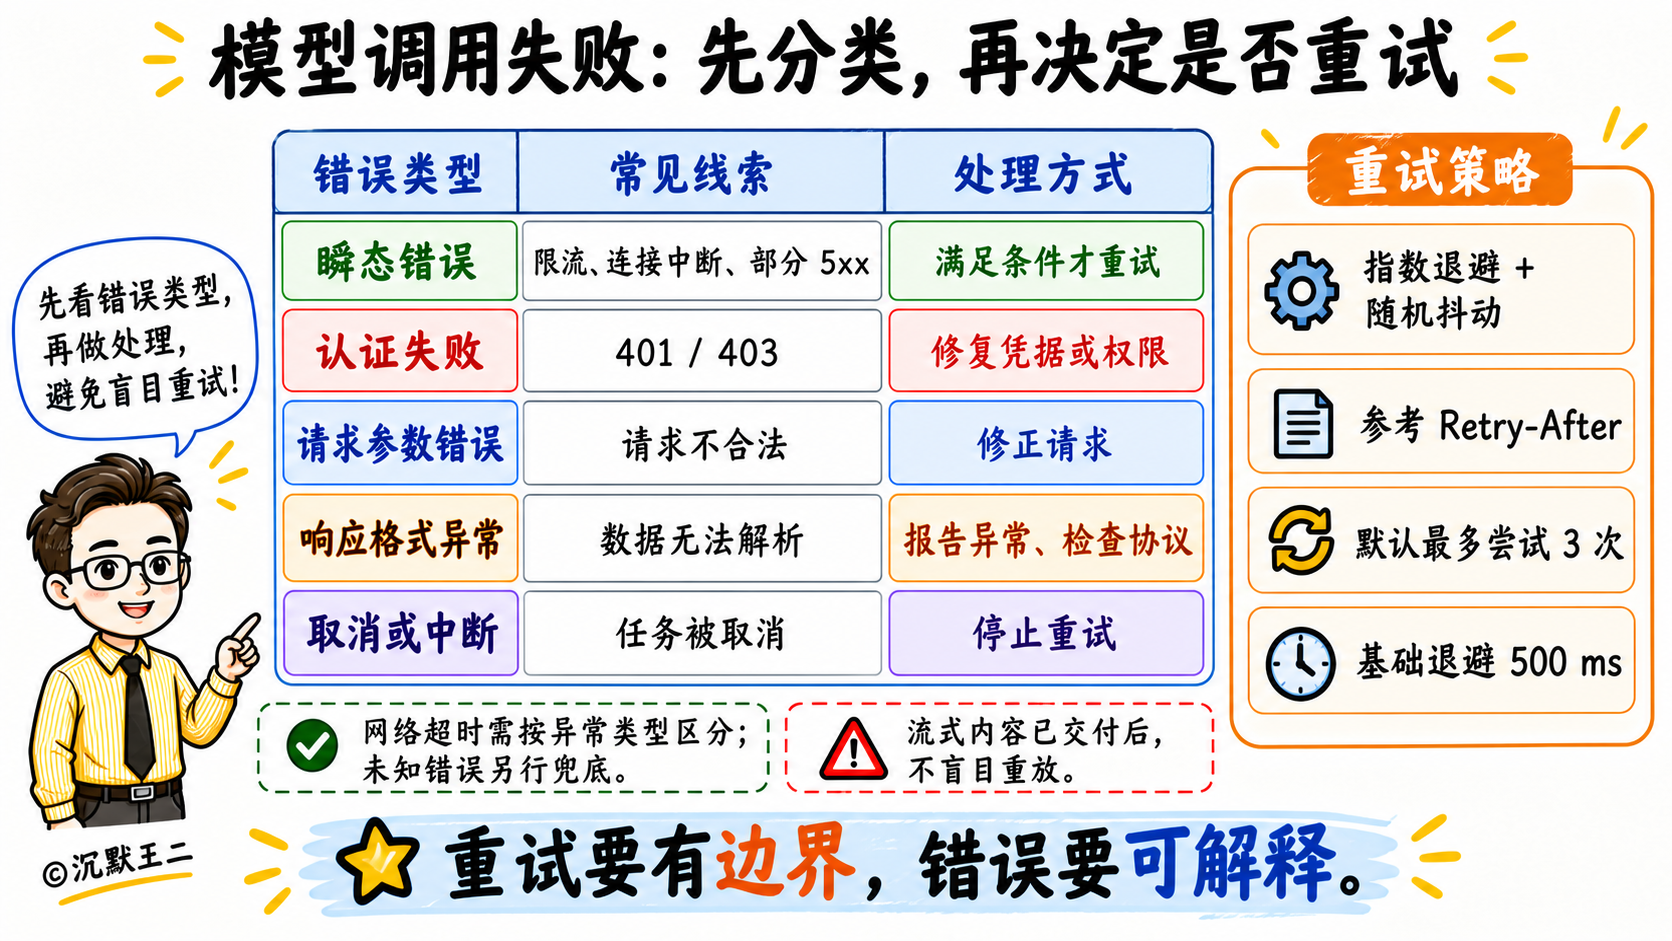
“重试策略是指数退避加随机抖动,默认最多 3 次,退避区间从 200 毫秒到 30 秒。如果响应头里带了 Retry-After,就按服务端指定的时间等。”
03、你项目里的工具系统是怎么做的?比如一个新工具从定义、注册、被 Agent 发现,到最后被调用,完整流程是什么?
“工具分两种:内置工具和 MCP 动态工具。”
“内置工具有读文件、写文件、跑命令、搜索代码、浏览器操作这些。每个工具在注册表里定义好名称、描述和参数的 JSON Schema。组装提示词的时候,注册表把所有工具的 Schema 一起发给模型,模型根据当前任务决定调哪个。”
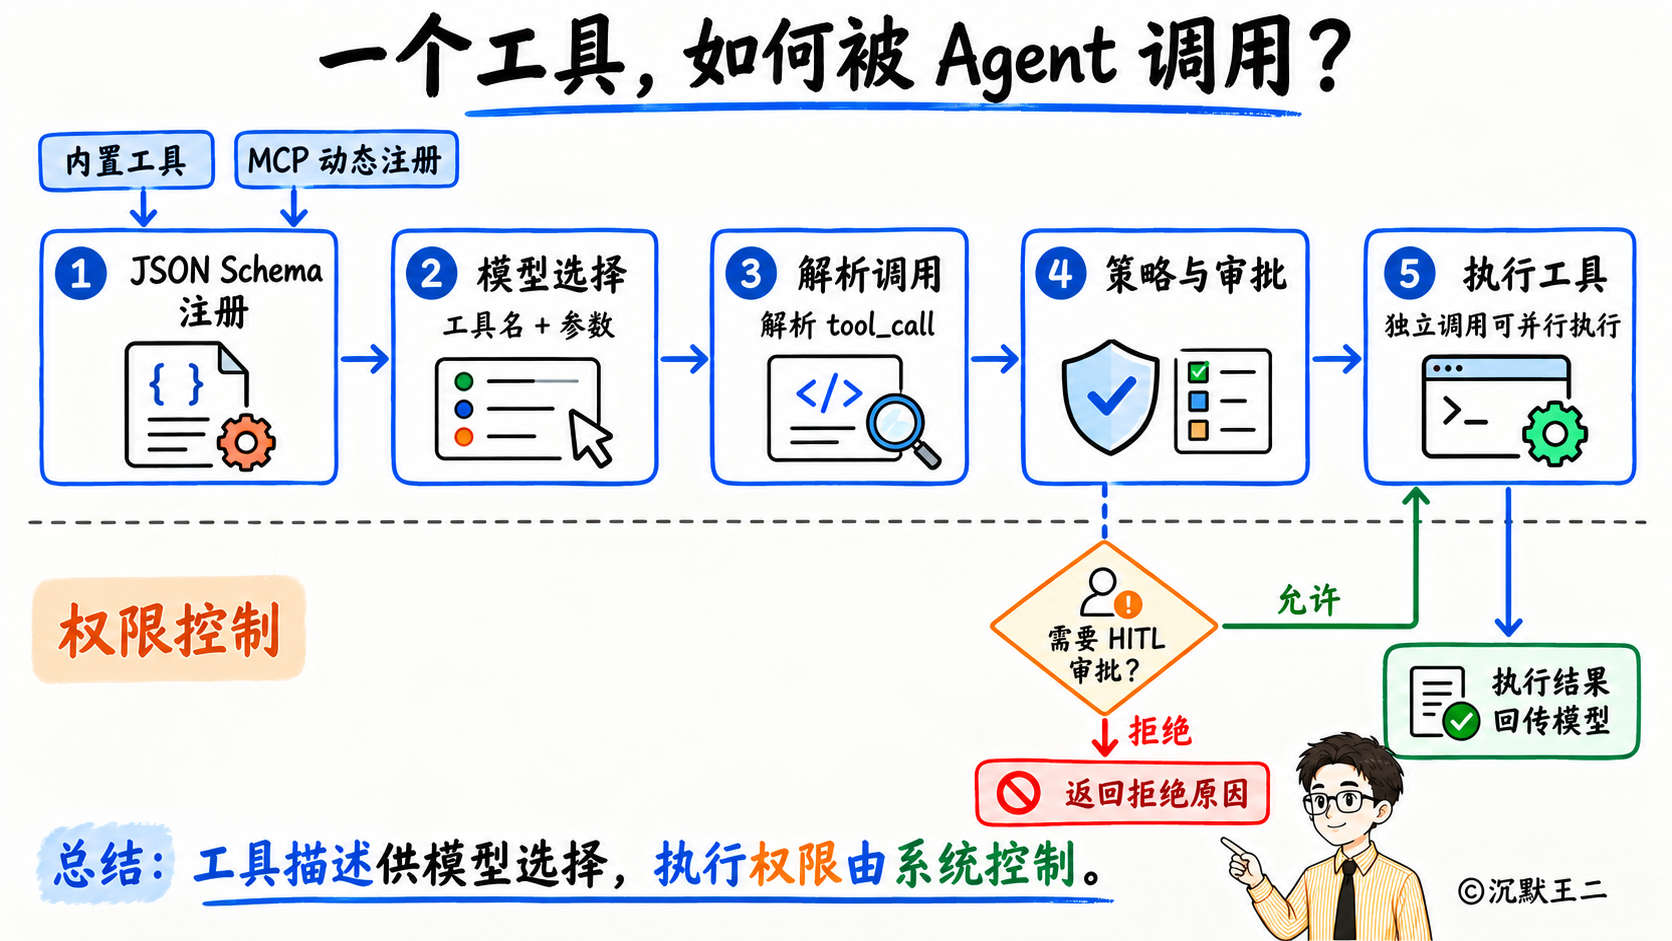
“MCP 工具是运行时动态注册的。用户配置了 MCP Server 之后,Agent 启动时通过 MCP 协议拿到服务端暴露的工具列表,按 mcp__服务名__工具名 的格式命名,放入注册表。”
“模型返回 tool_call 之后走三个阶段。解析阶段把工具名和参数从模型响应里提取出来。审批阶段区分读写,写操作要过人机审批(HITL),读操作直接放行。执行阶段,单个工具直接跑,多个工具线程池并行。”
04、如果工具调用失败,比如文件不存在、命令超时、权限不够,你的 Agent 是直接报错,还是会做恢复和重试?
“不自动重试,把失败信息原样回传给模型,由模型决定怎么办。”
“工具执行完会返回一个结果,exit code 不是 0 的,返回 exit code 加标准输出和标准错误。命令黑名单的,返回策略拒绝的具体原因。”
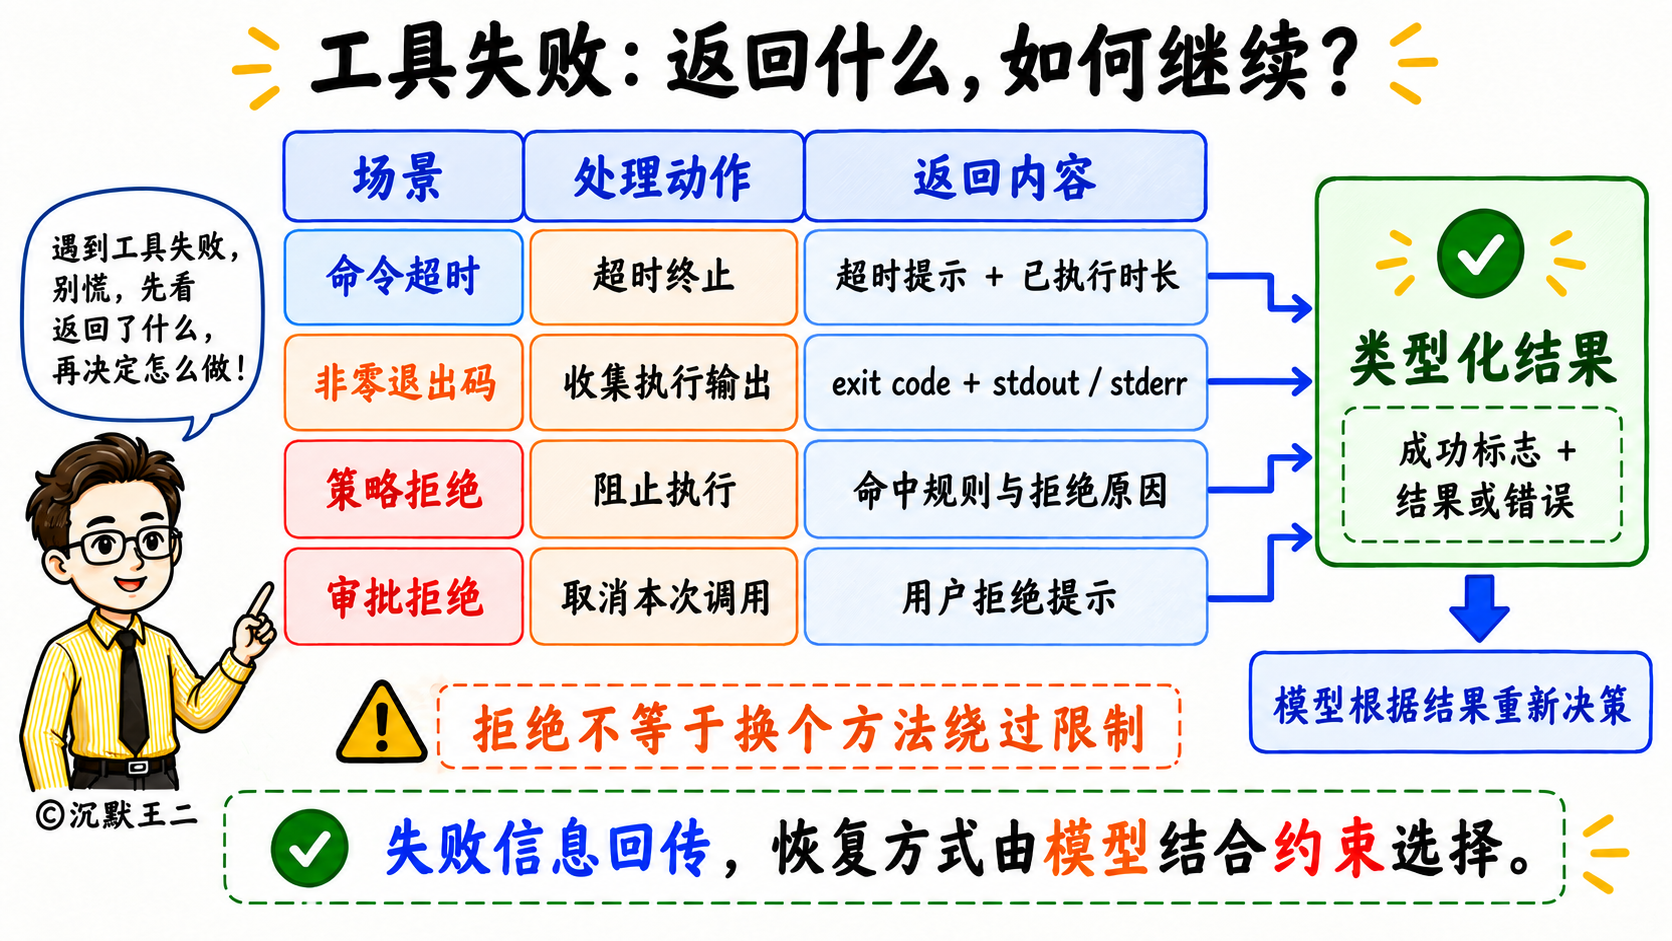
“模型看到失败信息后,通常会自己换一种方式。比如文件不存在,它会先用 list_dir 看看目录结构再决定路径;命令超时了,它会缩小搜索范围或者加过滤条件。”
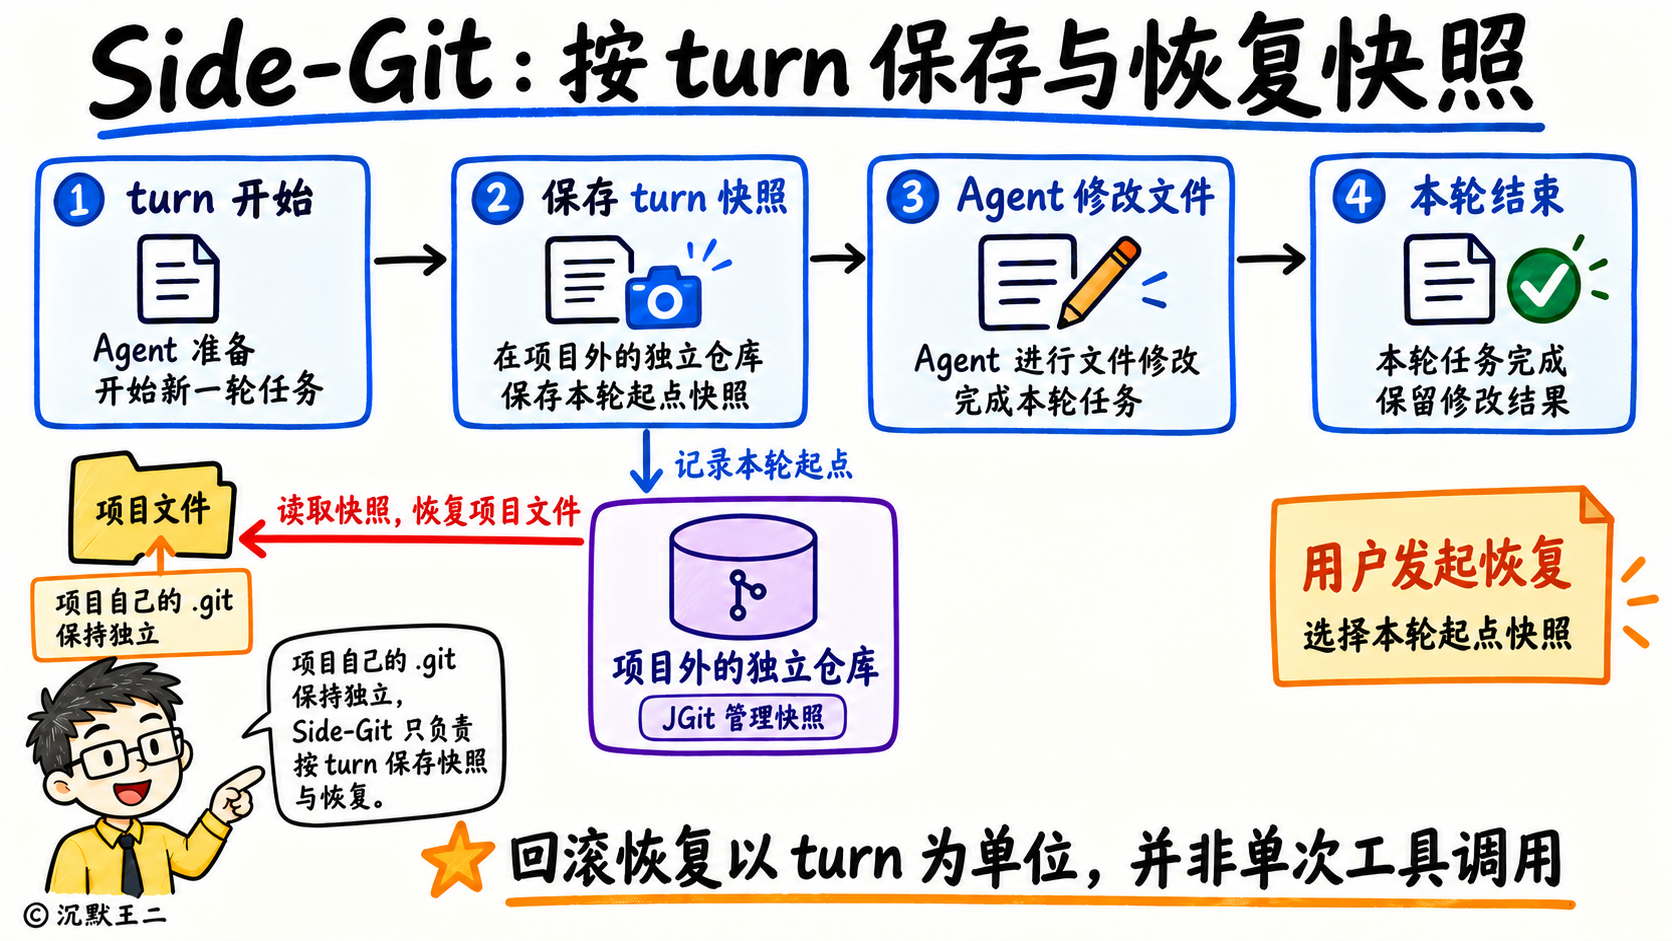
“兜底机制有两个。一个是快照回滚,每个 turn 开始前,系统自动对项目目录做一次 Git 快照,存在项目外的独立仓库里,用的是 JGit 单独建了一个 .git 目录,不碰项目自己的版本控制。Agent 改坏了代码,可以回滚到上一个 turn 开始前的状态。”
05、你提到做了多轮任务中的上下文治理,可以举一个真实场景吗?比如代码改到一半上下文越来越长,你是怎么处理的?
“最常见的场景是修 Bug。用户让 Agent 修一个问题,Agent 先搜索代码、读了好几个文件定位原因,然后改代码、跑测试、发现没改对,又读文件、改第二版、再跑测试。几轮下来,对话历史里塞满了文件内容、命令输出、测试报告,token 数很快就上去了。”
“我做了两层压缩来处理。”
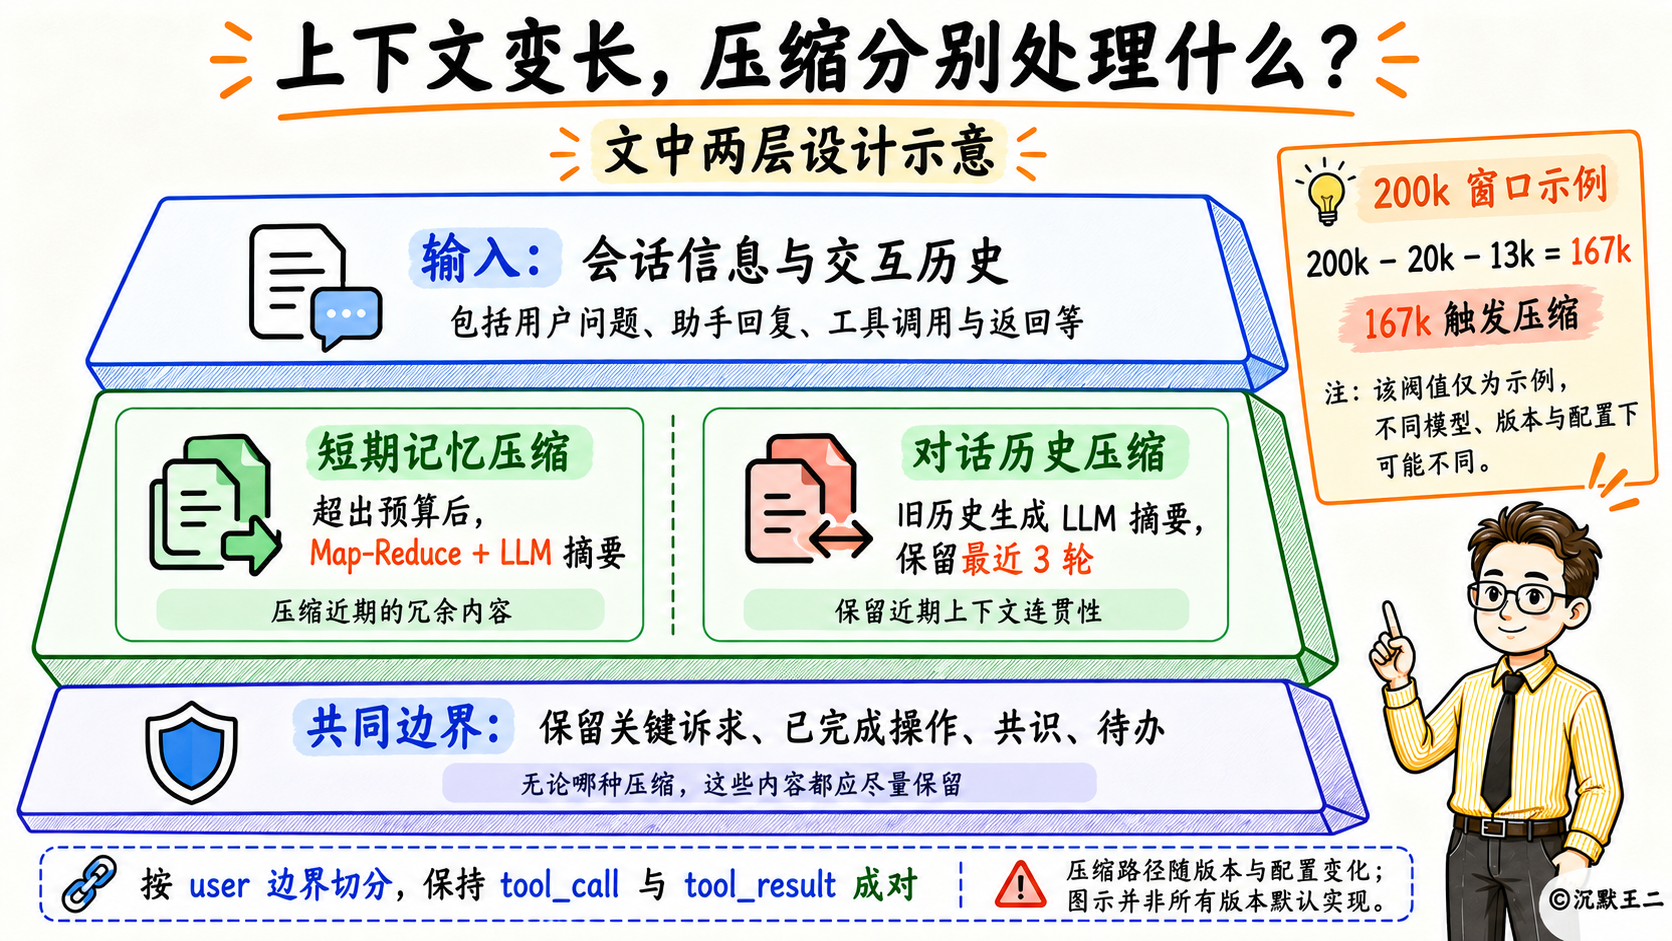
“第一层是短期记忆压缩。短期记忆是独立于对话历史的一个缓冲区,存当前会话里积累的关键信息。token 数超过预算时,用 Map-Reduce 策略加 LLM 摘要进行压缩,最近几轮的内容保持原样不动。”
“第二层是对话历史压缩。每轮调用模型之前,系统检查当前对话的 token 数。以 200k 的上下文窗口为例,差不多到 167k 就触发压缩。做法是保留最近 3 轮 user 消息及其完整交互,包括 tool_call 和 tool_result,更早的历史用 LLM 生成一段摘要替换掉。”
06、上下文压缩之后,你怎么判断压缩没有破坏当前任务?有没有什么校验标准?
“每次写文件操作完成后,如果写的是 .java 文件,系统会用 JavaParser 做一次语法解析,收集语法层面的错误。这些诊断信息在下一轮模型调用前以 user 消息的形式自动注入,模型看到后会主动修正。”
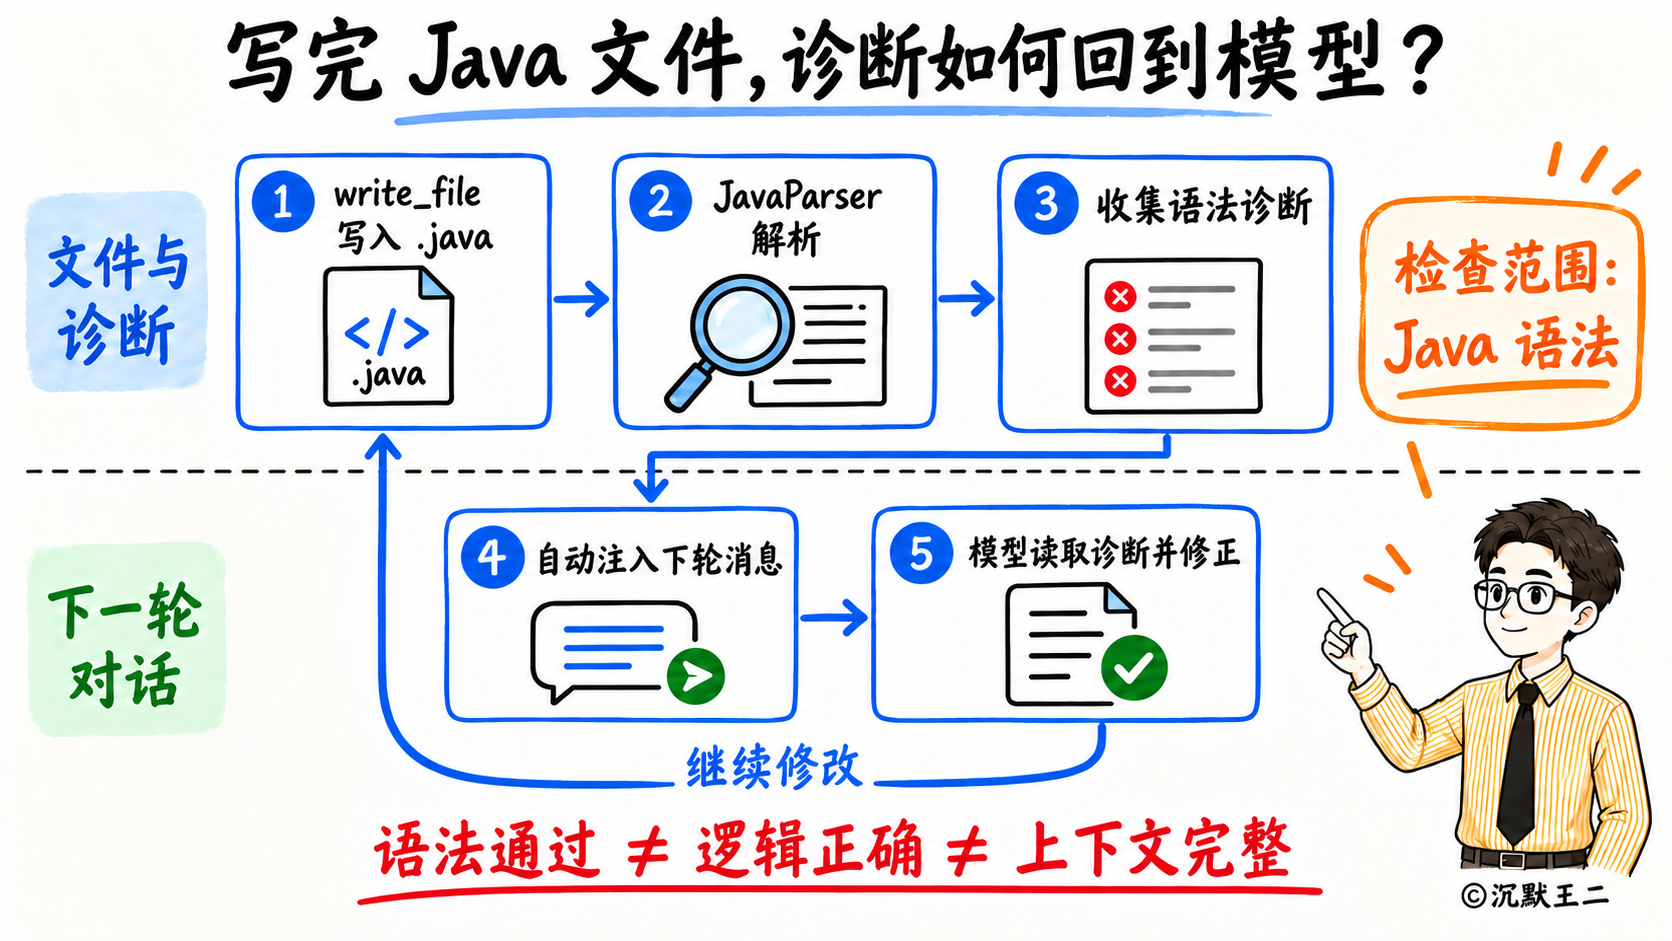
“压缩有没有丢掉关键上下文,目前主要靠两个间接信号。一个是模型的行为连贯性,如果压缩后模型突然问已经确认过的问题,或者重做已经完成的操作,说明摘要丢了东西。另一个是工具调用的结果,如果压缩前模型知道问题出在第 50 行,压缩后去重新搜索代码,说明这个定位信息没保留下来。”
有没有更主动的校验方案?
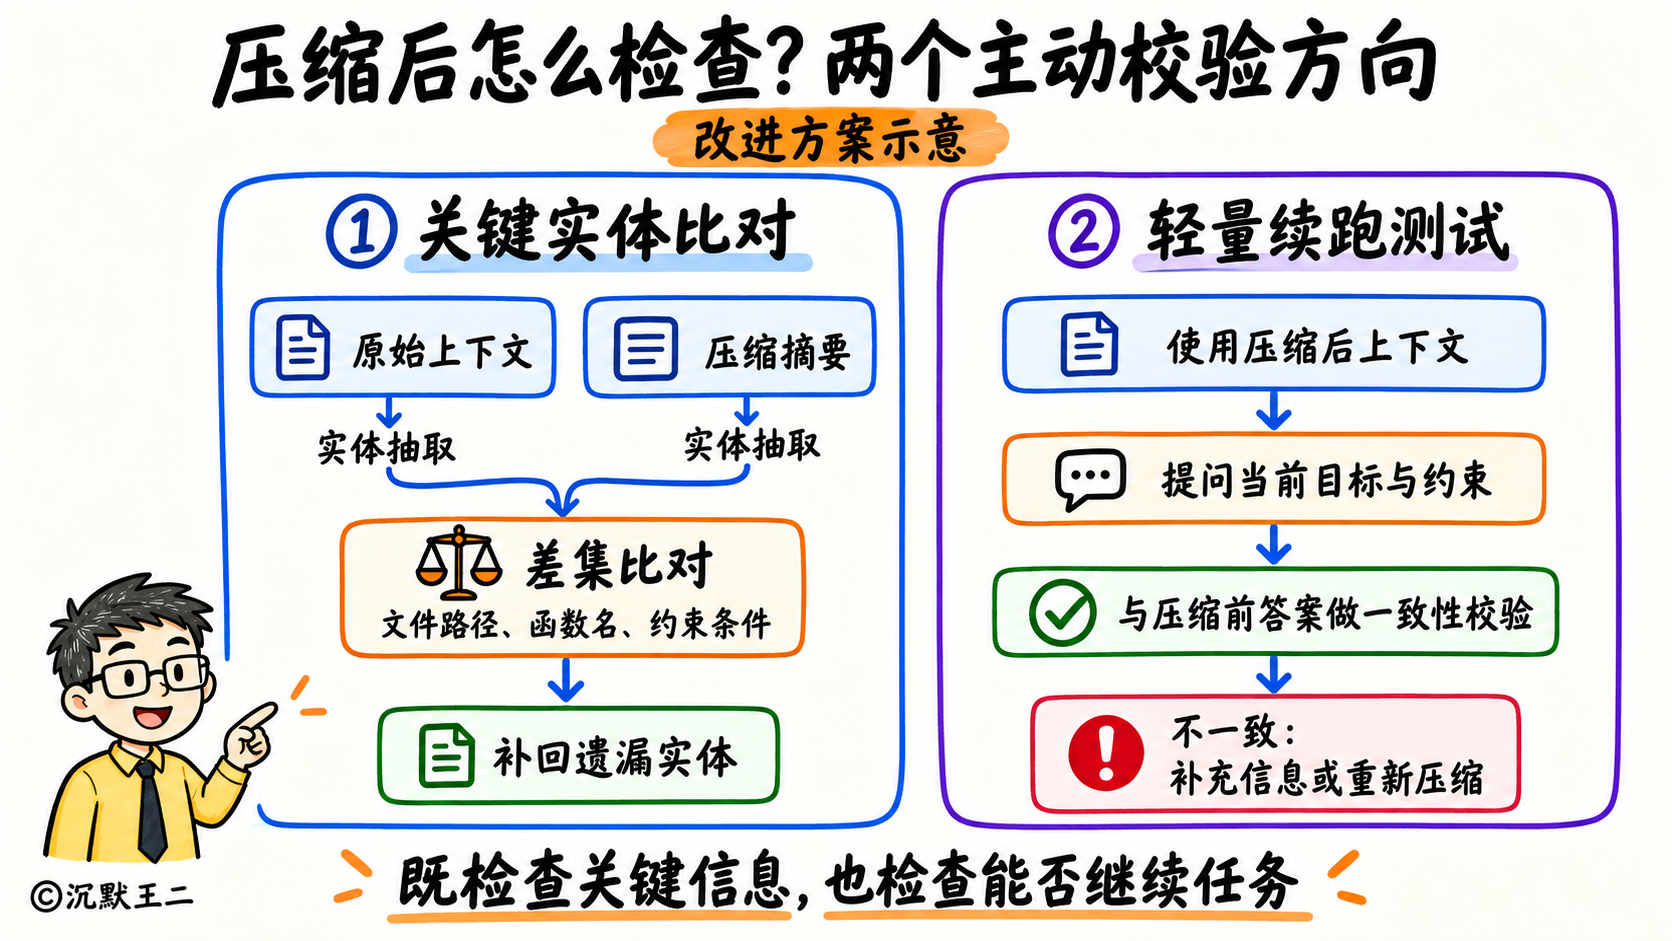
“一个是压缩前后做关键实体比对。压缩之前,抽取当前任务涉及的关键实体,比如文件路径、函数名、变量名、约束条件。压缩之后对摘要做同样的抽取,看有没有遗漏,遗漏的就补回去。”
“另一个是压缩完之后跑一个轻量的测试。用压缩后的上下文让模型回答一个和当前任务相关的简单问题,比如‘当前任务的目标是什么’,看模型的回答和压缩前是否一致。”
07、任务摘要、文件摘要、过程笔记这些压缩产物,你是怎么生成和维护的?如何避免关键信息被压掉?
“压缩产物目前有三种:对话摘要、项目记忆、长期记忆。”
“对话摘要是压缩对话历史时由 LLM 生成的。生成时给了明确的保留清单,关键诉求、已完成操作、达成共识、待办事项,这四类信息必须保留。”
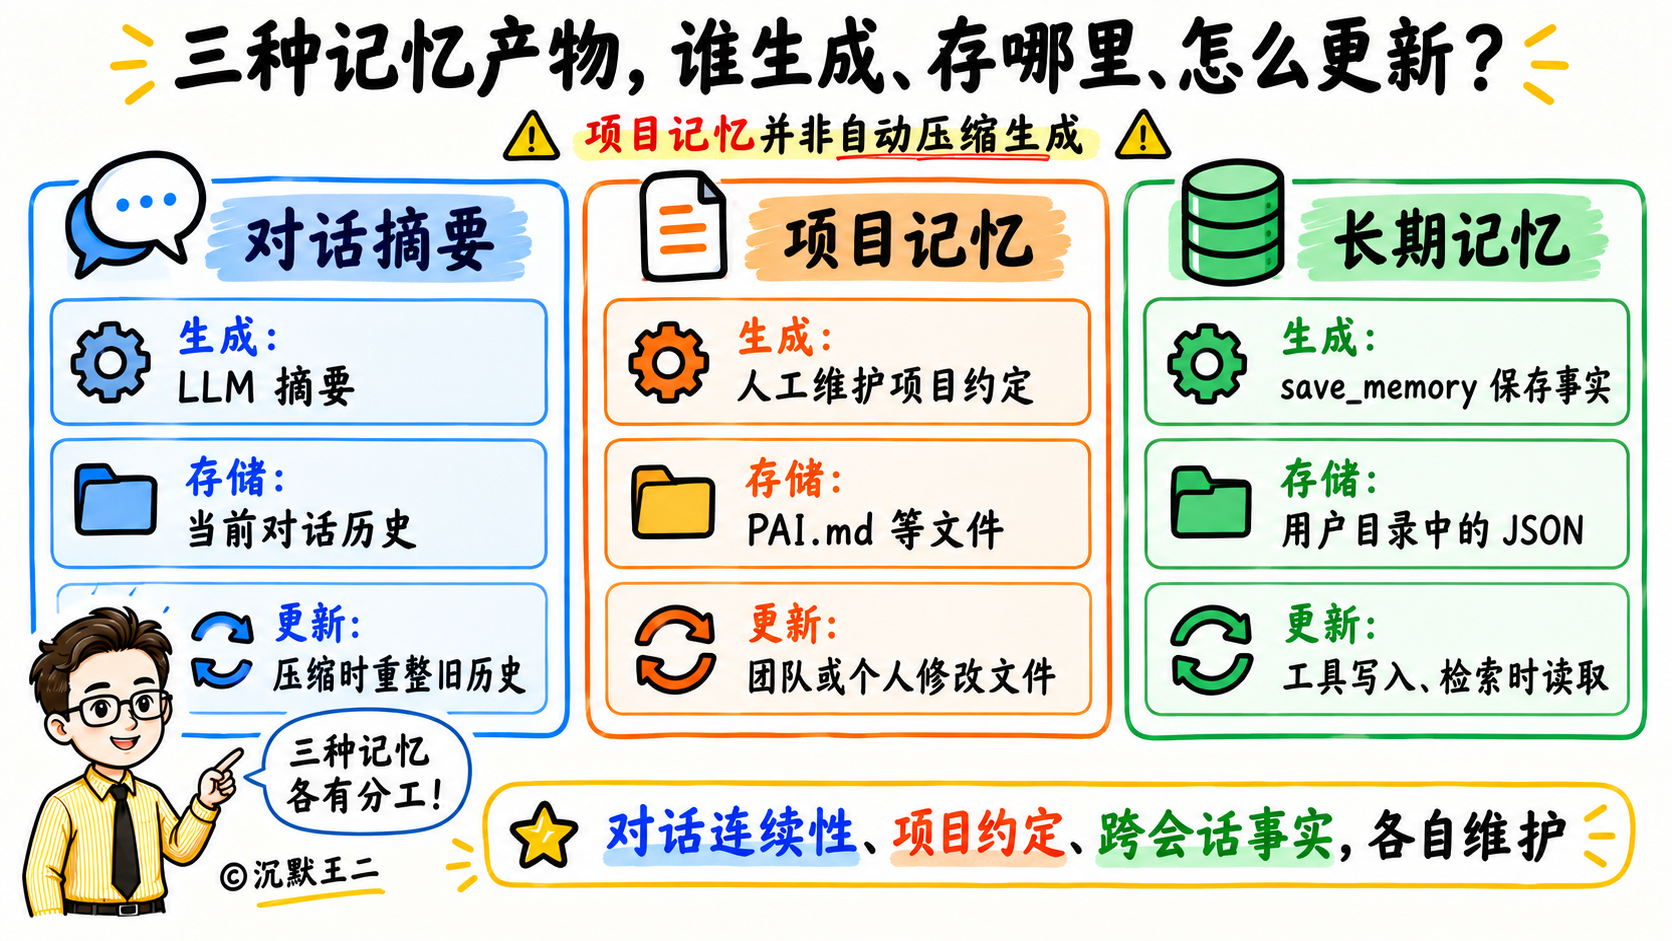
“项目记忆是手动维护的,存在 PAI.md 文件里。”
“长期记忆存在用户主目录的 JSON 文件里,Agent 调用 save_memory 工具写入。每轮模型调用前,记忆检索模块根据当前输入查询相关记忆,注入到系统提示词。”
怎么避免关键信息被压掉?
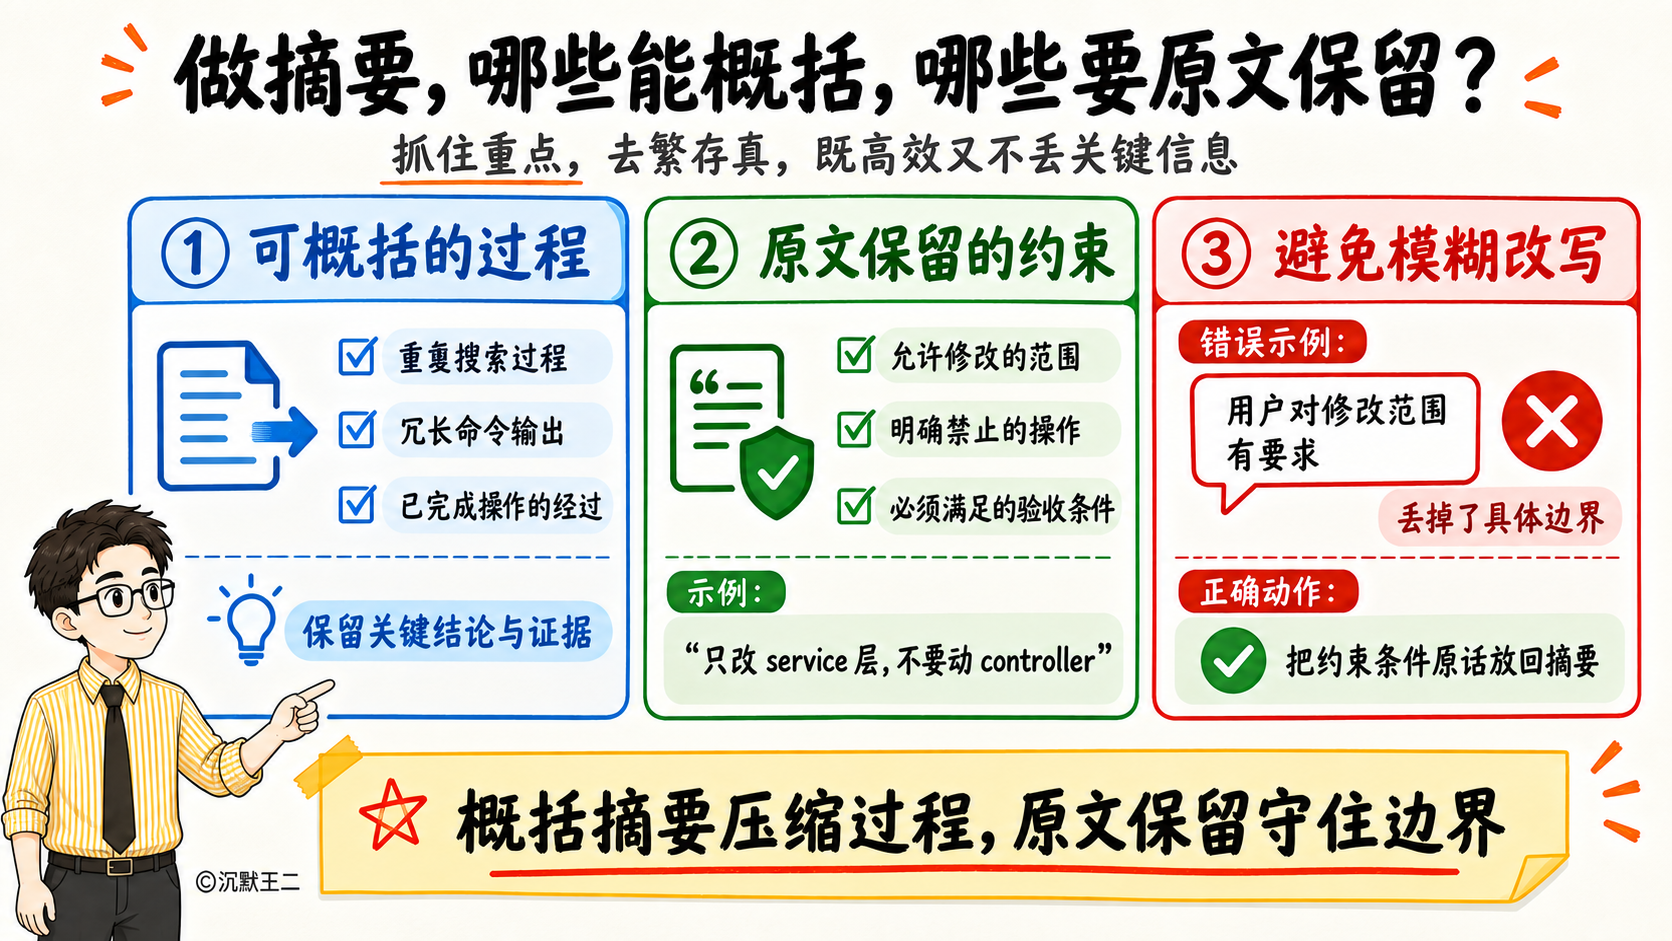
“比如用户说‘只改 service 层,不要动 controller’,如果被概括成‘用户对修改范围有要求’,模型就不知道具体边界了。我的做法是让摘要模型单独把用户的原话约束条件提取出来,不做概括,原文保留。”
08、如果压缩后的摘要里遗漏了关键约束,导致后续 Agent 做错了,你会怎么发现并修正?
“第一个是审批环节拦截。比如摘要丢了‘只改 service 层’这个约束,模型去改了 controller 的代码,写文件的时候用户会在审批环节看到改动内容,直接拒绝。第二个是用户主动纠正。终端 Agent 的交互是实时的,用户看到 Agent 往错误的方向走,随时可以打断补充约束。模型收到纠正后,会把这条约束写进当前上下文,后续压缩时自然会保留。”
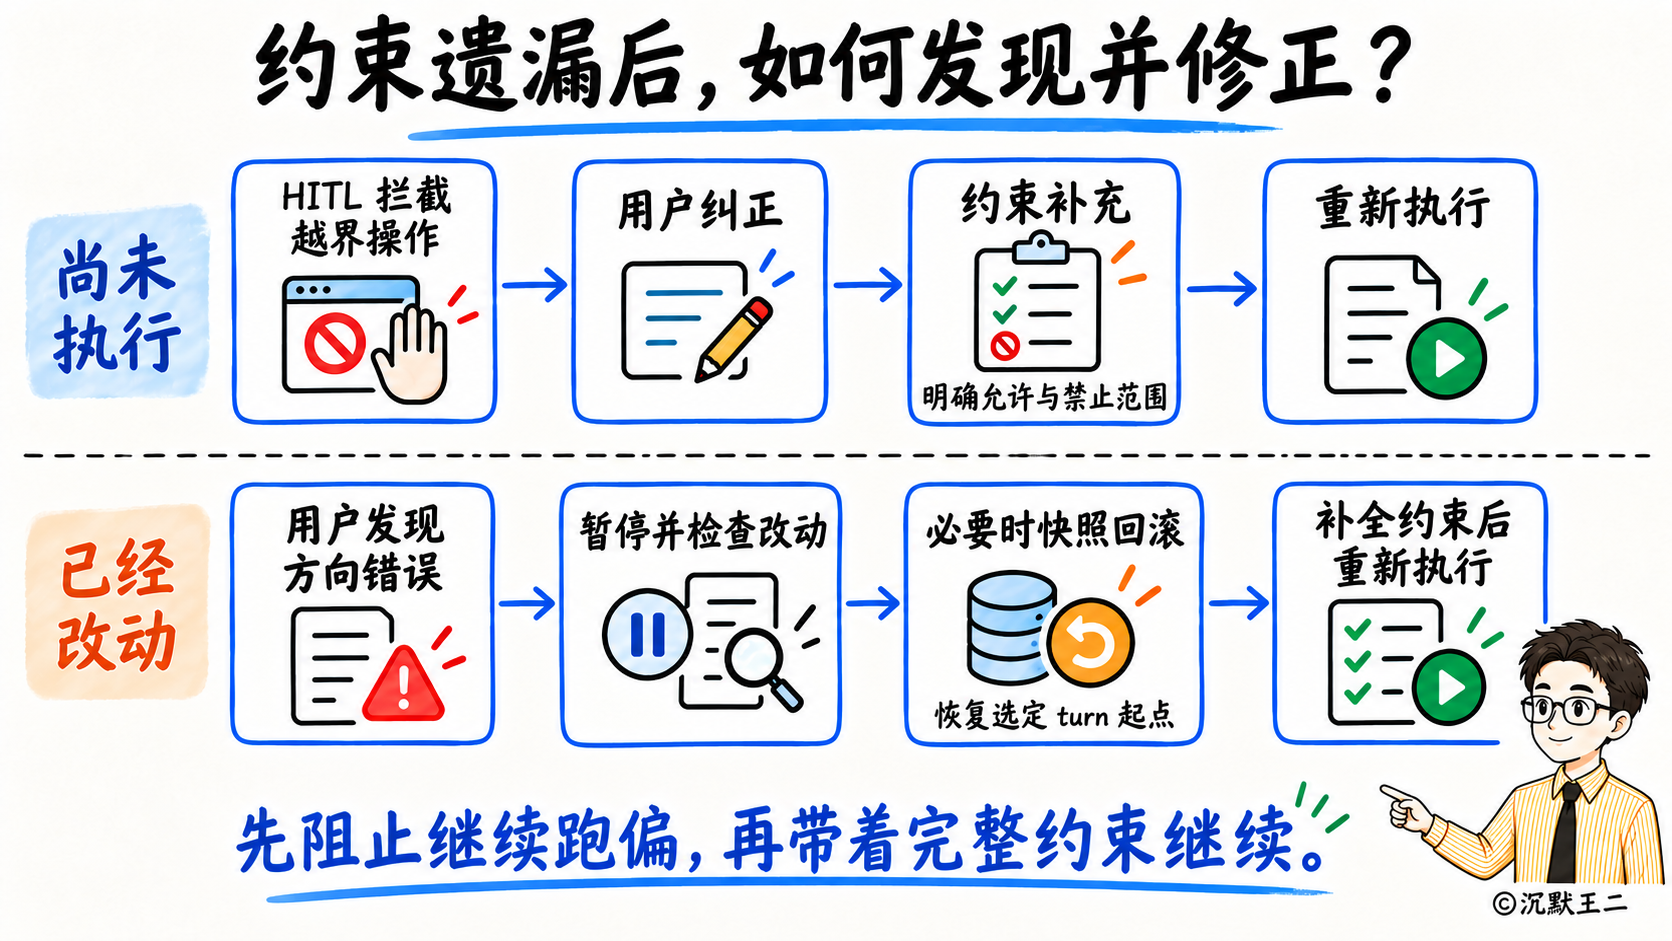
“修正的最后兜底是快照回滚。Agent 已经改了好几个文件、整个方向走偏了,用户可以回滚到上一个 turn 之前的状态,把改动全部撤销,然后重新下指令,这次带上更完整的约束。”
09、如果长期记忆里保存了过时的文件摘要,后面 Agent 又拿它做判断,这种污染怎么处理?
“记忆污染的根源是记忆条目和实际代码状态不一致。”
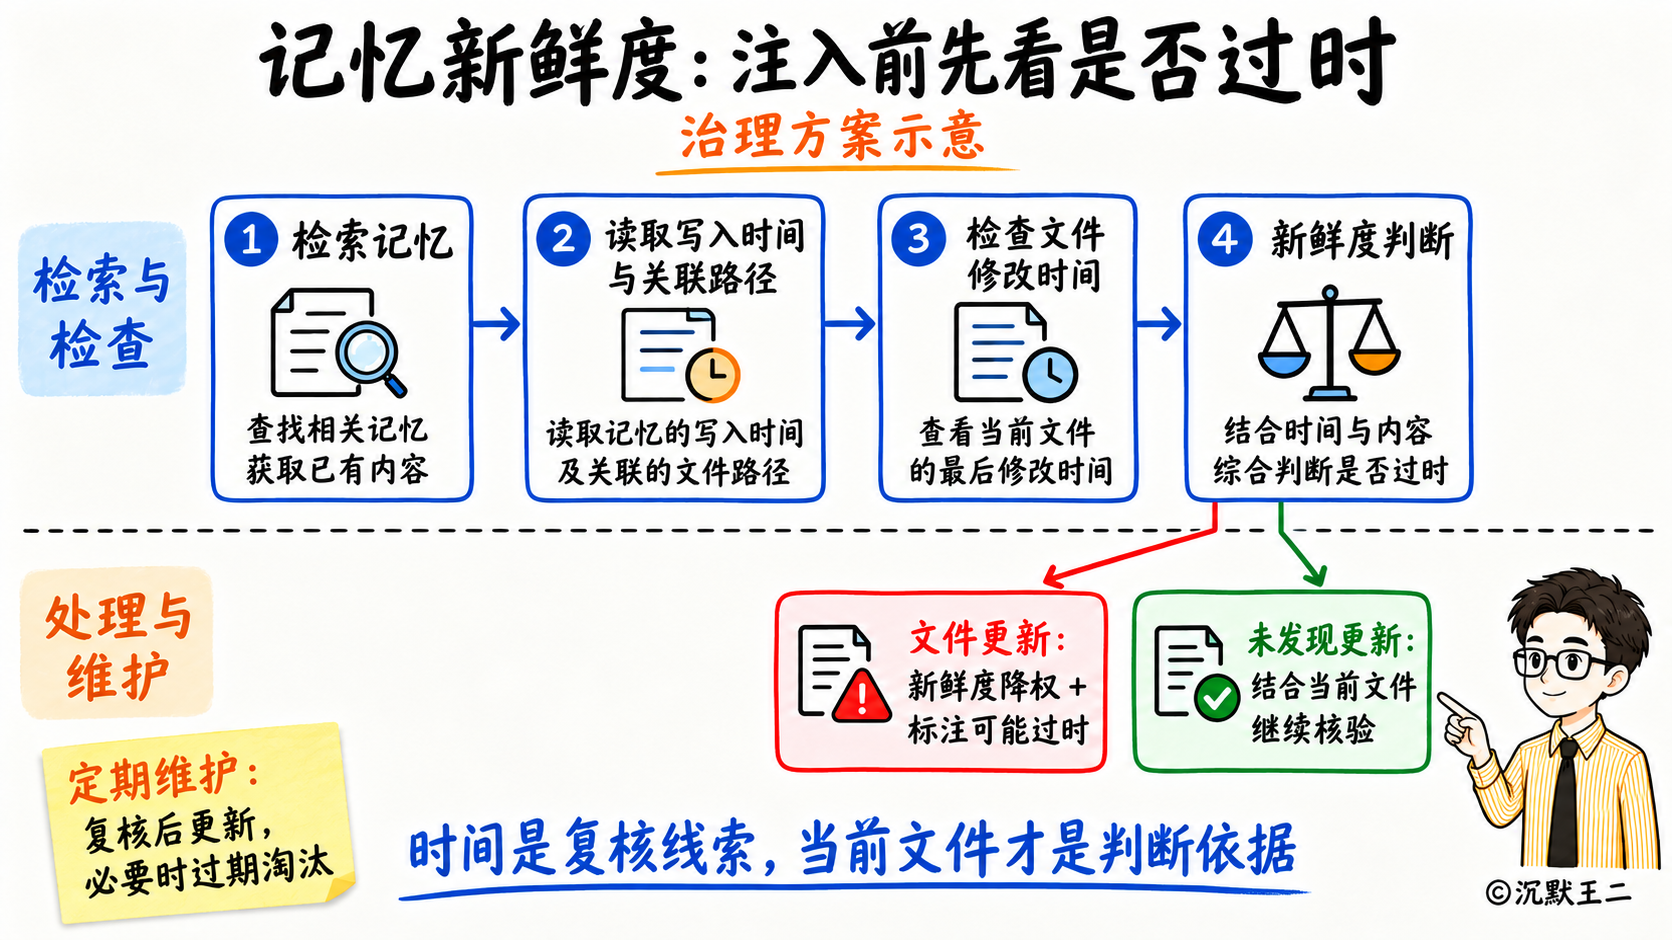
“写入的时候,每条记忆带上写入时间和关联的文件路径。检索注入的时候,如果这条记忆关联了某个文件,先查文件的最后修改时间。修改时间比记忆写入时间新,说明文件更新了。这时候要么降低这条记忆的检索排名,要么在注入时标注‘此条记忆可能已过时,以实际文件内容为准’,让模型自己判断。”
“定期清理也很重要。文件摘要类的记忆如果长时间没被引用,逐步降权直到淘汰。”
10、如果模型把错误结论写进了记忆,比如误判某个函数作用,后续任务一直沿用这个错误,你怎么做纠错?
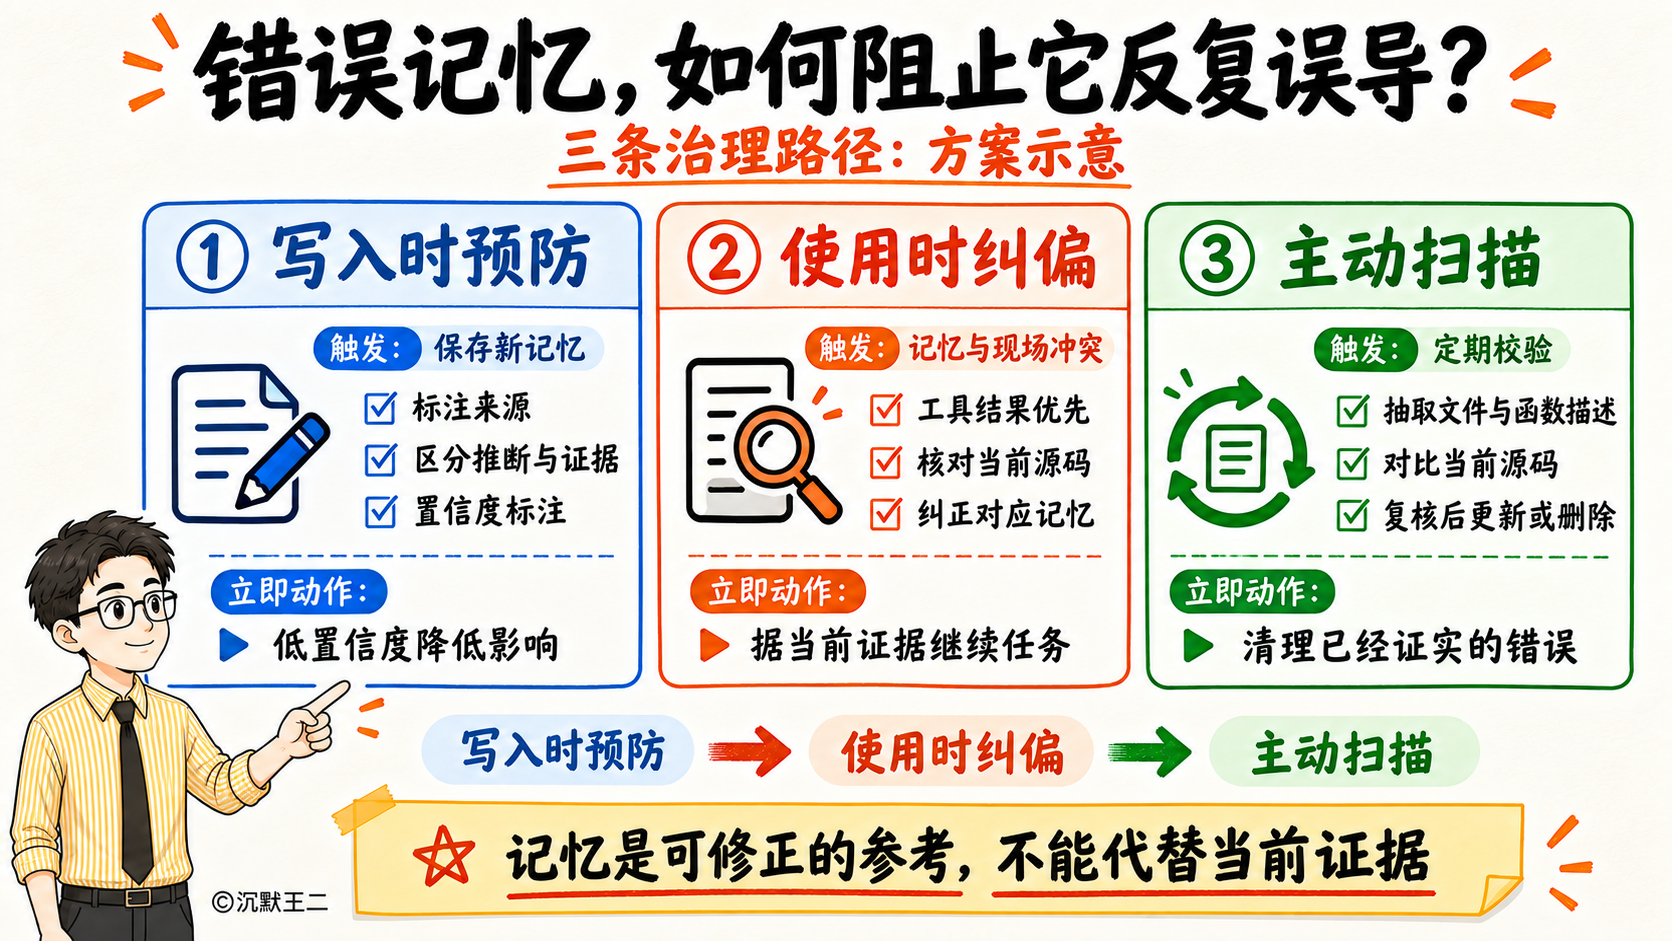
“第一,写入记忆的时候标注来源,是模型自己推断的,还是从源码里读到的,还是用户说的。来源不同,置信度不同。”
“假如记忆里写了‘函数 A 的作用是处理日志’,Agent 在执行任务时读了函数 A 的源码,发现它其实是处理消息队列的。系统提示词有硬性规则,工具结果和记忆冲突时以工具结果为准。模型会基于正确的信息继续执行,同时更新长期记忆里的那条错误记录。”
“定期跑一个轻量的校验任务,把记忆里的文件摘要和函数描述拿出来,跟实际源码做比对。把记忆条目和对应文件的当前内容一起发给模型,让它判断描述是否还准确。不准确的标记为待更新或者直接删掉。”
ending
我发现,人真的是不能停下来。
一旦你停下来,就会有无穷无尽的拖延症、妄想症。
哪怕是自律的我,也一样。
所以最近两周我又加强了输出,开始疯狂蹬Claude Code和Codex,甚至我还开通了Gemini。
于是我的x开始更新了,派简历上线了,JobClaw的教程也开始更新了,王二讲Agent的视频、脚本、网站都跟着更新了。
哪怕是在做的过程中,不一定会实时得到积极正面的反馈。
原因很简单,人是有惰性的。
一旦你开始后退,你就会一直后退,刹不住车。
而做,会让你感受到自我的迭代和进化,那种对知识的渴求,对生活的积极拥抱,都会让你的精神面貌焕然一新。