那聪明的你肯定要问,大模型不是预训练完就能用了吗?预训练本身已经花费了天文数字,为什么还要再砸一大笔钱做 RL?RL 到底是在干什么?普通人怎么去理解才能在 AI 时代不掉队?
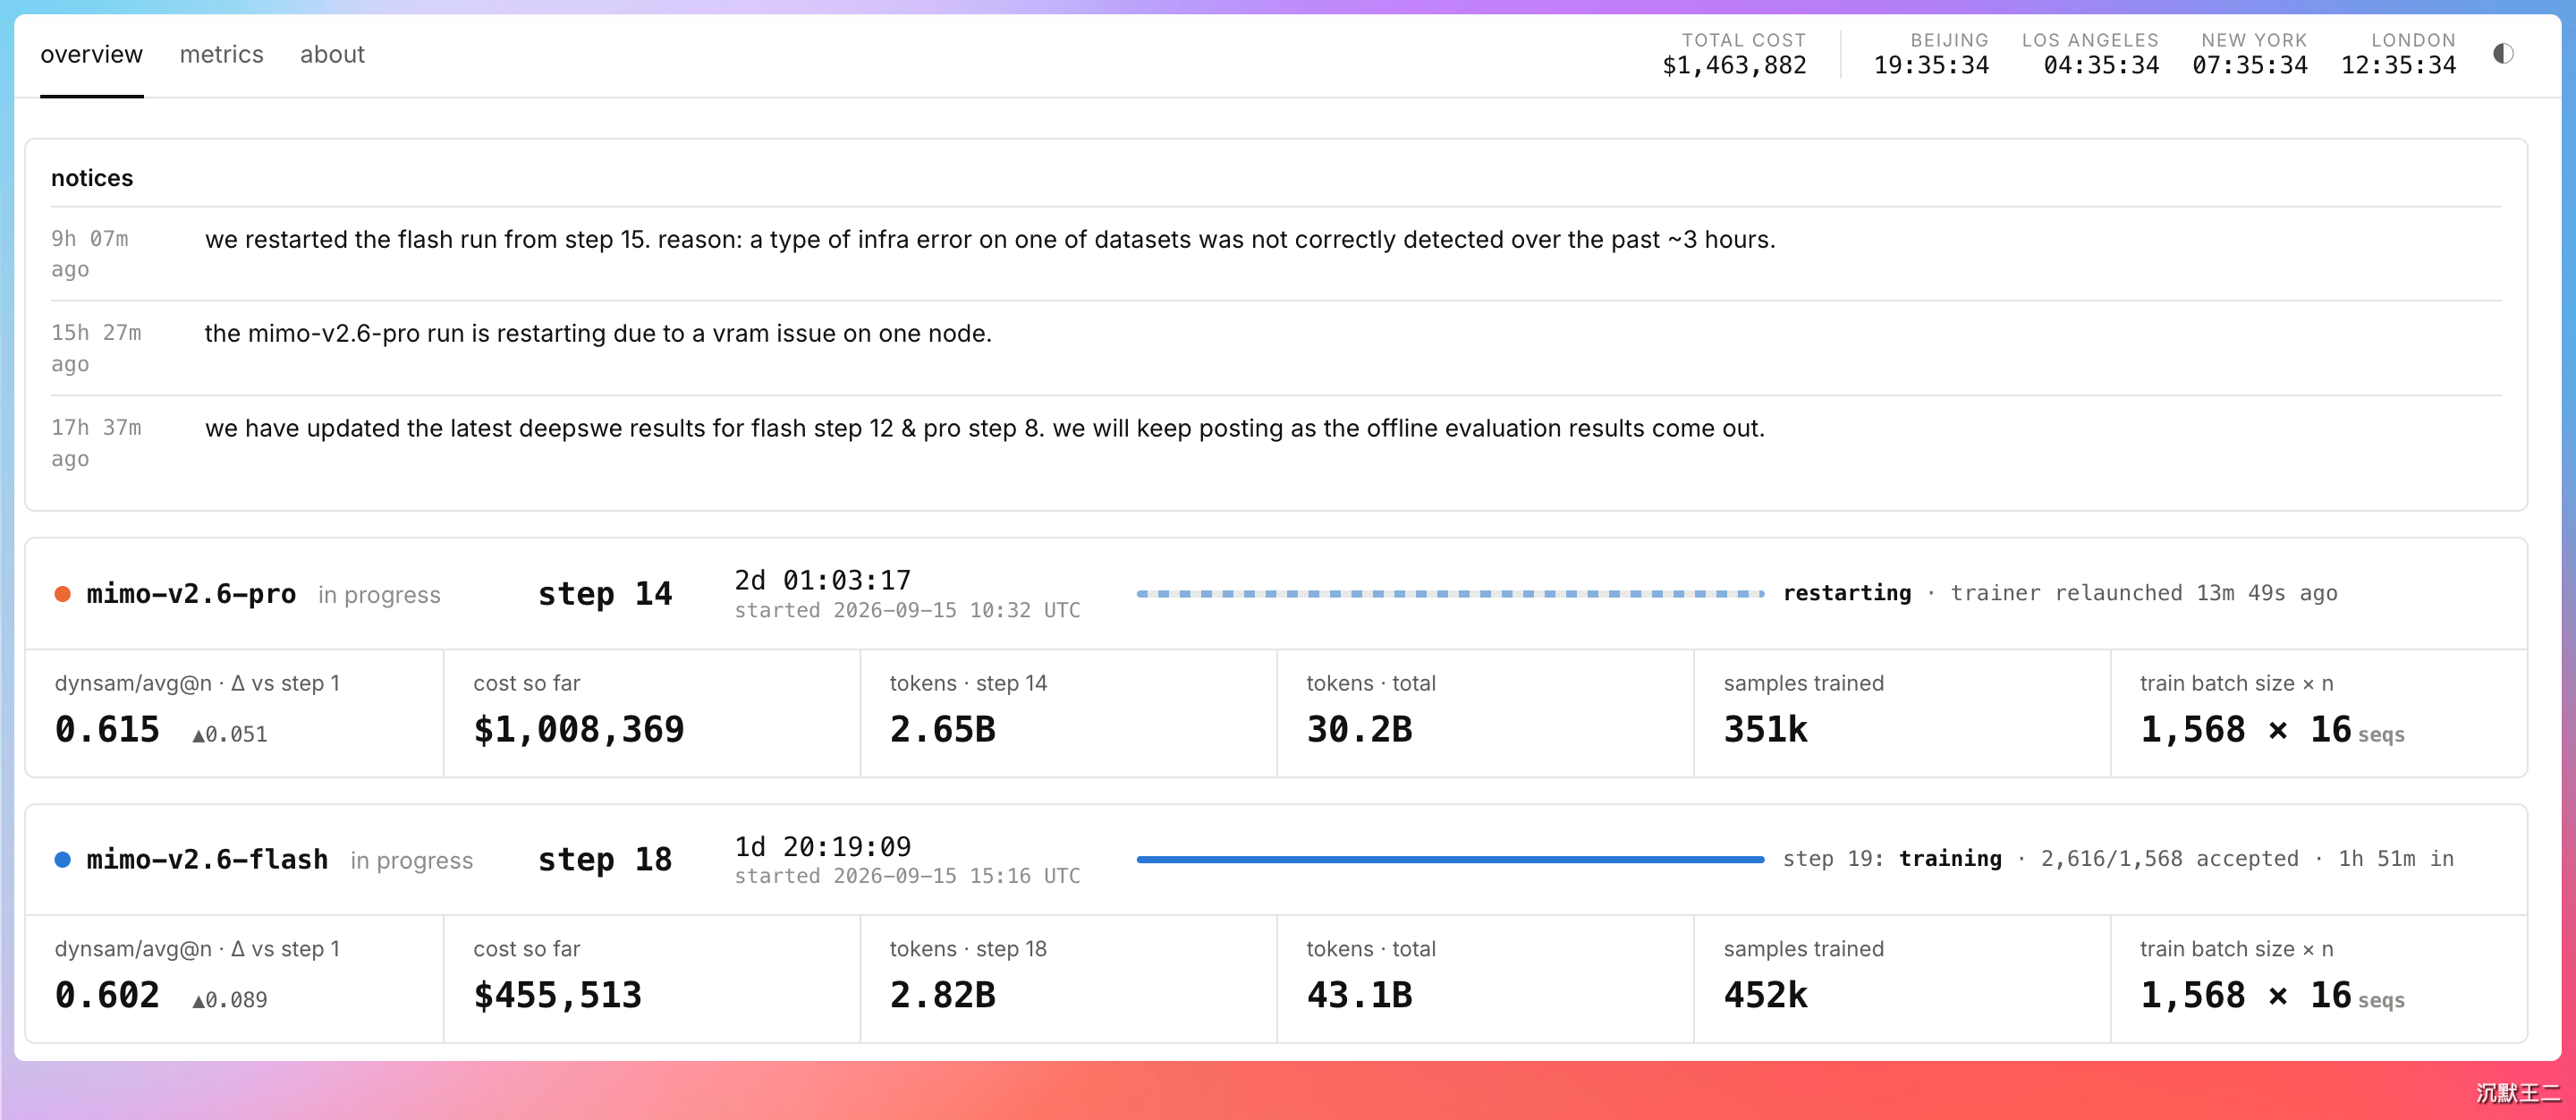
我翻了 DeepSeek R1 的技术报告、Sutton 的强化学习教科书、MiMo 团队的公开数据,可以自信地、大方地、光明磊落地帮你搞清楚这三件事。
先说第一件事,强化学习到底是什么。
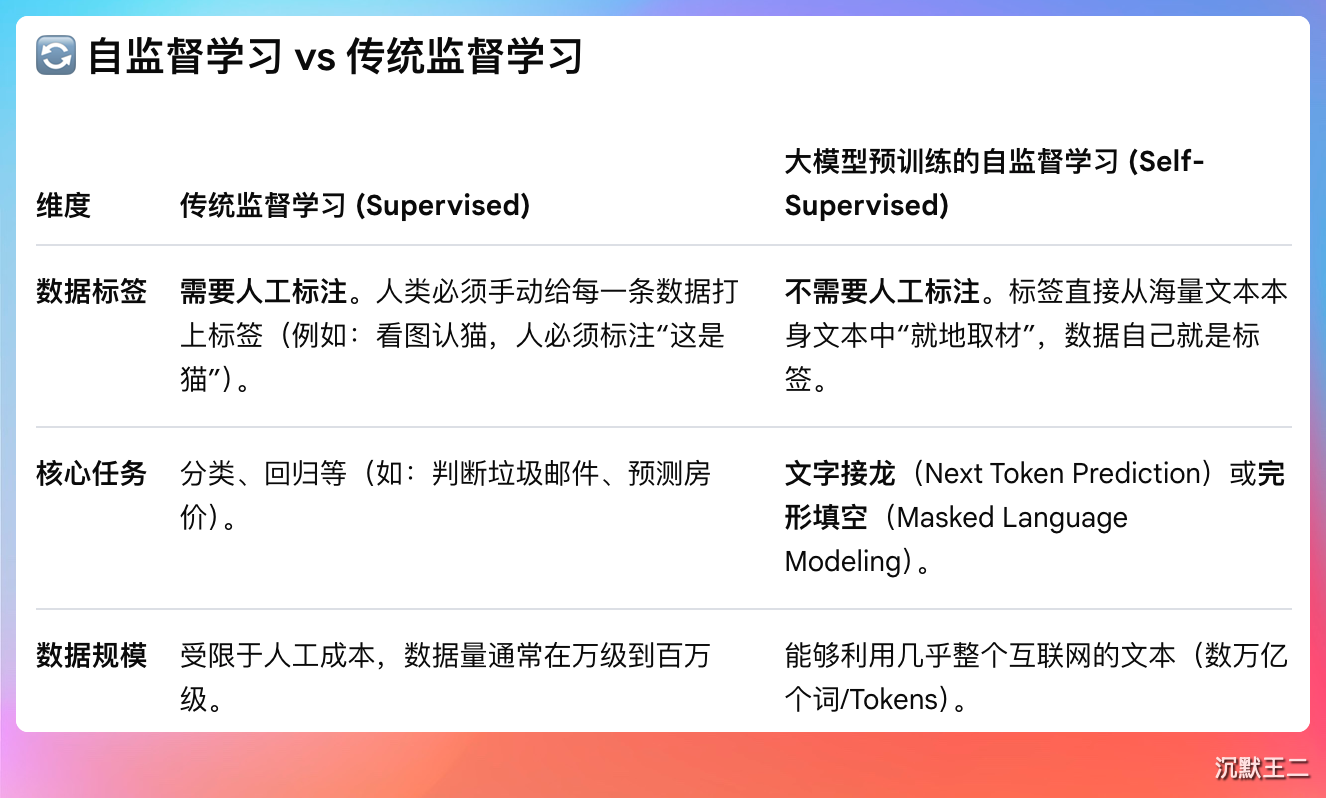
大模型在预训练阶段用的是自监督学习(Self-Supervised Learning,也就是不用人工打标签的监督学习)。
传统的监督学习是你请了 100 个英语老师,给每个句子标注出主谓宾、语法错误和情感倾向。你看着这些标注来学习(特点是手把手教,成本高)。
自监督学习是你不再雇佣任何老师,自己去读海量的英文原稿,读的时候用书签挡住一些词,自己猜这些词是什么意思。猜完之后,拿开书签看一眼原文,自己校对答案(特点是疯狂刷题)。
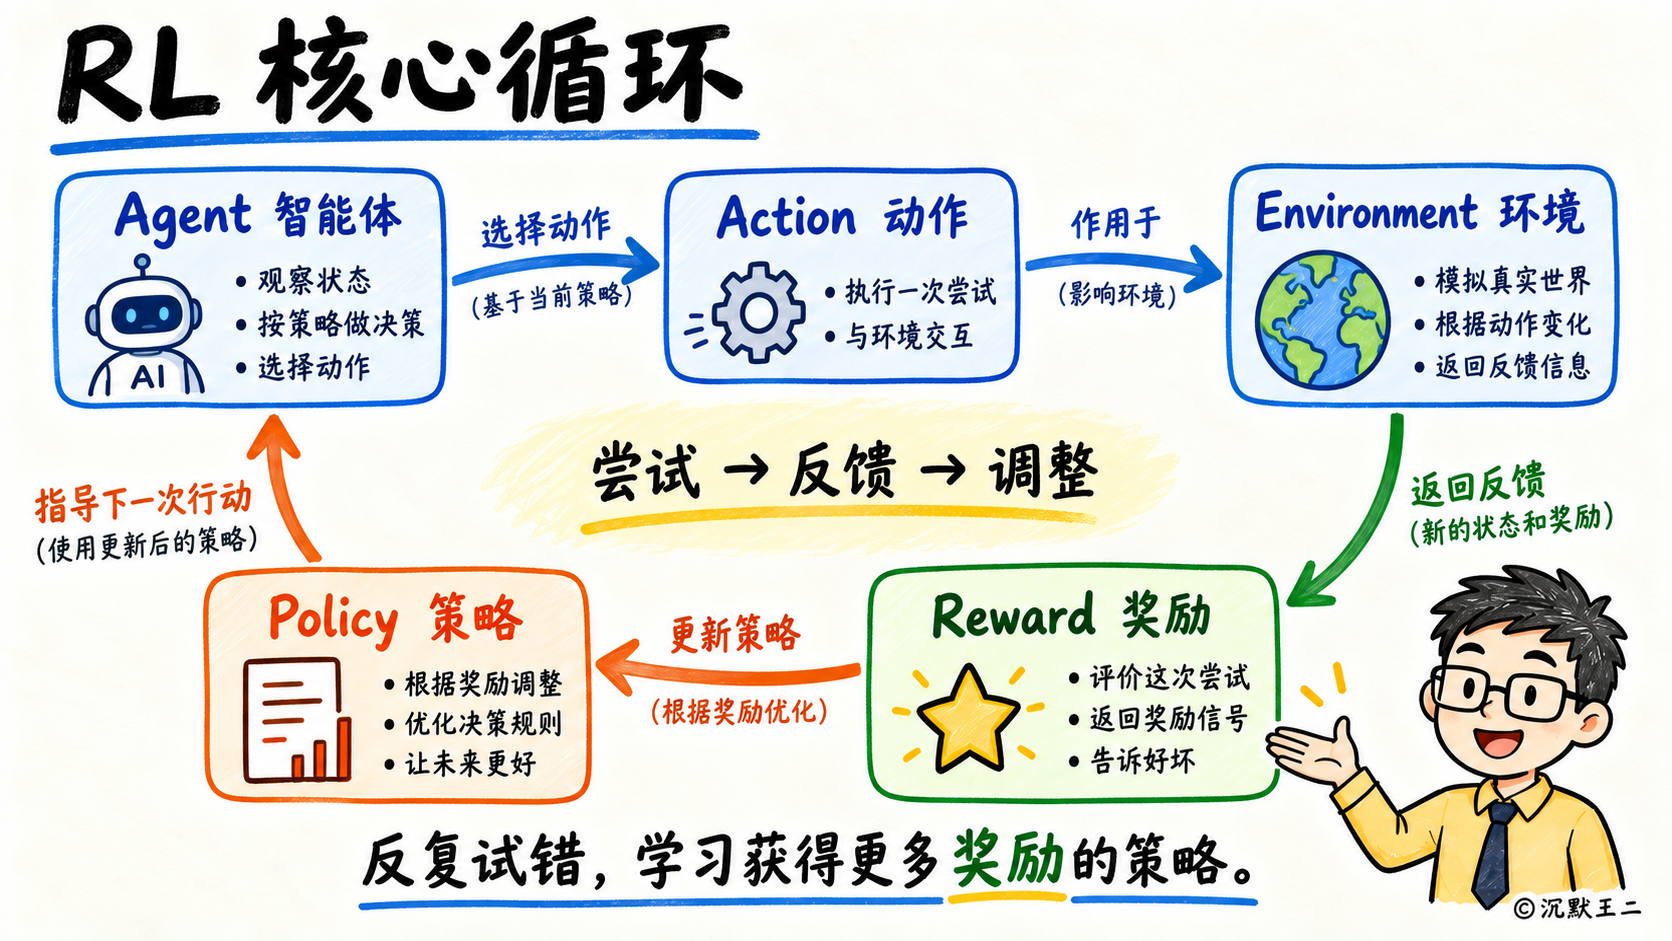
强化学习(英文全称 Reinforcement Learning)是你不仅没有老师,连一本书也没有。你被直接扔进纯英文的现实环境中,通过和环境的人进行互动,从每一次的“奖励”或“惩罚”中,自己摸索出生存之道(特点是活学活用,试错进化)。
和你学科目三的过程很类似。
你是一个 LLM(模型),负责做决策,你的目标是学会倒车入库、侧方停车和半坡起步。驾校是你学习的环境,对应 LLM 所在的世界或者场景。LLM 做出操作就是一次 Action,比如你正在倒车入库。
你没有压线就是一次高质量的 Action,对应到 LLM 就是 Reward(奖励)。你压线了,教练会骂你,对应到 LLM 就是 Penalty(惩罚)。
你根据教练的反馈或者自己的观察不断提升自己的车技,LLM 根据奖励不断调整自己的策略(Policy),你和 LLM 都会经过无数次的试错,但最终,你和 LLM 都会想尽办法让自己获得的奖励最大化,比如说通过科目三。
大模型靠自监督学习疯狂刷题,就像刚拿到驾照的萌新选手,会开不等于开得好。
于是 2025 年 1 月,DeepSeek-R1-Zero 做出了一件全世界都为之惊叹的事情。
他们没用任何标注数据,纯靠 RL 训练,让模型自己学会了推理。
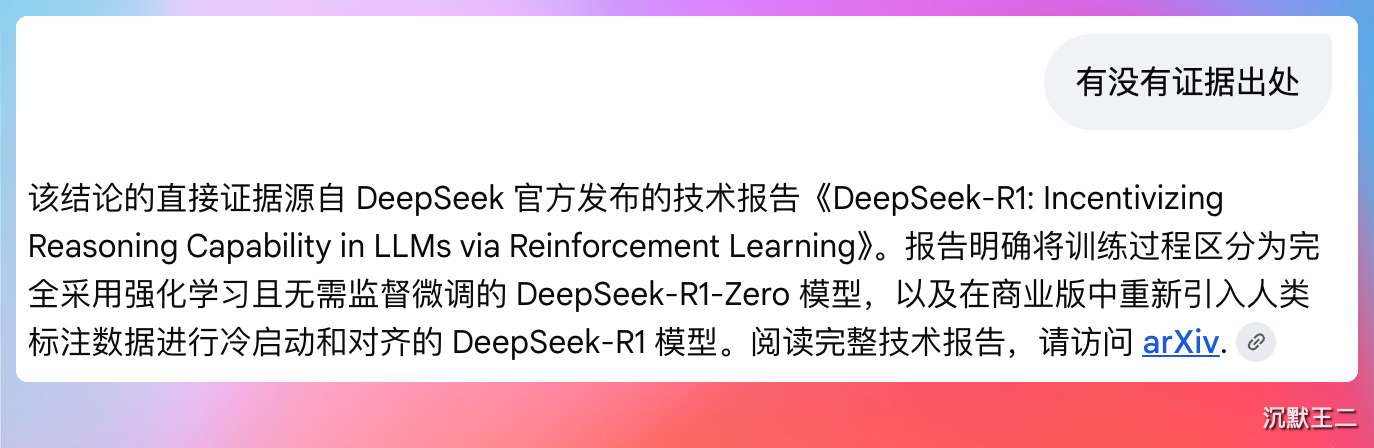
训练过程中甚至出现的“Aha Moment”,也就是顿悟时刻。模型自发学会了说“等一下,让我重新想想”、“我来验证一下结果”。这些反思行为正是 RL 在激励状态下自己涌现出来的。
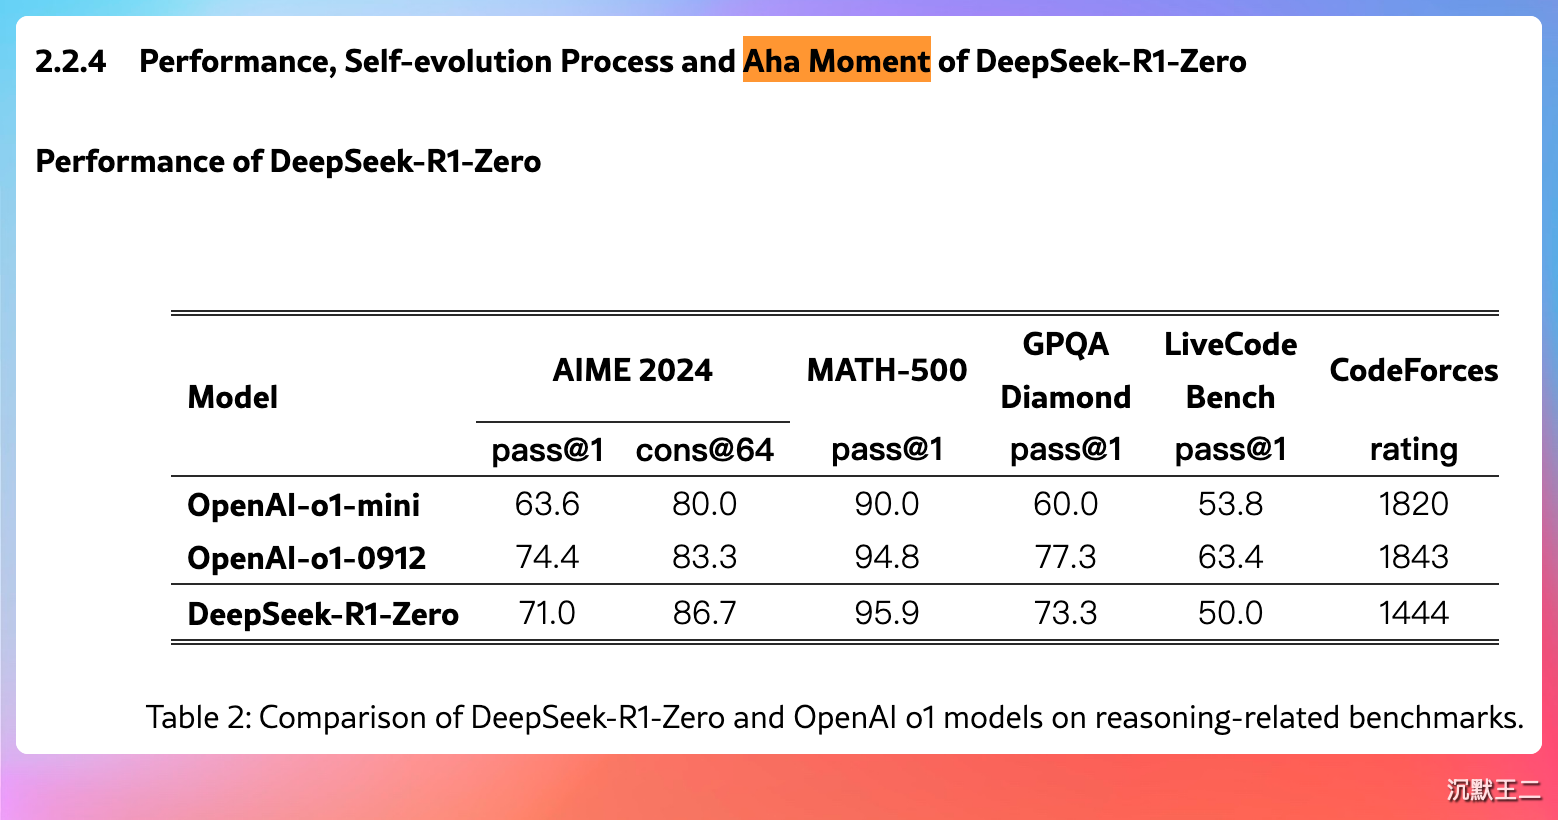
换句话说,预训练让模型有了满脑子的知识,RL 教会模型怎么把这些知识用对地方。
我们总说,学游泳最快的方法就是直接把你扔进泳池,在没有教练的情况下,求生本能会让你用最短的时间学会自救,因为呛水的惩罚让你极度难受,于是你要尽快学会闭气和换气。
RL 就很类似。
在强化学习阶段,模型被扔进了一个残酷的考场。这个考场没有老师,也没有教科书,只有无穷无尽的超级大难题。考场唯一的规则是:只要答案对了就给奖励;算错就立刻惩罚。
一开始,模型就像个莽撞的愣头青,不去思考就答题,于是被狠狠惩罚;后来他终于放慢脚步,告诉自己,不着急让我先想一想。于是他顿悟了。这个“停下来反思”的动作让他尝到了巨大的甜头,于是,模型产生了强烈的记忆(策略升级)。在接下来的无数次做题中,开始疯狂模仿这个能带来高分的动作。
这正是 RL 牛的地方。
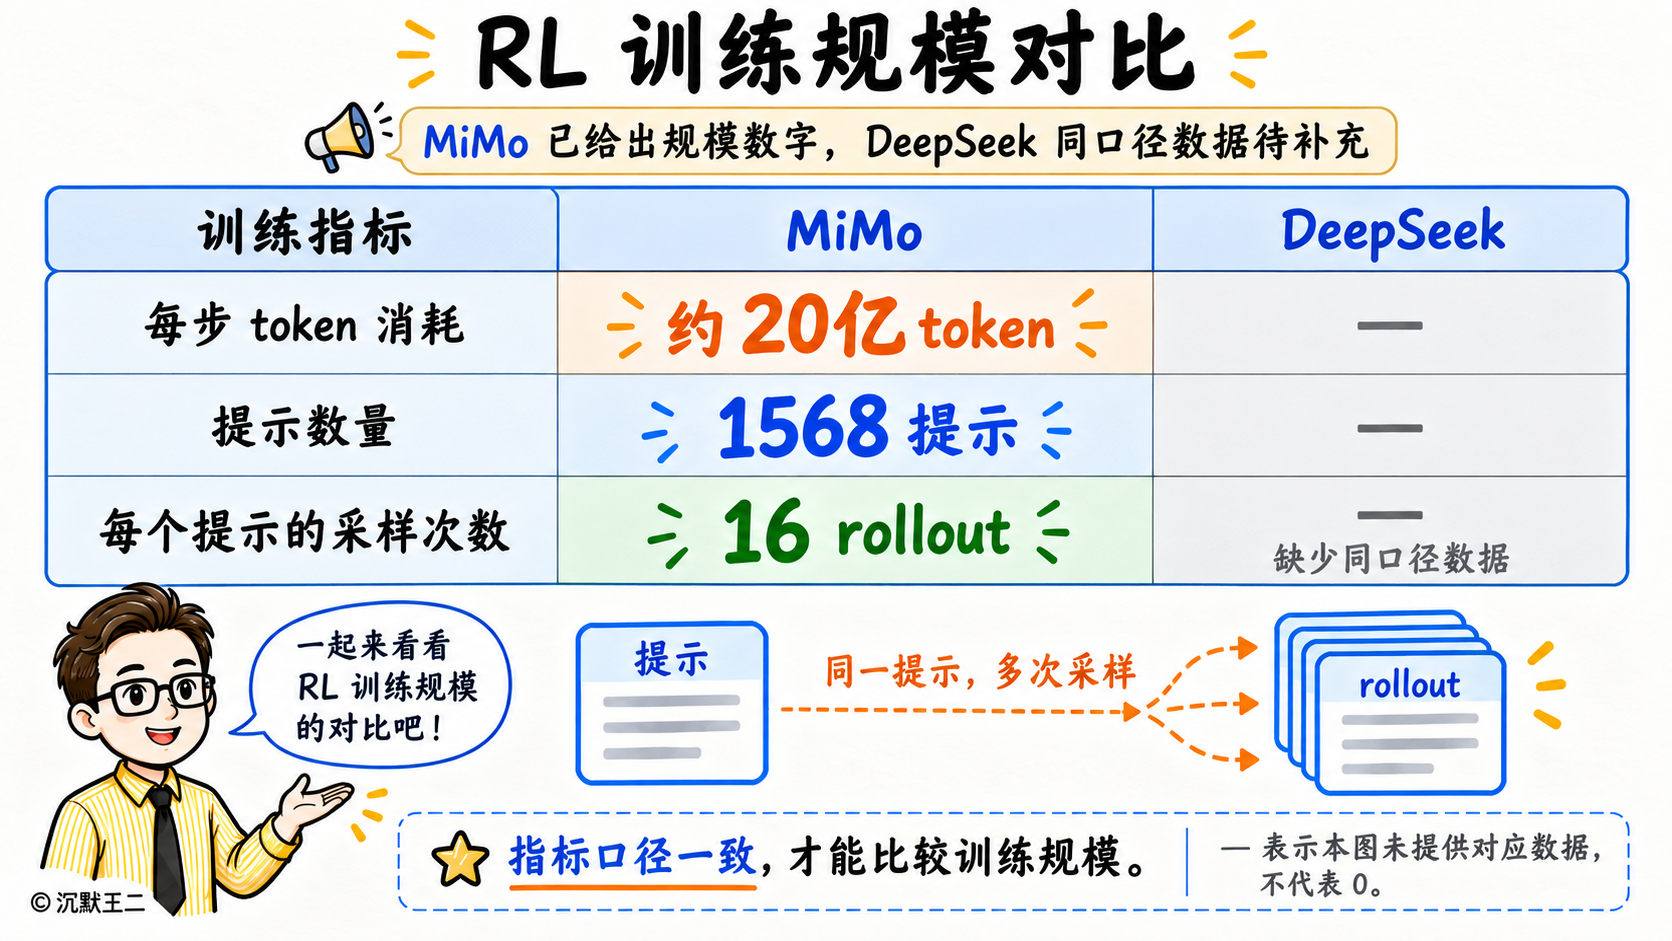
那聪明的你肯定要问,为什么各家都在往 RL 上砸钱?
因为预训练的高质量文本数据已经快用完了。继续堆数据、堆参数,性价比越来越低。但 RL 不需要新的数据,只需要一个能判断对错的奖励信号,模型就能自己越练越强。
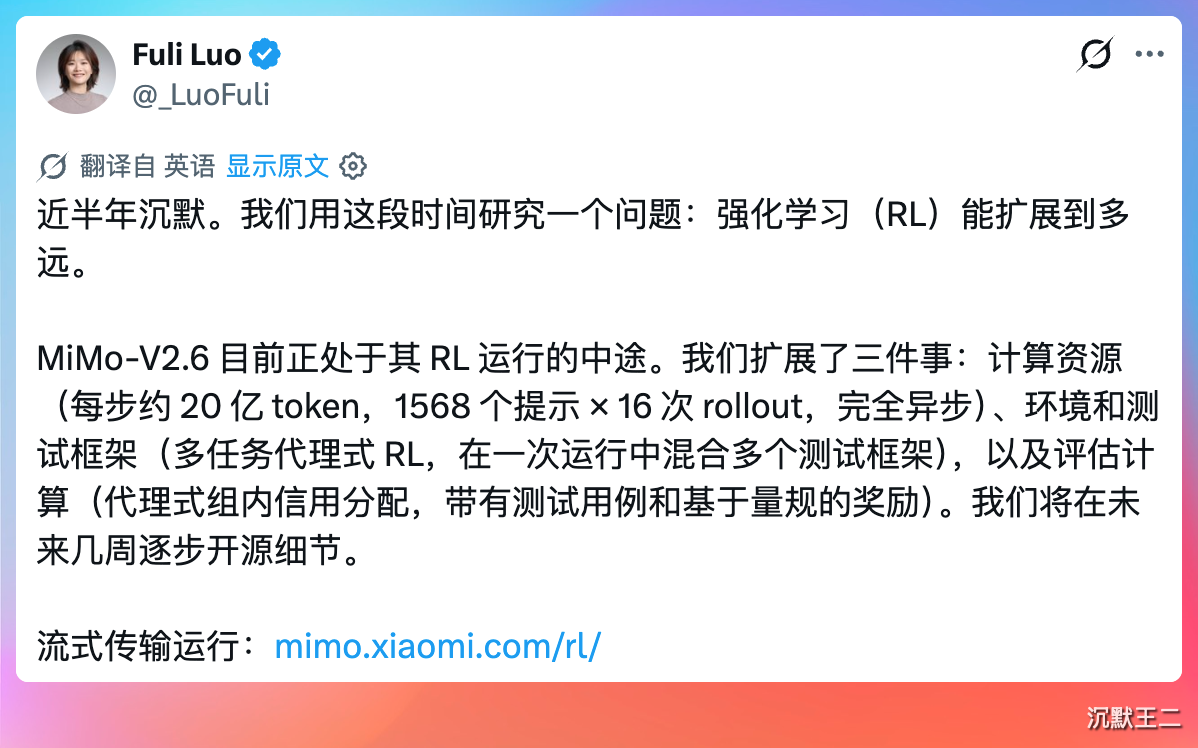
小米这次 RL 实验不只是砸算力。他们把代码、视觉、推理、对话这些完全不同的任务混在一起训练,让模型在同一轮 RL 里同时面对各种考试。奖励信号也不是简单的对或错,而是按测试用例逐项打分,答对第一步给一分,第二步再给一分,比粗暴的全对全错精细得多。
OpenAI 的 Dan Roberts 就曾在 2025 年 5 月说过这样一句话,“RL 的算力投入将超过此前所有预训练的总和。”预训练是让模型拥有海量的知识,RL 是让模型学会思考,让这些知识发挥出价值。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!