
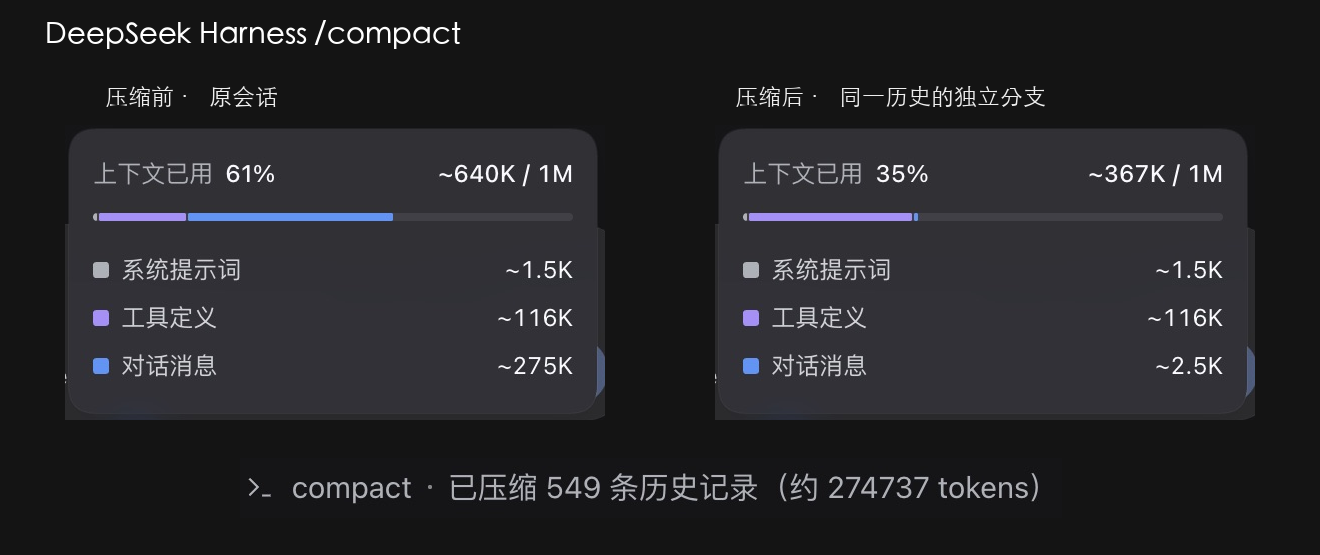
一开始我以为,压缩就是把最早的几轮对话删掉。可最早的对话里往往放着你交代的任务目标;而且提示词缓存是按前缀匹配的,删掉开头的,后面的缓存就都对不上了。所以生产级 Agent 做压缩的时候要解决两个问题,一是先压缩体积大的、价值低的内容;二是做摘要时,文件路径、报错、目标这类关键信息不能丢。
恭喜正在点赞的你,已经成功击败 30% 的学习者了。视频的原稿以及 369 道 Agent 八股已经整理到开源知识库。
接下来我问你,上下文里应该先压缩什么?
A,删掉最早的对话;B,裁剪超长的工具输出;C,直接调用大模型做摘要。
我的答案是 B。上下文窗口里占体积的大头,通常不是你和 Agent 的对话,而是读文件、搜代码、跑测试返回的大段文本。比如跑一次测试可能会输出上万字的日志,有用的信息往往集中在开头的执行命令和结尾的报错堆栈,中间基本没什么价值。所以各家 Agent 都会先处理工具输出,Claude Code 给单个工具结果设了 5 万字符的上限,Codex 和 Pi Agent 都是裁掉中间、保留头尾。这一步不调用大模型,几乎没有额外开销。
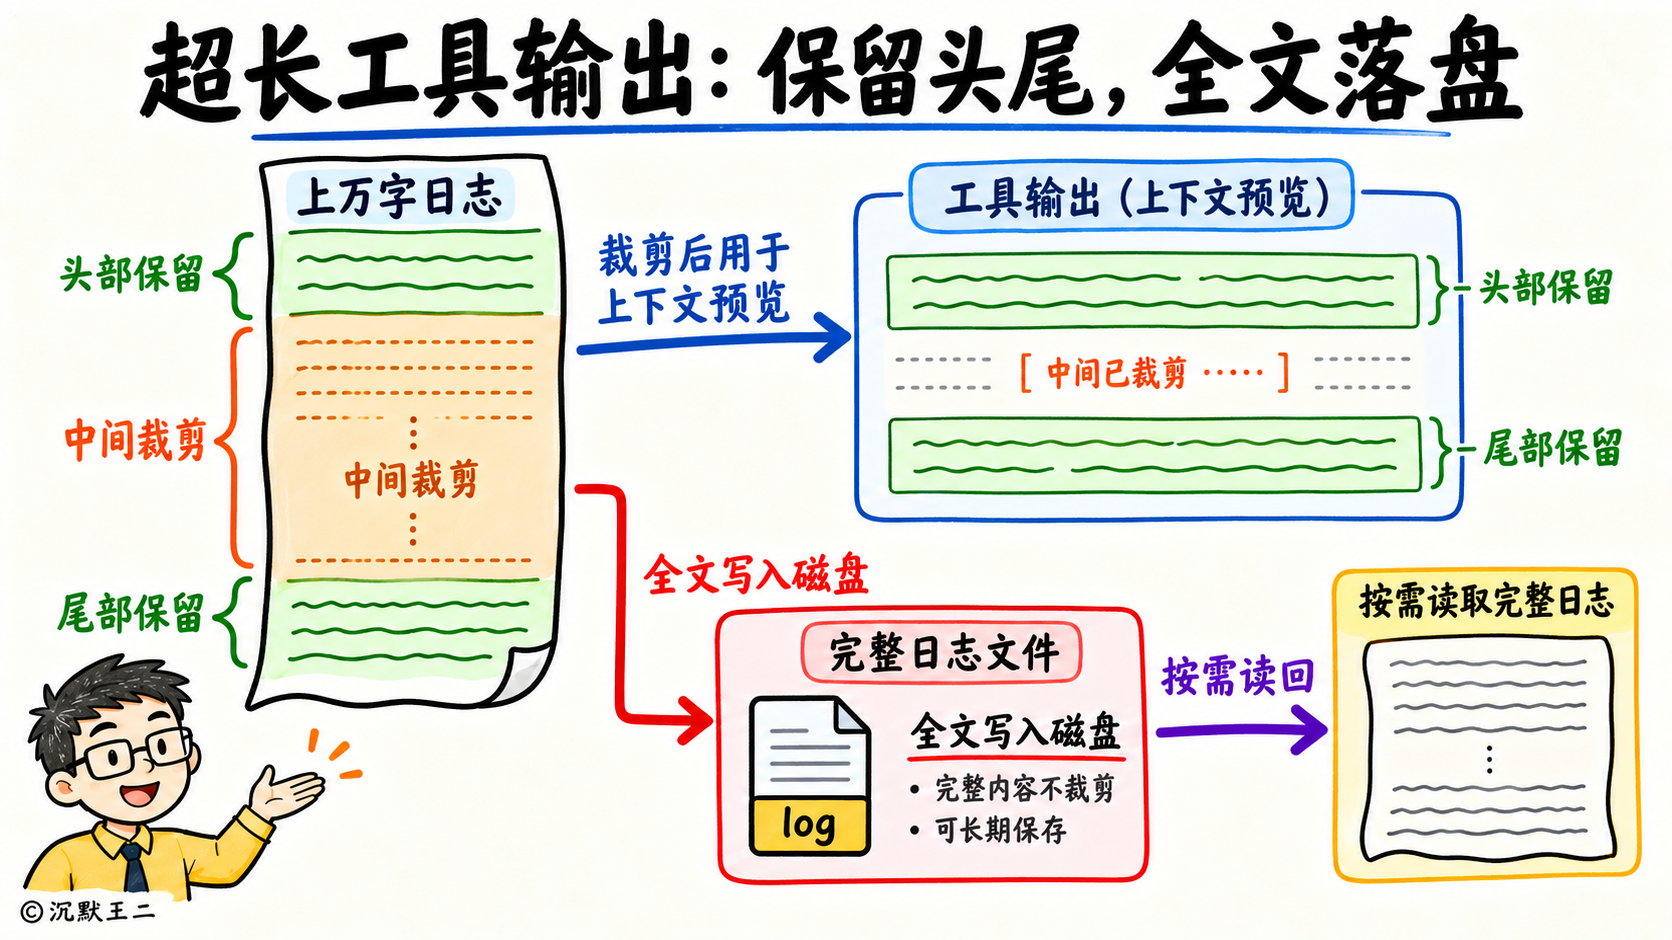
那聪明的你可能会问,万一中间部分很有用呢?DeepSeek Harness 会把超长结果的全文写进磁盘,上下文里只留下预览和文件位置,Agent 真需要时再读回来。相当于用一次读文件的开销,换回上下文里的一大块空间。
恭喜正在收藏的你,已经成功击败 50% 的学习者了。
继续问你,大模型做摘要时该做什么处理?
A,用一段话概括全部对话;B,按固定模板分段写;C,合并上一次的旧摘要。聪明的你会选哪一个?
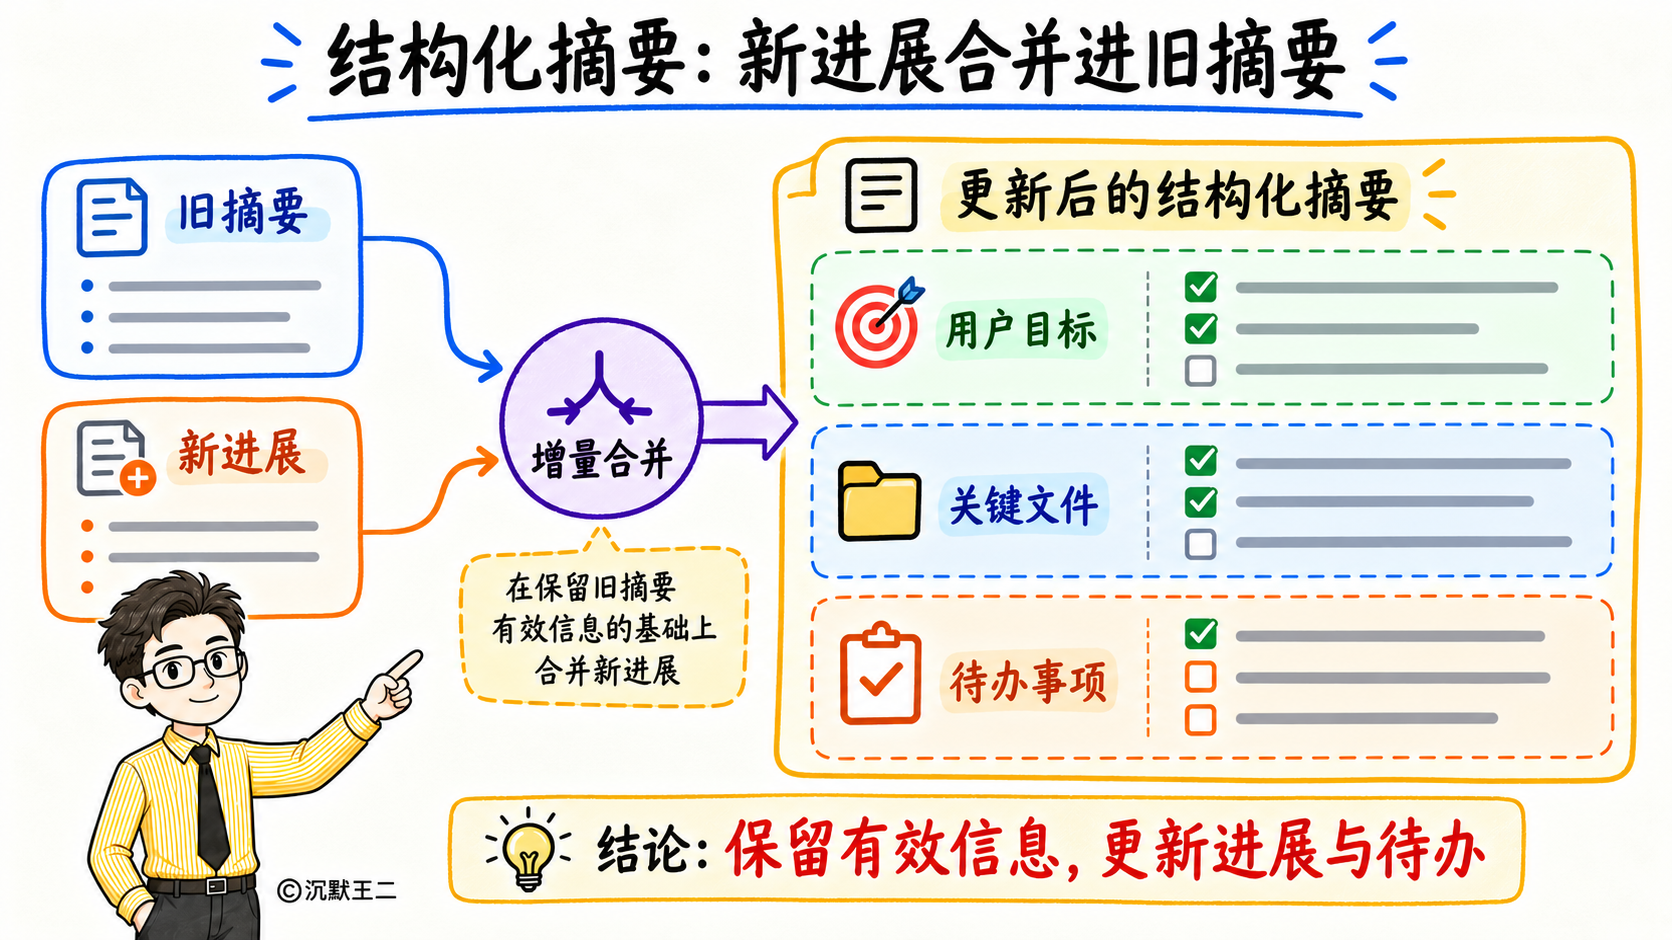
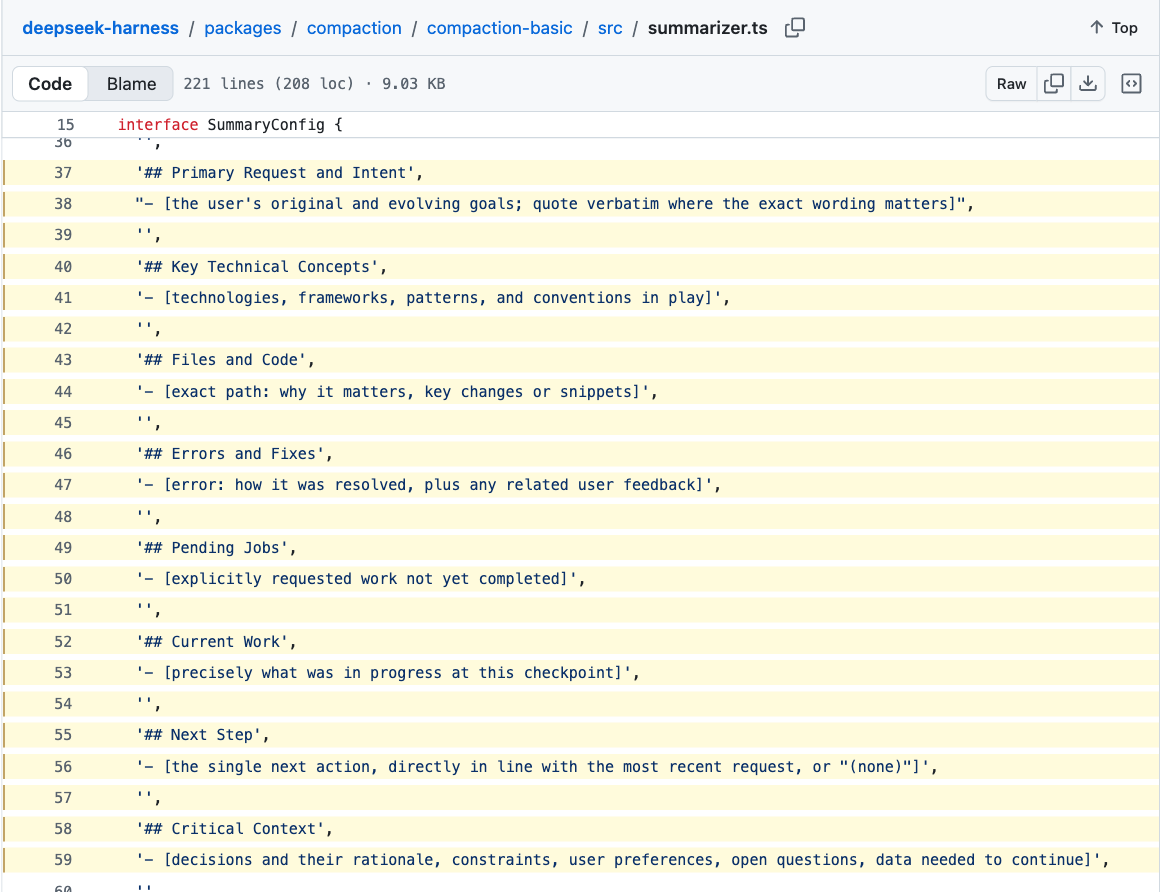
我的答案是 B + C。如果只让大模型用一段话概括,它很容易写成“用户在修一个登录的 bug,已经改了好几个文件”,可到底改了哪几个文件、报的什么错、你中途纠正过它什么,全都没了。所以 DeepSeek Harness 会给摘要固定一个模板,分成用户目标、关键文件、报错与修复、待办事项、下一步等等,并且要求文件路径、命令和报错信息一字不改地保留。
那聪明的你肯定会问,第二次压缩怎么办?这时候上下文里已经有一份旧摘要了。如果把旧摘要和新对话混在一起重新概括,就成了摘要套摘要,信息一轮比一轮少。DeepSeek Harness 的做法是让大模型把新的进展合并进旧的摘要,接着更新已完成和待办的部分。另外,最近的一段对话是不参与压缩的,Pi Agent 默认保留大约 2 万个 Token,这样 Agent 压缩完还记得自己正在干什么。
恭喜正在点推荐的你,成功击败 70% 的学习者了。
继续,DeepSeek Harness 什么时候触发压缩?
A,每次请求前检查用量;B,固定每十轮压缩一次;C,服务端提示上下文窗口超上限后补救。你会选哪一个?
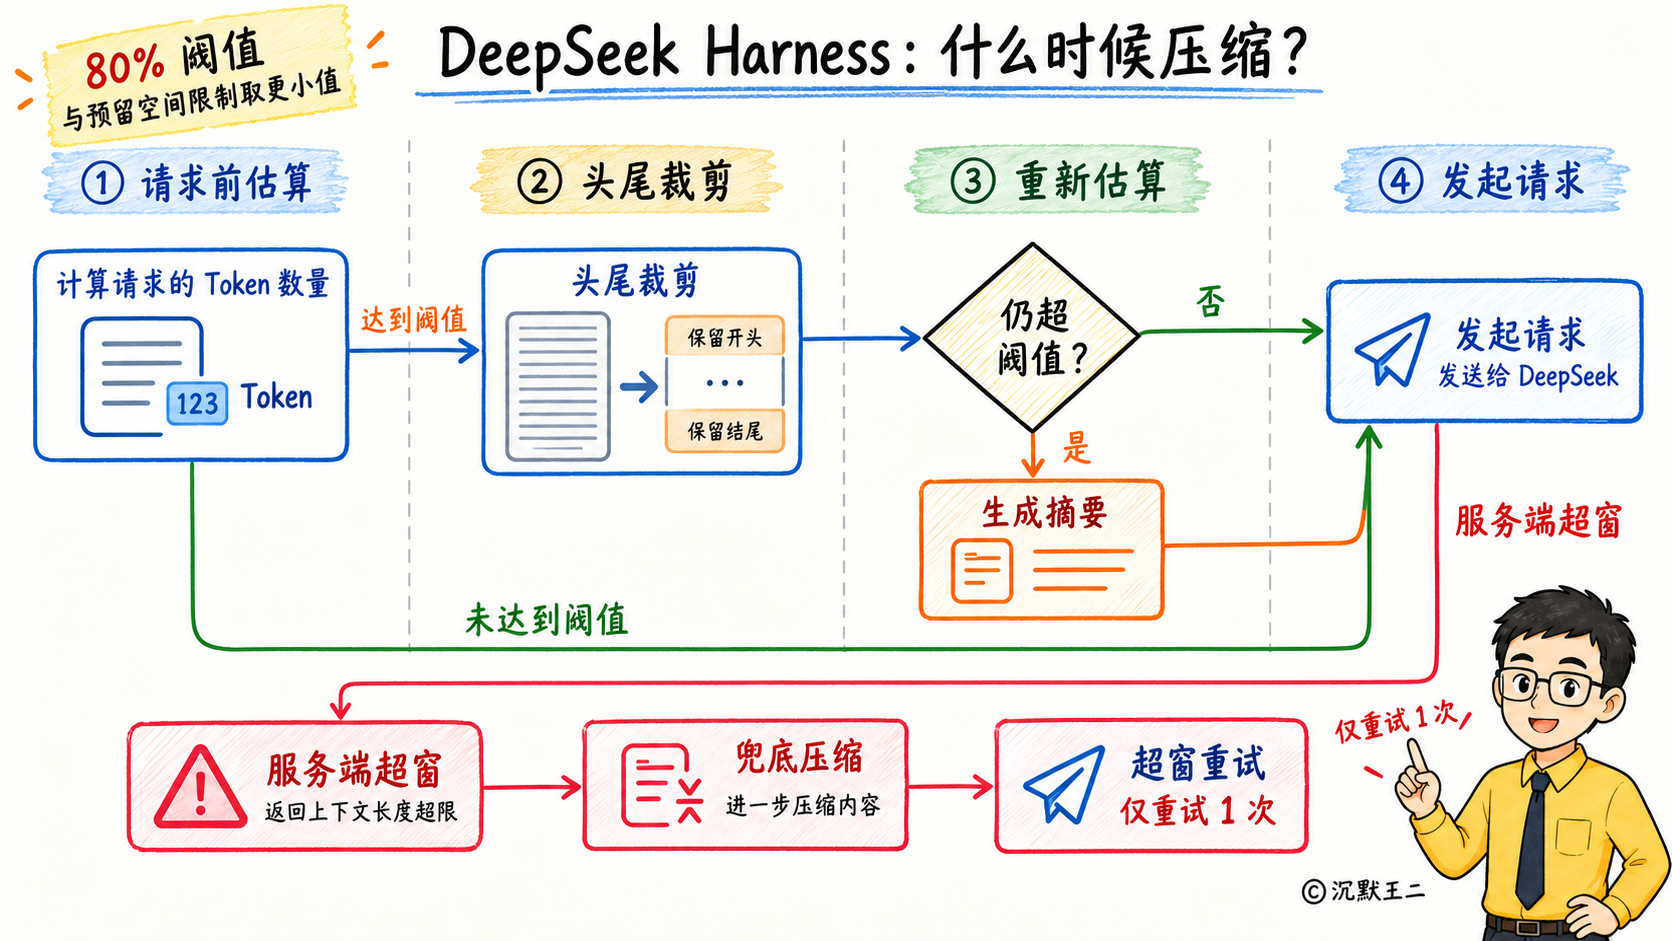
我的答案是 A + C。翻开 DeepSeek Harness 的源码,每次发请求之前,它都会先估算一遍当前上下文的 Token 数。阈值取两个数里更小的那个,一个是窗口容量的 80%;另一个是先扣掉预留空间,再扣掉大约 6.4 万 Token 的余量。按 DeepSeek 1 M 的窗口算下来,大约在 68 万 Token 时触发。
到了阈值,也不急着调用大模型,而是把超过 8192 个字符的工具输出裁剪成开头 4096 个字符加结尾 1024 个字符,再重新估算一遍。如果已经降回阈值以下,就直接跳过摘要。
不过 Token 数是估算出来的,难免有误差。万一估少了,服务端会返回上下文超出的错误,DeepSeek Harness 会兜底压缩一次再重新发请求,而且只重试 1 次,避免压缩、报错、再压缩陷入死循环。
恭喜每次都来看我内容的你,成功击败 90% 的学习者了。
最后再问你,DeepSeek Harness 怎么生成摘要?
A,换一套摘要专用提示词;B,复用主会话前缀;C,用摘要替换原对话。聪明的你会选哪一个?
我的答案是 B + C。如果单独写一套“你是一个总结助手”的系统提示词,前缀一换,后面紧跟着的几十万 Token 就得从头 Prefill。DeepSeek Harness 的做法是保持系统提示词和工具定义不变,只在要压缩的哪段历史末尾追加一条用户消息作为摘要指令。只要缓存还没过期,除了新加的这条新指令,前面的内容都能命中 KV Cache。
不过,摘要并不是把整段历史全部做压缩。动手之前,Harness 要先决定哪一部分交给模型去总结,哪一部分保留原文。 DeepSeek Harness 在做切分的时候,会从末尾往前保留大约 16% 的原文。如果切分点正好落在工具调用和工具返回之间,就继续往前,保证两者成对出现。
切分点之前的内容交给模型生成摘要,摘要会替换掉这段对话,但底层的事件日志只追加、不删除,原始记录随时可以回放。AGENTS.md 这类规则文件如果在压缩中被裁掉了,下一轮会重新注入上下文。
当然,压缩是有代价的。下一轮请求里,系统提示词和工具定义还能命中缓存,单摘要和保留的原文则要重新 Prefill。
恭喜你升到王者段位了,成功击败 99% 的学习者。
最后简单总结一下,Agent 做摘要压缩不是简单地删除旧消息。先裁剪超长的工具输出,全文写进磁盘;再让大模型按模板写摘要;第二次压缩时合并到旧摘要;最近一段对话保留原文。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!