
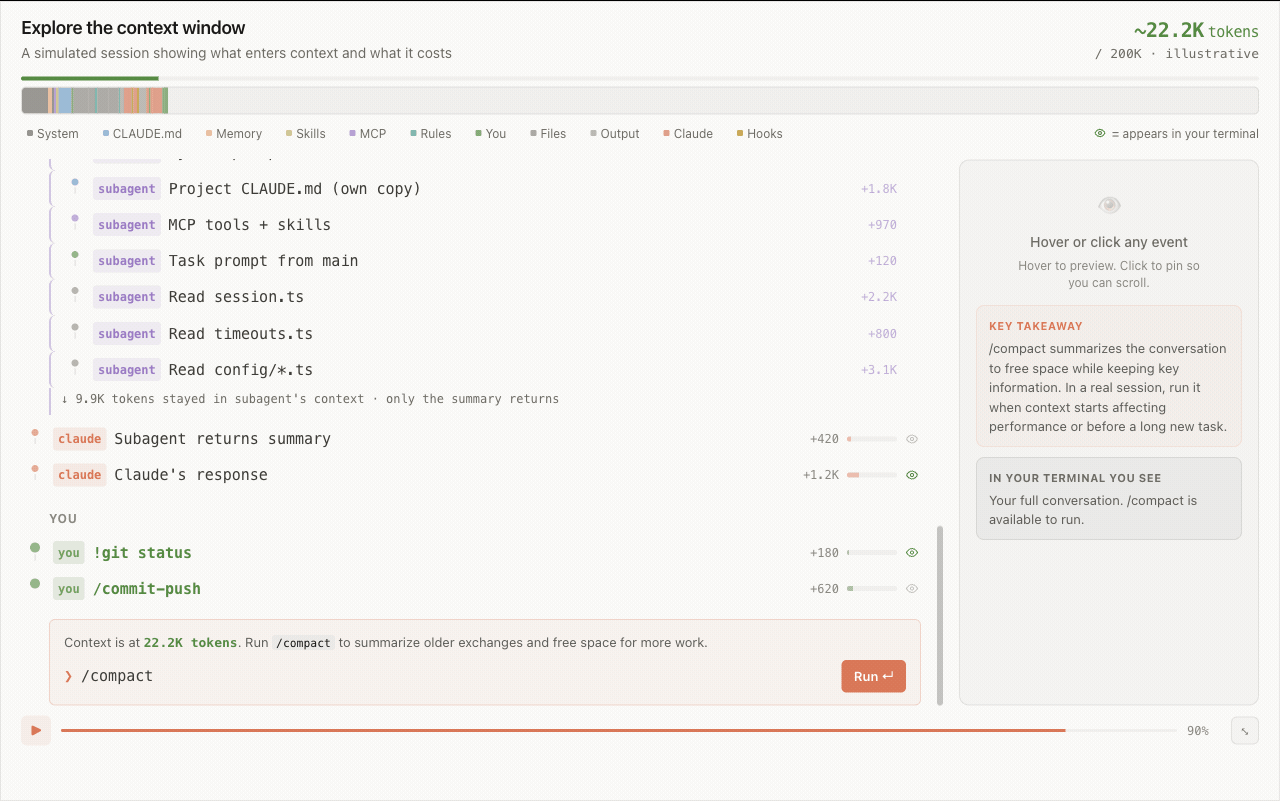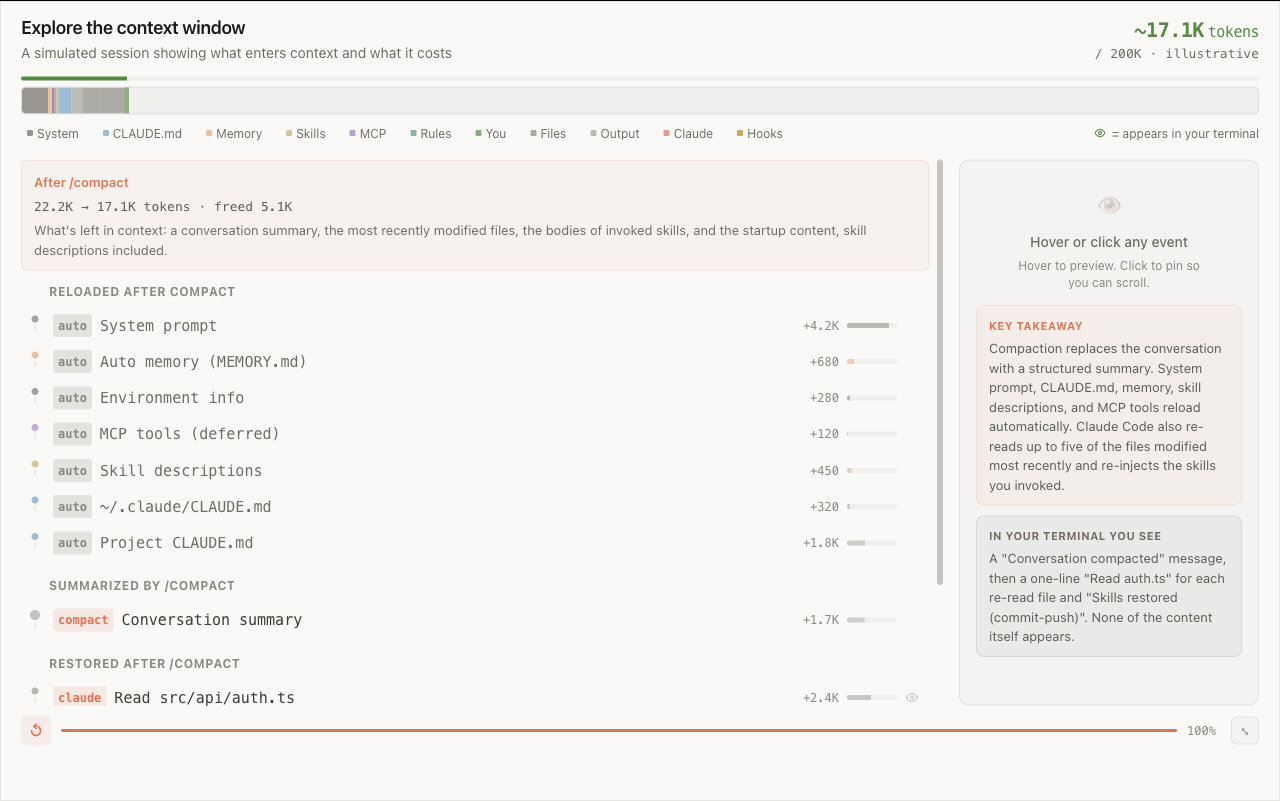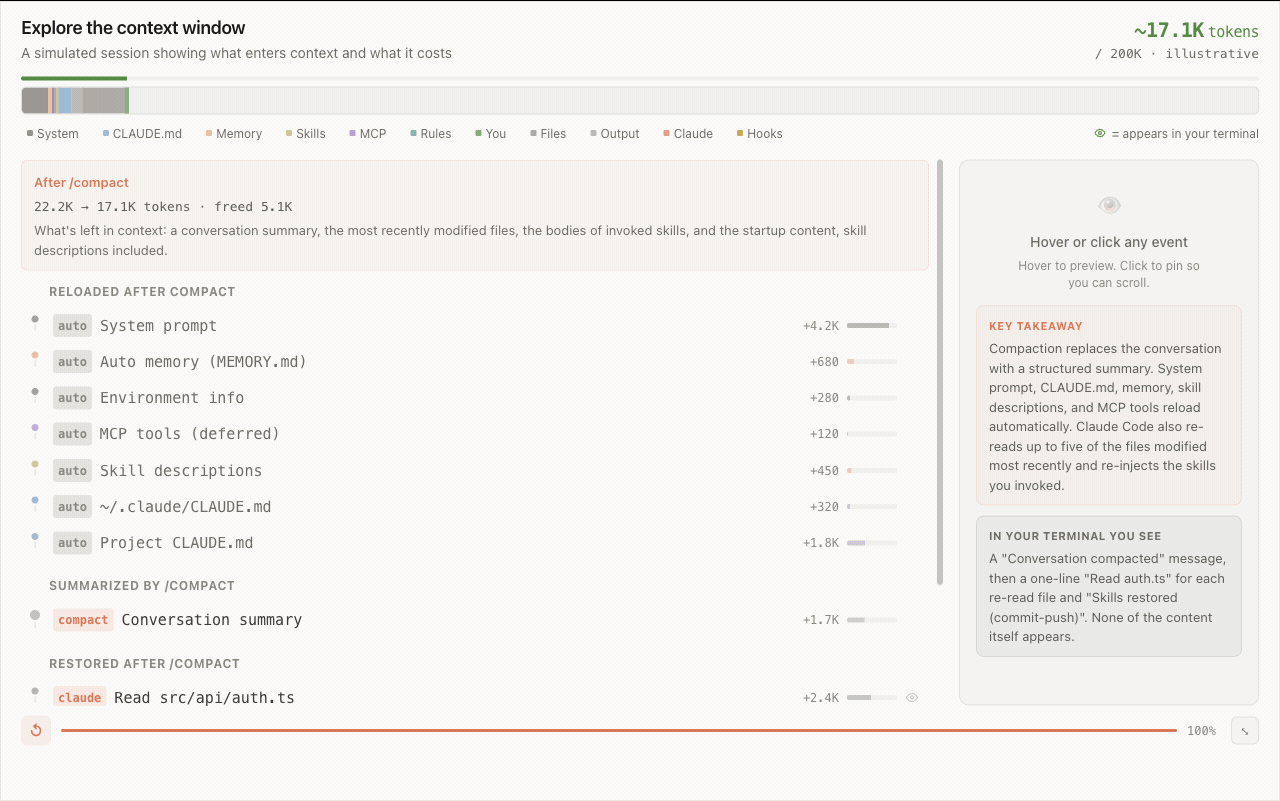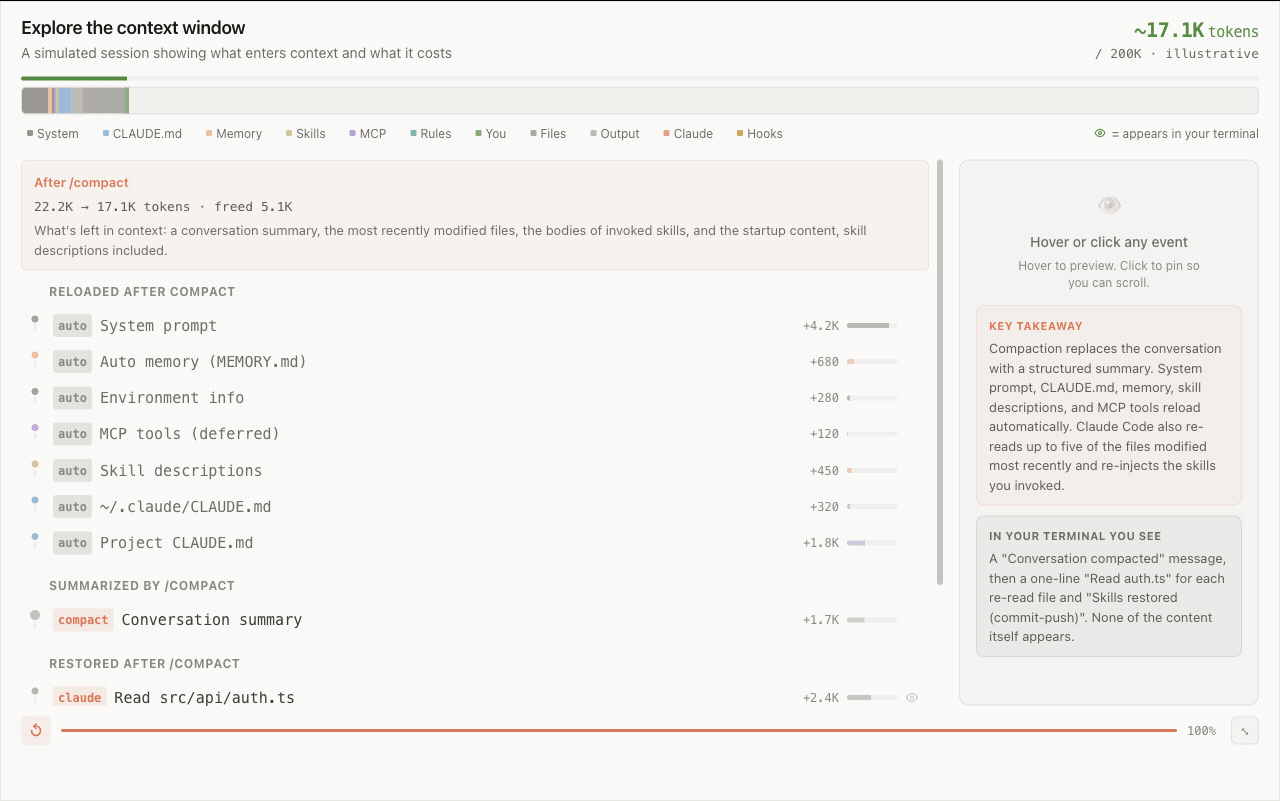
之前我们讲过,大模型推理靠 Prefix Caching 复用显存里的 KV Cache。命中规则是从第 0 个 Token 开始逐块匹配的,前面的改了,后面的缓存就会失效。那聪明的你应该已经注意到了,上下文压缩需要删改历史消息,这两者岂不是有冲突?
如果你觉得上下文压缩就是每轮用滑动窗口删掉最早的内容,那确实会让之前的 KV Cache 失效。但在生产级 Agent 里,两者是配合工作的,他们需要共同解决两个问题,一是历史对话只追加不修改,达到上下文窗口的阈值才压缩,从而守住缓存命中;二是清理旧的工具结果和生成摘要时,靠服务端删除和前缀复用,降低重建代价。
恭喜看到这里的你,已经成功击败 30% 的学习者,给自己来个关注鼓励一下吧。视频的原稿以及 369 道 Agent 八股已经整理到开源知识库。
接下来我问你,Agent 是什么时候触发上下文压缩的?
A,每轮都用滑动窗口删除旧消息;B,达到窗口阈值才压缩;C,每隔十轮压缩一次。喜欢收藏的你可以把答案打在弹幕或者留言区。
我的答案是 B。假设任务要跑 50 轮工具调用,每轮都删掉最早的一条对话消息。系统提示词和工具定义虽然没变,还能命中,但紧跟其后的第一条对话消息每轮都在变,前缀从这里断开,后面的整段对话历史每轮都要重新计算。翻开 Claude Code、DeepSeek Harness 和 Pi Agent 的源码,日常轮次都采用只追加写入,系统提示词和工具定义排在最前面保持不动,新消息只往末尾追加。这样每一轮除了新加的那部分,前面的内容都能命中 KV Cache。
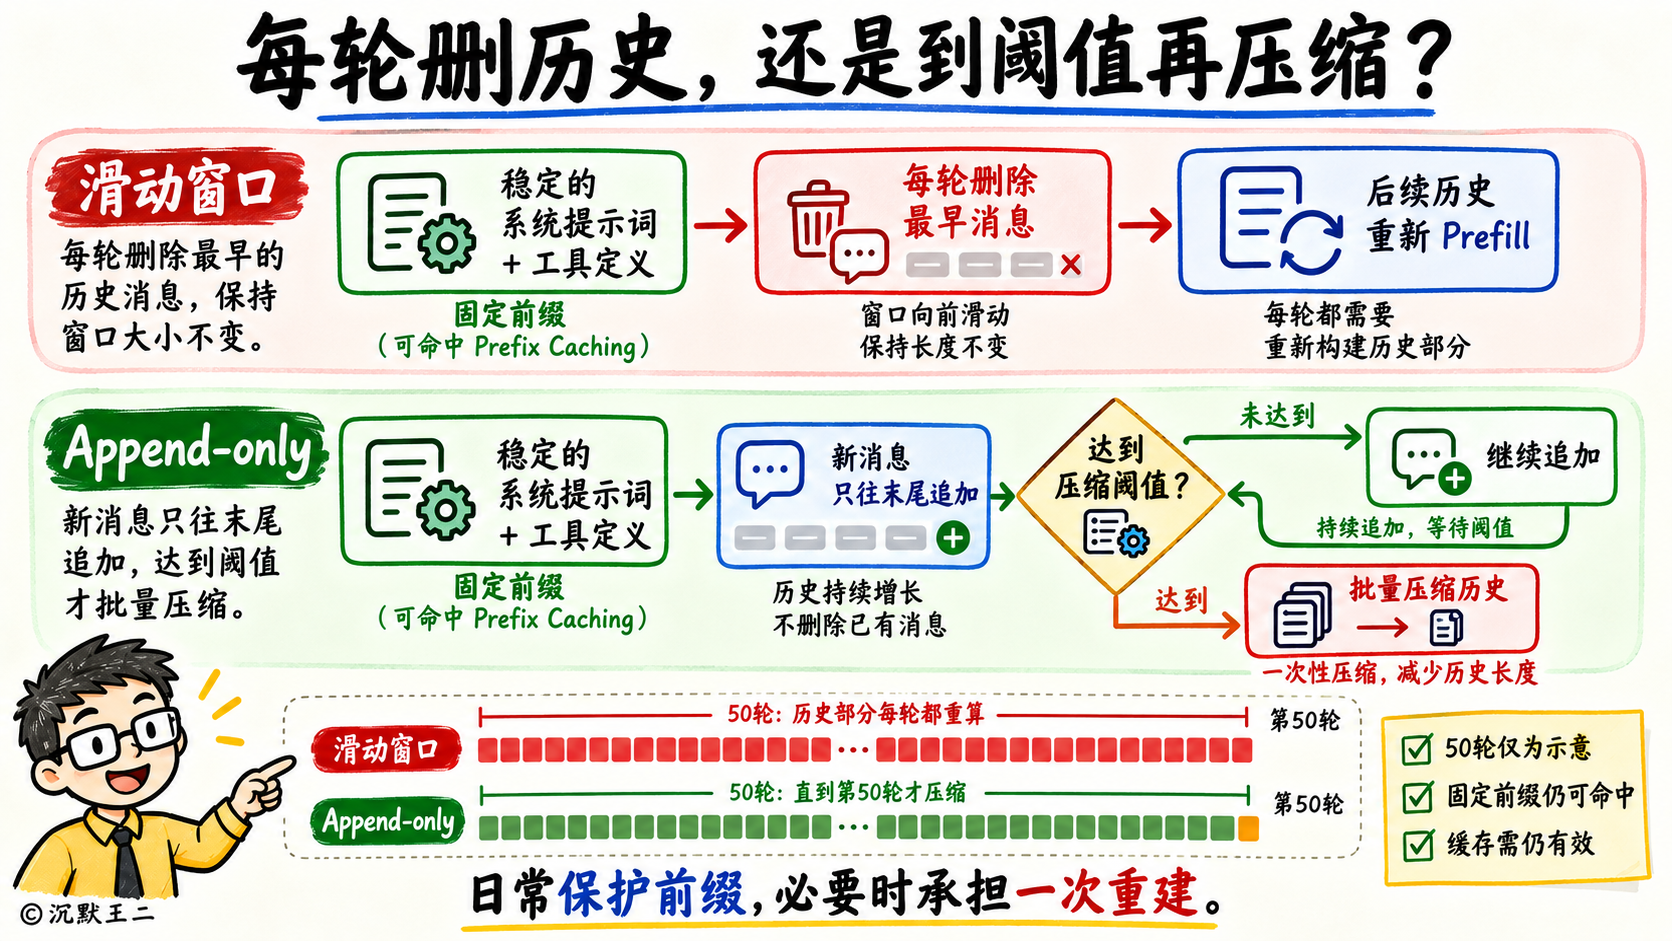
只有当上下文快把窗口撑满、比如达到窗口容量的 80% 时,Agent 才会触发压缩。而且压缩不是全部清空,它会保留最近几轮的对话原文,只把早期历史压缩成摘要;还会避开 tool_result,保证工具调用和返回成对出现。这样就能在最大程度上控制缓存重算的成本。
恭喜看到这里的你,已经成功击败 50% 的学习者了。
继续问你,Claude Code 怎么清理旧工具的返回结果?
A,每次都在本地改成占位符;B,缓存未过期时通知服务端删除;C,缓存过期后再在本地替换。喜欢点赞的你会选哪一个?
我的答案是 B + C。上下文窗口里占体积的大头,通常是读文件、搜代码、跑测试返回的大段文本。如果直接在本地把几轮前的工具输出改成一句简短提示,消息内容一变,提示词缓存是按前缀匹配的,从被改的那条消息开始,后面的缓存就都对不上了,等于白白重算一遍。翻开 Claude Code 的源码能看到,它会按服务端缓存有没有过期,分两种方式清理。当你还在连续对话、缓存还在有效期内时,它会保持本地消息原文不动,只把要清理的旧工具调用 ID 发给服务端,由服务端把这几段工具结果从缓存里剔掉,其余部分的缓存尽量继续复用,不用整段重新计算。
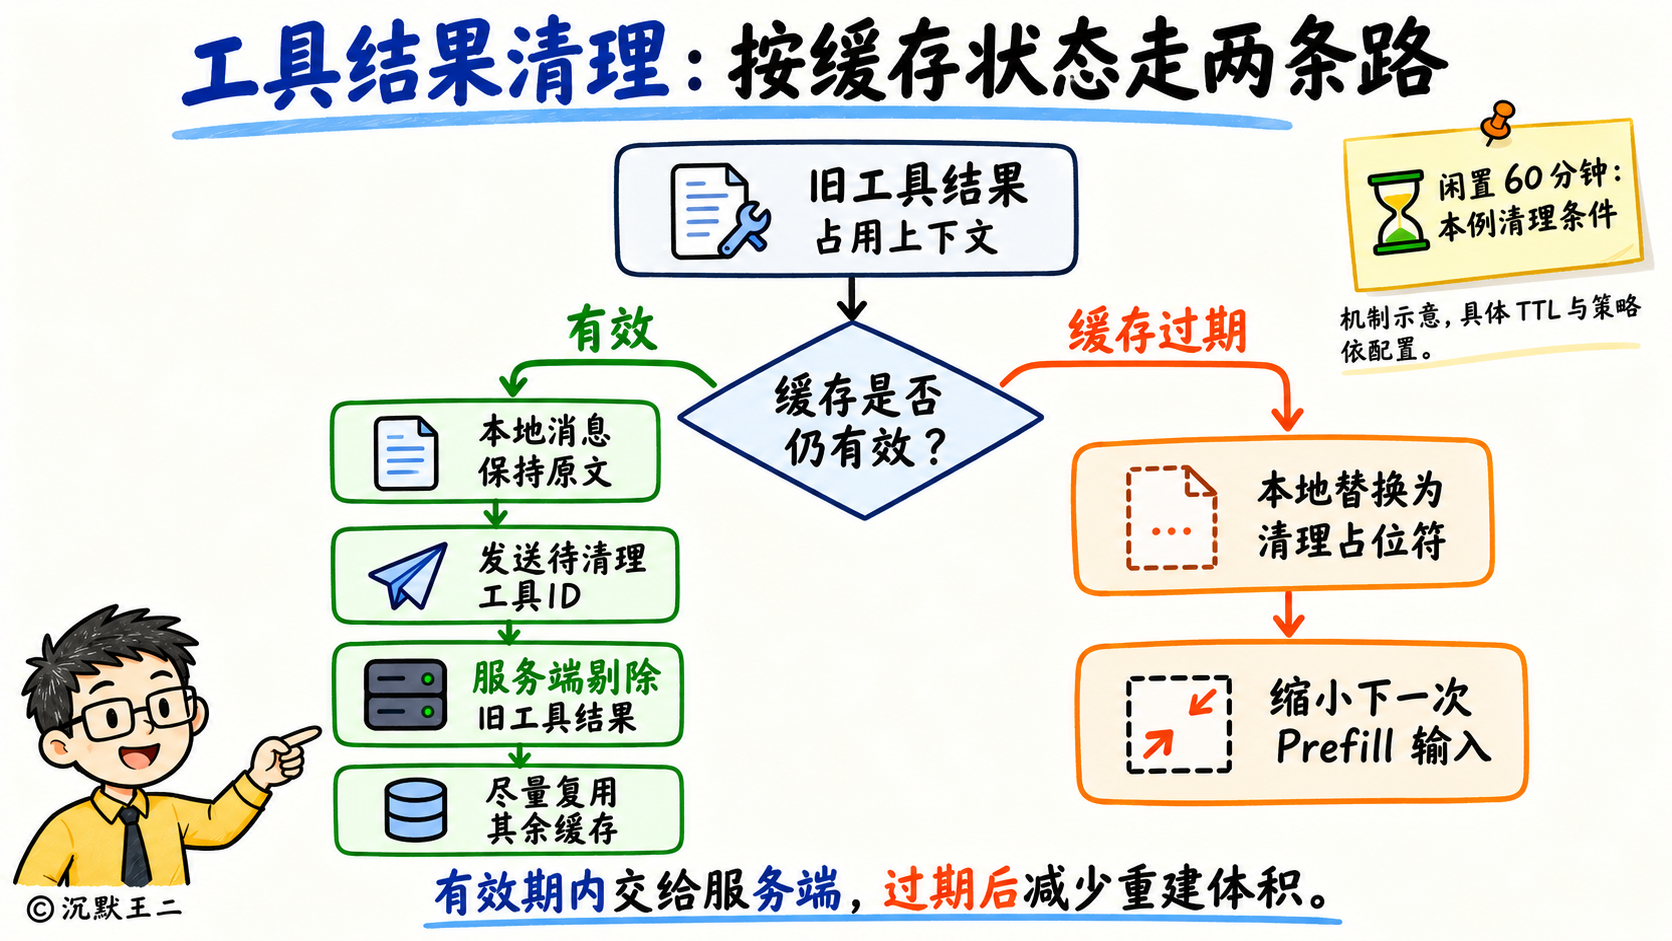
那什么时候在本地改消息呢?等缓存过期之后。服务端的提示词缓存默认 TTL 是 5 分钟,也可以选 1 个小时。Claude Code 会根据上一次请求过去了多久,判断缓存是否失效。如果下一轮本来就要重新跑一遍 Prefill,它就顺手在本地把早期的工具输出换成一行清理提示,只保留最近几次的工具结果,让重建的体积小一些。
恭喜看到这里的你,成功击败 70% 的学习者了。
继续,大模型生成压缩摘要时,怎么命中已有的 KV Cache?
A,换一套新的摘要提示词;B,复用主会话前缀;C,在历史末尾追加摘要指令。喜欢推荐的你会选哪一个?
我的答案是 B + C。写压缩逻辑时,如果你单独写了一套新的系统提示词,比如“你是一个总结助手”,再把几十万字的历史记录塞进去让模型概括。可系统提示词一换,历史记录跟主会话就对不上前缀了,生成摘要这一下就得把几十万字从头重算一遍 Prefill。Claude Code 在生成摘要时会尽量复用主会话的系统提示词、工具列表和历史消息,只在最后追加一条总结指令。
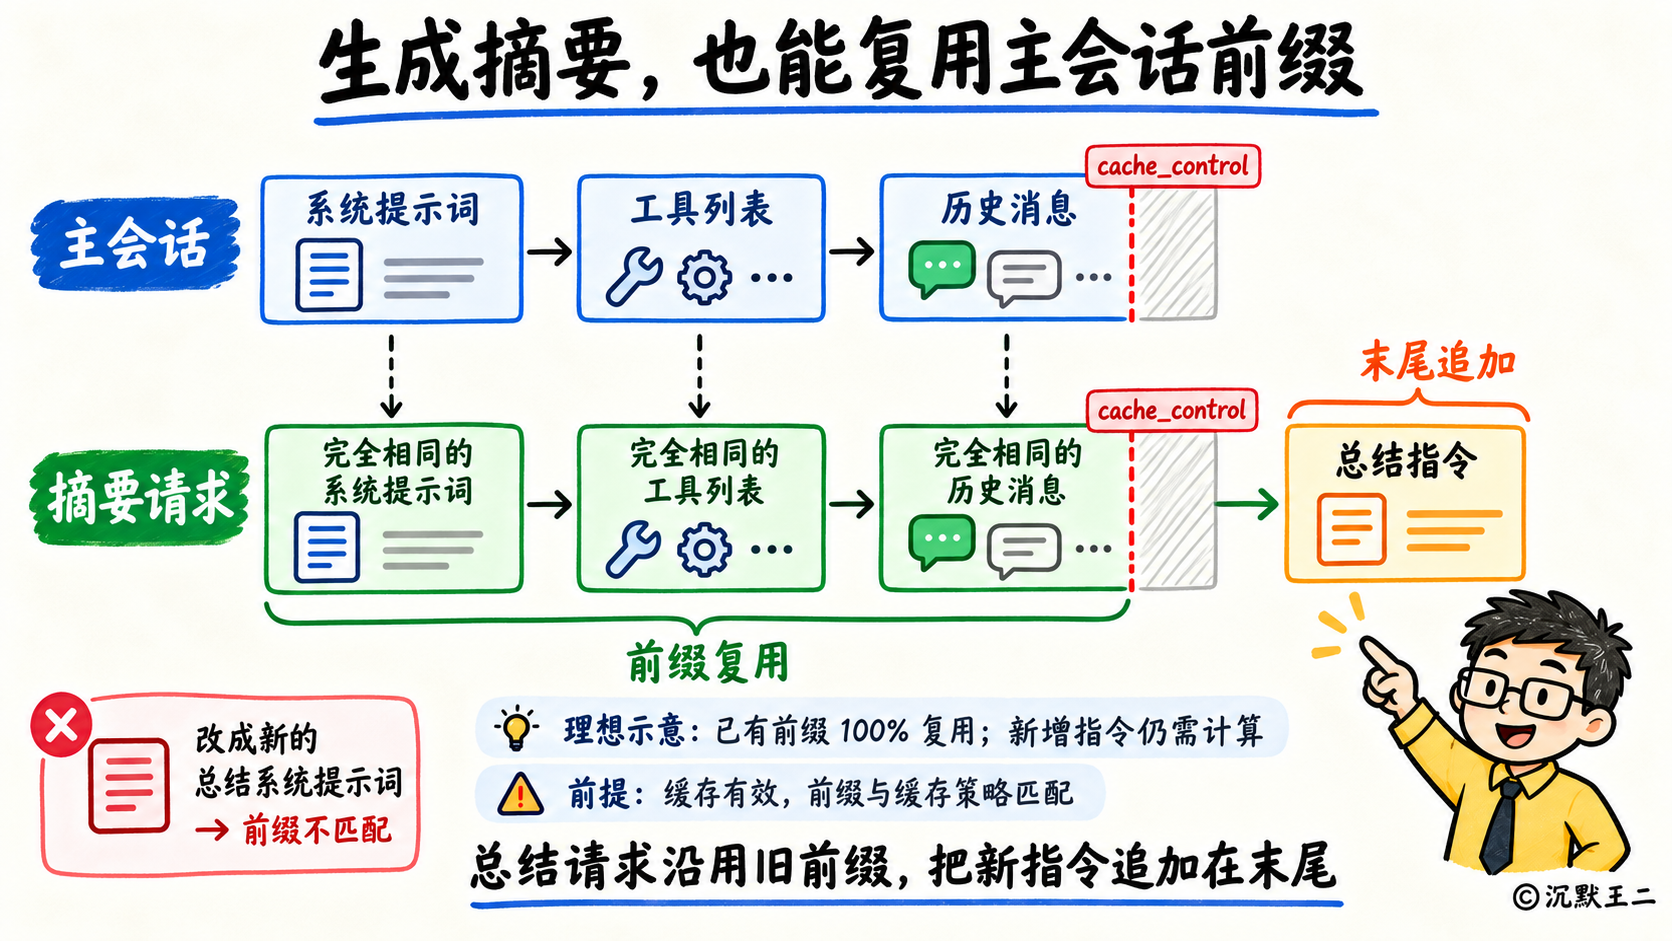
这样在服务端看来,这只是一次普通的后续提问,前面几十万字就可以命中已有的 KV Cache,很快就能输出摘要。如果需要进行上下文压缩,Codex 还会从末尾往前倒序截断超大工具的输出,从而保住前面的缓存前缀。
恭喜看到这里的你,成功击败 90% 的学习者了。
最后再问你,除了全量摘要,Agent 怎么减少上下文压缩的次数?
A,限制单次提问字数;B,对超长工具输出做头尾截断;C,用 Sub-agent 隔离任务。聪明的你会选哪一个?
全量摘要不光要多调用一次大模型,还很容易丢掉代码行号、报错细节这类关键信息。为了少做全量摘要,DeepSeek Harness 会先做一步轻量裁剪。比如跑一次测试吐出了上万字日志,有用的信息往往集中在开头的执行命令和结尾的报错堆栈,中间的打印过程大多没什么价值。所以窗口快满时,它先不调用大模型,只把超长工具输出的中间部分裁掉,保留开头和结尾。如果裁剪完 Token 降回阈值以下,就跳过摘要。被裁剪的那条消息之前的前缀没变,还能继续命中缓存,从裁剪位置往后的部分则需要重新 Prefill。
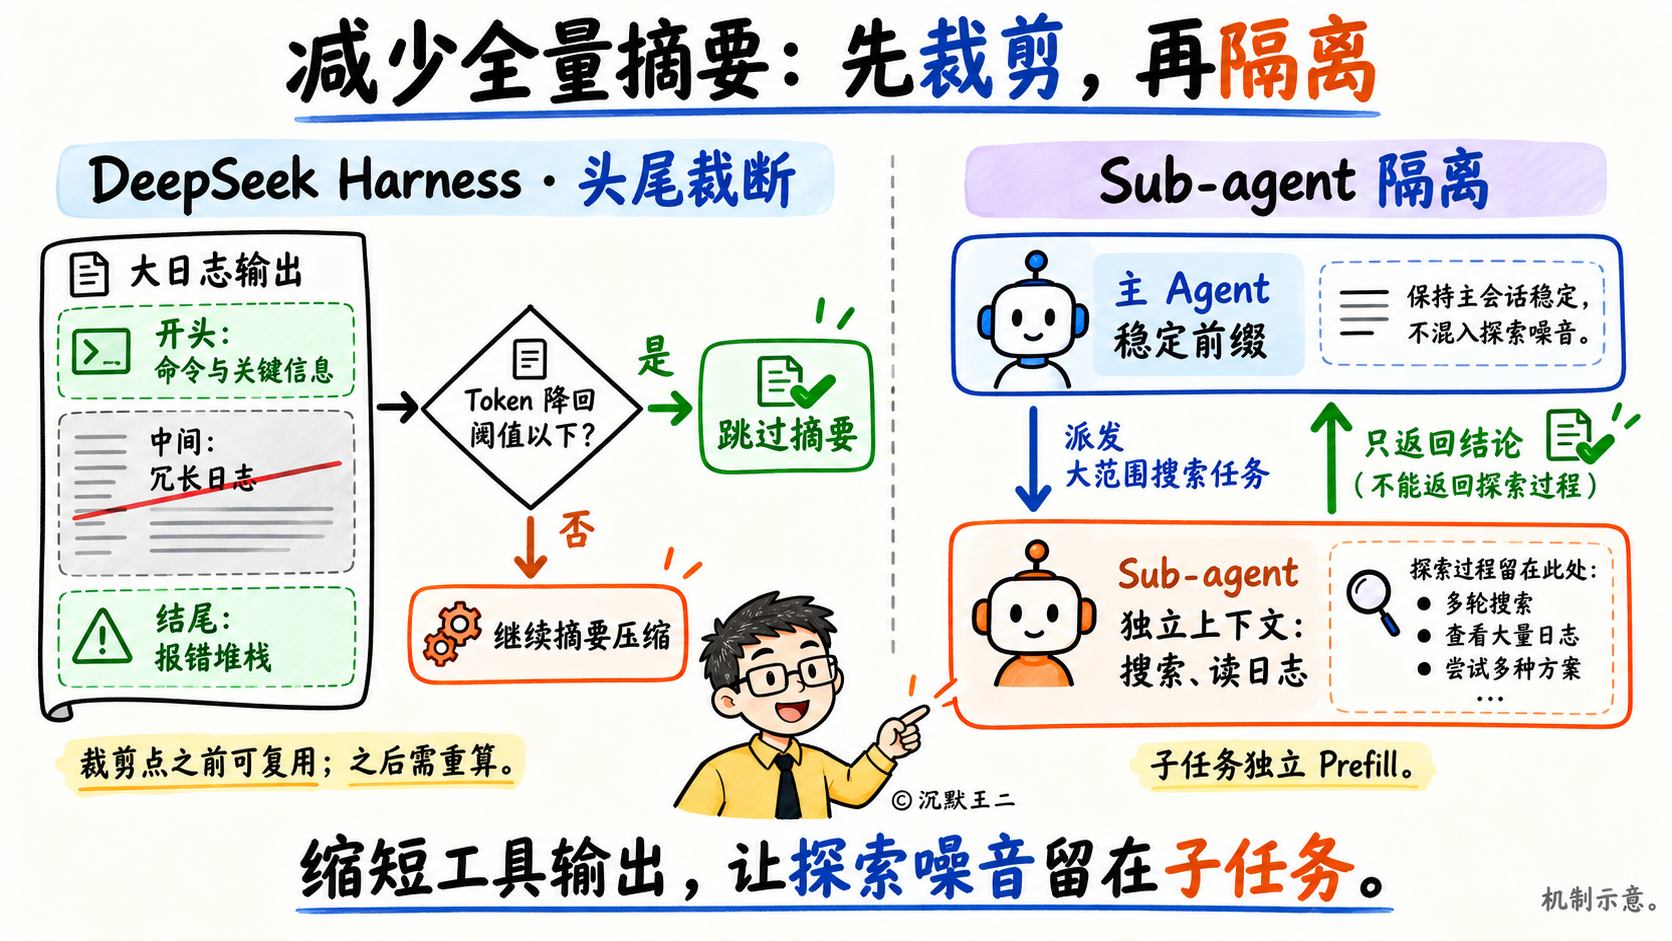
更干脆的办法是隔离。碰到搜代码、读长日志这类任务,Claude Code 可以派生一个上下文独立的 Sub-agent 去跑,跑完只把结论交回给主 Agent。中间的探索过程不进主会话,主会话的上下文就不会因为这些中间输出而膨胀,前缀缓存也少了一次被压缩打断的风险。当然,Sub-agent 自己的上下文要从头 Prefill,相当于拿一点额外开销换主会话的干净上下文。
恭喜你升到王者段位了,成功击败 99% 的学习者。
最后简单总结一下,上下文压缩和 KV Cache 并不是非此即彼。像 Claude Code 靠的是这几招,平时消息只追加,快到阈值才触发压缩,按缓存有没有过期选择怎么清理工具输出,复用主会话前缀来生成摘要,再用 Sub-agent 隔离噪音。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!