它最大的价值在于把 Agent 的 “判断” 和 “执行” 拆开了。以前的传统大模型,比如说 DeepSeek 既要判断该做什么又要去执行,现在可以把“该做什么”这件事交给一个更快更便宜的专用模型来做了。
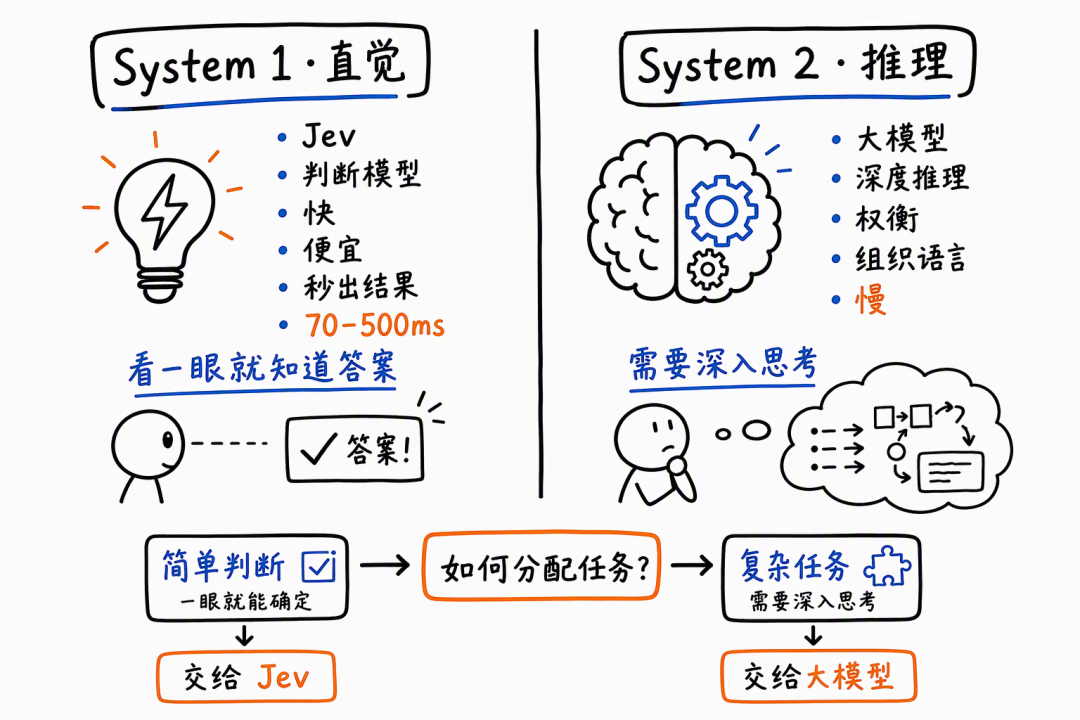
用认知科学的话来说,Jev 就是 System 1,大模型就是 System 2。System 1 是直觉,是第六感,看一眼就知道答案,不需要深入思考。System 2 是理性分析,要推理、要权衡、要组织语言。人类大脑在日常生活中大部分决策都是靠直觉完成的,只有碰到复杂问题才会启动深度思考。Agent 也应该这样,简单的判断交给 Jev 秒出结果,需要推理和生成内容的复杂任务再让大模型慢慢想。
那聪明的你肯定要问,“Jev 虽然好用,但它是闭源的云端 API,况且服务还不稳定,核心业务数据也根本不敢随便往外传,怎么办?”
完全不用担心。
就在 Jev 发布的 48 小时内,开源社区就通过逆向工程复刻出了一整套高质量的开源替代方案。不仅完全免费、权重公开,甚至连你手头的笔记本电脑都能跑起来。
我翻了 5 个项目的开源代码、训练配方以及技术社区的深度拆解,可以自信地、大方地、光明磊落地帮你搞清楚这三件事。
- 开源社区到底用了什么黑科技,把逐字生成的大模型改造成专做判断的“决策模型”?
- Kev、Nimble、Laya 和 Open-Jev 这几个复刻标杆,各自都有哪些看家本领?
- 在我们的实际业务里,到底该怎么用 Jev?
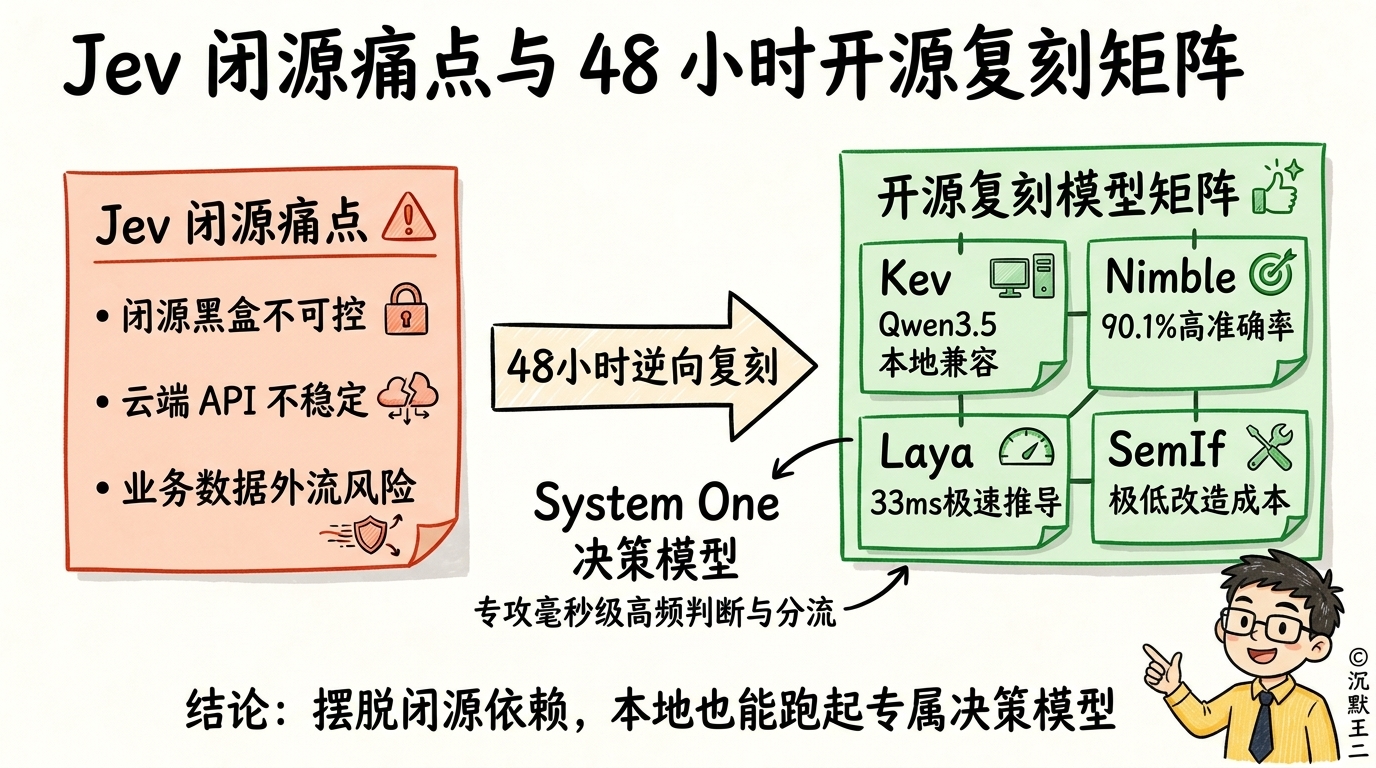
哈喽大家好,我是二哥呀。今天用 3 分钟,带你盘点开源社区最火的 Jev 复刻项目,教你摆脱闭源依赖,在本地跑起属于自己的决策模型。
先说第一件事,开源社区是怎么复刻 Jev 的。
很多人以为复刻 Jev 需要几百张显卡去重新预训练,其实完全不用。
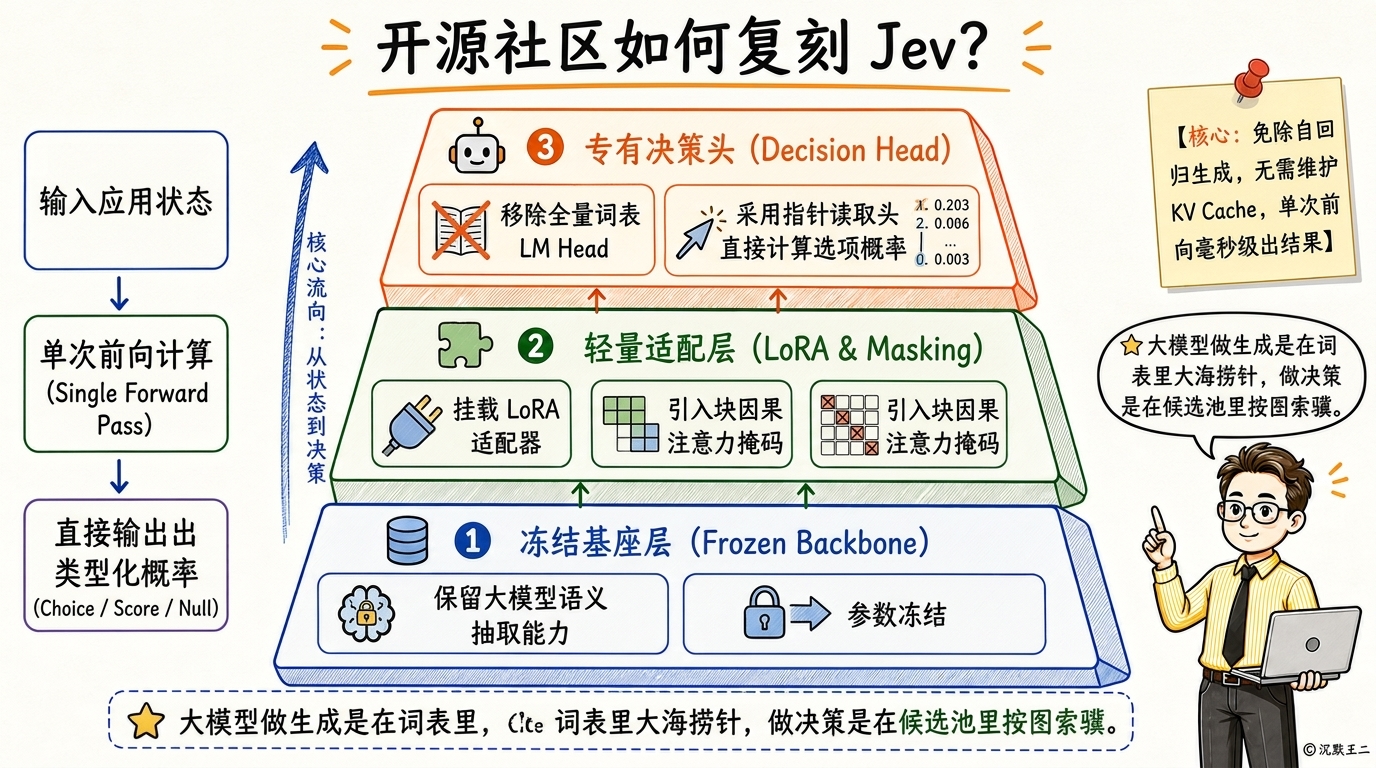
大模型做文本生成之所以慢,是因为自回归机制必须逐字循环解码,不仅计算冗余,还要维护昂贵的 KV Cache。
而决策任务无论是分类、打分还是意图路由,候选结果通常只有几个固定选项。
开源社区的解法非常简单,直接扔掉映射词表的全量语言模型头,换成一个专用的轻量决策头。在输入序列末尾插入决策标记,利用指针机制直接计算上下文与候选选项之间的相似度,经过一次归一化,输出准确的概率分布。
为了保留基础模型的深层语义理解,采用冻结底层参数、仅挂载 LoRA 适配器的方式进行微调。
再加上块因果掩码技术,同一段上下文可以同时面向多个互不干扰的问题分支,单次前向计算就能并发完成多项决策了。
那聪明的你肯定想到了:这些开源复刻项目,各自都有什么看家本领?
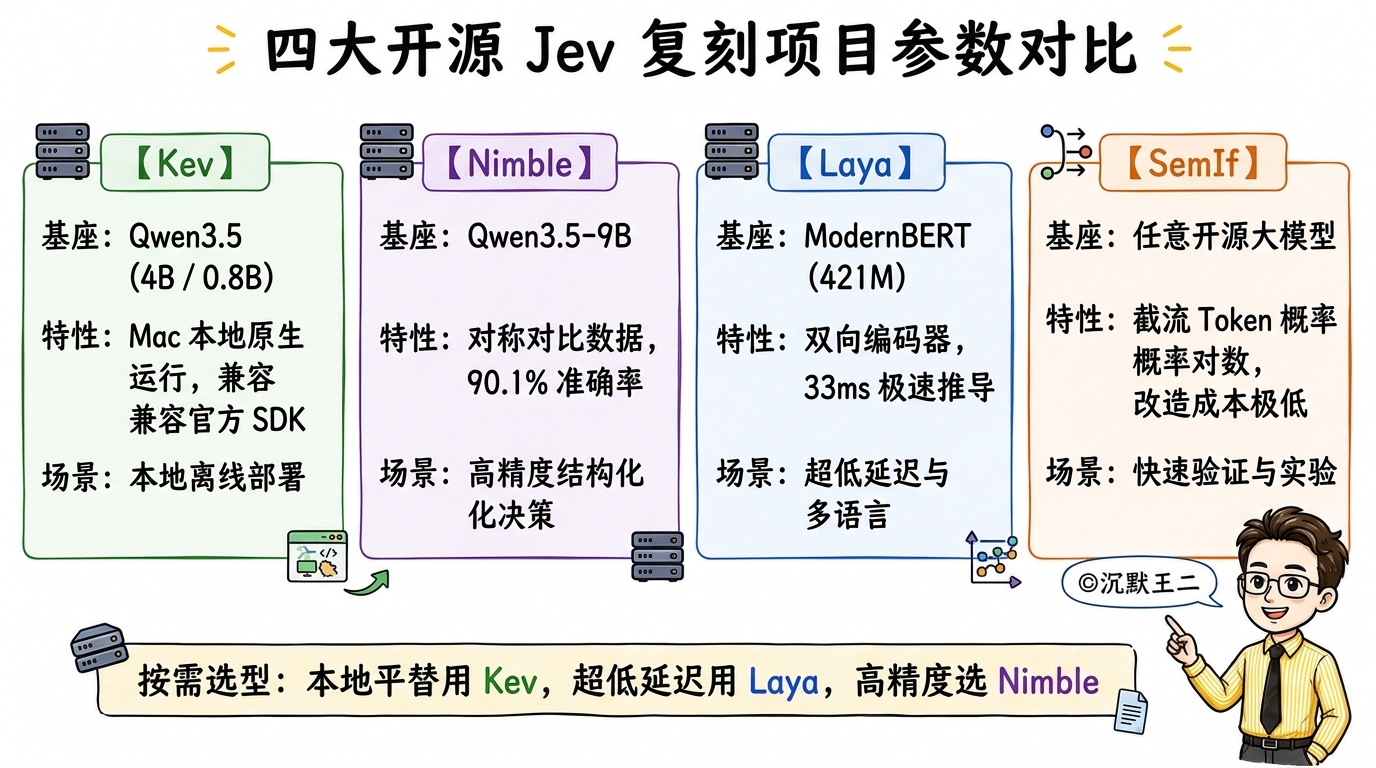
第一个是 Jared Palmer 打造的 Kev。
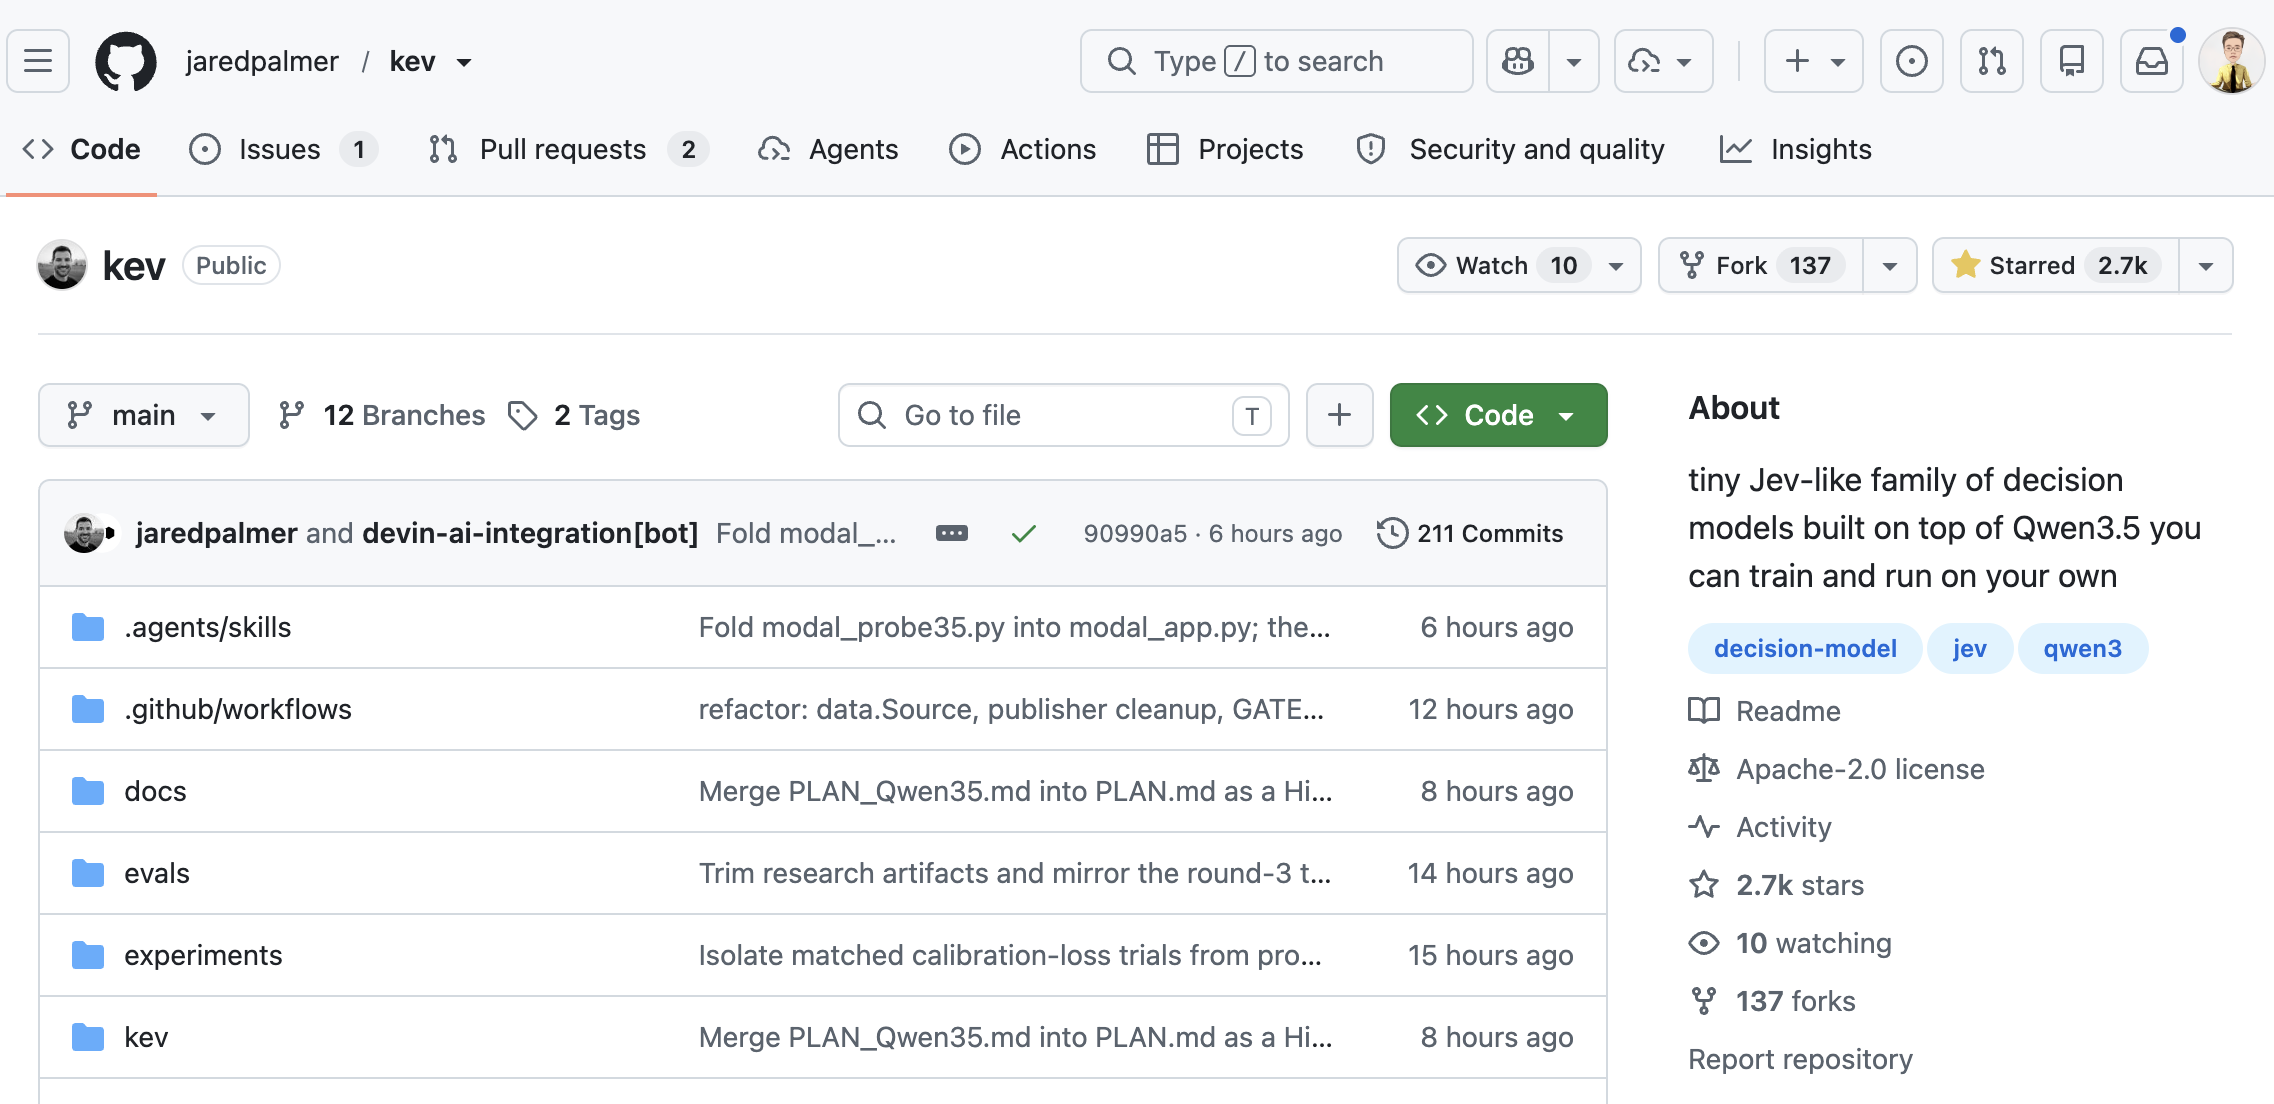
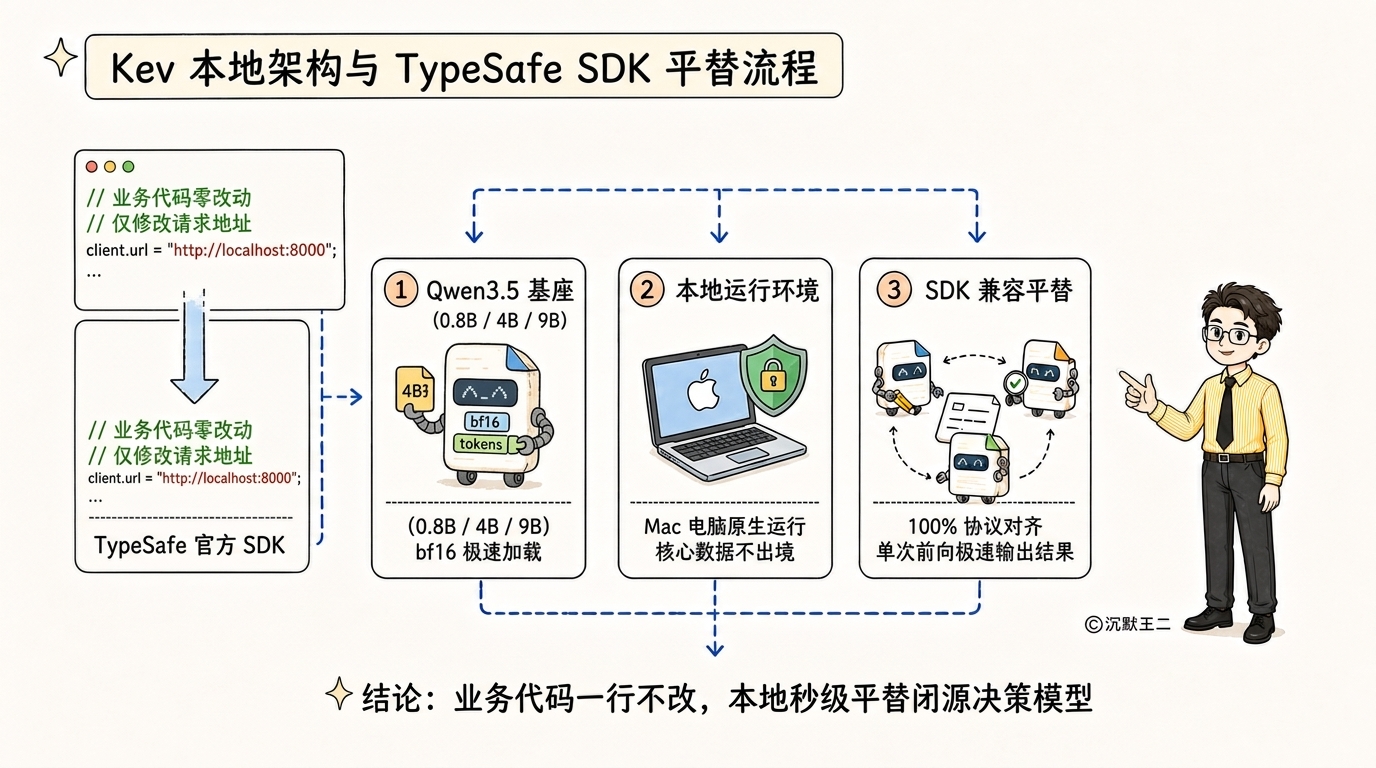
已升级到 Qwen3.5 基座,推出 0.8B、4B 和 9B 三个规格,官方推荐默认使用 4B 版本。
在 Mac 电脑开启 bf16 精度,Kev 就能直接在本地运行。更绝的是它完全兼容 TypeSafe 的官方 SDK,业务代码一行不用改,把请求地址改成你的本地端口即可平替,是本地运行的首选。
第二个是 Bespoke Labs 开源的 Nimble。
基于 Qwen3.5-9B,仅对答案 Token 挂载 LoRA 微调,权重、配方和数据全部公开。
Nimble 的杀手锏是“对比数据构建”策略。Bespoke Labs 构造了对称的最小对比数据对,两段文本几乎一致,仅在一个关键事实上做微小反转。测试集上准确率达 90.1%,几乎追平了 Jev 官方公布的 93.2%。
第三个是 NandhaKishorM 推出的 Laya。
Laya 包含了 421M 参数的 ModernBERT 英文模型和支持百种语言的 mmBERT 多语言模型。双向编码器具备全局视野,彻底甩掉自回归生成的包袱。在校准算法加持下,Laya 单次推导仅需 33 毫秒,内置路由器还能在亚毫秒内自动识别语种并分发,真正做到极速多语言决策。
第四个是 TheoLeeCJ 主导的 Open-Jev,目前仓库已演进为 SemIf。
它直接在大模型即将输出下一个 Token 时截流状态,读取候选选项对应 Token 的概率对数,改造成本极低。
此外,还有基于 SGLang 前缀缓存做高并发 API 的 openjev-sglang,以及仅 40KB 的极简 Embedding 项目 Jevlike。
那聪明的你肯定又要问了:在我们自己的业务里,到底该怎么应用 Jev?
最核心的用法,就是把它当作 Agent 处理过程中的“裁判”,专门接管那类高频、轻量且要求毫秒级响应的结构化决策。
第一个入口是意图路由。用户请求刚进来,直接用 Jev 判定用户是咨询、退款还是技术答疑,在几十毫秒内迅速分流给对应的 Sub-agent 或业务模块。
第二个是工具调用前后的安全护栏。Agent 执行关键命令前,调用 Jev 给出一个布尔值,快速检查当前指令是否越权、参数是否异常;工具执行完毕后,再用它秒级判定返回结果是否包含敏感信息或者是否需要触发重试。
第三个是上下文压缩与历史剪枝。在多轮交互中,工具返回往往会撑爆上下文。用 Jev 对历史消息的相关性进行区间打分,剔除低分噪音,只把关键信息喂给大模型。
最后简单总结下。
复杂推理交给生成式大模型,高频判断交给 Jev,这已经是被验证可行的架构分工。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!