它不生成任何文本,只做判断。你给它一堆信息和几个选项,它告诉你选哪个,概率多大。
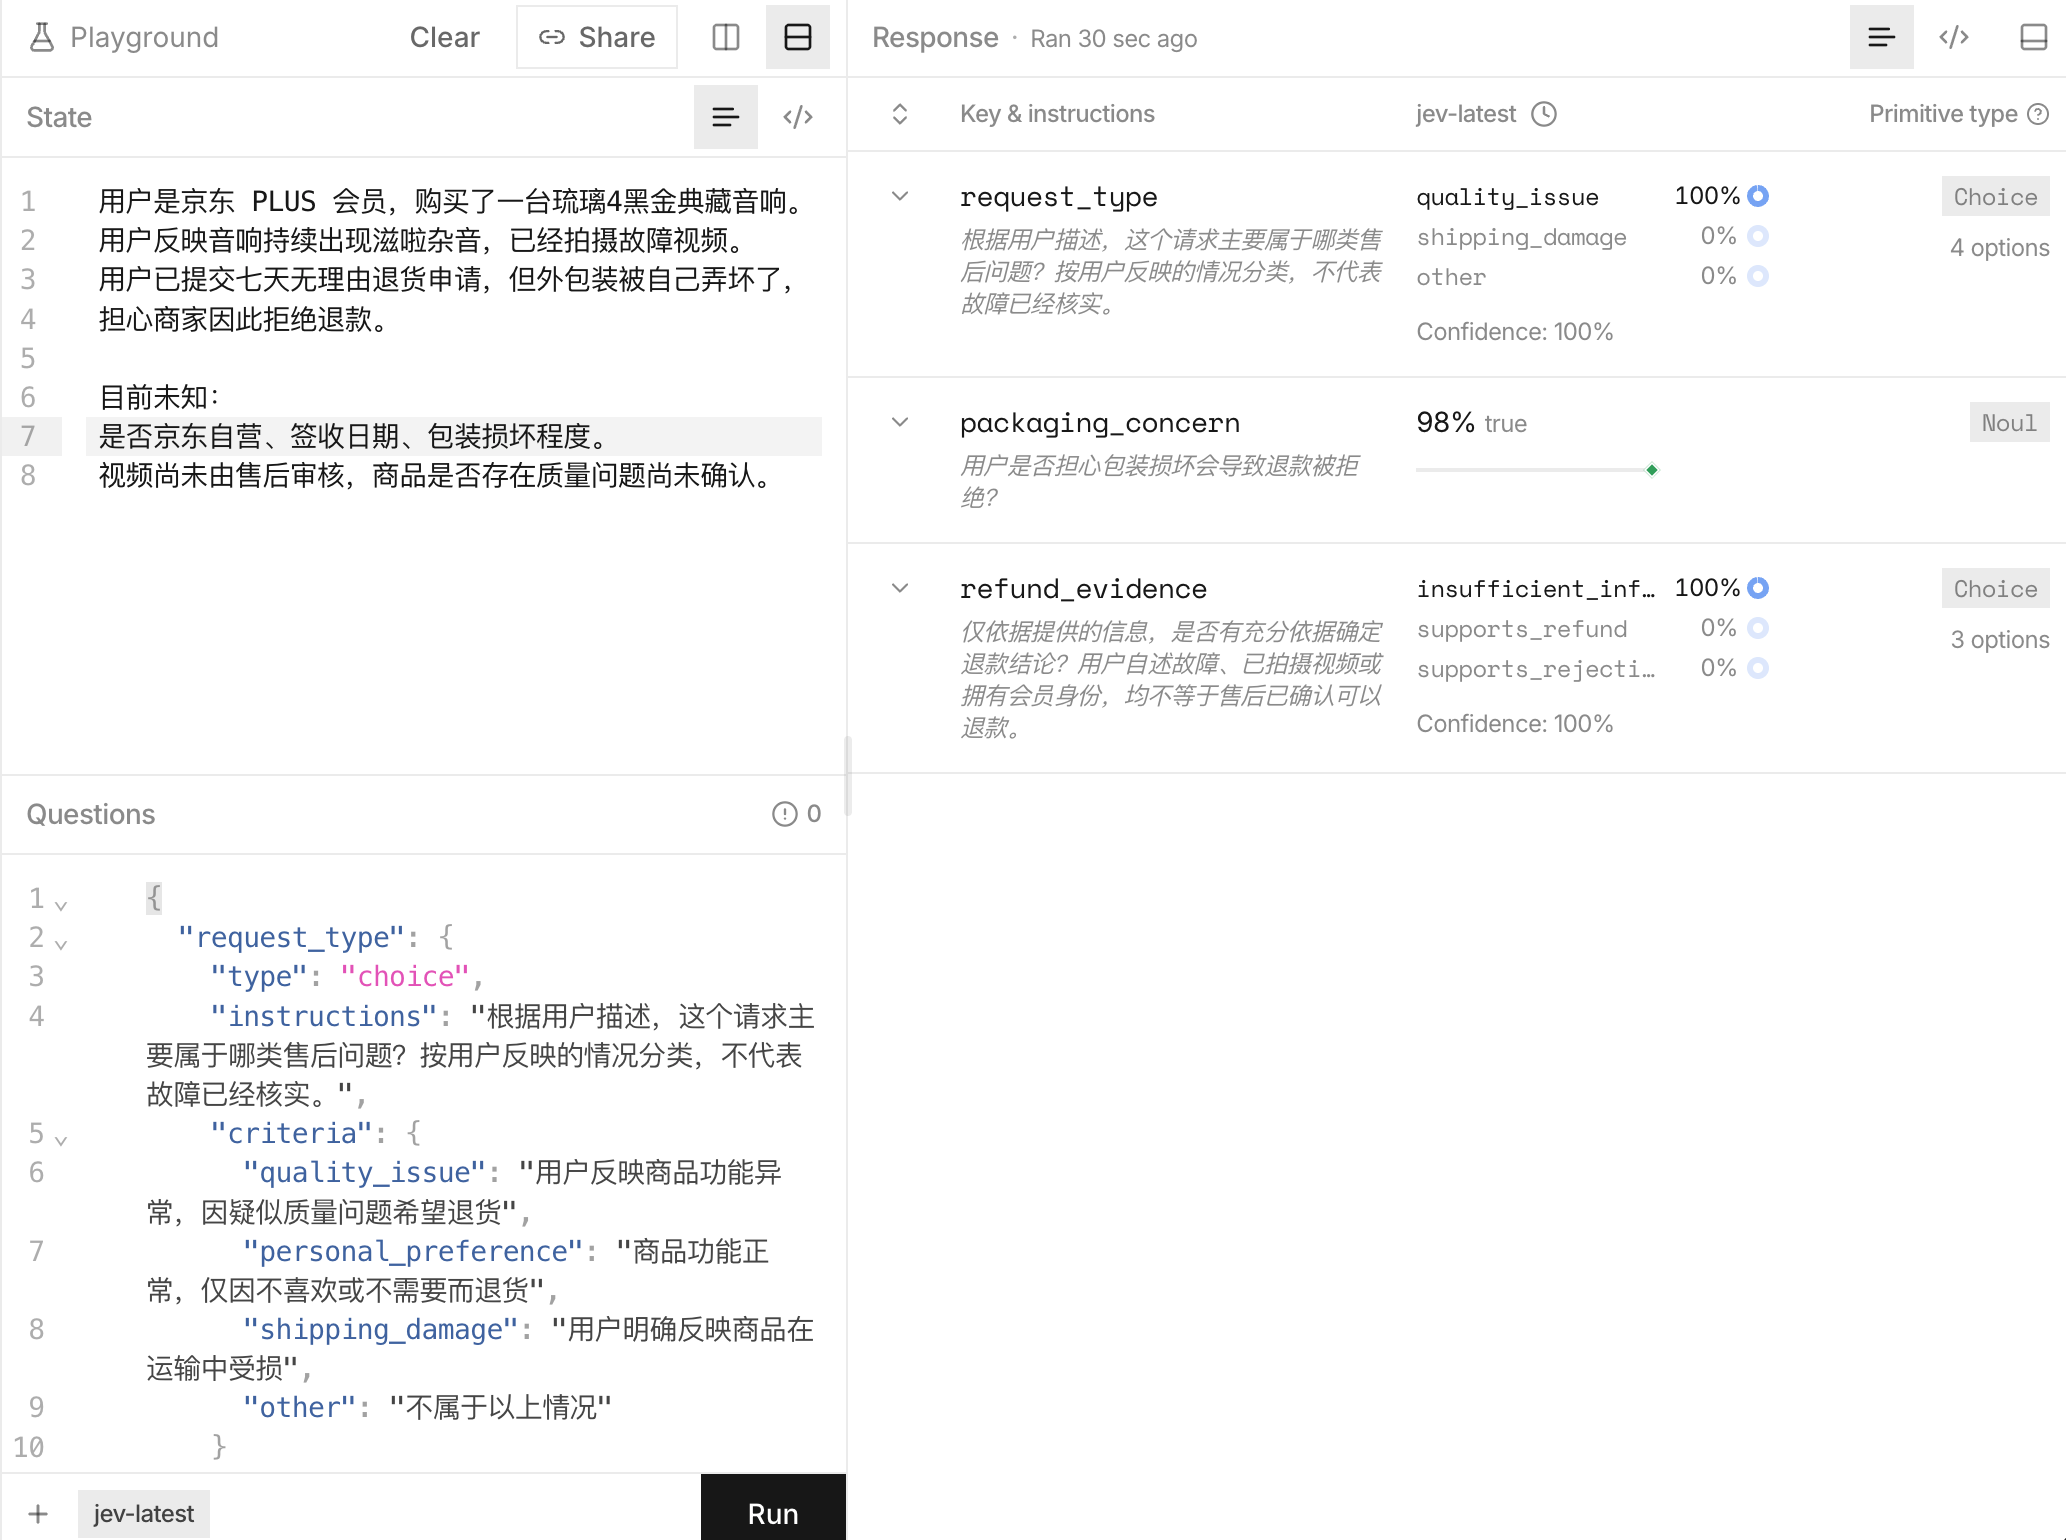
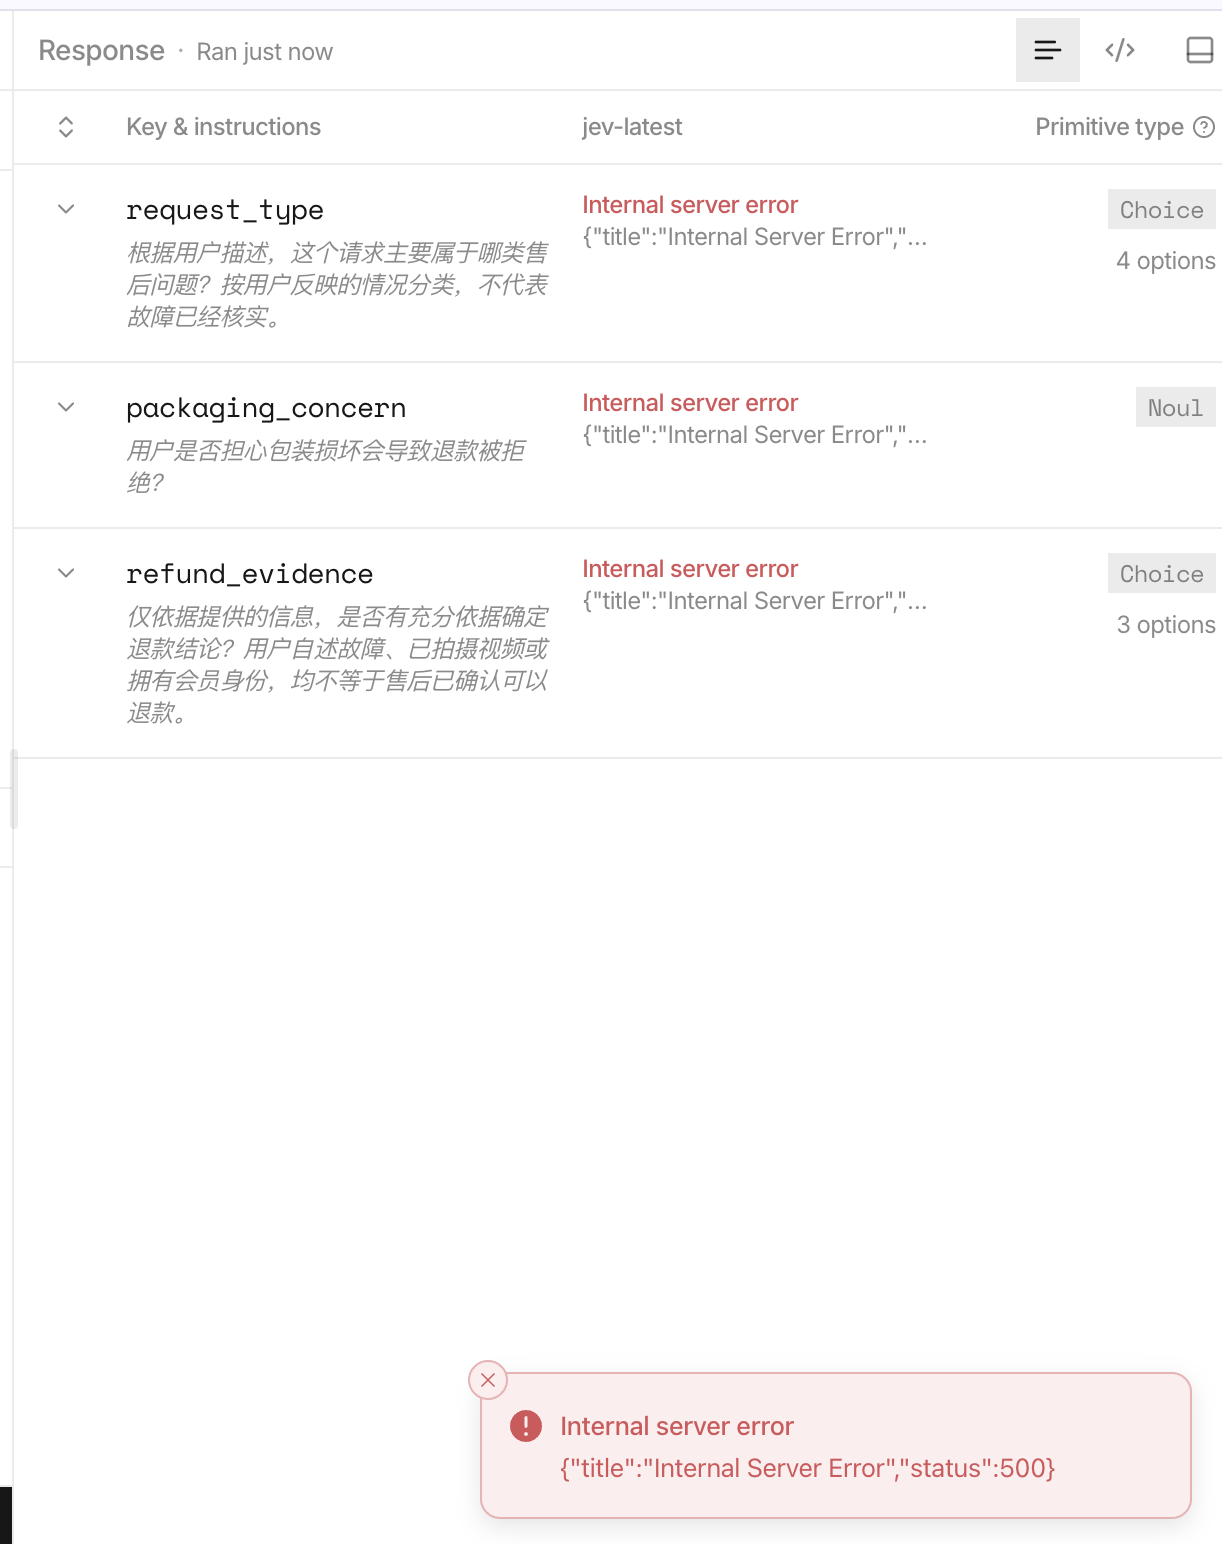
我刚去试了一把,但很快整个网站就挂了,还没搞清楚具体原因。后面再想办法吧。
这个模型火到什么程度呢?36 小时,14 万开发者涌入 waitlist。LangChain、Vercel、Cloudflare 三天内完成集成。48 小时内出现了 6 个开源复刻。
为什么一个不会生成文本的模型,让这么多人抢着排队?
我翻了 TypeSafe AI 的官方文档、DataCamp 的技术分析、LangChain 的集成博客,可以自信地、大方地、光明磊落地帮你搞清楚这三件事。
- Jev 到底是什么,为什么叫 System One 模型?
- 它和传统 LLM、传统分类模型有什么本质区别?
- 做 Agent 开发的你,该不该用?
哈喽大家好,我是二哥呀。今天用 3 分钟,给你讲清楚最近爆火的 Jev 到底是什么。
先说第一件事,Jev 是什么。
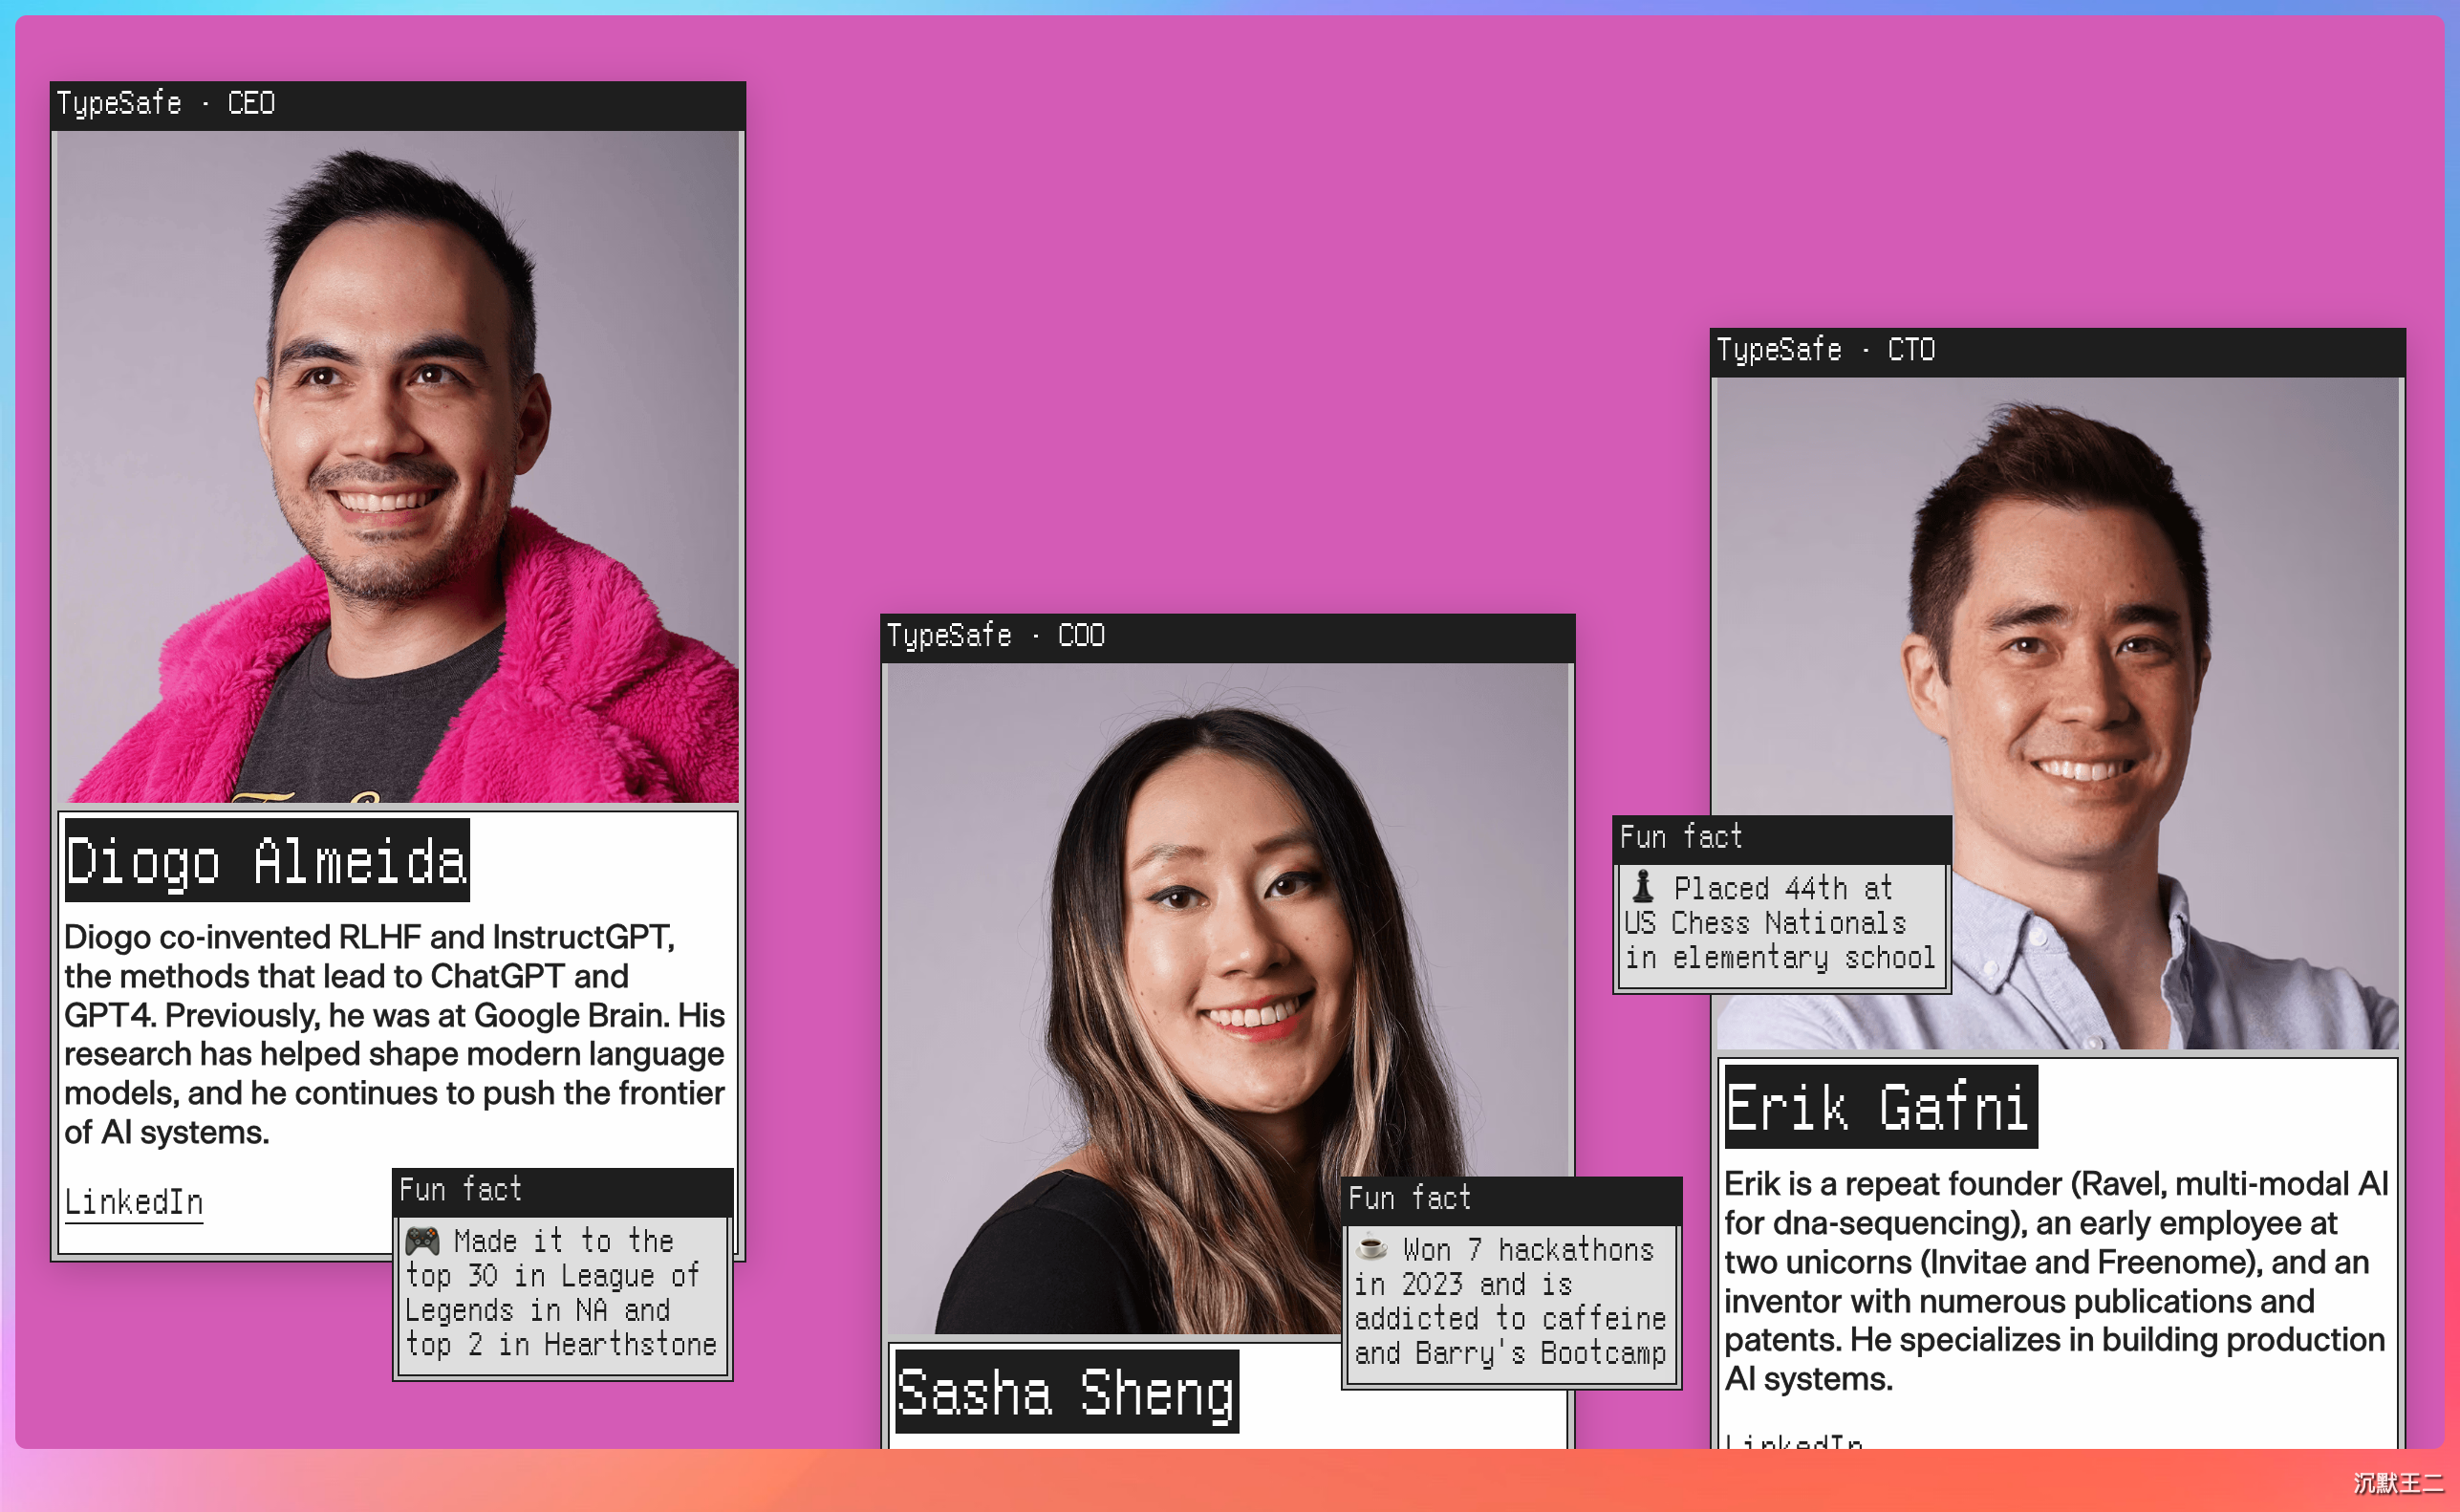
Jev 是 TypeSafe AI 在 9 月 15 日发布的模型。创始人 Diogo Almeida 是前 OpenAI 研究员,做过 InstructGPT 和早期的 RLHF,就是 ChatGPT 背后的核心训练方法。他在旧金山秘密做了两年,同时宣布了 4000 万美元种子轮融资(DCVC 领投)和 Jev 模型。
Jev 的官方定位叫 System One 模型。System One 是心理学家卡尼曼提出的概念,指人类大脑那套快速、直觉式的判断系统,不需要深度思考,瞬间给出答案。
Jev 做的就是这件事。
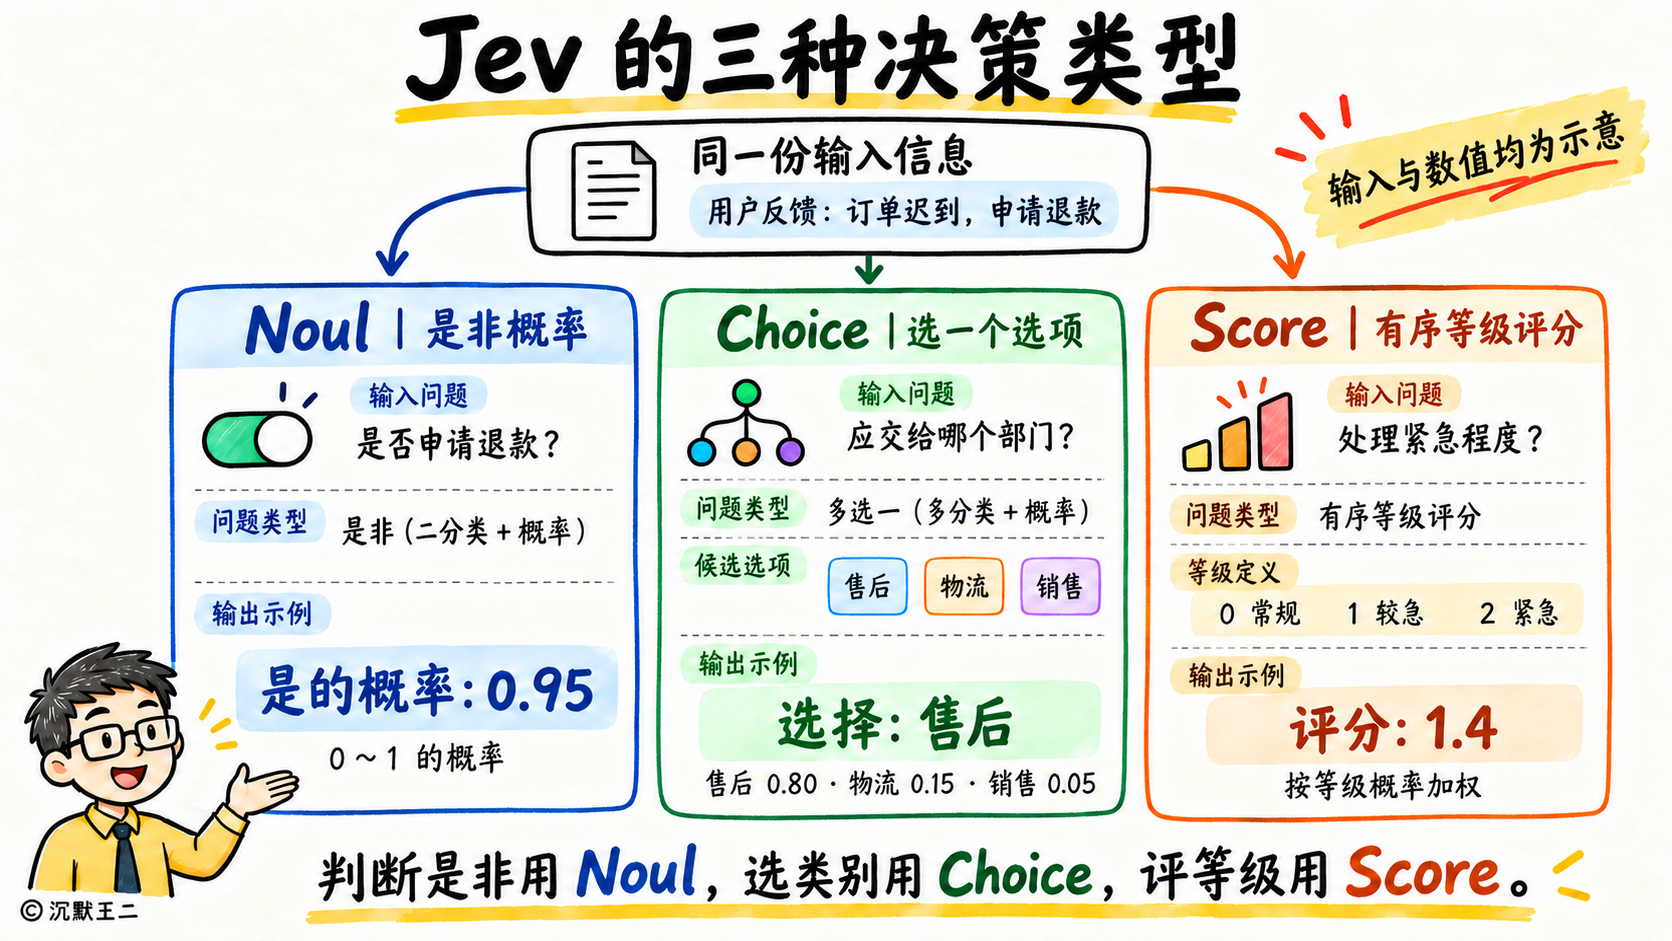
你给它一段非结构化的应用状态,比如一个用户的退款请求,再给它一个预定义的结构化问题,比如“退款风险等级,低、中、高”。Jev 通过一次前向计算,直接在三个选项上分配概率,告诉你“低风险 85%,中风险 12%,高风险 3%”。
它支持三种决策类型。Noul,给一个是或否的概率。Choice,从预定义的选项里选一个。Score,打一个分数。名字取自经济学家 William Stanley Jevons。
用一句话来总结就是,DeepSeek 这类模型是个作家,能写七十万字的小说。Jev 这类模型是个裁判,负责吹哨,发红宝石卡和黄宝石卡。
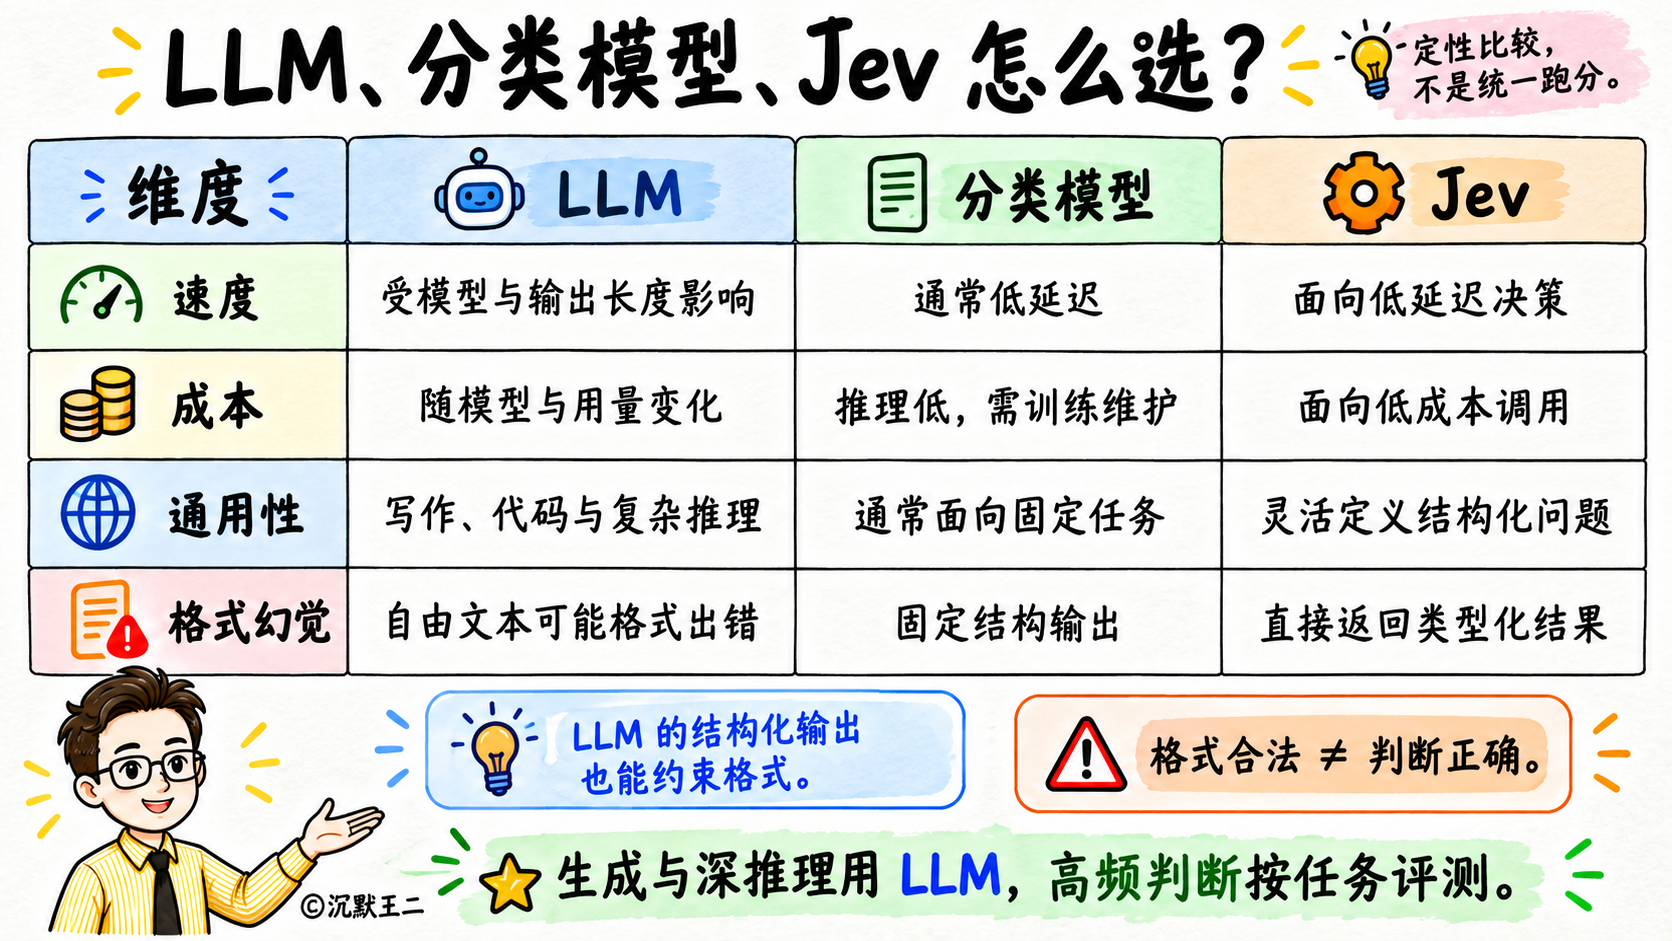
那聪明的你肯定想到了,传统 LLM 也能做判断,传统分类模型也能做判断,Jev 凭什么这么火?
先看传统 LLM 怎么做判断。你让 DeepSeek 判断一条评论是正面还是负面,它会逐 token 生成一段文字,“这条评论的情感倾向是正面的”,然后你用正则表达式从这段文字里提取结果。
问题在哪?
慢,还有格式幻觉。模型有时候会生成你解析不了的格式,比如多了一个换行符、少了一个引号,你的代码就挂了。
再看传统的分类模型。快,不会有格式问题。但标签空间是训练时固定死的。你训练了一个“正面/负面”的分类器,现在想加一个“居中”的选项,对不起,需要重新训练。
Jev 介于两者之间。开发者用 JSON Schema 定义输出结构,Jev 的并行采样器(Parallel Sampler)在一次前向计算中同时产出所有判断,不走逐 token 解码。从机制上消除了格式幻觉,因为它根本不生成文本。
训练方法也不一样。Jev 用的是 RLCD(Reinforcement Learning for Calibrated Decisions),专门优化判断准确性和置信度校准。
聪明的你肯定要问,什么是校准?
模型报 90% 的把握时,实际正确率可能确实是 90%。你的代码可以根据这个概率自主决定,是相信 Jev 的判断,还是交给人工复核。
从 TypeSafe AI 官方给出的性能数据来看,比同类 LLM 快 40 到 200 倍,便宜 40 到 400 倍。输入价格 0.042 刀每百万 token,输出免费,延迟 70 到 500 毫秒。
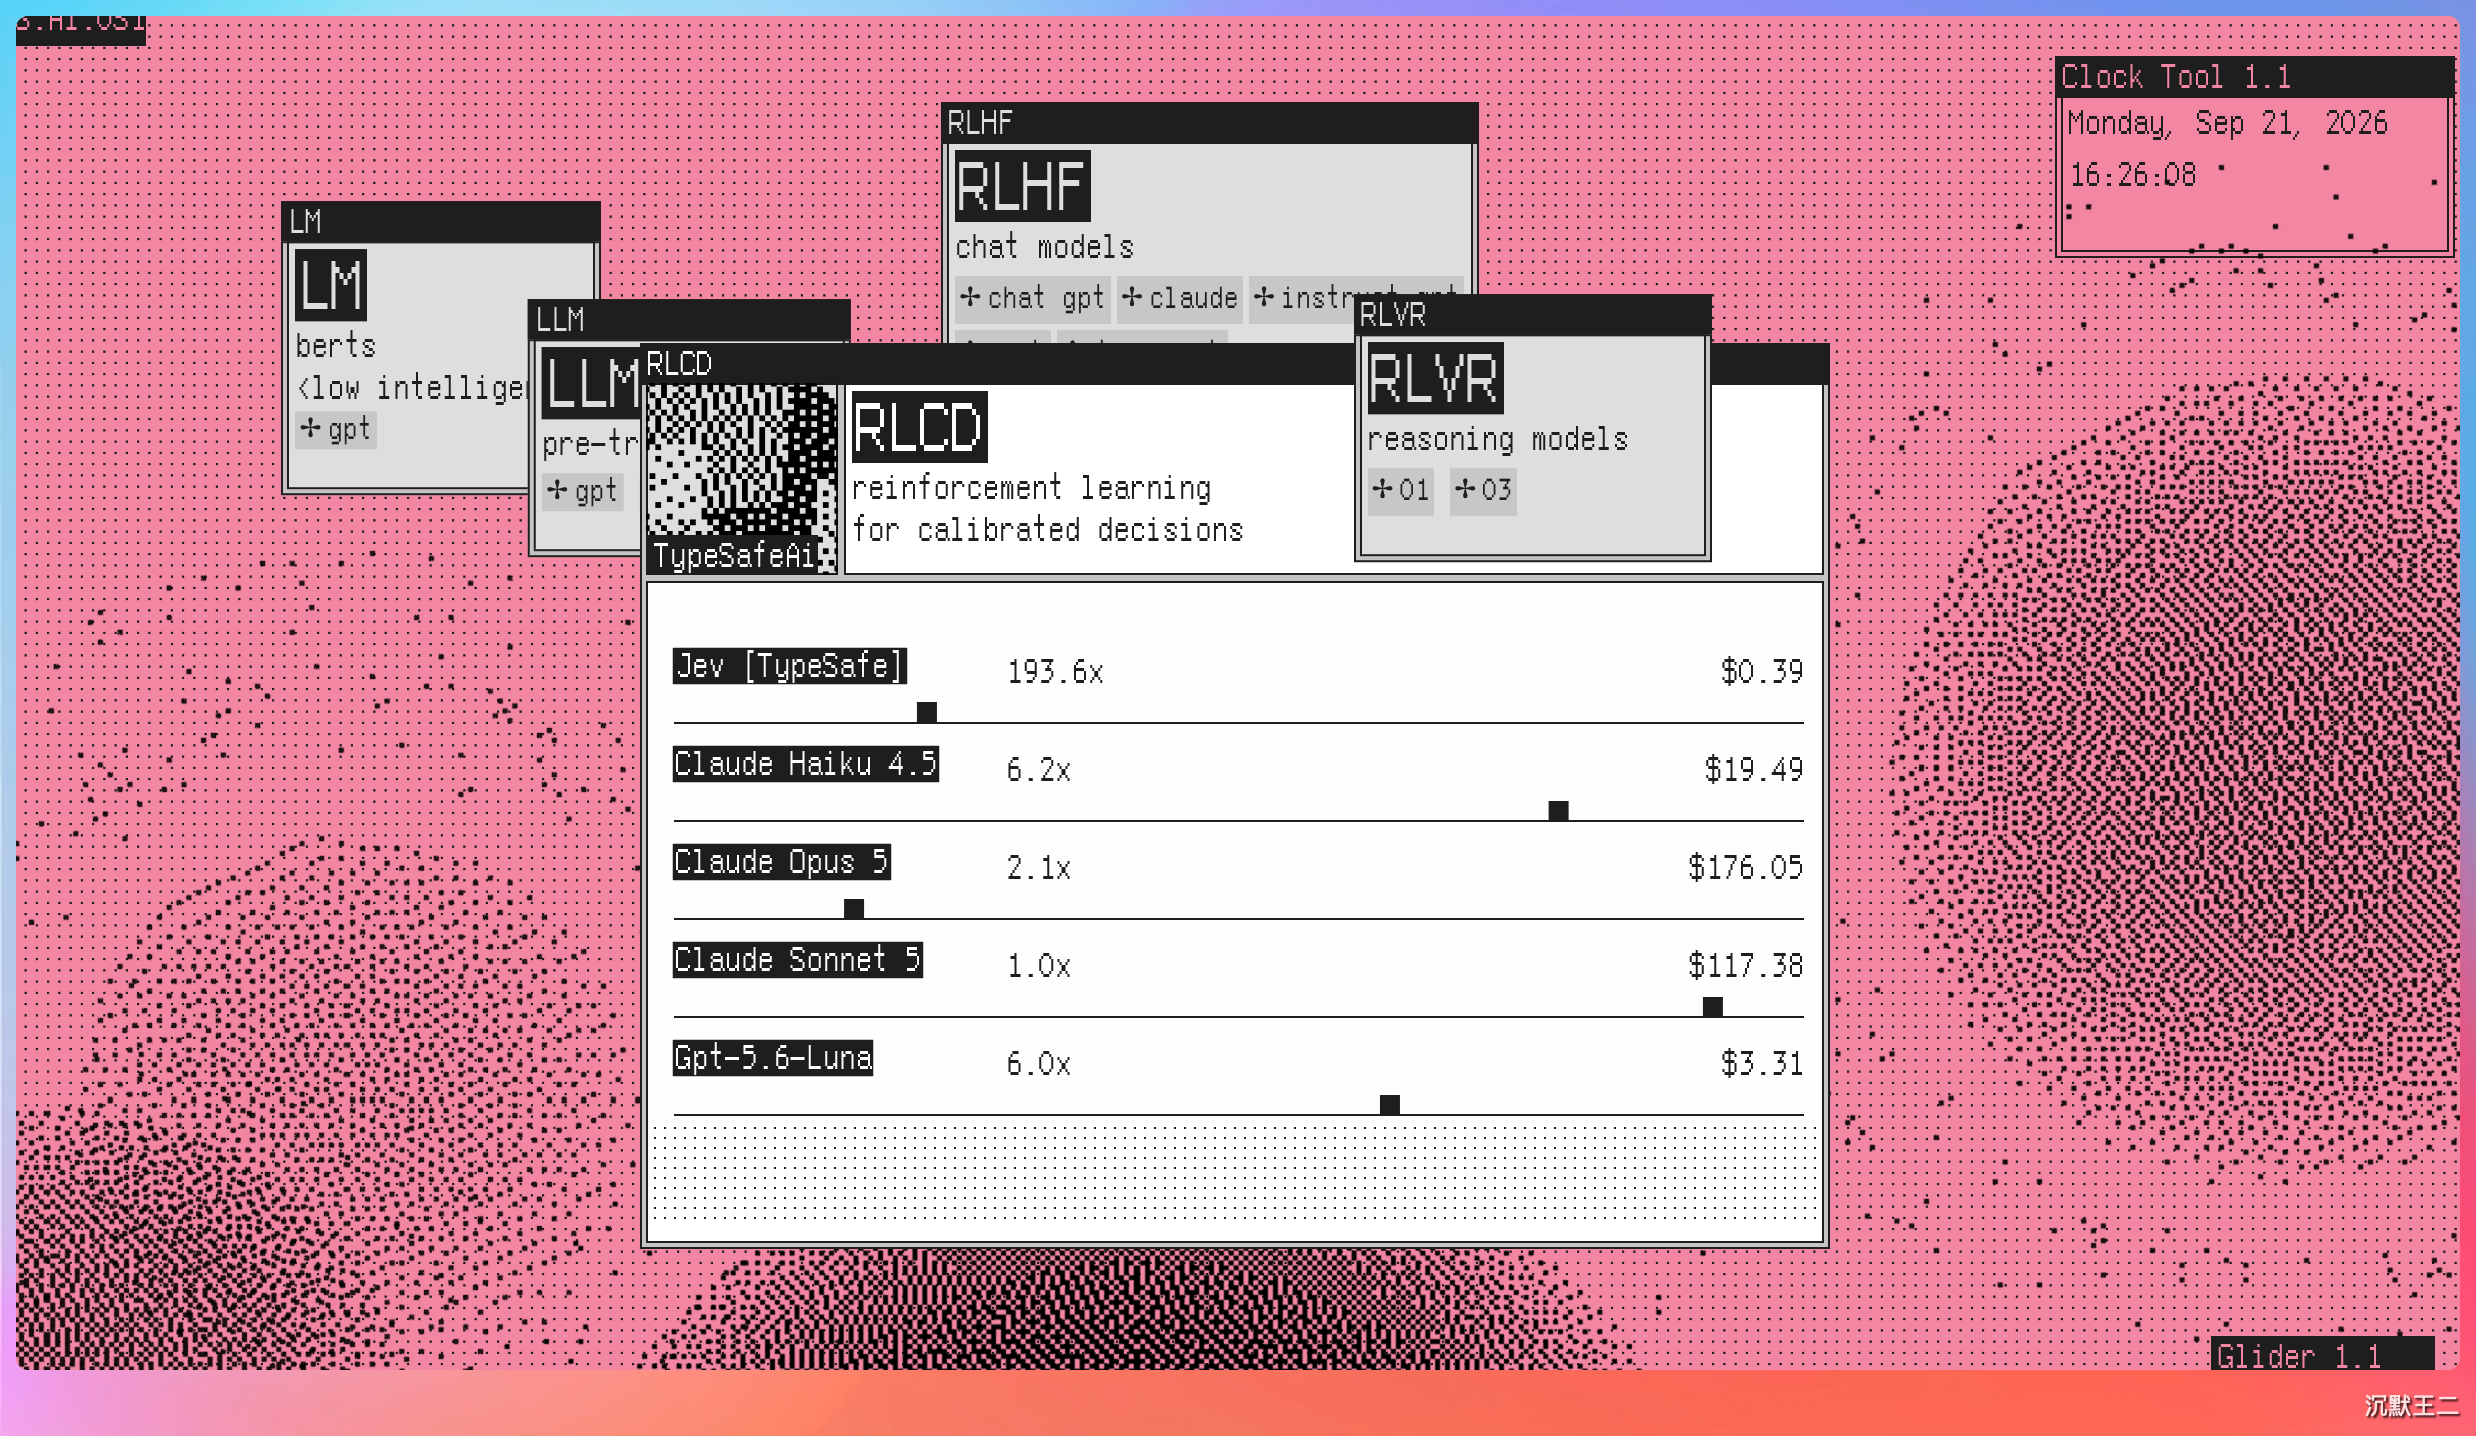
LLM 是全能选手但出手慢,分类模型快但换个场景就报废,Jev 在两者之间找到了一个平衡,通用,但只做判断。
那聪明的你肯定又要问了,我做 Agent 开发,到底该不该用 Jev?
想想 Agent 的工作流。一个 Agent 在执行任务的过程中,要做大量高频小决策。比如说这条用户消息该分给哪个 Sub-agent?这段内容需不需要审核?风控初筛是通过还是拦截?当前步骤失败了,是重试、上报还是直接停下来?
这些决策每一个都很小,不需要停下来思考很久,只需要一个快速的判断。但这些问题出现的频率又很高,一个 Agent 一分钟可能要做几十个这样的判断。用大语言模型来做这些判断,就像请一个伟大的作家(比如说我)来当交通信号灯,能干,但杀鸡焉用牛刀?
Judge,正是 Jev 的设计目标。
生态方面,发布三天内 LangChain、Vercel、Cloudflare、Pydantic AI、LiteLLM 都完成了集成。48 小时内还出现了 6 个开源替代品。其中 Jared Palmer 的 Kev 基于 Qwen2.5-0.5B,在 MacBook M5 上 1 小时 45 分钟就能训练完成。Bespoke Labs 的 Nimble 基于 Qwen3.5-9B,准确率 90.12%,接近 Jev 官方的 93.21%。
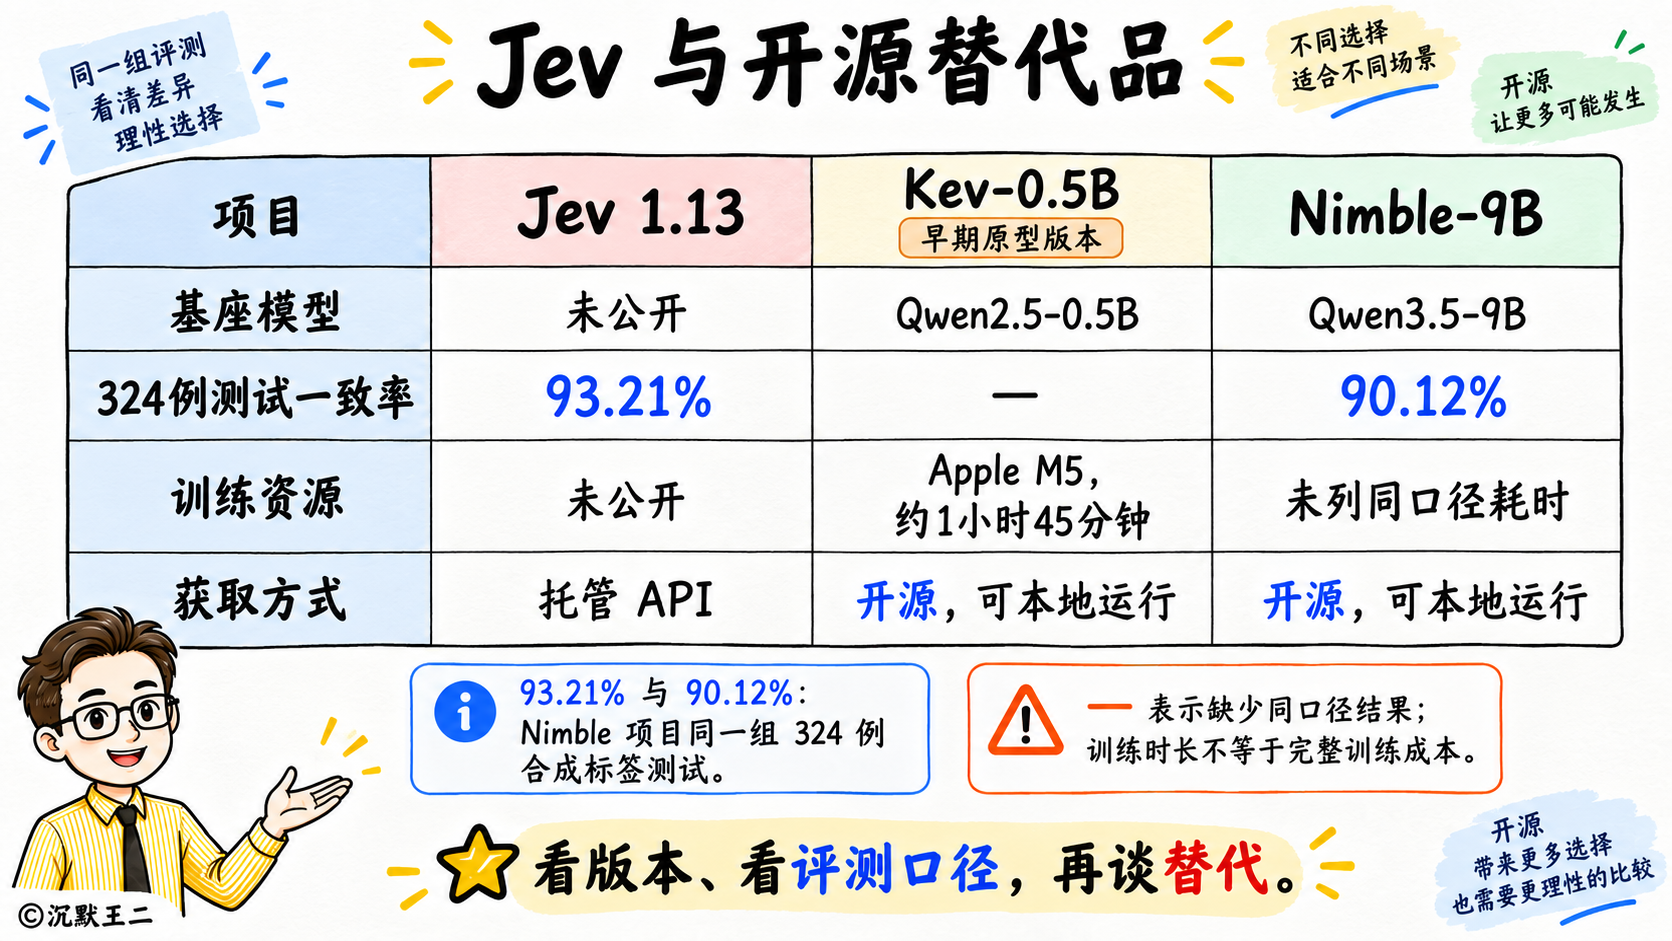
AI 圈的一位大佬曾说过这样一句话:
generating language may be the wrong interface between a model and the software that has to act on it
翻译过来就是,模型生成自然语言,然后软件再去解析这段文字提取结果,可能本质上就是一种错误。Jev 可能才是真正的答案。当然了,我还是持这样的一个观点,Jev 取代不了 DeepSeek 这类大模型,但做意图识别是一顶一的好用。
最后简单总结下。
复杂推理交给大语言模型,高频结构化决策交给 Jev,这是 Agent 架构中越来越清晰的分工。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!