
那你一定好奇过,我们天天挂在嘴边的 LLM,也就是大语言模型,到底是什么?它回答问题时,是像搜索引擎那样去数据库里翻现成的答案,还是像人脑一样在思考?
LLM 既不是数据库,也不是搜索引擎,而是一个基于 Transformer 架构、按概率逐个预测下一个 Token 的神经网络。要搞懂它,得先弄明白两件事:一是它怎么靠“词语接龙”把一段话输出出来;二是它怎么从只会问答的基座模型,变成听得懂指令、干得了活的 Super Agent。
恭喜看到这里的你,已经成功击败 30% 的学习者。
接下来我问你,LLM 是怎么输出的?
A,去数据库里拼接现成的内容;B,一次性算完并输出;C,切分成 Token 后按概率逐个往下猜。喜欢收藏的你可以把答案打在弹幕或者留言区。
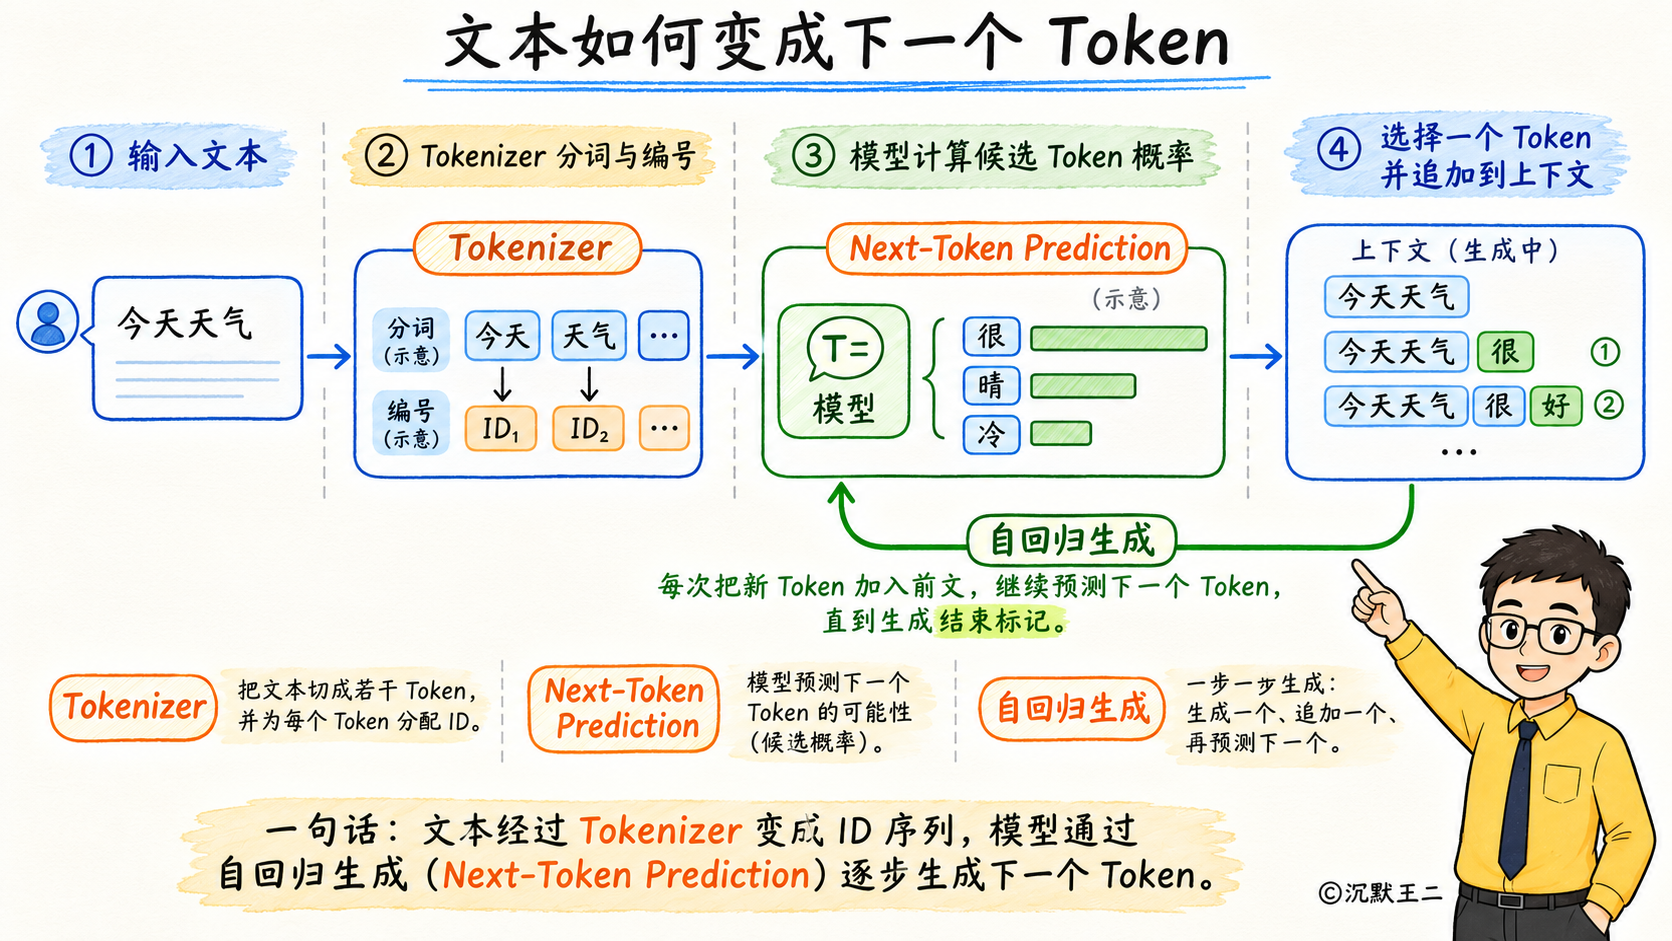
大模型既不认识汉字,也不认识英文单词。你输入一句话,分词器会先把它切成模型能处理的最小单位,叫 Token,也就是词元,再把每个 Token 转成一个数字编号。按 DeepSeek 官方给出的估算,1 个中文字符大约是 0.6 个 Token,1 个英文字符大约是 0.3 个 Token。
拿到这串 Token 之后,LLM 生成文本的方式叫“自回归”,说白了就是词语接龙。比如你输入“床前明月”,模型会给词表里十几万个候选 Token 各算出一个概率。假设“光”的概率最高,达到 95%,模型就输出“光”;接着把“光”拼到末尾,变成“床前明月光”,再拿这一整句去预测下一个 Token,比如“疑”。模型一个字一个字往外蹦出的“打字机效果”,并不是前端特意做的动画,而是模型在底层本来就是一个 Token 一个 Token 往外输出的。
恭喜看到这里的你,已经成功击败 50% 的学习者了。
继续问你,大语言模型的“大”,指的到底是什么?
A,安装包的体积大;B,训练语料和参数规模大;C,单次回答的字数多。喜欢点赞的你会选哪一个?
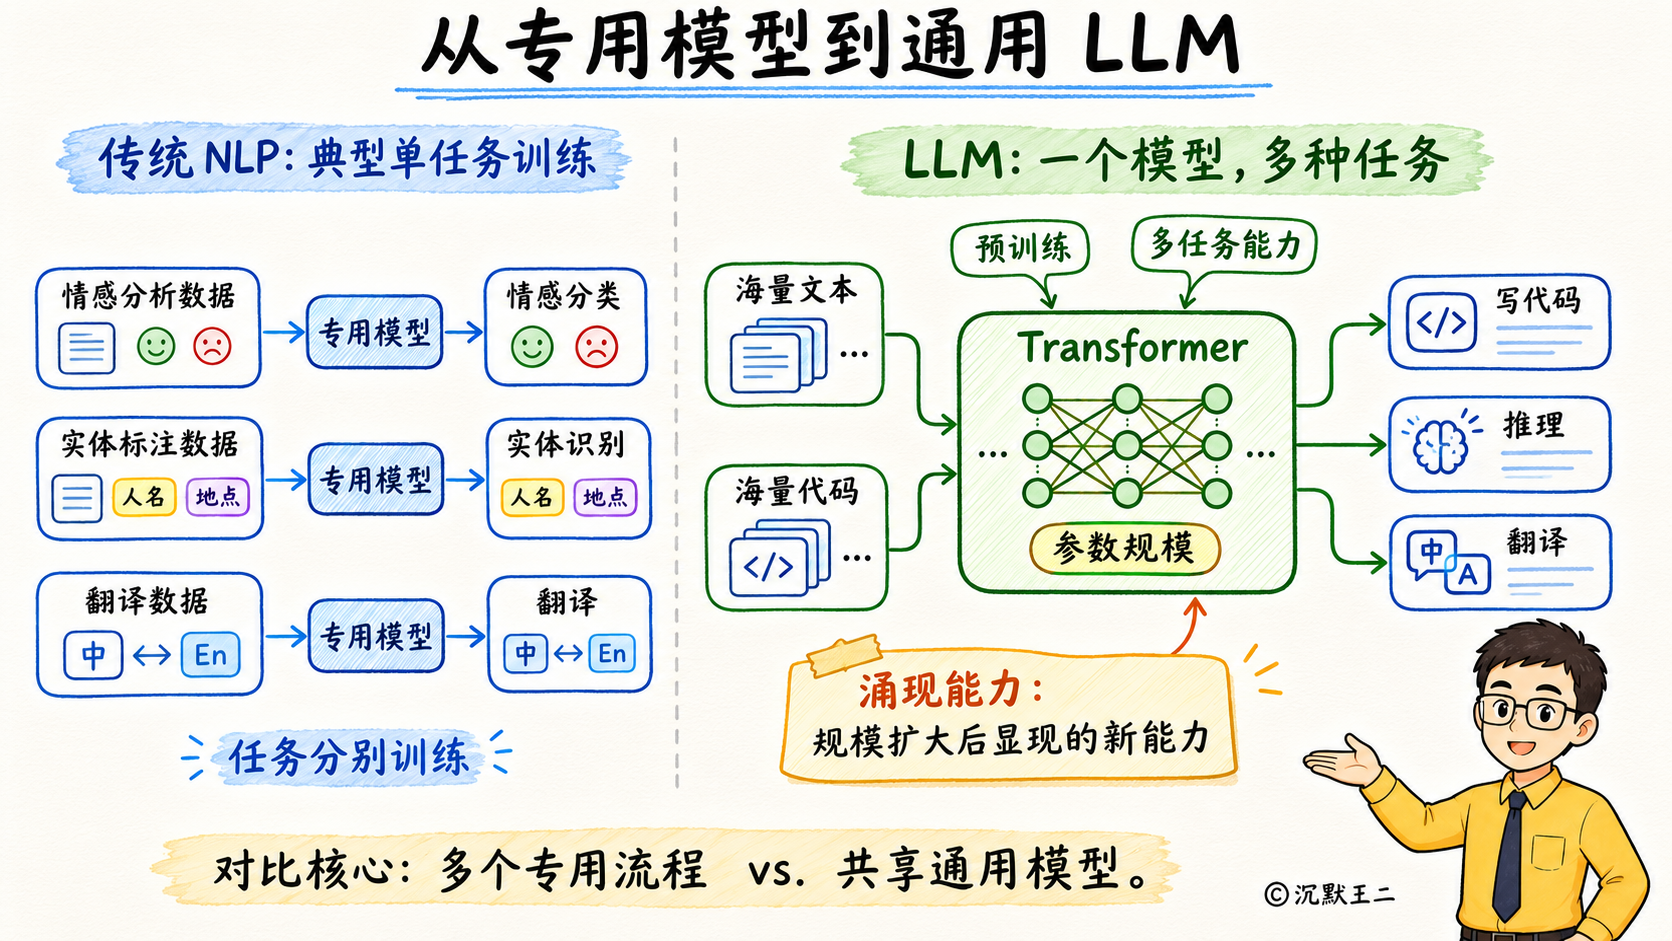
我们常听到的 7B、70B、671B,里面的 B 是英文 Billion 的缩写,代表十亿,指的是模型内部的参数数量,也就是权重。参数可以理解成神经网络里各个连接的强弱,训练的过程,就是一遍遍调整这些数值。以前的自然语言处理模型,像 LSTM 或 BERT,参数通常只有几百万到几亿,而且一个模型只能干一件事:做情感分析要训练一个模型,做意图识别又得另外训练一个,换个任务就得重来。
现在主流的 LLM 大多采用 Transformer 的 Decoder-only 架构,靠自注意力机制计算每个 Token 和前文所有 Token 之间的关联。研究人员发现了缩放定律(Scaling Law):参数、训练数据和算力一起往上加,模型效果就会稳定变好。当训练语料达到十几万亿 Token、参数跨过百亿甚至千亿量级时,模型还会出现所谓的“涌现能力”。
恭喜看到这里的你,成功击败 70% 的学习者了。
继续,只会词语接龙的模型,怎么学会了听懂人类指令?
A,写几万条判断规则;B,靠预训练学习通用知识;C,靠后训练做指令微调和强化学习。喜欢推荐的你会选哪一个?
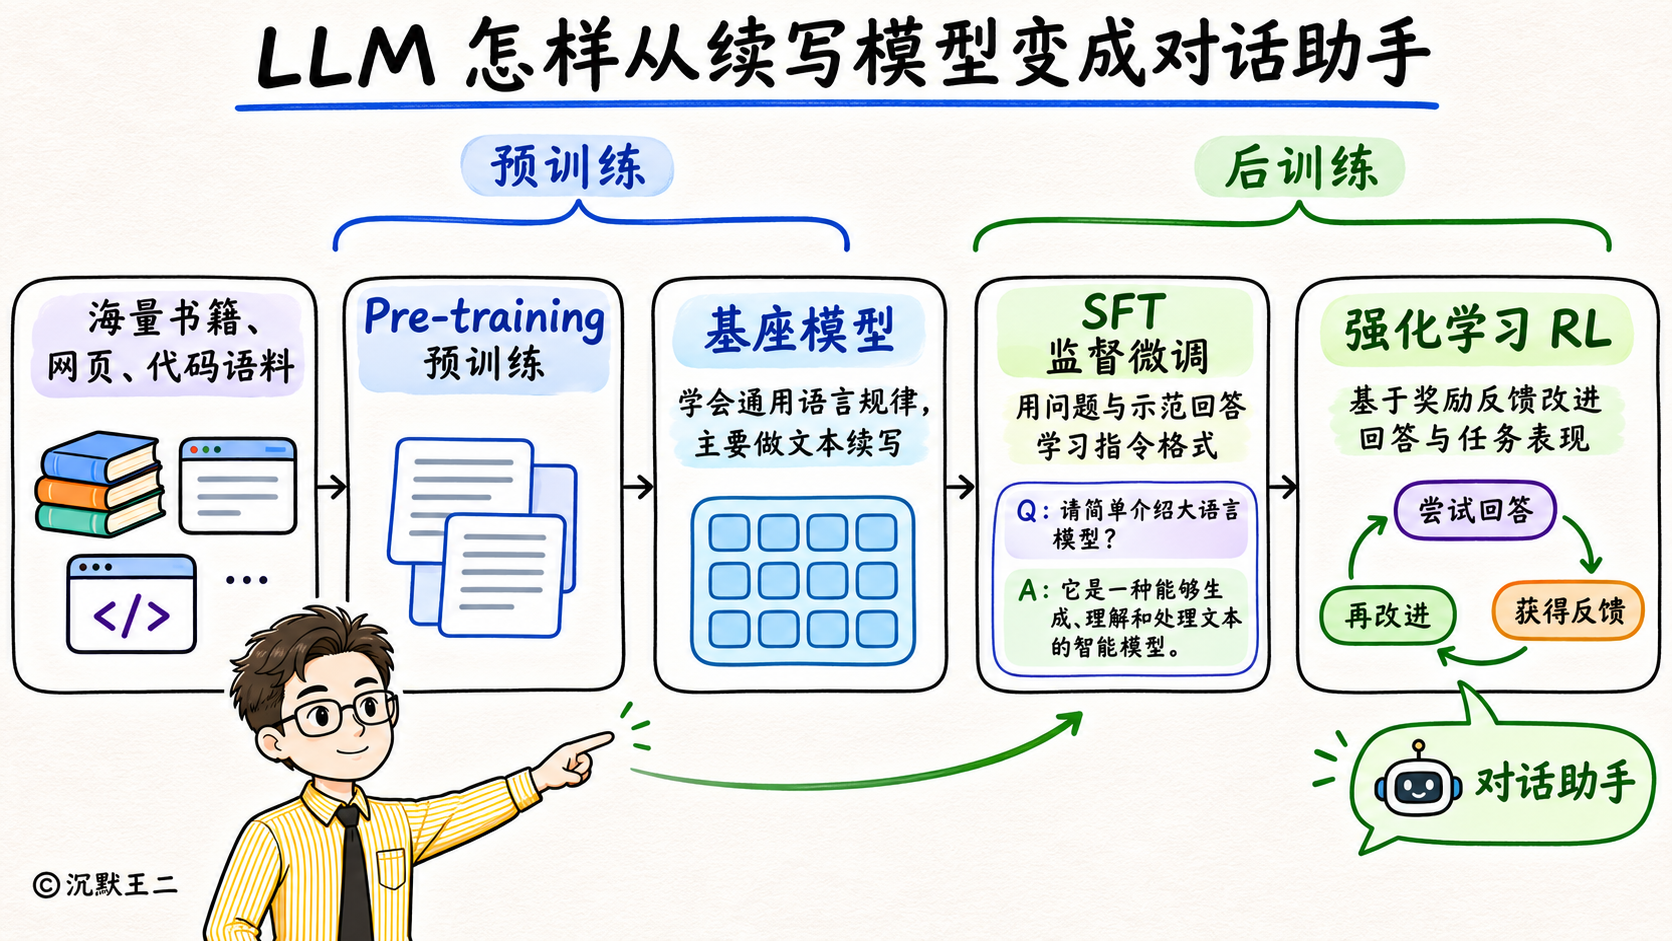
训练一个 LLM 分两大步。第一步叫预训练,好比让模型从小学一路读到大学,把互联网上的书籍、网页和代码这些海量语料读一遍,把通用知识压缩进参数里。
第二步叫后训练。先做 SFT 监督微调,拿“问题+标准回答”的示范数据,教它按问答的格式回答;再做 RL 强化学习,一方面让回答更符合人类的偏好,另一方面让模型在数学和代码任务里反复试错,答对了加分,答错了扣分,慢慢练出一步一步推导、再回头验算的思维链能力。预训练决定了模型肚子里有多少墨水,后训练决定了它能不能把这些知识用对地方。
恭喜看到这里的你,成功击败 90% 的学习者了。
最后再问你,为什么 LLM 有时候会一本正经地胡说八道?
A,模型故意编瞎话骗人;B,生成过程靠概率采样;C,参数记忆是有损压缩且不会实时更新。聪明的你会选哪一个?
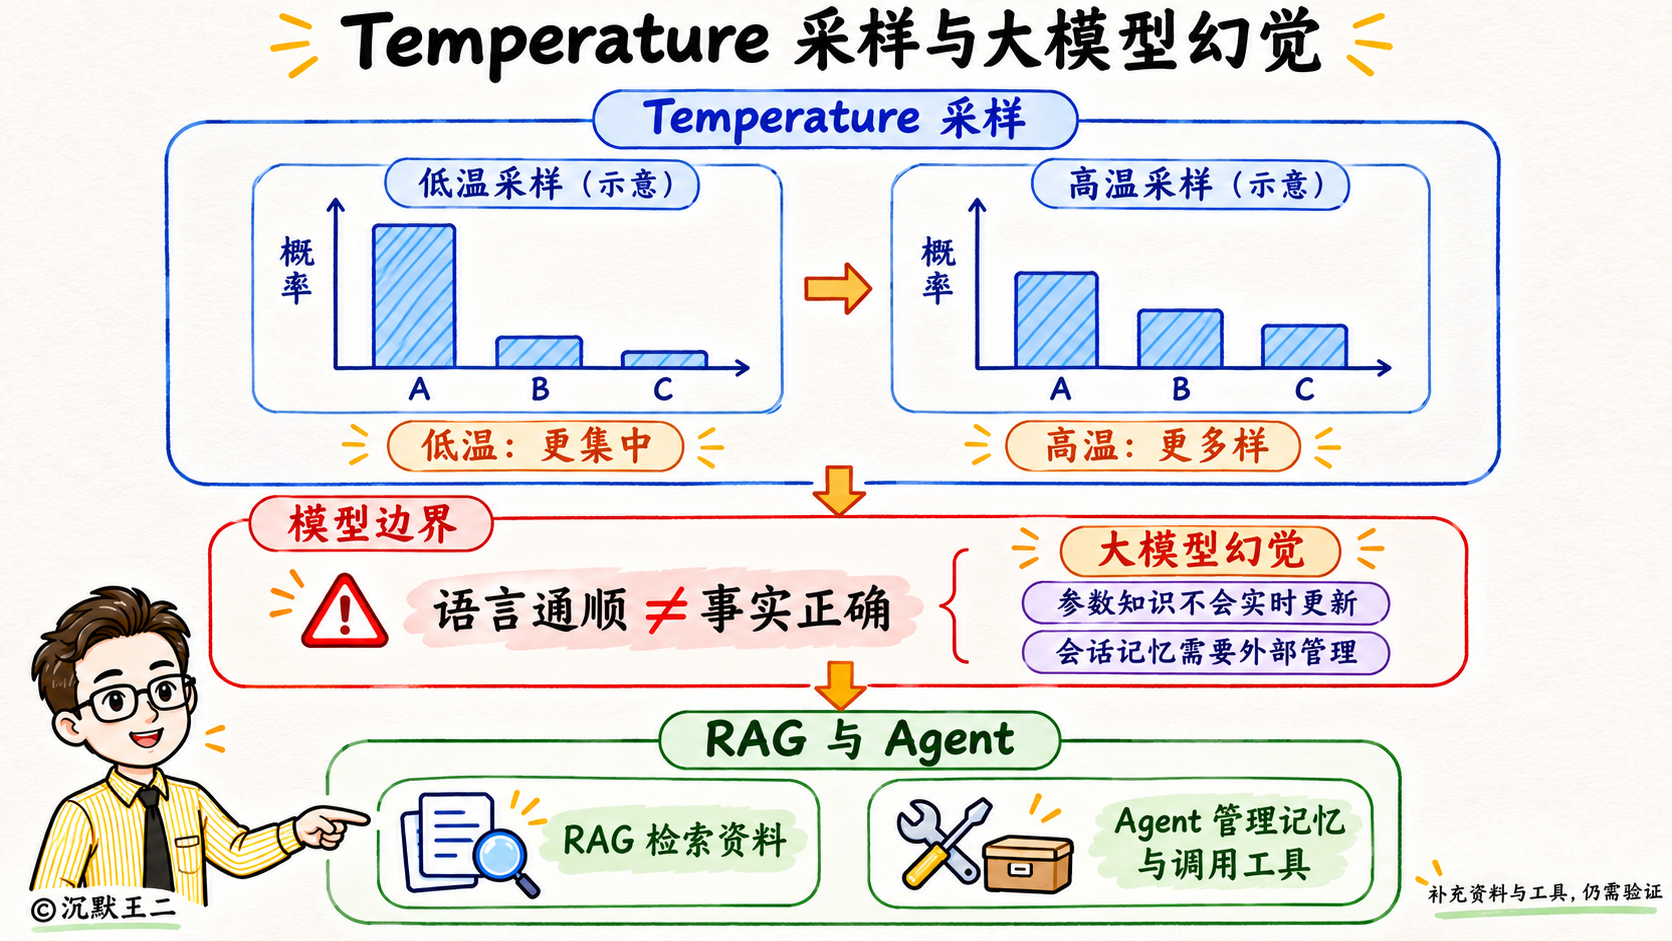
模型算出下一个 Token 的概率排名后,如果每次都只挑第一名,写出来的内容会很死板,还容易反复说车轱辘话。所以生成时通常会用温度(Temperature)参数来控制采样的随机性。写代码时一般把温度调低,比如 0.1,让模型尽量选概率最高的 Token;写文案时把温度调高,比如 0.8,给排第二、第三的 Token 一点机会,回答会更灵活。
更深层的原因是,LLM 把海量语料压缩进了固定大小的参数里,记住的是语言的统计规律,也就是什么词后面更可能接什么词,而不是一字不差的原文。遇到训练截止日之后的新闻,或者没记准的细节,它往往不会主动说“不知道”,而是照样挑一条读起来通顺、概率又高的路径把话接完,这就产生了“幻觉”。再加上模型训练完成后权重就固定了,不会自己学习新知识;它本身也不会记住上一次对话,更没法自己查资料或执行命令。所以工程落地时,才需要用 RAG 给它补充真实资料,用 Harness 帮它管理记忆、调用工具。
恭喜你升到王者段位了,成功击败 99% 的学习者。
最后简单总结一下,LLM 本质上是一个基于 Transformer 的神经网络,它做的事情,就是根据前文按概率一个一个地预测下一个 Token。参数和语料的规模大到一定程度,一个模型就能应付很多种任务。它靠预训练把海量知识装进参数,靠后训练学会听指令和推理。也正因为它会产生幻觉,实际应用时才需要配合 Prompt、RAG 和 Harness。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!