
拿欧洲 AI 公司 Aleph Alpha 发布的开源模型 Kolibri 来说,官方在技术报告里直接坦白,后训练阶段的数据主要来源于智谱的 GLM-5.3 和阿里的 Qwen3.8,国模当老师,欧模当学生。
我翻了 Kolibri 的技术报告、Google Gemma 2 的技术报告以及 Anthropic 的防蒸馏攻击报告,可以自信地、大方地、光明磊落地帮你把模型蒸馏这件事讲清楚。
恭喜看到这里的你,已经成功击败 30% 的学习者,给自己鼓个掌吧。接下来我问你,训练一个新模型时,直接喂互联网上的原始数据,和蒸馏顶级模型,最大的区别是什么?
A、把顶级模型的代码复制一半过来;B、告诉新模型每道题的标准答案;C,让顶级模型把解题步骤和每个 Token 的概率偏好吐出来,喂给新模型。喜欢收藏的你可以把答案打在弹幕区或者留言区。
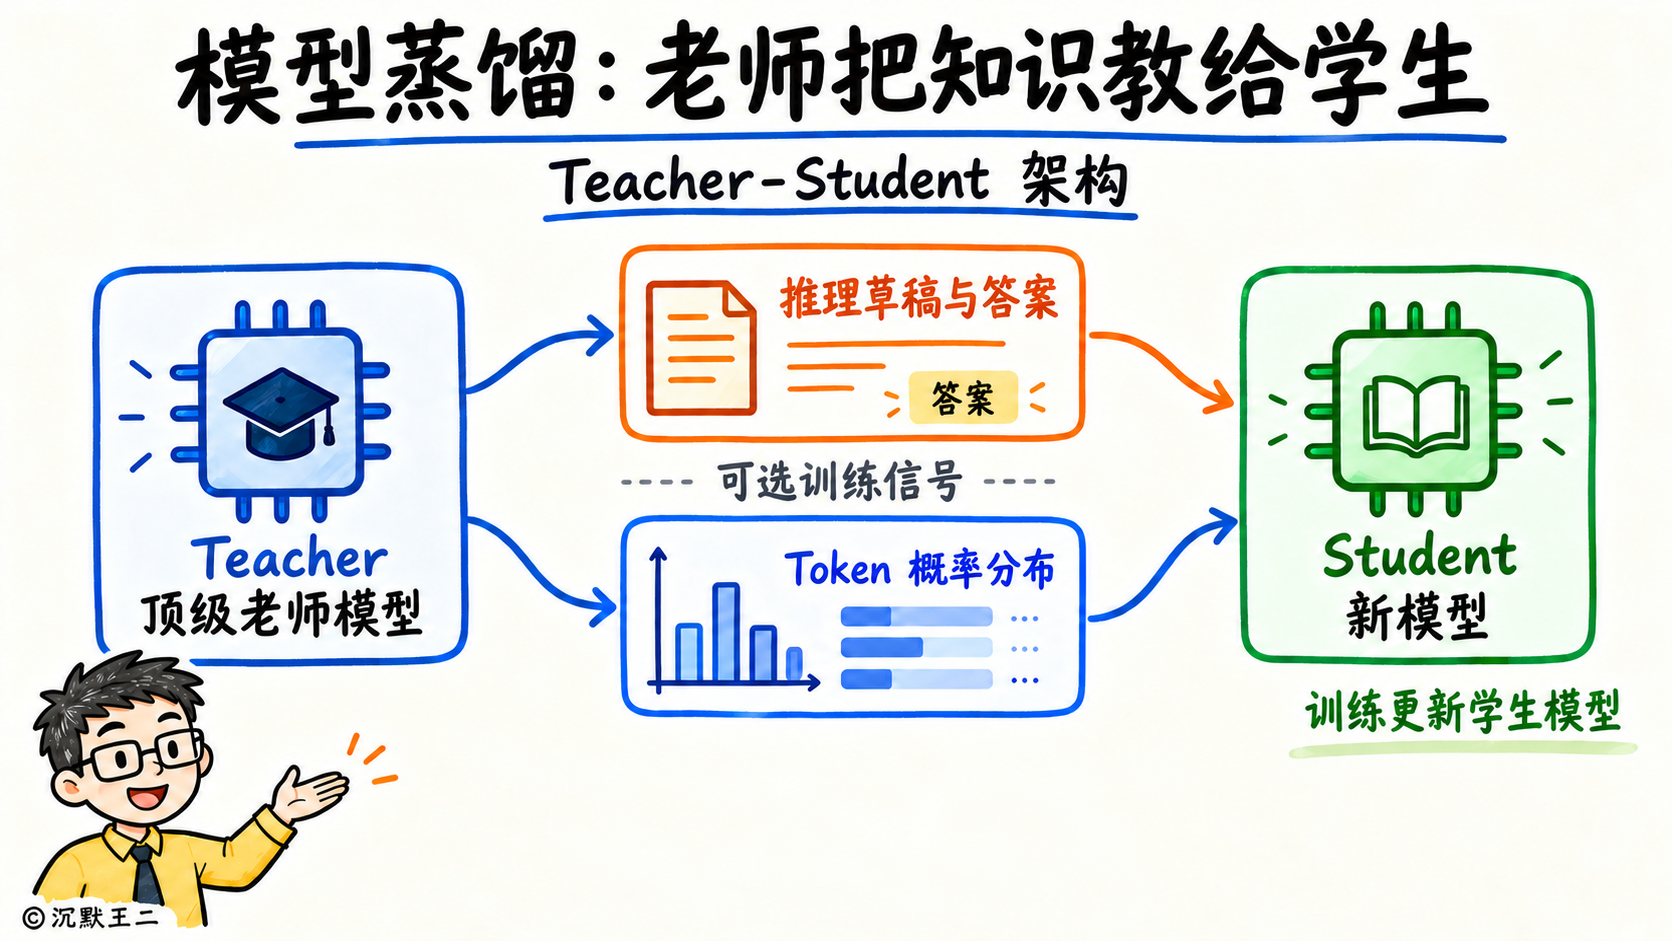
说一下我的答案。知识蒸馏也就是 Knowledge Distillation,最早由图灵奖得主 Geoffrey Hinton 等人在 2015 年提出,核心是“老师如何教学生”。
打个比方。像 GPT-6 Astra、Claude Opus 5.5、DeepSeek V4.1 Flash 这类顶级模型,就像博学但出场费极高的老师;而那些新模型或者第二梯队的次顶级模型,就像正在追赶的学生。让学生自己去啃全网杂乱的原始内容,既烧显卡又很难【龙场悟道】。
老师带学生主要有两种蒸馏方式。
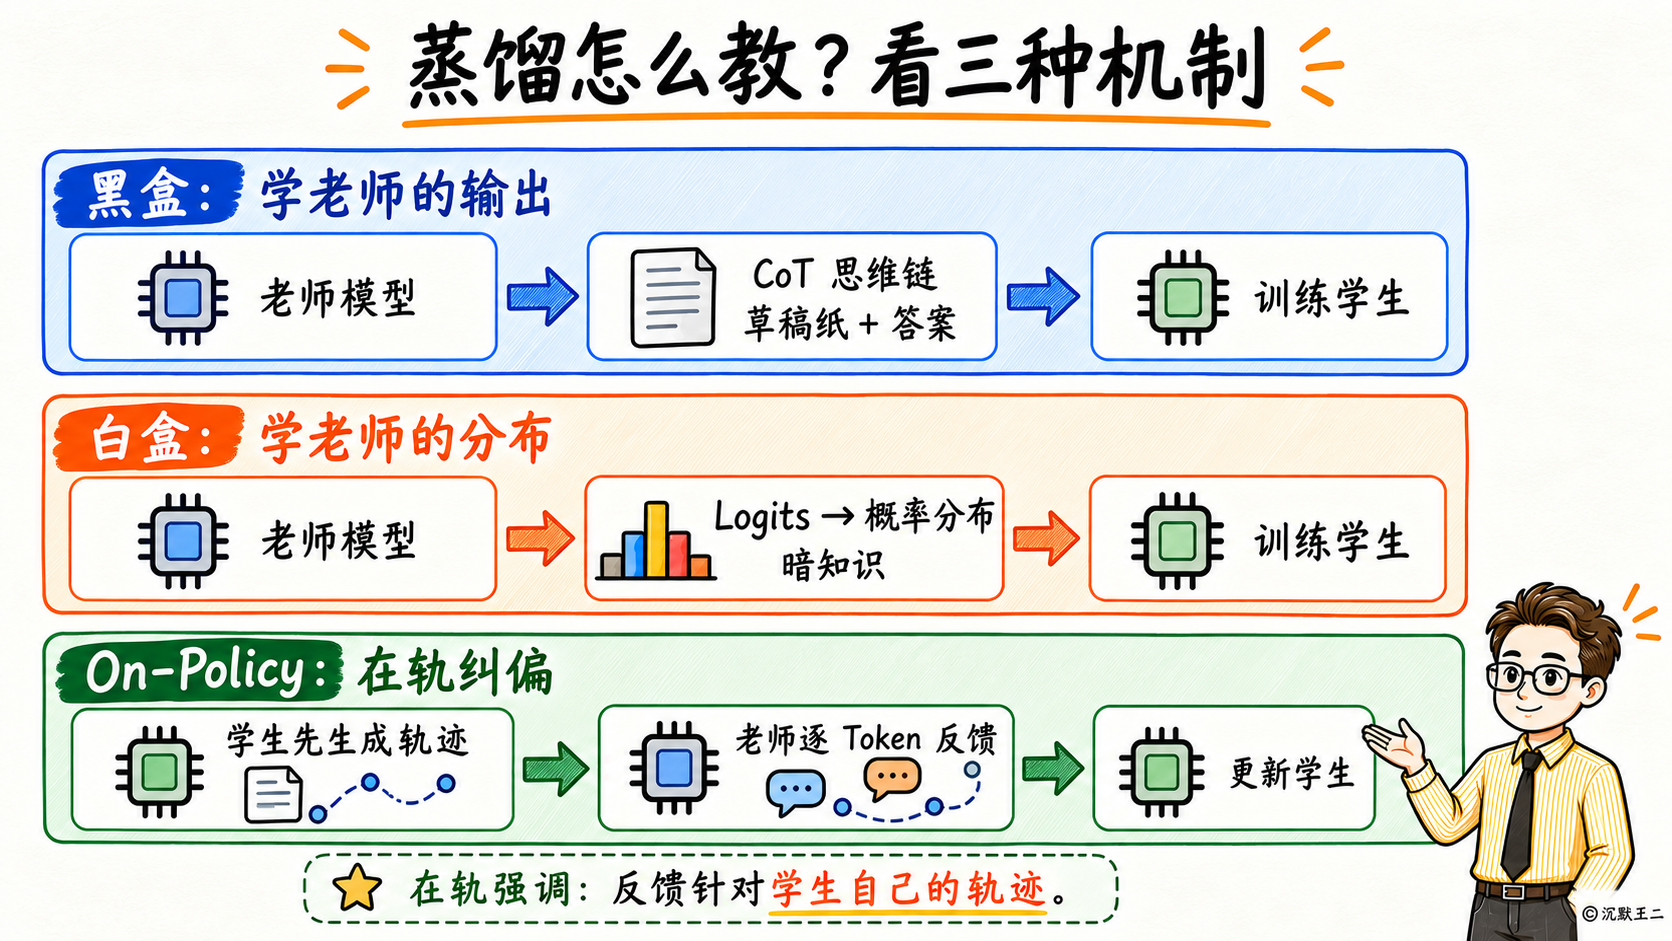
第一种叫黑盒蒸馏。就像 Kolibri 蒸馏 GLM-5.3,让老师把难题一步步验算的思考过程,也就是 CoT 思维链,连同答案一起写出来。学生直接照着这份草稿去学习,很快就能掌握老师的解题套路。
第二种叫白盒蒸馏。如果老师开源了权重,学生不仅能看到老师最后输出了哪个答案,还能看到老师在给出答案时对词表里几万个 Token 的打分表,专业术语叫 Logits,也就是对数几率。比如你问模型“今天降温了,晚饭吃什么好?”黑盒蒸馏只把老师最后的答案“火锅”教给学生;而在白盒蒸馏里,老师会把脑子里的候选词打分给学生看,推荐火锅占 60%,羊蝎子占 25%,麻辣烫占 14%,冰淇淋只有 0.0001%。学生不仅学会了这道题应该回答“火锅”,还悟出了“天冷要推荐热乎的、不能推荐冷饮”的潜台词,Hinton 把这叫做暗知识。
现在后训练里还流行一种在轨蒸馏(On-Policy Distillation)。让学生自己先动手,哪一步错了,老师就在这一步逐个 Token 手把手告诉学生下一步怎么改。
恭喜看到这里的你,已经成功击败 50% 的学习者了。接下来继续问你,模型蒸馏、模型量化和 SFT 监督微调到底怎么区分?
A、蒸馏和量化都是在删减模型参数;B、蒸馏是名师带高徒,量化是同一个模型降低精度,黑盒蒸馏用的训练方法就是 SFT;C、三者是一回事。喜欢推荐的你会选哪一个?
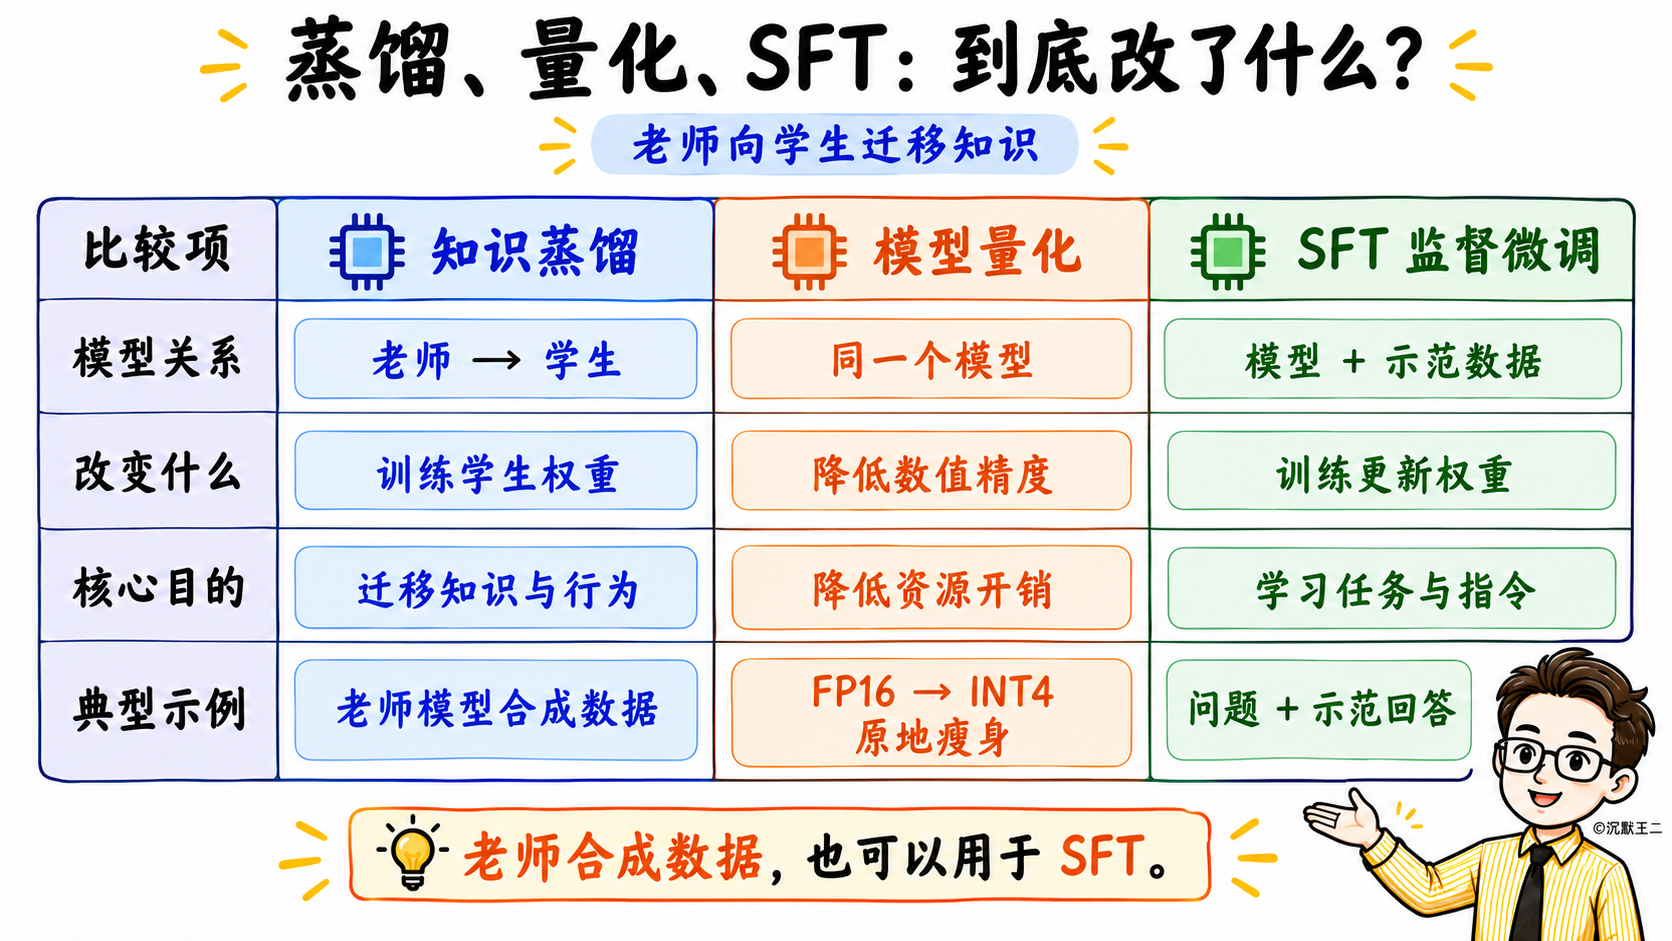
蒸馏是“名师带高徒”,把顶级模型的知识迁移给学生模型。
而量化(Quantization)是“给同一个模型瘦身”。比如一个 7B 模型,70 亿个参数,只降低每个权重数值在显存里的存储精度。原本用 FP16 也就是 16 位浮点数存储,7B 模型的权重大约占 14GB 显存;用 FP8(8 位浮点数)后,显存直接降到约 7GB。
SFT(Supervised Fine-Tuning,监督微调)是拿“问题加回答”的示范数据训练模型,让模型能更好的遵循指令。做黑盒蒸馏时,底层跑的训练代码其实就是 SFT。
恭喜看到这里的你,成功击败 70% 的学习者了。最后我问你,蒸馏到底算不算攻击?
A、算,这是在白嫖顶级模型的算力和心血;B、不算,闭源大厂自己也是拿全网数据训练出来的;C、看情况,取决于老师模型有没有开源授权。喜欢点赞的你会选哪一个?
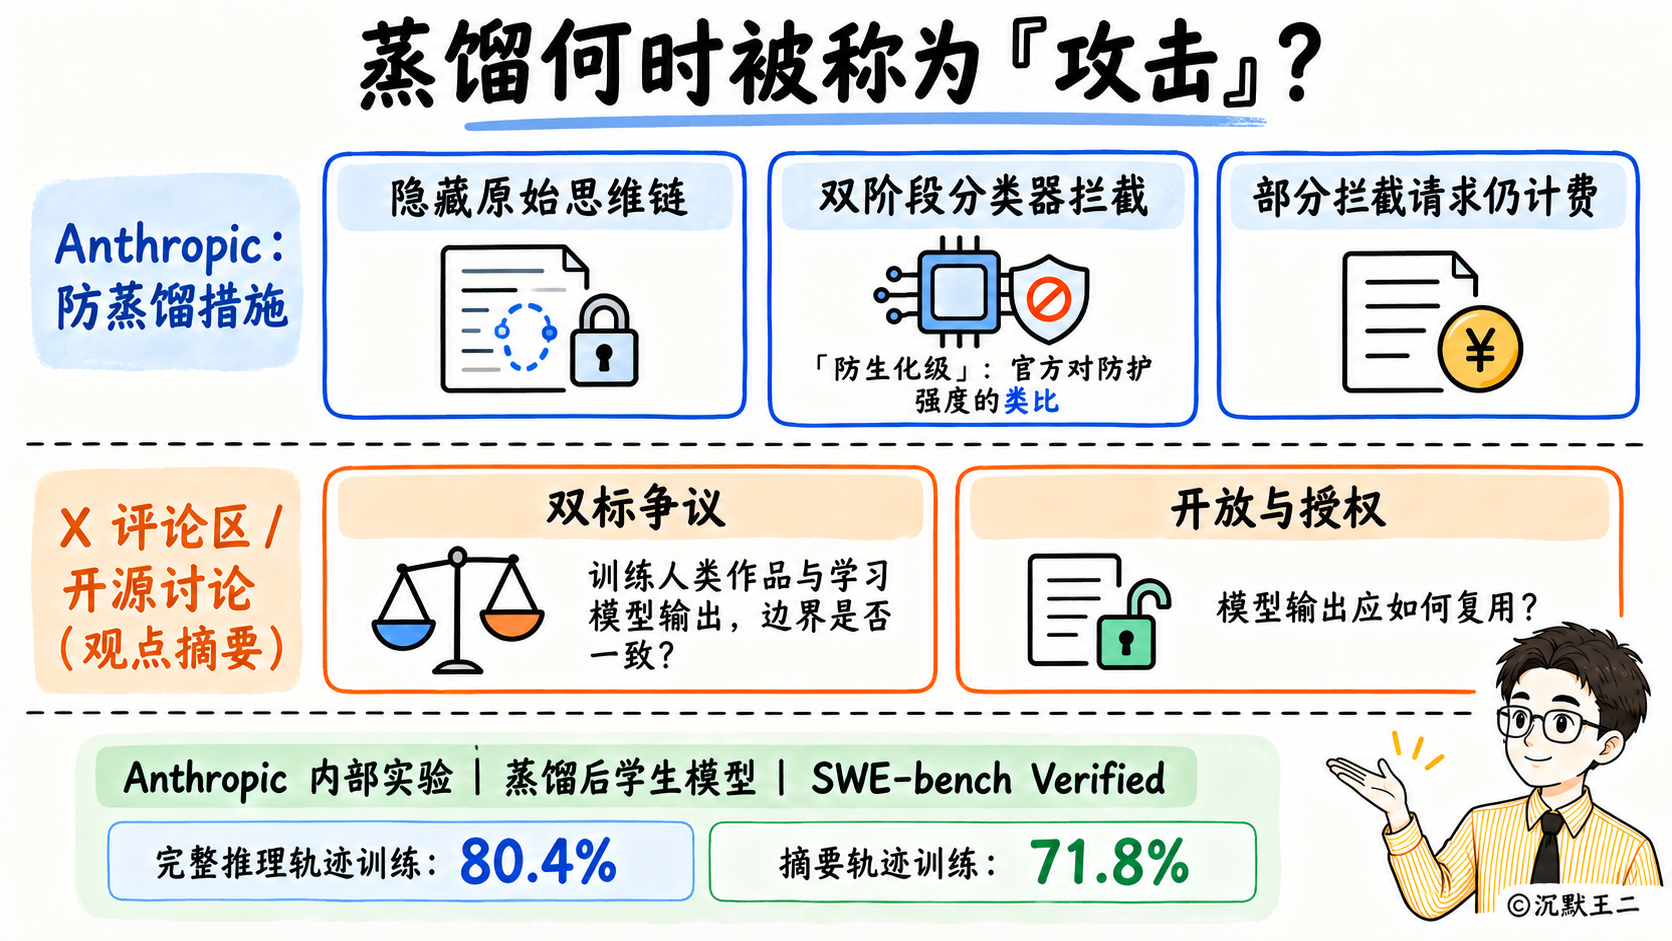
10 月 12 日,Anthropic 专门发了一篇官方博客,高调宣布他们用新方法把针对 Claude 的“蒸馏攻击”数据提取量压低了 99%,一口气封禁了数万个账号。
Anthropic 为什么这么急?因为他们在博客里公布了一组内部测试数据。如果拿 Claude Opus 4.8 的完整原始思维链去做蒸馏,训练出来的模型在 SWE-bench Verified 编程测试上能拿到 80.4 的高分。
说说网友们的答案,有人说:“蒸馏根本不是攻击”,“毕竟 Anthropic 是靠抄全人类的作品训练出来的模型,结果别人拿他们的输出训练模型就叫‘攻击’了?”你怎么看?
恭喜看到这里的你升到王者段位了,成功击败 99% 的学习者,点个推荐证明自己的实力吧。
最后简单总结下。量化是给同一个模型降精度瘦身,SFT 是喂示范数据立规矩,而蒸馏是让老师模型把推理过程传授给学生模型。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!