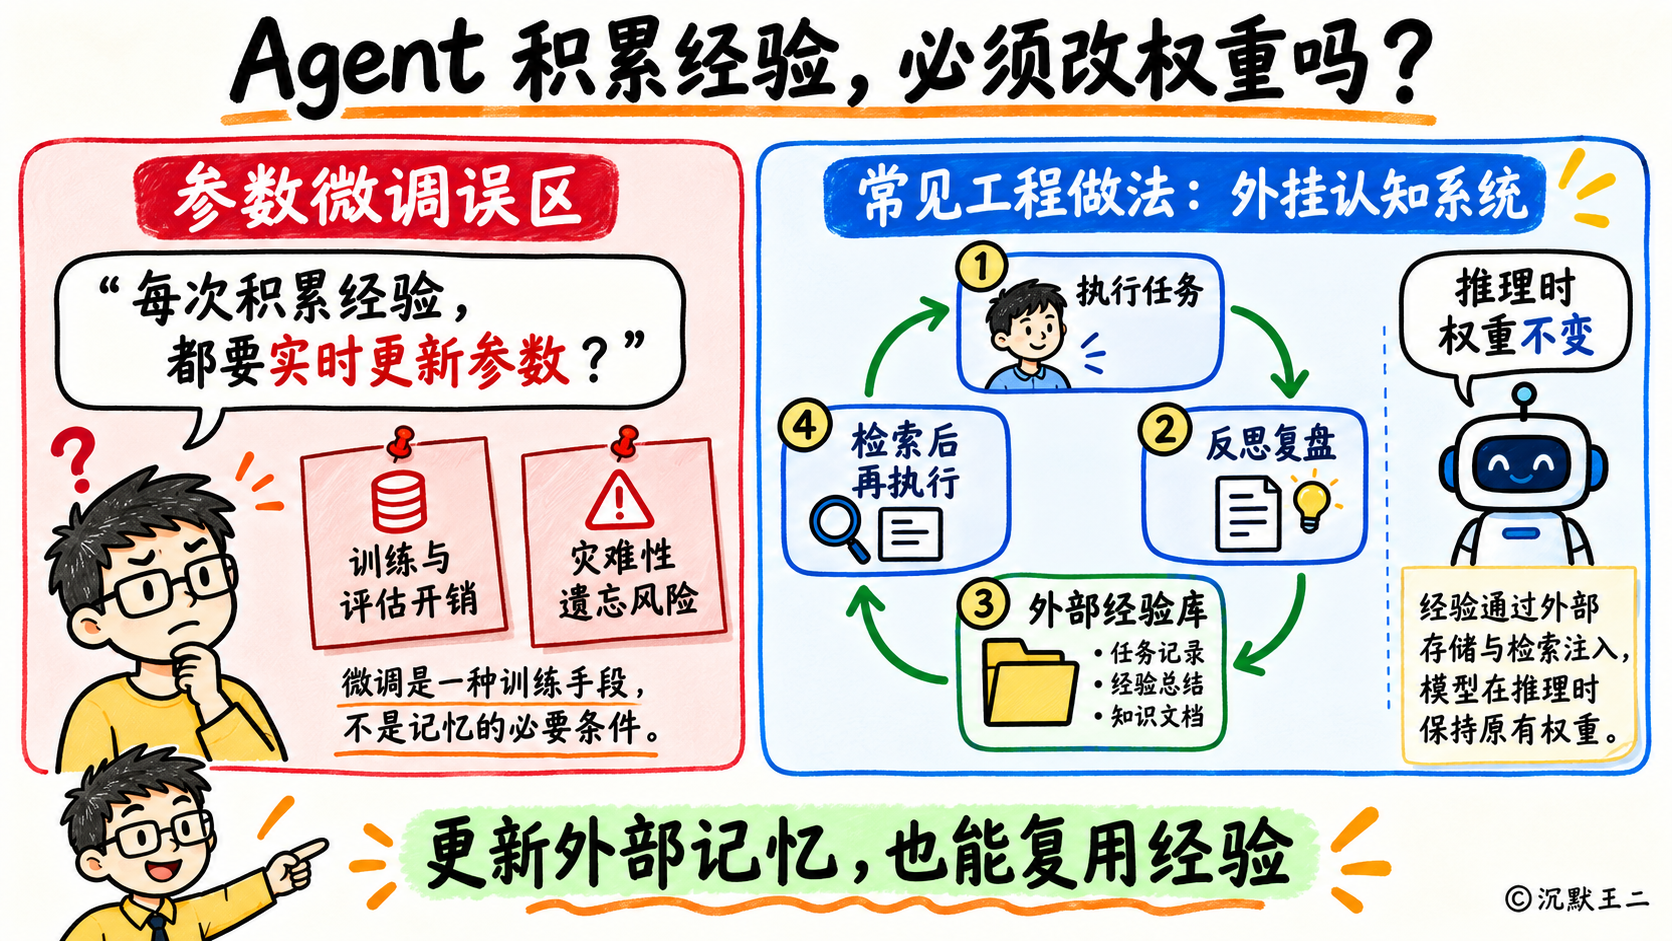
为什么?因为在真实的工程落地中,底座大模型在推理时的权重必须提前冻结。实时微调不仅算力成本高到无法承受,还会带来致命的灾难性遗忘。真正的 Agent 自我进化,靠的从来不是在模型内部调参,而是围绕上下文工程搭建的外挂认知系统。
我翻了 Claude Code 的底层机制、MemGPT 的论文以及前沿的 Agent 记忆系统,可以自信地、大方地、光明磊落地帮你搞清楚这三件事:
- 为什么 Agent 自我学习不能靠实时微调参数?
- Claude Code、Codex 和 OpenClaw 是怎么把经验持久化归档并检索出来的?
- Claude Code 的 AutoDream 是如何让 Agent 像人类睡觉时做梦一样完成记忆整合的?
哈喽大家好,我是二哥呀。今天用 3 分钟,给你彻底讲透 Agent 的经验积累与自我进化的底层秘密。
先说第一件事,为什么 Agent 的自我学习不能靠实时微调参数。
很多初学者一听到自我学习,总觉得模型应该是一边对话一边改写参数。但在工程实践里,这样很容易出问题。
首先是算力成本和响应延迟根本顶不住。大模型每更新一次权重,消耗的算力都是天文数字,响应延迟可能会从几百毫秒飙升到几十分钟,甚至更长时间。
比成本更可怕的是灾难性遗忘。大模型的神经网络极其脆弱且复杂,为了让它记住今天的特定报错去微调参数,明天它可能连基础的逻辑都搞不清楚了。
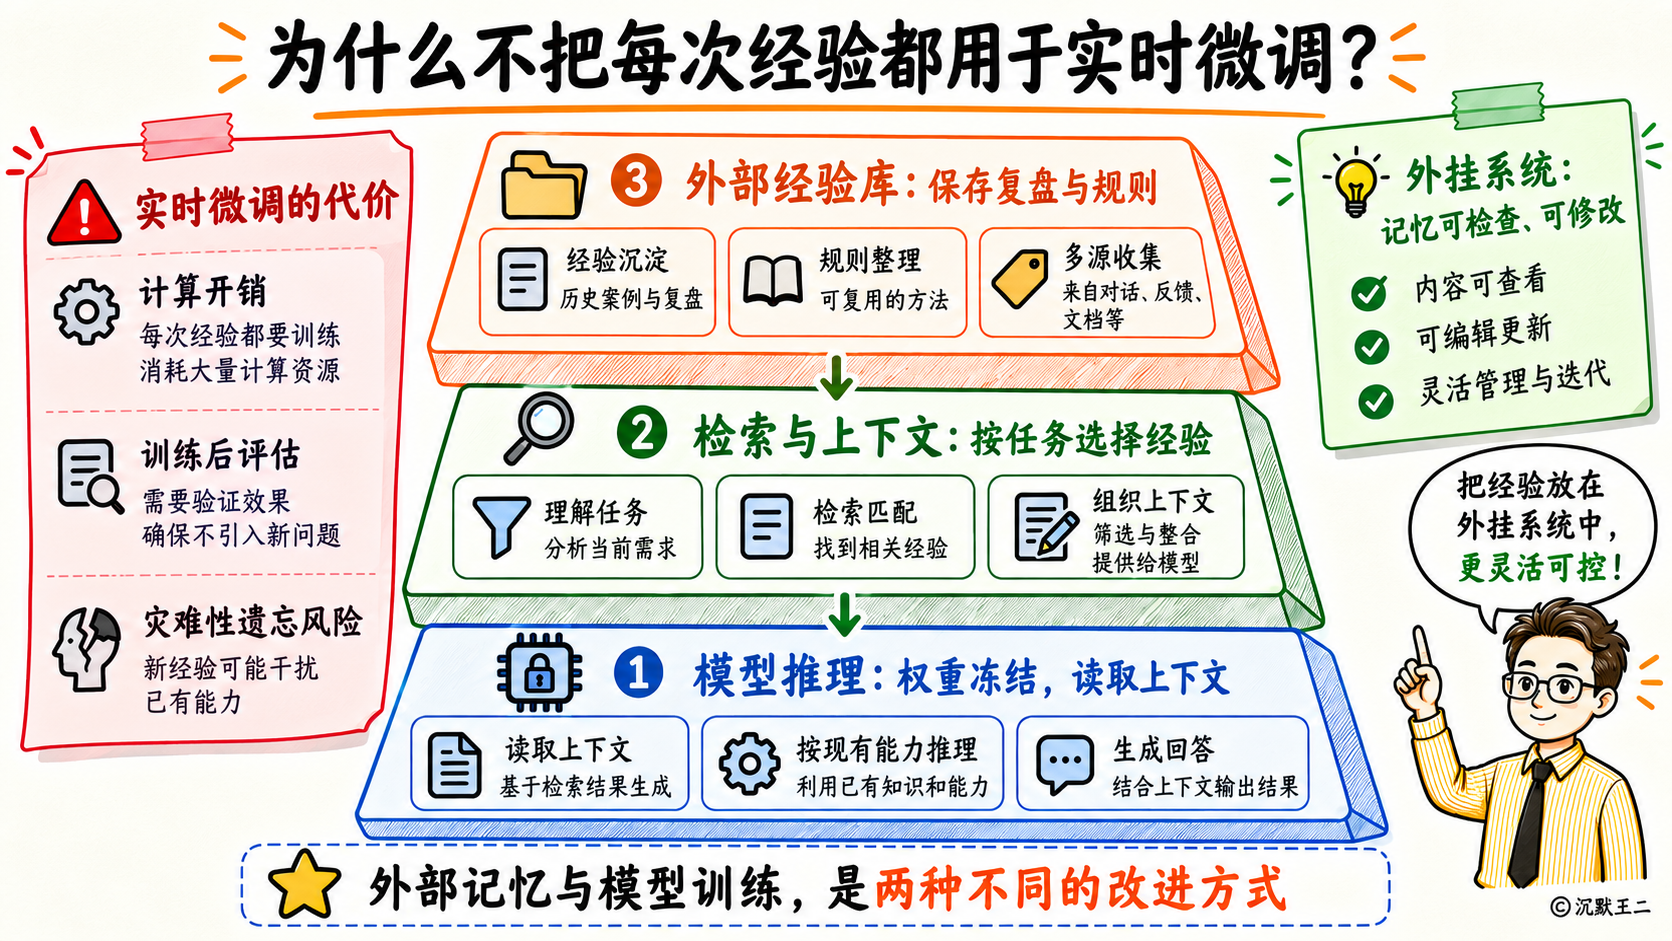
那聪明的你肯定要问:既然底座模型的通用能力不能实时改变,工程上到底靠什么让 Agent 积累经验?
答案是上下文工程机制。
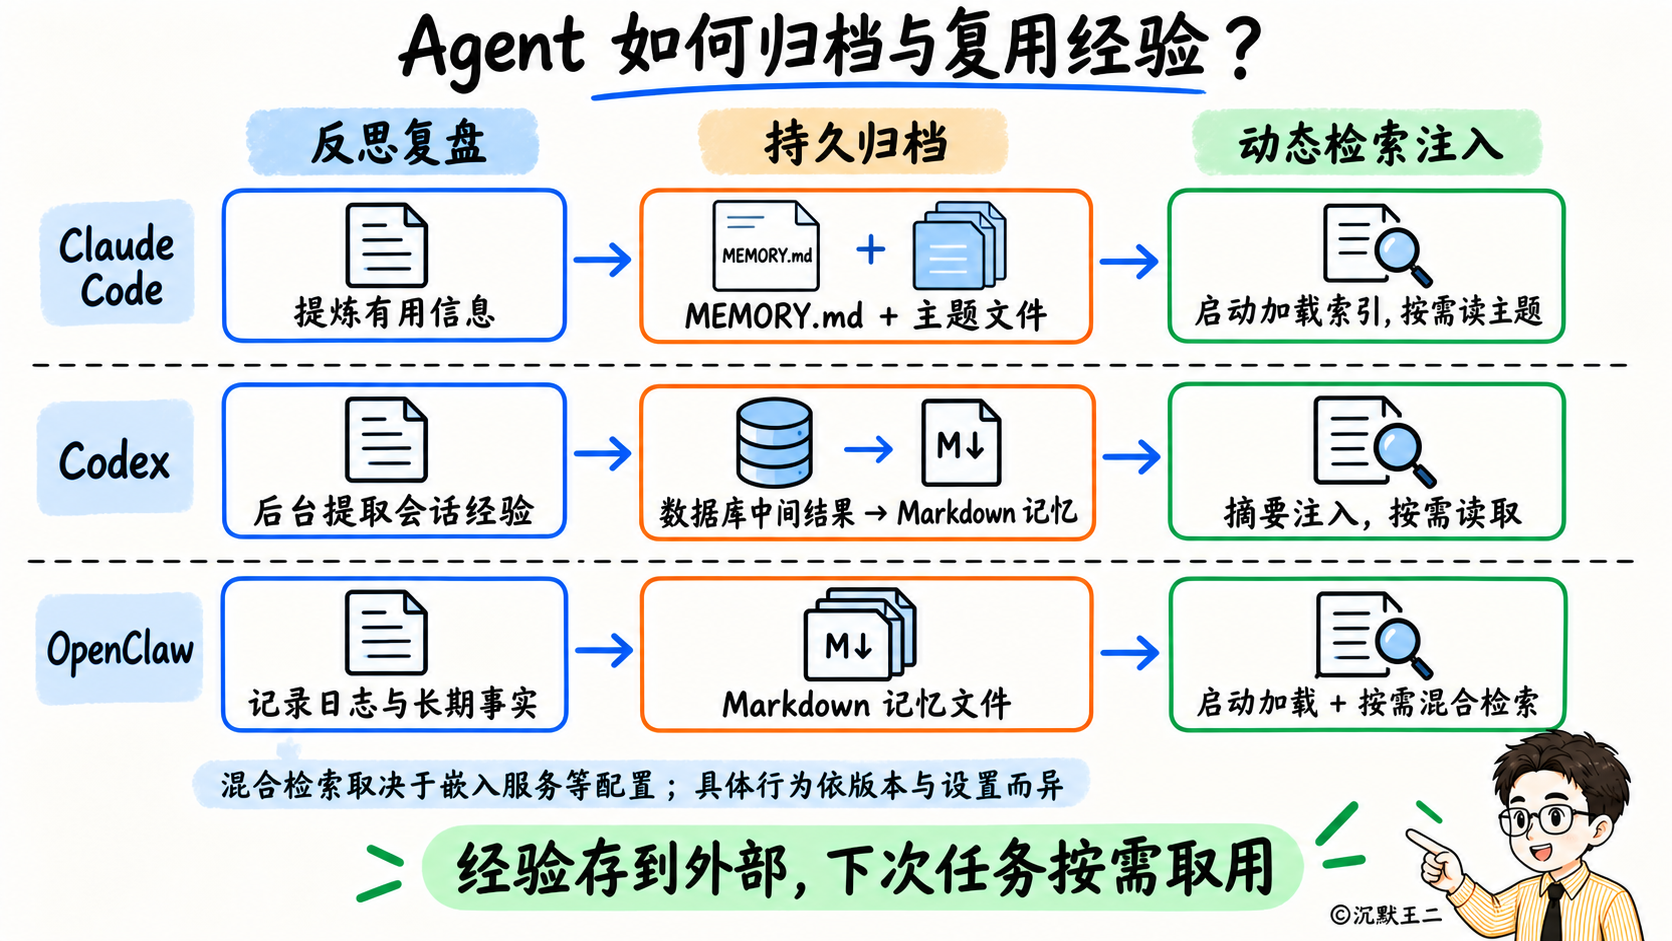
第一层是执行后的反思复盘。当 Agent 遇到报错、测试未通过或用户纠错时,系统立刻调用反思提示词,让模型推演复盘提炼经验教训。比如“修改文件前必须先检查路径是否存在”,这就是一份精准的错题记录。
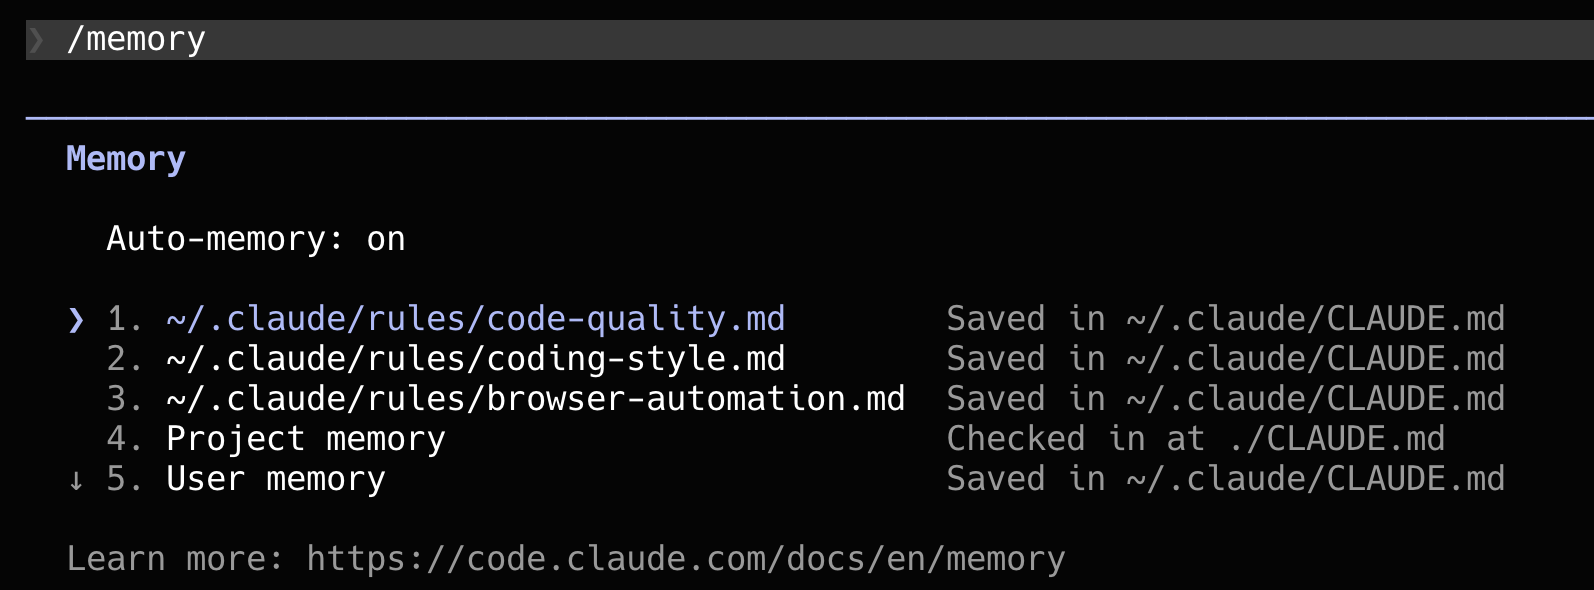
第二层是经验的持久归档。经验不能只停留在临时内存里,必须沉淀到外部存储。比如之前讲过的 Claude Code,会把团队的规范放在根目录的 CLAUDE.md 文件里,把个人偏好和纠错教训自动写入本地的 memory 目录,生成带类型的 Markdown 文件;而 Codex 则是派后台子 Agent 提炼有效记忆,写入本地 SQLite。包括我们把跑通的工作流固化为 Skill,经验就落地生根了。
第三层是动态检索注入。新任务到来时,Agent 开始各显神通。Claude Code 走的是极简索引路线,新开会话时直接把索引文件的前 200 行注入系统提示词,交给大模型注意力机制自行挑拣;而 OpenClaw 走的是混合检索路线,把 Markdown 记忆切块做向量化,新任务先做语义和关键词匹配,精准筛出两三条避坑指南动态塞给模型。这样 Agent 在推理前,就拿到了之前沉淀的经验教训。
反思提炼经验,持久归档文件,动态检索注入,这就把一次次的经验教训,变成了 Agent 长期可用的稳定能力。
那聪明的你肯定又要问了:随着时间推移,积累的经验越来越多,Agent 怎么避免记忆库变成屎山?
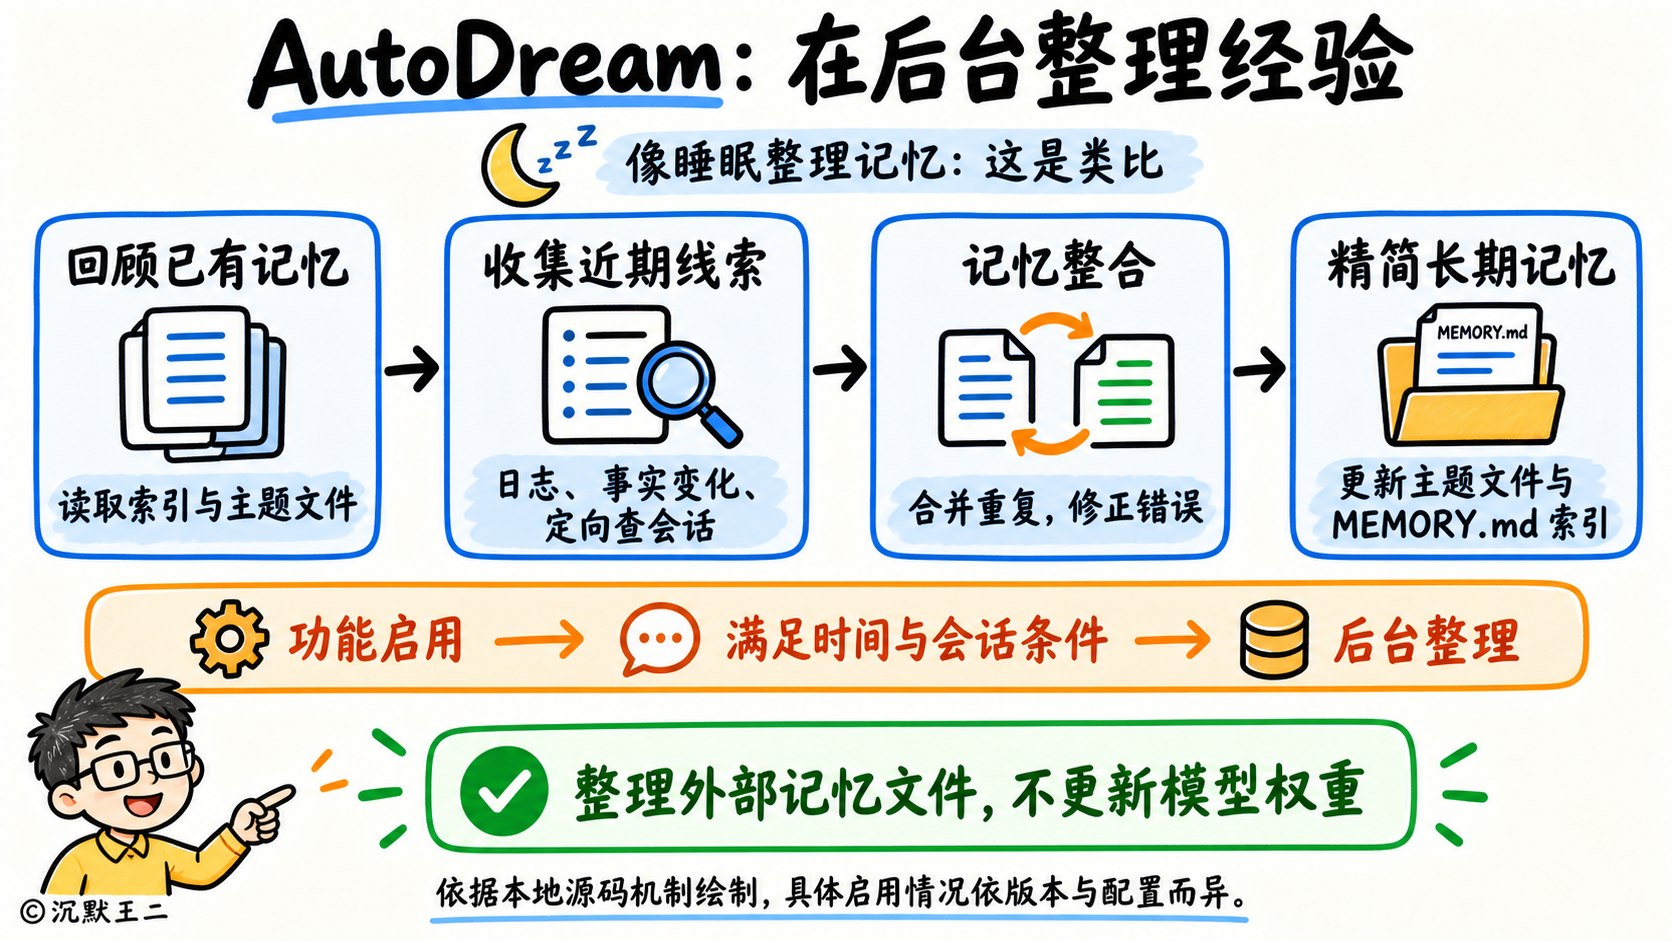
这就不得不提 Claude Code 里一个惊艳的后台机制:AutoDream,自动做梦。
这个设计灵感来自于人类大脑。白天清醒时,海马体接收零散的短期记忆;晚上做梦时,大脑启动记忆整合,清除琐碎噪音,把核心经验转移到皮层巩固成长期记忆。
Claude Code 的 AutoDream 也是这个逻辑。在后台空闲时,系统自动扫描近期会话日志,主动合并重复经验、淘汰过时策略,发现规则冲突时生成整理提案,最终沉淀出精炼的长期记忆。
有了这种如同做梦一样的后台整理机制,Agent 才不会被海量冗余记录拖垮,反而在每次重新唤醒时更懂你。
最后简单总结下。
Agent 的经验积累不是让模型改写自身参数,而是用反思、归档与后台整理构建起一套精巧的外挂认知系统。
另外给大家一条实用建议:配置 Agent 时,多利用规则文件和自定义 Skill 记录规范与踩坑经验,把这套外挂经验库喂饱,普通模型也能跑出顶尖水准。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!