为什么有的 Agent 能自我迭代自我进化,有的却无能为力,让你感觉很挫败,这个 Agent 很蠢?
我翻了 Self-Refine 和 Reflexion 的两篇论文,加上 Claude Code 源码的阅读,以及在 PaiCLI 开源项目里的反思模块实现,今天有底气帮你把这三件事讲清楚。
- 反思和重试到底有什么区别?
- Agent 的反思机制是怎么实现的?
- Self-Refine 和 Reflexion 到底有什么区别?
哈喽大家好,我是二哥呀。今天用 3 分钟,给你讲清楚 Agent 的反思机制。在这梳理了一份 AI Agent 开发学习路线和 294 道配套八股,需要的可以来个 222。
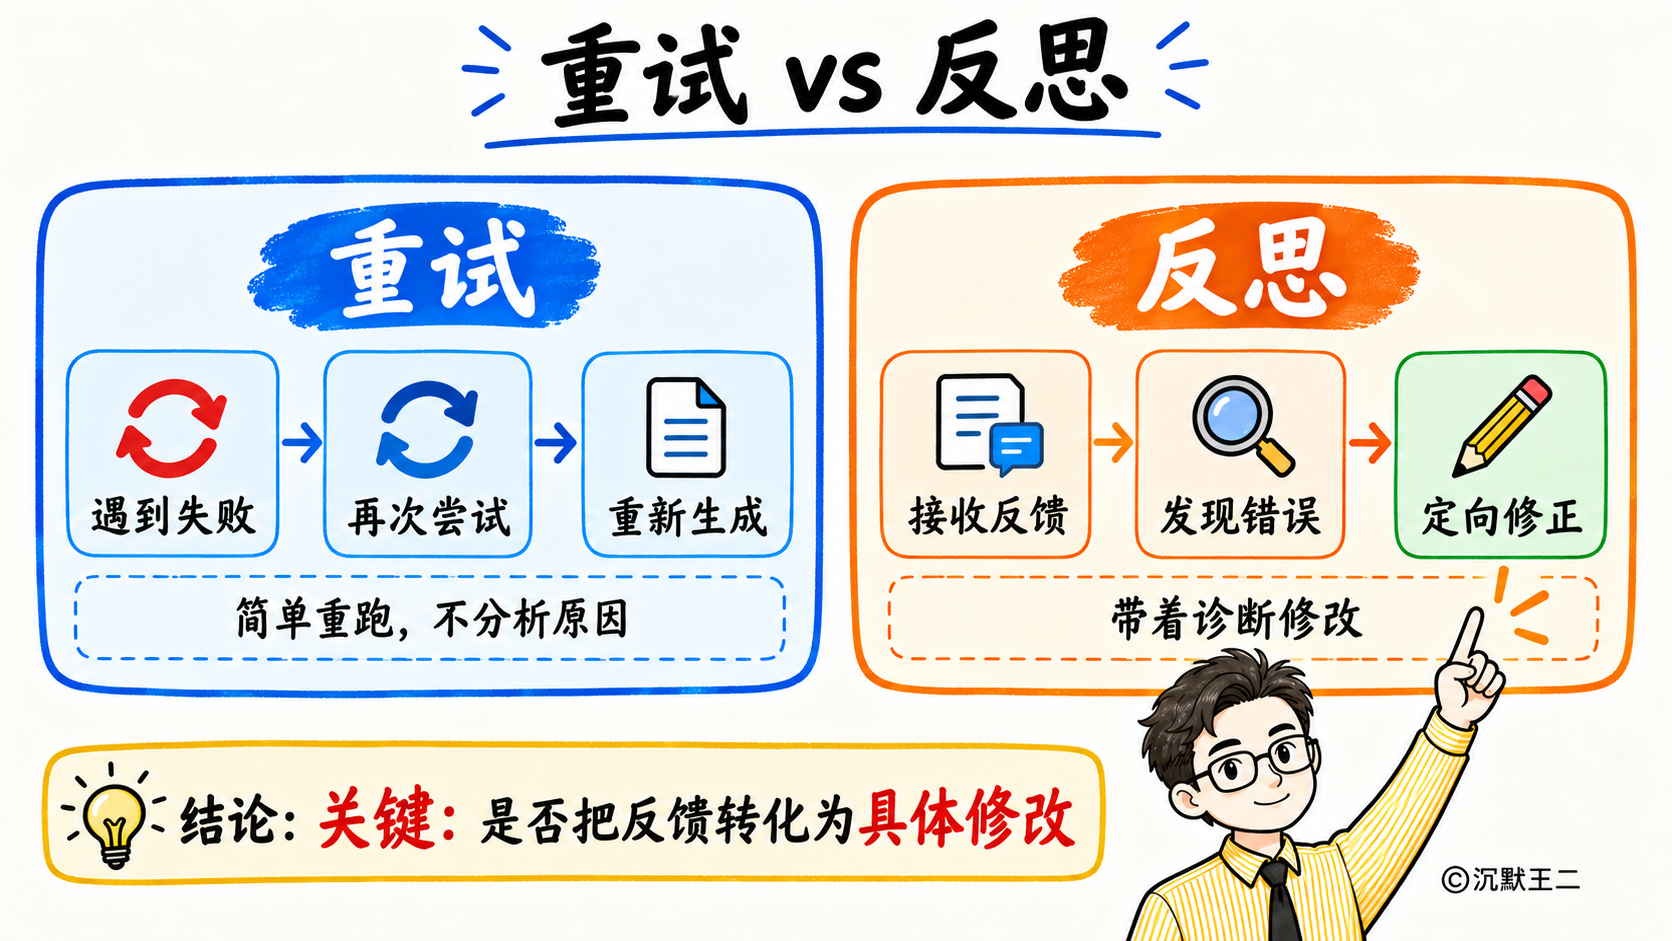
先说反思和重试有什么区别。
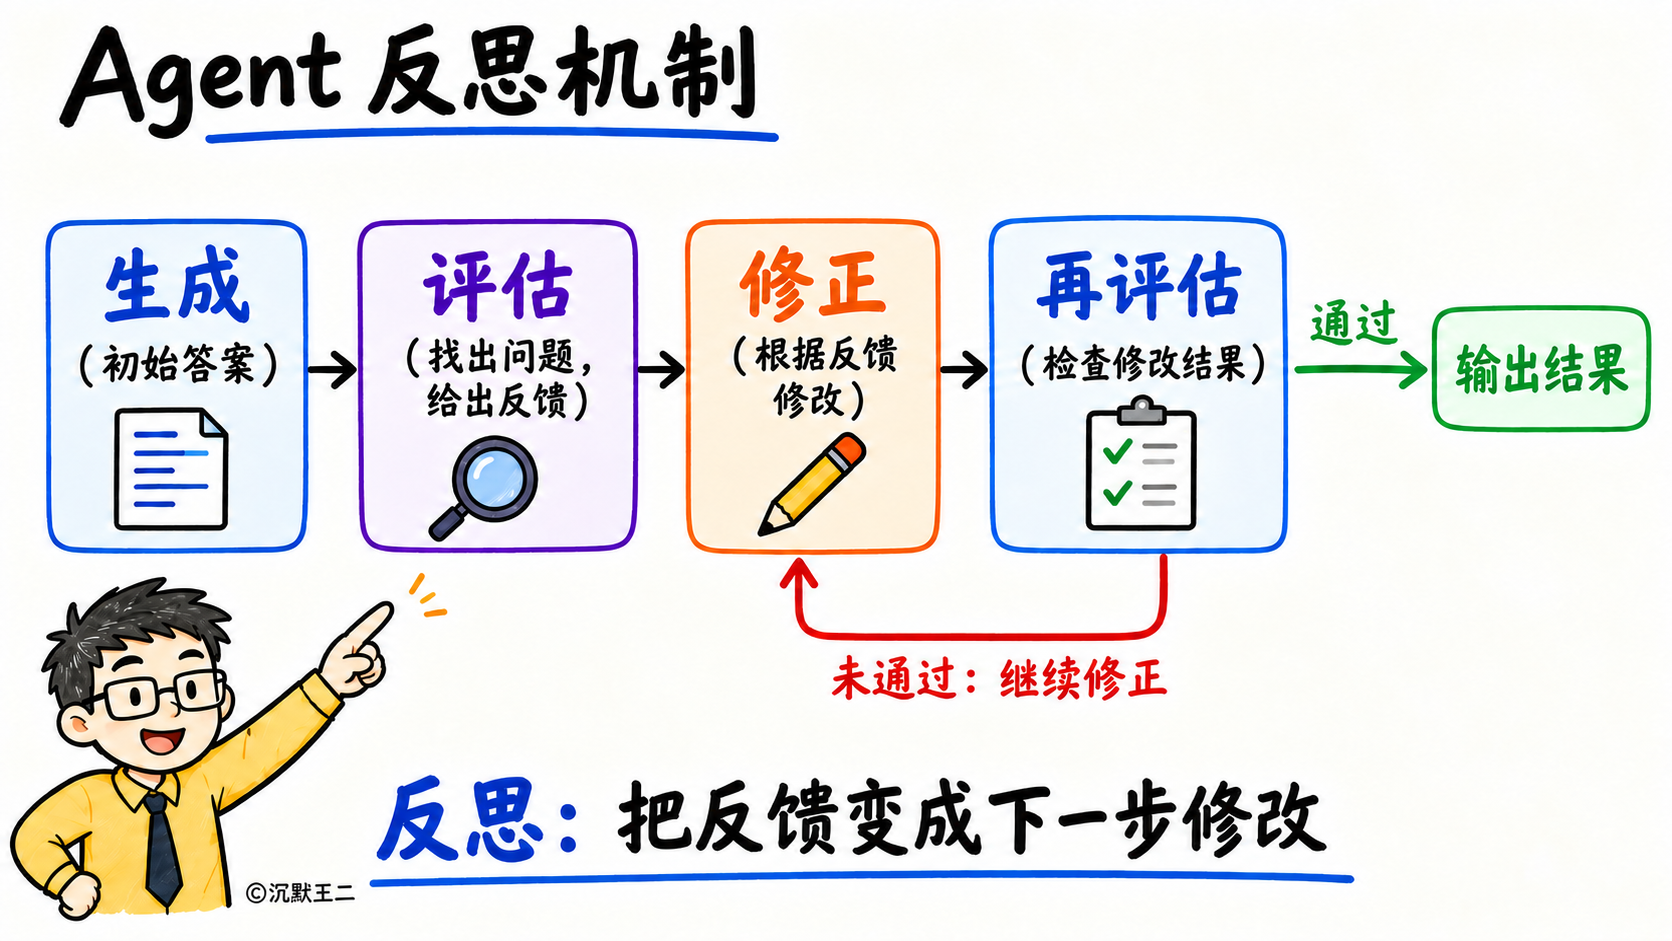
重试是闭着眼睛重来一遍,靠 LLM 的自我调整。反思是先看哪里错了,带着诊断去修改、去调整。
打个比方。考试交完卷,老师说“你这张卷子不及格,需要重考”。重试就是拿一张新卷子从头开始答,脑子里还是那些东西,最后还是不及格。
反思不一样。老师不仅把卷子发给你,还在错题上圈了个红圈,告诉你“应该用勾股定律”。那你大概率能改对,除非你连勾股定律都不懂。
那聪明的你肯定要继续问,反思机制具体怎么实现的?
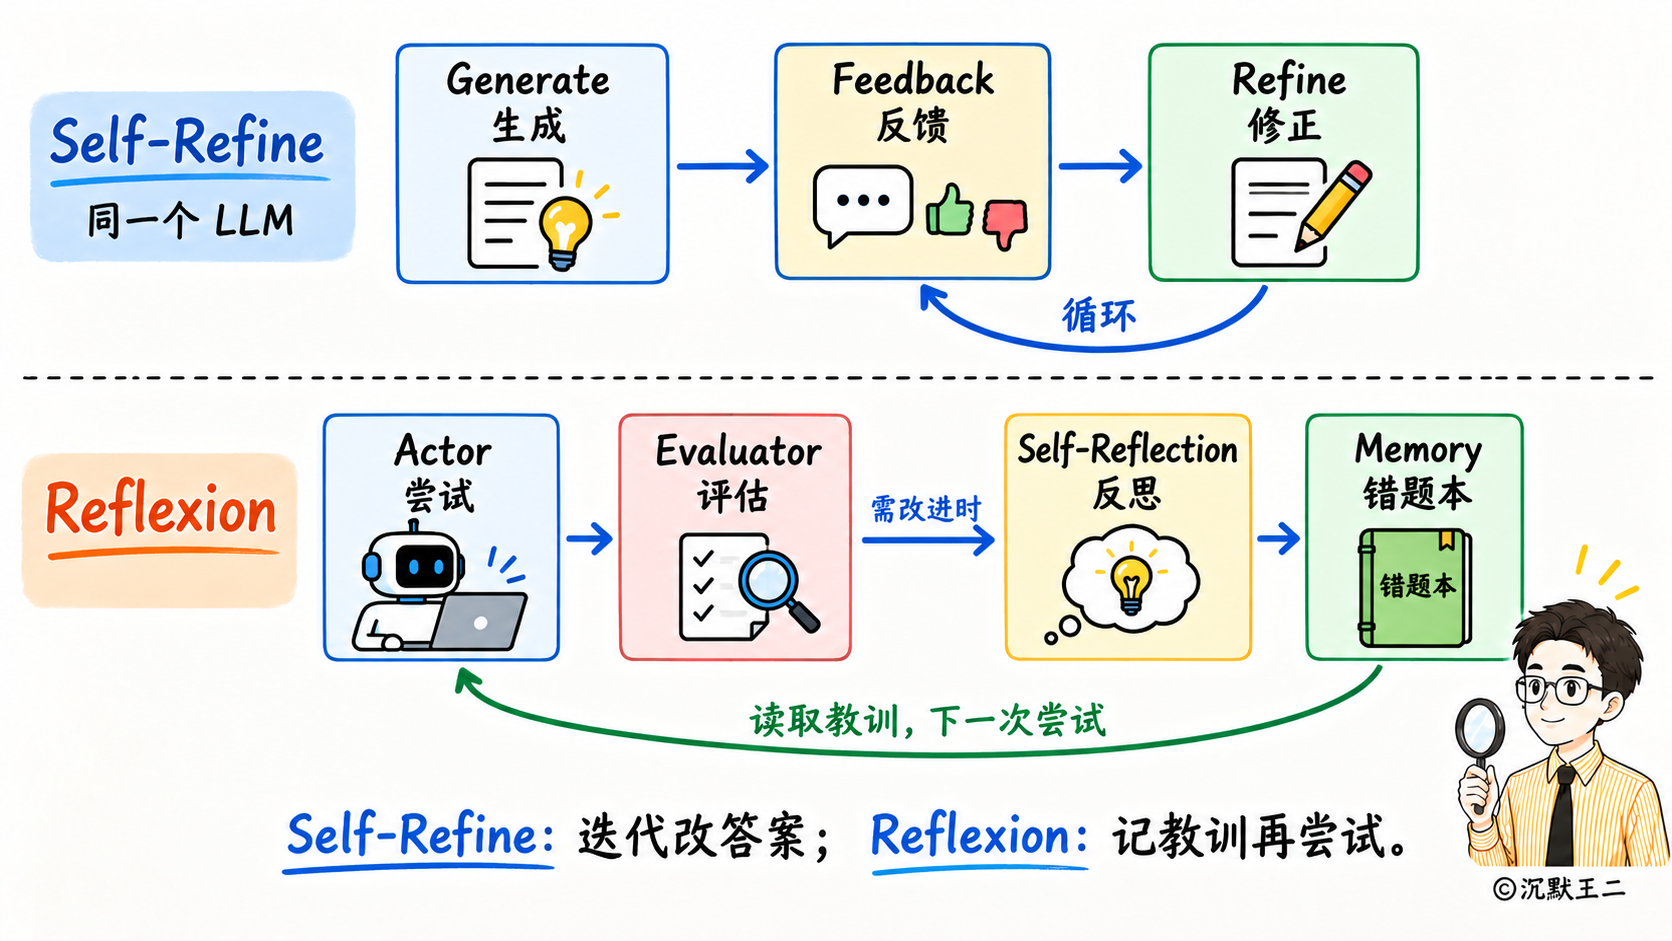
第一种叫 Self-Refine,也就是自我精炼。其核心思想是让同一个 LLM 在不借助外部工具或者人工干预的情况下,完全通过“自我反馈”和“迭代修改”来提升输出质量。
第一步 Generate,模型根据用户的 Prompt,直接生成一个初始版本的答案。第二步 Feedback,模型充当裁判,回过头来审视自己刚生成的答案,对着初稿挑毛病,给出反馈,比如“第二段 AI 味太重,去掉不是而是”。第三步 Refine,模型带着刚才自己提出的“修改意见”和“初稿”,重新生成一个优化后的版本。
还有一种做法叫 Reflexion,也就是强化反思框架。如果说 Self-Refine 是 AI 在脑子里“闭门造车”,那么 Reflexion 则是一个允许 AI 走向现实,通过“试错(Trial and Error)”并在失败中汲取教训的完整进化系统。
它的核心颠覆在于:用“教训反馈”替代传统强化学习中的“标量奖励(一般是参数权重更新)”,让 Agent 拥有跨越多次任务的“长期记忆”。
具体怎么做呢?
执行者 Actor 基于大模型构建,负责干具体的活。它不仅看眼前的任务,还会读取记忆库中积攒的“前车之鉴”,然后给出推理或者代码。
评估者 Evaluator 负责给结果打分或者判定对错,通过运行测试用例(比如编译代码看是否报错)、引入外部工具进行验证,或者基于特定规则检查执行结果是否达到了目标。
当 Evaluator 判定任务失败时,反思器 Self-Reflection 启动,它会精确分析 Actor 的“失败轨迹”和报错信息,然后写一段“反思总结”,例如“上一次我在第三步计算时忽略了分母不能为0的边界条件,导致报错,下一次应该先做判断”)。这段反思会作为“错题本”存入记忆库(Memory Buffer)。
那聪明的你肯定又要问了,两种做法有什么区别呢?
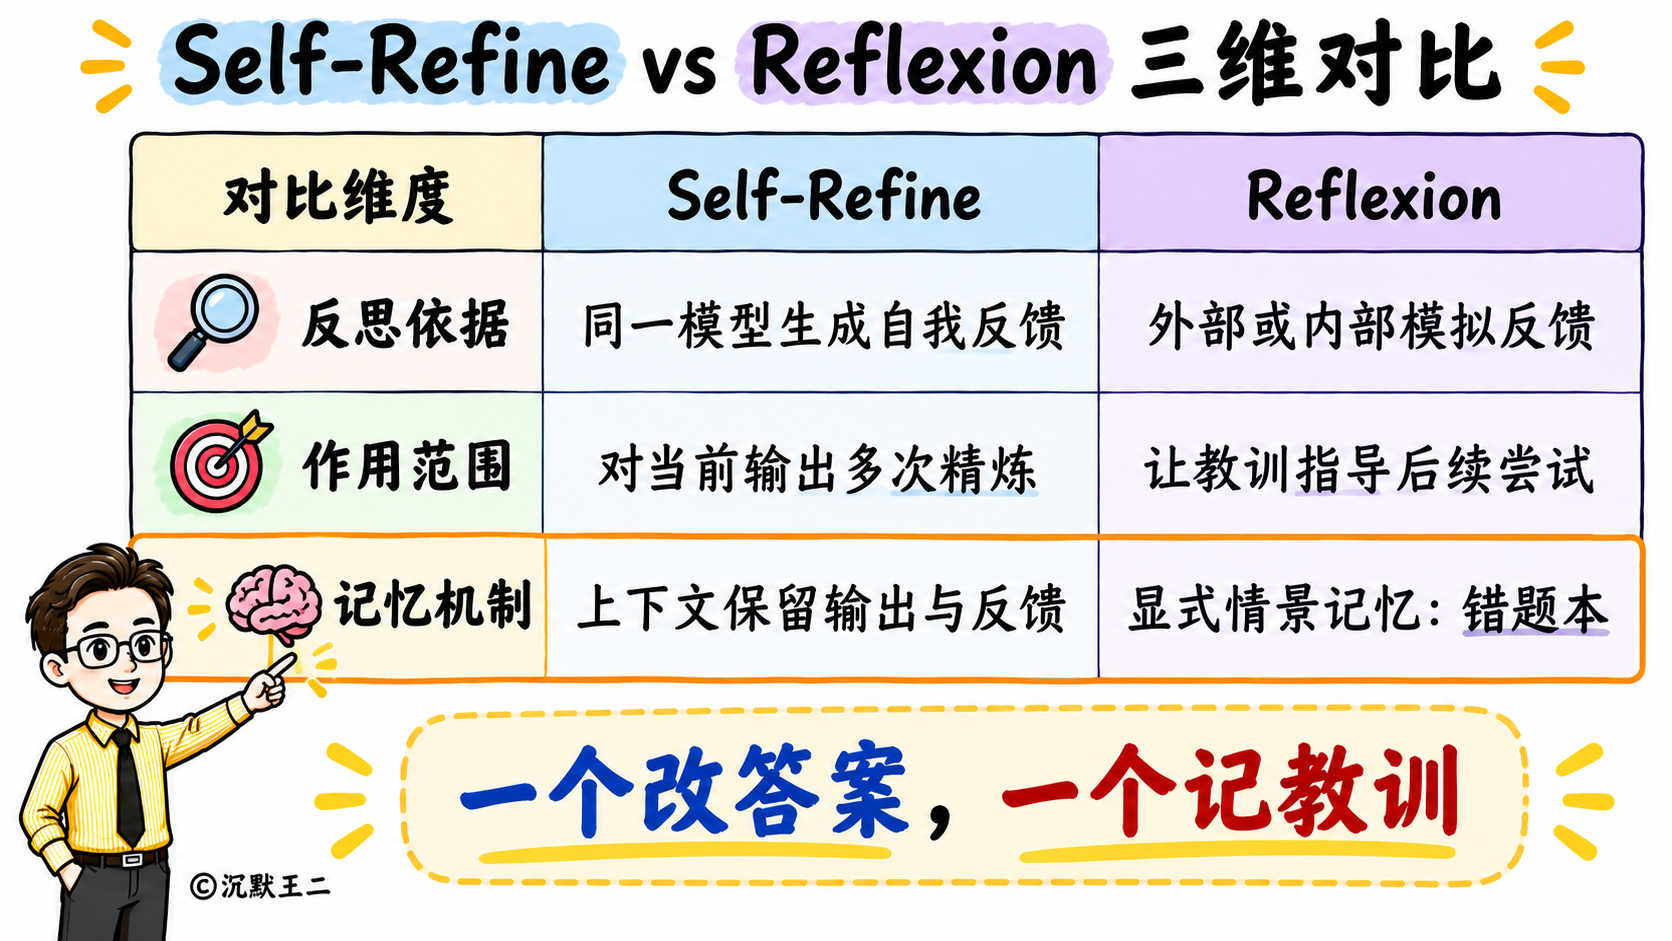
第一,依据不同。Self-Refine 的反馈完全靠模型自己,同一个 LLM 既当选手又当裁判,没有外部反馈。Reflexion 基于试错与外部反馈,可以通过在具体环境里跑一下,拿到真实的报错(Traceback)或工具反馈。
第二,作用范围不同。Self-Refine 只能在一次任务内完成所有修正,生成、反馈、修正都在同一轮对话里。Reflexion 是跨轮次的,当前任务失败后,总结的教训会存入记忆,指导下一次全新的尝试。
第三,记忆机制不同。Self-Refine 仅依赖当前的上下文窗口(Context)。Reflexion 除了可以依据当前的上下文,还有一个显式的记忆库。
最后简单总结下。
反思不是重试,核心在于有没有反馈信号。Self-Refine 靠模型自己,Reflexion 加了错题本和外部反馈。
这道题你学会了吗?想解锁更多 AI 硬核知识,点赞关注,我是二哥,咱们下期见!