
那聪明且好学的你一定会问,HySparse2 和 MiMo-V2 系列的混合滑动窗口注意力(Hybrid SWA)有什么区别?
大模型是由一层一层的 Transformer 构建起来的,每一层都要做一次注意力计算,也就是让每个 token 回头去看前面的内容,判断哪些和自己有关。MiMo-V2.6-Flash 一共 48 层 Transformer,其中 39 层是滑动窗口层,每个 token 只看自己前面最近的 128 个 token。剩下 9 层是全注意力层,需要把前面所有的内容从头到尾看一遍。
全注意力看得全,但上下文越长,计算越慢,占用的显存也越多。滑动窗口只看一小段,又快又省。所以 MiMo-V2 让大部分层用滑动窗口,只留少数几层看全局。
HySparse2 的骨架和 MiMo-V2 一样,还是 MoE(混合专家),这次改的是注意力这部分。HySparse 这个名字取自 Hybrid Sparse Attention,意思是混合稀疏注意力。HySparse2 把这一层层叠起来的结构切成了前后两段。
前半段叫 Self-Decoder,由全注意力层和滑动窗口层混合组成,这部分和 MiMo-V2 很像。
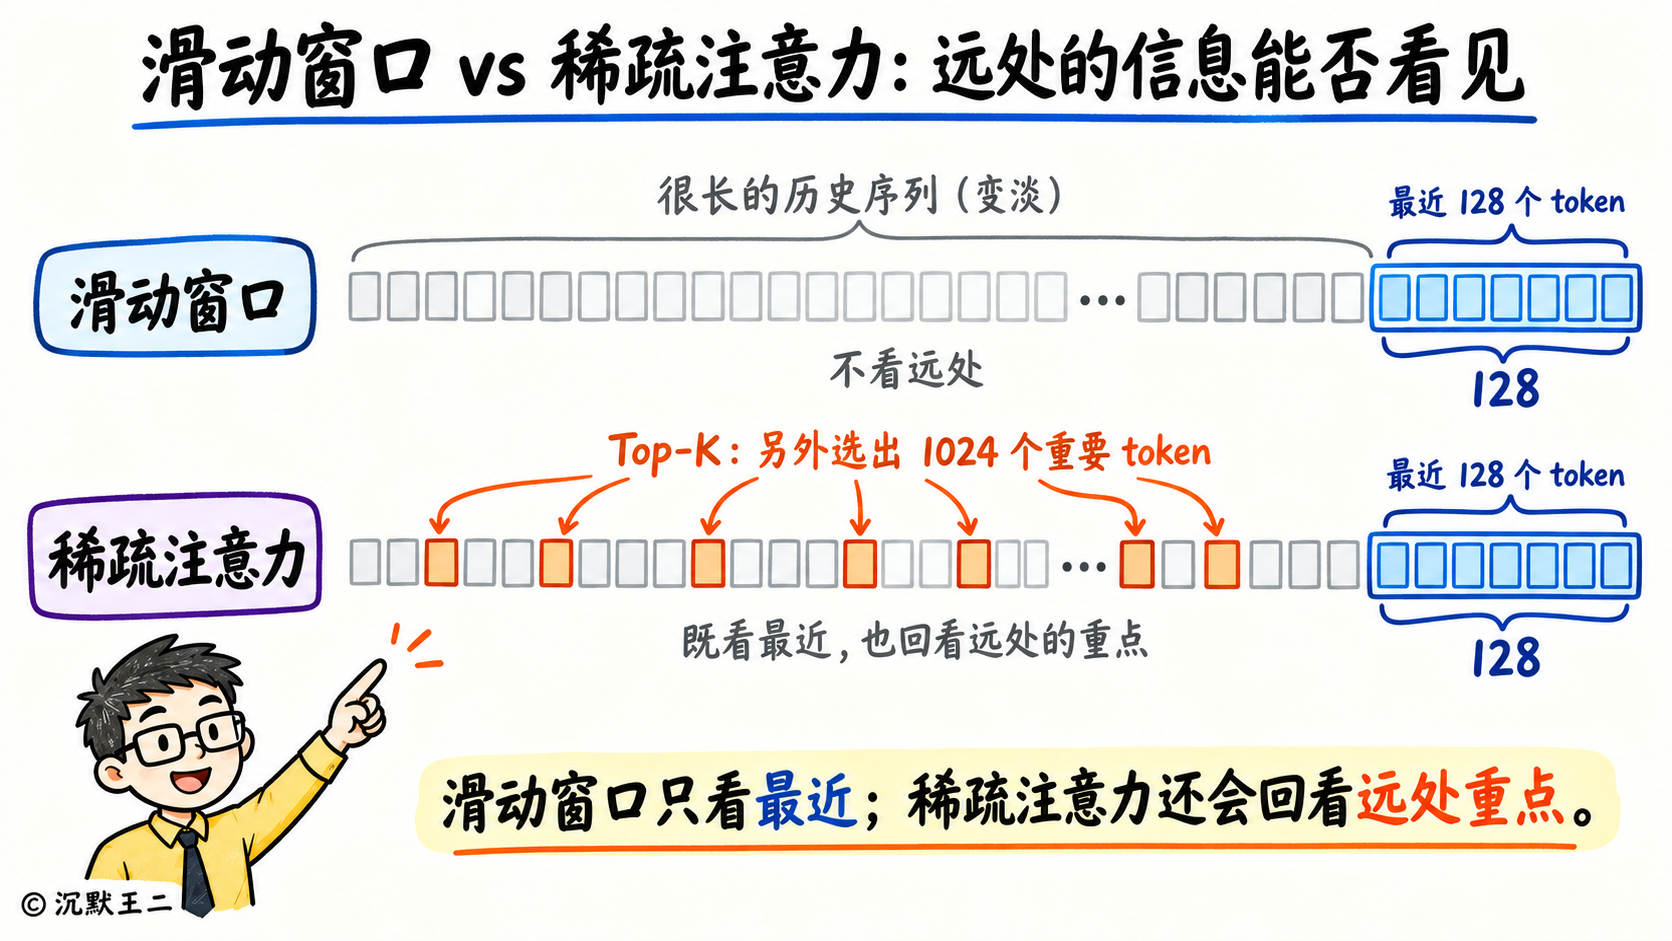
后半段叫 Cross-Decoder,由一个个小模块组成,每个小模块是一层全注意力,后面跟着几层稀疏注意力。稀疏注意力既不像滑动窗口那样只看眼前,也不像全注意力那样全都看。它除了看最近的 128 个 token,还会从整段上下文里挑出最重要的一批 token 来看。
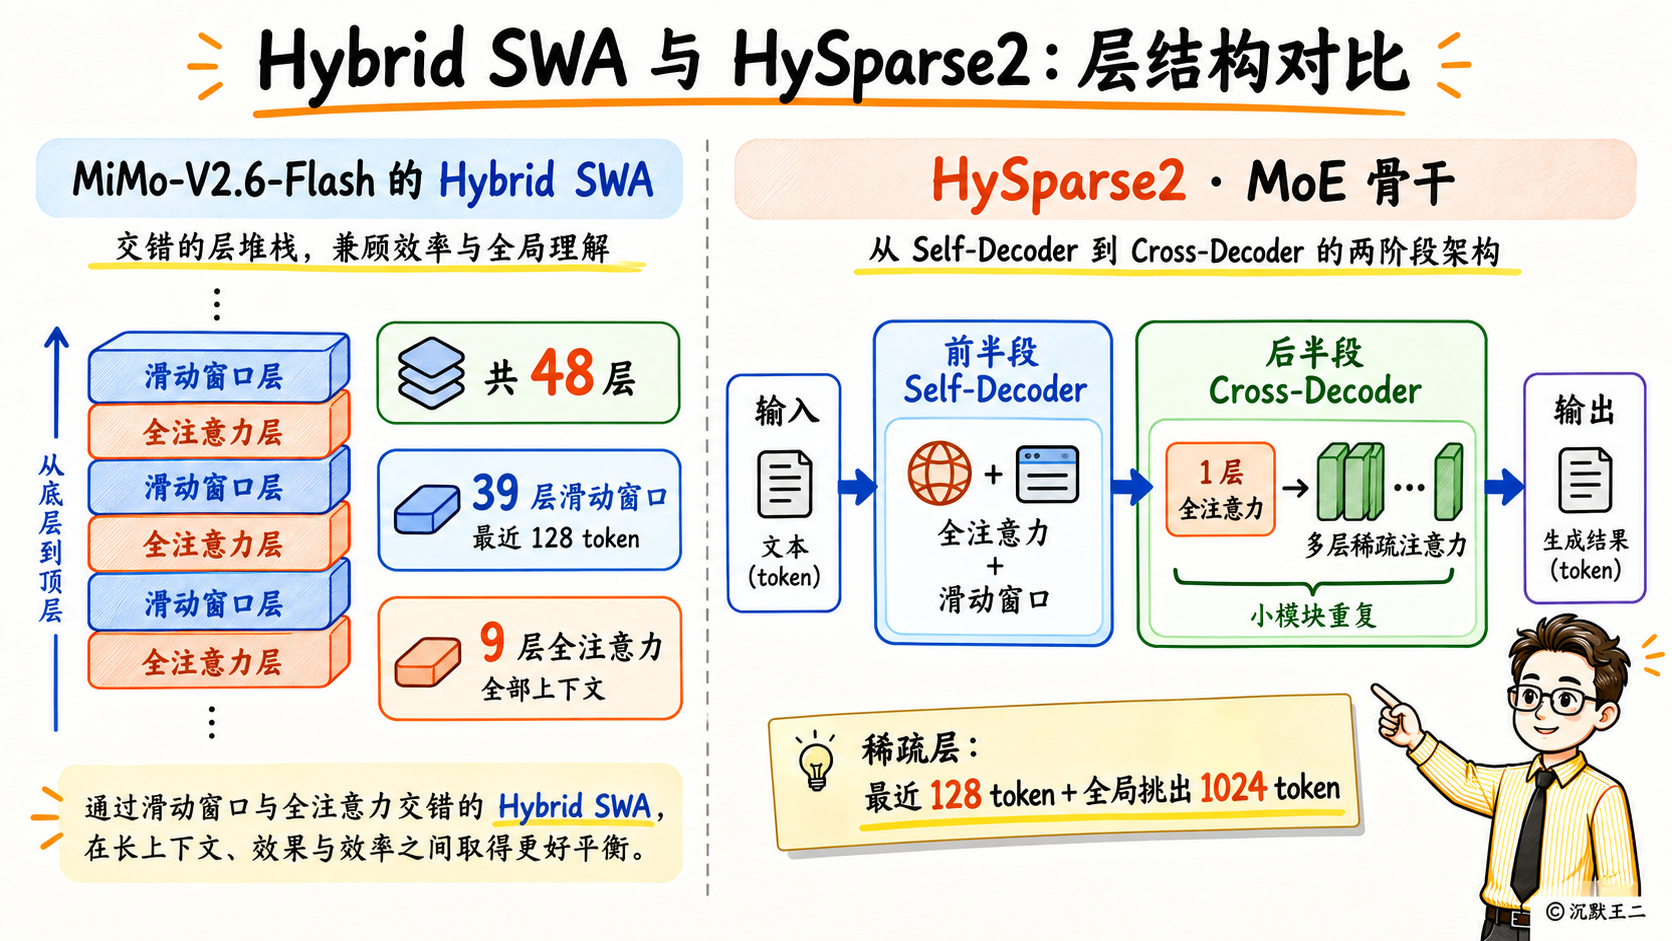
也就是说,MiMo-V2 从头到尾都是滑动窗口加全注意力,HySparse2 把后半段的滑动窗口层换成了稀疏注意力,既看眼前,也能回头翻重点。
那聪明的你肯定想到了:把模型切成前后两段,到底图什么?
图的是 Prefill(预填充)。模型在输出之前,要先把你塞进去的输入从头读一遍,把每一层的 KV Cache 建好,这一步就是 Prefill。KV Cache 存的是每个 token 在每一层算出来的 K 和 V,可以理解成模型为读过的内容留下了一份笔记,后面每生成一个 token,都要回头去查它。Agent 每调用一次工具,返回的日志、网页内容都要先走一遍 Prefill,输入越长,这一步越慢,KV Cache 也越占显存。
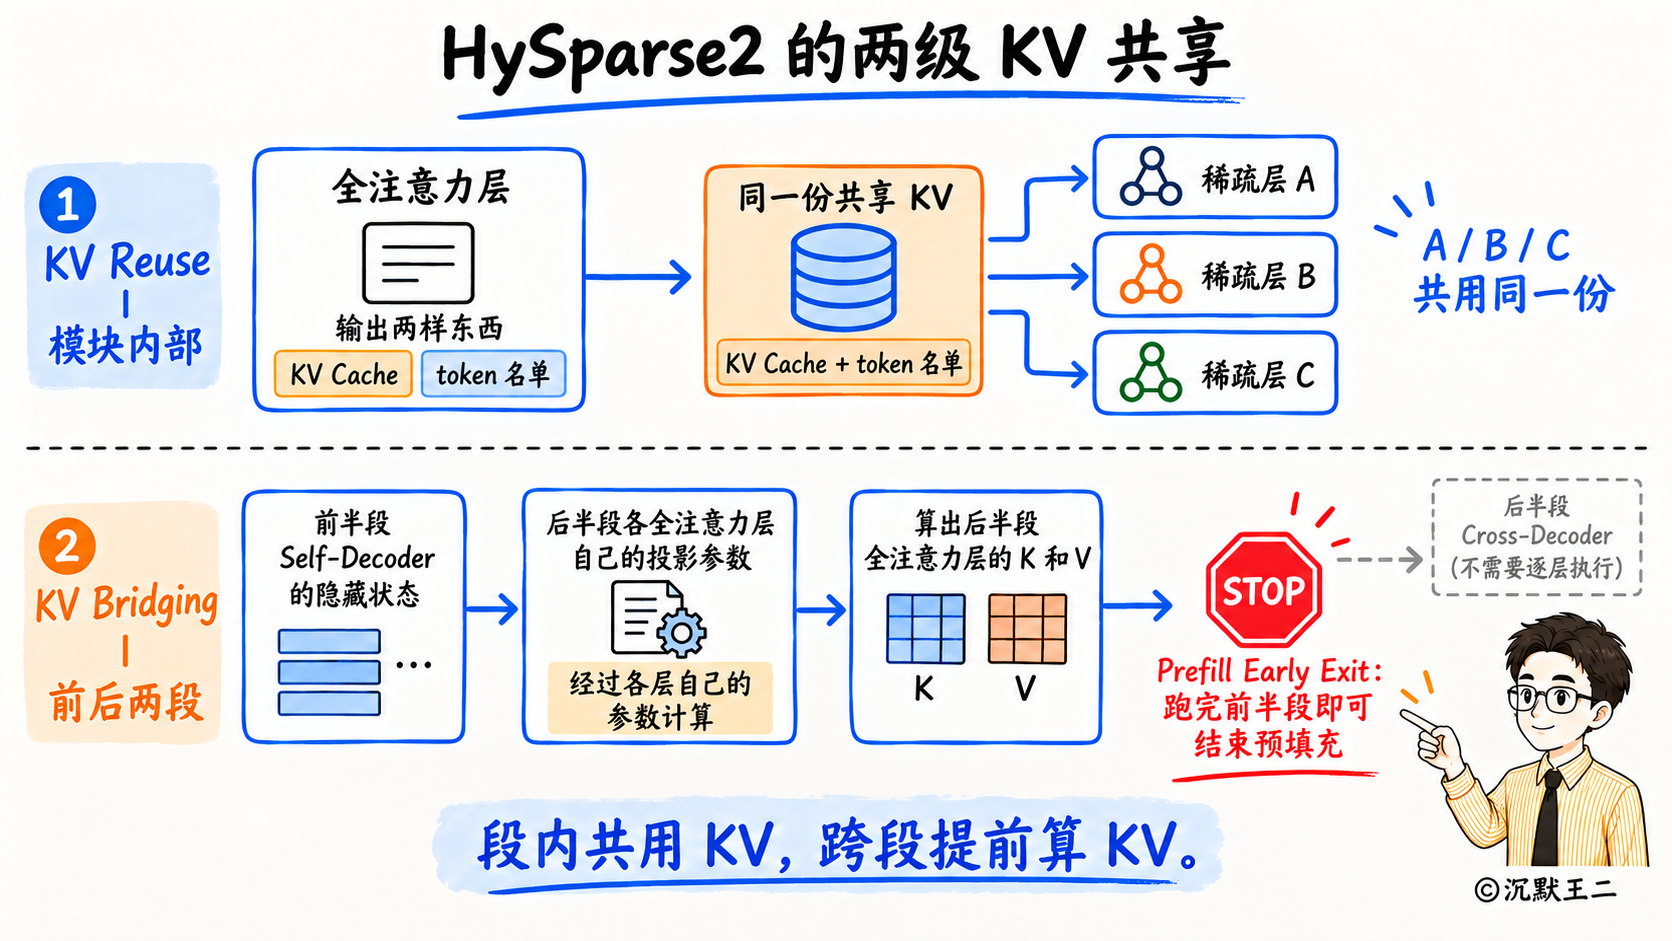
HySparse2 的办法是两级 KV 共享,一级在后半段的小模块内部,另一级跨越前后两段。
先看小模块内部,这一级叫 KV Reuse,段内复用。后半段每个小模块里,稀疏注意力层直接复用本模块全注意力层的 KV Cache,以及全注意力层挑出来的 token 名单,自己不计算、也不保存 KV Cache。这样一来,后半段真正需要 KV Cache 的,只剩下那几层全注意力层。
再看跨越前后两段的这一级,叫 KV Bridging,跨段桥接。正常情况下,每一层的 K 和 V 都要用这一层自己的输入来计算。KV Bridging 让后半段的全注意力层不用自己那一层的输入,而是直接用前半段某一层全注意力层的隐藏状态来计算 K 和 V。隐藏状态可以理解成模型读到这一层时,对每个 token 的理解。后半段的每一层全注意力层都有自己的一套参数,把这份理解转换成自己要用的 K 和 V。
两级共享合在一起,Prefill 就能提前结束。后半段的稀疏层不存 KV Cache,后半段全注意力层的 K 和 V 又都能从前半段直接算出来。所以工具返回的一大段日志进来后,只要跑完前半段,整个模型需要的 KV Cache 就齐了,不用再一层一层地穿过后半段。
小米 9 月 22 日在 arXiv 上发布了论文《HySparse2: Hybrid Sparse Attention with Two-Level KV Sharing》。大规模部署时,可以把 Prefill 和生成回答分开放在不同的机器上。论文里 49 层的模型,负责 Prefill 的机器只需要部署前 25 层,显存需求接近减半。
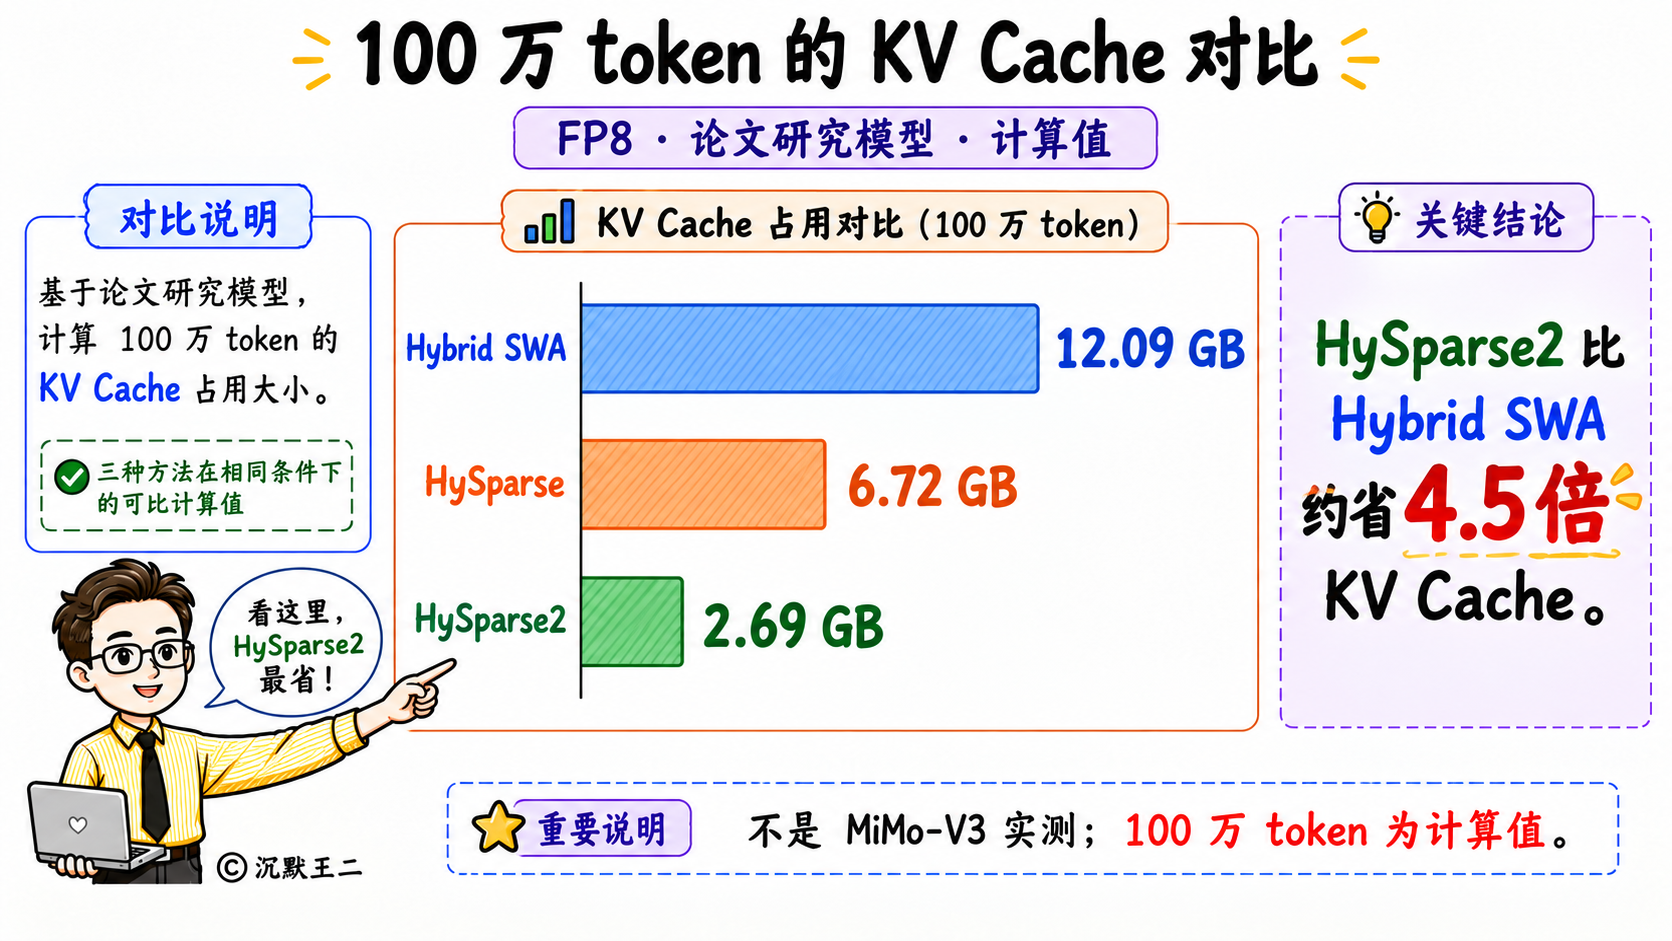
前面说的两个麻烦,Prefill 慢和 KV Cache 占显存,就都得到了缓解。论文用一个总参数 800 亿、每处理一个 token 只激活其中 30 亿参数的 MoE 模型做了测算,条件是 100 万 token 上下文、FP8 精度。KV Cache 方面,HySparse2 是 2.69GB,同样规模的 Hybrid SWA 是 12.09GB,HySparse2 少了将近八成,上一代 HySparse 是 6.72GB。Prefill 的计算量方面,HySparse2 只有 Hybrid SWA 的约五分之一,也比上一代少了约三分之二。
注意,这是论文里的研究模型,不是 MiMo-V3 本身,MiMo-V3 还没有发布。
那聪明的你肯定又要问了:几十轮工具调用攒下的记录里,它怎么准确找回那一条关键线索?
和上一代 HySparse 比,改了两处。
第一处,挑选的粒度变细了。上一代 HySparse 以 64 个 token 为一块,整块整块地挑。关键线索可能只有一行,却要连带着周围几十个不相关的 token 一起占掉挑选名额。HySparse2 改成一个 token 一个 token 地挑,比如从全局挑出 1024 个。挑选的依据和上一代一样,来自全注意力层的注意力分数,也就是当前 token 和前面每个 token 的相关程度。全注意力层本来就要把所有 token 算一遍,谁最重要,它给出的分数最准确。
第二处,局部窗口合并进来了。上一代的稀疏层外挂了一个单独的滑动窗口分支,专门看最近的 128 个 token。这个分支要用后半段自己算出来的结果,Prefill 就不得不把后半段也跑一遍。HySparse2 把这个分支取消了,改成挑选时强制保留最近的 128 个 token,最近的上下文和远处的关键线索读的是同一份 KV Cache。前面讲的 Prefill 提前结束,就是建立在这个基础上。
当然了,这一处是有代价的。MRCR-v2 考的是在很长的多轮对话里找回指定内容的能力,论文的实验里,和保留单独的滑动窗口分支相比,MRCR-v2 低了约 5 分,小米认为这个代价可以接受。
RULER-v2 考的是模型在长文本里找信息的能力。单看按 token 挑选这一项,论文的对照实验里,RULER-v2 从 49.56 提高到了 56.13。放到整个架构上看,HySparse2 的 RULER-v2 平均分比 Hybrid SWA 高 18.65 分,比上一代高 19.81 分;MRCR-v2 平均分比 Hybrid SWA 高 6.44 分,比上一代高 11.30 分。
最后简单总结下。
HySparse2 把模型切成了前后两段,用两级 KV 共享让 Prefill 只跑前半段、稀疏层不存 KV Cache,再用 token 级挑选把关键线索找出来。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!