
在大家拼命卷输入上下文的时候,Gemini 4 在输出上发了大力,单次响应支持 100 万 Output Tokens,要知道,GPT-6 Astra 和 Opus 5.5 还只有 128K。
在官方披露的案例中,Argon 接手视频解码器 libgav1 现成的 Rust 移植版后,把其中 32000 行的 SIMD(单指令多数据)进行了代码优化,替换成内存更安全的 Rust 代码,改完之后视频输出完全一致,运行速度比原来的 Rust 移植版快了 2.7 倍。
同时,安全公司 Wiz 用 Argon 在医疗软件里找到了一个会泄露患者敏感个人信息的高危漏洞,此前的前沿模型都没有发现它。
那聪明的你肯定要问,为什么行业普遍聚焦于扩展输入窗口,Gemini 偏偏要把单次输出做大到 100 万?它和刚刚发布的 GPT-6 Astra、Opus 5.5 相比,到底谁更胜一筹?
我翻了 Google DeepMind 的官方发布说明、Koray Kavukcuoglu 的技术长文,以及 Vals AI 和 DeepSWE 最新的评测白皮书,可以自信地、大方地、光明磊落地帮你搞清楚这三件事:
- 什么是 Gemini 4 Argon?为什么单次 100 万输出是工程上的关键分水岭?
- Gemini 4 Argon 凭什么能在编程与安全实测中拔得头筹?
- 作为开发者,我们啥时候才能用上?
哈喽大家好,我是二哥呀。今天用 3 分钟,给你讲清楚刚刚发布的 Gemini 4 Argon 到底带来了什么。
先说第一件,100 万输出意味着什么?
很多人会觉得,输入上下文给到一百万就够用了,输出也搞 100 万有什么用?
其实,输出比输入难做得多。
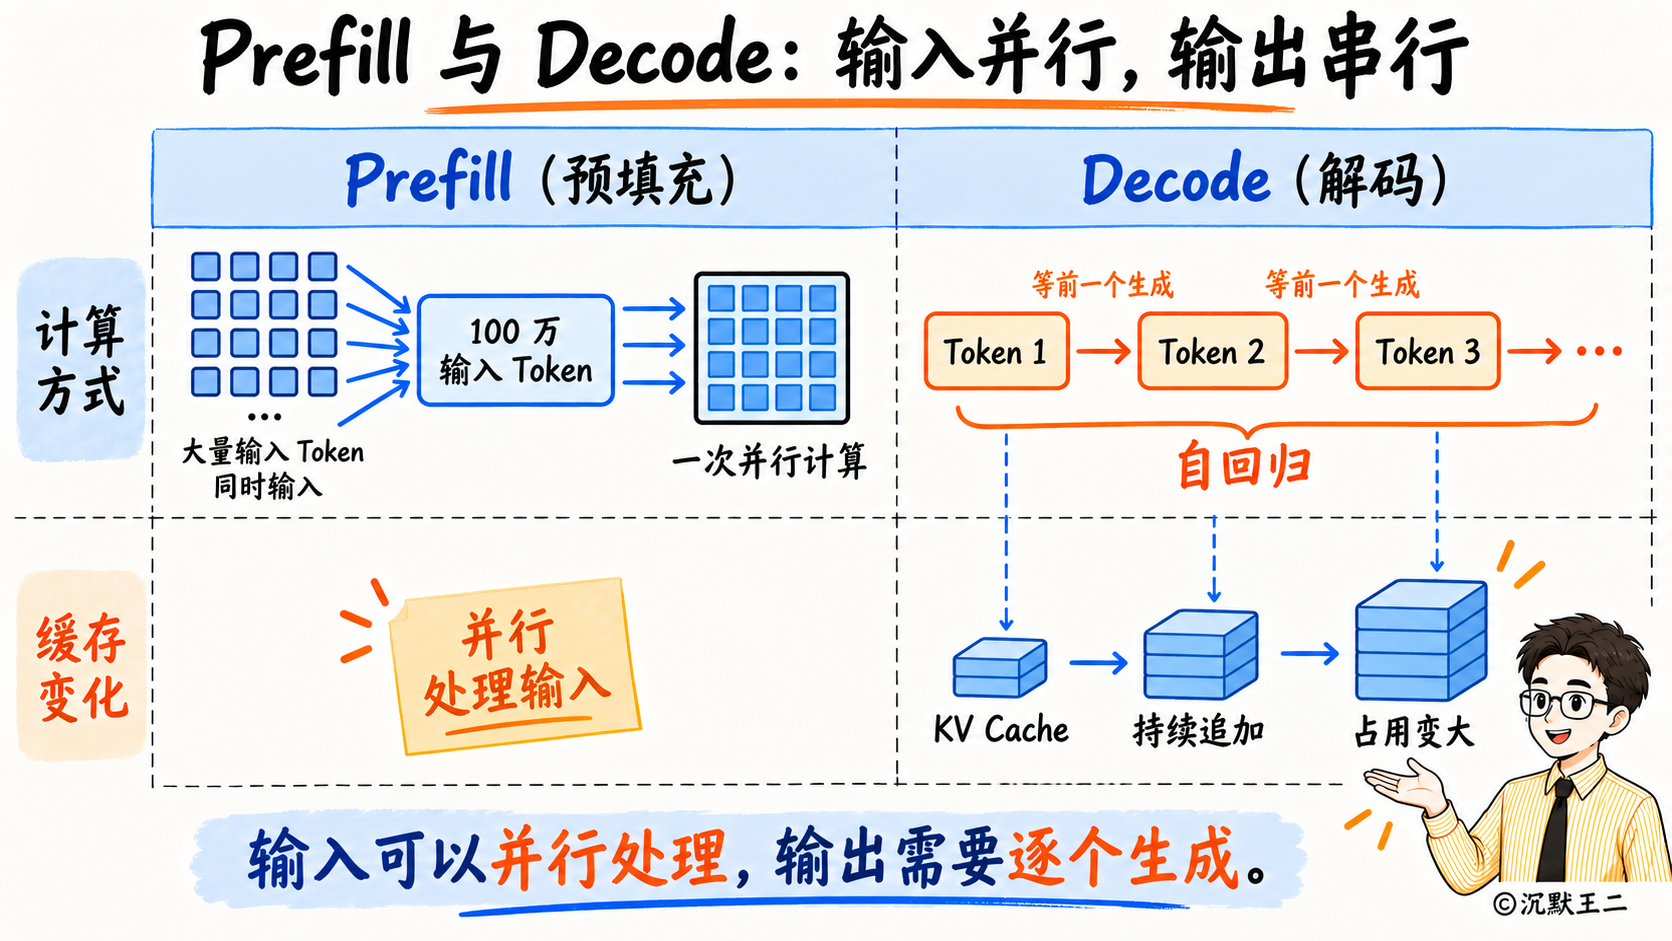
模型处理输入的阶段叫 Prefill(预填充),100 万个 Token 可以一次性并行计算,TPU 和 GPU 最擅长这种大批量的矩阵运算。
生成输出的阶段叫 Decode(解码),是自回归的。每生成一个 Token,都要把整个模型完整地跑一遍前向计算,第二个 Token 必须等第一个 Token 出来才能开始。100 万输出,就是串行地跑 100 万次前向计算。
这还没完。每生成一个 Token,它的 Key 和 Value 向量都要存进 KV Cache,供后面的每一个 Token 做注意力计算。输出越长,KV Cache 占用的显存越大,每一步要读取的数据也越多,越往后生成得越慢。
训练端同样有门槛。清华大学和智谱发表的 LongWriter 论文中发现,模型能稳定写出的长度,受限于监督微调数据里见过的最长输出。
所以在 Argon 之前,GPT-6 Astra 和 Opus 5.5 也只有 128K 输出上限。
这意味着当一个 Agent 尝试重构大型工程、推演深度思维链时,或者生成几十个关联文件的完整测试集时,一旦输出超过上限,调用过程就会被强行切断。为了把剩下的内容补齐,架构中必须引入繁琐的分段机制,把中间生成的内容重新塞回下一轮的输入里进行拼接。
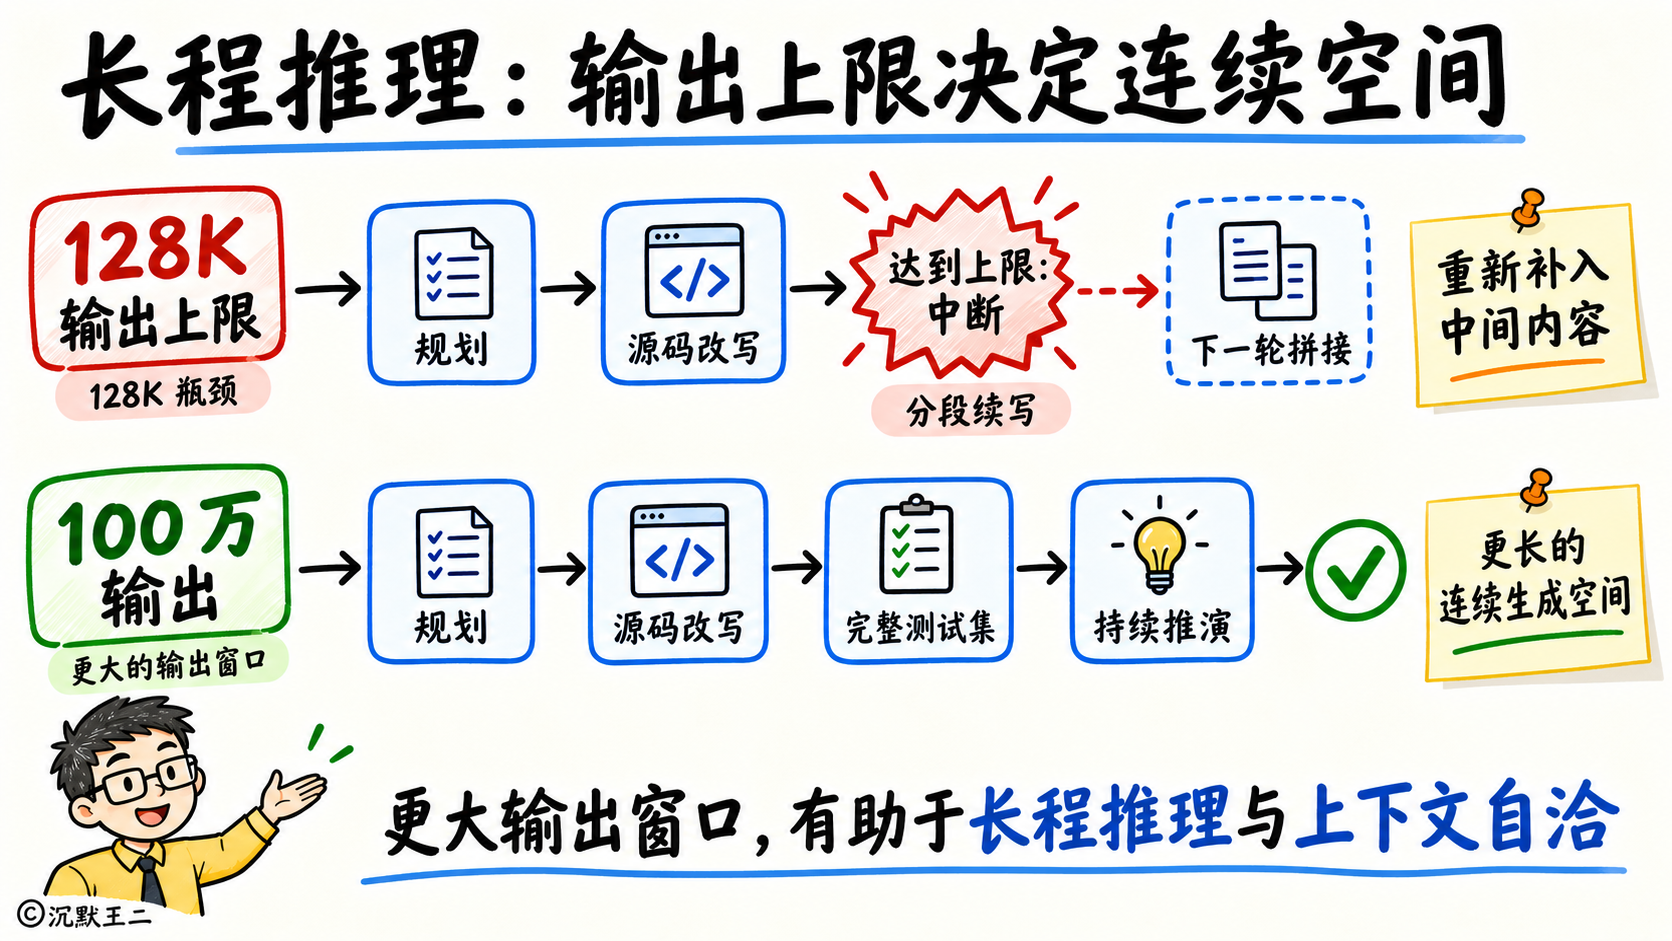
这种处理方式极易丢失上下文状态,只要中间某一步出现幻觉,后续的所有代码都会跟着全盘跑偏。
Gemini 4 Argon 将单次输出拉升到 100 万 Token,让模型能在单次连续的执行轨迹中,完整容纳自主反思、规划、全套源码改写与工具调用记录,不需要被频繁打断,从而在极长的推演中保持逻辑自洽。
那聪明的你肯定要质疑:Argon 真有说的那么强?
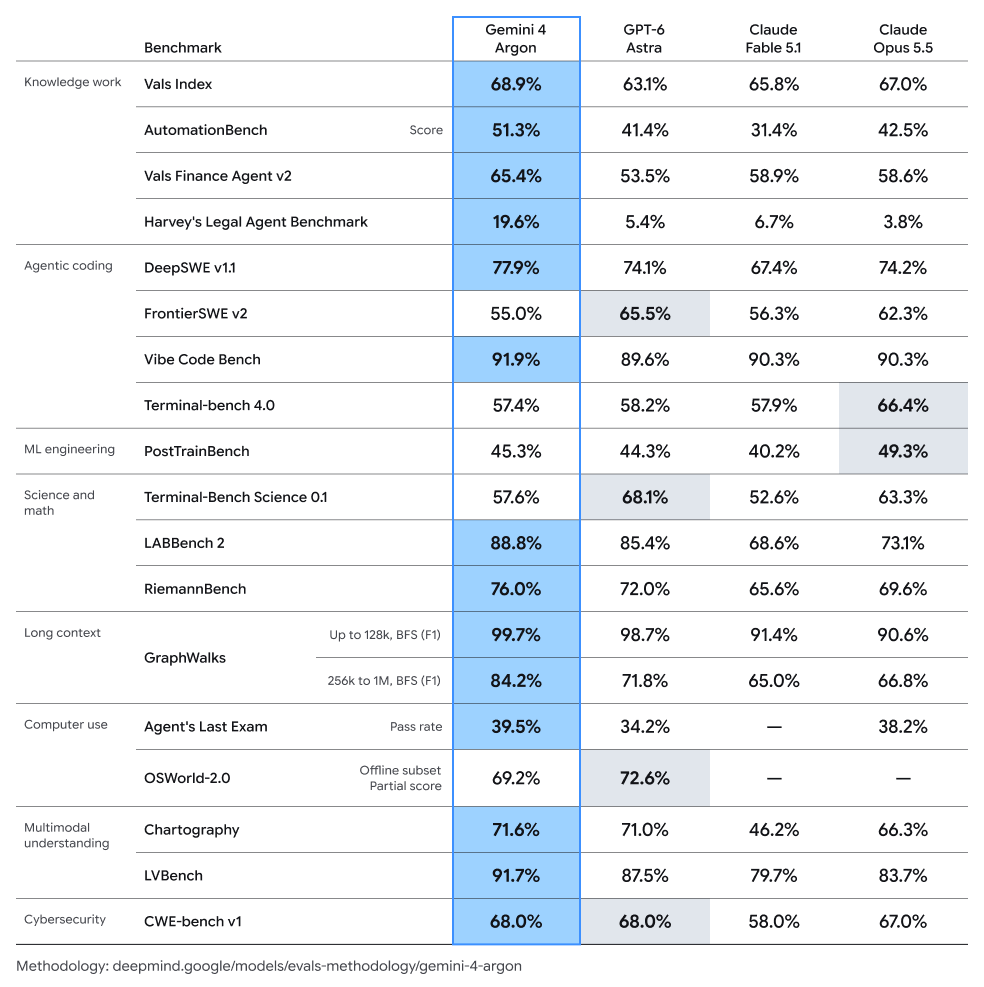
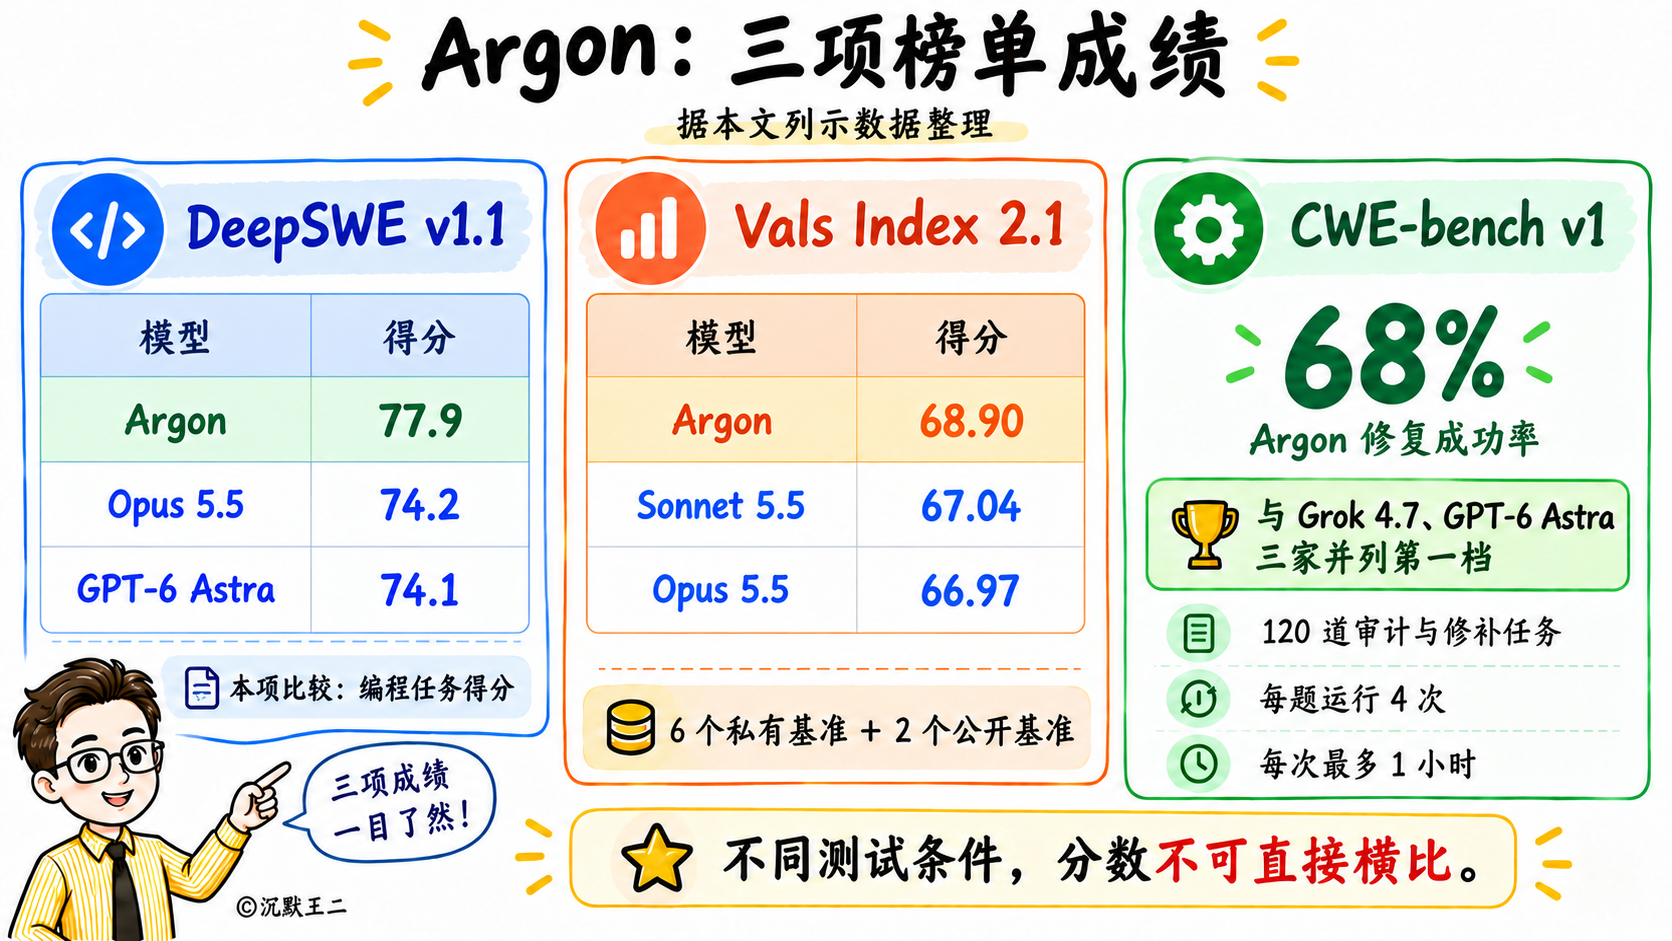
在 DeepSWE v1.1 基准测试中,Argon 跑出 77.9,超过了 Opus 5.5 的 74.2 与 GPT-6 Astra 的 74.1。
在第三方机构 Vals AI 的 Vals Index 2.1 榜单上,Argon 以 68.90 的成绩在 41 个系统里排名第一,第二名是 Sonnet 5.5 的 67.04,Opus 5.5 是 66.97。这份榜单由 6 个私有基准和 2 个公开基准组成,私有部分的题目不对外公开,模型没法提前刷题。
在 Collinear AI 推出的网络安全测试 CWE-bench v1 中,Argon 的修复成功率是 68%,和 Grok 4.7、GPT-6 Astra 三家并列第一档。这个测试有 120 道审计加修补任务,题目里不告诉模型漏洞是什么、有几个,每道题跑 4 次,每次最多 1 小时。
黑盒渗透测试则是 Argon 模型本身的能力。只给它一个正在运行的网站,不给源码,它就能自己完成渗透测试。在 Wiz 的渗透测试基准上,Argon 得分 70.9。
但光能发现漏洞还不够,更关键的是怎么把漏洞给安全地修补好。DeepMind 为此专门打造了代码安全 Agent——CodeMender。它把 Argon 的深度推理能力与传统程序分析工具结合在一起,分三步工作:第一步 Scan,扫描代码找出疑似漏洞;第二步 Verify,在隔离沙盒里自动构造并运行 PoC(概念验证)攻击代码,确认漏洞真的能被利用,避免误报;第三步 Remediate,自动生成修复补丁,再由另外一个大模型担任评审,检查补丁有没有破坏原有功能,最后交由开发者人工审批。
从黑盒渗透发现隐患,到自动验证并生成补丁,Argon 真正把能力延伸到了高难度的生产级安全攻防上。
那聪明的你肯定又要问了:这么厉害的模型,我们普通开发者现在到底能不能用上?
答案是:目前还不能。
官方给出的理由是,这个级别的前沿能力,必须分阶段放出来才安全。
第一批用上 Argon 的是 Fairwind 计划的合作方。
下一步才会开放给付费 API 客户和 AI Ultra 订阅用户。不过价格已经公布,首发优惠期输入每百万 Token 2 刀,输出每百万 Token 10 刀;优惠期结束后,输入涨到 4 刀,输出涨到 20 刀。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!