
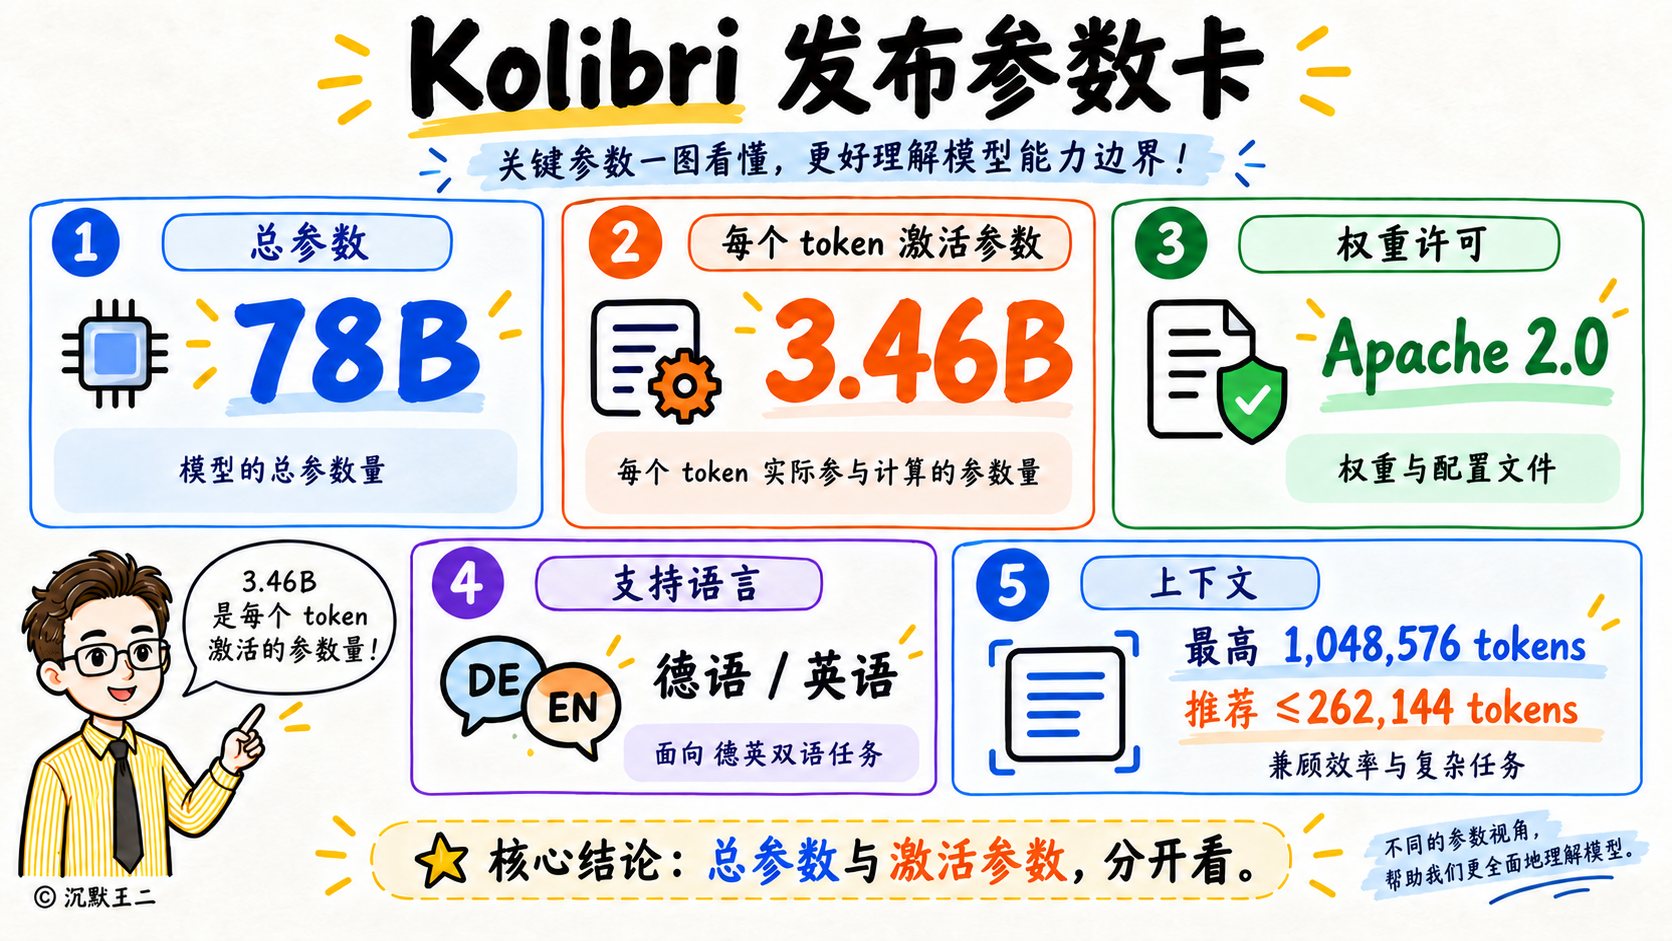
总参数 78B,每次只激活 3.46B,权重按 Apache 2.0 协议开源。官方在技术报告里强调,后训练合成阶段的数据主要来源于智谱的 GLM-5.3 和阿里的 Qwen3.8!
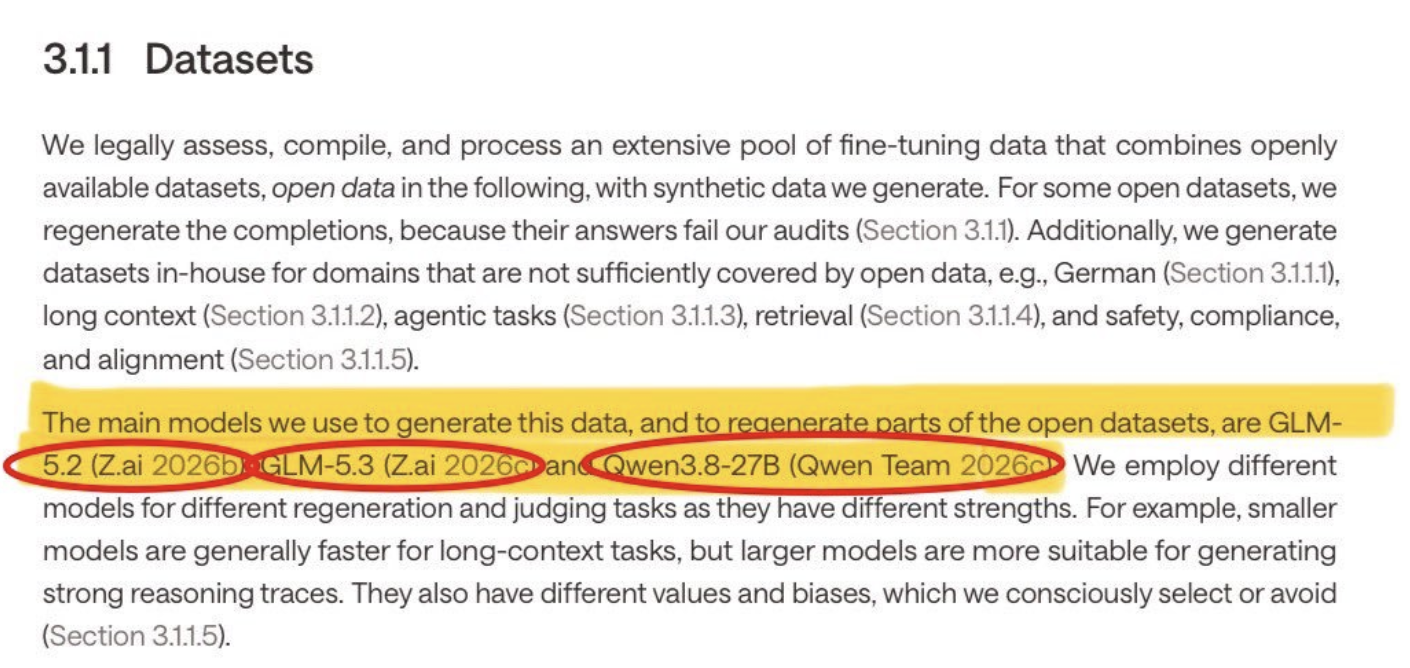
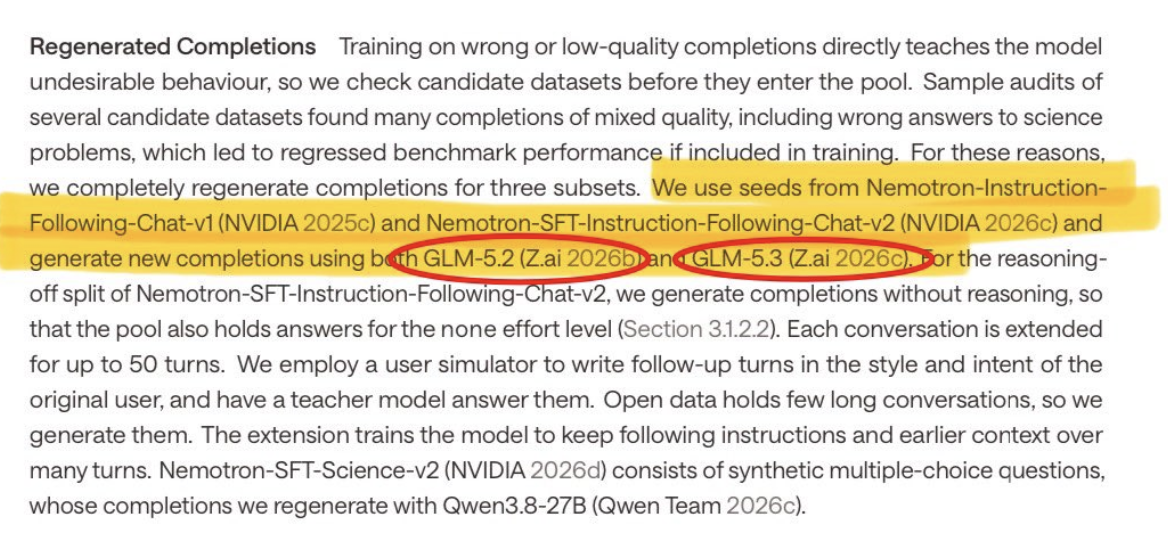
比如 Nemotron 指令跟随数据集的 completions,直接用 GLM-5.2 和 GLM-5.3 重新生成;Nemotron 科学选择题的completions,用 Qwen3.8-27B 重写。
我想,此刻应该给我们的国模送上一点点掌声。
这里解释一下,Nemotron 是由全球算力霸主英伟达开发的一系列先进的开源 AI 大模型、数据集和技术生态的集合。
恭喜看到这里的你,已经成功击败 30% 的学习者,给自己点个赞吧。
接下来我问你,一个只激活 3.46B 参数的模型,英文和德文的综合跑分却在同类 MoE 模型里排第一,凭什么?
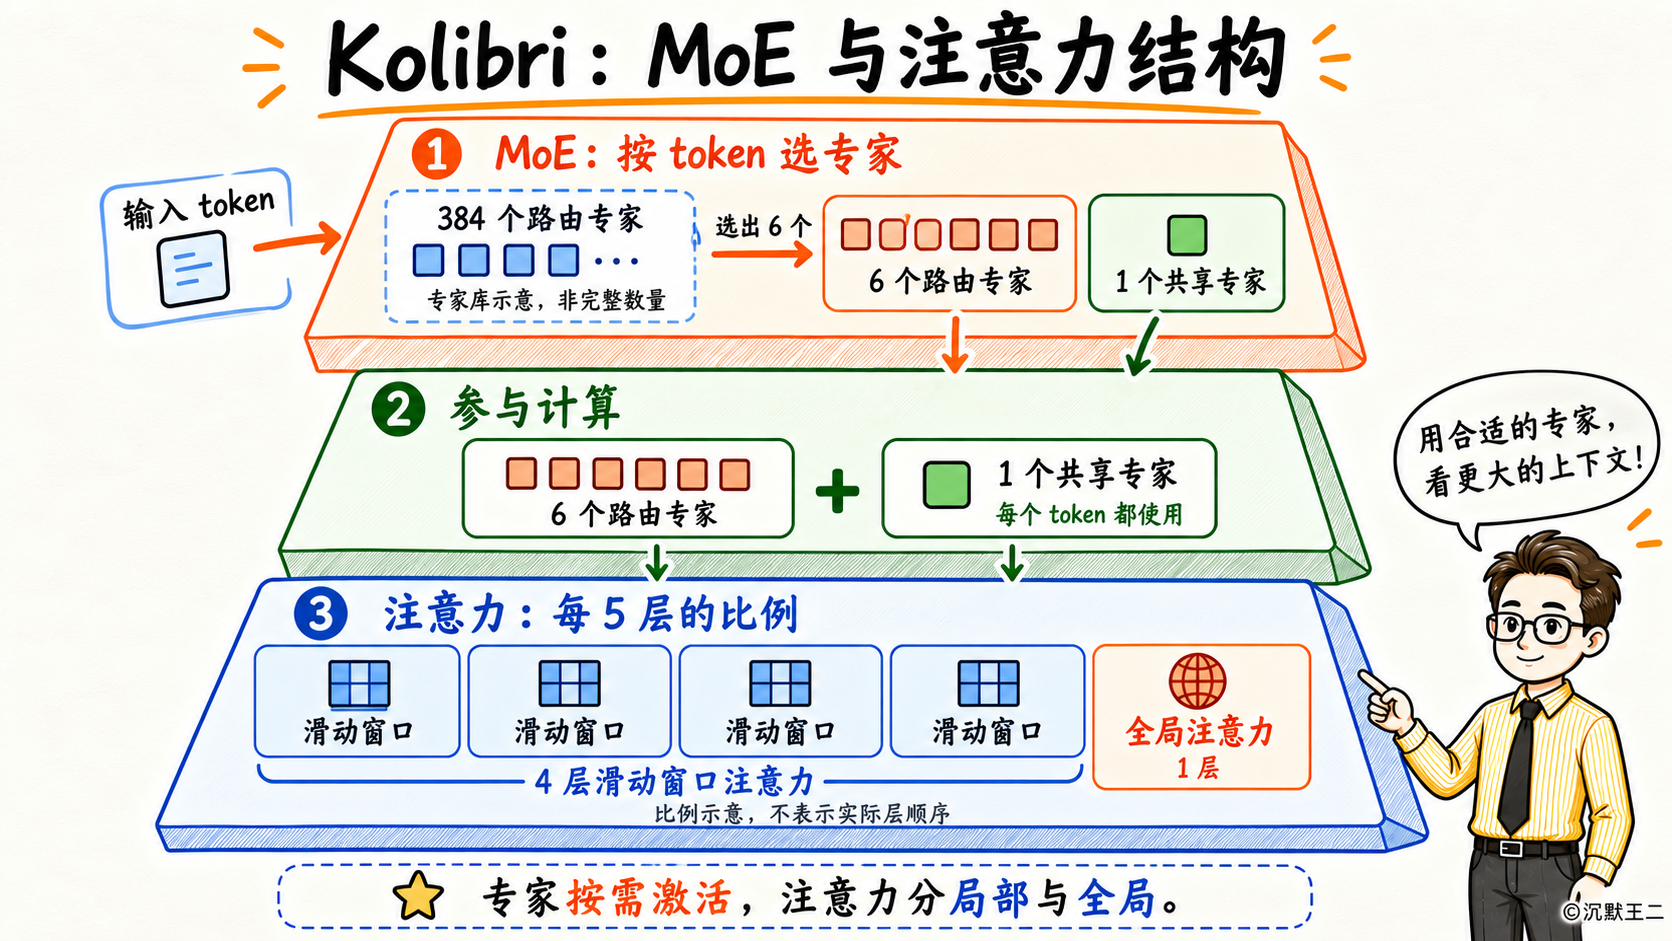
说说我的答案。Kolibri 是一个 MoE 架构模型。MoE,也就是 Mixture of Experts,翻译过来就是混合专家,它改变了传统模型“所有计算都激活全部参数(稠密模型)”的做法,采用条件计算,每次只动态激活一小部分最适配的“专家”,来处理特定的输入任务。
Kolibri 的每一层有 384 个专家,每个 token 会选出 6 个,再加上 1 个所有 token 都会用到的共享专家。78B 的总参数,每次真正参与计算的只有 3.46B。每生成一个 token 的计算量接近一个 3B 级别的模型。
注意力层也做了处理。Kolibri 的每 5 层注意力里,有 4 层是滑动窗口注意力,每个 token 只看前面 512 个 token,剩下 1 层才看全部的上下文。这样做的好处是,上下文拉长以后,大部分层的 KV Cache 是固定的,不会跟着上下文一起增长。
Kolibri 目前只支持德语和英语。部署的话,FP8 权重大约 78GB,2 张 H100 就能跑起来。
这里解释一下,FP8 权重是指在大语言模型(如 DeepSeek)中,使用 8 位浮点数格式来存储和计算模型的参数。
恭喜看到这里的你,已经成功击败 50% 的学习者了,给自己点个收藏吧。
接下来继续问你,Kolibri 是怎么训练出来的?
我翻了 Kolibri 模型近 200 页的技术报告,可以自信地、大方地、光明磊落地帮你搞清楚这件事。
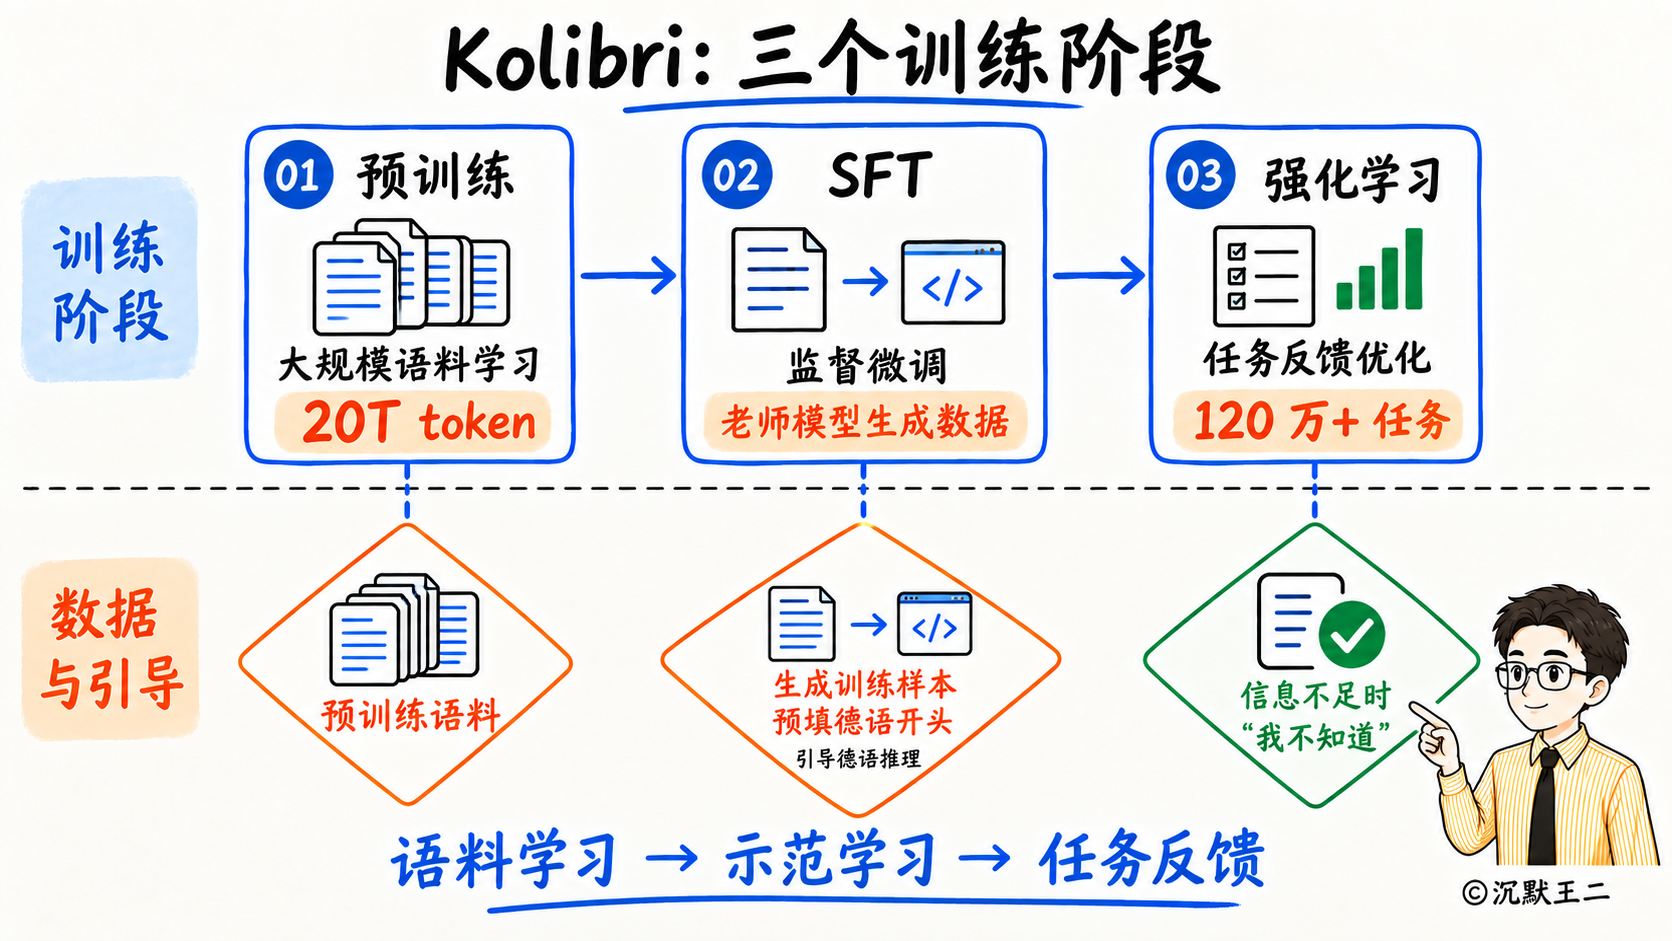
预训练用了 20T token,在 768 张 B200 上跑了 21 天,其中有一份 Aleph Alpha 自己从互联网上清洗出来的德语数据集,有 2.4T token。
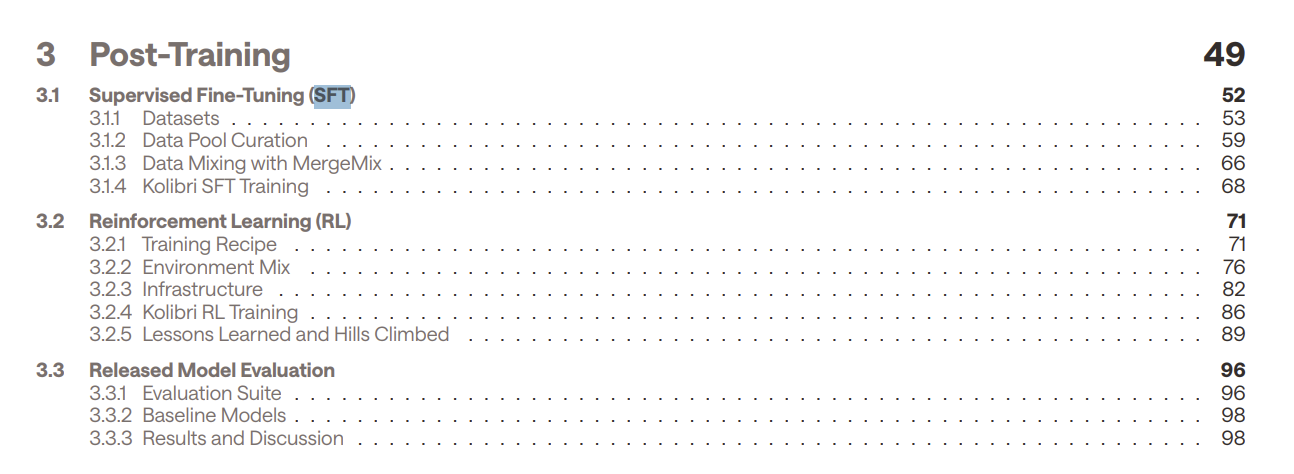
后训练阶段用的是 SFT,也就是监督微调,数据主要由 GLM-5.3、Qwen3.8 这些开源模型生成,国模当老师,Kolibri 当学生。
这里有个细节很有意思。如果仅在系统提示词中要求模型使用德语思考,Kolibri 在推理过程中全程保持德语语境的概率只有 67%。而 Aleph Alpha 的做法是在模型生成推理前,直接预填充(Prefill)一句德语作为引导,这个比例就能大幅提升至 97%。
SFT 之后,Kolibri 又在 120 万个任务上做了强化学习。其中有一类任务,专门用来训练它在上下文信息不够的时候,回答“我不知道”,而不是生编硬造一个答案。
恭喜看到这里的你,成功击败 70% 的学习者了,给自己点个推荐吧。
继续问你,Kolibri 真有说的那么强?
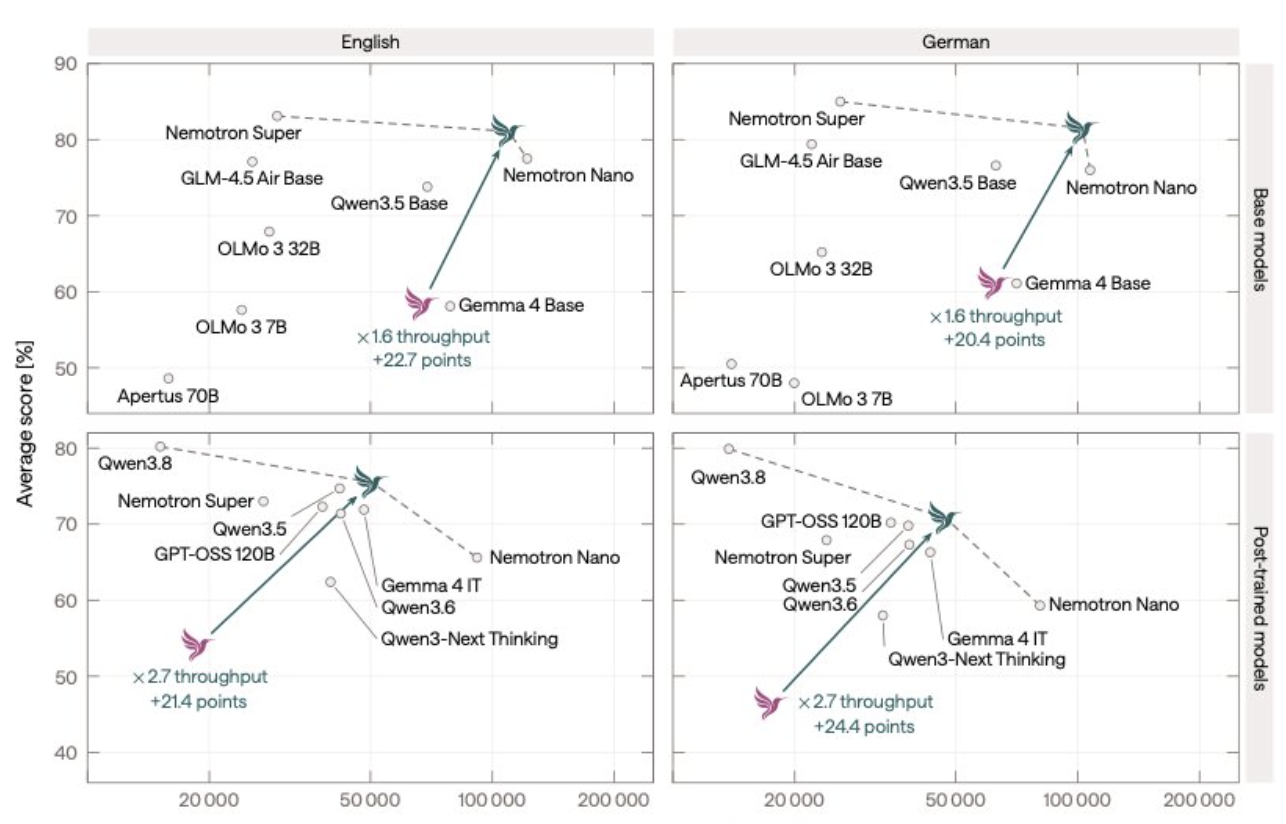
官方公布的跑分是这样的。英语综合得分 75.5,在同类 MoE 模型里排第一。该得分是由英语语境下的五大核心维度基准加权平均得出,包括数学与逻辑推理、专业通用知识、代码生成、Agentic 和 Tool Use、长文本理解等。
官方对比了一个 27B 的 dense 模型 Qwen3.8,英语综合得分是 80.2,德语 79.9,比 Kolibri 高出一截。
SWE-Bench Verified 考察的是 GitHub 上真实的 issue 修复能力,Kolibri 是 66.4,Qwen3.6 是 73.8;TerminalBench 考察的是在终端里完成任务的能力,Kolibri 只有 27.7。
Kolibri 现在已经开源,可以自由下载和本地部署,但目前还没有类似 ChatGPT 那种可以直接打开网页在线聊天的官方托管平台。并且主流的第三方云端 API 平台也都没有上线该模型。
如果你有足够的硬件资源(例如至少 2 张 A100/H100 显卡),可以直接参考官方在 Kolibri-1 Hugging Face 页面提供的教程,通过专用的 vLLM 分支或推理脚本进行本地或者私有云部署。
如果你的公司或者所在的研究机构是面向欧洲市场的话,完全可以尝试下。
恭喜看到这里的你,成功击败 99% 的学习者了。
最后简单总结下。
Kolibri 用 3.46B 的激活参数,换来了更低的推理成本和不错的综合跑分,但在代码和 Agent 任务上,还追不上同级别的国产模型。
另外,如果你想学习怎么用大模型生成训练数据,推荐去读 Kolibri 技术报告里讲 SFT 数据的那一节,老师模型怎么选、数据怎么改写,写得非常具体。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!