
上下文窗口从早期的 128K 一路涨到 1M,可不是改一个配置参数那么简单。上期讲 Transformer 时我们提到过,大模型每生成一个新 Token,都要回头去看前面所有 Token 的键向量 K 和值向量 V。为了不每次都重新计算,模型会把这些 K 和 V 存在显存里,这份存起来的数据就叫 KV Cache。
上下文从 128k 扩展到 1M,需要解决两个问题。一个是 KV Cache 太大,一张显卡存不下。另外一个是计算量太大,每个 Token 都要和前面所有 Token 算一遍注意力,上下文长度翻一倍,计算量就要翻四倍,100 万 Token,计算量和显存的读写次数会变得非常惊人。
恭喜看到这里的你,已经成功击败 30% 的学习者。
那聪明的你一定会问,为什么标准的多头注意力撑不起这么大的上下文?
早期的 Transformer 用的是标准多头注意力,简称 MHA。所谓“多头”,就是让模型从多个角度同时理解上下文,每一个角度就是一个注意力头,模型的每一层通常有几十个甚至上百个注意力头。
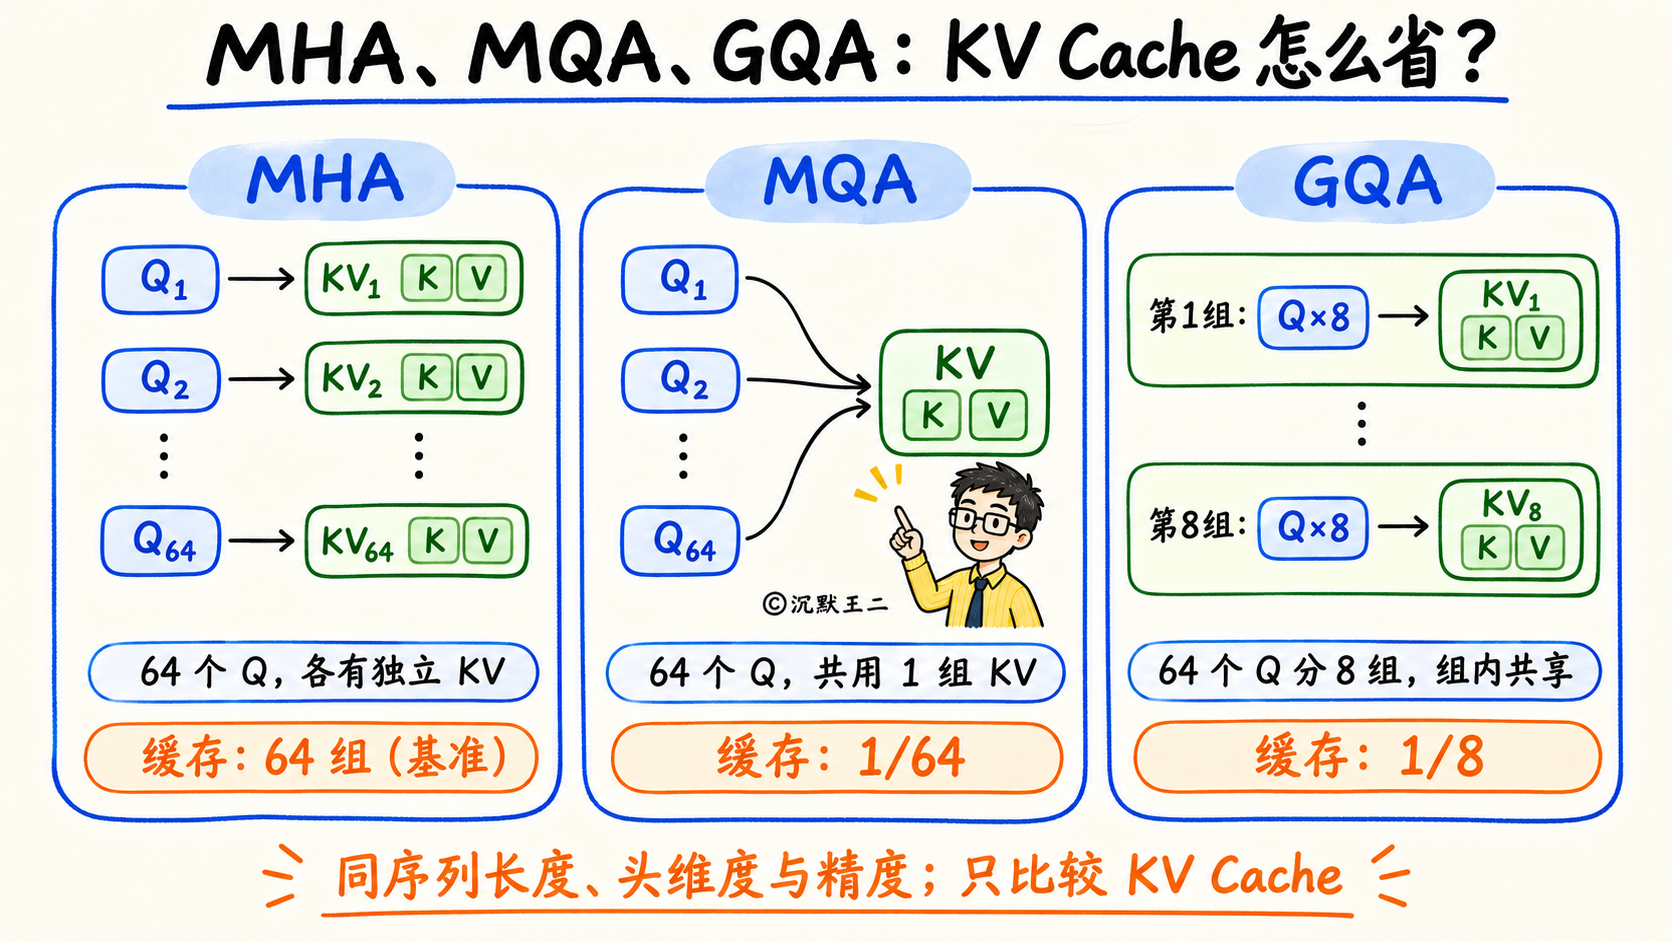
在 MHA 里,每个注意力头都有自己独立的一套查询 Q、键 K 和值 V。假设一层有 64 个注意力头,那么每个 Token 在每一层都要往显存里存 64 份 K 和 64 份 V。同时要处理的请求变多了、上下文也变大了,光是 KV Cache 就能把显存撑爆。
为了给 KV Cache 瘦身,业界先后想到了两个办法。第一个是多查询注意力,简称 MQA。它的做法很简单,64 个查询 Q 照样保留,但所有注意力头共用同一份 K 和 V。这样一来,KV Cache 直接缩小到了原来的六十四分之一。可惜这样一来,模型的回答质量明显下降了。
于是又有了一种新的办法,叫分组查询注意力,简称 GQA,Llama 和 Qwen 系列都在用这种机制。这种机制会把 64 个注意力头分成 8 组,同一组里的 8 个头共用一份 K 和 V。这样一来,KV Cache 就缩小到了原来的八分之一,模型的回答质量基本没受影响。
恭喜看到这里的你,成功击败 50% 的学习者了。
那聪明的你肯定会继续问,DeepSeek 的 MLA 是怎么进一步压缩 KV Cache 的?
GQA 省显存的办法,是减少 K 和 V 的份数。DeepSeek 在 V2 和 V3 里换了一个思路,提出了多头潜在注意力,简称 MLA,注意力头的数量不变,把每个 Token 要存的 K 和 V 压缩成一个更短的向量。
具体来说,MLA 先用一个压缩矩阵,把 K 和 V 压成一个很短的向量,这个短向量就叫“潜在向量”。显存里的 KV Cache 只需要存这个短向量就行。等到计算注意力、真正需要 K 和 V 的时候,再用另一个矩阵把它展开还原。
更巧妙的是,负责还原的矩阵可以提前和计算查询 Q 的矩阵合并成一个。这样计算时就不用真的把完整的 K 和 V 还原出来放进显存,既省显存,也省了一步计算。
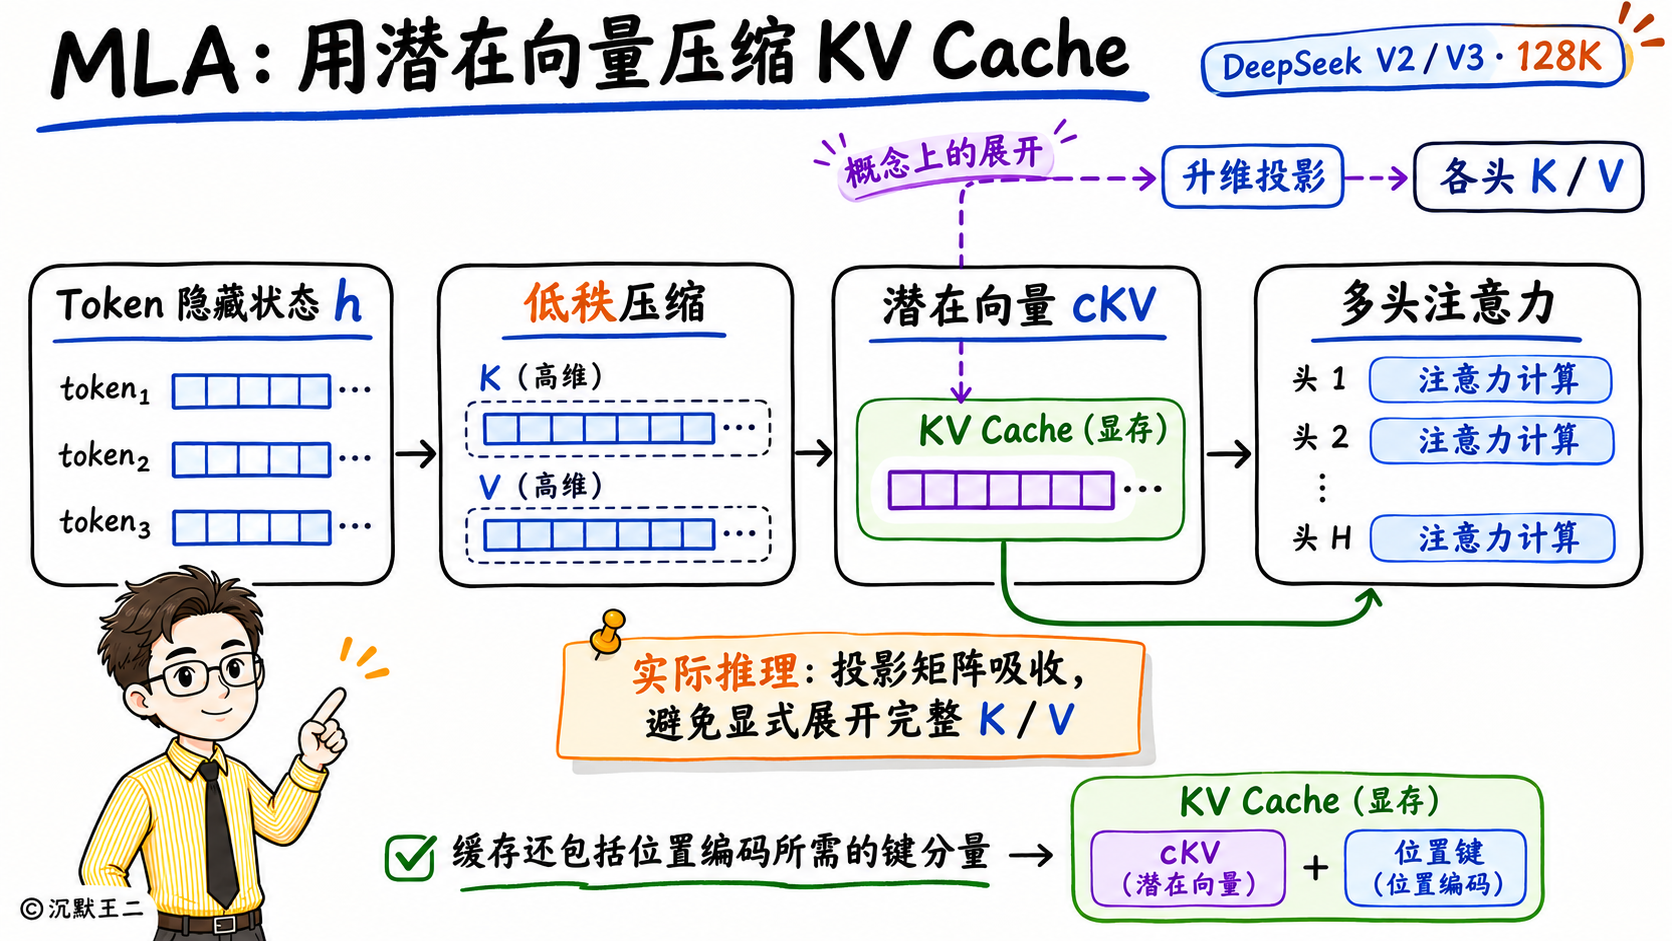
靠着 MLA,DeepSeek V2 和 V3 在模型能力基本不受影响的前提下,把每个 Token 的 KV Cache 压得比 GQA 还要小,也顺利撑起了 128K 的上下文窗口。
但上下文从 128K 扩到 1M,Token 数量变成了原来的 8 倍。MLA 虽然把每个 Token 的 KV 数据压小了,可 100 万个 Token 依然要存 100 万份。在 V3 上,单单一个百万 Token 的请求,就要占掉大约 84G 的显存,差不多能把一整张显卡撑满,根本没法同时处理多个请求。
恭喜看到这里的你,成功击败 70% 的学习者了。
聪明的你可能会继续问,从 128K 扩到 1M,DeepSeek V4 又做了什么升级?
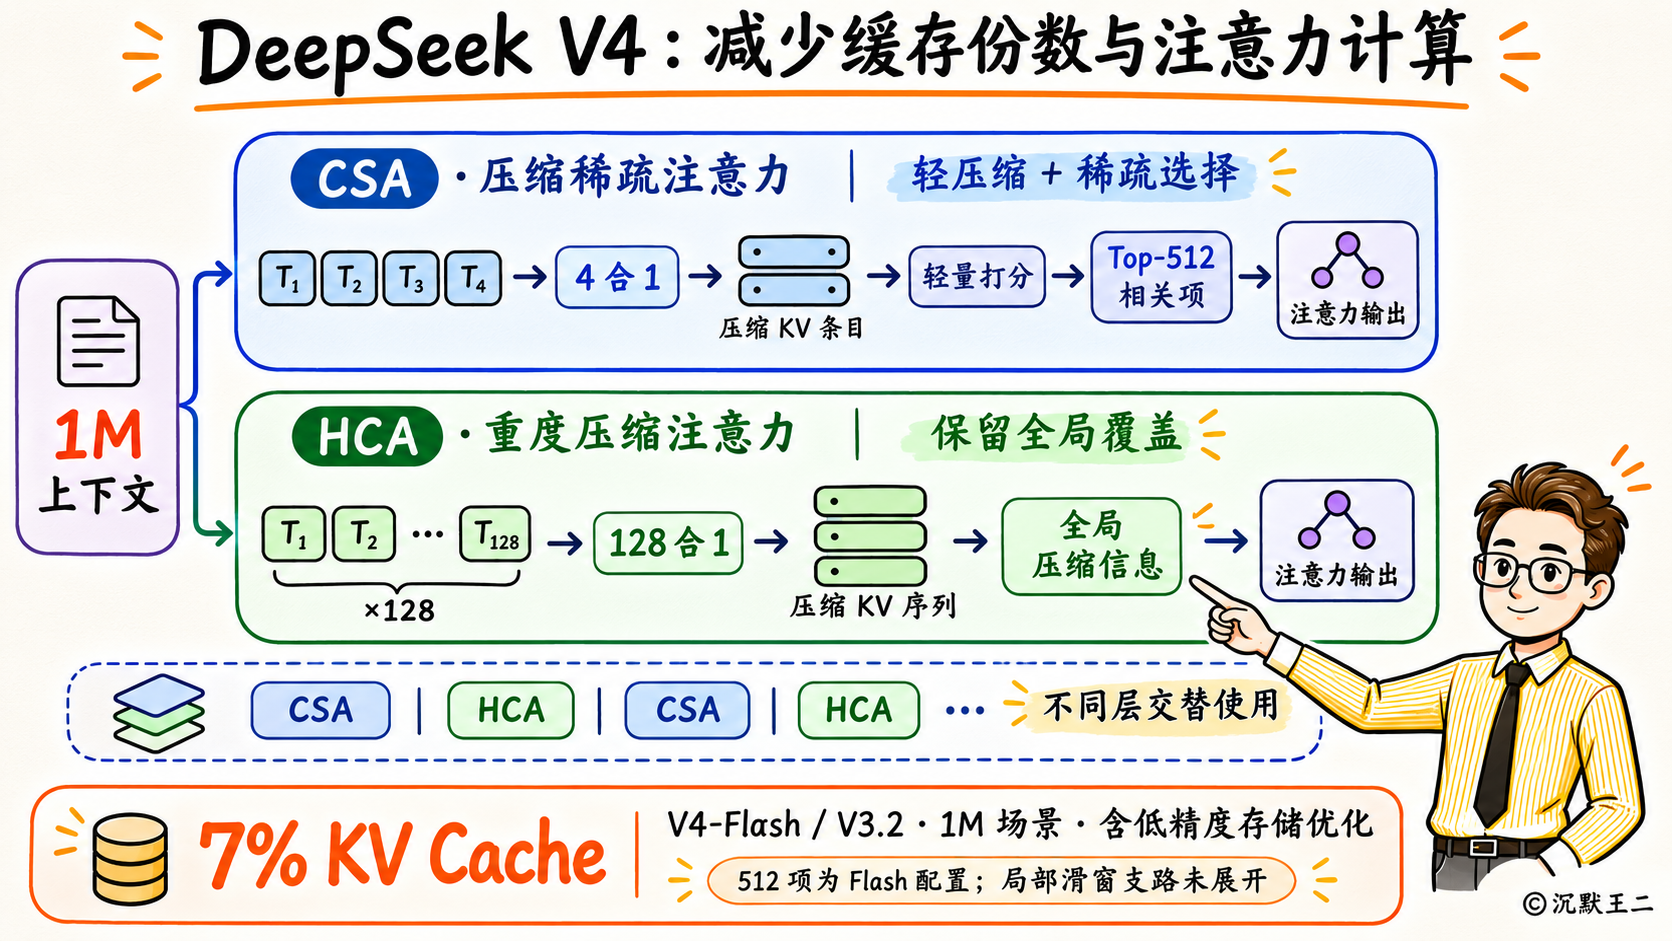
既然只压缩每个 Token 的数据量解决不了问题,那就换个方向,直接减少 KV Cache 要存的份数。用 CSA(压缩稀疏注意力)和 HCA(重度压缩注意力)这两套机制,替换掉原来的 MLA。
先看 CSA,它做了两件事。第一件,把相邻的 4 个 Token 合并成 1 份 KV 数据来存,这样的话,原本 100 万份的数据一下子就减少到了 25 万份。第二件,计算注意力时不再把这 25 万份全部算一遍,而是先用一个计算量很小的打分模块给它们打分,每次只挑出最相关的 512 份参与计算。这样既省了显存,又省了计算量。
再看 HCA,它压得更狠,把每 128 个相邻的 Token 合并成 1 份 KV 数据,100 万个 Token 合并完只剩大约 8000 份。
两者的分工是这样的。HCA 压得狠,但能覆盖整篇文档,负责记住全文的大意,防止模型漏掉背景;CSA 压得轻,负责从中挑出和当前问题最相关的 512 份细节。两套机制配合下来,DeepSeek V4 的 KV Cache 显存占用只有 V3 的 7%,一张显卡就能同时处理十几个 100 万 Token 级别的请求。
恭喜看到这里的你,成功击败 90% 的学习者了。
最后,聪明的你还会问,100 万个 Token 怎么计算得过来?
这就要靠 GPU 计算层面的 Flash Attention,以及服务端的上下文硬盘缓存了。
GPU 在算注意力时,真正拖慢速度的往往不是乘法本身,而是搬运数据。传统做法会先算出一个巨大的注意力分数表,写进显存,下一步再从显存里读出来接着算。显存容量大,但读写速度比 GPU 芯片内部的缓存慢得多,来回搬几趟,时间就耗在上面了。
Flash Attention 把 Q、K、V 切成一小块一小块,放进 GPU 芯片内部的高速缓存 SRAM 里,在芯片内部直接算出最终的结果,再写回显存。那张巨大的分数表根本不用写进显存,这样就省掉了大量的来回读写,长文本的训练和推理都快了一大截。
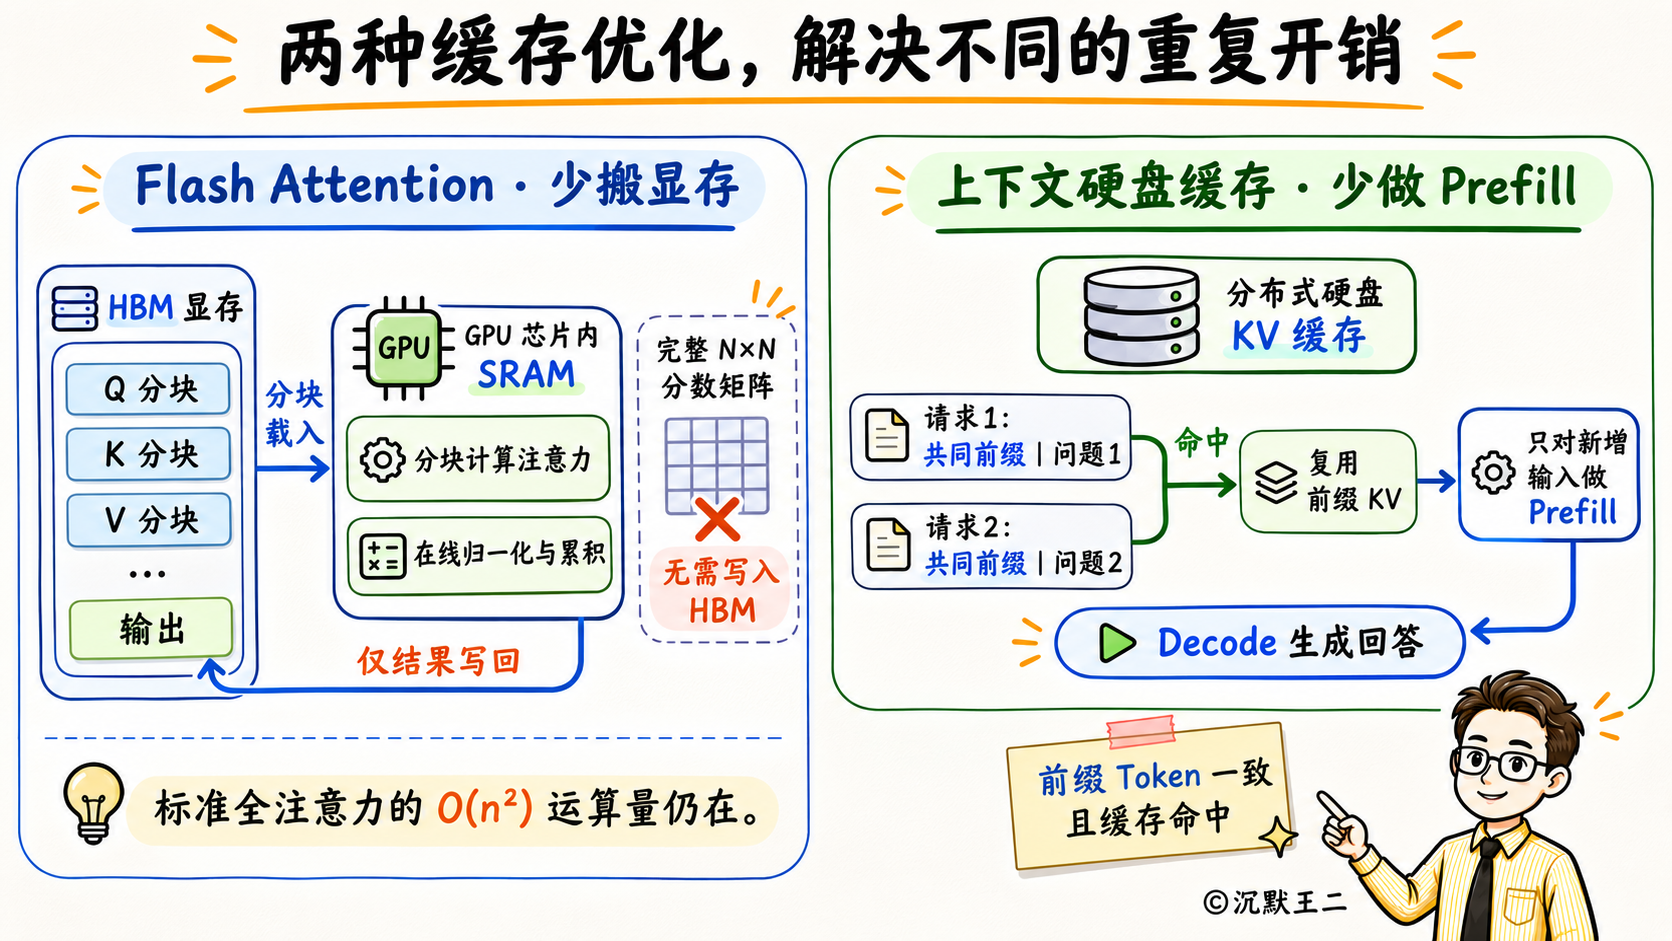
另外,DeepSeek 还在服务端做了上下文硬盘缓存,算好的 KV Cache 会在后台存到服务器的硬盘上。当你连续多轮提问时,前面没变的那部分内容直接读取缓存,不用再让模型从头读一遍,也就跳过了 Prefill 阶段的重复计算。这样不仅回复得更快,命中缓存的那部分输入,API 价格也便宜得多。
恭喜你升到王者段位了,成功击败 99% 的学习者。
最后简单总结一下。大模型要撑起 1M 上下文,关键要做两件事,把 KV Cache 变小,把注意力的计算变少。
MQA 和 GQA 是让多个注意力头共用 K 和 V。MLA 是把每个 Token 的 K 和 V 压成一个短向量。到了 DeepSeek V4,又用 CSA 和 HCA 把相邻的 Token 合并存储,计算时只挑最相关的部分来算。
再加上 Flash Attention 能减少显存读写,以及上下文硬盘缓存还能避免重复计算,100 万 Token 的上下文就做到了既装得下,又用得起。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!