
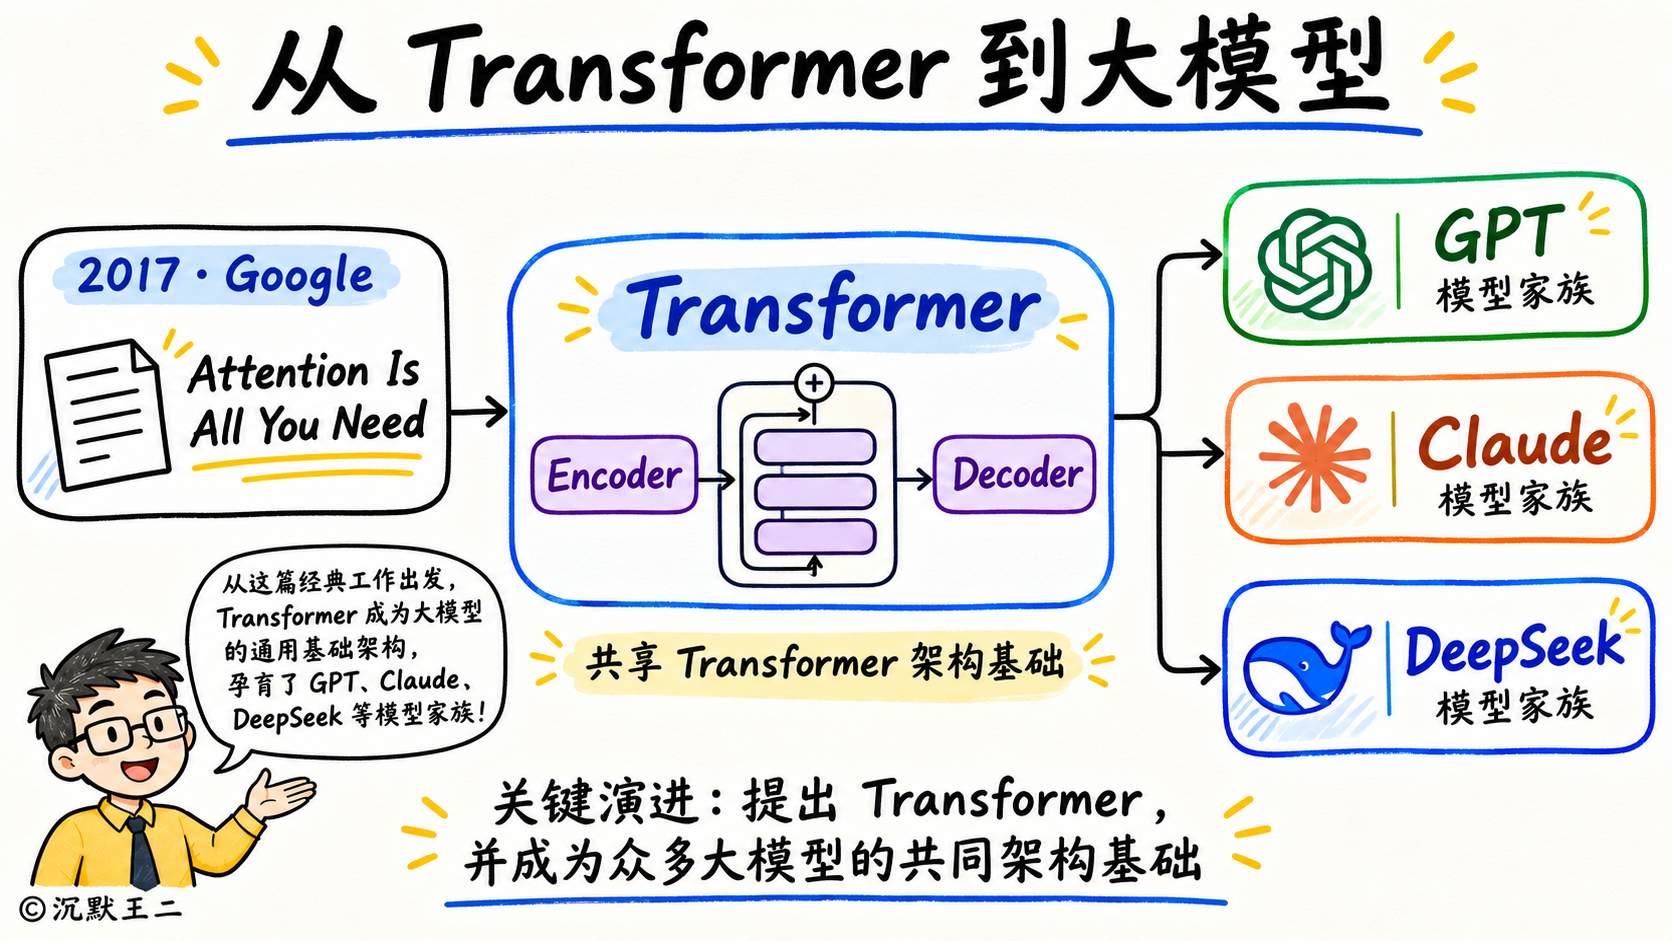
答案就是 Transformer。2017 年,Google 在论文《Attention Is All You Need》里提出了 Transformer,它由编码器 Encoder 和解码器 Decoder 两部分组成。
视频的原稿以及 369 道 Agent 八股已经整理到开源知识库。
接下来我问你,Transformer 为什么能取代 RNN?
A,参数量比 RNN 小;B,靠自注意力并行训练;C,不需要切分 Token。喜欢收藏的你可以把答案打在弹幕或者留言区。
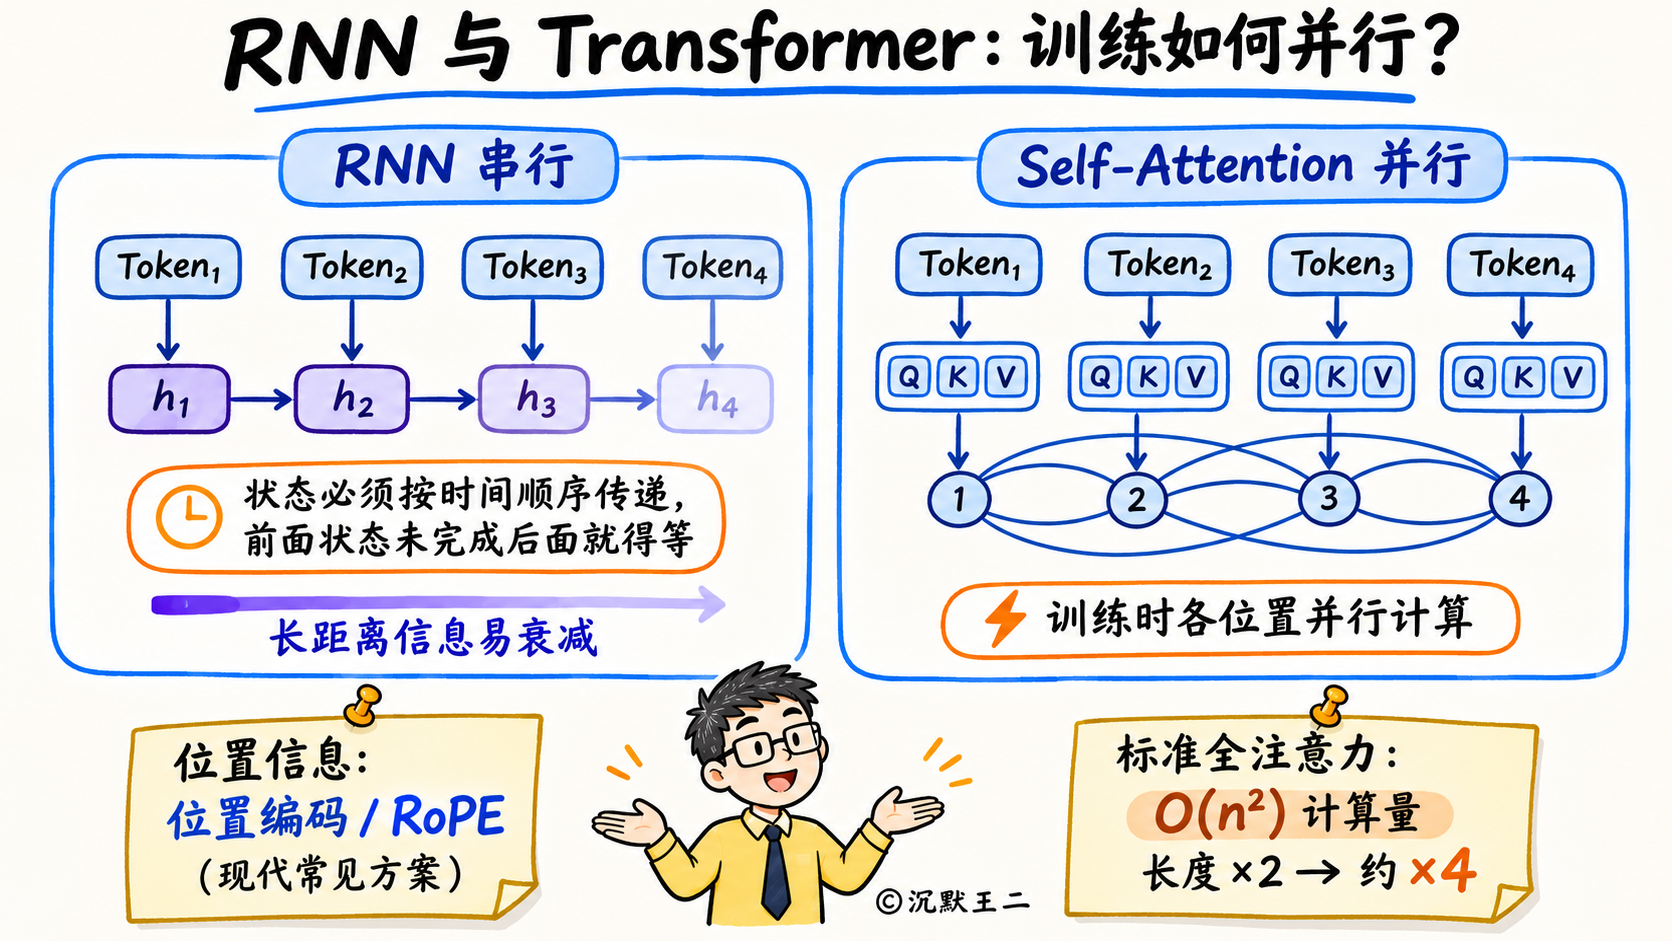
早期的循环神经网络 RNN 只能按顺序一个词一个词地读:先读第 1 个词,算出一个“记忆状态”传给第 2 个词,第 2 个词更新完再传给第 3 个词。这种按顺序传递的方式有两个问题,一是训练没法并行,后面的词必须等前面的词算完,显卡再多也帮不上忙;二是句子一长,模型很容易忘掉开头说了什么。
Transformer 换了一种思路,叫自注意力 Self-Attention。不再一个词一个词地往后传,而是让每个词直接去看句子里的所有词。比如读到“苹果发布了新手机 iPhone Duo,它很抢手”,模型会先把句子切成一个个 Token,Token 是模型处理文本的最小单位,可以粗略理解成一个字或一个词。每个 Token 都会算出三个向量,查询 Q、键 K 和值 V。可以这样理解,Q 表示“我想找什么”,K 表示“我能被怎样找到”,V 表示“我实际的内容”。处理“它”这个字时,模型拿“它”的 Q 去和所有词的 K 逐个打分,发现“手机”的分数最高,于是模型就知道“它”指的是手机。
这样一来,不管两个词隔得有多远,都能直接关联上;而且每个词的计算不用等别的词,训练时可以在 GPU 上同时进行。当然,这样是有代价的。一是自注意力本身不区分词的先后顺序,所以要额外加上位置编码,告诉模型每个词的排位;二是每个词都要和所有词打一遍分,句子长度翻一倍,计算量大约要翻四倍,这是 Transformer 处理长文本时的主要开销。
继续问你,Transformer 的每一层里,核心是哪两个模块在干活?
A,分词器与词表;B,多头注意力层;C,前馈神经网络 FFN。喜欢点赞的你会选哪一个?
一个 Transformer 模型由几十个结构相同的层叠在一起,每一层里都有两个模块接力干活:先是多头注意力,再是前馈神经网络 FFN。
多头注意力负责让每个词去看上下文,把相关的信息收集过来。每个词在模型里都用一串数字来表示,叫向量,512 维就是 512 个数字。“多头”的意思是分成几组同时看:比如把 512 维的向量拆分成 8 个 64 维的注意力头。训练下来,不同的头往往会关注不同的东西,有的关注语法结构,有的找“它”指的是谁,有的看语气。算完再把结果拼起来,还原成 512 维。
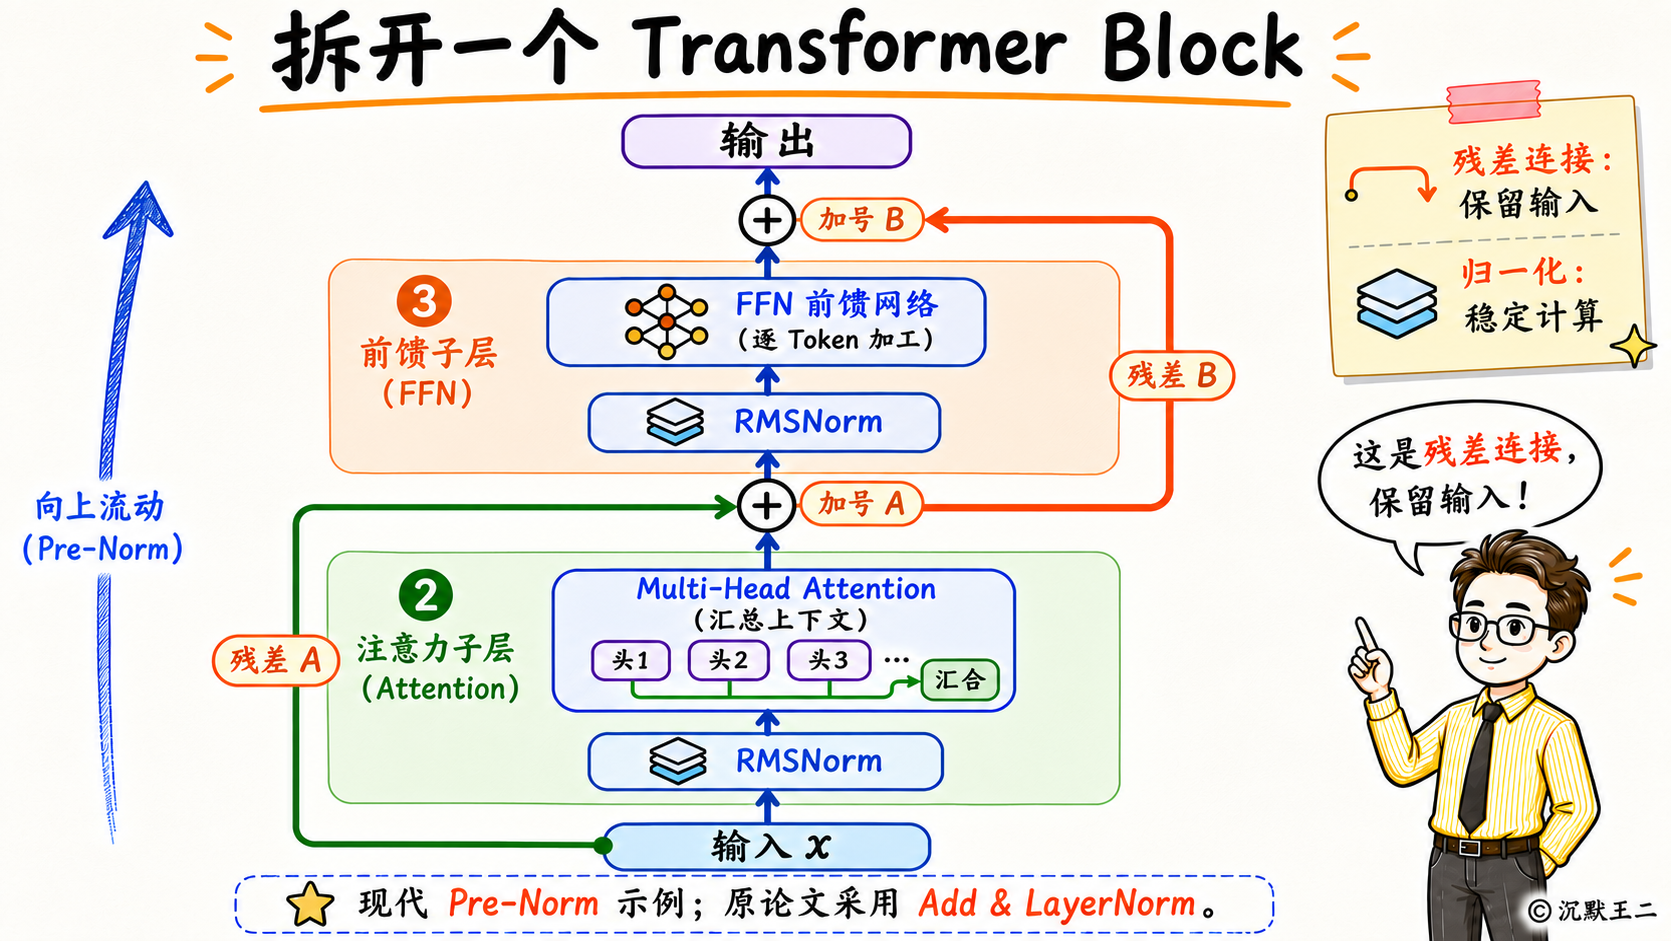
收集完上下文之后,FFN 再对每个 Token 单独做一次加工。模型在预训练时学到的知识,很大一部分存放在 FFN 的参数里。DeepSeek 用的混合专家架构 MoE,就是把一个大 FFN 拆分成 256 个小 FFN,每个小 FFN 叫一个专家。每个 Token 进来时,由路由模块挑出其中几个专家来处理,其余专家不参与计算。这样模型的总参数可以做得很大,每次参与计算的却只需要一小部分。
继续,Transformer 里的 Encoder 和 Decoder 分别干什么?
A,Encoder 负责理解输入;B,Decoder 用掩码遮住后文逐词生成;C,两者做的事情一样。喜欢推荐的你会选哪一个?
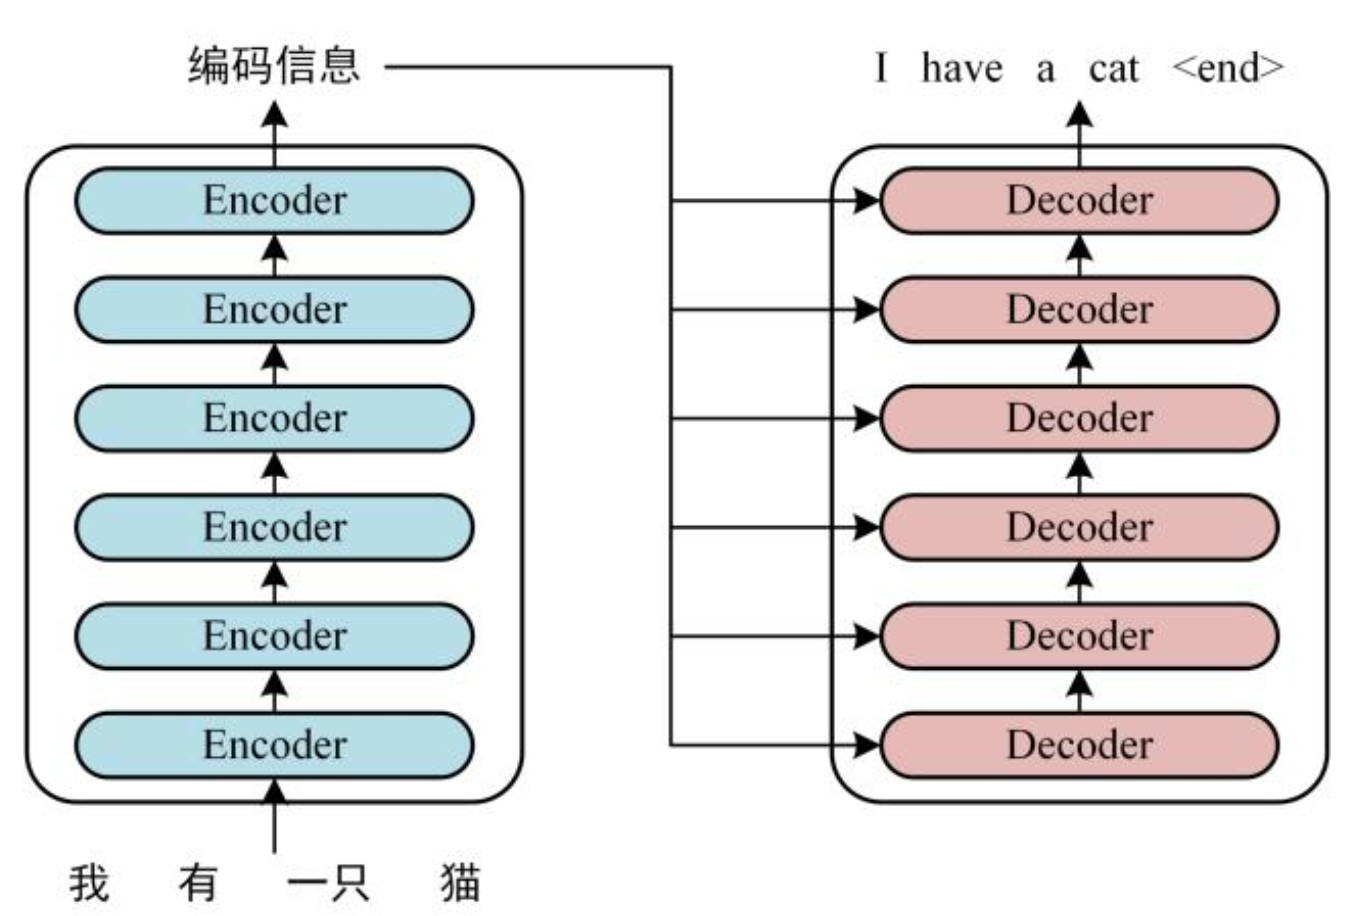
最初的 Transformer 是为机器翻译设计的,论文架构图里左边是 6 层 Encoder,右边是 6 层 Decoder。
Encoder 负责读懂输入。比如把中文翻译成英文,Encoder 先读整句中文,它用的是双向注意力,每个词既能看到前面的词,也能看到后面的词,最后把整句话转换成一组包含语义的向量。
Decoder 负责一个词一个词地生成英文。训练时,整句译文是一次性交给模型的,为了防止模型偷看后面的答案,Decoder 加了因果掩码,把当前位置后面的词全部遮住,比如预测第 3 个词时,只能看到前 2 个词。Encoder 和 Decoder 之间靠交叉注意力连接,Decoder 拿当前位置的 Q,去查 Encoder 算好的 K 和 V,相当于一边写译文,一边回头翻看原文。
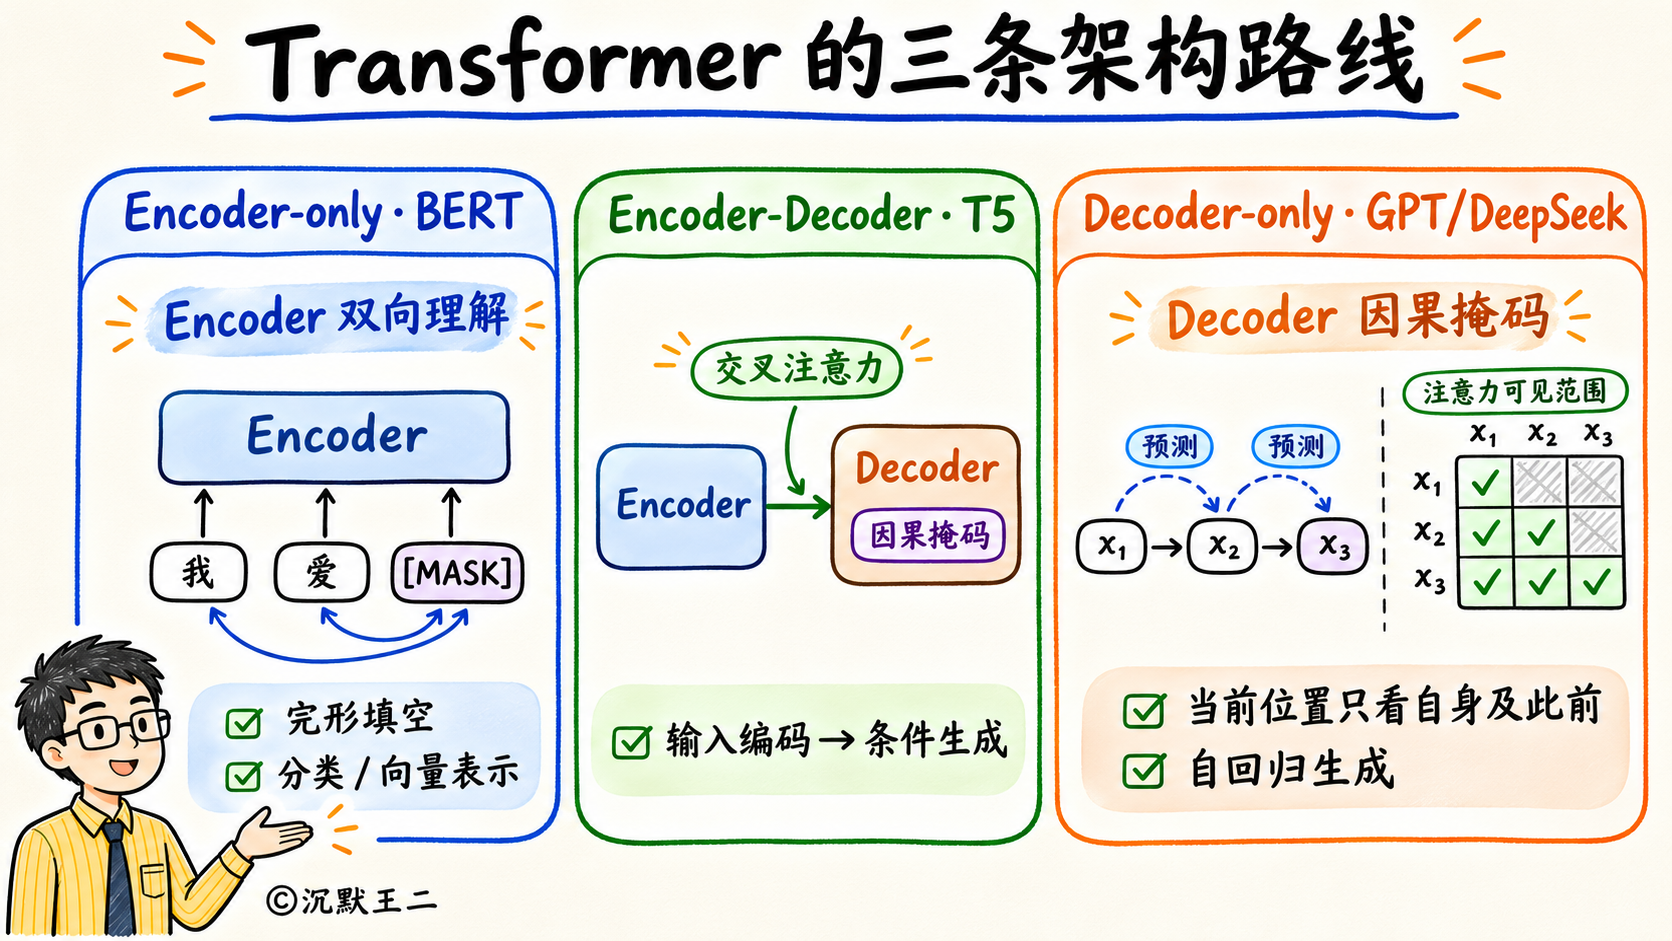
后来,Transformer 演化出了三个流派。只保留 Encoder 的代表是 BERT,擅长文本分类和把文本转换成向量;两部分都保留的代表是 T5;只保留 Decoder、并去掉交叉注意力的代表是 GPT。
最后再问你,为什么 GPT 只保留了 Decoder?
A,Encoder 太复杂;B,训练时每个 Token 都能算损失,效率高;C,推理时输入输出共用一套 KV Cache。聪明的你会选哪一个?
现在主流的大模型基本都采用了 Decoder-only 结构,也就是把你的提问和模型的回答拼成同一段文本,从头到尾一个 Token 接一个 Token 地输出。这么做主要有两个原因。
第一是训练效率高。像 BERT 这种双向模型,训练时做的是“完形填空”,随机遮住 15% 的词让模型去猜,算一遍下来,只有被遮住的这 15% 的位置能算出误差、帮模型学习。而 Decoder-only 配合因果掩码,一次并行计算,就能让每个位置都去预测它的下一个词,几乎每个 Token 都能用来训练。
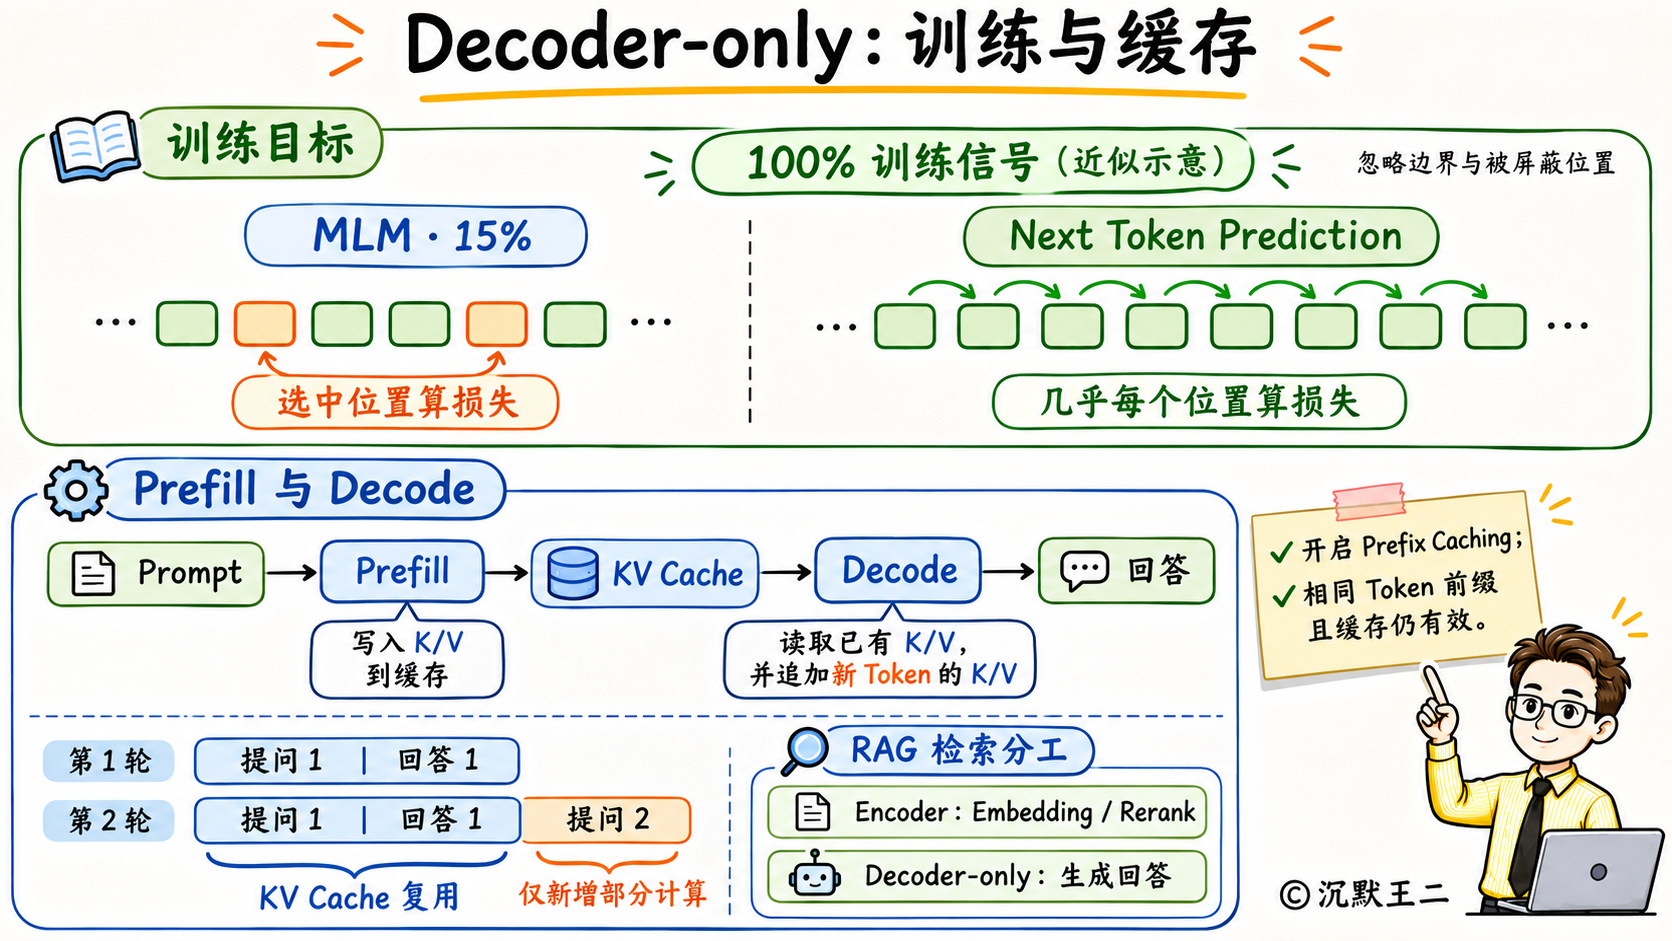
第二是推理开销低。推理就是模型回答问题的过程,Decoder-only 只要两步,先是 Prefill,把你的输入一次性读进来;再是 Decode,一个 Token 一个 Token 地生成。读输入时,每个 Token 算出的 K 和 V 会存进显存,这就是 KV Cache,后面生成时直接用,不用重算。用 ChatGPT 进行多轮对话时,上一轮的提问、回答和工具返回的结果,会放到下一轮输入的开头,配合 Prefix Caching 就可以直接复用这部分的 KV Cache。
当然,Decoder-only 也有短板,因为有因果掩码,每个词只能看到前面的词,看不到后面的词。所以做向量检索时,通常还需要专门的检索训练。这就是为什么做 RAG 时,生成回答用 Decoder-only 的大模型,而把文档转换成向量的 Embedding 模型、给检索结果重新排序的 Rerank 模型,也常用 BERT、BGE 这类 Encoder 模型。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!