
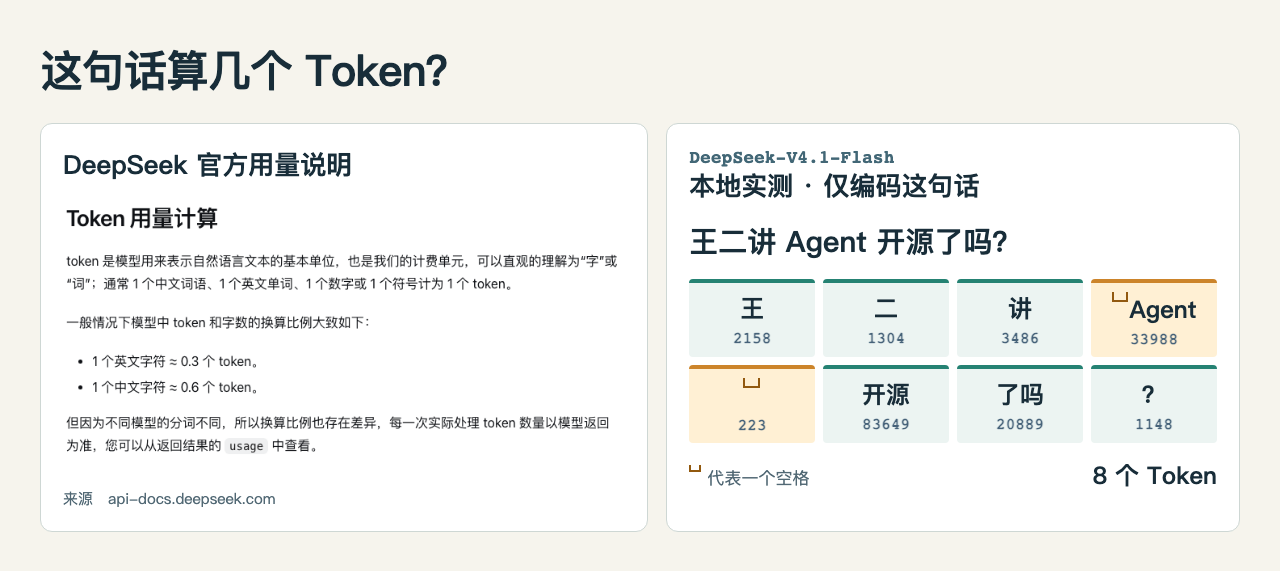
因为大模型读的不是一个个汉字,而是一个个 Token。负责把文字切成 Token 的工具,叫分词器,英文叫 Tokenizer。以 DeepSeek-V4.1-Flash 为例,它用的是字节级 BPE。
恭喜看到这里的你,已经成功击败 30% 的学习者。点赞关注,我是二哥,咱们开始!
那聪明的你一定会问,分词器到底是用来干嘛的?
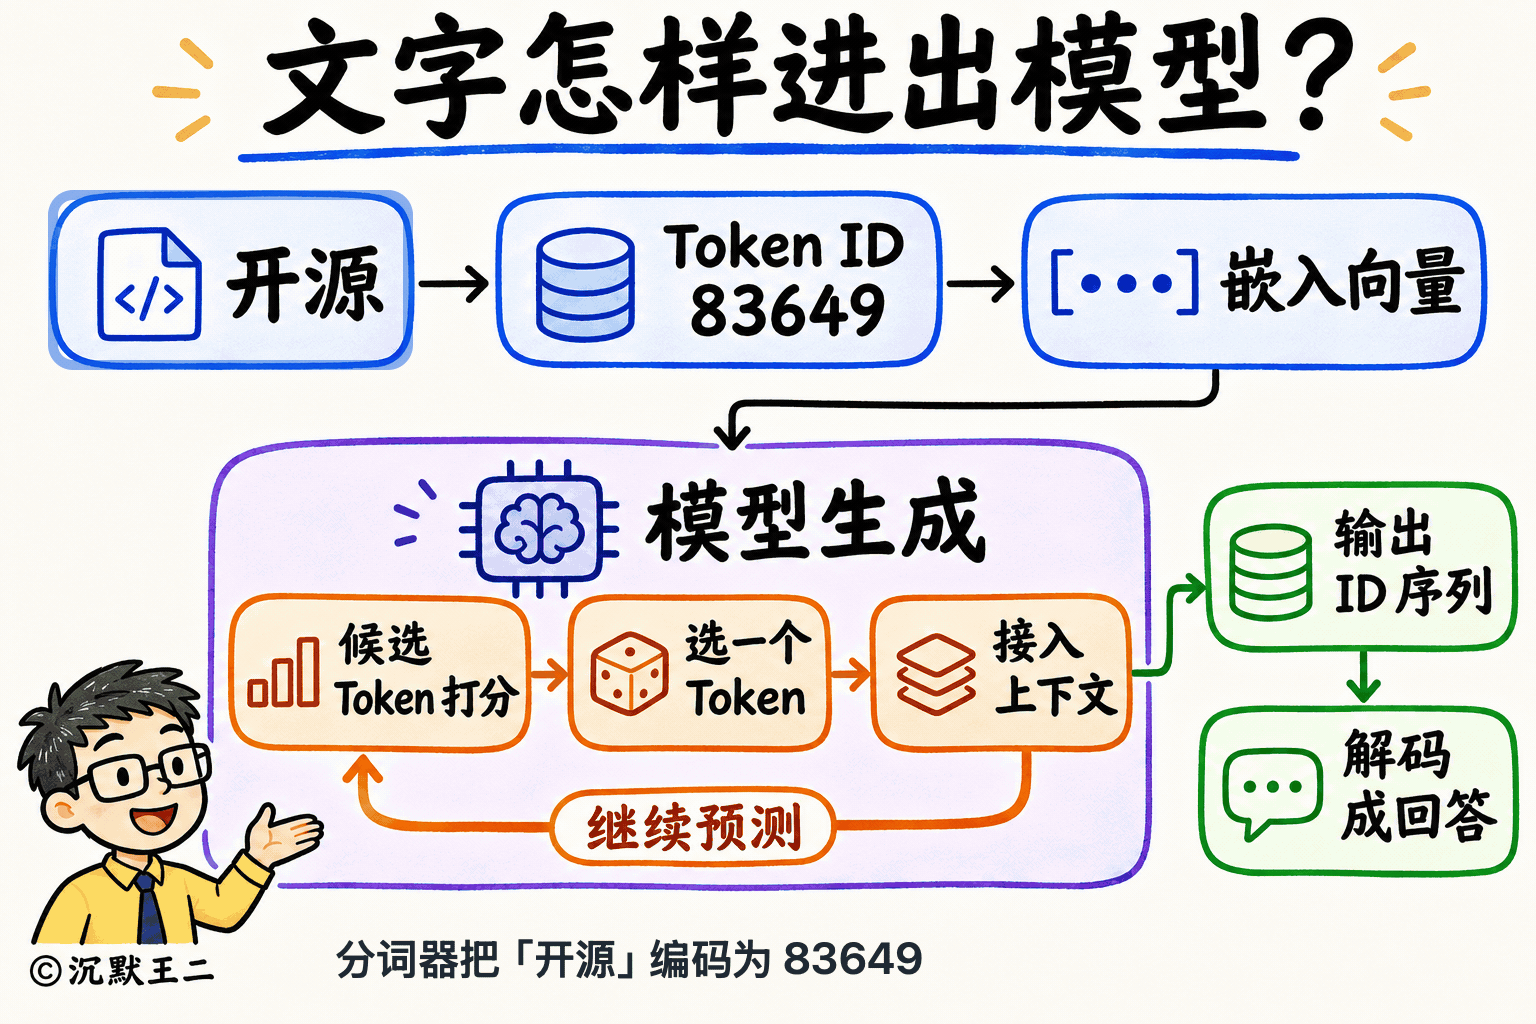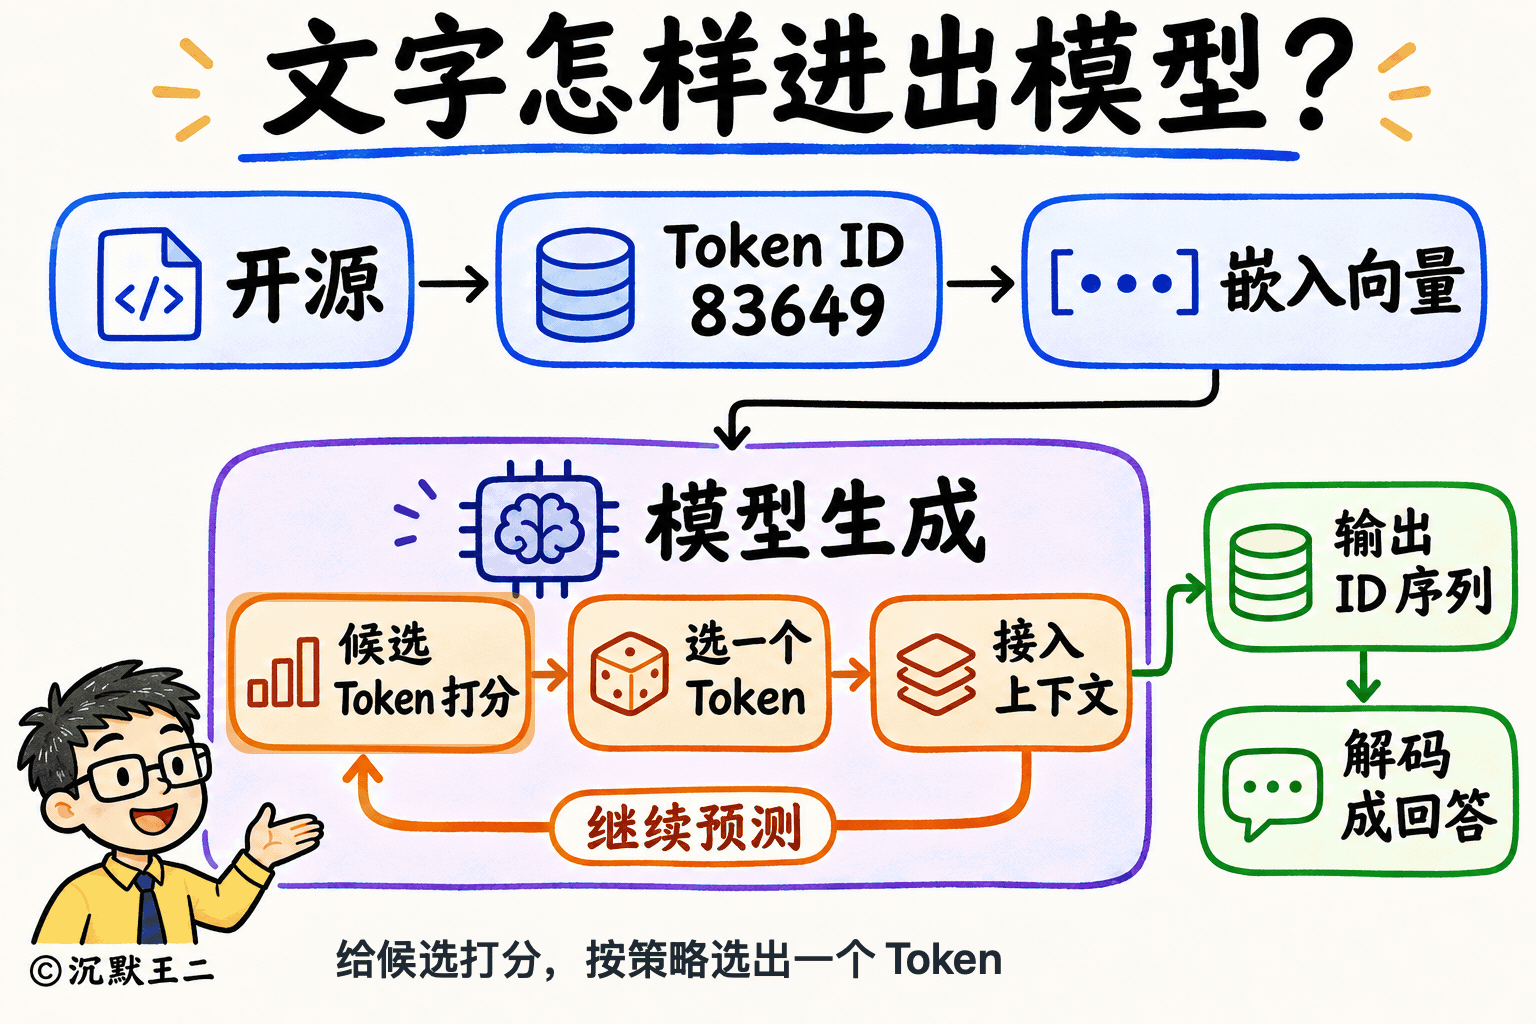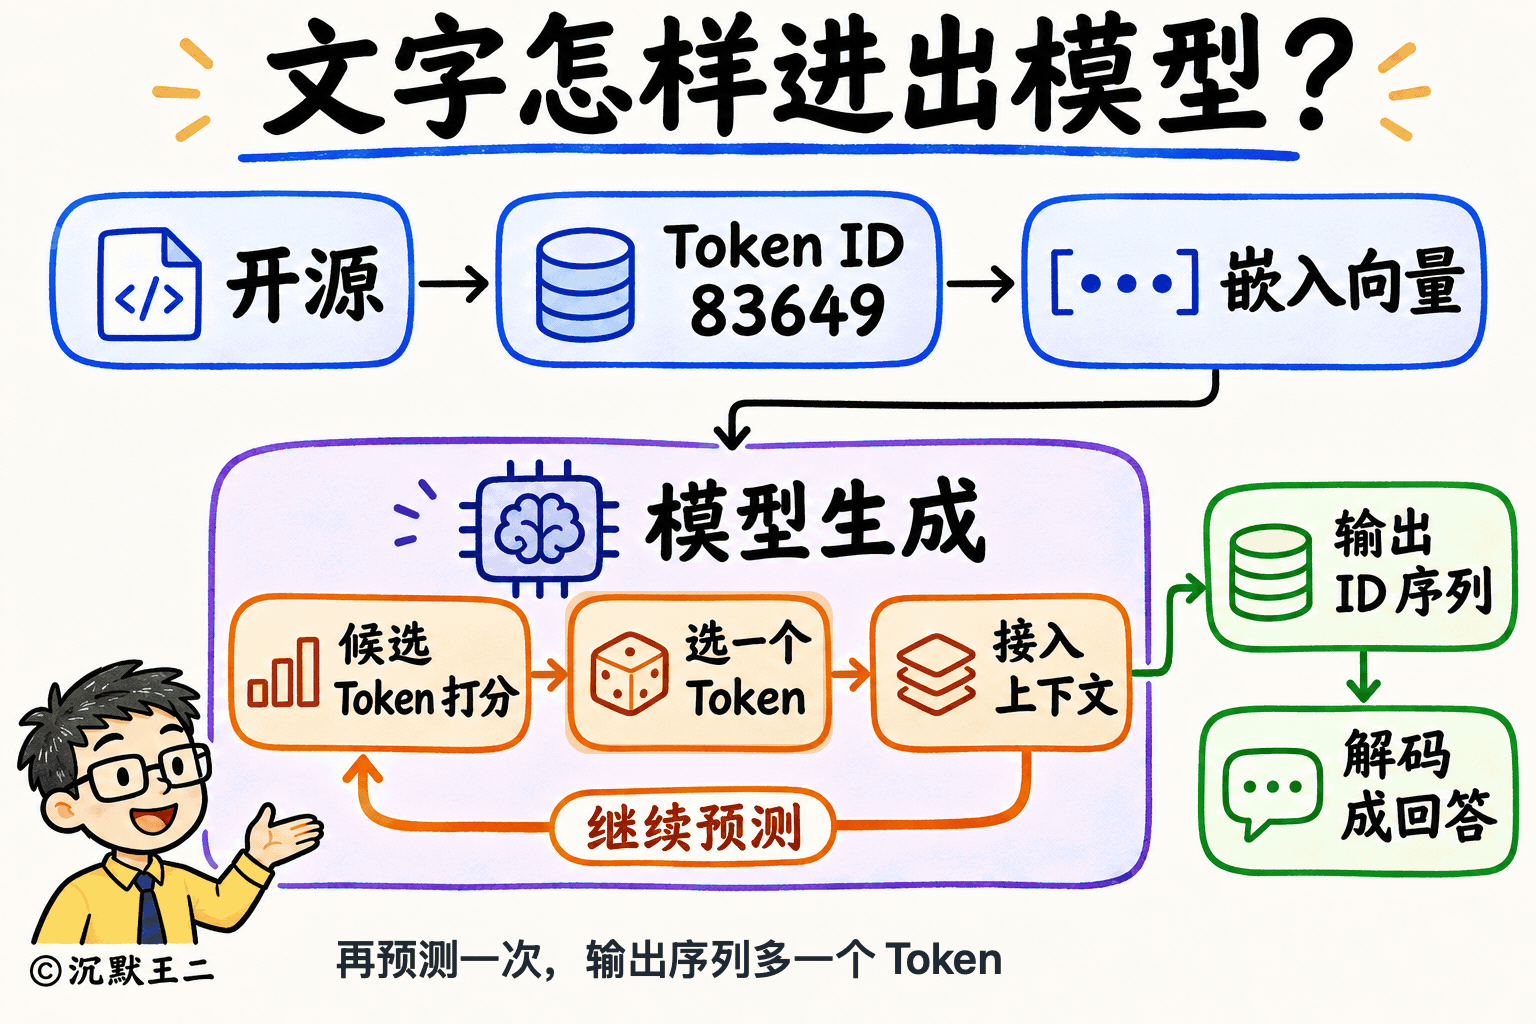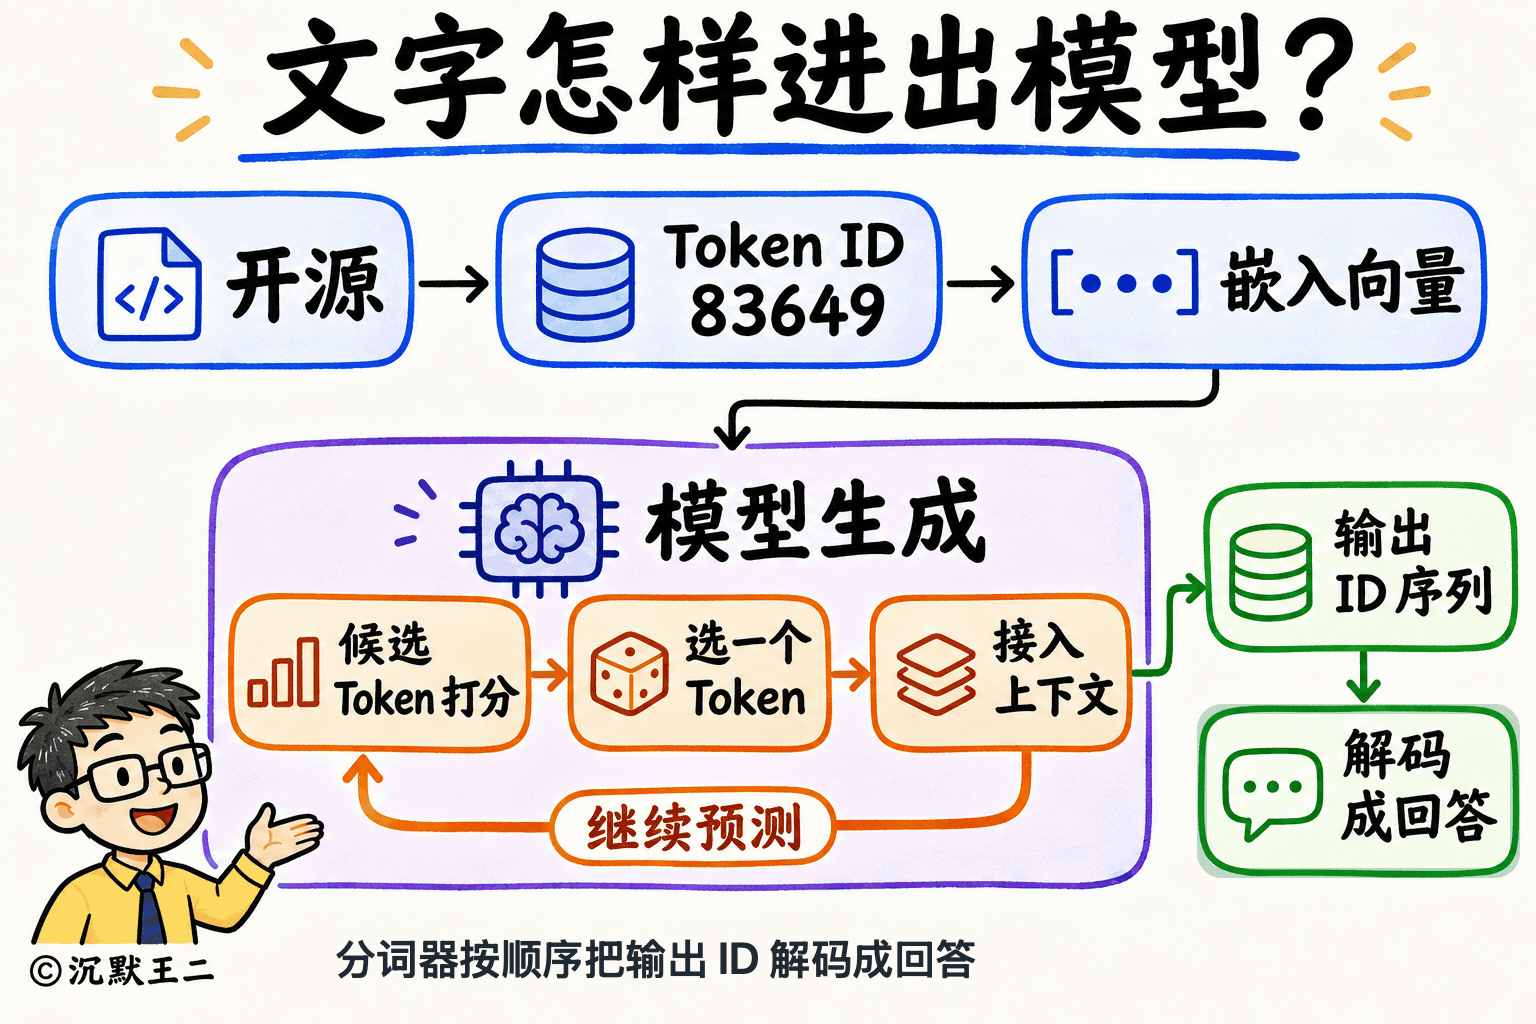
大模型的底层是 Transformer 神经网络,它做的全是矩阵运算,只能处理数字,看不懂我们输入的文字。分词器就是文字和模型之间的翻译官,文字进模型之前,翻译成数字,这一步叫编码;模型计算完之后,再把数字翻译成文字,这一步叫解码。
比如你在 DeepSeek Harness 中输入了“王二讲 Agent 开源了吗?”,分词器先按照提前训练好的规则,把这句话切成一小段一小段,每一小段就是一个 Token。接着,分词器去查自带的一张对照表,我们叫它“词表”,词表里记着每个 Token 对应的编号,比如“王二”切成“王”和“二”,分别对应 2158 和 1304,“开源”对应 83649。模型拿到这串编号后,先把每个编号换成一组数字,也就是向量,模型再结合上下文计算这个 Token 在句子里的含义。
模型会预测下一个 Token,生成时可以挑概率最高的,也可以是其他概率的。分词器把生成的编号按顺序解码成文字,有时要等几个 Token 凑齐,才能显示一个字。换句话说,如果没有分词器,大模型就读不懂我们的提示词,更没法做回答。
恭喜看到这里的你,已经成功击败 50% 的学习者了。
那聪明的你肯定会继续问,分词器为什么不直接按整个词切?
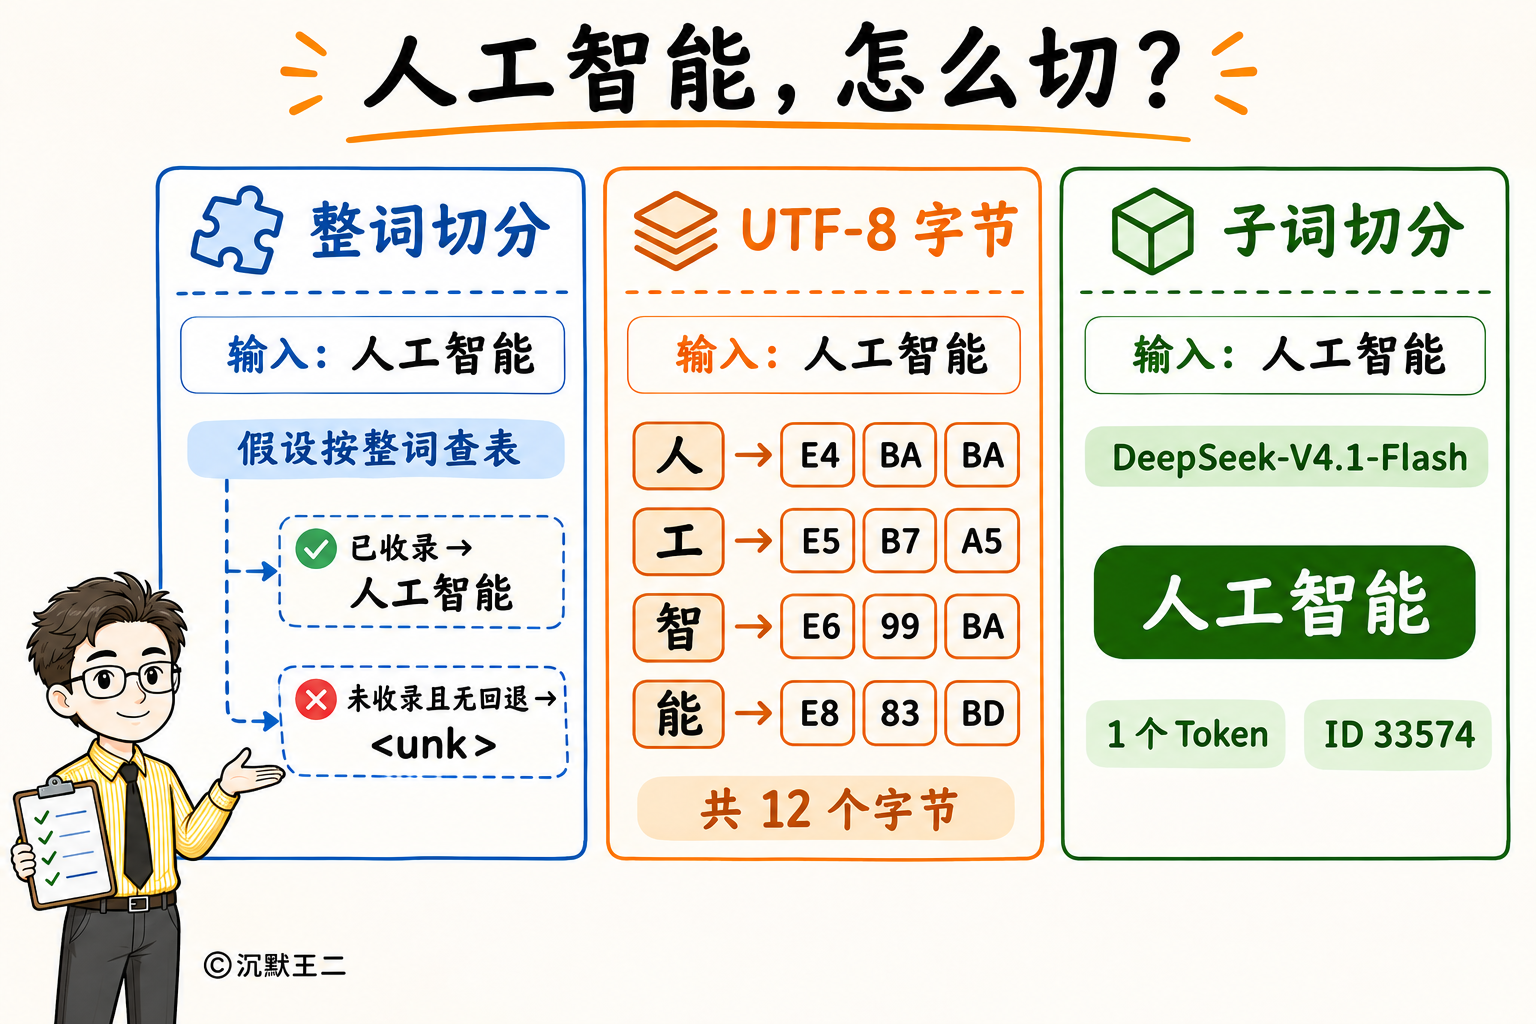
我们日常的用词,加上英文单词的各种变形、网络新词、代码里的变量名,词表再大也很难收全。更麻烦的是,用户打错了一个字,或者用了一个词表里没有的新词,如果只按整词查表,又不能把它拆开,分词器就查不到编号,只能把它记成一个表示“不认识”的特殊符号 <unk>。这样一来,模型就完全不知道这个位置原本是什么,信息就丢了。
如果按单个字节来切,基础词表只要收集齐 256 种字节取值就够了,不会出现不认识的字。但问题是,单个字节本身几乎不带含义,模型得把它们拼起来再去理解;而且同一段话切出来的 Token 数量往往会更多。上一期我们讲过,用标准的全注意力一次性处理整段输入时,计算各个位置之间的相关性开销,跟 Token 数量的平方成正比。
为了让词表别太大、切出来的 Token 也别太多,分词器普遍采用了一种折中的办法,叫“子词切分”。思路很简单,像“人工智能”这样的词,在这版分词器里整个保留成 1 个 Token;不常见的生僻词或者很长的组合词,就用几个词表里已有的小片段拼出来,有时刚好是词根、前缀或后缀。这样,词表大小能控制在几万到十几万个,切出来的 Token 数量也不会太多。
恭喜看到这里的你,成功击败 70% 的学习者了。
聪明的你可能会继续问,常见的子词分词器有哪几种?
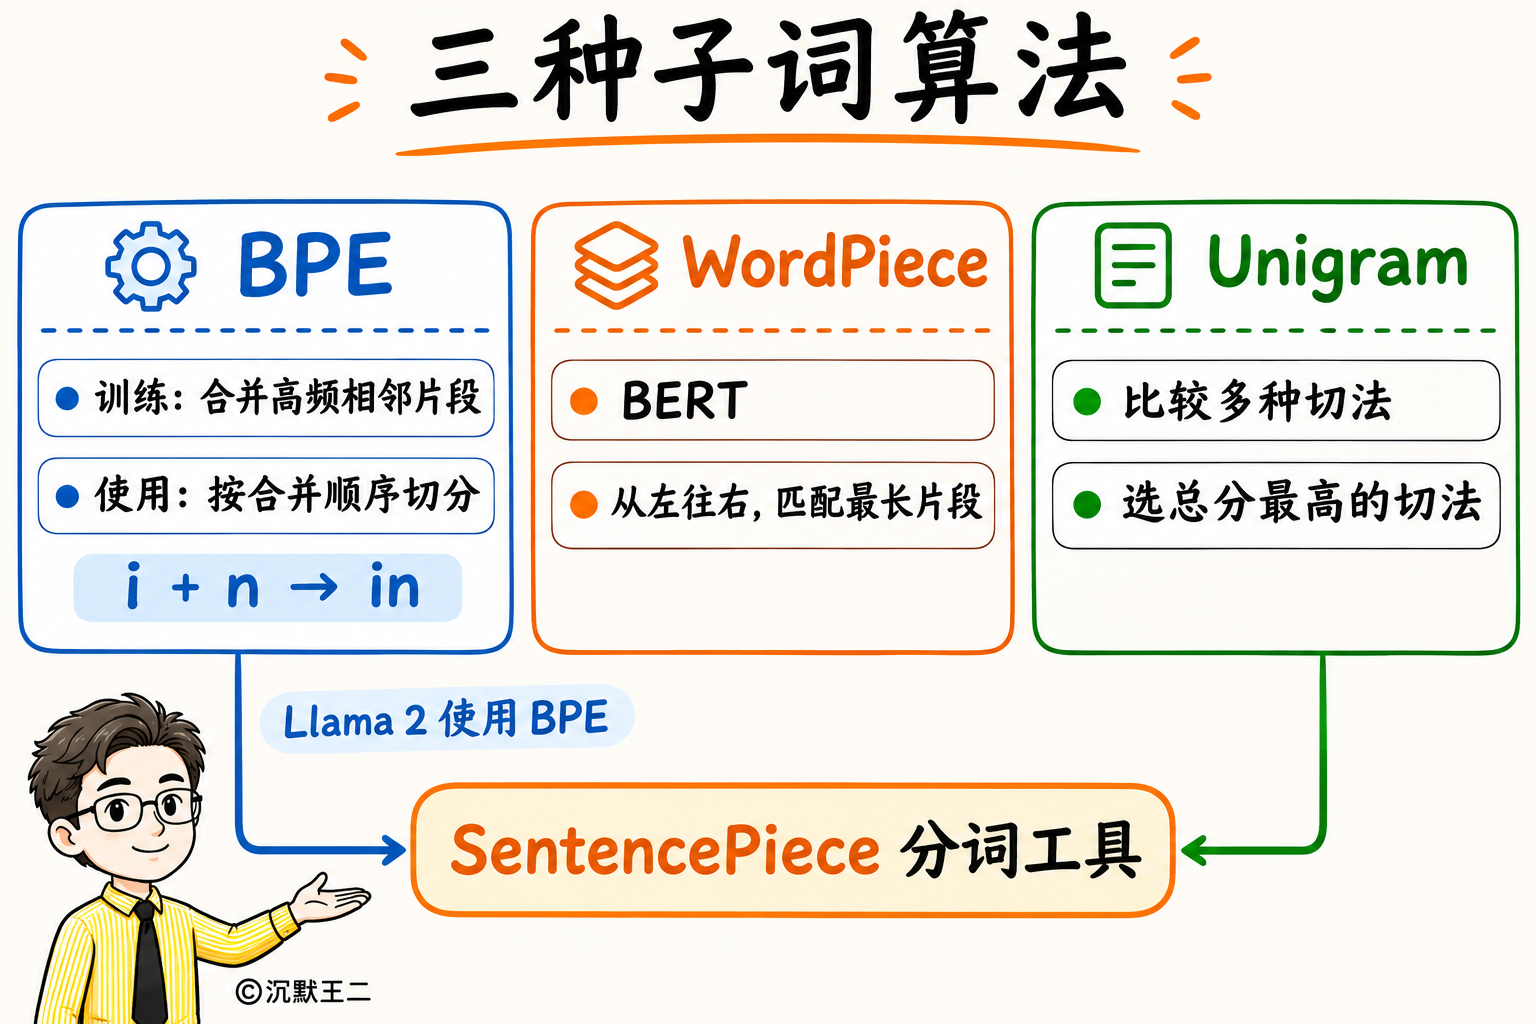
目前主流的有三种,BPE、WordPiece 和 Unigram。
BPE,全称叫字节对编码,GPT、DeepSeek、Qwen 用的都是它。它建词表的过程是从小往大一步步合并的。先把文本拆分成最小的单位,也就是单个字符或字节;然后在大量文本里统计,哪两个相邻的片段挨在一起出现的次数最多,就把这两个片段合成一个新片段,加进词表。比如 i 和 n 经常挨着出现,就先合成 in;下一轮发现 in 和 g 又经常挨着出现,就再合成 ing。一轮接一轮地合并下去,直到词表的数量达到提前设定好的大小为止。
第二种是 WordPiece,代表模型是 BERT。第三种是 Unigram,它会给不同的切法打分,通常选得分最高的一种。Llama 2 和早期 Gemma 用的 SentencePiece 是个分词工具,支持 BPE 和 Unigram。
恭喜看到这里的你,成功击败 90% 的学习者了。
最后,聪明的你还会问,DeepSeek 为什么选择 BPE?
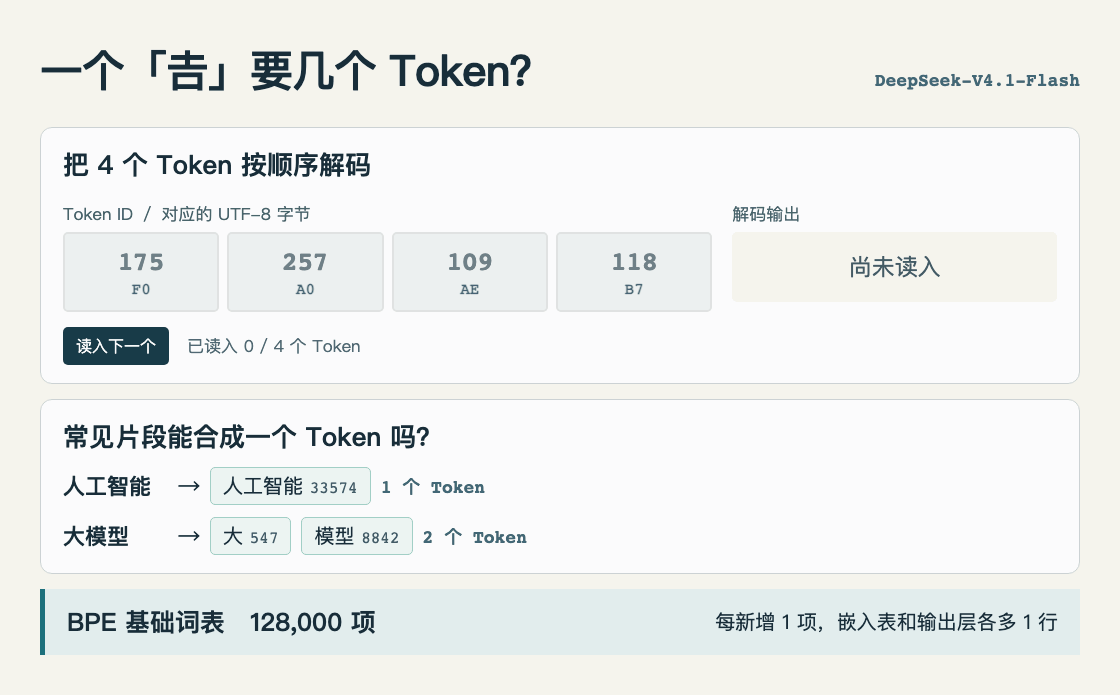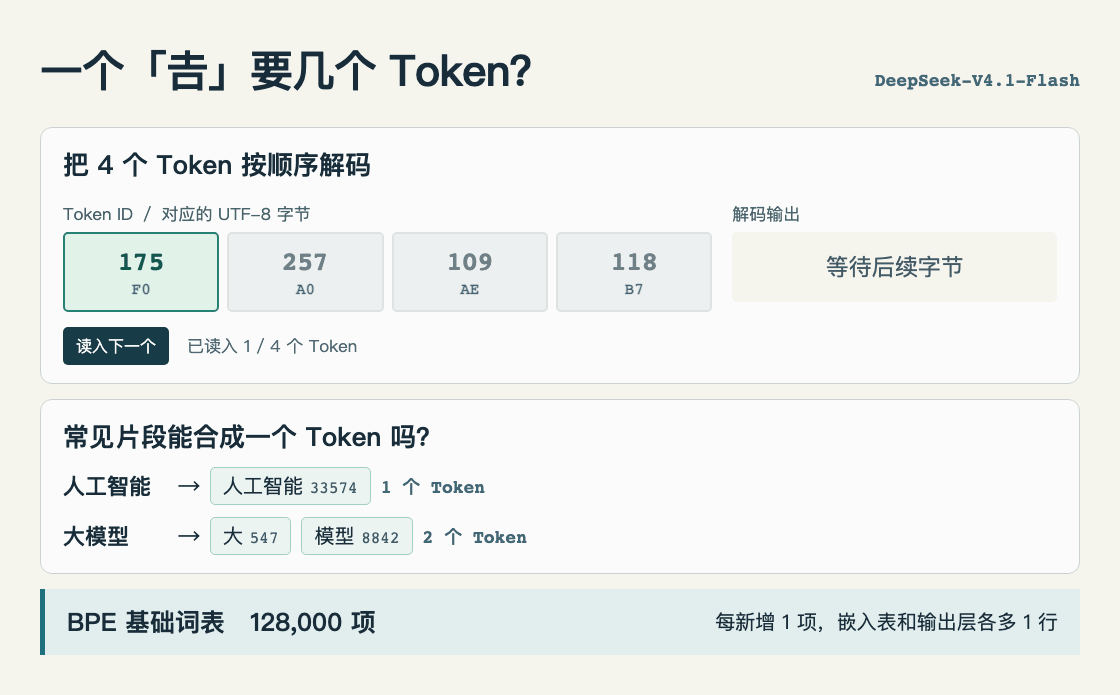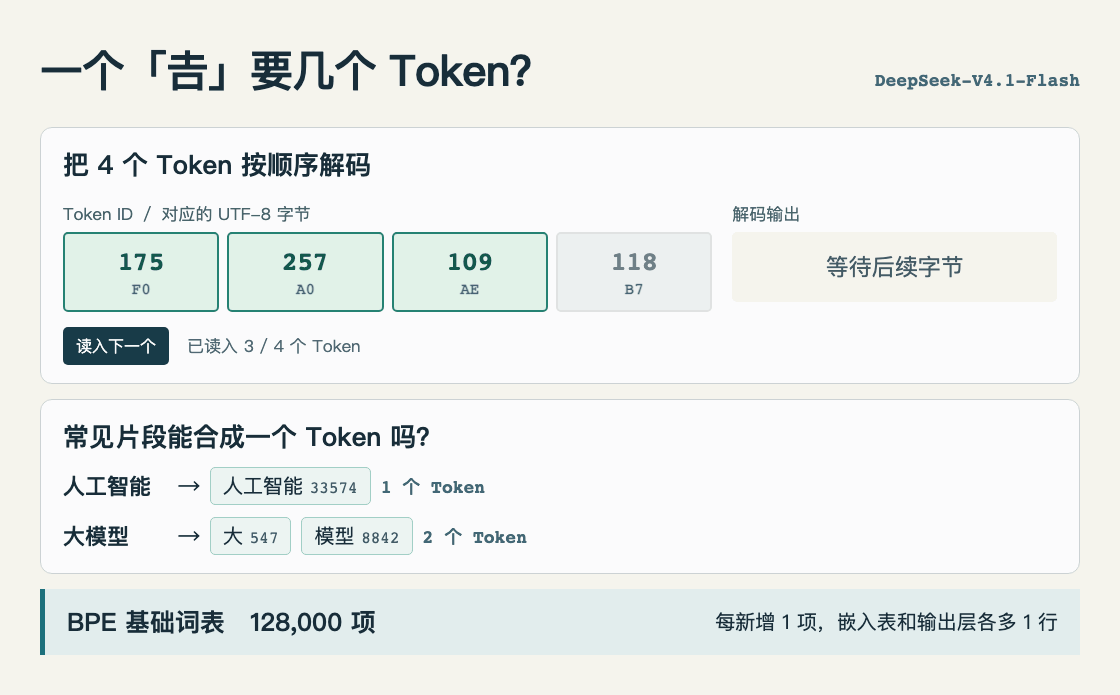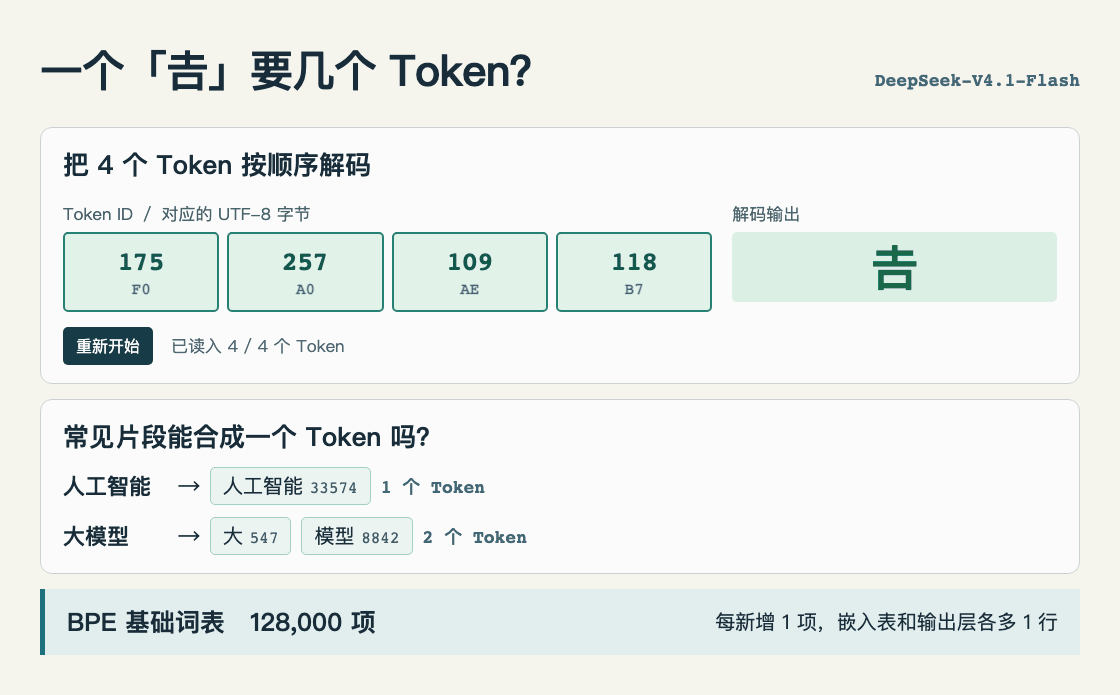
DeepSeek-V4.1-Flash 用的是字节级的 BPE,BPE 基础词表大小是 128K,也就是大约 12.8 万个 Token。
第一,生僻字也能编码。如果只按字符查表,也没有字节回退机制的话,遇到词表里没有的生僻字、Emoji 表情或者特殊符号,只能用 <unk>来表示。字节级 BPE 会先把所有文本转换成 UTF-8 编码的字节,而一个字节只有 256 种可能的取值,所以初始词表就是这 256 个字节,任何文字都能用它们表示出来。在这个基础上,常见的字和词会在合并过程中变成单独的 Token;万一碰到词表里没有收录的生僻字,分词器也能用字节片段来表示。比如“𠮷”在这版分词器里占 4 个 Token,放在一起解码,就能还原成原字。模型懂不懂字义,还要看它在训练里学到了什么。
第二,切出来的 Token 更少。比如“人工智能”合并成了 1 个 Token,“大模型”则切成“大”和“模型”两个。常见片段合并之后,同样大小的上下文窗口就能装下更多内容。另外,在开始合并之前,DeepSeek 会先用正则表达式划分片段,空格有时会和后面的英文留在同一个片段里。
第三,词表太小,文本会切得很碎;词表太大,比如做到几十万甚至上百万,模型负责把编号转成向量的那一层,和负责给词表里每个 Token 算概率的那一层,在向量维度不变时,参数量都会随词表大小线性增长,显存占用也会增加。当前版本的 DeepSeek 选择了 128K 的基础词表,在序列长度和参数开销之间做了取舍。
恭喜你升到王者段位了,成功击败 99% 的学习者。
最后简单总结一下。分词器把我们的输入切成一个个 Token,再查词表转换成数字编号交给模型。