如果你回答“还有 Memory 和 Planning 吧”或者“不就这两样吗”,恭喜你,出门右拐回家等通知吧。
为什么?
因为 Memory 和 Planning 是 Agent 的能力维度,它们在 Harness 里的落脚点是 Context 和工作模式。Memory 最终是以上下文的形式进模型的,Planning 只是一种计划模式,负责规划后再执行任务。真正让生产级 Agent 稳定运行的,是另外三项,约束 Guardrails、验证 Evaluation 和纠错 Recovery。
我翻了 VILA-Lab 对 Claude Code 的源码分析论文和李博杰的《深入理解 AI Agent》(需要PDF的可以callback我),可以自信地、大方地、光明磊落地帮你搞清楚这三件事。
第一,Harness 是什么,五要素分别是什么? 第二,五个要素各管什么事,解决了什么问题? 第三,工程上怎么落地,生产级代码是怎么实现的?
先说第一件事。
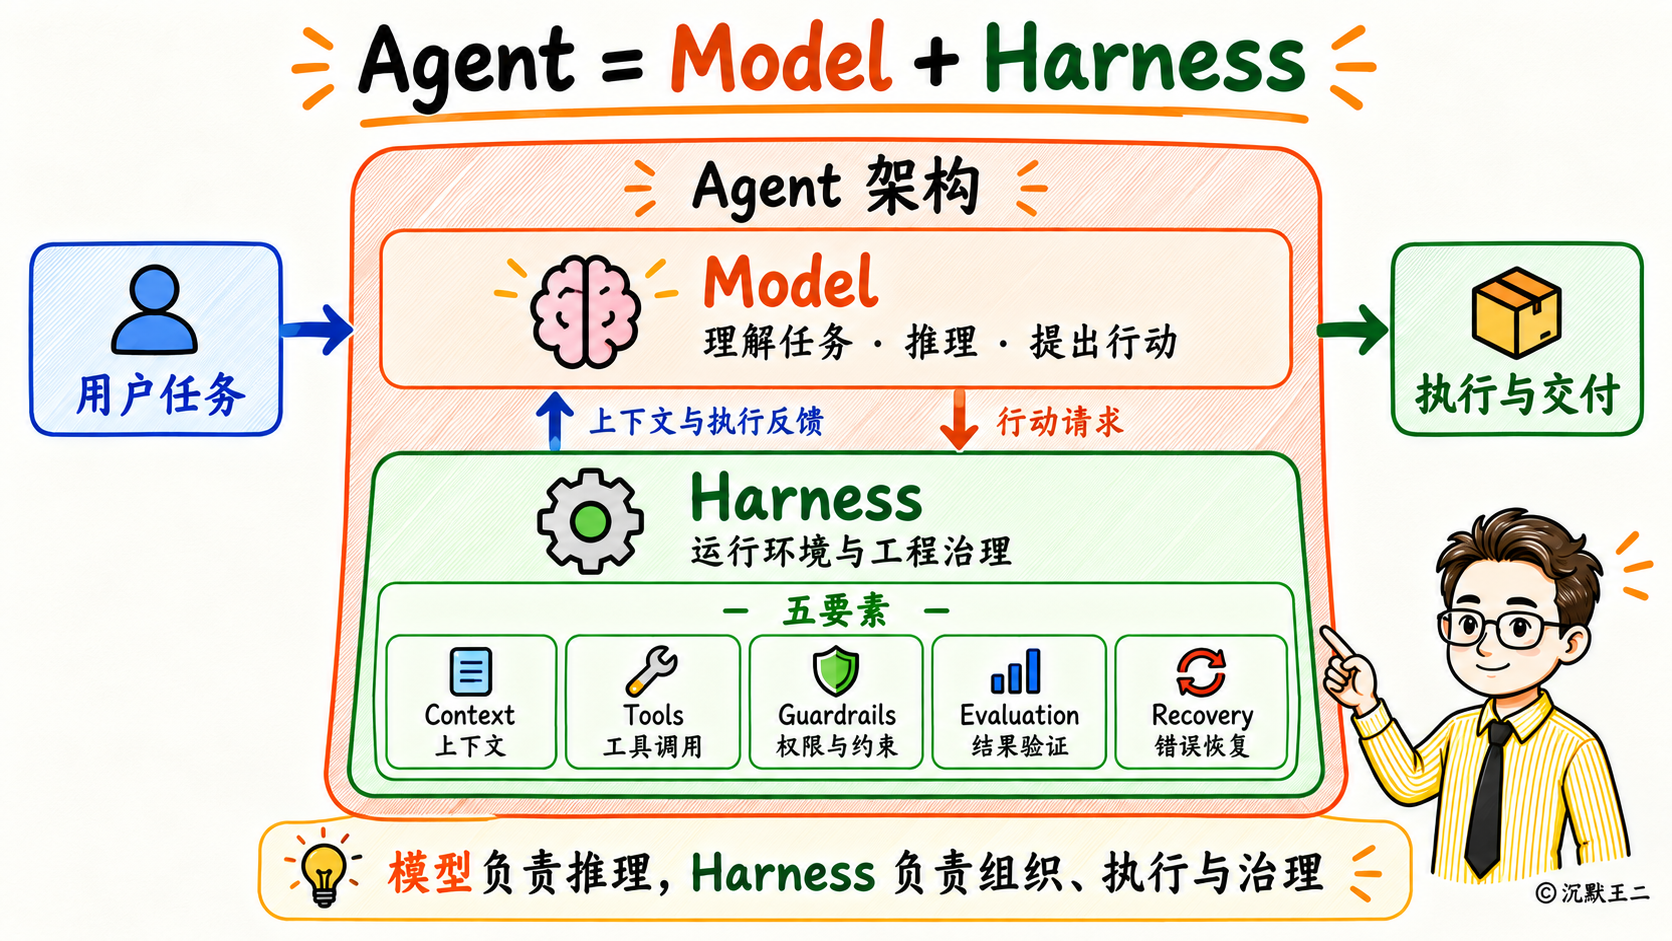
Agent = Model + Harness。Model 是负责推理,Harness 是模型之外 Agent 的运行治理环境。Harness 的本义是马具,大模型就像爆发力极强的野马,给它套上缰绳和马鞍,才能在受控的轨道上全速奔跑。
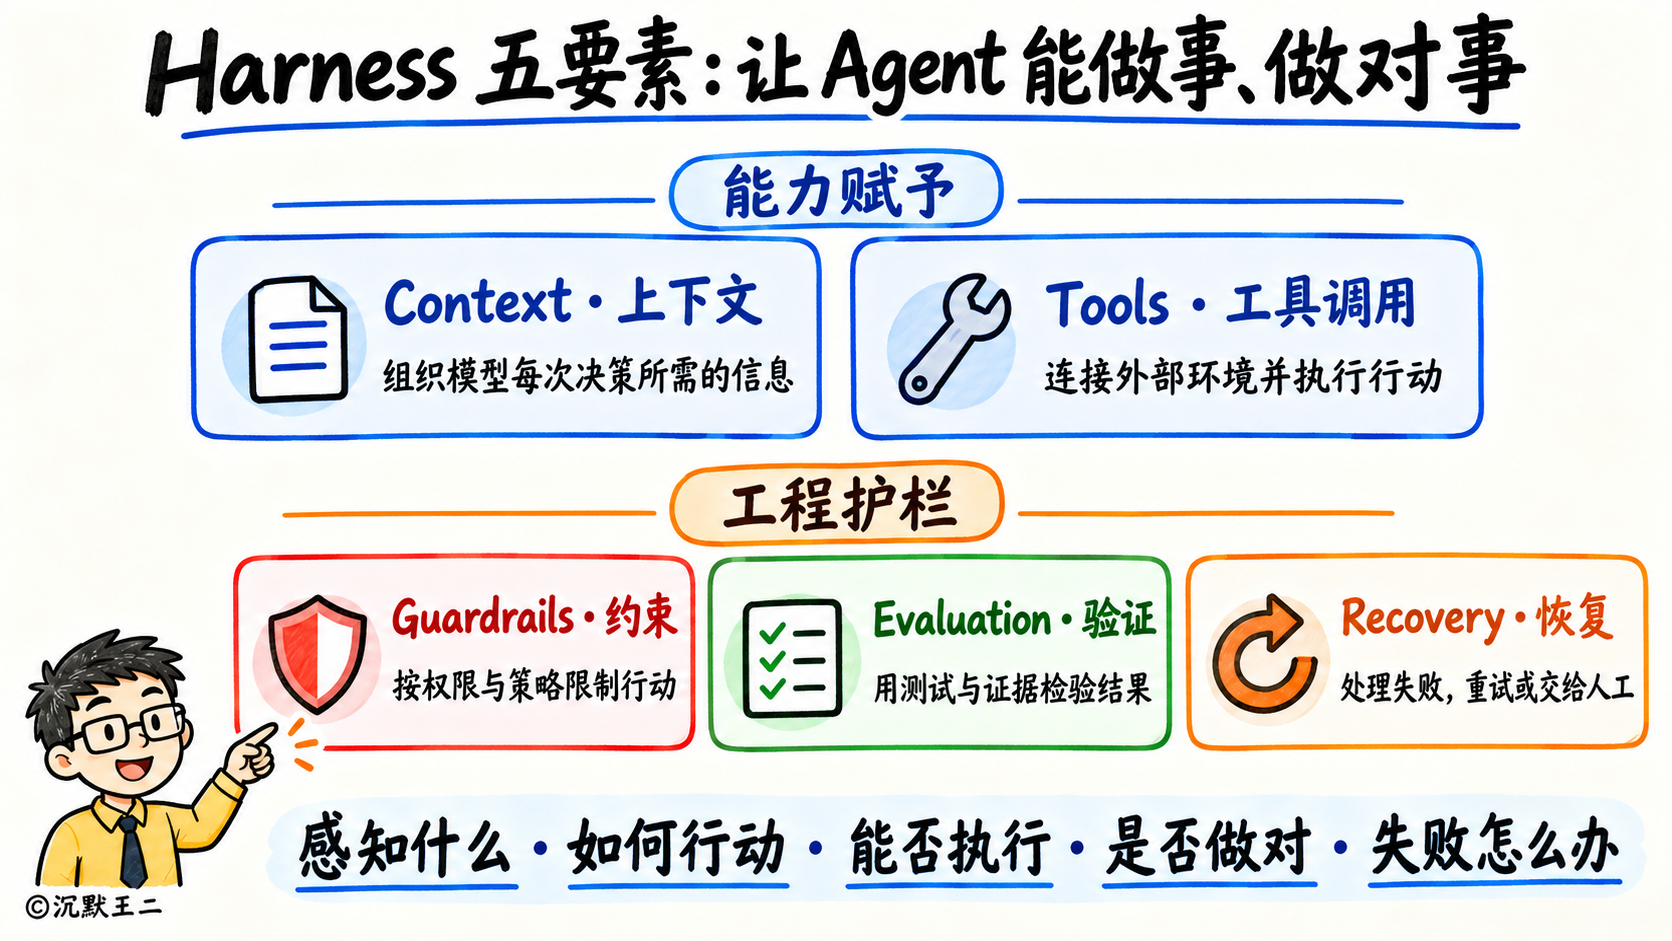
五要素分别对应上下文管理 Context、工具调用 Tools、约束 Guardrails、验证 Evaluation、纠错 Recovery。前两项管能不能做事,后三项管能不能做错事,做错了怎么办。
那聪明的你肯定要问:这五个要素各管什么事?
Context 管模型能感知什么。负责 System Prompt、历史会话、Skill 及工具执行结果的组装与状态维护,核心目标是让模型每次决策时看到的都是高质量的信息。
Tools 解决“模型如何与外部环境交互”的问题。负责工具的注册、定义(JSON Schema)、MCP 协议适配和具体的执行。
Guardrails “限制模型不能做什么”。删文件、跑脚本、访问敏感文件,这些高危操作必须要有拦截能力,防止模型失控、越权或者产生不可逆的破坏。而且高危操作必须要触发 HITL(人机协同审批),且判定逻辑必须硬编码在 Harness 层,不能交给容易受提示词注入影响的模型自身。
Evaluation 解决“如何客观判断模型做对了没有”的问题。不能盲目信任模型自称的“任务已完成”,必须引入外部的确定性反馈。
Recovery 管模型做错了怎么恢复。带着报错信息让模型反思后重试,连续失败时触发熔断,并能打断任务交给人工处理。
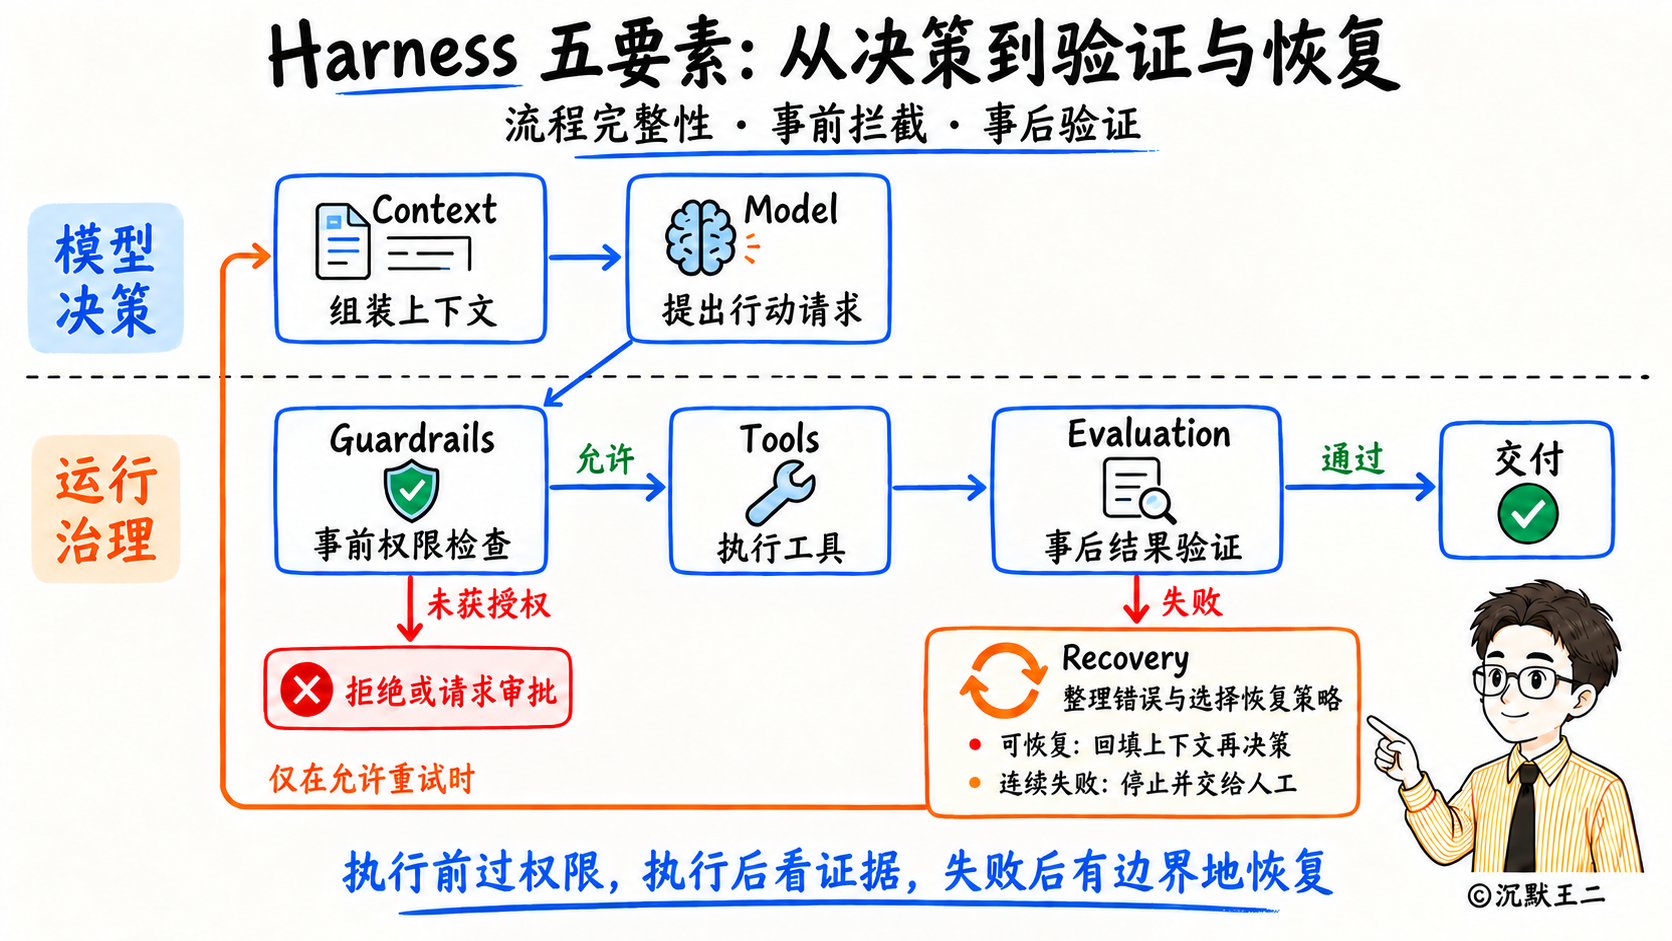
那聪明的你肯定又要问了:工程上怎么落地?说说真实代码是怎么实现的。
拿 Claude Code 来举例。
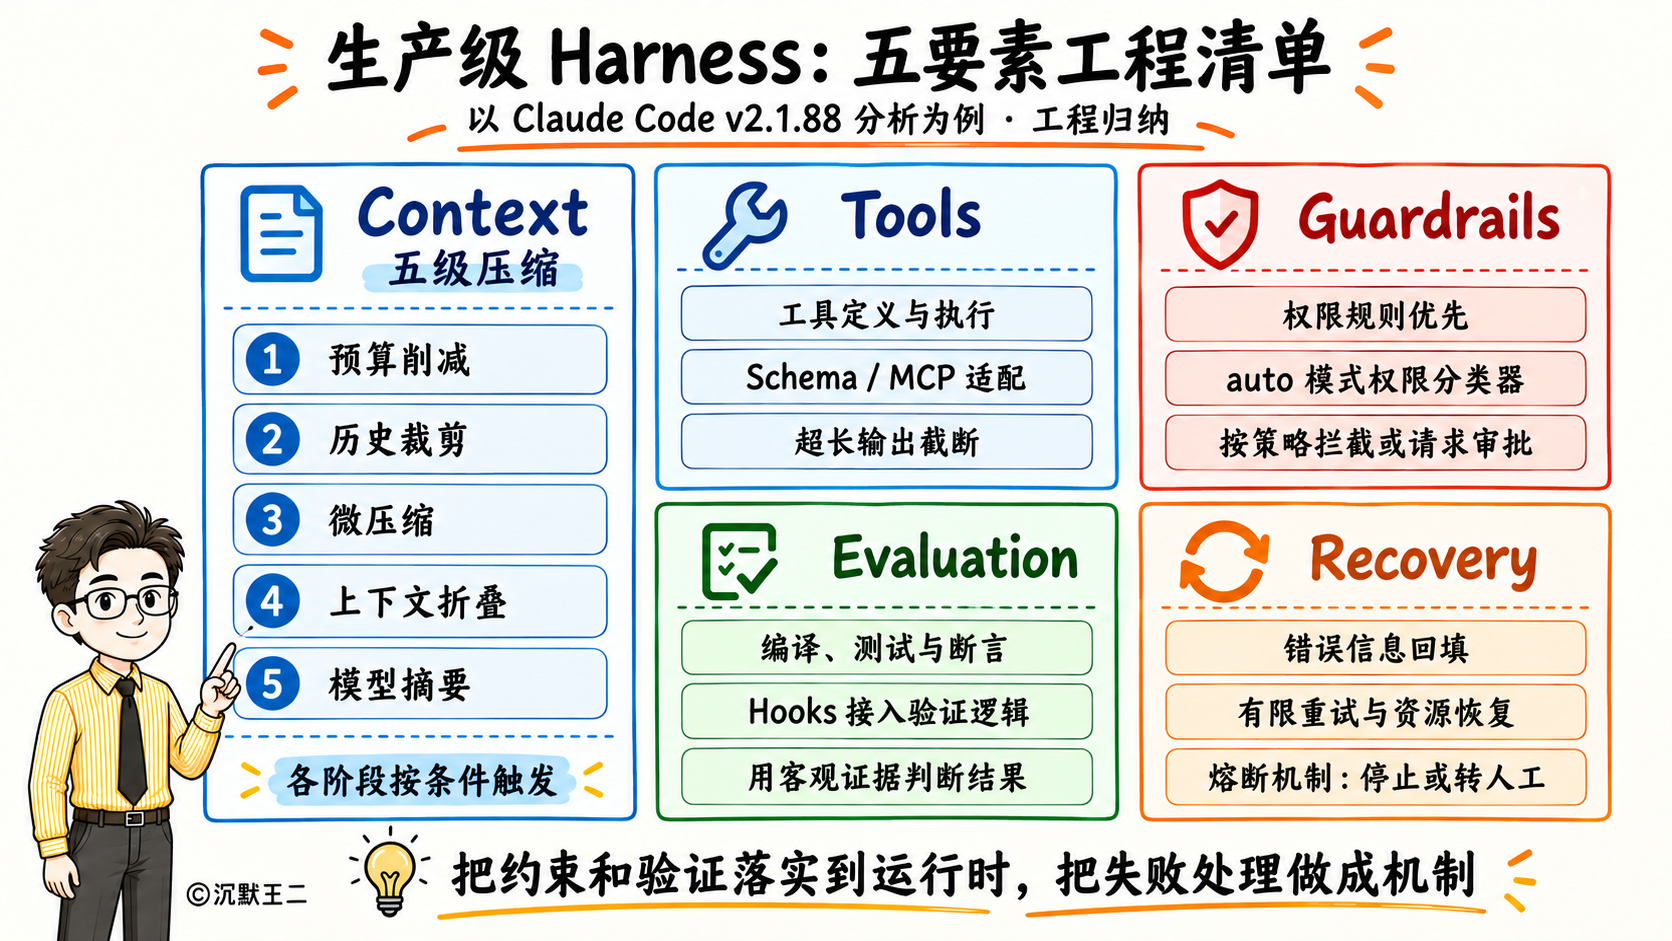
Context 要解决的问题是上下文越来越长怎么办。Claude Code 在把用户的输入发送给大模型之前会经过五个阶段,第一个阶段是预算削减,给单条消息里的工具结果设一个大小上限;第二个阶段是历史裁剪,把过旧的、没用的对话直接删掉;第三个阶段是微压缩,专门清理较旧的工具结果;第四个阶段是上下文折叠,做读取时的虚拟投影;第五个阶段才是自动压缩,让模型生成摘要。前四个阶段是确定性的规则,只有最后一个阶段才会调用 LLM。之所以不直接让模型总结,是因为 LLM 生成摘要本身就要花 Token,而且是有损的,能用规则解决的就不要碰模型。
Tools 要预防的是输出直接把上下文撑爆,比如让 Claude Code 跑一条 git log,输出可能几万行,全塞进上下文,系统指令和会话历史的权重就被噪音淹没了。超长的输出一定要有截断机制,保证工具结果不会把关键信息挤出上下文。
对于 Guardrails,Claude Code 有七种权限模式,auto 模式下会启动一个独立 Sonnet 分类器判定每次工具调用是否危险,这个分类器看不到主模型的推理文本。因为主模型可能在推理里写了【这个删除是用户明确要求的】,从而诱导分类器放行。分类器只看工具名和参数,这样就不会被主模型的推理干扰。
Evaluation 的原则是只认客观物证。编译器的状态码、语法树的差异、单测的断言等等,模型说【代码已修复】是没用的,必须跑一遍全量测试才算。因为模型的自我评估可能会被提示词注入操纵,也可能就是产生幻觉了。Claude Code 有 27 个钩子事件(Hooks)可以插桩验证逻辑,比如工具执行完先经过 PostToolUse 钩子,才允许收尾。
模型最容易犯的错不是不会做,是错了之后还想接着做,所以 Recovery 干的第一件事,是让模型必须看到真相。Claude Code 会把报错的堆栈清洗一遍再回填上下文,只留能定位问题的信息,不带噪音。真到了 Token 输出的上限,它会逐级放宽限制重试,每轮最多 3 次。上下文吃紧先做一次上下文折叠,再压缩,如果还不行就终止。
VILA-Lab 曾分析过 Claude Code v2.1.88 的源码快照,给出这样一个暴论,在 Claude Code 中,98.4% 的代码都是在做 Harness,只有 1.6% 是 AI 决策逻辑。
最后简单总结下。
Context 和 Tools 是 Harness 最基本的两项要素,Guardrails、Evaluation、Recovery 是 Harness 的安全边界。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!