如果你回答“肯定选更强的 LLM 啊,模型越聪明,Agent 不就越厉害吗?”,恭喜你,出门右拐回家等通知吧。
为什么?
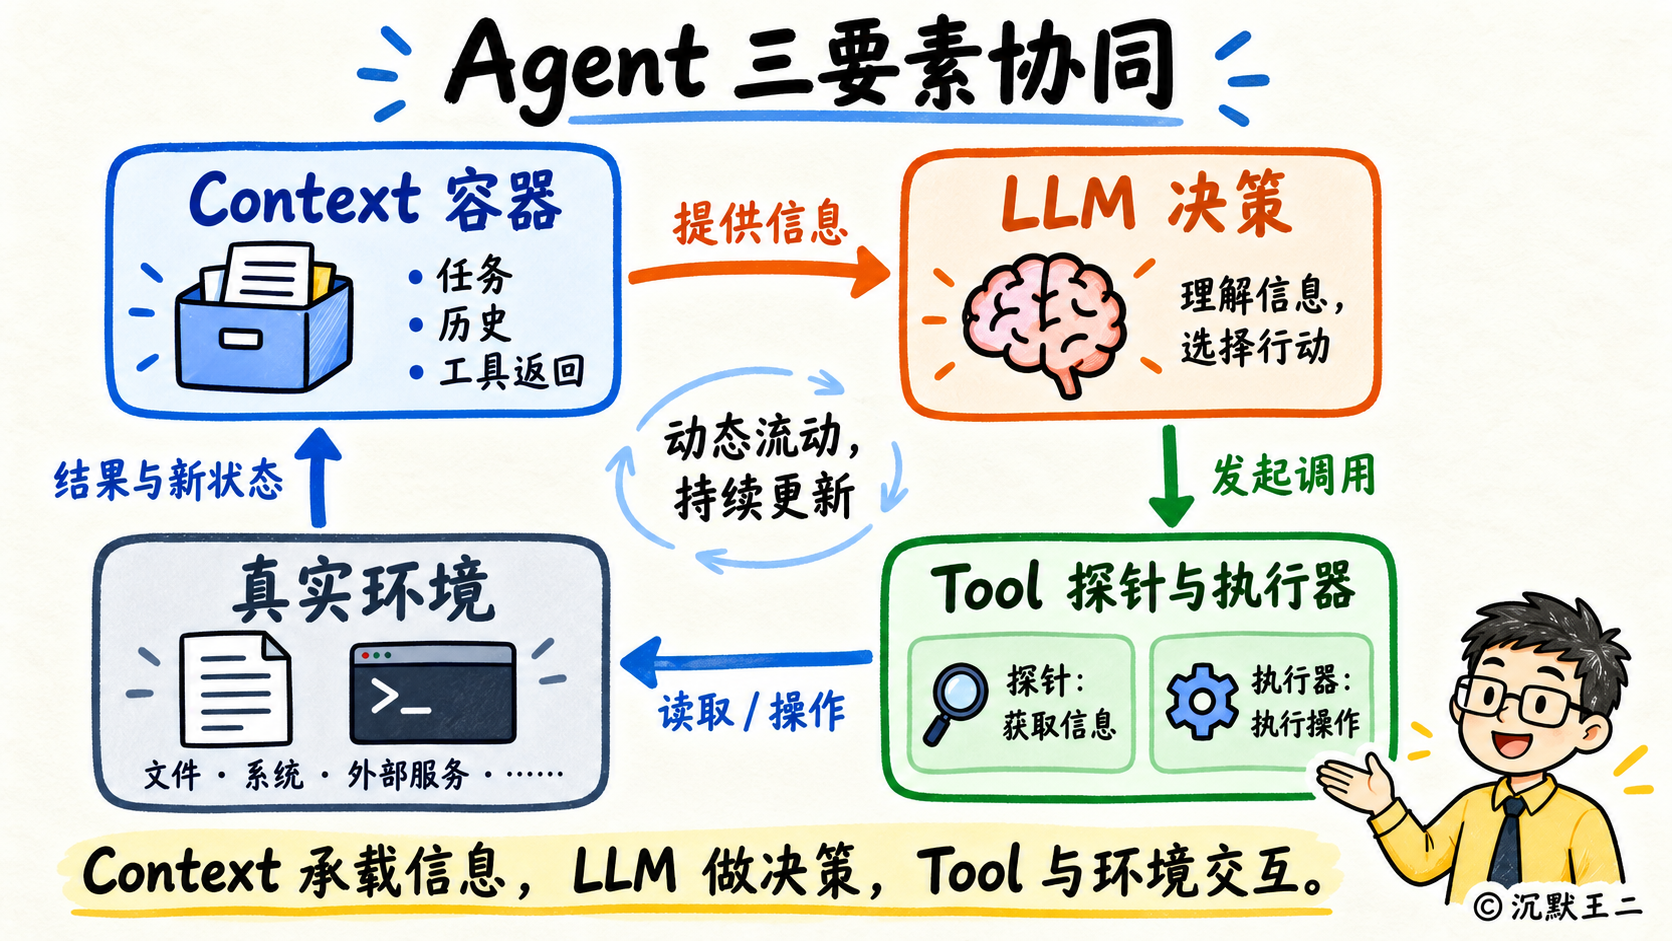
因为这道题本身就是个陷阱。你以为 Context 只是被动接收信息的容器,Tool 只是机械干活的工具,真正决定成败的是 LLM 的智商。但反过来说,模型再聪明,看不到报错信息也修不了 bug,拿不到数据库的最新表结构也不能帮你优化慢 SQL 的性能。Context 决定模型能看见什么,Tool 决定模型能动手做什么,三者缺一不可。
我翻了李博杰的《深入理解 AI Agent》(需要这本书的可以 call 我)、Claude Code 的工程架构分析,以及 Codex 的官方技术报告,可以自信地、大方地、光明磊落地帮你搞清楚这三件事。
先说第一件事,为什么盲目堆更长的 Context 反而是陷阱。
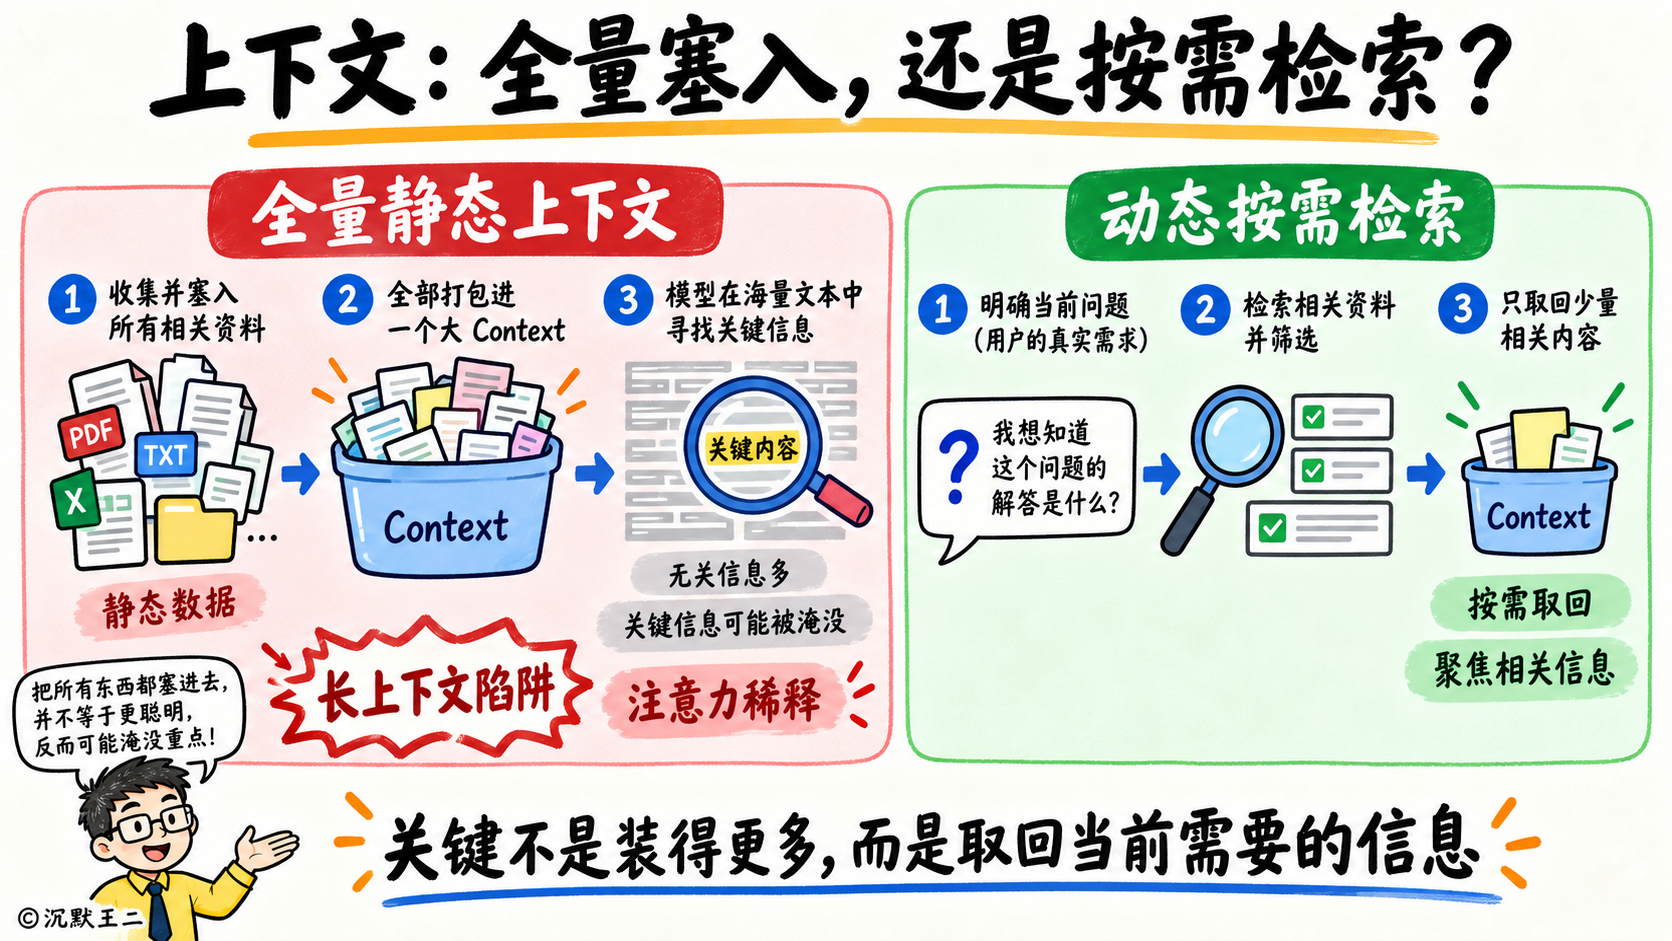
很多开发者做 Agent 时有一种执念,以为只要把上下文拉到一百万 Token,把整个项目的代码和文档一口气全塞给模型,问题就能迎刃而解。
但实际跑下来,不仅 Token 扛不住,Agent 给的解决方案仍然不是你预期的结果。
原因有两点。第一,模型在超长序列中容易出现注意力稀释,有个很出名的现象叫“lost in the middle”,把关键信息放在长上下文的开头或者结尾,比放到中间更容易让模型看得到。因为 Transformer 的注意力机制在处理超长序列时,分配给中间位置的权重会降低,关键信息就被前后的海量文本“淹没”了。上下文越长,中间信息的召回率就越低。第二,被动塞入的都是静态文本,运行时的异常和 error、测试的反馈、数据库的变动,模型根本无法感知到。
Context 不是越长越好,关键是里面装的信息够不够精准、够不够新鲜。
那聪明的你肯定想到了:既然被动塞 Context 不行,Tool 到底怎么解决这个问题?
Anthropic 官方博客就曾提到,不要让 Agent 把整个代码库都装进上下文,而是让它用搜索和 grep 去按需取回自己最需要的。
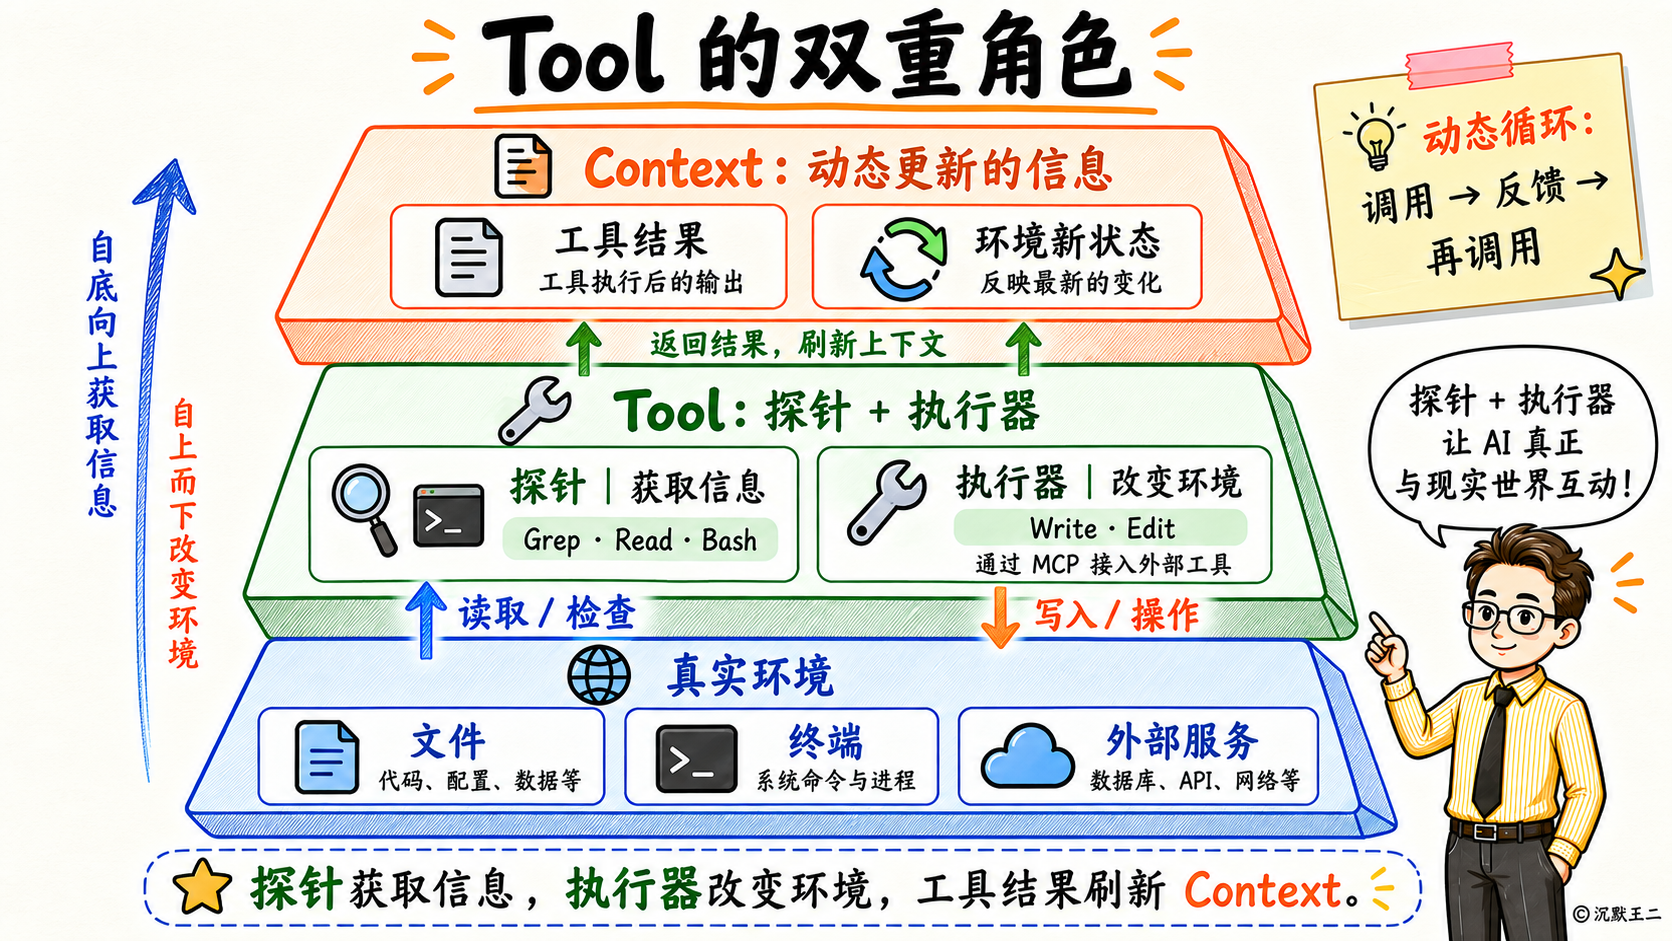
Tool 的第一个角色是探针,就是主动伸进真实环境里获取实时信息的工具。Claude Code 用 Grep 搜代码、Read 看文件、Bash 在终端跑测试看报错,每次调用后的返回值实时追加到 Context。模型不再是坐在那里等你喂信息,而是自己伸手去环境里翻、去现场看。
Tool 的第二个角色是执行器。Write 和 Edit 能改文件,接上 MCP 之后还能连上数据库、云端服务、第三方 API。这意味着 Tool 不仅能帮模型“看到”世界,还能帮模型“改变”世界。而改完之后产生的新状态又会回到 Context 里,形成“调用工具,获取信息,做出决策,再调用工具”的循环。
Claude Code 和 Codex 之所以能在 AI 时代备受大家推崇,除了他们配置的模型能力强之外,就是因为它们在上下文处理上、工具的调配上,有着更优雅的解决方案。
Tool 是 Agent 里唯一能同时感知环境和改变环境的变量,每一次工具调用都在为下一轮决策刷新上下文。
那聪明的你肯定又要问了:既然 Tool 这么强,那什么时候才真的需要换更强的 LLM?
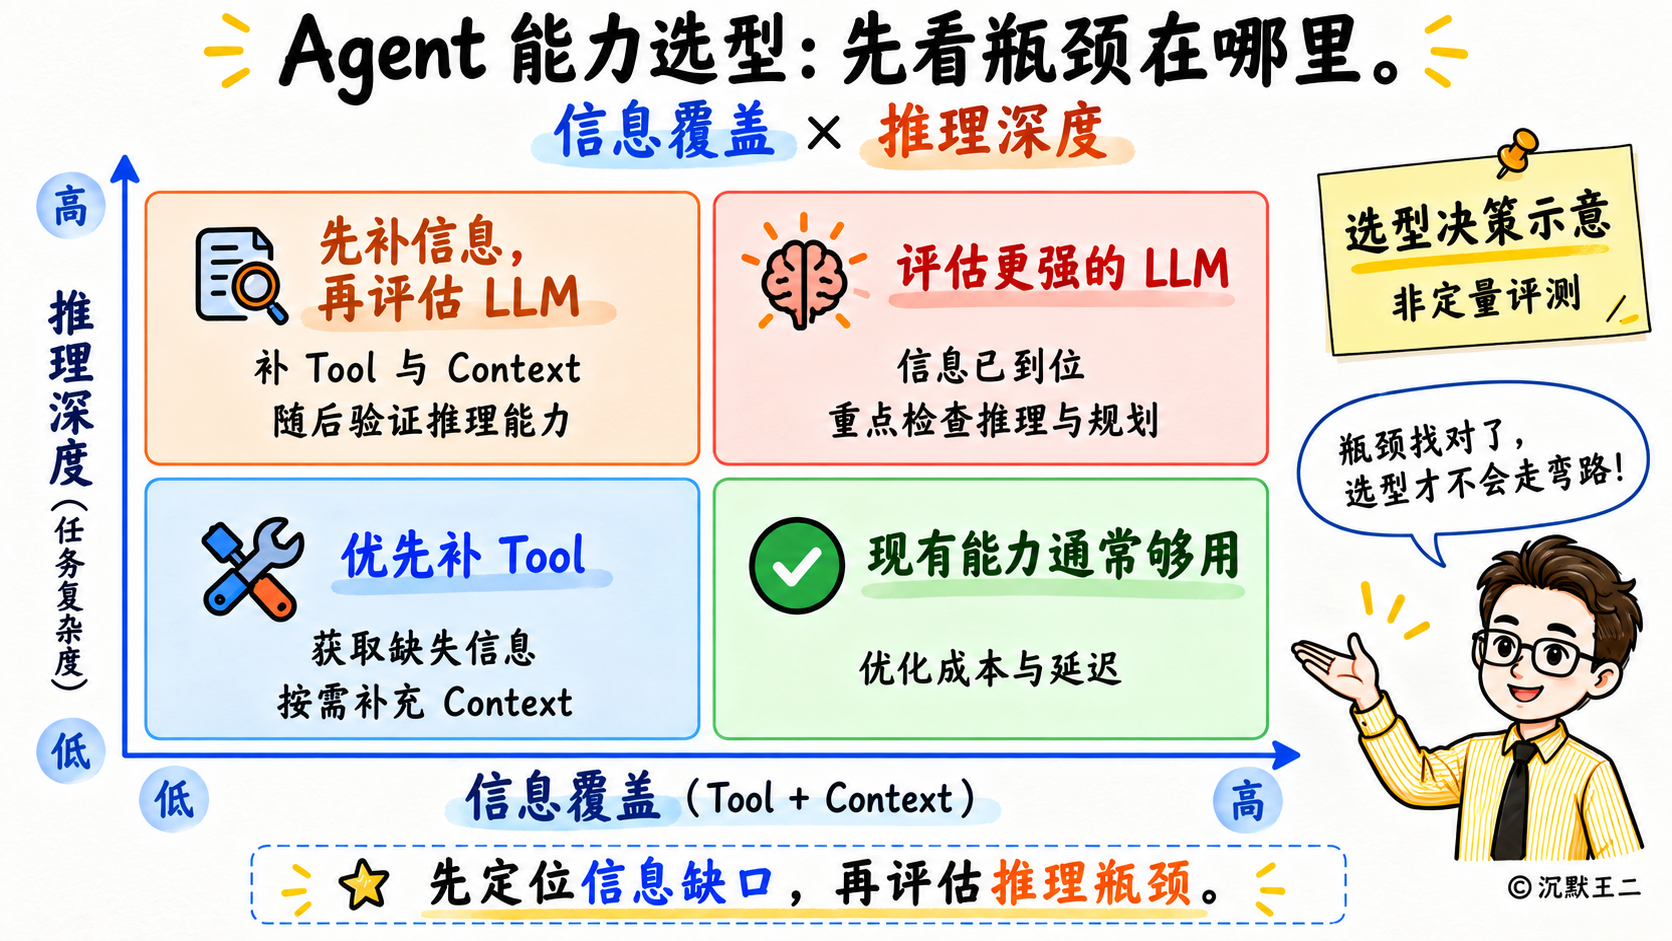
当出现后面这三个信号时,说明瓶颈已经不在信息够不够了,而在推理深度。
第一,任务要连续跑几十轮以上,中间某一步开始反复做同一件无意义的事,陷入死循环。第二,Tool 已经把精准的信息拉回来了,Context 里该有的都有了,但模型给出的方案仍然前后矛盾,把自己前面确认过的结论又推翻了。第三,同一个报错反复出现,模型换了好几种 Tool 去查,信息都拿到了,就是推理不出正确的修复方案。
这三个信号的共同特征是信息已经到位,问题出在模型的推理和规划能力。Tool 与 Context 决定 Agent 能不能接触到真实世界,LLM 的推理能力决定它在这个世界里能走多远。
最后简单总结下。
Context 承载运行时的全部信息,Tool 是主动获取上下文的探针与改变环境的执行器,LLM 是调度决策的大脑。遇到 Agent 跑不通,排查顺序是这样的,先看 Tool 有没有把关键信息给到 Context,再看 Context 里那几段关键信息有没有被淹没,最后才考虑换更强的 LLM。
另外,这三项如果只能补一项,优先补 Tool。因为加一个 Tool,既能让模型看到之前看不到的信息,又能让模型做到之前做不到的操作,一次投入同时撬动感知和执行两个维度。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!
视频封面