
为什么?
因为 Anthropic 的《Building effective agents》告诉我们,Agent 做得最成功的团队,都没有用复杂的框架,保持简单,保持透明,精心设计 ACI 才是最重要的。
模型当然重要,但一个 Agent 到底好不好用,还得看 Harness。Codex 之所以成为这个时代最好用的 Agent,除了 GPT 系列模型足够强之外,就是因为 Harness 做得足够好,不管是 Computer Use、Browser Use,还是 Memory、钩子、插件、Worktree,都做得无可挑剔。
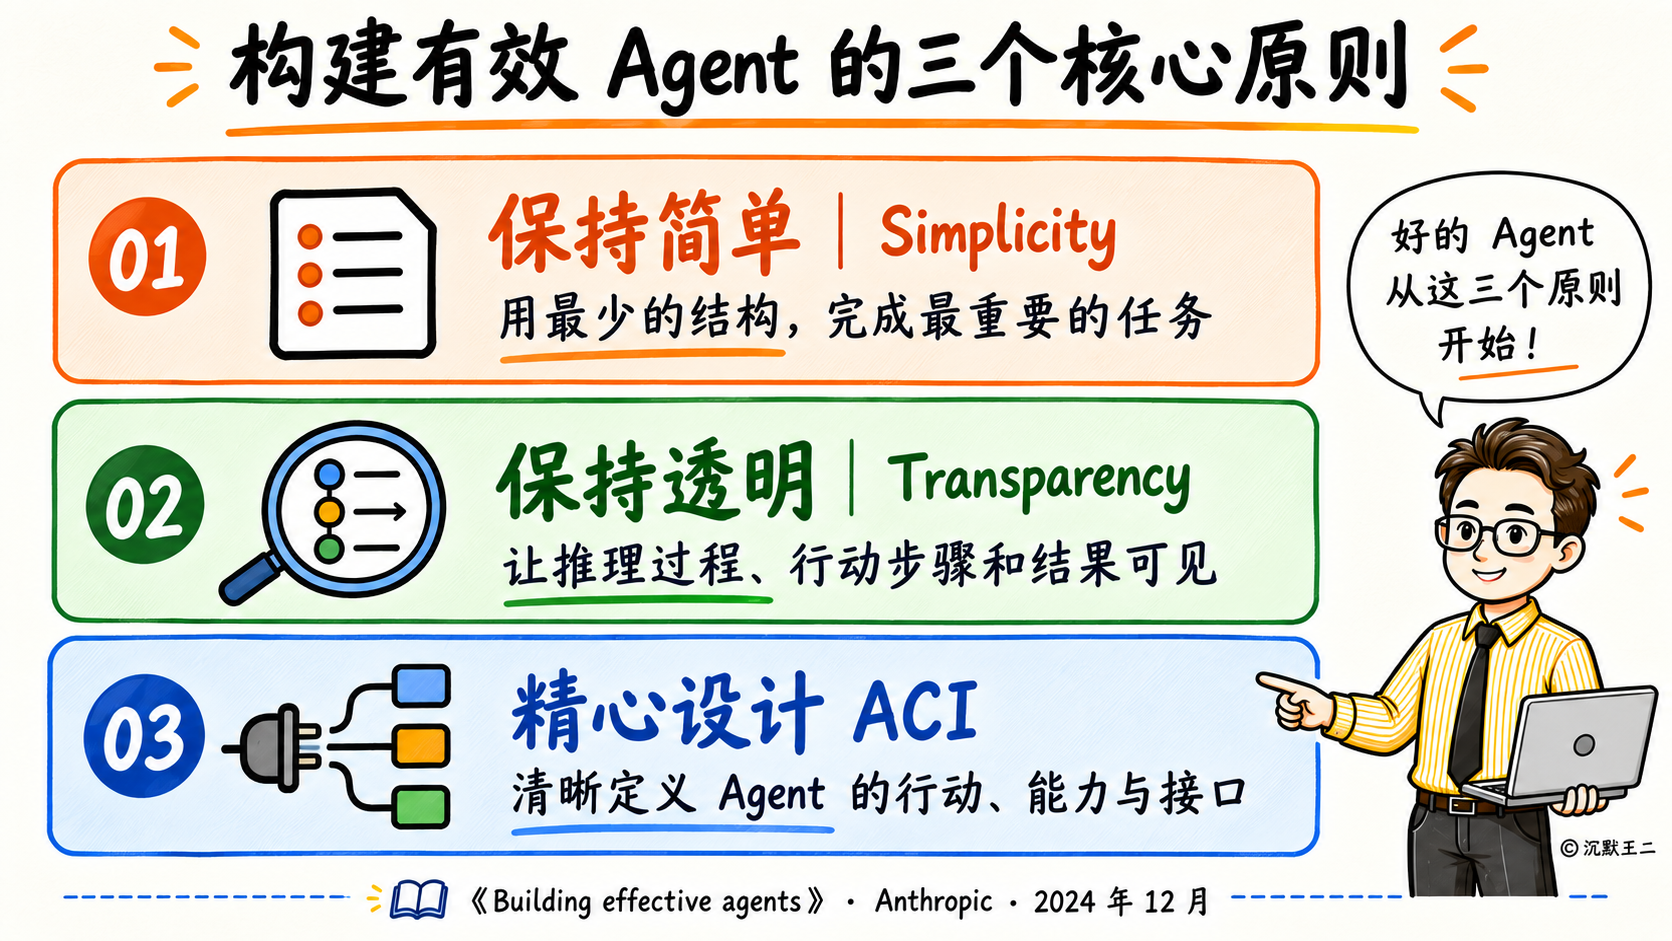
哈喽大家好,我是二哥呀。我翻了 Anthropic 的原文和 Pi 的源码,今天就拿 Pi 这个开源 Agent 帮你把这三条原则讲清楚。
先说第一条,保持简单。
先找最简单的方案,确实需要的时候再增加复杂度。一次模型调用加上 RAG 就能解决的问题,没必要上 Agent Loop。
框架多出来的抽象层,会把提示词和模型的输入输出隐藏在底层,出了问题很难调试。能直接调用 LLM 的 API 拿到结果,就不要引入 LangGraph4J 这类框架。
在这方面做得相当不错的是 Pi。它默认只给模型开放 read、bash、edit、write 四个工具,连 grep、find、ls 都没有。Pi 的系统提示词是按开启的工具动态拼接的,只要这三个工具没开启,它就会在规则里补上一句“Use bash for file operations like ls, rg, find”,让模型直接用 bash 去搜。
为什么?Anthropic 就建议,工具的格式要尽量贴近模型在互联网上见过的文本。rg、find 这些命令,模型在训练数据里见过无数次,用起来反而更顺手。
Anthropic 在 2025 年 9 月发布的《Effective context engineering for AI agents》里就讲过,如果你都说不清该用哪个工具,就别指望 Agent 能选对。
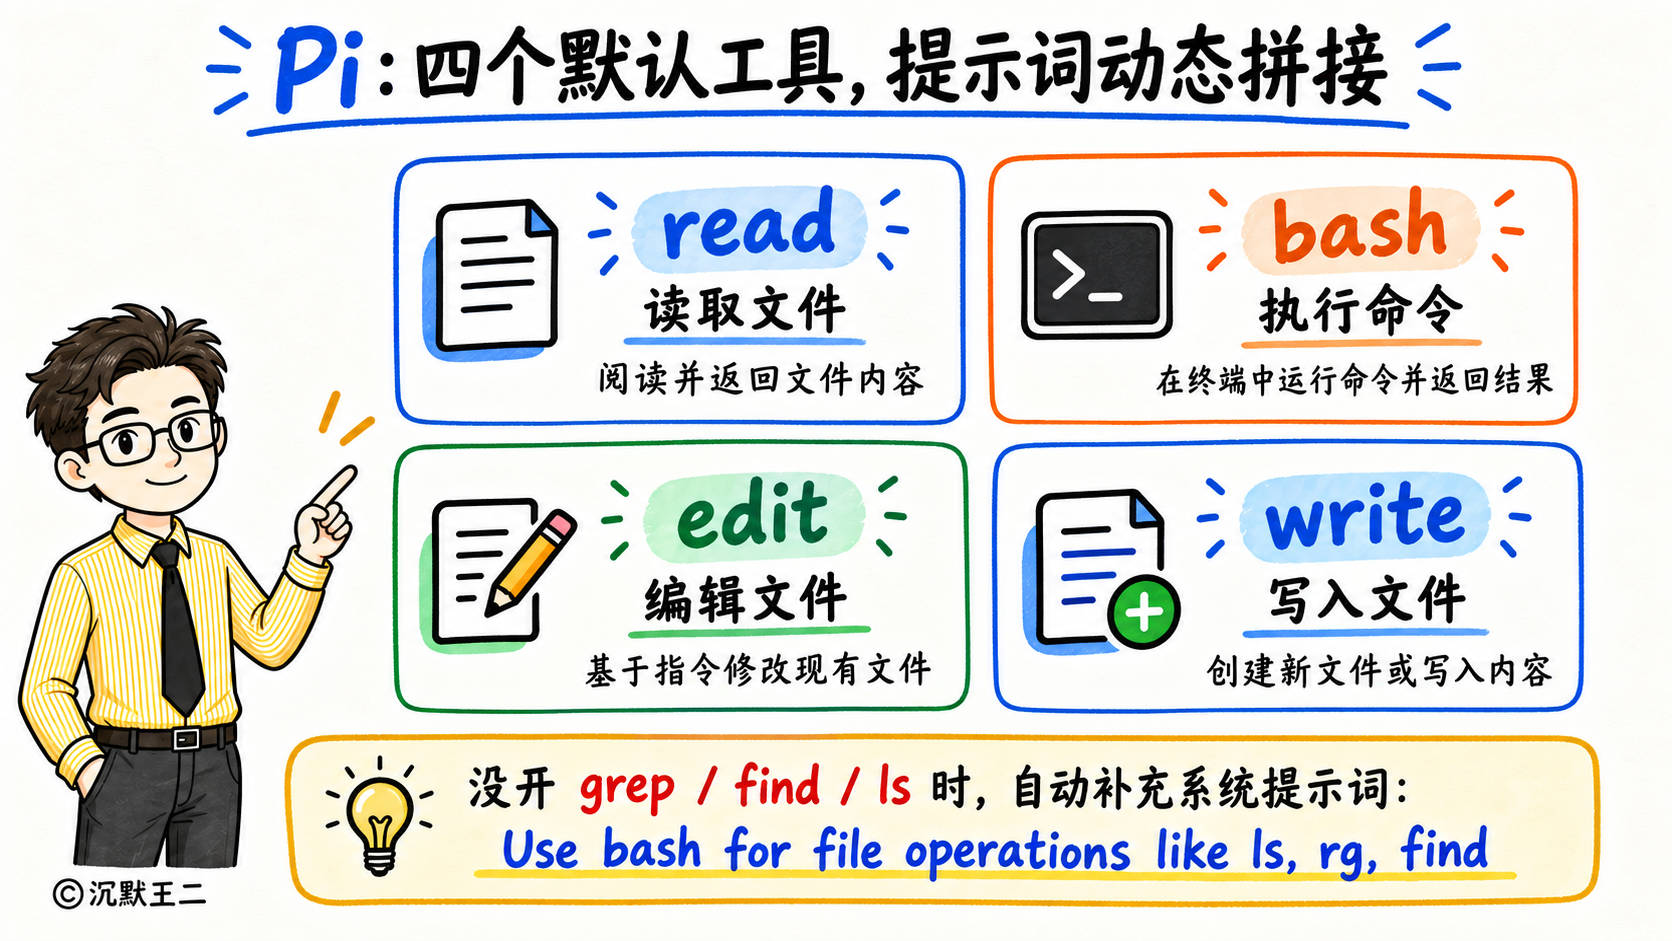
工具越少,模型越不用纠结该选哪一个。
那聪明的你肯定想到了:Agent 跑偏了怎么办?
保持透明。
Agent 要显式展示具体的执行步骤,每一步都要从真实环境里拿到结果,比如工具的返回值、代码的执行结果,然后再判断自己有没有走对。
如果你用过 Claude Code 应该就见过,它接到复杂任务时会先列出一份 todo list,做完一项就打勾一项。具体的执行步骤也会实时展示在你面前,如果你感觉它跑偏了,可以及时纠正。
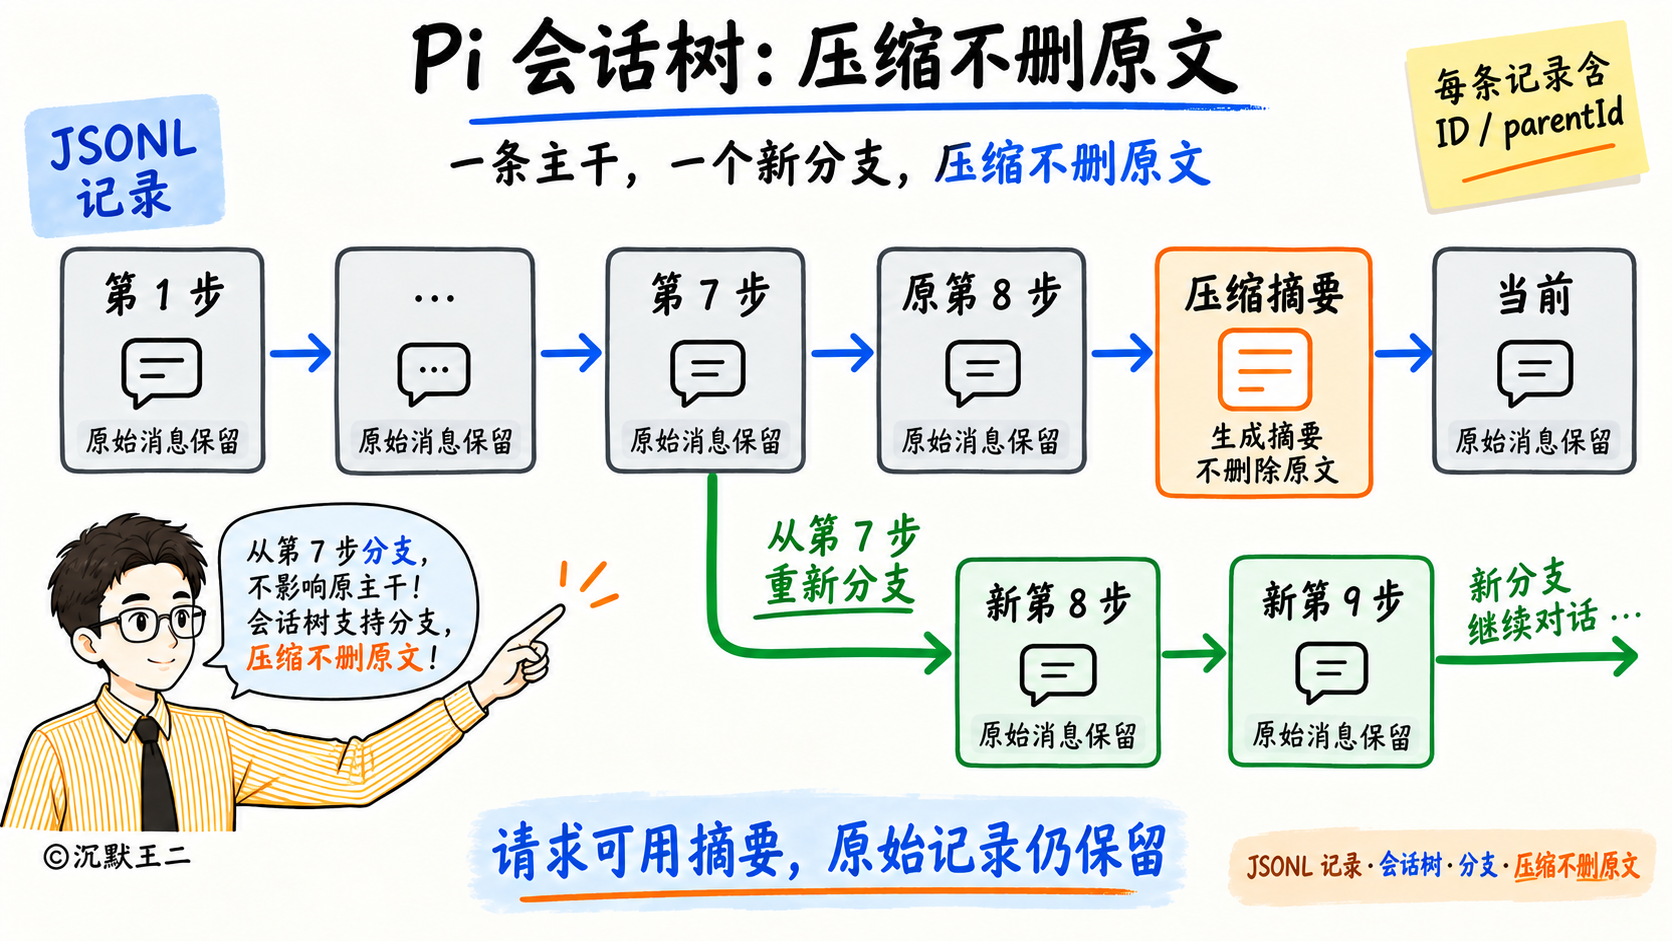
Pi 在这一点上做得更开放。它把每个会话存成一个 JSONL 文件,每条记录都有自己的 ID 和父节点 ID,消息、工具调用、工具结果、模型切换、上下文压缩,全都记下来。
上下文太长需要压缩时,Pi 会插入一条摘要记录,之后发给模型的请求会用摘要代替旧消息,但原始记录一条不会删除。发现 Agent 在第 8 步跑偏了,就可以从第 7 步重新分出一个分支,前面得就不用重跑。
那聪明的你肯定又要问了:ACI 是什么?
Agent-Computer Interface,也就是 Agent 和计算机之间的接口,说白了就是你给 Agent 设计的工具、插件、Skill,要把工具名、参数和描述都写得清清楚楚。我们曾经在设计 GUI 的时候花了多少功夫,为 Agent 设计 ACI 也应该花多少功夫。
Anthropic 在做 SWE-bench 的时候,花在优化工具上的时间就比花在提示词上的要多。就比如说 Agent 切换到子目录以后,传相对路径总是出错。他们就没有在提示词里反复叮嘱,而是把工具改成必须传绝对路径,模型就再也没出错过。
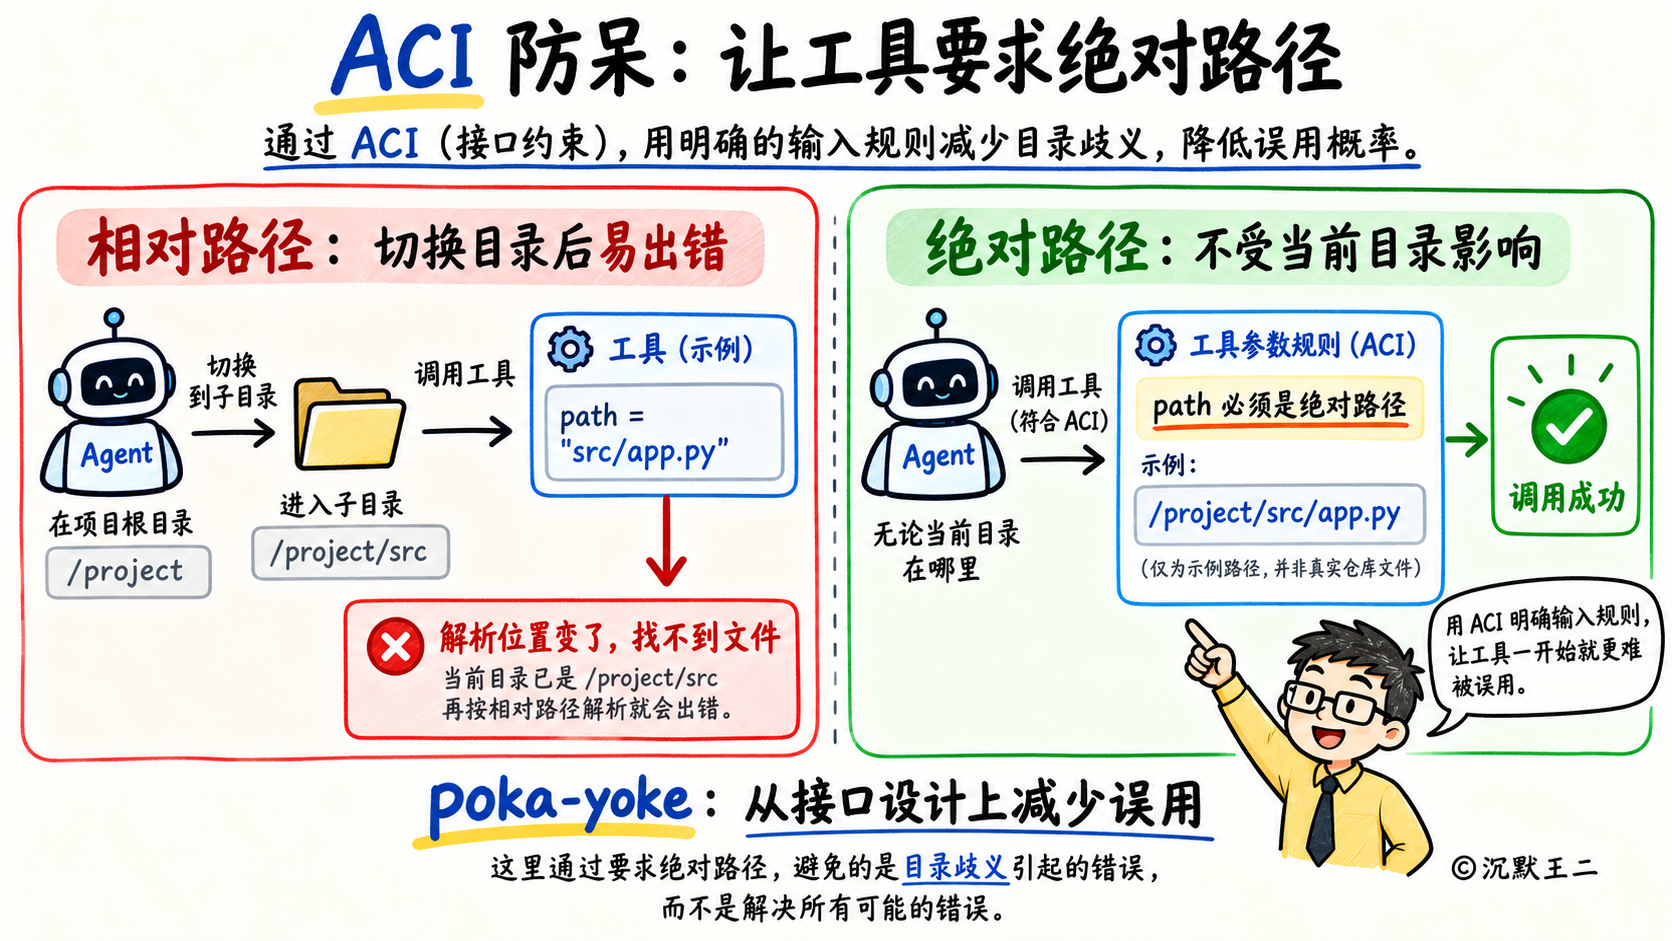
这种思路叫防呆设计(poka-yoke),让工具从设计上就很难被用错。Pi 的 edit 工具就是一个很好的例子。
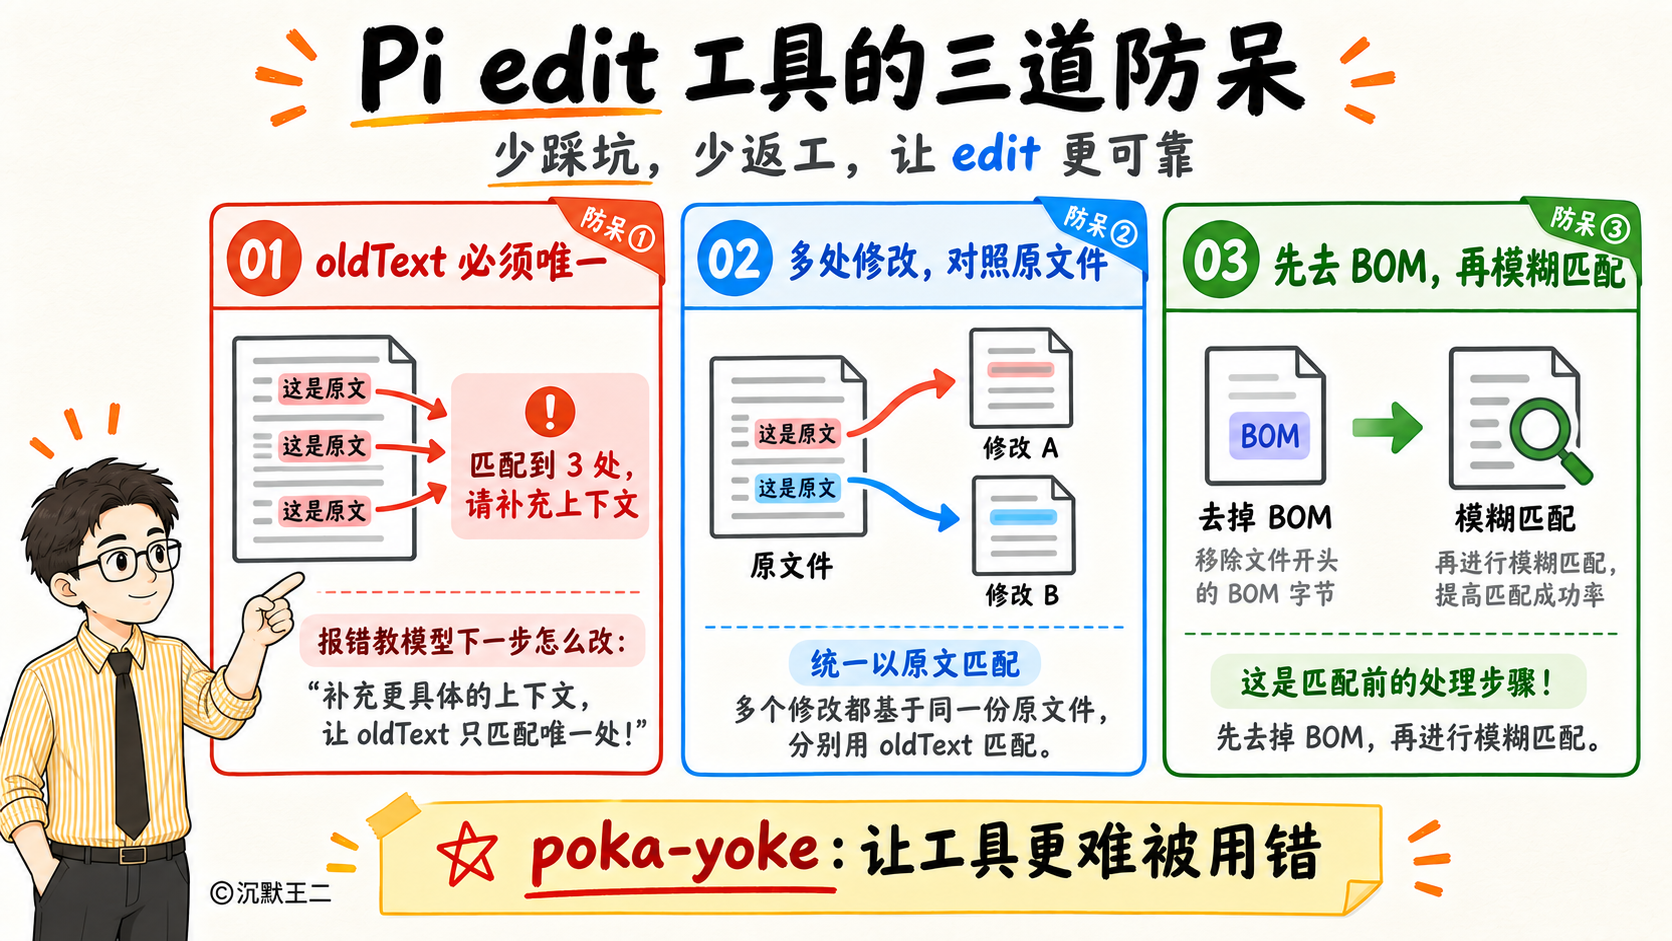
它的参数只有 path 和一个 edits 数组,分别是要替换的原文 oldText 和新内容 newText,为了防止 Pi Agent 出错,他们是这样设计的。
第一,oldText 必须在文件里唯一。模型只返回了一行“return null;”,文件里却匹配到 3 处,Agent 就直接报错,“Found 3 occurrences,Please provide more context to make it unique”。报错信息不仅要说清楚错在哪,还告诉 Agent 下一步该怎么改。工具的报错信息是发给模型的下一条提示词。
第二,多处修改对照原始文件去匹配,而不是改完一处再在新文件上找下一处,靠偏移量推断在一处很容易出错。
那好学的你肯定要问,GitHub 上有没有优秀的开源项目可以照着学啊?
有,必须得有。
第一个就是 Pi,将近 11 万星标。建议从 system-prompt.ts 和 tools 目录读起,能吃透 Pi 的源码,那你肯定能成为招聘市场上的香饽饽。
拥有 5.3 万星标的 claude-cookbooks,是 Anthropic 官方的示例仓库。它的 patterns/agents 目录用 notebook 把 Prompt Chaining、Orchestrator-Workers、Evaluator-Optimizer 这些模式都实现了一遍。
突破 2.6 万星标的 12-factor-agents,其中“own your prompts”和“own your context window”的意思就很明确,提示词和上下文都要握在自己手里,不要交给框架去处理。
面试官如果追问:“工具描述写得好不好,怎么验证?”
告诉他,准备一批真实的任务让 Agent 跑一遍,把工具调用的报错全部收集起来,看模型在哪个参数上反复犯错,改完描述或者参数再重新跑。Anthropic 在 2025 年 9 月发布的《Writing effective tools for agents》里,直接把评测记录交给 Claude,让它自己分析、自己改工具描述,效果就很好。
这道题你学会了吗?想解锁更多 Agent 面试题的源码级拆解,点赞关注,我是二哥,咱们下期见!