
为什么?
先说清楚什么是意图路由。用户发来一句话,系统要先判断这句话该交给哪条处理路径,可能是一个子 Agent,比如电商客服 Agent 背后,通常挂着查商品、查订单、处理退换货等这多个子 Agent;也可能是一个工作流分支,或者一个更便宜、能力更强的模型,这一步就叫意图路由。
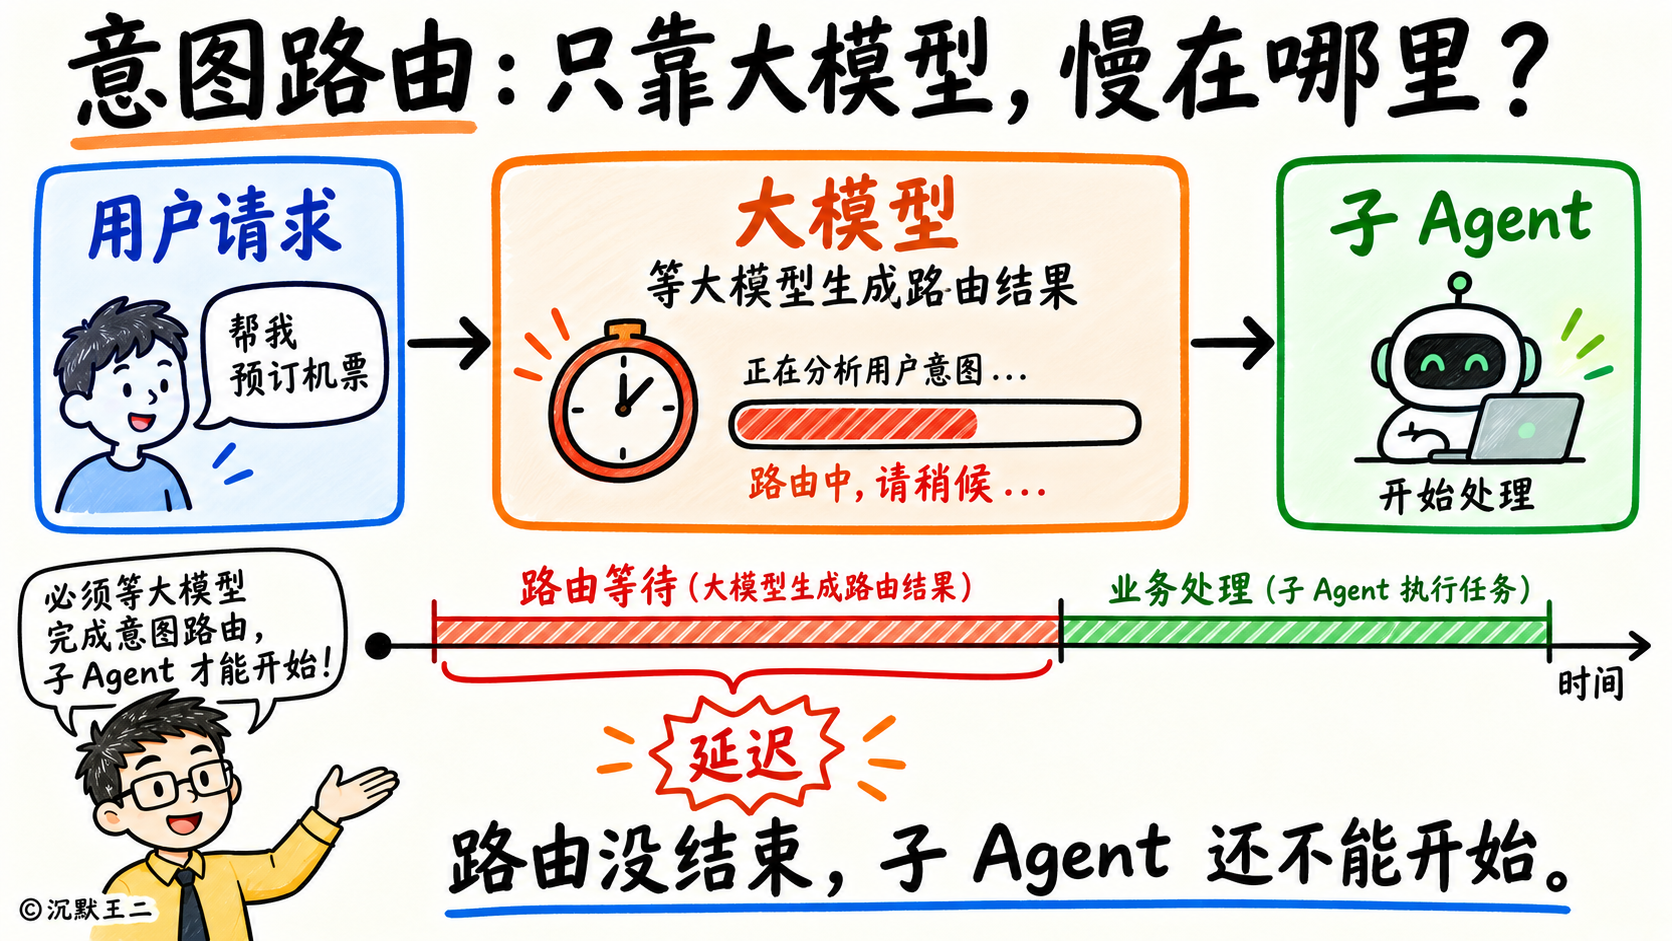
把路由直接交给大模型,最大的问题是慢。之前不是有很多网友吐槽说,发几个hello,一个 20 刀的订阅就没了~
恭喜看到这里的你,已经成功击败 30% 的学习者,给自己鼓个掌吧。接下来我问你,OpenAI 是怎么处理路由的?
A,写一个专门的路由函数;B,调用一次工具;C,调用一次大模型。聪明的你可以把答案打在弹幕或者留言区。
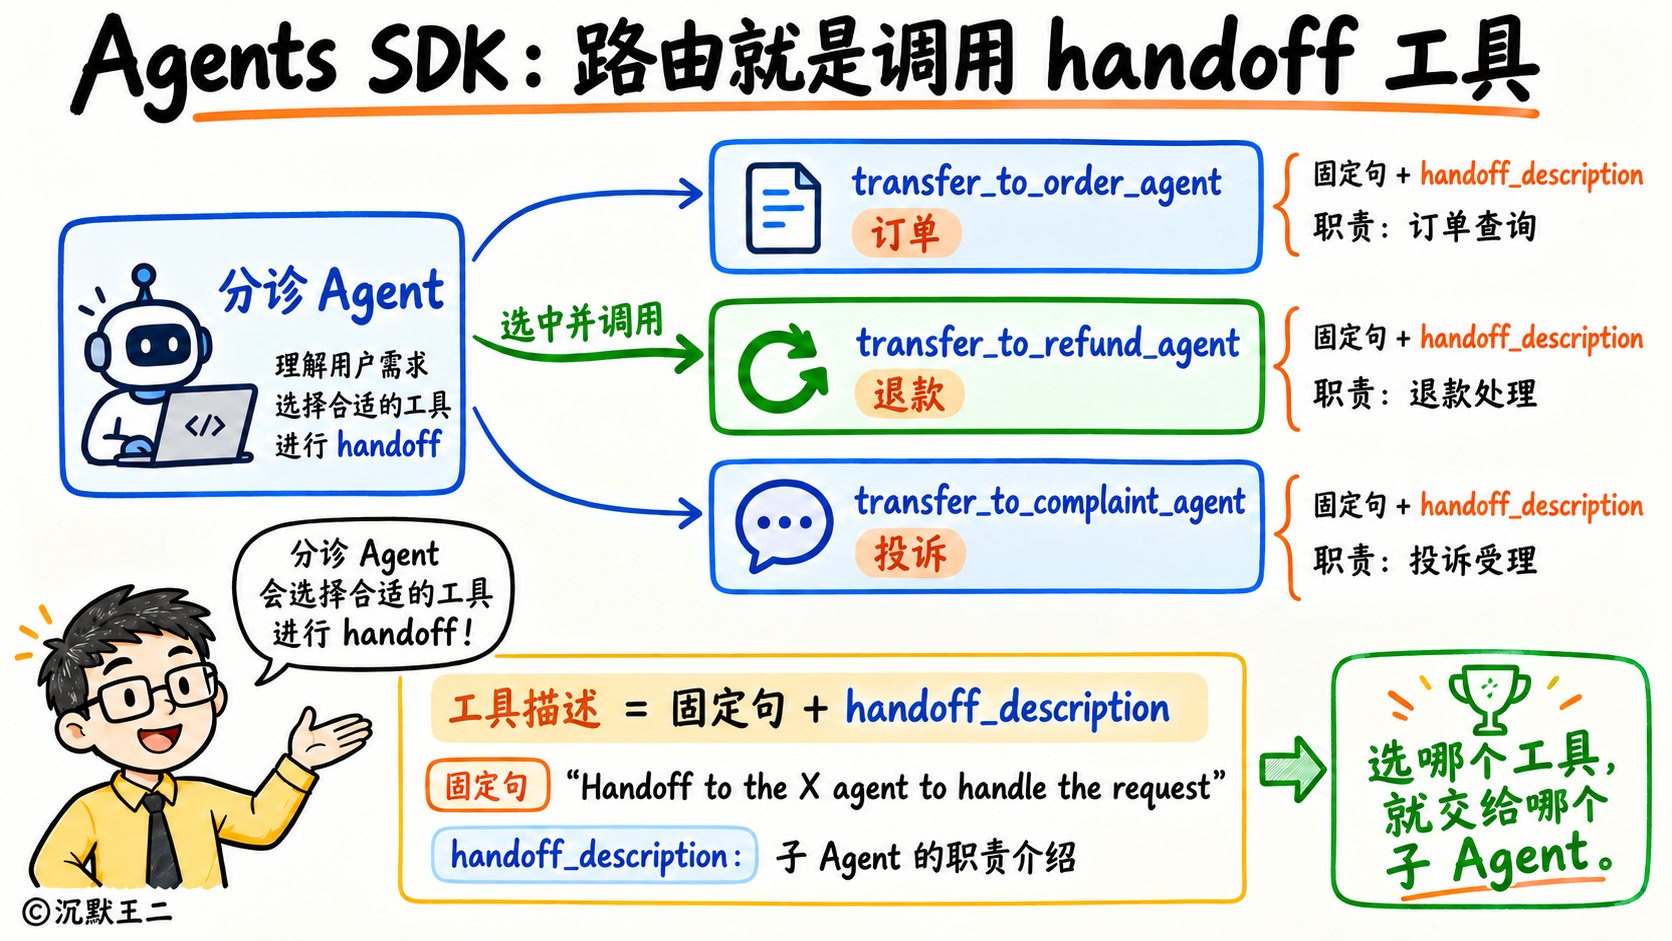
拿 OpenAI 开源的 Agents SDK 来说,负责分流的那个 Agent 叫分诊 Agent。SDK 会把每一个子 Agent 包装成一个工具,交给分诊 Agent 使用。工具的名字是 transfer_to 加上子 Agent 的名字,比如 transfer_to_refund_agent;工具的描述是,“Handoff to the X agent to handle the request”,后面是这个子 Agent 的 handoff_description,也就是开发者给这个子 Agent 写的一段介绍。
分诊 Agent 选中哪个子 Agent,就调用对应的那个工具。这种把对话交给另一个 Agent 接手的动作,SDK 里叫 handoff。
所以路由准不准,全看每个子 Agent 的介绍写得清不清楚。Anthropic 给的建议是,分类任务要么用枚举(enum)做参数,要么用结构化输出,只能让模型在你给出的选项里选。
恭喜你,已经成功击败 50% 的学习者了。
接下来继续问你,生产级的 Agent 是怎么设计路由的?
A,规则;B,向量比对;C,上决策模型;D:上大模型,这四种路由方式,聪明的你会选哪一个?
我的答案是。第一,像“查订单”、“退款”这种关键词明确的请求,用规则直接处理。
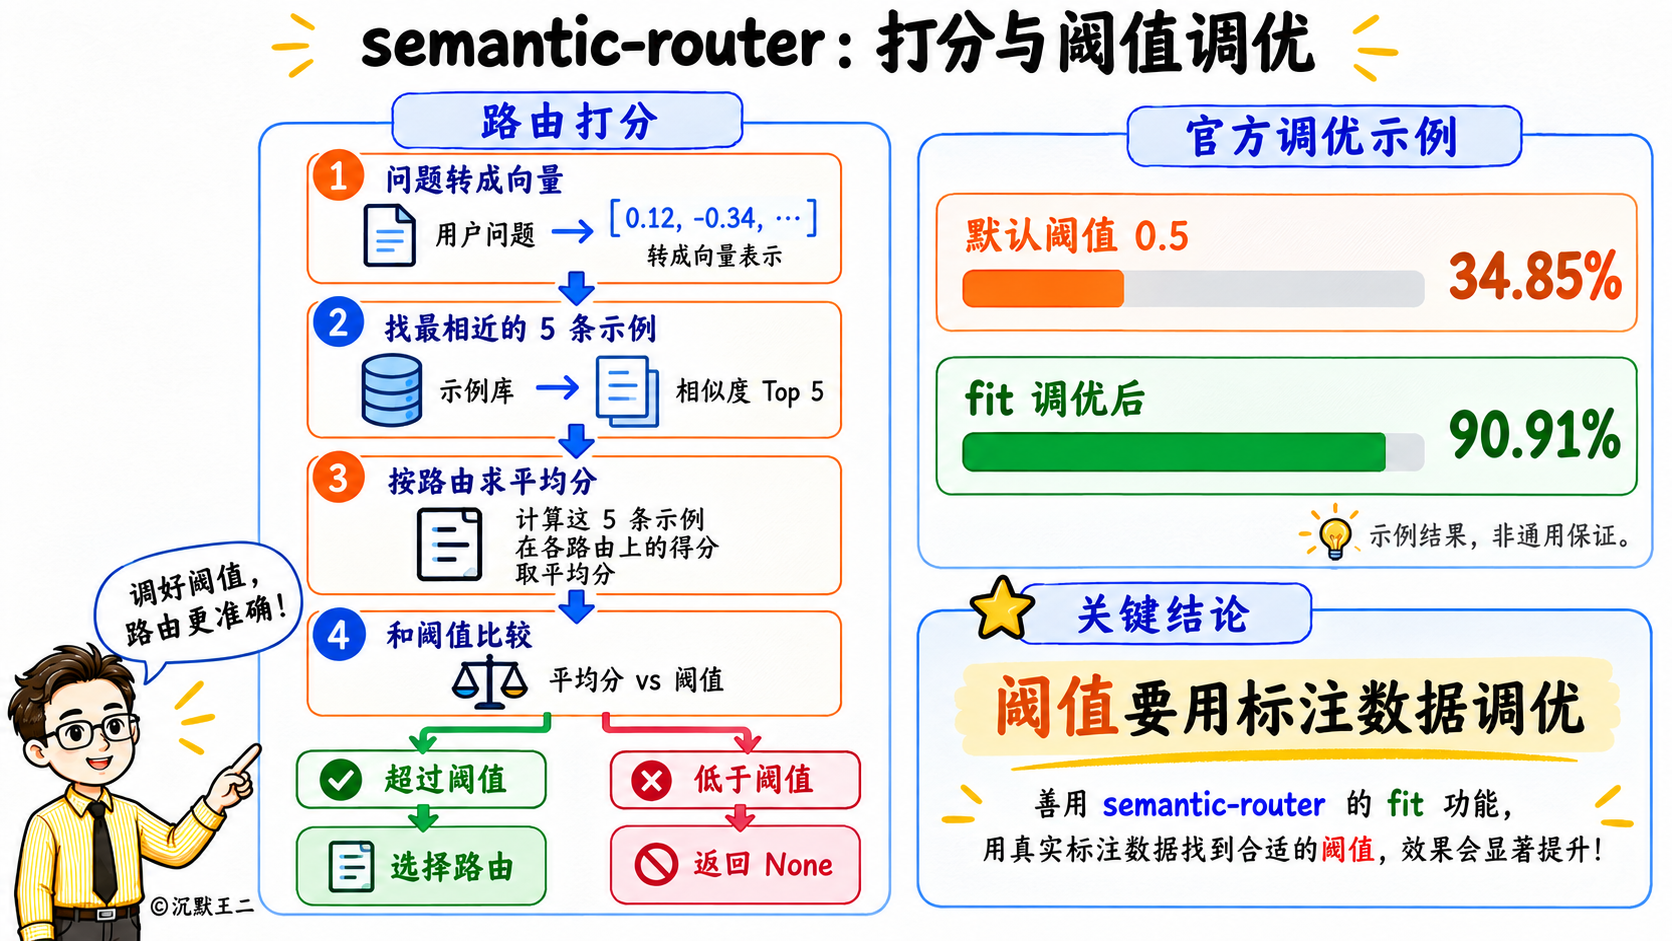
第二,向量比对,semantic-router 就是这么做的。它不调用大模型,而是给每个路由准备示例,比如订单路由的示例是“我的快递到哪了”、“订单怎么还没发货”。用户的问题进来后,先转成向量,再找出和它最相近的 5 条示例,按所属的路由求平均分。分数超过阈值就走这个路由。
第三,上决策模型。一个是 TypeSafe AI 的 Jev,官方给出的延迟是 70 到 500 毫秒。另一个是 OpenAI 刚刚发布的 Decisions API,单个任务只需要 150 毫秒,要知道 GPT-6 的轻量模型 Luna 需要 1.6 秒。
最后才是大模型。前面都判断不了的模糊请求,再交给大模型,简单问题交给便宜的模型,比如 Sonnet 5.5,困难的问题再交给更强的模型,比如 Opus 5.5。
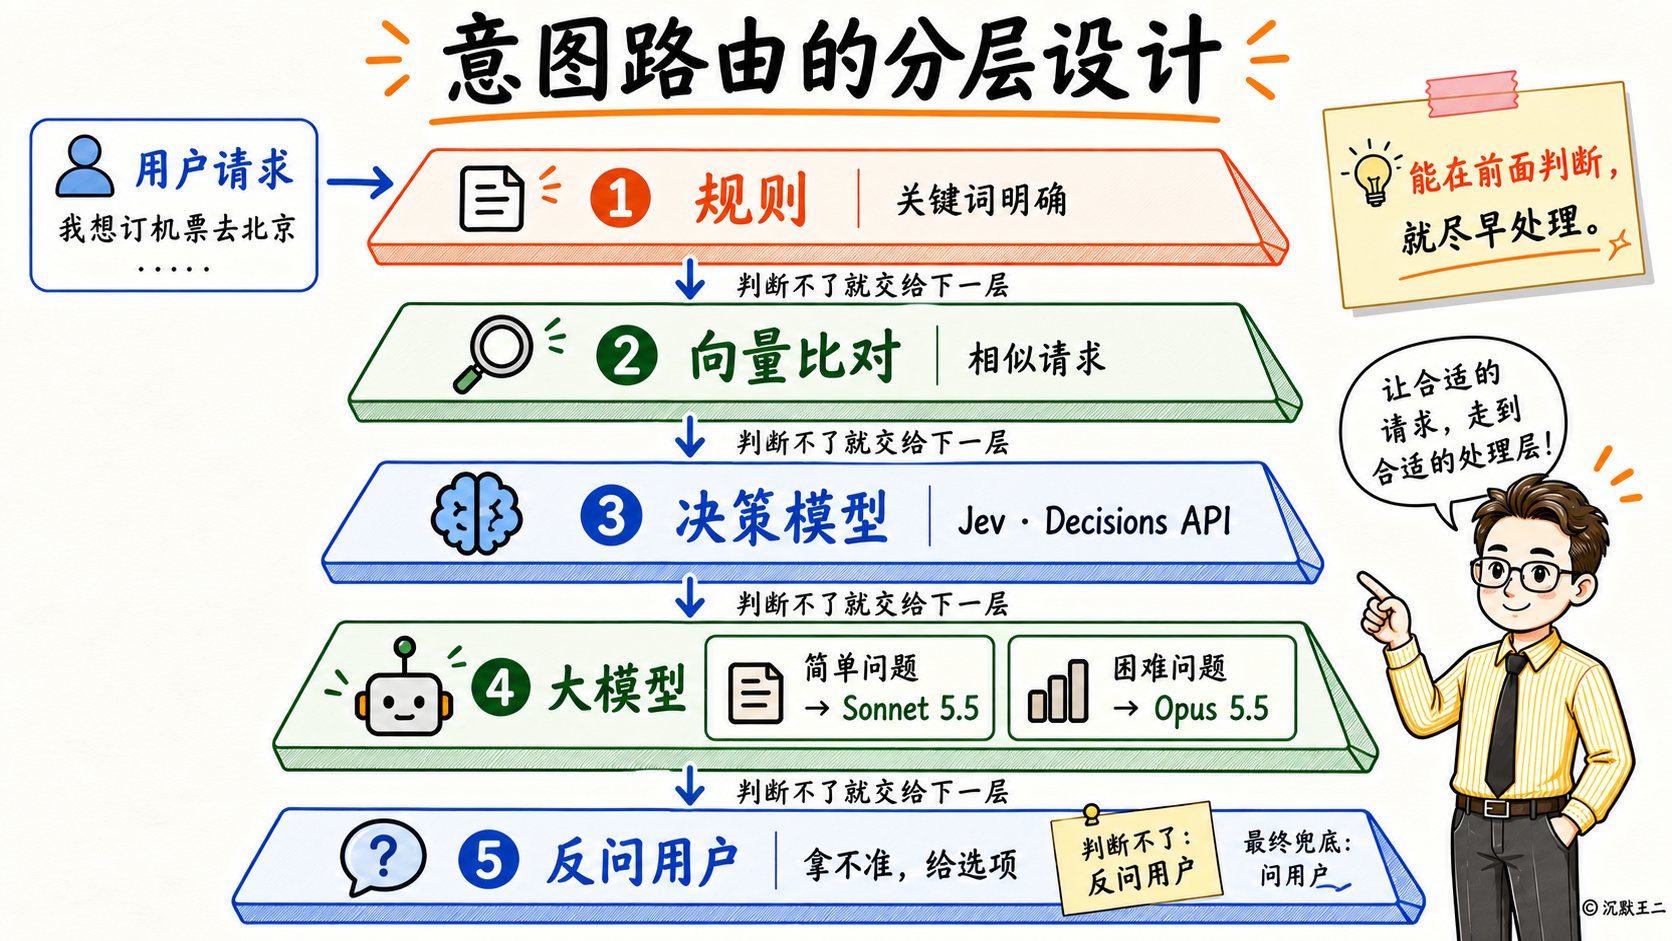
换句话说,能用向量比对和决策模型解决的,不用上大模型。恭喜你,成功击败 70% 的学习者了。
继续问你,路由不准确,或者错了,怎么办?
比如说用户的一句话同时命中了退款和查订单两个意图,分数都不高,系统应该怎么办?A,选分数高的那个;B,两个都执行;C,带上选项去问用户。
我的答案是拿不准的就问用户。分数低于阈值,或者同时命中了两个以上的意图,就带上选项去问用户。
选错了要能回退。比如说负责订座的子 Agent 遇到了超出自己范围的问题,就把对话转回分诊 Agent,由分诊 Agent 重新分配。当然了,转回的次数要设上限,不然两个子 Agent 会互相踢皮球。
Anthropic 的工单路由指南建议,一个请求里有多个意图时,事先写明哪个优先处理;意图超过 20 个,就分层分类,先分大类再分小类。
另外,要准备一批标注好意图的测试问题,按每个意图分别统计准确率和召回率。有数据表明,从向量库里找出和当前问题相似的已标注问题,放进提示词里,准确率能从 71% 提高到 93%。
恭喜你,成功击败 90% 的学习者了。
最后,面试官如果追问:“让模型自己报置信度,靠得住吗?”
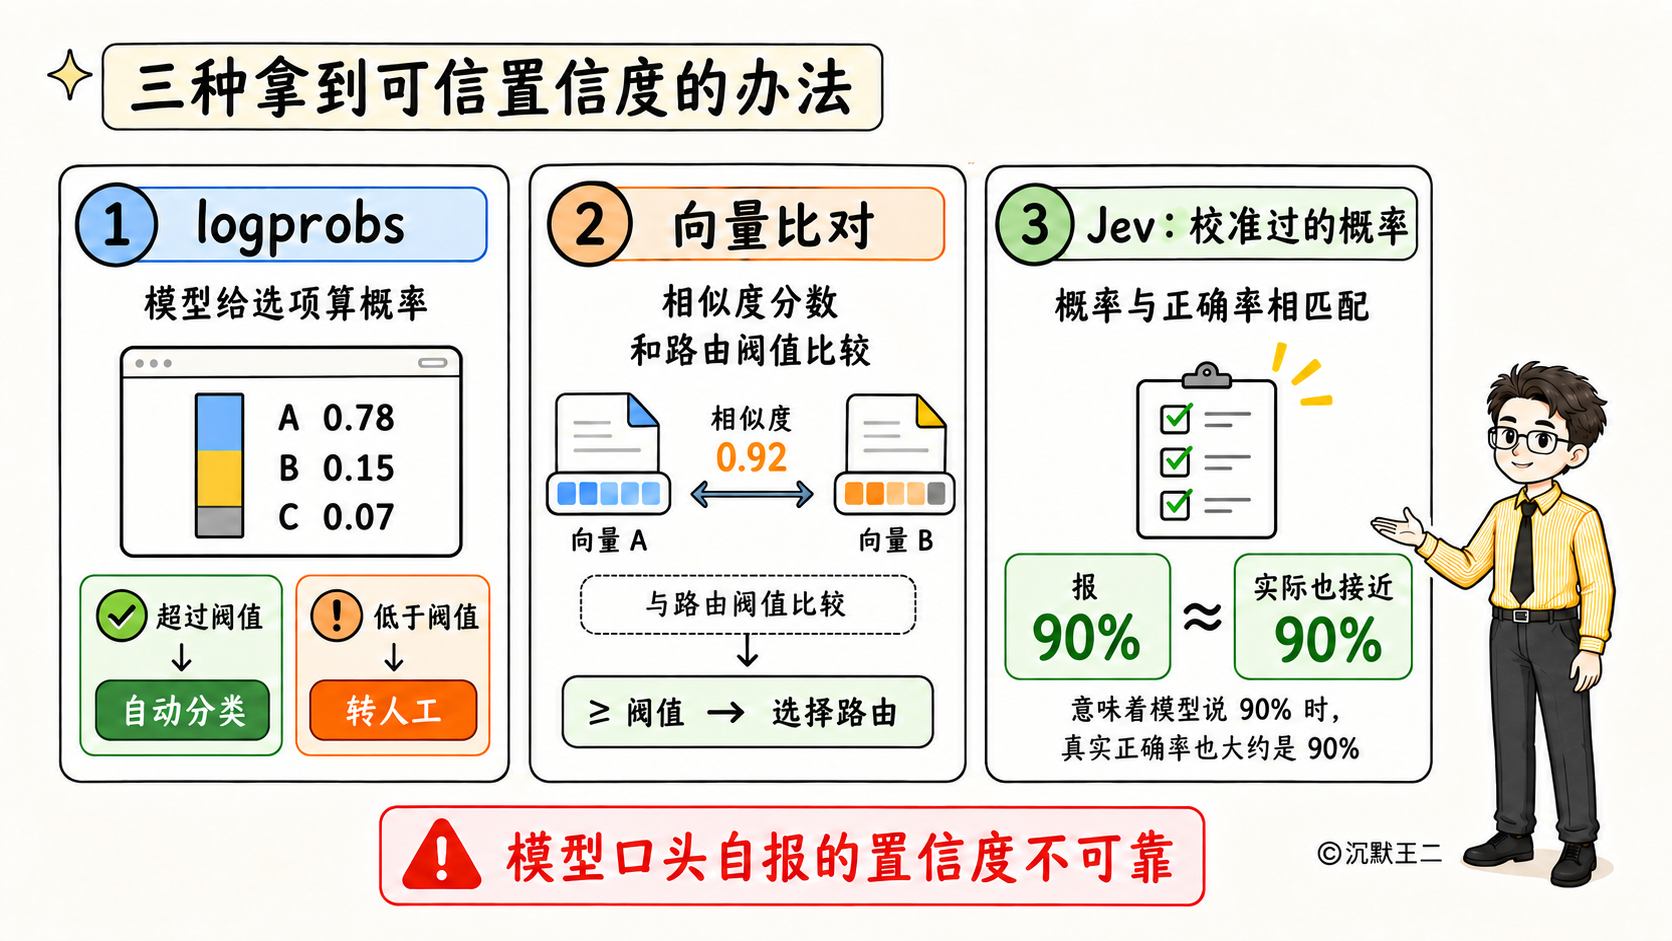
告诉他,靠不住。可信的置信度需要这样做。第一,用 logprobs,也就是模型给每个选项算出一个对数概率,OpenAI Cookbook 里的做法是,概率超过阈值的自动分类,低于阈值的转给人工复核。第二,直接用向量比对相似度。第三,用 Jev 这种做过校准的决策模型,校准的意思是,它报 90% 的把握,实际正确率也接近 90%。
恭喜你升到王者段位了,成功击败 99% 的学习者。
最后简单总结下。
确定的用规则,相似的用向量,有固定选项的用决策模型,模糊的交给大模型,拿不准的问用户。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!