
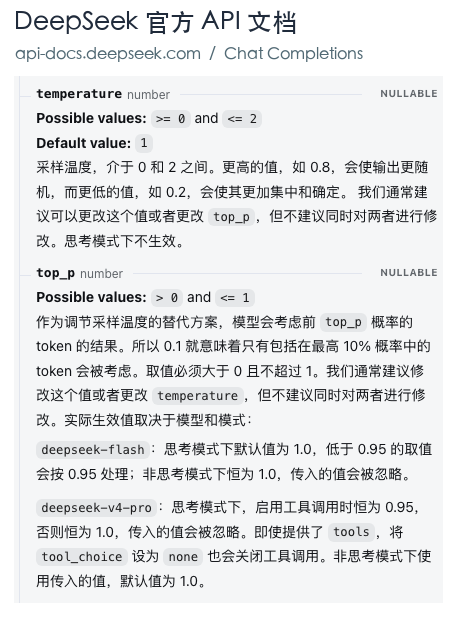
上期讲分词器时我们讲过,大模型是一个 Token 接一个 Token 输出的。词表里大约有 12.8 万个 Token,为了好理解,后面统一把它们叫作“候选词”。每生成一个新 Token,模型都要给候选词打分。采用随机采样时,再按概率选出一个,这个过程就像抽签。temperature 负责调整候选词之间的概率差距,top_p 负责决定哪些候选词有资格参与抽签。
恭喜看到这里的你,已经成功击败 30% 的学习者。
那聪明的你一定会问,Temperature 到底改变了什么?
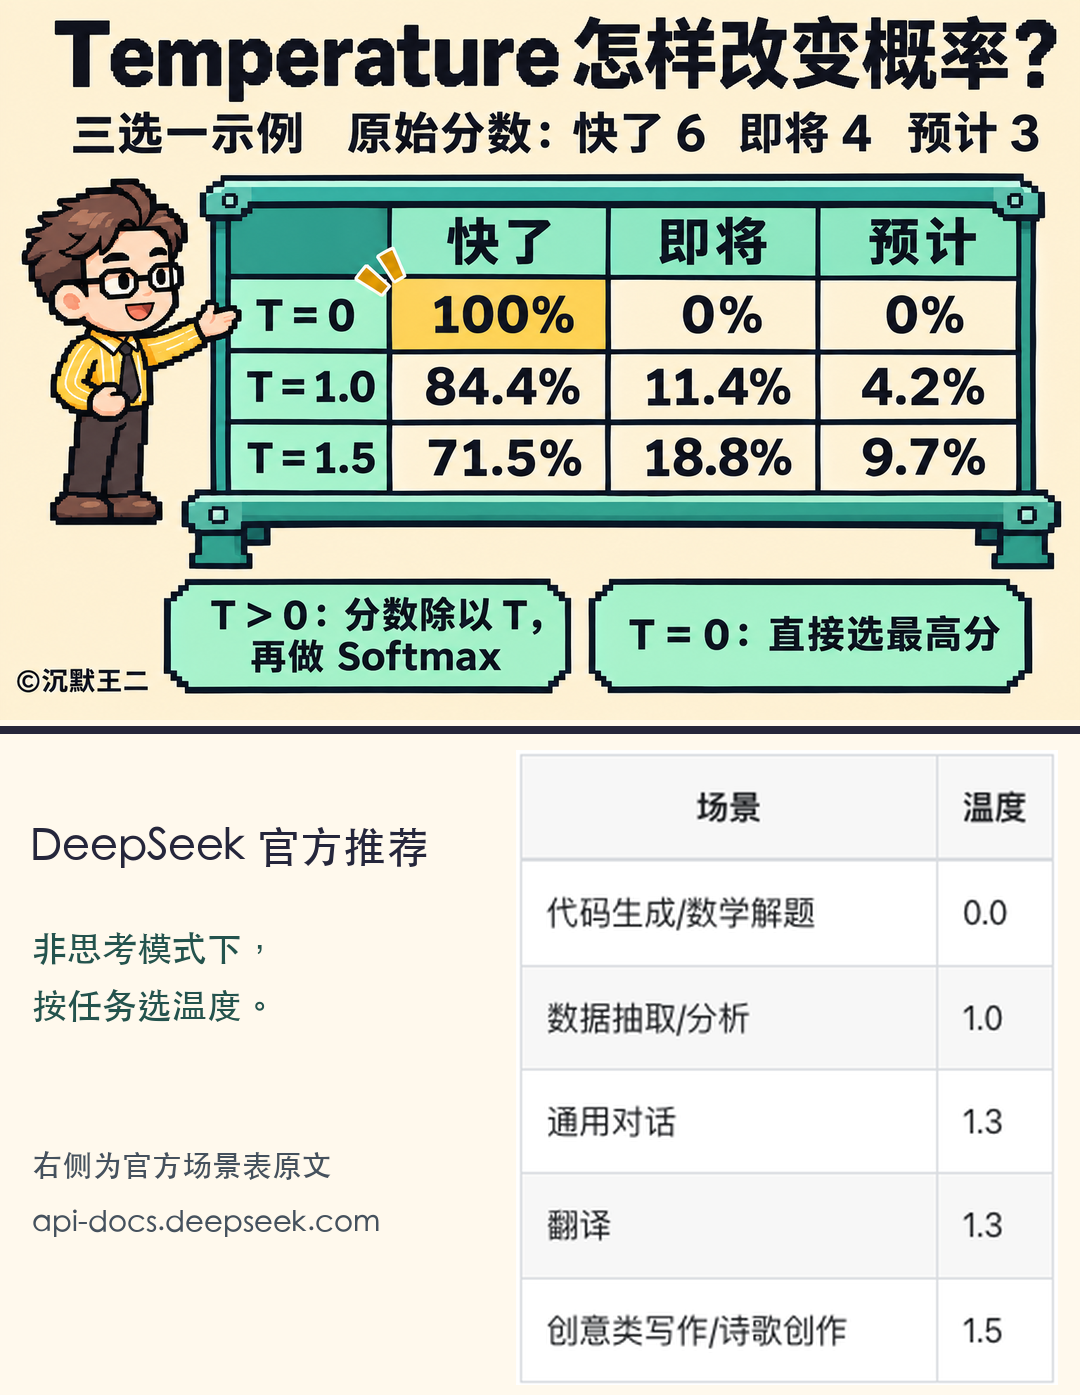
比如你输入了“Qwen4 要来了吗?”,模型会先给每个候选词打一个分数(技术上叫 Logits)。假设这一步只有三个候选词,“快了”得 6 分,“即将”得 4 分,“预计”得 3 分。接下来,模型要把这些分数换算成加起来等于 100% 的概率,这一步叫 Softmax。而在换算之前,只要温度大于零,模型就会先用每个分数除以 temperature。
如果 temperature 很低,比如设成 0.1,原来的 6 分和 4 分除以 0.1 后就变成了 60 分和 40 分,两者的分差从 2 分拉大到了 20 分。Softmax 会先对分数做指数运算,分差越大,换算出来的概率差距就越悬殊。所以排第一的“快了”会拿到将近 100% 的概率,几乎每次都会被选中。当 temperature 设为 0.0 时,不能再做除法,常见的做法是直接选分数最高的那个词。
反过来,如果把 temperature 调高到 1.5,原本的 6 分和 4 分除以 1.5 后变成了 4 分和 2.67 分,分差从 2 分缩小到了 1.33 分,各个候选词的概率也就更接近了。原本排在第二、第三名的“即将”和“预计”会分到更多概率,被选中的机会也变大了。这样生成的内容会更多样化;但排名靠后的词也更有机会被选中。
正因为如此,DeepSeek 官方文档针对不同场景给出了推荐值。写代码和解数学题要求结果准确,建议设为 0.0;做数据抽取和数据分析,建议保留默认的 1.0;日常对话和翻译需要表达自然,建议设为 1.3;写故事这类创意写作,可以调到 1.5。
恭喜看到这里的你,已经成功击败 50% 的学习者了。
那聪明的你肯定会继续问,为什么还要 Top-P?
因为在温度大于零的情况下,分数很低的候选词也可能分到一点概率。哪怕是和问题毫不相干,也有可能被抽中。把候选词按概率从高到低排列,排在后面的叫“长尾词”。如果抽到的是长尾词,后面的内容很可能就不是你想要的。
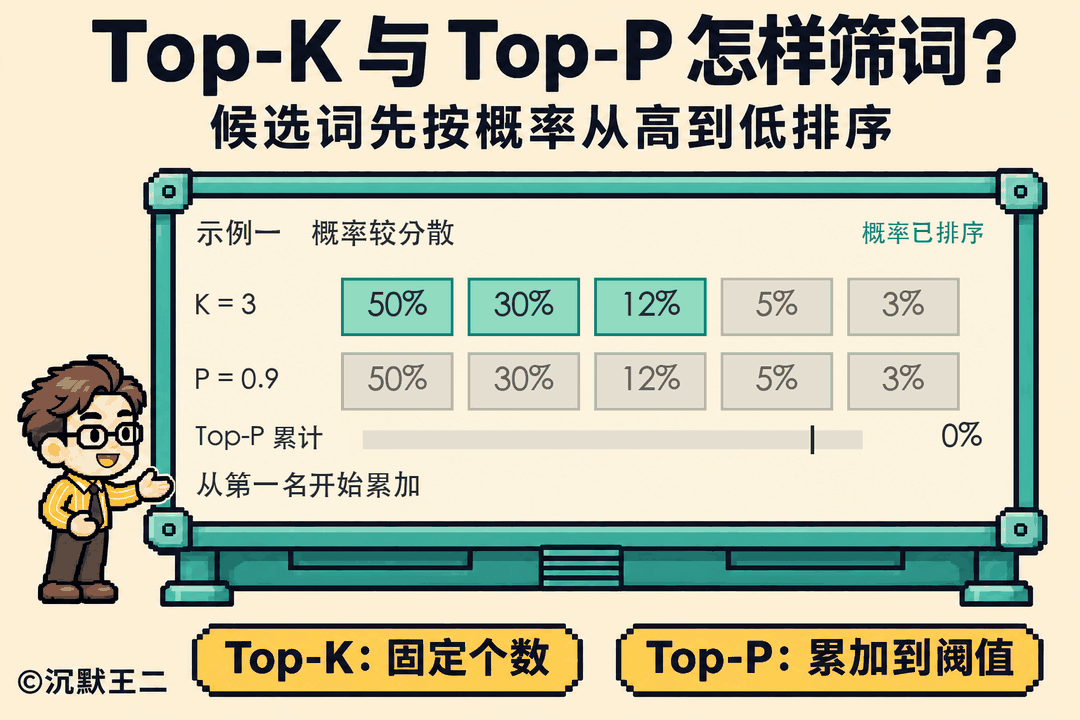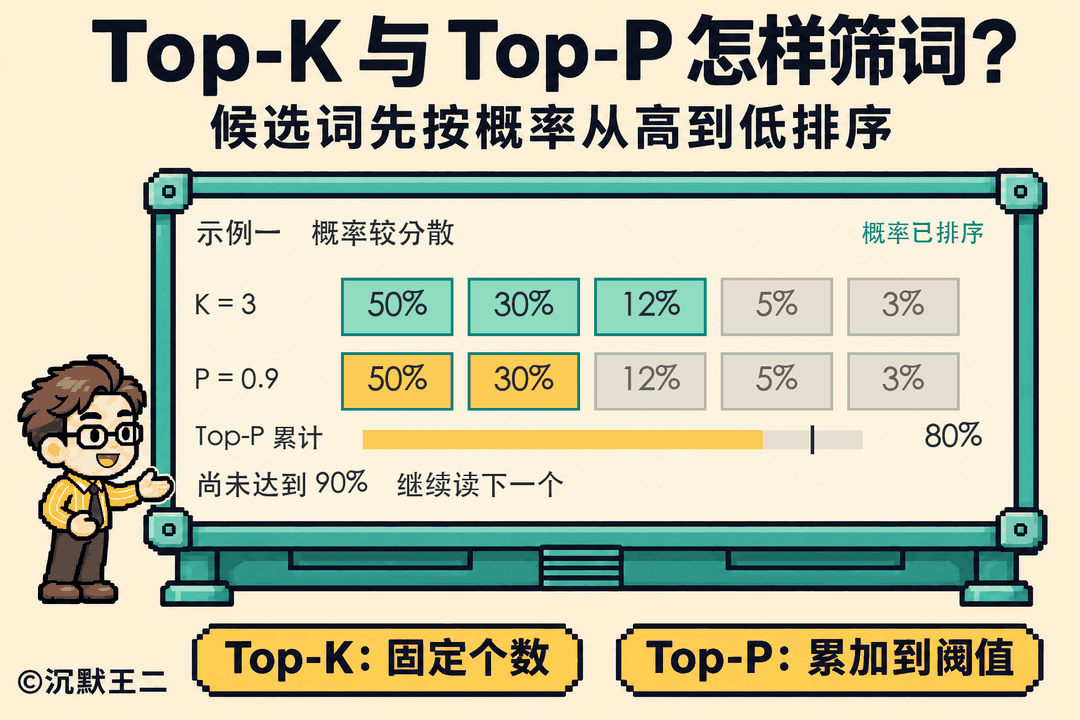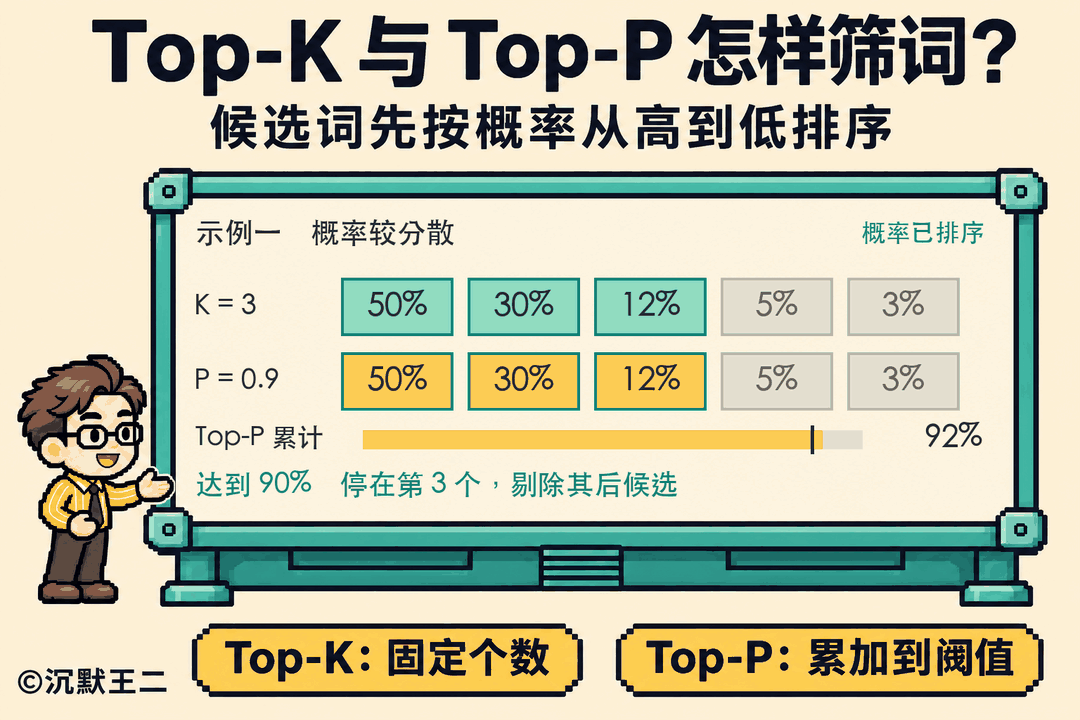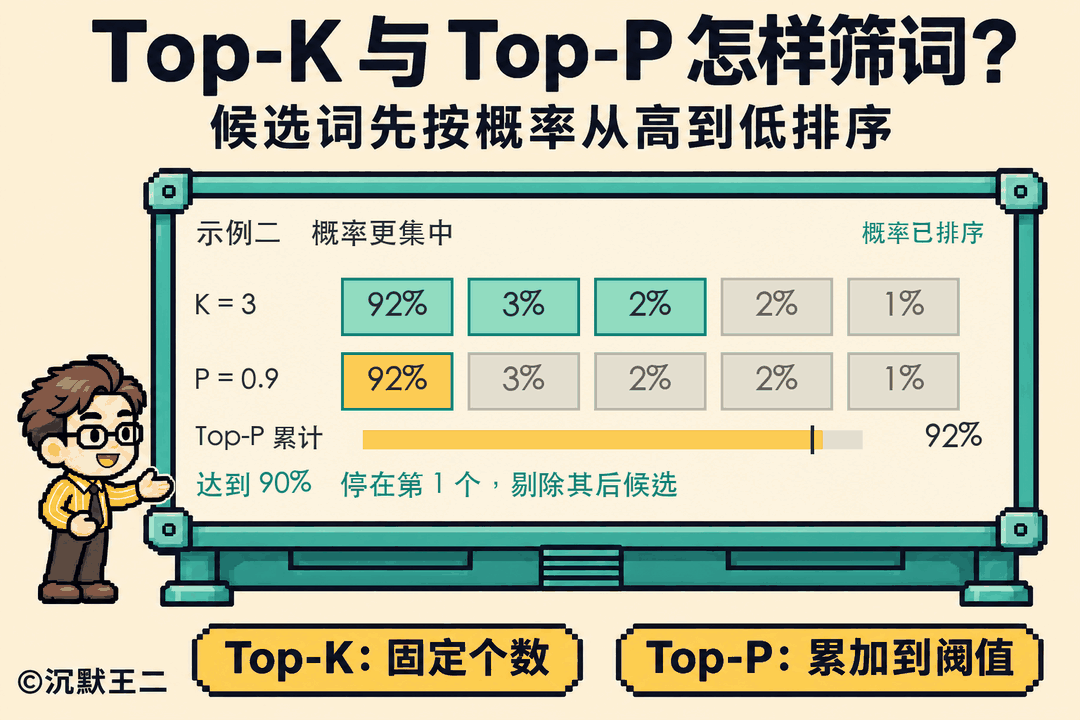
为了去掉长尾,早期的做法是用 top_k,也就是只保留排名的前 K 个词,比如只保留前 50 个。但固定数量有个缺点,当模型回答“1 + 1 等于几?”这种答案很确定的问题时,即使“2”的概率已经很高,仍会把另外 49 个词留在候选范围里;而当模型写开放式的内容、有很多个词都说得通时,只留 50 个又会把不少合适的词过滤掉。
top_p 也叫核采样,它不按固定个数保留,而是按累积概率来决定保留多少个词。具体做法是,在 temperature 处理完、算出概率之后,模型把所有候选词按概率从高到低排好,从第一名开始往下累加概率,一旦累加的总和达到 top_p,就停下来,把后面的词全部扔掉,再把候选词的概率按比例放大,让它们加起来重新等于 100%。比如把 top_p 设为 0.9,如果模型对答案很有把握,第一名的概率已经达到 92%,超过了 90%,那就只留下这 1 个词;假设排在最前面的 15 个词各占 6%,就要累加到第 15 个词才够 90%,于是这 15 个词都会被留下。
恭喜看到这里的你,成功击败 70% 的学习者了。
聪明的你可能会继续问,Temperature 和 Top-P 到底怎么设置?
官方一般建议先改其中一个,另一个保持默认值 1.0,这样方便看出是哪一个起了作用。
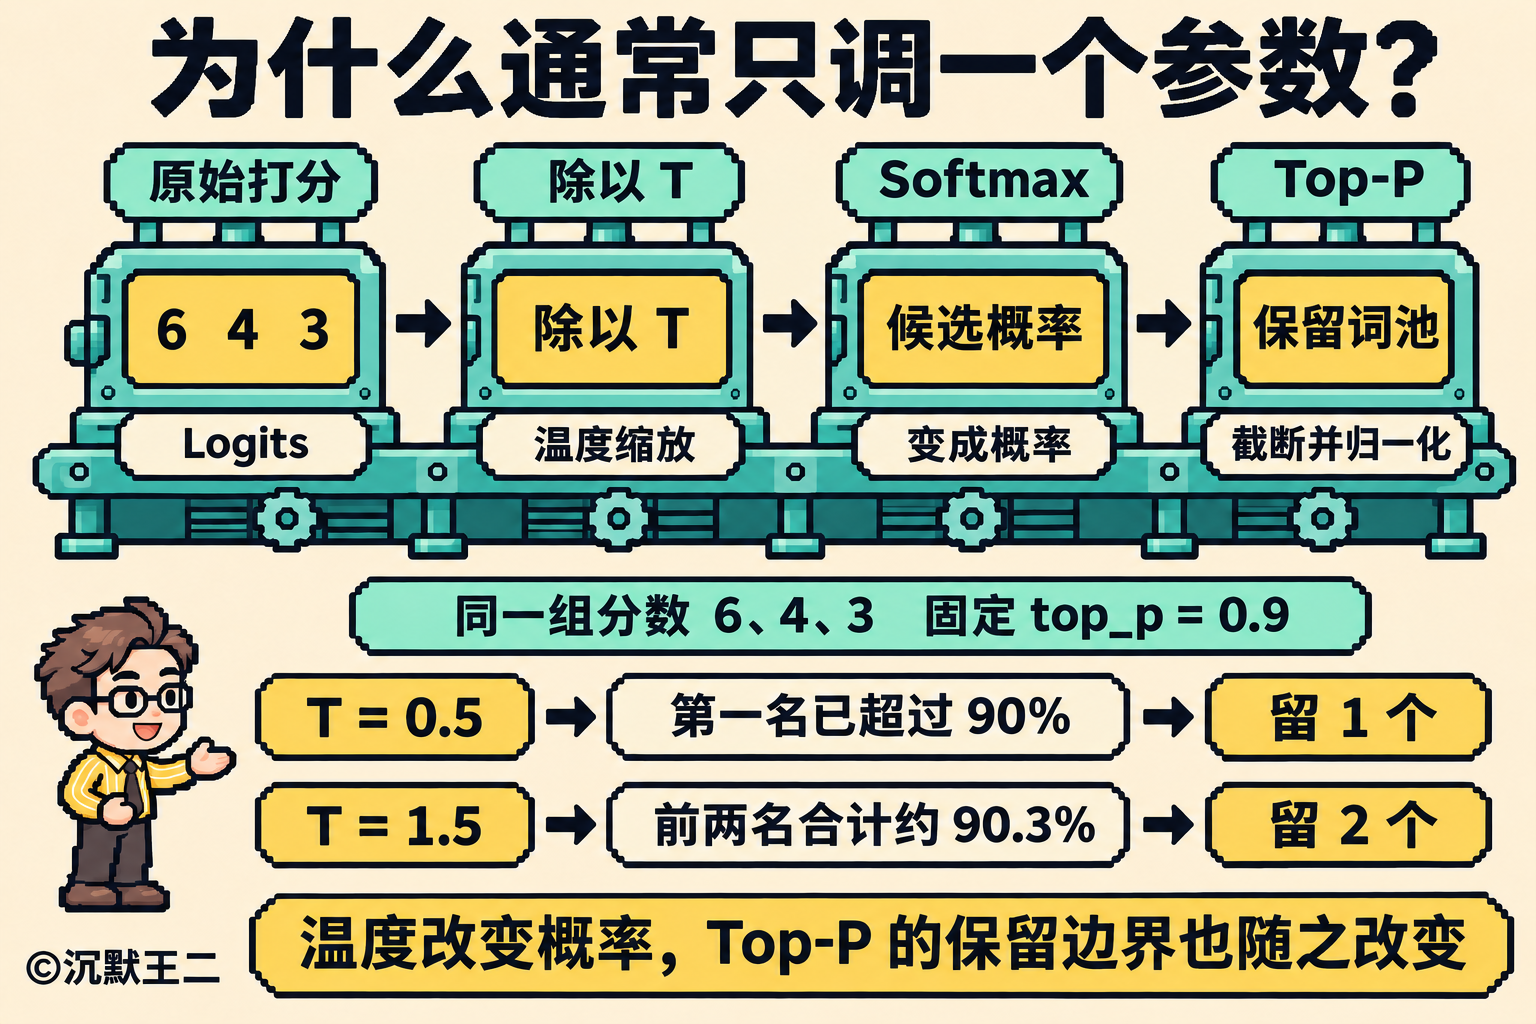
原因在于,这两个参数是按先后顺序起作用的,后一个参数的效果取决于前一个参数的结果。模型先用 temperature 调整各个候选词之间的概率差距,然后根据 top_p 再拿着调整后的概率去累加、决定留下哪些词。
举个例子,假设在默认温度下,前 3 个词的概率加起来就够 90%。如果把 temperature 调高到 1.5,各个词的概率变得更接近,同样是 top_p 设为 0.9,可能要累加到第 30 个词才够 90%,原先排在截断范围外的词也被留了下来。
恭喜看到这里的你,成功击败 90% 的学习者了。
最后聪明的你还会问,Claude Code、Codex、DeepSeek Harness 都是怎么处理 temperature 参数的?
DeepSeek 默认开启思考模式,这时传入的 temperature 会被忽略。top_p 要看模型。Flash 能在 0.95 到 1.0 之间调整,低于 0.95 也按 0.95 算。Pro 会忽略传入的值,启用工具调用时固定为 0.95,否则固定为 1.0。关闭思考模式后,Flash 的 top_p 固定为 1.0,Pro 的 top_p 可以调整。
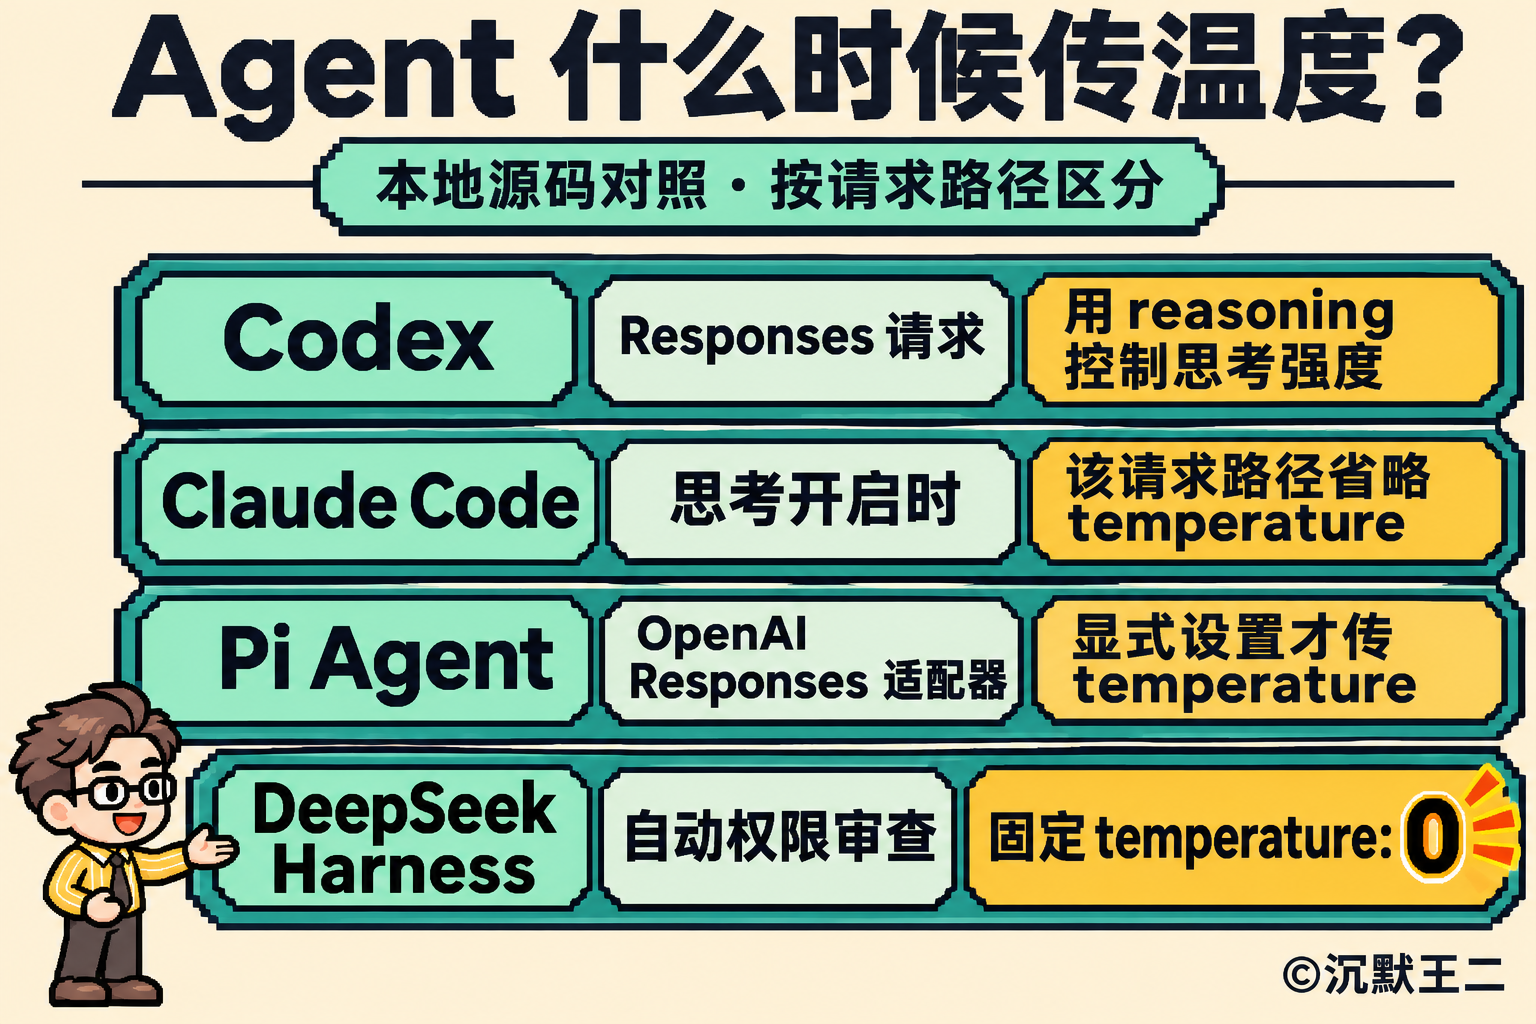
Codex 的主对话请求里没有 temperature 和 top_p 这两个字段。
Claude Code 在开启思考模式时,会省略 temperature。
DeepSeek Harness 的适配器没有传 top_p,只保留了可选的 temperature,自动权限审批里写死了 temperature: 0。如果审批请求走的是 DeepSeek 思考模式,这个 0 也不会生效。
恭喜你升到王者段位了,成功击败 99% 的学习者。这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!