
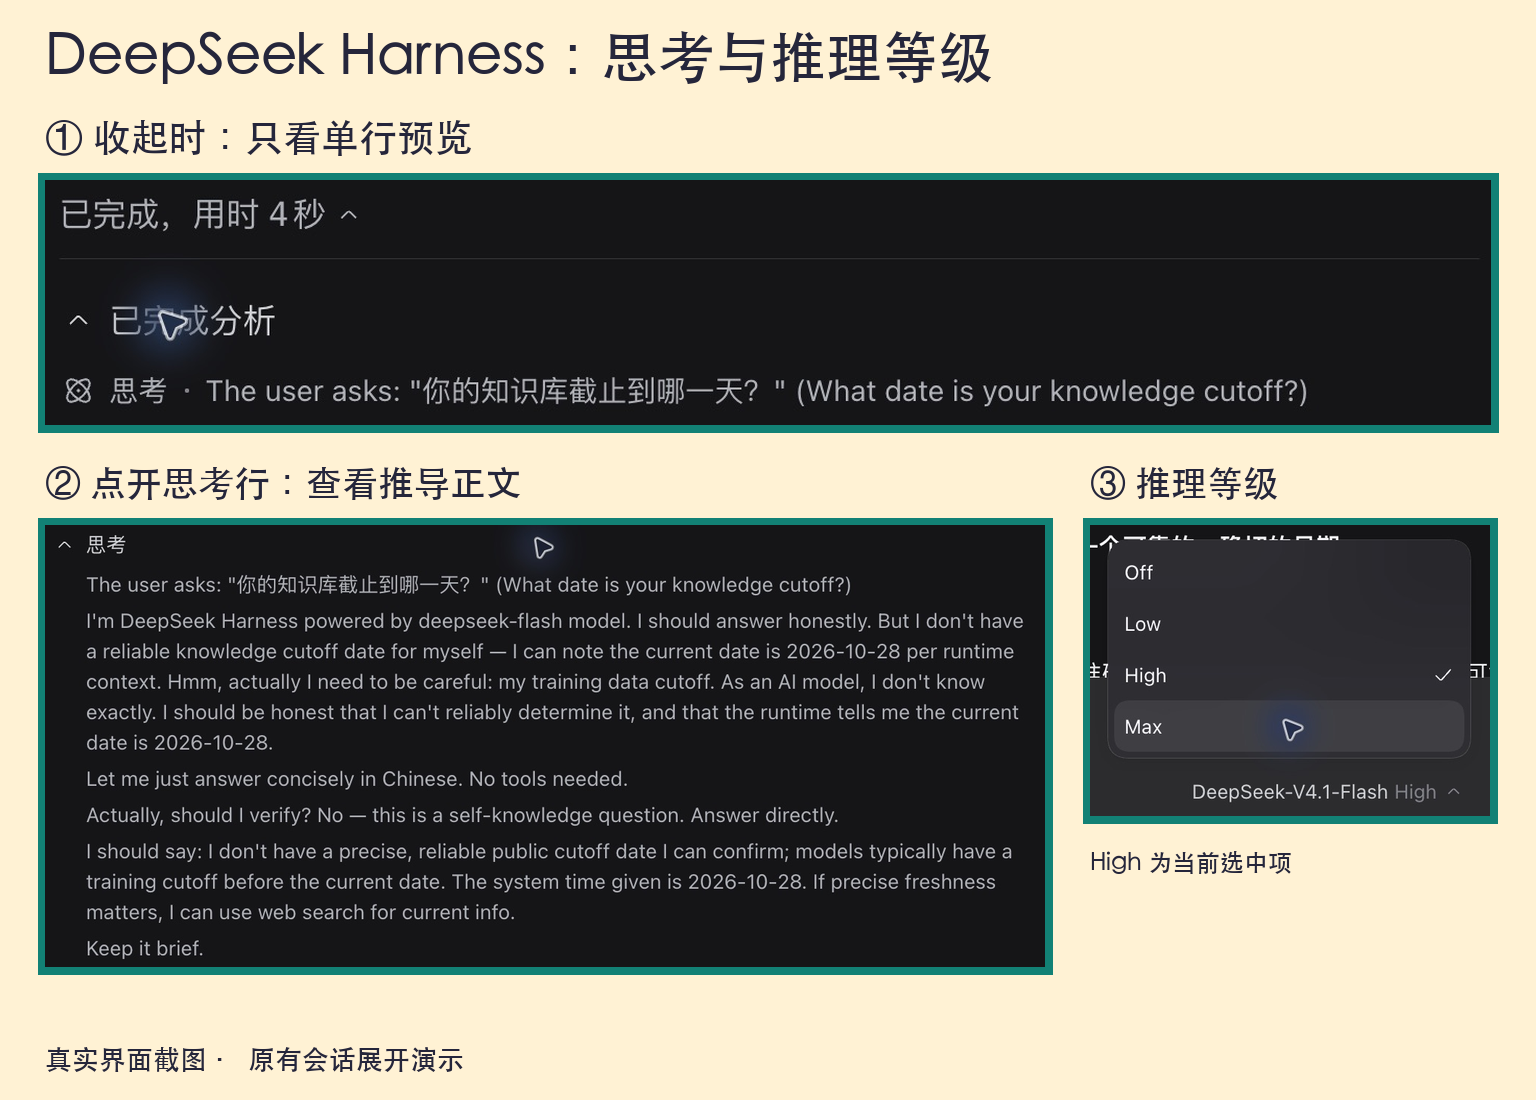
展开「正在分析请求」,再点开里面的「思考」,就能实时看到模型怎样拆解问题、分析条件、尝试不同的思路。回答结束后,这部分内容会默认收起,变成一条“已完成,用时×秒”的折叠条,需要回看时逐层展开即可。这里展示的、由模型一步一步生成的推理过程,就是 CoT 思维链(Chain of Thought)。
恭喜看到这里的你,已经成功击败 30% 的学习者。
那聪明的你一定会问,为什么要让模型先输出思考过程?
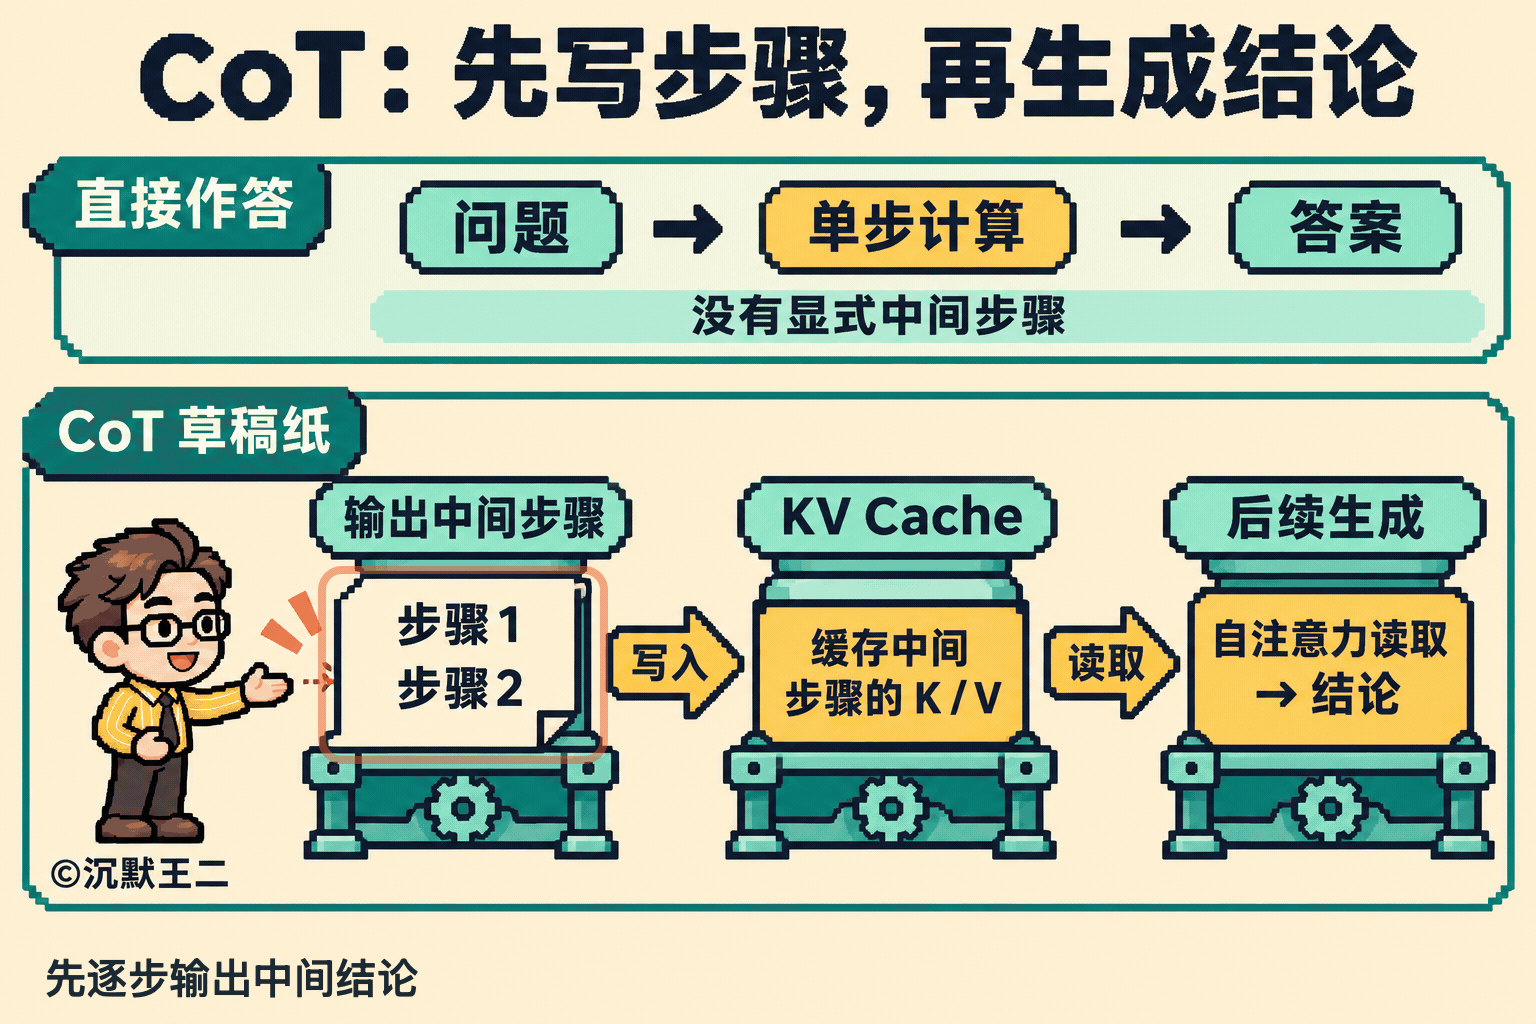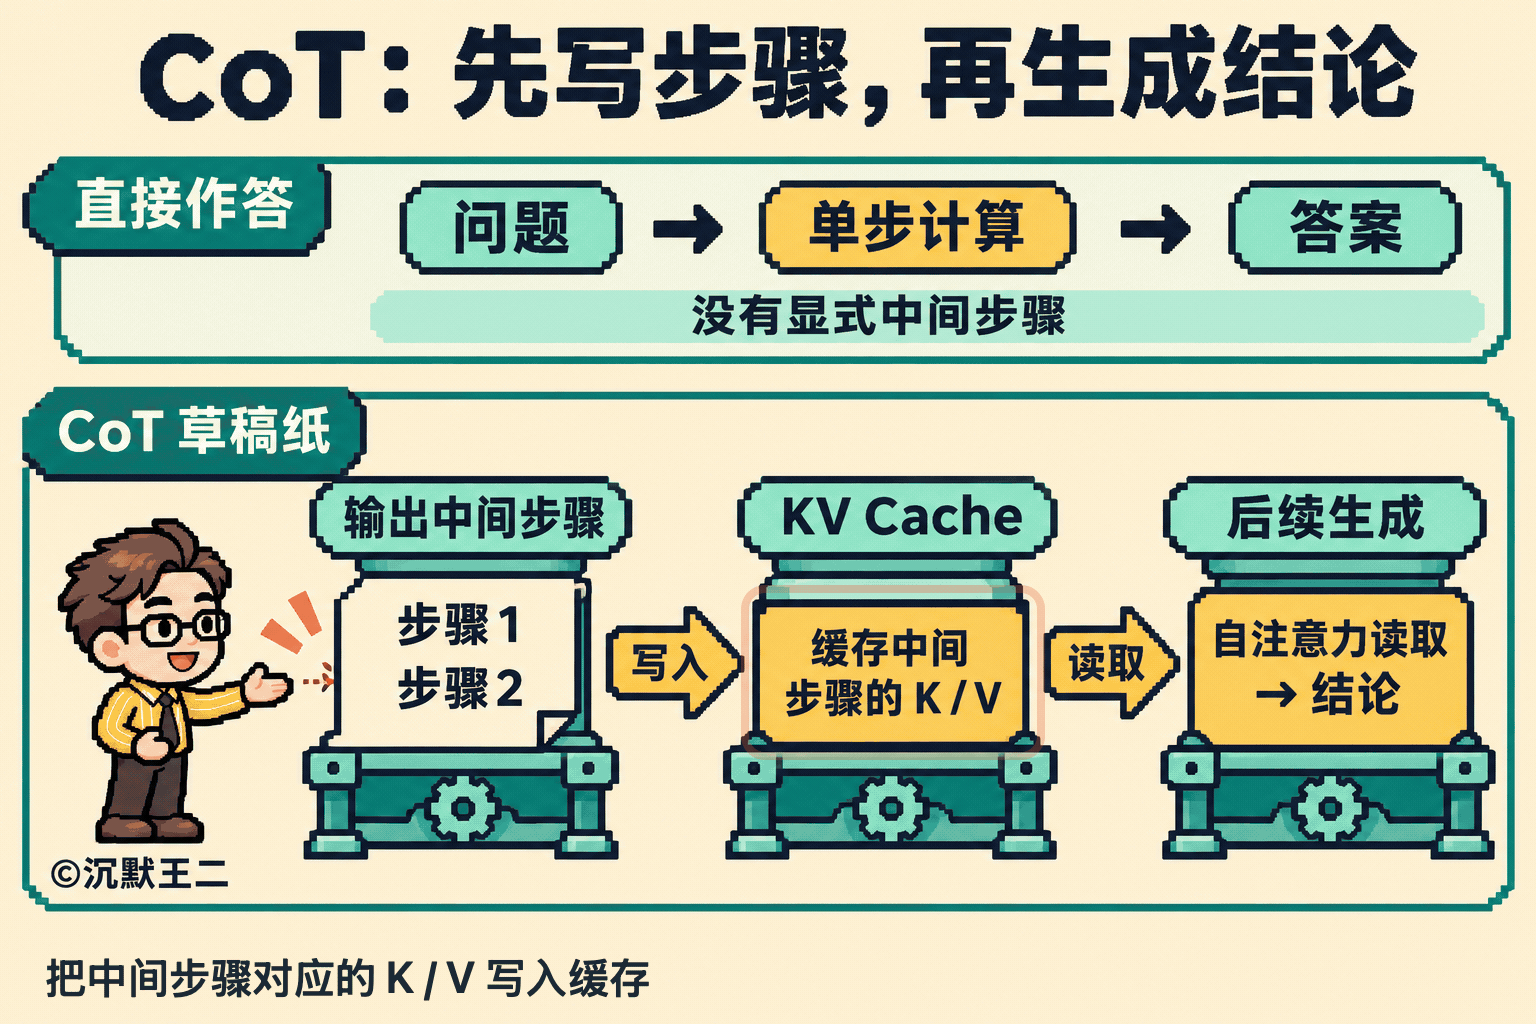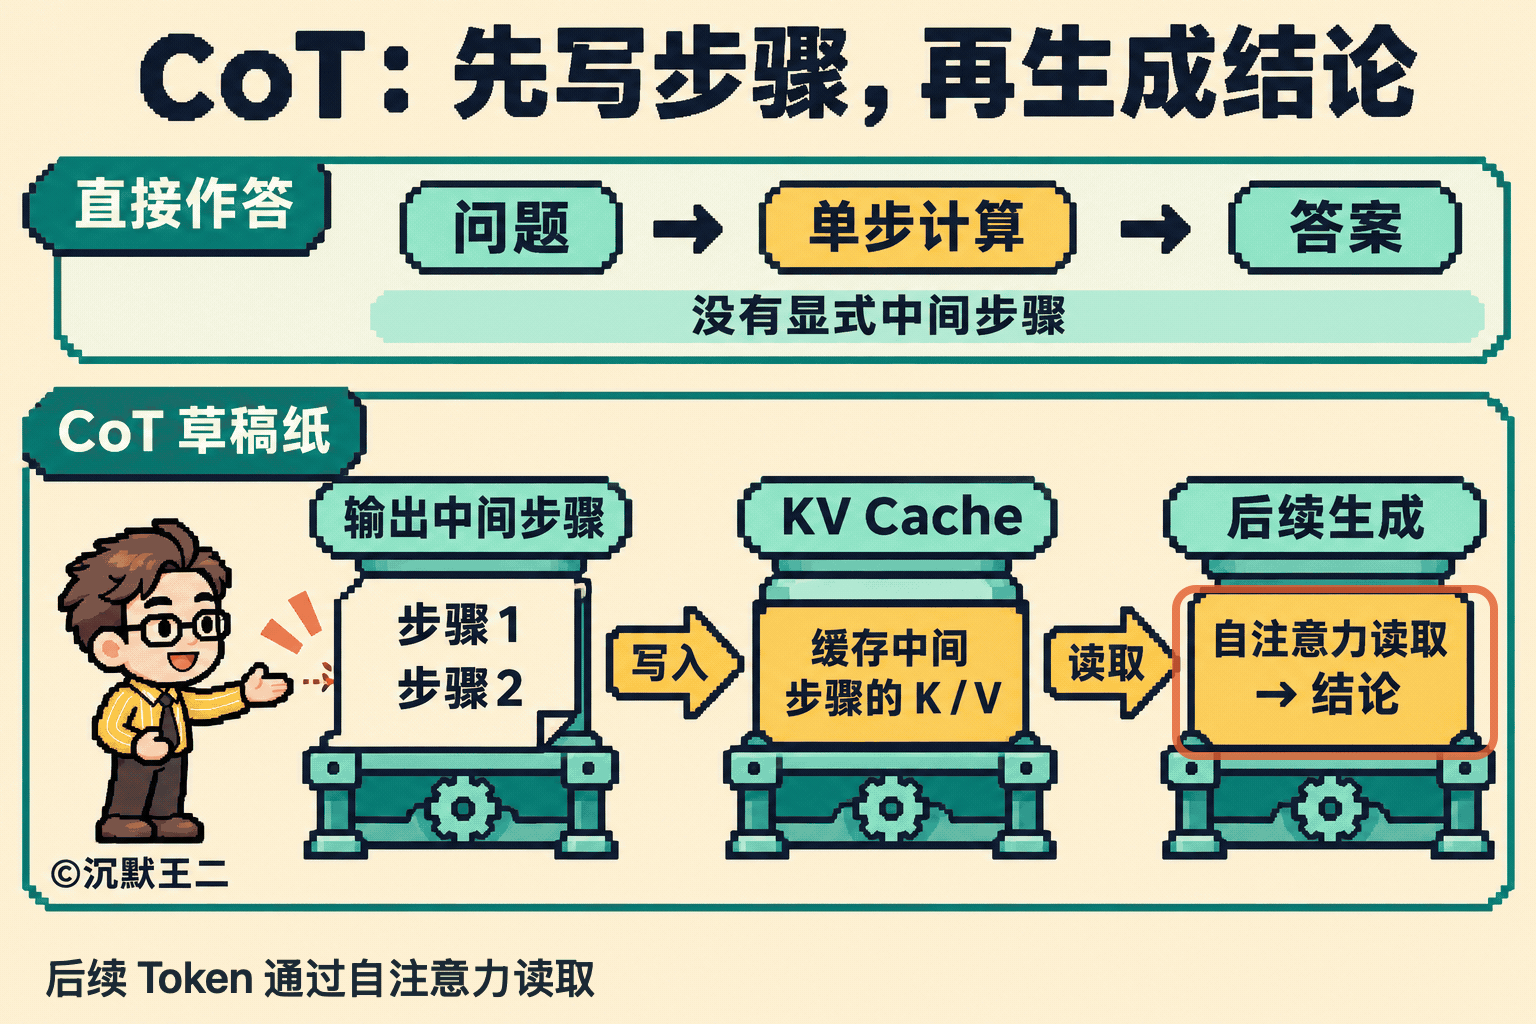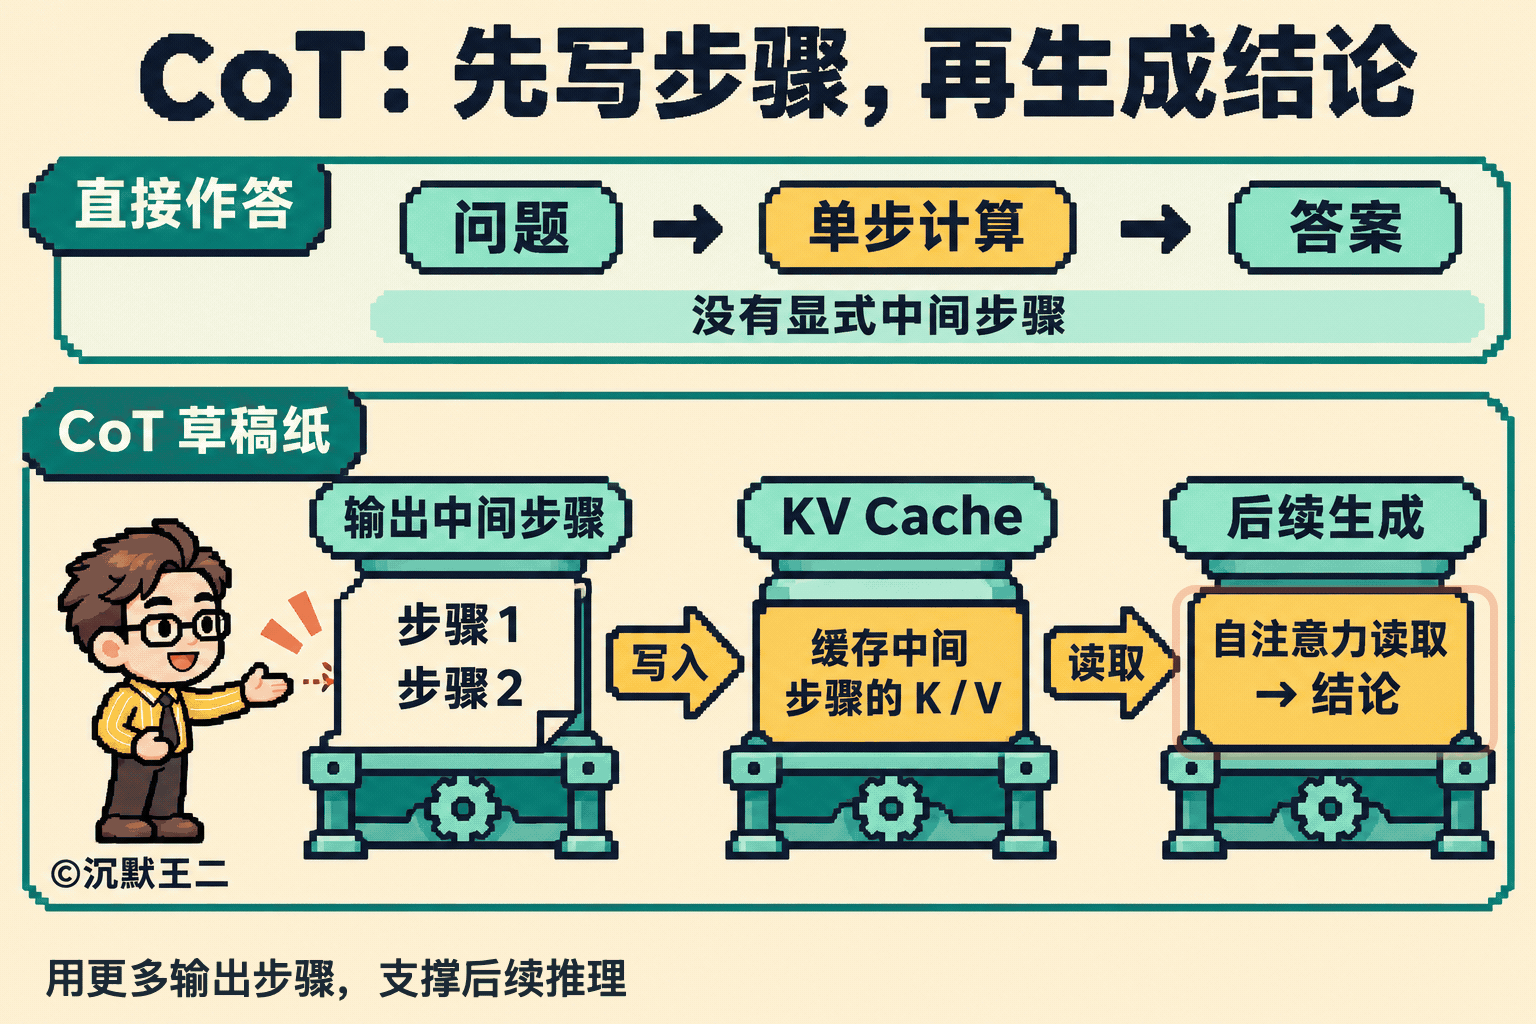
前几期我们讲过,大模型采用自回归的方式生成内容,一个 Token 接一个 Token 地输出。每生成一个 Token,模型经过的 Transformer 层数和矩阵运算量都是固定的。如果要求模型输出的第一个 Token 就是一道复杂数学题的答案,就相当于要求它在一个 Token 的计算量里完成多步推导。计算量不够,答案就很容易出错。
如果模型先把中间的推理步骤逐字输出,这些步骤就会进入上下文窗口,对应的 K 和 V 向量也会存入 KV Cache。等到生成最终答案时,自注意力机制可以读取这些中间结论。简单来说,思维链就是把上下文窗口当成草稿纸,用更多的输出 Token 换来更多的推理计算量。
当然,草稿越多,消耗的 Token 就越多。在 DeepSeek Harness 中,每轮回复底部都有一个显示「用量」和 tok 数值的按钮,点开后会弹出「本轮用量」面板,可以查看「输出」等数据。
恭喜看到这里的你,已经成功击败 50% 的学习者了。
那聪明的你肯定会继续问,在 DeepSeek Harness 桌面端里,思维链是以什么形式呈现的?
早期的大模型没有专门训练过推理能力,需要在提示词末尾加一句“让我们一步步思考”,引导模型输出推导步骤。这样的话,推导步骤和最终答案就混在一起。现在的 DeepSeek 在后训练阶段通过强化学习获得了推理能力,就会先提出假设、再验算,发现思路走不通就推翻重来。从 DeepSeek Harness 的源码可以看到,它在协议层把模型的输出拆成了两种独立的内容:text 文本块和 reasoning 思考块。
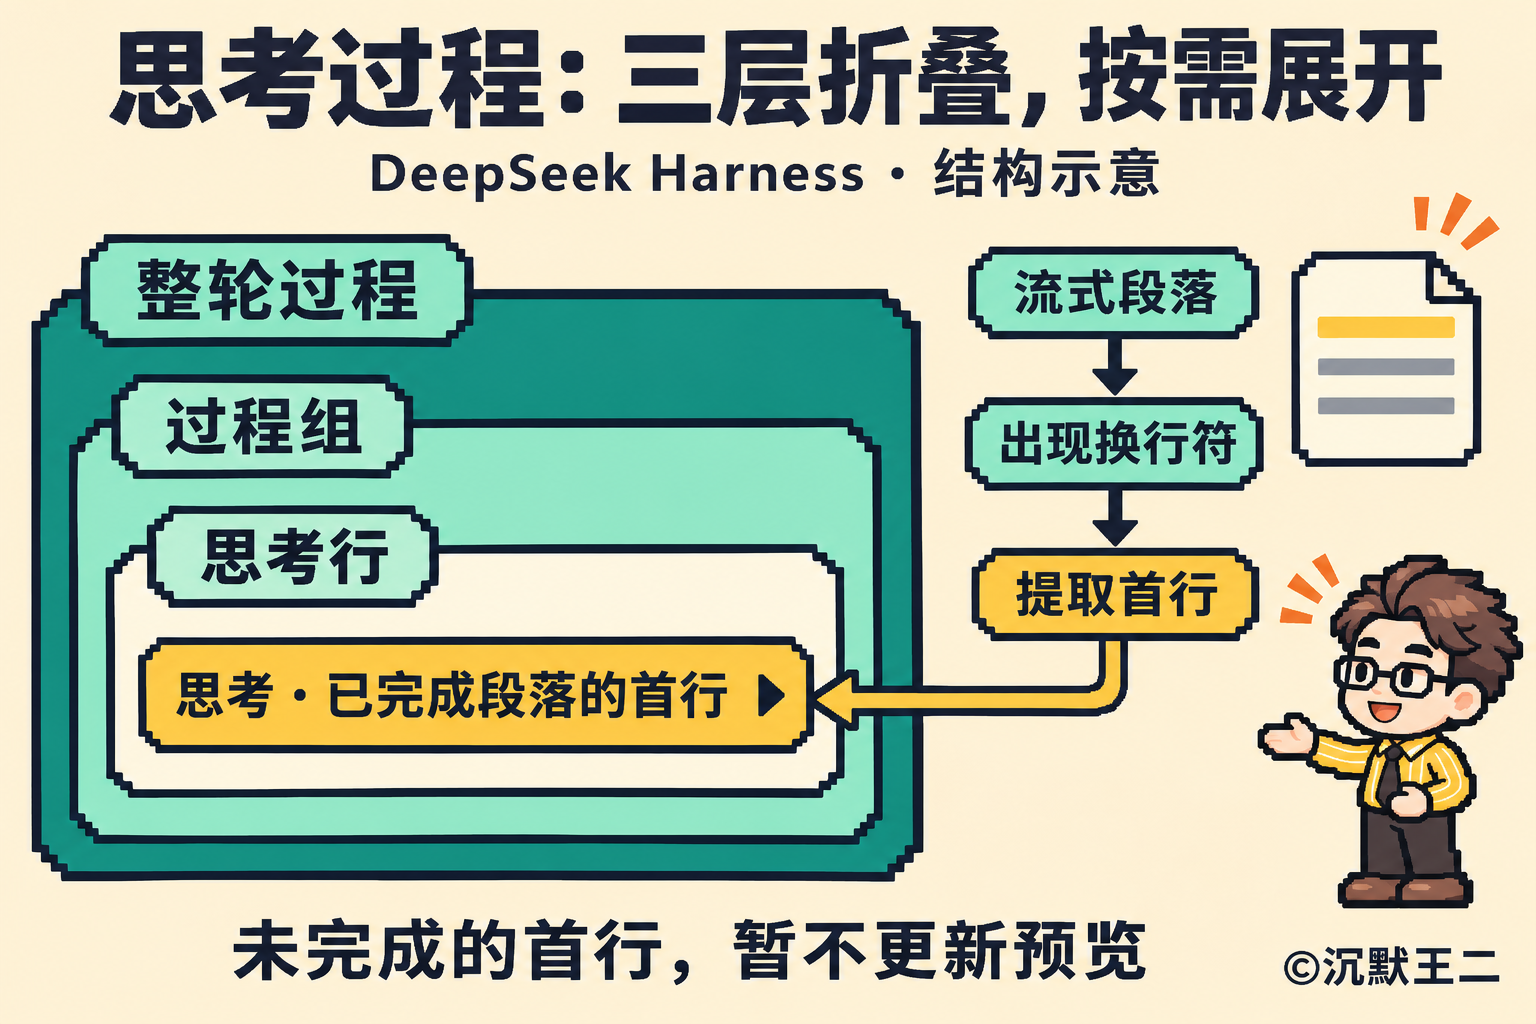
DeepSeek Harness 把思考过程分三层折叠,最外层是「已完成,用时×秒」,点开后是「已完成分析」,再展开是具体的「思考」。
恭喜看到这里的你,成功击败 70% 的学习者了。
聪明的你可能会继续问,DeepSeek Harness 是怎么控制模型思考深度的?
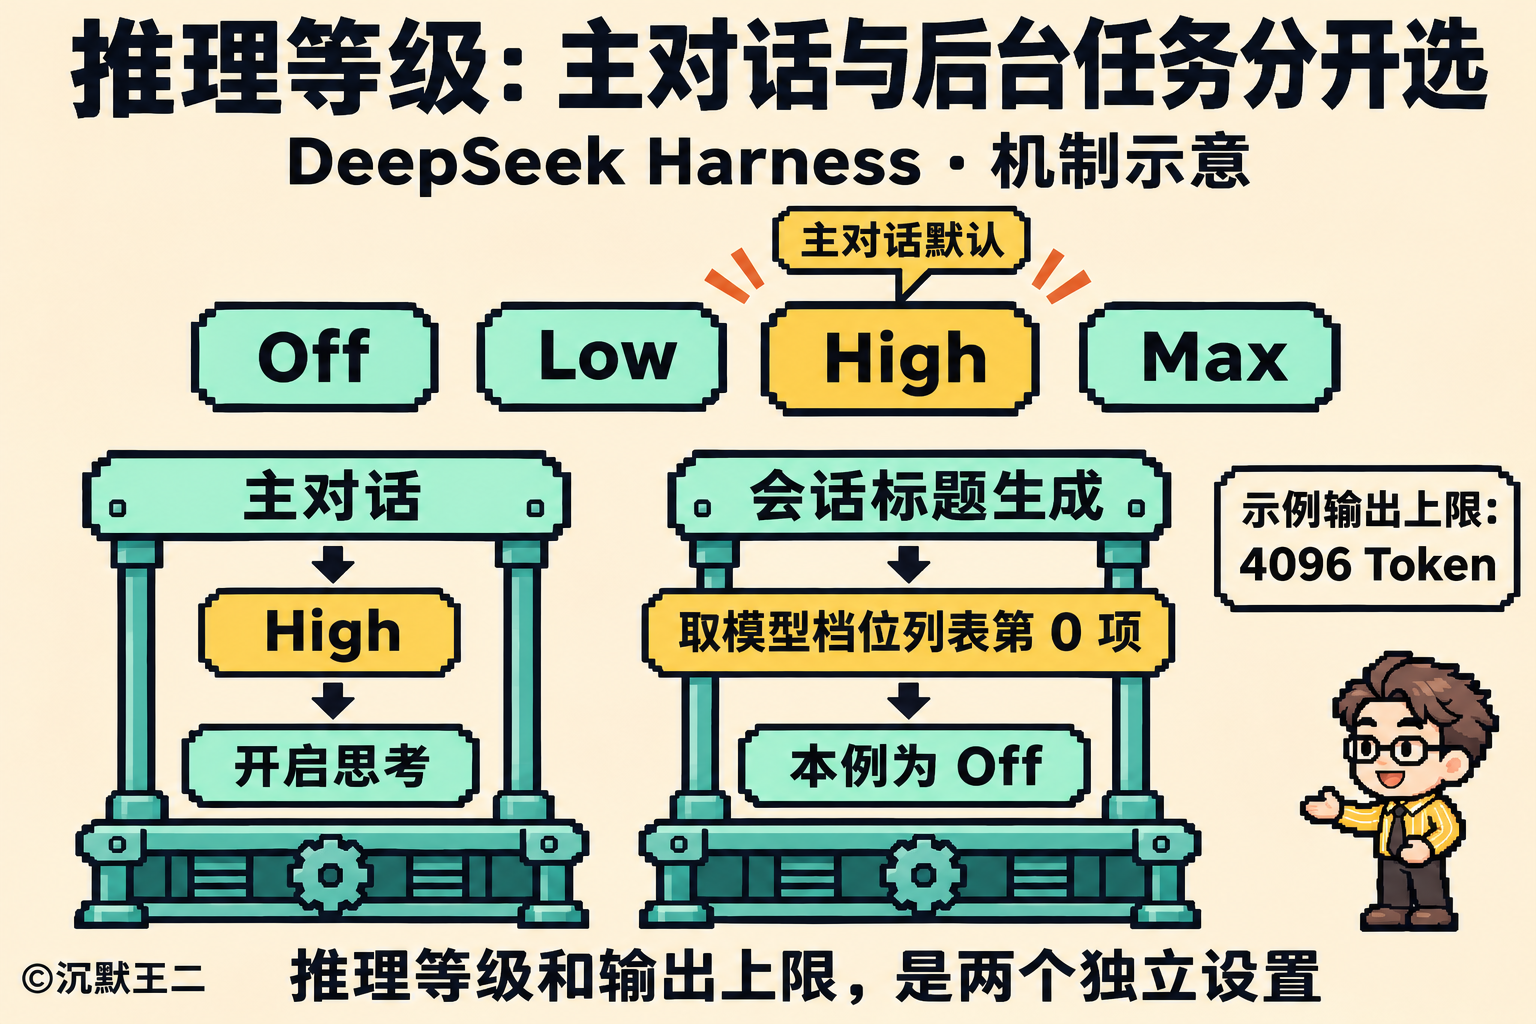
点击显示模型名称和当前等级的位置,再点「推理等级」,就能看到可选档位。官方适配器按从低到高的顺序定义了四档推理等级:Off、Low、High 和 Max,默认是 High。选择 Low、High 或 Max 时,请求会把 thinking 设为 enabled,并通过 output_config 把对应等级传给模型;选择 Off 时,请求会发送 thinking: disabled 关闭思考。
恭喜看到这里的你,成功击败 90% 的学习者了。
最后聪明的你还会问,在多轮对话和上下文压缩时,DeepSeek Harness 怎么处理历史消息里的思维链?
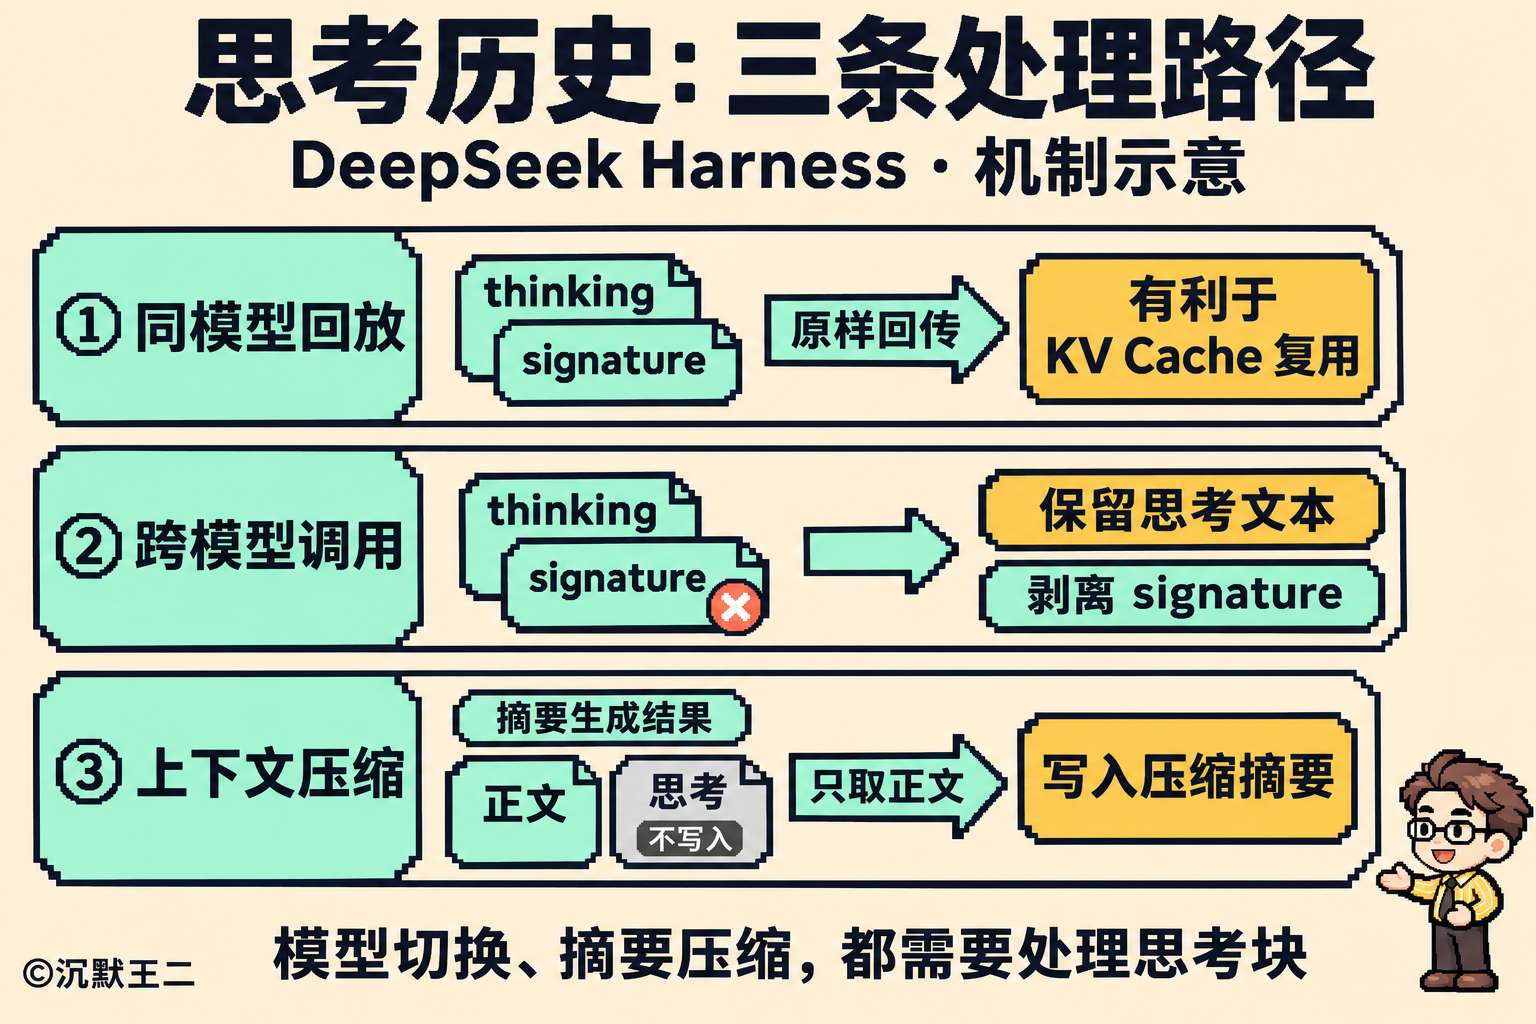
分三种情况,同一模型下的多轮对话、中途切换模型和上下文压缩。
第一种,服务端以流式返回思考块时,会下发一个加密签名 signature,DeepSeek Harness 在后台把这些片段拼成完整的签名。发送下一轮请求时,DeepSeek Harness 会把 assistant 消息里的思考块连同签名原样发回服务端,同时过滤掉 user 消息和工具返回结果里的思考块。原样发回有两个好处,一是模型连续调用工具时,能看到上一步的推理过程;二是历史消息对应的 Token 序列保持不变,服务端可以继续复用已经缓存的 KV Cache。
第二种,比如从 deepseek-v4-pro 切换到 deepseek-flash。加密签名与生成它的模型是绑定的,换了模型,签名就无法通过校验。因此,DeepSeek Harness 在组装请求前,会检查每条消息的来源模型和当前要调用的模型是否一致。如果不一致,就丢弃这些思考块的签名,只发送思考内容,避免接口报错。
第三种,DeepSeek Harness 会把较早的历史消息发给模型,让它生成一份摘要。这次调用返回的思考块会被丢弃,只有摘要正文会放进 <compacted-summary> 标签并写入检查点,这样生成摘要时的思考内容就不会占用后续对话的上下文空间。
恭喜你升到王者段位了,成功击败 99% 的学习者。
最后简单总结一下。CoT 思维链就是把上下文窗口当成草稿纸,让模型先输出中间的推理步骤,再基于这些步骤得出最终答案。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!