
那如果你点开 DeepSeek 官方提供的配置,会发现一个有意思的细节,默认接口地址是 https://api.deepseek.com/anthropic,而不是 OpenAI Responses。
恭喜看到这里的你,已经成功击败 30% 的学习者。
那聪明的你一定会问,这两套协议在组装消息和调用工具时有什么区别?
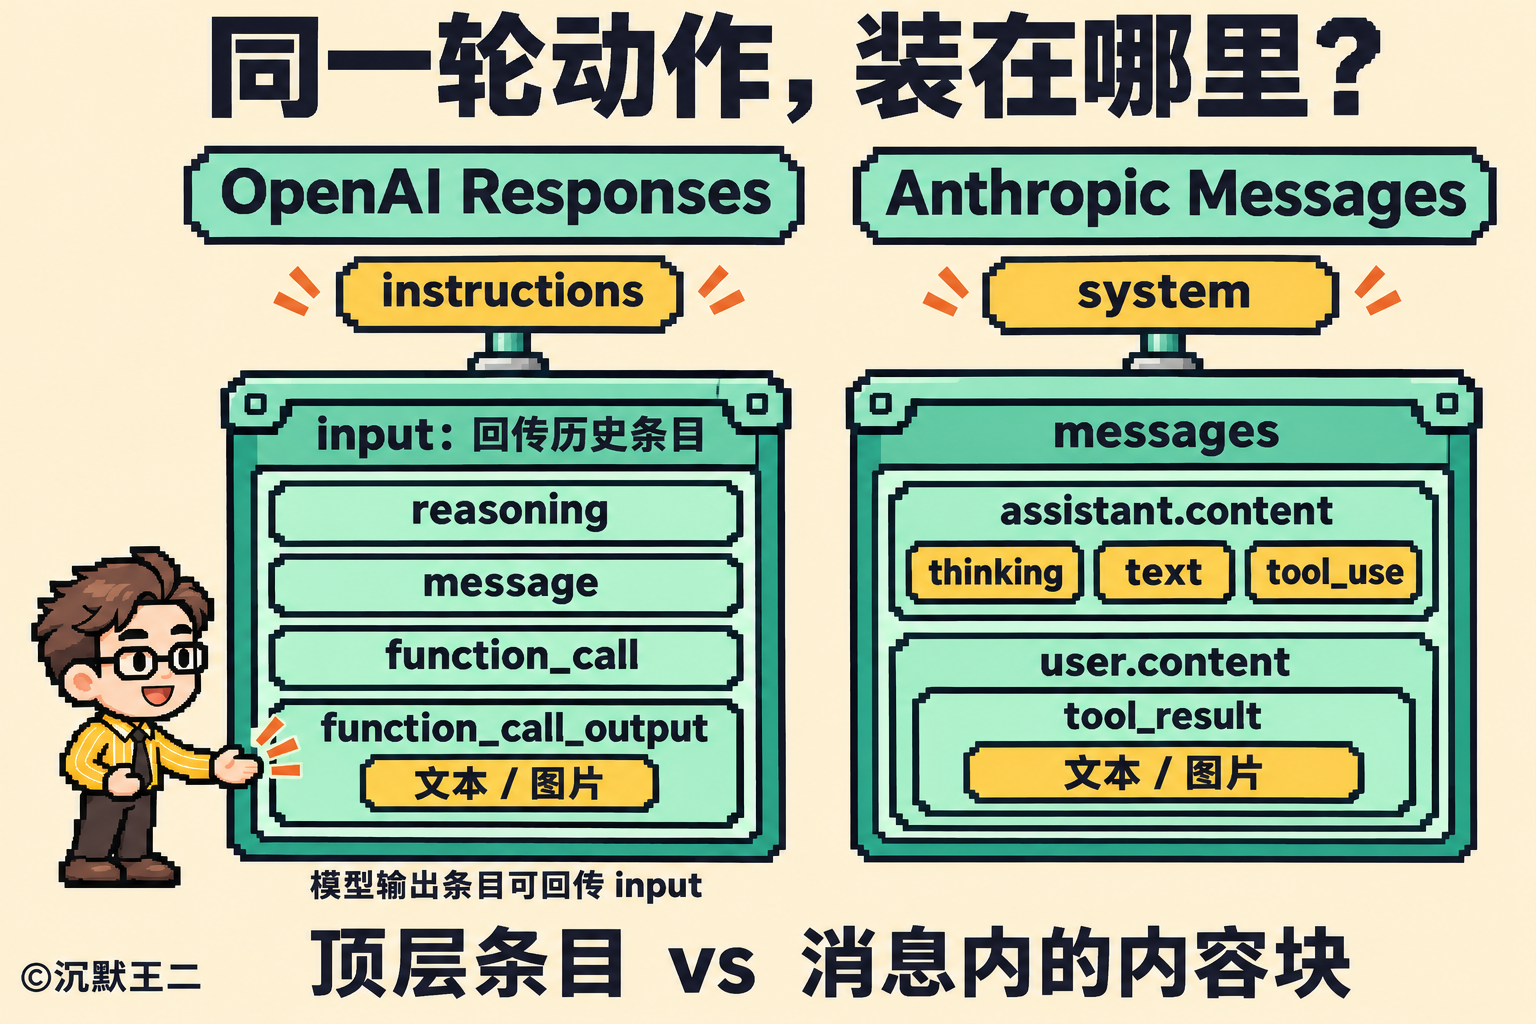
先看 OpenAI Responses。它把系统指令放在了最外层的 instructions 字段里,把对话历史放在了 input 数组里。比如模型在一轮回复里先思考、再输出、最后调用工具,这些内容在 input 数组里不会合成一条消息,而是排列成三条独立的:reasoning、message 和 function_call。工具执行完以后,返回结果也是一条单独的 function_call_output,里面可以同时放文本和图片。
再看 Anthropic Messages。它把系统提示词单独放在请求体最外层的 system 字段里,messages 数组只允许 user 和 assistant 两种角色,用 content 数组来表示每条消息的内容。模型在一轮回复里生成的 thinking 思考块、text 文本块和 tool_use 工具调用块,按生成顺序放在同一条 assistant 消息的 content 数组里。工具执行完以后,所有返回结果都以 tool_result 内容块的形式,合并到紧随其后的 user 消息里,tool_result 块里同样可以包含文本和图片。
如果同一条 user 消息里既有工具返回的 tool_result,又有用户追加的普通文本,tool_result 必须排在最前面。
恭喜看到这里的你,已经成功击败 50% 的学习者。
那聪明的你肯定会继续问,遇到思考过程和流式输出时,两套协议谁更好用?
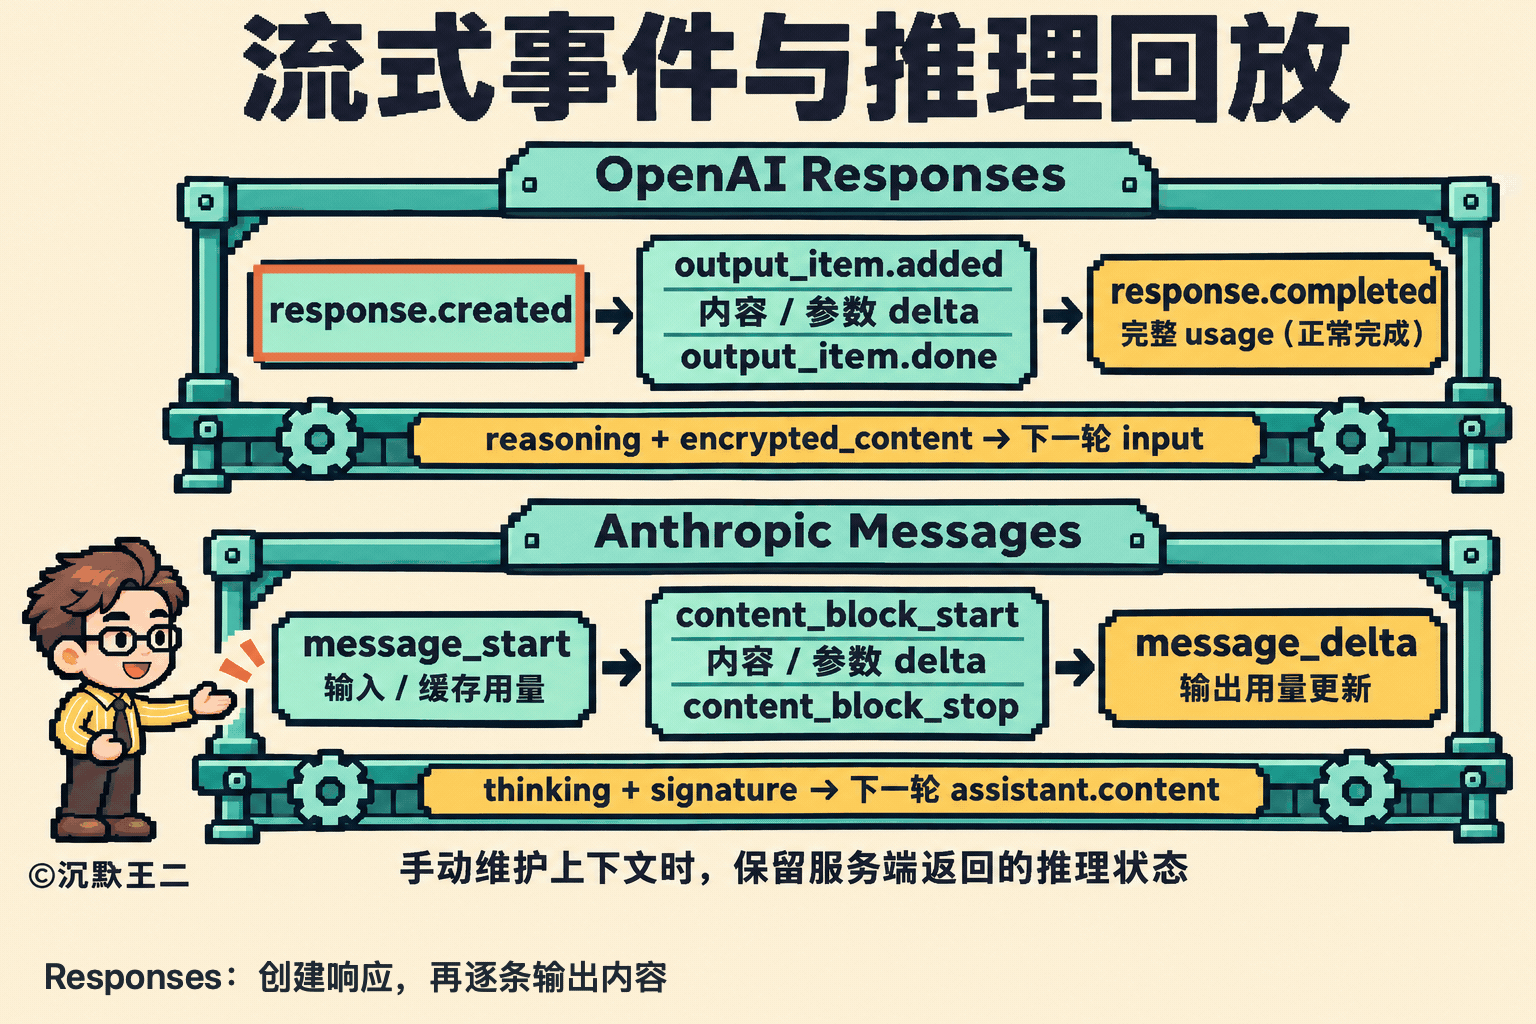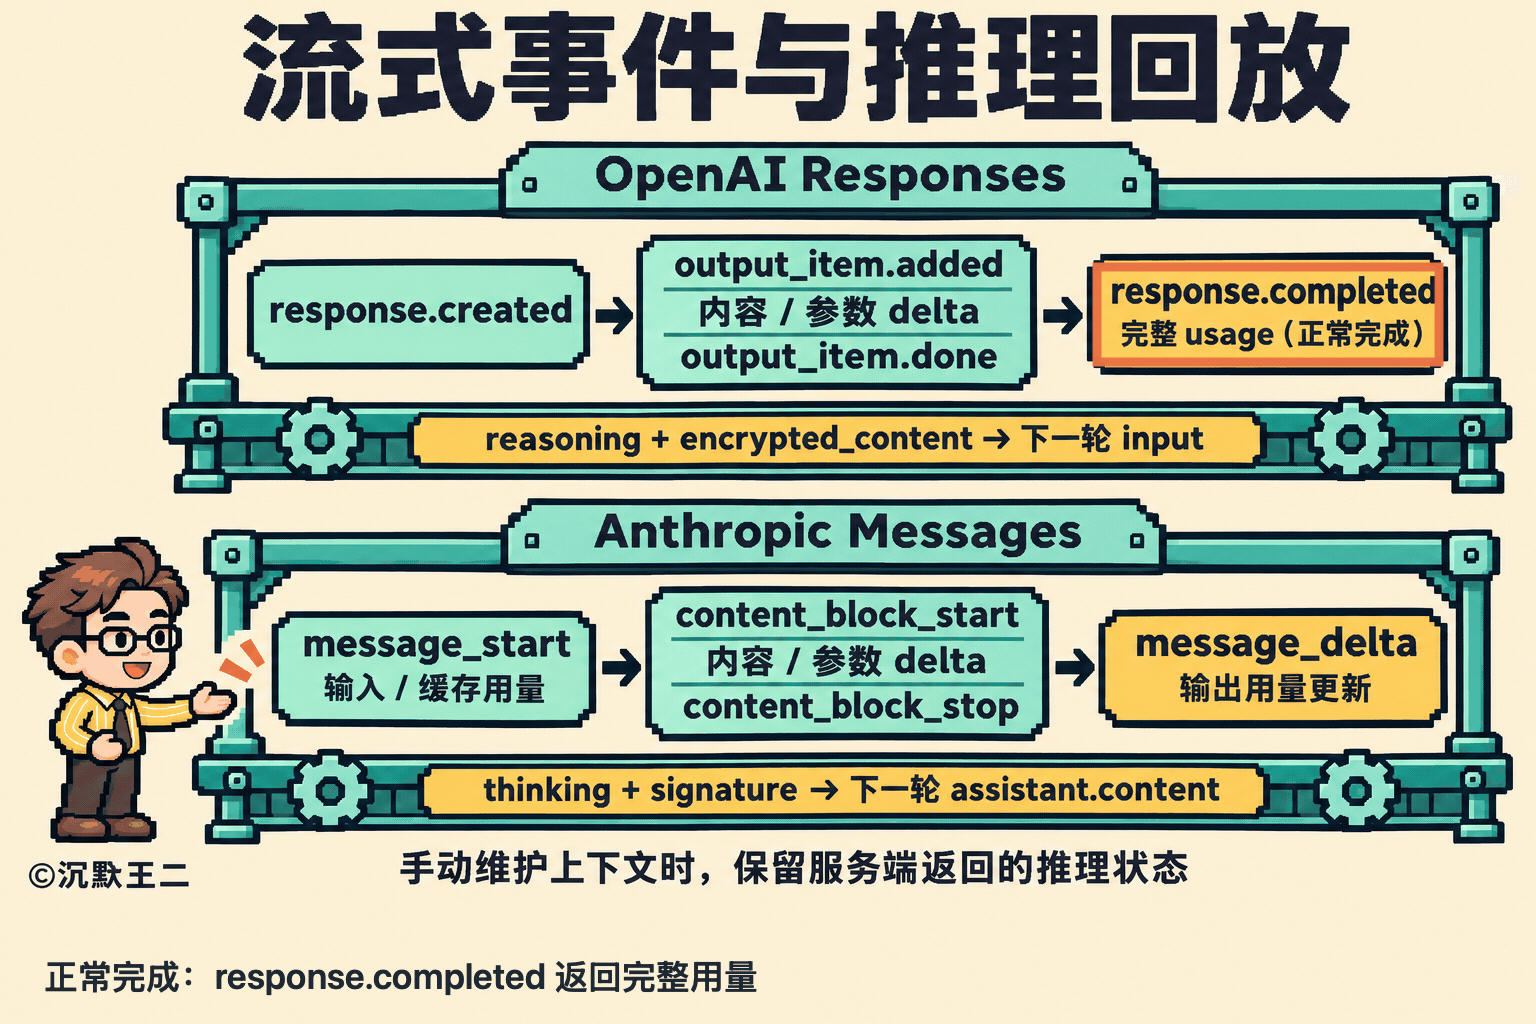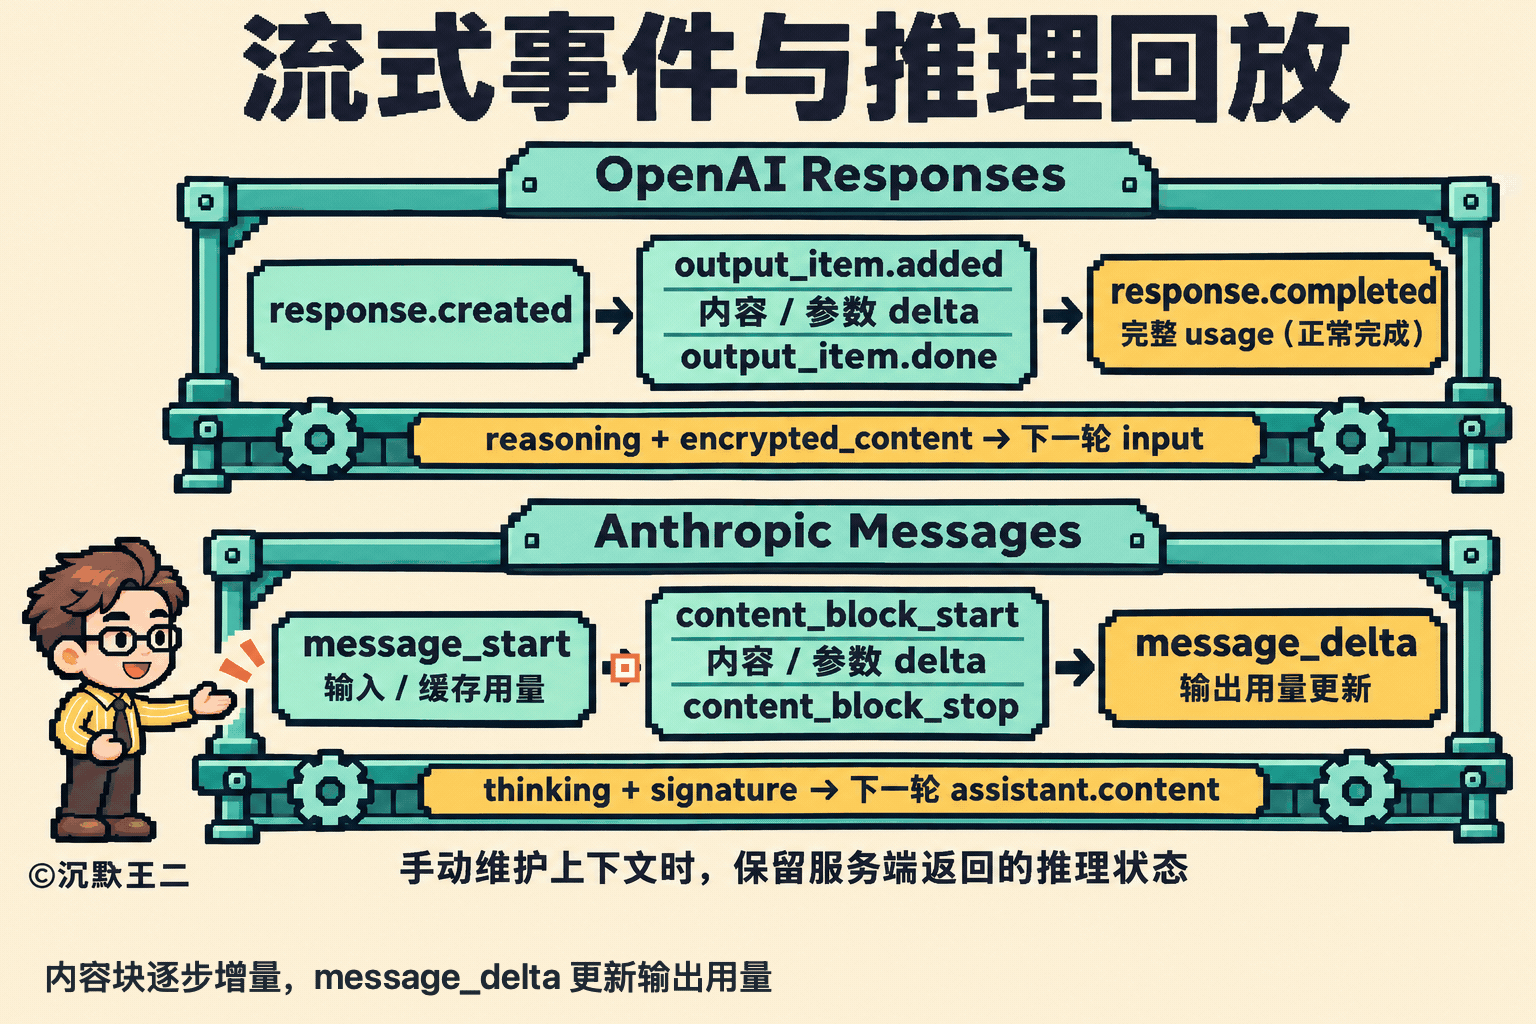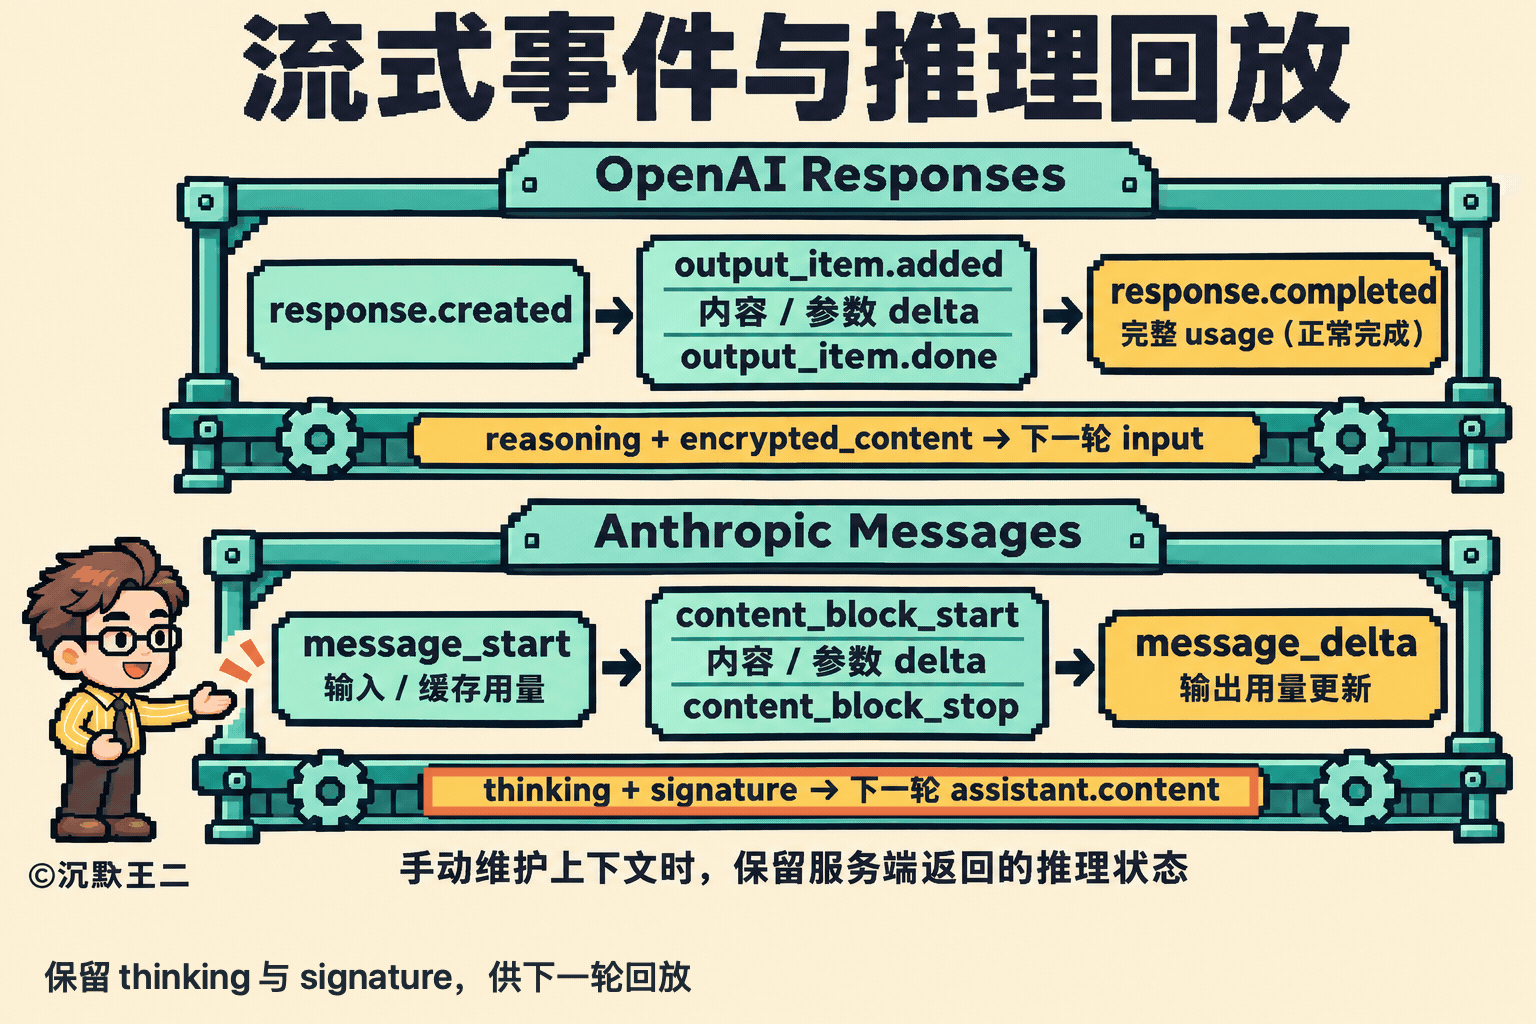
OpenAI Responses 默认只下发推理摘要,不返回完整的推理过程。如果 Harness 在本地自己维护上下文,就必须在请求参数里显式加上 include: ["reasoning.encrypted_content"],服务端才会在 reasoning 里下发一段加密密文。下一轮请求时,Harness 再把带密文的整条 reasoning 原样放回 input 数组。
Anthropic Messages 则在 content 数组里定义了明文可读的 thinking 思考块。流式返回时,服务端先下发 thinking_delta,在这个思考块结束之前,再下发 signature_delta 签名片段。DeepSeek Harness 会把收到的签名片段拼接完整,下一轮请求时把整个 thinking 块连同 signature 签名原样放回 assistant 消息。这样一来,前端能实时展示完整的思考过程,多步工具调用时模型的推理也不会中断。
OpenAI Responses 虽然提供了 added、delta、done 等状态事件,但整轮对话的 Token 用量,要等流式输出结束、收到最后一条 response.completed 事件时才会返回。
Anthropic Messages 在第一条 message_start 事件里就会把输入 Token 数和缓存命中的 Token 数发给 Harness,即使用户中途取消,输入成本也能准确统计。之后每个内容块都有成对的 content_block_start 和 content_block_stop 事件,分别标记开始和结束。DeepSeek Harness 也充分利用了这一点,收到 content_block_stop、确认工具调用块已经结束后,才把完整的工具参数按 JSON 解析一次,这样能节省不少 CPU 开销。
另外,OpenAI Responses 返回的 input_tokens 已经包含了缓存命中的 cached_tokens,要算未命中缓存的输入,需要用 input_tokens 减去 cached_tokens;Anthropic Messages 返回的 input_tokens 只表示未命中缓存的那部分输入,要算总输入,需要把 input_tokens、缓存读取和缓存写入三项加起来。
恭喜看到这里的你,已经成功击败 70% 的学习者。
聪明的你可能还会问,在控制 KV Cache 提示词缓存时,两套协议的做法有什么不同?
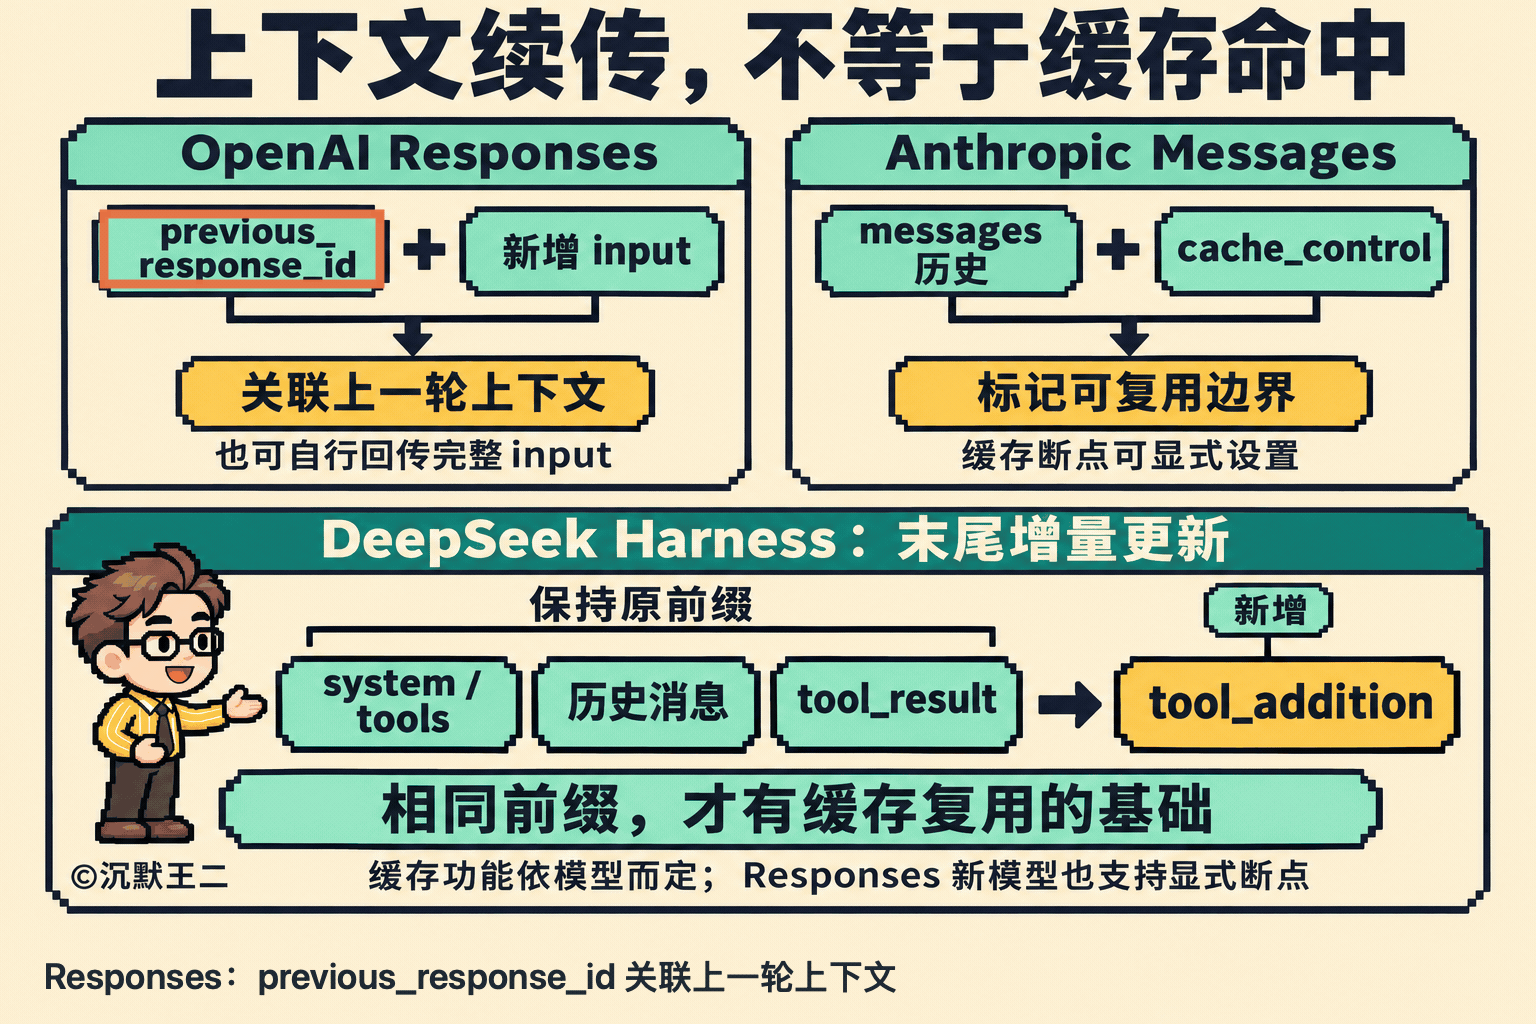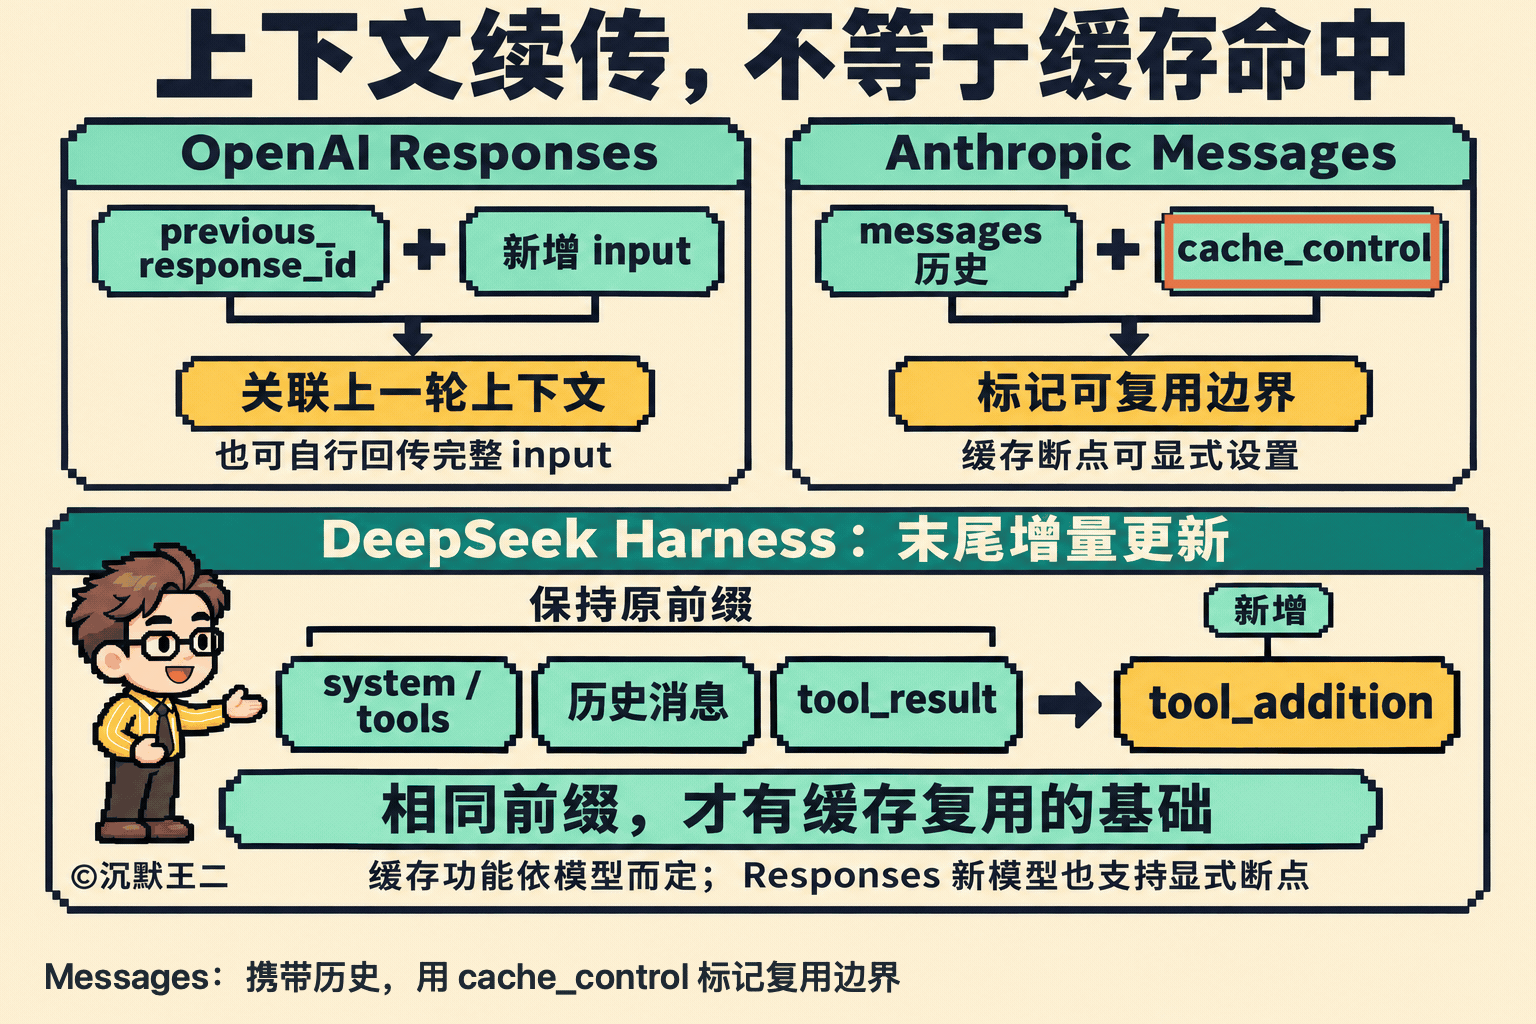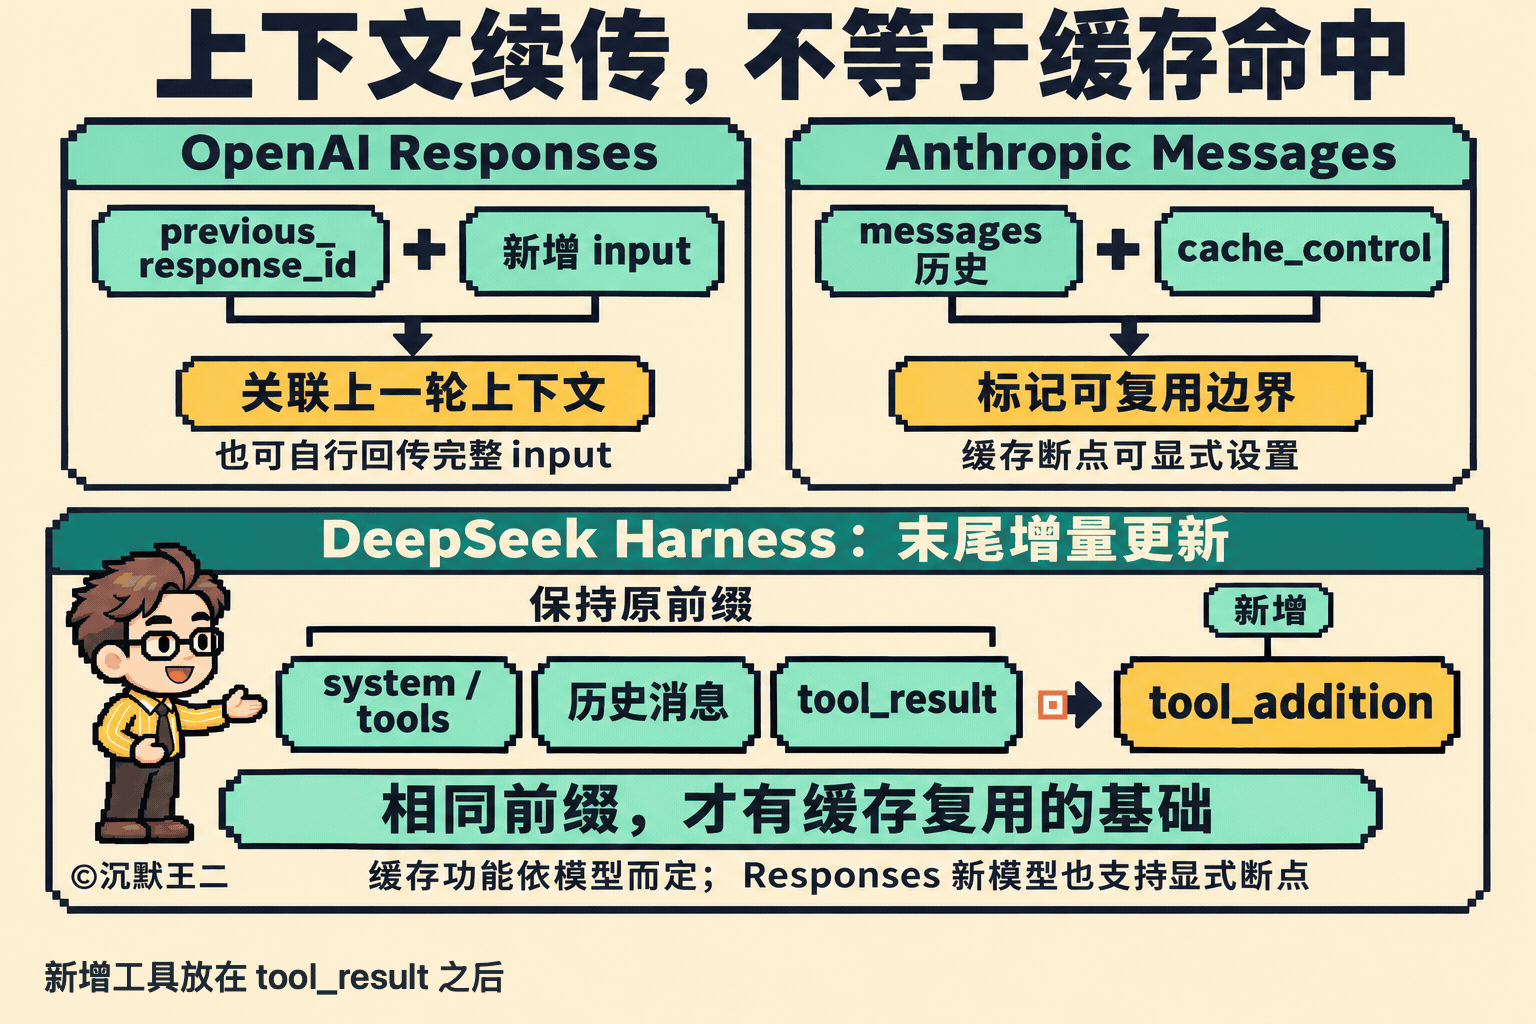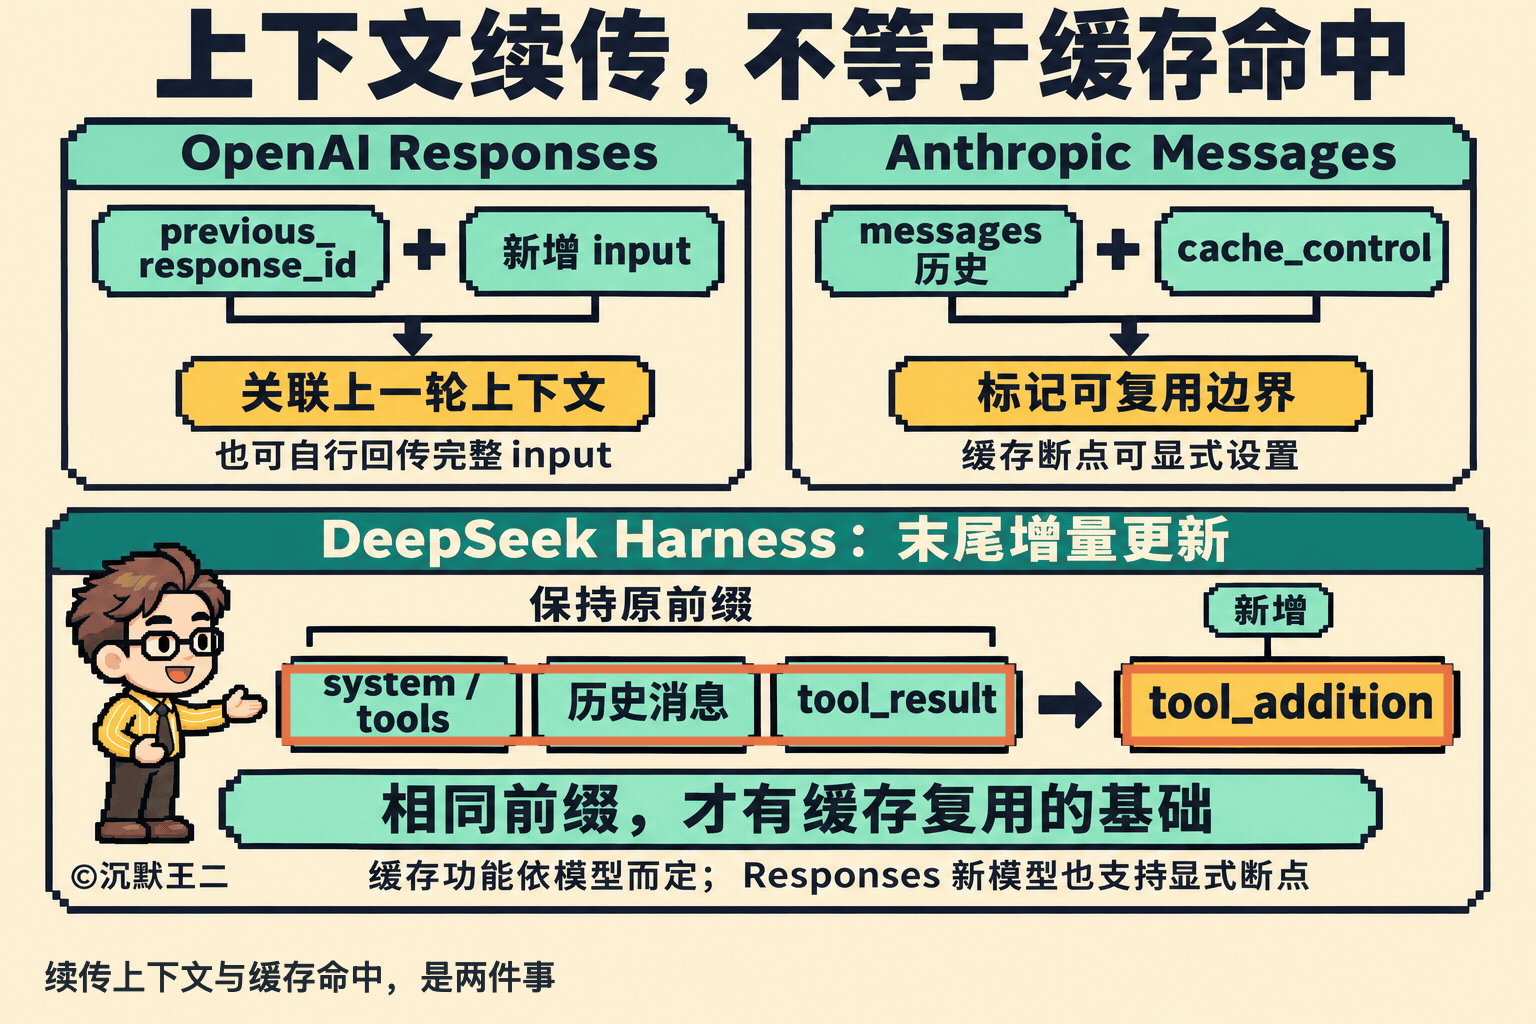
OpenAI Responses 由服务端自动匹配相同的提示词前缀,没有标记缓存位置的字段。Harness 能做两件事,一是在请求里传一个 prompt_cache_key 作为会话标识,让服务端的负载均衡器尽量把同一个会话的请求转发到同一台推理机器上;二是像 Codex 那样传入上一轮的 previous_response_id,每轮只发送新增的工具返回,由服务端拼接历史上下文。
Anthropic Messages 则把上下文和缓存的控制权交给 Harness,允许 Harness 用 cache_control 字段手动标记,告诉服务端从开头到这个位置的内容需要缓存。
借助在 Anthropic Messages 协议之上扩展的增量更新能力,DeepSeek Harness 可以保持顶层的 system 和 tools 不变,只在上一轮 tool_result 消息之后,往历史消息里追加一个系统更新块或 tool_addition 工具新增块。这也是 DeepSeek 大量命中缓存的一个秘密。
恭喜看到这里的你,已经成功击败 90% 的学习者。
最后聪明的你还会问,如果在一个会话中途切换到另一种协议的模型,Agent 会怎么处理历史消息?
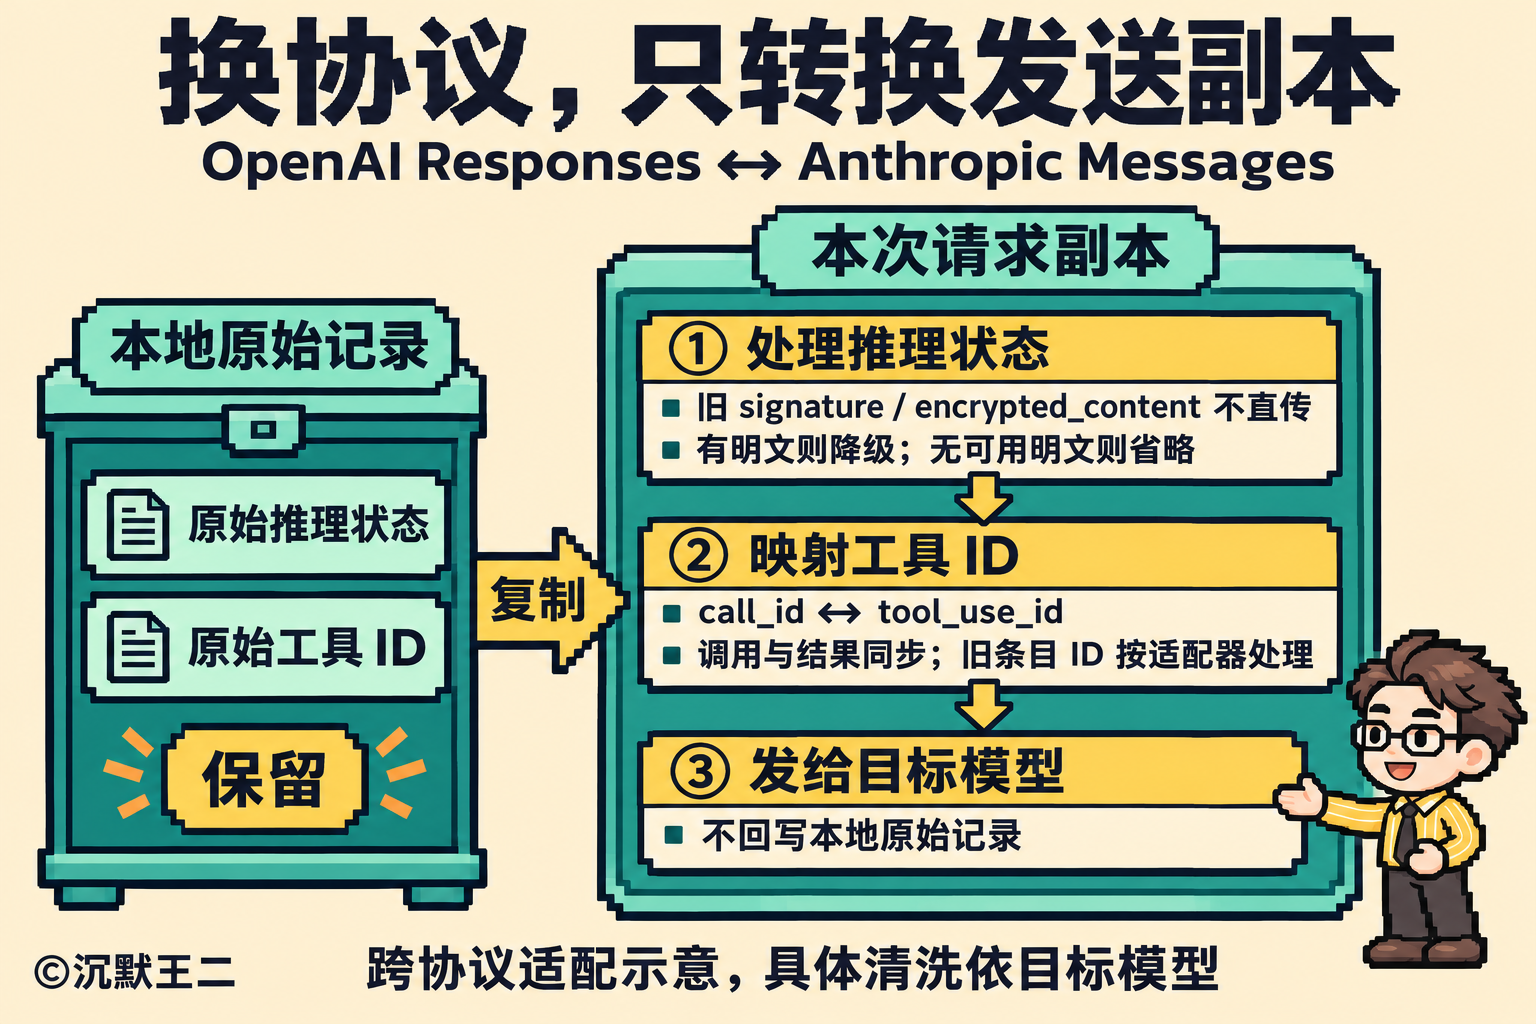
DeepSeek Harness 在跨协议切换模型时,会对历史消息做三步处理。
第一步,把思考块降级为普通文本。Anthropic Messages 的 signature 签名和 OpenAI Responses 的 encrypted_content 密文都和生成它们的模型绑定,换了协议就无法通过校验。适配器会检查历史消息来自哪个模型,如果和当前模型不一致,就去掉旧的签名或密文,把明文的 thinking 思考块转换成普通的 text 文本块,再发给新模型。
第二步,重写工具调用 ID,解除和原协议的绑定。两套协议对工具调用 ID 的格式要求差别很大。OpenAI Responses 会给每次工具调用同时分配 call_id 和以 fc_ 开头的 ID,服务端会严格校验 fc_ 是否和紧挨着的 rs_ 推理配对。Anthropic Messages 只用一个 ID,所以从 OpenAI Responses 切换到 Anthropic Messages 时,适配器会过滤掉 ID 中不合规的字符,再通过映射表把 tool_result 里引用的 ID 一并替换。反过来时,适配器会主动去掉旧的 ID,只传 call_id,避免触发服务端的配对校验报错。
第三步,保护本地的原始记录。DeepSeek Harness 会把本地保存的会话日志和每次发请求用的临时副本分开,跨协议处理只作用在当次请求的临时副本上,本地日志始终保留原模型的完整签名。
恭喜你升到王者段位,成功击败 99% 的学习者。想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!