
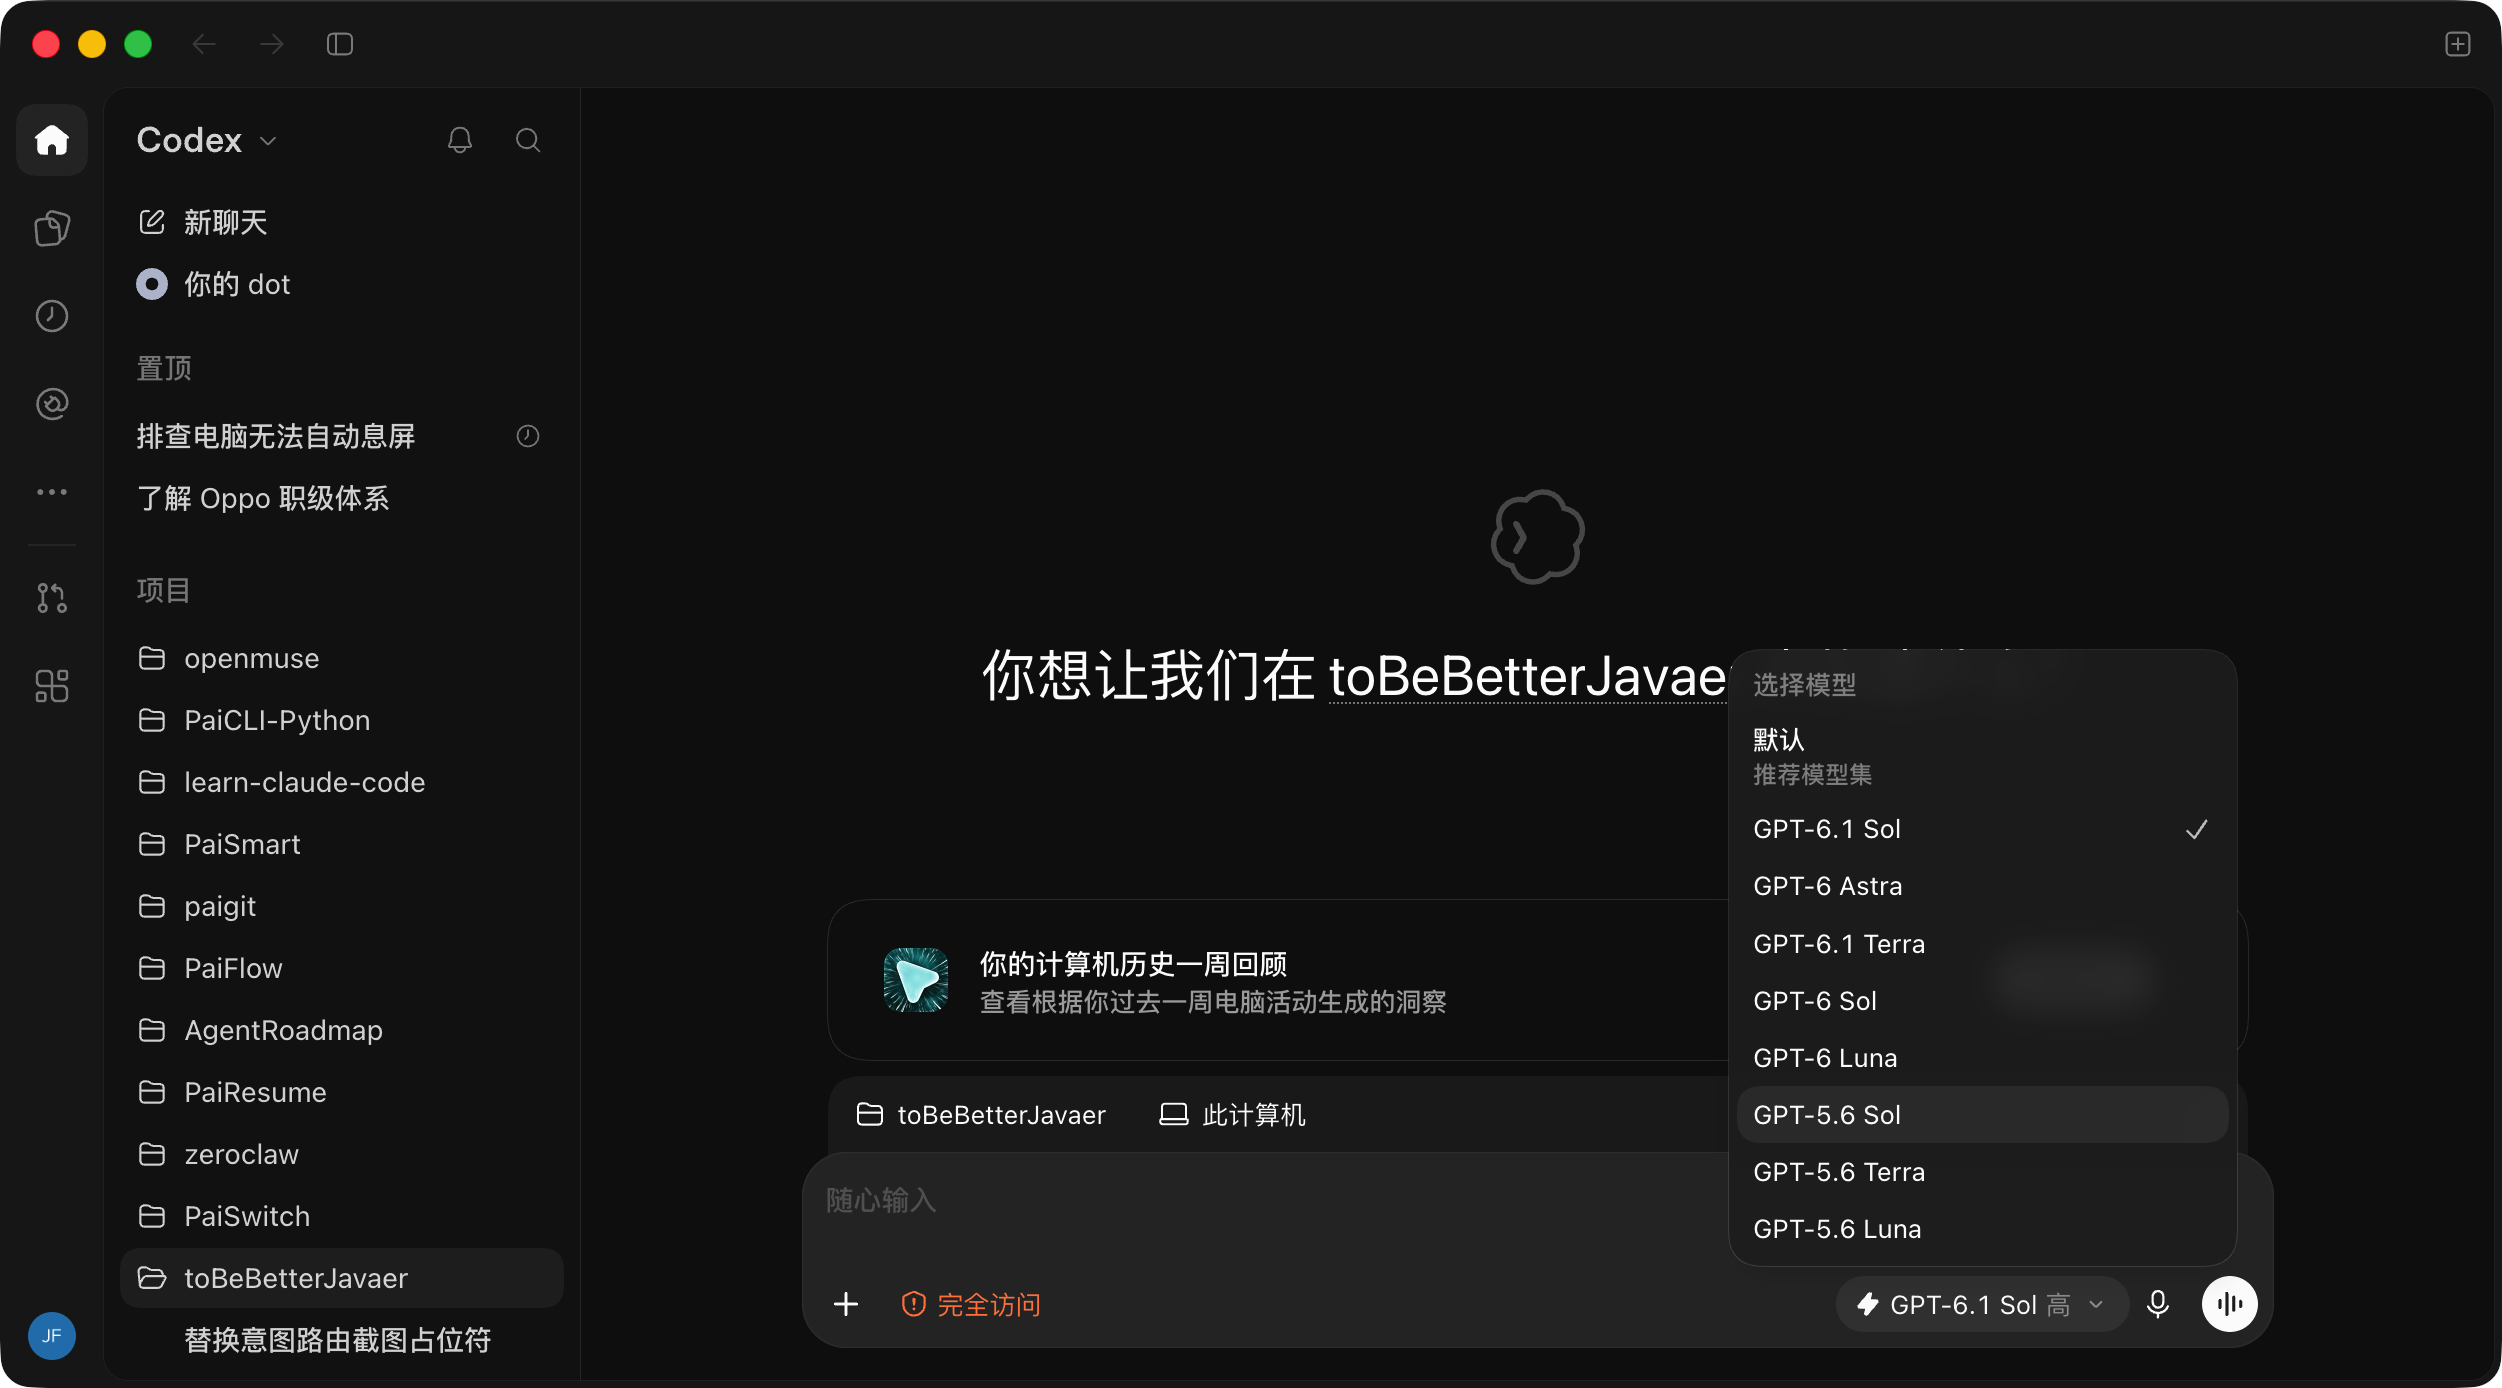
官方展示了把 2D 建筑蓝图还原成 3D 交互模型的例子,我也整理好了提示词,大家可以试一下。
请在 index.html 中(用 Three.js),编写“2D 建筑蓝图转 3D 模型”工具。左侧绘制双层住宅 2D 蓝图(含承重墙、旋转楼梯与轴线);右侧还原为支持剖面切换与日照阴影的 3D 模型;点击左侧构件,右侧联动高亮并展示参数。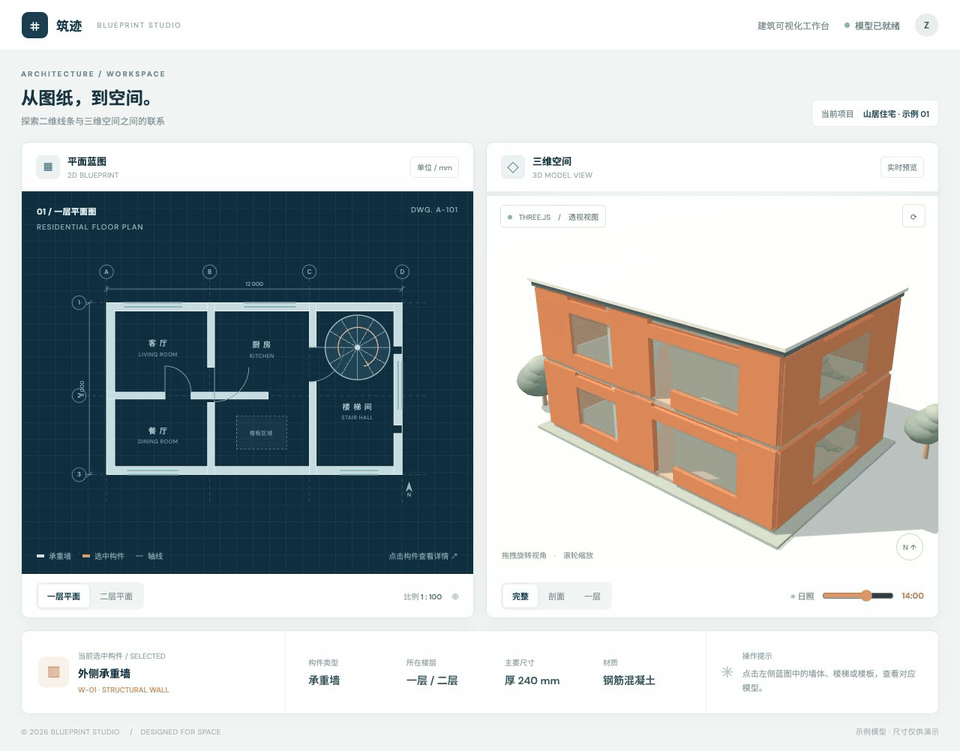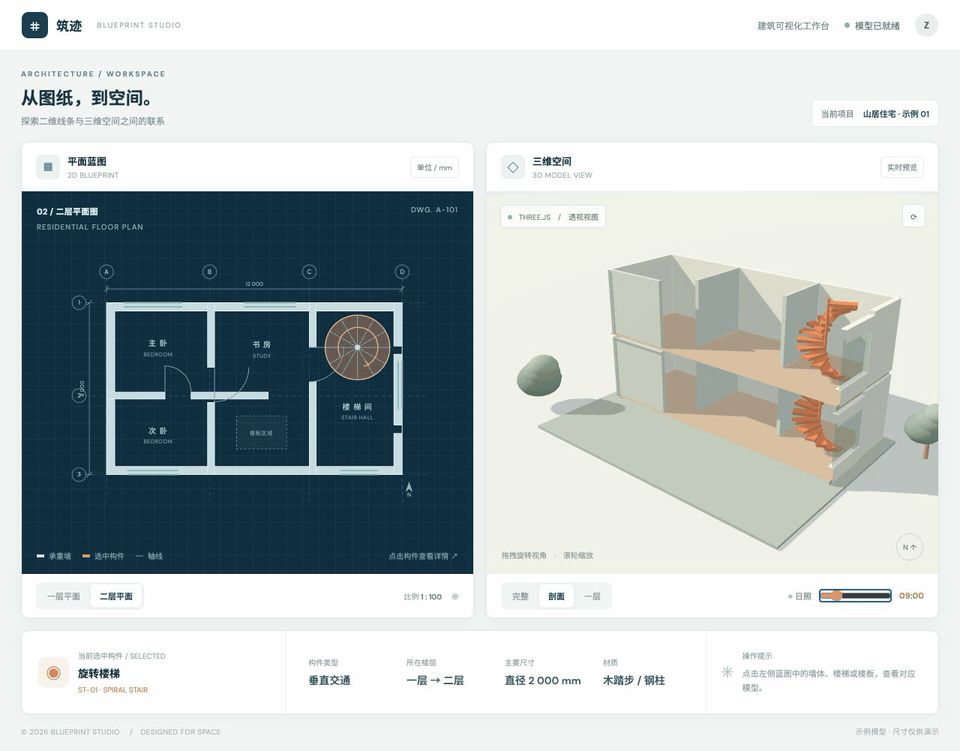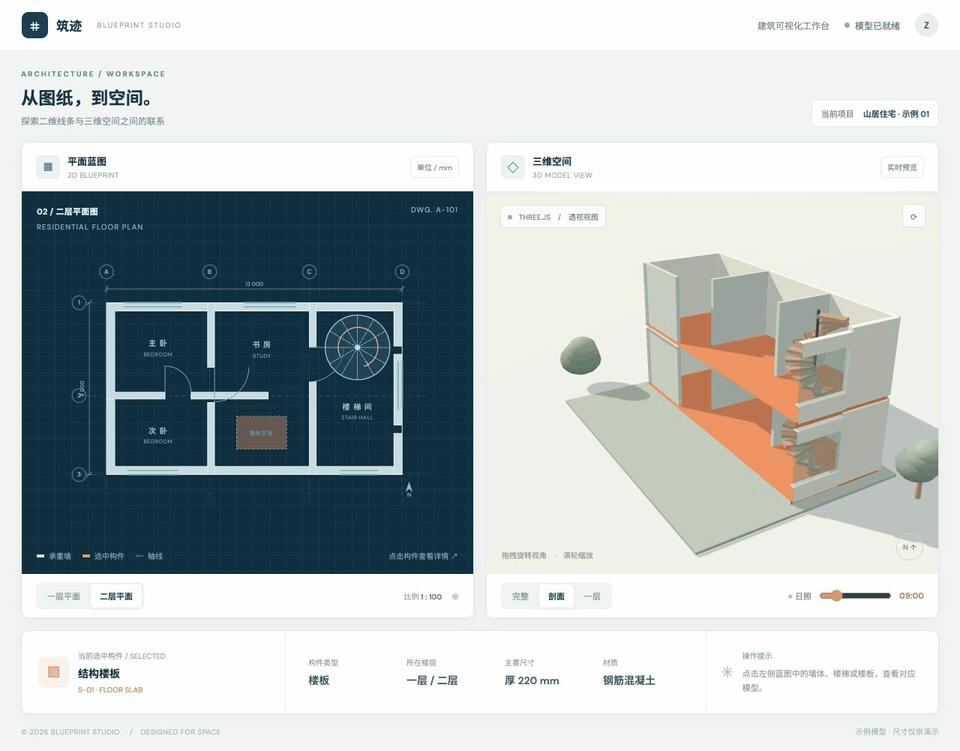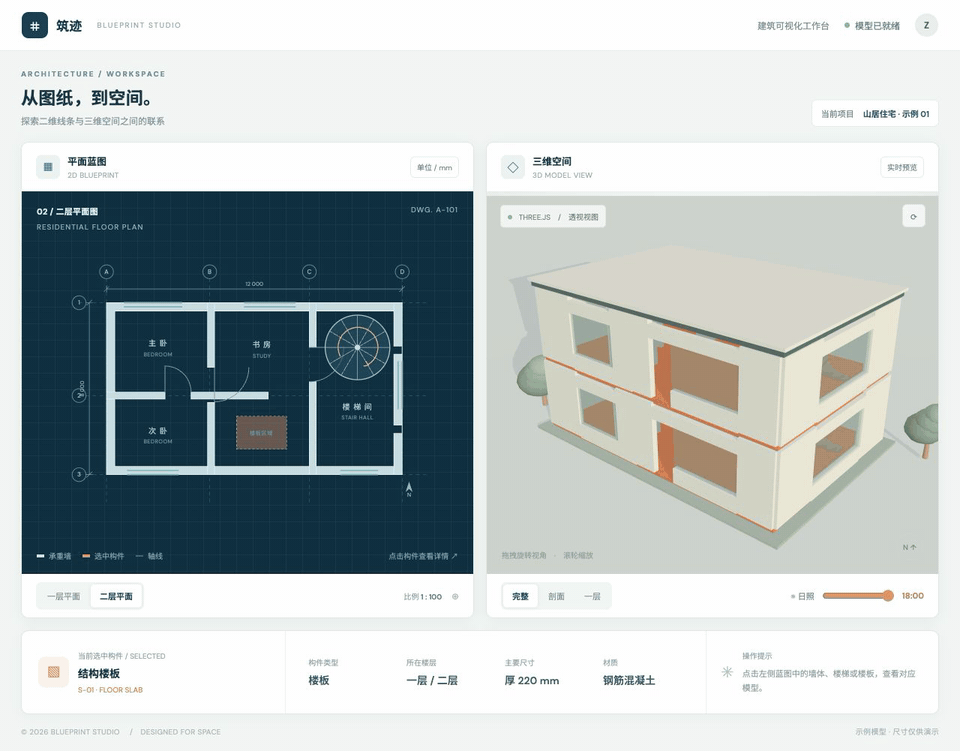
你别说,效果还真的挺不错。
不过有一说一,市面上便宜又快的模型够多了,我需要的是能打败 Opus 5.5 的模型啊,OpenAI,你抓紧点啊。
恭喜看到这里的你,已经成功击败 30% 的学习者,给自己来个关注鼓励一下吧。视频的原稿以及 364 道 Agent 八股已经整理到开源知识库。
先说第一件事,Astra、Sol、Terra、Luna 怎么区分?
从 GPT-6 开始,OpenAI 按天体体积从小到大排了四档。
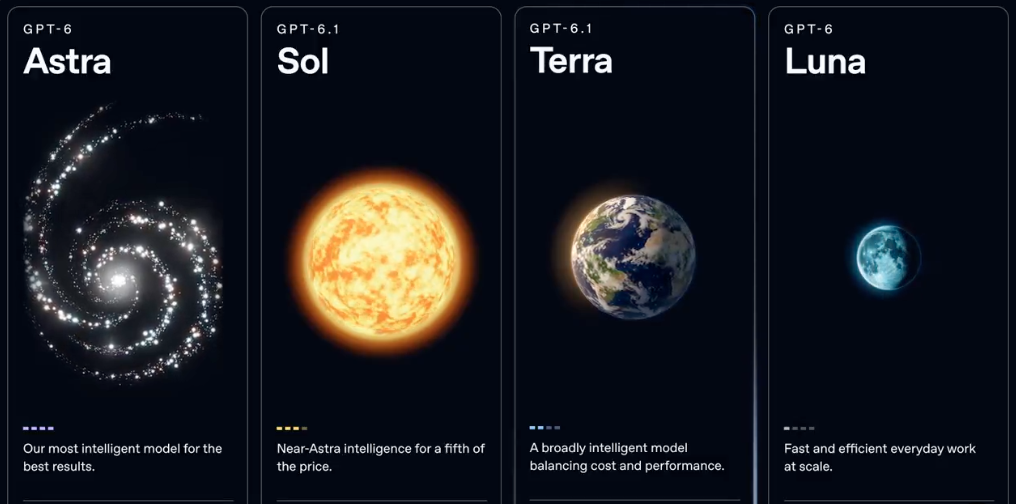
最小的 Luna 对标 Haiku 5.5,负责高并发路由。往上一档是 Terra,对标 Sonnet 5.5。再往上是 Sol,是我现在使用的主力模型,主要是比 Astra 省 Token。最顶上是 Astra,负责前沿数学推导和漏洞分析,能力我觉得还是可以的,但 200 刀的用量根本不够用。
那聪明的你肯定要问,Terra 到底强在哪里?OpenAI 在 Codex 源码里给它塞了哪三个大招?
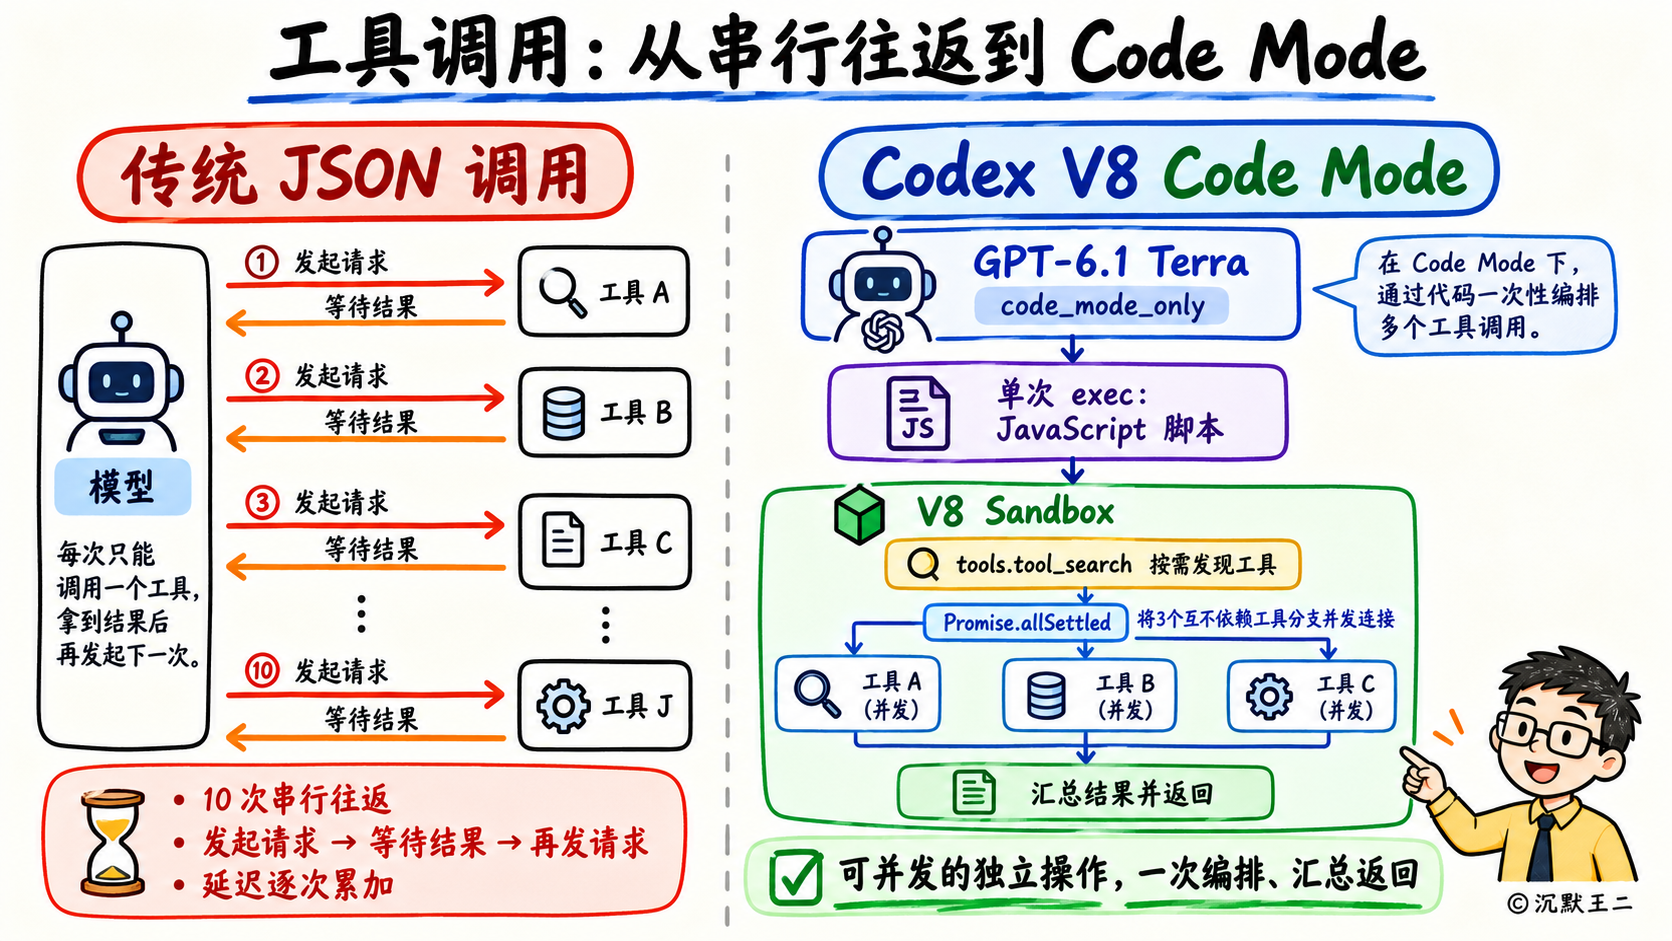
第一个,Codex 为 GPT-6.1 Terra 默认开启了 code_mode_only 纯代码执行模式,把传统的“一次调用一个工具”变成了 V8 沙箱里的并发脚本编程。
平时咱们用 Agent,调用工具走的是传统的 JSON 往返模式。比如模型要先查一个文件名,发一次 JSON 请求,等宿主环境返回结果;再读第一个文件,再等返回;接着读第二个文件。排查一个问题需要做十次只读操作,就要跟大模型来回交互十轮,每一轮都要把前面的历史上下文重新发一遍,不仅慢,上下文窗口也很快被塞满。
但在最新的 Codex 模型配置里,GPT-6.1 Terra 的工具模式被设成了 code_mode_only。一旦开启这个模式,Codex 会把零散的工具全部隐藏起来,只向模型暴露一个运行在独立 V8 沙箱里的 exec 工具,并把文件读写、终端命令和外部 MCP 插件全部挂载到沙箱的全局 tools 对象上。
这还没完,如果把几十个工具的参数签名全塞进初始提示词,同样会浪费大量上下文。Codex 的解法是加一套延迟加载机制,当 Terra 拿到复杂任务后,它会写一段 JavaScript 代码交给 V8 沙箱执行,先调用 tool_search,底层用 BM25 实时检索出当前需要的工具并拿到 TypeScript 签名,紧接着在同一段 JavaScript 代码里,用 Promise.allSettled 把多个互不依赖的文件搜索、代码读取一次性并发完成。这也是 Terra 执行任务比 Sol 和 Astra 快三倍以上的第一个变化。
恭喜看到这里的你,已经成功击败 50% 的学习者了。
那聪明的你肯定又要问了,第二个大招是什么?
很多人以为 Terra 只是个中杯模型,能力肯定全面落后于大杯 Sol 和超大杯 Astra。但在长周期多模态评测 Agents' Last Exam v1 当中,面对把 2D 工程图纸转成 3D 模型、逐帧审查动画成片这类任务,GPT-6.1 Terra 在最高推理档位下拿到了 60 的高分,反超了自家的 GPT-6.1 Sol,58.6 分。
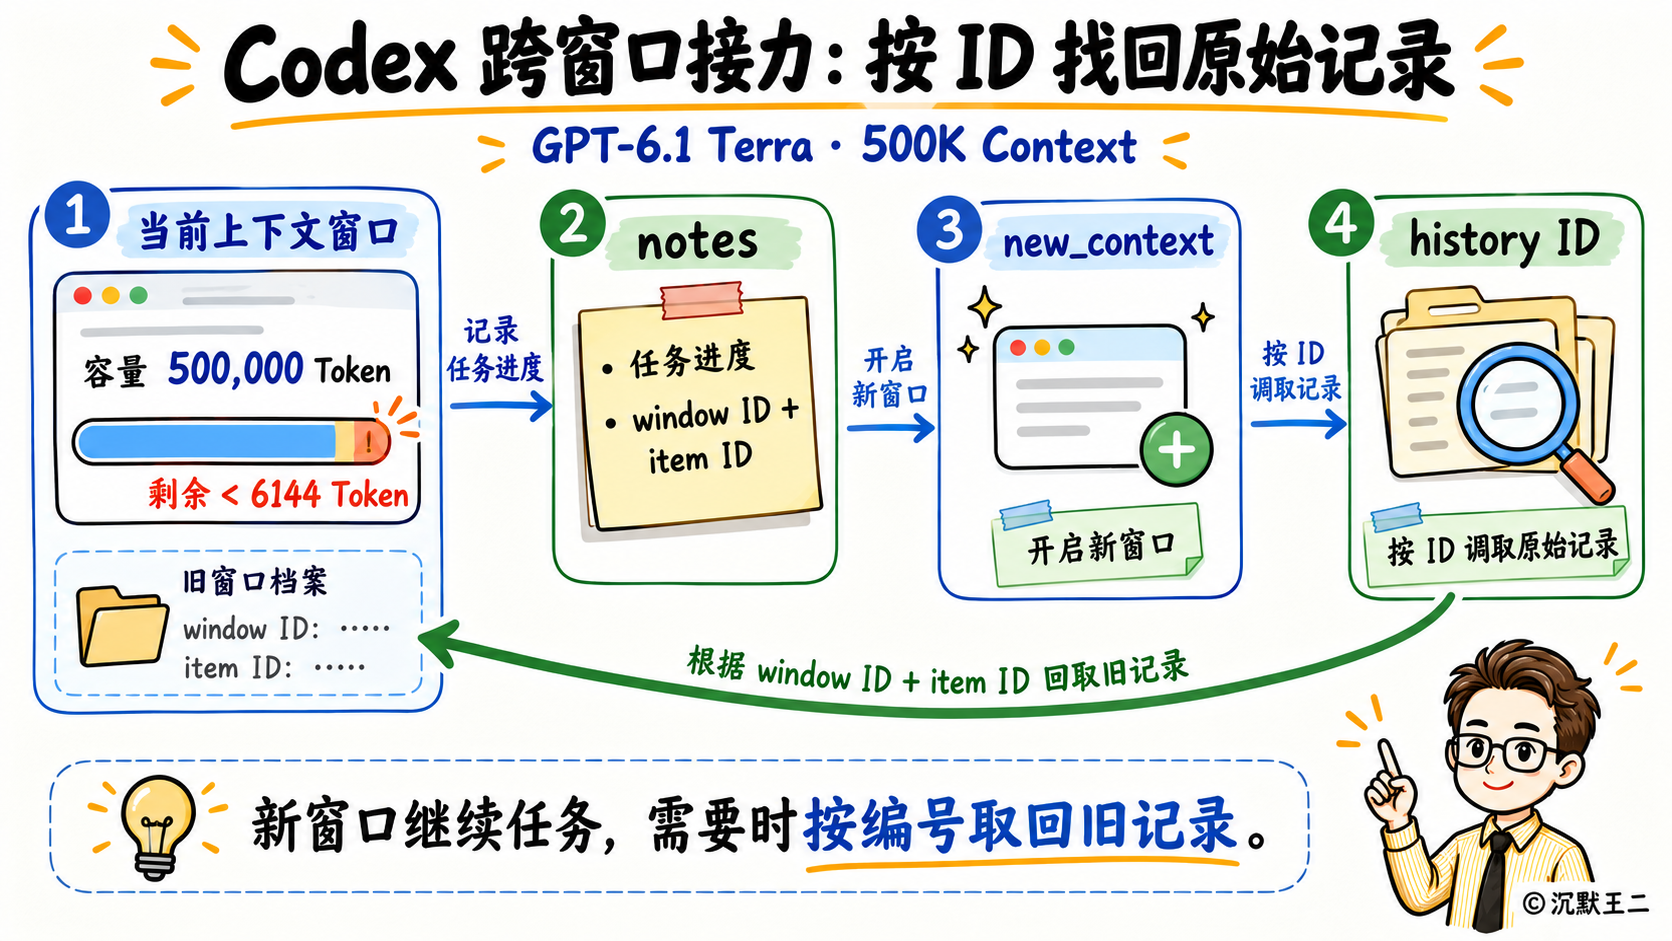
为什么?我去翻了 Codex 源码里的模型配置清单,发现了两个关键参数。第一,虽然 GPT-6 全系的上下文都是 105 万 Token,但在 Codex 的源码里,Astra、Sol 和 Luna 的默认工作窗口 context_window 全都被锁死在 27.2 万 Token。唯独 GPT-6.1 Terra 放开到了 50 万 Token,同时开启了 supports_image_detail_original 开关。这意味着你喂给它一张高清建筑施工图,它不需要缩略裁剪,能看清每一个像素。
第二,源码里还设计了一套基于编号寻址的跨窗口接力机制。当剩余可用空间低于 6144 个 Token 时,Codex 不做全文摘要压缩,反而提醒 Terra 先调用 notes 工具,把当前任务进度和关键记录的 window ID 与 item ID 写成结构化数据,接着调用 new_context 开启一个干净的新窗口,再通过 history 工具按编号把旧窗口里的原始内容一字不差地调取出来。这样做的好处是,既能读取高清原图,又能跨窗口无损调取记忆。
恭喜看到这里的你,成功击败 70% 的学习者了。那第三个大招又是什么呢?
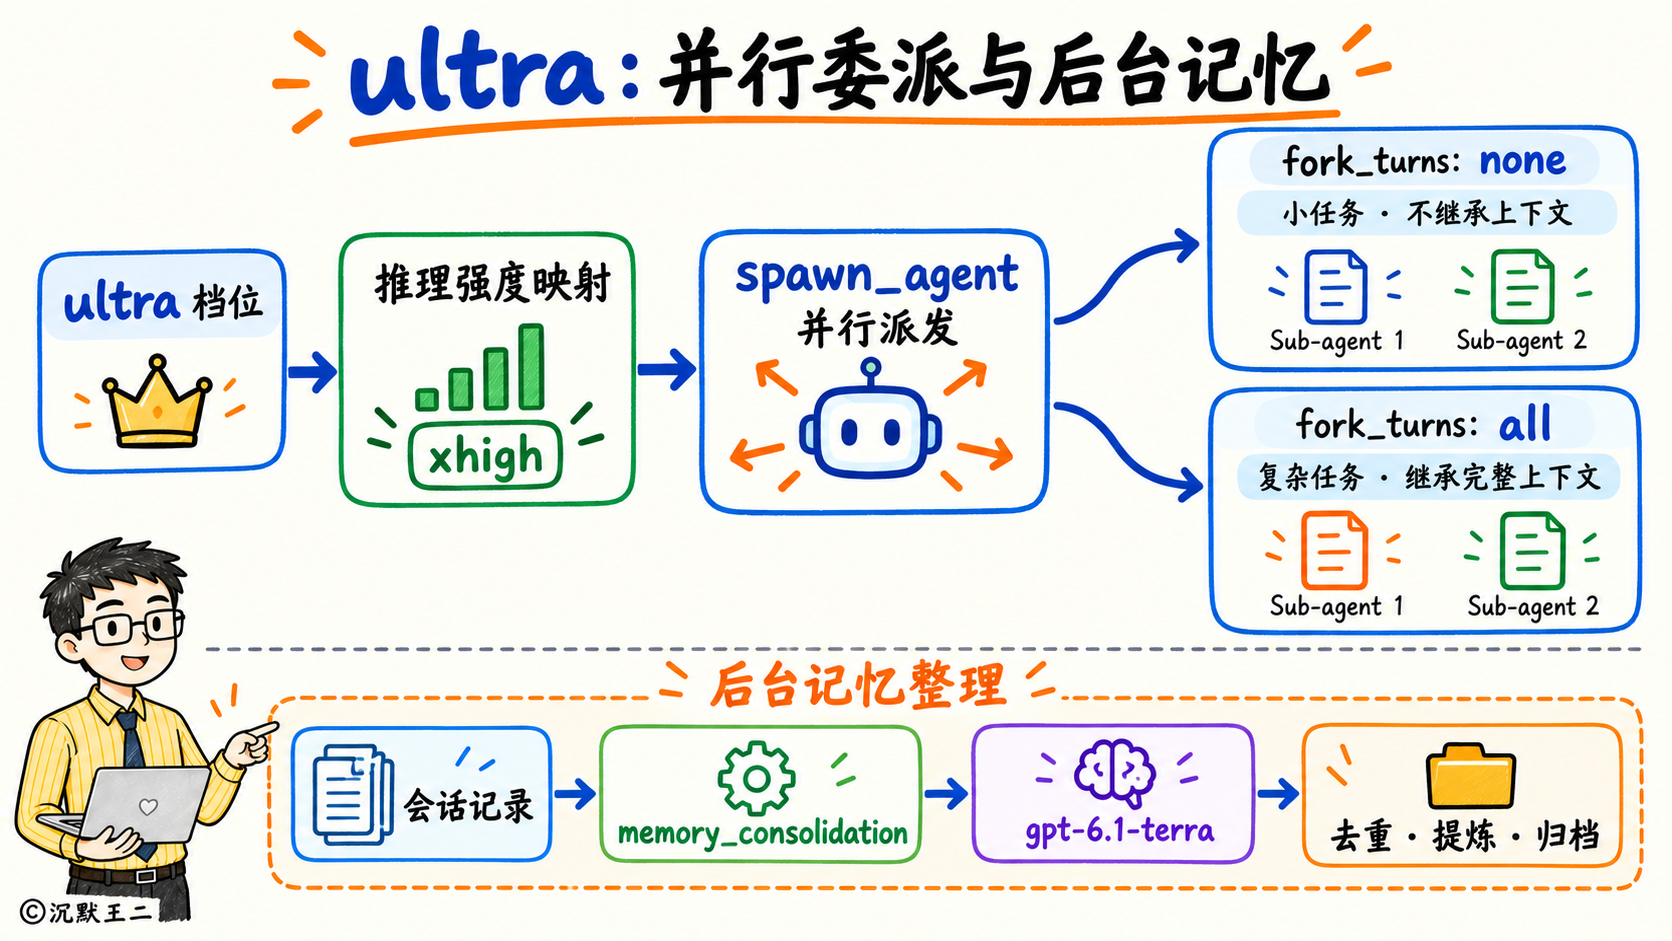
公开 API 的推理强度只有 none 到 max 五档,但在 Codex 内部,OpenAI 给 Astra、Sol 和 Terra 加了一个隐藏的第六档位 ultra,主打最高强度配合自动任务委派。当你在客户端切换到 ultra 档位时,Codex 会把主模型的推理强度映射到 xhigh,同时调用 spawn_agent 派生多个并行的 Sub-agent,并通过 fork_turns 控制上下文继承。如果是修一个小函数,就传入 none 让 Sub-agent 零负担启动;如果是复杂的模块改造,就传入 all 继承完整上下文。
还有,Codex 修改了云端服务模块,把后台负责会话记忆整理的 memory_consolidation 默认模型,从原来的 gpt-6.1-sol 换成了 gpt-6.1-terra。也就是说,背后默默帮你去重、提炼、归档长期记忆的那个总管,现在已经是 Terra 了。
恭喜你升到王者段位了,成功击败 99% 的学习者。
最后简单总结下。
GPT-6.1 Terra 把 V8 沙箱并发执行、50 万原图窗口和低幻觉的 Multi-Agent 委派打包在了一起,在速度和多模态任务上交出了超出预期的答卷。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!