
注意,目前 Kimi Code 已经全量上线 K3.1 Pro。
直接来看 Case。
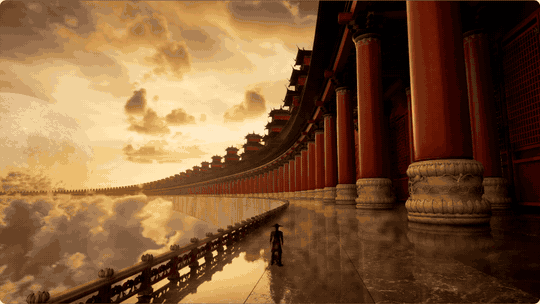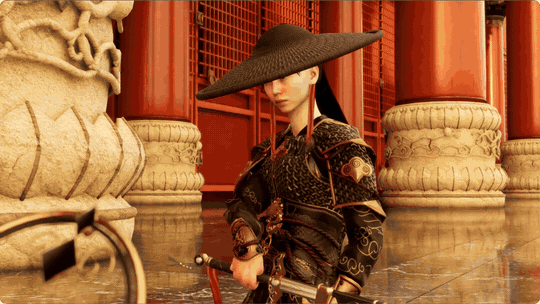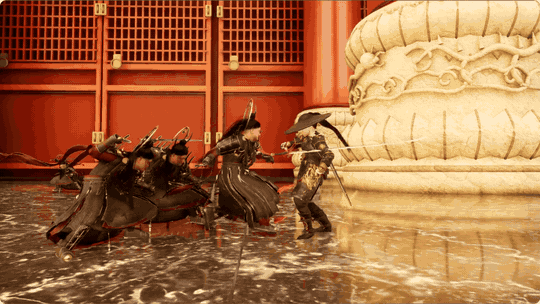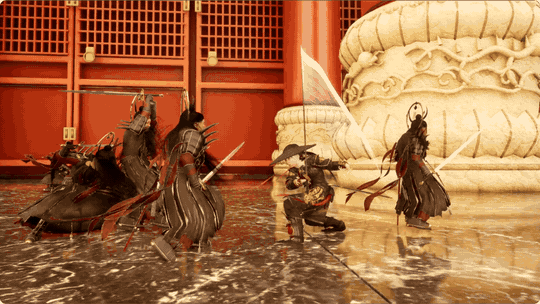
在 Unreal Engine 5.8 里,Kimi 从零搭建了一座东方天宫战斗场景,连盘旋的巨龙和全局光照都配齐了。
在 FreeCAD 里,Kimi 没借助任何外部插件,直接用 Python 脚本拼出了一台包含 2100 个实体的涡扇发动机。
在浏览器里,Kimi 用代码直接生成了包含 2317 个零件和 268 条动态布线路径的 3D 机械臂。
哈喽大家好,我是二哥呀。今天用 3 分钟,给你彻底讲清楚 Kimi K3.1 Pro。视频的原稿以及 363 道 Agent 八股已经整理到开源知识库。
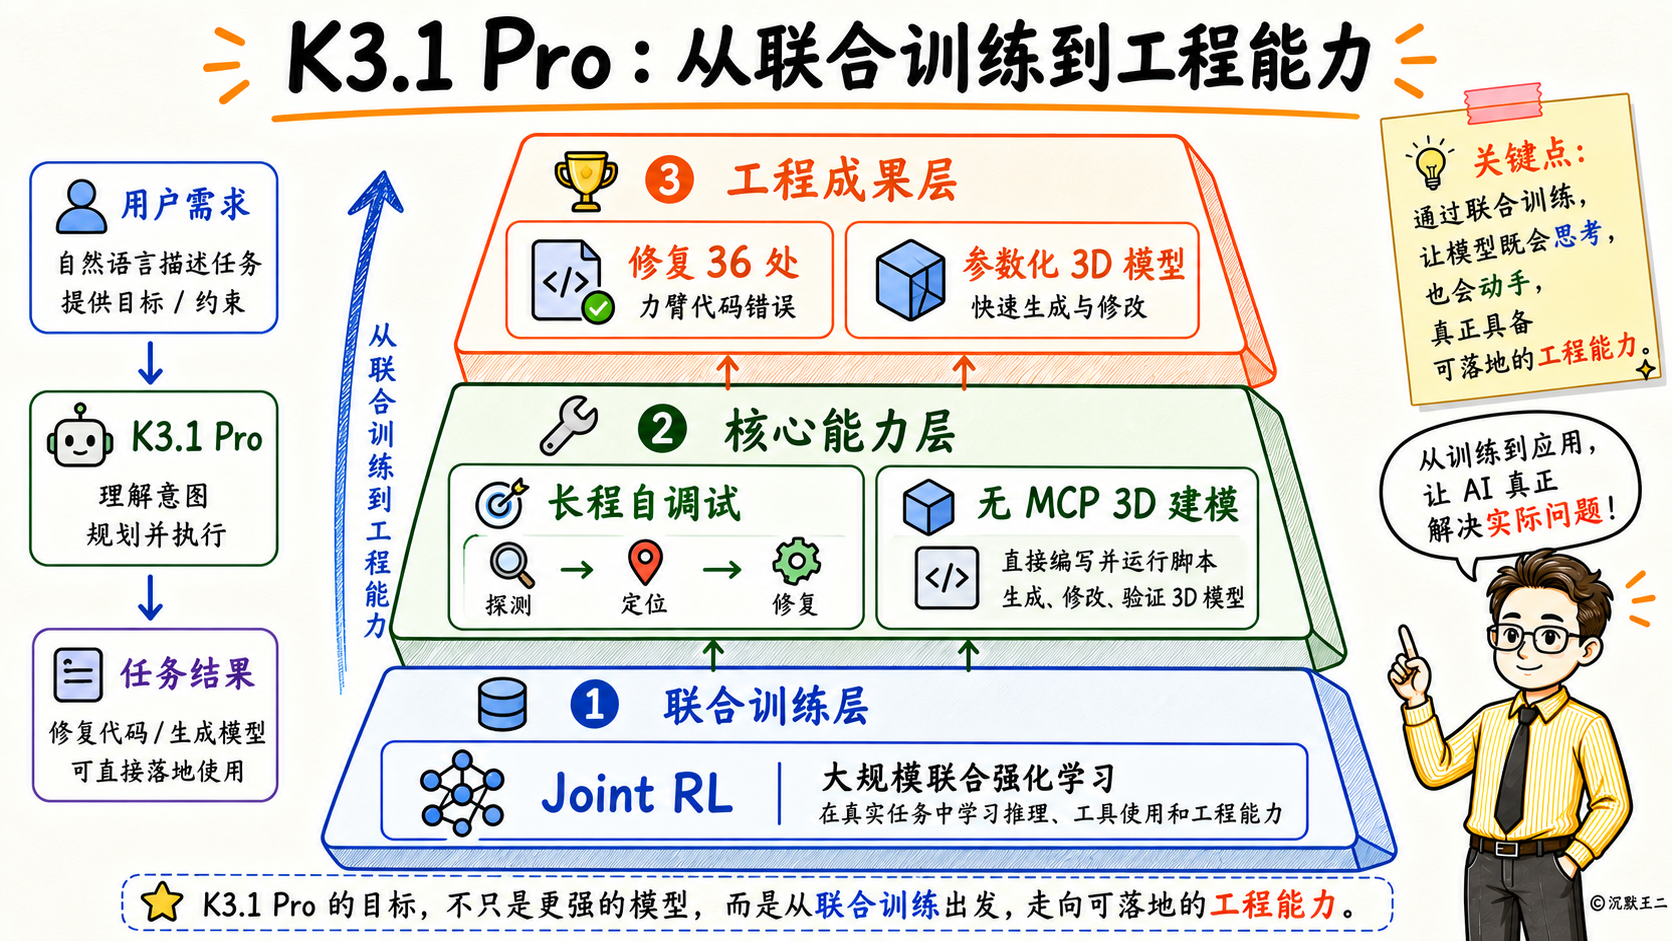
先看最考验长程编码能力的案例。研发团队让 K3.1 Pro 基于一个包含 296 块骨骼和 402 块肌肉的人体解剖模型,从头搭建人体行走动力学仿真器。在跨越 167 个任务和 420 次独立评审的迭代里,模型发现单纯调整奖励函数根本无法改善人体模型的手臂摆动姿态。它没有盲目修改参数,而是主动对仿真器做探测,精准定位并修复了肩部肌肉力臂计算里的 36 处代码错误,最终让人体模型实现了 11.2 秒的连续自然行走。
再看参数化 3D 建模。K3.1 Pro 不需要依赖 MCP 连接器,就能直接根据文字或参考图推导空间几何关系,编写并运行 Blender 的 Python 脚本、Geometry Nodes 节点或 FreeCAD 代码。Kimi 网页端和手机 App 也同步上线了 3D Make 功能,生成的模型可以在线预览和编辑,还能直接导出文件用于 3D 打印。
那为什么底座没变,K3.1 Pro 的工程表现却像换了一个模型?答案是后训练阶段的 Large-scale Joint RL,也就是大规模联合强化学习。月之暗面重构了他们的强化学习训练框架、长上下文推理、沙箱基础设施和采样调度机制,让模型在数百个下游领域同时做强化学习。
来看一下跑分。
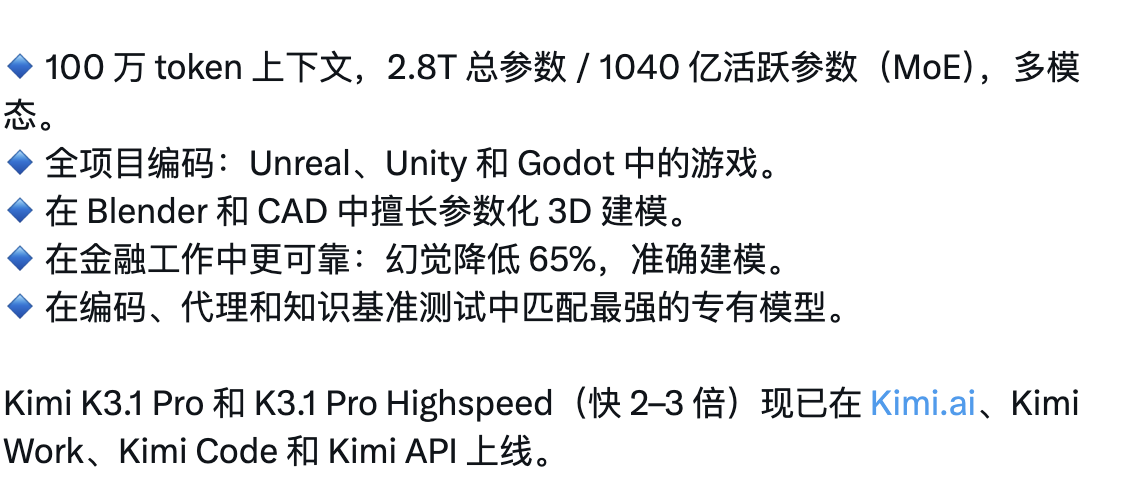
Kimi 专门把真实工作任务和用户标记过事实错误的高难度对话收集起来,构建了内部事实抗压评测集 Kimi Hallu Bench,让专门的事实核查 Agent 一句一句去抠错误。K3.1 Pro 的单条事实幻觉率比上一代 K3 降低了 65%,表现甚至优于 Claude Opus 5.5。
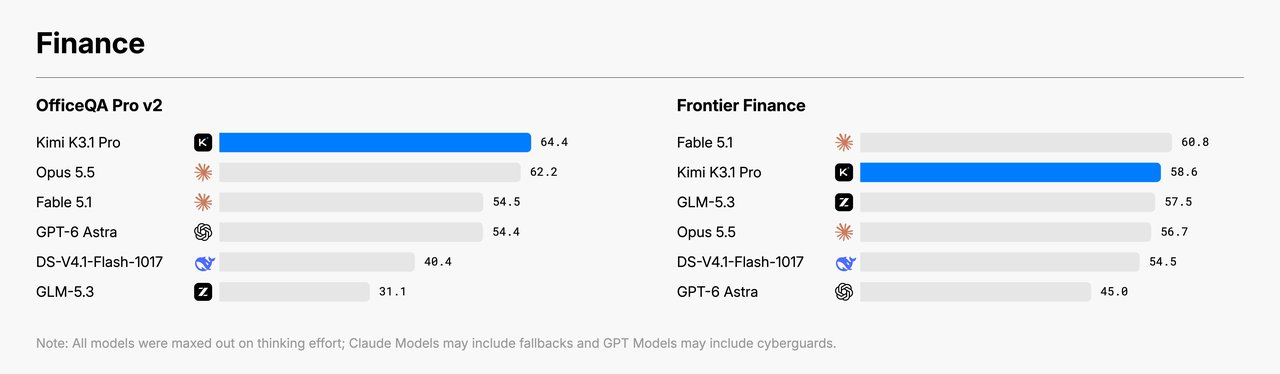
在考察纯图片财报解析的 OfficeQA Pro v2、考察长程软件工程的 SWE Marathon、考察 Agent 综合能力的 Agents' Last Exam 以及带工具的 Humanity's Last Exam 等四项权威榜单上,Kimi K3.1 全部拿下了第一。
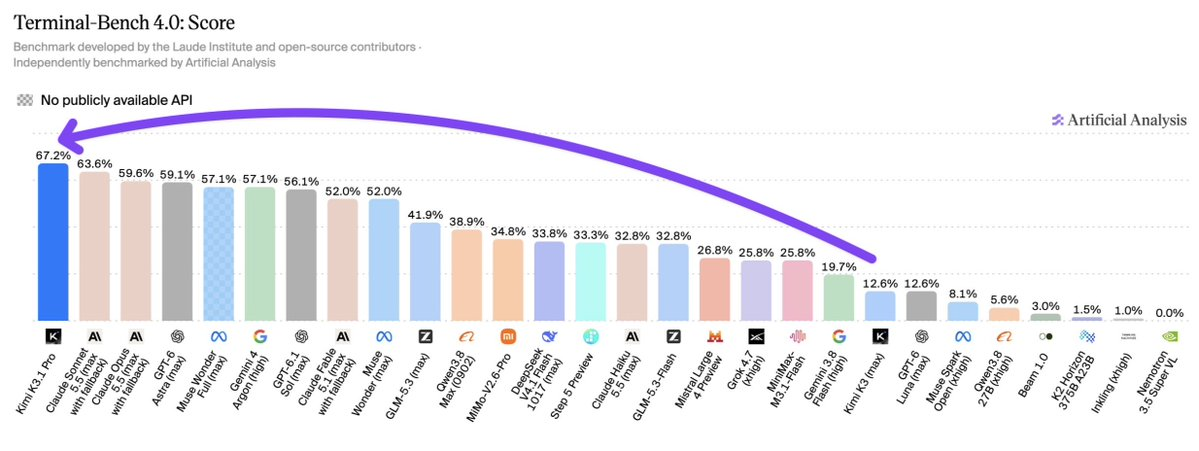
在考察真实终端干活能力的 Terminal-Bench 4.0 上,它的成绩甚至追平了 Claude Opus 5.5,但价格只有 Claude Opus 5.5 的三分之一。
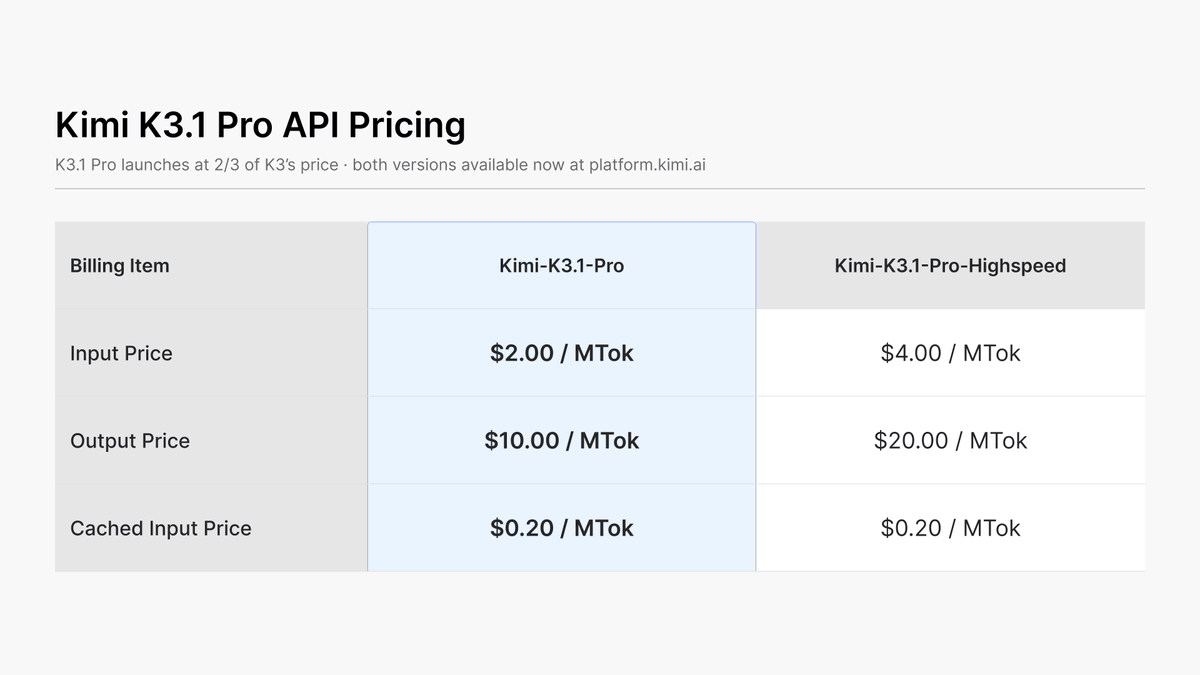
定价方面,这次非常有诚意,直接比上一代 K3 便宜了三分之一。
标准版 kimi-k3.1-pro 的输入价格从每百万 Token 20 元降到了 13 元,输出价格从 100 元降到了 68 元,缓存命中只要 1.3 元。
第三方评测机构 Artificial Analysis 发布的报告显示,标准版的中位输出速度是每秒 77.1 个 Token,综合智能指数拿到 55.1 分,位列全球第四,也是目前得分最高的开放权重模型。
再给聪明的你两个硬核的知识点。
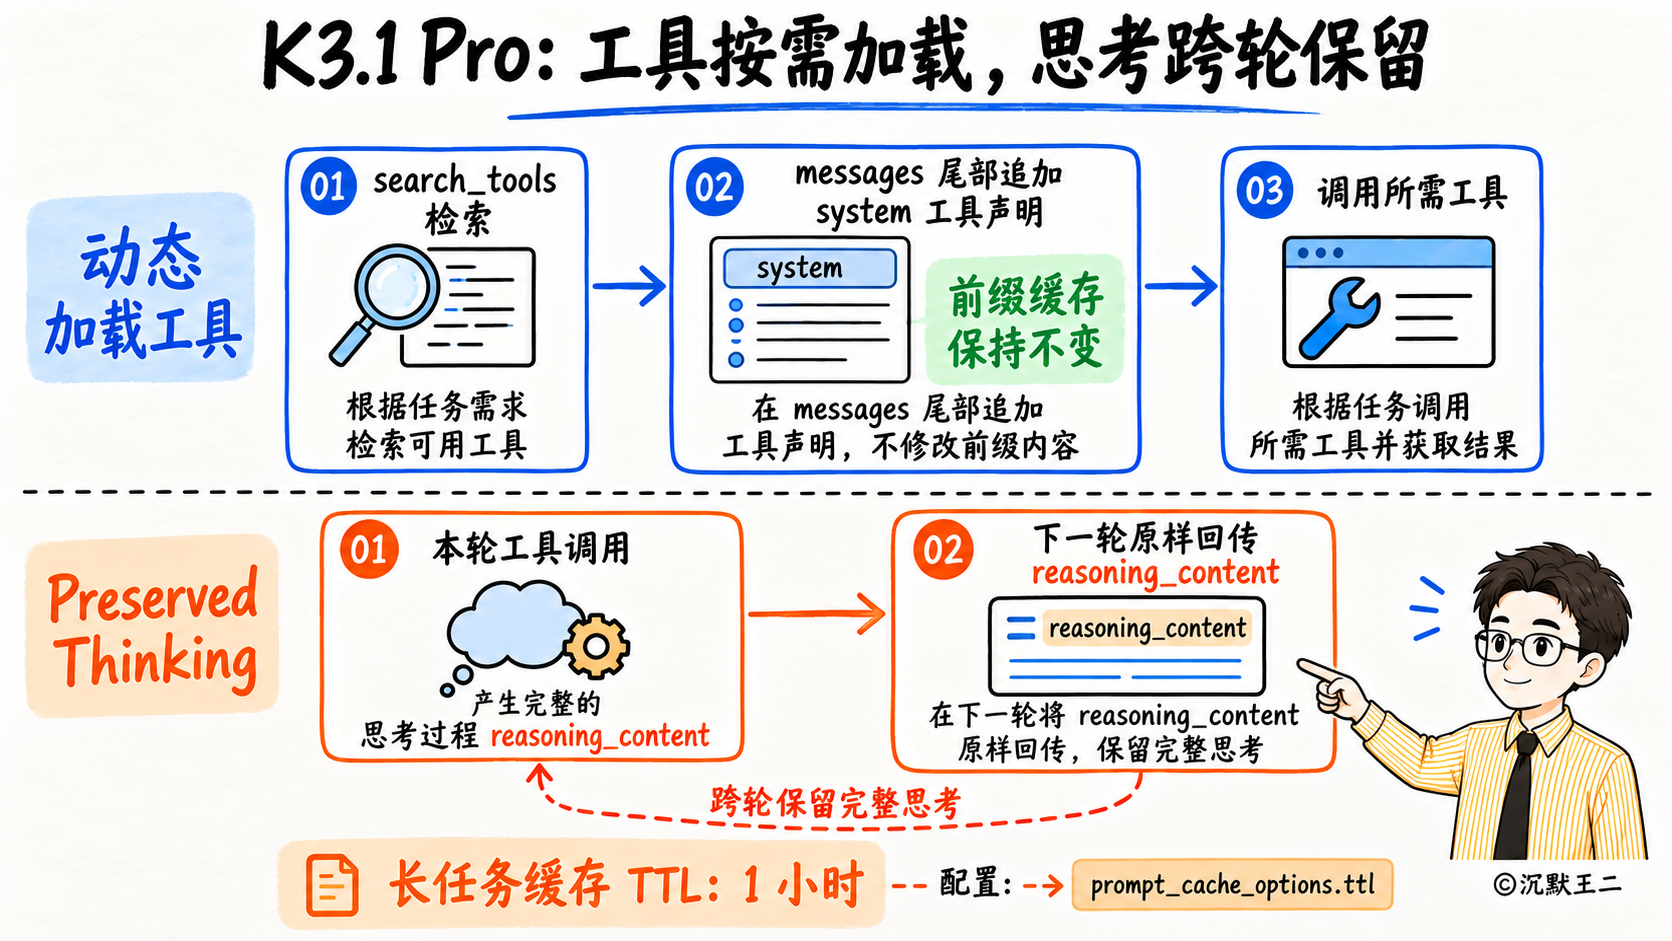
第一个叫 Dynamically Loaded Tools(动态工具加载)。开发 Agent 时,如果把上百个工具一次性全塞进 tools 字段里,不仅每轮要白白消耗几万个 Token,候选一多,模型还容易选错。可如果每轮按需修改 tools 列表,会导致 Prefix Caching 失效。
K3.1 Pro 给出了一个非常巧妙的工程解法。在请求顶层只放一个 search_tools 检索工具,首轮把 tool_choice 设为 required 强制模型先搜索需要什么工具;等拿到检索结果后,直接往对话历史 messages 的末尾追加一条带 tools 字段的 system 消息,把刚查到的工具定义塞进去。因为工具定义是追加在 messages 尾部的,所以前缀缓存不会失效。
第二个是 Preserved Thinking(保留式思考)。传统推理模型在多轮工具调用时,往往会在下一轮丢掉上一轮的思考过程 reasoning_content,只保留最终回复,几十步之后模型就很容易忘记最初的排查思路。K3.1 Pro 强制开启了保留式思考,要求每一轮工具调用都把上一轮完整的 reasoning_content 原样传回给模型。
同时,K3.1 Pro 把自动前缀缓存设置成了两档 TTL,默认是 5 分钟。跑长程任务时,可以把 prompt_cache_options.ttl 设成 1 个小时,这样做的好处是,哪怕沙箱渲染等了二十分钟,下一轮请求依然能直接命中缓存。
最后简单总结下。
Kimi K3.1 Pro 解决的是用大规模联合强化学习把全项目编程、参数化 3D 建模和低幻觉金融分析真正落到生产环境里。
另外给你一条实用建议,如果你在用 Kimi API 开发多轮工具调用的 Agent,一定记得在会话开始前把 reasoning_effort 思考档位固定下来,不要在对话中途切换档位,同时不要在请求里修改 temperature 参数,这样不仅可以避免接口报错,还能稳稳吃满前缀缓存折扣。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!