
官方在介绍里用了一句古文,叫「为善与众行之,为巧与众能之」。观众老爷给的评价是,这才是真正的 OpenAI,就像村民免费向你分享了核聚变技术一样。
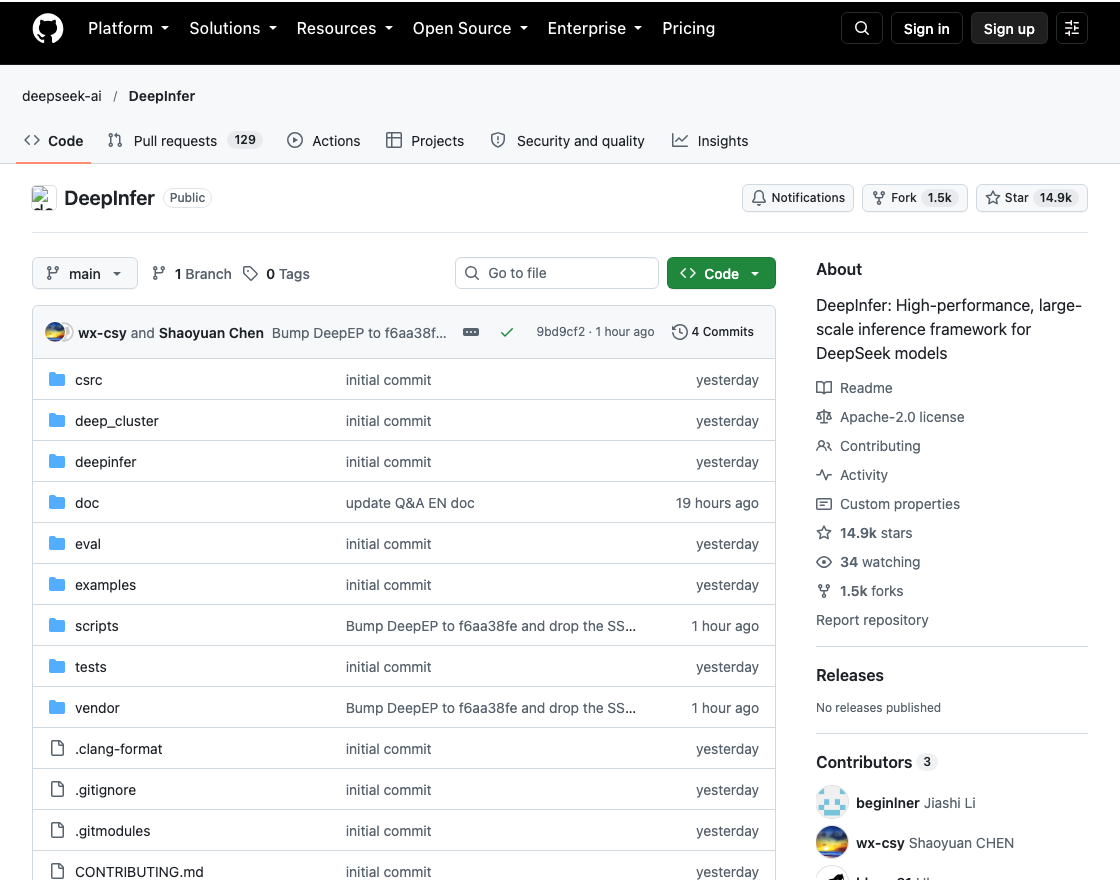
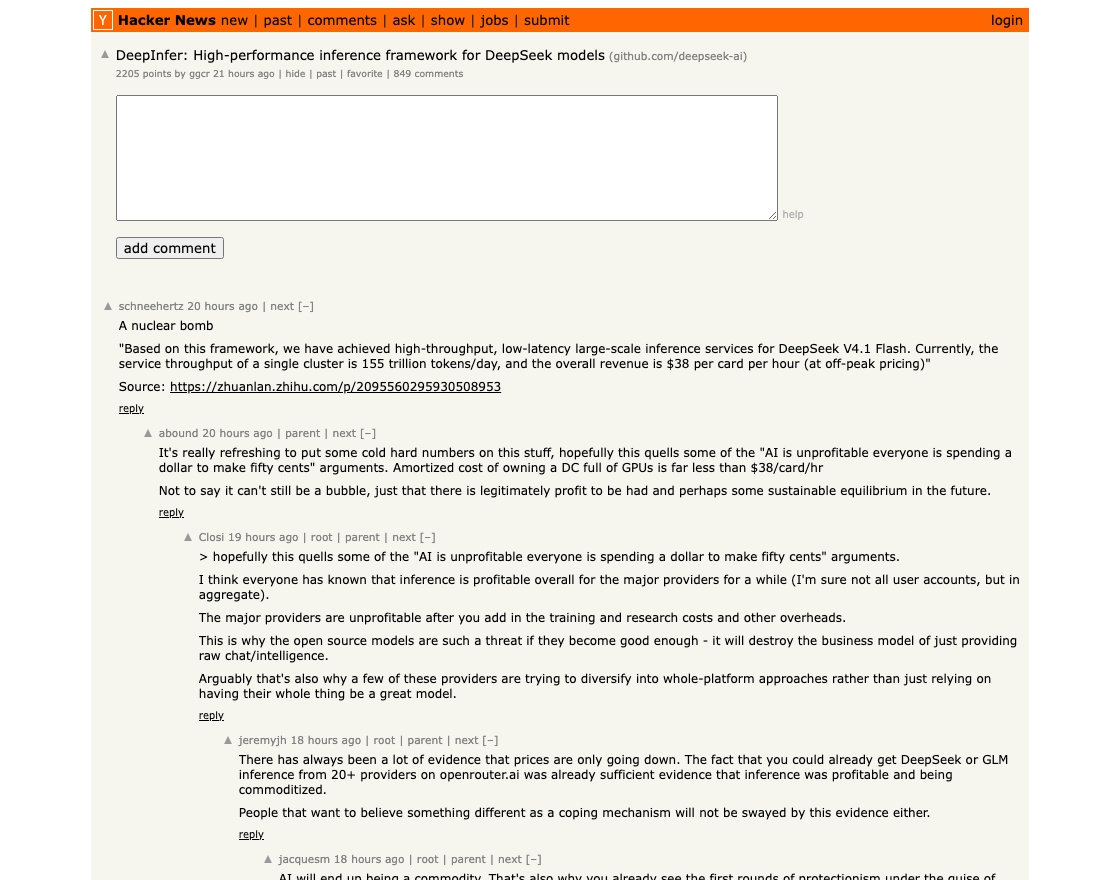
截图来源:DeepInfer 官方仓库、Hacker News 社区讨论;星标与评论数为截图时状态。
为什么一个推理框架的开源,能让观众老爷发出这样的感慨?
看看《DeepSeek V4.1 Flash 大规模推理部署实践》报告里的真实运行数据就明白了。基于这套 DeepInfer 框架,DeepSeek V4.1 Flash 单集群每天的吞吐量高达 155 万亿 Tokens,而且把 KV Cache 的保留时间拉长到了 72 个小时以上。开源不到 24 小时,DeepInfer 的 GitHub 仓库就已经突破了 1.46 万颗星标。
我翻了 DeepInfer 和 deepseek-recipe 两个 GitHub 仓库的源码与文档,可以自信地、大方地、光明磊落地帮你搞清楚这三件事。
- DeepInfer 和 deepseek-recipe 到底是什么?
- DeepInfer 凭什么这么快?
- 做大模型部署或者 Agent 开发的我们,能获取到什么红利?
哈喽大家好,我是二哥呀。今天用 3 分钟,给你彻底讲透 DeepSeek 最新开源的内部推理框架 DeepInfer。
先说第一件事。
训练决定大模型的能力上限,推理框架决定这些能力能不能以合理的成本服务海量用户。以前厂商开源模型通常只给权重文件,虽然 DeepSeek 之前就开源过 FlashMLA(多头潜在注意力算子)、DeepGEMM(矩阵乘法算子)、DeepEP(专家并行通信库)和 TileLang 编译工具,但这些都是底层零件,企业想要部署的话还得靠 vLLM 或 SGLang 去拼装。
这次开源的 DeepInfer,是 DeepSeek 基于 vLLM 演进、同时吸收 SGLang 和 TensorRT-LLM 思路打造的生产级推理引擎,原生兼容英伟达 SM100 架构的 GPU 与华为昇腾 950 NPU 两大硬件平台。
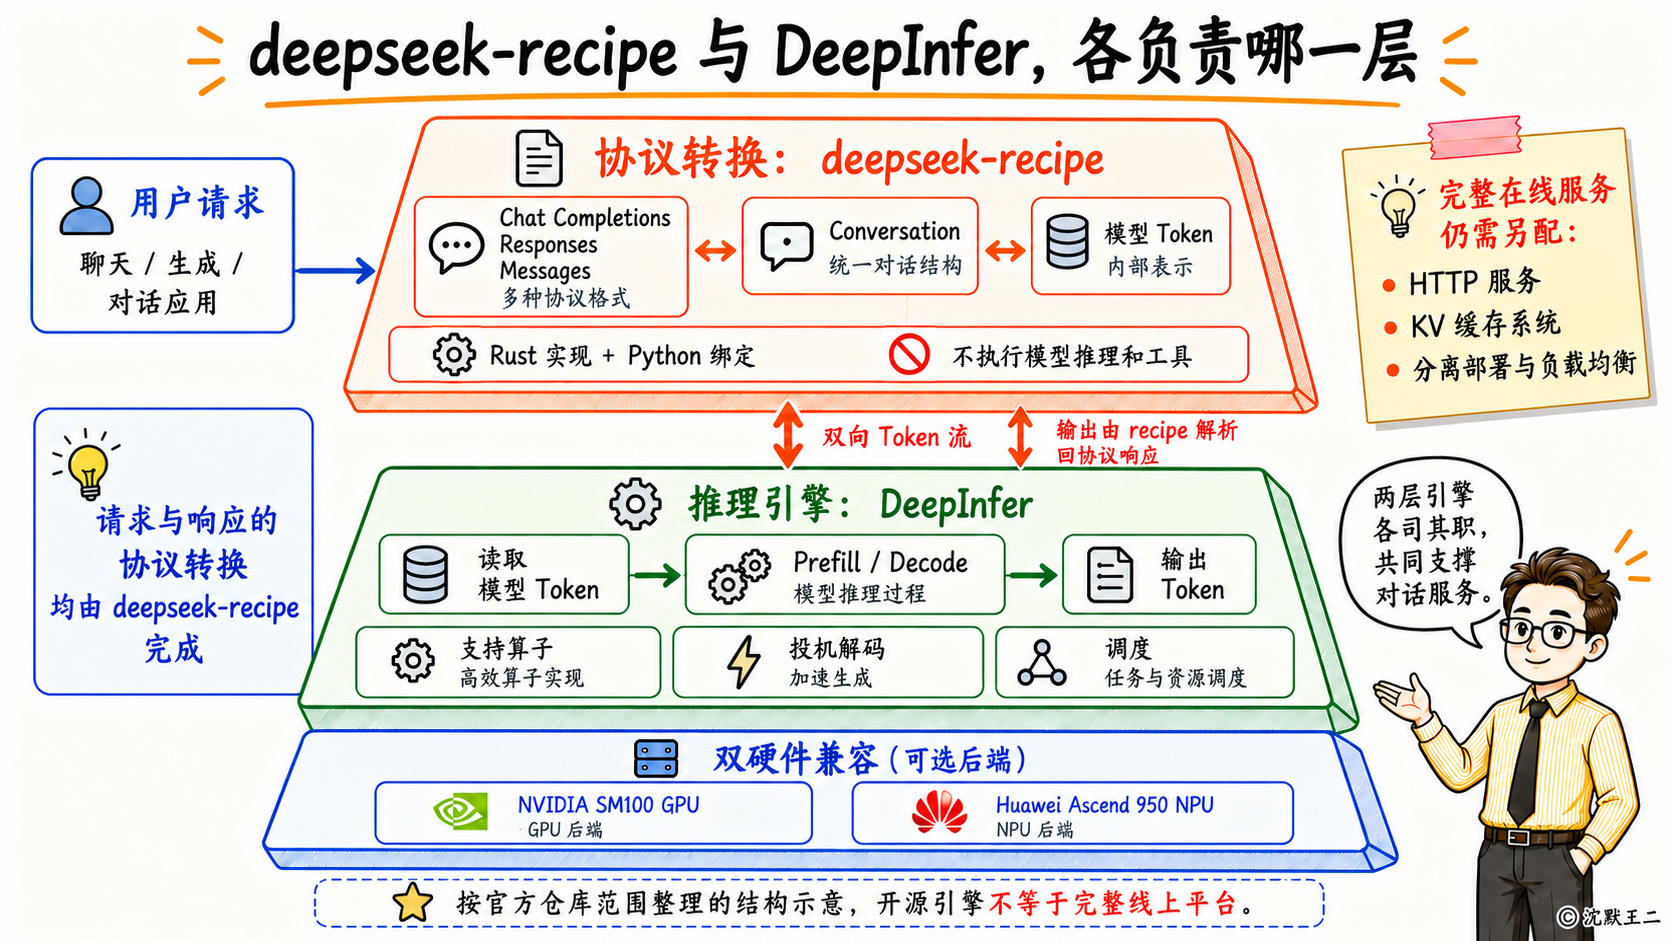
同时开源的还有采用 Rust 编写的编解码组件 deepseek-recipe。很多团队部署私有化模型时可能都踩过这个坑,明明权重一模一样,自己搭建的服务在深度思考或工具调用时就是不如官方的 API 稳定,病根就在于协议转换与分词处理。
deepseek-recipe 把 Chat Completions API、Responses API 和 Messages API 统一转换成了标准的对话格式,并用特殊的 Token 边界匹配解决了两大难题。一个是提示词注入,用户输入或工具结果里夹带的 <|User|> 或 </think> 会被直接编码成普通 Token,防止恶意文本篡改思考边界。第二个是分段并行分词,沿着特殊 Token 划定的边界多线程并行编码各段文本,大幅降低了长上下文的分词耗时。输出端则用基于 KMP 算法的状态机做跨数据块(Chunk)的流式解析,工具名解析完就立刻返回,参数生成时再逐段输出 JSON 片段,省去了反复构造完整对象的开销。
以前开源给你的是发动机图纸和散装零件,这次 DeepSeek 直接把每天吞吐 155 万亿 Tokens 的整车生产线交到了你手里。
那聪明的你肯定想到了,DeepInfer 凭什么这么猛?
从官方发布的 V4.1 Flash 部署报告来看,核心主要靠四项硬核的工程设计。
第一个是三阶段的分离部署。视觉编码器(Vision Encoder)放在了最便宜的单卡上运行;计算密集型的 Prefill 放在了常见的 8 卡机器上做小规模专家并行;显存带宽和通信密集型的 Decode 则放在了 64 到 128 卡的超节点上做大规模专家并行(Wide-EP),配合预留冗余专家副本的动态负载均衡器(EPLB),把跨卡空转的损耗压到了最低。
第二个是 100 PiB 的独立分布式存储加 SWA Bounded Replay(滑动窗口注意力有界重放)。DeepSeek 用自研的 3FS 分布式文件系统搭建了约 100 PiB 的 SSD 存储集群,峰值聚合读取带宽达到了 10 TiB/s,把按 128 个 Token 分页的块缓存全部写入硬盘,让 KV Cache 保留时间达到了 72 个小时。
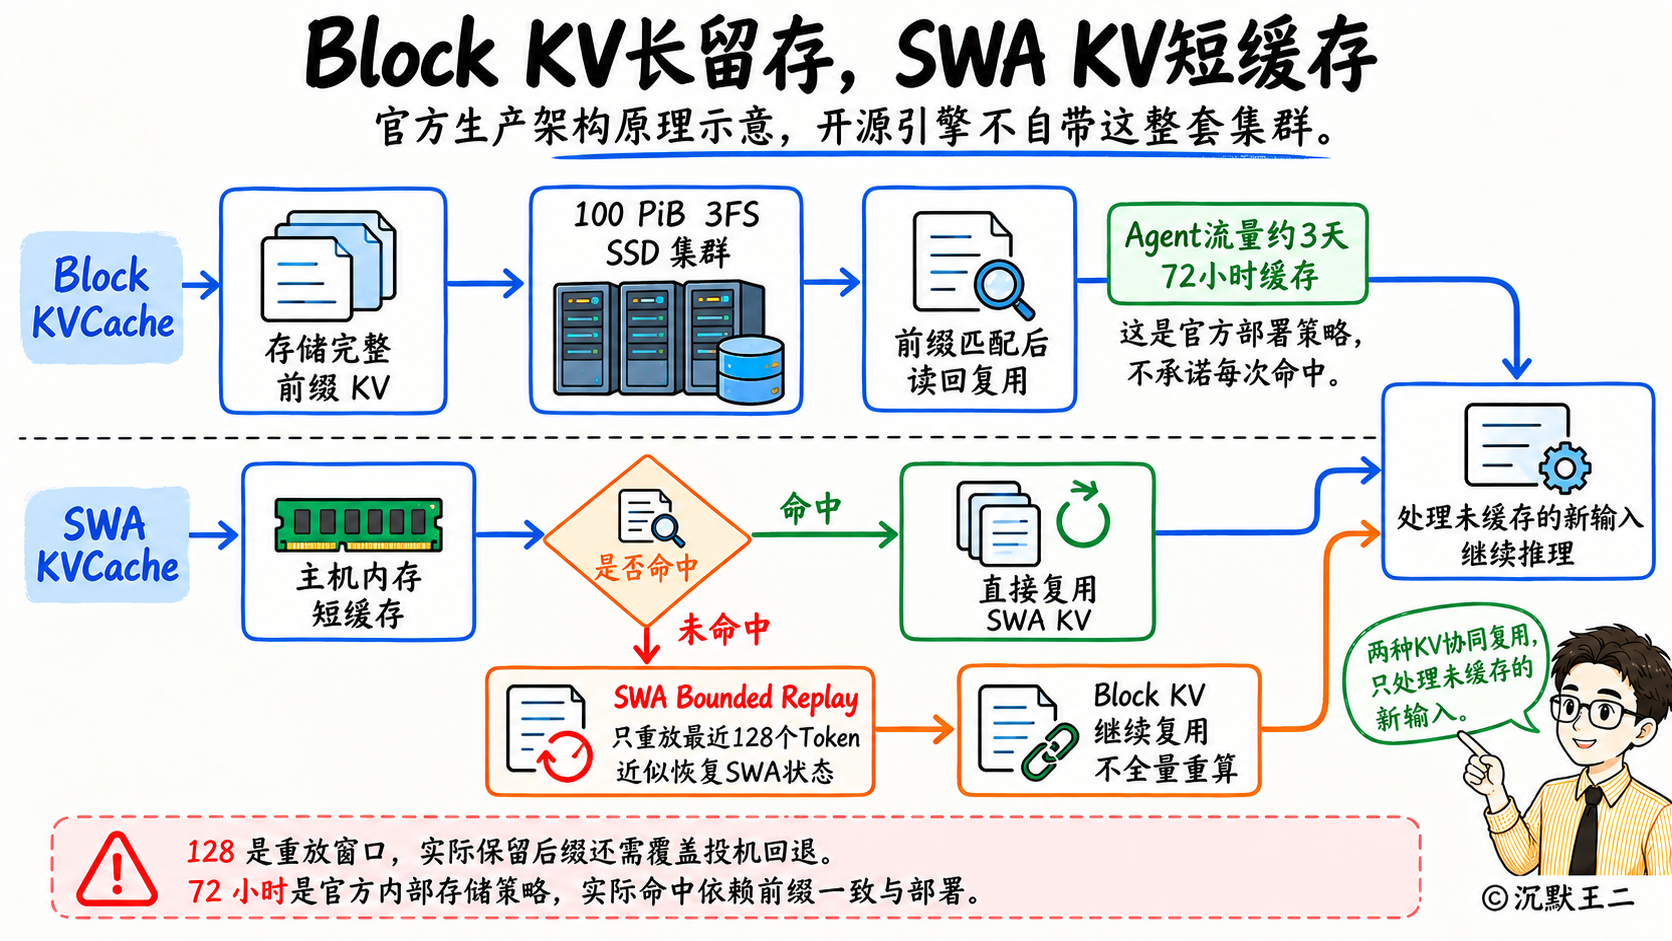
针对只在活跃会话里有效的滑动窗口缓存(SWA KVCache),写硬盘会占掉近一半容量,全量重算代价又太高。DeepInfer 选择只把它留在机器内存里保存约 180 秒,这样做的好处是,线上命中率超过 98%。一旦未命中就启用 SWA Bounded Replay,只截断重算的最近 128 个 Token,把重算代价变成与上下文长度和层数无关的常数,让预填充在解码层的总计算量减少了近一半。
第三个是 DSpark 置信度投机解码。它通过置信度预测头(Confidence Head)预测每个草稿 Token 的接受概率,只把验证算力分给收益最高的前缀子集,相比固定验证 5 个 Token,线上吞吐量直接提升了 6%。
第四个是零开销的异步批调度(Asynchronous Scheduling)。当 GPU 执行第 N 步的前向计算和采样时,CPU 已经在并行执行第 N 加 1 步的批次调度和第 N 减 1 步的后处理,实现 GPU 全程零空闲。
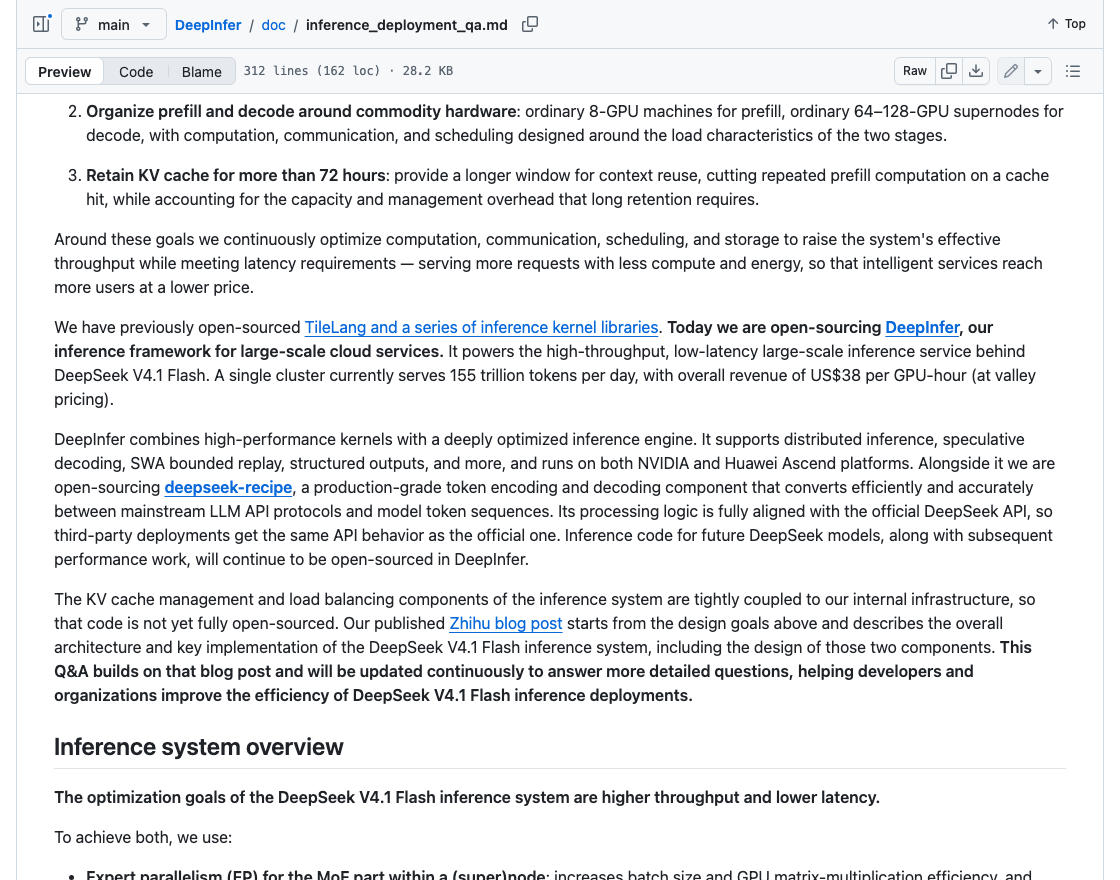
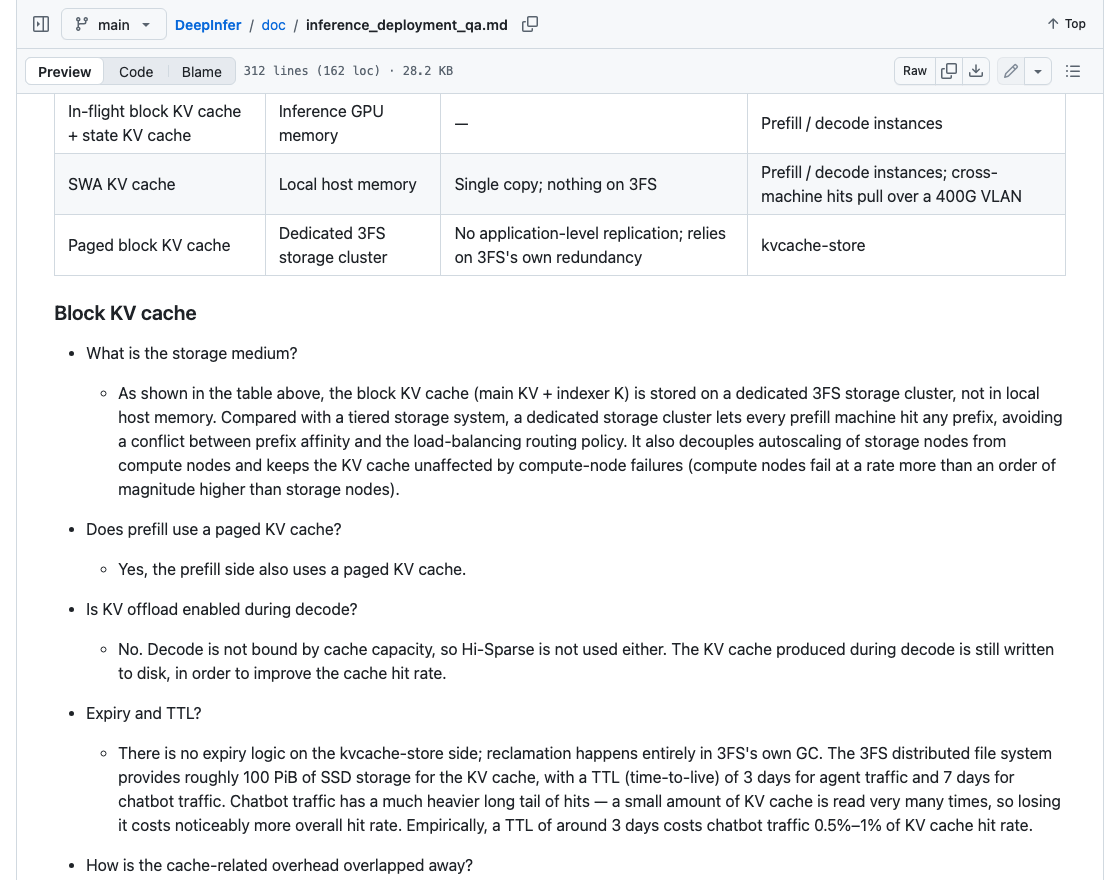
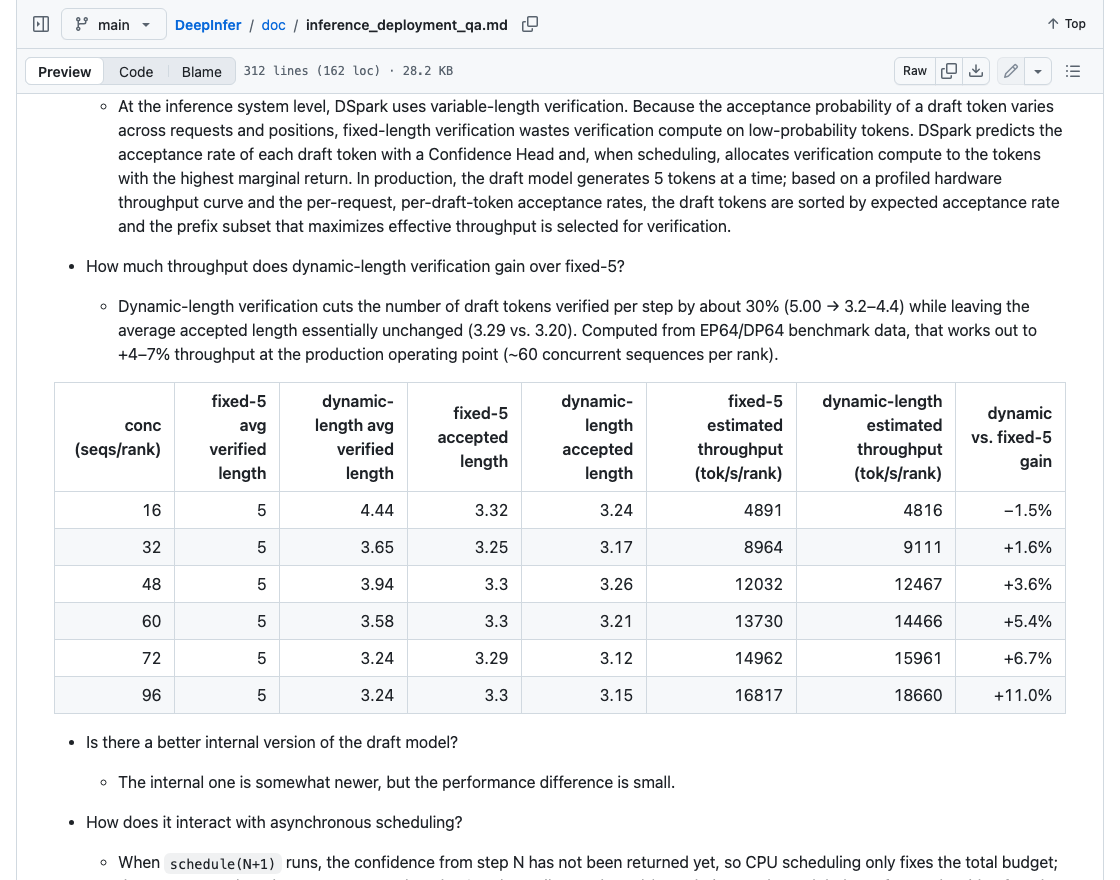
截图来源:官方部署 Q&A。38 美元为每 GPU·小时收入;DSpark 在文中生产并发点的吞吐收益约为 4%–7%,具体随并发变化。
那聪明的你肯定又要问了,这次开源对我们到底意味着什么?
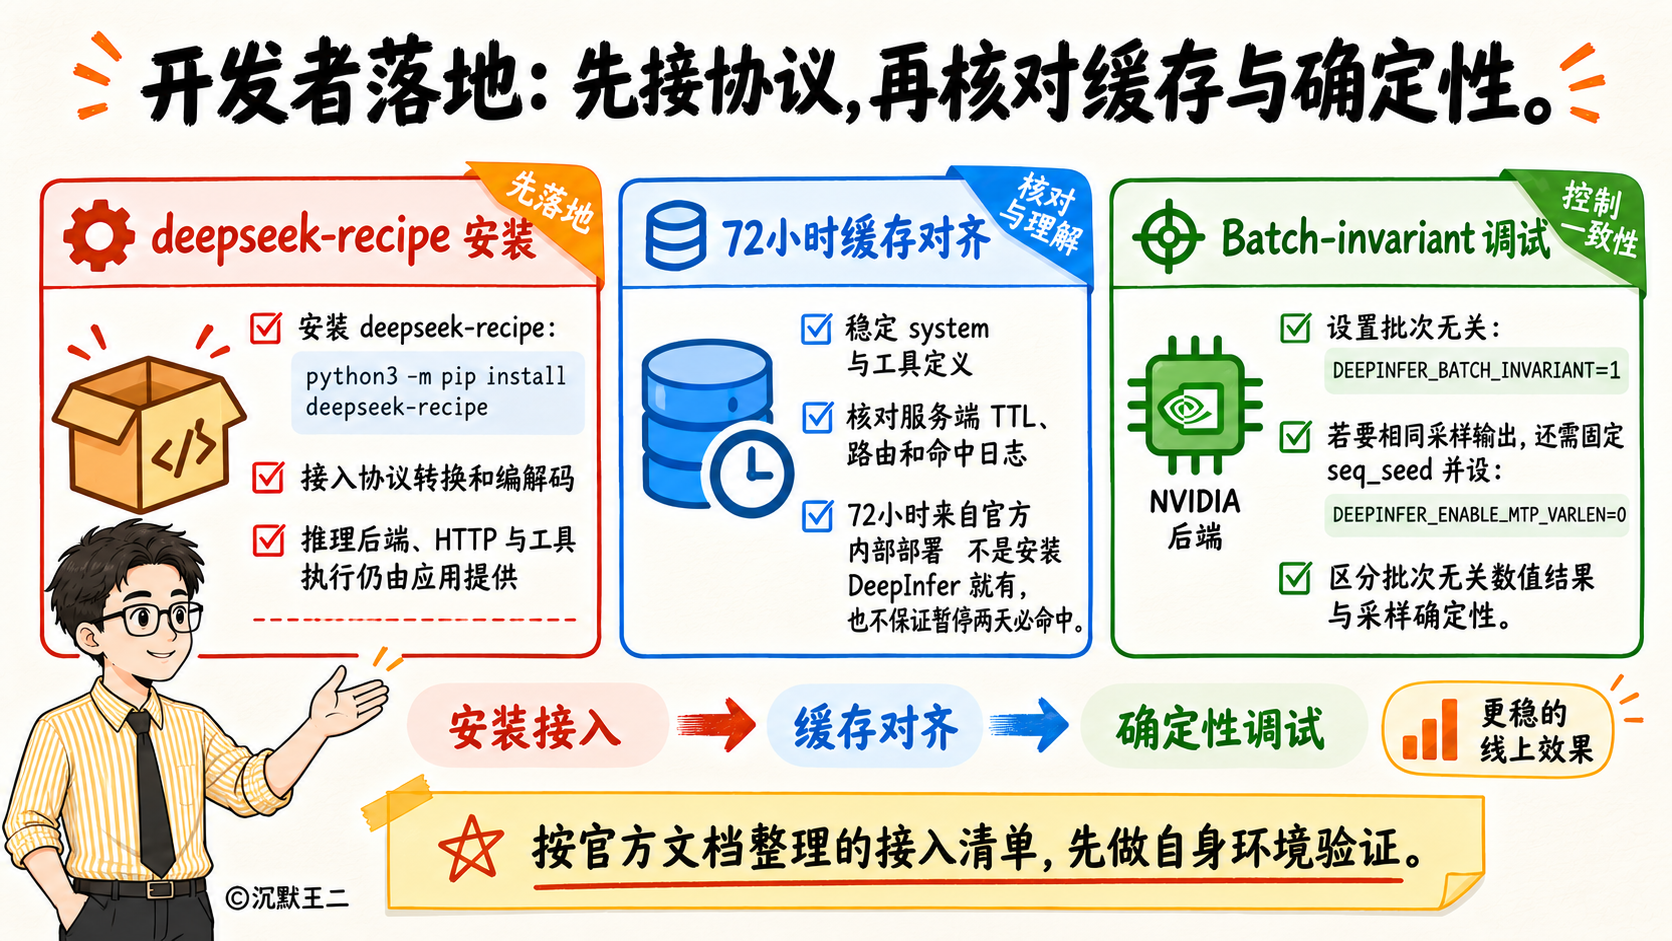
第一,自建模型网关时可以直接安装 deepseek-recipe,一步到位接管多协议转换、特殊字符注入和流式工具调用解析。第二,既然官方把 KV Cache 在硬盘里保留了 72 小时,设计需要人工审批或跨天恢复的 Agent 时,只要固定好开头的系统提示词和工具定义,暂停两天依然能命中服务端缓存。第三,开启 DEEPINFER_BATCH_INVARIANT=1 批次无关确定性推理后,不论并发批次怎么变,相同输入永远产出相同的结果,对线上复现与评测是极大的便利。
最后简单总结下。
模型权重决定了 AI 智商的上限,而 DeepInfer 和 deepseek-recipe 这类推理基础设施,决定了顶尖智能能不能以人人用得起的价格走进千行百业。
另外给你一条实用建议。今天就可以把 deepseek-recipe 仓库克隆下来,运行它自带的编码解码去可视化网页,再去读一读它用 KMP 状态机做跨数据块流式工具参数解析的源码,这会让你的工程能力直接上一个台阶。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!