
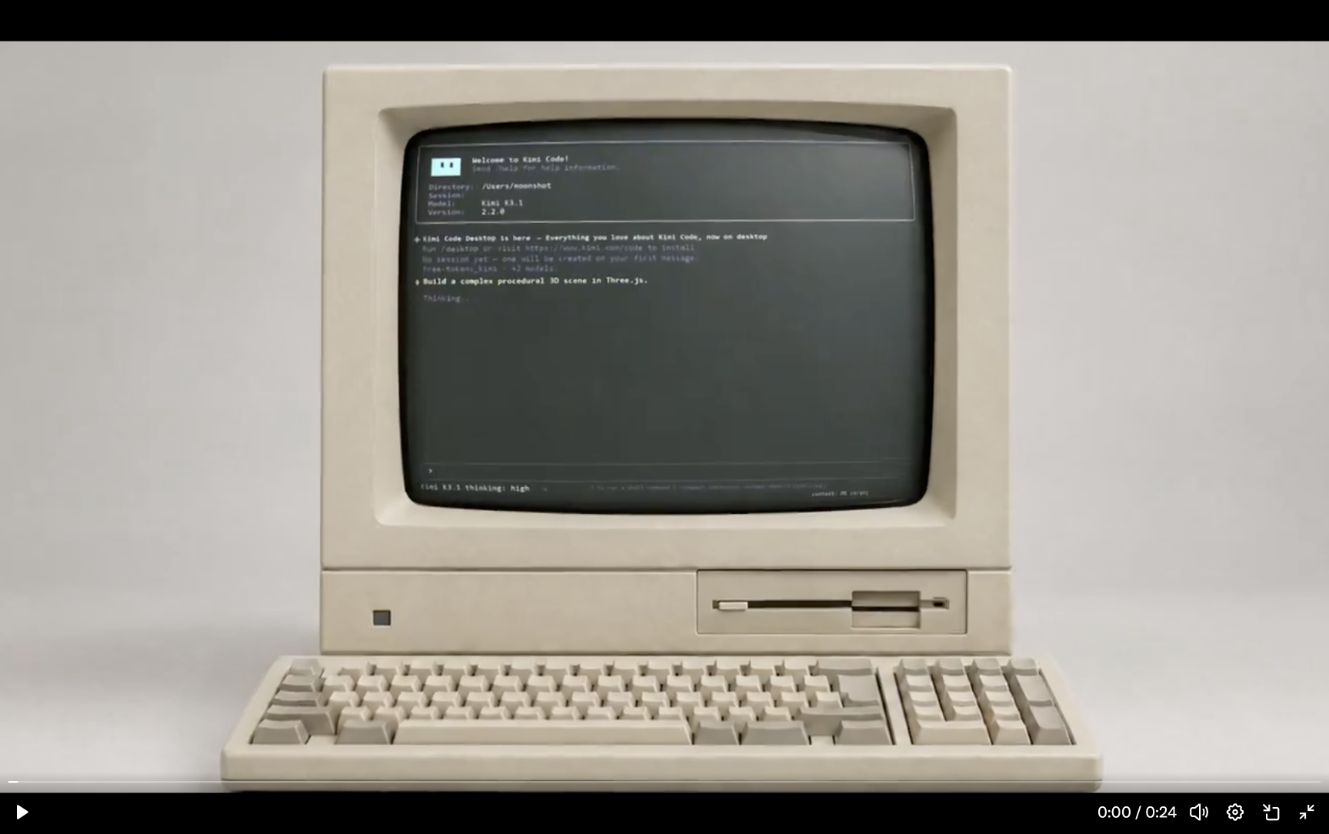
24 秒,一台复古电脑,屏幕里是 Kimi Code 的终端,模型一栏写着 Kimi K3.1,正在用 Three.js 写一个 3D 场景。
经历了 10 月份的短暂平静后,国产大模型终于要迎来新一轮的大爆发了。听说 GLM、Qwen 也要更新大版本,让我们拭目以待吧。
有意思的是,早在预告片发布的前一天,大模型竞技场 LMArena 上就冒出了一个匿名模型,名叫 Kibitz。你问它是谁,它直接说自己是 Kimi。
一个没发布的模型,网友是怎么提前认出来的?K3.1 相比 K3 到底改了什么?
我翻了 Kimi 官方的预告、K3 的技术报告、SGLang 的代码提交记录以及 Arena 官方的 FAQ,可以帮你把这件事的来龙去脉讲清楚。视频的原稿以及 371 道 Agent 八股已经整理到开源知识库。
哈喽大家好,我是二哥呀。今天用 3 分钟,给你讲清楚 Kimi K3.1 到底透露了什么。
先说第一件事,Kimi K3.1 有没有升级底层架构?
截至 10 月 23 日下午,官方还没有正式公布 K3.1 的详细跑分和定价。但模型代号既然叫 3.1 而不是 K4,说明它仍然是基于 K3 底座的。
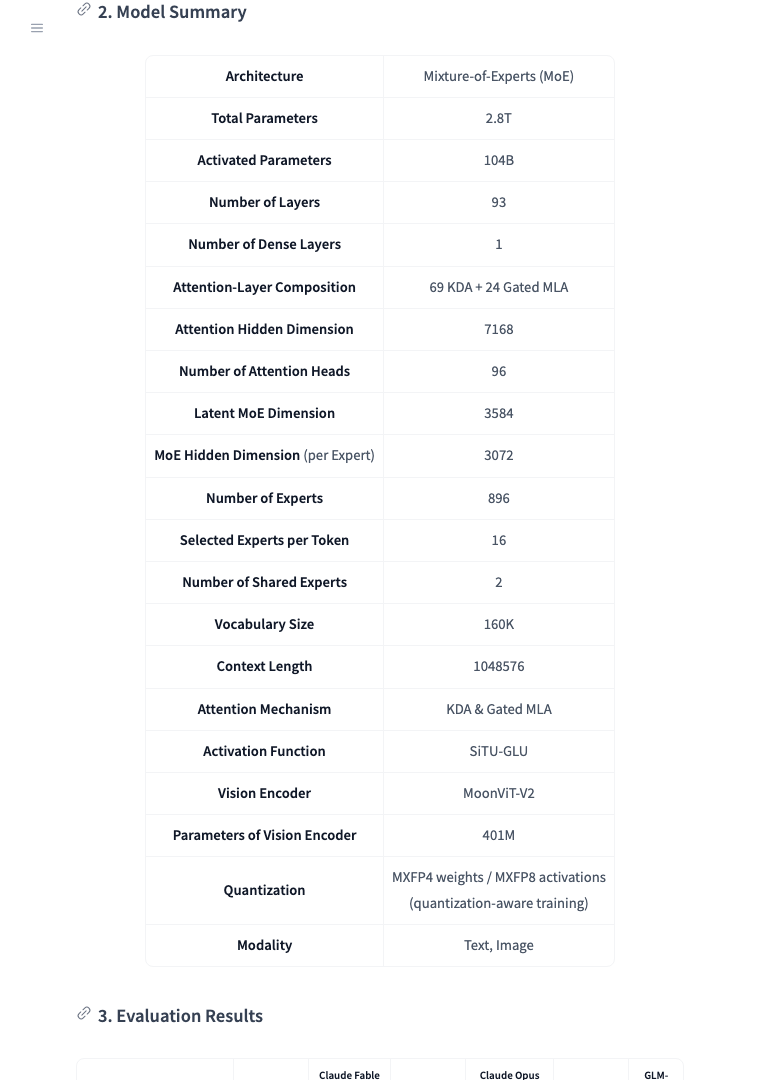
那 K3 是什么水平呢?总参数 2.8T,是全球第一个开源的 3T 级模型,支持 100 万 Token 上下文和原生多模态。它采用 MoE(混合专家)架构,每个 Token 从 896 个路由专家里只激活 16 个,激活参数 104B。
传统的全注意力模型跑 100 万上下文,显存占用会呈现出平方级指数的暴涨。K3 把 KDA(Kimi Delta Attention,线性注意力)和 Gated MLA(门控多头潜在注意力)按 3 比 1 的比例交替,每 4 层里用 3 层线性注意力把 KV Cache 显存占用砍掉了 75%,只留 1 层做全局精准检索。靠这套架构,K3 在 Terminal-Bench 2.1 上拿到了 88.3 的高分。
那聪明的你肯定要问,K3.1 升级了什么新东西啊?
虽然官方没发公告,但网友已经在主流开源推理框架 SGLang 的代码提交记录里,抓到了 Kimi-K3.1 的适配代码。代码显示,K3.1 在推理思考档位里,除了原有的 low、high、max 之外,新增了一个 medium 档位。
那聪明的你肯定想到了,厂商为什么要先把模型放到 Arena 上?
Arena 官方的规则是,厂商可以把未发布的模型用匿名代号放上去测试,用户在对战模式里看不到名字,投完票才揭晓。等积累够真实的对战数据后,平台会把结果私下发给厂商,再下架模型。
所以对厂商来说,Arena 就是一场真实用户的盲测。没有品牌光环,只看谁的能力更强。
那 Kibitz 是怎么被认出来是 Kimi K3.1 的?
第一条线索是自报家门。10 月 22 日,博主 AiBattle 发帖说 Kibitz 在对战中自称是 Kimi,而且在 Code Arena(代码竞技场)里出现得极其频繁。
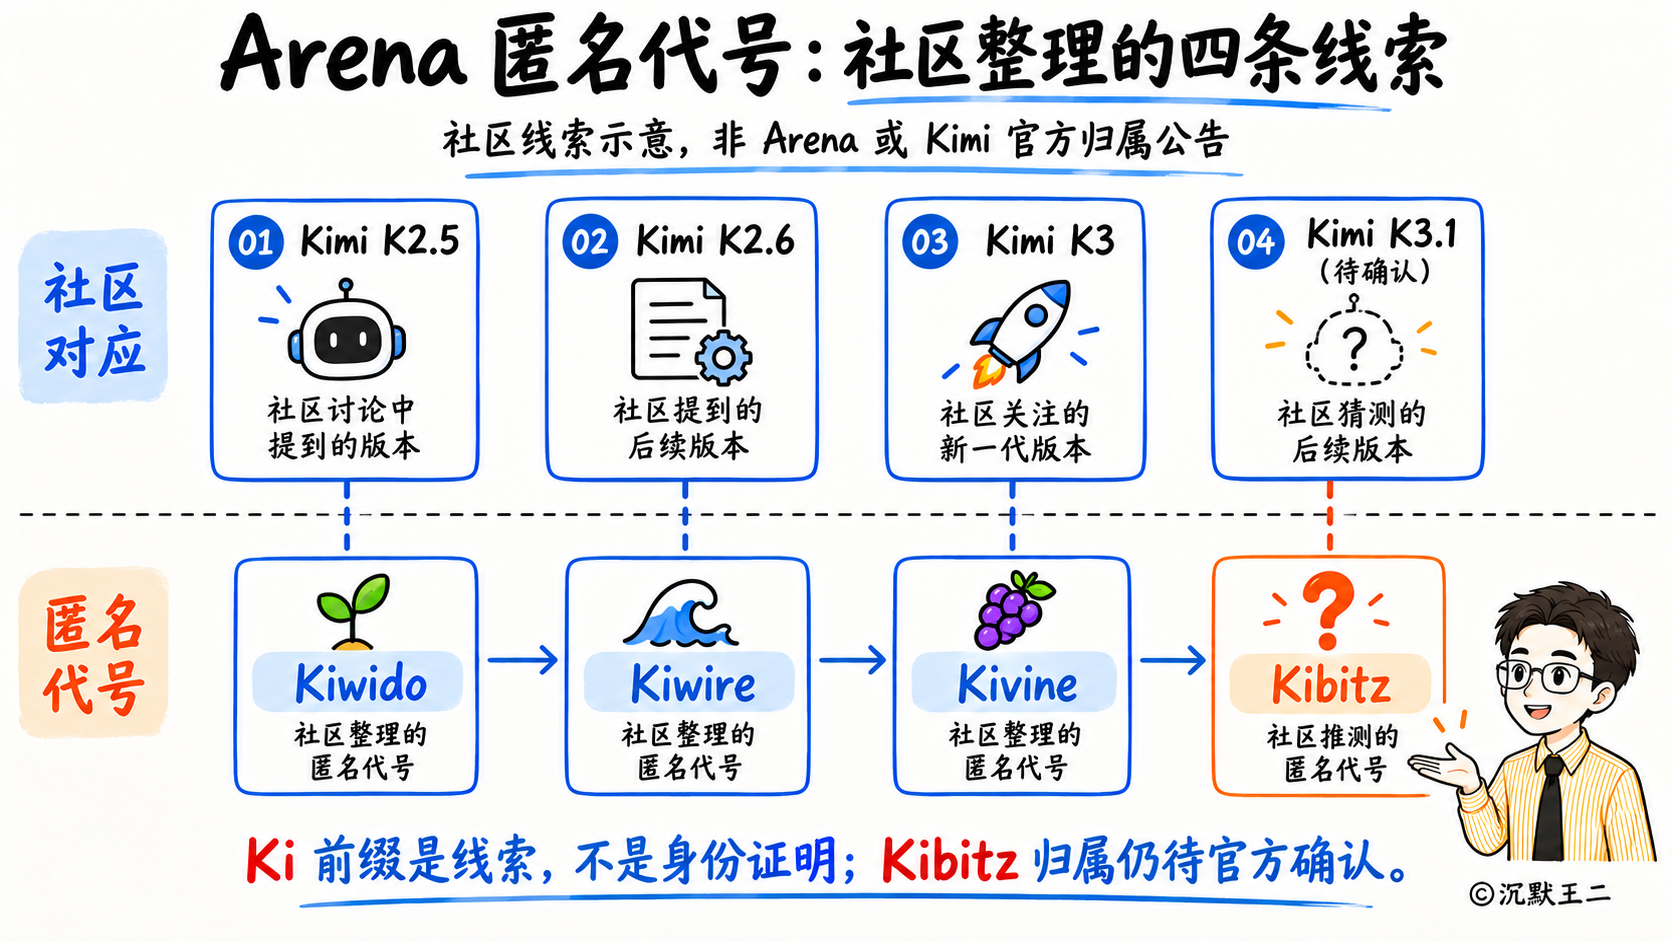
第二条线索是代号规律。K3 发布前在 Arena 上的匿名代号叫 Kivine,再往前的 K2.5、K2.6 分别叫 Kiwido 和 Kiwire,清一色全是 Ki 开头。
第三条线索是分词器,也就是 Tokenizer。模型的自我介绍可以伪装,但底层的词表规则是写死在权重里的。同一段包含特殊缩进、生僻字和代码符号的文本,不同厂商的分词器切出来的 Token 数量完全不同。通过比对分词粒度,就能锁定 Kibitz 用的是 Kimi 自家的分词器;有网友据此推测,同时出现的另一个匿名模型 Kalmia 像是 Qwen。
据透露,K3.1 预计会在 10 月 24 日或者 10 月 26 日正式发布,狠狠期待一波。
那聪明的你肯定又要问了,这对我们开发者意味着什么?
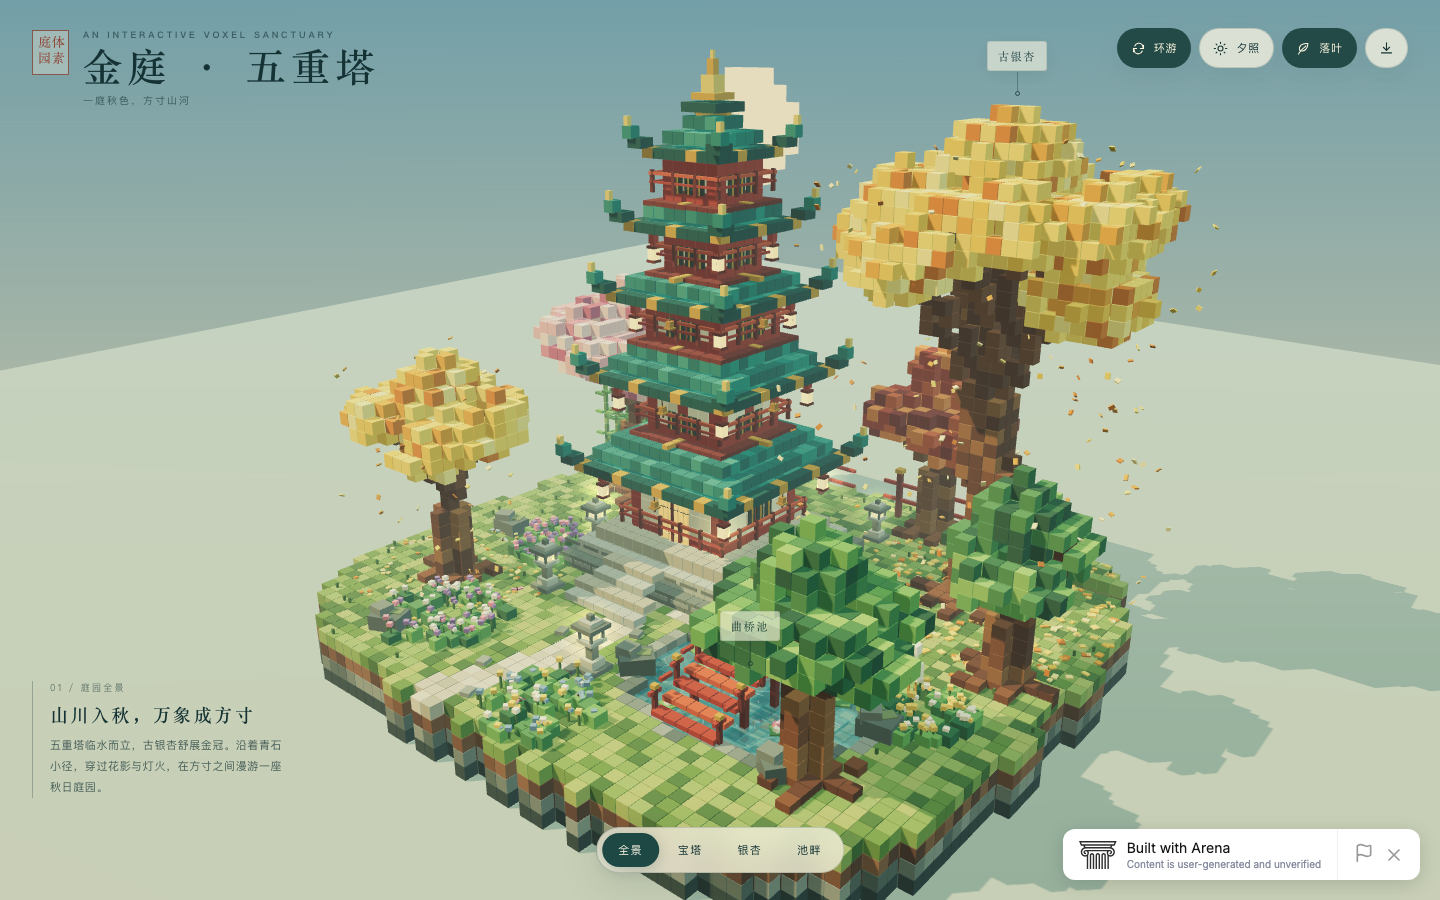
说实话,现在网上流传的 Kibitz 作品,大多是 3D 城堡、像素宝塔这类演示,而且有网友指出,目前的效果波动很大,五十次生成里才能挑出一个满意的。
Arena 的匿名模型也没有 API,所以暂时也没有办法拿它跑真实项目。
等官方把参数、价格和跑分放出来后,我们再接入 Kimi Code 实测一波,狠狠期待了。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!