
为什么?幻觉不是大模型侧的问题吗,Agent 哪来的幻觉?
没错,幻觉的源头确实是模型。但模型的幻觉一旦进入 Agent 的执行流程,就从说错变成了做错。Agent 的幻觉,通常表现为错误的工具调用、错误的上下文压缩、错误的长期记忆检索。2025 年 9 月,中国科学院信息工程研究所牵头,联合南洋理工大学、中国人民大学等十几家机构,在 arXiv 上发表了一篇论文,题目叫《LLM-based Agents Suffer from Hallucinations》,意思是基于大模型的 Agent 会产生幻觉,并按照幻觉发生的阶段,把 Agent 的幻觉分成了推理、执行、感知、记忆和通信五个大类。
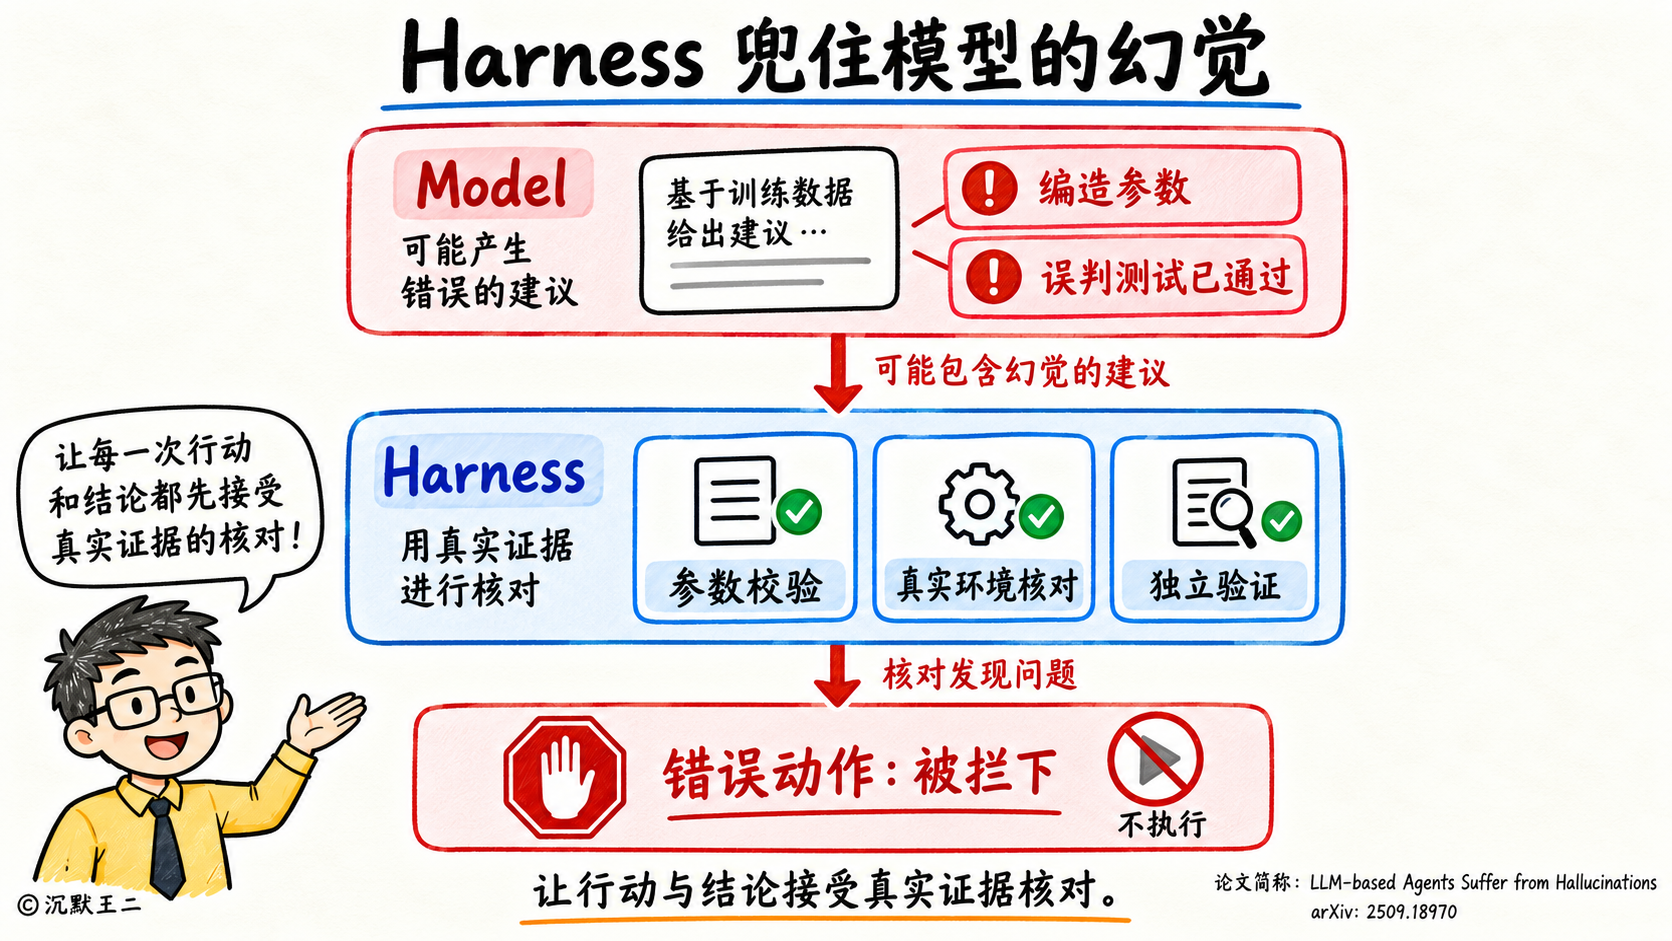
我翻了 Claude Code 和 Codex 的官方文档、Pi Agent 的源码,可以自信地、大方地、光明磊落地帮你把 Agent 的幻觉讲清楚。
先说第一件事,Agent 的幻觉要如何治理?
思路只有一条,让 Agent 执行的每一步都去真实环境核对一遍,把错误当作工具结果交还给模型,让模型自己改正。
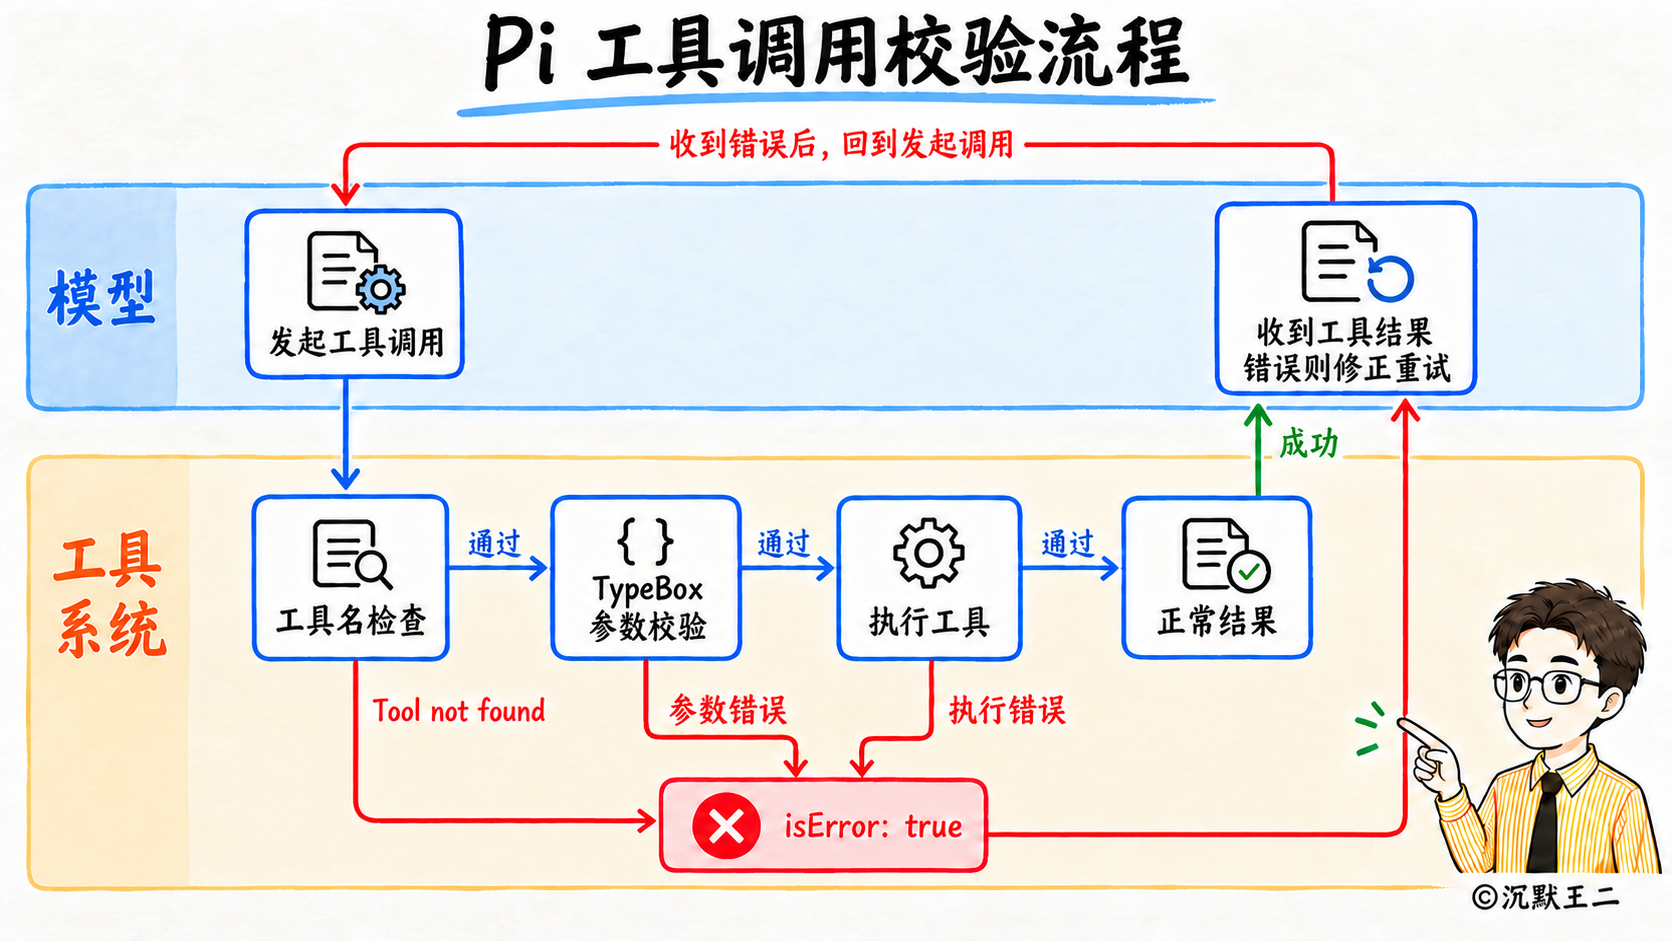
拿 Pi Agent 来说。模型调用了一个不存在的工具,Pi 会返回“Tool xxx not found”。工具名对了,参数还要经过 TypeBox 校验,TypeBox 是一个用来定义和校验 JSON Schema 的 TypeScript 库。校验失败时,Pi 会把出错的字段路径和模型传进来的原始参数一起发回去,并打上 isError 标记,模型能分清楚这是报错而不是正常返回,下一轮就会重新发起调用。
修改文件也是同样的道理。模型最容易凭记忆编造文件内容,以为某一行内容是这样那样,其实早就被改过了。
Claude Code 的 Edit 工具要求传一个 old_string 参数,也就是要被替换的原文,必须在文件里一字不差地出现,并且只能出现一次,差一个空格都会匹配失败。Codex 的 apply_patch 对不上原文,就会报“Failed to find expected lines”。Pi 的 edit 工具每次执行都会重新从磁盘读取文件,校验的是磁盘上的真实内容,而不是模型记忆里的版本。
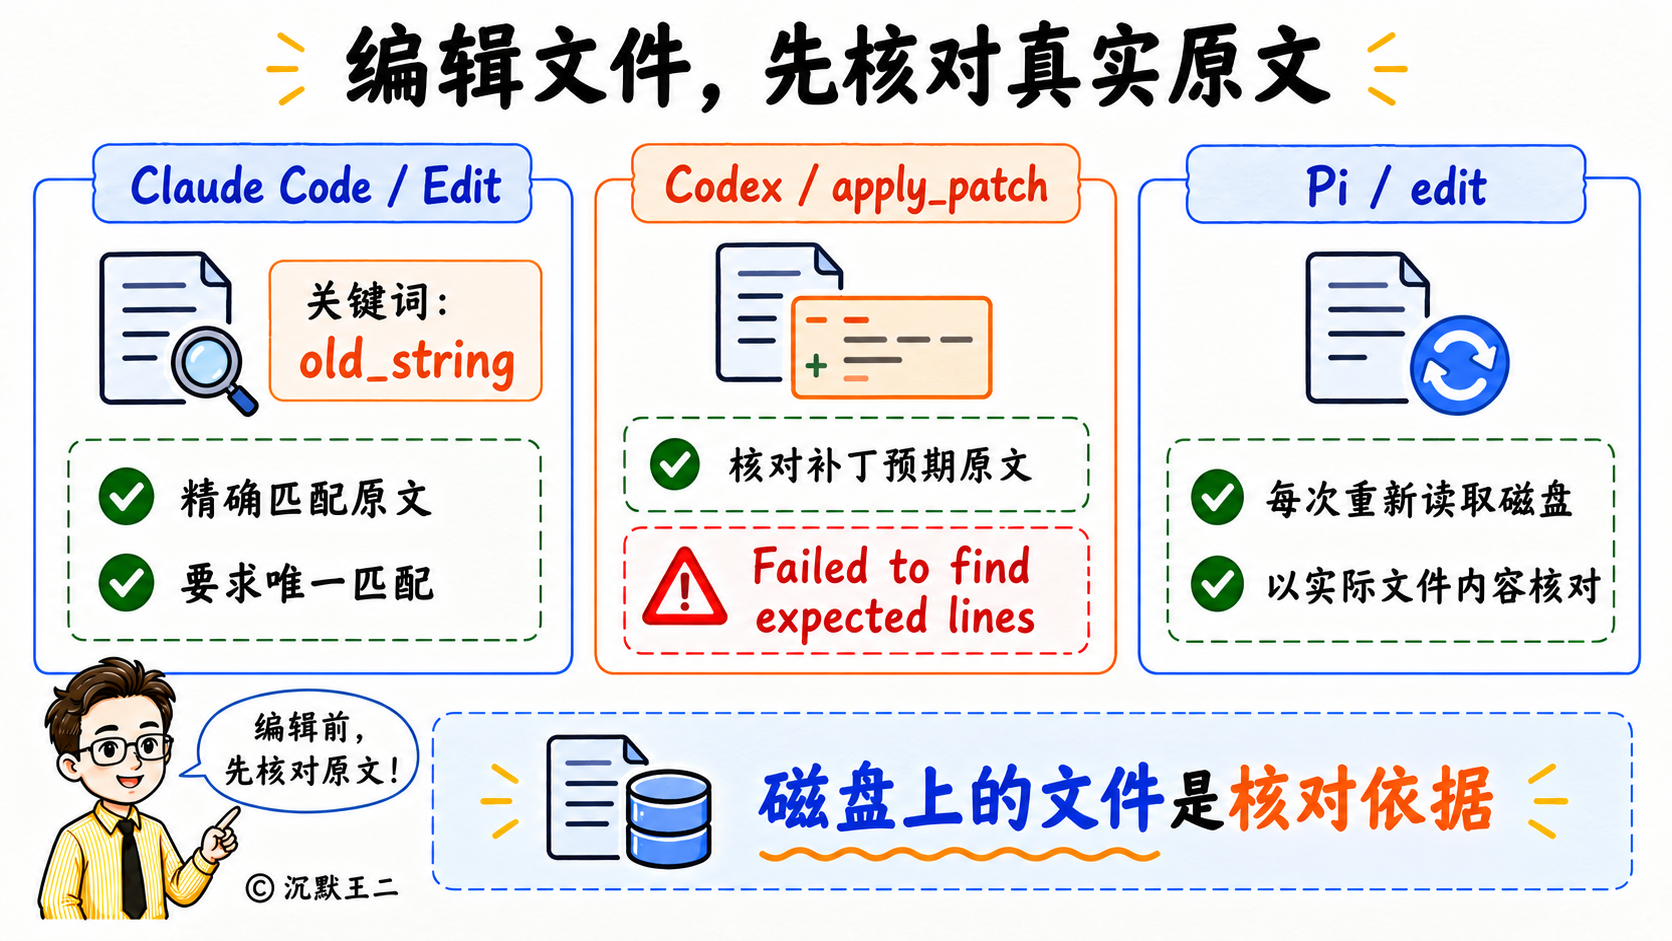
模型可以记错,但磁盘上的文件不会错。恭喜看到这里的你,已经成功击败 30% 的学习者,给自己鼓个掌吧。
那聪明的你肯定想到了:Agent 记错了怎么办?
Agent 记错有两种情况。一种是上下文快满了,Agent 做压缩的时候把信息弄丢了,或者摘要错了;另一种是长期记忆过时了,文件早就改过,记忆里还是旧的版本。前面提到的那篇论文对记忆幻觉的定义就是,Agent 不经核对就相信自己的记忆,用上了过时的、编造的或者混淆的内容。
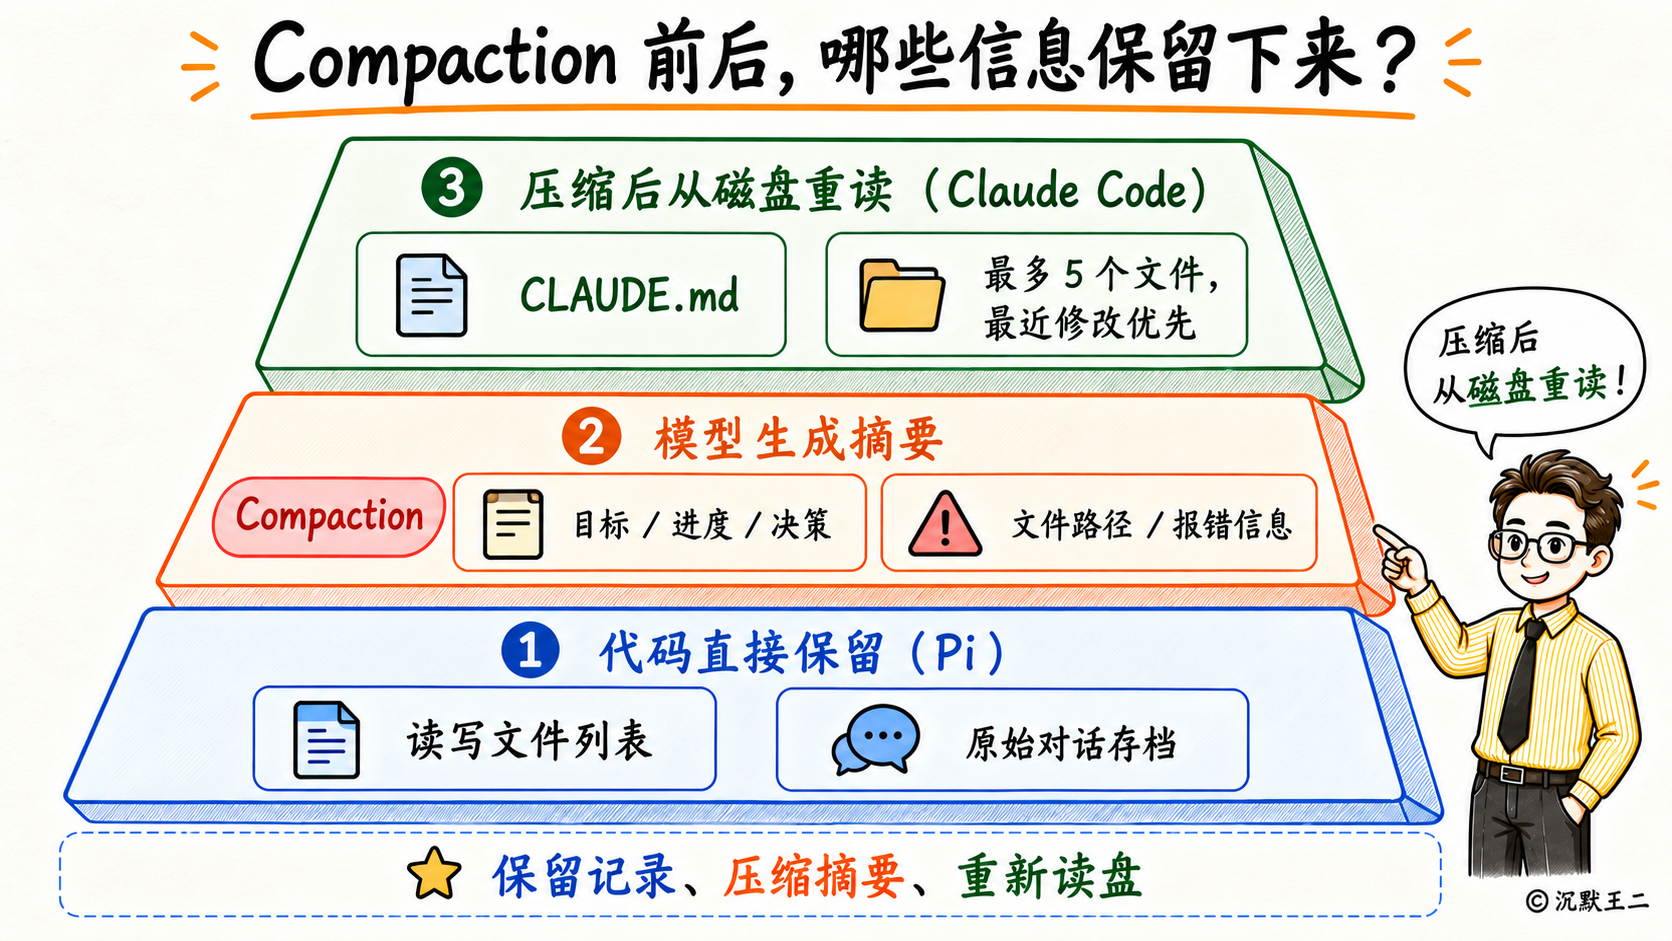
先说压缩。Pi 的压缩提示词要求摘要保留准确的文件路径、函数名和报错信息。但读过和改过哪些文件,Pi 并不交给模型去总结,而是交给代码从工具调用记录里提取出来,附在摘要后面。原始对话也不会删除,还保存在会话文件里,随时可以回溯。
Claude Code 压缩以后,会从磁盘重新读取读过或者改过的文件,最多 5 个,最近修改的优先,项目根目录的 CLAUDE.md 也会从磁盘重新注入。只在对话里交代过的指令,压缩以后可能会丢失,所以官方建议把需要一直遵守的规则写进 CLAUDE.md。
再说长期记忆。Codex 读取记忆时用的提示词里有一句“Memory is not proof of current behavior”,意思是记忆不能证明现在的情况还是这样。容易变化、核实成本又低的事实,先核实再回答;没有核实过的,不能当成当前的事实。Claude Code 会在记忆文件里记录写入时间,模型读到的时候,知道这条记忆是什么时候记下的。
记忆只是线索,磁盘上的内容才是证据。恭喜看到这里的你,已经成功击败 50% 的学习者了。
那聪明的你肯定又要问了:Agent 说“自己活干完了”,怎么判断到底有没有干完?
论文对执行幻觉的定义是,Agent 表现得好像已经完成了某个执行步骤,实际上并没有完成。Claude Code 的官方最佳实践里有一句话说得很明白,Claude 觉得活儿看起来干完了,就会停下来。
解决办法有两个。
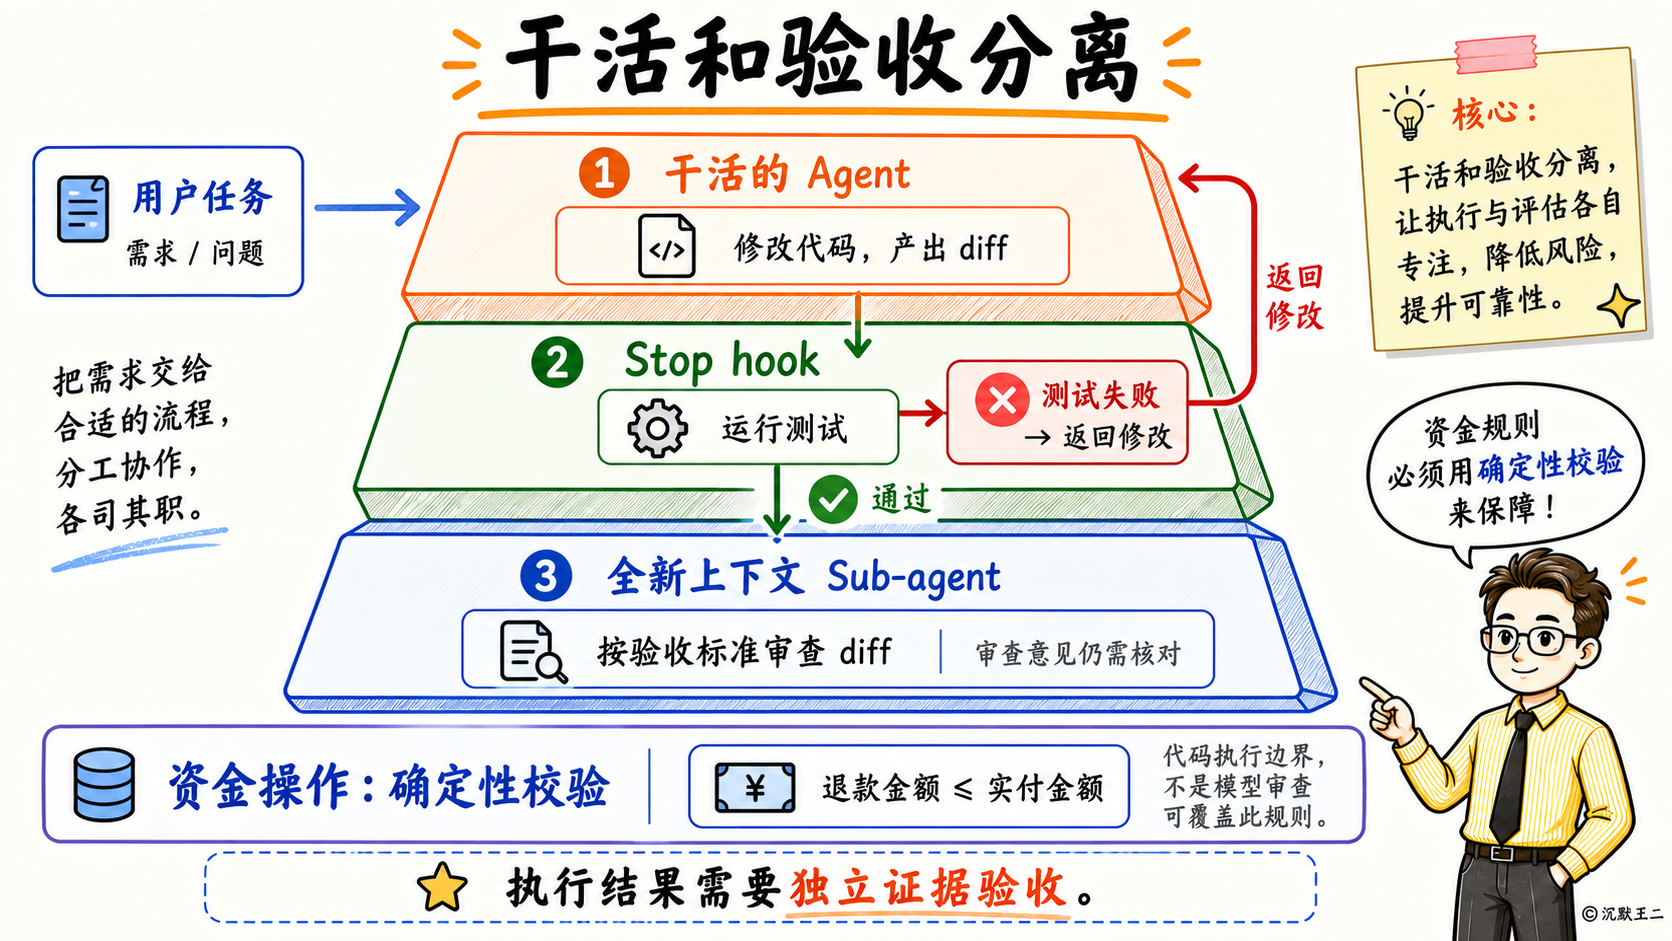
第一个,用确定性的检查代替模型的自我判断。Claude Code 的 Stop hook 会在 Agent 准备结束的时候触发,我们可以在里面运行测试,测试没通过就返回 block,把原因告诉 Claude,让它接着修改。为了防止无限循环,连续跑最多 8 次。这和 Harness 五要素里 Evaluation 的原则一样,只认客观物证。
第二个,验证的人不能是干活的人。Claude Code 官方推荐开一个上下文全新的 Sub-agent 去审查 diff,它只能看到 diff 和你给的验收标准,看不到写代码时的推理过程,也就不会顺着原来的思路替自己辩护。不过官方也提醒,被要求找问题的审查者,就算代码没有问题,通常也会报告几个问题,所以审查意见不能照单全收。
涉及到金钱的操作,最后一步必须交给确定性的代码校验。比如退款金额不能超过订单的实付金额,这一条要写死在代码里,模型说什么都不算数。恭喜看到这里的你,成功击败 70% 的学习者了。
面试官如果追问:“多个 Agent 协作的时候怎么办?”
告诉他,下游 Agent 会把上游 Agent 的幻觉当成事实,继续往下推理,论文里的通信幻觉说的就是这种情况。所以 Agent 之间传递结论时要附上证据,比如文件路径、行号、命令的原始输出等。下游 Agent 拿到以后能自己核对一遍,而不是只接收一句“已经修好了”。
恭喜你升到王者段位了,成功击败 99% 的学习者。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!