
上面写着“2 已完成,1 进行中,3 待处理”,展开后是一排带状态圆点的任务清单。
但聪明的你应该已经注意到了,大模型明明自己会做推理规划,为什么各大 Agent 还要专门给它配一个 Todo List 工具呢?
如果觉得这只是一个给用户看的进度条界面,那就没有 get 到 Todo List 的价值。
大模型执行长程任务时,工具返回的结果越来越多,最开始的目标很容易被淹没在后来的上下文当中。Todo List 主要解决两个问题,一是让模型把大的目标拆分成具体的步骤,通过不断重写清单把目标刷新到上下文末尾,防止执行跑偏;二是把推理进度展示给用户看,让用户能在 Agent 跑偏之前及时纠正。
恭喜看到这里的你,已经成功击败 30% 的学习者,给自己鼓个掌吧。接下来我问你,DeepSeek Harness 更新 Todo List 时,底层是怎么修改状态的?
A,提供新增、修改、删除、查询四个工具;B,只提供一个 todo_write 工具,每次全量覆写整张清单;C,直接改写本地磁盘上的 Markdown 文件。喜欢收藏的你可以把答案打在弹幕或者留言区。
说说我的答案,只提供一个 todo_write 工具,每次全量覆写整张清单。
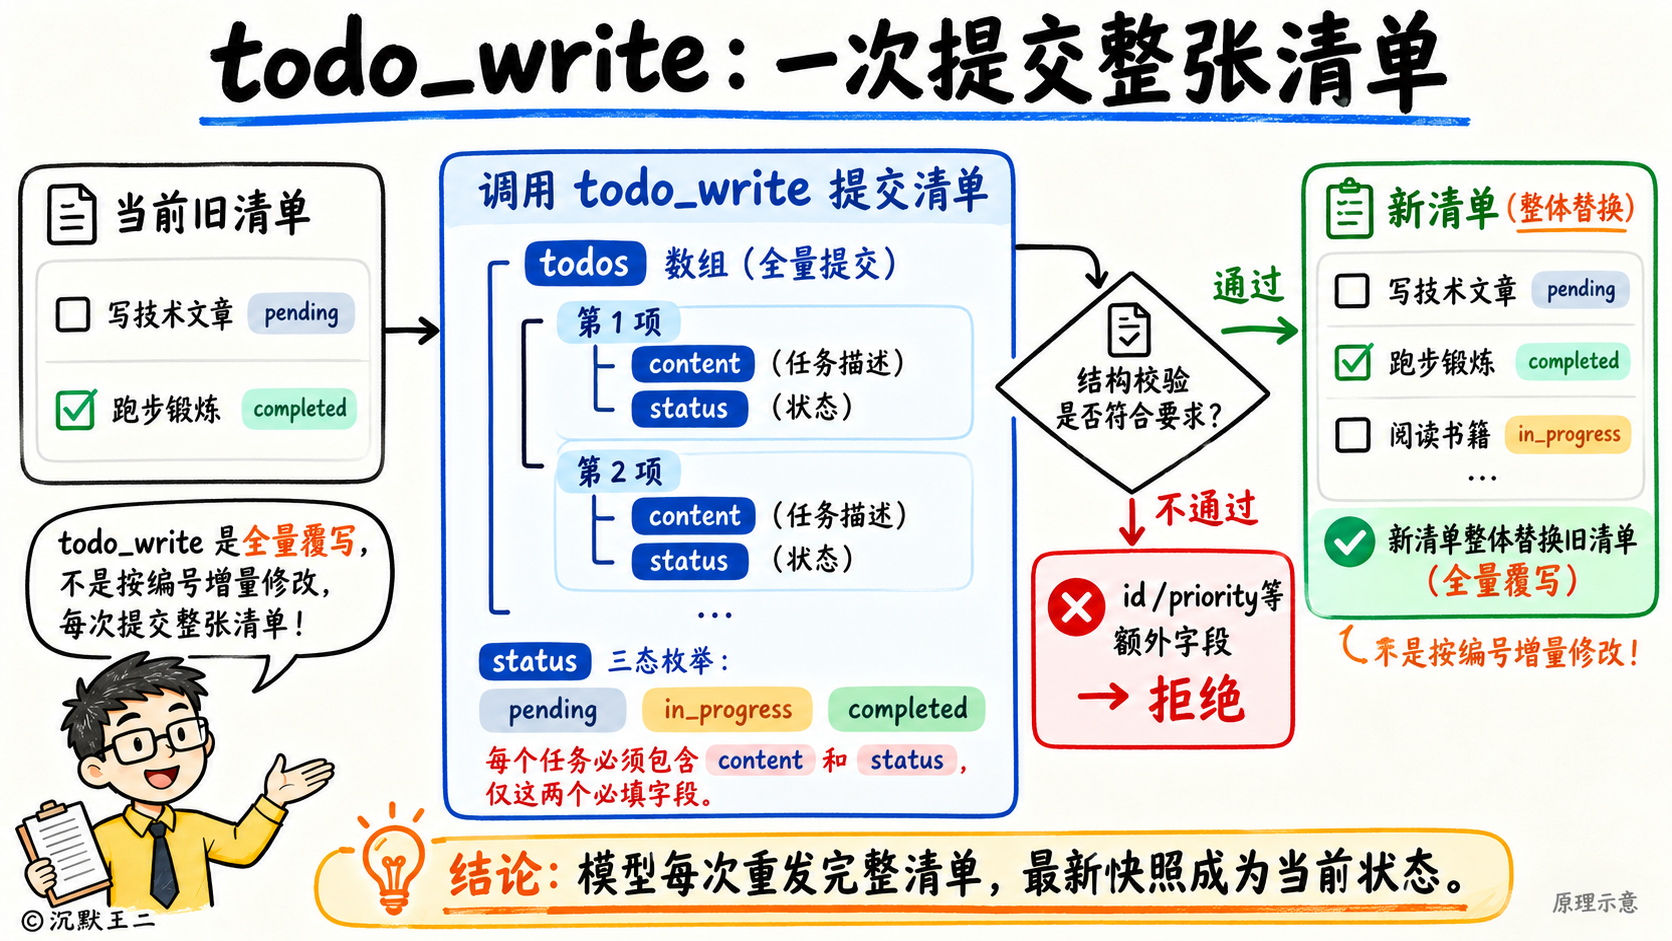
翻开 DeepSeek Harness 的 Todo 源码,整个模块只向模型暴露了一个 todo_write 工具。参数是一个名叫 todos 的数组,数组中的每一项只保留两个必填字段,代表任务描述的 content 和代表状态的 status。状态枚举只有三种,pending 和 in_progress 分别代表待处理和进行中,任务做完后就标记为 completed。如果模型多传了任务编号 id 或者优先级 priority 字段,参数校验器就会当场报错拦截。
那聪明的你一定想问,为什么要每次把整张清单重新发送一遍呢?
一方面,省去了模型跨轮次记忆任务编号的负担。另一方面,Manus 团队在《Context Engineering for AI Agents》博客里专门讲过,通过复述可以加强模型的注意力。大模型对靠近上下文末尾的内容注意力最强,每次调用 todo_write 把完整清单重写一遍,就是让模型把全局目标和当前进度复述到上下文末尾,防止中途忘掉。
恭喜看到这里的你,已经成功击败 50% 的学习者了。
接下来继续问你,怎么防止模型一口气把所有任务全部标记成进行中?
A,完全靠提示词;B,完全靠工具执行时的代码校验;C,提示词加代码校验,同时留一个配置开关。喜欢点赞的你会选哪一个?
我的答案是 C,双管齐下。
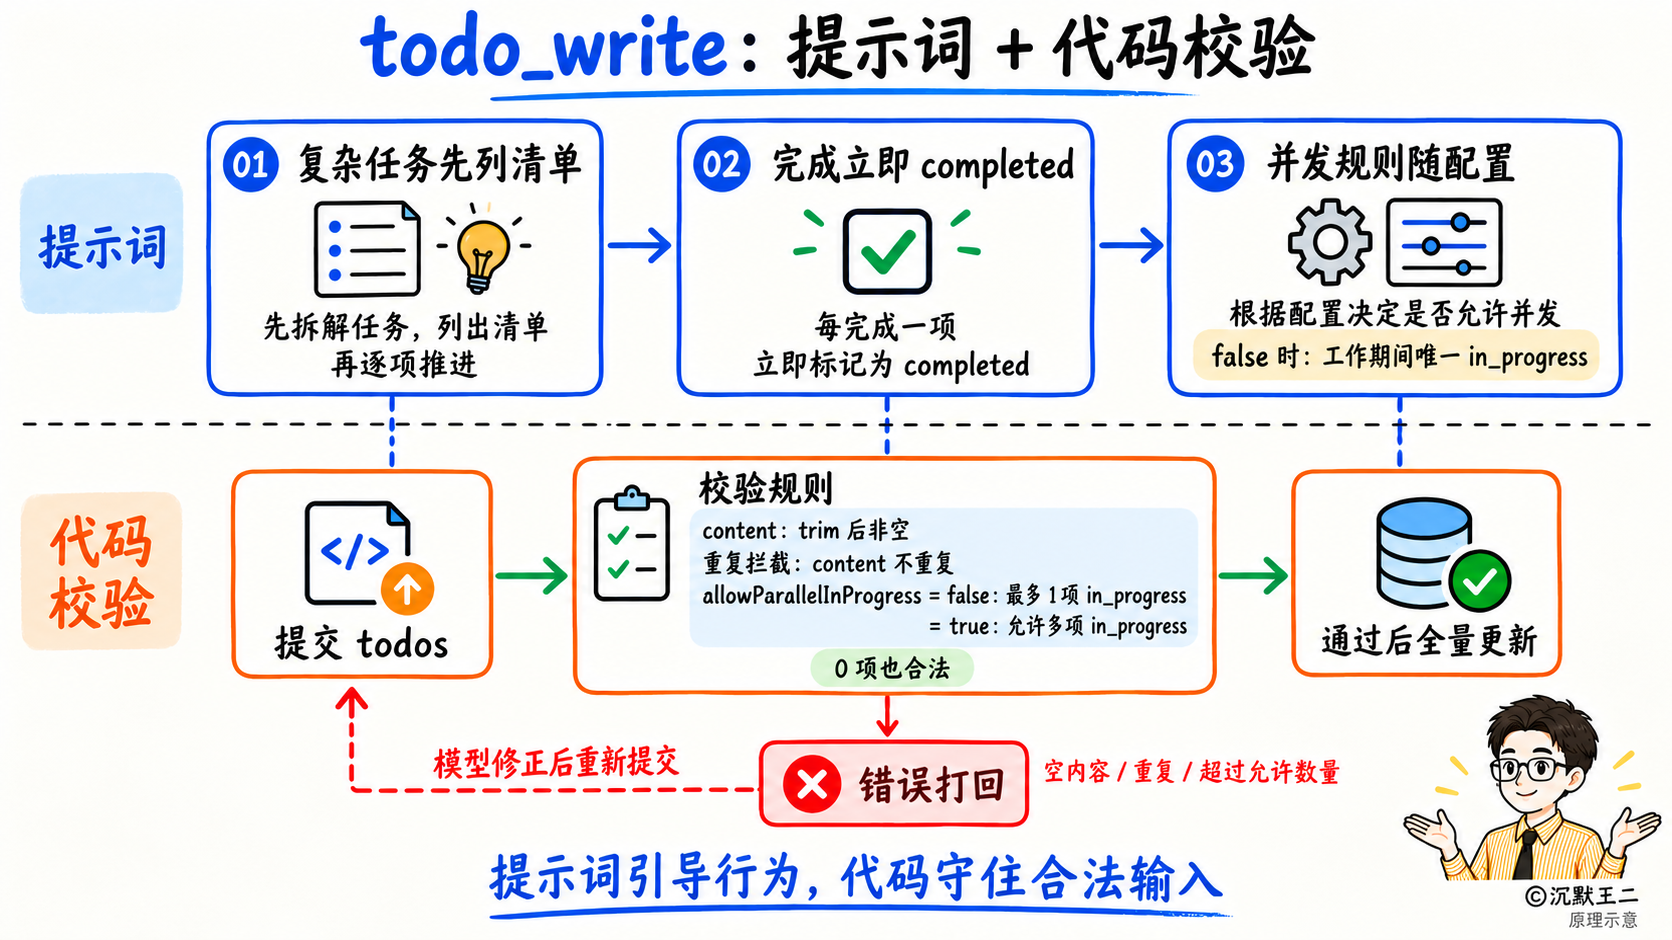
先看提示词。DeepSeek Harness 在 todo_write 的工具描述里规定,简单的单步任务直接跳过,复杂的多步任务在动手前先列出清单,而且每完成一项必须立刻标记为 completed,不允许累积到最后批量交差。
那能不能同时有好几项任务处于 in_progress 状态呢?这取决于 Todo 工具模块里的布尔配置项 allowParallelInProgress(是否允许并行执行)。
当这个开关设为 false 时,工具描述要求模型同一时间只保持一项 in_progress。一旦模型提交了两个以上的 in_progress 任务,工具执行模块里的校验函数就会直接抛出异常,返回一条错误结果,逼迫模型当场修正参数并重新调用。这段校验逻辑还会拦截空的字符串和重复的任务描述。而在开启并发 Sub-agent 和后台任务的配置下,这个开关会设为 true,允许模型在并行派发任务时标记多项任务同时进行。
恭喜看到这里的你,成功击败 70% 的学习者了。
继续问你,每次调用 todo_write 之后,清单数据是怎么同时给到大模型和前端界面的?如果长对话触发了上下文压缩,清单会不会丢?
A,把清单当成普通聊天消息放入对话历史;B,通过事件溯源日志与会话投影分离渲染,压缩时用结构化摘要保留;C,每一轮都在系统提示词里重复注入一遍。喜欢推荐的你会选哪一个?
我的答案是 B,模型上下文与前端界面视图完全分离。
在 DeepSeek Harness 里,模型调用一次 todo_write,工具只给模型返回短短一行计数文本,告诉它当前有几项待处理、几项进行中、几项已完成。
同时,工具会在会话日志里追加一条类型为 todo/write 的事件。这条事件不进入大模型对话历史的消息流,既不占用上下文窗口,也不会破坏 Prefix Caching 的命中率。
而输入框上方的任务面板,靠的是一个名叫 todos 的会话投影。它专门监听会话日志里的 todo/write 事件来渲染进度条,并在用户发出下一轮新提问、触发 turn/start 事件时自动清空旧的面板,避免上一轮的旧清单残留在新的问题里。
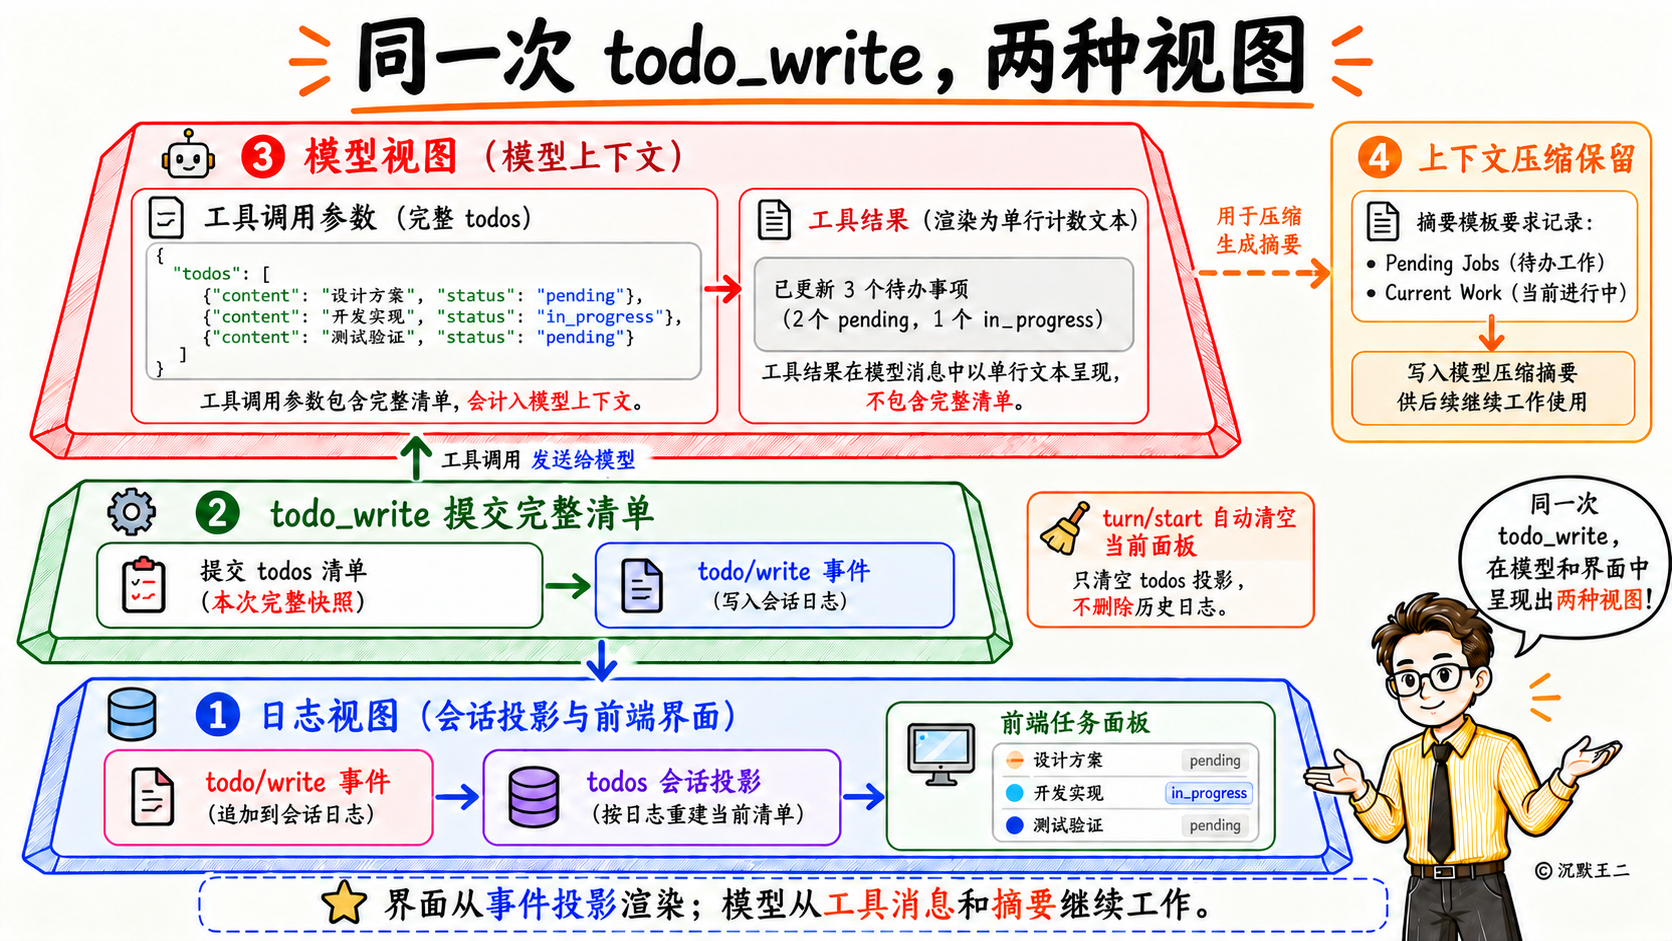
就算长对话触发了上下文压缩,前端界面因为直接读取的会话投影,丝毫不受影响;大模型侧,上下文压缩模块内置了固定的 Checkpoint 摘要模板,强制把还没做完的任务写进 Pending Jobs 和 Current Work 章节,确保压缩后不会出现任务丢失。
恭喜看到这里的你,成功击败 90% 的学习者了。
最后再问你,在只做规划的 Plan 模式下能不能调用 todo_write?是不是所有 Agent 都该用全量覆写?
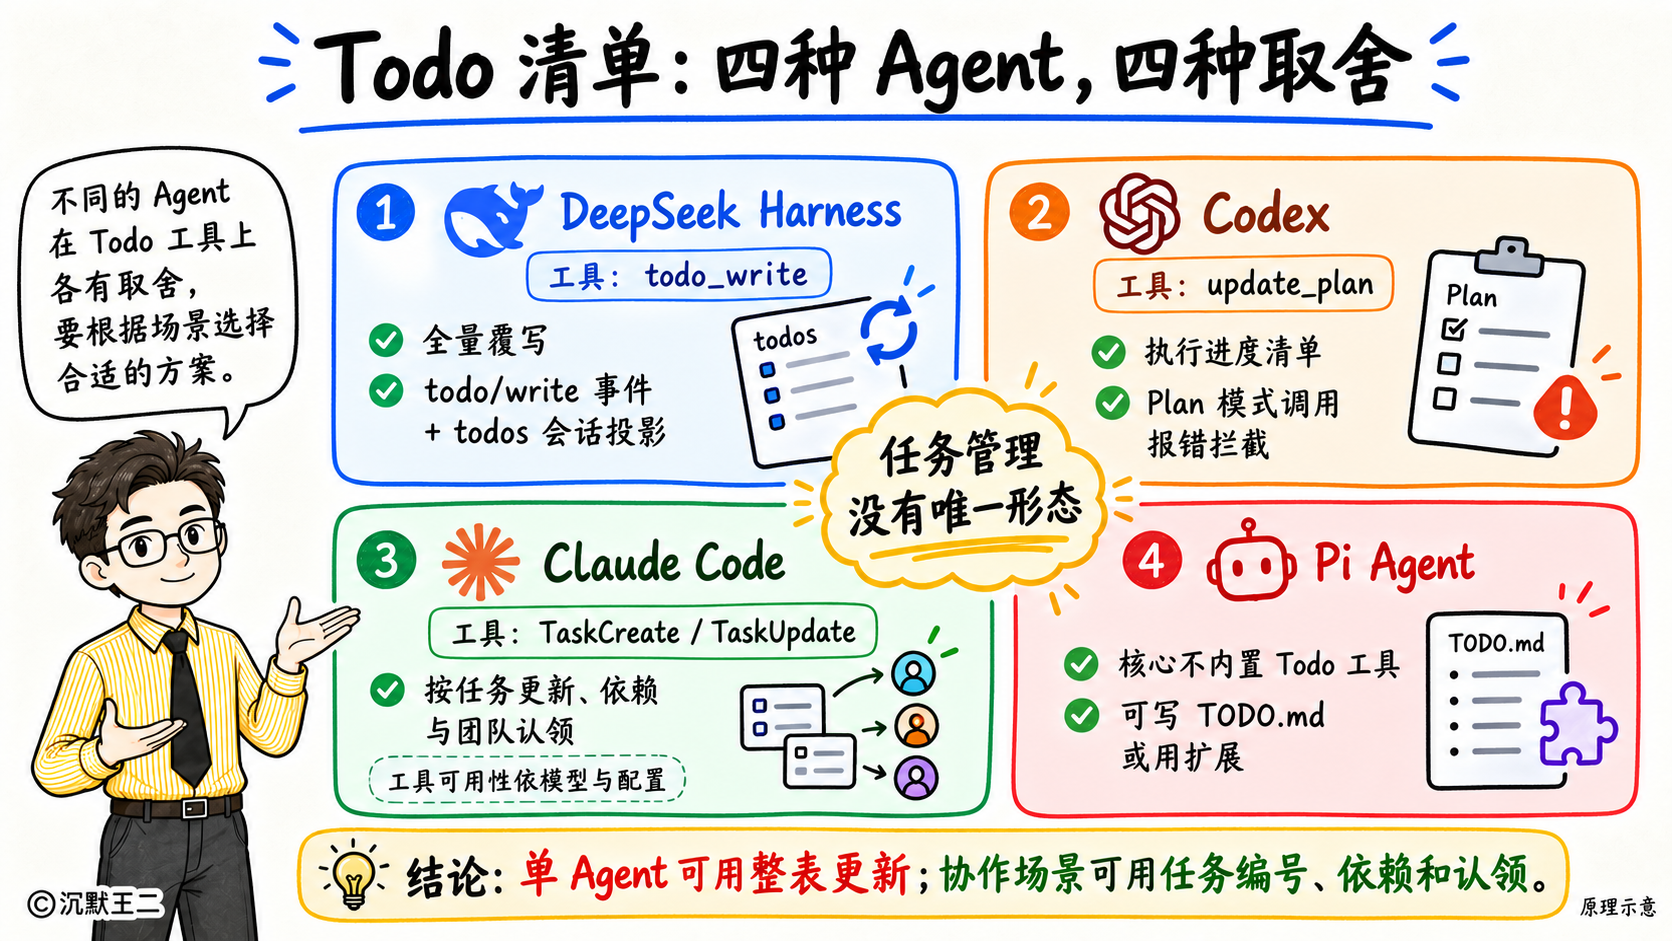
A,所有模式和所有 Agent 都该直接照抄;B,Plan 模式下严禁调用,而且多 Agent 分工时需要演进成按编号更新的任务工具。聪明的你会选哪一个?
我的答案是 B。
DeepSeek Harness 在 Plan 模式的系统提示词里明令禁止调用 todo_write,因为 Plan 模式负责在动手前敲定方案,而 todo_write 跟踪的是方案获批后的执行进度。
恭喜你升到王者段位了,成功击败 99% 的学习者。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!