
如果你回答“把函数封装一下,写清楚名称、描述和参数的 JSON Schema,让大模型通过 Function Calling 调用就行了”,恭喜你,出门右拐回家等通知吧。
为什么?
因为大模型生成合法参数的能力,远比你想象的差。Claude Code 的工具执行模块里专门写了一行源码注释,大意是“没想到模型生成合法参数的能力这么差”。
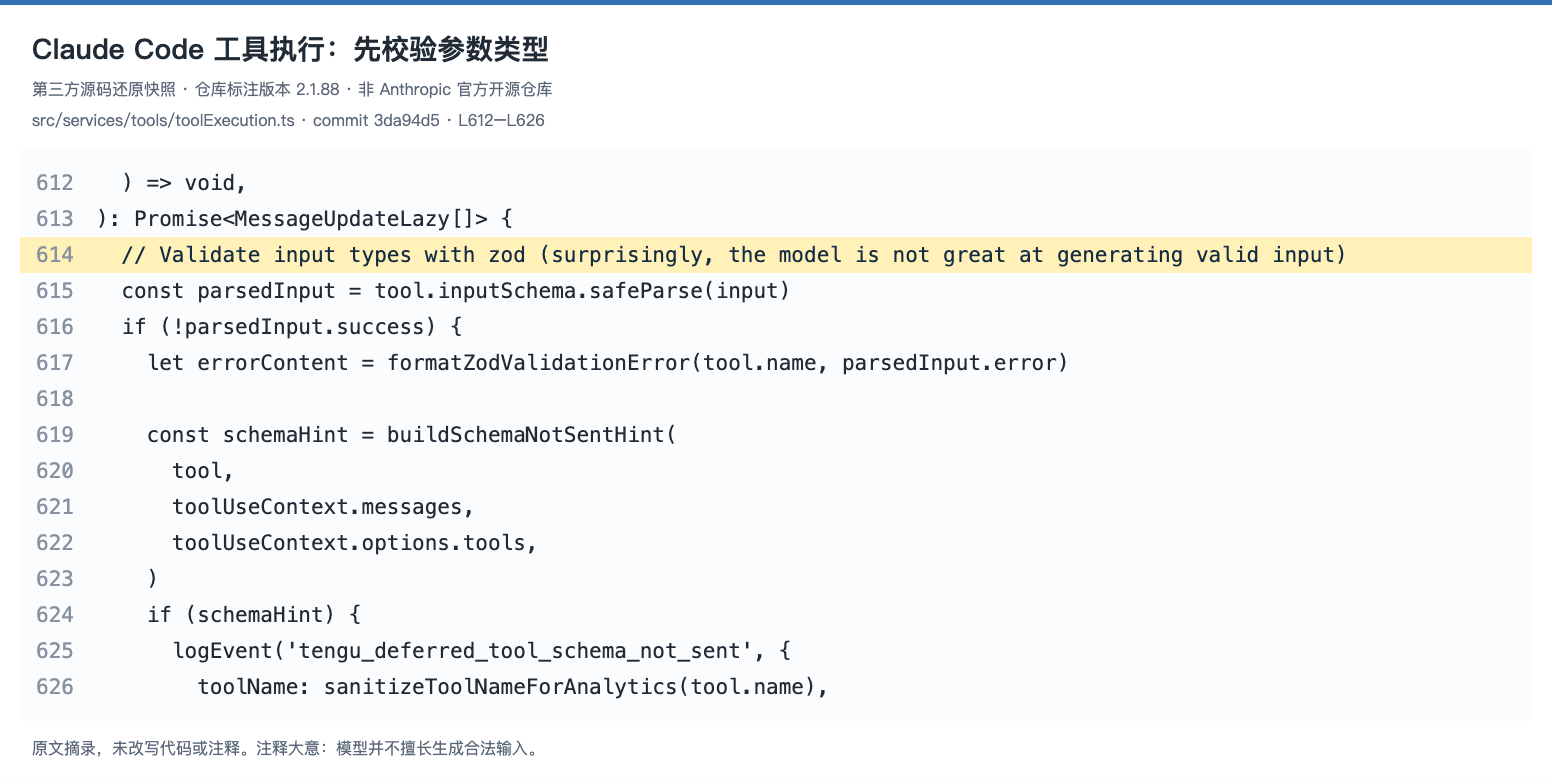
我翻了 Claude Code 和 Pi 的源码,还有 Anthropic 的官方指南,可以自信地、大方地、光明磊落地帮你搞清楚 Tool 的设计原则。
先说第一件事,工具的数量越多越好吗?
很多新手觉得给 Agent 挂载的工具越多能力就越强。恰恰相反,工具越多,上下文里的工具定义就越长,模型在相似工具之间选错的概率也就越高。
Pi Agent 就把极简做到了极致。它的代码库里一共写了八个工具,但默认只开放 read、bash、edit、write 四个核心工具,连 grep、find、ls 都默认关闭。
同时 Pi 会在系统提示词里动态补上一句规则,让模型直接用 bash 工具去执行 ls、rg 和 find。因为这些标准命令,模型在预训练语料里见过无数次,调用起来反而最准确。
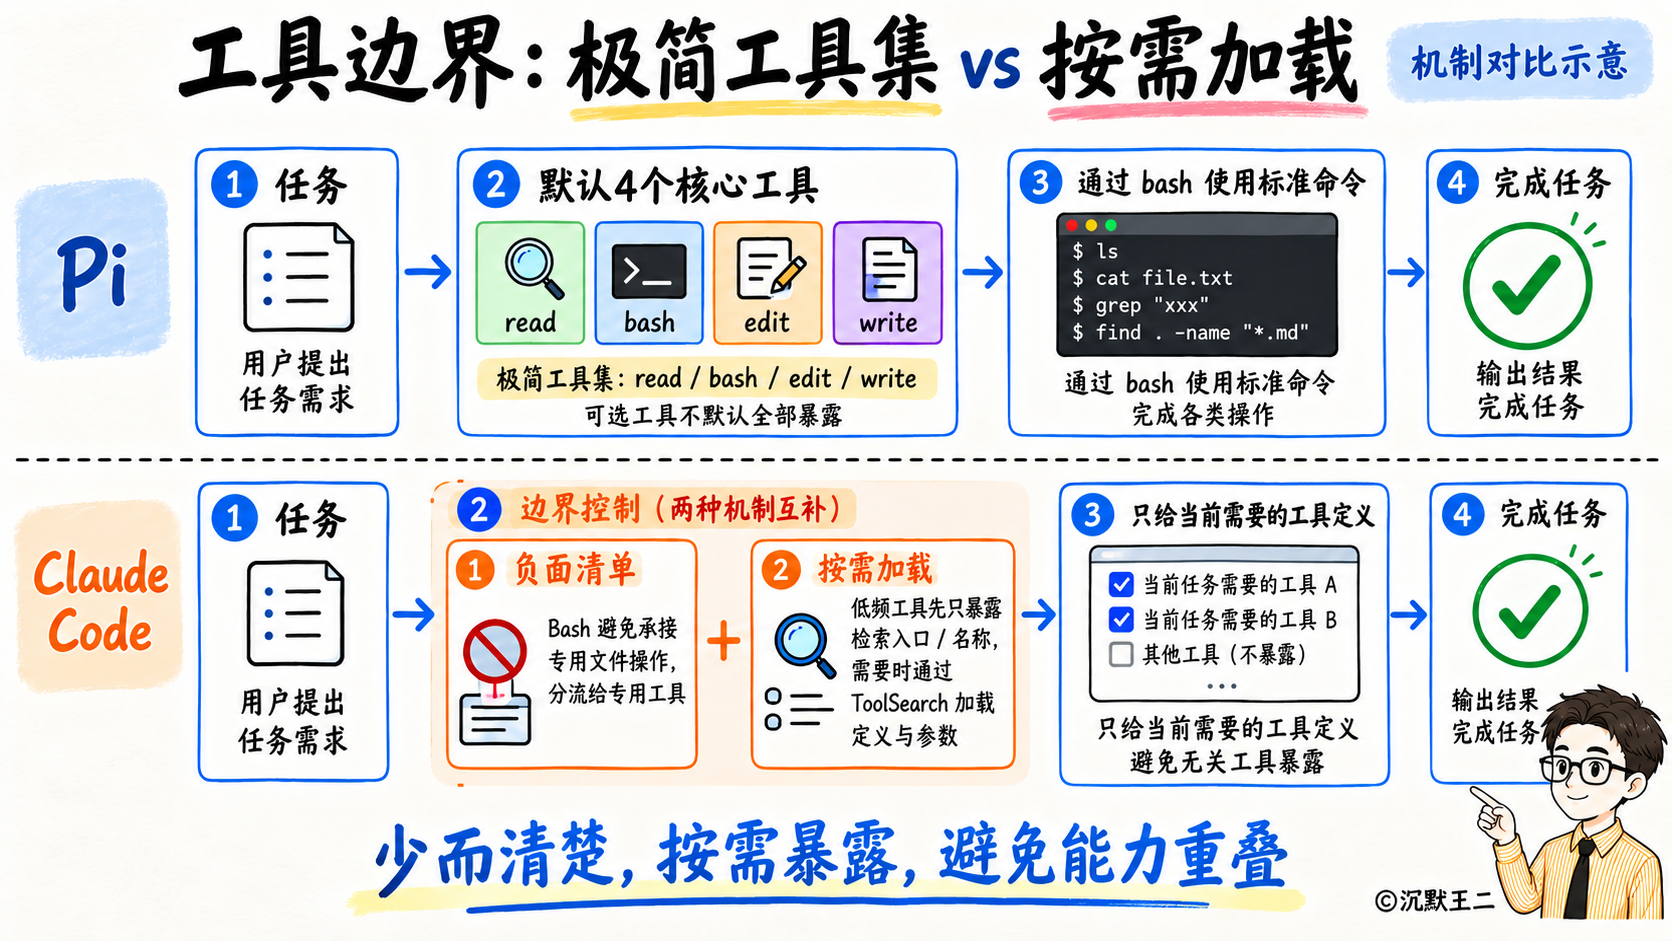
那如果业务很复杂,像 Claude Code 一样内置了四五十个工具,还挂载了一堆 MCP 工具,怎么办?
第一招,在 Bash 工具的提示词里明确禁止用 Bash 执行 find、grep、cat、sed,强制分流给 Glob、Grep、Read、Edit 这些专用工具。
第二招是延迟加载,把所有 MCP 工具和低频工具默认标记为延迟加载,第一轮只发送工具名称,不发参数结构,等模型真正需要时再调用 ToolSearch 按需拉取。
那聪明的你肯定想到了,模型选对了工具,但传回来的参数千奇百怪,怎么在入口处做好防护?
Anthropic 在《Building effective agents》里提出过一个重要原则:从工具接口的设计上杜绝错误的发生。比如模型切换目录后传相对路径总是出错,他们干脆把工具参数改成强制只接收绝对路径,模型就再也没犯过错。
Claude Code 和 Pi 把入口处的参数处理做了两层处理。
先是静默兼容。Pi 的 edit 工具里有一段参数预处理逻辑,注释里直接点名 Opus 4.6 和 GLM-5.1 有时候会把 edits 数组传成 JSON 字符串或者单个对象。Pi 不会直接报错浪费一轮推理,而是在校验前静默把它包装成标准的数组。
Claude Code 也一样。模型经常把数字参数加上引号传成字符串,比如说办数字 30 加上双引号变成字符串 "30",它就在客户端静默转成数字;文件里的中文双引号、不可见的 BOM 头,甚至苹果电脑截图文件名里 AM、PM 前面那个肉眼看不见的特殊窄空格,包括 Read 和 Edit 工具,都会在底层自动对齐匹配。
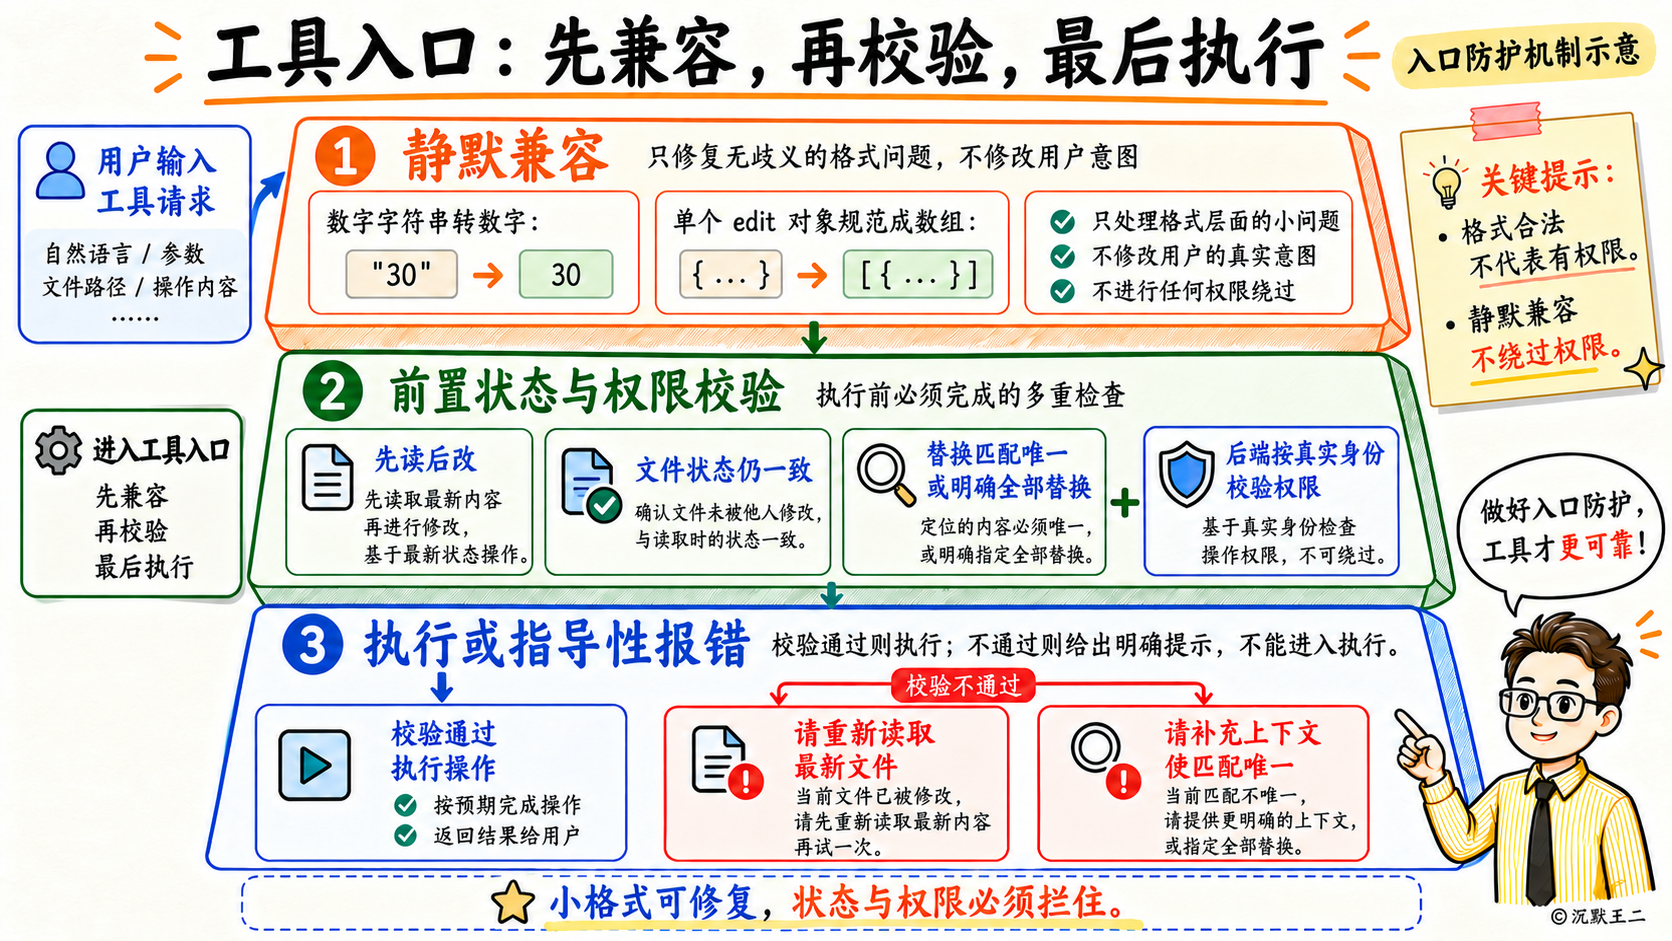
再是前置拦截。Claude Code 的 Edit 工具在写入前设了三道关卡。第一,没调用过 Read 工具就想直接修改文件,拦截。第二,Read 之后文件被用户或者格式化工具动过了,拒绝写入,防止覆盖最新文件。第三,要替换的 old_string 在文件里匹配到了好几处,也必须拦截。
而且报错信息绝不只给一个错误码,而是像写提示词一样指导模型:“找到了几处匹配,想全部替换请把 replace_all 设为 true,只想修改一处请补充更多上下文行让它唯一”。
那聪明的你肯定又要问了,工具执行时出现并发冲突或者返回值太大,怎么在出口处做好处理?
第一是读写分离的并发控制。Claude Code 默认把所有工具都标记为不可并发,只有连续调用 Read、Grep、Glob 这类只读工具时,才会打包并发执行,默认最多十个并发;一旦遇到 Edit、Write 或者 Bash,立刻切回串行。Pi 则按文件的真实路径加锁排队,修改不同的文件可以并行,修改同一个文件严格串行。
第二是首尾差异化的输出截断。Pi 给工具输出设了两千行和 50KB 的硬门槛。read 工具采用头部截断,保留开头并提示模型传入 offset 起始行号继续往下读;bash 工具采用尾部截断,只保留最后两千行,因为编译报错和异常堆栈永远在最末尾,完整输出则存进临时文件。
Claude Code 的 Read 工具默认限制单次输出两万五千个 Token。全局工具输出一旦超过五万个字符,就会把完整结果写进磁盘,只给模型返回前两千字节的预览和文件路径,同时冻结这次替换结果,保证后续轮次的 Prefix Caching 不会失效。
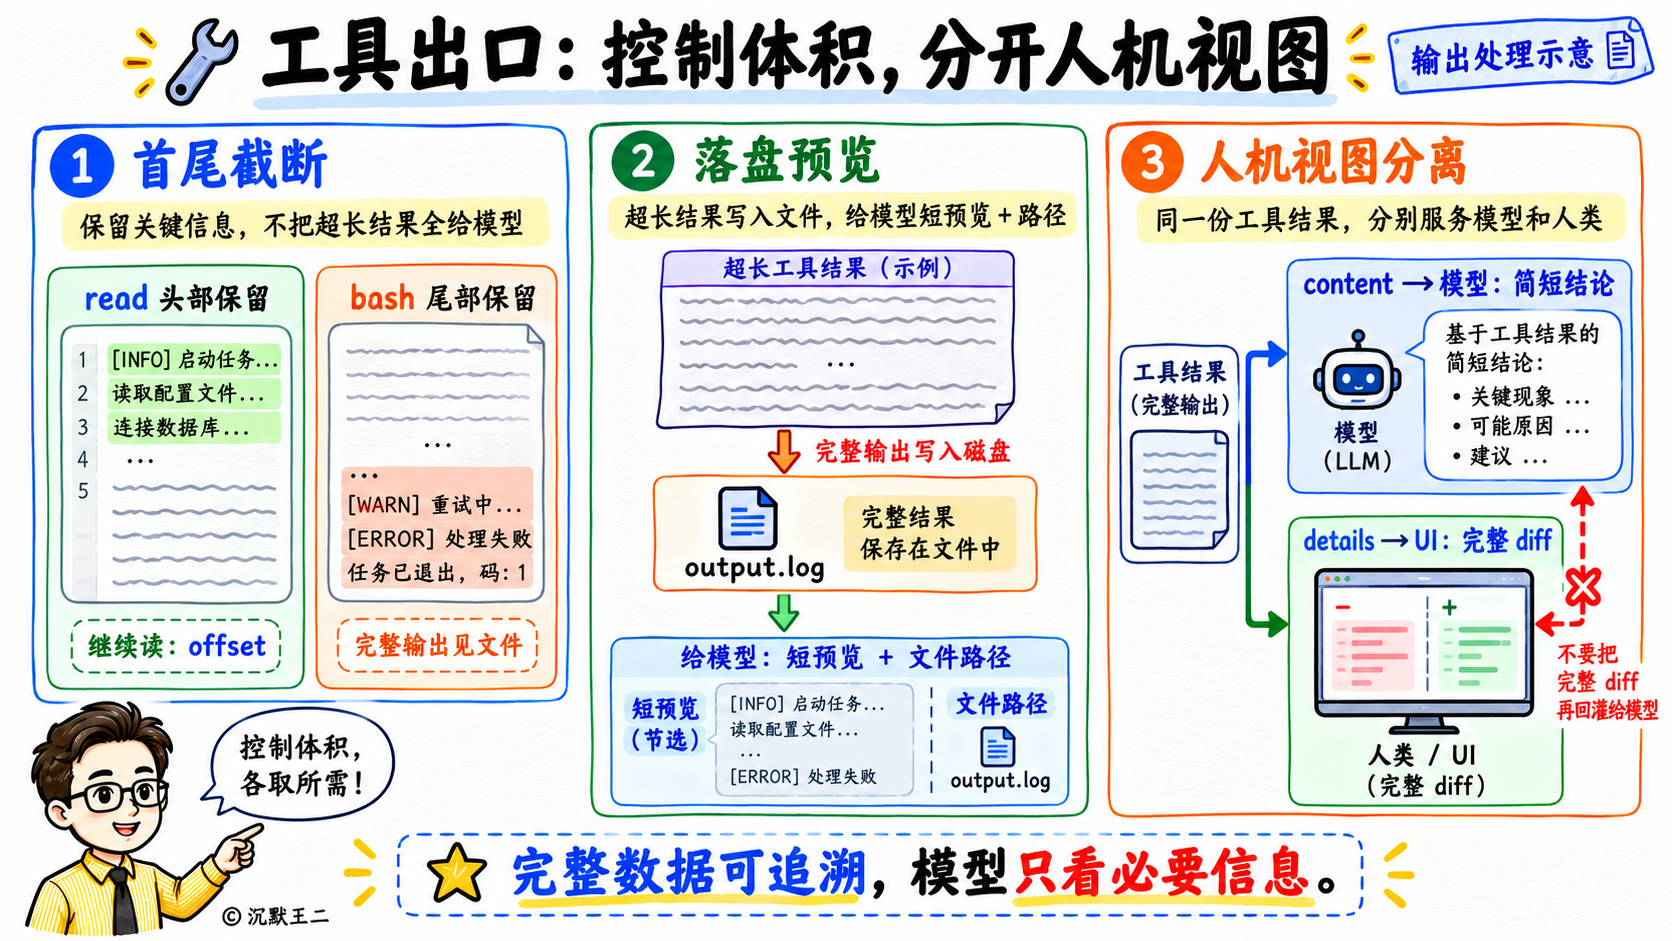
第三是人机视图分离。Pi 的 edit 工具修改完代码后,返回值拆分成了 content 和 details 两个字段。发给大模型的 content 只有短短一句“成功替换了几处代码块”,而完整的 diff 补丁放在 details 里只给终端界面渲染,一个多余的 Token 都不喂给模型。
面试官如果追问:“用户让 Agent 去查不属于他的订单,但参数格式完全合法,怎么预防?”
告诉他,权限边界绝不能交给模型判断,必须在工具的代码内部,根据当前登录用户的真实身份和权限规则做好拦截。
一句话概括,只读并发与写操作加锁守住执行安全,截断落盘与人机分离守住了上下文窗口和缓存命中。
另外给大家一条实用建议,自己写工具的时候,一定把“发给模型推理的精简结果”和“发给前端渲染的完整数据”拆分清楚,并在出口做好行数截断和明确的下一步报错提示,Agent 的稳定性马上就能上一个台阶。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!