
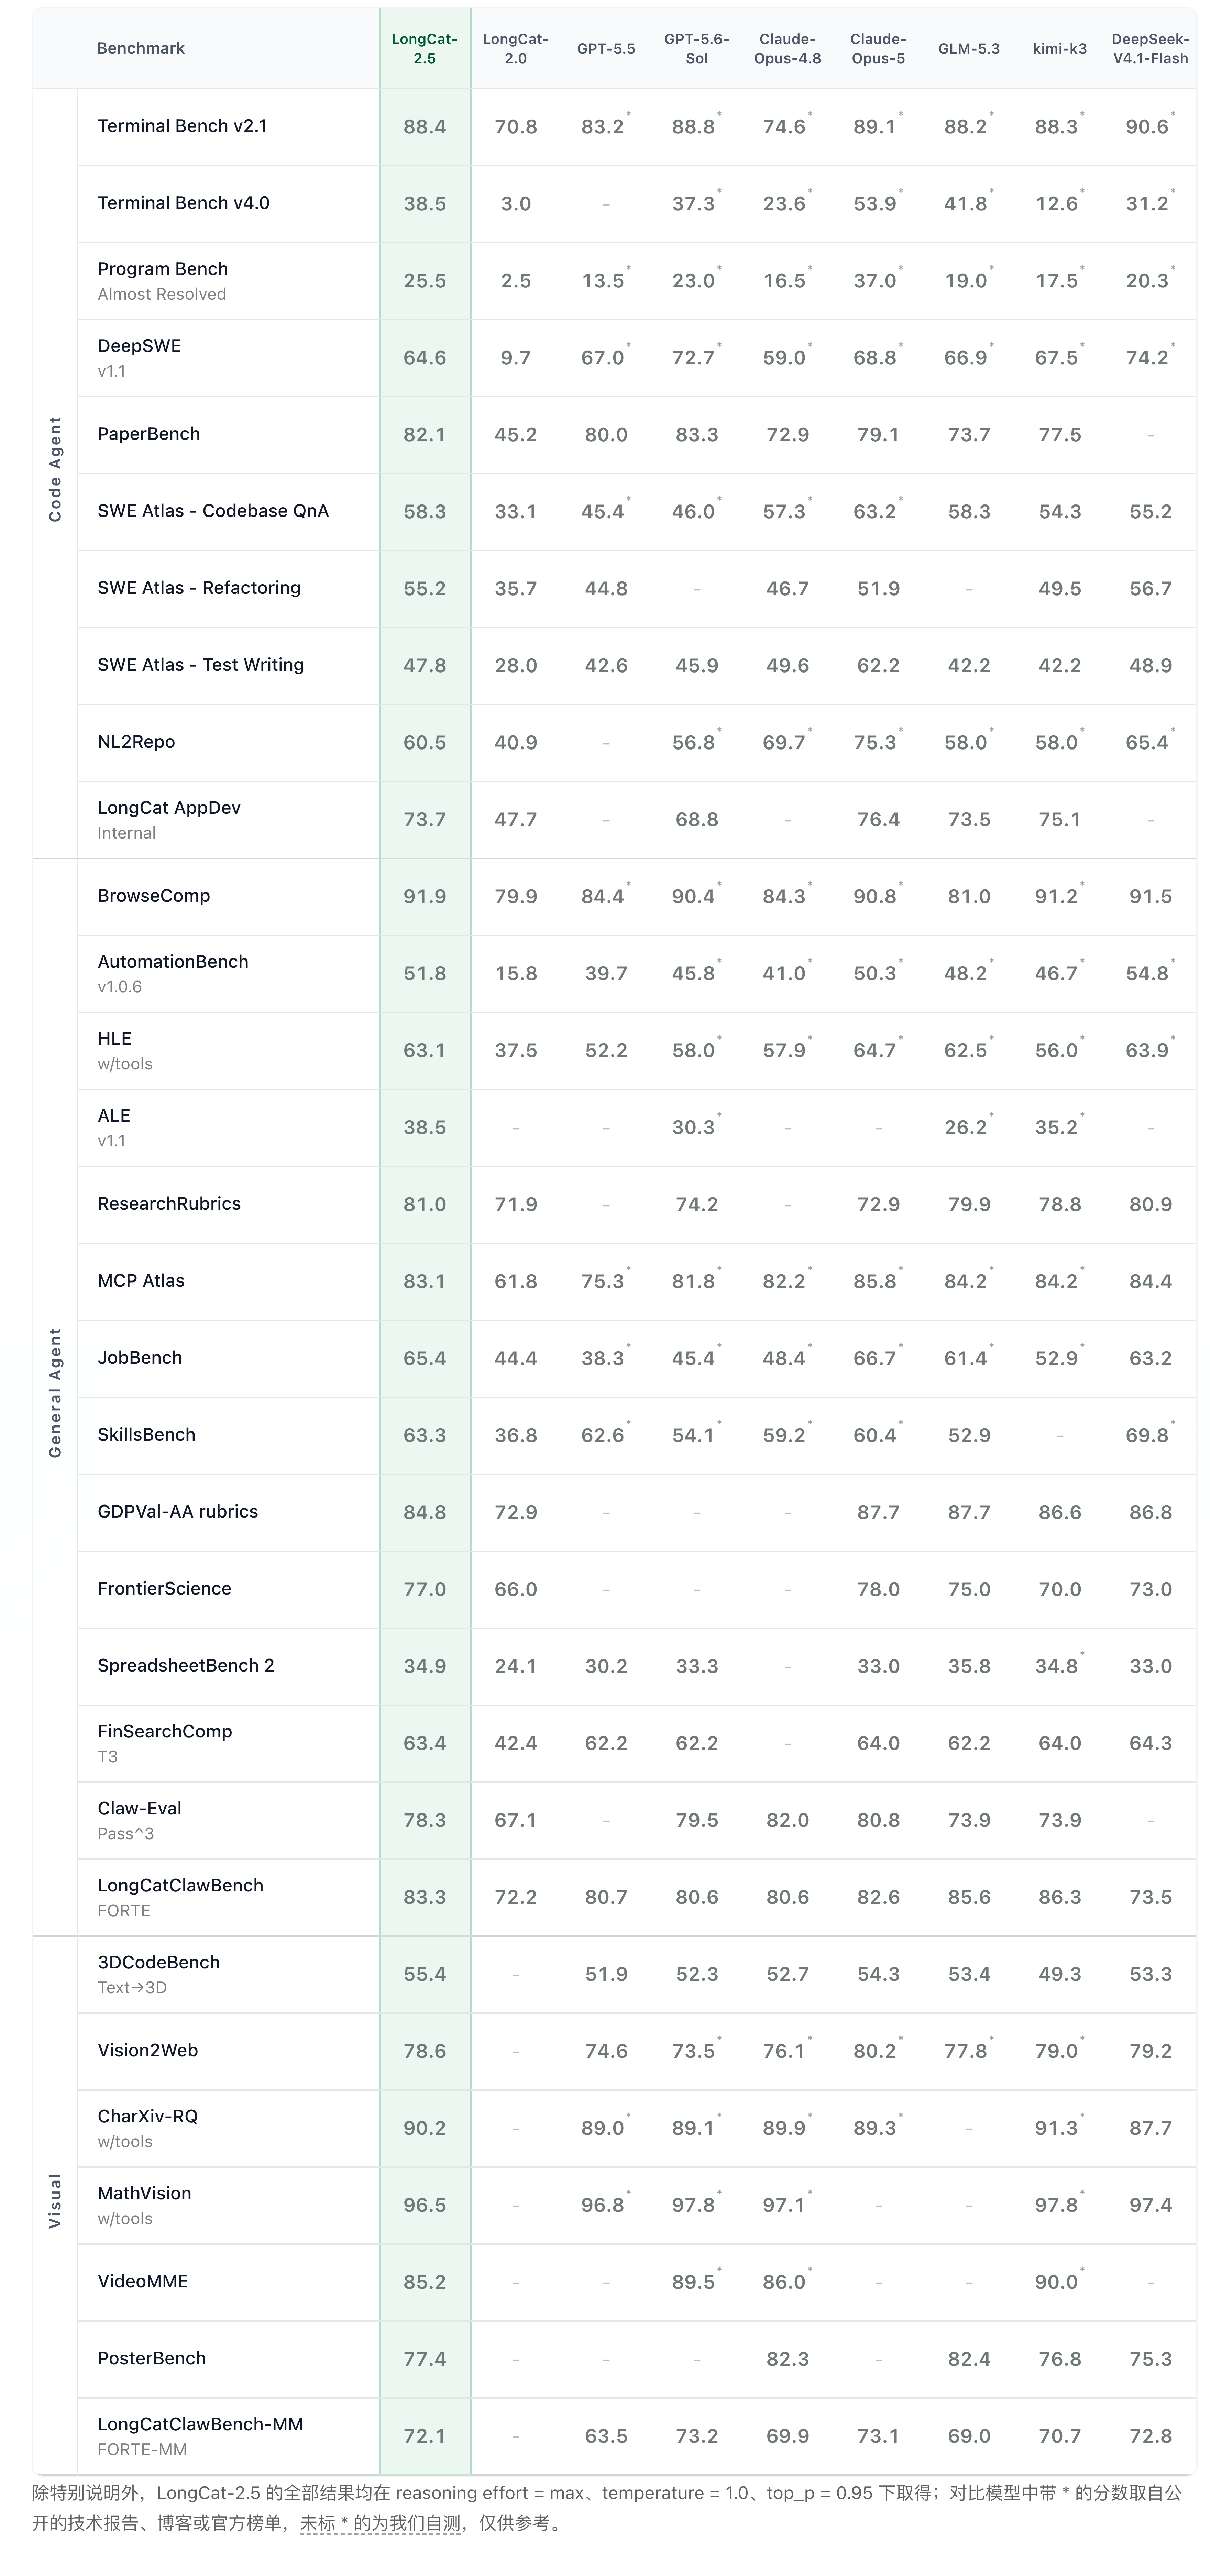
从跑分成绩来看,比肩 Opus 5,这是一个不错的成绩呢,继续给我们的国产模型加油助威吧。
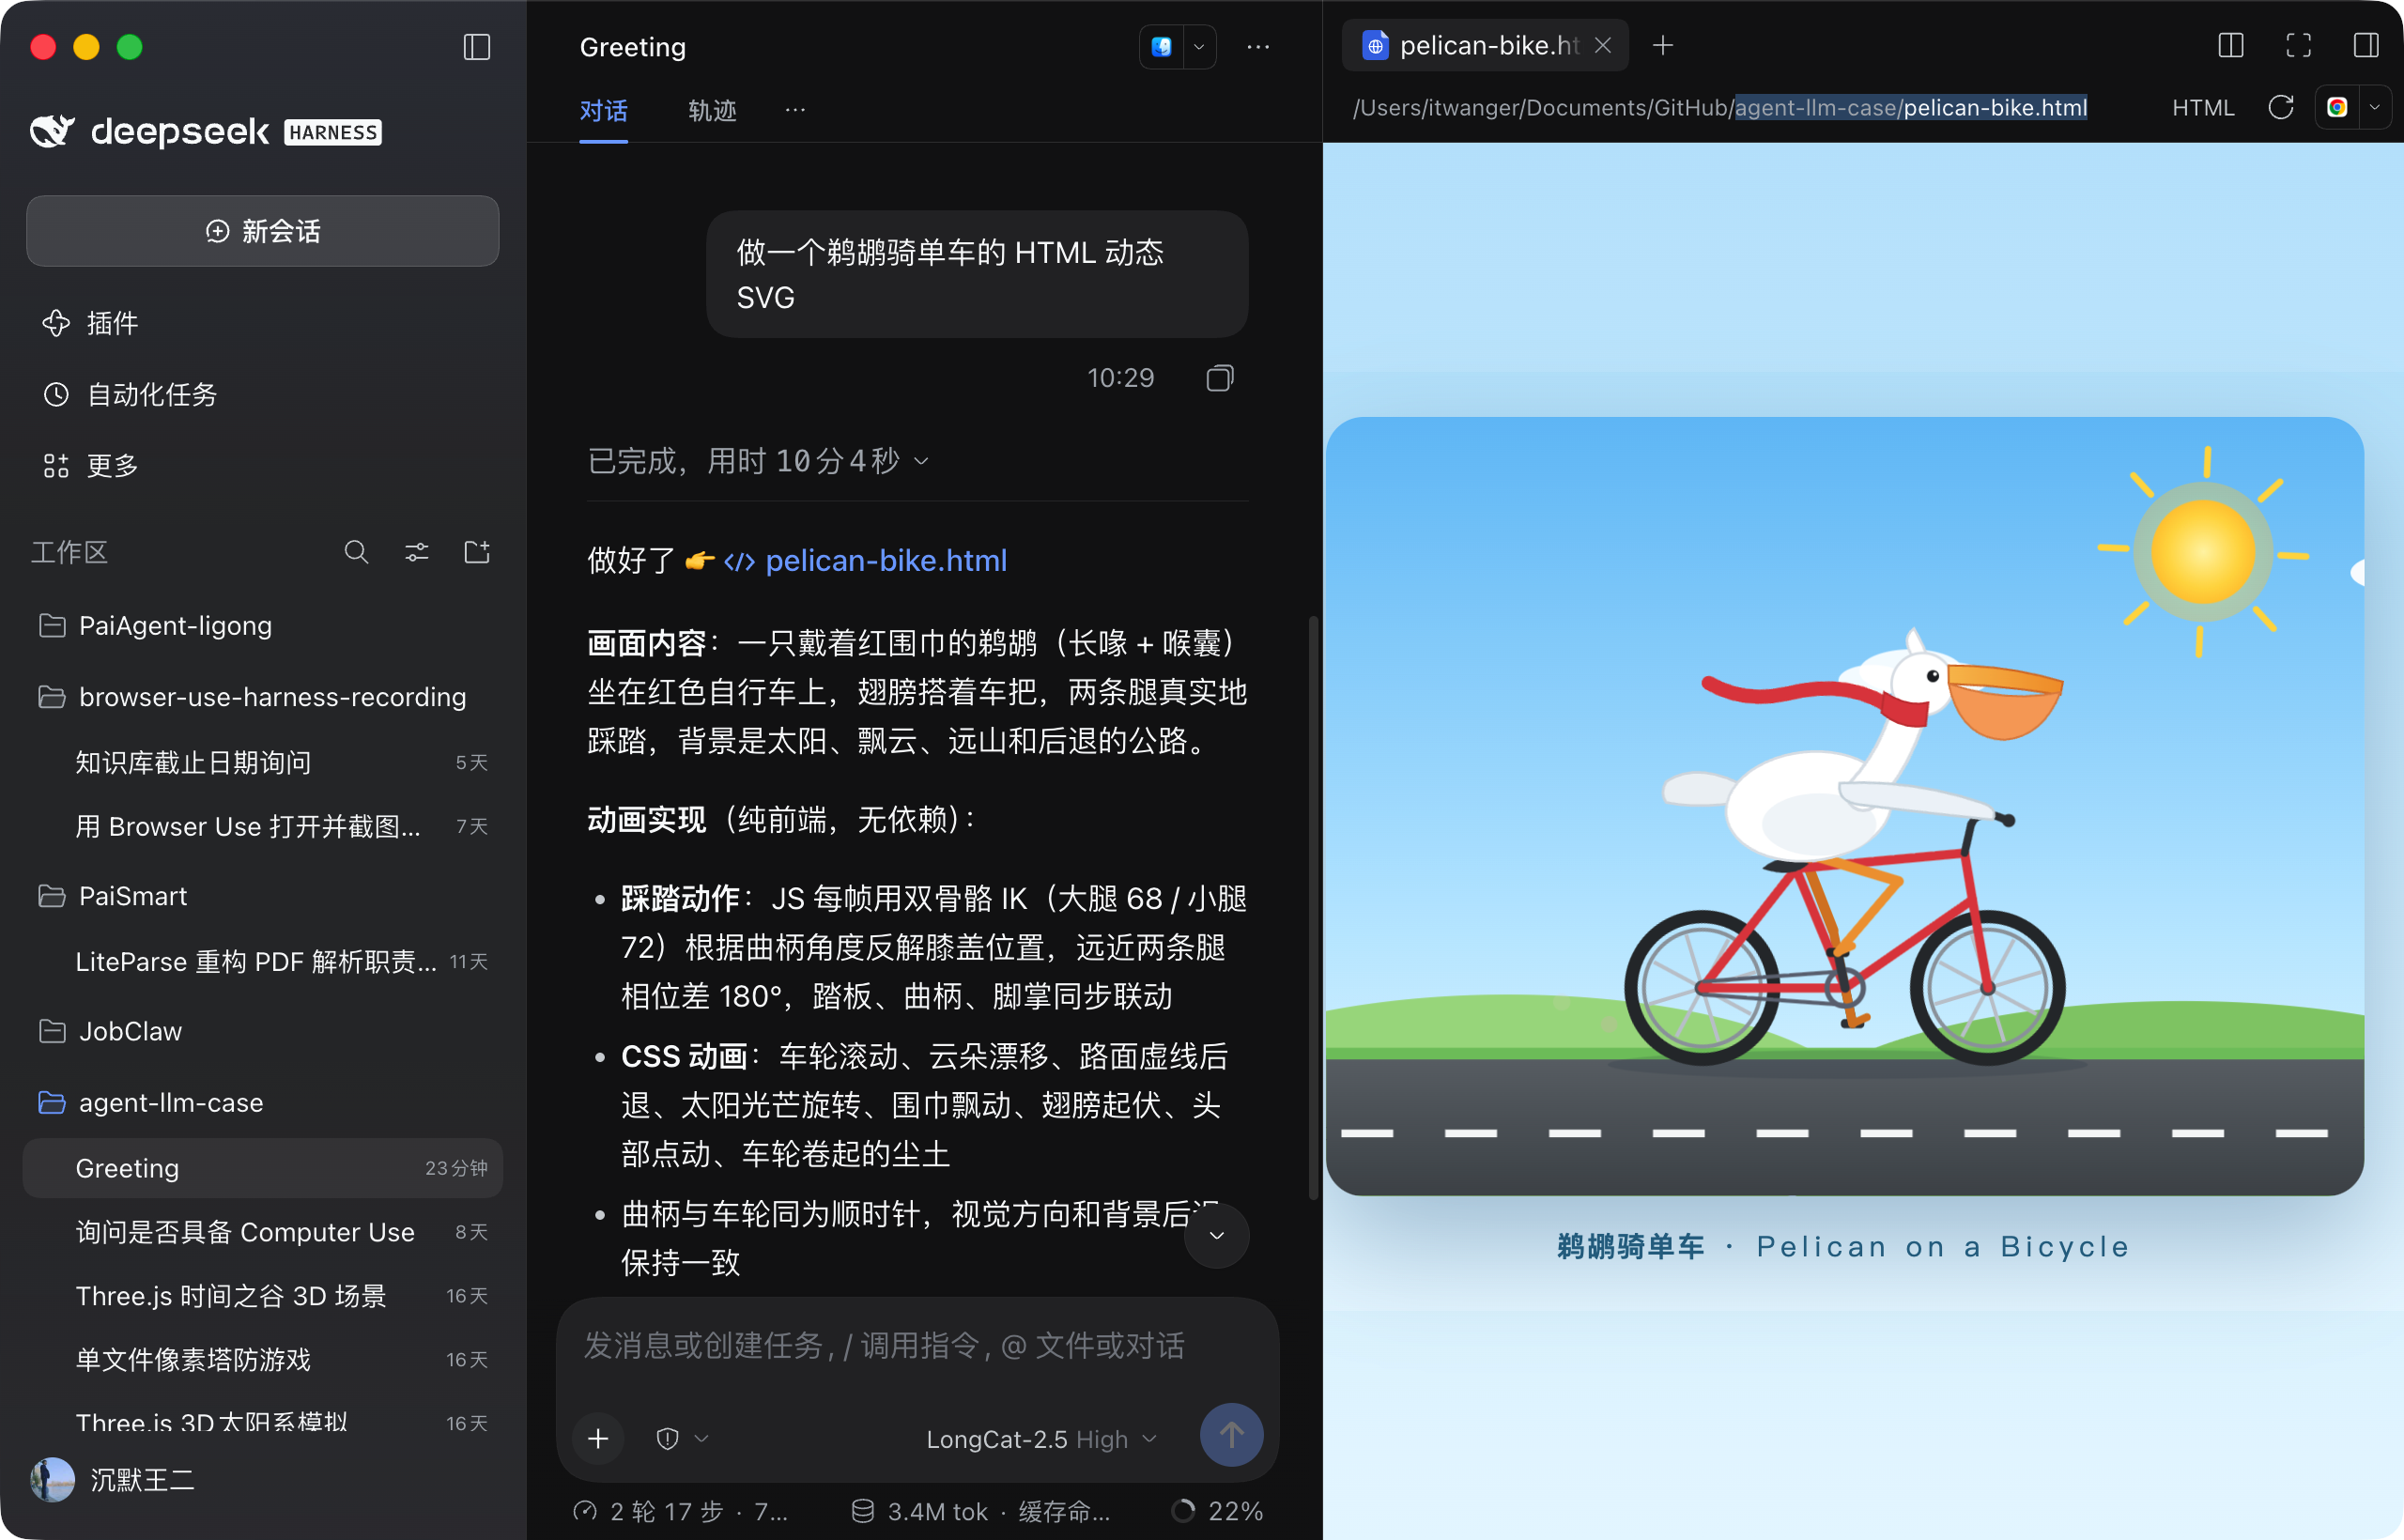
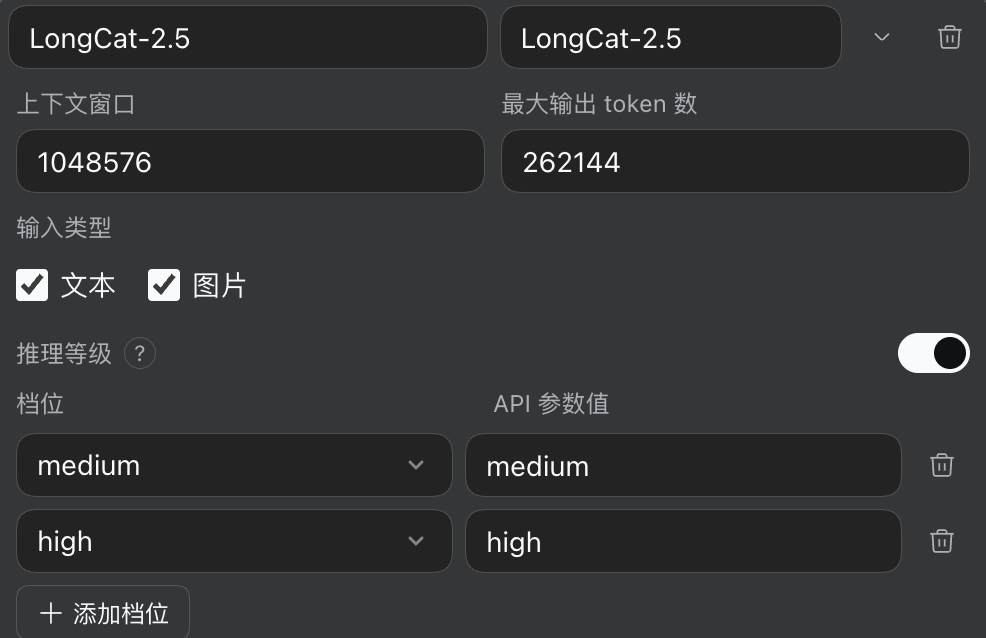
我第一时间在 DeepSeek Harness 里接入了 LongCat-2.5,切到 High 思考档位,测试了一下经典的“鹈鹕骑单车”。
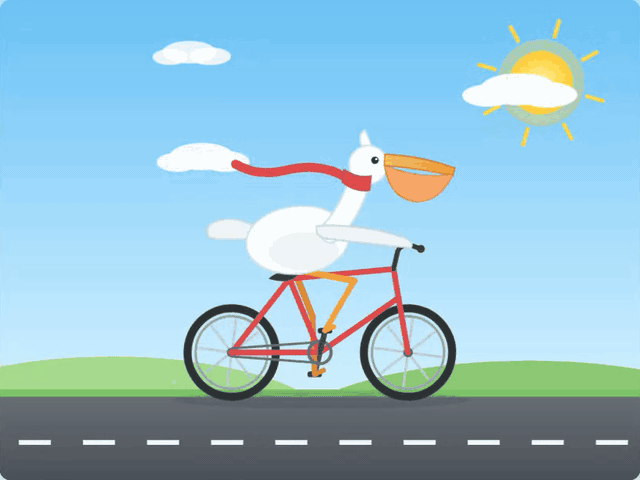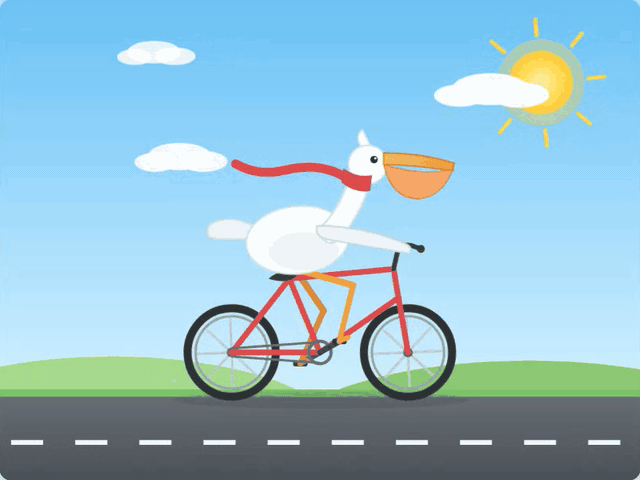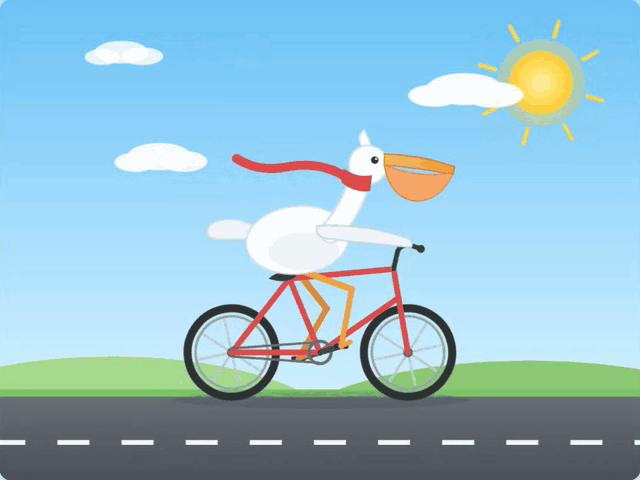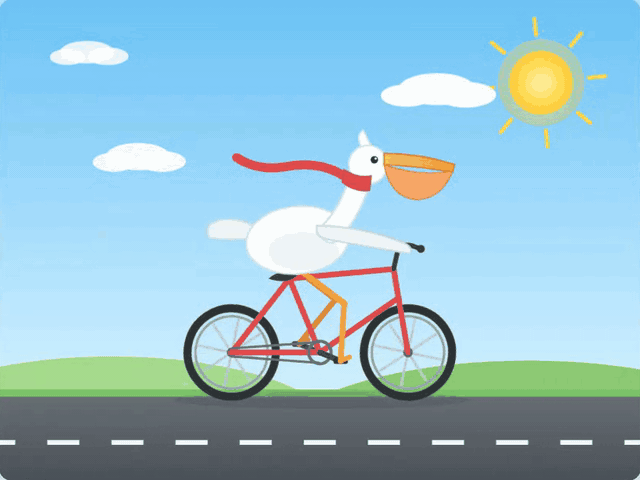
你看生成的页面,从蓝天白云、旋转的太阳、顺时针滚动的车轮,到鹈鹕踩动踏板、喉囊抖动和随风飘扬的红围巾,图层关系和物理动态一气呵成。
恭喜看到这里的你,已经成功击败 30% 的学习者。
那聪明的你一定会问,DeepSeek Harness 怎么接入 LongCat-2.5?
先去官方平台 longcat.chat 申请一个 API Key。它的接口同时兼容 OpenAI 和 Anthropic 协议,不管接入 Claude Code、Codex 还是 DeepSeek Harness 都很顺手。
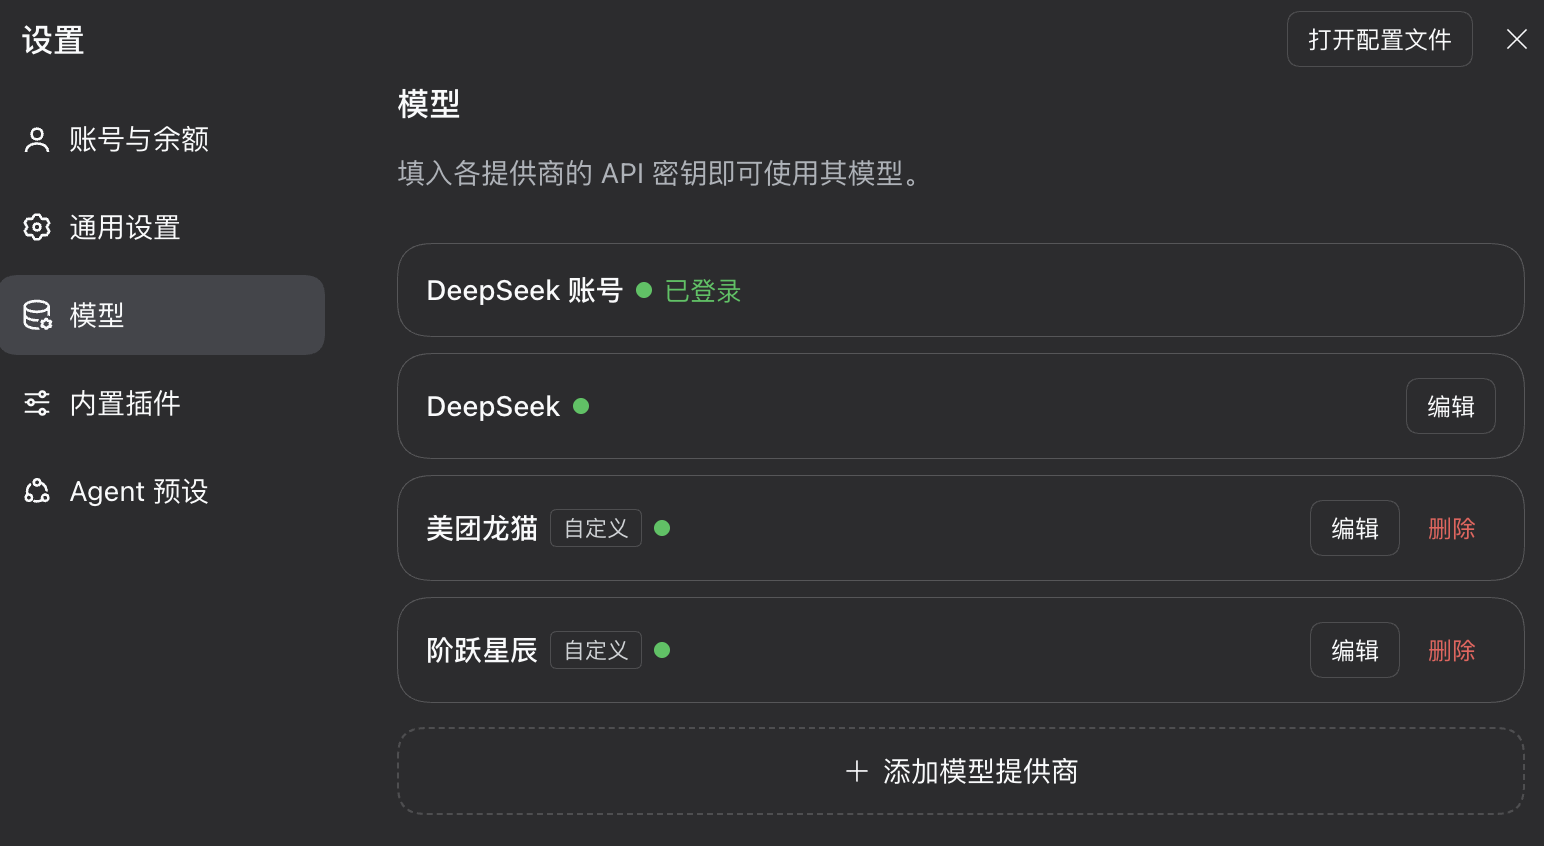
在 DeepSeek Harness 里打开设置,找到【模型】新增一个【美团龙猫】供应商,填入 API key,接口协议选 openai-completions,地址填 https://api.longcat.chat/openai/v1。
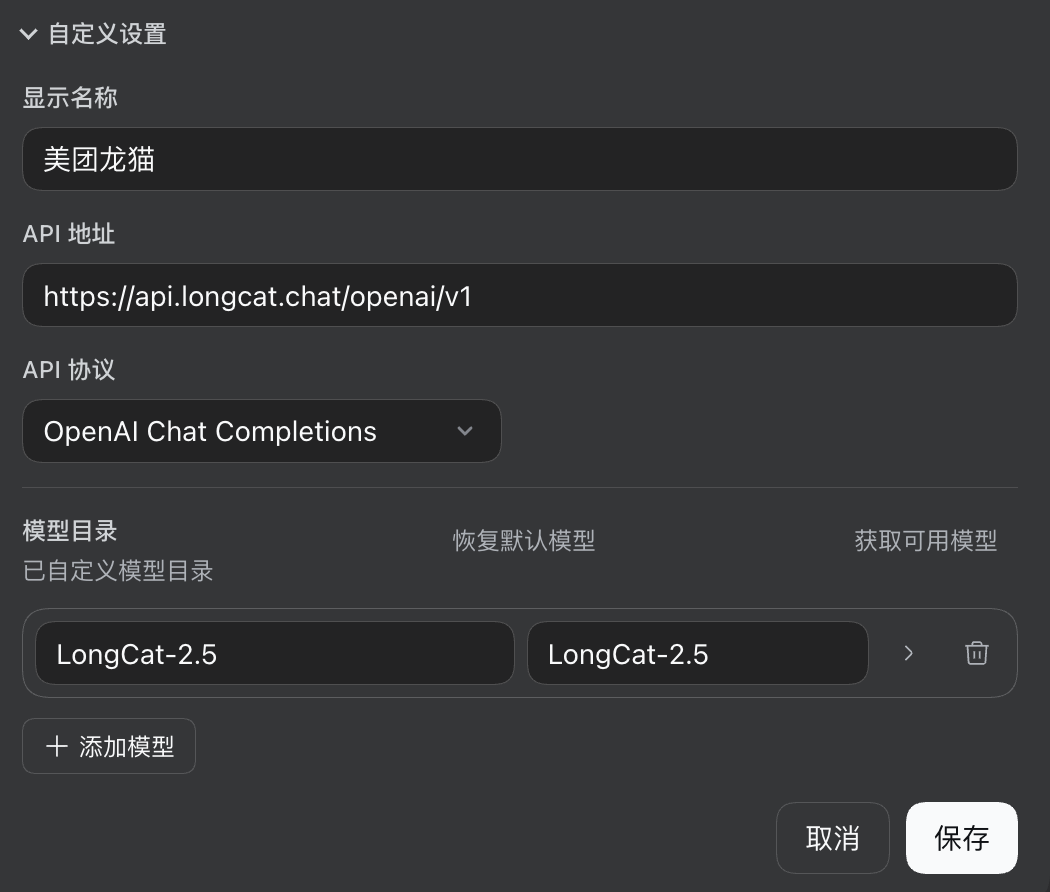
再在输入类型中勾选 文本 和 图片 就能调用了。API 的定价也很划算,输入未命中缓存每百万 Token 只要 2 元,命中缓存低至 4 分钱,输出每百万 Token 8 元。
恭喜看到这里的你,已经成功击败 50% 的学习者了。
那聪明的你肯定会继续问,LongCat-2.5 有哪些能力追上了 Opus 5?
综合官方公布的评测结果来看,LongCat-2.5 的整体成绩在 Opus 4.8 和 Opus 5 之间,在通用 Agent 和视觉编程榜单上拿下了多项第一。比如考察网页浏览检索的 BrowseComp,拿到了 91.9 分,超过了 Opus 5 的 90.8;考察跨应用自动化的 AutomationBench 拿到 51.8 分,超过了 Opus 5 的 50.3 分;在综合难度很高的 Agents' Last Exam v1.1 上拿到 38.5 分,领先 Opus 5 的 26.2 分。
恭喜看到这里的你,成功击败 70% 的学习者了。
聪明的你可能会继续问,LongCat-2.5 是怎么实现原生多模态的?
传统的多模态模型通常是在文本模型外面,单独挂一个独立的视觉编码器。文字走的是词表里的离散 Token,图片走的却是视觉编码器算出来的连续特征向量,中间靠投影层做映射,两种模态在底层并不是统一的表示。
LongCat-2.5 走的是原生多模态路线,把图片也变成了和文字一样的离散 Token。它先提取原生分辨率的图像特征,再通过残差向量量化(RVQ),去固定大小的视觉词表里查最接近的编号:第一层先匹配主体特征,再把没对齐的细节误差交给下一层继续查,最终转成多层级的离散视觉 Token。这套视觉词表和基座模型是一起联合训练的,图片和文字从一开始就处在同一个语义空间里。
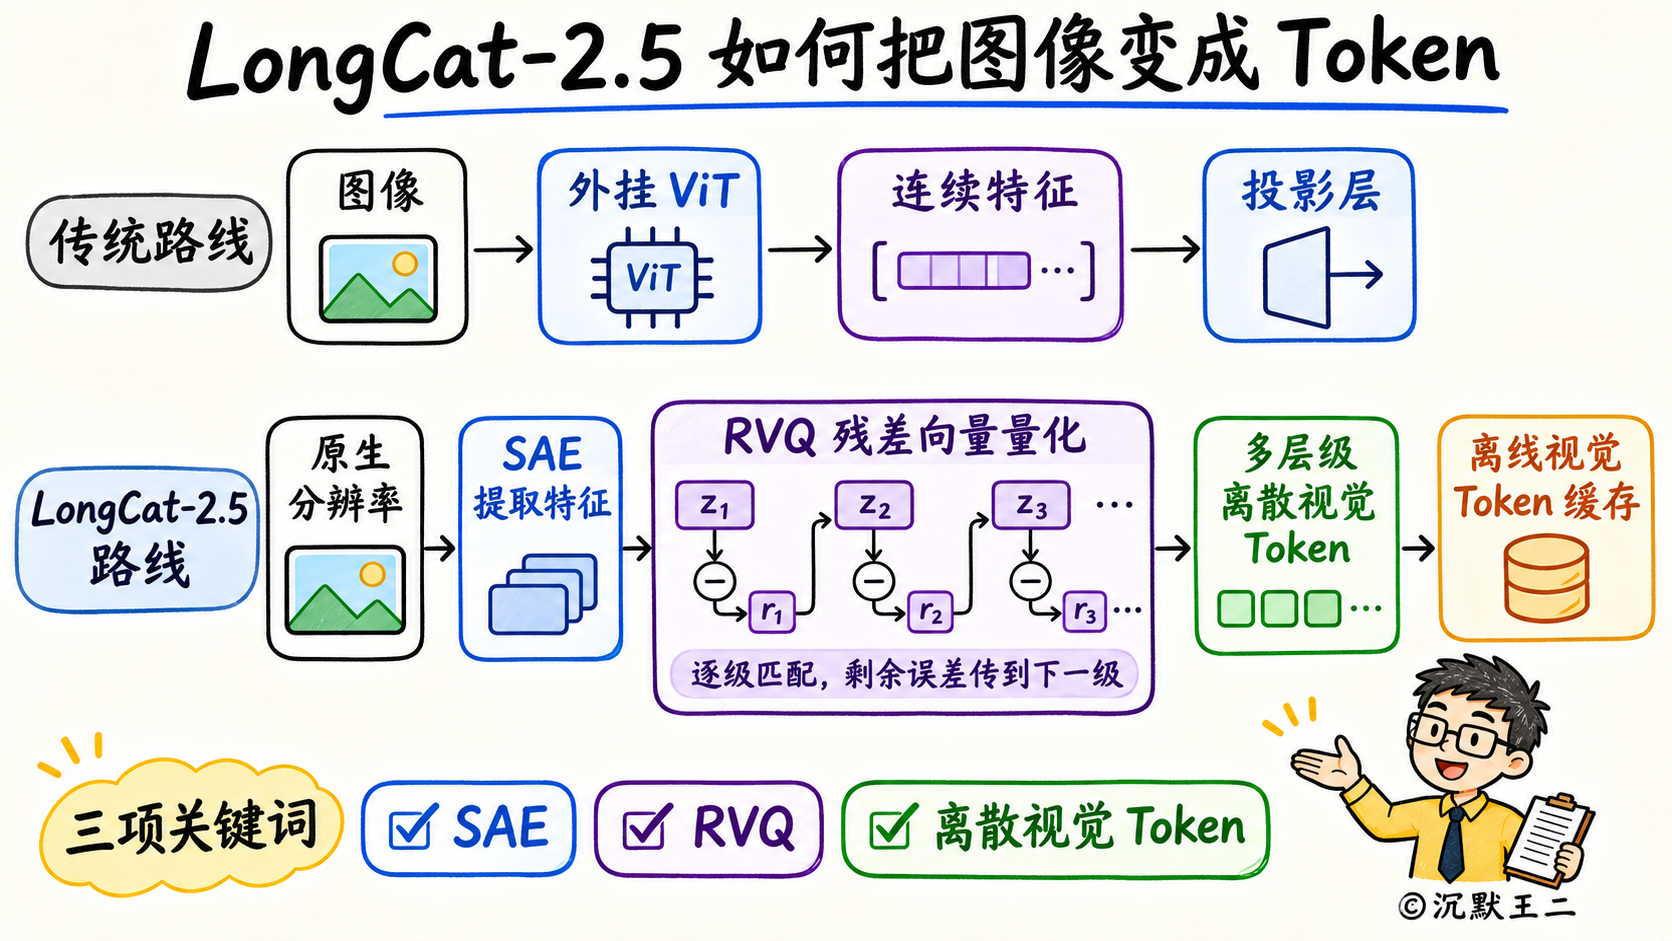
这样做还有一个好处。LongCat-2.5 的视觉分词器可以提前把图片离线转成 Token ID 缓存起来,基座模型直接读取计算好的 Token 序列就行,打包 1M 的长序列时也能按已知的 Token 数量把每张卡的图文比例分配均匀。
恭喜看到这里的你,成功击败 90% 的学习者了。
最后,聪明的你可能还会问,龙猫是怎么把成本压这么低的?
国产加速卡单张显存不到 80G,装不下 1.6 万亿的大模型,必须拆分到多张卡上一起跑。同一个机柜、也就是一个“超节点”里的卡,走内部的高速通道;但跨机柜就要慢一些。所以美团把需要频繁互传的计算,全部放在同一个超节点内部;同时把最占显存的数据拆分到不同超节点一起分摊,这样带来的好处是,单卡训练吞吐量提升了 86%。
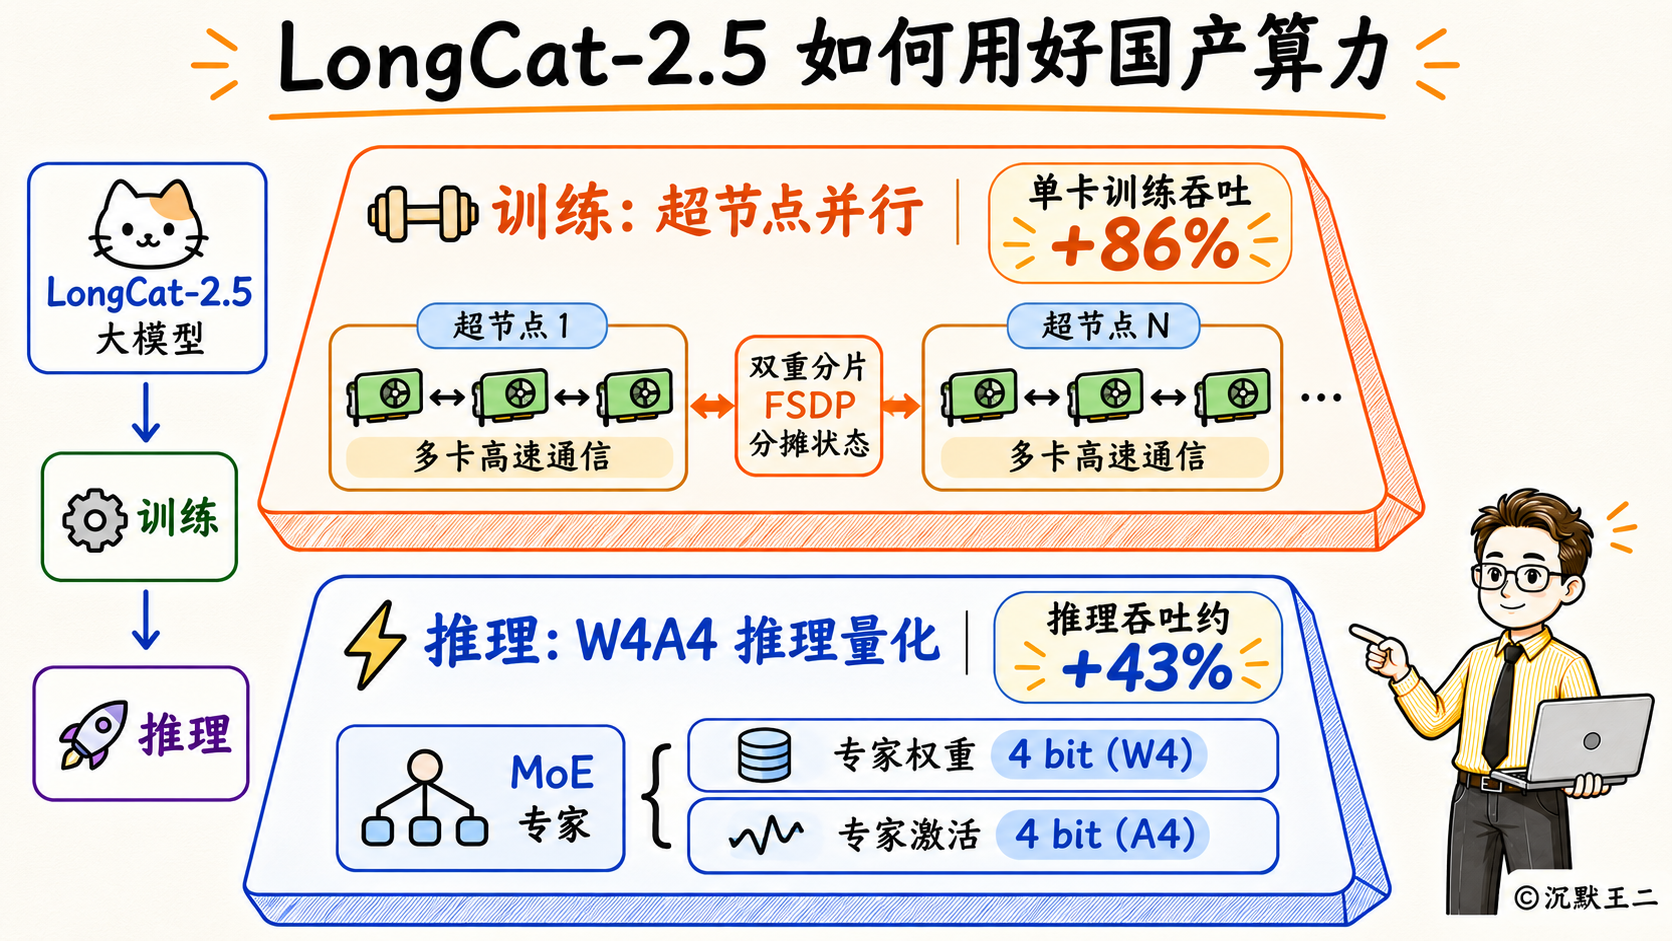
为了让 1.6 万亿参数的模型在线上跑得又快又省,美团结合国产芯片的硬件特点,落地了 W4A4 量化方案,也就是把 MoE 专家的权重和激活值同时压缩到 4 比特。而且在把 Token 复制并分发给各个专家之前,先一步完成量化,后面的通信和矩阵计算全程复用同一份 4 比特数据。线上压测下来,在精度和量化相当的前提下,相比 8 比特方案,Prefill 和 Decode 吞吐量提升了 43% 左右,首字延迟缩短了约 16%。
恭喜你升到王者段位了,成功击败 99% 的学习者。
最后简单总结一下,LongCat-2.5 是一个在国产算力上训练出来的 1.6 万亿参数原生多模态模型。在 DeepSeek Harness 里配置 OpenAI 兼容接口就能调用,跑分比肩 Claude Opus 5,API 命中缓存每百万 Token 只要 4 分钱。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!