
他们把这个 Super-agent 拉进了日常的聊天群和 GitHub 代码仓库,当成全天在线的同事来用。比如有人在群里提了一句,想给 DeepSeek Harness 加个字体设置的功能。维护者在群里艾特了一下 Super-agent,Super-agent 就去改好代码、然后提交 PR 到 GitHub;随后维护者跑到 GitHub 提修改意见,Super-agent 记得刚才在群里聊过什么,接着在同一个 PR 里把代码改完 merge。就算平时没人艾特它,Super-agent 也会自己盯着群里的反馈,主动排查原因并提交修复 PR。
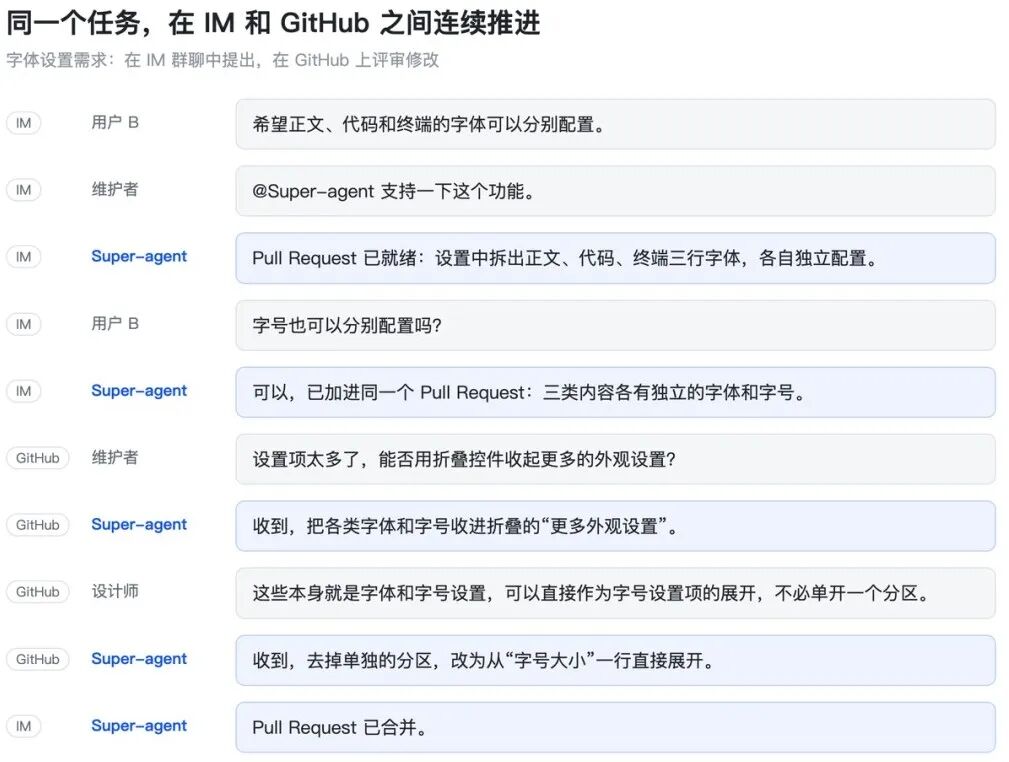
那聪明的你应该已经注意到了,平常我们用 Agent 都是在一个会话里一问一答,开多个 session 同时盯着又很累。Super-agent 是怎么做到同时干好几件事呢?
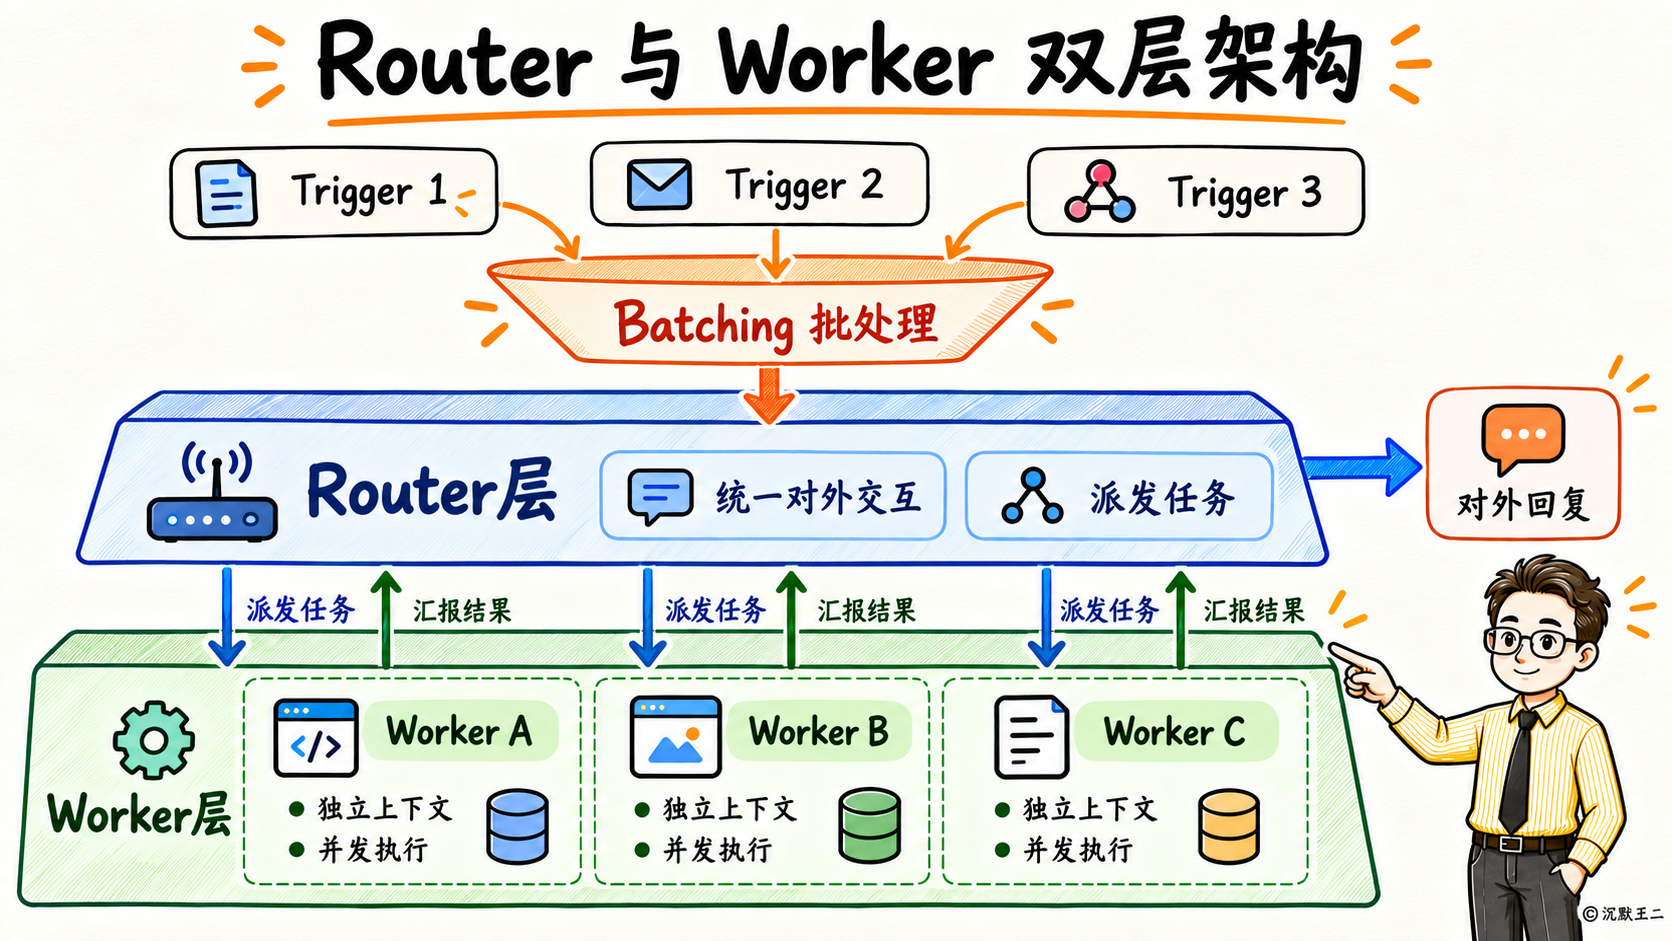
秘密在于 Super-agent 把 Agent 分成了两层,一层是常驻的 Router,负责对外输出和派活;一层是隔离的 Worker,负责后台干活。
恭喜看到这里的你,已经成功击败 30% 的学习者。
接下来我问你,Router 和 Worker 分别负责什么?
Router 可以用轻量模型,甚至可以不配 Bash 工具,只负责跟人沟通、维护全局记忆和派活;Worker 用最强的模型,挂载所有工具,每个 Worker 在独立的上下文里并发执行,跑完向 Router 汇报。DeepSeek Harness 团队实测下来,95% 的任务能在 15 分钟左右跑完,如果不用这套架构要 30 分钟。
那聪明的你肯定会问,只有一个 Router,消息一多会不会堵塞?
并不会。Router 在推理期间攒下的多个事件,会合并成一次请求发给大模型。这些事件在 Prefill 阶段是并行计算的,多几条消息,耗时可以忽略不计。
恭喜看到这里的你,已经成功击败 50% 的学习者了。
继续问你,Router 怎么过滤和派发消息?
第一步,按消息来源、群组和白名单过滤掉噪音,剩下的候选事件再交给大模型判断要不要处理。
第二步,同一个群聊话题或者同一个 PR 下面的后续消息,不用每次都找 Router 路由。Router 只在第一条消息进来时,派一个 Worker 去跟进;后面围绕这件事的所有回复,都会跳过 Router,直接交给 Worker 干活。
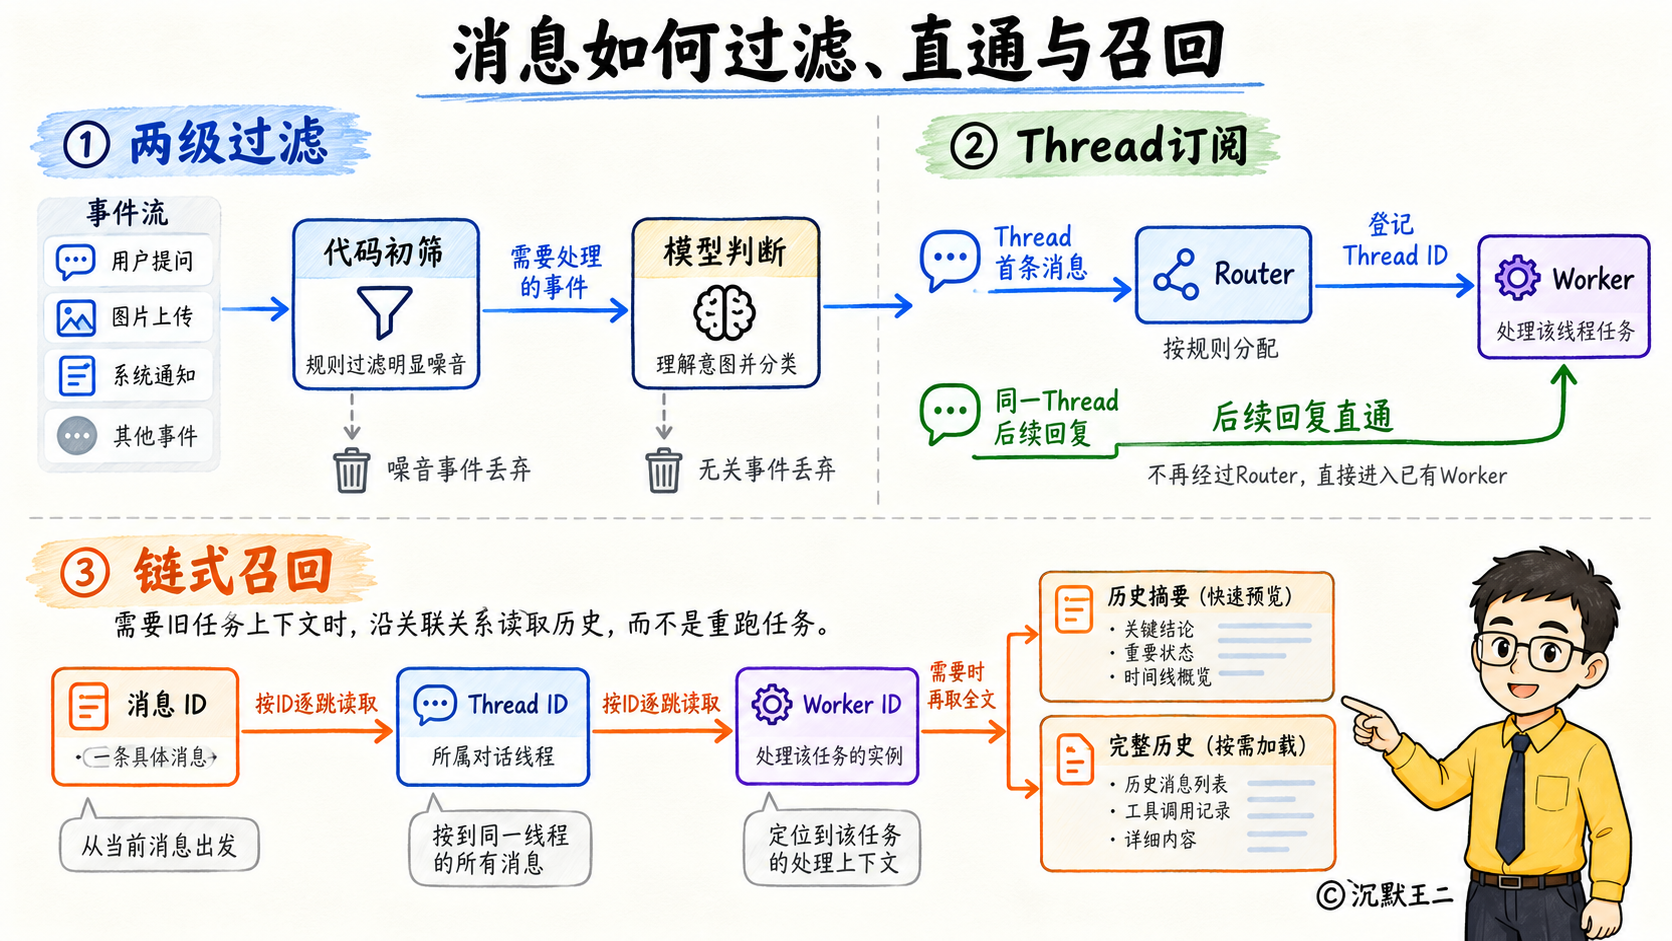
第三步,按需注入和召回上下文。新消息进来时,上下文里只放摘要、前后相邻的几条消息和关联 ID,超长内容先截断,模型需要全文时再调用工具读取。同时,每条消息、每个话题和每个 Worker 都绑定一个幂等 ID;如果后续消息跳过了 Router,当用户跨渠道提起某个旧任务时,Router 可以顺着关联 ID 重新读取历史记录,不必把所有任务的全量历史都常驻在上下文窗口里。
恭喜看到这里的你,成功击败 70% 的学习者了。
继续,跑耗时任务时 Super-agent 是怎么处理的?
Super-agent 把同步阻塞的工具调用,改成了由 start() 和 stop() 组成的异步 ReAct 循环。模型调用 start() 启动耗时命令或子任务后,工具会返回“已启动”状态,Agent Loop 不必停在原地等待执行结果,随时可以响应新的用户消息;等后台任务执行完毕,再把最终结果作为一条新的事件消息投递回主会话,如果任务运行了很长很长时间,模型也可以调用 stop() 主动终止。
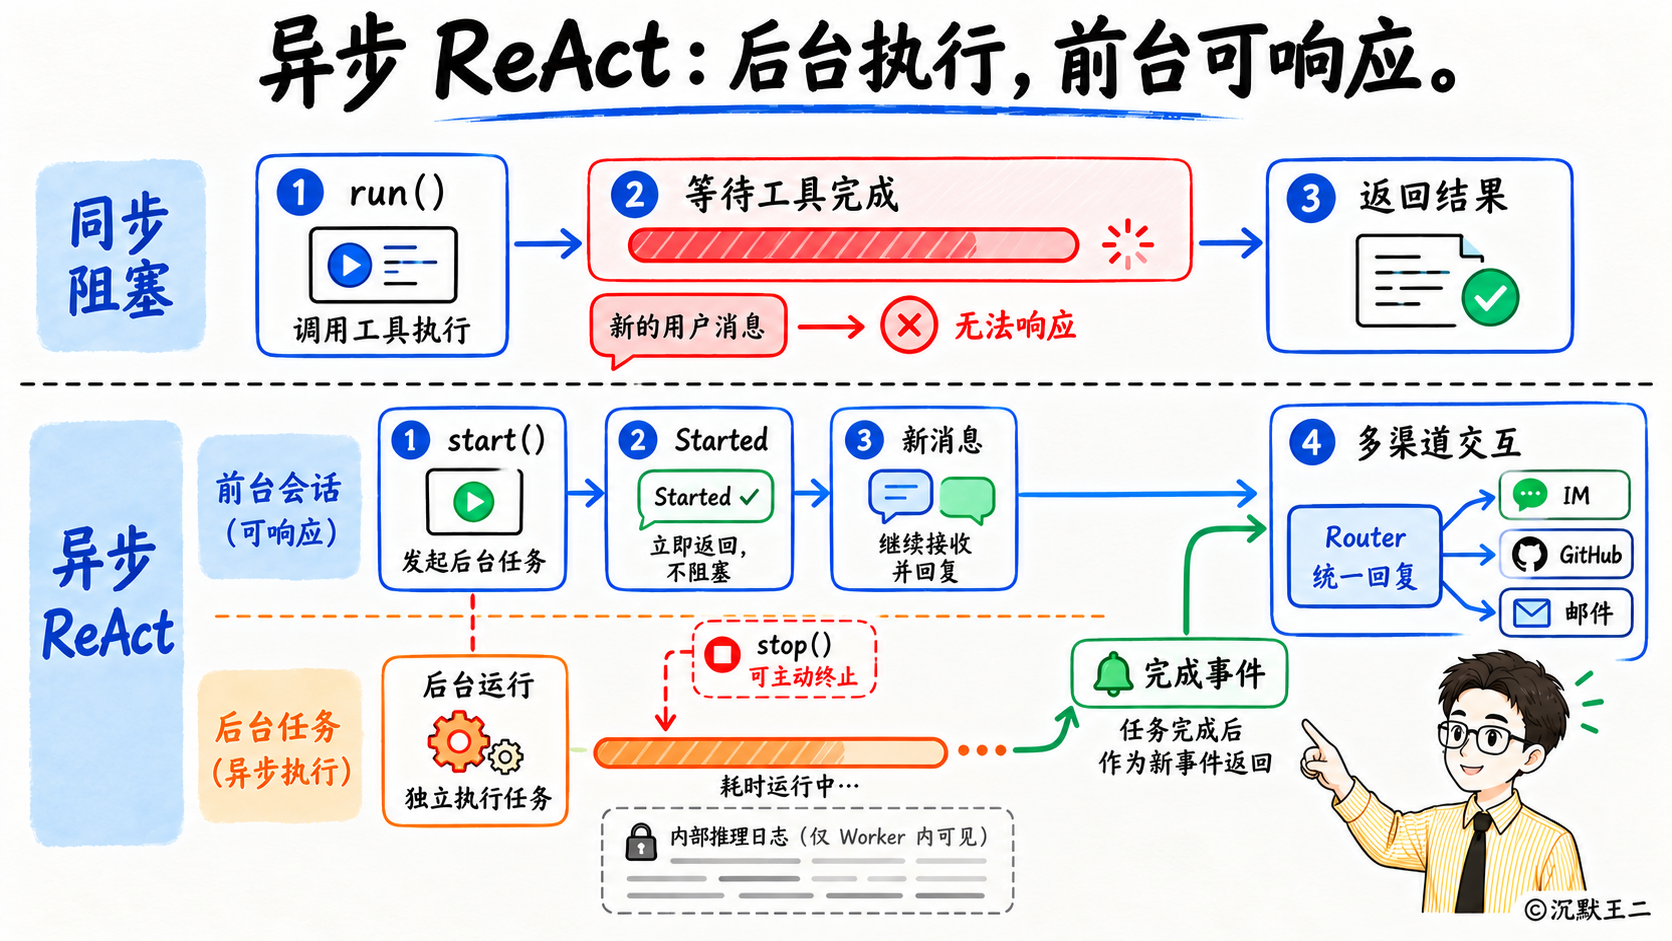
需要注意的是,耗时任务在后台执行时会产生大量的中间推理和工具调用日志,如果原样输出很容易刷屏。因此,执行过程中的输出全部隔离在 Worker 内部,只在需要决策或者交付结果时由 Router 对外统一回复。
恭喜看到这里的你,成功击败 90% 的学习者了。
最后再问你,Super-agent 陷入死循环了怎么办?
DeepSeek Harness 为系统配置了一个 Watchdog,俗称看门狗。Watchdog 除了处理接口报错这类底层故障,还会调用大模型去检查各个 Worker 有没有实质性进展,发现异常就会介入修复。
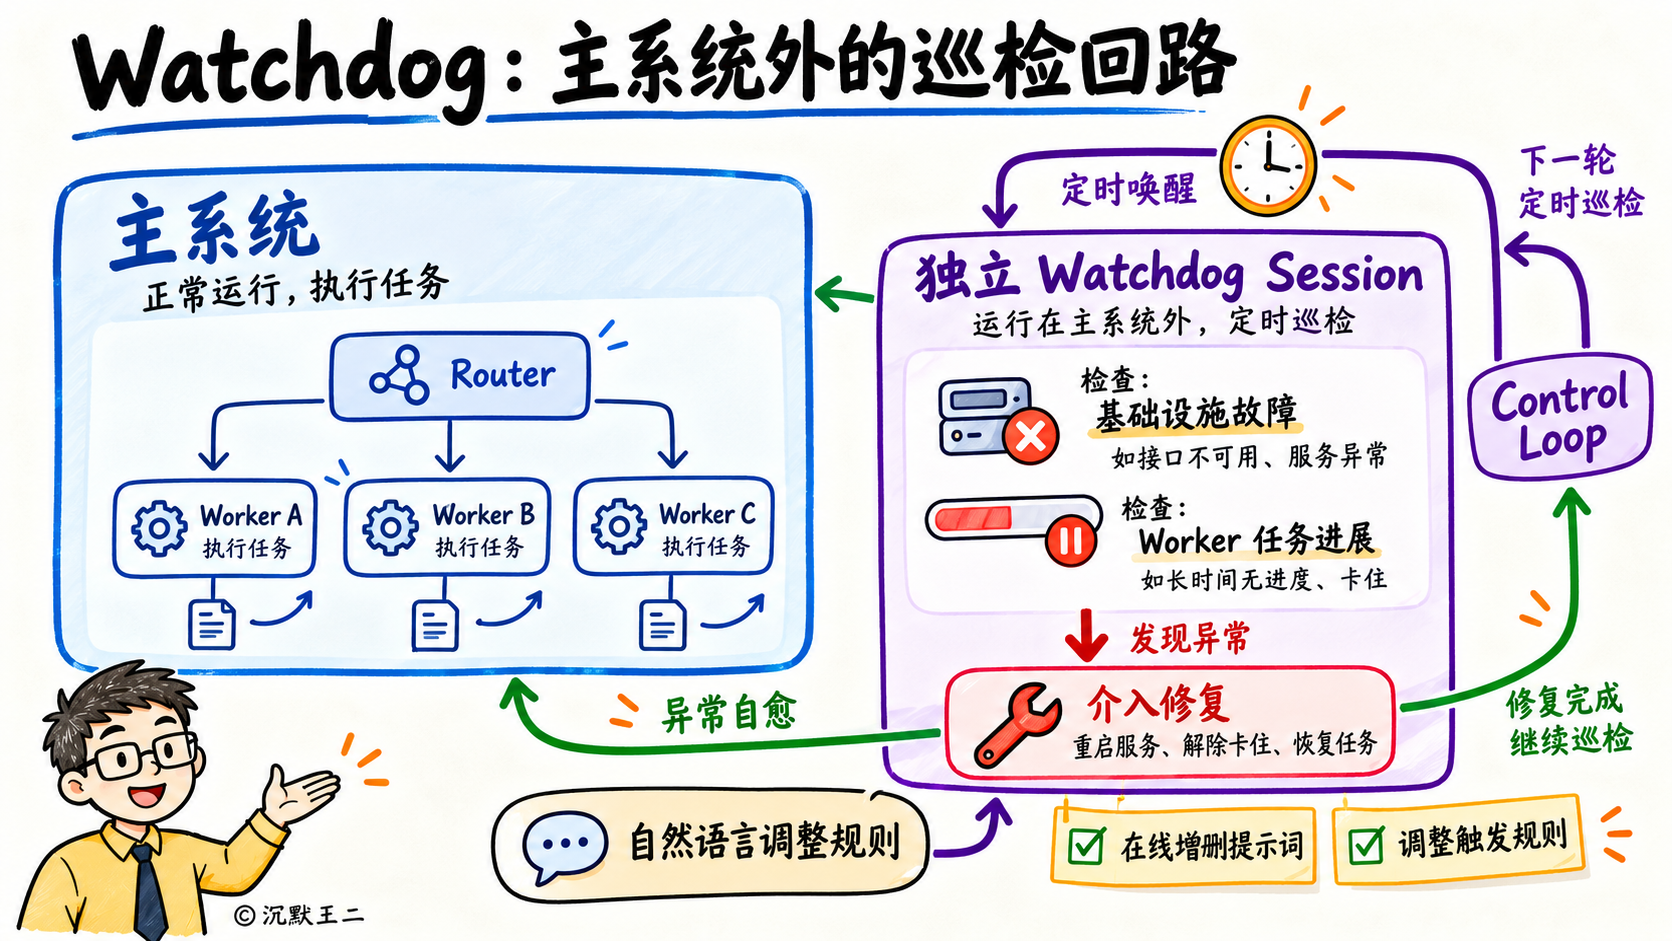
恭喜你升到王者段位了,成功击败 99% 的学习者。
最后简单总结一下,Super-agent 解决了单会话的任务瓶颈。Router 负责和用户沟通,以及派活,Worker 负责并发干活,再配一个 Watchdog 定时巡检、自动纠偏。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!