
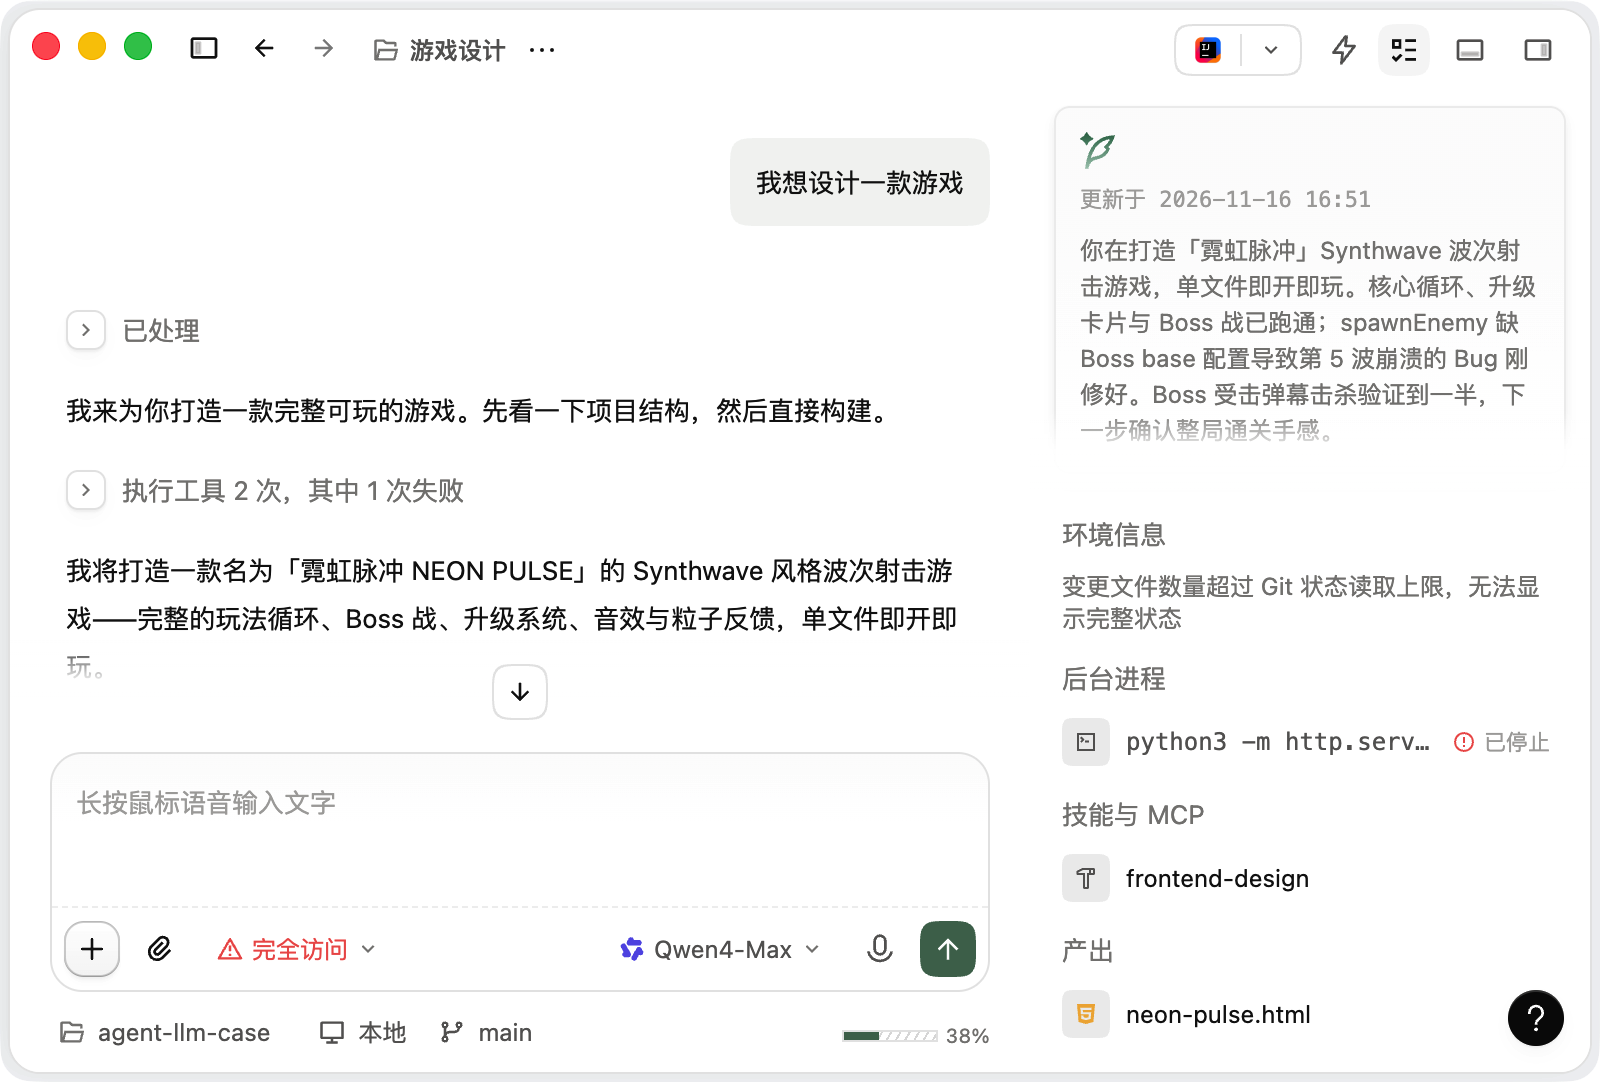
我已经在 Qoder 里用上了。
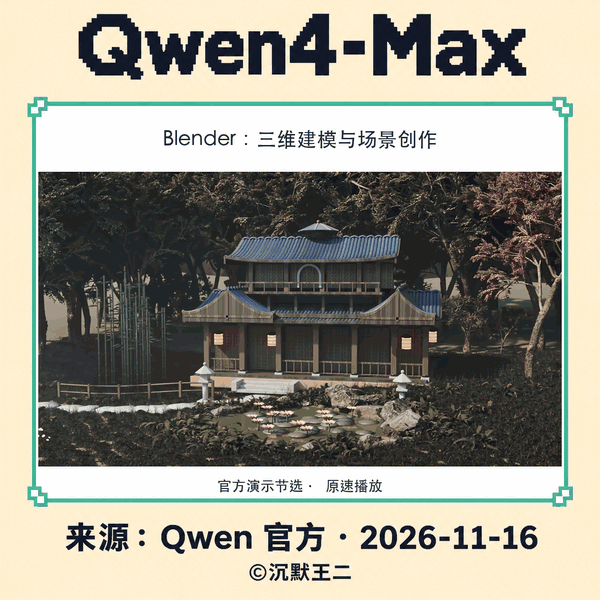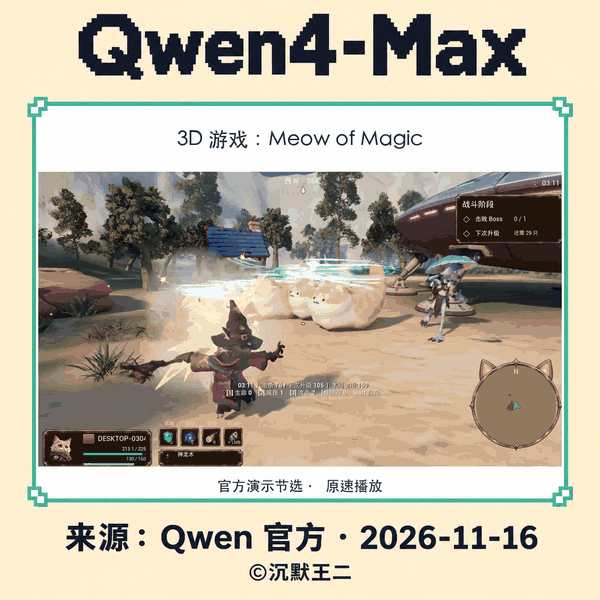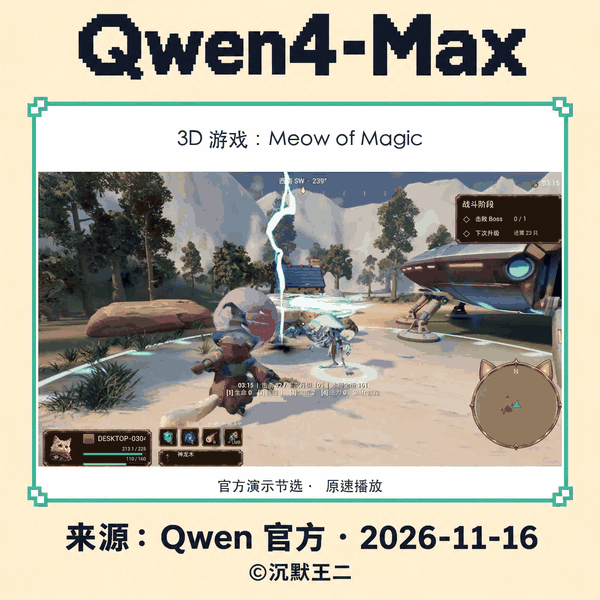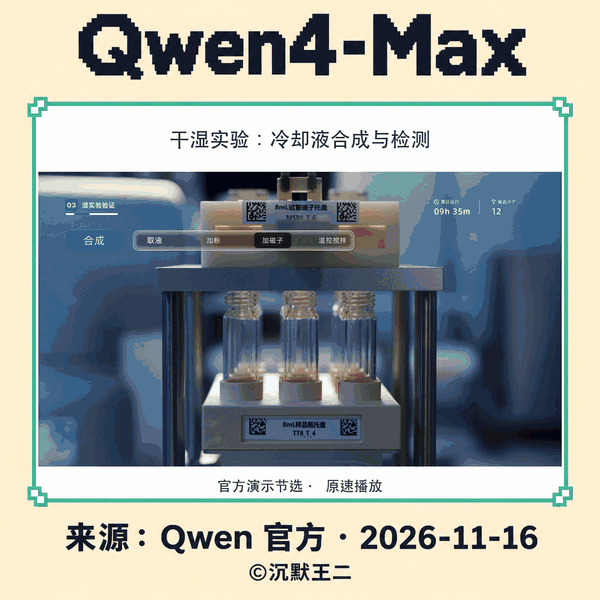
官方展示了不少实测案例。比如让它操作 Blender 完成建模和灯光渲染,再交给 3D 打印机做出实物;在 Unity、Unreal Engine 和 Godot 这些游戏引擎里,只要给它一句需求,就能自己搭场景、设计玩法和特效,开发过程中还会把游戏跑起来,看着画面调整镜头、角色动作和打击感,最后交出一款能直接玩的 3D 游戏。
恭喜看到这里的你,已经成功击败 30% 的学习者。
那聪明的你一定会问,Qwen4-Max 的实战能力处于什么水平?
先看三个专业领域的案例。在汽车工厂里,Qwen4-Max 能根据一张二维平面图搭出三维产线,并在机床开工前检查出刀具多切或少切的问题,把单个工件加工编程所需的人工投入,从 475 分钟缩短到 24 分钟。在一个重症病人的案例里,它一次读完了上万字的病历和 1433 张原始影像,从胸部 CT 里发现了“双肺背侧病变”,给出的四条治疗建议和主治医生当天开的医嘱完全对得上。在一家公司上市前的法律核查中,它把分几批送来、命名混乱的 198 份文件重新命名,归纳进 14 个文件夹,再上网核对公司的工商和诉讼信息,查出了“对赌协议”等风险,最后写出一份 86 页、6 万多字的核查报告,报告里每一处引用都能找到出处。
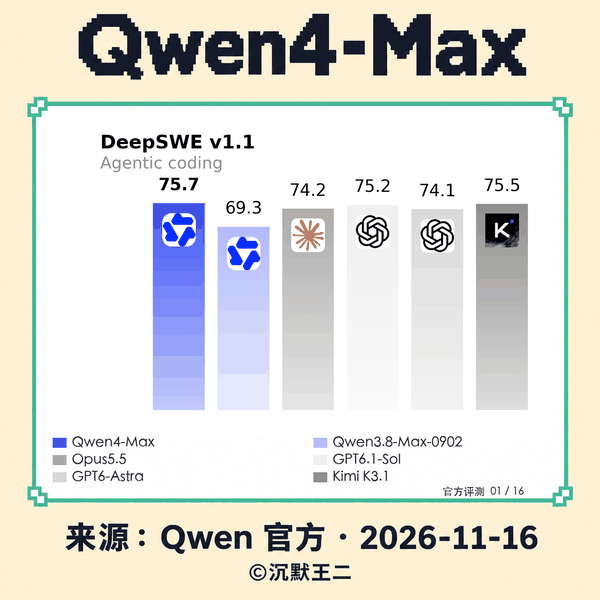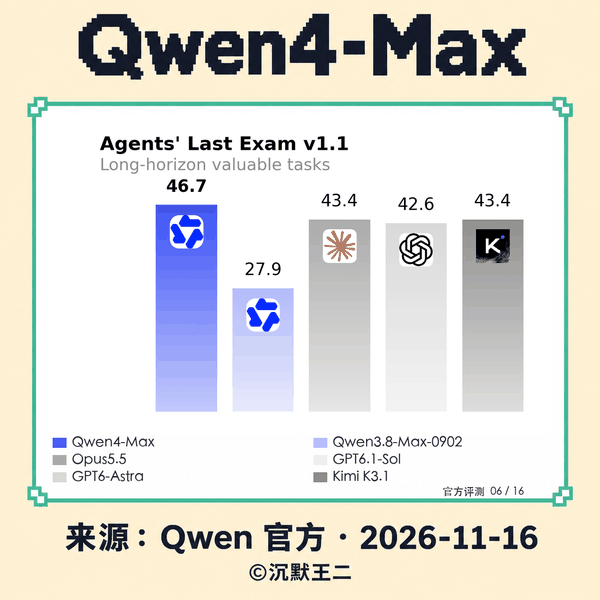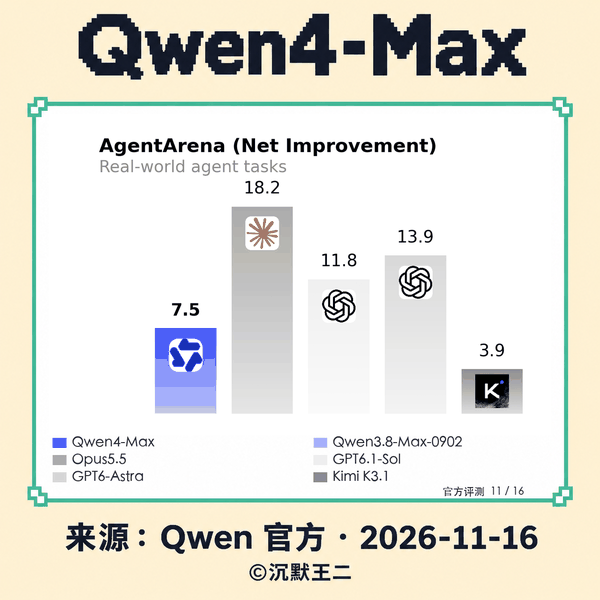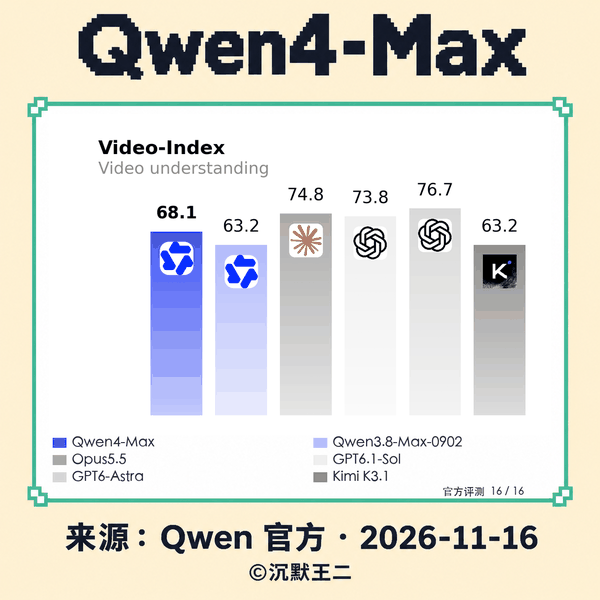
再看跑分。在考察 Agent 写代码能力的 DeepSWE v1.1 上,Qwen4-Max 拿到 75.7 分,排名第一,略高于 GPT-6.1 Sol 的 75.2 分和 Opus 5.5 的 74.2 分;在考察长时间复杂任务的 Agents' Last Exam v1.1 上拿到 46.7 分,也是第一,高于 Opus 5.5 的 43.4 分;在法律评测 HLAB-Vals-1.1 上拿到 21.3 分,是 Opus 5.5(9.2 分)的两倍多。
恭喜看到这里的你,已经成功击败 50% 的学习者了。
那聪明的你肯定会继续问,2.4 万亿参数的模型,为什么每个 Token 用到的参数反而比上一代少了 25%?
先说两个难题。第一个难题是长文本会浪费大量资源:传统注意力机制要让每个 Token 都和其他所有 Token 算一遍关系,文本长度翻一倍,计算量就翻四倍。第二个难题是重复计算:日常文字和代码里有大量固定搭配,比如“因为……所以……”,如果每次都让模型从头算一遍,既浪费算力,又拖慢速度。
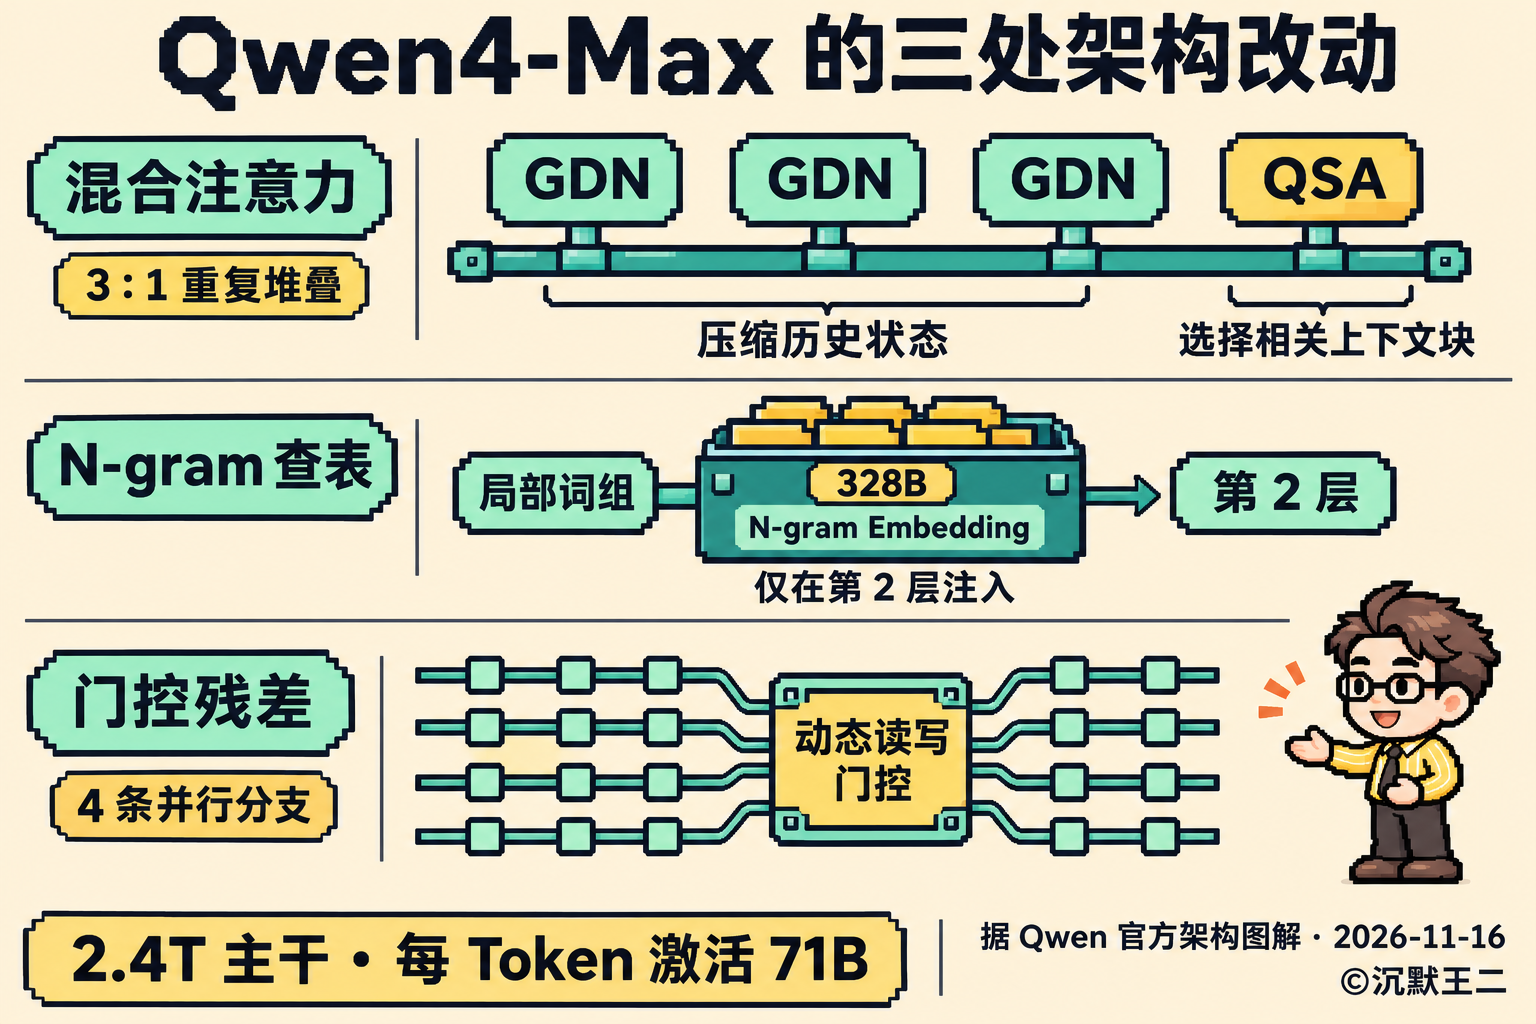
针对这两个难题,千问团队在 Qwen4 上做了三处改动。第一处是把注意力层按 3 比 1 混搭,每 4 层里,前 3 层用一种叫 Gated DeltaNet 的线性注意力,把前面读过的内容压缩成一份固定大小的摘要往下传,上下文再长,这份摘要也不会变大;第 4 层用千问稀疏注意力(QSA),先把上下文切成一块一块的,只挑出和当前内容有关的几块仔细计算。这样既不会漏掉 1M 上下文里的关键细节,计算量也小了很多。
第二处是 3280 亿参数的 N-gram 词表。N-gram 指的是经常连在一起出现的几个词,这张词表把常见的词组和代码搭配提前存好,只在模型的第 2 层使用。模型读到这些搭配时,直接查表就能拿到结果,后面的专家网络就不用再重复计算。所以 Qwen4-Max 虽然总共有 2.4 万亿参数,但每个 Token 只需要用到 710 亿参数,比上一代少了大约 25%。第三处是扩宽了层与层之间传递信息的通道,也就是残差连接,从原来的 1 条变成 4 条,再由门控机制决定每一层从哪条通道读、往哪条通道写。
恭喜看到这里的你,已经成功击败 70% 的学习者了。
聪明的你可能会继续问,Qwen4-Max 在跑长任务时表现如何?
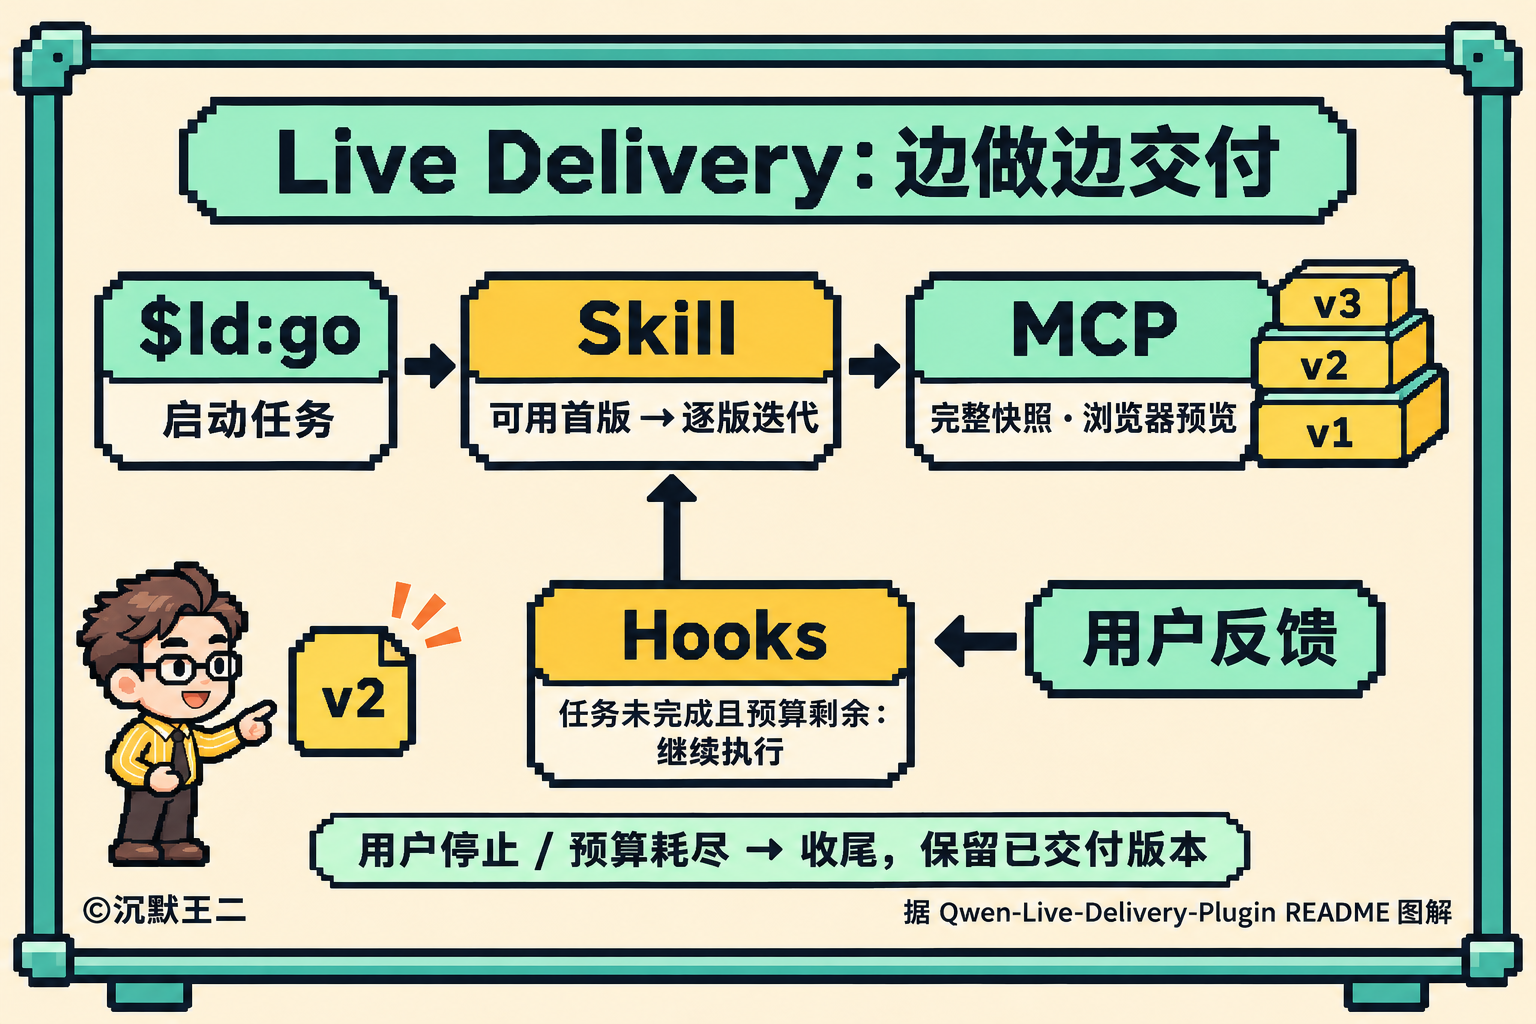
千问团队给 Qwen4-Max 加入了持续交付(Live Delivery)能力,还在 GitHub 上开源了配套插件,目前先支持了 Codex CLI。以官方演示的投资网站为例,这套插件分三个部分:第一部分是一个 Skill,它让 Agent 先做出一个能跑起来的简版,确认没问题后,再一版一版地加上策略回测和模拟交易等功能;第二部分是 MCP 工具,负责保存每一版的完整代码,并在本地浏览器里实时展示效果;第三部分是钩子(Hooks),也就是在 Agent 运行到特定节点时自动执行的脚本。只要时间还没用完、任务还没完成,钩子就会阻止 Agent 提前收工;你提出的新需求,钩子也会及时转交给 Agent。
恭喜看到这里的你,已经成功击败 90% 的学习者了。
最后聪明的你还会问,Qwen4-Max 的价格呢?
和上一代 Qwen3.8-Max 相比,API 价格全面下调,降幅达到 70%。输入每百万 Token 10 元,输出 30 元;如果输入内容命中了缓存,每百万 Token 只要 0.5 元。
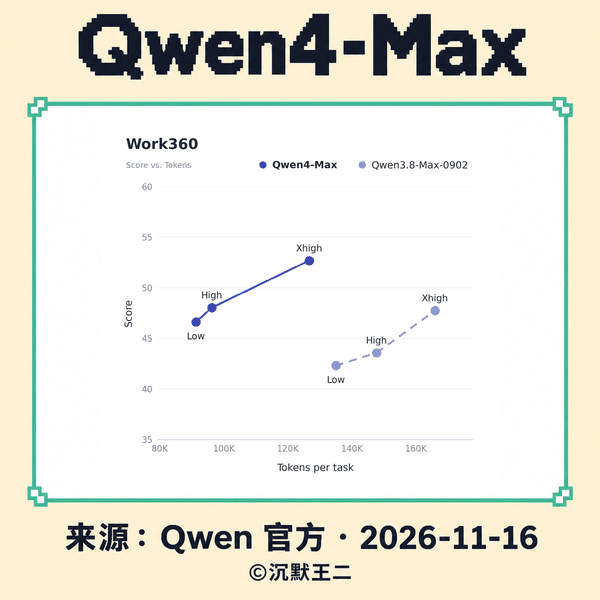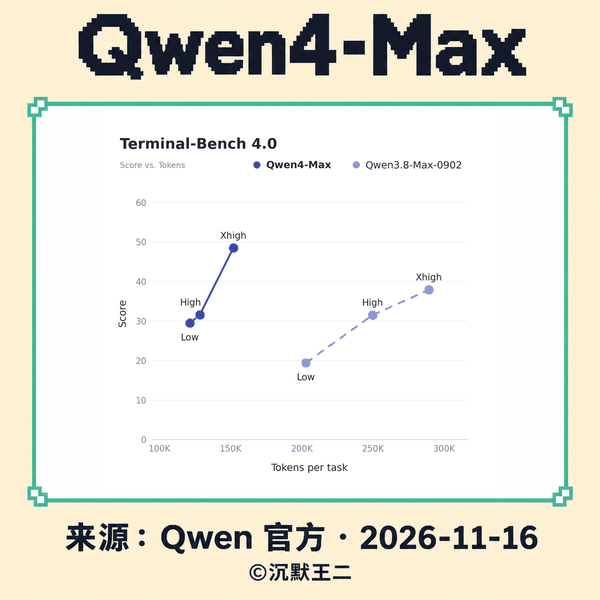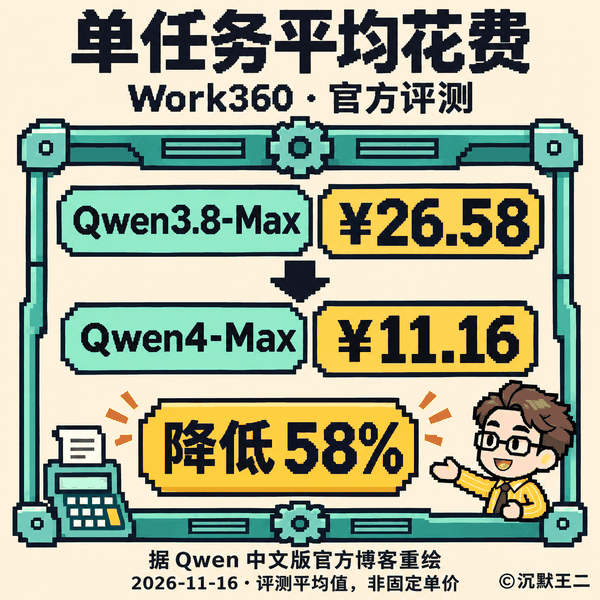
另外,千问团队和 Qoder 团队一起打磨了模型和 Agent 工具,模型做事时绕的弯路更少,完成同样的任务用的 Token 也更少。在 Work360 和 Terminal-Bench 4.0 上,单个任务用的 Token 少了 24% 到 49%。Work360 上单个任务的平均花费从 26.58 元降到了 11.16 元。
恭喜你升到王者段位了,成功击败 99% 的学习者。
最后简单总结一下,Qwen4-Max 是阿里最新发布的 2.4 万亿参数旗舰模型。它靠 3 比 1 混搭的注意力、常见词组表和残差通道,把每个 Token 用到的参数降到了 710 亿。再加上配套开源的持续交付插件,单个任务的平均花费比上一代省了 58%。
这个知识点你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见!