大家好,我是二哥呀。
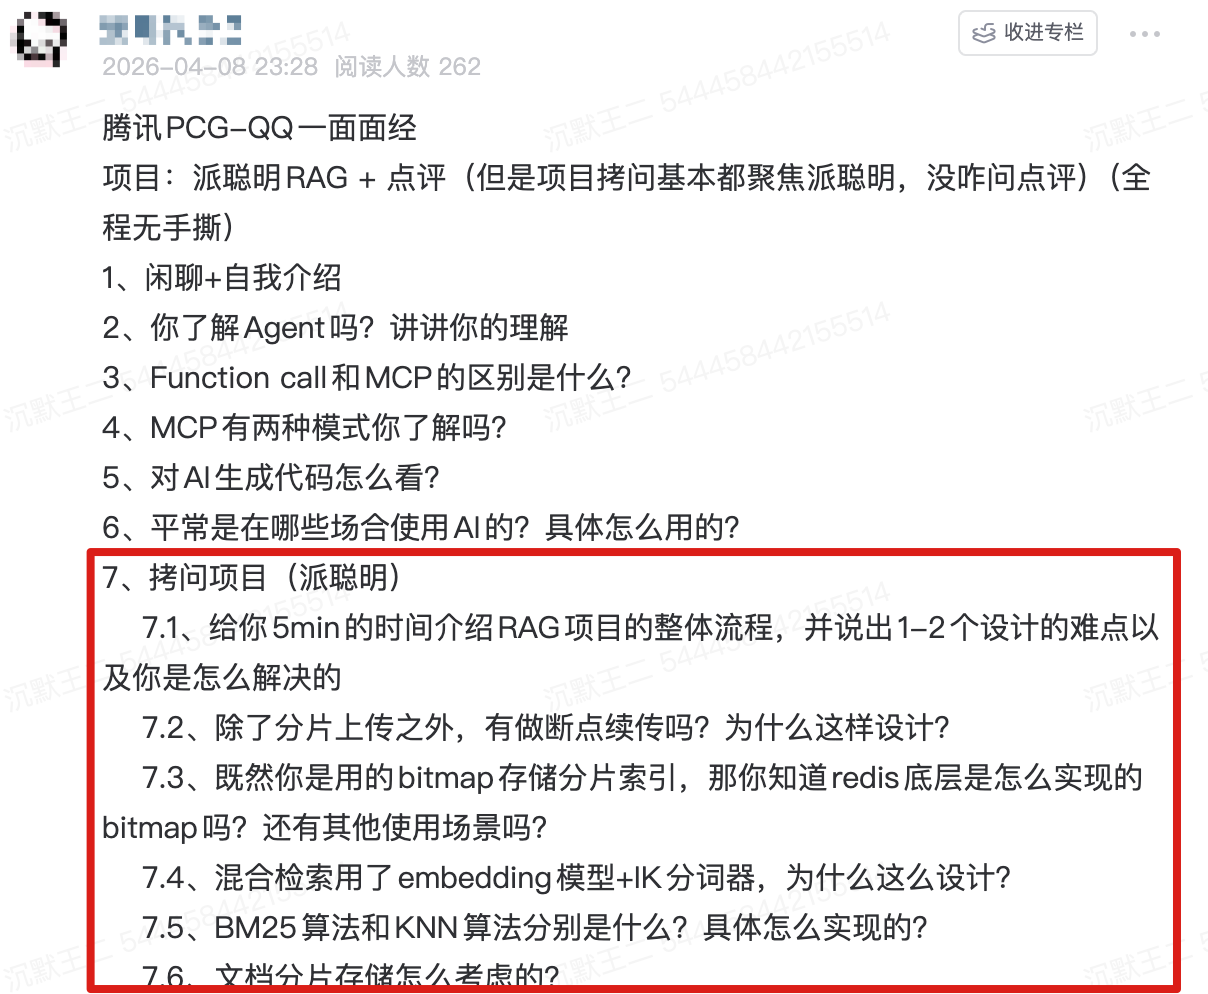
不少球友拿派聪明去面试,回来跟我说,面试官问得越来越细了。以前问混合检索怎么做、分块怎么切,现在开始问,你们的 RAG 效果怎么评估的?测评集有多少道题?改了一个参数,怎么证明它变好了?
这个问题如果只能回答“我自己试了几个问题,感觉挺准的”,面试官基本就不往下问了。
说来惭愧,派聪明的评测框架其实早就写好了,检索指标、LLM 评委、人工复核接口都在,但一直忙,忙王二讲Agent的脚本和视频,忙简历修改,忙星球的提问,忙开发新的项目,一直拖着这件事。没办法,一个人的精力实在是有限。
终于,这几天压缩出来了一点时间,加上Opus 5.5的协助,我把测评集这件事搞定了,覆盖事实查询、口语化提问、多文档综合、资料冲突、无答案拒答等 7 类场景,然后老老实实运行了十来轮。
大约 28 分钟